
消息队列 / 知识点
RabbitMQ 开发与排障手册
手册条目
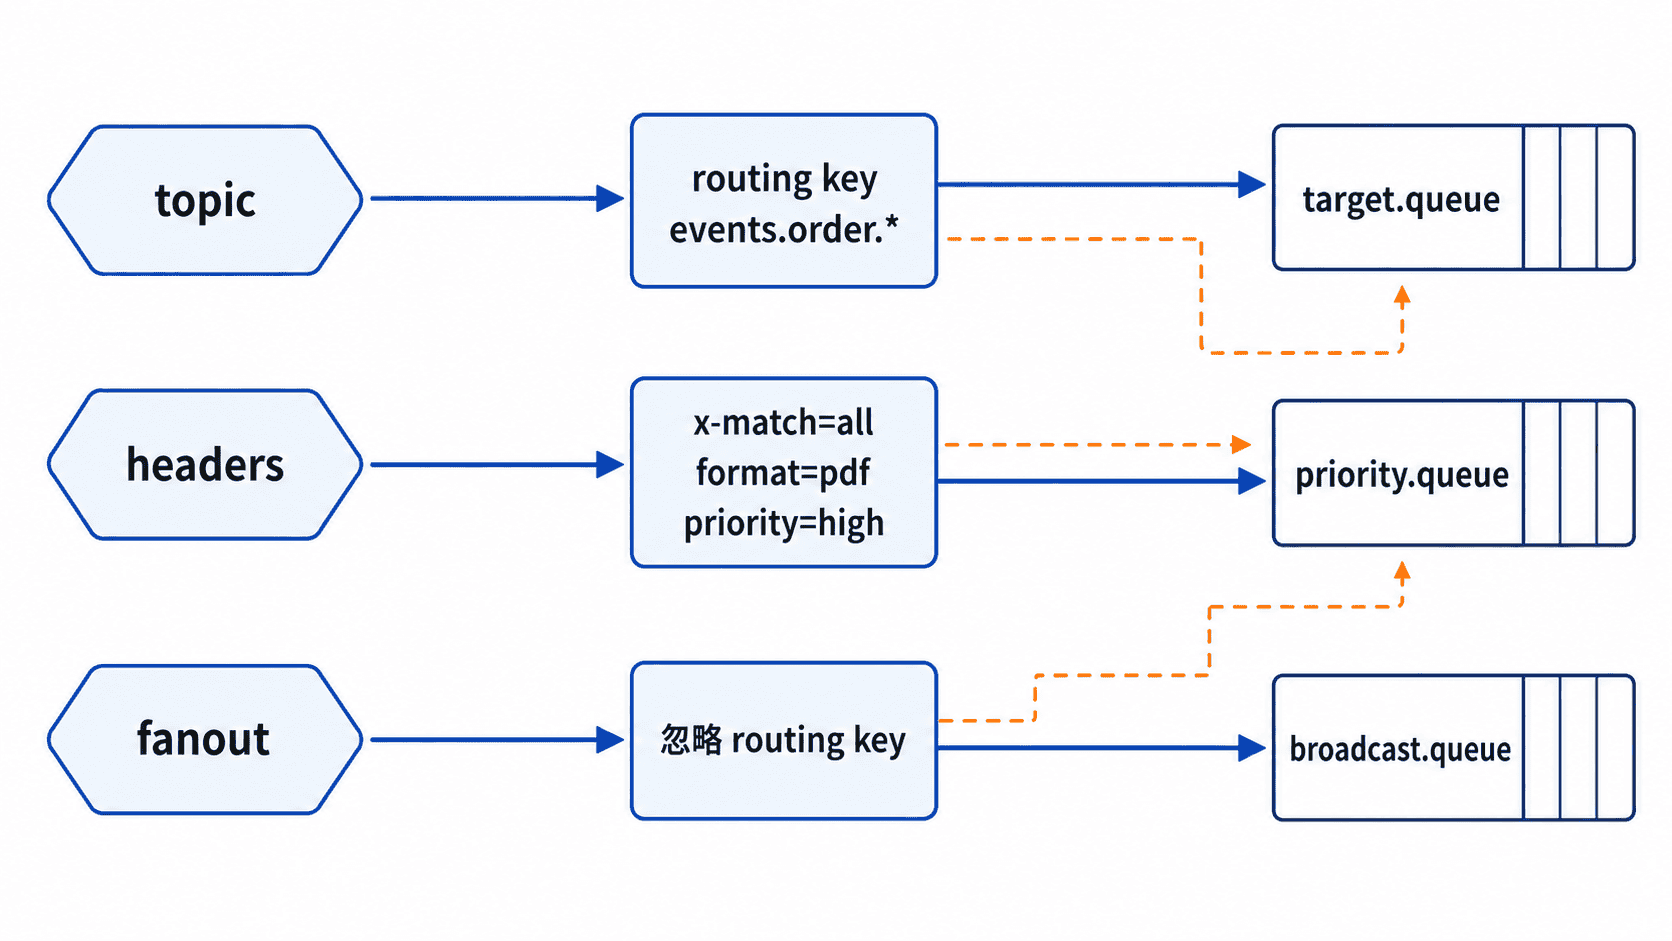
使用 routing key 或 headers 参数建立交换机到队列的绑定。
绑定队列
在交换机与已存在的队列之间建立绑定,用于定义消息从交换机进入队列的匹配条件。direct、topic 通常使用 routing key;headers 使用绑定参数;fanout 会忽略 routing key。
前置条件
交换机、队列必须位于同一个 vhost 且已存在。通过 Management HTTP API 操作时需启用 rabbitmq_management,账号需要访问该 vhost;创建绑定还要求对目标队列具备写权限、对源交换机具备读权限。
基本语法
HTTP API 使用 POST /api/bindings/{vhost}/e/{exchange}/q/{queue}。请求体中的 routing_key 和 arguments 均可选;路径里的 vhost、交换机名和队列名必须进行 URL 编码,默认 vhost / 写成 %2F。
高频用法
下面分别创建 topic routing key 绑定和 headers 参数绑定。示例假定 vhost 为 events,相关交换机与队列已经声明;密码使用环境变量传入,避免直接进入 Shell 历史。
export RMQ_API='http://127.0.0.1:15672'
export RMQ_USER='ops'
export RMQ_PASS='<PASSWORD>'

# topic 绑定:消息 routing key 命中 events.order.* 时进入 target.queue
curl -sS -o /dev/null -w 'topic binding: %{http_code}\n' \
  -u "$RMQ_USER:$RMQ_PASS" \
  -H 'Content-Type: application/json' \
  -X POST \
  --data '{"routing_key":"events.order.*","arguments":{}}' \
  "$RMQ_API/api/bindings/events/e/events.topic/q/target.queue"

# headers 绑定:消息头同时满足 format=pdf 与 priority=high
curl -sS -o /dev/null -w 'headers binding: %{http_code}\n' \
  -u "$RMQ_USER:$RMQ_PASS" \
  -H 'Content-Type: application/json' \
  -X POST \
  --data '{"routing_key":"","arguments":{"x-match":"all","format":"pdf","priority":"high"}}' \
  "$RMQ_API/api/bindings/events/e/events.headers/q/priority.queue"
预期输出
topic binding: 201
headers binding: 201
201 表示绑定已创建。重复提交完全相同的源、目标、routing key 和参数不会产生新的路由效果;参数不同则可能形成另一条绑定。
验证绑定
按 vhost 查询绑定并只提取关键字段,避免在大型集群中拉取所有 vhost 的完整拓扑。
curl -sS -u "$RMQ_USER:$RMQ_PASS" \
  "$RMQ_API/api/bindings/events" |
jq '[.[] |
  select(.source == "events.topic" or .source == "events.headers") |
  {
    source,
    destination,
    routing_key,
    x_match: (.arguments["x-match"] // null)
  }]'
预期输出
[
  {
    "source": "events.topic",
    "destination": "target.queue",
    "routing_key": "events.order.*",
    "x_match": null
  },
  {
    "source": "events.headers",
    "destination": "priority.queue",
    "routing_key": "",
    "x_match": "all"
  }
]
读取时先核对 source 和 destination,再看 routing_key 或 x_match。headers 交换机不依赖 routing key;x-match=all 要求列出的全部头匹配,any 则任意一个匹配即可。
风险与边界
绑定到错误 vhost、交换机或队列时,命令可能成功但业务消息进入错误路径。生产变更前先查询目标对象并记录现有绑定,优先在测试 vhost 验证,再用同一组名称和参数发布。
headers 匹配对字段名、值及 AMQP 数据类型敏感,例如字符串 "9" 与整数 9 不是同一值。安全做法是固定生产者的消息头类型,并用一条带 mandatory 或发布确认的测试消息验证路由。
删除绑定时若只凭 routing key 猜测,可能误删同一交换机与队列之间的其他参数化绑定。应先从绑定列表取得 properties_key,确认源、目标、routing key 和 arguments 后再调用对应 DELETE 接口。
默认交换机会在队列声明时自动按“队列名作为 routing key”创建绑定,不应把它当作普通业务交换机重复配置。
查询交换机、队列和绑定,核对实际路由拓扑。
查看拓扑关系
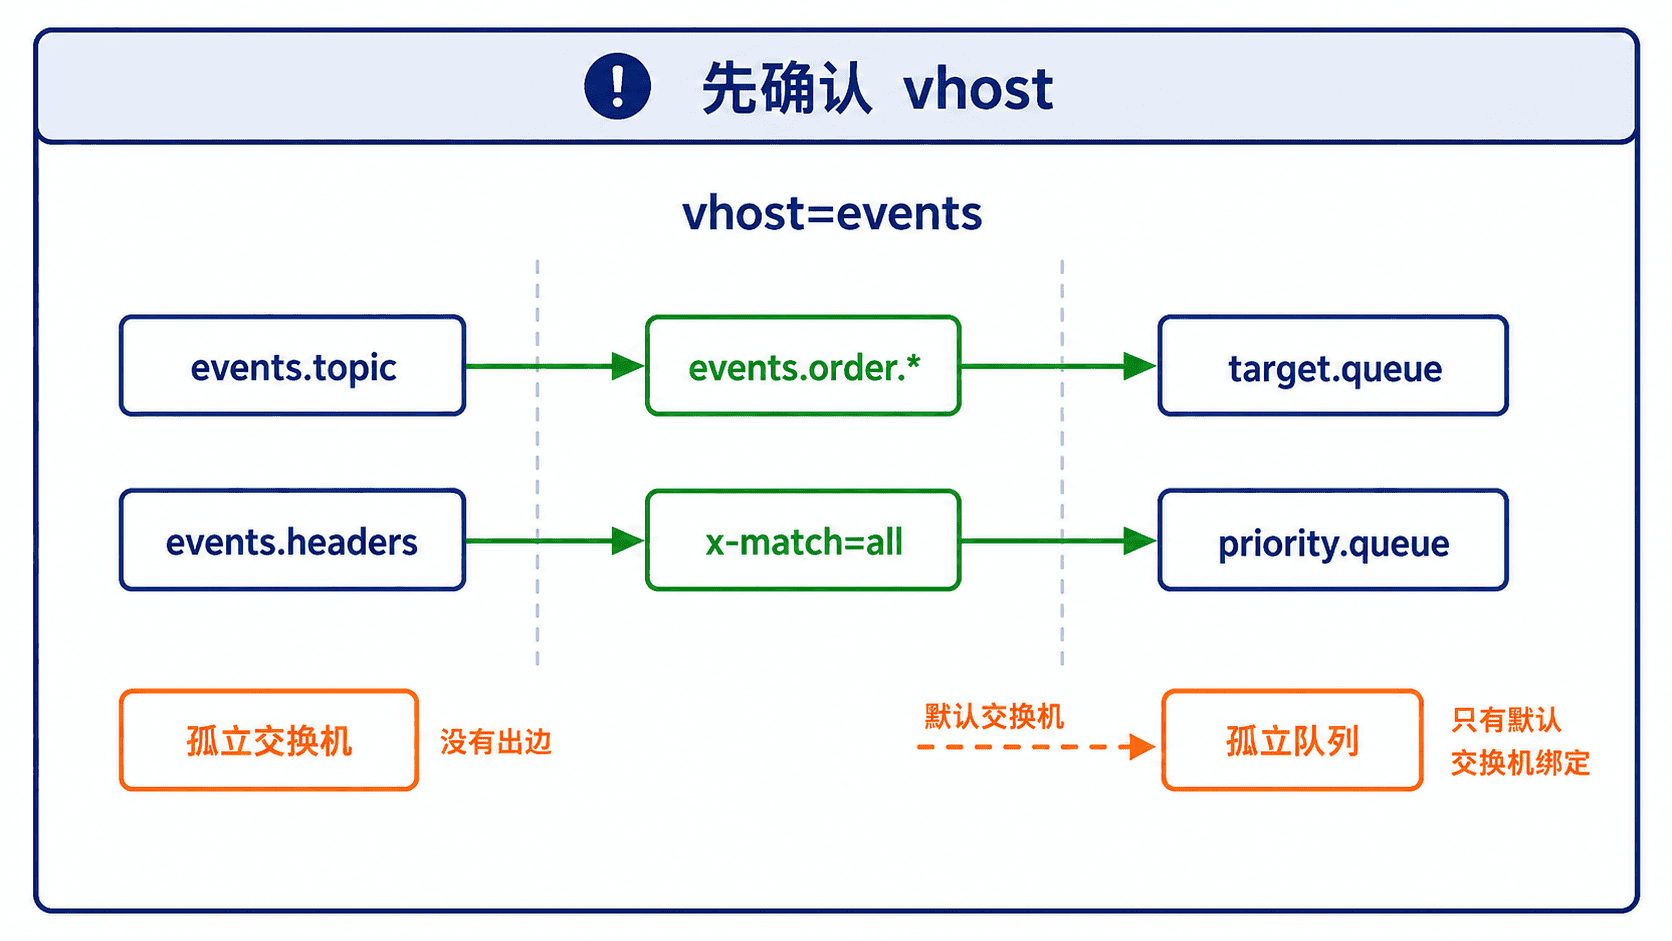
查询同一 vhost 下的交换机、队列和绑定,用于核对“源交换机 → 匹配规则 → 目标队列”的实际定义。排障时先限定 vhost,再按名称串联三类对象,避免把其他环境或系统自动创建的资源混入判断。
命令定位
rabbitmqctl list_exchanges、list_queues 和 list_bindings 直接读取节点上的 RabbitMQ 定义。命令通过 Erlang cookie 连接目标节点,不使用业务账号密码;默认查询 /,生产排障应始终显式传入 -p <vhost>。
高频用法
下面只查看示例业务资源,并用 -s 去掉提示文字和表头。sort 固定输出顺序,便于人工比对或保存为变更前快照。
VHOST='events'

printf '== exchanges ==\n'
rabbitmqctl -s list_exchanges -p "$VHOST" \
  name type durable auto_delete internal |
  awk '$1 ~ /^events\./' |
  LC_ALL=C sort

printf '== queues ==\n'
rabbitmqctl -s list_queues -p "$VHOST" \
  name durable auto_delete |
  awk '$1 ~ /^(target\.queue|priority\.queue)$/' |
  LC_ALL=C sort

printf '== bindings ==\n'
rabbitmqctl -s list_bindings -p "$VHOST" \
  source_name destination_name destination_kind routing_key |
  awk '$1 ~ /^events\./' |
  LC_ALL=C sort
预期输出
== exchanges ==
events.headers	headers	true	false	false
events.topic	topic	true	false	false
== queues ==
priority.queue	true	false
target.queue	true	false
== bindings ==
events.headers	priority.queue	queue
events.topic	target.queue	queue	events.order.*
输出以制表符分列。先确认交换机和队列都存在,再在 bindings 中检查源名称、目标名称、目标类型和 routing key;headers 绑定的 routing key 通常为空,还需额外查看 arguments。
查看完整绑定参数
当 routing key 正确但 headers 路由仍不生效时,使用 Management HTTP API 获取 JSON,再固定提取 arguments,避免解析 RabbitMQ CLI 的内部参数格式。
export RMQ_API='http://127.0.0.1:15672'
export RMQ_USER='ops'
export RMQ_PASS='<PASSWORD>'

curl -sS -u "$RMQ_USER:$RMQ_PASS" \
  "$RMQ_API/api/bindings/events/e/events.headers/q/priority.queue" |
jq '[.[] | {
  source,
  destination,
  routing_key,
  arguments
}]'
预期输出
[
  {
    "source": "events.headers",
    "destination": "priority.queue",
    "routing_key": "",
    "arguments": {
      "format": "pdf",
      "priority": "high",
      "x-match": "all"
    }
  }
]
JSON 对象字段顺序不影响含义;核对时关注键值集合和数据类型。x-match=all 表示消息头必须同时满足 format=pdf 与 priority=high。
输出字段说明
source_name 是源交换机;destination_name 是队列或下游交换机;destination_kind 常见为 queue 或 exchange;routing_key 是 direct/topic/fanout 绑定键;arguments 保存 headers 条件等扩展参数。
默认交换机名称为空,因此它的绑定行可能以空白列开头。RabbitMQ 会在声明队列时自动创建“默认交换机 → 队列”的绑定,routing key 等于队列名;这类行不是异常,也不表示业务交换机缺失。
排障清单
- 交换机或队列完全看不到:先检查
-p指定的 vhost,再确认应用连接串中的 vhost、对象是否为自动删除或独占资源。 rabbitmqctl无法连接:核对目标节点名、节点是否运行以及 Erlang cookie;远程节点使用-n rabbit@<HOST>,长节点名环境补充--longnames。- 绑定存在但消息未进入队列:检查交换机类型、发布目标、routing key 通配规则或 headers 类型和值;拓扑存在只证明定义存在,不证明消息已匹配。
- 同名资源属性不符合预期:继续查看
durable、auto_delete、internal、队列类型和 arguments,排除应用声明参数冲突。
风险与边界
这些查询是只读操作,但在拥有大量对象的 vhost 中频繁拉取全部字段会增加节点和终端开销。安全做法是限定 vhost、明确列名、按资源前缀过滤,并避免把全量查询作为秒级轮询。
拓扑结果是瞬时快照。自动删除交换机、独占队列和临时绑定可能在查询前后消失;需要证据时将命令输出与应用日志、连接 vhost、声明时间放在同一时间窗口核对。
不同 RabbitMQ 版本的可选字段可能略有差异,可先运行 rabbitmqctl help list_bindings、rabbitmqctl help list_exchanges 和 rabbitmqctl help list_queues 确认可用列。
删除队列前检查消费者和消息数量,降低误删风险。
安全删除队列
用于确认队列没有消费者、待投递消息和未确认消息后再删除队列。删除会同时移除队列本身、队列内消息及相关绑定,适合下线废弃队列;仅想丢弃积压消息时应改用 purge_queue。
命令定位
rabbitmqctl delete_queue 直接操作目标虚拟主机中的队列。生产环境不要裸执行删除命令,应先核对虚拟主机、队列名、消费者数以及两类消息计数,再使用条件参数阻止明显的误删。
安全执行
下面示例先检查目标队列,再要求“无待投递消息且无消费者”才允许删除。执行前应暂停该队列的生产者和消费者,避免检查完成后又出现新消息或新消费者。
VHOST="/prod"
QUEUE="orders.retry"

rabbitmqctl list_queues -p "$VHOST" \
  name consumers messages_ready messages_unacknowledged

rabbitmqctl delete_queue "$QUEUE" --vhost "$VHOST" \
  --if-empty --if-unused
预期输出(只列出目标队列的关键行,实际可能额外显示超时配置):
name          consumers  messages_ready  messages_unacknowledged
orders.retry  0          0               0
Deleting queue 'orders.retry' on vhost '/prod' if queue is empty and if queue is unused ...
Queue was successfully deleted with 0 ready messages
看到最后一行表示删除成功。若条件不满足,命令返回非零退出码并保留队列,不要去掉保护参数重试。
输出字段说明
consumers:当前订阅该队列的消费者数量。messages_ready:仍在队列中、等待投递的消息数量。messages_unacknowledged:已投递给消费者但尚未确认的消息数量。
只有三项均为 0,并且生产者、消费者已经停止,才具备相对安全的删除条件。--if-empty 重点保护待投递消息,不能替代对未确认消息的人工核对。
常用参数
--vhost或-p:指定虚拟主机;省略时通常操作默认虚拟主机/。--if-empty或-e:队列存在待投递消息时拒绝删除。--if-unused或-u:队列仍有消费者时拒绝删除。-n rabbit@host:从管理节点指定目标 RabbitMQ 节点,节点名和 Erlang Cookie 必须匹配。
风险与边界
触发风险的常见条件是选错虚拟主机、队列同名、遗漏保护参数,或在检查与删除之间仍有生产流量。后果包括消息永久丢失、绑定消失以及应用重新声明队列时属性不一致。安全替代方案是先停流量并保留变更记录;若只需清理积压,使用 purge_queue 而不是删除队列。
条件检查不能消除并发竞态:生产者可能在检查后、删除前继续发布。关键业务应在维护窗口封禁发布和消费入口,确认指标稳定为零后再执行。
排障清单
- 提示队列非空或正在使用:重新检查
messages_ready、messages_unacknowledged和consumers,不要绕过条件参数。 - 提示队列不存在:核对大小写、特殊字符和
--vhost;同名队列可以存在于不同虚拟主机。 - 出现
nodedown、超时或队列无响应:先检查目标节点、集群状态和队列 leader,不要在普通故障中直接调用内部eval删除接口。 - 删除后应用报声明冲突:检查应用重新声明时的 durable、auto-delete、exclusive、队列类型和参数是否与预期一致。
兼容性
先运行 rabbitmqctl help delete_queue 查看当前版本支持的参数。旧版本或特定队列类型对条件删除的实现可能不同;Windows 使用 rabbitmqctl.bat,其余参数含义相同。
在保留队列与绑定的前提下清空待消费消息。
清空队列消息
用于保留队列、交换机绑定和声明参数,只删除当前仍在队列中等待投递的消息。适合测试环境复位或已确认可以丢弃的生产积压,不适合处理仍由消费者持有的未确认消息。
命令定位
rabbitmqctl purge_queue 清空指定虚拟主机中的队列内容,但不会删除队列和绑定。执行前应明确消息不可恢复,并暂停生产者;否则清空完成后队列可能立即重新出现消息。
安全执行
下面示例先记录消费者与消息状态,执行清空后再次验证。示例中的 messages_unacknowledged 保留为 3,用于强调已经投递但尚未确认的消息不会被清空操作删除。
VHOST="/prod"
QUEUE="orders.retry"

rabbitmqctl list_queues -p "$VHOST" \
  name consumers messages_ready messages_unacknowledged

rabbitmqctl purge_queue -p "$VHOST" "$QUEUE"

rabbitmqctl list_queues -p "$VHOST" \
  name messages_ready messages_unacknowledged
预期输出(消息数按执行时状态变化):
name          consumers  messages_ready  messages_unacknowledged
orders.retry  1          1250            3
Purging queue 'orders.retry' in vhost '/prod' ...
name          messages_ready  messages_unacknowledged
orders.retry  0               3
验证重点是 messages_ready 变为 0。未确认消息后续可能被消费者确认、拒绝,或在连接关闭后重新入队,因此必须继续观察 messages_unacknowledged 和队列增长。
基本语法
rabbitmqctl purge_queue -p "<VHOST>" "<QUEUE>"命令成功通常只打印正在清空的队列和虚拟主机。队列名包含空格或 shell 特殊字符时必须使用引号;虚拟主机不要依赖默认值,生产操作应显式指定。
风险与边界
触发风险的条件包括选错队列、业务仍在发布、消费者仍持有未确认消息,或队列配置了死信与重试链路。后果可能是待处理任务永久丢失、未确认消息稍后重新入队,以及生产者持续写入造成“刚清空又增长”。安全替代方案是先停生产和消费,导出必要的业务数据或转移消息,再执行清空。
清空不是事务性维护窗口。命令执行期间的新发布可能与清空并发,不能据此证明某一时间点之前的消息全部消失。需要严格边界时,应先封禁发布入口并等待指标稳定。
高频用法
检查单个虚拟主机的队列积压:
rabbitmqctl list_queues -p "/prod" \
  name messages_ready messages_unacknowledged consumers
预期输出:
name          messages_ready  messages_unacknowledged  consumers
orders.retry  1250            3                        1
清空后只验证目标队列时,可先列出全部队列再按名称读取对应行;不要使用模糊匹配批量清空相似名称的队列。
排障清单
messages_ready清零后又增长:仍有生产者发布,或未确认消息被重新入队;先停止流量再复查。messages_unacknowledged不为零:定位消费者连接,等待确认或按业务策略停止消费者;再次清空只能处理重新变为 ready 的消息。- 提示队列不存在:核对虚拟主机和队列名,注意名称区分大小写。
- 出现超时、
nodedown或队列无响应:检查节点连通性、Erlang Cookie、队列 leader 和集群健康,避免连续重试加重故障。
兼容性
先运行 rabbitmqctl help purge_queue 核对当前版本语法。Windows 使用 rabbitmqctl.bat。专属队列、受保护环境或托管服务可能限制管理操作,应使用平台提供的维护入口并遵循审计流程。
通过管理 API 或命令行向指定交换机发送可验证的测试消息。
发送测试消息
用于在不改业务代码的情况下,向指定交换机发布一条带唯一标识的消息,并通过专用测试队列确认路由键和消息体。适合联调交换机、绑定、权限和消费者前置链路,不用于压测或长期生产发送。
前置条件
管理插件的 HTTP API 已可访问;账号对目标虚拟主机具有写交换机和读测试队列的权限。示例假定虚拟主机为 /,交换机 test.direct 已通过路由键 test.verify 绑定到空闲的专用队列 test.verify.q。
基本语法
发布端点为 PUT /api/exchanges/{vhost}/{exchange}/publish。请求体必须包含 properties、routing_key、payload 和 payload_encoding;payload_encoding 使用 string 时,payload 按 UTF-8 文本发送。
高频用法
下面先发布 JSON 测试消息,再以 ack_requeue_true 读取并重新入队,避免验证动作直接删除消息。修改顶部变量即可指向其他测试交换机、队列和路由键。
set -euo pipefail

RMQ_API="${RMQ_API:-http://127.0.0.1:15672}"
RMQ_USER="${RMQ_USER:-ops}"
RMQ_VHOST="${RMQ_VHOST:-%2F}"
RMQ_EXCHANGE="${RMQ_EXCHANGE:-test.direct}"
RMQ_QUEUE="${RMQ_QUEUE:-test.verify.q}"
RMQ_ROUTING_KEY="${RMQ_ROUTING_KEY:-test.verify}"

read -rsp 'RabbitMQ password: ' RMQ_PASS
printf '\n'

request_body=$(cat <<JSON
{"properties":{"content_type":"application/json","headers":{"x-test-id":"rmq-smoke-001"}},"routing_key":"$RMQ_ROUTING_KEY","payload":"{\"testId\":\"rmq-smoke-001\",\"kind\":\"smoke\"}","payload_encoding":"string"}
JSON
)

publish_result=$(
  curl -sS --fail-with-body -u "$RMQ_USER:$RMQ_PASS" \
    -H 'content-type: application/json' \
    -X PUT "$RMQ_API/api/exchanges/$RMQ_VHOST/$RMQ_EXCHANGE/publish" \
    -d "$request_body"
)

printf '%s' "$publish_result" |
python3 -c 'import json,sys; print("routed=" + str(json.load(sys.stdin)["routed"]))'

curl -sS --fail-with-body -u "$RMQ_USER:$RMQ_PASS" \
  -H 'content-type: application/json' \
  -X POST "$RMQ_API/api/queues/$RMQ_VHOST/$RMQ_QUEUE/get" \
  -d '{"count":1,"ackmode":"ack_requeue_true","encoding":"auto","truncate":50000}' |
python3 -c 'import json,sys; rows=json.load(sys.stdin); rows or sys.exit("no message returned"); m=rows[0]; print("routing_key=" + m["routing_key"]); print("payload=" + m["payload"])'
预期输出
routed=True
routing_key=test.verify
payload={"testId":"rmq-smoke-001","kind":"smoke"}
routed=True 表示消息至少进入一个队列,不代表消费者已经处理成功。读取结果中的 routing_key 和 payload 与发送值一致,才说明本次测试队列接收到了目标消息。
风险与边界
管理 HTTP API 的发布和取消息接口效率较低,也不提供业务发布所需的完整确认能力。批量发送、持续流量或可靠投递应改用 AMQP 客户端并启用 publisher confirms。
在业务队列上执行 ack_requeue_true 会产生重新入队和再次投递行为,可能影响顺序、积压判断或 redelivered 标记。安全做法是使用无消费者的专用测试队列,完成后由既定清理流程删除测试消息或队列。
排障清单
- 返回
401时检查用户名和密码;返回403时检查虚拟主机权限中的 write/read 正则是否覆盖交换机和队列。 - 返回
404时检查管理插件、虚拟主机编码和资源名称;根虚拟主机必须写成%2F。 - 返回
routed=False时检查交换机类型、路由键和绑定;HTTP 成功并不等于消息已路由。 - 读取结果为空时检查是否有消费者抢先取走消息、队列名是否正确,以及测试队列发送前是否为空。
兼容性
交换机、队列或虚拟主机名称包含 /、空格等字符时必须进行 URL 百分号编码。旧版 curl 若不支持 --fail-with-body,可替换为 --fail,但错误响应体可能不会保留。
设置 delivery mode,并确认目标队列具备持久化能力。
发送持久化消息
用于发送 delivery_mode=2 的消息,并同时核对目标队列为 durable。只有“持久化消息进入持久化队列”这一组合,消息才具备节点重启后恢复的基础条件;生产可靠性还需要发布确认和合适的队列副本策略。
前置条件
示例假定根虚拟主机中的交换机 test.direct 已通过路由键 test.persist 绑定到专用队列 test.persist.q。先读取队列属性确认 durable=True,再发送消息,避免只设置 delivery mode 却投递到临时队列。
基本语法
在管理 API 的发布请求中,将 properties.delivery_mode 设为整数 2。值 1 或省略该字段表示瞬态消息。交换机负责路由,真正保存消息的是目标队列,因此必须单独核对队列耐久性。
高频用法
下面依次检查队列、发送持久化消息,并回读消息属性。验证队列应无消费者且发送前为空,避免读取到其他消息。
set -euo pipefail

RMQ_API="${RMQ_API:-http://127.0.0.1:15672}"
RMQ_USER="${RMQ_USER:-ops}"
RMQ_VHOST="${RMQ_VHOST:-%2F}"
RMQ_EXCHANGE="${RMQ_EXCHANGE:-test.direct}"
RMQ_QUEUE="${RMQ_QUEUE:-test.persist.q}"
RMQ_ROUTING_KEY="${RMQ_ROUTING_KEY:-test.persist}"

read -rsp 'RabbitMQ password: ' RMQ_PASS
printf '\n'

curl -sS --fail-with-body -u "$RMQ_USER:$RMQ_PASS" \
  "$RMQ_API/api/queues/$RMQ_VHOST/$RMQ_QUEUE" |
python3 -c 'import json,sys; q=json.load(sys.stdin); print("durable=" + str(q["durable"]))'

request_body=$(cat <<JSON
{"properties":{"delivery_mode":2,"content_type":"application/json","message_id":"persist-001"},"routing_key":"$RMQ_ROUTING_KEY","payload":"{\"testId\":\"persist-001\"}","payload_encoding":"string"}
JSON
)

publish_result=$(
  curl -sS --fail-with-body -u "$RMQ_USER:$RMQ_PASS" \
    -H 'content-type: application/json' \
    -X PUT "$RMQ_API/api/exchanges/$RMQ_VHOST/$RMQ_EXCHANGE/publish" \
    -d "$request_body"
)

printf '%s' "$publish_result" |
python3 -c 'import json,sys; print("routed=" + str(json.load(sys.stdin)["routed"]))'

curl -sS --fail-with-body -u "$RMQ_USER:$RMQ_PASS" \
  -H 'content-type: application/json' \
  -X POST "$RMQ_API/api/queues/$RMQ_VHOST/$RMQ_QUEUE/get" \
  -d '{"count":1,"ackmode":"ack_requeue_true","encoding":"auto","truncate":50000}' |
python3 -c 'import json,sys; rows=json.load(sys.stdin); rows or sys.exit("no message returned"); m=rows[0]; print("delivery_mode=" + str(m["properties"].get("delivery_mode"))); print("payload=" + m["payload"])'
预期输出
durable=True
routed=True
delivery_mode=2
payload={"testId":"persist-001"}
durable=True 验证队列元数据可恢复,delivery_mode=2 验证消息被标记为持久化。routed=True 仅说明至少一个队列接受了路由,不能替代 broker 对持久化完成的发布确认。
风险与边界
仅设置 delivery_mode=2,但目标队列为非持久化、exclusive 或会自动删除时,队列消失后消息仍会丢失。安全替代是使用 durable 队列,并让交换机和绑定也采用可恢复的耐久拓扑。
管理 API 返回成功不等于应用获得 publisher confirm。生产发送应使用 AMQP 客户端开启确认,并处理 nack、连接中断和重试幂等;不要通过重启生产节点来验证消息是否持久化,应在隔离环境做受控恢复测试。
持久化会增加磁盘写入和确认延迟。对可丢弃的指标、心跳或临时事件,不要仅为“更安全”而全部设为持久化,应按业务恢复目标选择。
排障清单
durable=False:停止测试,修正队列声明或策略后再发;不要把 delivery mode 当成队列耐久性的替代。routed=False:检查绑定键、交换机类型和目标队列是否存在;消息未进入队列时谈不上持久化。- 回读为
delivery_mode=1或空值:检查请求字段是否位于properties内,且值是否为数字2,不要写成字符串"2"。 - 队列重启后仍丢消息:检查是否实际路由到 durable 队列、是否存在 TTL、最大长度、死信或消费者确认等删除路径,并结合 publisher confirms 定位。
兼容性
管理插件必须启用,账号需具备对应虚拟主机权限。根虚拟主机在 URL 中使用 %2F;其他名称也必须百分号编码。HTTP API 适合开发验证,正式发送优先使用 RabbitMQ 官方客户端。
正确设置 content-type、message-id、correlation-id、headers 等属性。
设置消息属性
发布 JSON、RPC 请求或可追踪事件时,在 BasicProperties 中明确声明正文格式、消息标识和业务头。属性只描述消息及其上下文,不会替你序列化正文、校验 JSON,也不会自动实现去重。
完整示例
示例需要本机 RabbitMQ 和 pika。它创建临时队列,发布后立即读取消息,验证消费者实际收到的属性。
import json
import time
import uuid

import pika

def main() -> None:
    connection = pika.BlockingConnection(
        pika.ConnectionParameters(host="localhost")
    )
    channel = connection.channel()
    queue = channel.queue_declare(
        queue="", exclusive=True, auto_delete=True
    ).method.queue

    message_id = str(uuid.uuid4())
    body = json.dumps(
        {"orderId": "A1001", "status": "created"},
        ensure_ascii=False,
    ).encode("utf-8")

    properties = pika.BasicProperties(
        content_type="application/json",
        content_encoding="utf-8",
        message_id=message_id,
        correlation_id="request-A1001",
        type="order.created",
        timestamp=int(time.time()),
        app_id="order-service",
        headers={
            "schema-version": 1,
            "trace-id": "trace-A1001",
            "retryable": True,
        },
    )

    channel.basic_publish(
        exchange="",
        routing_key=queue,
        body=body,
        properties=properties,
    )
    method, received, received_body = channel.basic_get(
        queue=queue, auto_ack=True
    )
    if method is None or received is None:
        raise RuntimeError("message was not available")

    print(f"content_type={received.content_type}")
    print(f"message_id={received.message_id}")
    print(f"correlation_id={received.correlation_id}")
    print(f"headers={received.headers}")
    encoding = received.content_encoding or "utf-8"
    print(f"body={received_body.decode(encoding)}")
    connection.close()

if __name__ == "__main__":
main()预期输出如下,<ID> 每次运行不同,字典字段顺序可能不同。
content_type=application/json
message_id=<ID>
correlation_id=request-A1001
headers={'schema-version': 1, 'trace-id': 'trace-A1001', 'retryable': True}
body={"orderId": "A1001", "status": "created"}
属性速查
| 属性 | 建议用途 | 读取要点 |
|---|---|---|
content_type |
声明正文格式,如 application/json |
消费者仍需自行解析和校验 |
content_encoding |
声明字符编码,如 utf-8 |
必须与正文实际字节一致 |
message_id |
标识一条业务消息 | Broker 不保证唯一,也不会自动去重 |
correlation_id |
关联请求、响应或同一业务链路 | 由生产者与消费者共同约定 |
headers |
放版本、追踪、租户、重试提示等元数据 | 值必须可编码为 AMQP 字段类型 |
type |
标识事件类型或消息契约 | 不应代替交换机和路由键设计 |
需要消息在 Broker 重启后恢复时,可增加 delivery_mode=2,但还必须使用 durable 队列并启用发布确认;单独设置该属性不构成可靠投递。
风险与边界
content_type="application/json" 但正文不是合法 JSON 时,消费者会按错误契约解析并失败。安全做法是先完成序列化,再设置匹配的类型与编码,并在消费端校验 schema。
把隐私数据、令牌或超大对象放入 headers 会造成泄露风险和额外网络、内存开销。仅放小型元数据,敏感内容放受控存储,消息中只传引用标识。
把 message_id 当作 Broker 去重键会导致重复业务处理。网络重试时复用同一个业务消息 ID,并由消费者或幂等存储显式去重。
排障清单
- 消费者读到
None:确认属性传给了basic_publish(properties=...),并检查协议转换或转发程序是否丢弃字段。 - JSON 解码异常:对照
content_type、content_encoding与正文真实字节,不要对未知编码直接调用 UTF-8 解码。 - 链路无法关联:确认生产者生成
message_id,响应消息复制请求的correlation_id。 - 发布时报字段编码错误:将自定义对象转换为字符串、整数、布尔值、字节或受支持的容器类型。
使用 Publisher Confirms 判断消息是否被 Broker 接收并持久化。
启用发布确认
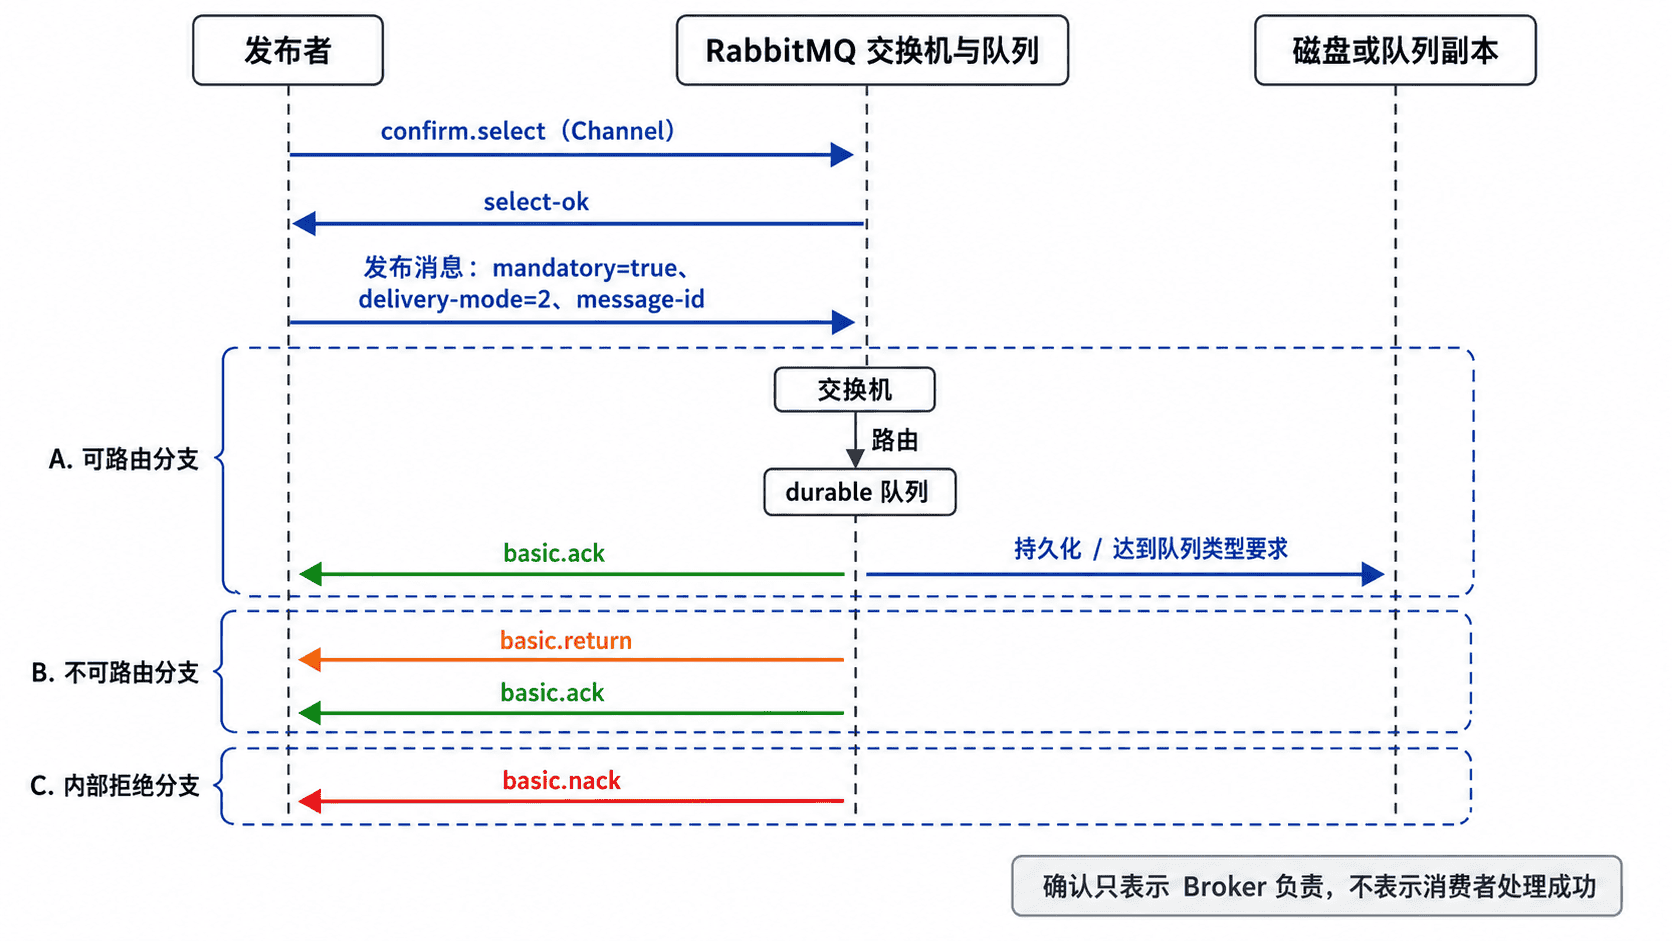
当生产者不能接受“写入 socket 就算成功”时,在发布 Channel 上启用 Publisher Confirms。Broker 会返回 ack 或 nack;配合持久化消息和 durable 队列,才能确认持久化链路,而不是确认消费者已经处理。
启用与发布
示例需要本机 RabbitMQ 和 pika。confirm_delivery() 将当前 Channel 切换到确认模式;mandatory=True 同时把“没有任何可路由队列”识别为失败。
import json
import uuid

import pika

def main() -> None:
    connection = pika.BlockingConnection(
        pika.ConnectionParameters(host="localhost")
    )
    channel = connection.channel()
    queue = "demo.publisher.confirm"

    channel.queue_declare(
        queue=queue,
        durable=True,
        exclusive=False,
        auto_delete=False,
    )
    channel.confirm_delivery()

    message_id = str(uuid.uuid4())
    body = json.dumps(
        {"event": "order.created", "orderId": "A1001"}
    ).encode("utf-8")

    try:
        confirmed = channel.basic_publish(
            exchange="",
            routing_key=queue,
            body=body,
            mandatory=True,
            properties=pika.BasicProperties(
                content_type="application/json",
                delivery_mode=2,
                message_id=message_id,
            ),
        )
        print(f"confirmed={confirmed} message_id={message_id}")
    except pika.exceptions.UnroutableError:
        print(f"unroutable message_id={message_id}")
    except pika.exceptions.NackError:
        print(f"nacked message_id={message_id}")
    finally:
        connection.close()

if __name__ == "__main__":
main()预期输出如下,<ID> 每次运行不同。
confirmed=True message_id=<ID>确认结果怎么读
ack 表示 Broker 已接受责任。对路由到 durable 队列的持久化消息,确认会等待消息满足该队列的持久化条件;Quorum Queue 还需要达到副本确认条件。瞬时消息或非 durable 队列收到 ack,不等于消息可在重启后恢复。
nack 表示 Broker 因内部错误拒绝承担责任,生产者可进入受控重试。不可路由消息在 mandatory=True 时先被退回;只看 confirm 而不检查退回,会把“Broker 已处理但没有入队”误判为成功。
Publisher Confirm 与消费者确认相互独立。发布成功不代表消费者已收到、业务已提交或下游调用已完成;端到端结果需要另行设计消费确认、幂等和业务回执。
高频用法
低吞吐任务可逐条等待确认,逻辑最简单,但每条消息都承担网络往返延迟。高吞吐生产者应异步收集确认或按批次等待,并用 Channel 发布序号关联未确认消息,避免串行阻塞。
连接中断时,生产者可能无法判断某条消息是否已被 Broker 接收。此时不要生成新业务 ID 盲目重发;应复用原 message_id,结合本地 Outbox、有限重试和消费者幂等处理重复。
风险与边界
确认超时、连接断开或进程在收到 ack 前崩溃时,消息状态会变成“未知”。直接丢弃可能漏消息,直接重发可能重复;安全替代是持久化待确认记录,恢复后按相同消息 ID 重发,并让消费者幂等。
逐条同步确认在高延迟链路上会显著降低吞吐。安全替代是限制在途消息数量,批量或异步处理确认,同时为未确认集合设置容量与超时上限。
Confirm 模式与事务模式不能在同一 Channel 混用。需要切换策略时新建 Channel,不要在已进入确认模式的 Channel 上启用事务。
排障清单
- 始终显示成功但队列没有消息:检查交换机、路由键和绑定,并确保处理了
mandatory=True的退回异常。 - 持久化消息重启后丢失:核对队列是否 durable、消息是否
delivery_mode=2、发布者是否确实收到 confirm。 - 吞吐突然下降:检查是否逐条同步等待、磁盘延迟、队列副本状态和网络 RTT。
- 重试后出现重复:确认重试复用了业务消息 ID,并检查消费者幂等键与事务提交边界。
- 长时间没有确认:记录连接阻塞、Channel 关闭和超时事件;不要无限等待,应转入未知状态恢复流程。
使用 mandatory 和 Return 回调捕获未匹配任何队列的消息。
处理不可路由消息
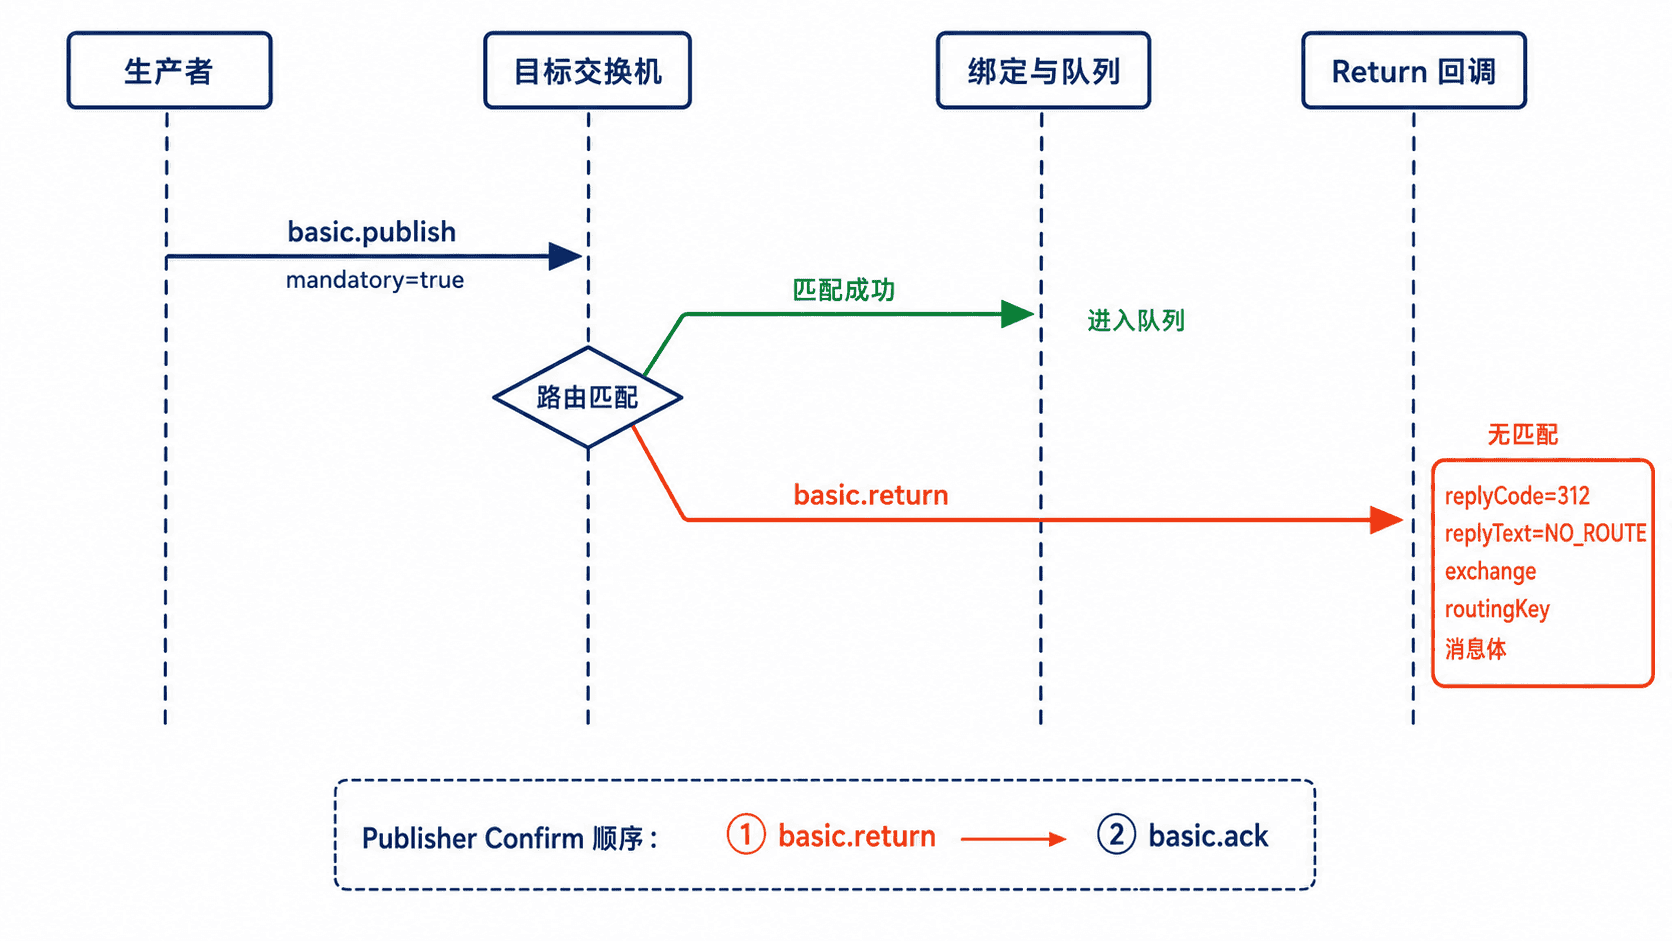
当生产者必须确认消息是否匹配到队列时,发布时设置 mandatory=True,并在发布前注册 Return 回调。交换机存在但没有任何匹配绑定时,RabbitMQ 会返回 312 NO_ROUTE,应用可据此记录、告警或转入受控重试。
使用条件
mandatory 只处理“目标交换机已存在,但消息最终没有路由到任何队列”的情况。回调必须在发布前注册,并保持连接事件循环继续运行,否则返回帧可能尚未被客户端处理,进程就已经退出。
可运行示例
以下 Python 示例创建一个随机命名的 direct 交换机且不绑定队列,因此发布必然触发 Return 回调。运行前需安装 pika,并保证环境变量中的 RabbitMQ 连接信息有效。
import os
import time
import uuid

import pika

def main() -> None:
    credentials = pika.PlainCredentials(
        os.getenv("RABBITMQ_USER", "guest"),
        os.getenv("RABBITMQ_PASSWORD", "guest"),
    )
    parameters = pika.ConnectionParameters(
        host=os.getenv("RABBITMQ_HOST", "127.0.0.1"),
        port=int(os.getenv("RABBITMQ_PORT", "5672")),
        virtual_host=os.getenv("RABBITMQ_VHOST", "/"),
        credentials=credentials,
    )

    connection = pika.BlockingConnection(parameters)
    channel = connection.channel()
    exchange = f"demo.mandatory.{uuid.uuid4().hex}"
    returned = []

    def on_return(ch, method, properties, body: bytes) -> None:
        returned.append(method.reply_code)
        print(
            "RETURN "
            f"code={method.reply_code} "
            f"text={method.reply_text} "
            f"exchange={method.exchange} "
            f"routing_key={method.routing_key} "
            f"body={body.decode('utf-8')}"
        )

    try:
        # 使用随机交换机避免被已有绑定意外接收。
        channel.exchange_declare(
            exchange=exchange,
            exchange_type="direct",
            durable=False,
            auto_delete=True,
        )
        channel.add_on_return_callback(on_return)

        channel.basic_publish(
            exchange=exchange,
            routing_key="missing.route",
            body=b"order-42",
            mandatory=True,
            properties=pika.BasicProperties(
                message_id="order-42",
                content_type="text/plain",
                delivery_mode=1,
            ),
        )

        # BlockingConnection 仍需处理网络事件,Return 回调才会执行。
        deadline = time.monotonic() + 3
        while not returned and time.monotonic() < deadline:
            connection.process_data_events(time_limit=0.2)

        print("RESULT=returned" if returned else "RESULT=no-return-within-timeout")
        channel.exchange_delete(exchange=exchange)
    finally:
        if connection.is_open:
            connection.close()

if __name__ == "__main__":
    main()
预期输出
RETURN code=312 text=NO_ROUTE exchange=demo.mandatory.<ID> routing_key=missing.route body=order-42
RESULT=returned
<ID> 是脚本生成的随机交换机后缀,实际值每次不同。若输出 RESULT=no-return-within-timeout,优先检查客户端是否持续处理网络事件,以及消息是否被已有绑定或备用交换机接管。
返回字段读取
| 字段 | 读取方法 |
|---|---|
reply_code、reply_text |
312 与 NO_ROUTE 表示没有队列接受该消息 |
exchange、routing_key |
定位发布目标、虚拟主机和绑定规则是否一致 |
properties |
使用 message_id、correlation_id 等字段关联原始业务请求 |
body |
写入隔离存储或重试队列前保留原始载荷,避免只记录错误文本 |
风险与边界
发布到不存在的交换机、权限不足或连接中断会产生通道或连接异常,而不是 basic.return,必须单独捕获。启用 publisher confirm 后,不可路由消息仍可能收到 basic.ack;同时使用 mandatory 时,应先处理 Return,再按 message_id 关联 confirm,不能把 ack 直接解释为“已进入业务队列”。
Return 回调只存在于生产者进程内。进程崩溃、回调异常或无界立即重试都可能造成丢失、重复和流量放大;安全做法是先持久化失败记录,设置最大重试次数与退避时间,并让消费者按业务幂等键去重。
排障清单
- 确认
mandatory=True,Return 回调在第一次发布前已经注册。 - 核对连接的 vhost、交换机名称、类型、routing key 与绑定键,避免在错误环境排查。
- 确认客户端线程或事件循环仍在处理连接事件,没有发布后立即关闭连接。
- Return 未触发时检查目标交换机是否配置 Alternate Exchange,消息可能已进入备用队列。
使用 Alternate Exchange 接收未路由消息并保留排查线索。
配置备用交换机
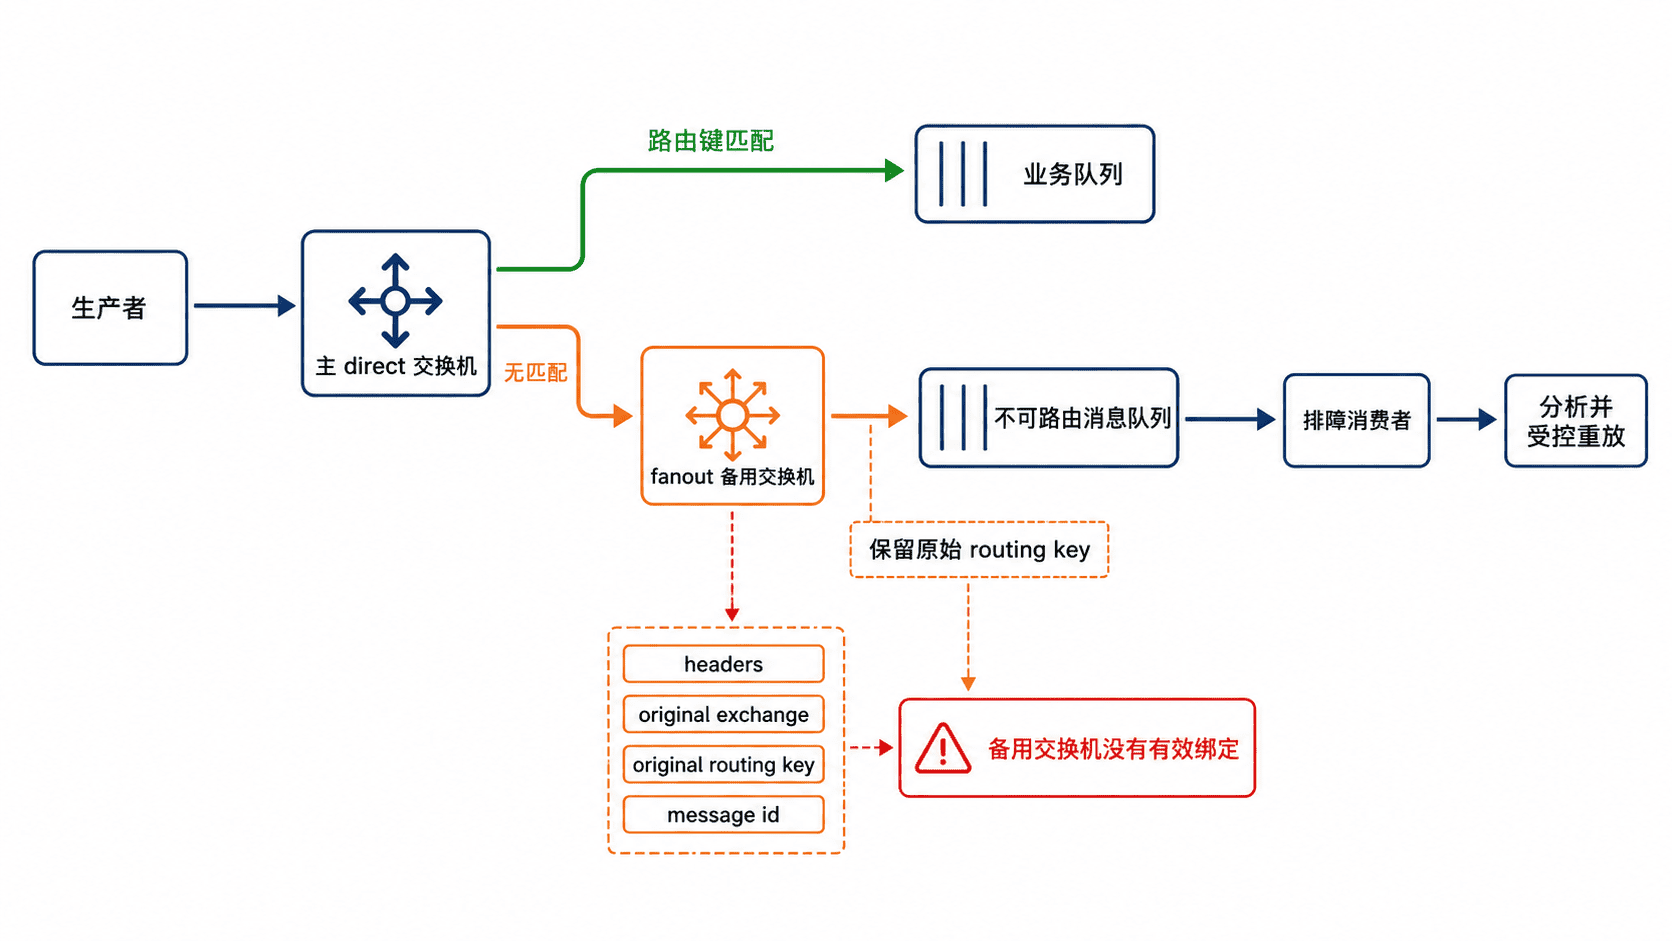
当主交换机无法将消息路由到任何队列时,可配置 Alternate Exchange(AE)把消息转交给专用兜底队列。生产者无需逐条处理 Return 回调,运维侧可集中查看原始路由键、消息属性和载荷,再决定修复绑定或受控重放。
推荐配置
先声明备用交换机和兜底队列,再通过 policy 为主交换机设置 alternate-exchange。Policy 便于在线调整和回滚,避免把 alternate-exchange 固化为声明参数;若声明参数与 policy 同时存在,声明参数会覆盖 policy。
可运行示例
以下脚本使用 Management HTTP API 创建一套带时间戳的临时拓扑,避免与现有资源冲突。需启用 management 插件,并安装 curl 与 jq;可通过 RABBITMQ_API 和 RABBITMQ_AUTH 覆盖默认地址与凭据。
set -euo pipefail

API="${RABBITMQ_API:-http://127.0.0.1:15672/api}"
AUTH="${RABBITMQ_AUTH:-guest:guest}"
ID="${DEMO_ID:-$(date +%s)}"
PRIMARY="demo.primary.${ID}"
AE="demo.ae.${ID}"
QUEUE="demo.unrouted.${ID}"
POLICY="demo-ae-${ID}"

request() {
  local label="$1"
  local method="$2"
  local path="$3"
  local payload="$4"
  local code

  code="$(
    curl -sS -u "$AUTH" -o /dev/null -w '%{http_code}' \
      -H 'content-type: application/json' \
      -X "$method" "$API$path" \
      -d "$payload"
  )"

  if [[ "$code" == 2* ]]; then
    printf '%s=ok\n' "$label"
  else
    printf '%s=http_%s\n' "$label" "$code" >&2
    exit 1
  fi
}

request declare_ae PUT "/exchanges/%2F/$AE" \
  '{"type":"fanout","auto_delete":false,"durable":true,"internal":false,"arguments":{}}'
request declare_queue PUT "/queues/%2F/$QUEUE" \
  '{"auto_delete":false,"durable":true,"arguments":{}}'
request bind_queue POST "/bindings/%2F/e/$AE/q/$QUEUE" \
  '{"routing_key":"","arguments":{}}'
request declare_primary PUT "/exchanges/%2F/$PRIMARY" \
  '{"type":"direct","auto_delete":false,"durable":true,"internal":false,"arguments":{}}'

policy_body="$(
  jq -nc \
    --arg pattern "^demo[.]primary[.]${ID}$" \
    --arg ae "$AE" \
    '{pattern:$pattern,definition:{"alternate-exchange":$ae},priority:0,"apply-to":"exchanges"}'
)"
request set_policy PUT "/policies/%2F/$POLICY" "$policy_body"

publish_body="$(
  jq -nc \
    --arg id "order-${ID}" \
    --arg ex "$PRIMARY" \
    '{
      properties:{
        message_id:$id,
        headers:{
          "x-original-exchange":$ex,
          "x-original-routing-key":"missing.route"
        }
      },
      routing_key:"missing.route",
      payload:$id,
      payload_encoding:"string"
    }'
)"

curl -sS -f -u "$AUTH" \
  -H 'content-type: application/json' \
  -X POST "$API/exchanges/%2F/$PRIMARY/publish" \
  -d "$publish_body" | jq .

curl -sS -f -u "$AUTH" \
  -H 'content-type: application/json' \
  -X POST "$API/queues/%2F/$QUEUE/get" \
  -d '{"count":1,"ackmode":"ack_requeue_true","encoding":"auto","truncate":50000}' |
jq '.[0] | {
  routing_key,
  payload,
  message_id:.properties.message_id,
  headers:.properties.headers
}'
预期输出
declare_ae=ok
declare_queue=ok
bind_queue=ok
declare_primary=ok
set_policy=ok
{
  "routed": true
}
{
  "routing_key": "missing.route",
  "payload": "order-<ID>",
  "message_id": "order-<ID>",
  "headers": {
    "x-original-exchange": "demo.primary.<ID>",
    "x-original-routing-key": "missing.route"
  }
}
<ID> 是运行时生成的时间戳。routed: true 表示消息最终到达至少一个队列,本例中接收者是 AE 后面的兜底队列;读取命令使用 ack_requeue_true,仅用于排障验证,不会删除消息。
设计要点
备用交换机通常使用 fanout,确保主交换机未匹配的消息都进入同一兜底队列。AE 不会自动补充业务失败原因,生产者应主动设置唯一 message_id,并在 headers 中记录原始交换机、原始 routing key、来源服务和重试次数,便于审计与幂等重放。
风险与边界
Policy 正则过宽会把无关交换机的不可路由消息引入同一队列,导致数据混杂;应使用带 ^、$ 的精确模式,并在目标 vhost 验证命中范围。备用交换机或兜底绑定缺失时,消息仍无法被保留,因此上线顺序必须是“AE 与队列 → 绑定 → policy → 验证发布”。
兜底队列长期无人消费会持续增长,可能耗尽磁盘并触发集群流控。安全做法是设置容量或 TTL 边界、建立队列深度与最老消息年龄告警,并通过专用排障消费者人工审核后重放;不要把兜底队列直接接入无限自动重试。
排障清单
- 检查 policy 的 vhost、pattern、priority 和
apply-to=exchanges是否命中主交换机。 - 检查 AE 已存在,兜底队列已绑定;若 AE 使用
direct或topic,还要确认绑定键能匹配原 routing key。 - 发布后出现
routed:false时,说明最终没有任何队列接受消息,应继续检查 AE 绑定与队列状态。 - Management API 的
/get仅适合开发和排障;生产消费、确认与重放应使用 AMQP 客户端。 - 默认交换机不支持 AE;示例生成的临时 policy、交换机和队列验证后应删除,避免遗留测试资源。
按交换机、routing key、绑定和 vhost 顺序定位消息未入队原因。
排查消息路由失败
发布端没有报错但目标队列不增长时,先沿交换机、routing key、绑定逐层核对;对象查不到或结果与预期不一致,再回头确认连接所在 vhost。最后用 mandatory 返回判断消息是否确实没有路由,而不是只依赖 publisher confirm。
定位顺序
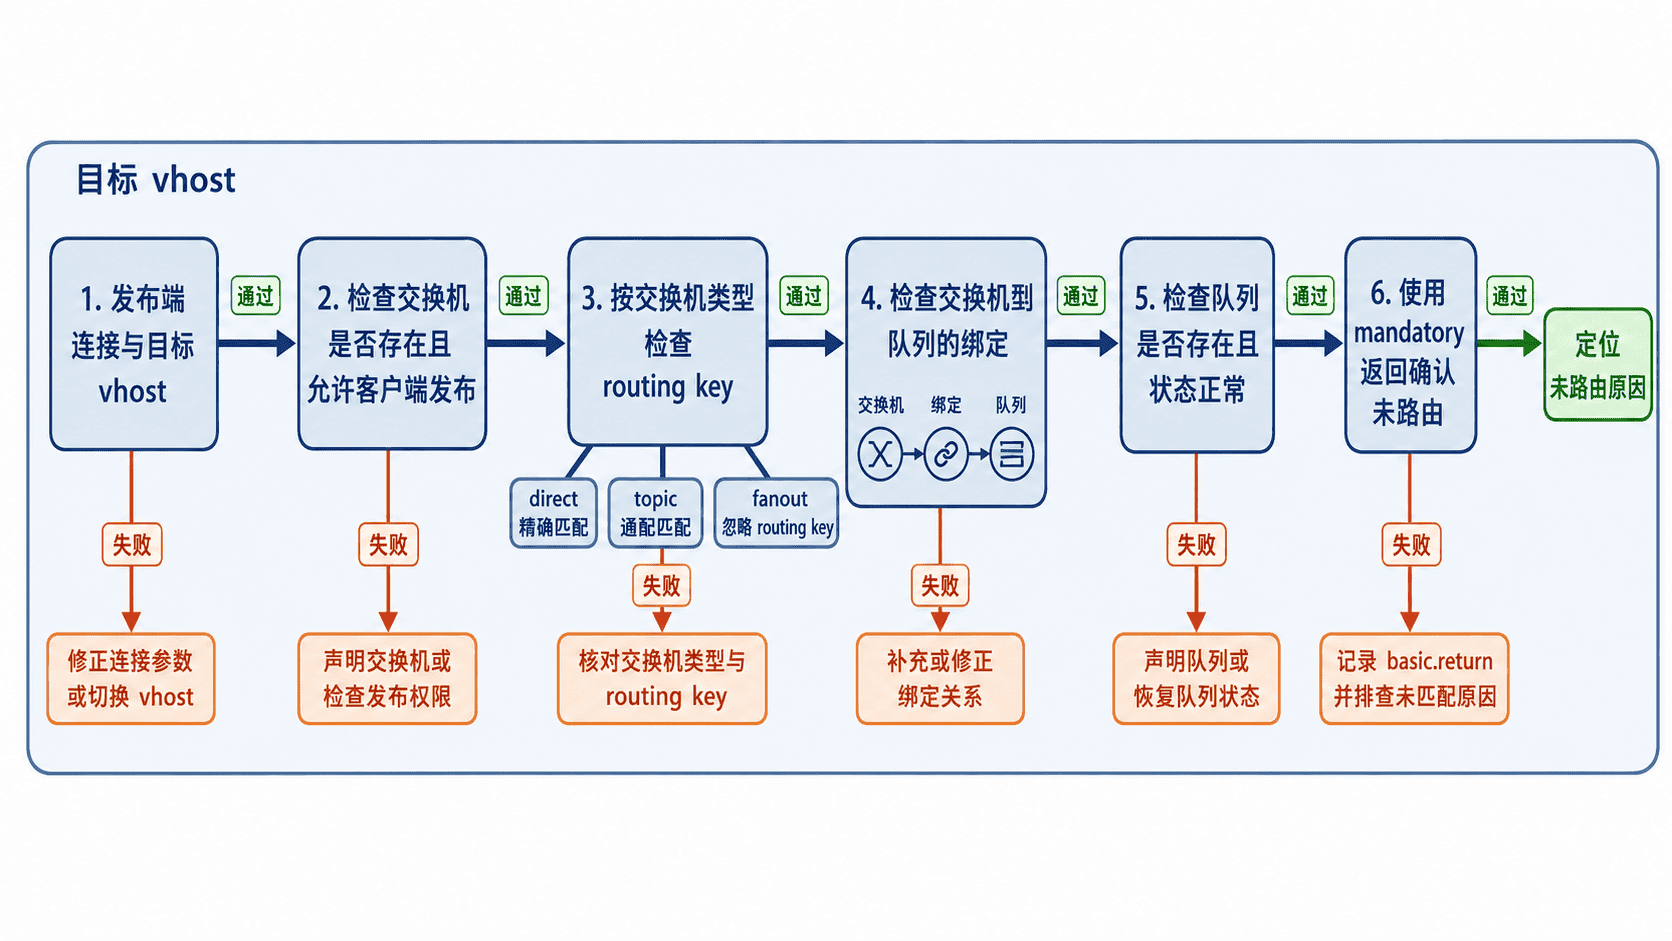
在 RabbitMQ 节点上执行以下只读检查。示例拓扑为 vhost /、topic 交换机 orders.topic、队列 orders.created.q,目标 routing key 为 order.created。
VHOST="/"
EXCHANGE="orders.topic"
QUEUE="orders.created.q"

# `-p` 强制所有查询使用与发布端一致的 vhost。
echo "[exchange]"
rabbitmqctl -q list_exchanges -p "$VHOST" name type durable internal |
  awk -F '\t' -v target="$EXCHANGE" 'NR == 1 || $1 == target'

# 只保留表头和目标对象,避免在现场输出整套拓扑。
echo "[binding]"
rabbitmqctl -q list_bindings -p "$VHOST" \
  source_name destination_name destination_kind routing_key |
  awk -F '\t' -v source="$EXCHANGE" -v dest="$QUEUE" \
  'NR == 1 || ($1 == source && $2 == dest)'

echo "[queue]"
rabbitmqctl -q list_queues -p "$VHOST" \
  name state messages_ready messages_unacknowledged consumers |
  awk -F '\t' -v target="$QUEUE" 'NR == 1 || $1 == target'
正常拓扑的关键输出如下,消息数和消费者数会随现场变化。
[exchange]
name    type    durable    internal
orders.topic    topic    true    false
[binding]
source_name    destination_name    destination_kind    routing_key
orders.topic    orders.created.q    queue    order.created
[queue]
name    state    messages_ready    messages_unacknowledged    consumers
orders.created.q    running    0    0    2
交换机、绑定或队列只打印表头,表示该对象在指定 vhost 中不存在。internal=true 表示客户端不能直接发布;队列 state 不是 running 时,应先处理队列或节点可用性。
核对 routing key
交换机类型决定匹配方式。direct 要求 binding key 与 routing key 完全相等;topic 中 * 匹配一个单词,# 匹配零个或多个单词;fanout 忽略 routing key;headers 根据消息头匹配,单看 routing key 无法判断。
例如 binding key 为 order.* 时,order.created 能匹配,order.eu.created 不能匹配。排障时必须复制发布端最终发送值,注意大小写、前后空格、分隔符以及配置变量是否被错误覆盖。
用 mandatory 证明未路由
在发布端设置 mandatory=true 并注册 basic.return 回调。消息无法匹配任何队列时,RabbitMQ 会先返回消息,再发送 publisher confirm;因此只收到 confirm ack 并不能证明消息已经进入队列。若配置了 alternate exchange,未匹配消息可能被转交到备用交换机,此时不会按普通未路由路径丢弃。
默认交换机是特殊 direct 交换机,AMQP 0-9-1 发布时交换机名必须传空字符串,routing key 必须等于队列名。不要把管理命令中显示的 amq.default 当作可发布交换机名称。
风险与边界
在包含大量队列或绑定的 vhost 中高频执行全量 list_* 会产生大输出并增加节点负担。生产环境不要放入秒级循环;优先单次采样,或通过管理 HTTP API 查询指定对象。
开启全局消息 tracing 会复制和记录大量消息,触发条件是持续高吞吐或大消息体时,后果可能是磁盘、网络和 CPU 压力上升。安全替代方案是先用拓扑查询、mandatory 返回和应用日志定位,仅在受控时间窗口对最小范围启用追踪。
排障清单
- 交换机是否在应用实际连接的 vhost 中存在,类型和
internal属性是否正确。 - 发布端最终 routing key 是否与交换机类型及 binding key 匹配。
- 绑定的源交换机、目标队列和 routing key 是否为同一套环境配置。
- 队列是否存在且状态正常,是否因 exclusive、auto-delete 或连接断开而消失。
- 发布端是否同时启用 publisher confirms 与
mandatory返回,并记录 exchange、routing key、message ID 和 return reply text。 - 出现
NOT_FOUND或ACCESS_REFUSED时先处理交换机不存在或权限问题;这类错误通常会关闭 channel,不属于静默路由失败。
使用批量确认或异步确认减少逐条等待带来的吞吐损失。
批量发布消息
逐条发布后立即等待 confirm 会把网络往返和落盘等待串行化。吞吐要求中等且实现要简单时,连续发布一批再统一等待;持续高吞吐时,用异步 confirm、发布序号和未确认集合并行处理 ack 与 nack。
策略选择
| 模式 | 发布方式 | 失败定位 | 适用场景 |
|---|---|---|---|
| 逐条等待 | 每发一条就等待 confirm | 单条清晰 | 低频管理消息 |
| 批量确认 | 连续发布 N 条后统一等待 | 通常按整批处理 | 快速提升吞吐 |
| 异步确认 | 发布不停顿,回调处理 ack/nack | 可关联到发布序号 | 持续高吞吐 |
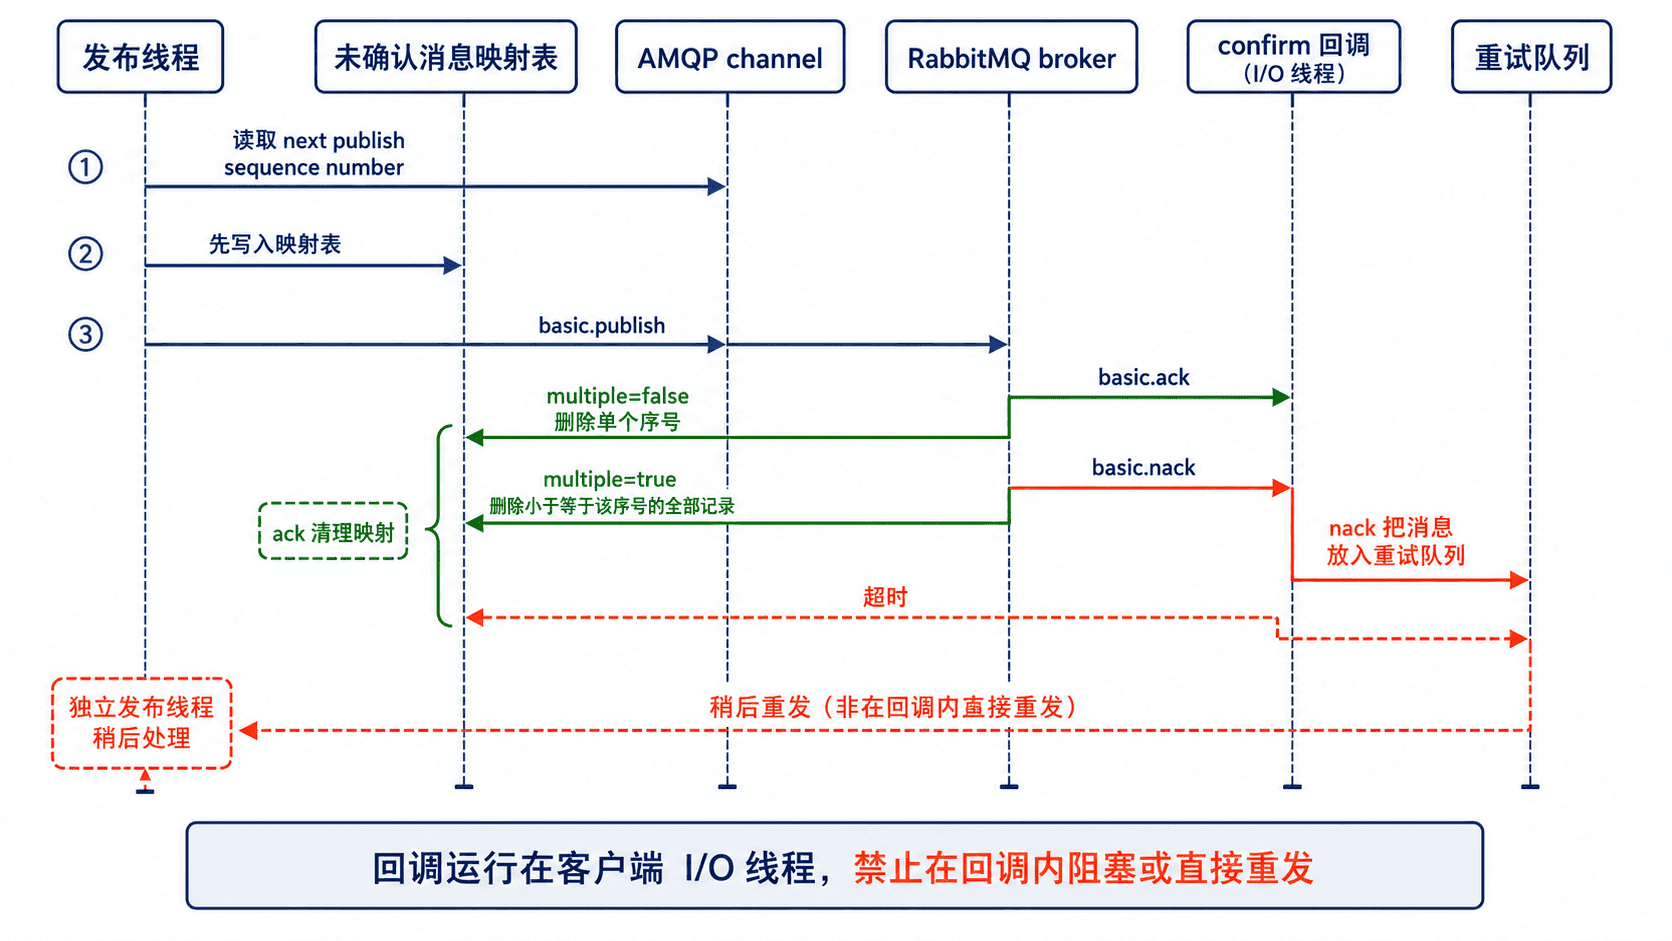
RabbitMQ 没有把多条普通 AMQP 0-9-1 消息合成一个“批量帧”;这里的批量是客户端连续调用 basicPublish,然后等待这批未确认消息全部被 broker 确认。
可运行示例
创建 Maven 项目并保存以下 pom.xml。示例使用 Java 17 和 RabbitMQ Java Client 5.28.0,exec-maven-plugin 用于直接运行主类。
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>example</groupId>
  <artifactId>rabbitmq-batch-publisher</artifactId>
  <version>1.0.0</version>

  <properties>
    <maven.compiler.release>17</maven.compiler.release>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
  </properties>

  <dependencies>
    <dependency>
      <groupId>com.rabbitmq</groupId>
      <artifactId>amqp-client</artifactId>
      <version>5.28.0</version>
    </dependency>
  </dependencies>

  <build>
    <plugins>
      <plugin>
        <groupId>org.codehaus.mojo</groupId>
        <artifactId>exec-maven-plugin</artifactId>
        <version>3.5.1</version>
      </plugin>
    </plugins>
  </build>
</project>
将以下文件保存为 src/main/java/BatchPublisher.java。程序会声明演示拓扑,可通过第一个参数选择 batch 或 async。
import com.rabbitmq.client.BuiltinExchangeType;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.ConfirmCallback;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;
import com.rabbitmq.client.MessageProperties;

import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.List;
import java.util.NavigableMap;
import java.util.concurrent.ConcurrentLinkedQueue;
import java.util.concurrent.ConcurrentNavigableMap;
import java.util.concurrent.ConcurrentSkipListMap;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.TimeoutException;

public final class BatchPublisher {
    private static final String EXCHANGE = "bulk.demo";
    private static final String QUEUE = "bulk.demo.q";
    private static final String ROUTING_KEY = "bulk";

    public static void main(String[] args) throws Exception {
        String mode = args.length > 0 ? args[0] : "batch";
        int total = args.length > 1 ? Integer.parseInt(args[1]) : 1000;
        int batchSize = args.length > 2 ? Integer.parseInt(args[2]) : 100;
        if (total <= 0 || ("batch".equals(mode) && batchSize <= 0)) {
            throw new IllegalArgumentException("total and batchSize must be positive");
        }

        ConnectionFactory factory = new ConnectionFactory();
        factory.setUri(System.getenv().getOrDefault(
                "AMQP_URI", "amqp://guest:guest@localhost:5672/%2f"));

        try (Connection connection = factory.newConnection("batch-publisher");
             Channel channel = connection.createChannel()) {
            channel.exchangeDeclare(EXCHANGE, BuiltinExchangeType.DIRECT, true);
            channel.queueDeclare(QUEUE, true, false, false, null);
            channel.queueBind(QUEUE, EXCHANGE, ROUTING_KEY);
            // Confirm 模式按 channel 开启一次,不能每条消息重复开启。
            channel.confirmSelect();

            if ("batch".equals(mode)) {
                publishInBatches(channel, total, batchSize);
            } else if ("async".equals(mode)) {
                publishAsynchronously(channel, total);
            } else {
                throw new IllegalArgumentException("mode must be batch or async");
            }
        }
    }

    private static void publishInBatches(Channel channel, int total, int batchSize)
            throws Exception {
        int pending = 0;
        for (int i = 1; i <= total; i++) {
            channel.basicPublish(EXCHANGE, ROUTING_KEY,
                    MessageProperties.PERSISTENT_TEXT_PLAIN, body(i));
            pending++;
            if (pending == batchSize) {
                // 只在批次边界等待,避免每条消息承担一次同步往返。
                channel.waitForConfirmsOrDie(5000);
                pending = 0;
            }
        }
        if (pending > 0) {
            channel.waitForConfirmsOrDie(5000);
        }
        System.out.printf("mode=batch published=%d batchSize=%d%n", total, batchSize);
    }

    private static void publishAsynchronously(Channel channel, int total)
            throws Exception {
        // 发布线程写入、I/O 回调线程清理,因此使用并发且有序的映射。
        ConcurrentNavigableMap<Long, String> outstanding =
                new ConcurrentSkipListMap<>();
        ConcurrentLinkedQueue<String> retryQueue = new ConcurrentLinkedQueue<>();
        CountDownLatch settled = new CountDownLatch(total);

        ConfirmCallback ack = (sequenceNumber, multiple) ->
                countDown(settled, remove(outstanding, sequenceNumber, multiple).size());

        ConfirmCallback nack = (sequenceNumber, multiple) -> {
            // 回调中只转交失败消息,禁止阻塞或直接调用 channel 重发。
            List<String> failed = remove(outstanding, sequenceNumber, multiple);
            retryQueue.addAll(failed);
            countDown(settled, failed.size());
        };
        channel.addConfirmListener(ack, nack);

        for (int i = 1; i <= total; i++) {
            String message = "message-" + i;
            long sequenceNumber = channel.getNextPublishSeqNo();
            // 必须先登记再发布,避免 confirm 先到而找不到关联记录。
            outstanding.put(sequenceNumber, message);
            channel.basicPublish(EXCHANGE, ROUTING_KEY,
                    MessageProperties.PERSISTENT_TEXT_PLAIN,
                    message.getBytes(StandardCharsets.UTF_8));
        }

        // 有界等待防止 broker 或网络异常时永久挂住发布线程。
        if (!settled.await(10, TimeUnit.SECONDS)) {
            throw new TimeoutException("publisher confirms timed out");
        }
        if (!retryQueue.isEmpty()) {
            throw new IllegalStateException("nack count=" + retryQueue.size());
        }
        System.out.printf("mode=async published=%d outstanding=%d nacks=%d%n",
                total, outstanding.size(), retryQueue.size());
    }

    private static List<String> remove(
            ConcurrentNavigableMap<Long, String> outstanding,
            long sequenceNumber,
            boolean multiple) {
        if (multiple) {
            NavigableMap<Long, String> confirmed =
                    outstanding.headMap(sequenceNumber, true);
            List<String> messages = new ArrayList<>(confirmed.values());
            confirmed.clear();
            return messages;
        }
        String message = outstanding.remove(sequenceNumber);
        return message == null ? List.of() : List.of(message);
    }

    private static void countDown(CountDownLatch latch, int count) {
        for (int i = 0; i < count; i++) {
            latch.countDown();
        }
    }

    private static byte[] body(int number) {
        return ("message-" + number).getBytes(StandardCharsets.UTF_8);
    }
}运行两种模式。AMQP_URI 中的主机、端口、账号和 vhost 按实际环境修改;默认账号 guest 通常只允许本机连接。
mvn -q -DskipTests compile

AMQP_URI='amqp://guest:guest@localhost:5672/%2f' \
  mvn -q exec:java -Dexec.mainClass=BatchPublisher \
  -Dexec.args='batch 1000 100'

AMQP_URI='amqp://guest:guest@localhost:5672/%2f' \
  mvn -q exec:java -Dexec.mainClass=BatchPublisher \
  -Dexec.args='async 1000'
忽略 Maven 或日志框架可能附加的提示,程序关键输出如下。
mode=batch published=1000 batchSize=100
mode=async published=1000 outstanding=0 nacks=0
确认结果读取
confirmSelect() 只需对每个发布 channel 调用一次。异步回调中的 sequenceNumber 用于关联消息;multiple=false 只确认该序号,multiple=true 表示小于等于该序号的消息一起被确认或拒绝。
Publisher confirm 表示 broker 已处理发布请求,不表示消费者已经收到或完成业务处理。持久消息路由到持久队列时,ack 的时点还取决于落盘和队列类型,因此应按实际 confirm 延迟调节批量大小与超时。
风险与边界
批量过大时,触发条件是 confirm 延迟升高或连接中断,可能导致内存中保留大量消息,并在重试时形成重复发布尖峰。安全替代方案是限制未确认窗口,超时后暂停继续发送,并把整批原始消息保留到可审计的重试队列。
连接断开或等待超时时,发布结果可能处于未知状态;直接重试可能产生重复消息。演示程序还会声明固定名称的持久交换机和队列,生产验证应改用隔离 vhost 或不会与现有拓扑冲突的名称。生产端应为消息设置稳定 message ID,消费端按业务键幂等处理,而不是假设 confirm 能提供端到端恰好一次语义。
不要让多个发布线程共享同一个 channel,否则可能造成帧交错并干扰 confirm 序号关联。异步 confirm 回调运行在客户端 I/O 线程,禁止在回调中阻塞或直接重发;应把 nack 消息转交给独立发布线程。
速查提示
先用批量确认替换逐条等待,验证吞吐和可接受的整批重试成本;当等待仍成为瓶颈,再升级为异步确认。示例中的批量大小 100 和超时 5 秒仅用于演示,生产值应依据消息大小、队列类型、网络延迟和 broker confirm 延迟压测确定。
从连接复用、确认模式、批量大小和网络往返定位发布瓶颈。
优化发布吞吐
用于定位发布端吞吐低是由连接抖动、逐条等待确认、未确认窗口过小、网络往返还是 Broker 写入能力造成。压测时固定消息大小、持久化属性、队列类型和消费者数量,每轮只改一个变量,避免把拓扑差异误判为客户端优化效果。
定位链路
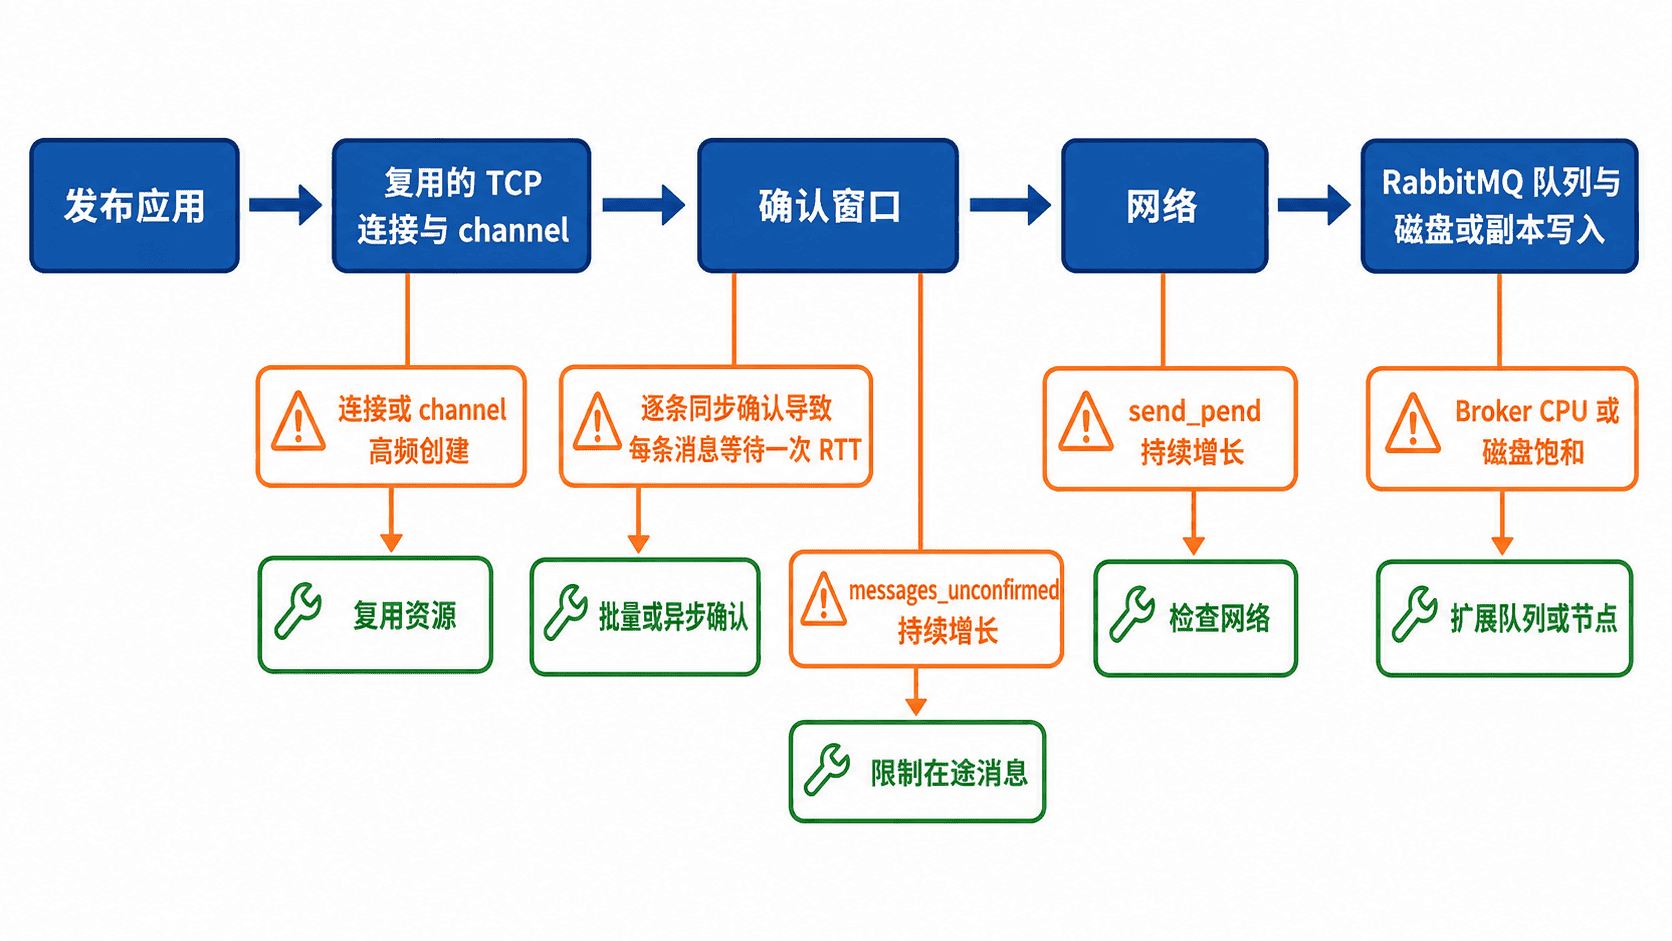
先确认客户端是否被 socket 背压,以及 publisher confirm 是否堆积。send_pend 持续增大通常表示数据已在客户端连接上排队;messages_unconfirmed 长时间增长则说明发布速度高于确认返回速度,需要继续看磁盘、副本、流控和确认回调。
rabbitmqctl list_connections name channels state send_pend -q
rabbitmqctl list_channels connection number messages_unconfirmed -q
预期输出
name                                             channels  state    send_pend
<CLIENT_IP>:<PORT> -> <BROKER_IP>:5672          4         running  0
connection                         number  messages_unconfirmed
<rabbit@node.<ID>.0> 1 240读取时关注趋势而不是单次值:send_pend 和未确认数短暂波动正常;若二者持续上升且发布速率下降,说明在途窗口没有被及时消化。连接和 channel 应在应用启动后趋于稳定,而不是随消息数增长。
用 PerfTest 比较确认窗口
下面固定 1 KiB 持久化消息、单生产者、单消费者和 30 秒时长,只改变最大未确认发布数。-c 越大,越能摊薄网络往返,但也会增加内存占用和失败后的重试范围。RabbitMQ 官方 PerfTest 将 -c 定义为最大 outstanding publishes,并建议用一致工作负载建立基线。:contentReference[oaicite:0]{index=0}
export AMQP_URI='amqp://user:password@rabbitmq.example.com:5672/%2f'

for window in 1 100 500 2000; do
  java -jar perf-test.jar --uri "$AMQP_URI" \
    -x 1 -y 1 -u "publish-throughput-$window" \
    -f persistent -s 1024 -c "$window" -z 30 \
    --id "confirm-$window" -mf compact
done
预期输出
time               sent          received        consumer latency
1.000s             <SENT> msg/s  <RECEIVED> msg/s <P0>/<P50>/<P75>/<P95>/<P99> <UNIT>
...
比较每组稳定阶段的 sent,不要只看首秒。若窗口从 1 增至 100 后吞吐明显上升,瓶颈主要是逐条确认和 RTT;继续增大到 500、2000 已无收益时,应停止扩窗,转查 Broker、磁盘、队列副本或网络带宽。
调优顺序
优先复用长连接和 channel,再将“每条消息同步等待 confirm”改为批量等待或异步 confirm。官方 Java 教程指出,逐条同步确认会阻塞后续发布;批量确认能显著提高远端节点场景的吞吐,异步确认则能获得更细粒度的失败处理。:contentReference[oaicite:1]{index=1}
批量大小不要只按条数控制。生产代码通常同时设置“最大条数、最大字节数、最大等待时间”三个边界,任一达到就发送或等待确认;低流量时靠时间边界避免消息长期滞留,高流量时靠条数或字节边界限制内存。
单个发布 channel 达到平台上限后,再逐步增加发布线程和 channel。每次增加后同时观察发送速率、confirm 延迟、CPU、磁盘和网络;若吞吐不再增长而尾延迟上升,说明并发已经超过有效拐点。
风险与边界
关闭 publisher confirm 只适用于允许丢失、可从源端重放或有其他端到端校验的消息。连接在 Broker 接收前断开时,客户端无法知道消息是否到达;安全替代方案是异步 confirm、有限在途窗口、超时重试,并让消费者按 messageId 幂等处理。
确认窗口过大在 Broker 变慢或网络中断时会积压大量消息,导致发布进程内存上涨;批量重试还可能产生重复消息。应设置最大 outstanding 数、确认超时和失败队列,重试时保留稳定业务键,不能把“未收到确认”直接等同于“Broker 未写入”。
不要在生产 vhost 直接运行无上限压测。PerfTest 会创建队列并持续发送,可能触发内存或磁盘告警并影响真实流量;应使用隔离 vhost、限时参数和独立测试队列,结束后删除残留资源。
避免频繁创建 TCP 连接,并控制每个连接上的 channel 数量。
复用连接与信道
用于避免每次发布都创建 TCP 连接或 channel,同时防止单个连接挂载过多 channel。推荐把连接作为进程级长生命周期资源,把 channel 作为线程、协程或受控池中的工作资源,并在连接恢复后重新校验可用性。
推荐结构
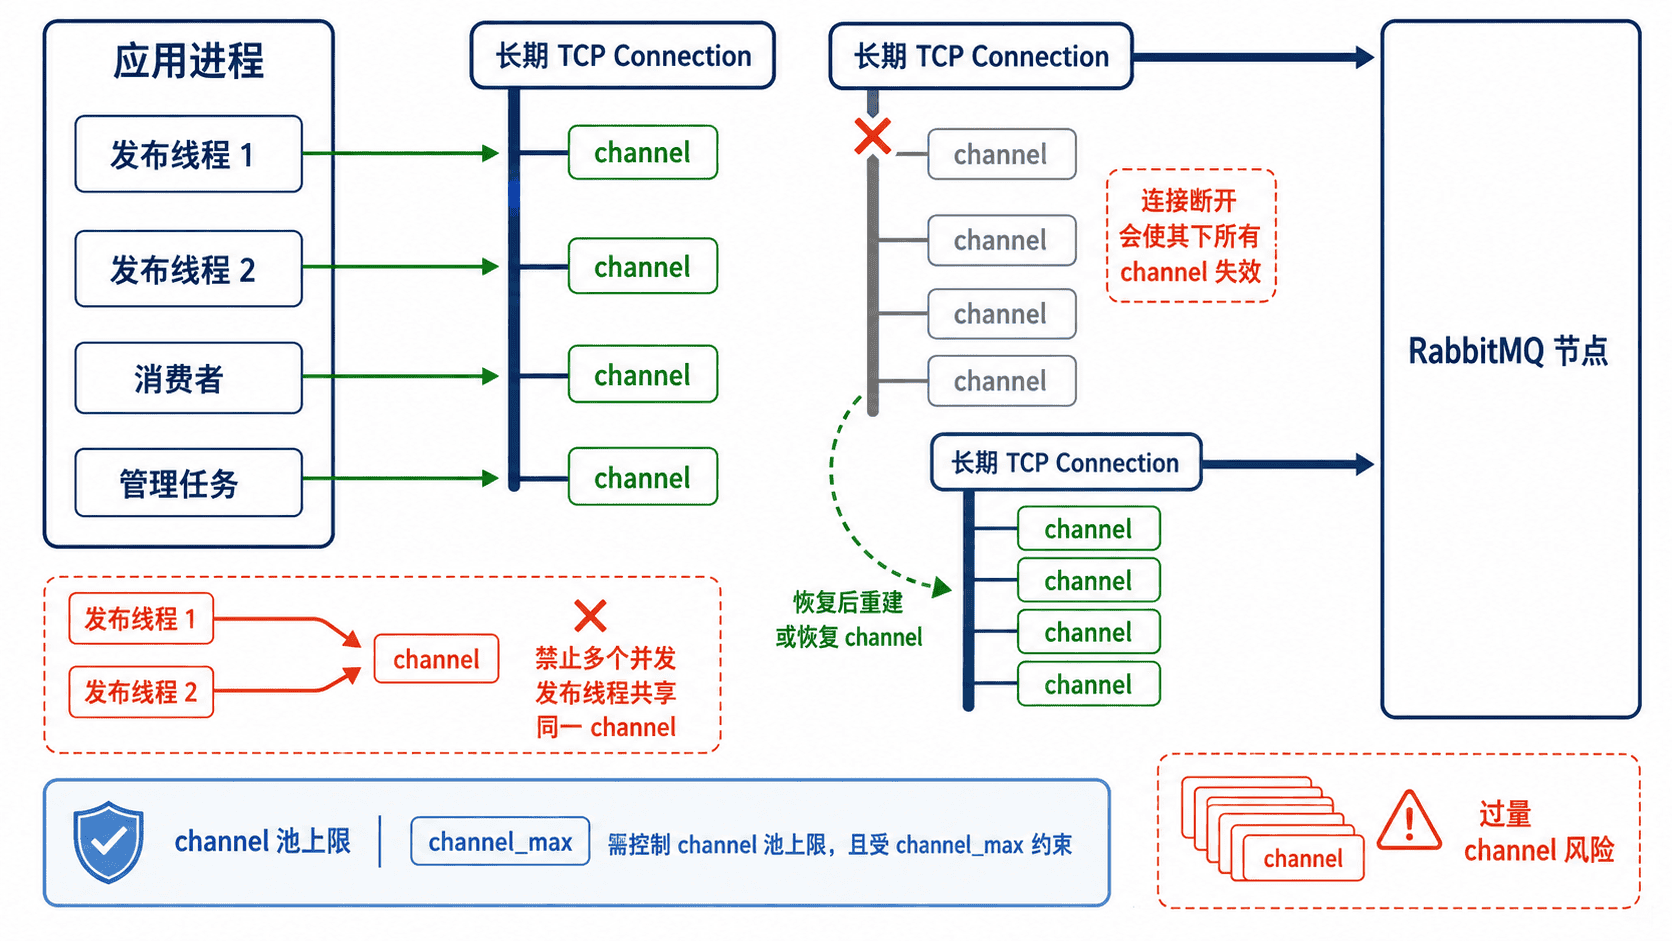
AMQP 0-9-1 在一个 TCP 连接上复用多个 channel。连接和 channel 都应长期存在;为每条消息新建连接会产生 TCP、认证和协议握手开销,为每次操作新建 channel 也会增加一次网络往返。官方文档明确建议优先复用二者。:contentReference[oaicite:2]{index=2}
并发发布时不要让多个线程同时操作同一个 channel。常见模型是“少量进程级连接 + 每个发布线程一个 channel”,或者使用有上限的 channel 池;消费 channel 与发布 channel 分离,避免确认、消费回调和拓扑操作互相干扰。
Java 复用示例
示例只创建一个连接,两个发布线程各自创建并复用自己的 channel。测试队列设置为 exclusive 和 auto-delete,连接关闭后自动删除;每个 channel 开启 confirm,并在发送完一批消息后统一等待确认。
<project xmlns="http://maven.apache.org/POM/4.0.0">
  <modelVersion>4.0.0</modelVersion>
  <groupId>demo</groupId>
  <artifactId>rabbitmq-reuse</artifactId>
  <version>1.0.0</version>
  <dependencies>
    <dependency>
      <groupId>com.rabbitmq</groupId>
      <artifactId>amqp-client</artifactId>
      <version>5.28.0</version>
    </dependency>
  </dependencies>
</project>import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;
import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;
public class ConnectionReuseDemo {
private static final String QUEUE = "reuse.demo";
public static void main(String[] args) throws Exception {
ConnectionFactory factory = new ConnectionFactory();
factory.setUri(System.getenv().getOrDefault(
"AMQP_URI", "amqp://guest:guest@localhost:5672/%2f"));
factory.setAutomaticRecoveryEnabled(true);
try (Connection connection = factory.newConnection("publisher-reuse-demo")) {
ExecutorService pool = Executors.newFixedThreadPool(2);
List<Future<?>> tasks = new ArrayList<>();
for (int publisherId = 0; publisherId < 2; publisherId++) {
int id = publisherId;
tasks.add(pool.submit(() -> {
// Connection 可共享;每个并发发布线程独占自己的 Channel。
try (Channel channel = connection.createChannel()) {
channel.queueDeclare(QUEUE, false, true, true, null);
channel.confirmSelect();
for (int i = 0; i < 10; i++) {
String body = "publisher=" + id + ",seq=" + i;
channel.basicPublish("", QUEUE, null,
body.getBytes(StandardCharsets.UTF_8));
}
channel.waitForConfirmsOrDie(5_000);
System.out.println("publisher-" + id + " confirmed=10");
} catch (Exception e) {
throw new RuntimeException(e);
}
}));
}
for (Future<?> task : tasks) {
task.get();
}
pool.shutdown();
System.out.println("connectionOpen=" + connection.isOpen());
}
}
}mkdir -p src/main/java
# 将 Java 代码保存为 src/main/java/ConnectionReuseDemo.java
mvn -q dependency:build-classpath -Dmdep.outputFile=cp.txt
javac -cp "$(cat cp.txt)" src/main/java/ConnectionReuseDemo.java
java -cp "src/main/java:$(cat cp.txt)" ConnectionReuseDemo预期输出
publisher-0 confirmed=10
publisher-1 confirmed=10
connectionOpen=true
前两行顺序可能交换。结果表明两个线程共享同一个仍保持打开的 TCP 连接,但各自使用独立 channel;若连接失败,所属 channel 也会失效,未启用自动恢复的客户端必须重建连接、channel 和必要拓扑。
检查复用效果
部署后查看每条连接上的 channel 数。应用启动完成后,连接数和 channel 数应大致稳定;持续增长说明泄漏,持续高频开关说明生命周期放错了位置。
rabbitmqctl list_connections name channels state -q
rabbitmqctl list_channels connection number user consumer_count messages_unconfirmed -q
预期输出
name                                             channels  state
<CLIENT_IP>:<PORT> -> <BROKER_IP>:5672          4         running
connection                         number  user       consumer_count  messages_unconfirmed
<rabbit@node.<ID>.0>               1       app_user   0               0
channels 是该 TCP 连接上的 channel 总数;number 是连接内的 channel 编号。发布连接上的 messages_unconfirmed 应随流量波动并能回落。RabbitMQ 官方建议多数应用从每连接个位数 channel 起步,高并发场景可先按线程、进程或协程分配,再在资源指标不允许时切换为池化;这只是起点,不是硬阈值。:contentReference[oaicite:3]{index=3}
数量与生命周期边界
连接不要无限集中。把全部业务共用一条连接会扩大故障影响面,也可能让高吞吐发布挤压低延迟消费;安全做法是按应用实例、业务角色或可靠性等级拆成少量连接,而不是退回“每条消息一连接”。
channel 也不能无限增加。每个 channel 都占用客户端内存、Broker 内存和 Erlang 进程;超过协商的 channel_max 会导致连接级致命错误。先限制池大小并监控 open、close 速率,确需更多并发时再增加连接或拆分工作负载。:contentReference[oaicite:4]{index=4}
若某个声明、权限或资源访问错误关闭了 channel,不要把已关闭对象放回池中。应读取 shutdown reason,丢弃该 channel,修复根因后创建新 channel;盲目重试同一声明会形成高 channel churn,并持续消耗 Broker 资源。
快速消费指定队列并打印消息体、属性和投递信息。
启动测试消费者
用于临时连接指定队列,读取一条消息并打印消息体、属性和投递信息。默认不确认消息,连接关闭后消息会重新入队;只有明确传入 --ack 才会删除该消息,适合联调和故障取样。
前置条件
准备一个仅具目标 vhost 读取权限的测试账号,并通过 AMQP_URL 传入连接信息。默认 vhost / 在 URI 中写成 %2F;脚本依赖 Pika,并使用 passive=True 检查队列是否已经存在。
可运行脚本
import argparse
import os

import pika

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("queue")
    parser.add_argument("--ack", action="store_true")
    args = parser.parse_args()

    amqp_url = os.getenv("AMQP_URL")
    if not amqp_url:
        raise SystemExit("AMQP_URL is required")

    connection = pika.BlockingConnection(pika.URLParameters(amqp_url))
    channel = connection.channel()

    # 只检查现有队列,避免因名称写错而意外创建新队列。
    channel.queue_declare(queue=args.queue, passive=True)
    channel.basic_qos(prefetch_count=1)

    def on_message(ch, method, properties, body: bytes) -> None:
        text = body.decode("utf-8", errors="replace")
        print(
            f"delivery exchange={method.exchange!r} "
            f"routing_key={method.routing_key!r} "
            f"delivery_tag={method.delivery_tag} "
            f"redelivered={method.redelivered}"
        )
        print(
            f"properties content_type={properties.content_type!r} "
            f"message_id={properties.message_id!r} "
            f"correlation_id={properties.correlation_id!r} "
            f"headers={properties.headers!r}"
        )
        print(f"body={text}")

        if args.ack:
            ch.basic_ack(delivery_tag=method.delivery_tag)
            print("result=acked")
        else:
            # 保持未确认并停止;关闭连接后 Broker 会把消息重新入队。
            print("result=left-unacked; closing connection will requeue")
        ch.stop_consuming()

    channel.basic_consume(
        queue=args.queue,
        on_message_callback=on_message,
        auto_ack=False,
    )

    try:
        print(f"waiting queue={args.queue!r} ack={args.ack}")
        channel.start_consuming()
    except KeyboardInterrupt:
        print("stopped by user")
    finally:
        if connection.is_open:
            connection.close()

if __name__ == "__main__":
    main()
启动与预期输出
先在当前虚拟环境安装 Pika,再执行脚本。不要把真实密码写入共享脚本、工单或 shell 历史。
export AMQP_URL='amqp://test_user:<PASSWORD>@127.0.0.1:5672/%2F'
python test_consumer.py orders.test预期输出如下;<ID>、交换机、路由键和属性值由实际消息决定。
waiting queue='orders.test' ack=False
delivery exchange='orders' routing_key='created' delivery_tag=<ID> redelivered=False
properties content_type='application/json' message_id='msg-1001' correlation_id=None headers={'source': 'smoke-test'}
body={"orderId":1001}
result=left-unacked; closing connection will requeue
输出读取
delivery 用于确认消息来自哪个交换机和路由键;redelivered=True 表示该投递可能是重新投递。properties 用于核对内容类型、消息 ID、关联 ID 和业务头;body 是实际消息体,非 UTF-8 字节会以替换字符显示。RabbitMQ 的重新投递与未确认消息关闭通道后的处理规则见官方说明。:contentReference[oaicite:0]{index=0}
风险与排障
传入 --ack 会在打印后确认并删除消息;若连到生产队列,可能造成真实任务被消费,安全替代是使用镜像测试队列或保持默认不确认。默认模式若持续反复运行,会让同一消息多次显示为重新投递,因此只取样一次后停止。
出现 NOT_FOUND 时先核对 vhost 和队列名;出现 ACCESS_REFUSED 时检查账号对该 vhost 的 read 权限;连接超时则检查主机、端口、TLS 和防火墙。脚本采用 Pika BlockingConnection 的 basic_consume 回调接口。:contentReference[oaicite:1]{index=1}
在业务处理成功后 ack,失败时按策略 nack 或 reject。
使用手动确认
手动确认把“收到消息”和“业务处理成功”分开:处理成功后发送 ack;临时失败按受控策略 nack;不可处理的数据 reject 或 nack 且不重新入队。这样可以避免业务失败时消息被提前删除。
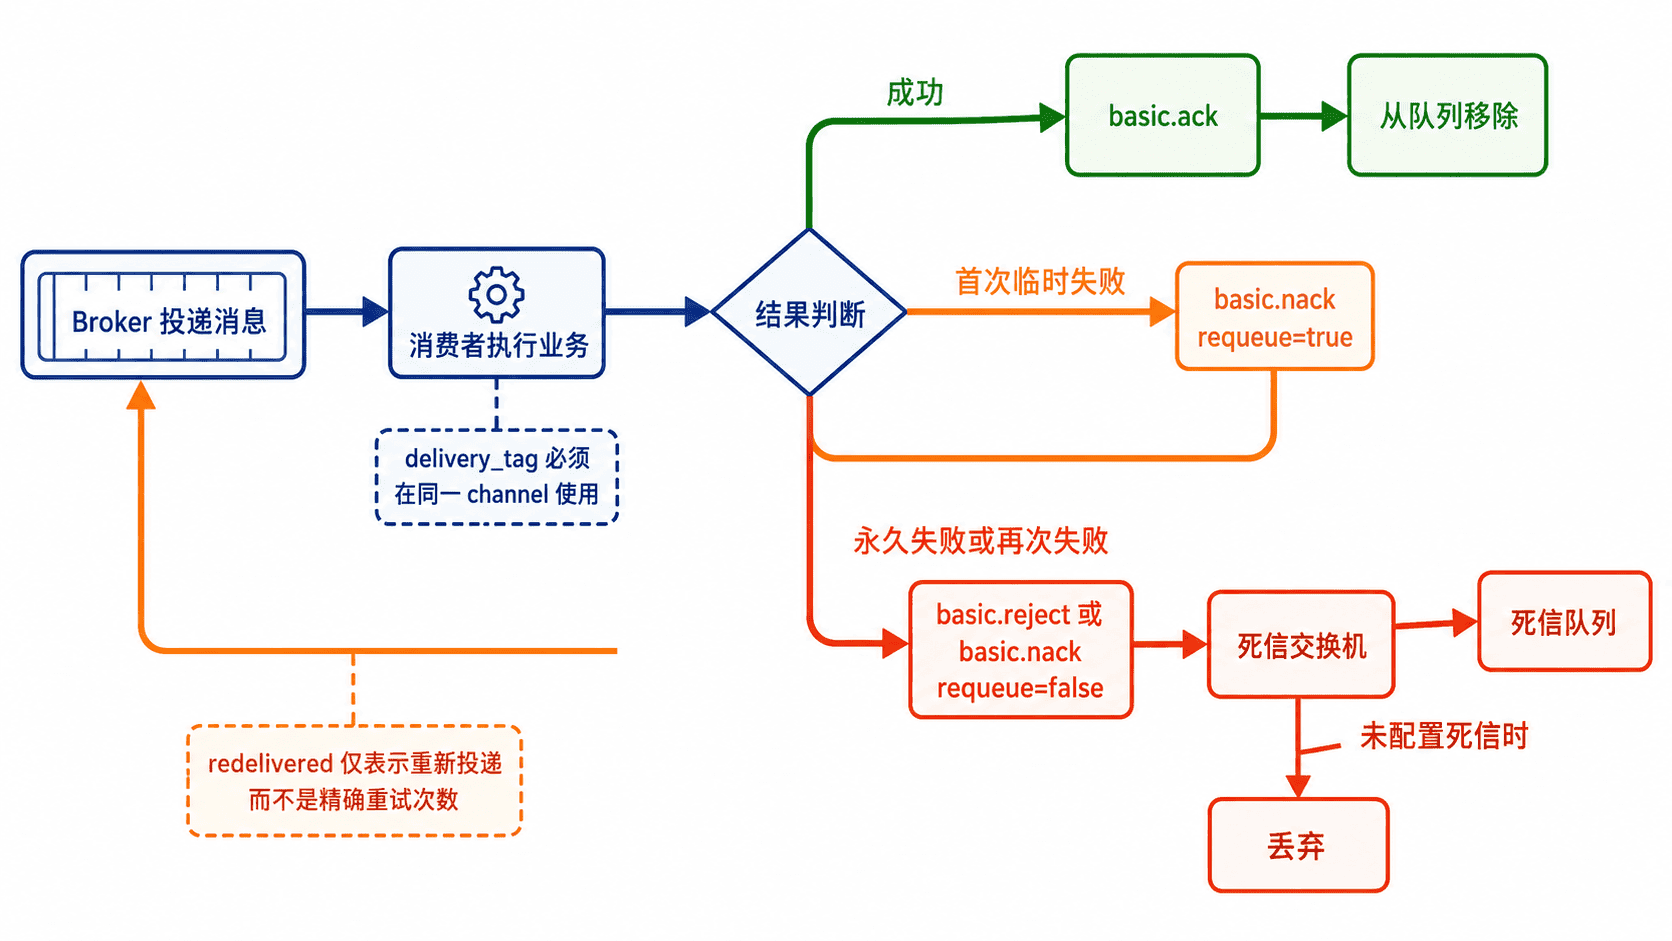
决策规则
| 处理结果 | 操作 | 结果 |
|---|---|---|
| 业务成功 | basic_ack |
Broker 删除本次投递 |
| 临时失败且允许立即重试 | basic_nack(requeue=True) |
消息重新入队,可能很快再次投递 |
| 数据无效或重试耗尽 | basic_reject(requeue=False) 或 basic_nack(requeue=False) |
配置 DLX 时进入死信流程,否则被丢弃 |
basic.reject 只能处理一条投递;RabbitMQ 扩展的 basic.nack 还支持批量否定确认。确认语义及 nack 行为见官方文档。:contentReference[oaicite:2]{index=2}
可运行示例
下面脚本用 redelivered 做一次性保护:临时错误首次重新入队,再次投递仍失败时不再 requeue。它不是精确重试计数;生产环境更适合使用带 TTL 的重试队列或延迟交换方案记录次数。
import argparse
import json
import os

import pika

class PermanentError(Exception):
    pass

class TransientError(Exception):
    pass

def handle(body: bytes) -> str:
    try:
        payload = json.loads(body.decode("utf-8"))
    except (UnicodeDecodeError, json.JSONDecodeError) as exc:
        raise PermanentError("invalid JSON payload") from exc

    if payload.get("simulate") == "transient":
        raise TransientError("temporary downstream failure")
    if "taskId" not in payload:
        raise PermanentError("missing taskId")

    return str(payload["taskId"])

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("queue")
    args = parser.parse_args()

    amqp_url = os.getenv("AMQP_URL")
    if not amqp_url:
        raise SystemExit("AMQP_URL is required")

    connection = pika.BlockingConnection(pika.URLParameters(amqp_url))
    channel = connection.channel()
    channel.queue_declare(queue=args.queue, passive=True)

    # 限制未确认消息数量,避免单个消费者积压大量在途消息。
    channel.basic_qos(prefetch_count=10)

    def on_message(ch, method, properties, body: bytes) -> None:
        tag = method.delivery_tag
        try:
            task_id = handle(body)
        except PermanentError as exc:
            ch.basic_reject(delivery_tag=tag, requeue=False)
            print(f"reject tag={tag} reason={exc}")
        except TransientError as exc:
            if method.redelivered:
                ch.basic_nack(delivery_tag=tag, requeue=False)
                print(f"nack-no-requeue tag={tag} reason={exc}")
            else:
                ch.basic_nack(delivery_tag=tag, requeue=True)
                print(f"nack-requeue tag={tag} reason={exc}")
        except Exception as exc:
            # 未知异常不立即循环重试,交给死信或人工补偿处理。
            ch.basic_nack(delivery_tag=tag, requeue=False)
            print(f"nack-no-requeue tag={tag} reason=unexpected:{exc}")
        else:
            ch.basic_ack(delivery_tag=tag)
            print(f"ack tag={tag} taskId={task_id}")

    channel.basic_consume(
        queue=args.queue,
        on_message_callback=on_message,
        auto_ack=False,
    )

    try:
        print(f"consuming queue={args.queue!r}")
        channel.start_consuming()
    except KeyboardInterrupt:
        print("stopped by user")
    finally:
        if connection.is_open:
            connection.close()

if __name__ == "__main__":
    main()
启动与预期输出
export AMQP_URL='amqp://worker_user:<PASSWORD>@127.0.0.1:5672/%2F'
python manual_ack_consumer.py tasks.ready
当队列收到 {"taskId":"t-1001"} 时,预期输出如下;<ID> 是当前 channel 分配的投递标签。
consuming queue='tasks.ready'
ack tag=<ID> taskId=t-1001
若消息缺少 taskId,输出 reject;若 simulate 为 transient,首次输出 nack-requeue,重新投递后仍失败则输出 nack-no-requeue。
风险与边界
requeue=True 在故障持续时可能形成高频重投,造成 CPU、网络和日志放大;安全替代是有限次数的延迟重试,并在耗尽后进入 DLX。requeue=False 只有在队列配置死信交换机时才会保留到死信链路,否则消息会被丢弃。:contentReference[oaicite:3]{index=3}
确认必须使用收到该消息的同一 channel 和对应 delivery_tag;跨 channel 或重复确认可能导致通道级错误。处理时间过长还可能触发消费者确认超时并关闭通道,应把长任务拆分、延长合理超时,或定期持久化进度后快速确认。
排障清单
发现消息持续处于 unacked 时,检查回调是否阻塞、异常分支是否遗漏确认,以及消费者是否仍存活。发现同一消息反复出现时,检查 requeue=True、消费者崩溃和连接抖动;redelivered=True 只能说明曾重新投递,不能当作可靠重试计数。
发现死信队列为空时,确认源队列已配置 DLX、路由键匹配,并确认失败分支实际使用了 requeue=False。批量确认使用 multiple=True 前必须保证此前所有投递都已成功,否则会一次确认多个尚未完成的消息。
通过 basic.qos 控制未确认消息数量并平衡吞吐与内存。
设置预取数量
在消费者处理速度不稳定、单条消息耗时较长或进程内存上涨时,用 basic.qos 限制尚未确认的投递数量。常用起点是每个消费者 10~50 条,再根据处理耗时、消息大小和实例内存逐步调整。
基本语法
先设置 QoS,再启动 basic.consume;手动确认必须使用 auto_ack=False。
channel.basic_qos(prefetch_count=20, global_qos=False)
channel.basic_consume(queue="jobs", on_message_callback=handle, auto_ack=False)
channel.start_consuming()
prefetch_count 是允许同时处于未确认状态的消息上限。RabbitMQ 中 global_qos=False 通常按消费者应用;多个消费者共享通道时,不要依赖较大的全局预取值做精确限流。
可运行示例
前置条件:本机 RabbitMQ 可通过 guest/guest 访问,且已安装 pika。示例创建临时队列,发布 3 条消息,以预取 2 条的配置消费并逐条确认。
import os
import time

import pika

url = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
connection = pika.BlockingConnection(pika.URLParameters(url))
channel = connection.channel()

queue = channel.queue_declare(
    queue="", exclusive=True, auto_delete=True
).method.queue

for index in range(1, 4):
    channel.basic_publish(
        exchange="",
        routing_key=queue,
        body=f"job-{index}".encode(),
    )

# 最多允许当前消费者持有 2 条未确认消息。
channel.basic_qos(prefetch_count=2)
processed = 0

def handle(ch, method, properties, body):
    global processed
    print(f"received={body.decode()} tag={method.delivery_tag}")
    time.sleep(0.1)
    ch.basic_ack(delivery_tag=method.delivery_tag)
    processed += 1

    if processed == 3:
        ch.stop_consuming()

channel.basic_consume(
    queue=queue,
    on_message_callback=handle,
    auto_ack=False,
)
channel.start_consuming()
connection.close()预期输出如下,tag 是当前通道内递增的投递标识,实际值可能不同。
received=job-1 tag=1
received=job-2 tag=2
received=job-3 tag=3
调整方法
吞吐不足且 CPU、下游连接池和内存都有余量时,逐步增大 prefetch_count;内存上涨、处理超时或消费者重启后重复消息明显时,优先减小。可用 并发处理数 × 2 作为初始值,再通过压测观察确认延迟、消费速率和常驻内存。
预取值设为 0 表示不限制。大消息或慢任务下可能一次推送大量消息,导致内存激增、消费者负载不均和故障恢复时间变长;安全替代方案是从较小值开始,并尽量为每个消费者使用独立通道。
排障清单
确认消费者确实使用手动确认;自动确认下消息投递后立即视为已确认,预取无法限制实际处理中任务的数量。确认 QoS 在 basic_consume 前设置,并检查应用是否意外在同一通道创建多个消费者。若消息长期堆积,应同时查看消费速率、未确认数、单条处理时长和下游依赖,不要只通过放大预取掩盖瓶颈。
根据错误类型决定 requeue,避免无效消息持续占用消费者。
拒绝并重新入队
消费失败时,只有临时故障才应重新入队;格式错误、业务校验失败或缺少必需字段的消息应拒绝且不重入队。这样可避免同一坏消息被立即反复投递,占满消费者并放大日志、CPU 和下游压力。
基本语法
处理单条消息可用 basic.reject;需要批量拒绝或一次处理多个未确认投递时使用 basic.nack。
channel.basic_reject(
    delivery_tag=method.delivery_tag,
    requeue=False,
)

channel.basic_nack(
    delivery_tag=method.delivery_tag,
    multiple=False,
    requeue=True,
)
requeue=True 会把消息重新放回队列,之后可能投递给当前或其他消费者;requeue=False 会丢弃消息,若队列配置了死信交换机则转入死信路径。multiple=True 会影响当前通道内截至指定 delivery_tag 的多个未确认消息,误用可能批量重入队或丢弃。
可运行示例
示例先把一次临时失败的消息重新入队,检测到 redelivered=True 后确认成功;随后拒绝一条永久无效消息。临时队列未配置死信交换机,因此永久无效消息会被丢弃。
import os

import pika

url = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
connection = pika.BlockingConnection(pika.URLParameters(url))
channel = connection.channel()

queue = channel.queue_declare(
    queue="", exclusive=True, auto_delete=True
).method.queue

channel.basic_publish(
    exchange="",
    routing_key=queue,
    body=b"transient",
)
channel.basic_qos(prefetch_count=1)

def handle(ch, method, properties, body):
    text = body.decode()

    # 临时失败只演示重新入队一次,避免形成无限重投循环。
    if text == "transient" and not method.redelivered:
        print("nack transient requeue=True redelivered=False")
        ch.basic_nack(
            delivery_tag=method.delivery_tag,
            requeue=True,
        )
        return

    if text == "transient":
        print("ack transient redelivered=True")
        ch.basic_ack(delivery_tag=method.delivery_tag)
        ch.basic_publish(
            exchange="",
            routing_key=queue,
            body=b"invalid",
        )
        return

    print("reject invalid requeue=False redelivered=False")
    ch.basic_reject(
        delivery_tag=method.delivery_tag,
        requeue=False,
    )
    ch.stop_consuming()

channel.basic_consume(
    queue=queue,
    on_message_callback=handle,
    auto_ack=False,
)
channel.start_consuming()
connection.close()
预期输出如下。
nack transient requeue=True redelivered=False
ack transient redelivered=True
reject invalid requeue=False redelivered=False
决策边界
网络闪断、短暂限流和下游服务暂时不可用可以重试,但应设置最大次数和退避时间。直接使用 requeue=True 不会自动增加自定义重试计数,持续失败时会形成热循环;生产环境更安全的方案是投递到带 TTL 的重试队列,再通过死信交换机返回原队列。
反序列化失败、签名无效、字段缺失和明确的业务拒绝不应重新入队。若必须保留失败证据,应先配置死信队列或显式写入失败存储,再使用 requeue=False;否则消息可能永久丢失。
排障清单
确认消费者关闭了自动确认,并且每条处理路径最终只执行一次 ack、reject 或 nack。若队列出现高频重复投递,检查 redelivered、消费者异常退出、连接中断和重试策略;若死信队列为空,检查源队列是否设置死信交换机、路由键是否匹配,以及拒绝时是否确实使用了 requeue=False。
识别 redelivered 消息并结合重试次数或死信机制终止循环。
避免重复投递死循环
当同一条失败消息被持续 requeue=true 时,消费者可能在毫秒级反复收到它。处理目标是把 redelivered 当作重复投递信号,而不是次数;真正的次数由受控重试头或 x-death 记录,并在达到上限后进入死信队列。
识别循环
redelivered=true 只表示该投递可能已被消费者见过,不能推导“第几次重试”。普通 basic.nack(..., requeue=true) 不会生成 x-death;只有消息经过死信路由后,x-death 中相同队列与原因的 count 才会累加。
先对照应用日志中的 message_id、重试头和以下队列状态。messages_unacknowledged 持续波动、同一消息快速重复出现、消费者 CPU 或网络升高,通常说明正在形成紧密重投循环。
rabbitmqctl list_queues name messages_ready messages_unacknowledged consumers预期输出:
Listing queues for vhost / ...
name              messages_ready  messages_unacknowledged  consumers
orders.work.q     <N>             <N>                      <N>
<N> 为动态值;重点结合消息日志观察同一 message_id 是否在短时间内重复,而不是只看某一时刻的队列深度。
处理路径
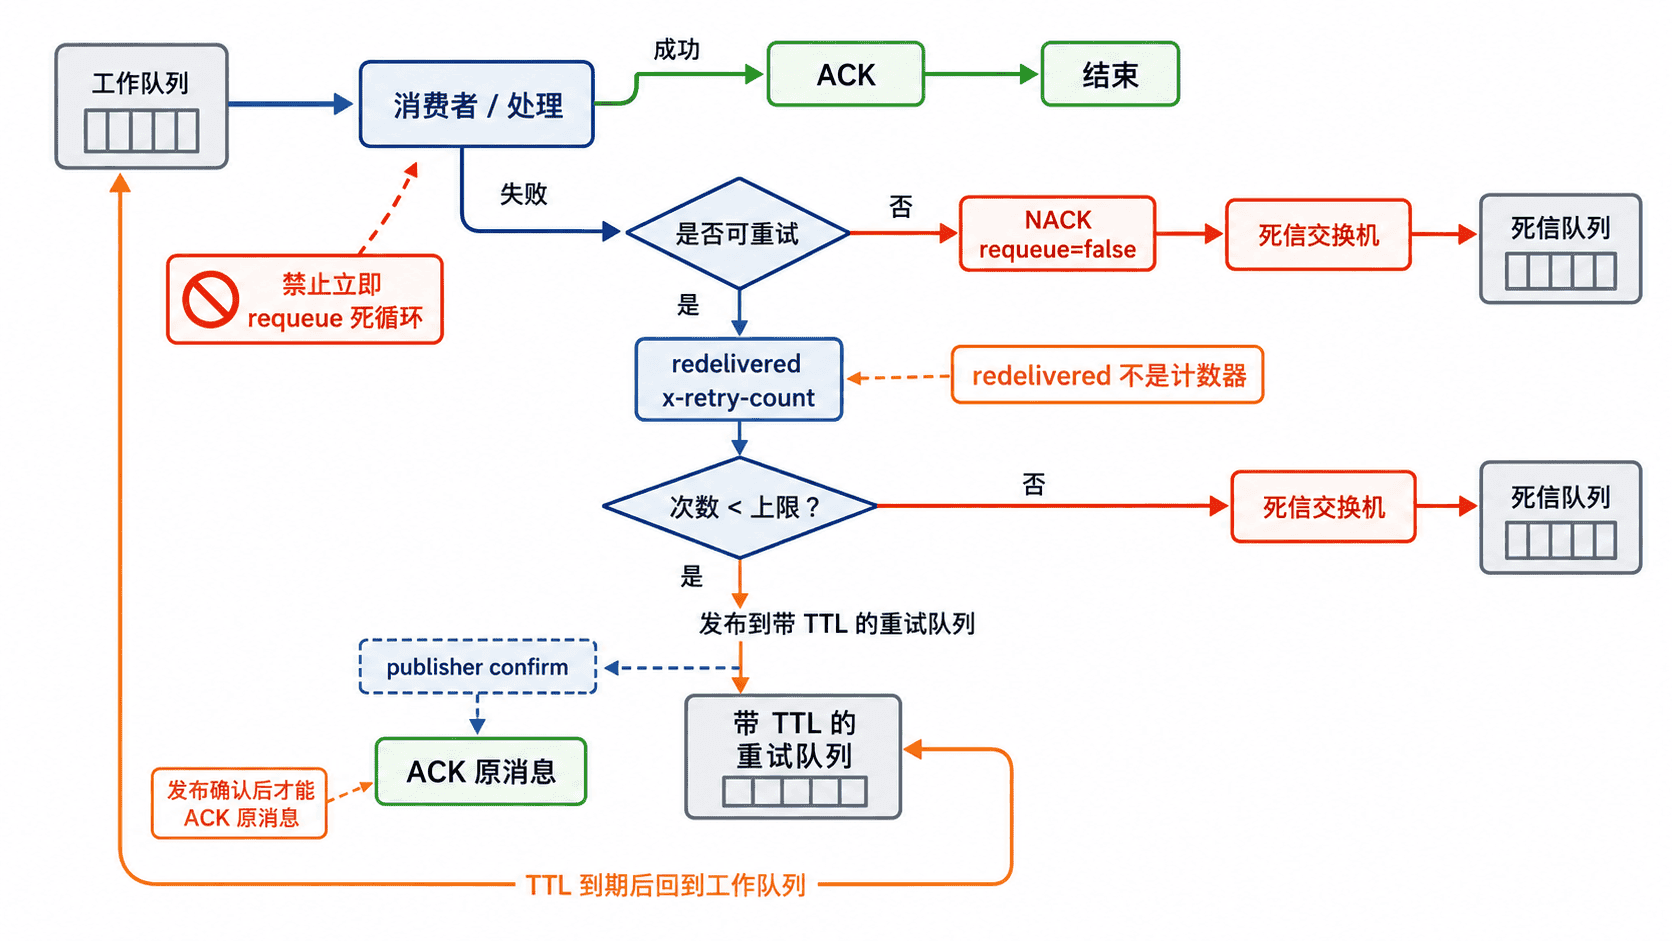
瞬时故障应走带延迟的重试队列;永久性数据错误直接死信。重试消息发布成功并收到确认后,才确认原投递。这样既避免立即重投,也避免“先 ACK、后发布”造成消息丢失。
可运行实现
下面脚本声明工作队列、5 秒重试队列和最终死信队列。示例用自定义 x-retry-count 做稳定计数,并保留 redelivered 仅用于日志判断。保存为 retry_consumer.py。
import os
import uuid

import pika

AMQP_URL = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
WORK_EXCHANGE = "orders.work"
WORK_QUEUE = "orders.work.q"
WORK_KEY = "orders"
RETRY_EXCHANGE = "orders.retry"
RETRY_QUEUE = "orders.retry.5s"
DLX = "orders.dlx"
DLQ = "orders.dead.q"
DEAD_KEY = "orders.dead"
MAX_RETRIES = 3

class TransientError(Exception):
    pass

def read_retry_count(headers):
    try:
        return max(0, int((headers or {}).get("x-retry-count", 0)))
    except (TypeError, ValueError):
        return 0

def process(body):
    if body == b"poison":
        raise TransientError("downstream service unavailable")
    print(f"processed body={body.decode('utf-8')}")

params = pika.URLParameters(AMQP_URL)
with pika.BlockingConnection(params) as connection:
    channel = connection.channel()
    channel.confirm_delivery()
    channel.basic_qos(prefetch_count=1)

    channel.exchange_declare(WORK_EXCHANGE, "direct", durable=True)
    channel.exchange_declare(RETRY_EXCHANGE, "direct", durable=True)
    channel.exchange_declare(DLX, "direct", durable=True)

    channel.queue_declare(
        WORK_QUEUE,
        durable=True,
        arguments={
            "x-dead-letter-exchange": DLX,
            "x-dead-letter-routing-key": DEAD_KEY,
        },
    )
    channel.queue_bind(WORK_QUEUE, WORK_EXCHANGE, WORK_KEY)

    channel.queue_declare(
        RETRY_QUEUE,
        durable=True,
        arguments={
            "x-message-ttl": 5000,
            "x-dead-letter-exchange": WORK_EXCHANGE,
            "x-dead-letter-routing-key": WORK_KEY,
        },
    )
    channel.queue_bind(RETRY_QUEUE, RETRY_EXCHANGE, WORK_KEY)

    channel.queue_declare(DLQ, durable=True)
    channel.queue_bind(DLQ, DLX, DEAD_KEY)

    def on_message(ch, method, properties, body):
        headers = dict(properties.headers or {})
        retry_count = read_retry_count(headers)
        message_id = properties.message_id or "<NONE>"
        print(
            f"delivery id={message_id} "
            f"redelivered={method.redelivered} retry={retry_count}"
        )

        try:
            process(body)
            ch.basic_ack(method.delivery_tag)
        except TransientError:
            if retry_count >= MAX_RETRIES:
                ch.basic_nack(method.delivery_tag, requeue=False)
                print(f"sent to DLQ retry={retry_count}")
                return

            headers["x-retry-count"] = retry_count + 1
            retry_properties = pika.BasicProperties(
                content_type=properties.content_type,
                headers=headers,
                delivery_mode=2,
                message_id=properties.message_id,
                correlation_id=properties.correlation_id,
            )

            # mandatory + publisher confirms 保证重试消息可路由并被 Broker 接收。
            ch.basic_publish(
                exchange=RETRY_EXCHANGE,
                routing_key=WORK_KEY,
                body=body,
                properties=retry_properties,
                mandatory=True,
            )
            ch.basic_ack(method.delivery_tag)
            print(f"retry scheduled count={retry_count + 1}")

    if os.getenv("SEED_POISON") == "1":
        message_id = "demo-" + uuid.uuid4().hex[:8]
        channel.basic_publish(
            WORK_EXCHANGE,
            WORK_KEY,
            b"poison",
            pika.BasicProperties(delivery_mode=2, message_id=message_id),
            mandatory=True,
        )
        print(f"seeded id={message_id}")

    channel.basic_consume(WORK_QUEUE, on_message, auto_ack=False)
    channel.start_consuming()
安装依赖并注入一条测试消息:
python -m pip install pika
SEED_POISON=1 python retry_consumer.py
预期输出:
seeded id=demo-<ID>
delivery id=demo-<ID> redelivered=<BOOLEAN> retry=0
retry scheduled count=1
delivery id=demo-<ID> redelivered=<BOOLEAN> retry=1
retry scheduled count=2
delivery id=demo-<ID> redelivered=<BOOLEAN> retry=2
retry scheduled count=3
delivery id=demo-<ID> redelivered=<BOOLEAN> retry=3
sent to DLQ retry=3
每次重试间隔约 5 秒;<ID>、<BOOLEAN> 为动态值。最终可在 orders.dead.q 中看到该消息。
风险与边界
触发条件是持续失败仍执行 requeue=true。后果是消息被立即重新投递,占满消费者、CPU 和网络,并阻塞后续正常消息。安全替代是延迟重试、有限次数和最终死信;不可恢复的格式或业务校验错误应直接 requeue=false。
重试发布后若未等待 publisher confirm 就 ACK 原消息,连接故障可能让原消息已删除而重试副本未落盘。示例启用发布确认;生产环境还应监控不可路由和发布 NACK,并让进程退出后由 supervisor 按退避策略重启,不能在发布失败时高速原地重投。
消费者即使正确限制重试,也仍可能因“业务已成功、ACK 丢失”再次收到消息。最终写库、扣款或调用外部接口必须使用业务幂等键;message_id 缺失时应由生产者补充稳定事件 ID。
排障清单
- 日志必须同时记录
message_id、redelivered、重试次数、队列和最终处置。 - 确认工作队列的 DLX、路由键及死信队列绑定真实存在;目标缺失可能导致死信丢失或不可路由。
- 检查重试队列 TTL 是否过短;短于下游恢复时间时仍会形成高频抖动。
- 观察 DLQ 增长并建立告警;死信只是隔离,不是问题已经解决。
兼容性
自定义重试头加 TTL 重试队列可用于 classic queue 和 quorum queue。Quorum queue 还可配置 delivery-limit,但计数行为会受 RabbitMQ 版本和负确认方式影响,升级前必须在目标版本验证,不能把它当作应用层最大重试的唯一保护。
处理 consumer cancel、队列删除和连接中断后的重新订阅。
恢复消费者订阅
消费者停止收消息时,先区分网络连接恢复和 Broker 主动取消订阅。连接中断可交给客户端自动恢复;队列删除、不可用或复制队列角色变化触发的 consumer cancel,则要在回调外串行重建队列或等待队列恢复,再重新 basicConsume。
中断来源
| 现象 | 常见原因 | 正确动作 |
|---|---|---|
| 连接或通道关闭,随后自动重连 | 网络闪断、节点重启、负载均衡连接切换 | 启用 connection recovery 与 topology recovery,不手工重复订阅 |
| 收到 consumer cancel,连接仍可用 | 队列被删除、暂时不可用、复制队列变化 | 进入受控重订阅流程 |
应用主动 basicCancel 或进程关闭 |
发布、扩缩容或优雅停机 | 标记停止状态,不再自动订阅 |
不要只依赖 TCP 连接状态。consumer cancel 发生时,连接和通道可能仍然是打开的,但该 consumer 已不会再收到新消息。
恢复路径
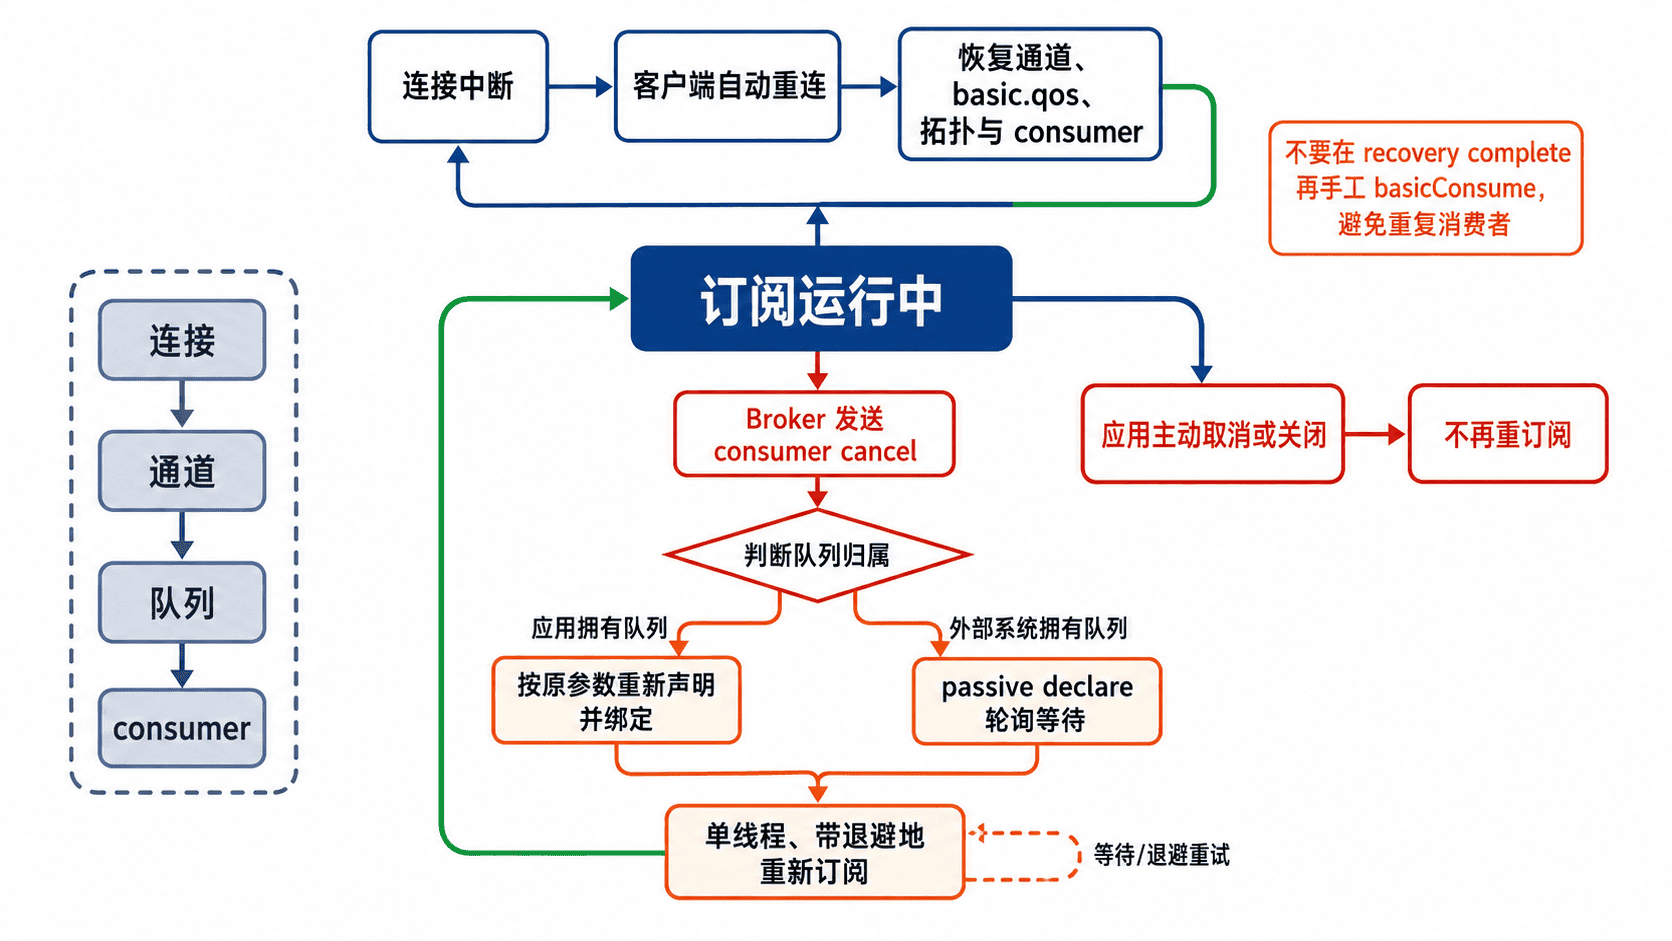
恢复逻辑必须只有一个控制线程,并用原子标记合并重复通知。网络故障由 topology recovery 恢复原 consumer;只有收到服务端 cancel 时才启动手工重订阅,避免自动恢复和手工恢复同时创建两个消费者。
可运行实现
示例使用 RabbitMQ Java Client 5.34.0。应用拥有队列时设置 OWNS_QUEUE=true 并按完全相同的参数声明;队列由其他系统管理时设置为 false,代码只做 passive declare,直到队列重新出现。
pom.xml:
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>example</groupId>
  <artifactId>recovering-consumer</artifactId>
  <version>1.0.0</version>
  <properties>
    <maven.compiler.release>17</maven.compiler.release>
  </properties>
  <dependencies>
    <dependency>
      <groupId>com.rabbitmq</groupId>
      <artifactId>amqp-client</artifactId>
      <version>5.34.0</version>
    </dependency>
  </dependencies>
</project>
保存为 src/main/java/RecoveringConsumer.java:
import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;
import com.rabbitmq.client.DeliverCallback;
import com.rabbitmq.client.Recoverable;
import com.rabbitmq.client.RecoveryListener;

import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.Executors;
import java.util.concurrent.ScheduledExecutorService;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicBoolean;

public final class RecoveringConsumer {
    private static final String QUEUE = env("QUEUE_NAME", "orders.events");
    private static final boolean OWNS_QUEUE =
            Boolean.parseBoolean(env("OWNS_QUEUE", "true"));
    private static final long RETRY_MS = 5000;

    private static final ScheduledExecutorService CONTROL =
            Executors.newSingleThreadScheduledExecutor();
    private static final AtomicBoolean RESUBSCRIBE_PENDING =
            new AtomicBoolean(false);
    private static final AtomicBoolean STOPPING = new AtomicBoolean(false);

    private static volatile Connection connection;
    private static volatile Channel consumerChannel;

    public static void main(String[] args) throws Exception {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setUri(env(
                "AMQP_URI",
                "amqp://guest:guest@localhost:5672/%2F"
        ));
        factory.setAutomaticRecoveryEnabled(true);
        factory.setTopologyRecoveryEnabled(true);
        factory.setNetworkRecoveryInterval(RETRY_MS);

        connection = factory.newConnection("recovering-consumer");
        ((Recoverable) connection).addRecoveryListener(new RecoveryListener() {
            @Override
            public void handleRecoveryStarted(Recoverable recoverable) {
                System.out.println("connection recovery started");
            }

            @Override
            public void handleRecovery(Recoverable recoverable) {
                // topology recovery 会恢复已有 consumer,这里只记录状态。
                System.out.println("connection recovery complete");
            }
        });

        Runtime.getRuntime().addShutdownHook(new Thread(() -> {
            STOPPING.set(true);
            CONTROL.shutdownNow();
            closeQuietly(consumerChannel);
            closeQuietly(connection);
        }));

        subscribeNow();
        new CountDownLatch(1).await();
    }

    private static void subscribeNow() throws Exception {
        if (connection == null || !connection.isOpen()) {
            throw new IOException("connection is not open");
        }

        Channel next = connection.createChannel();
        try {
            next.basicQos(20);

            if (OWNS_QUEUE) {
                next.queueDeclare(QUEUE, true, false, false, null);
            } else {
                // passive declare 不会误建外部系统拥有的队列。
                next.queueDeclarePassive(QUEUE);
            }

            DeliverCallback deliver = (consumerTag, delivery) -> {
                long tag = delivery.getEnvelope().getDeliveryTag();
                String body = new String(
                        delivery.getBody(),
                        StandardCharsets.UTF_8
                );
                System.out.printf(
                        "received tag=%s body=%s%n",
                        consumerTag,
                        body
                );
                // ACK 失败时让异常上抛,连接关闭后未确认消息会重新投递。
                next.basicAck(tag, false);
            };

            CancelCallback cancel = consumerTag -> {
                System.out.printf(
                        "consumer cancelled tag=%s; retry in %d ms%n",
                        consumerTag,
                        RETRY_MS
                );
                scheduleResubscribe();
            };

            String consumerTag =
                    next.basicConsume(QUEUE, false, deliver, cancel);

            Channel previous = consumerChannel;
            consumerChannel = next;
            if (previous != null && previous != next && previous.isOpen()) {
                previous.close();
            }

            System.out.printf(
                    "subscribed queue=%s tag=%s ownsQueue=%s%n",
                    QUEUE,
                    consumerTag,
                    OWNS_QUEUE
            );
        } catch (Exception error) {
            closeQuietly(next);
            throw error;
        }
    }

    private static void scheduleResubscribe() {
        if (STOPPING.get()
                || !RESUBSCRIBE_PENDING.compareAndSet(false, true)) {
            return;
        }

        CONTROL.schedule(() -> {
            try {
                subscribeNow();
                RESUBSCRIBE_PENDING.set(false);
            } catch (Exception error) {
                System.out.printf(
                        "resubscribe failed: %s; retry in %d ms%n",
                        error.getMessage(),
                        RETRY_MS
                );
                RESUBSCRIBE_PENDING.set(false);
                scheduleResubscribe();
            }
        }, RETRY_MS, TimeUnit.MILLISECONDS);
    }

    private static String env(String name, String fallback) {
        return System.getenv().getOrDefault(name, fallback);
    }

    private static void closeQuietly(Channel channel) {
        try {
            if (channel != null && channel.isOpen()) {
                channel.close();
            }
        } catch (Exception ignored) {
        }
    }

    private static void closeQuietly(Connection conn) {
        try {
            if (conn != null && conn.isOpen()) {
                conn.close();
            }
        } catch (Exception ignored) {
        }
    }
}
编译并启动:
mvn -q package dependency:copy-dependencies
AMQP_URI='amqp://guest:guest@localhost:5672/%2F' OWNS_QUEUE=true java -cp 'target/classes:target/dependency/*' RecoveringConsumer
预期输出:
subscribed queue=orders.events tag=<ID> ownsQueue=true<ID> 是 Broker 分配的 consumer tag。Windows 使用 ; 作为 classpath 分隔符,并用 PowerShell 环境变量语法设置参数。
验证恢复
在测试环境删除队列,可验证服务端 cancel、重新声明和重订阅。不要在生产队列上执行。
rabbitmqctl delete_queue orders.events预期消费者日志:
consumer cancelled tag=<ID>; retry in 5000 ms
subscribed queue=orders.events tag=<ID> ownsQueue=true
仅在本地容器中重启 Broker,可验证连接与拓扑自动恢复:
docker restart <CONTAINER>预期消费者日志:
connection recovery started
connection recovery complete
恢复完成后 consumer 由 topology recovery 自动恢复,因此代码不在 handleRecovery 中再次调用 basicConsume。
风险与边界
队列被删除后立即并发重订阅,可能创建多个 consumer、重复处理消息或触发通道数量增长。示例用单线程调度器和原子标记合并重试;生产环境还应给 consumer 设置稳定实例标识,并监控队列的 consumer 数量。
应用声明已存在队列时,durable、exclusive、auto-delete 和 arguments 任一不一致都会触发 PRECONDITION_FAILED 并关闭通道。应用不拥有队列时应使用 passive declare 等待,不要擅自用默认参数重建。
自动恢复期间发布不会由 Java 客户端代为缓存重放;恢复消费者并不等于恢复发布可靠性。生产者仍需 publisher confirms、不可路由处理和业务幂等。
排障与兼容性
- consumer cancel 后连接仍打开但没有消息时,确认 cancel callback 是否被执行,以及调度线程是否存活。
- 持续出现
NOT_FOUND时核对 vhost、队列名和队列归属;外部拥有的队列应等待其控制面恢复。 - 持续出现
PRECONDITION_FAILED时逐项比对队列声明参数,不要无限重试同一错误配置。 - Java Client 4.0.0 起自动连接恢复默认开启;示例仍显式启用,便于审计配置。旧客户端或其他语言客户端要分别确认是否支持 topology recovery 与 consumer cancel notification。