
机器学习与深度学习 / 知识点
机器学习算法速查手册
手册条目
选择最近邻算法样本规模较小且相似样本具有相似标签时使用 K 近邻算法。
选择最近邻算法
当数据量较小、特征距离能表达样本相似度,并且“附近样本通常同类”时,优先用 K 近邻(KNN)建立基线。它几乎不需要训练,但预测时要计算邻居,适合低到中等维度、可接受实时查询成本的分类或回归任务。
选择条件
适合样本规模较小、类别边界局部且不规则的任务,例如相似用户分类、简单图像特征分类和小型推荐候选判断。连续特征必须先缩放;类别特征需要先编码成有意义的数值,否则欧氏距离没有可比性。
不建议直接用于几十万以上样本、上千维稀疏特征或严格低延迟接口。维度升高后样本间距离趋于相近,邻居区分度会明显下降。
基本语法
下面使用标准化流水线训练 3 近邻分类器,weights="distance" 让更近的样本权重更高。
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X_train = [[0, 0], [0, 1], [1, 0], [5, 5], [5, 6], [6, 5]]
y_train = ["A", "A", "A", "B", "B", "B"]
X_test = [[0.8, 0.7], [5.2, 5.1]]

model = make_pipeline(
    StandardScaler(),
    KNeighborsClassifier(
        n_neighbors=3,
        weights="distance",
        metric="minkowski",
        p=2,
    ),
)
model.fit(X_train, y_train)

print(model.predict(X_test).tolist())
print(model.named_steps["kneighborsclassifier"].classes_.tolist())
print(model.predict_proba(X_test).round(3).tolist())
预期输出:
['A', 'B']
['A', 'B']
[[1.0, 0.0], [0.0, 1.0]]
第一行是预测标签;第二行给出概率列的类别顺序;第三行每一组概率都按该顺序读取。实际数据存在混合邻居时,概率通常不会是 0 或 1。
常用参数
n_neighbors:邻居数量。小值更贴合局部边界但容易受噪声影响,大值更平滑但可能忽略少数类。通常从 3、5、7 等奇数开始交叉验证。weights:uniform表示邻居等权,distance表示距离越近权重越高;边界复杂或邻居距离差异明显时优先测试后者。metric与p:p=2是欧氏距离,p=1是曼哈顿距离。高维稀疏文本通常不应直接使用默认欧氏距离。algorithm:一般保持auto。树结构在高维下未必更快,应以实际预测耗时为准。
风险与边界
未标准化时,量纲大的特征会主导距离,导致模型看似可运行但分类依据错误;安全做法是把缩放器与 KNN 放入同一 Pipeline,避免训练集和线上处理不一致。
样本量增大时,预测延迟和内存占用会同步上升。若线上延迟超标,可改用逻辑回归、树模型,或在允许近似结果时使用专门的近似最近邻索引。类别严重不平衡时还要检查召回率,不能只看准确率。
速查提示:先标准化,再用交叉验证选择 n_neighbors;同时记录验证指标和单次预测耗时。
选择朴素贝叶斯在文本分类和高维稀疏特征场景中快速建立概率分类模型。
选择朴素贝叶斯
当特征是词频、计数或高维稀疏向量,并且需要快速训练一个概率分类基线时,优先考虑朴素贝叶斯。它在垃圾邮件、主题分类、工单路由和情感倾向等文本任务中通常成本低、收敛快。
选择条件
文本词袋或 TF-IDF 特征常用 MultinomialNB;二值词项、是否出现某特征可用 BernoulliNB;近似连续正态分布的数值特征可用 GaussianNB。模型假设给定类别后各特征相互独立,这一假设通常不完全成立,但在高维稀疏分类中仍常能得到可靠基线。
如果任务高度依赖词序、上下文或特征之间的组合关系,朴素贝叶斯通常上限有限,应改用线性模型、树模型或文本表示模型。
基本语法
下面用空格分词后的中文短文本训练多项式朴素贝叶斯。真实项目可把分词器替换为现有中文分词流程。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.pipeline import make_pipeline

docs = [
    "免费 领取 优惠券",
    "限时 特价 立即 购买",
    "项目 会议 时间",
    "请 审核 合同",
]
labels = ["spam", "spam", "normal", "normal"]
test_docs = ["请 审核 项目 合同", "限时 免费 优惠"]

model = make_pipeline(
    CountVectorizer(token_pattern=r"(?u)\b\w+\b"),
    MultinomialNB(alpha=1.0),
)
model.fit(docs, labels)

print(model.predict(test_docs).tolist())
print(model.named_steps["multinomialnb"].classes_.tolist())
print(model.predict_proba(test_docs).round(3).tolist())
预期输出:
['normal', 'spam']
['normal', 'spam']
[[0.952, 0.048], [0.217, 0.783]]
概率列按第二行的类别顺序读取。例如第一条文本属于 normal 的估计概率为 0.952。样本和词表变化后概率会随之变化,不能把示例数值当作固定阈值。
常用参数
alpha:拉普拉斯平滑强度。1.0是常用起点;值过小会让未见词造成极端概率,值过大则会抹平类别差异。fit_prior:是否学习类别先验。训练集能反映真实分布时保持True;若采样比例被人为改变,应显式评估或设置class_prior。CountVectorizer:适合词频计数;TfidfVectorizer也可与MultinomialNB配合,但必须通过验证集确认是否改善。- 特征类型:
MultinomialNB要求非负特征,标准化后出现负值的矩阵不能直接输入。
高频用法
先用词袋加 MultinomialNB 建立文本基线,再与逻辑回归比较宏平均 F1。数据持续新增时,可使用支持 partial_fit 的朴素贝叶斯实现增量训练,但首次调用必须提供完整类别集合。
需要解释预测时,可查看每个类别下词项的对数概率,定位哪些词把结果推向某一类别;不要把概率值直接解释为严格校准后的真实发生概率。
风险与边界
训练集类别比例失真会改变先验,造成线上预测整体偏向某类;安全做法是按生产分布抽样、检查混淆矩阵,并在独立验证集上确定阈值。
分词、停用词和词表版本不一致会让线上特征错位,后果是预测质量骤降而程序不一定报错。应把向量器和分类器封装在同一 Pipeline 后整体保存,部署时禁止单独重建词表。
速查提示:高维稀疏文本先试 MultinomialNB,重点核对非负特征、类别先验、分词一致性和宏平均 F1。
数据量充足且传统模型难以拟合复杂非线性关系时使用多层感知机。
选择多层感知机
当线性模型、树模型经过合理调参后仍无法拟合明显的特征交互和复杂非线性关系,并且有足够的标注数据、计算预算与验证集时,可考虑多层感知机。它不是默认首选:小样本、强可解释性或低延迟场景通常先用逻辑回归、梯度提升树等基线。
选择判断
适合选择:
- 数值特征较多,目标与特征之间存在复杂非线性关系。
- 数据量足以支撑额外参数,且能留出独立验证集监控过拟合。
- 可以统一完成缺失值处理、类别编码和特征缩放。
- 传统模型性能已进入平台期,继续手工构造交叉特征成本较高。
暂不选择:
- 样本很少、标签噪声高,训练分数明显高于验证分数。
- 需要直接解释每个特征对预测的贡献。
- 线上资源紧张,无法接受多层矩阵计算带来的额外延迟。
结构速查
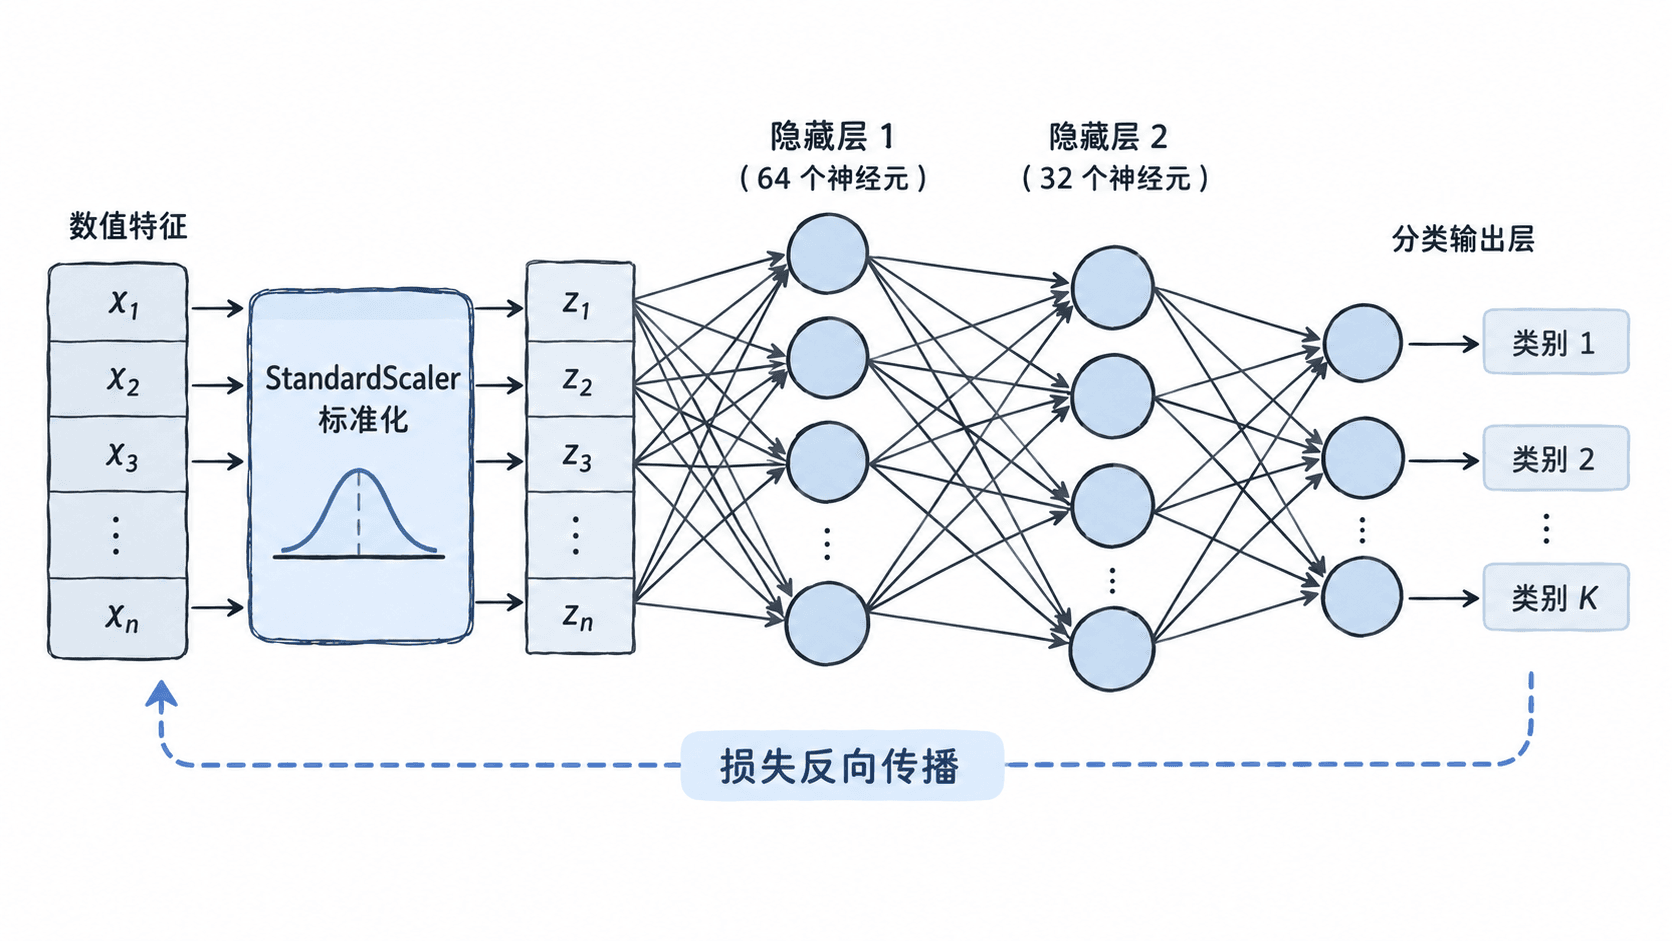
hidden_layer_sizes=(64, 32) 表示两个隐藏层,分别有 64 和 32 个神经元。输入特征先标准化,再依次经过隐藏层和输出层;分类任务由输出层产生类别分数或概率。
基本用法
下面用异或数据验证 MLP 能拟合线性模型无法直接分开的非线性边界。Pipeline 保证训练和预测使用同一套标准化规则。
import numpy as np
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X = np.array([
    [0, 0],
    [0, 1],
    [1, 0],
    [1, 1],
], dtype=float)
y = np.array([0, 1, 1, 0])

model = make_pipeline(
    StandardScaler(),
    MLPClassifier(
        hidden_layer_sizes=(4,),
        activation='tanh',
        solver='lbfgs',
        alpha=1e-5,
        max_iter=5000,
        random_state=0,
    ),
)

model.fit(X, y)
print(model.predict(X).tolist())
print(f'{model.score(X, y):.3f}')
预期输出
[0, 1, 1, 0]
1.000
第一行表示四个样本均预测正确;第二行是训练集准确率。该微型示例只验证非线性拟合能力,不能代表真实业务泛化效果。
关键参数
hidden_layer_sizes:控制隐藏层数量和宽度。层数或神经元过多会增加训练时间和过拟合风险。activation:常用relu;小型、平滑数据可尝试tanh。solver:小数据可测试lbfgs,较大数据通常使用adam。alpha:L2 正则强度;验证集过拟合时可适当增大。early_stopping=True:从训练数据中划出验证部分并提前停止,适合迭代训练场景。max_iter:最大迭代次数,不应把单纯增大它当作所有收敛问题的解决方案。
MLPClassifier 会迭代优化分类损失,并提供 loss_curve_、n_iter_ 等训练状态;scikit-learn 的该实现不提供 GPU 训练。:contentReference[oaicite:0]{index=0}
风险与排障
- 未缩放特征:当不同列量纲差异很大时,优化可能震荡、收敛缓慢或触发
ConvergenceWarning。后果是结果不稳定;安全替代是把StandardScaler放入Pipeline。 - 训练集很好、验证集下降:模型容量过大或样本不足,线上误差会放大。优先减小网络、增大
alpha、启用提前停止,而不是继续加层。 - 损失不下降:可能由学习率、异常值、标签错误或输入含非有限值触发。先检查数据和缩放,再调整
learning_rate_init或更换求解器。 - 训练耗时过长:隐藏层过宽、样本过多或迭代上限过高会增加成本。先用小网络建立基线,并记录验证分数、训练时长和推理延迟。
速查提示:只有在独立验证集上稳定超过简单基线,并满足线上延迟预算时,才把 MLP 纳入候选。
将多个差异化模型的预测结果通过硬投票或软投票进行组合。
选择投票集成
当已有多个性能接近但错误模式不同的分类模型时,可用投票集成降低单模型波动。关键不是模型数量,而是差异性:若所有模型结构、特征和训练数据几乎相同,它们往往会同时犯错,组合收益有限。
选择判断
适合选择:
- 已有 2~4 个可独立训练和验证的候选模型。
- 各模型在不同类别、不同样本区间上各有优势。
- 希望以较低改造成本提升稳定性,不准备训练复杂的二层模型。
- 可以接受预测时同时调用全部子模型的延迟和资源消耗。
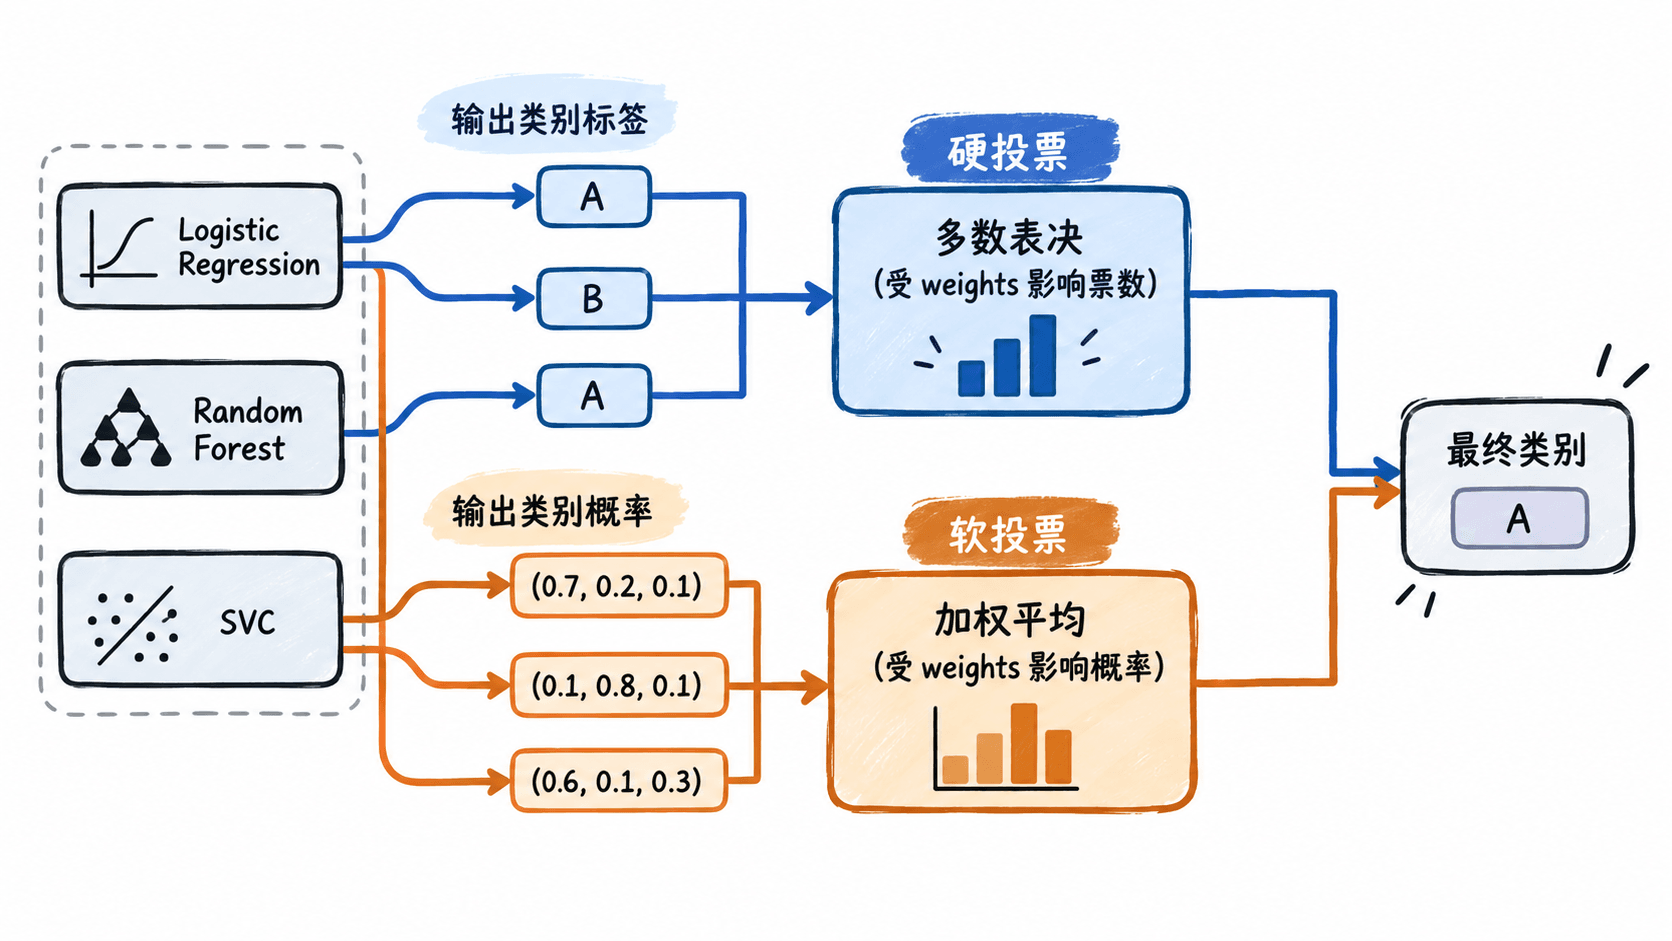
hard 直接统计类别标签,适合子模型没有可靠概率输出的情况;soft 对类别概率加权平均,通常用于概率已经校准的模型。
聚合流程
基本用法
下面组合逻辑回归、随机森林和支持向量机。软投票要求每个子模型支持 predict_proba,因此 SVC 需要启用 probability=True。
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier, VotingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.3,
    stratify=y,
    random_state=42,
)

model = VotingClassifier(
    estimators=[
        ('lr', LogisticRegression(max_iter=1000)),
        ('rf', RandomForestClassifier(
            n_estimators=200,
            random_state=42,
        )),
        ('svc', SVC(
            probability=True,
            random_state=42,
        )),
    ],
    voting='soft',
    weights=[2, 1, 2],
)

model.fit(X_train, y_train)
pred = model.predict(X_test)

print(f'accuracy={accuracy_score(y_test, pred):.3f}')
print(pred[:5].tolist())
预期输出
accuracy=0.956
[2, 1, 2, 1, 2]
accuracy 是测试集准确率;第二行是前五个样本的最终类别。相同数据切分和依赖版本下结果可复现,底层数值库差异可能造成末位小数变化。
关键参数与读取
estimators:由(名称, 模型)元组组成。名称用于调参和读取已训练子模型。voting='hard':按类别票数决定结果;weights放大指定模型的票数。voting='soft':按加权平均概率决定结果;所有有效子模型必须提供predict_proba。weights:长度必须与子模型数量一致。权重应来自交叉验证,而不是测试集表现。n_jobs=-1:可并行训练支持并行的子任务,但会占用更多 CPU 和内存。named_estimators_:训练后可通过model.named_estimators_['rf']读取具体子模型。
VotingClassifier 会克隆并训练传入的未拟合模型;软投票按加权类别概率聚合,官方建议用于概率校准较好的分类器。:contentReference[oaicite:1]{index=1}
高频用法
比较硬投票与软投票时,保持相同的数据切分和子模型,只替换 voting。若某个模型明显拖累整体,可使用 set_params(模型名='drop') 暂时移除,再重新训练验证。
权重不要直接按训练准确率分配。更可靠的做法是记录交叉验证均值、方差和类别级指标,再对稳定且互补的模型给予较高权重。
风险与排障
- 模型高度同质:相同特征和相近算法会产生相关错误,集成后几乎不提升。安全替代是增加不同模型族、不同特征视角,并检查预测分歧率。
- 概率未校准:软投票中,过度自信的模型会压制其他模型,导致错误更集中。先用独立验证数据校准概率,或改用硬投票。
- 权重泄漏:根据测试集反复调权重会高估效果,线上性能可能回落。权重必须在训练集内部通过交叉验证确定,测试集只做最终评估。
- 推理延迟增加:每次预测都要执行全部子模型,慢模型会成为尾延迟瓶颈。上线前分别测量子模型和整体耗时,必要时删除收益小但成本高的模型。
- 类别顺序或预处理不一致:各模型使用不同编码、缩放或特征列时可能直接报错或产生错误结果。把预处理封装进每个模型自己的
Pipeline。
速查提示:先验证“子模型有差异且组合后交叉验证更稳”,再决定使用硬投票、软投票和权重。
使用元模型学习多个基础模型的互补预测结果以提升整体性能。
选择堆叠集成
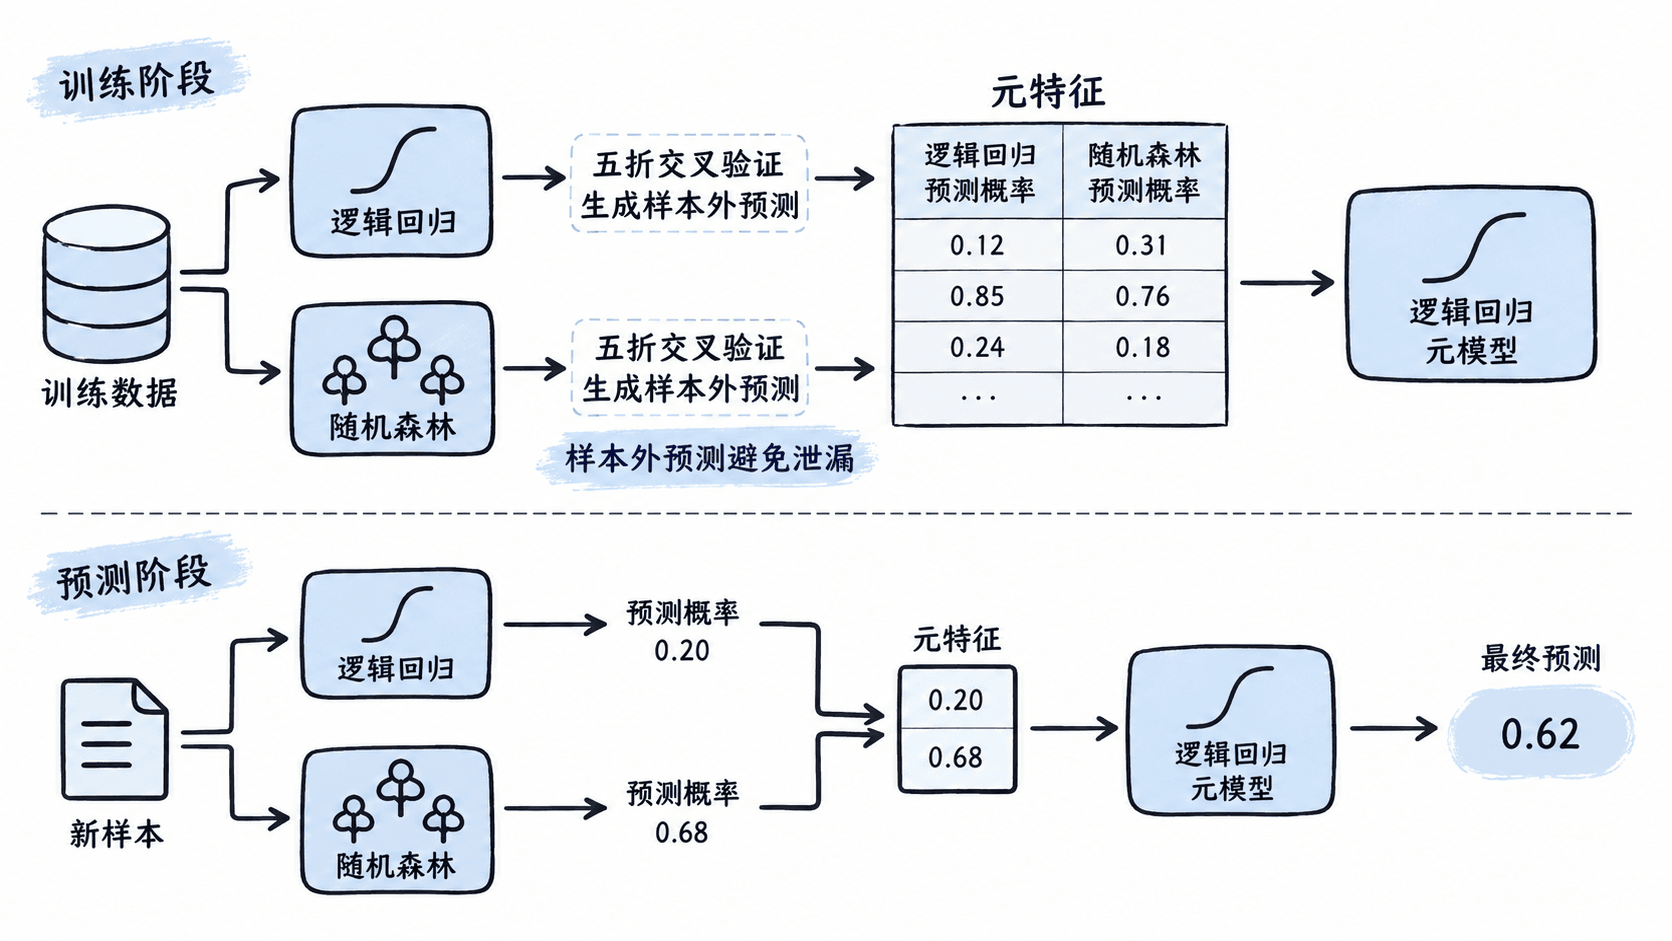
当两个以上模型各有所长、单模型指标已接近瓶颈时,用堆叠集成把基础模型的预测作为新特征,再由元模型学习如何组合。最终产物是一个统一预测器,但训练成本、推理延迟和过拟合风险都会增加。
何时选择
优先在以下条件同时满足时使用:基础模型类型有差异,例如线性模型与树模型;各模型在同一验证集上的错误并不完全重合;训练样本足以支持交叉验证;线上延迟允许执行多个模型。
基础模型如果只是同一种算法的轻微参数变化,通常只会增加计算量。先比较预测相关性或错误重合率,再决定是否堆叠。
基本用法
下面以乳腺癌二分类数据为例。StackingClassifier 会用五折交叉验证生成基础模型的样本外概率,元模型不会直接看到基础模型对自身训练样本的拟合结果。
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier, StackingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

# 线性模型负责捕捉全局趋势,树模型负责非线性与特征交互。
estimators = [
    (
        "lr",
        make_pipeline(
            StandardScaler(),
            LogisticRegression(max_iter=2000, random_state=42),
        ),
    ),
    (
        "rf",
        RandomForestClassifier(
            n_estimators=200,
            min_samples_leaf=2,
            random_state=42,
            n_jobs=-1,
        ),
    ),
]

# 元模型保持简单并使用正则化,降低第二层过拟合概率。
model = StackingClassifier(
    estimators=estimators,
    final_estimator=LogisticRegression(max_iter=1000, random_state=42),
    cv=5,
    stack_method="predict_proba",
    passthrough=False,
    n_jobs=-1,
)

model.fit(X_train, y_train)
proba = model.predict_proba(X_test)[:, 1]
pred = (proba >= 0.5).astype(int)

print(f"accuracy={accuracy_score(y_test, pred):.3f}")
print(f"roc_auc={roc_auc_score(y_test, proba):.3f}")
print(model.transform(X_test[:3]).round(3))
预期输出:
accuracy=0.979
roc_auc=0.998
[[0.969 0.988]
 [0.    0.   ]
 [0.559 0.654]]
最后三行每列对应一个基础模型输出的正类概率;元模型正是基于这些元特征完成最终判断。不同库版本或硬件上的末位小数可能略有差异。
关键参数
estimators:基础模型列表。优先选择归纳偏置不同的模型,而不是堆叠大量相似模型。final_estimator:元模型。分类任务常先用带正则化的逻辑回归,只有数据量充足时再尝试复杂模型。cv:生成样本外预测的折数。折数越高,训练越慢;类别不平衡时必须保持分层抽样。stack_method:基础模型提供给元模型的输出。分类常用predict_proba,没有概率接口时可用decision_function或predict。passthrough:为True时,元模型同时接收原始特征与预测特征,表达力更强,但维度和过拟合风险也更高。n_jobs:并行训练基础模型。生产环境应给进程预留 CPU,避免与在线服务争抢资源。
风险与边界
训练元模型时若直接使用基础模型在训练集上的拟合概率,会发生数据泄漏,离线指标虚高而线上失效。安全做法是使用交叉验证生成样本外预测,或直接使用支持该流程的堆叠实现。
样本较少且元模型复杂时,第二层容易记住噪声。应先用简单元模型,并通过独立测试集或嵌套交叉验证评估;不能只比较训练集或同一交叉验证折上的成绩。
多个基础模型会线性增加推理耗时和内存占用。若堆叠收益很小,应改用加权平均、软投票,或只保留贡献最大的模型。
排障清单
- 堆叠结果低于最佳基础模型:确认所有模型使用相同数据切分和指标,再检查基础模型是否缺乏互补性。
- 交叉验证很好、独立测试集下降明显:检查预处理是否在全量数据上提前拟合,流水线应把缩放、编码和模型封装在同一折内。
- 训练时间异常增长:减少基础模型数量、降低
cv、限制树数量,并确认并行线程没有层层嵌套。 - 线上概率分布突变:分别记录基础模型概率与元模型输出,定位是单个基础模型漂移还是组合规则失效。
速查判断:只有“模型互补带来的增益”明显高于新增的训练、部署和推理成本时,才值得选择堆叠集成。
已知大致分组数量且簇近似球形时使用 K 均值完成样本分群。
选择 K 均值聚类
当样本主要是数值特征、预计存在固定数量的紧凑分组,并且各簇大小与密度差异不大时,使用 K 均值可快速得到每个样本的簇标签和簇中心。
适用判断
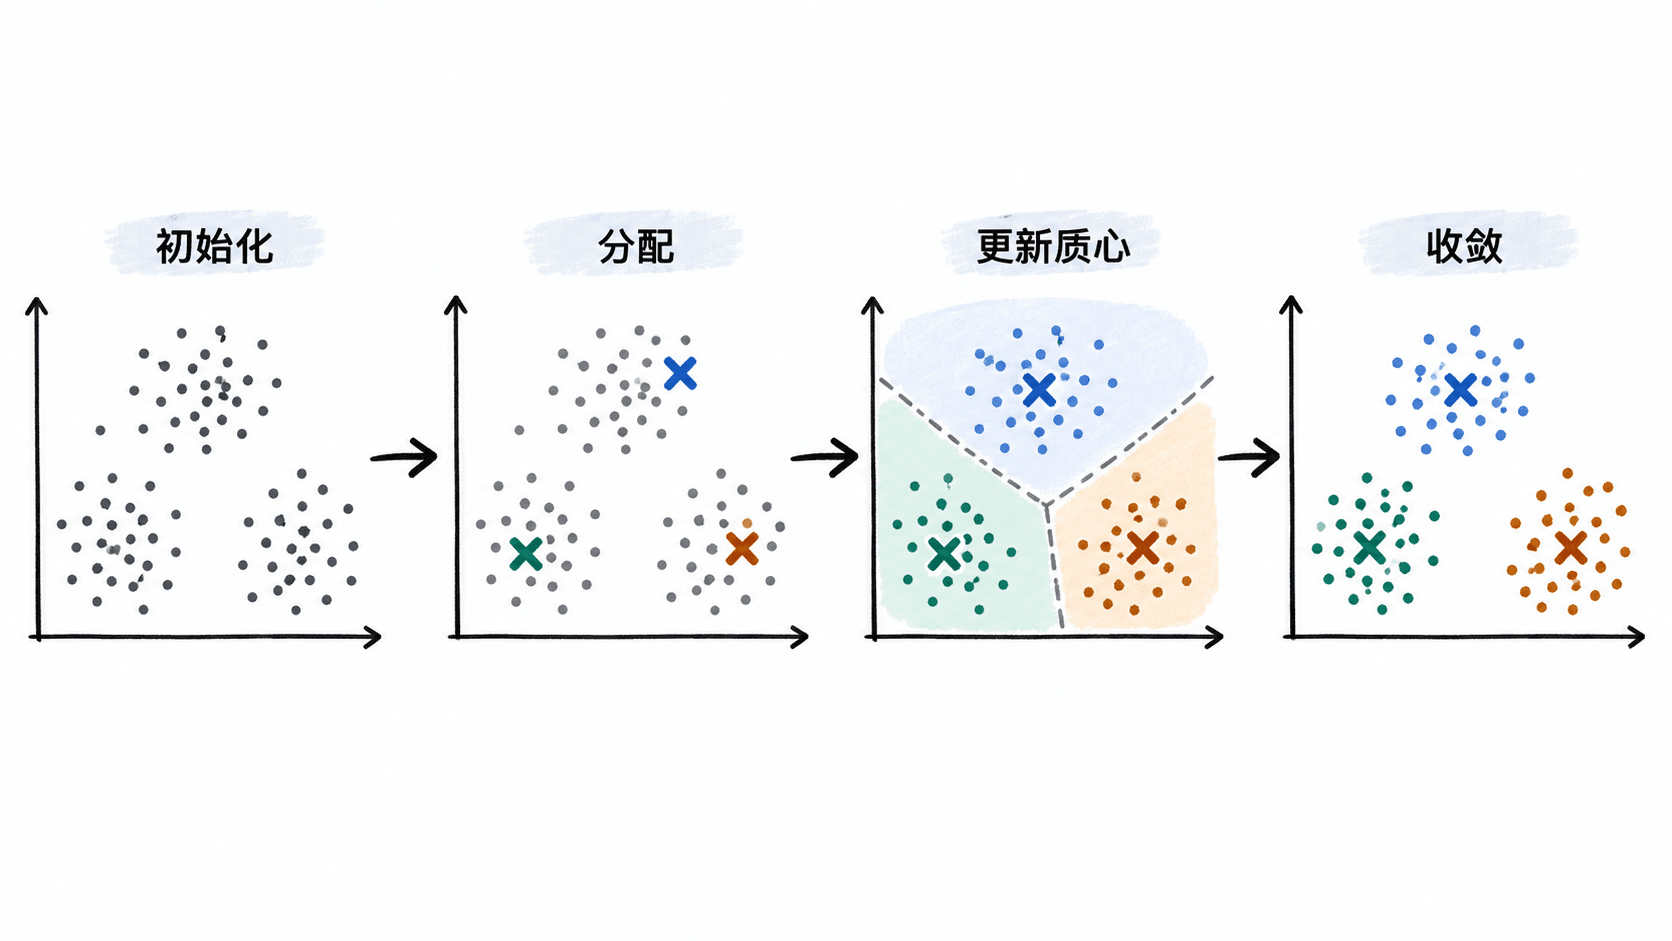
K 均值通过反复执行“分配到最近中心”和“重新计算中心”收敛。它更适合近似球形、凸形且尺度相近的簇;对弯月形簇、离群点很多的数据或纯类别特征不合适。
特征量纲会直接影响欧氏距离。金额、次数、时长等不同尺度特征应先标准化,并在训练和预测阶段复用同一个缩放器。
基本用法
下面生成三个可分簇的数据区域,标准化后训练 K 均值,并同时查看簇内平方和、轮廓系数、簇大小和中心坐标。
import numpy as np
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs
from sklearn.metrics import silhouette_score
from sklearn.preprocessing import StandardScaler

X, _ = make_blobs(
    n_samples=300,
    centers=[(-5, -2), (0, 4), (5, -1)],
    cluster_std=[0.8, 1.0, 0.9],
    random_state=42,
)

# 距离算法对量纲敏感,缩放器必须与模型一起保存并复用。
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 显式执行多次初始化,减少落入较差局部最优解的概率。
model = KMeans(
    n_clusters=3,
    n_init=10,
    random_state=42,
)
labels = model.fit_predict(X_scaled)

print(f"inertia={model.inertia_:.3f}")
print(f"silhouette={silhouette_score(X_scaled, labels):.3f}")
print("cluster_sizes=", np.bincount(labels).tolist())
print("centers=")
print(np.round(model.cluster_centers_, 3))
预期输出:
inertia=42.228
silhouette=0.787
cluster_sizes= [100, 100, 100]
centers=
[[ 0.031  1.333]
 [-1.212 -0.82 ]
 [ 1.181 -0.513]]
inertia 越小表示样本到各自中心的平方距离总和越小,但它会随簇数增加而自然下降,不能单独用来选 K。silhouette 越接近 1,簇内越紧凑且簇间越分离。簇编号只是内部索引,没有天然的大小、优先级或业务语义。
常用参数
n_clusters:目标簇数 K。应结合肘部法、轮廓系数、重复抽样稳定性和业务可解释性决定。init:质心初始化方式,通常保留k-means++,可降低差初始化概率。n_init:使用不同初始质心重复训练的次数,最终保留惯性最小的结果;建议显式设置,避免不同环境默认值差异。max_iter:单次初始化允许的最大迭代次数。频繁达到上限时,应检查特征尺度、离群点或收敛阈值。tol:质心变化小于该阈值时停止。过大可能提前结束,过小会增加计算量。random_state:固定初始化随机性,便于复现实验和回归测试。
高频用法
- 客户或商品分群:先把行为指标标准化,再训练模型;完成后根据各簇中心反向解释业务特征。
- 新样本归类:必须先调用训练阶段保存的
scaler.transform,再调用model.predict,不能重新拟合缩放器。 - 选择 K:在同一份预处理数据上比较多个 K,综合查看惯性拐点、轮廓系数和多次运行的标签稳定性。
- 生产监控:持续观察各簇样本占比、到中心的距离和中心漂移,防止数据分布变化后标签仍被机械使用。
风险与边界
未标准化时,大数值量纲会主导距离,导致簇只反映某一列的大小。安全做法是使用 StandardScaler;离群点明显时先清洗,或改用稳健缩放与更抗异常值的聚类方法。
离群点会拉动均值中心,造成边界偏移甚至产生孤立小簇。应先检查距离分布并处理异常样本;需要按真实密度识别噪声时,可考虑 DBSCAN 等方法。
真实簇若为弯曲、环状或密度差异很大,K 均值会强行切成近似球形区域。此时应改用密度聚类、谱聚类或高斯混合模型,而不是不断增大 K。
K 选择错误会产生看似整齐但不可解释的分组。不要只追求某个指标最优,还要检查簇大小是否合理、中心是否稳定以及分组能否支持后续动作。
排障清单
- 一个簇占据绝大多数样本:检查是否忘记标准化、K 是否过小,或数据本身是否只有一个高密度区域。
- 多次运行标签变化很大:增大
n_init、固定random_state,并评估不同抽样下的中心稳定性。 - 轮廓系数很低:检查簇形状是否不适合欧氏距离,尝试降维可视化或替换算法。
- 线上新样本距离中心持续变大:数据可能漂移,应重新评估特征分布、缩放参数和聚类中心。
速查判断:能合理回答“K 大致是多少、距离是否有意义、簇是否近似紧凑球形”时,再选择 K 均值。
需要观察样本逐层合并关系或生成聚类树时使用层次聚类。
选择层次聚类
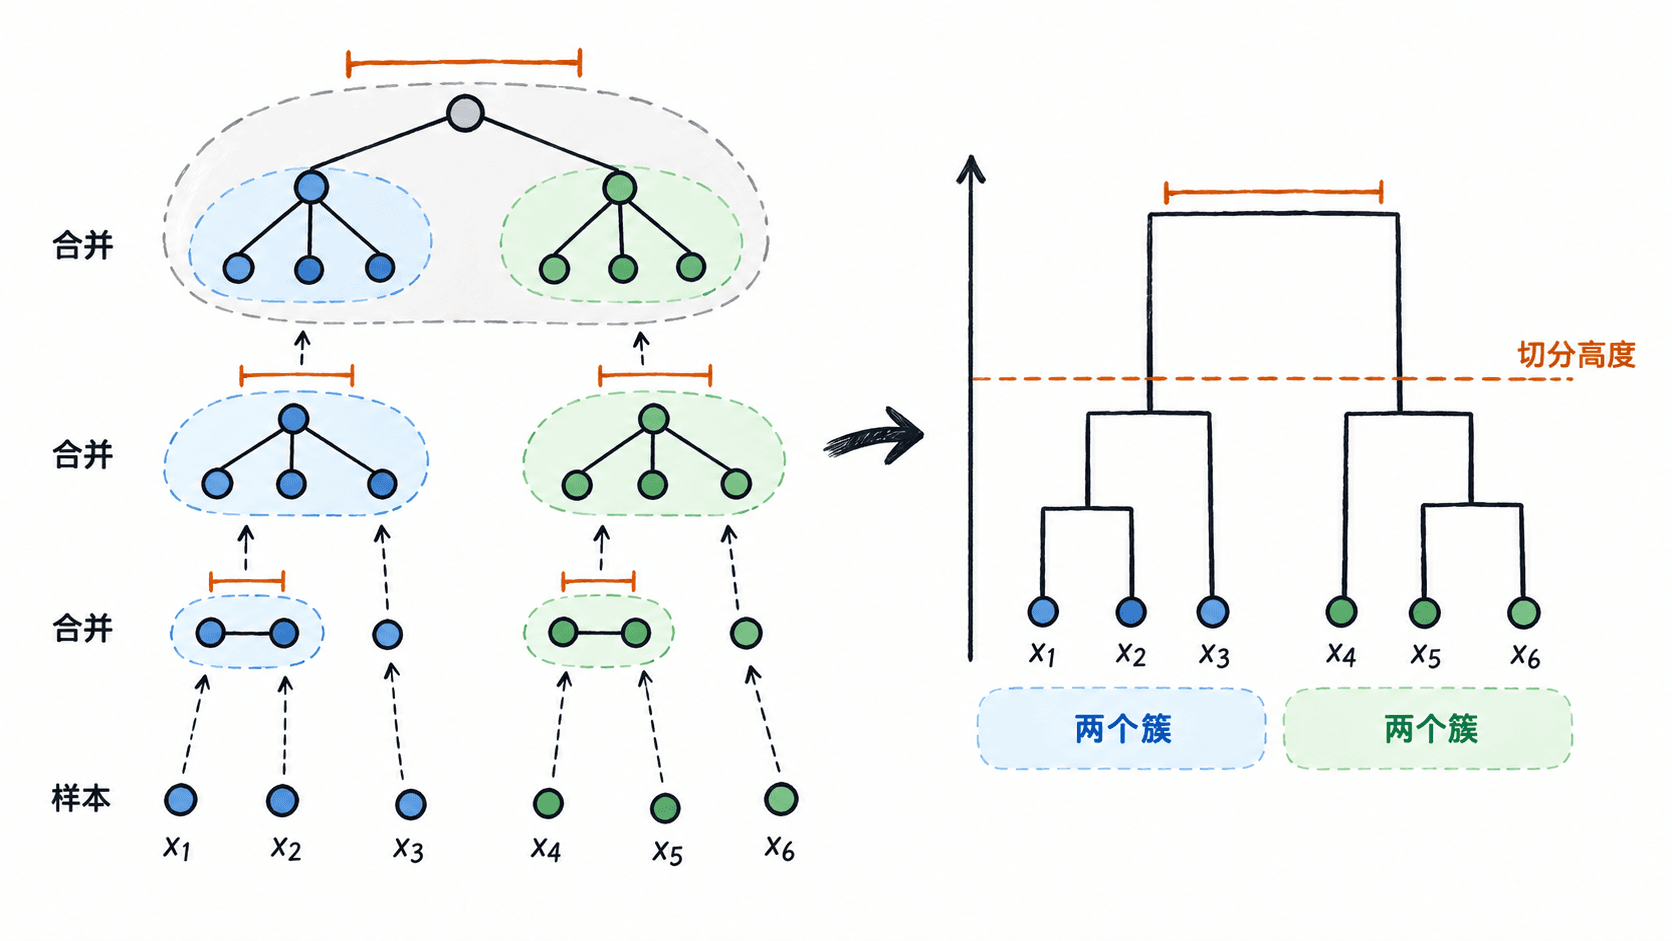
当你需要查看样本如何逐层合并、比较不同切分高度,或希望得到可解释的聚类树时,优先考虑层次聚类。它适合中小规模数据;只想快速处理百万级样本时,通常应换用 BIRCH、MiniBatchKMeans 或先抽样。
什么时候选
适合以下情况:簇数暂时不确定,需要从聚类树上选择;样本之间存在天然层级;需要解释“哪些样本先合并、合并距离多大”。若簇明显为任意形状并夹杂大量噪声,密度聚类通常更合适。
基本语法
下面使用 Ward 凝聚聚类把 6 个点切成 2 簇,并输出合并顺序与每次合并距离。示例要求已安装 numpy 和 scikit-learn。
import numpy as np
from sklearn.cluster import AgglomerativeClustering

X = np.array(
    [[0, 0], [0, 1], [1, 0], [8, 8], [8, 9], [9, 8]],
    dtype=float,
)

model = AgglomerativeClustering(
    n_clusters=2,
    linkage="ward",
    compute_distances=True,
)
labels = model.fit_predict(X)

print("labels:", labels.tolist())
print("children:", model.children_.tolist())
print("distances:", np.round(model.distances_, 3).tolist())
预期输出
labels: [1, 1, 1, 0, 0, 0]
children: [[0, 1], [3, 4], [2, 6], [5, 7], [8, 9]]
distances: [1.0, 1.0, 1.291, 1.291, 19.596]
labels 表示最终簇编号,编号本身没有大小含义。children 的每一行是一次合并;编号小于样本数时指原始样本,编号不小于样本数时指此前生成的新节点。最后一个距离显著增大,说明两大簇之间存在清晰间隔。
关键参数
n_clusters:最终簇数。已经知道业务需要几组时直接设置。distance_threshold:按合并距离停止;使用时应设置n_clusters=None,适合从距离阈值控制切分。linkage:ward偏向紧凑、方差较小的簇;complete抑制链式连接;average较折中;single能连接细长簇,但容易被噪声串联。metric:距离度量。ward只能配欧氏距离;文本、二值或预计算距离需改用其他 linkage。connectivity:限制只在邻接样本间合并,适合网格、图或空间邻域数据,也可降低无意义的远距离合并。
风险与边界
特征量纲差异会主导距离,导致聚类树失真;应先标准化连续特征,并单独处理类别特征。样本量较大时,距离计算和完整树会消耗大量内存;安全做法是先抽样验证结构,再使用 BIRCH、近邻约束或分批算法。
层次聚类对异常点和 linkage 很敏感。同一数据在 single 与 ward 下可能得到完全不同结果,因此不要只看最终标签,应同时检查树状图、合并距离和业务可解释性。
排障清单
- 报错提示 Ward 不支持当前距离:改为欧氏距离,或把
linkage改为average、complete、single。 - 几乎所有点过早合并:检查是否未标准化、存在大尺度特征,或阈值设置过高。
- 想画树却没有合并距离:启用
compute_distances=True;需要完整树时确认未用固定簇数提前截断。 - 旧代码使用
affinity:新版本应改用metric;维护跨版本项目时锁定 scikit-learn 版本并运行回归测试。
速查:要“看层级、选切分、解释合并过程”选层次聚类;只要一个固定簇数且数据很大,不要优先选它。
簇形状不规则且数据包含噪声点时使用基于密度的聚类算法。
选择密度聚类
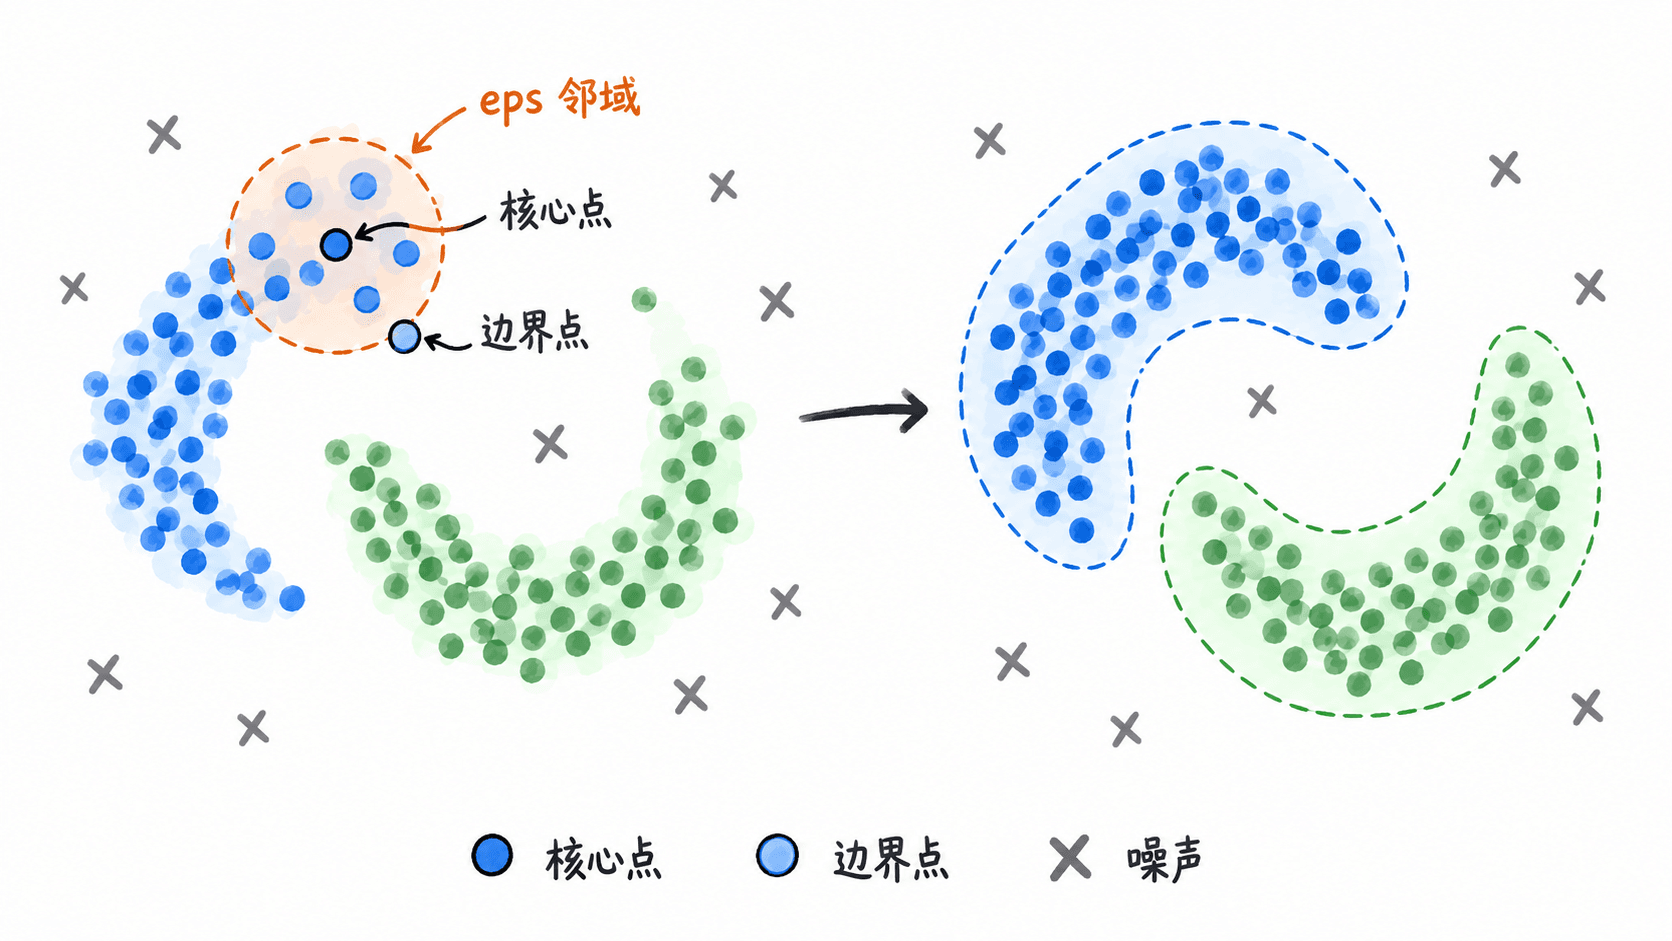
当簇形状不规则、簇数未知,并且数据中存在离群点时,优先考虑密度聚类。它通过局部邻域密度扩展簇,能把无法归入任何高密度区域的样本标为噪声。
什么时候选
DBSCAN 适合密度相近、噪声明显的数据;OPTICS 更适合密度变化较大的数据,并可观察不同距离尺度下的簇结构;HDBSCAN 通常更擅长多密度簇,但需确认当前运行环境是否提供对应实现。
基本语法
下面的 7 个点中,前 3 个形成一簇,中间 3 个形成另一簇,最后一个点被识别为噪声。示例要求已安装 numpy 和 scikit-learn。
import numpy as np
from sklearn.cluster import DBSCAN

X = np.array(
    [[0, 0], [0, 0.1], [0.1, 0],
     [5, 5], [5, 5.1], [5.1, 5],
     [10, 10]],
    dtype=float,
)

model = DBSCAN(eps=0.25, min_samples=2)
labels = model.fit_predict(X)

print("labels:", labels.tolist())
print("core_samples:", model.core_sample_indices_.tolist())
预期输出
labels: [0, 0, 0, 1, 1, 1, -1]
core_samples: [0, 1, 2, 3, 4, 5]
标签 0、1 代表两个簇,编号没有业务顺序;-1 固定表示噪声。core_sample_indices_ 给出核心样本在输入数组中的索引,边界点可能属于某个簇,但不会出现在该数组中。
关键参数
eps:邻域半径,是最敏感的参数。过小会让大量样本变成-1,过大会把多个簇连成一簇。min_samples:成为核心点所需的邻域样本数,包含样本自身。值越大,判定越保守,噪声通常越多。metric:距离函数。默认欧氏距离;文本、地理坐标或稀疏向量应选择与数据含义匹配的距离。n_jobs:邻域搜索可并行时使用;是否提速取决于距离算法和数据规模。
生产中先对连续特征标准化,再用第 min_samples 个近邻距离的排序曲线寻找 eps 候选拐点。不要直接复制其他数据集的 eps,因为量纲、维度和采样密度都会改变有效半径。
风险与边界
DBSCAN 使用一个全局 eps,面对“一个簇很密、另一个簇很稀”的数据时,常出现密簇正常而稀簇被判为噪声,或稀簇正常但密簇与邻簇粘连。安全替代方案是使用 OPTICS、HDBSCAN,或先按业务区域分层后分别调参。
高维数据中距离差异会收缩,邻域密度不再稳定;应先做特征选择、降维或改用更合适的度量。eps 过大时邻域矩阵可能急剧膨胀并耗尽内存;先在抽样数据上评估邻居数量,再逐步扩大参数。
排障清单
- 全部是
-1:确认已标准化,逐步增大eps,或降低min_samples。 - 只得到一个大簇:减小
eps,检查是否存在桥接点;必要时改用 OPTICS 或 HDBSCAN。 - 结果每次看似不同:DBSCAN 本身通常是确定性的,但边界点在重复样本或等距邻居下可能受输入顺序影响,应固定数据排序并检查重复点。
- 运行很慢或内存过高:减少维度、限制样本量、选择可索引的距离度量,并避免一次把
eps调得过大。
速查:要“不规则簇、自动识别噪声、不预设簇数”选密度聚类;密度差异明显时不要只依赖单一 DBSCAN 参数。
选择高斯混合模型需要输出样本归属概率并允许多个分布重叠时使用高斯混合模型。
选择高斯混合模型
当同一片特征空间可能由多个相互重叠的概率分布生成,并且需要输出每个样本属于各分量的概率时,选择高斯混合模型(GMM)。它适合软聚类、概率密度估计和低概率样本筛查,不要求样本只能归入一个簇。
什么时候选
优先选择 GMM 的典型条件:
- 需要
predict_proba()返回分量归属概率,而不是只有硬标签。 - 簇之间可能重叠,且单个簇可近似为椭圆形高斯分布。
- 希望通过 AIC、BIC 或验证集对数似然比较分量数。
- 需要用
score_samples()得到每个样本的对数似然。
仅需要球形、边界清晰的硬聚类时,K-Means 通常更简单;簇形状明显非高斯或存在复杂流形时,应考虑 DBSCAN、谱聚类等方法。
基本语法与参数
from sklearn.mixture import GaussianMixture

model = GaussianMixture(
    n_components=3,
    covariance_type="full",
    n_init=10,
    reg_covar=1e-6,
    random_state=42,
)
model.fit(X)
probabilities = model.predict_proba(X)
关键参数:
n_components:混合分量数。过小会合并不同分布,过大会把噪声拆成额外分量。covariance_type:full最灵活但参数最多;diag更适合高维或样本较少的场景;tied让所有分量共享协方差;spherical约束最强。n_init:使用多组初始化并保留最佳结果,可降低局部最优风险。reg_covar:给协方差对角线增加正则项,协方差奇异或训练报错时可适当调大。max_iter、tol:控制 EM 迭代上限与收敛阈值。官方 API 同时提供weights_、means_、covariances_、converged_等训练结果。:contentReference[oaicite:0]{index=0}
高频用法
下面示例构造两个重叠程度较低的一维分布,训练后输出分量中心、权重和新样本的软归属概率。排序步骤用于消除“分量编号可交换”导致的展示差异。
import numpy as np
from sklearn.mixture import GaussianMixture

X = np.array([[-2.2], [-2.0], [-1.8], [1.8], [2.0], [2.2]])

model = GaussianMixture(
    n_components=2,
    covariance_type="full",
    n_init=10,
    random_state=42,
)
model.fit(X)

new_samples = np.array([[0.0], [1.9]])
probabilities = model.predict_proba(new_samples)

# 按均值从小到大重排,避免分量编号交换影响输出阅读。
order = np.argsort(model.means_.ravel())
means = model.means_.ravel()[order]
weights = model.weights_[order]
probabilities = probabilities[:, order]

print("means:", np.round(means, 3))
print("weights:", np.round(weights, 3))
print("probabilities:")
print(np.round(probabilities, 3))
print("converged:", model.converged_)
预期输出:
means: [-2.  2.]
weights: [0.5 0.5]
probabilities:
[[0.5 0.5]
 [0.  1. ]]
converged: True
第一行新样本位于两个分布中间,因此概率接近各半;第二行靠近右侧分量,因此右侧归属概率接近 1。每行概率之和为 1。
选择分量数时,不要只比较训练集拟合值。可在候选范围内计算 BIC,数值越小通常表示“拟合效果与模型复杂度”的折中更好。
for k in range(1, 5):
    candidate = GaussianMixture(n_components=k, n_init=10, random_state=42)
    candidate.fit(X)
    print(k, round(candidate.bic(X), 3))
预期结果会列出每个 k 的 BIC;应选择较低值附近且业务解释合理的分量数,实际数值会随数据变化。
输出字段说明
predict(X):返回分量编号,但编号没有固定业务含义。predict_proba(X):返回形状为“样本数 × 分量数”的后验概率矩阵。score_samples(X):返回逐样本对数似然,越低表示样本越不符合已学习分布。weights_、means_、covariances_:分别表示分量权重、均值和协方差。converged_、n_iter_:用于确认是否在迭代上限内收敛。
风险与边界
特征量纲差异很大时,协方差会被大尺度特征主导,导致分量形状失真;应先用训练集拟合标准化器,再对训练集和线上数据执行同一变换。
样本少、维度高或分量过多时,协方差可能接近奇异,可能出现不收敛、数值错误或极端概率;优先减少分量、改用 diag、增加样本,或适当提高 reg_covar。
GMM 的分量编号可能在重新训练后交换,不能直接把“分量 0”写死为某个业务类别;应按均值、中心位置或已知样本完成稳定映射。概率也不是天然校准后的业务风险概率,涉及决策阈值时必须用独立数据验证。
选择孤立森林在无标签数据中识别少量异常样本时使用孤立森林。
选择孤立森林
当数据没有异常标签、异常样本占比很低,并且需要从大量正常样本中筛出可疑点时,选择孤立森林。它通过随机切分使少数、偏离主体分布的样本更快被隔离,适合数值型表格数据的无监督异常检测。
什么时候选
优先选择孤立森林的典型条件:
- 没有可靠标签,只知道异常应当是少数。
- 数据量较大,需要比核方法更容易扩展的检测器。
- 异常表现为偏离整体分布,而不是只偏离某个局部邻域。
- 需要输出连续异常分数,并按风险从高到低复核。
若异常主要由局部密度差异决定,可比较 LOF;若正常数据近似单峰高斯,可比较 EllipticEnvelope;若已有高质量标签,应优先训练监督分类模型。
基本语法与参数
from sklearn.ensemble import IsolationForest

model = IsolationForest(
    n_estimators=200,
    max_samples="auto",
    contamination="auto",
    n_jobs=-1,
    random_state=42,
)
model.fit(X)
labels = model.predict(X)
scores = model.decision_function(X)
关键参数:
n_estimators:树的数量。增加后结果通常更稳定,但训练与推理成本上升。max_samples:每棵树使用的样本数;auto会限制单树样本规模,适合大数据快速训练。contamination:预期异常比例,用于确定判定阈值;比例未知时可用auto,再按验证集或人工复核结果设阈值。max_features:每棵树使用的特征比例。特征很多且噪声大时可小于 1。n_jobs:训练并行度;-1使用可用 CPU 核心。random_state:固定随机过程,便于复现。
高频用法
下面示例把 8.0 作为明显偏离主体的一维异常点。fit_predict() 返回 1 表示正常,-1 表示异常;decision_function() 越小越异常,负值位于模型阈值的异常侧。:contentReference[oaicite:1]{index=1}
import numpy as np
from sklearn.ensemble import IsolationForest

X = np.array([[0.0], [0.1], [-0.1], [0.2], [-0.2], [8.0]])

model = IsolationForest(
    n_estimators=200,
    contamination=1 / 6,
    random_state=42,
)
labels = model.fit_predict(X)
scores = model.decision_function(X)

print("labels:", labels)
print("scores:", np.round(scores, 3))
print("most_anomalous_index:", int(np.argmin(scores)))
预期输出:
labels: [ 1  1  1  1  1 -1]
scores: [ 0.136  0.128  0.122  0.058  0.05  -0.248]
most_anomalous_index: 5
索引 5 对应样本 8.0。生产中不要只保存标签,应同时保存连续分数,便于按风险排序和调整阈值。
已知每天只能人工复核前 100 条时,可直接按分数升序截取,而不是强依赖 contamination:
review_count = min(100, len(X))
review_indices = np.argsort(scores)[:review_count]
print(review_indices)
预期结果为异常程度从高到低的样本索引;当前小数据会输出全部索引,真实结果随输入变化。
输出字段说明
predict(X):1为正常,-1为异常。decision_function(X):相对模型阈值的分数,通常小于 0 判为异常,越小越可疑。score_samples(X):原始样本分数,越小越异常;不要与“越大风险越高”的业务分数直接混用。offset_:把原始分数转换为decision_function时使用的偏移量。estimators_:已训练的随机隔离树集合。
风险与边界
contamination 设置过高会把正常样本强制划为异常,造成大量误报;设置过低会漏掉真实异常。安全做法是先用连续分数排序,再结合历史事件、抽样复核或有标签验证集确定阈值。
训练数据被异常大量污染时,模型会把异常模式当成正常结构,后果是检测能力下降;应先清洗明显脏数据,按时间窗口训练,并监控分数分布漂移。
特征量纲、缺失值编码和类别编码方式变化会改变随机切分结果,可能导致线上分数突变;应固化同一预处理流水线,并对缺失率、取值范围和类别集合做上线校验。
孤立森林更擅长发现全局稀有点,不保证识别所有业务异常。对“金额正常但频率异常”“单用户局部异常”等模式,应增加聚合特征、分群建模,或与规则、LOF、监督模型组合使用。
选择局部异常因子需要根据局部邻域密度差异识别异常点时使用局部异常因子。
选择局部异常因子
当异常点只在局部邻域中显得稀疏,而全局数据又包含多个密度不同的簇时,优先使用局部异常因子(LOF)。它比较样本与邻居的局部可达密度,适合发现“在所在小范围内不合群”的点。
基本语法
from sklearn.neighbors import LocalOutlierFactor

model = LocalOutlierFactor(
    n_neighbors=20,
    contamination="auto",
    metric="minkowski",
    p=2
)
labels = model.fit_predict(X)
fit_predict 返回 1 表示正常点,-1 表示异常点。默认模式用于一次性检测训练数据;需要判断后续新样本时,必须在建模前设置 novelty=True。
常用参数
n_neighbors:参与密度比较的邻居数。应大于最小正常簇规模,又不能大到把不同密度区域混在一起;常从 10、20、50 交叉验证。contamination:预期异常比例,可用"auto"或0 < 值 <= 0.5。比例填得过高会把边界正常点误报为异常。metric、p:距离度量。连续特征常用欧氏距离,即metric="minkowski", p=2。novelty:False检测训练集异常;True学习正常结构后预测未见样本,两种模式的调用方式不能混用。
高频用法
下面示例检测一个远离局部密集区域的样本,执行前安装 numpy 与 scikit-learn。
import numpy as np
from sklearn.neighbors import LocalOutlierFactor

X = np.array([
    [0.0, 0.0],
    [0.1, 0.0],
    [0.0, 0.1],
    [0.1, 0.1],
    [3.0, 3.0],
])

# contamination=0.2 表示预计 5 个样本中约有 1 个异常点
model = LocalOutlierFactor(n_neighbors=2, contamination=0.2)
labels = model.fit_predict(X)
lof_scores = -model.negative_outlier_factor_

print("labels:", labels.tolist())
print("lof:", np.round(lof_scores, 3).tolist())
预期输出
labels: [1, 1, 1, 1, -1]
lof: [1.0, 1.0, 1.0, 1.0, 41.369]
读取时先看 labels 定位异常,再看正向化后的 lof 分数排序;分数约等于 1 通常表示与邻域密度接近,数值越大越可疑。
风险与边界
特征量纲差异会直接扭曲距离,例如“金额”远大于“次数”时,模型可能只按金额判断。后果是误报集中在大数值特征上;安全做法是先使用 StandardScaler 或稳健缩放,并在同一流水线中训练和预测。
当数据维度很高、样本极多或邻域距离趋同时,LOF 的区分度和计算效率会下降。可先降维或筛选特征;若异常表现为全局远离主体而非局部稀疏,可改用 Isolation Forest。
使用 novelty=True 后,不要再对训练集调用 predict、decision_function 或 score_samples 来复现训练异常标签,否则结果语义会变化。训练集检测使用默认模式和 fit_predict,新样本检测才使用 novelty 模式。
排障清单
- 几乎全部被判异常:检查
contamination是否过高、是否未缩放特征。 - 小簇整体被误报:减小
n_neighbors,确保邻居数小于该正常簇的有效规模。 - 每次换数据结果波动大:固定预处理规则,并用带已知异常的验证集选择邻居数和阈值。
- 新样本无法调用
predict:模型初始化时未设置novelty=True,需要重新训练。
选择单类支持向量机仅有正常样本并需要学习正常数据边界时使用单类支持向量机。
选择单类支持向量机
当训练数据几乎只有正常样本,需要学习一条包围正常区域的非线性边界,并对后续样本做新颖性检测时,使用单类支持向量机(One-Class SVM)。它更适合特征维度中等、样本量可控且正常分布边界较清晰的场景。
基本语法
from sklearn.svm import OneClassSVM

model = OneClassSVM(
    kernel="rbf",
    gamma="scale",
    nu=0.05
)
model.fit(X_train)
labels = model.predict(X_test)
scores = model.decision_function(X_test)
predict 返回 1 表示落在学习到的正常区域内,-1 表示边界外样本。decision_function 大于等于 0 通常偏正常,小于 0 通常偏异常,绝对值可用于比较样本距离边界的程度。
常用参数
kernel:默认rbf,适合弯曲的非线性边界;边界近似线性时可用linear。nu:取值(0, 1],同时影响允许的训练异常比例上界和支持向量比例下界。只有正常样本时通常从0.01、0.05、0.1开始验证。gamma:RBF 核的影响范围。值过大时边界贴合单个样本,容易过拟合;值过小时边界过平滑,可能漏报。max_iter:默认-1表示不限制迭代。生产任务可设置上限并检查fit_status_,避免异常数据导致训练长时间占用资源。
高频用法
下面示例只用靠近原点的正常样本训练,再判断一个正常候选点和一个远离主体的异常点。
import numpy as np
from sklearn.svm import OneClassSVM

X_train = np.array([
    [0.0, 0.0],
    [0.2, 0.1],
    [-0.1, 0.2],
    [0.1, -0.2],
    [-0.2, -0.1],
])
X_test = np.array([
    [0.1, 0.0],
    [3.0, 3.0],
])

# 固定 gamma 与 nu,使示例结果可复现
model = OneClassSVM(kernel="rbf", gamma=0.5, nu=0.1)
model.fit(X_train)

labels = model.predict(X_test)
scores = model.decision_function(X_test)

print("labels:", labels.tolist())
print("scores:", np.round(scores, 3).tolist())
预期输出
labels: [1, -1]
scores: [0.009, -0.476]
读取时以 labels 作为最终分类,以 scores 作为排序依据。接近 0 的样本位于边界附近,应结合人工复核或业务规则设置缓冲区,而不是直接按正负值执行高风险拦截。
风险与边界
若训练集混入大量异常,模型会把异常区域也学成正常边界,导致后续漏报。安全做法是先清洗训练数据,按时间窗口抽样,并保留一组独立的已知正常与已知异常样本调参。
未缩放特征会让大数值维度主导 RBF 距离,可能造成边界严重偏移。应使用 StandardScaler,并确保线上预测复用训练时同一个 scaler;禁止分别对训练集和单批预测数据重新拟合缩放器。
RBF 单类 SVM 的训练和预测成本会随样本量上升,不适合直接吞入超大规模明细。样本达到数十万级时,可先抽取代表性正常样本,或评估 Isolation Forest、SGDOneClassSVM 等更可扩展方案。
排障清单
- 训练样本大量被判异常:减小
nu,检查训练集污染和特征缩放。 - 所有测试样本都正常:适当增大
gamma或nu,并确认异常样本确实超出训练分布。 - 结果对参数极敏感:在标准化后对
nu与gamma做网格验证,不要只凭默认值上线。 - 训练耗时或内存异常:减少样本量、缩短特征维度,并设置
cache_size、max_iter后检查收敛状态。
选择分类指标根据误报、漏报和类别分布选择准确率、精确率、召回率或 F1 值。
选择分类指标
分类指标要跟业务损失对齐:先判断误报和漏报谁更贵,再看类别是否均衡。不要只因为准确率最高就认定模型最好。
快速选择
| 主要关注点 | 优先指标 | 典型判断 |
|---|---|---|
| 各类别数量接近,误报与漏报代价相近 | 准确率 Accuracy | 整体预测正确比例 |
| 误报代价高 | 精确率 Precision | 被判为正类的样本中有多少是真的 |
| 漏报代价高 | 召回率 Recall | 真实正类中有多少被找出来 |
| 误报、漏报都重要,且正类较少 | F1 值 | 精确率与召回率的调和平均 |
二分类常用公式为:Accuracy=(TP+TN)/(TP+TN+FP+FN)、Precision=TP/(TP+FP)、Recall=TP/(TP+FN)、F1=2×Precision×Recall/(Precision+Recall)。
主示例
下面构造 95 个负类和 5 个正类,模型全部预测为负类。示例说明类别不平衡时,准确率可能看起来很高,但模型完全没有识别出正类。
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score

y_true = [0] * 95 + [1] * 5
y_pred = [0] * 100

print(f"accuracy={accuracy_score(y_true, y_pred):.2f}")
print(f"precision={precision_score(y_true, y_pred, zero_division=0):.2f}")
print(f"recall={recall_score(y_true, y_pred, zero_division=0):.2f}")
print(f"f1={f1_score(y_true, y_pred, zero_division=0):.2f}")
预期输出
accuracy=0.95
precision=0.00
recall=0.00
f1=0.00读取方法:accuracy=0.95 只表示 100 个样本中预测对了 95 个;后三项为 0,说明 5 个正类一个也没有识别出来。
多分类与类别不平衡
多分类计算指标时要明确平均方式。macro 先分别计算每个类别再等权平均,适合关注小类;weighted 按类别样本数加权,结果容易被大类主导;micro 汇总所有类别的 TP、FP、FN 后计算,更接近整体表现。
生产评估建议同时保留每个类别的 Precision、Recall、F1 和样本数 support,不要只看一个总分。对于严重不平衡数据,优先查看少数类召回率、精确率以及 PR 曲线。
风险与边界
准确率在类别极不均衡时会掩盖少数类失效,可能导致欺诈、故障或疾病样本被全部漏掉;安全替代方案是同时报告混淆矩阵和少数类指标。
F1 不包含 TN,负类识别能力很重要时不能单独使用;应补充特异度或负类召回率。Precision 和 Recall 还会随分类阈值变化,比较模型时必须使用相同数据集、正类定义和阈值。
速查:误报贵看 Precision,漏报贵看 Recall,两者都重要看 F1,类别均衡且错误代价接近才优先看 Accuracy。
读取混淆矩阵通过真实类别与预测类别的交叉统计定位主要分类错误。
读取混淆矩阵
混淆矩阵把真实类别与预测类别交叉统计,用于定位模型主要把哪一类错分成了哪一类。读取前先确认行列含义和类别顺序。
矩阵布局
在 scikit-learn 中,行表示真实类别,列表示预测类别。二分类且标签顺序为 [0, 1] 时,矩阵布局如下:
| 真实值 / 预测值 | 预测 0 | 预测 1 |
|---|---|---|
| 真实 0 | TN 真负例 | FP 假正例 |
| 真实 1 | FN 假负例 | TP 真正例 |
主对角线是预测正确的数量;非主对角线是分类错误。FP 表示把负类误报成正类,FN 表示把正类漏判成负类。
主示例
显式传入 labels=[0, 1] 可以固定类别顺序,避免某批数据缺少某个类别时矩阵维度变化。
from sklearn.metrics import confusion_matrix

y_true = [0, 0, 0, 0, 0, 1, 1, 1, 1, 1]
y_pred = [0, 0, 0, 0, 1, 0, 0, 1, 1, 1]

cm = confusion_matrix(y_true, y_pred, labels=[0, 1])
tn, fp, fn, tp = cm.ravel()

print(cm)
print(f"TN={tn}, FP={fp}, FN={fn}, TP={tp}")
预期输出
[[4 1]
 [2 3]]
TN=4, FP=1, FN=2, TP=3
读取方法:第一行表示 5 个真实负类,其中 4 个预测正确、1 个被误报;第二行表示 5 个真实正类,其中 3 个识别正确、2 个被漏报。由此可得正类精确率 3/(3+1)=0.75,正类召回率 3/(3+2)=0.60,当前更突出的问题是漏报。
高频排查顺序
先找数值最大的非对角单元格,确认主要错分方向;再回查这些样本的原始特征、标签质量和预测置信度。若某一行错误很多,通常表示该真实类别召回率低;若某一列混入很多其他类别,通常表示该预测类别精确率低。
多分类矩阵按同样方法读取:第 i 行第 j 列表示真实类别 i 被预测成类别 j 的数量。重点观察成对混淆,例如 A 经常被判成 B,但 B 很少被判成 A。
风险与边界
不同库可能交换行列定义,直接套用 TN、FP、FN、TP 会得出相反结论;安全做法是查明 API 约定,并用一个手工可验证的小样本确认。
未固定 labels 时,类别顺序可能按排序结果生成;报告和线上监控应显式保存标签顺序。归一化矩阵适合比较比例,但会隐藏真实样本量;生产排障应同时保留原始计数和按行归一化结果。
速查:看对角线判断正确量,看非对角线定位错分方向;行错误多对应召回问题,列混入多对应精确率问题。
使用 ROC 曲线和 AUC 比较模型在不同分类阈值下的区分能力。
评估 ROC 曲线
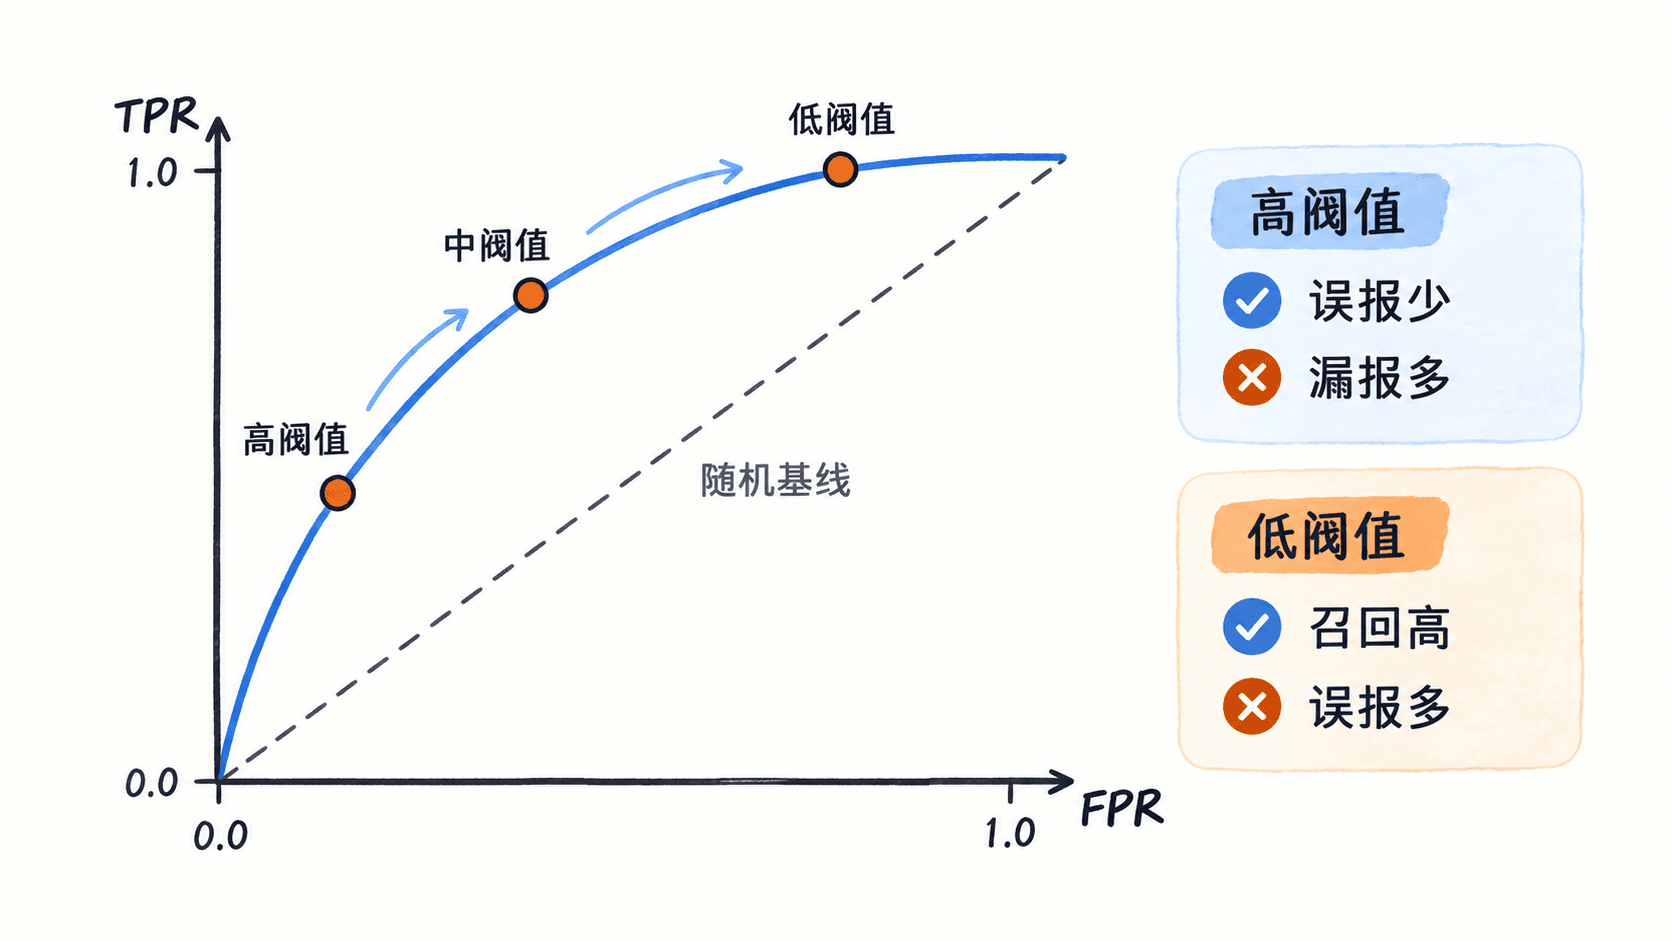
ROC 曲线用于比较二分类模型在不同阈值下“识别正类”和“误报负类”的权衡。横轴是假正率 FPR,纵轴是真正率 TPR;AUC 用一个数概括排序能力,适合先比较模型,再结合业务成本选择阈值。
基本语法
传入真实标签 y_true 和连续得分 y_score。得分应使用正类概率 predict_proba(X)[:, 1] 或 decision_function(X),不要直接传入已经按阈值切分的 predict(X) 结果。
from sklearn.metrics import roc_curve, roc_auc_score

fpr, tpr, thresholds = roc_curve(y_true, y_score, pos_label=1)
auc_value = roc_auc_score(y_true, y_score)
roc_curve 返回各候选阈值对应的 FPR、TPR 和阈值;roc_auc_score 返回曲线下面积。AUC 越接近 1,模型越能把正样本排在负样本之前;接近 0.5 通常表示排序能力接近随机。
高频用法
下面的示例同时计算 AUC、读取阈值 0.40 对应的 FPR/TPR,并绘制 ROC 曲线。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import RocCurveDisplay, roc_auc_score, roc_curve

y_true = np.array([0, 0, 1, 1, 0, 1, 0, 1])
y_score = np.array([0.05, 0.20, 0.35, 0.80, 0.40, 0.70, 0.10, 0.60])

fpr, tpr, thresholds = roc_curve(y_true, y_score)
auc_value = roc_auc_score(y_true, y_score)

# 找到最接近业务候选阈值 0.40 的曲线点。
index = int(np.argmin(np.abs(thresholds - 0.40)))
print(f"AUC={auc_value:.4f}")
print(
    f"threshold={thresholds[index]:.2f}, "
    f"FPR={fpr[index]:.4f}, TPR={tpr[index]:.4f}"
)

RocCurveDisplay(
    fpr=fpr,
    tpr=tpr,
    roc_auc=auc_value,
    estimator_name="demo",
).plot()
plt.tight_layout()
plt.show()
预期输出
AUC=0.9375
threshold=0.40, FPR=0.2500, TPR=0.7500
同时会显示 ROC 图。该阈值下,负样本误报率为 25%,正样本召回率为 75%;阈值继续降低通常会提高 TPR,也可能同步提高 FPR。
输出字段说明
fpr[i]:阈值thresholds[i]下,负样本被错误判为正类的比例。tpr[i]:同一阈值下,正样本被正确识别的比例,也就是召回率。thresholds[i]:从高到低扫描的判定阈值,首个值可能为inf,表示尚未预测任何正类。AUC:衡量整体排序能力,不代表某个固定阈值下的精确率、召回率或实际收益。
风险与边界
当正类极少时,大量真负样本会压低 FPR,ROC AUC 可能看起来很好,但实际误报数量仍不可接受。此时应同时查看精确率召回率曲线、AP、混淆矩阵和具体阈值下的误报数。
不要在最终测试集上反复挑阈值,否则测试结果会被间接用于调参并产生乐观偏差。安全做法是在验证集或交叉验证的折外预测上选阈值,测试集只做一次最终评估。
多分类任务不能直接把二维概率矩阵交给 roc_curve。需要按一对其余分别绘制,或使用 roc_auc_score(..., multi_class="ovr")、multi_class="ovo" 计算汇总 AUC。
排障清单
- 标签不是
0/1、-1/1时,显式设置pos_label,避免正类方向反转或报错。 - AUC 小于 0.5 时,先检查是否取错了概率列;二分类通常应取模型
classes_中正类对应的列。 - 曲线只有少量折点时,检查是否误传了离散预测标签,应改传连续概率或决策分数。
- 训练 AUC 很高而验证 AUC 明显下降时,优先检查过拟合、数据泄漏和训练验证分布差异。
速查:ROC 适合看整体排序能力;阈值决策必须回到误报、漏报成本和真实样本比例。
在正负样本严重不均衡时使用精确率召回率曲线评估分类模型。
评估精确率召回率曲线
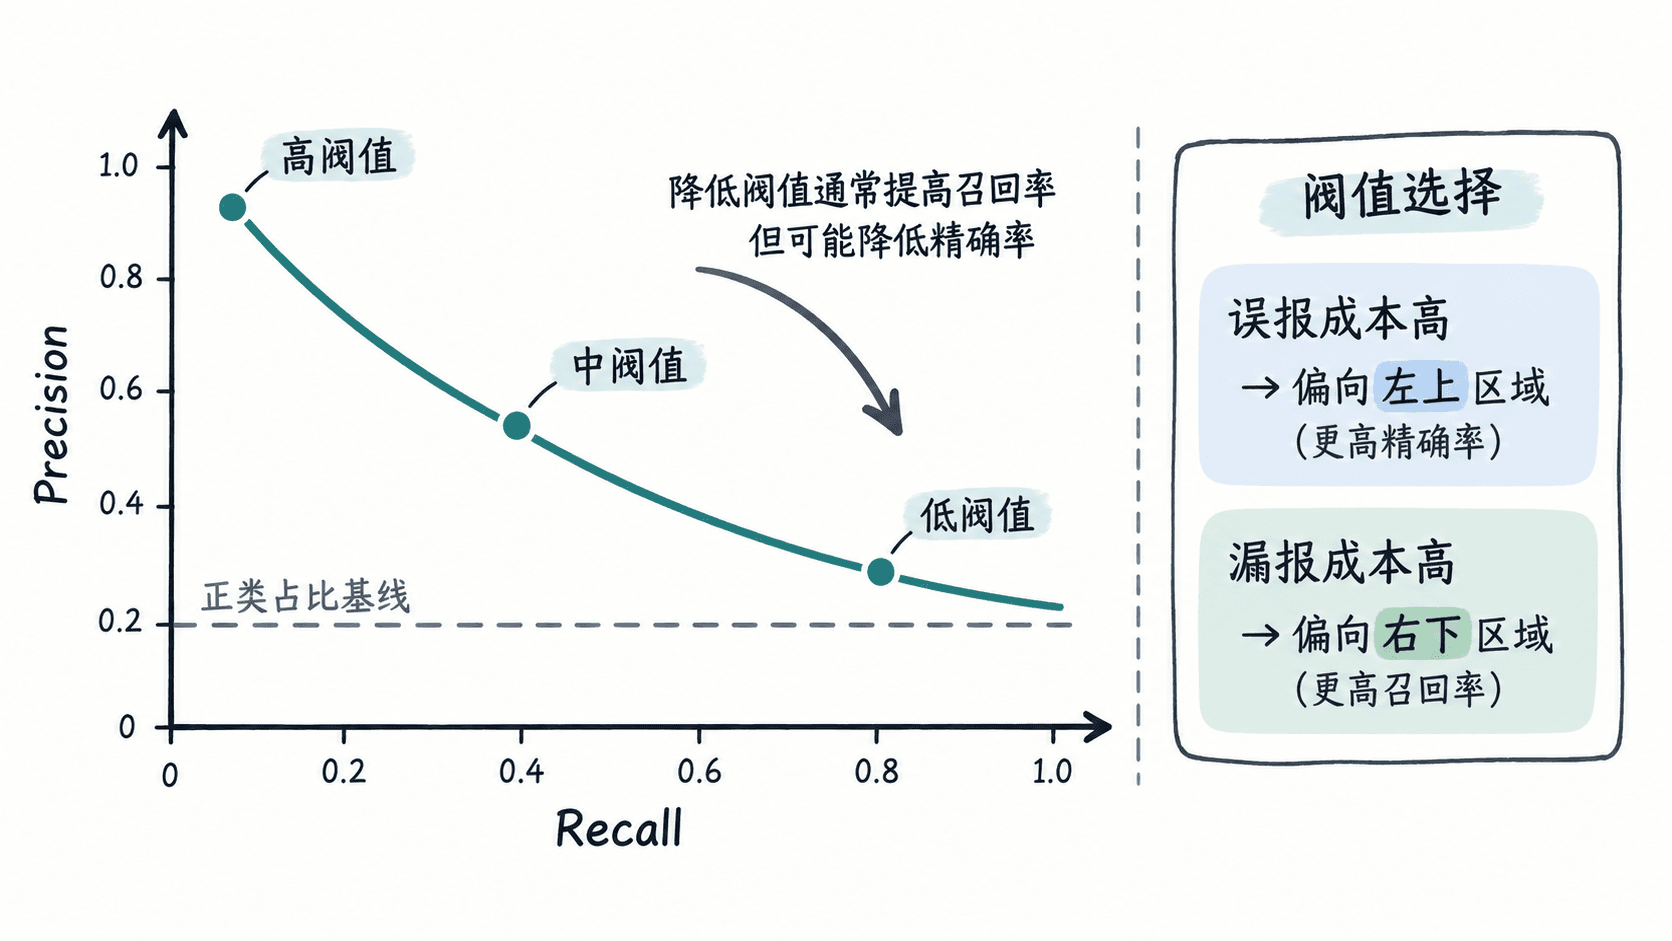
精确率召回率曲线用于正类稀少的二分类任务,例如欺诈、故障和告警检测。它直接展示不同阈值下精确率与召回率的取舍,并用 AP 汇总曲线表现,比只看准确率或 ROC AUC 更容易暴露误报问题。
基本语法
传入真实标签 y_true 和正类连续得分 y_score。precision_recall_curve 返回精确率、召回率和阈值;average_precision_score 计算 AP。
from sklearn.metrics import average_precision_score, precision_recall_curve

precision, recall, thresholds = precision_recall_curve(
    y_true,
    y_score,
    pos_label=1,
)
ap_value = average_precision_score(y_true, y_score)
thresholds 比 precision、recall 少一个元素,因此阈值 thresholds[i] 对应 precision[i] 和 recall[i]。曲线的无技巧基线约等于正类占比,例如正类占 1%,基线精确率约为 1%。
高频用法
下面构造 20 个样本,其中只有 3 个正样本,并检查阈值 0.70 下的精确率和召回率。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import (
    PrecisionRecallDisplay,
    average_precision_score,
    precision_score,
    recall_score,
)

y_true = np.array([
    0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
    0, 0, 0, 0, 0, 0, 0, 1, 1, 1,
])
y_score = np.array([
    0.02, 0.05, 0.08, 0.10, 0.12, 0.15, 0.18, 0.20, 0.22, 0.25,
    0.28, 0.30, 0.35, 0.45, 0.50, 0.55, 0.60, 0.90, 0.70, 0.40,
])

threshold = 0.70
y_pred = (y_score >= threshold).astype(int)

ap_value = average_precision_score(y_true, y_score)
precision = precision_score(y_true, y_pred, zero_division=0)
recall = recall_score(y_true, y_pred)

print(f"positive_rate={y_true.mean():.4f}")
print(f"AP={ap_value:.4f}")
print(
    f"threshold={threshold:.2f}, "
    f"precision={precision:.4f}, recall={recall:.4f}"
)

PrecisionRecallDisplay.from_predictions(
    y_true,
    y_score,
    name="demo",
)
plt.tight_layout()
plt.show()
预期输出
positive_rate=0.1500
AP=0.8095
threshold=0.70, precision=1.0000, recall=0.6667
同时会显示 PR 曲线。阈值 0.70 没有产生误报,因此精确率为 1;但只找回 3 个正样本中的 2 个,因此召回率为 0.6667。
输出字段说明
precision[i]:被模型判为正类的样本中,真实正类所占比例。recall[i]:全部真实正类中,被模型找回的比例。thresholds[i]:产生对应精确率和召回率的分数阈值。AP:按召回率增量加权汇总各点精确率,越高越好;不要把它与固定阈值下的精确率混为一谈。
阈值选择
先写清业务约束,再从曲线上选点。误报会触发昂贵人工复核时,可要求 precision >= 0.90 后选择召回率最高的阈值;漏报后果严重时,可要求 recall >= 0.95 后选择精确率最高的阈值。
选出的阈值还应在验证集上输出 TP、FP、FN、每千样本误报数和预计人工处理量。只报告 AP 无法说明上线后的实际告警规模。
风险与边界
不要使用 predict(X) 的离散标签绘制曲线,否则只能得到极少数点,无法观察阈值变化。应传入正类概率或决策分数。
AP 会受正类比例影响,不同数据集或不同时间窗口的 AP 不能脱离样本基线直接横向比较。安全做法是同时报告正类占比,并在固定评估集或一致采样规则下比较模型。
不要在测试集上依据曲线反复调整阈值。应在验证集、时间外验证集或交叉验证折外预测上确定阈值,再在测试集上冻结评估。
排障清单
- 曲线起点精确率异常时,检查正类标签和
pos_label是否设置正确。 - 精确率全为 1 但召回率很低时,通常是阈值过高或模型只对少量样本给出高分。
- 召回率很高但精确率接近正类占比时,说明阈值过低,模型几乎把所有样本都判为正类。
- AP 明显高于线上效果时,检查离线数据是否过度下采样负类、存在标签泄漏或时间穿越。
速查:类别越不平衡,越应优先看 PR 曲线、AP 和目标阈值下的真实误报数量。
选择回归指标根据异常值敏感度和业务含义选择 MAE、MSE、RMSE 或决定系数。
选择回归指标
用验证集或测试集同时计算 MAE、MSE、RMSE 和 R²,再按业务损失选择主指标。预测误差要用原始业务单位解释;不要只看单个分数。
快速选择
| 指标 | 什么时候用 | 读取方式 |
|---|---|---|
| MAE | 每单位误差成本近似线性,且不希望少数异常值主导结果 | 越小越好,单位与目标值一致 |
| MSE | 大误差需要被平方惩罚,常用于模型训练或参数搜索 | 越小越好,单位是目标值单位的平方 |
| RMSE | 既要强化大误差,又要保留原始业务单位 | 越小越好;比 MAE 大很多时通常存在长尾误差 |
| R² | 需要判断模型相对“预测均值”解释了多少波动 | 越接近 1 越好;测试集上可以为负数 |
生产验收通常选一个主指标,再搭配一个诊断指标。例如以 MAE 控制平均成本,同时查看 RMSE 识别严重偏差。
可运行示例
下面只使用 Python 标准库,数组可替换为同一批样本的真实值和预测值。
from math import sqrt

y_true = [3.0, -0.5, 2.0, 7.0]
y_pred = [2.5, 0.0, 2.0, 8.0]

errors = [actual - predicted for actual, predicted in zip(y_true, y_pred)]
mae = sum(abs(error) for error in errors) / len(errors)
mse = sum(error ** 2 for error in errors) / len(errors)
rmse = sqrt(mse)

mean_y = sum(y_true) / len(y_true)
ss_res = sum(error ** 2 for error in errors)
ss_tot = sum((actual - mean_y) ** 2 for actual in y_true)
r2 = 1 - ss_res / ss_tot

print(f'MAE={mae:.3f}')
print(f'MSE={mse:.3f}')
print(f'RMSE={rmse:.3f}')
print(f'R2={r2:.3f}')
预期输出
MAE=0.500
MSE=0.375
RMSE=0.612
R2=0.949
MAE 表示平均偏差为 0.5 个目标单位;RMSE 高于 MAE,说明较大的误差被额外放大。R² 为 0.949,表示该样本上模型明显优于直接预测均值,但不能代替业务单位误差。
风险与边界
异常值进入评估集时,MSE 和 RMSE 会被少数大误差显著拉高,可能让模型选择过度偏向极端样本。安全做法是同时报告 MAE、RMSE 和误差分位数,必要时使用稳健损失或单独分析异常样本。
R² 不是准确率,也不是“预测正确百分比”。测试集分布变化、样本很少或目标波动很小时,R² 可能不稳定甚至为负;此时应以 MAE、RMSE 等绝对误差为主。
目标值经过对数、标准化或其他变换时,直接计算的 MAE、RMSE 不再是原始业务单位。应先对预测值和真实值做一致的逆变换,再生成对外指标。
排障清单
- 确认
y_true与y_pred样本顺序一致、长度相同,没有把训练集结果当成测试集结果。 - 按时间、地区、客户类型或金额区间拆分指标,避免总体均值掩盖局部严重误差。
- 检查缺失值、无穷值和目标值逆变换;这些问题会导致指标报错或失真。
- 固定同一测试集比较模型,不要跨数据集直接比较 MAE、RMSE 或 R²。
速查:线性成本优先 MAE,强调大误差优先 RMSE;MSE 常用于优化,R² 只用于补充解释能力。
评估聚类效果在缺少真实标签时使用轮廓系数等内部指标比较聚类结果。
评估聚类效果
没有真实标签时,先用轮廓系数、Davies-Bouldin 指数和 Calinski-Harabasz 指数比较候选聚类,再检查结果稳定性、噪声比例和业务可解释性。
指标定位
| 指标 | 方向 | 适合回答的问题 |
|---|---|---|
| 轮廓系数 Silhouette | 越接近 1 越好 | 样本是否更接近本簇而远离其他簇 |
| Davies-Bouldin | 越小越好 | 各簇是否紧凑且彼此分离 |
| Calinski-Harabasz | 越大越好 | 簇间离散是否明显高于簇内离散 |
轮廓系数通常在 -1 到 1 之间。接近 0 表示簇发生重叠,负值表示部分样本可能被分到更远的簇。内部指标只衡量特征空间几何关系,不能证明聚类具有业务价值。
可运行示例
示例比较同一批二维样本的两种标签方案。运行环境需已安装 scikit-learn。
from sklearn.metrics import (
    calinski_harabasz_score,
    davies_bouldin_score,
    silhouette_score,
)

points = [
    [0.0, 0.0],
    [0.0, 1.0],
    [1.0, 0.0],
    [8.0, 8.0],
    [8.0, 9.0],
    [9.0, 8.0],
]

candidates = {
    'separated': [0, 0, 0, 1, 1, 1],
    'mixed': [0, 1, 0, 1, 0, 1],
}

for name, labels in candidates.items():
    silhouette = silhouette_score(points, labels)
    db = davies_bouldin_score(points, labels)
    ch = calinski_harabasz_score(points, labels)
    print(
        f'{name}: silhouette={silhouette:.3f}, '
        f'DB={db:.3f}, CH={ch:.3f}'
    )
预期输出
separated: silhouette=0.900, DB=0.116, CH=288.000
mixed: silhouette=-0.051, DB=2.684, CH=0.492
separated 的轮廓系数和 CH 更高、DB 更低,三项指标方向一致,因此明显优于 mixed。生产数据中若指标结论冲突,应继续检查簇大小、离群点和不同随机种子的稳定性。
高频用法
比较不同簇数时,应在同一份预处理数据上循环计算指标,并排除只有一个簇或每个样本各自成簇的无效结果。选择分数较优且簇规模不过度失衡的方案,而不是机械选择最高分。
对 K-Means、GMM 等含随机初始化的算法,应使用多个随机种子重复训练。若分数和样本归属波动很大,说明聚类不稳定,暂不适合作为固定分群规则。
对 DBSCAN、HDBSCAN 等会产生噪声标签的算法,应同时报告噪声比例。计算轮廓系数前可按评估目的排除噪声样本,但必须单独记录被排除数量;排除后若只剩一个簇,则该指标不可计算。
风险与边界
特征量纲差异大时,数值范围最大的特征会主导距离,导致内部指标虚高或错误偏向。安全做法是在训练与评估前使用同一套标准化或稳健缩放,并保留原始特征用于业务解释。
轮廓系数偏好紧凑、分离明显的簇,对非球形、不同密度或链状簇可能评价不佳。不要只凭一个指标否定密度聚类结果,应结合抽样检查、稳定性和下游任务效果。
不同数据集、不同特征集合或不同距离度量产生的分数不可直接横向排名。只有数据范围、预处理和评估口径一致时,候选方案的分数才可比较。
排障清单
- 确认标签数量满足至少 2 个簇,且簇数小于样本数;否则轮廓系数无法计算。
- 检查是否存在单样本簇、极端小簇或大量噪声,这些情况会让平均分数失真。
- 确认训练和评估使用相同的缩放、缺失值处理与特征顺序。
- 按多个随机种子重复计算,并观察分数均值、波动和样本归属变化。
- 抽查每个簇的代表样本和业务特征,防止“几何上好看、业务上无意义”。
速查:同一数据上优先选择轮廓系数高、DB 低、CH 高且结果稳定的方案;最终仍需业务解释或下游效果验证。
执行交叉验证通过多次训练验证降低单次数据划分带来的评估偶然性。
执行交叉验证
用于在同一份数据上重复训练和验证模型,观察评分均值与波动,避免只依赖一次训练集、验证集划分。分类任务常用 StratifiedKFold 保持各折类别比例近似一致;cross_validate 可同时返回多个指标及训练、评分耗时。:contentReference[oaicite:0]{index=0}
基本语法
cv 决定如何切分数据,scoring 决定评估指标。预处理必须与模型一起放进 Pipeline,使标准化参数只从每一折的训练部分学习。
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_validate
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_breast_cancer(return_X_y=True)

model = make_pipeline(
    StandardScaler(),
    LogisticRegression(
        solver="liblinear",
        max_iter=1000,
        random_state=42,
    ),
)

# 打乱后分层切成 5 折;固定随机种子便于复现。
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

result = cross_validate(
    model,
    X,
    y,
    cv=cv,
    scoring={"accuracy": "accuracy", "roc_auc": "roc_auc"},
    n_jobs=-1,
)

print("accuracy:", np.round(result["test_accuracy"], 4))
print(
    "accuracy mean:",
    f"{result['test_accuracy'].mean():.4f}",
    "±",
    f"{result['test_accuracy'].std():.4f}",
)
print("roc_auc mean:", f"{result['test_roc_auc'].mean():.4f}")
预期输出
accuracy: [0.9737 0.9561 0.9649 0.9912 0.9912]
accuracy mean: 0.9754 ± 0.0140
roc_auc mean: 0.9954
末位小数可能随 scikit-learn 版本或底层数值库略有差异。均值反映整体水平,标准差越大,说明模型对数据划分越敏感。
输出字段说明
| 字段 | 读取方法 |
|---|---|
test_accuracy |
每一折验证集准确率 |
test_roc_auc |
每一折验证集 ROC AUC |
fit_time |
每一折模型拟合耗时,单位为秒 |
score_time |
每一折预测并计算指标的耗时 |
train_* |
仅在 return_train_score=True 时返回,用于检查过拟合 |
高频选择
单一指标且只需要分数时用 cross_val_score;需要多个指标或耗时信息时用 cross_validate。样本按用户、设备、患者等实体成组时改用 GroupKFold,防止同一实体同时进入训练折和验证折;时间序列使用 TimeSeriesSplit,禁止随机打乱未来数据。
风险与边界
在交叉验证之前对全量数据执行标准化、特征选择或缺失值填充,会把验证折信息泄漏进训练过程,导致评分虚高;安全做法是将所有数据驱动的预处理放入 Pipeline。少数类别样本数小于 n_splits 时,分层切分可能失败或产生不可靠折,应减少折数或增加样本。
若先用同一批交叉验证结果挑选参数,再把最高分直接当最终泛化能力,结果通常偏乐观;需要保留独立测试集,或使用外层评估、内层调参的嵌套交叉验证。:contentReference[oaicite:1]{index=1}
排障清单
- 各次运行分数变化:检查切分器是否启用随机打乱却未设置
random_state。 - 分数异常接近 1:检查目标泄漏、重复样本、同组样本跨折和全量预处理。
- 运行时间过长:降低折数,减少指标数量,或谨慎设置
n_jobs。 - 某折训练失败:查看警告并将
error_score="raise",直接暴露原始异常。
速查:先选对切分器,再把预处理封装进流水线,最后同时查看均值和折间波动。
搜索模型参数使用网格搜索、随机搜索或逐步搜索选择更合适的超参数组合。
搜索模型参数
用于系统比较多组超参数,并通过交叉验证选出评分更好的组合。候选较少且取值离散时用 GridSearchCV 穷举;空间较大或包含连续分布时用 RandomizedSearchCV,由 n_iter 控制抽样次数。:contentReference[oaicite:2]{index=2}
主示例
流水线参数名使用 步骤名__参数名。下面搜索 SVM 的 C 和 gamma,共评估 个组合,每个组合执行 5 折交叉验证。
from sklearn.datasets import load_iris
from sklearn.model_selection import GridSearchCV, StratifiedKFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = load_iris(return_X_y=True)

pipeline = Pipeline(
    [
        ("scale", StandardScaler()),
        ("svc", SVC()),
    ]
)

param_grid = {
    "svc__kernel": ["rbf"],
    "svc__C": [0.1, 1, 10],
    "svc__gamma": ["scale", 0.01, 0.1],
}

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

search = GridSearchCV(
    estimator=pipeline,
    param_grid=param_grid,
    scoring="accuracy",
    cv=cv,
    n_jobs=-1,
    refit=True,
    return_train_score=False,
)

search.fit(X, y)

print("best_params:", search.best_params_)
print("best_cv_accuracy:", f"{search.best_score_:.4f}")
print("candidate_count:", len(search.cv_results_["params"]))
预期输出
best_params: {'svc__C': 10, 'svc__gamma': 0.1, 'svc__kernel': 'rbf'}
best_cv_accuracy: 0.9667
candidate_count: 9
best_score_ 是最佳组合在交叉验证验证折上的平均分,不是独立测试集分数。refit=True 会用最佳参数在传入 fit 的全部数据上重新训练 best_estimator_。
关键参数
| 参数 | 作用与边界 |
|---|---|
param_grid |
字典值必须是候选列表;组合数等于各列表长度的乘积 |
scoring |
应与业务目标一致,如不平衡分类优先考虑 f1、roc_auc 或 average_precision |
cv |
控制切分策略;分组和时间数据不能直接使用普通随机 K 折 |
n_jobs |
-1 使用全部可用 CPU,但候选多、数据大时可能耗尽内存 |
refit |
为 True 时保留可直接预测的最佳模型;多指标搜索时可指定用于重训的指标名 |
error_score |
默认失败组合记为 NaN;排障时设置为 "raise" 获取原始异常 |
高频用法
小型离散空间使用网格搜索,先覆盖数量级而不是堆很多相近值,例如 C=[0.01, 0.1, 1, 10, 100]。候选达到数百或含连续参数时改用随机搜索,并固定 random_state;随机搜索不会尝试全部组合,而是抽取固定数量的参数设置。:contentReference[oaicite:3]{index=3}
存在条件参数时,将 param_grid 写成字典列表,例如线性核不搜索 gamma、RBF 核才搜索 gamma,避免无效组合。需要逐步淘汰候选时可考虑 HalvingGridSearchCV,但它仍属于实验接口,必须先导入 sklearn.experimental.enable_halving_search_cv,升级版本前应回归验证。:contentReference[oaicite:4]{index=4}
输出字段说明
best_params_ 是最佳参数,best_score_ 是其平均交叉验证分数,best_estimator_ 是重训后的模型。完整候选结果位于 cv_results_,常读字段包括 params、mean_test_score、std_test_score、rank_test_score 和 mean_fit_time。
风险与边界
在测试集上反复搜索参数会把测试集变成调参集,最终分数失真;安全做法是只在训练集内部搜索,最后对一次性保留的测试集评估。若既要调参又要无偏估计模型选择流程,应使用嵌套交叉验证。:contentReference[oaicite:5]{index=5}
网格规模会按参数候选数相乘,并再乘以交叉验证折数;例如 200 个组合、5 折至少需要约 1000 次拟合。出现内存峰值时,不要盲目使用 n_jobs=-1,应减少候选、降低并行度,或改用随机搜索。
排障清单
- 报
Invalid parameter:检查流水线参数是否写成步骤名__参数名,并用pipeline.get_params().keys()核对。 - 所有分数为
NaN:设置error_score="raise",检查参数类型、数据缺失值和模型约束。 - 最佳参数落在搜索边界:向该方向扩展范围后重新搜索。
- 交叉验证很高、测试集很低:检查数据泄漏、切分策略和是否对测试集反复调参。
速查:先缩小合理搜索空间,再选择匹配数据结构的交叉验证,最后只用独立测试集报告最终效果。