
机器学习与深度学习 / 知识点
机器学习算法速查手册
手册条目
根据目标变量和业务目标区分分类、回归、聚类、降维、异常检测与推荐任务。
判断任务类型
先确认要预测的结果、是否存在目标变量,以及最终动作是预测、分组、压缩、找异常还是排序推荐。任务类型判断错误,会直接导致标签设计、数据切分和评估指标全部偏离目标。
基本语法
按以下顺序判断,遇到明确业务目标时优先采用该目标对应的任务类型:
- 为用户或物品生成候选并排序:推荐。
- 识别少数异常样本或异常行为:异常检测。
- 没有目标变量,希望发现自然分组:聚类。
- 没有目标变量,希望减少特征数量:降维。
- 有目标变量且结果为离散类别:分类。
- 有目标变量且结果为连续数值:回归。
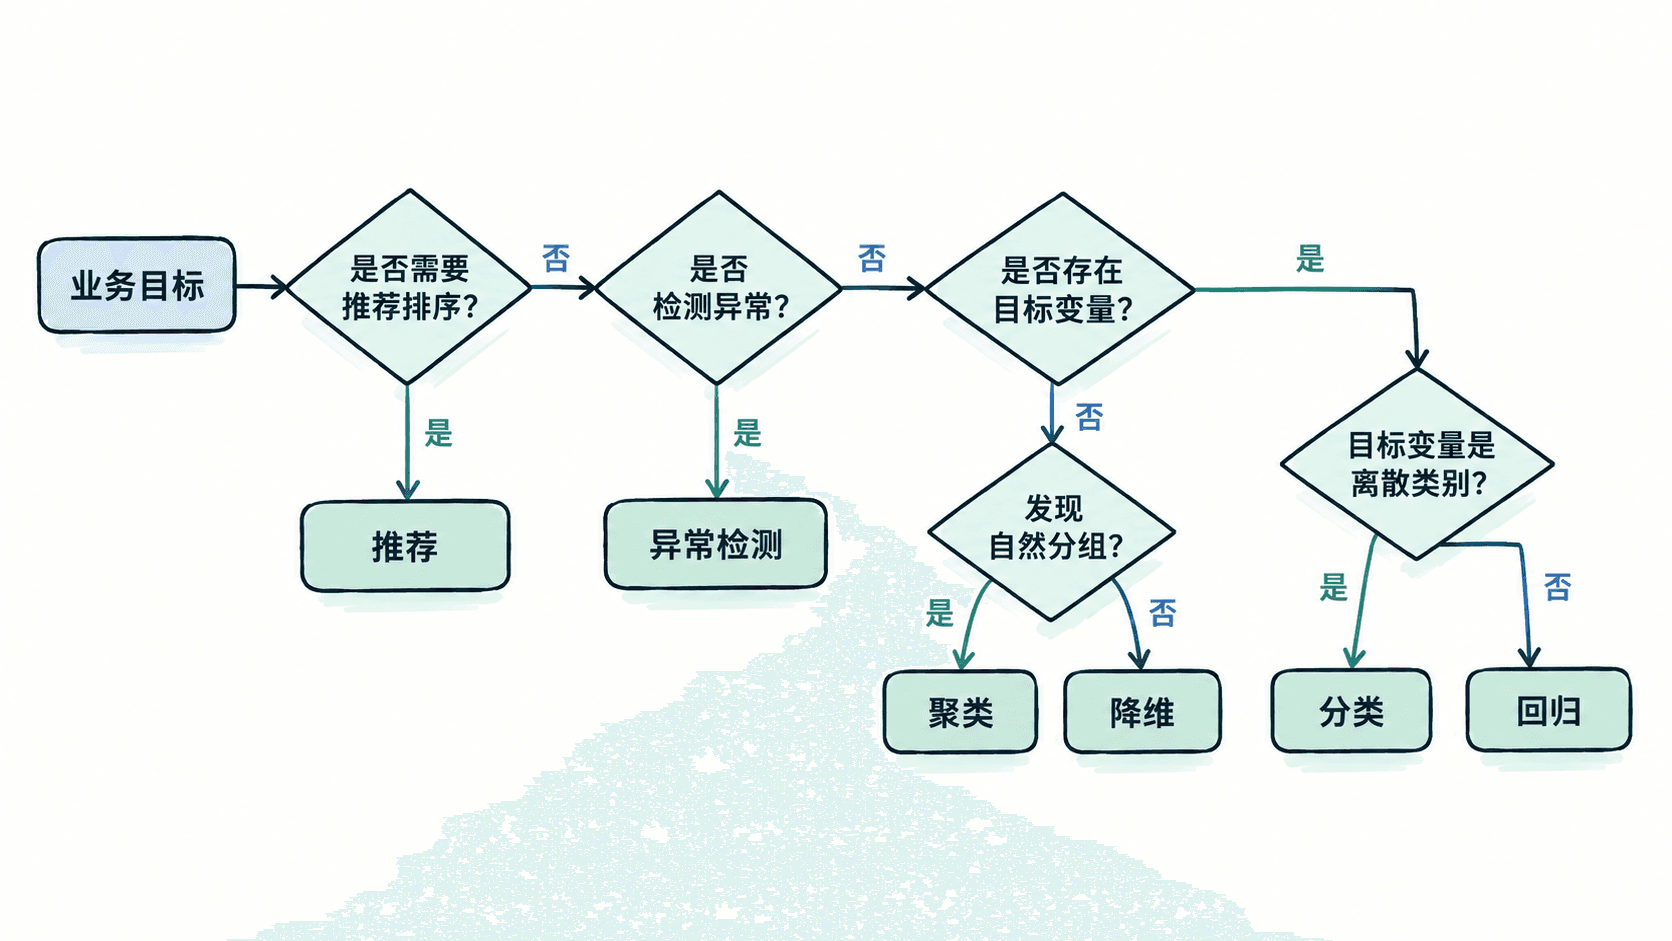
下面的脚本可把常见业务描述映射为任务类型:
from typing import Optional


def choose_task(
    has_target: bool,
    target_kind: Optional[str] = None,
    goal: Optional[str] = None,
) -> str:
    # 明确的推荐和异常检测目标优先于一般的监督学习判断。
    if goal == "recommend":
        return "推荐"
    if goal == "anomaly":
        return "异常检测"
    if not has_target:
        return "降维" if goal == "reduce_dim" else "聚类"
    if target_kind == "category":
        return "分类"
    if target_kind == "number":
        return "回归"
    raise ValueError("有监督任务必须指定 target_kind")


cases = [
    ("是否流失", True, "category", None),
    ("明日销量", True, "number", None),
    ("客户分群", False, None, None),
    ("压缩特征", False, None, "reduce_dim"),
    ("识别异常交易", False, None, "anomaly"),
    ("猜你喜欢", False, None, "recommend"),
]

for name, has_target, target_kind, goal in cases:
    print(f"{name}: {choose_task(has_target, target_kind, goal)}")
预期输出:
是否流失: 分类
明日销量: 回归
客户分群: 聚类
压缩特征: 降维
识别异常交易: 异常检测
猜你喜欢: 推荐
读取时先看冒号右侧的任务类型,再检查左侧业务目标是否确实对应可观测的标签或动作。
高频用法
| 业务问题 | 目标变量或结果 | 任务类型 |
|---|---|---|
| 判断订单是否欺诈 | 欺诈、正常 | 分类 |
| 预测下月销售额 | 连续金额 | 回归 |
| 将客户划分为若干群体 | 无预设标签 | 聚类 |
| 将数百个特征压缩为少量变量 | 低维表示 | 降维 |
| 找出偏离正常模式的设备 | 异常分数 | 异常检测 |
| 给用户排列候选商品 | 点击或购买排序 | 推荐 |
风险与边界
同一业务可能包含多个子任务。例如推荐系统通常同时包含候选召回、点击率预测和排序,不能只写成一个分类问题。安全做法是按最终交付结果拆分任务,并分别定义输入、标签和指标。
存在历史标签不代表一定要做分类。若目标是发现此前从未标注的新型欺诈,纯分类模型可能漏报,宜同时保留异常检测作为补充。
排障清单
- 模型输出无法直接支持业务动作:重新确认最终需要类别、数值、分组、异常分数还是排序列表。
- 标签在预测时才产生:检查是否把未来信息当成当前可用特征。
- 连续数值被人为切成区间:确认业务是否真的需要类别,否则优先保留为回归。
- 聚类结果无法解释:先确认分群是否有可执行用途,再调整特征和距离度量。
速查提示:先问“最终要输出什么”,再问“训练时是否有可信目标变量”
使用简单规则或基础算法建立可比较的最低性能基准。
建立基线模型
在训练复杂模型前,先用多数类、均值、最近值或热门度生成最低可接受基准。后续模型只有在相同数据切分和指标下稳定超过基线,才说明增加的复杂度有价值。
基本语法
分类任务可先用训练集中的多数类别预测全部验证样本。下面的示例不依赖第三方库,可直接运行:
from collections import Counter

train_y = [1, 1, 0, 1, 0, 1, 1, 0]
test_y = [1, 0, 1, 1, 0]

# 基线只能根据训练集确定,不能读取测试集分布。
majority_label = Counter(train_y).most_common(1)[0][0]
predictions = [majority_label] * len(test_y)

correct = sum(pred == actual for pred, actual in zip(predictions, test_y))
accuracy = correct / len(test_y)

print(f"majority_label={majority_label}")
print(f"predictions={predictions}")
print(f"accuracy={accuracy:.2f}")
预期输出:
majority_label=1
predictions=[1, 1, 1, 1, 1]
accuracy=0.60
accuracy=0.60 表示任何候选分类模型至少应在同一测试集上稳定高于 0.60;若类别严重不均衡,还要同时比较召回率、F1 或 PR-AUC。
高频用法
- 分类:始终预测训练集多数类别,或按训练集类别比例随机预测。
- 回归:使用训练集均值作为 MSE 基线,使用中位数作为 MAE 基线。
- 时间序列:使用上一时刻、上一周期同一时刻或移动平均作为朴素预测。
- 推荐:使用全局热门商品、分类热门商品或最近热门商品作为排序基线。
输出字段说明
记录基线时至少保留以下三个值:
| 字段 | 含义 | 读取方法 |
|---|---|---|
baseline_score |
简单策略的验证集得分 | 候选模型必须超过此值 |
candidate_score |
待评估模型的验证集得分 | 必须使用同一数据切分和指标 |
lift |
相对基线的提升量 | candidate_score - baseline_score |
仅比较单次得分容易受随机切分影响。数据量较小时,应记录多次交叉验证的均值和波动范围。
风险与边界
若用全量数据计算多数类、均值或热门度,会把验证集和测试集信息泄漏进基线,造成结果虚高。安全替代方案是只在训练集拟合基线,再对验证集或测试集生成预测。
类别极不均衡时,多数类基线可能获得很高准确率,却完全识别不出少数类。此时应使用少数类召回率、F1、平衡准确率或 PR-AUC,并同时查看混淆矩阵。
时间序列不能随机打乱后切分,否则未来数据可能进入训练集。应按时间顺序切分,并使用最近值或季节性朴素模型作为基线。
排障清单
- 复杂模型低于基线:检查特征、标签对齐、预处理和训练是否有错误。
- 基线异常高:检查目标泄漏、重复样本和训练测试交叉。
- 不同实验无法比较:统一数据版本、切分种子、指标定义和评估代码。
- 提升幅度很小且波动很大:增加重复验证,并报告均值与标准差。
速查提示:基线必须简单、可复现,并且只使用预测时真正可获得的信息
划分训练测试集将数据划分为训练集和测试集,避免使用训练数据评估最终效果。
划分训练测试集
用 train_test_split 将样本一次性拆成训练集和测试集。训练集用于拟合模型,测试集只在模型与参数确定后做最终评估,避免评估结果被训练过程污染。
基本语法
核心调用为 train_test_split(X, y, test_size=..., random_state=..., shuffle=...)。返回值顺序固定为 X_train、X_test、y_train、y_test,特征与标签会按同一组索引同步拆分。
from sklearn.model_selection import train_test_split

X = [[1], [2], [3], [4], [5], [6], [7], [8], [9], [10]]
y = [0, 0, 0, 0, 0, 1, 1, 1, 1, 1]

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.3,
    random_state=42,  # 固定随机种子,便于复现实验
    shuffle=True,
)

print("训练集样本数:", len(X_train))
print("测试集样本数:", len(X_test))
print("训练集标签数:", len(y_train))
print("测试集标签数:", len(y_test))
预期输出:
训练集样本数: 7
测试集样本数: 3
训练集标签数: 7
测试集标签数: 3
读取方法:特征数与标签数必须分别相等;这里 10 条数据按 70%/30% 拆为 7 条训练数据和 3 条测试数据。实际被抽中的样本由 random_state 和 scikit-learn 的随机拆分逻辑决定。
常用参数
test_size:测试集比例或样本数,例如0.2表示 20%,200表示固定 200 条。train_size:训练集比例或样本数,通常与test_size二选一;两者都省略时测试集默认为 25%。random_state:固定后可重复得到同一拆分结果。生产实验和教程应明确设置。shuffle:是否先打乱数据,默认True。设置为False时不能同时使用stratify。stratify:按指定标签保持类别比例,分类任务常设为y。
高频用法
普通独立样本分类或回归,可使用 test_size=0.2, random_state=42。类别明显不均衡时增加 stratify=y。需要额外验证集时,先拆出测试集,再从训练部分拆验证集,第二次拆分仍应固定随机种子。
时间序列不要随机打乱,应按时间先后切分,或使用 TimeSeriesSplit。同一用户、设备或病例产生多条记录时,不要让同一主体同时出现在训练集和测试集,应改用 GroupShuffleSplit 或分组交叉验证。
风险与边界
在拆分前对全量数据执行标准化、缺失值填补、特征选择或过采样,会把测试集信息泄露到训练过程,导致指标虚高。安全做法是先拆分,再仅用训练集拟合预处理器;更稳妥的是把预处理和模型放进 Pipeline。
测试集若被反复用于选模型、调阈值或调超参数,就不再是独立测试集。应使用验证集或交叉验证完成选择,最终只对测试集评估一次。
排障清单
- 出现样本数不一致:确认
X与y第一维长度相同。 - 每次结果不同:设置固定
random_state,并记录数据版本。 - 测试指标异常高:检查重复样本、同主体跨集合、目标泄漏和拆分前预处理。
- 时间序列线上效果差:检查是否错误使用了随机打乱。
- 类别在测试集中缺失:分类任务使用
stratify=y,并确保每个类别样本数足够。
速查提示:先划分,再拟合预处理与模型;测试集只负责最终验收。
执行分层抽样在类别分布不均衡时保持训练集与测试集的类别比例一致。
执行分层抽样
分类数据类别不均衡时,在 train_test_split 中设置 stratify=y,让训练集和测试集尽量保持原始类别比例,避免少数类只落入其中一侧。
基本语法
分层依据通常就是目标标签 y。拆分时仍会随机抽样,但每个类别分别按比例分配。
from collections import Counter
from sklearn.model_selection import train_test_split

X = [[i] for i in range(20)]
y = [0] * 16 + [1] * 4

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.25,
    random_state=42,
    stratify=y,  # 按类别分别抽样,保持 80%/20% 分布
)

print("全部:", Counter(y))
print("训练集:", Counter(y_train))
print("测试集:", Counter(y_test))
预期输出:
全部: Counter({0: 16, 1: 4})
训练集: Counter({0: 12, 1: 3})
测试集: Counter({0: 4, 1: 1})
读取方法:原数据中类别 0 与类别 1 的比例为 16:4,即 80%:20%;训练集和测试集仍保持 80%:20%。分层保证的是尽量接近原比例,不保证每次都能得到完全相同的整数比例。
高频用法
二分类和多分类任务通常直接使用 stratify=y。需要划分训练、验证、测试三部分时,第一次按 y 分层拆出测试集,第二次再用第一次得到的 y_train 作为分层依据拆验证集。
交叉验证场景使用 StratifiedKFold;如果同一用户、设备或病例不能跨折,应使用 StratifiedGroupKFold,同时满足类别比例与主体隔离。
风险与边界
少数类样本过少时,分层拆分可能报错。典型触发条件是某个类别只有 1 条数据,或测试集容量小到无法为每个类别至少分配 1 条。后果是无法完成拆分,或即使勉强拆分,评估方差也非常大。安全替代方案是补充样本、降低折数、扩大测试集,或合并业务上可合并的稀有类别。
分层只控制标签比例,不能阻止重复记录或同一主体跨集合泄漏。存在用户、设备、患者、门店等分组键时,应优先采用分组分层方法,而不是只传 stratify=y。
不要先对全量数据做 SMOTE、随机过采样或欠采样再拆分,否则合成样本及其近邻信息可能进入测试集。应先完成分层拆分,再只对训练集重采样。
排障清单
- 报错“least populated class has only 1 member”:某类别不足 2 条,先统计
Counter(y)。 - 报错测试集过小:增大
test_size,确保测试样本数不少于类别数。 - 拆分后比例偏差明显:检查样本量是否太小;整数取整会造成正常偏差。
- 少数类指标仍不稳定:增加测试样本,使用分层交叉验证,并同时查看召回率、F1 和混淆矩阵。
- 线上效果异常但离线很好:检查是否存在同主体跨集合、时间穿越或预处理泄漏。
兼容性
stratify 适用于离散类别标签。回归目标是连续值,不能直接把原始 y 作为分层依据;如确有需要,可先按业务合理区间分箱,但要避免箱数过多和每箱样本过少。
速查提示:类别不均衡用 stratify=y,主体相关数据用分组分层,重采样只对训练集执行。
划分时间序列数据按时间先后划分数据,避免未来信息泄漏到历史训练样本。
划分时间序列数据
按时间升序切分训练集、验证集和测试集,确保任何训练样本都早于评估样本。适用于预测、监控指标、销量、价格和日志等带时间顺序的数据。
基本规则
先按事件时间排序,再用较早区间训练、较晚区间验证、最新区间测试。不要使用 train_test_split(..., shuffle=True),也不要在全量数据上先标准化、填充或生成滚动特征。
当标签依赖未来窗口,例如用未来 7 天是否流失作为标签,训练集末尾与验证集开头之间应保留至少 7 天的间隔,避免标签窗口重叠。
可运行示例
下面同时演示一次性留出法和滚动验证。滚动验证会逐步扩大训练窗口,保持验证集始终位于训练集之后。
import pandas as pd
from sklearn.model_selection import TimeSeriesSplit

df = pd.DataFrame({
    "ts": pd.date_range("2026-01-01", periods=10, freq="D"),
    "y": range(10),
}).sort_values("ts").reset_index(drop=True)

cut = int(len(df) * 0.8)
train = df.iloc[:cut]
test = df.iloc[cut:]

print(f"holdout train: {train.ts.min():%Y-%m-%d} ~ {train.ts.max():%Y-%m-%d}")
print(f"holdout test : {test.ts.min():%Y-%m-%d} ~ {test.ts.max():%Y-%m-%d}")

tscv = TimeSeriesSplit(n_splits=3)
for fold, (train_idx, valid_idx) in enumerate(tscv.split(df), start=1):
    train_end = df.loc[train_idx[-1], "ts"]
    valid_start = df.loc[valid_idx[0], "ts"]
    valid_end = df.loc[valid_idx[-1], "ts"]
    print(
        f"fold {fold}: train<= {train_end:%Y-%m-%d}, "
        f"valid={valid_start:%Y-%m-%d}~{valid_end:%Y-%m-%d}"
    )
预期输出:
holdout train: 2026-01-01 ~ 2026-01-08
holdout test : 2026-01-09 ~ 2026-01-10
fold 1: train<= 2026-01-04, valid=2026-01-05~2026-01-06
fold 2: train<= 2026-01-06, valid=2026-01-07~2026-01-08
fold 3: train<= 2026-01-08, valid=2026-01-09~2026-01-10
读取时确认每个 valid 区间都晚于对应的 train 末日;实际日期和样本数会随数据变化。
常用参数
TimeSeriesSplit 常用参数如下:
n_splits:验证折数,折数越多,训练次数越多。test_size:每折验证集样本数;不指定时由样本量自动计算。gap:训练集末尾与验证集开头之间跳过的样本数,适合标签或特征存在未来窗口时。max_train_size:限制训练窗口长度,用于只保留近期数据的滑动窗口。
风险与边界
随机打乱会把未来模式泄漏到历史训练中,导致离线指标虚高;安全替代是按时间边界切分。若先在全量数据上拟合标准化器、编码器或缺失值填充器,也会产生泄漏,应只在每折训练集上 fit,再对验证集 transform。
多门店、多设备等面板数据应使用统一时间边界切分,不能仅按行号切分,否则同一时刻的不同实体可能跨集合。数据存在延迟到达时,应优先使用业务可获得时间,而不是事后修正时间。
排障清单
- 切分前确认时间列已转为日期类型、无倒序且时区一致。
- 检查训练集最大时间严格早于验证集最小时间。
- 检查滚动均值、累计量等特征是否只引用当前时刻之前的数据。
- 标签使用未来窗口时设置
gap,并核对窗口是否仍有交叉。 - 最终测试集只评估一次,不参与参数选择。
速查原则:任何预处理步骤都应随时间切分一起进入训练流程,不能提前在全量数据上拟合。
处理缺失值根据字段类型和缺失机制选择删除、统计填充或模型填充策略。
处理缺失值
先区分数值、类别和时间字段,再依据缺失比例、业务含义及缺失是否与目标相关选择策略。填充器只能在训练集上拟合,避免验证集或测试集信息泄漏。
策略选择
| 场景 | 推荐策略 | 注意点 |
|---|---|---|
| 缺失极少且近似随机 | 删除少量行或列 | 删除后检查样本分布是否变化 |
| 数值字段有异常值 | 中位数填充 | 通常比均值更稳健 |
| 类别字段缺失 | 众数或独立类别 UNKNOWN |
独立类别不得与真实值混淆 |
| 缺失本身有业务含义 | 填充并增加缺失指示列 | 让模型显式学习“是否缺失” |
| 字段关系强且缺失较复杂 | 迭代或模型填充 | 成本较高,必须用交叉验证确认收益 |
目标列通常不做普通填充。目标缺失时应追查标签生成流程,或在有明确业务依据时删除对应样本。
可运行示例
示例对数值列使用中位数,对类别列使用众数。fit_transform 只用于训练集,测试集仅调用 transform。
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer

train = pd.DataFrame({
    "age": [20, np.nan, 40, 30],
    "city": ["KL", np.nan, "KL", "Penang"],
})
test = pd.DataFrame({
    "age": [np.nan, 50],
    "city": ["Johor", np.nan],
})

imputer = ColumnTransformer(
    transformers=[
        ("num", SimpleImputer(strategy="median"), ["age"]),
        ("cat", SimpleImputer(strategy="most_frequent"), ["city"]),
    ],
)

train_array = imputer.fit_transform(train)
test_array = imputer.transform(test)

train_filled = pd.DataFrame(train_array, columns=["age", "city"])
test_filled = pd.DataFrame(test_array, columns=["age", "city"])
train_filled["age"] = train_filled["age"].astype(int)
test_filled["age"] = test_filled["age"].astype(int)

print("train")
print(train_filled.to_string(index=False))
print("test")
print(test_filled.to_string(index=False))
预期输出:
train
 age   city
  20     KL
  30     KL
  40     KL
  30 Penang
test
 age  city
  30 Johor
  50    KL
训练集 age 的中位数为 30,city 的众数为 KL;测试集缺失值沿用这两个训练集统计量。
高频用法
统计缺失比例时优先按列查看,并结合样本量判断,而不是只看缺失个数。
missing_rate = train.isna().mean()
print(missing_rate)
预期输出:
age     0.25
city    0.25
dtype: float64
缺失比例较高但字段仍有业务价值时,可增加指示列,例如 age_missing = age.isna().astype(int),再进行填充。这样模型可以同时使用填充值和缺失状态。
风险与边界
在全量数据上计算均值、中位数或众数会泄漏评估集分布,可能使指标虚高;安全做法是将填充器放进训练管道,每次只对当前训练折执行 fit。
直接用 0、空字符串或固定日期填充,若这些值本身合法,会让模型无法区分真实值与缺失值;应选用不会冲突的类别,或额外增加缺失指示列。删除非随机缺失样本可能改变人群分布,应先比较删除前后的目标率和关键字段分布。
模型填充只能生成估计值,不能恢复真实数据。若缺失比例过高、整列为空或线上缺失机制与训练期不同,应优先修复采集链路或降级使用更稳定的字段。
排障清单
- 分别统计训练集、验证集和线上样本的缺失比例,检查是否发生漂移。
- 确认填充器只在训练集拟合,验证集和测试集只做转换。
- 检查转换后是否仍存在
NaN,以及字段类型是否被意外转为字符串。 - 整列缺失时明确保留、删除或固定填充策略,避免列数变化。
- 类别填充后若继续做独热编码,应配置未知类别处理策略。
- 记录每个字段的填充值和缺失比例,便于线上复现与审计。
速查原则:先保护评估边界,再选择填充值;缺失状态有信息时,同时保留缺失指示列。
编码类别特征根据类别数量和是否有序选择独热编码、序数编码或目标编码。
编码类别特征
类别特征进入模型前,先判断它是否有明确顺序、类别数量是否可控,以及验证集是否可能出现新类别。无序且低基数用独热编码;有业务顺序用序数编码;高基数且样本充足时才考虑目标编码。
选择方法
| 情况 | 推荐方法 | 关键边界 |
|---|---|---|
| 城市、颜色、渠道等无序类别,类别较少 | 独热编码 | 维度会随类别数增长 |
| 风险等级、满意度等有明确顺序 | 序数编码 | 顺序必须由业务定义,不能按字母排序 |
| 商品、广告位等高基数类别 | 目标编码 | 必须防止标签泄漏,并处理低频类别 |
独热编码不会引入大小关系,适合线性模型、距离模型和神经网络。序数编码会把类别映射为整数,仅当整数顺序确实代表业务顺序时使用。目标编码把类别替换为该类别对应的目标统计量,通常需要交叉折外编码和平滑。
主示例
下面同时处理无序的 city 和有序的 level。编码器只在训练集上拟合,并为测试集中的未知城市输出全零向量。
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder

train = pd.DataFrame({
    "city": ["北京", "上海", "北京", "深圳"],
    "level": ["低", "中", "高", "中"],
})
test = pd.DataFrame({
    "city": ["上海", "广州"],
    "level": ["高", "低"],
})

encoder = ColumnTransformer(
    transformers=[
        (
            "city",
            OneHotEncoder(handle_unknown="ignore", sparse_output=False),
            ["city"],
        ),
        (
            "level",
            OrdinalEncoder(
                categories=[["低", "中", "高"]],
                handle_unknown="use_encoded_value",
                unknown_value=-1,
            ),
            ["level"],
        ),
    ],
    verbose_feature_names_out=False,
)

encoder.fit(train)
print(encoder.get_feature_names_out().tolist())
print(encoder.transform(test).astype(int).tolist())
预期输出
['city_上海', 'city_北京', 'city_深圳', 'level']
[[1, 0, 0, 2], [0, 0, 0, 0]]第一行给出编码后列名;第二行中,广州 未在训练集出现,因此三个城市列均为 0。level 按“低、中、高”映射为 0、1、2。
目标编码的安全用法
目标编码只适合有监督学习。训练集中的每一行应使用“不包含该行标签”的折外统计量;验证集和测试集只能使用完整训练集得到的映射。低频类别应向全局均值平滑,未知类别回退到全局均值。
当类别与标签高度相关但样本很少时,直接按全量训练集均值编码会把标签信息泄漏到特征中,导致离线指标虚高、线上效果下降。安全替代方案是交叉折外目标编码,或先使用哈希编码、频次编码和支持稀疏输入的模型。
排障清单
- 训练正常、预测报未知类别:确认独热编码设置了
handle_unknown="ignore",序数编码设置了未知值。 - 线性模型出现异常“大小关系”:检查是否把无序类别错误地做成整数编码。
- 特征维度突然暴涨:统计类别基数,合并低频类别或改用哈希、频次、目标编码。
- 验证分数异常高、上线明显下降:检查目标编码是否在切分数据前计算,或是否直接使用了当前行标签。
速查:无序低基数选独热,有序类别选序数,高基数目标编码必须采用折外统计并防泄漏。
缩放数值特征为距离模型、线性模型和神经网络选择标准化或归一化方法。
缩放数值特征
当模型依赖距离、梯度或正则化时,需要让数值特征处于可比较的尺度。近似对称分布通常用标准化;需要固定区间或输入受激活函数约束时用归一化;离群点明显时优先考虑稳健缩放。
选择方法
| 方法 | 变换方式 | 适用场景 | 主要边界 |
|---|---|---|---|
标准化 StandardScaler |
减均值后除以标准差 | 线性模型、SVM、KNN、PCA、神经网络 | 对极端离群点敏感 |
归一化 MinMaxScaler |
映射训练集最小值和最大值到指定区间 | 图像像素、受范围约束的输入 | 测试值超出训练范围时结果可超过区间 |
稳健缩放 RobustScaler |
使用中位数和四分位距 | 长尾分布、存在明显异常值 | 不保证均值为 0 或范围固定 |
决策树、随机森林和基于分裂阈值的梯度提升树通常不依赖特征尺度;除非同一流水线还包含距离计算、正则化线性层或神经网络,否则不必机械缩放。
主示例
缩放器只在训练集上 fit,测试集只能调用 transform。这样可以避免把测试集的均值、标准差或极值泄漏到训练过程。
import numpy as np
from sklearn.preprocessing import MinMaxScaler, StandardScaler

x_train = np.array([
    [10.0, 100.0],
    [20.0, 200.0],
    [30.0, 300.0],
])
x_test = np.array([[40.0, 150.0]])

standard = StandardScaler().fit(x_train)
minmax = MinMaxScaler().fit(x_train)

print("standard:", np.round(standard.transform(x_test), 3).tolist())
print("minmax:", np.round(minmax.transform(x_test), 3).tolist())
预期输出
standard: [[2.449, -0.612]]
minmax: [[1.5, 0.25]]
标准化结果表示第一列比训练均值高约 2.449 个标准差。归一化第一列得到 1.5,说明测试值 40 超过训练集最大值 30;MinMaxScaler 默认不会自动截断到 [0, 1]。
风险与边界
在全量数据上先缩放再划分训练集,会把验证集和测试集统计量泄漏给模型,造成评估偏乐观。安全做法是先划分数据,再只对训练集拟合缩放器;交叉验证时把缩放器与模型放进同一个 Pipeline。
训练期间存在极端异常值时,标准差和最大值会被拉大,正常样本被压缩到很窄的范围,可能降低距离模型和神经网络的可分性。应先确认异常值是否为数据错误;合法长尾数据可改用 RobustScaler、对数变换或分位数变换。
线上输入若使用另一套单位或漏掉缩放步骤,模型输出会整体漂移。应将已拟合的缩放器与模型一起保存和发布,不要在服务启动后根据实时请求重新计算统计量。
排障清单
- 训练分数正常、线上预测漂移:核对字段单位、列顺序和缩放器版本是否与训练一致。
- 交叉验证分数异常高:确认缩放步骤位于
Pipeline内,而不是在交叉验证前对全量数据执行。 - 归一化结果出现负数或大于
1:检查线上值是否超出训练集范围;这不是计算错误。 - 某列变换后全为
0:该列在训练集中可能是常量,需确认是否应删除或保留。
速查:依赖距离和梯度的模型先缩放;标准化最常用,固定范围用归一化,异常值明显用稳健缩放;所有统计量只从训练集获得。
处理类别不平衡通过类别权重、重采样和阈值调整改善少数类别识别效果。
处理类别不平衡
当少数类别漏判明显、整体准确率却看似很高时,先用类别权重建立基线,再按业务成本选择重采样或阈值调整。评估时重点查看少数类召回率、精确率、F1 和 PR-AUC,不要只看 accuracy。
类别权重与阈值调整
类别权重不改变样本数量,适合逻辑回归、支持向量机和部分树模型。阈值调整用于在召回率与误报率之间重新取舍,必须在独立验证集上确定。
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split

X, y = make_classification(
    n_samples=1000,
    n_features=10,
    weights=[0.95, 0.05],
    random_state=42,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42
)

model = LogisticRegression(class_weight="balanced", max_iter=1000)
model.fit(X_train, y_train)

proba = model.predict_proba(X_test)[:, 1]
for threshold in (0.50, 0.30):
    pred = (proba >= threshold).astype(int)
    print(f"threshold={threshold}")
    print(classification_report(y_test, pred, digits=3))
预期输出会分别展示阈值 0.50 和 0.30 的分类报告。具体数值随运行环境略有变化;通常降低阈值会提高类别 1 的召回率,同时降低精确率。
threshold=0.5
              precision    recall  f1-score   support
           0      <VALUE>   <VALUE>   <VALUE>       285
           1      <VALUE>   <VALUE>   <VALUE>        15

threshold=0.3
              precision    recall  f1-score   support
           0      <VALUE>   <VALUE>   <VALUE>       285
           1      <VALUE>   <VALUE>   <VALUE>        15
重采样
随机过采样适合少数类样本尚有代表性、但数量不足的场景;欠采样适合多数类规模远大于训练需要的场景。只对训练集重采样,验证集和测试集必须保留真实分布。
片段示例:沿用上例的 X_train 和 y_train,将少数类随机复制到与多数类相同数量。
import numpy as np
from sklearn.utils import resample

majority_idx = np.where(y_train == 0)[0]
minority_idx = np.where(y_train == 1)[0]

minority_up = resample(
    minority_idx,
    replace=True,
    n_samples=len(majority_idx),
    random_state=42,
)
balanced_idx = np.concatenate([majority_idx, minority_up])

X_balanced = X_train[balanced_idx]
y_balanced = y_train[balanced_idx]
print(np.bincount(y_balanced))
预期输出中的两个计数相同,表示训练样本已平衡;实际数量由训练集划分决定。
[<COUNT> <COUNT>]风险与边界
随机过采样会重复少数类样本,样本极少时容易过拟合;安全替代方案是先使用类别权重,并通过分层交叉验证确认收益。欠采样会丢失多数类信息,可能降低正常样本识别能力;应保留未采样的验证集进行对照。阈值降低过多会放大误报,生产前应明确可接受的精确率下限或单次误报成本。
排障清单
- 划分数据时是否使用
stratify=y,避免少数类在某个集合中缺失。 - 重采样是否只发生在训练集,且位于交叉验证的每个训练折内。
- 混淆矩阵中是否同时检查漏报和误报,而非只比较准确率。
- 线上类别比例变化后,是否重新校准概率和决策阈值。
选择有效特征使用过滤法、包装法或嵌入法删除无效和冗余特征。
选择有效特征
当特征数量过多、训练变慢、验证集效果下降或模型解释不稳定时,先用过滤法清理明显无效特征,再用嵌入法或包装法缩小候选集。特征选择器必须只在训练数据上拟合。
三种方法速查
过滤法按方差、相关性或统计检验打分,速度快,适合作为第一轮筛选。嵌入法在模型训练过程中选择特征,例如树模型重要性或正则化系数。包装法反复训练模型比较特征子集,通常更慢,但能直接围绕模型效果筛选。
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from sklearn.feature_selection import (
    RFE,
    SelectFromModel,
    SelectKBest,
    VarianceThreshold,
    f_classif,
)
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline

X, y = make_classification(
    n_samples=500,
    n_features=12,
    n_informative=5,
    n_redundant=3,
    random_state=42,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

filter_selector = Pipeline([
    ("variance", VarianceThreshold(threshold=0.0)),
    ("kbest", SelectKBest(score_func=f_classif, k=5)),
])
X_filter = filter_selector.fit_transform(X_train, y_train)

embedded_selector = SelectFromModel(
    RandomForestClassifier(n_estimators=100, random_state=42),
    threshold="median",
)
X_embedded = embedded_selector.fit_transform(X_train, y_train)

wrapper_selector = RFE(
    estimator=LogisticRegression(max_iter=1000),
    n_features_to_select=5,
    step=1,
)
X_wrapper = wrapper_selector.fit_transform(X_train, y_train)

print("filter:", X_filter.shape)
print("embedded:", X_embedded.shape)
print("wrapper:", X_wrapper.shape)
预期输出显示三种方法保留后的训练集形状。过滤法和包装法固定保留 5 个特征;嵌入法使用中位数阈值,本例通常保留约一半特征。
filter: (375, 5)
embedded: (375, 6)
wrapper: (375, 5)
选择顺序
特征数上百或上千时,先删除常量列、近零方差列和明显重复列,再用过滤法保留较小候选集。随后将筛选器与模型放入同一个 Pipeline,通过交叉验证比较不同特征数量。训练成本可控且需要进一步压缩时,再使用 RFE 等包装法。
输出读取
transform 后数组的第二维就是保留特征数。过滤法可通过 get_support() 获取保留位置;RFE.ranking_ 中排名为 1 的特征会被选中。上线时应保存完整流水线,而不是只记录特征名称,避免预处理和列顺序不一致。
风险与边界
在全量数据上先筛特征再划分,会把测试集信息泄漏到训练过程,导致指标虚高;安全方案是先划分数据,并让选择器在交叉验证的训练折内拟合。单变量过滤法可能删除组合后才有效的特征,应以验证集效果复核。树模型重要性可能偏向取值多或切分点多的特征,必要时用置换重要性再次验证。
排障清单
- 训练、验证和线上输入列是否保持相同名称、顺序和数据类型。
- 编码、标准化和特征选择是否封装在同一个
Pipeline中。 - 每个交叉验证折是否重新拟合选择器,避免数据泄漏。
- 精简后是否同时比较验证指标、训练耗时和推理延迟。
通过 PCA 压缩连续特征并缓解高维数据的共线性问题。
使用主成分分析
PCA 用于把多个相关的连续特征压缩为较少的主成分,在尽量保留总体方差的同时降低维度。适合特征数量较多、共线性明显,且下游模型不要求直接解释原始特征系数的场景。
什么时候用
当多个数值特征高度相关、训练速度受维度影响,或需要在建模前压缩噪声时使用 PCA。主成分是原始特征的线性组合,第一主成分保留最大方差,后续主成分依次保留剩余方差且彼此正交。
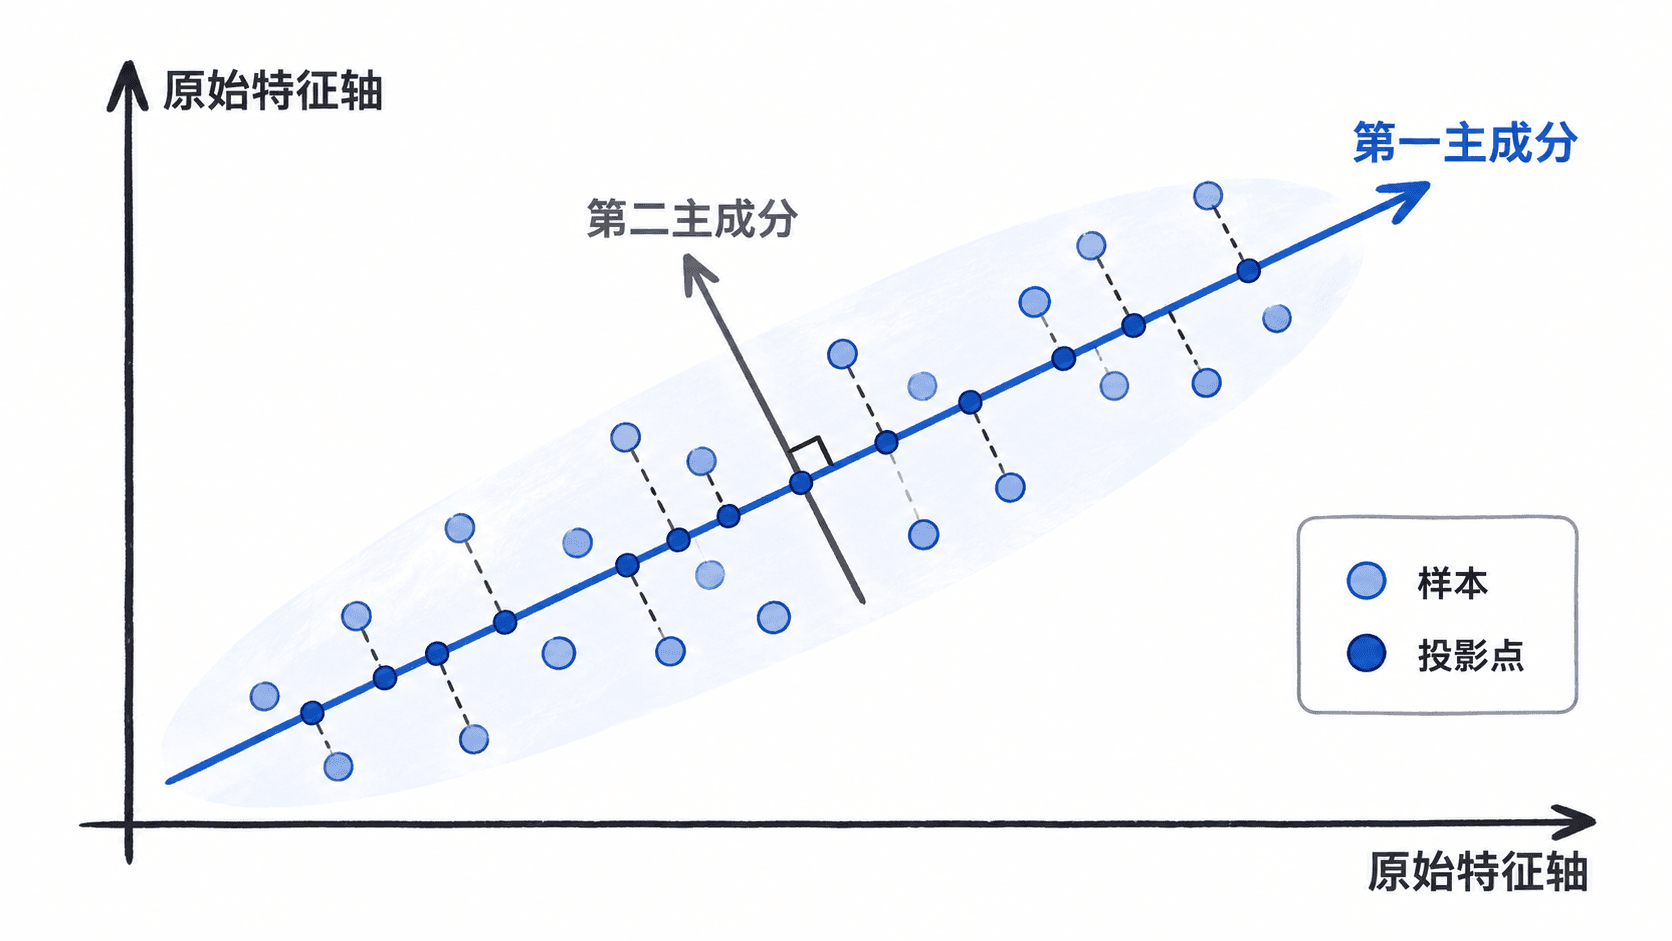
基本语法
先标准化再拟合 PCA,避免量纲较大的特征主导主成分。下面把两个完全共线的特征压缩为一维。
import numpy as np
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

def main() -> None:
    X = np.array([
        [1.0, 2.0],
        [2.0, 4.0],
        [3.0, 6.0],
        [4.0, 8.0],
    ])

    # 标准化器和 PCA 都只能在训练数据上拟合,避免数据泄漏。
    X_scaled = StandardScaler().fit_transform(X)
    pca = PCA(n_components=1)
    X_reduced = pca.fit_transform(X_scaled)

    print("explained_variance_ratio:", np.round(pca.explained_variance_ratio_, 3).tolist())
    print("components:", np.round(pca.components_, 3).tolist())
    print("reduced:", np.round(X_reduced, 3).tolist())

if __name__ == "__main__":
    main()
预期输出:
explained_variance_ratio: [1.0]
components: [[0.707, 0.707]]
reduced: [[-1.897], [-0.632], [0.632], [1.897]]
explained_variance_ratio 表示各主成分保留的方差比例;本例为 1.0,说明一维已保留全部变化。components 是主成分对原始标准化特征的权重。主成分整体正负号在数学上等价,其他实现可能输出符号相反但含义不变。
高频用法
- 固定维度:
PCA(n_components=20),用于明确限制模型输入宽度。 - 按方差保留:
PCA(n_components=0.95),自动选择累计解释方差达到 95% 的最少维度。 - 训练流水线:把
StandardScaler、PCA和模型放入同一个Pipeline,交叉验证时每折独立拟合。 - 查看压缩效果:累计求和
explained_variance_ratio_,选择拐点或满足业务精度的最小维度。
风险与边界
未标准化且特征量纲差异大时,大数值特征会主导主成分,造成错误压缩;安全做法是先标准化,只有单位和尺度天然一致时才考虑省略。若在全量数据上先拟合 PCA,再划分训练集和测试集,会把测试集分布泄漏给模型并抬高评估结果;应只在训练集拟合,生产中优先使用 Pipeline。
PCA 是线性变换,无法展开明显的非线性流形;此时可评估 Kernel PCA 或其他非线性降维方法。主成分也不等于原始业务特征,需要逐项解释系数时,优先使用特征选择、Ridge 或保留原始特征。
排障清单
- 输入含
NaN或无穷值:先完成缺失值填补和异常值处理。 n_components报错:确认其不大于样本数与特征数中的较小值。- 压缩后模型变差:检查保留方差是否过低,并比较不同维度的交叉验证结果。
- 第一主成分占比仍很低:特征可能相关性弱或噪声较多,不要为压缩而强行减少维度。
选择线性回归在线性关系明显且需要可解释系数时使用线性回归预测连续值。
选择线性回归
线性回归用于预测连续值,并用系数说明各特征与目标值的线性关系。适合关系近似线性、需要可解释系数,且训练数据覆盖实际预测范围的场景。
适用条件
目标变量应为连续数值,特征变化对目标的影响近似可加。判断是否适合时,不只看训练集的 ,还要检查测试误差、残差是否呈明显曲线,以及极端样本是否显著拉动拟合结果。
基本语法
下面拟合关系 y = 2x + 1,并预测 x = 5 时的结果。
import numpy as np
from sklearn.linear_model import LinearRegression

def main() -> None:
    X = np.array([[1.0], [2.0], [3.0], [4.0]])
    y = np.array([3.0, 5.0, 7.0, 9.0])

    model = LinearRegression()
    model.fit(X, y)

    prediction = model.predict(np.array([[5.0]]))
    print("coefficient:", round(float(model.coef_[0]), 3))
    print("intercept:", round(float(model.intercept_), 3))
    print("r2:", round(float(model.score(X, y)), 3))
    print("prediction:", round(float(prediction[0]), 3))

if __name__ == "__main__":
    main()
预期输出:
coefficient: 2.0
intercept: 1.0
r2: 1.0
prediction: 11.0
coefficient 表示 x 每增加 1 个单位,预测值平均增加 2;intercept 是所有特征为 0 时的基线预测。r2 衡量样本内拟合程度,本例数据完全在线上,因此为 1.0;生产判断应使用独立验证集或交叉验证结果。
高频用法
- 多特征回归:让
X包含多列,每个coef_与一列特征按顺序对应。 - 类别特征:先用独热编码,再与数值特征共同进入
Pipeline,不能直接把类别编号当作连续大小。 - 共线性明显:改用 Ridge 稳定系数;需要自动压缩部分系数时评估 Lasso。
- 目标分布右偏且误差随数值增大:可验证对目标取对数后建模,并在预测后执行反变换。
风险与边界
当预测值超出训练特征范围时,线性回归仍会沿直线外推,可能产生负数或不合理的大值;应限制预测范围、增加业务边界,或改用能表达非线性的模型。存在强共线性时,整体预测可能稳定但单个系数会大幅波动,导致解释失真;可删除重复特征、使用 Ridge,或先做降维。
少量离群点可能明显拉偏最小二乘解;应先确认离群点是否为数据错误,真实重尾数据可评估 HuberRegressor 或 RANSAC。若先用全量数据做标准化、编码或特征筛选,会造成数据泄漏;所有预处理都应在训练折内拟合。
排障清单
- 训练分数高、测试分数低:检查过拟合、数据泄漏和训练测试分布差异。
- 残差呈 U 形或波浪形:线性关系不足,可增加合理的非线性特征或更换模型。
- 系数符号频繁变化:检查共线性、样本量和异常值,并比较 Ridge 结果。
- 预测出现负值但业务不允许:增加目标变换或业务后处理,不要把截断后的训练指标当作原始模型指标。
选择岭回归在特征相关性较强或模型容易过拟合时使用 L2 正则化。
选择岭回归
当多个数值特征高度相关、普通线性回归的系数波动很大,且你仍希望保留全部特征时,优先使用岭回归。它通过 L2 正则化压缩系数,通常能降低方差并改善未见数据上的稳定性,但不会主动把系数压成零。
选择条件
适合以下情况:
- 多个特征表达近似信息,例如面积、房间数和总价相关指标同时存在。
- 训练集表现很好、验证集误差明显升高,怀疑线性模型过拟合。
- 需要保留全部特征,不希望模型自动删除变量。
- 特征数较多、样本较少,但目标与特征仍近似线性关系。
若明确需要稀疏特征选择,改用套索回归;若关系明显非线性,应先增加合理的非线性特征或选择树模型。
基本语法
岭回归最小化“平方误差 + L2 惩罚”。alpha 越大,系数收缩越强;alpha=0 等价于无正则的最小二乘,实际应直接使用 LinearRegression。数值特征量纲不一致时,应把标准化与模型放进同一条 Pipeline,避免数据泄漏。
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X = np.array([
    [1.0, 1.1, 0.0],
    [2.0, 2.0, 1.0],
    [3.0, 3.1, 0.0],
    [4.0, 4.2, 1.0],
    [5.0, 5.1, 0.0],
    [6.0, 6.2, 1.0],
])
y = np.array([2.1, 4.0, 6.2, 8.1, 10.1, 12.2])

# 标准化只在 fit 阶段学习训练数据统计量,预测时自动复用。
model = make_pipeline(StandardScaler(), Ridge(alpha=1.0))
model.fit(X, y)

ridge = model.named_steps["ridge"]
print("coef:", np.round(ridge.coef_, 3))
print("intercept:", round(ridge.intercept_, 3))
print("prediction:", np.round(model.predict([[7.0, 7.1, 0.0]]), 3))
print("train_r2:", round(model.score(X, y), 4))
预期输出:
coef: [1.589 1.584 0.044]
intercept: 7.117
prediction: [13.477]
train_r2: 0.9935
coef_ 是标准化后特征空间中的系数,不能直接按原始单位解释;prediction 是新样本预测值;train_r2 只用于确认示例运行正常,生产判断应查看独立验证集或交叉验证得分。
常用参数
| 参数 | 什么时候调整 |
|---|---|
alpha |
正则强度。验证集过拟合时增大,明显欠拟合时减小;优先用 RidgeCV 在候选值中选择。 |
fit_intercept |
数据已人工中心化时可设为 False,否则保持默认。 |
solver |
默认 auto 通常足够;大规模稀疏数据再按数据形态选择迭代求解器。 |
positive |
业务明确要求系数非负时设为 True,否则不要强加约束。 |
风险与边界
未标准化就直接正则化时,大量纲特征受到的惩罚相对失衡,可能导致系数和预测偏离预期;安全做法是使用 Pipeline(StandardScaler(), Ridge(...))。在全量数据上先标准化再划分训练集会泄漏验证集分布,应先划分数据,再由 Pipeline 在训练折内拟合。
岭回归不会完成特征删除。把小系数直接当作“无用特征”可能误判,尤其在强相关特征间,权重会被分摊。需要可复现的稀疏选择时,应比较套索回归或弹性网络,并检查交叉验证稳定性。
排障清单
- 验证集误差仍高:同时检查线性假设、异常值、遗漏变量和
alpha范围。 - 系数绝对值异常:确认所有数值列已标准化,类别列已正确编码。
- 训练分数高、线上效果差:检查时间穿越、重复样本和预处理泄漏。
- 更换求解器后不收敛:提高
max_iter、放宽tol,并确认特征尺度接近。
速查:强相关特征、全部保留、追求稳定预测时选岭回归;alpha 用交叉验证确定,不凭训练集分数拍值。
选择套索回归需要自动压缩部分特征系数并进行稀疏特征选择时使用 L1 正则化。
选择套索回归
当你需要线性回归同时完成系数收缩和稀疏特征选择时,使用套索回归。它通过 L1 正则化把部分系数精确压到零,便于得到更紧凑的模型,但在强相关特征之间可能只保留其中一个,选择结果不一定稳定。
选择条件
适合以下情况:
- 候选特征很多,预期只有少量特征真正有效。
- 希望模型自动产生零系数,降低后续解释或部署成本。
- 可接受在相关特征组中保留代表变量,而不是保留全部变量。
- 目标与特征近似线性,并且样本量足以支持交叉验证。
若所有相关特征都应保留,优先使用岭回归;若既要稀疏性又要缓解相关特征的不稳定选择,可使用弹性网络。
基本语法
alpha 控制 L1 惩罚强度:值越大,更多系数会变为零;值过大可能把有效特征一并删除。套索对特征尺度敏感,应在 Pipeline 中标准化,并用验证集或 LassoCV 选择正则强度。
import numpy as np
from sklearn.linear_model import Lasso
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X = np.array([
    [1.0, 1.1, 0.0],
    [2.0, 2.0, 1.0],
    [3.0, 3.1, 0.0],
    [4.0, 4.2, 1.0],
    [5.0, 5.1, 0.0],
    [6.0, 6.2, 1.0],
])
y = np.array([2.1, 4.0, 6.2, 8.1, 10.1, 12.2])

# max_iter 留出足够迭代次数,避免在小 alpha 下提前停止。
model = make_pipeline(
    StandardScaler(),
    Lasso(alpha=0.1, max_iter=10000),
)
model.fit(X, y)

lasso = model.named_steps["lasso"]
print("coef:", np.round(lasso.coef_, 3))
print("selected:", np.flatnonzero(lasso.coef_ != 0).tolist())
print("prediction:", np.round(model.predict([[7.0, 7.1, 0.0]]), 3))
print("train_r2:", round(model.score(X, y), 4))
预期输出:
coef: [2.724 0.627 0.   ]
selected: [0, 1]
prediction: [13.944]
train_r2: 0.9989
coef_ 中第三个系数为零,表示该特征在当前数据和 alpha=0.1 下未被选中;selected 返回保留特征的列索引。零系数是模型在当前训练条件下的结果,不等同于业务上永久无效。
常用参数
| 参数 | 什么时候调整 |
|---|---|
alpha |
控制稀疏程度。零系数过多时减小,过拟合或保留特征过多时增大;生产中优先使用 LassoCV。 |
max_iter |
出现未收敛警告时提高,但应先确认已标准化。 |
tol |
收敛精度;调大可更快停止,但可能降低系数精度。 |
selection |
默认 cyclic 结果稳定;高维数据可试 random,并设置 random_state 保证复现。 |
风险与边界
强相关特征同时存在时,套索可能在它们之间任意选择一个。数据轻微变化就可能换成另一个特征,导致解释不稳定;安全做法是检查多折交叉验证中的入选频率,或改用弹性网络。
alpha 过大时,有效特征会被压成零并造成欠拟合;过小时模型接近普通线性回归,稀疏效果消失且可能需要更多迭代。不要根据训练集最高分选择 alpha,应使用独立验证集、时间序列验证或嵌套交叉验证。
排障清单
- 出现
ConvergenceWarning:先标准化,再提高max_iter,必要时适度增大tol。 - 所有系数均为零:减小
alpha,并检查目标值和特征是否有有效变化。 - 入选特征每次不同:固定数据划分与随机种子,检查相关矩阵,考虑弹性网络。
- 验证集性能明显下降:扩大
alpha搜索范围,同时排查异常值和非线性关系。
速查:需要零系数和紧凑模型时选套索回归;特征强相关且都重要时,不要把一次 L1 选择结果直接当作最终结论。
选择逻辑回归在分类边界近似线性且需要输出概率和解释系数时使用逻辑回归。
选择逻辑回归
当目标是二分类或多分类、决策边界近似线性,并且需要类别概率、特征方向或可解释基线时,优先尝试逻辑回归。它通常适合经过编码的表格数据,也常作为上线前的基准模型。LogisticRegression 默认带正则化,可处理稠密或稀疏特征。:contentReference[oaicite:0]{index=0}
选择条件
适合以下情况:
- 需要
predict_proba输出概率,再按业务成本调整分类阈值。 - 特征与对数几率近似线性,或已通过分箱、交互项扩展线性表达能力。
- 需要读取系数正负方向,快速判断特征对类别的推动作用。
- 样本量较大、特征较多,希望训练和预测成本可控。
若边界明显弯曲、特征间存在复杂条件组合,逻辑回归容易欠拟合,应与决策树、梯度提升树等模型交叉验证比较。
基本语法
下面使用标准化流水线训练模型。标准化应放入 Pipeline,避免训练集之外的数据参与均值和方差计算。
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X = np.array([
    [0, 0], [0, 1], [1, 0], [1, 1],
    [2, 1], [1, 2], [2, 2], [3, 2],
], dtype=float)
y = np.array([0, 0, 0, 0, 1, 1, 1, 1])

model = make_pipeline(
    StandardScaler(),
    LogisticRegression(C=1.0, max_iter=1000, random_state=42),
)
model.fit(X, y)

sample = np.array([[1.5, 1.0]])
classifier = model.named_steps["logisticregression"]
print("classes:", classifier.classes_.tolist())
print("prediction:", int(model.predict(sample)[0]))
print("probability:", np.round(model.predict_proba(sample)[0], 3).tolist())
预期输出:
classes: [0, 1]
prediction: 1
probability: [0.473, 0.527]
probability 的位置与 classes 一一对应,本例中类别 1 的概率为 0.527。概率刚超过默认阈值 0.5,因此预测为 1。
常用参数
C:正则化强度的倒数。值越小,约束越强,系数通常越小;过小可能欠拟合。class_weight="balanced":类别严重不均衡时按样本频率自动加权,但仍应检查精确率、召回率和业务阈值。max_iter:最大迭代次数。出现未收敛警告时,先标准化特征,再适当提高该值。solver与penalty:必须使用兼容组合;切换前查看当前 scikit-learn 文档,而不是盲目替换。:contentReference[oaicite:1]{index=1}
风险与边界
类别特征必须先编码,缺失值必须有明确填补策略。若直接把类别编号当连续数值,模型会错误地解释大小和间距关系。
高度相关的特征会让单个系数不稳定,可能导致解释结论随样本变化。安全做法是删除冗余特征、加强正则化,并同时观察交叉验证结果,而不是只看一次训练得到的系数。
类别不均衡时,准确率可能很高但少数类几乎无法识别。应查看混淆矩阵、PR-AUC 或召回率,并根据误报和漏报成本调整阈值。
排障清单
- 出现
ConvergenceWarning:检查量纲差异、异常值和共线性,再增加max_iter。 - 训练分数和验证分数都低:增加合理交互特征,或改用能表达非线性关系的模型。
- 概率排序可用但阈值效果差:在独立验证集上选择阈值,必要时做概率校准。
- 系数方向与业务认知冲突:确认编码方式、类别基准、数据泄漏和强相关特征。
选择决策树需要处理非线性关系、混合特征并生成直观决策规则时使用决策树。
选择决策树
当分类规则包含明显阈值、条件组合或非线性关系,并且需要导出接近“如果……那么……”的决策路径时,可优先尝试决策树。它无需特征标准化,能直接学习数值特征之间的分裂规则,但单棵树必须限制复杂度。:contentReference[oaicite:2]{index=2}
选择条件
适合以下情况:
- 同时存在不同量纲的数值特征,不希望为距离或线性模型做标准化。
- 目标关系由多个阈值和条件分支组成,例如“年龄大于某值且风险等级较高”。
- 需要把模型规则导出给业务、审核或排障人员检查。
- 需要一个能快速发现非线性和特征交互的基线模型。
若数据噪声大、样本较少或要求预测稳定,单棵树容易随训练样本变化,应限制树深或改用随机森林、梯度提升树。
基本语法
下面训练一棵深度受限的分类树,并输出预测、叶节点概率和文本规则。
import numpy as np
from sklearn.tree import DecisionTreeClassifier, export_text

X = np.array([
    [22, 0], [25, 0], [28, 0], [35, 0],
    [40, 1], [45, 1], [50, 1], [55, 1],
], dtype=float)
y = np.array([0, 0, 0, 0, 1, 1, 1, 1])

model = DecisionTreeClassifier(
    max_depth=2,
    min_samples_leaf=2,
    random_state=42,
)
model.fit(X, y)

sample = np.array([[38, 0]], dtype=float)
print("prediction:", int(model.predict(sample)[0]))
print("probability:", np.round(model.predict_proba(sample)[0], 3).tolist())
print(export_text(model, feature_names=["age", "has_house"]))
预期输出:
prediction: 1
probability: [0.0, 1.0]
|--- age <= 37.50
|   |--- class: 0
|--- age >  37.50
|   |--- class: 1
规则从上向下读取:样本 age=38 进入右分支,最终落到类别 1。概率来自该叶节点中的训练样本分布,不代表天然经过校准的业务风险概率。
常用参数
max_depth:限制路径深度,是抑制过拟合最直接的参数。min_samples_leaf:限制每个叶节点的最少样本数;值过小会生成只适配少量样本的规则。min_samples_split:控制节点继续分裂所需的最少样本数。class_weight="balanced":类别不均衡时提高少数类权重,但必须结合混淆矩阵验证实际收益。criterion:选择分裂质量指标;不要只凭训练分数决定,应用交叉验证比较。:contentReference[oaicite:3]{index=3}
高频用法
需要解释规则时,可用 export_text 输出文本;规则较深时先减小 max_depth,否则导出的内容难以审核。官方工具能生成树的文本报告,但其展示格式不应作为长期稳定的接口协议。:contentReference[oaicite:4]{index=4}
需要评估特征作用时,可查看 feature_importances_,但不要把它当作因果解释。高基数或可产生大量候选切分的特征可能获得偏高的重要性,应结合置换重要性和业务验证。
风险与边界
不限制深度时,树会持续切分直到叶节点很纯,触发条件是样本足够且仍能找到收益;后果是训练分数很高、验证性能下降。安全做法是同时设置 max_depth、min_samples_leaf,并通过交叉验证选择范围。
类别特征若用整数编码,树会按数值阈值切分,可能制造不存在的顺序关系。应使用适合的编码方式,并警惕独热编码后形成大量稀疏分支。
单棵树对数据扰动敏感,相邻批次可能得到不同首层规则。生产中应固定数据切分和 random_state,监控规则漂移;稳定性要求高时优先使用集成树模型。
排障清单
- 训练准确率接近
1.0、验证明显下降:减小max_depth,增大min_samples_leaf。 - 规则数量过多:删除泄漏或高基数特征,并加强剪枝约束。
- 概率大量为
0或1:叶节点样本太少,增大min_samples_leaf,必要时做概率校准。 - 线上规则与导出规则不一致:确认使用的是同一模型文件、同一特征顺序和同一预处理流程。
选择随机森林需要稳定处理非线性表格数据并降低单棵决策树方差时使用随机森林。
选择随机森林
当表格数据存在明显非线性、特征交互较多,并且希望比单棵决策树更稳定时,优先使用随机森林。它通常不需要标准化,能直接处理连续特征和已编码的类别特征,适合作为分类或回归任务的稳健基线。
何时优先选择
适合样本量中等、特征数量不太高的结构化数据,例如风控、流失预测、设备故障分类和销量回归。模型通过多棵树投票或平均降低单棵树的方差,对异常值和特征尺度通常不敏感。
以下情况可先考虑其他模型:需要线性外推时用线性模型;超高维稀疏文本可先试线性分类器;要求极低推理延迟时应限制树数量与深度,或改用更轻量模型。
基本用法
下面示例生成二分类数据,固定随机种子训练模型,并输出准确率、混淆矩阵和最重要特征索引。
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, confusion_matrix
from sklearn.model_selection import train_test_split

X, y = make_classification(
    n_samples=800,
    n_features=10,
    n_informative=6,
    n_redundant=2,
    class_sep=1.0,
    random_state=42,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

model = RandomForestClassifier(
    n_estimators=300,
    max_features="sqrt",
    min_samples_leaf=2,
    random_state=42,
    n_jobs=-1,
)
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(f"accuracy={accuracy_score(y_test, pred):.3f}")
print("confusion_matrix=")
print(confusion_matrix(y_test, pred))
print(f"top_feature={model.feature_importances_.argmax()}")
预期输出:
accuracy=0.920
confusion_matrix=
[[91  9]
 [ 7 93]]
top_feature=5
accuracy 是整体命中率;混淆矩阵第一行对应真实类别 0,第二行对应真实类别 1;top_feature=5 表示第 6 个输入特征的重要性最高。不同 scikit-learn 小版本可能出现末位轻微差异,但读取方式不变。
常用参数
| 参数 | 作用 | 速查建议 |
|---|---|---|
n_estimators |
树的数量 | 先用 200~500;继续增加通常更稳,但训练和推理更慢 |
max_depth |
单棵树最大深度 | 训练集明显高于验证集时限制深度 |
min_samples_leaf |
叶节点最少样本数 | 从 1 调到 2、5、10,可抑制过拟合并平滑概率 |
max_features |
每次分裂候选特征数 | 分类常用 "sqrt";特征很少时可适当增大 |
class_weight |
类别权重 | 类别不平衡时尝试 "balanced",仍需检查召回率 |
n_jobs |
并行线程数 | 本地可用 -1;共享服务器应限制线程避免抢占资源 |
风险与边界
当训练集含目标泄漏字段,例如“退款结果”“人工审核结论”或未来时间窗口统计时,模型会得到虚高验证分数,上线后迅速失效。安全做法是按业务时间切分数据,并在建模前逐列检查字段产生时间。
当类别特征直接使用任意整数编码时,树可能把编号误当作有序数值,导致不合理切分。无序类别应使用独热编码、目标编码的无泄漏实现,或选择原生支持类别特征的算法。
树数量过多且深度不受限会放大内存、模型文件和推理延迟。上线前应记录模型大小与单批耗时,并通过 max_depth、min_samples_leaf 或减少 n_estimators 控制资源。
排障清单
- 训练分数高、验证分数低:先限制
max_depth,提高min_samples_leaf,再检查数据泄漏。 - 少数类几乎识别不到:查看混淆矩阵和召回率,设置
class_weight="balanced",不要只看准确率。 - 训练耗时过长:减少树数量,限制深度,确认
n_jobs没有在容器中造成线程争抢。 - 特征重要性被高基数特征占据:不要只依赖
feature_importances_,改用置换重要性并结合业务验证。
速查结论:需要稳定、低预处理成本的非线性表格模型时先选随机森林;效果确认后再围绕深度、叶节点样本数和树数量做小范围调参。
选择极端随机树希望通过更强随机化快速建立稳健的树集成模型时使用极端随机树。
选择极端随机树
当希望快速建立稳健的树集成基线,并愿意用更强的随机化换取更低方差时,选择极端随机树。它与随机森林相似,但分裂阈值通常更随机,默认使用完整训练集而不是自助采样,因此训练往往更直接。
与随机森林怎么选
| 判断条件 | 随机森林 | 极端随机树 |
|---|---|---|
| 分裂方式 | 在候选特征中搜索较优阈值 | 对候选特征随机生成阈值再选较优者 |
| 默认采样 | bootstrap=True |
bootstrap=False |
| 模型倾向 | 偏差较低、训练稍重 | 随机性更强、方差更低但偏差可能略高 |
| 推荐用法 | 需要稳健通用基线 | 需要快速对照实验或随机森林仍过拟合 |
无法仅凭算法名称判断谁更准。生产选择应使用相同数据切分、相同评价指标和相近资源预算进行交叉验证。
基本用法
下面示例使用与随机森林相同的数据规模,固定随机种子训练极端随机树,并输出可直接检查的分类结果。
from sklearn.datasets import make_classification
from sklearn.ensemble import ExtraTreesClassifier
from sklearn.metrics import accuracy_score, confusion_matrix
from sklearn.model_selection import train_test_split

X, y = make_classification(
    n_samples=800,
    n_features=10,
    n_informative=6,
    n_redundant=2,
    class_sep=1.0,
    random_state=42,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

model = ExtraTreesClassifier(
    n_estimators=300,
    max_features="sqrt",
    min_samples_leaf=2,
    random_state=42,
    n_jobs=-1,
)
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(f"accuracy={accuracy_score(y_test, pred):.3f}")
print("confusion_matrix=")
print(confusion_matrix(y_test, pred))
print(f"top_feature={model.feature_importances_.argmax()}")
预期输出:
accuracy=0.920
confusion_matrix=
[[91  9]
 [ 7 93]]
top_feature=5
第一行 91 表示真实类别 0 被正确预测 91 次,第二行 93 表示真实类别 1 被正确预测 93 次。若更关注少数类,应继续计算召回率、精确率或 PR-AUC,而不是只依据 accuracy。
常用参数
n_estimators 控制树数量,通常从 200~500 开始;max_features 控制每次分裂查看多少特征,分类常用 "sqrt";min_samples_leaf 增大后可减少过细切分;max_depth 用于直接限制复杂度;class_weight="balanced" 可按类别频率自动加权;n_jobs=-1 会使用全部可用 CPU。
极端随机树默认 bootstrap=False。只有显式启用 bootstrap=True 后,才适合进一步使用袋外评估相关能力;不要把随机森林的默认采样行为直接套用到该模型。
高频用法
- 快速基线:保持默认采样方式,固定
random_state,先评估交叉验证均值和波动。 - 抑制过拟合:提高
min_samples_leaf,或设置有限的max_depth。 - 类别不平衡:设置
class_weight="balanced",同时观察少数类召回率和混淆矩阵。 - 回归任务:替换为
ExtraTreesRegressor,评价指标改用 MAE、RMSE 或业务误差。
风险与边界
当样本量很小或噪声特征很多时,随机阈值可能使模型偏差升高,验证结果波动也可能较大。安全做法是使用分层交叉验证,并与随机森林、线性模型做同切分对照。
当特征包含未来信息、重复实体跨训练集和验证集,或同一用户记录被随机拆散时,模型会出现虚高分数。应按时间、用户或设备分组切分,确保线上不可见信息不会进入训练。
当树数量和深度过大时,虽然训练可并行,模型文件和推理成本仍会持续增长。应在目标指标达到平台期后停止增加树,并记录 P95 推理耗时和峰值内存。
排障清单
- 结果每次变化:确认训练切分和模型都设置了
random_state。 - 比随机森林明显更差:增加
max_features,降低随机性,或直接回退随机森林。 - 训练快但预测慢:减少
n_estimators,限制深度,并检查是否对单条请求逐条调用。 - 特征重要性异常集中:检查高基数编码、泄漏字段,并用置换重要性复核。
速查结论:需要更强随机化、较快训练和稳健对照基线时选极端随机树;最终是否采用,应以同一验证方案下的效果、波动和推理成本共同决定。
选择梯度提升树在结构化数据上追求较高预测精度时使用梯度提升树模型。
选择梯度提升树
当数据以表格形式为主,特征之间存在非线性关系或组合效应,并且预测精度优先于模型可解释性时,优先试用梯度提升树。它通常不要求特征标准化,适合分类、回归和缺失值较多的结构化数据。
适用判断
优先选择梯度提升树的典型信号:
- 数据量从几千到数百万行,特征主要是数值、类别编码或统计特征。
- 单棵决策树欠拟合,随机森林效果尚可,但仍需要更高精度。
- 特征尺度差异明显,且不希望为距离计算专门标准化。
- 需要捕获阈值、非线性和特征交互。
高维稀疏文本、需要稳定外推的时间趋势,或必须给出简单线性系数时,通常先考虑线性模型。
基本用法
下面使用 HistGradientBoostingClassifier 完成二分类。该实现适合较大的表格数据,并可直接接收 NaN。
import numpy as np
from sklearn.ensemble import HistGradientBoostingClassifier

X = np.array([
    [0, 0], [0, 1], [1, 0], [1, 1],
    [2, 0], [2, 1], [3, 0], [3, 1],
], dtype=float)
y = np.array([0, 0, 0, 0, 1, 1, 1, 1])

model = HistGradientBoostingClassifier(
    learning_rate=0.1,
    max_iter=50,
    max_leaf_nodes=7,
    min_samples_leaf=2,
    random_state=42,
)
model.fit(X, y)

samples = np.array([[0.5, 1], [2.5, 0]], dtype=float)
print(model.predict(samples).tolist())
print([
    round(value, 3)
    for value in model.predict_proba(samples)[:, 1]
])
预期输出:
[0, 1]
[0.003, 0.997]
第一行是预测类别;第二行是类别 1 的概率。不同 scikit-learn 版本可能产生轻微概率差异,类别结果应保持一致。
关键参数
learning_rate:每棵树的贡献。调小通常更稳,但需要增大max_iter。max_iter:提升轮数。过小会欠拟合,过大会增加训练时间并可能过拟合。max_leaf_nodes:限制单棵树复杂度。叶子越多,越容易拟合局部噪声。min_samples_leaf:叶节点最少样本数。数据噪声大时适当增大。l2_regularization:对叶节点值施加正则,过拟合时可从小值开始增加。early_stopping:验证分数不再改善时提前停止;生产调参时建议保留验证集确认效果。
高频选择
小到中等数据可先用 GradientBoostingClassifier 建立基线;数据更大、包含缺失值或训练速度更重要时,优先 HistGradientBoostingClassifier。类别极不平衡时,不要只看准确率,应同时检查 PR-AUC、召回率和业务阈值。
调参顺序通常是先固定较小的 learning_rate,再搜索 max_iter,随后控制 max_leaf_nodes 与 min_samples_leaf。先限制树复杂度,再增加轮数,比直接堆叠深树更稳。
风险与边界
当训练集与线上数据分布发生漂移时,树模型会继续沿既有阈值切分,可能产生高置信度误判。安全做法是监控特征分布、缺失率和分桶命中率,并定期用新数据回测。
类别特征若直接编码为连续整数,模型可能误认为编码存在大小关系。应使用可靠的类别编码、独热编码,或选用原生支持类别特征的提升树实现。
树模型不擅长超出训练范围的数值外推。预测未来增长、容量或价格趋势时,应加入时间与业务约束,或与可外推模型组合验证。
选择支持向量机在中小规模、高维数据上需要构造复杂分类边界时使用支持向量机。
选择支持向量机
当样本量中小、特征维度较高,并且类别边界可能是非线性时,可选择支持向量机。线性核适合高维稀疏数据,RBF 核适合经过标准化的中小规模稠密数据。
适用判断
支持向量机更适合以下情况:
- 样本通常在数百到数万级,特征维度较高。
- 类别之间存在清晰间隔,但线性边界不足。
- 需要通过核函数构造复杂边界。
- 可以接受训练前进行标准化,并投入时间调节
C和gamma。
样本达到数十万甚至更多时,经典核 SVM 的训练时间和内存开销可能迅速上升。此时优先评估 LinearSVC、SGDClassifier 或梯度提升树。
基本用法
RBF 核依赖样本间距离,必须先标准化。使用流水线可避免训练集和预测集采用不同缩放参数。
import numpy as np
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X = np.array([
    [0, 0], [0, 1], [1, 0], [1, 1],
    [3, 3], [3, 4], [4, 3], [4, 4],
], dtype=float)
y = np.array([0, 0, 0, 0, 1, 1, 1, 1])

model = make_pipeline(
    StandardScaler(),
    SVC(kernel="rbf", C=10, gamma="scale"),
)
model.fit(X, y)

samples = np.array([[0.5, 0.5], [3.5, 3.5]], dtype=float)
print(model.predict(samples).tolist())
print([
    round(value, 3)
    for value in model.decision_function(samples)
])
预期输出:
[0, 1]
[-1.126, 1.126]
predict 返回类别;decision_function 返回样本到分类边界的有符号距离。二分类中负值偏向类别 0,正值偏向类别 1,绝对值越大通常表示离边界越远。
关键参数
kernel:linear用于近似线性或高维稀疏数据;rbf是非线性分类的常用起点。C:误分类惩罚。值大时更重视训练误差,边界可能更复杂;值小时正则更强。gamma:RBF 核影响范围。值大时每个样本影响更局部,容易过拟合;值小时边界更平滑。class_weight="balanced":按类别频率自动调整权重,适用于类别不平衡的初始方案。probability=True:启用概率估计,但会显著增加训练成本;只需要排序或阈值时优先使用决策分数。
高频选择
文本分类或极高维稀疏特征优先尝试 LinearSVC,通常比 RBF 核更快。特征数不高但边界弯曲明显时,使用标准化后的 SVC(kernel="rbf")。
调参时应联合搜索 C 和 gamma。先用对数尺度尝试 C 为 0.1、1、10、100,再围绕最佳区域缩小范围;不要只在训练集上选择参数。
风险与边界
未标准化时,大尺度特征会主导距离计算,导致边界偏移。安全替代是把 StandardScaler 与 SVM 放入同一流水线,并让交叉验证覆盖整个流水线。
同时把 C 和 gamma 设得很大,会使模型围绕少量样本形成复杂边界,训练分数很高但线上泛化变差。应使用分层交叉验证,并观察验证集混淆矩阵、召回率和决策分数分布。
SVM 的决策分数不是概率。需要业务概率时,应在独立验证数据上校准,或谨慎启用 probability=True;不要直接把分数解释为百分比。