
机器学习与深度学习 / 知识点
机器学习算法速查手册
手册条目
调整分类阈值根据业务中的误报和漏报成本选择合适的分类概率阈值。
调整分类阈值
当模型已经能输出正类概率,但默认判定结果与业务成本不匹配时,用验证集调整阈值。漏报代价高时通常降低阈值,误报代价高时通常提高阈值;阈值只改变最终决策,不会重新训练模型或改善概率本身。
基本语法
二分类的判定规则是 y_pred = (y_prob >= threshold).astype(int)。阈值应在独立验证集或交叉验证结果上选择,测试集只用于最终评估。若直接在测试集上反复试阈值,会把测试信息泄漏到决策规则中,线上效果通常会被高估。
高频用法
下面同时观察混淆矩阵、精确率、召回率和 F1,快速判断不同阈值的取舍。
import numpy as np
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score

y_true = np.array([0, 0, 0, 0, 1, 1, 1, 1, 1, 1])
y_prob = np.array([0.05, 0.20, 0.35, 0.60, 0.25, 0.45, 0.55, 0.70, 0.85, 0.95])

for threshold in (0.30, 0.50, 0.70):
    y_pred = (y_prob >= threshold).astype(int)
    tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()
    precision = precision_score(y_true, y_pred, zero_division=0)
    recall = recall_score(y_true, y_pred, zero_division=0)
    f1 = f1_score(y_true, y_pred, zero_division=0)
    print(
        f"threshold={threshold:.2f} "
        f"TN={tn} FP={fp} FN={fn} TP={tp} "
        f"precision={precision:.3f} recall={recall:.3f} f1={f1:.3f}"
    )
预期输出
threshold=0.30 TN=2 FP=2 FN=1 TP=5 precision=0.714 recall=0.833 f1=0.769
threshold=0.50 TN=3 FP=1 FN=2 TP=4 precision=0.800 recall=0.667 f1=0.727
threshold=0.70 TN=4 FP=0 FN=3 TP=3 precision=1.000 recall=0.500 f1=0.667
读取时先看业务最不能接受的错误类型:阈值 0.30 漏报最少,适合召回优先;阈值 0.70 没有误报,但漏掉一半正类,适合误报成本极高的场景。生产中不要只按 F1 选阈值,应把误报和漏报换算成同一业务成本后比较。
风险与边界
在训练集上调阈值会过拟合,后果是离线指标很好、线上迅速回落;安全做法是保留验证集,或用交叉验证汇总多个折的最佳阈值。类别比例、渠道流量或欺诈手法变化后,原阈值也可能失效,应监控 FP、FN 和正类率并定期复核。
阈值调整不能修复失真的概率。例如输出 0.8 的样本实际只有约 50% 发生率时,应先做概率校准,再基于业务成本选阈值。概率估计与把分数转换为类别决策是两个不同问题。:contentReference[oaicite:0]{index=0}
排障清单
- 全部预测为同一类:检查概率最小值、最大值和分位数,阈值可能落在分布之外。
- 模型没有
predict_proba:改用decision_function,但阈值单位不再是概率,不能直接照搬0.5。 - 验证集有效、线上失效:核对正类定义、样本时间窗口、类别比例和业务成本是否发生变化。
- 指标冲突:明确主目标,例如“召回率至少 90%,在此约束下最大化精确率”,不要同时追求所有指标最大化。
速查:先定错误成本,再用独立验证数据选阈值,最后用未参与调参的测试集确认。
校准预测概率当预测概率与真实发生频率不一致时对分类概率进行校准。
校准预测概率
当模型给出的 0.8 并不对应约 80% 的真实发生率时,需要校准概率。校准后的概率更适合风险定价、额度分层、成本计算和后续阈值选择,但不保证分类准确率一定提高。
基本语法
CalibratedClassifierCV 用交叉验证数据训练校准器,并优先使用基础模型的 decision_function,否则使用 predict_proba。常用方法是 sigmoid 和 isotonic;样本较少时通常先使用更平滑的 sigmoid。:contentReference[oaicite:1]{index=1}
片段示例:假设 base_model 已经定义,调用 fit 后再通过 predict_proba 获取校准概率。
from sklearn.calibration import CalibratedClassifierCV

calibrated_model = CalibratedClassifierCV(
    estimator=base_model,
    method="sigmoid",
    cv=5,
)
该配置会在拟合时通过五折交叉验证生成校准数据;是否改善应使用独立测试集上的 Brier 分数、Log Loss 和分箱实际率验证。
高频用法
下面用 Brier 分数和分箱后的“平均预测概率 → 实际正类率”检查校准效果。Brier 分数越低越好;箭头两侧越接近,概率越可信。
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.calibration import CalibratedClassifierCV, calibration_curve
from sklearn.metrics import brier_score_loss

X, y = make_classification(
    n_samples=2000,
    n_features=12,
    n_informative=6,
    n_redundant=2,
    weights=[0.7, 0.3],
    class_sep=0.8,
    flip_y=0.03,
    random_state=42,
)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.4, stratify=y, random_state=42
)

raw_model = GaussianNB().fit(X_train, y_train)
calibrated_model = CalibratedClassifierCV(
    estimator=GaussianNB(),
    method="sigmoid",
    cv=5,
).fit(X_train, y_train)

raw_prob = raw_model.predict_proba(X_test)[:, 1]
cal_prob = calibrated_model.predict_proba(X_test)[:, 1]

print(f"raw_brier={brier_score_loss(y_test, raw_prob):.4f}")
print(f"cal_brier={brier_score_loss(y_test, cal_prob):.4f}")

for name, prob in (("raw", raw_prob), ("cal", cal_prob)):
    frac_pos, mean_pred = calibration_curve(
        y_test, prob, n_bins=5, strategy="quantile"
    )
    pairs = [f"{p:.2f}->{f:.2f}" for p, f in zip(mean_pred, frac_pos)]
    print(f"{name}: " + ", ".join(pairs))
预期输出
raw_brier=0.1024
cal_brier=0.1005
raw: 0.01->0.03, 0.06->0.04, 0.16->0.15, 0.39->0.41, 0.83->0.91
cal: 0.06->0.03, 0.08->0.04, 0.15->0.15, 0.45->0.41, 0.90->0.90
本例中校准后 Brier 分数下降,最高概率分箱也从 0.83→0.91 改善为 0.90→0.90。不同 scikit-learn 版本或底层数值库可能造成末位小数差异,但读取方法不变。
常用参数
method="sigmoid":参数化映射,数据量有限或希望结果更平滑时优先使用。method="isotonic":非参数单调映射,校准样本充足时可拟合更复杂的偏差,但小样本更容易过拟合。cv=5:用交叉验证避免校准器直接看到基础模型拟合过的同一批预测。n_jobs=-1:并行拟合多个交叉验证折,可缩短训练时间,但会增加 CPU 和内存占用。
风险与边界
使用训练基础模型的同一批数据再校准,会得到过于乐观的概率;后果是风险成本和阈值决策失真。安全做法是使用 CalibratedClassifierCV 的交叉验证,或准备与模型训练集完全隔离的校准集。校准已拟合模型时,需要自行保证训练数据与校准数据分离。:contentReference[oaicite:2]{index=2}
校准只修正概率映射,不补充模型缺失的特征,也不会解决数据漂移。上线后应按时间窗口持续比较预测概率与真实发生率;若分布变化明显,应重新训练基础模型并重新校准,而不是只反复修补校准器。
排障清单
- 校准后 Brier 或 Log Loss 变差:校准集太小、分布不一致,或
isotonic过拟合;先换sigmoid并扩大校准数据。 - 分箱结果忽高忽低:每箱样本太少;改用
strategy="quantile"或减少n_bins。 - 报错不认识
estimator:旧版 scikit-learn 使用过base_estimator参数;升级版本,或按当前环境 API 替换参数名。:contentReference[oaicite:3]{index=3} - 校准很好但阈值仍不合适:概率可信不等于业务决策最优,仍需按误报和漏报成本单独选择阈值。
速查:先隔离校准数据,再比较 Brier、Log Loss 和分箱实际率,确认概率可信后再调分类阈值。
解释特征重要性使用模型内置重要性或置换重要性识别影响预测的关键特征。
解释特征重要性
用于回答“模型主要依赖哪些输入做预测”。先用模型内置重要性快速排序,再用验证集上的置换重要性复核;两者结论一致时可信度更高。
方法选择
feature_importances_:适合决策树、随机森林和部分提升树,计算快,但只反映该模型的分裂贡献。permutation_importance:逐列打乱特征并观察评分下降,适用于已拟合且支持score或指定scoring的模型。- 线性模型通常查看标准化后的
coef_;系数正负表示方向,绝对值才用于比较影响强弱。
主示例
下面同时输出决策树内置重要性和置换重要性。示例为保证结果可复现,使用同一小数据集训练和演示;生产环境必须把置换计算放到验证集或测试集。
import pandas as pd
from sklearn.inspection import permutation_importance
from sklearn.tree import DecisionTreeClassifier

X = pd.DataFrame(
    {
        "signal": [0, 0, 0, 0, 1, 1, 1, 1],
        "noise_a": [0, 1, 0, 1, 0, 1, 0, 1],
        "noise_b": [0, 1, 1, 0, 0, 1, 1, 0],
    }
)
y = [0, 0, 0, 0, 1, 1, 1, 1]

model = DecisionTreeClassifier(max_depth=2, random_state=42)
model.fit(X, y)

# n_repeats 越大结果越稳定,但计算成本近似线性增加
permutation = permutation_importance(
    model,
    X,
    y,
    scoring="accuracy",
    n_repeats=10,
    random_state=42,
)

result = pd.DataFrame(
    {
        "feature": X.columns,
        "model_importance": model.feature_importances_,
        "permutation_mean": permutation.importances_mean,
        "permutation_std": permutation.importances_std,
    }
).sort_values("permutation_mean", ascending=False)

print(f"accuracy={model.score(X, y):.3f}")
print(result.to_string(index=False, float_format=lambda v: f"{v:.3f}"))
预期输出
accuracy=1.000
feature  model_importance  permutation_mean  permutation_std
 signal             1.000             0.575            0.115
noise_a             0.000             0.000            0.000
noise_b             0.000             0.000            0.000
输出字段说明
model_importance 是归一化后的模型内置贡献,通常总和为 1。permutation_mean 表示打乱该列后评分平均下降量,数值越大,模型越依赖该特征;接近 0 表示当前模型几乎未使用。permutation_std 较大说明重复打乱后的结果不稳定,应增加 n_repeats 或检查样本量。
常用参数中,scoring 必须与最终业务指标一致;random_state 用于复现;数据量大时可设置 n_jobs=-1 并通过 max_samples 限制单次抽样规模。
风险与边界
- 在训练集计算置换重要性会高估作用,后果是把过拟合特征当成关键特征;安全做法是在独立验证集计算,或按交叉验证折汇总。
- 高相关特征会相互替代,单列打乱后重要性可能同时偏低;应结合相关性分组、聚类后保留代表特征,或成组置换。
- 树模型内置重要性可能偏向取值多的连续或高基数特征;不要直接据此删列,应使用置换重要性或消融实验复核。
- 模型自身评分明显低于基线时,重要性只是在解释一个无效模型;先确认模型具备可接受的验证表现。
排障清单
- 特征名、列顺序和预处理管道是否与模型训练时一致。
- 分类任务是否使用了合适指标;类别不平衡时不要只看准确率。
- 重要性是否在验证集计算,且没有目标泄漏、时间穿越或重复样本。
- 删除低重要性特征后是否重新训练并比较验证指标,而不是只比较原模型输出。
速查:内置重要性用于快速定位,置换重要性用于验证依赖;任何删特征决定都应以重新训练后的验证结果为准。
诊断欠拟合通过训练集和验证集表现判断模型是否过于简单或特征不足。
诊断欠拟合
用于判断模型是否因为表达能力不足、特征缺失或约束过强,导致训练集和验证集都表现不佳。核心信号是两边分数都低且差距小,而不是只看验证集低。
判断标准
| 训练集表现 | 验证集表现 | 常见结论 |
|---|---|---|
| 低 | 低且接近训练集 | 欠拟合或数据、指标存在问题 |
| 高 | 明显低于训练集 | 过拟合、数据漂移或切分异常 |
| 高 | 高且差距小 | 当前复杂度基本合适 |
“低”必须相对简单基线、历史模型或业务门槛判断。分类任务至少与多数类、随机策略或规则基线比较;回归任务可与预测均值或中位数的基线比较。
主示例
异或数据需要非线性交互。线性逻辑回归在训练集和验证集都只有 0.5,属于典型欠拟合;提高模型表达能力后,两边同时改善。
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

base_X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
base_y = np.array([0, 1, 1, 0])

# 每种组合在训练集和验证集中保持相同比例,避免切分噪声干扰判断
X_train = np.repeat(base_X, 30, axis=0)
y_train = np.repeat(base_y, 30)
X_valid = np.repeat(base_X, 20, axis=0)
y_valid = np.repeat(base_y, 20)

models = {
    "linear": LogisticRegression(random_state=42),
    "nonlinear": RandomForestClassifier(
        n_estimators=100,
        max_depth=3,
        random_state=42,
    ),
}

for name, model in models.items():
    model.fit(X_train, y_train)
    train_acc = accuracy_score(y_train, model.predict(X_train))
    valid_acc = accuracy_score(y_valid, model.predict(X_valid))
    print(f"{name}: train={train_acc:.3f}, valid={valid_acc:.3f}")
预期输出
linear: train=0.500, valid=0.500
nonlinear: train=1.000, valid=1.000读取方法:linear 的训练和验证准确率都低且相等,说明继续增加同类数据通常不会解决表达能力不足;nonlinear 同时提高两边分数,证明问题来自模型无法表达特征交互。示例数据很小,生产判断还需交叉验证或学习曲线确认稳定性。
修复顺序
- 先验证标签、特征、切分和指标,确认不是数据错误或不合适的评价方式。
- 增加有效特征、交互项或非线性变换;优先修复信息不足,而不是盲目调参。
- 提高模型容量,例如增加树深、隐藏单元或基函数阶数。
- 减弱过强正则化、剪枝、最小叶节点限制或提前停止,并继续观察验证集。
- 训练未收敛时增加迭代轮数或调整学习率;只有学习曲线仍在上升时,新增数据才更可能有效。
风险与边界
类别严重不平衡时,准确率可能让“全预测多数类”的模型看似很好,应改看宏平均 F1、召回率、PR-AUC 或业务代价指标。训练集低但验证集更高,常见于训练阶段启用了数据增强、Dropout 或正则项,需在相同推理模式下重新评估。
数据泄漏会让两边分数虚高,从而掩盖欠拟合;时间序列随机切分则可能制造错误结论。安全做法是固定可复现切分、把预处理放入管道,并确保验证数据严格晚于训练数据或来自独立实体。
排障清单
- 与简单基线相比,训练分数是否确实偏低。
- 训练和验证是否使用同一指标、同一预处理和同一标签定义。
- 模型是否已收敛,是否触发最大迭代次数或提前停止。
- 正则化、树深、叶节点、特征选择是否限制过强。
- 增加容量后训练分数是否上升;若仍不升,优先检查特征和标签质量。
速查:训练低、验证低且接近,先查数据与指标,再提升特征信息和模型容量;不要把“多加数据”当作欠拟合的默认修复。
识别训练效果良好但验证效果明显下降的模型泛化问题。
诊断过拟合
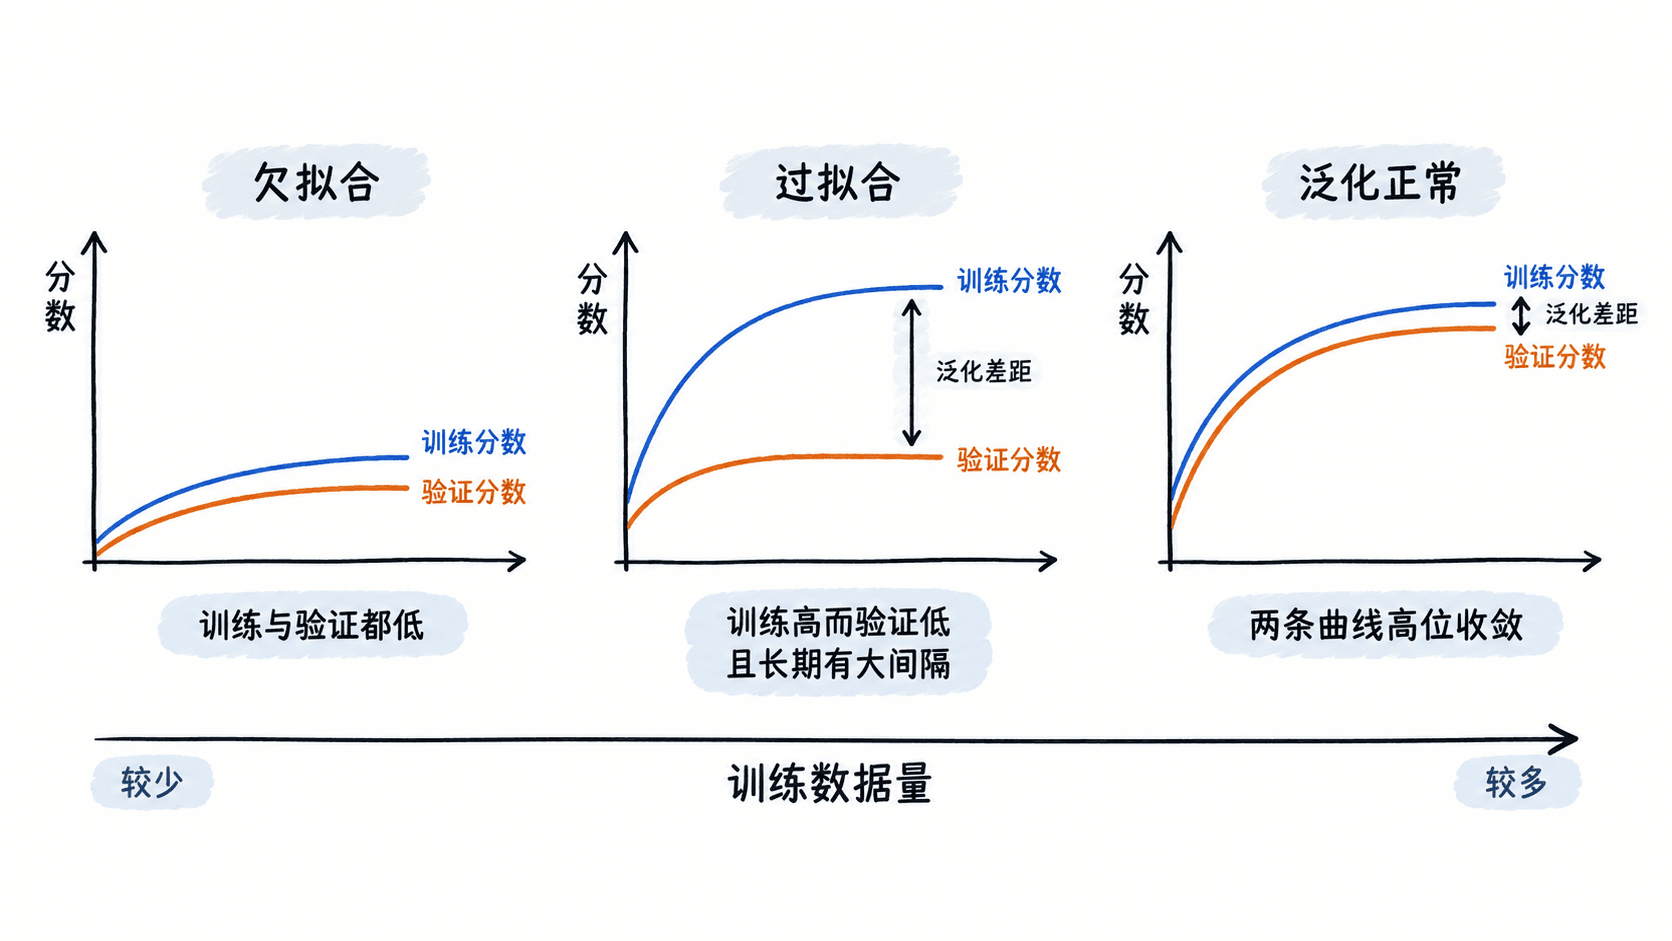
用于确认模型是否只记住训练样本、未能泛化。核心证据不是“训练分数高”,而是同一指标下训练分数持续高于验证分数,并且差距在增加数据后仍明显存在。
快速判定
| 训练分数 | 验证分数 | 常见判断 |
|---|---|---|
| 高 | 高且接近 | 泛化正常,继续检查稳定性 |
| 高 | 明显较低 | 过拟合或数据划分不一致 |
| 低 | 低且接近 | 更可能欠拟合 |
不要使用训练集调参后再把同一批数据称为验证集。分类任务还应同时查看召回率、F1 或 ROC-AUC,类别严重不平衡时不能只看准确率。
可运行检查
下面用固定随机种子构造噪声较多的数据,并用未限制深度的决策树演示训练集满分、验证集明显下降的情况。
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import learning_curve, train_test_split
from sklearn.tree import DecisionTreeClassifier

X, y = make_classification(
    n_samples=600,
    n_features=30,
    n_informative=5,
    n_redundant=2,
    flip_y=0.12,
    class_sep=0.7,
    random_state=42,
)

X_train, X_valid, y_train, y_valid = train_test_split(
    X, y, test_size=0.30, stratify=y, random_state=42
)

model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)

train_score = model.score(X_train, y_train)
valid_score = model.score(X_valid, y_valid)
print(f"train={train_score:.3f}")
print(f"valid={valid_score:.3f}")
print(f"gap={train_score - valid_score:.3f}")

sizes, train_scores, valid_scores = learning_curve(
    DecisionTreeClassifier(random_state=42),
    X_train,
    y_train,
    cv=5,
    scoring="accuracy",
    train_sizes=[0.3, 0.6, 1.0],
    shuffle=True,
    random_state=42,
    n_jobs=1,
)

for size, tr, va in zip(
    sizes, train_scores.mean(axis=1), valid_scores.mean(axis=1)
):
    print(f"samples={size} train={tr:.3f} valid={va:.3f} gap={tr-va:.3f}")
预期输出(不同 scikit-learn 小版本的末位数值可能轻微浮动):
train=1.000
valid=0.672
gap=0.328
samples=100 train=1.000 valid=0.631 gap=0.369
samples=201 train=1.000 valid=0.619 gap=0.381
samples=336 train=1.000 valid=0.650 gap=0.350
读取方法:训练分数始终为 1.000,验证分数约为 0.62~0.67,且差距超过 0.30;增加样本后差距没有明显收敛,可判定模型方差过高。
排障顺序
- 先确认划分规则:时间数据按时间切分,同一用户、设备或商户的数据按组隔离,分类任务保持类别比例。
- 再与简单基线比较:限制树深、增大叶节点最小样本数,或使用带正则化的模型。
- 只在训练折内完成特征选择、标准化和采样,防止数据泄漏掩盖真实问题。
- 逐步降低复杂度并重复交叉验证;若验证分数上升且训练验证差距缩小,整改方向有效。
风险与边界
- 触发条件:只看一次随机划分。可能后果:样本偶然分布导致误判。安全替代:使用重复交叉验证,并同时记录均值和标准差。
- 触发条件:训练与验证使用不同预处理或不同指标。可能后果:人为制造分数差距。安全替代:把预处理和模型放入同一
Pipeline,统一评分函数。 - 触发条件:直接以固定差值阈值认定过拟合。可能后果:忽略样本量、业务成本和指标波动。安全替代:结合学习曲线、交叉验证方差及独立测试集共同判断。
速查结论:先验证数据划分,再看训练与验证差距是否稳定存在,最后通过降低复杂度或增加有效数据确认问题是否缓解。
检查特征构造、数据划分和预处理流程中是否使用了不可用的未来信息。
排查数据泄漏
用于检查离线指标异常偏高、上线效果骤降或交叉验证结果不可信的问题。泄漏的本质是训练阶段看到了预测时不可获得的信息,常见来源包括事后字段、全量预处理、重复实体跨集合和未来时间数据。
先看泄漏链路
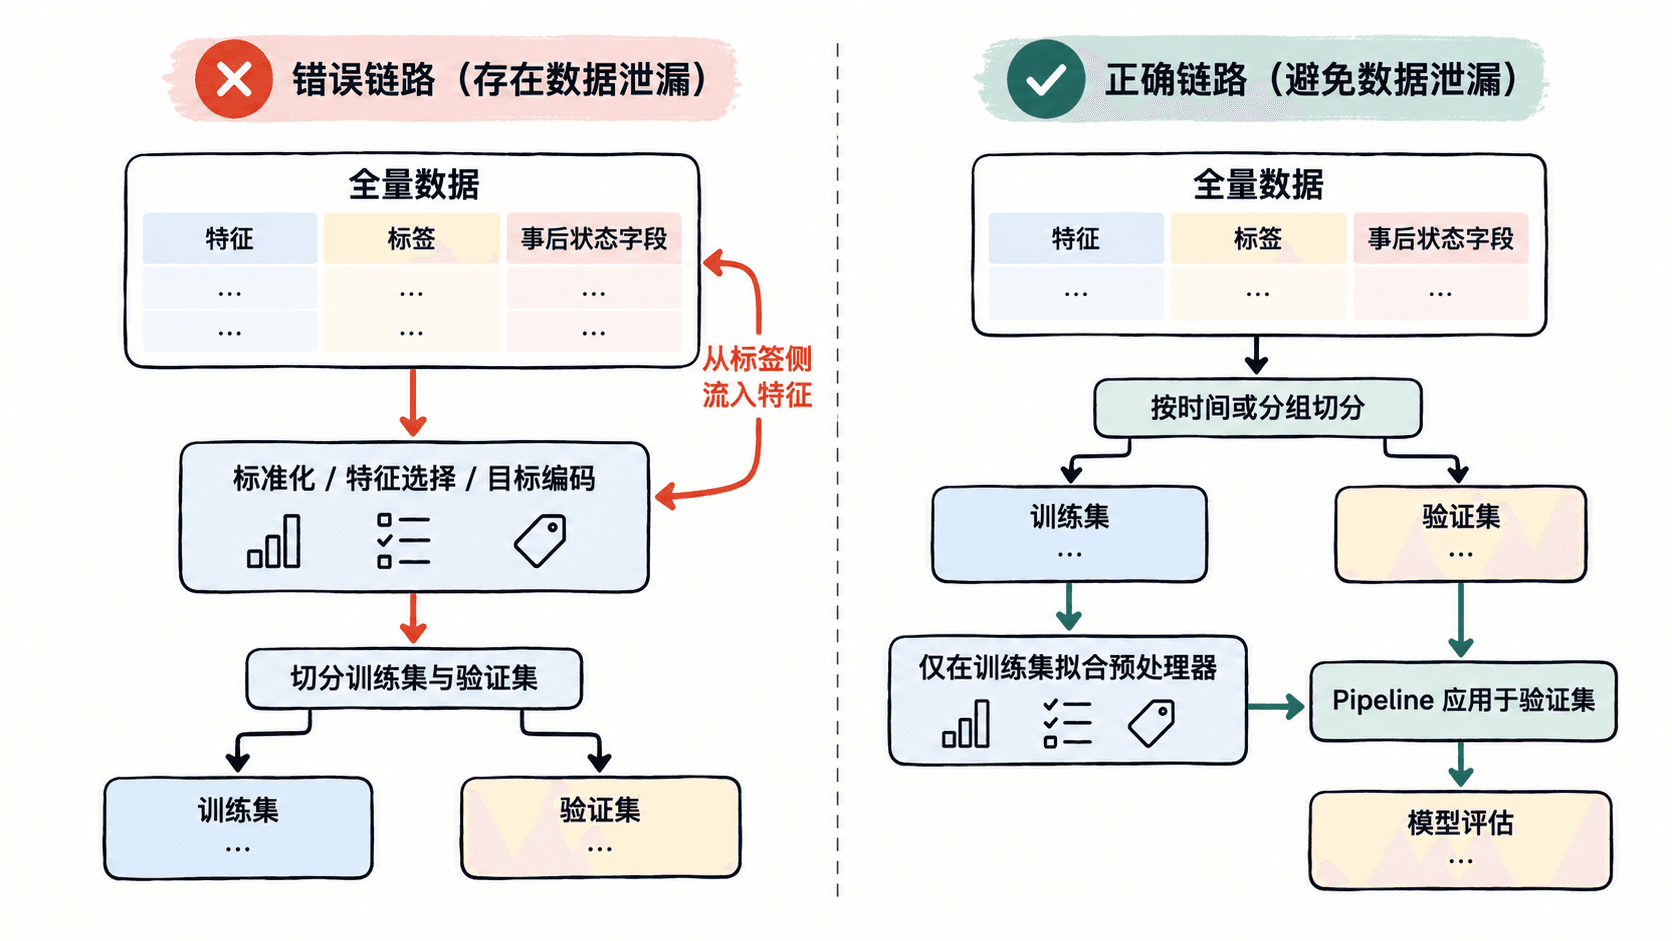
| 泄漏类型 | 典型信号 | 修复方式 |
|---|---|---|
| 目标泄漏 | 特征直接或间接包含结果状态 | 删除预测时不可用字段 |
| 预处理泄漏 | 切分前对全量数据拟合标准化、选择器或编码器 | 先切分,再用 Pipeline 仅拟合训练数据 |
| 分组泄漏 | 同一用户、设备、订单派生样本跨训练与验证 | 按实体使用分组切分 |
| 时间泄漏 | 训练样本使用未来窗口统计或随机打乱时间序列 | 按时间截点或滚动窗口验证 |
可运行对照
示例中的 post_event_status 与标签相同,代表支付完成状态、退款结果等预测后才产生的字段。保留它会得到虚假的满分,删除后才接近真实可用效果。
import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(42)
sample_count = 1000
signal = rng.normal(size=sample_count)
noise = rng.normal(scale=1.0, size=sample_count)
y = (signal + noise > 0).astype(int)

X = pd.DataFrame(
    {
        "signal": signal,
        "noise_feature": rng.normal(size=sample_count),
        # 该字段在真实预测时尚未产生,属于目标泄漏
        "post_event_status": y,
    }
)

X_train, X_valid, y_train, y_valid = train_test_split(
    X, y, test_size=0.30, stratify=y, random_state=42
)

def evaluate(columns):
    pipeline = make_pipeline(
        StandardScaler(),
        LogisticRegression(max_iter=1000, random_state=42),
    )
    pipeline.fit(X_train[columns], y_train)
    prediction = pipeline.predict(X_valid[columns])
    return accuracy_score(y_valid, prediction)

print(f"with_leak={evaluate(['signal', 'noise_feature', 'post_event_status']):.3f}")
print(f"without_leak={evaluate(['signal', 'noise_feature']):.3f}")
预期输出:
with_leak=1.000
without_leak=0.700
读取方法:删除单个可疑字段后准确率从 1.000 降到 0.700,说明原指标主要由泄漏贡献。真实项目中还应比较多个时间窗口和业务分组,确认下降不是偶然波动。
排障清单
- 为每个特征标注“最早可用时间”,晚于预测时点的字段直接禁用。
- 检查聚合特征是否包含当前样本、验证样本或未来窗口;历史统计应使用严格的截止时间。
- 检查标准化、缺失值填充、特征选择、目标编码和重采样是否在切分后、训练折内拟合。
- 对用户、设备、商户、患者等重复实体使用分组切分,并在切分前处理近重复样本。
- 逐个移除异常重要的特征;若离线分数断崖式下降,回查其来源表、生成时间和关联键。
- 用更靠后的时间段做最终留出测试;若随机验证很好而时间外推明显变差,优先怀疑时间泄漏或分布漂移。
风险与边界
- 触发条件:随机切分时间序列。可能后果:未来模式进入训练集,离线指标虚高。安全替代:使用时间截点或
TimeSeriesSplit,保持时间顺序。 - 触发条件:在全量数据上做目标编码、特征选择或过采样。可能后果:验证标签间接参与训练。安全替代:把这些步骤封装进交叉验证内部的
Pipeline。 - 触发条件:仅凭“分数下降”认定泄漏。可能后果:把正常特征贡献误判为问题。安全替代:结合字段可用时点、数据血缘、消融实验和独立时间测试共同确认。
速查结论:任何预测时拿不到的信息都不能进入特征;先切分、后拟合预处理,并按时间或实体隔离样本,是排除泄漏的基本顺序。
排查训练不收敛从特征尺度、学习率、迭代次数和数据质量定位模型不收敛原因。
排查训练不收敛
训练损失长期不下降、出现 ConvergenceWarning、达到最大迭代次数仍未停止时,先检查数据,再检查特征尺度和优化参数。不要直接把 max_iter 调得很大,否则只会延长无效训练。
定位顺序
按以下顺序排查,能最快区分数据问题和优化器问题:
- 检查特征与标签是否包含
NaN、Inf、常量列、重复样本或错误标签。 - 比较各数值特征的标准差;最大与最小非零标准差相差数千倍时,优先标准化。
- 查看损失曲线:持续震荡或变大通常是学习率过高;下降极慢通常是学习率过低。
- 确认迭代次数、停止阈值和求解器是否适合当前样本量、稀疏性及正则化方式。
- 在小样本上尝试过拟合;连小样本都拟合不了,通常是数据、实现或目标函数有误。
主诊断示例
下面故意放大一个特征,再比较未缩放和标准化后的逻辑回归。示例需要 numpy 与 scikit-learn。
import warnings
import numpy as np
from sklearn.datasets import make_classification
from sklearn.exceptions import ConvergenceWarning
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import log_loss
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

def fit_with_warning(model, X, y):
    with warnings.catch_warnings(record=True) as caught:
        warnings.simplefilter("always", ConvergenceWarning)
        model.fit(X, y)
    return any(
        issubclass(item.category, ConvergenceWarning)
        for item in caught
    )

def main():
    X, y = make_classification(
        n_samples=1000,
        n_features=8,
        n_informative=5,
        n_redundant=0,
        random_state=42,
    )
    # 模拟生产数据中某一列量纲异常放大。
    X[:, 0] *= 1_000_000

    std = np.std(X, axis=0)
    std_ratio = std.max() / std[std > 0].min()
    print(f"nan={np.isnan(X).sum()}, inf={np.isinf(X).sum()}")
    print(f"std_ratio={std_ratio:.1f}")

    raw = LogisticRegression(
        solver="saga",
        max_iter=20,
        tol=1e-4,
        random_state=0,
    )
    raw_warned = fit_with_warning(raw, X, y)
    raw_loss = log_loss(y, raw.predict_proba(X)[:, 1])
    print(
        f"unscaled: warning={raw_warned}, "
        f"n_iter={raw.n_iter_[0]}, log_loss={raw_loss:.4f}"
    )

    scaled = make_pipeline(
        StandardScaler(),
        LogisticRegression(
            solver="saga",
            max_iter=2000,
            tol=1e-4,
            random_state=0,
        ),
    )
    scaled_warned = fit_with_warning(scaled, X, y)
    clf = scaled.named_steps["logisticregression"]
    scaled_loss = log_loss(y, scaled.predict_proba(X)[:, 1])
    print(
        f"scaled: warning={scaled_warned}, "
        f"n_iter={clf.n_iter_[0]}, log_loss={scaled_loss:.4f}"
    )

if __name__ == "__main__":
    main()
预期输出如下;不同 scikit-learn 小版本的迭代次数可能略有差异。
nan=0, inf=0
std_ratio=995580.6
unscaled: warning=True, n_iter=20, log_loss=0.6931
scaled: warning=False, n_iter=19, log_loss=0.4171读取时重点看三项:warning=True 表示达到停止条件前训练被截断;n_iter=max_iter 表示迭代预算耗尽;标准化后 log_loss 明显下降,说明量纲失衡是主要原因。
高频处理
- 特征尺度差异大:把
StandardScaler、RobustScaler等放进训练流水线,并让训练和推理复用同一预处理器。 - 损失震荡或发散:将学习率降低 5~10 倍;神经网络同时检查梯度爆炸,并考虑梯度裁剪。
- 损失稳定下降但提前停止:逐步增加
max_iter,或适当减小tol,同时记录每轮损失确认仍有收益。 - 只有部分批次失败:检查异常值、空值填充、类别编码和标签范围,尤其是线上新增类别与训练字典不一致的情况。
风险与边界
盲目增加迭代次数的触发条件是模型已经震荡、损失不变或数据存在异常;后果是训练时间增加但结果不改善。安全替代方案是先保存损失曲线、梯度范数和数据统计,再只对持续下降的模型增加迭代预算。
对树模型,特征标准化通常不是收敛前提;若随机森林或梯度提升训练异常,应优先检查非法值、样本权重、类别标签、内存和参数组合。对深度学习模型,还需额外检查激活函数饱和、初始化、归一化层状态及混合精度溢出。
排障清单
- 训练集和验证集是否使用完全相同的特征生成逻辑。
- 数值列是否存在
NaN、Inf、极端值或近零方差。 - 分类标签是否从预期集合中取值,样本与标签是否错位。
- 损失函数是否与输出层匹配,概率输入是否经过重复激活。
- 学习率、批大小、正则化强度和停止阈值是否同时改动。
- 固定随机种子后问题是否仍能稳定复现。
速查结论:先证明数据有效,再处理尺度和学习率,最后才增加迭代次数。
排查共线性识别高度相关特征对线性模型系数稳定性和解释性的影响。
排查共线性
线性回归或逻辑回归的系数方向反复变化、绝对值异常大、显著性不稳定,但整体预测指标仍较好时,应检查特征共线性。目标不是删除所有相关特征,而是恢复系数稳定性和可解释性。
快速判断
先结合业务含义检查重复口径,再使用相关系数和方差膨胀因子 VIF:
- 两个特征的绝对相关系数接近
1,说明存在明显线性关系,但只能识别成对相关。 VIF = 1 / (1 - R²);常用经验是VIF > 5需要关注,VIF > 10通常表示严重共线性。- 模型整体
R²或分类指标正常,并不能证明系数可靠;共线性主要放大系数方差。 - 类别变量独热编码时必须删除一个基准列,或使用支持自动处理冗余列的编码器。
主诊断示例
下面构造 x2 ≈ 2 × x1,计算相关系数和 VIF,并比较普通最小二乘与岭回归在轻微标签扰动前后的系数。
import numpy as np
from sklearn.linear_model import LinearRegression, Ridge

def calculate_vif(X):
    values = []
    for index in range(X.shape[1]):
        target = X[:, index]
        others = np.delete(X, index, axis=1)
        r2 = LinearRegression().fit(others, target).score(
            others, target
        )
        values.append(1.0 / (1.0 - r2))
    return np.array(values)

def main():
    rng = np.random.default_rng(42)
    sample_count = 200

    x1 = rng.normal(size=sample_count)
    # 极小噪声使 x2 与 x1 几乎完全线性相关。
    x2 = 2 * x1 + rng.normal(scale=0.01, size=sample_count)
    x3 = rng.normal(size=sample_count)
    X = np.column_stack([x1, x2, x3])

    y = (
        3 * x1
        + 0.5 * x3
        + rng.normal(scale=0.1, size=sample_count)
    )
    y_perturbed = y + rng.normal(
        scale=0.01,
        size=sample_count,
    )

    corr = np.corrcoef(X, rowvar=False)
    vif = calculate_vif(X)

    ols = LinearRegression().fit(X, y)
    ols_perturbed = LinearRegression().fit(X, y_perturbed)
    ridge = Ridge(alpha=1.0).fit(X, y)
    ridge_perturbed = Ridge(alpha=1.0).fit(
        X, y_perturbed
    )

    print(f"corr_x1_x2={corr[0, 1]:.4f}")
    print(
        "vif="
        + ",".join(f"{value:.1f}" for value in vif)
    )
    print(
        "ols="
        + ",".join(f"{value:.3f}" for value in ols.coef_)
    )
    print(
        "ols_perturbed="
        + ",".join(
            f"{value:.3f}"
            for value in ols_perturbed.coef_
        )
    )
    print(
        "ridge="
        + ",".join(
            f"{value:.3f}" for value in ridge.coef_
        )
    )
    print(
        "ridge_perturbed="
        + ",".join(
            f"{value:.3f}"
            for value in ridge_perturbed.coef_
        )
    )
    print(f"ols_r2={ols.score(X, y):.4f}")

if __name__ == "__main__":
    main()
预期输出如下。
corr_x1_x2=1.0000
vif=30087.3,30086.8,1.0
ols=3.881,-0.442,0.509
ols_perturbed=4.236,-0.619,0.509
ridge=0.612,1.191,0.506
ridge_perturbed=0.614,1.191,0.506
ols_r2=0.9986
x1 和 x2 的 VIF 超过三万,普通最小二乘系数在轻微扰动后明显变化,但 R² 仍很高。岭回归的两个相关特征系数变化较小,说明正则化提高了稳定性;此处系数仍受特征量纲影响,正式比较前应先标准化。
高频处理
- 同一业务量被多个口径重复表达:保留最稳定、最接近业务含义的一列,或合并为一个派生特征。
- 独热编码形成虚拟变量陷阱:设置
drop="first",或明确删除一个基准类别。 - 特征都必须保留且以预测为主:先标准化,再使用岭回归或带 L2 正则的逻辑回归。
- 需要解释单个变量效应:删除或合并强相关特征,并用时间外验证集检查系数方向是否稳定。
风险与边界
只按相关系数删列会漏掉三个及以上变量共同形成的共线性;后果是成对相关不高,但 VIF 仍异常。安全替代方案是同时查看业务口径、相关矩阵、VIF、条件数和不同抽样下的系数波动。
岭回归能稳定系数,但不会自动恢复因果解释,也不会判断哪个相关变量更重要。若目标是因果推断,还需处理遗漏变量、反向因果和数据生成机制,不能仅凭 VIF 或正则化下结论。
排障清单
- 是否存在金额与单价乘数量、总量与分项和等确定性关系。
- 是否同时保留原始字段、归一化字段和由其直接派生的字段。
- 独热编码是否保留了全部类别以及截距项。
- 系数在不同随机切分、时间窗口或轻微扰动下是否大幅变化。
- 删除一列后预测指标是否几乎不变,而系数和标准误明显稳定。
- 正则化前是否完成数值特征标准化。
速查结论:预测正常但系数不稳定时,优先用业务口径加 VIF确认共线性,再选择删列、合并或 L2 正则化。
控制随机性固定随机种子并记录数据划分和参数,确保实验结果可以复现。
控制随机性
用于需要复现实验、回归排查或比较模型版本时。核心做法不是只写一个种子,而是同时固定随机源、保存数据划分索引、记录数据指纹与运行环境。train_test_split 的 random_state 可固定随机划分;启用随机交叉验证或随机模型时,也应分别设置对应组件的 random_state。:contentReference[oaicite:0]{index=0}
基本做法
统一定义一个种子常量,并显式传给所有会使用随机数的组件,例如数据划分、交叉验证器、模型初始化和超参数搜索。比“依赖全局随机状态”更稳妥的方式,是保存训练集与测试集的实际索引;即使后续库内部实现变化,也能复用同一批样本。
可运行示例
下面固定分类数据的分层划分,并把种子、版本、数据指纹和划分索引写入运行清单。
from __future__ import annotations

import hashlib
import json
import platform
from pathlib import Path

import numpy as np
import sklearn
from sklearn.model_selection import train_test_split

SEED = 42

X = np.arange(40, dtype=np.int64).reshape(20, 2)
y = np.array([0, 1] * 10, dtype=np.int64)
sample_indices = np.arange(len(y))

# 保存实际索引比只保存种子更可靠,可直接复用同一数据划分。
train_idx, test_idx = train_test_split(
    sample_indices,
    test_size=0.25,
    random_state=SEED,
    stratify=y,
)
train_idx_again, test_idx_again = train_test_split(
    sample_indices,
    test_size=0.25,
    random_state=SEED,
    stratify=y,
)

manifest = {
    'seed': SEED,
    'python': platform.python_version(),
    'numpy': np.__version__,
    'scikit_learn': sklearn.__version__,
    'x_sha256': hashlib.sha256(X.tobytes()).hexdigest(),
    'y_sha256': hashlib.sha256(y.tobytes()).hexdigest(),
    'train_indices': train_idx.tolist(),
    'test_indices': test_idx.tolist(),
}

Path('run_manifest.json').write_text(
    json.dumps(manifest, ensure_ascii=False, indent=2),
    encoding='utf-8',
)

print(f'same_split={np.array_equal(train_idx, train_idx_again) and np.array_equal(test_idx, test_idx_again)}')
print(f'train_size={len(train_idx)} test_size={len(test_idx)}')
print(f'x_sha256={manifest["x_sha256"][:12]}')
print('manifest=run_manifest.json')
预期输出
same_split=True
train_size=15 test_size=5
x_sha256=eedc539e16fc
manifest=run_manifest.json读取方法:same_split=True 说明相同输入和相同参数在本次环境中得到一致划分;x_sha256 用于确认数据内容未变化;完整索引和软件版本保存在 run_manifest.json。Python、NumPy 和 scikit-learn 的实际版本会因环境不同而变化。
必须记录的内容
至少记录数据文件或数组指纹、样本顺序、训练/验证/测试索引、随机种子、完整参数、代码提交号、依赖版本和模型产物。使用交叉验证时,还要记录折数、是否打乱、分组字段和每折索引;使用 GPU 或并行训练时,记录设备、线程数和确定性开关。
风险与边界
只固定种子但数据内容或顺序发生变化,会得到不同划分,后果是指标无法直接比较;安全做法是保存数据指纹和实际索引。随机参数保持默认 None 时,每次运行可能使用不同随机状态;安全做法是对每个随机组件显式传值。
多线程、GPU 算子或底层数值库可能造成细微差异,严格回归测试可能因此失败;安全替代方案是固定依赖和硬件环境,临时使用单线程或确定性算法,并用容差比较浮点结果。固定种子只能提高可复现性,不能保证跨平台逐位一致。
排障清单
结果不一致时依次核对:数据哈希与样本顺序是否相同、划分索引是否复用、所有 random_state 是否设置、预处理是否重新拟合、依赖和硬件是否变化、并行度与 GPU 确定性配置是否一致。优先比较运行清单,再检查模型代码,避免只反复修改种子。
检测数据漂移比较训练数据与线上数据分布,识别特征或目标关系发生的变化。
检测数据漂移
用于比较训练基线与线上时间窗口,发现数值特征、类别占比、缺失率或模型效果是否发生变化。检测结果用于触发调查和重训评估,不应仅凭单个统计量自动替换模型。
检测路径
先固定参考窗口和当前窗口,确保字段定义、过滤条件、采样方式和预处理一致。数值特征可比较分位数、均值、缺失率以及 KS 或 Wasserstein 距离;类别特征可比较各类别占比和总变差。标签延迟到达后,再按整体与关键分群检查 AUC、召回率、MAE、残差或校准误差,才能判断目标关系是否变化。
可运行示例
下面使用双样本 KS 检验比较一个数值特征。SciPy 的 ks_2samp 返回两组独立样本经验分布之间的 KS 统计量和 p 值。:contentReference[oaicite:1]{index=1}
from __future__ import annotations

import numpy as np
from scipy.stats import ks_2samp

KS_THRESHOLD = 0.10
ALPHA = 0.01

rng = np.random.default_rng(42)
reference = rng.normal(loc=0.0, scale=1.0, size=1000)
current = rng.normal(loc=0.5, scale=1.0, size=1000)

result = ks_2samp(reference, current, method='auto')
drift = result.statistic >= KS_THRESHOLD and result.pvalue < ALPHA

print(f'ks={result.statistic:.3f}')
print(f'p_value={result.pvalue:.3e}')
print(f'drift={str(drift).lower()}')
预期输出
ks=0.212
p_value=4.397e-20
drift=true读取方法:ks 越大,两个经验分布的最大差距越明显;p_value 用于判断差异是否具有统计证据。示例同时要求 ks >= 0.10 和 p_value < 0.01,避免只因样本量很大而对极小差异报警。阈值必须用历史稳定窗口和业务损失校准,不能直接照搬。
输出字段说明
| 字段 | 读取方式 |
|---|---|
ks |
影响大小信号,适合比较连续数值分布;应与历史基线和业务阈值一起看 |
p_value |
统计显著性信号;样本越大越容易检出微小差异 |
drift |
当前规则的综合判断,只表示需要调查,不等于模型已经失效 |
生产监控还应输出窗口时间、样本量、缺失率、基线版本、特征名、分群维度和连续异常次数,便于定位是数据管道、流量结构还是业务行为变化。
风险与边界
只看 p 值时,大样本会把业务上无意义的小变化判为异常,后果是频繁误报;安全做法是同时设置影响大小阈值,并要求连续多个窗口超限。一次检查大量特征会增加偶然告警;安全做法是做多重检验校正、按重要性分级并限制自动处置。
训练与线上使用不同清洗、编码或缺失值填充时,会制造假漂移,后果是错误重训或掩盖数据故障;安全做法是复用同一特征流水线,并单独监控原始值与处理后值。节假日、促销和昼夜周期会形成正常分布变化;应与同星期、同时段或同活动阶段的基线比较。
没有真实标签时,只能确认输入分布变化,不能确认特征与目标的关系已经变化。安全做法是等待延迟标签后检查性能、残差和分群表现,在此之前只触发人工调查或影子评估。
排障清单
告警后先确认样本量和时间窗口是否完整,再检查字段类型、单位、时区、缺失值、默认值和类别映射。随后按渠道、地区、设备、客户等级等维度切分,找出漂移来源;最后结合线上指标和延迟标签判断是否需要重训、回滚数据管道或仅调整监控基线。
评估模型公平性比较不同群体的预测表现,识别数据和模型可能产生的系统性偏差。
评估模型公平性
用于在同一标签定义、测试集和决策阈值下,按群体比较预测结果,快速定位某一群体是否承担了更高的漏判、误报或拒绝率。不要只看总体准确率,也不要把单个差值直接解释为歧视结论。
基本做法
先确认群体字段、正类含义和观察窗口一致,再按群体统计样本数、TP、FN、FP、TN。常用指标包括选择率、真正率 TPR、假正率 FPR 和精确率;同时查看真实正类占比,避免把群体基础分布差异误判为模型偏差。
高频用法
下面的纯 Python 示例不依赖第三方库,可直接运行。生产评估应把 records 替换为独立测试集或线上回放样本。
records = [
    {"group": "A", "y": 1, "pred": 1},
    {"group": "A", "y": 1, "pred": 1},
    {"group": "A", "y": 1, "pred": 0},
    {"group": "A", "y": 0, "pred": 1},
    {"group": "A", "y": 0, "pred": 0},
    {"group": "B", "y": 1, "pred": 1},
    {"group": "B", "y": 1, "pred": 0},
    {"group": "B", "y": 0, "pred": 0},
    {"group": "B", "y": 0, "pred": 0},
    {"group": "B", "y": 0, "pred": 0},
]

def safe_div(numerator, denominator):
    return numerator / denominator if denominator else float("nan")

results = {}
for group in sorted({row["group"] for row in records}):
    rows = [row for row in records if row["group"] == group]

    # 先保留混淆矩阵原始计数,便于发现小样本和分母为零。
    tp = sum(row["y"] == 1 and row["pred"] == 1 for row in rows)
    fn = sum(row["y"] == 1 and row["pred"] == 0 for row in rows)
    fp = sum(row["y"] == 0 and row["pred"] == 1 for row in rows)
    tn = sum(row["y"] == 0 and row["pred"] == 0 for row in rows)

    metrics = {
        "n": len(rows),
        "positive_rate": safe_div(tp + fn, len(rows)),
        "selection_rate": safe_div(tp + fp, len(rows)),
        "tpr": safe_div(tp, tp + fn),
        "fpr": safe_div(fp, fp + tn),
        "precision": safe_div(tp, tp + fp),
    }
    results[group] = metrics
    print(
        f"{group} n={metrics['n']} TP={tp} FN={fn} FP={fp} TN={tn} "
        f"base={metrics['positive_rate']:.2f} "
        f"selection={metrics['selection_rate']:.2f} "
        f"TPR={metrics['tpr']:.2f} FPR={metrics['fpr']:.2f} "
        f"precision={metrics['precision']:.2f}"
    )

# 差值只用于定位问题,是否可接受必须结合样本量和业务伤害判断。
print(
    "selection_gap="
    f"{abs(results['A']['selection_rate'] - results['B']['selection_rate']):.2f}"
)
print(f"tpr_gap={abs(results['A']['tpr'] - results['B']['tpr']):.2f}")
预期输出
A n=5 TP=2 FN=1 FP=1 TN=1 base=0.60 selection=0.60 TPR=0.67 FPR=0.50 precision=0.67
B n=5 TP=1 FN=1 FP=0 TN=3 base=0.40 selection=0.20 TPR=0.50 FPR=0.00 precision=1.00
selection_gap=0.40
tpr_gap=0.17
读取时先看 n 和混淆矩阵,再看差值。示例中 B 组选择率低 0.40、TPR 低 0.17,但两组真实正类占比不同且样本极少,只能触发进一步审计,不能直接下公平性结论。
输出字段说明
selection_rate 表示被预测为正类的比例;TPR 表示真实正类被识别出的比例;FPR 表示真实负类被误判为正类的比例;precision 表示正类预测中实际为正类的比例。不同业务受伤害的一方不同,应优先检查对应指标,而不是机械追求所有差值同时为零。
风险与边界
当群体样本过少、标签本身带偏差、各组使用不同时间窗口或阈值时,指标会产生误导,可能导致错误整改或掩盖真实伤害。安全做法是固定评估口径,报告样本数和置信区间,审计标签质量,并分别检查交叉群体;敏感属性应受权限和隐私控制。
单个公平性指标不能证明模型在法律、伦理或业务上公平。发现明显差异后,应回查数据采集、缺失值、特征代理变量、阈值和人工流程,再由业务、风控与合规共同决定处理方案。
避免指标误导结合业务目标、数据分布和错误成本判断离线指标是否真实有效。
避免指标误导
用于判断离线分数是否真正支持业务目标。核心做法是把指标、数据分布、决策阈值和错误成本放在同一张评估表中,防止“准确率更高”却造成更大实际损失。
指标定位
分类任务先输出混淆矩阵,再选择指标:漏判成本高时重点看召回率和 FN;误报成本高时重点看精确率和 FP;类别严重不平衡时不要只看准确率,可补充 balanced accuracy、PR-AUC 或分层结果。排序指标如 ROC-AUC 不能替代具体阈值下的业务表现。
高频用法
下面示例比较两个阈值。假设漏掉一个正例的损失为 10,误报一个负例的损失为 1,因此同时计算常规指标和错误成本。
scores = [0.95, 0.80, 0.70, 0.55, 0.45, 0.40, 0.35, 0.20, 0.10, 0.05]
labels = [1, 1, 0, 1, 0, 1, 0, 0, 0, 0]

def evaluate(threshold):
    predictions = [int(score >= threshold) for score in scores]

    # 混淆矩阵是所有派生指标的核对入口。
    tp = sum(y == 1 and p == 1 for y, p in zip(labels, predictions))
    fn = sum(y == 1 and p == 0 for y, p in zip(labels, predictions))
    fp = sum(y == 0 and p == 1 for y, p in zip(labels, predictions))
    tn = sum(y == 0 and p == 0 for y, p in zip(labels, predictions))

    accuracy = (tp + tn) / len(labels)
    precision = tp / (tp + fp) if tp + fp else 0.0
    recall = tp / (tp + fn) if tp + fn else 0.0
    f1 = (
        2 * precision * recall / (precision + recall)
        if precision + recall
        else 0.0
    )
    specificity = tn / (tn + fp) if tn + fp else 0.0
    balanced_accuracy = (recall + specificity) / 2

    # 成本权重必须来自业务损失或运营容量,不能为追求结果临时调整。
    expected_cost = fn * 10 + fp
    return (
        accuracy,
        precision,
        recall,
        f1,
        balanced_accuracy,
        expected_cost,
        tp,
        fn,
        fp,
        tn,
    )

for threshold in (0.50, 0.30):
    acc, pre, rec, f1, bacc, cost, tp, fn, fp, tn = evaluate(threshold)
    print(
        f"threshold={threshold:.2f} TP={tp} FN={fn} FP={fp} TN={tn} "
        f"accuracy={acc:.2f} precision={pre:.2f} recall={rec:.2f} "
        f"f1={f1:.2f} balanced_accuracy={bacc:.2f} cost={cost}"
    )
预期输出
threshold=0.50 TP=3 FN=1 FP=1 TN=5 accuracy=0.80 precision=0.75 recall=0.75 f1=0.75 balanced_accuracy=0.79 cost=11
threshold=0.30 TP=4 FN=0 FP=3 TN=3 accuracy=0.70 precision=0.57 recall=1.00 f1=0.73 balanced_accuracy=0.75 cost=3
阈值 0.50 的准确率更高,但因出现一次高成本漏判,总成本为 11;阈值 0.30 的准确率下降到 0.70,总成本却降到 3。读取结论时应优先判断哪个结果符合业务约束,而不是只挑数值最大的指标。
排障清单
- 训练集与测试集类别比例是否接近真实流量,是否存在时间穿越或重复样本。
- 阈值是否只在验证集上选择,并在独立测试集上进行一次最终评估。
- 是否按时间、渠道、地区、设备和关键客群切片,避免总体平均值掩盖局部失效。
- 指标提升是否伴随请求量、人工审核量、拒绝率或单位成本超出容量。
风险与边界
当类别不平衡、错误成本悬殊或线上分布漂移时,单一准确率、F1 或 AUC 可能给出错误方向,后果包括漏掉高风险样本、制造大量误报或上线后容量失控。安全替代方案是预先定义成本矩阵和容量约束,固定验证流程,并同时报告混淆矩阵、阈值指标、分层指标及置信区间。
不要在测试集上反复调阈值或选择指标,否则测试结果会被间接过拟合。上线前应使用独立留出集确认,线上再通过小流量灰度监控真实成本、校准偏差和数据漂移。