
Redis 与缓存 / 技术文章
Redis TTL 到底应该怎么设计
这篇文章面向已经在项目中使用 Redis、但 TTL 仍然靠经验随手填写的后端开发者。你会知道 TTL 应该由数据新鲜度、访问热度、重建成本和故障风险共同决定,并掌握避免缓存雪崩、热点击穿和脏数据长期滞留的基本设计方法。
TTL 不是越长越好,也不是越短越安全
TTL 本质上是在回答一个问题:这份缓存最多允许多久不重新确认真实数据。
设置得太短,会导致缓存频繁失效、数据库回源增加,甚至形成缓存击穿;设置得太长,又会让旧数据长期停留,扩大缓存与最终数据源不一致的时间窗口。
所以 TTL 设计不能只看“缓存能存多久”,而要同时考虑四个因素:
- 数据允许多旧
- 数据被访问得有多频繁
- 缓存重建成本有多高
- 同一时间有多少 Key 可能一起过期
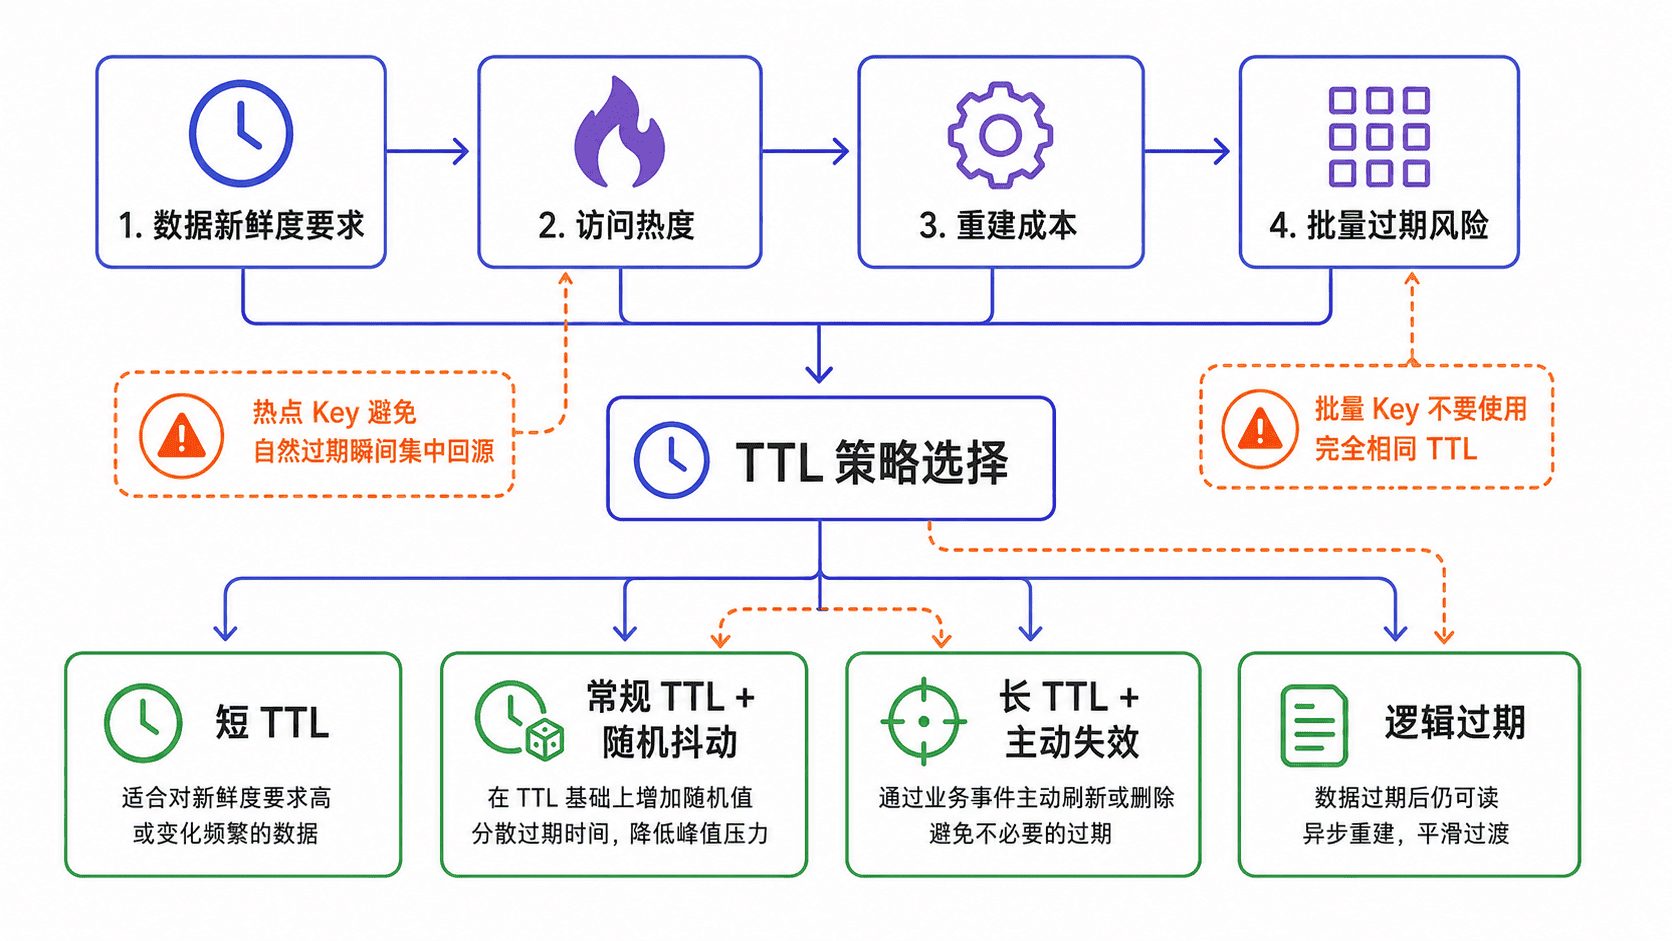
先由“允许多旧”决定基础 TTL
最先要确定的不是 Redis 性能,而是业务对数据新鲜度的要求。
例如:
- 验证码通常只允许几分钟有效
- 商品详情可能允许缓存几分钟到几十分钟
- 配置类数据如果有主动通知机制,可以缓存更久
- 几乎不变化的基础字典甚至可以使用很长 TTL
也就是说,TTL 首先是业务语义,而不是基础设施参数。
如果一份数据 10 分钟内变化一次都不可接受,那么把 TTL 设成 2 小时,即使命中率很高,也属于错误设计。
批量 Key 一定要避免同时过期
如果一批缓存由同一个任务同时写入,并且全部设置相同 TTL,那么这些 Key 也会在同一时间集中失效。
例如下面这种写法就存在雪崩风险:
redis-cli SET product:10001 '<VALUE>' EX 1800
redis-cli SET product:10002 '<VALUE>' EX 1800
redis-cli SET product:10003 '<VALUE>' EX 1800
预期输出:
OK
OK
OK
三个 Key 都会在大约 1800 秒后进入过期窗口。如果真实业务一次写入成千上万个 Key,就可能形成集中回源。
更稳妥的做法,是在基础 TTL 上增加一定范围的随机抖动,例如:
baseTtl = 1800 秒
jitter = 0 ~ 300 秒
finalTtl = baseTtl + jitter
生效行为:不同 Key 的实际过期时间会被摊开,避免大量缓存集中在同一秒失效。
热点 Key 不适合只依赖自然过期
普通 Key 过期后,下一次请求回源数据库通常问题不大;但热点 Key 在失效瞬间可能同时迎来大量请求。
例如首页配置、热门商品、活动信息,如果每秒都有大量访问,那么自然 TTL 到期可能直接触发缓存击穿。
这类数据更适合:
- 长 TTL + 主动失效
- 逻辑过期 + 后台刷新
- 互斥重建,只允许一个请求回源
- 提前刷新,在真正过期前异步续期
关键原则是:越热点的数据,越不应该把“自然到期后的第一批请求”当成缓存重建机制。
空值缓存的 TTL 应该更短
为了解决缓存穿透,很多系统会把“数据库中不存在”的结果也缓存下来。
但空值和真实数据的 TTL 不应该一样长。
假设一个用户 ID 当前不存在,你缓存了 24 小时空值;如果 5 分钟后这个用户刚好被创建,那么后续请求可能仍然被空值挡住。
因此空值缓存通常应该使用更短 TTL,例如几十秒到几分钟,具体取决于业务对新建数据可见性的要求。
主动更新的缓存可以设置更长 TTL
如果数据库更新后,系统能够可靠地删除或刷新缓存,那么 TTL 就不再是唯一的一致性保障。
这种场景下,可以把 TTL 设置得更长,让大部分失效依赖主动更新完成,而 TTL 只承担兜底职责。
例如典型的 Cache Aside 模式中:
- 更新数据库
- 删除缓存
- 下一次读取重新构建缓存
此时 TTL 可以理解为“如果主动失效漏掉了,最多多久以后自动纠正”。
TTL 越长,命中率通常越高,但兜底纠错时间也越长,因此仍然需要结合业务容忍度设置上限。
不同类型的数据不要共用一个 TTL 常量
很多项目会定义一个全局常量,例如所有缓存统一 30 分钟。代码简单了,但业务语义被完全抹平。
用户会话、商品详情、排行榜、验证码、空值缓存和系统配置,对新鲜度和风险的要求明显不同,不应该使用同一个过期时间。
更合理的做法是按业务类型定义 TTL 策略,例如:
verification-code     5 分钟
null-cache            1~3 分钟
product-detail        10~30 分钟 + 抖动
hot-config            长 TTL + 主动失效
ranking               短 TTL 或定时刷新
片段示例,具体时间必须根据业务更新频率、访问量和数据一致性要求确定,不能直接照搬。
TTL 设计最终要服务故障边界
一个好的 TTL 方案,应该让缓存过期后系统仍然可控,而不是把所有风险推给数据库。
可以用下面几个问题检查设计:
- 数据最多允许多旧?
- 过期后重建一次需要多大成本?
- 这个 Key 是不是热点?
- 同类 Key 会不会一起过期?
- 缓存失效时数据库能否承受回源流量?
- 是否有主动删除、刷新或逻辑过期机制?
- 空值和正常值是否使用了不同 TTL?
最终可以记住一句话:TTL 不是一个时间常量,而是一种流量控制和一致性策略。 普通数据根据新鲜度设置基础 TTL,批量 Key 加随机抖动,热点 Key 避免直接自然过期,主动失效则让 TTL 回归兜底角色。