
Redis 与缓存 / 技术文章
Redis Key 为什么一定要设计命名空间
这篇文章面向已经在项目中使用 Redis、但 Key 仍然随手命名的后端开发者。你会理解为什么 Redis Key 必须有稳定命名空间,如何避免跨环境、跨模块和跨业务冲突,并掌握一套可长期演进、方便排障和迁移的命名规则。
命名空间首先解决的是 Key 冲突
Redis 本质上是一个共享 Key 空间。只要多个模块、服务或业务使用同一个 Redis 实例,它们写入的 Key 就会落在同一个逻辑空间里。
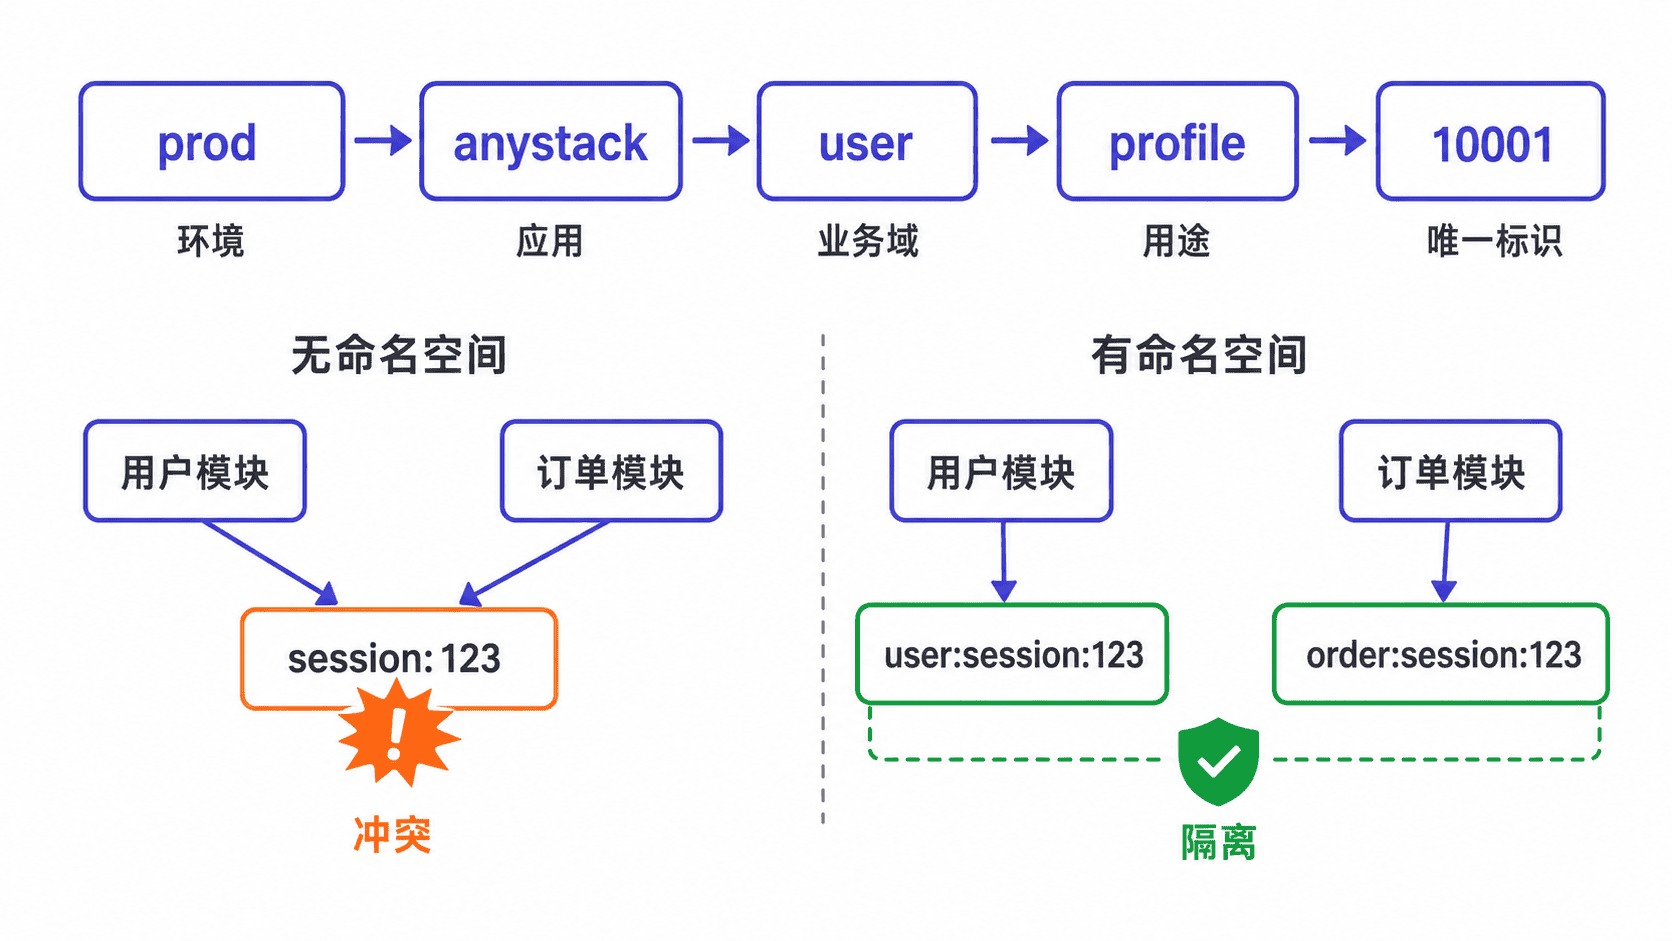
如果用户模块写入 session:123,订单模块也碰巧使用 session:123,后写入的一方就可能覆盖前者。更危险的是,两边的数据结构可能完全不同:一个按 String 读取,另一个按 Hash 写入,最终会直接触发类型错误或脏数据。
命名空间的第一价值,就是在 Key 前增加稳定的业务边界,例如:
user:session:123
order:session:123
预期结果:
两个 Key 可以在同一 Redis 实例中独立存在,不会发生覆盖。这里的前缀不是为了“看起来整齐”,而是在共享存储中建立最基本的隔离边界。
环境不隔离,测试数据迟早会碰到生产数据
开发、测试、预发布和生产环境如果复用了同一个 Redis 集群,而 Key 又没有环境前缀,就可能出现不同环境写入相同 Key 的情况。
一个常见做法是在最外层加入环境命名空间:
dev:user:session:123
test:user:session:123
prod:user:session:123
预期结果:
同一业务 Key 在不同环境中拥有独立地址,测试写入不会覆盖生产数据。如果基础设施已经做到 Redis 实例完全隔离,环境前缀可以不是强制项;但只要存在共用实例、迁移、临时联调或多租户场景,环境边界就非常重要。
好的命名空间应该能读出业务归属
一个长期可维护的 Redis Key,通常应该从左到右逐步缩小范围,例如:
prod:anystack:user:profile:10001
prod:anystack:article:view-count:article-123
prod:anystack:auth:session:8f2c
预期结果:
仅通过 Key 本身,就能判断环境、系统、业务模块和数据用途。推荐把层级理解为:
- 环境:
prod、test - 系统或应用:
anystack - 业务域:
user、article、auth - 数据用途:
profile、view-count、session - 唯一标识:用户 ID、文章 ID、会话 ID
命名空间也是排障和治理工具
线上 Redis 出问题时,排障通常不是只查一个 Key,而是要判断“哪一类 Key 在增长”“哪个模块占用内存最多”“哪些 Key TTL 异常”。
如果 Key 前缀稳定,就可以围绕前缀做扫描、统计、监控和容量治理。比如所有用户会话都统一放在 auth:session: 下,就可以单独统计这一类 Key 的数量、内存和 TTL 分布。
反过来,如果 Key 只有 12345、cache_1、tmp_data 这类名字,即使数据没冲突,运维人员也很难快速判断它属于谁、能不能删、出了问题应该找哪个服务。
因此命名空间不仅服务代码,还服务监控、审计、容量分析和故障恢复。
命名规则必须稳定,不能随着代码随意改
Redis Key 往往比某次代码版本活得更久。只要存在 TTL 较长的数据、分布式锁、幂等标记、会话或迁移状态,旧 Key 就可能和新版本程序同时存在。
如果每次重构都顺手改前缀,例如从 user: 改成 users:,再改成 account:,就会产生两套甚至三套 Key 共存的问题。旧数据无法命中,新旧代码也可能互相不兼容。
因此 Key 命名应当像数据库表名和接口协议一样,视为一种持久化契约。真的需要改名时,应该设计迁移策略,而不是直接替换字符串。
常见迁移方式包括:
- 新旧 Key 双读或读新回退旧。
- 写入阶段短期双写。
- 观察旧 Key 命中率逐步下降。
- 等待旧 TTL 自然过期,或完成显式迁移后再下线旧格式。
一个实用的命名规范
对于大多数 Java 或后端项目,可以先采用下面这类结构:
<env>:<app>:<domain>:<resource>:<id>片段示例,实际项目可按是否独立 Redis 实例决定要不要保留 <env> 和 <app>。
例如:
prod:anystack:auth:session:8f2c
prod:anystack:user:profile:10001
prod:anystack:article:detail:article-123
生效行为:同一业务域的 Key 会自然聚合在统一前缀下,既降低冲突概率,也方便按前缀做监控和迁移。
还需要注意几个边界:
- 分隔符统一使用一种,例如
:,不要在同一项目混用-、_、: - 前缀顺序固定,不要有的 Key 先写模块、有的先写环境
- 不要把超长自然语言直接塞进 Key,避免额外内存浪费
- 不要把敏感信息直接写入 Key,因为 Key 经常出现在监控、日志和排障命令中
- TTL、数据结构和命名空间应该一起形成规范,而不是只规定名字
最终可以记住一句话:Redis Key 命名空间的本质,是给共享缓存建立可识别、可隔离、可治理的地址体系。 只要 Redis 被多个环境、模块或服务共同使用,就应该把 Key 命名当成正式的数据协议来设计。