
Redis 与缓存 / 技术文章
缓存穿透、缓存击穿和缓存雪崩到底有什么区别
这篇文章面向已经会用 Redis 或本地缓存、但容易混淆三种缓存异常的开发者。你会从“数据是否存在、失效范围、并发形态”三个维度区分缓存穿透、缓存击穿和缓存雪崩,并知道各自应该优先采用什么治理手段。
三种问题的本质区别
三者的共同点都是:请求没有被缓存正常承接,压力继续向后端数据库或服务传递。真正的区别,不在“有没有缓存未命中”,而在于未命中的原因和影响范围。
| 问题 | 核心原因 | 典型对象 | 对后端的影响 |
|---|---|---|---|
| 缓存穿透 | 查询的数据本来就不存在 | 不存在的 Key | 缺少前置保护时,不存在的查询反复回源 |
| 缓存击穿 | 单个热点 Key 突然失效 | 一个高频热点 Key | 大量并发同时回源 |
| 缓存雪崩 | 大量 Key 在同一窗口失效,或缓存服务大范围不可用 | 一批 Key 或大量缓存分片 | 大面积请求集中回源,可能拖垮数据库 |
记忆时可以抓住三个关键词:穿透看“数据不存在”,击穿看“单个热点”,雪崩看“大面积失效”。
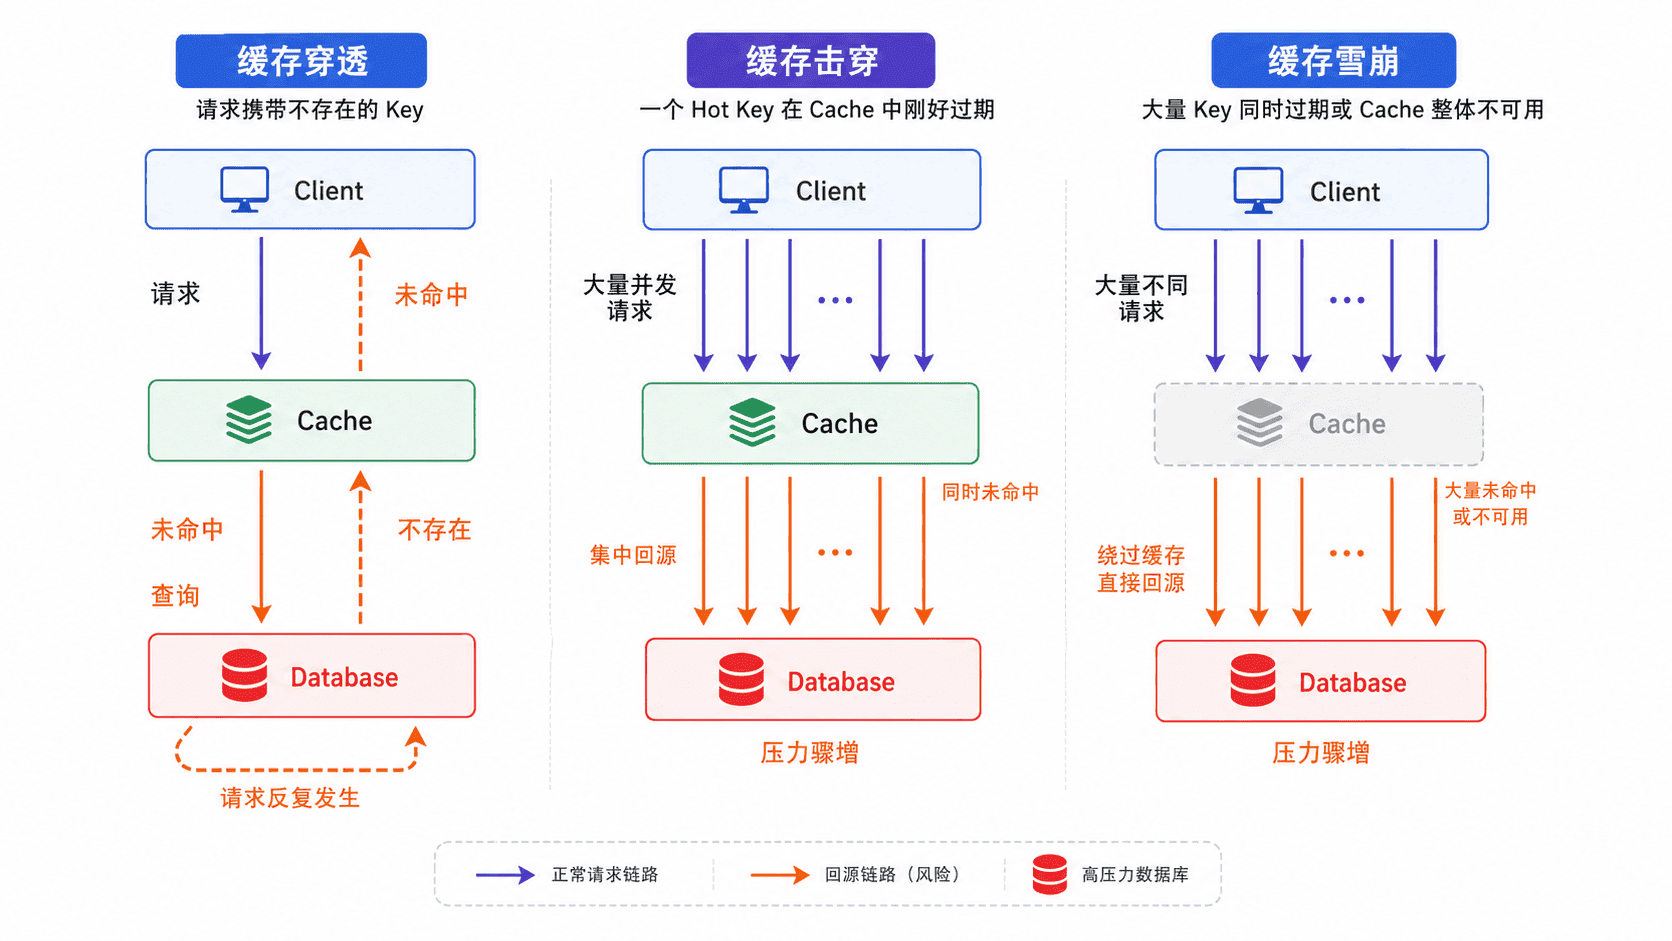
缓存穿透:请求的是不存在的数据
缓存穿透发生在“缓存里没有,数据库里也没有”的场景。比如接口按用户 ID 查询资料,而攻击者不断传入随机且不存在的 ID。由于数据库返回空结果后通常不会写入缓存,下一次相同请求仍然会再次访问数据库。
这类问题的危险之处,是攻击者可以通过大量随机 Key 持续制造缓存未命中。即使缓存服务完全正常,也无法拦住这些请求,因为目标数据从一开始就不存在。
- 对权威源明确返回的“不存在”短暂写入负缓存,同一资源创建后清理对应空值。缓存键须与资源所属租户及可见范围一致。超时、服务错误和无权限应按各自语义处理。
- 布隆过滤器可以节省集合查询的空间开销。它可能把从未加入的成员判断为“可能存在”,已经正确加入且位图保持完整的成员会被判为“可能存在”。若新增数据尚未进入过滤器,阴性结果只说明当前过滤器没有该成员。能否直接返回不存在,要看过滤器对所查数据的覆盖是否有保证。
- 参数校验和按调用方限流可以处理持续变化的随机 ID。短期缓存空值主要节省同一 ID 的重复查询。
下面用一个 64 位教学位图观察新增记录尚未同步时的结果。两个散列位置均置位才返回“可能存在”。
from hashlib import sha256

def positions(key):
    digest = sha256(key.encode("utf-8")).digest()
    return digest[0] % 64, digest[1] % 64

def mask(key):
    first, second = positions(key)
    return (1 << first) | (1 << second)

records = {"u-1", "u-2"}
bits = mask("u-1")  # u-2 已在权威集合,但同步尚未完成

def maybe_present(key):
    return (bits & mask(key)) == mask(key)

print(maybe_present("u-1"), maybe_present("u-2"), "u-2" in records)
bits |= mask("u-2")
print(maybe_present("u-2"))
输出依次为 True False True 和 True。同步滞后时应为受影响的查询保留受控回源,或按一致版本构建和切换过滤器。示例的容量只够说明集合覆盖,生产容量和误判率需要根据成员规模配置。
缓存击穿:单个热点 Key 突然失效
缓存击穿通常发生在一个访问量极高的 Key 上。这个 Key 平时命中率很高,但在某一时刻过期、被删除或重建失败,随后成百上千个并发请求同时发现缓存不存在,于是一起访问数据库。
它与缓存穿透最大的区别是:数据本身是存在的,只是这个热点 Key 在关键时刻没有缓存住。因此数据库通常能够返回结果,但数据库可能在很短时间内被同一条查询压垮。
可以按 Key 合并同时进行的重建请求。以 Go 的 singleflight.Group 为例,同一组内同时等待同一 Key 的调用可以共享一次执行。进入重建逻辑后先检查缓存,避免另一请求已回填时再次回源。多进程部署下,每个进程各自合并,整体回源仍要受数据库预算限制。若业务允许有限时间内的旧值,也可以让请求在后台刷新期间读取旧值,并限制刷新失败后还能继续提供旧值的时长。
对极少数真正长期热点的数据,也可以采用不过期或超长 TTL,再配合主动更新,但这会把一致性责任转移给业务系统,不能把它当成默认方案。
缓存雪崩:大量缓存同时失效
缓存雪崩关注的是规模。如果大量 Key 在同一时间过期,或者 Redis 集群发生故障、网络中断,原本由缓存承担的请求会在短时间内大面积回源到数据库。
最常见的诱因是批量写入缓存时给所有 Key 设置完全相同的 TTL。例如一批数据都在 30 分钟后过期,那么 30 分钟后就可能出现一次集中回源。另一类更严重的情况,是整个缓存服务不可用,此时所有业务 Key 都失去保护。
治理雪崩通常需要多层措施共同生效:
- 给 TTL 增加随机抖动,避免大量 Key 在同一秒集中失效。
- 对缓存集群做高可用和故障转移,降低“整个缓存层消失”的概率。
- 在数据库前增加限流、熔断、降级和队列削峰,防止缓存故障直接传导为数据库故障。
- 对核心数据使用多级缓存或本地兜底,让部分流量在 Redis 不可用时仍有退路。
TTL 抖动用来分散过期窗口,范围应满足业务的新鲜度要求。缓存服务失联时,即使 TTL 分布均匀,流量仍可能大面积回源。此时优先观察缓存连接错误、超时及权威源的并发,用有上限的回源和降级保护后端。
最容易混淆的边界
如果一个热点 Key 过期后,大量请求同时访问数据库,这是缓存击穿;如果一批热点 Key 同时过期,导致大量不同查询一起访问数据库,就已经更接近缓存雪崩。
偶尔查到不存在的记录是正常行为。当大量不存在的查询反复越过缓存、增加回源时,才需要按穿透治理。排查时可同时看权威源确认不存在的比例、回源请求是否集中于少数 Key、过期分布及缓存错误率。
因此判断时不要先看“数据库压力大不大”,而要先问三个问题:数据是否真实存在?失效的是一个热点 Key 还是很多 Key?缓存服务本身是否仍然可用?