
大模型应用开发 / 技术文章
RAG 是什么,为什么大模型还需要检索
大模型已经学习了大量公开知识,但它并不天然知道公司的内部文档、刚发布的产品规则或今天才更新的数据。RAG 解决的正是这个缺口:先从外部知识源找到与问题相关的内容,再让模型基于这些内容回答。理解这条链路后,就能判断什么时候应该使用 RAG,而不是单纯换一个更大的模型。
RAG 本质上是在回答前先查资料
RAG 是 Retrieval-Augmented Generation 的缩写,通常译为检索增强生成。它把“检索”和“大模型生成”组合成一条问答链路。
普通大模型问答主要依赖模型训练阶段形成的参数知识。用户提出问题后,模型根据已有参数直接预测回答。RAG 则会在生成之前增加一个检索步骤:系统先根据问题从文档、数据库或其他知识源中找到相关资料,再把问题和这些资料一起交给大模型。
可以把两种方式简单理解为:普通大模型更像依靠记忆回答,而 RAG 更像先查资料再组织答案。
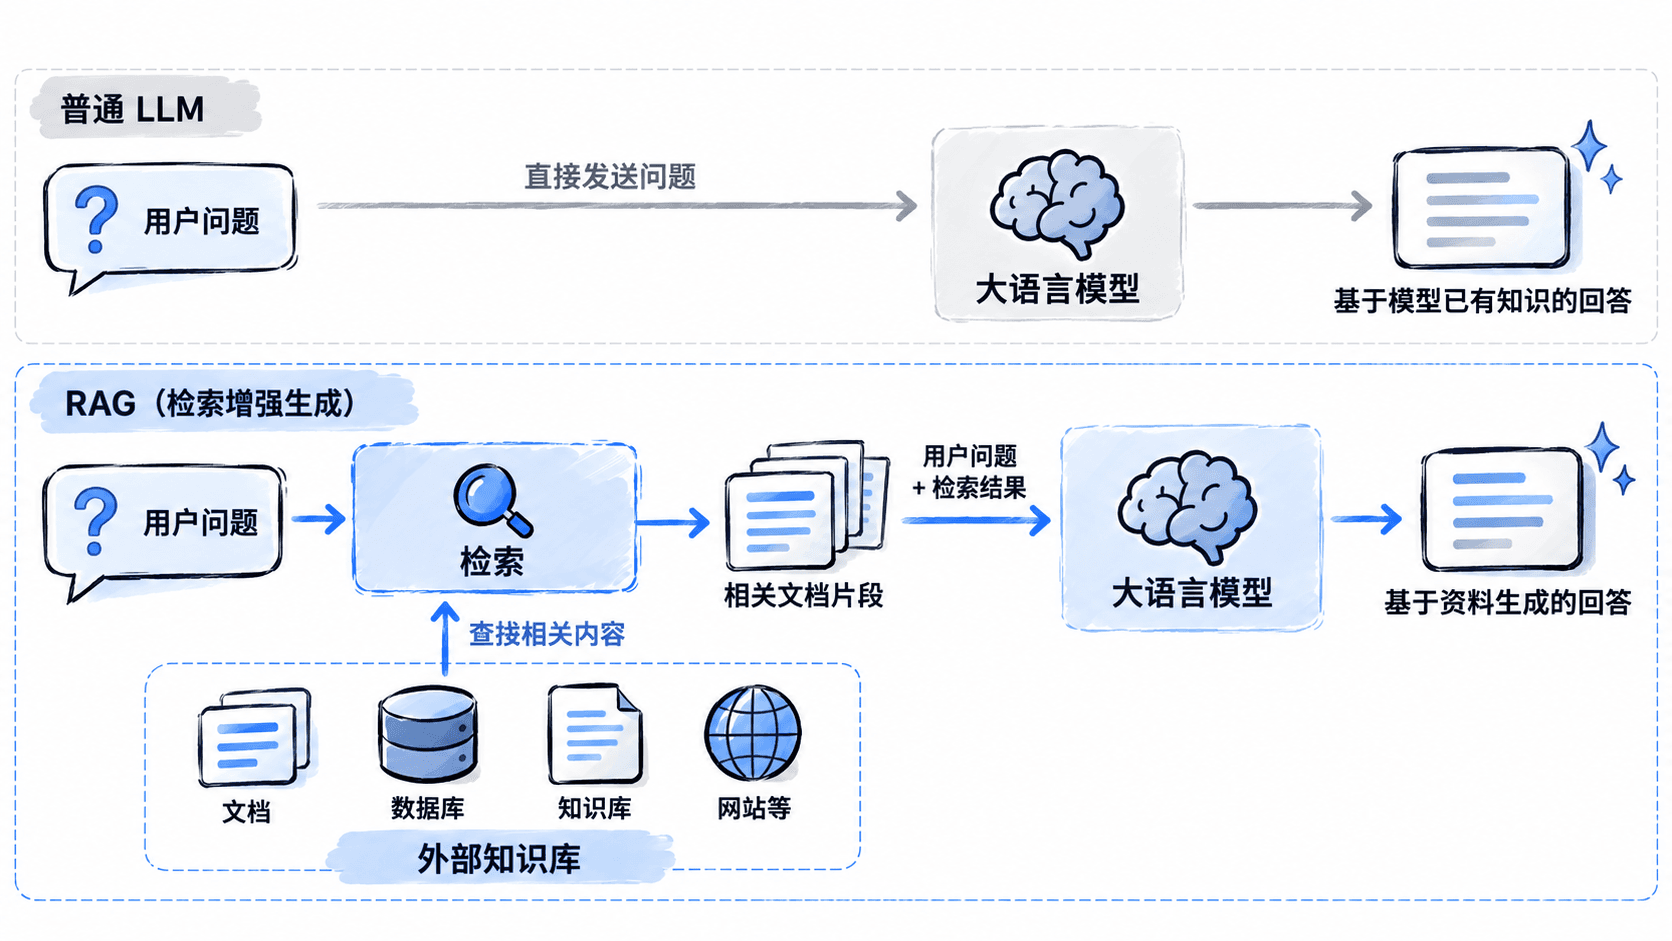
这里的“增强”并不是修改模型本身,而是在模型处理当前请求时,为它临时补充一组更相关、更可信的上下文。
大模型为什么不能直接记住所有知识
训练一个大模型,本质上是把大量数据中的统计规律压缩进模型参数。训练完成后,这些知识并不像数据库记录一样,可以按照某个主键精确读取。
这会带来几个天然限制。
首先是知识有时间边界。模型训练完成之后发生的新事件、新版本、新政策不会自动进入参数。即使模型提供商不断更新模型,也很难保证所有领域知识实时同步。
其次是私有知识不在训练数据里。企业内部接口文档、项目设计、客服手册、合同条款和研发规范,本来就不应该被公开拿去训练通用模型。
再次是模型生成并不等于事实查询。语言模型擅长根据上下文预测合理文本,当已有知识不足时,仍可能生成听起来正确但实际上没有依据的内容,这也是常说的幻觉问题。
因此,“模型参数很多”与“能够准确查询所有知识”是两件不同的事。
RAG 怎样把自己的知识交给大模型
一个典型 RAG 系统并不是用户提问时才去遍历所有原始文件。实际应用通常会先对知识进行预处理。
文档进入知识库后,会被拆成较小的文本片段,例如把一篇很长的产品手册拆成若干段。系统再为这些片段建立可检索的表示。常见做法是使用 Embedding 模型把文本转换成向量,并存入支持向量搜索的索引或数据库。
用户提出问题后,系统也会把问题转换成可用于检索的表示,然后找出语义最接近的若干文档片段。最后,再把这些片段和原始问题一起组成模型输入。
整个过程可以概括为:
- 准备原始文档或其他知识源。
- 将长内容拆分成适合检索的片段。
- 为片段建立索引,例如向量索引或关键词索引。
- 用户提出问题后检索相关片段。
- 将问题和检索结果一起发送给大模型。
- 大模型根据提供的资料组织最终回答。
检索出来的内容为什么能改善回答
大模型生成文本时非常依赖当前上下文。如果提示词中已经提供了“产品退款期限为 7 天”“某接口从 v2 开始废弃”这类明确资料,模型就不必完全依靠参数中的旧知识猜测答案。
例如,公司昨天修改了一项内部报销规则。重新训练一个大模型显然不现实,但 RAG 只需要更新知识库中的对应文档。员工第二天提问时,检索阶段就可以把最新规则送进模型。
这也是 RAG 相比重新训练模型非常重要的一点:知识可以独立于模型更新。
同时,系统还可以把被检索到的文档来源一起返回,让用户知道回答依据来自哪份资料。对于企业知识问答、客服和技术文档助手,这种可追溯性往往比单纯让回答更流畅更重要。
RAG 不等于把所有文档塞进提示词
如果知识库只有几页内容,确实可以一次性把全部文本交给模型。但随着文档增加,这种方式很快会遇到问题。
模型的上下文窗口虽然越来越大,但输入越长通常意味着更高的推理成本,而且大量无关内容会干扰模型判断。一个包含几千份文档的知识库,没有必要为了回答“怎么重置密码”而把全部内容发送给模型。
RAG 的作用就是先做筛选,只挑出当前问题可能需要的部分。
例如知识库里有 10 万个文本片段,检索阶段可能只选出最相关的 5~10 个片段,再交给模型。模型面对的是一个经过压缩的候选知识集合,而不是整个知识库。
但这也意味着 RAG 的质量高度依赖检索。如果真正需要的文档没有被找出来,后面的模型再强,也很难基于不存在的上下文给出正确答案。
RAG 和微调解决的不是同一个问题
RAG 经常和模型微调放在一起比较,但两者的目标并不相同。
RAG 更适合解决“模型现在需要知道什么”。知识保存在模型外部,可以频繁更新,也可以在生成答案时附带来源。
微调更适合改变“模型应该怎样回答或完成任务”。例如固定输出格式、适应某种任务模式、学习特定表达方式,或者强化某类专业任务能力。
如果公司的产品手册每天都会更新,单纯依靠微调同步知识通常成本很高;如果要求模型始终按照一种特定结构输出,仅靠 RAG 提供几篇文档也未必能稳定解决。
实际系统中两者也不是互斥的。一个模型可以先经过任务微调,再通过 RAG 获取最新或私有知识。
哪些场景值得使用 RAG
当回答依赖模型训练之外、变化频繁或者需要明确依据的知识时,RAG 通常具有明显价值。
常见场景包括企业内部知识问答、产品帮助中心、技术文档助手、客服知识库、法律或制度资料查询,以及需要查询大量专业文献的应用。
如果问题本身主要依赖通用推理,例如改写一段文字、解释一个基础概念或者根据用户已经提供的信息进行总结,就不一定需要额外检索。没有明确知识源时强行加入 RAG,反而会增加系统复杂度和延迟。
判断是否需要 RAG,可以先问一个问题:模型回答之前,是否存在一批它应该先查阅的外部资料? 如果答案是肯定的,而且这些资料不能可靠地依靠模型参数保存,RAG 通常就是值得考虑的方案。
RAG 的核心价值并不是让大模型“拥有更多参数”,而是把模型从只依靠记忆回答,变成能够在需要时获取外部知识再回答。模型负责理解问题和组织语言,检索系统负责找到当前可信、相关的资料,两部分结合起来,才构成更适合真实知识场景的问答系统。