
大模型应用开发 / 技术文章
RAG 系统:从检索到生成的完整流程
本文解决“RAG 请求进入系统后究竟经历了什么”的问题,适合准备开发知识库问答、企业搜索或智能客服的工程人员。读完后,你将能按摄取、检索、重排、上下文组装、生成与验证六个阶段理解并设计一条完整链路。
RAG 的核心不是“先搜再问”
RAG,即检索增强生成,把外部知识检索结果作为上下文交给大模型。它解决的不是模型会不会组织语言,而是回答时能否拿到与当前问题相关、可追溯且足够新的事实。
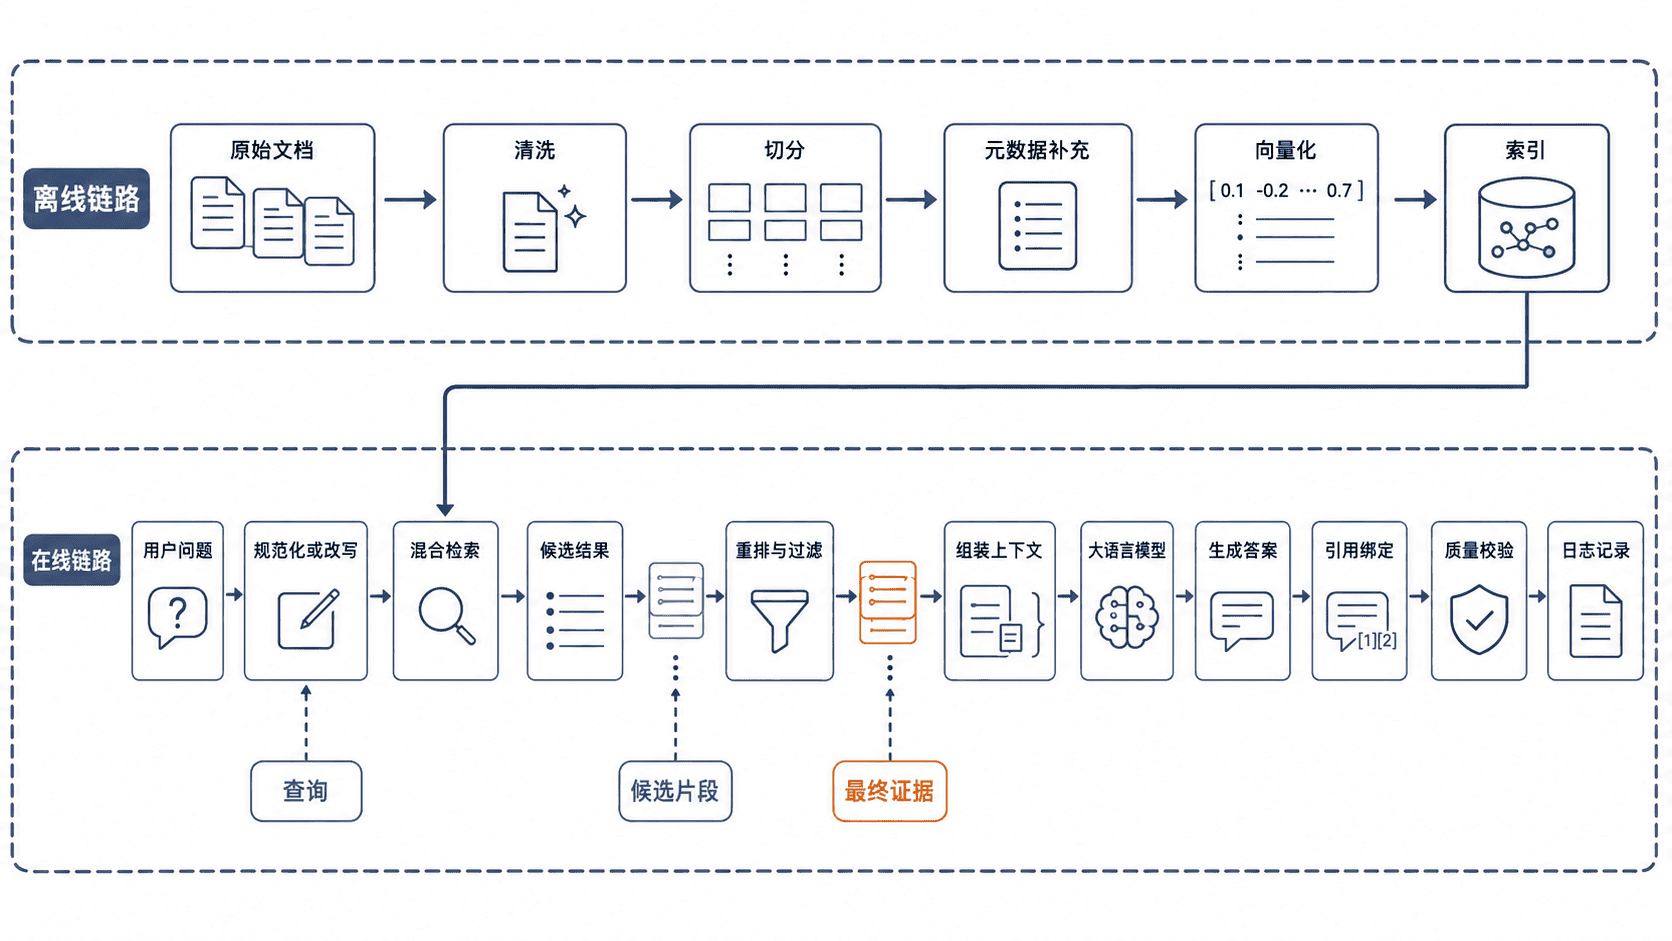
一条可靠链路通常分为离线和在线两部分。离线阶段负责把原始文档转换成可检索索引;在线阶段接收用户问题,找到证据,组织提示词,再让模型基于证据生成答案。两部分共同决定最终效果,单独更换大模型通常无法修复错误切分、召回不足或上下文污染。
离线阶段:把文档变成可检索知识
文档进入索引前,通常要经过解析、清洗、切分、补充元数据和向量化。解析负责提取正文、标题、表格或页码;清洗去除导航、页眉和重复模板;切分则把长文档拆成模型和检索器都能处理的片段。
切分不是越短越好。片段过短会丢失上下文,过长则容易包含多个主题并挤占提示词窗口。常见做法是按标题和段落边界切分,再保留少量重叠内容。每个片段还应携带 document_id、标题、来源、更新时间、权限范围和页码等元数据,方便过滤、引用和审计。
向量索引适合召回语义相近内容,关键词索引擅长识别产品名、错误码和精确术语。生产系统常采用混合检索,而不是只依赖一种索引。
在线阶段:从问题得到候选证据
用户问题到达后,系统先做轻量预处理,例如语言识别、拼写归一、时间范围提取、权限注入和多轮对话补全。只有当原问题含糊或依赖上下文时才需要查询改写,过度改写可能改变用户真实意图。
检索器随后从索引中返回一批候选片段。第一阶段追求高召回率,宁可多找一些;第二阶段使用交叉编码器、规则或大模型重排,判断每个片段是否真正回答当前问题。重排后还要执行权限过滤、时间过滤、去重和来源多样性控制。
可以把在线检索理解为三次收缩:先从全部知识中召回候选,再按相关性重排,最后按权限、时效和上下文预算选出证据。任何一步过早丢弃正确片段,后续生成阶段都无法凭空恢复。
上下文组装:把证据变成模型可用输入
上下文组装不是简单拼接检索结果。系统需要控制片段顺序、总长度、重复内容和指令边界,并明确告诉模型“只能依据给定证据回答”。通常将高相关片段放在前部,为每段分配稳定编号,并保留来源信息以便答案引用。
当证据相互冲突时,不应让模型自行猜测。更稳妥的策略是优先采用更新时间更近、来源等级更高的内容,或在答案中明确指出冲突。若证据不足,应允许模型回答“现有资料无法确认”,而不是强制生成完整结论。
一个基础提示词通常包含四部分:系统约束、用户问题、编号后的证据片段和输出格式。上下文预算不足时,应优先保留覆盖问题关键实体和关键条件的片段,而不是机械截断最后几段。
最小可运行示例:串起检索与生成
下面示例用标准库实现一个可运行的简化链路:先计算词频余弦相似度召回片段,再组装上下文,最后由规则生成器根据证据输出答案。它用于观察 RAG 的数据流;生产环境可将 retrieve 替换为向量数据库或混合检索,将 generate_answer 替换为真实大模型调用。
import math
import re
from collections import Counter

DOCUMENTS = [
    {
        "id": "doc-1",
        "text": "RAG 在生成答案前检索外部知识,并把相关片段放入上下文。"
    },
    {
        "id": "doc-2",
        "text": "重排模型会重新评估候选片段与用户问题的相关性。"
    },
    {
        "id": "doc-3",
        "text": "向量数据库负责保存向量及其对应的文本和元数据。"
    },
]

def tokenize(text: str) -> list[str]:
    # 示例按中文单字和英文单词切分,便于保持零依赖运行。
    return re.findall(r"[A-Za-z]+|[\u4e00-\u9fff]", text.lower())

def cosine_similarity(left: str, right: str) -> float:
    a, b = Counter(tokenize(left)), Counter(tokenize(right))
    common = set(a) & set(b)
    numerator = sum(a[token] * b[token] for token in common)
    norm_a = math.sqrt(sum(value * value for value in a.values()))
    norm_b = math.sqrt(sum(value * value for value in b.values()))
    return numerator / (norm_a * norm_b) if norm_a and norm_b else 0.0

def retrieve(query: str, top_k: int = 2) -> list[dict]:
    scored = [
        (cosine_similarity(query, item["text"]), item)
        for item in DOCUMENTS
    ]
    scored.sort(key=lambda pair: pair[0], reverse=True)
    return [item for score, item in scored[:top_k] if score > 0]

def generate_answer(query: str, evidence: list[dict]) -> str:
    # 规则生成器只演示“基于证据回答”,不冒充真实大模型。
    if not evidence:
        return "现有资料无法回答该问题。"
    context = " ".join(item["text"] for item in evidence)
    if "生成" in query and "检索" in context:
        return f"RAG 会先检索外部知识,再把相关片段加入上下文后生成答案。[来源:{evidence[0]['id']}]"
    return "现有资料包含相关证据,但不足以形成确定结论。"

def main() -> None:
    query = "RAG 如何从检索走到生成?"
    evidence = retrieve(query)
    print("命中片段:", [item["id"] for item in evidence])
    print("回答:", generate_answer(query, evidence))

if __name__ == "__main__":
    main()
预期输出
命中片段: ['doc-1']
回答: RAG 会先检索外部知识,再把相关片段加入上下文后生成答案。[来源:doc-1]
示例中的检索结果完全由本地文档决定,因此输出稳定。真实系统还应记录候选分数、重排分数、过滤原因、上下文长度、模型版本和最终引用,才能定位问题出在召回还是生成。
生成之后:验证答案而不是直接返回
模型生成文本后,系统仍需执行答案后处理。最基本的检查包括:引用编号是否存在、关键事实能否在证据中找到、是否泄露无权限内容、输出格式是否满足接口协议,以及答案是否包含模型自行补充的断言。
质量评估应拆成不同指标。检索阶段可看 Recall@K、MRR 或命中率;生成阶段可看忠实度、答案相关性和引用准确率;线上还要观察无答案率、响应时间、Token 消耗和用户追问率。只看“答案像不像人写的”,无法判断系统是否真的可信。
出现错误时应按链路逆向定位:先确认答案是否忠于上下文,再检查上下文是否包含正确证据,最后检查索引中是否存在正确内容。这个顺序能快速区分生成错误、检索错误和数据源缺失。
设计一条可上线的 RAG 链路
落地时可以先建立最小闭环:选定一类高价值文档,定义可回答的问题范围,完成切分与索引,加入混合检索和重排,再实现带引用的受约束生成。不要一开始接入所有知识源,否则难以判断质量变化来自哪一环。
上线前至少准备一组真实问题及标准证据,并对每次版本变更进行回归测试。只有当系统能稳定找到正确片段、在证据不足时拒绝猜测,并能把答案追溯到来源时,这条从检索到生成的流程才算完整。