
大模型应用开发 / 技术文章
Embedding 为什么能够实现语义搜索
本文解决“为什么一串数字能理解语义”这个核心问题,适合准备学习 RAG、向量数据库或 AI 搜索的开发者。读完后,你将能说清 Embedding、向量距离与语义召回之间的关系,并知道这种搜索什么时候可靠、什么时候会失效。
关键词搜索为什么不够
传统关键词搜索主要判断查询词是否出现在文档中,或统计词频、位置和字段权重。它擅长查找产品编号、错误码、专有名词等精确内容,却难以识别“表达不同、含义相近”的文本。
例如,用户搜索“如何降低接口响应时间”,文档标题可能写成“Web 服务性能优化”。两段文字几乎没有相同词语,但都围绕服务延迟与性能。如果系统只比较字符或词项,它们的相关性会被低估。
语义搜索要解决的不是“有没有同一个词”,而是“是否在讨论同一件事”。Embedding 正是把这个难以直接计算的问题,转换成可以计算的向量距离问题。
Embedding 把含义映射到向量空间
Embedding 模型接收一段文本,输出一个固定长度的稠密向量,例如 768 维或 1536 维。向量中的单个数字通常没有可独立解释的业务含义,真正有价值的是整个向量在高维空间中的位置。
以对比学习训练的检索模型为例,训练目标鼓励查询与相关文档的向量取得更高的匹配分数,并降低与训练中负样本的匹配分数。因此,“退款多久到账”和“退回的钱何时到账”可以比无关文本更接近。模型学到的相关性取决于训练数据和目标,换到新领域时需要用样本核对。
这种映射不是把每个主题硬编码到某一维,而是把语义分布到许多维度共同表达。主题、意图、对象、语气和上下文等信息会组合成一个整体位置,所以向量能保留比关键词集合更丰富的关系。
相似度如何变成搜索分数
查询向量 与文档向量 需要处于兼容的向量空间。对称任务可以共用编码入口。短查询检索长文档时,要依模型约定使用配套的查询与文档编码入口,部分模型要求不同前缀或采用不同编码路径。系统据相似度从高到低排序,若用距离则一般从小到大排序。 Sentence Transformers 语义检索说明
常见方法是余弦相似度:
余弦相似度比较两个非零向量的方向。若查询和文档向量都经过 L2 归一化,点积等于余弦相似度,平方欧氏距离等于 ,三种度量得到相同顺序。未归一化时点积会受到向量长度影响。检索时应采用模型建议的度量,并让索引配置与查询一致。
| 比较方式 | 关注重点 | 常见特点 |
|---|---|---|
| 关键词匹配 | 是否出现相同词项 | 精确、可解释,但容易漏掉同义表达 |
| 余弦相似度 | 向量方向是否接近 | 适合比较语义方向,常用于文本检索 |
| 欧氏距离 | 空间中的直线距离 | 直观,但对向量尺度更敏感 |
一次语义搜索如何完成
文档入库时,系统先把长文切成适合检索的文本块,再为每个文本块生成向量,并将向量与原文、标题、来源等元数据一起保存。用户发起查询后,系统按配套的查询入口生成向量,从允许访问的文档中召回最近的若干文本块。精确检索逐一比较候选向量,可用作召回基线。近似索引减少比较量,可能漏掉精确结果中的近邻,需在实际数据量与过滤条件下验证召回率和延迟。
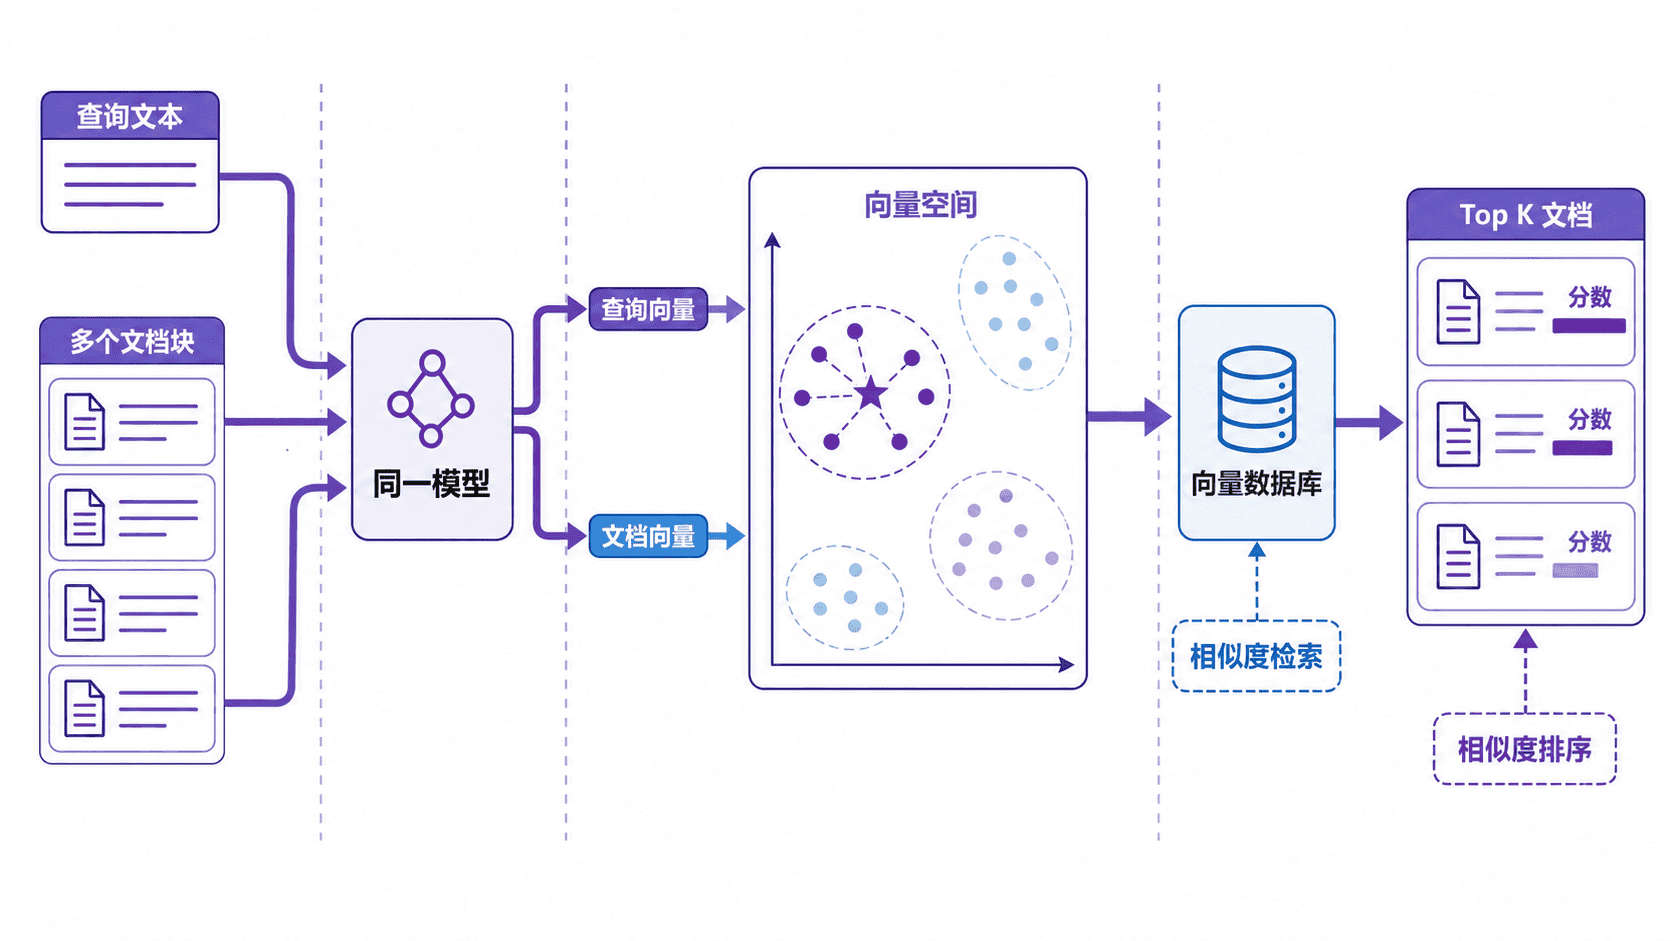
这个流程可以分成两个阶段。离线阶段负责切分、向量化和建立索引;在线阶段负责查询向量化、近邻搜索和结果排序。文档向量提前生成,在线仍需计入查询编码、过滤、索引搜索与重排的耗时。候选预算和过滤方式会改变召回率。例如 pgvector 的近似索引可能先扫描再应用过滤,筛掉不可访问的文档后,实际结果可能少于所需条数。授权校验要在服务端落实,禁止未授权正文进入返回结果或生成模型的上下文。 pgvector 近似索引过滤
用二维向量复现排序
下面的向量是手工设定的,只演示度量和权限过滤。查询向量与内部文档同向,因此全局余弦分数最高。对公开资料而言,按余弦排序与按未经归一化的点积排序会得到不同的首选。
from math import hypot

query = (2, 1)
docs = [
    ("退款到账指南", (3, 2), True),
    ("支付服务监控", (8, 0), True),
    ("退款内部审核", (2, 1), False),
]

def dot(a, b):
    return sum(x*y for x, y in zip(a, b, strict=True))

def cosine(a, b):
    return dot(a, b) / (hypot(*a) * hypot(*b))

public = [(name, vector) for name, vector, allowed in docs if allowed]
for metric in (cosine, dot):
    name, vector = max(public, key=lambda doc: metric(query, doc[1]))
    print(f"{metric.__name__}: {name} ({metric(query, vector):.3f})")
余弦选中“退款到账指南”,原始点积选中向量较长的“支付服务监控”。若只取全局余弦第一名再剔除内部资料,这个查询会返回空结果,即便库中存在相关的公开文档。
在 RAG 系统中,检索结果还会被送入大语言模型作为上下文。Embedding 负责“找可能相关的材料”,生成模型负责“阅读材料并组织答案”,两者职责不同。
为什么不同表达仍能被找出来
Embedding 能处理同义表达,关键不在于模型认识某个固定词典,而在于它从上下文中学习了词语和句子的使用规律。例如“苹果”可能指水果,也可能指公司;完整句子中的其他词会帮助模型确定当前语境。
它还能够识别意图层面的相似性。查询“订单一直显示处理中怎么办”,可能匹配到“支付状态长时间未更新的排查方法”,因为两者共享“状态异常”和“需要排查”的意图结构。
不过,语义接近不等于事实完全匹配。两段文本可能主题相同,却在地区、版本、时间或权限条件上不同。因此生产系统通常会把向量相似度与关键词、时间范围、产品类型、权限标签等过滤条件结合使用。
能力边界与使用原则
Embedding 不是通用事实判断器。文本切分过碎会丢失上下文,切分过长又会混入多个主题;模型不适合目标领域时,专业术语之间的距离也可能不准确。更换模型或维度时,要核对新旧向量空间兼容性,通常需要按新配置重新向量化并建索引。若只修改归一化规则且保留了可用的原始向量,可以由原向量重新变换,再按新度量重建索引。
对于订单号、身份证号、错误码和精确字段,关键词或结构化查询往往更可靠;对于自然语言问答、知识库召回、相似内容推荐和同义问题匹配,向量检索更有优势。实际系统常采用混合检索,再用重排模型提升前几名结果的相关性。
判断语义搜索是否有效,不应只看某个示例“看起来合理”,而要准备包含同义表达、干扰文档、专业术语和边界条件的测试集,持续评估召回率与前几名结果质量。Embedding 真正实现语义搜索的原因,是它把不可直接比较的语言含义,转换成了可计算、可索引、可排序的空间关系。