
NoSQL 与搜索 / 技术文章
向量数据库为什么适合 AI 应用
这篇文章解决“为什么 AI 应用经常需要向量数据库”这一问题,适合正在学习 RAG、智能问答或推荐系统的开发者。读完后,你将能判断向量数据库解决了什么、它与传统数据库的差异,以及项目中何时值得引入。
AI 应用真正需要的是语义检索
大模型可以生成文本,却不会自动记住企业文档、商品资料或实时业务数据。应用若要基于私有知识回答问题,必须先从外部数据中找到与当前问题最相关的内容,再把结果交给模型生成答案。
关键词检索依赖字面匹配。例如用户搜索“订单为什么被退回”,文档中可能写的是“支付请求被拒绝”。两段文字没有相同关键词,但语义接近。AI 应用需要的不是简单查找某个词,而是找出“意思最相近”的内容。
向量把语义变成可计算的距离
Embedding 模型会把文本、图片或音频转换成固定维度的数字向量。语义越接近的内容,向量在空间中的方向通常越相似。检索时,系统只需比较查询向量与数据向量的相似度,就能得到最相关的候选结果。
下面的最小示例用余弦相似度演示这一核心过程。它不是完整的向量数据库,但能说明向量检索为何可以跨越关键词差异。
from math import sqrt

documents = {
    "退款申请被拒绝": [0.9, 0.1],
    "重置登录密码": [0.1, 0.9],
    "支付状态异常": [0.7, 0.7],
}
query_vector = [1.0, 0.0]

def cosine_similarity(left: list[float], right: list[float]) -> float:
    dot = sum(a * b for a, b in zip(left, right))
    left_norm = sqrt(sum(a * a for a in left))
    right_norm = sqrt(sum(b * b for b in right))
    return dot / (left_norm * right_norm)

results = sorted(
    (
        (text, cosine_similarity(query_vector, vector))
        for text, vector in documents.items()
    ),
    key=lambda item: item[1],
    reverse=True,
)

for text, score in results:
    print(f"{text}: {score:.4f}")
预期输出
退款申请被拒绝: 0.9939
支付状态异常: 0.7071
重置登录密码: 0.1104
真实向量数据库会在此基础上提供高维向量存储、近似最近邻索引、批量写入、持久化、分片、过滤和并发查询,使相似度搜索可以在大量数据上稳定运行。
为什么普通数据库难以直接替代
关系型数据库擅长精确条件、事务和关联查询,例如按订单号查询订单,或按时间范围统计交易。全文搜索引擎擅长倒排索引、关键词权重和模糊匹配。它们都很重要,但并非为高维向量的最近邻搜索而设计。
| 能力 | 关系型数据库 | 全文搜索引擎 | 向量数据库 |
|---|---|---|---|
| 主要查询方式 | 精确条件与关联 | 关键词与文本相关性 | 语义相似度 |
| 典型数据 | 订单、账户、配置 | 文章、日志、网页 | Embedding 向量与元数据 |
| 擅长场景 | 事务和一致性 | 关键词检索 | RAG、推荐、以图搜图 |
| 常见限制 | 高维近邻搜索成本高 | 依赖词面特征 | 不适合替代核心交易库 |
向量数据库的关键价值不是“也能存数据”,而是把向量索引、相似度计算和元数据过滤组合成面向 AI 检索的基础设施。常见近似最近邻索引会牺牲少量精确度,换取更快的查询速度和更低的计算成本。
一次 AI 检索请求如何运行
典型流程包含查询向量化、候选召回、条件过滤、结果重排和模型生成。系统需要同时处理原始文档、向量、业务元数据以及大模型上下文,因此用图理解数据流比只看文字更直接。
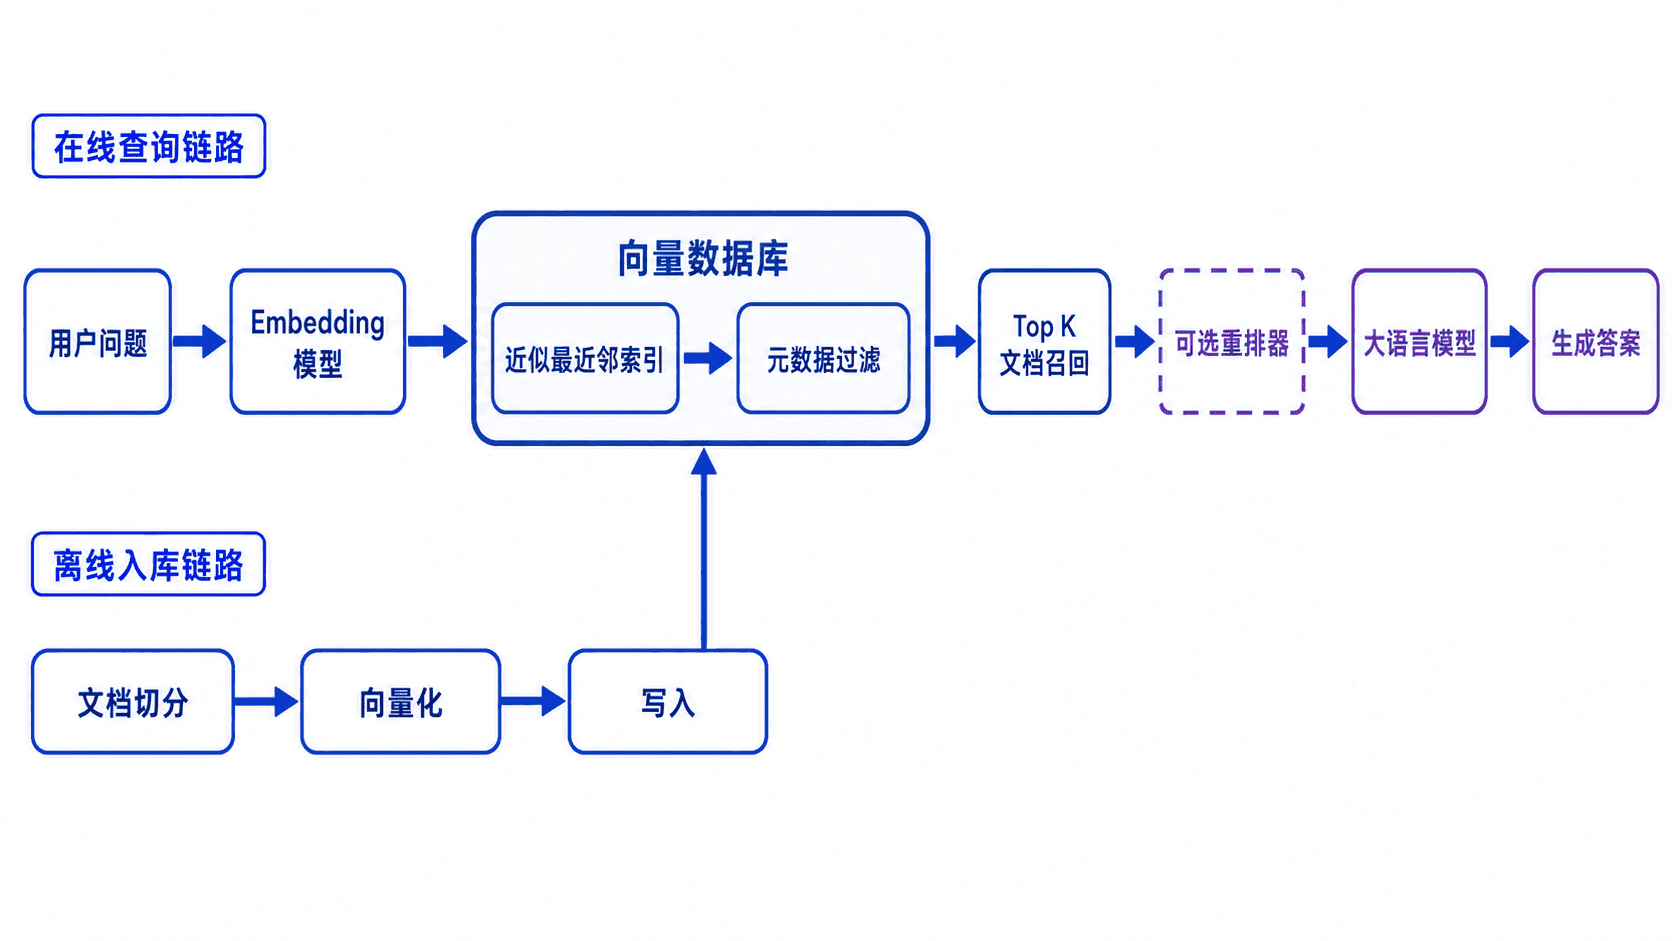
向量数据库返回的通常不是最终答案,而是若干相关片段及其相似度、文档 ID、来源、时间、权限等元数据。应用再将这些片段组织成提示词,让大模型在受控上下文中回答,从而减少脱离业务资料的猜测。
它为什么特别适合 AI 应用
第一,输入类型统一。文本、图片、音频和用户行为都可以转换为向量,检索层因此能用相似的方式处理多种数据。第二,语义召回更自然,用户不必准确记住文档中的原词。
第三,结果可以与业务条件结合。系统能够先限制租户、语言、时间或权限,再执行向量检索,避免把无权访问的内容送入模型。第四,向量索引适合 Top K 查询,正好对应 RAG 中“召回少量高相关上下文”的需求。
这些能力让向量数据库成为模型与业务知识之间的检索层,而不是大模型本身的替代品。模型负责理解和生成,向量数据库负责从大量候选数据中快速找到相关内容。
什么时候使用,什么时候不要硬用
当应用需要语义问答、相似内容推荐、重复内容检测、图片检索或跨模态搜索时,向量数据库通常值得采用。若数据量很小,也可以先用内存计算或数据库扩展验证方案,再决定是否引入独立服务。
如果需求只是按主键查订单、执行强事务更新或生成财务报表,应继续使用关系型数据库。向量数据库不应承担账户余额、支付状态等强一致核心数据。实际项目通常采用组合架构:关系型数据库保存事实数据,搜索引擎处理关键词检索,向量数据库负责语义召回。
落地时先定义可衡量的检索指标,例如相关片段命中率、无答案问题识别率和查询延迟,再选择向量模型、切分策略与索引参数。只有检索质量稳定,后续的大模型生成才有可靠输入。