
大模型应用开发 / 知识点
LangChain 开发速查手册
手册条目
安装 LangChain创建 Python 环境并安装 LangChain 1.x 核心依赖。
安装 LangChain
用于新建隔离的 Python 环境并安装 LangChain 1.x 核心包。LangChain 1.x 要求 Python 3.10 及以上;模型服务商集成包需要另行安装。:contentReference[oaicite:0]{index=0}
命令定位
先确认解释器版本,再创建 .venv。使用 python -m pip 可确保依赖安装到当前解释器,而不是系统中的另一套 pip。
python --version
python -m venv .venv
source .venv/bin/activate

# 先升级安装工具,再安装当前 LangChain 1.x
python -m pip install --quiet -U pip
python -m pip install --quiet -U "langchain>=1,<2"

python -c "import langchain; print(langchain.__version__)"
预期输出
Python 3.<MINOR>.<PATCH>
<VERSION><MINOR>、<PATCH> 和 <VERSION> 取决于本机及安装时间。最后一行能打印 1.x 版本号,说明虚拟环境和核心包均可用。
Windows 激活
Windows PowerShell 创建环境的命令相同,激活脚本路径不同。
py -3.10 -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --quiet -U pip
python -m pip install --quiet -U "langchain>=1,<2"
python -c "import langchain; print(langchain.__version__)"
预期输出
<VERSION>若 PowerShell 阻止脚本执行,可仅对当前进程放开限制:Set-ExecutionPolicy -Scope Process Bypass,关闭终端后设置自动失效。
常用参数
-m venv .venv:在项目目录创建独立环境,避免污染系统 Python。-U:升级到约束范围内的最新版本;生产环境不要无约束升级。"langchain>=1,<2":允许获得 1.x 修复版本,同时阻止未来自动跨到 2.x。deactivate:退出当前虚拟环境。
风险与边界
直接对系统 Python 执行 pip install -U,可能覆盖其他项目依赖并引发版本冲突。安全替代方案是每个项目单独使用 .venv,并在验证后固定依赖:
python -m pip freeze > requirements.txt
python -m pip check
预期输出
No broken requirements found.requirements.txt 会记录当前完整版本;提交前检查其中是否混入仅用于本机调试的包。
排障清单
python --version低于 3.10:安装较新 Python,并用对应解释器重新创建.venv。- 激活后仍安装到全局:执行
python -c "import sys; print(sys.executable)",路径应位于.venv。 - 出现依赖冲突:执行
python -m pip check;优先新建干净环境,不要反复强制覆盖。 - 下载超时:先确认代理、DNS 和 PyPI 连通性,再重试;不要把不受信任的镜像设为永久源。
速查:看到终端提示符含 .venv,且版本验证输出 1.x,即可继续安装模型集成包。
安装模型集成包按模型服务商安装独立的 LangChain 集成包。
安装模型集成包
用于连接具体模型服务商。LangChain 将模型适配器拆成独立包,项目只安装实际使用的服务商,避免引入无关依赖。:contentReference[oaicite:1]{index=1}
常用包
| 服务商或运行方式 | 安装包 | 常用导入 |
|---|---|---|
| OpenAI | langchain-openai |
from langchain_openai import ChatOpenAI |
| Anthropic | langchain-anthropic |
from langchain_anthropic import ChatAnthropic |
| Google Gemini | langchain-google-genai |
from langchain_google_genai import ChatGoogleGenerativeAI |
| Ollama 本地模型 | langchain-ollama |
from langchain_ollama import ChatOllama |
这些包名和导入入口由各官方集成文档定义。:contentReference[oaicite:2]{index=2}
高频用法
在已激活的虚拟环境中,把第一行改成目标包名后执行。包名中的短横线会自动转换为 Python 导入名。
PROVIDER_PACKAGE="langchain-openai"

python -m pip install --quiet -U "$PROVIDER_PACKAGE"
IMPORT_NAME="${PROVIDER_PACKAGE//-/_}"
python -c "import ${IMPORT_NAME}; print('${PROVIDER_PACKAGE}: OK')"
预期输出
langchain-openai: OK安装其他常见集成时,仅替换变量值:
PROVIDER_PACKAGE="langchain-anthropic"   # Anthropic Claude
PROVIDER_PACKAGE="langchain-google-genai" # Google Gemini
PROVIDER_PACKAGE="langchain-ollama"      # 本地 Ollama
这是命令取值片段,不要同时保留三行赋值;选择一行后运行上一段安装命令。
验证类是否可导入
安装成功不代表导入路径写对。下面示例只验证 Python 包和类,不会请求模型 API,也不需要密钥。
python -c "from langchain_openai import ChatOpenAI; print(ChatOpenAI.__name__)"预期输出
ChatOpenAI若使用其他服务商,将导入语句替换为表格中的对应类。
风险与边界
同时安装大量服务商包会扩大依赖树,升级其中一个包时可能改变共享的 langchain-core 版本。安全做法是按项目最小化安装,并在测试通过后固定版本:
python -m pip freeze > requirements.txt
python -m pip check
预期输出
No broken requirements found.只安装集成包不会自动获得服务商权限。云模型仍需要 API 密钥、账号权限和可访问的模型名称;Ollama 还要求本地服务已启动并已拉取模型。
排障清单
ModuleNotFoundError:确认包安装在当前.venv,并检查安装包名与导入名是否混淆。ImportError或依赖冲突:执行python -m pip check;必要时在新环境中重新安装最小依赖集。- 安装成功但调用时报 401/403:检查密钥、账号权限、区域和模型授权,不要重复重装 Python 包。
- Ollama 连接失败:先执行
ollama list和ollama serve检查本地服务;LangChain 集成包不会自动启动 Ollama。 - 使用 OpenAI 兼容但含扩展字段的第三方接口:优先查找服务商专用集成包,避免假设
ChatOpenAI支持所有非标准字段。:contentReference[oaicite:3]{index=3}
速查:先选服务商,再安装一个对应集成包,最后用最小导入命令验证。
配置 API 密钥通过环境变量安全配置模型服务的认证信息。
配置 API 密钥
通过环境变量向 LangChain 提供模型服务认证信息。代码只读取变量,不把密钥写进源码、命令输出或日志。
临时配置
Linux、macOS 当前终端会话可直接导出变量:
export OPENAI_API_KEY="<YOUR_API_KEY>"
python -c 'import os; print("已设置" if os.getenv("OPENAI_API_KEY") else "未设置")'
预期输出:
已设置该变量只对当前终端及其子进程生效。关闭终端后需要重新设置。
Windows PowerShell 使用进程级环境变量:
$env:OPENAI_API_KEY="<YOUR_API_KEY>"
python -c "import os; print('已设置' if os.getenv('OPENAI_API_KEY') else '未设置')"
预期输出:
已设置修改变量后应从同一终端启动 Python、IDE 或服务;已运行的进程不会自动获得新值。
本地项目使用 .env
先在项目根目录创建 .env:
OPENAI_API_KEY=<YOUR_API_KEY>再将文件排除出版本控制:
# .gitignore
.env
.env.*
!.env.example
安装加载器并验证变量,不打印密钥内容:
python -m pip install -q -U python-dotenv
python -c "from dotenv import load_dotenv; import os; load_dotenv(); print('已加载' if os.getenv('OPENAI_API_KEY') else '未加载')"
预期输出:
已加载应用入口应尽早调用 load_dotenv();生产环境通常直接注入环境变量,不依赖 .env 文件。
常见变量名
不同服务商使用不同变量名,必须与对应 LangChain 集成保持一致:
| 服务商 | 常用变量 |
|---|---|
| OpenAI | OPENAI_API_KEY |
| Anthropic | ANTHROPIC_API_KEY |
| Google Gemini | GOOGLE_API_KEY |
| Azure OpenAI | AZURE_OPENAI_API_KEY、AZURE_OPENAI_ENDPOINT |
同一项目切换服务商时,不要把一个服务商的密钥写入另一个变量,也不要仅修改模型名却遗漏对应集成包和认证变量。
风险与边界
把真实密钥提交到 Git、镜像、工单或聊天记录会导致凭证泄露,可能产生未授权调用和费用。安全替代方案是使用 CI/CD Secret、容器 Secret、云密钥管理服务或受控环境变量注入。
在命令行中直接写真实密钥可能进入 Shell 历史;应使用交互式 Secret 注入或受权限保护的配置。若密钥已经泄露,立即在服务商控制台撤销并重新生成,不要只删除代码中的字符串。
不要用 print(os.environ)、异常上下文或调试日志输出完整环境变量。排障时只打印“是否存在”、长度或脱敏后缀。
排障清单
- 报“缺少 API key”:确认变量名拼写、大小写和当前进程是否继承变量。
- 返回
401:检查密钥是否过期、撤销、复制不完整,或是否连到了错误的服务商端点。 - IDE 中读取不到:完全重启 IDE,或从已设置变量的终端启动 IDE。
- 容器中读取不到:显式传入环境变量或 Secret,并在容器内仅检查变量是否存在。
.env未生效:确认运行目录、文件名和load_dotenv()调用位置。
速查:先验证“变量存在”,再验证“进程继承”,最后再检查密钥权限和服务商端点。
初始化聊天模型使用统一接口创建指定服务商的聊天模型实例。
初始化聊天模型
使用 init_chat_model() 通过统一入口创建聊天模型。初始化成功后可用相同的 invoke()、stream() 和 batch() 接口调用不同服务商模型。
基本语法
统一入口为 init_chat_model(model, model_provider=None, **kwargs)。推荐把模型写成 模型服务商:模型名,例如 openai:gpt-5.5,以明确路由到对应集成;也可将服务商单独传给 model_provider。
模型名必须是当前账号和区域实际可用的标识。初始化参数会继续传给具体服务商客户端,因此专属参数是否可用要以对应集成为准。
可运行示例
前置条件:已设置 OPENAI_API_KEY。安装 LangChain 和 OpenAI 集成后,初始化模型并执行一次最小调用:
python -m pip install -q -U "langchain[openai]"
python -c "import langchain, langchain_openai; print('依赖可导入')"
预期输出:
依赖可导入创建 app.py:
import os

from langchain.chat_models import init_chat_model

def main() -> None:
    if not os.getenv("OPENAI_API_KEY"):
        raise RuntimeError("未设置 OPENAI_API_KEY")

    # 显式指定服务商,避免同名模型被错误路由。
    model = init_chat_model(
        "openai:gpt-5.5",
        temperature=0,
        timeout=30,
        max_retries=2,
    )

    response = model.invoke("只需回答:1+1等于几?")
    print(type(model).__name__)
    print(type(response).__name__)
    print(bool(response.content))

if __name__ == "__main__":
    main()
运行:
python app.py预期输出:
ChatOpenAI
AIMessage
True
最后一行只验证响应正文非空;模型生成的具体文字可能不同。
常用参数
| 参数 | 什么时候设置 | 读取方式 |
|---|---|---|
temperature |
需要降低或提高输出随机性时 | 越低通常越稳定,支持范围以服务商为准 |
timeout |
避免请求长期挂起时 | 单位通常为秒,超时会抛出异常 |
max_retries |
处理限流、网络抖动或服务端错误时 | 重试会增加总等待时间和潜在调用次数 |
max_tokens |
限制单次输出长度时 | 参数是否可用及含义以具体模型为准 |
model_provider |
模型名无法自动推断服务商时 | 传入对应的 LangChain 服务商标识 |
生产代码应在应用启动阶段复用模型实例,不要为每个请求重复初始化客户端。
高频用法
明确拆分服务商与模型名:
from langchain.chat_models import init_chat_model

model = init_chat_model(
    "gpt-5.5",
    model_provider="openai",
    temperature=0,
)
print(type(model).__name__)
预期输出:
ChatOpenAI只在需要服务商专属能力时改用具体类,例如 ChatOpenAI、ChatAnthropic。统一入口适合跨服务商切换,具体类适合访问专属参数和返回字段。
风险与边界
模型实例创建成功不代表账号一定有模型权限;真正发起请求后仍可能返回 401、403、404 或 429。安全做法是在启动检查中验证配置,在业务调用中分别处理认证、权限、模型不存在和限流错误。
不要盲目提高 max_retries。触发限流或服务端故障时,过多重试会放大延迟和调用量;应设置总超时、退避策略和业务级熔断,并避免对非幂等工具调用自动重放。
不同服务商只保证统一的基础聊天接口,工具调用、结构化输出、多模态和推理字段仍可能不同。切换模型前必须运行接口契约测试。
排障清单
ImportError:确认已安装langchain和目标服务商集成包,并检查虚拟环境是否正确。- 缺少 API key:检查环境变量名和启动进程的继承范围。
- 模型未找到:核对模型标识、服务商前缀、账号权限和区域。
- 请求超时:先确认网络和端点,再调整
timeout,不要只增加重试次数。 - 返回对象字段不同:优先读取统一的
AIMessage.content,专属字段按具体集成文档处理。
速查:先确认“依赖包、认证变量、服务商路由、模型权限”,再执行最小 invoke() 验证链路。
调用聊天模型向聊天模型发送输入并获取标准消息响应。
调用聊天模型
需要向模型发送一次输入并取得标准消息对象时,使用聊天模型的 invoke()。返回值不是普通字符串,而是 AIMessage;业务通常读取 response.text,需要原始内容或元数据时再访问 content、response_metadata 和 usage_metadata。
基本语法
先安装 LangChain 的 OpenAI 集成,并通过环境变量提供密钥。不要把密钥硬编码进脚本或提交到仓库。
python -m pip install -q -U langchain langchain-openai
python -c "import langchain, langchain_openai; print('imports-ok')"
export OPENAI_API_KEY="<YOUR_API_KEY>"
预期结果
imports-okWindows PowerShell 设置当前终端变量时使用 $env:OPENAI_API_KEY="<YOUR_API_KEY>"。
高频用法
下面的完整示例发送单条用户输入,并分别读取消息类型和文本结果。模型名需替换为账号当前可用的模型。
from langchain_openai import ChatOpenAI

def main() -> None:
    model = ChatOpenAI(
        model="gpt-5-nano",
        timeout=30,
        max_retries=2,
    )

    response = model.invoke("只返回数字:2 + 2 等于多少?")

    print(type(response).__name__)
    print(response.text)

if __name__ == "__main__":
    main()
预期输出
AIMessage
4
模型生成结果存在小幅差异;此例通过限定“只返回数字”降低变化。生产代码不要依赖自然语言完全一致,应解析结构化输出或验证结果格式。
异步服务中使用 await model.ainvoke(input),避免在事件循环内执行同步网络请求。批量输入可使用 model.batch([...]),但要结合提供商限流控制并发量。
输出字段说明
response.text 是标准化后的文本,适合直接展示;response.content 保留原始内容,可能是字符串或多模态内容块。response.usage_metadata 可包含输入、输出和总令牌数,具体字段取决于模型提供商是否返回统计。
排查请求时可临时打印消息对象:
print(response)
print(response.response_metadata)
print(response.usage_metadata)
预期结果
AIMessage(content='4', ...)
{...}
{...}id、令牌数、模型版本和耗时属于动态值,实际输出会不同。
风险与边界
未设置或错误设置 OPENAI_API_KEY 会触发鉴权失败,继续重试不会解决问题;应先校验环境变量和密钥权限。网络超时、429 或服务端错误可能被自动重试,因此接口总耗时可能超过单次请求时间;对外服务应同时设置调用超时和业务总超时。
不要把完整响应元数据直接返回给前端,其中可能包含提供商内部标识。日志只保留请求追踪 ID、模型名、耗时和必要的用量字段,用户输入与模型输出按数据分级脱敏。
排障清单
ModuleNotFoundError:确认当前解释器已安装langchain-openai。- 401:检查密钥是否存在、是否过期以及运行进程是否读取到环境变量。
- 404 或模型不可用:核对模型名与账号权限,不要通过增加重试次数掩盖配置错误。
- 429:降低并发、增加退避,或按租户设置请求队列。
- 返回值无法字符串拼接:读取
response.text,不要直接把AIMessage当作字符串。
构造消息列表使用系统、用户和助手消息组织多轮模型输入。
构造消息列表
需要设置系统指令、携带历史对话或区分不同角色时,将消息按实际发生顺序组成列表。常用类型是 SystemMessage、HumanMessage 和 AIMessage;列表末尾通常放本轮新的用户消息。
基本语法
消息对象写法类型明确,适合需要读取消息属性、维护历史记录或混合多模态内容的代码。
from langchain.messages import AIMessage, HumanMessage, SystemMessage

messages = [
    SystemMessage("你是一个简洁的 Java 排障助手。"),
    HumanMessage("连接池耗尽时先检查什么?"),
    AIMessage("先检查活跃连接数、等待线程和慢 SQL。"),
    HumanMessage("如何确认是否存在连接泄漏?"),
]

for message in messages:
    print(f"{message.type}: {message.text}")
预期输出
system: 你是一个简洁的 Java 排障助手。
human: 连接池耗尽时先检查什么?
ai: 先检查活跃连接数、等待线程和慢 SQL。
human: 如何确认是否存在连接泄漏?
这里的 AIMessage 表示已经发生的助手回复,用于补充历史上下文,不是对当前输入的预测答案。
高频用法
单轮调用只需系统消息和用户消息:
messages = [
    SystemMessage("只回答 Linux 命令,并说明危险参数。"),
    HumanMessage("查看 8080 端口由哪个进程占用。"),
]
多轮调用应按 system → human → ai → human 的时间顺序追加。不要把历史回答全部拼进一条用户消息,否则模型难以区分指令、问题和助手曾经说过的内容。
也可以使用字典格式,适合从数据库或 JSON 反序列化后直接组装:
messages = [
    {"role": "system", "content": "你是一个简洁的 SQL 助手。"},
    {"role": "user", "content": "如何查看当前数据库?"},
    {"role": "assistant", "content": "执行 SELECT DATABASE();"},
    {"role": "user", "content": "如何查看当前用户?"},
]
生效行为:该列表可以直接传给 model.invoke(messages);返回值仍是新的 AIMessage。
角色说明
| 消息类型 | 作用 | 常见位置 |
|---|---|---|
SystemMessage |
定义角色、约束和回答风格 | 通常位于列表开头 |
HumanMessage |
表示用户输入 | 每轮用户请求处 |
AIMessage |
表示历史助手回复 | 与对应用户消息之后 |
ToolMessage |
表示工具调用结果 | 工具调用完成之后 |
系统消息不是安全边界。用户输入、工具结果和外部文档仍需做权限校验与提示注入防护,不能仅依赖“忽略恶意指令”之类文本约束。
风险与边界
历史消息持续增长会增加令牌消耗,并可能超过模型上下文限制。安全替代方案是保留最近若干轮,对更早内容做摘要,并单独保存不可丢失的业务状态,不要简单截断关键订单号、权限范围或工具结果。
不要伪造 AIMessage 让模型误以为某项操作已经执行。若历史回复包含“已退款”“已删除”等结果,必须由真实审计记录或工具返回值支撑,否则可能导致模型沿错误状态继续处理。
排障清单
- 模型忽略约束:确认
SystemMessage位于前部,且后续消息没有冲突指令。 - 上下文顺序混乱:按真实时间排序,不要把新的用户消息插到旧的助手消息前。
- 成本突然升高:统计消息数量和总长度,压缩重复历史。
content不是字符串:多模态消息可能返回内容块;展示文本时优先读取标准化的message.text。- 从存储恢复失败:统一保存
role与content,恢复时校验未知角色和空内容。
创建提示词模板定义带变量的可复用聊天提示词模板。
创建聊天提示词模板
使用 ChatPromptTemplate 固定消息角色、指令结构和变量名,适合把同一套提示词重复用于不同输入。模板创建阶段不会调用模型,先检查变量和消息数量即可确认结构正确。
基本语法
from_messages() 接收按顺序排列的消息定义;{变量名} 会被识别为运行时必填变量。常用角色是 system 和 human,前者放稳定约束,后者放本次请求。
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一名{role},回答必须准确、简洁。"),
        ("human", "请用{language}解释:{topic}"),
    ]
)

# 创建后先核对变量集合,避免运行时才发现拼写错误。
print(sorted(prompt.input_variables))
print(len(prompt.messages))
预期输出
['language', 'role', 'topic']
2
第一行表示模板要求三个变量;第二行表示最终输入由两条聊天消息组成。
高频用法
稳定的行为约束放在 system 消息中,把主题、语言、受众等变化内容写成变量。变量名应表达业务含义,例如 {topic}、{audience},不要使用 {x} 这类难排查的名称。
同一变量可以在多条消息中重复引用,但调用时只需传一次。需要插入历史对话时再使用 MessagesPlaceholder;只有固定的两三条消息时,直接使用元组更容易检查。
风险与边界
模板正文需要展示 JSON、字典或数学集合中的字面花括号时,必须写成 {{ 和 }}。未转义会被识别为变量,可能导致变量列表异常或调用时报缺少参数;安全做法是创建后立即检查 prompt.input_variables。
不要把外部用户提交的模板文本直接作为 Jinja2 模板执行,否则可能扩大模板注入风险。优先使用默认的 f-string 模板格式,并只允许服务端维护模板结构。
排障清单
- 导入失败时确认包名是
langchain-core,导入路径是langchain_core.prompts。 - 变量数量不对时打印
sorted(prompt.input_variables),检查拼写和未转义花括号。 - 消息顺序异常时检查
prompt.messages;模型会按模板中定义的顺序接收消息。 - 模板创建成功只代表结构有效,不代表模型输出质量已验证,仍需用代表性输入测试。
传递提示词变量在运行时填充模板变量并生成最终模型输入。
传递提示词变量
在运行时通过 invoke() 传入变量字典,LangChain 会生成可直接交给聊天模型的 ChatPromptValue。多变量场景建议始终使用显式字典,便于检查字段名和接入链式调用。
基本语法
字典键必须与模板变量名一致。invoke() 只完成模板渲染,不会请求模型;可通过 to_messages() 查看最终消息。
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一名{role},回答必须准确、简洁。"),
        ("human", "请用{language}解释:{topic}"),
    ]
)

prompt_value = prompt.invoke(
    {
        "role": "Python 讲师",
        "language": "中文",
        "topic": "生成器",
    }
)

# 在调用模型前打印最终消息,便于定位变量填充和角色顺序问题。
for message in prompt_value.to_messages():
    print(f"{message.type}: {message.content}")
预期输出
system: 你是一名Python 讲师,回答必须准确、简洁。
human: 请用中文解释:生成器
读取时先看 system 约束是否完整,再确认 human 内容是否已替换全部变量。输出中仍出现 {topic} 通常表示模板变量写法或调用对象不正确。
高频用法
多变量模板使用 prompt.invoke({"name": value})。部分变量长期固定时,可先用 prompt.partial(role="Python 讲师") 生成新模板,再只传剩余变量。
接入模型时可组合为 chain = prompt | model,随后把同一变量字典传给 chain.invoke()。只有一个变量时虽然可以直接传单个值,但显式字典在增加变量后更不容易产生隐式行为变化。
输出字段说明
invoke() 返回的不是模型答案,而是 ChatPromptValue。to_messages() 返回按顺序排列的消息列表;每条消息的 type 表示角色,content 是替换变量后的最终文本。
风险与边界
缺少必填变量会在模型调用前失败,导致请求无法生成;安全做法是将 prompt.input_variables 与业务入参做集合校验,并在边界层返回明确错误。
用户输入即使作为变量传入,也可能包含试图覆盖系统约束的指令。可能后果是模型偏离预期;应限制输入长度、分隔用户数据,并对高风险操作增加独立权限校验,不能只依赖提示词。
排障清单
- 报缺少变量时,对照
prompt.input_variables检查键名、大小写和嵌套字段。 - 内容替换错误时,在模型调用前打印
prompt_value.to_messages(),不要只检查原始模板。 - 链式调用报输入类型错误时,向
chain.invoke()传变量字典,不要传已格式化的普通字符串。 - 批量请求应保证每条输入都包含完整变量集合,避免单条坏数据中断整批处理。
设置模型参数配置温度、最大输出长度和停止条件等生成参数。
设置模型参数
用于控制模型输出的随机性、长度和提前停止条件。生产环境应把参数显式写入模型初始化或单次调用,避免升级依赖后受到默认值变化影响。
基本语法
temperature 控制采样随机性;max_tokens 限制最大输出令牌数;stop 在匹配指定字符串时停止生成。ChatOpenAI 会把 max_tokens 转换为 OpenAI 当前使用的最大完成令牌参数。
import os

from langchain_openai import ChatOpenAI

model = ChatOpenAI(
    model=os.getenv("OPENAI_MODEL", "gpt-4.1-mini"),
    temperature=0,
    max_tokens=80,
)

response = model.invoke(
    [
        ("system", "你是生产排障助手,回答必须简短。"),
        ("human", "只输出“排障完成<END>”,不要补充其他内容。"),
    ],
    stop=["<END>"],
)

print(response.text)
print(response.response_metadata.get("finish_reason"))
预期输出
排障完成
stop
实际措辞和令牌统计可能随模型变化;重点检查 <END> 未出现在正文中,并且 finish_reason 为 stop。
常用参数
temperature=0:适合分类、抽取、结构化输出和排障结论;值越高,措辞和答案差异通常越大。max_tokens=<N>:限制输出令牌,不是字符数。中文、英文、标点和代码的令牌占用不同。stop=["<END>"]:命中任一停止串后终止,停止串本身通常不会返回。- 调用级参数会覆盖模型实例的默认值,适合不同请求使用不同停止条件。
高频用法
稳定生成 JSON 或固定格式时,将 temperature 设为 0,同时给出明确输出 schema。长文本摘要应逐步增大 max_tokens,并检查 finish_reason,避免把截断结果当成完整答案。
同一模型实例可复用默认参数;只有单次任务需要特殊停止条件时,把 stop 放在 invoke() 中,不必创建新实例。
风险与边界
当 max_tokens 过小时,输出可能在 JSON、代码块或句子中间被截断,导致解析失败。安全做法是检查 finish_reason,并为结构化输出预留余量。
部分推理模型或第三方兼容接口不接受自定义 temperature,会返回参数错误。遇到此类模型时删除该参数,使用模型支持的默认采样设置。
停止串如果可能自然出现在正文中,会造成意外截断。应选择业务文本中极少出现的标记,例如 <END_OF_RESULT_7F3A>,并在上线前用真实提示词回归测试。
速查:低随机性用 temperature=0,长度限制看令牌而不是字符,完整性同时检查正文和 finish_reason。
设置超时与重试限制模型请求耗时并处理临时网络或服务故障。
设置超时与重试
用于限制单次模型请求的等待时间,并自动恢复网络中断、限流或服务端临时故障。生产环境应显式设置 timeout 和 max_retries,再由上层决定最终失败后的降级策略。
基本语法
timeout 表示每次请求最多等待的秒数;max_retries 表示失败后的最大重试次数。一次初始请求加三次重试,最多可能发出四次请求,实际总耗时还会包含退避等待。
import os

from langchain_openai import ChatOpenAI
from openai import APIConnectionError, APITimeoutError, RateLimitError

model = ChatOpenAI(
    model=os.getenv("OPENAI_MODEL", "gpt-4.1-mini"),
    timeout=20.0,
    max_retries=3,
)

try:
    response = model.invoke("只回复 OK")
    print(response.text)
except (APITimeoutError, APIConnectionError, RateLimitError) as exc:
    # 自动重试耗尽后,交给上层记录、降级或返回可重试状态。
    print(f"temporary_failure={type(exc).__name__}")
预期输出
OK网络持续异常时,预期结果类似:
temporary_failure=APITimeoutError具体异常类型取决于失败阶段,也可能是 APIConnectionError 或 RateLimitError。
参数选择
交互式接口通常从 timeout=10~30 秒起步;长上下文、复杂推理或非流式长输出可适当放宽。重试通常设置为 2~3 次,避免故障期间持续堆积请求。
超时应小于网关、负载均衡器和调用方的总超时,并预留重试与返回错误的时间。不要只调大模型超时而忽略整个请求链路的时间预算。
高频用法
临时网络抖动、HTTP 429 和部分 5xx 错误可交给模型客户端自动重试。认证失败、无效参数、模型不存在等永久错误应立即修复配置,不应通过增加重试次数掩盖。
批量任务可适度提高重试次数,但同时限制并发量;在线请求更重视响应上限,应使用较短超时和快速降级。
风险与边界
每次重试都可能增加延迟和费用;请求已被服务端处理但响应丢失时,还可能形成重复模型调用。涉及计费、写库或外部动作时,应把副作用放在模型调用成功之后,并使用业务幂等键。
不要同时在 ChatOpenAI(max_retries=...)、Runnable 的 with_retry() 和网关层叠加大量重试,否则重试次数会相乘,引发请求风暴。安全做法是只保留一个主重试层,其他层最多做有限兜底。
流式调用中,已经输出部分内容后再超时,不能把前后两次响应直接拼接。应丢弃不完整结果、记录请求标识,并从完整请求重新生成。
排障清单
- 先区分超时、连接失败、429、5xx 与 4xx 配置错误。
- 记录每次尝试的耗时、异常类型、模型名和请求追踪 ID,但不要记录 API Key 或敏感提示词。
- 总耗时过长时,同时检查客户端重试、代理重试和网关重试是否叠加。
- 持续 429 时降低并发或增加限流队列,而不是无限提高
max_retries。
速查:超时控制单次等待,重试处理临时故障;最终失败必须由上层明确降级或返回错误。
获取结构化输出让模型按照 Pydantic 或 JSON Schema 返回类型化结果。
获取结构化输出
当下游代码需要稳定字段而不是自然语言时,用 with_structured_output() 把聊天模型包装为类型化 Runnable。Pydantic 适合需要本地校验和对象方法的场景;原生 JSON Schema 适合跨语言接口或已有契约。
基本用法
下面示例要求已设置 OPENAI_API_KEY,并安装 langchain-openai 与 Pydantic 2。method="json_schema" 使用模型提供商的原生结构化输出能力。
import json
from typing import Literal

from langchain_openai import ChatOpenAI
from pydantic import BaseModel, ConfigDict, Field

class Ticket(BaseModel):
    model_config = ConfigDict(extra="forbid")

    title: str = Field(description="工单标题")
    priority: Literal["low", "medium", "high"] = Field(description="处理优先级")
    tags: list[str] = Field(description="用于检索的标签")
    owner: str | None = Field(default=None, description="负责人,未提供时为空")

model = ChatOpenAI(model="gpt-4.1-mini", temperature=0)
structured_model = model.with_structured_output(
    Ticket,
    method="json_schema",
)

ticket = structured_model.invoke(
    "严格提取:标题=支付回调超时;优先级=high;"
    "标签=payment,timeout;负责人未提供。"
)

print(json.dumps(ticket.model_dump(), ensure_ascii=False, indent=2))
预期输出
{
  "title": "支付回调超时",
  "priority": "high",
  "tags": [
    "payment",
    "timeout"
  ],
  "owner": null
}
返回值是 Ticket 实例,可直接访问 ticket.priority。模型名称、耗时和令牌用量属于动态值,实际运行可能不同。
使用 JSON Schema
已有跨语言契约时可直接传入 JSON Schema。以下是片段示例,复用上例中的 model;此方式通常返回普通 dict。
ticket_schema = {
    "title": "Ticket",
    "description": "待处理工单",
    "type": "object",
    "properties": {
        "title": {"type": "string", "description": "工单标题"},
        "priority": {
            "type": "string",
            "enum": ["low", "medium", "high"],
        },
        "tags": {
            "type": "array",
            "items": {"type": "string"},
        },
    },
    "required": ["title", "priority", "tags"],
    "additionalProperties": false,
}

json_model = model.with_structured_output(
    ticket_schema,
    method="json_schema",
)
result = json_model.invoke(
    "标题=缓存击穿;优先级=medium;标签=redis,cache"
)预期结果:result 为包含 title、priority、tags 的字典,且不应出现未声明字段。业务代码仍应对字典做二次校验。
常用参数
| 参数 | 什么时候用 | 结果 |
|---|---|---|
schema |
指定 Pydantic 类、TypedDict 或 JSON Schema | 决定返回字段与类型 |
method="json_schema" |
提供商和模型支持原生结构化输出时 | 通常比提示词解析更稳定 |
include_raw=True |
需要保留原始消息并诊断解析失败时 | 返回 raw、parsed、parsing_error |
风险与边界
Pydantic 类会生成并校验模型实例;原生 JSON Schema 通常返回字典,不应等同于完成业务校验。结构正确也不代表内容真实,订单号、用户权限和数据库记录仍需访问可信数据源核验。
不同模型提供商支持的方法和 Schema 子集不同。触发条件是模型不支持原生 JSON Schema 或使用了递归、复杂联合类型等限制特性,可能导致请求被拒绝。安全替代方案是简化 Schema,或切换为该集成支持的函数调用方式。
排障清单
- 返回字段经常为空:为类、字段和枚举补充明确描述,并在提示词中说明缺失值策略。
- 报
response_format或 Schema 不支持:确认模型能力与集成包版本,必要时去掉method或改用函数调用。 - 返回类型不是预期对象:检查传入的是 Pydantic 类还是字典 Schema;字典 Schema 通常得到
dict。 - 字段结构正确但值不可信:把结构化输出视为候选数据,再执行权限、存在性和业务规则校验。
校验模型输出验证结构化结果并处理字段缺失或类型错误。
校验模型输出
当结构化结果将进入支付、订单或自动化流程时,应把“字段格式”和“业务关系”分开校验。字段缺失、类型错误、额外字段和跨字段冲突都应显式失败,不能静默补默认值后继续执行。
严格校验
下面使用 Pydantic 2 对三个典型错误分类输出。strict=True 会拒绝把字符串 "100" 自动转换为整数,extra="forbid" 会拒绝 Schema 外字段。
from typing import Literal

from pydantic import (
    BaseModel,
    ConfigDict,
    Field,
    ValidationError,
    model_validator,
)

class PaymentResult(BaseModel):
    model_config = ConfigDict(extra="forbid", strict=True)

    status: Literal["SUCCESS", "FAILED"]
    amount: int = Field(gt=0)
    transaction_id: str | None = None
    error_message: str | None = None

    @model_validator(mode="after")
    def validate_status_fields(self):
        if self.status == "SUCCESS" and not self.transaction_id:
            raise ValueError("SUCCESS 时必须提供 transaction_id")
        if self.status == "FAILED" and not self.error_message:
            raise ValueError("FAILED 时必须提供 error_message")
        return self

samples = [
    ("字段缺失", {"amount": 100}),
    (
        "类型错误",
        {
            "status": "FAILED",
            "amount": "100",
            "error_message": "余额不足",
        },
    ),
    ("关联字段错误", {"status": "SUCCESS", "amount": 100}),
]

for label, payload in samples:
    try:
        PaymentResult.model_validate(payload)
    except ValidationError as exc:
        print(label)
        for error in exc.errors():
            field = ".".join(str(item) for item in error["loc"]) or "<model>"
            print(f"  {field}: {error['type']}")
预期输出
字段缺失
  status: missing
类型错误
  amount: int_type
关联字段错误
<model>: value_error读取时先看字段路径,再看错误类型:missing 表示必填字段缺失,int_type 表示严格整数校验失败,value_error 表示自定义业务规则未通过。
接入 LangChain
调用模型时可启用 include_raw=True。以下片段复用上节的 PaymentResult,解析失败不会立即丢失原始消息。
from langchain_openai import ChatOpenAI

model = ChatOpenAI(model="gpt-4.1-mini", temperature=0)
safe_model = model.with_structured_output(
    PaymentResult,
    method="json_schema",
    include_raw=True,
)

outcome = safe_model.invoke(
    "严格返回:status=SUCCESS,amount=100,"
    "transaction_id=T1001,error_message 为空。"
)

if outcome["parsing_error"] is not None:
    print(type(outcome["parsing_error"]).__name__)
    print(outcome["raw"].content)
else:
    validated = PaymentResult.model_validate(outcome["parsed"])
    print(validated.status, validated.amount)
预期输出
SUCCESS 100outcome["raw"] 是原始模型消息,outcome["parsed"] 是解析结果,outcome["parsing_error"] 保存解析异常。提供商在生成阶段拒绝请求时,异常可能在 invoke() 处直接抛出,仍需在调用边界捕获。
处理策略
- 缺失或类型错误:记录字段路径和错误类型,返回可定位的错误,不要把整段 Pydantic 堆栈直接暴露给终端用户。
- 额外字段:生产写操作建议使用
extra="forbid",防止模型生成的未知字段被误传给数据库或下游接口。 - 跨字段冲突:使用
model_validator校验状态与关联字段,例如成功必须有交易号、失败必须有错误原因。 - 解析失败:保留
raw便于排障;仅对临时网络错误或偶发解析错误做有限重试,确定性的业务校验失败不应重试。
风险与边界
strict=True 的触发条件是输入类型与声明类型不完全一致,可能拒绝本可安全转换的数字字符串。安全替代方案是在进入校验器前建立明确的规范化层,而不是全局关闭严格模式。
自动重试会重复模型调用,可能增加费用、延迟,甚至重复触发有副作用的工具。应限制重试次数,并确保写操作有幂等键;字段错误应修正 Schema、提示词或上游数据后再调用。
排障清单
- 只有
parsed=None:检查parsing_error,同时保存raw.content和请求追踪 ID。 - 同一字段反复类型错误:核对 Schema 是否过严,或在提示词中明确单位、格式和枚举值。
- 本地校验通过但下游失败:继续检查数据库存在性、金额精度、权限和状态机约束。
- 错误突然增多:对比模型版本、集成包版本和 Schema 变更,避免只靠增加重试掩盖回归。
兼容性
示例使用 Pydantic 2 的 model_validate()、model_dump() 和 model_validator。旧版项目若仍使用 Pydantic 1,应先确认 LangChain 集成的兼容层,再迁移到对应 API,避免同时混用两套模型基类。
组合 Runnable使用 LangChain 表达式语言连接提示词、模型和输出处理步骤。
组合 Runnable
需要把提示模板、模型和输出处理器连接成一个可调用对象时,使用 LangChain 表达式语言(LCEL)的 | 运算符。数据从左向右传递,前一步输出必须能作为后一步输入。
基本语法
核心形式是 step1 | step2 | step3。组合结果仍是 Runnable,可统一调用 invoke、batch、stream 等接口。普通 Python 函数需要插入链路时,优先用 RunnableLambda 显式包装,便于确认输入输出类型和追踪步骤名称。
下面使用测试模型演示“提示词 → 模型 → 字符串解析器”的完整组合,不需要外部 API 密钥。
from langchain_core.language_models.fake import FakeStreamingListLLM
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate

prompt = PromptTemplate.from_template("请用一句话解释 {topic}")
model = FakeStreamingListLLM(
    responses=["LCEL 用管道语法把多个 Runnable 组合成可调用链路。"]
)
parser = StrOutputParser()

# 每一步的输出会自动传给右侧步骤
chain = prompt | model | parser

result = chain.invoke({"topic": "Runnable"})
print(result)
预期输出
LCEL 用管道语法把多个 Runnable 组合成可调用链路。高频用法
invoke(input) 处理单个输入;batch(inputs) 处理一组输入;ainvoke 和 abatch 用于异步调用。需要复用局部链路时,可以先保存 prompt | model,再按场景追加不同解析器。
需要插入清洗、字段转换或校验逻辑时,使用 RunnableLambda(function)。若右侧步骤需要字典而左侧只返回字符串,应先增加转换步骤,不要依赖隐式类型转换。
输出读取
最终返回类型由最后一个步骤决定。本例最后使用 StrOutputParser,因此 invoke 直接返回 str;若省略解析器,聊天模型通常返回消息对象,需要读取其 content。
提示模板的变量名必须与输入字典键一致。例如模板包含 {topic},调用时就必须提供 {"topic": ...}。
风险与边界
当相邻步骤类型不匹配时,链路会在运行期抛出 TypeError、KeyError 或属性访问异常,后续步骤不会执行。安全做法是为自定义函数添加类型标注,并在边界处显式转换数据结构。
RunnableLambda 默认不适合承担需要逐块透传的流式转换。把阻塞函数放在链路中间,可能导致前端迟迟收不到首个分块;需要真正流式处理时,改用支持生成器或 transform 的 Runnable。
生产环境不要把密钥、完整用户隐私或支付数据直接写入提示词和追踪元数据,否则异常日志或链路追踪可能泄露内容。应先脱敏,并通过安全配置注入凭据。
排障清单
- 报缺少模板变量:核对模板占位符和
invoke输入键。 - 返回消息对象而不是字符串:在末尾追加
StrOutputParser()。 - 自定义步骤返回
None:检查函数是否遗漏return。 - 流式输出一次性出现:检查中间是否存在不支持流式转换的
RunnableLambda。
速查:先确认每一步“接收什么、返回什么”,再用 | 组合。
串行执行步骤将多个 Runnable 按固定顺序组成处理流水线。
串行执行步骤
当处理过程必须按固定顺序执行,并且每一步都依赖上一步结果时,使用 RunnableSequence。最常见的写法是用 | 串联,单个输入始终按从左到右的顺序经过全部步骤。
基本语法
first | second | third 会生成串行链路。下面依次执行字段标准化、业务校验和结果格式化,并同时演示单条调用与批量调用。
from langchain_core.runnables import RunnableLambda

def normalize(payload: dict) -> dict:
    return {
        "order_no": payload["order_no"].strip().upper(),
        "amount": int(payload["amount"]),
    }

def validate(order: dict) -> dict:
    # 校验失败时直接终止当前输入的后续步骤
    if order["amount"] <= 0:
        raise ValueError("amount must be greater than 0")
    return order

def render(order: dict) -> str:
    return f"{order['order_no']}|{order['amount']}"

pipeline = (
    RunnableLambda(normalize)
    | RunnableLambda(validate)
    | RunnableLambda(render)
)

print(type(pipeline).__name__)
print(pipeline.invoke({"order_no": " po-1001 ", "amount": "25"}))
print(
    pipeline.batch(
        [
            {"order_no": "po-1002", "amount": "10"},
            {"order_no": "po-1003", "amount": "30"},
        ]
    )
)
预期输出
RunnableSequence
PO-1001|25
['PO-1002|10', 'PO-1003|30']
执行方式
invoke 处理一条数据,适合请求链路或单次任务;batch 接收输入列表,返回与输入顺序对应的结果列表;异步代码使用 ainvoke 或 abatch。
批量调用可能并发处理不同输入,但每个输入内部仍按“标准化 → 校验 → 格式化”的顺序执行。因此不能把 batch 理解成所有数据先完成第一步,再统一进入第二步。
输出与失败行为
链路最终输出由最后一步决定,本例返回字符串。任意中间步骤抛出异常时,该输入不会继续进入后续步骤;batch 默认会抛出异常,调用方可能拿不到普通结果列表。
批量任务需要保留逐条失败信息时,可使用 batch(inputs, return_exceptions=True),然后逐项判断结果是正常值还是异常对象。不要静默吞掉异常,否则下游可能把未校验数据当成成功结果。
风险与边界
在 batch 中执行写数据库、扣库存或发送消息等副作用时,不同输入可能并发交错,导致锁竞争、乱序或重复操作。安全替代方案是让步骤具备幂等性,或通过 config={"max_concurrency": 1} 限制并发。
如果某一步改变了数据类型,例如从字典变为字符串,后续步骤却仍按字典读取字段,会在运行期失败。应为每一步明确输入输出类型,并把结构转换集中在独立步骤中。
串行链路过长会让错误定位困难。生产中应为关键步骤配置清晰名称和追踪标签,并避免把多个无关业务动作塞进一个匿名函数。
排障清单
- 第二步未执行:查看第一步是否抛出异常或返回了错误类型。
- 批量结果出现异常对象:确认是否启用了
return_exceptions=True,并逐项处理。 - 批量写操作顺序不稳定:限制并发,或改为显式循环调用
invoke。 - 流式响应延迟:检查序列中是否存在阻塞且不支持流式转换的步骤。
速查:串行保证单个输入的步骤顺序,不保证多个批量输入之间按提交顺序逐个执行。
并行执行步骤同时运行多个独立任务并合并其执行结果。
并行执行步骤
当多个步骤彼此独立、都只依赖同一份输入时,使用 RunnableParallel 并发执行,并把结果按名称合并为一个字典。它适合并行调用检索器、模型、规则计算或格式转换;存在前后依赖的步骤应改用顺序链。
命令定位
从 langchain_core.runnables 导入 RunnableParallel 和 RunnableLambda。RunnableParallel 接收“结果字段名到 Runnable”的映射,调用 invoke() 时把同一输入传给全部子步骤,完成后返回包含全部字段的字典。
也可以在 LCEL 管道中直接写字典:上游输出会被同时发送给字典中的各个 Runnable,字典会自动转换为并行步骤。
基本语法
下面的示例同时完成文本规范化、字符计数和单词计数,不依赖模型或 API 密钥,可直接运行。
from langchain_core.runnables import RunnableLambda, RunnableParallel

def normalize(text: str) -> str:
    return text.strip().lower()

def char_count(text: str) -> int:
    return len(text.strip())

def word_count(text: str) -> int:
    return len(text.strip().split())

# 三个步骤互不依赖,并且都会收到同一份原始字符串。
parallel = RunnableParallel(
    normalized=RunnableLambda(normalize),
    chars=RunnableLambda(char_count),
    words=RunnableLambda(word_count),
)

# invoke 会等待全部步骤结束,再按构造时的字段名汇总结果。
result = parallel.invoke("  LangChain makes workflows composable  ")
print(result)
预期输出
{'normalized': 'langchain makes workflows composable', 'chars': 36, 'words': 4}读取方法:normalized、chars、words 来自构造时指定的字段名;每个值是对应 Runnable 的返回值。字段顺序不应作为业务判断依据,应始终按键读取。
高频用法
- 同一问题同时执行关键词检索、向量检索和权限过滤,再由下游合并结果。
- 同一文本同时生成摘要、标签和质量评分,避免把无依赖步骤串行等待。
- 在 LCEL 中使用
upstream | {"left": runnable_a, "right": runnable_b},将上游结果扇出到多个步骤。 - I/O 型异步任务使用
await parallel.ainvoke(input);批量输入使用batch()或abatch(),不要在业务代码中自行重复创建线程池。
需要限制外部服务并发量时,可在调用配置中设置 max_concurrency,例如 parallel.invoke(data, config={"max_concurrency": 2})。
风险与边界
只有步骤互不依赖时才能并行。若步骤 B 必须读取步骤 A 的结果,强行并行会导致输入缺失或使用旧数据;安全替代方案是用 RunnableSequence 或 a | b 明确执行顺序。
并行调用模型、数据库或第三方接口可能瞬间放大请求量,触发限流、连接池耗尽或成本上升。生产环境应设置并发上限、超时和重试策略,并按下游容量逐步压测。
任一子步骤抛出异常时,整体调用通常不会返回完整结果。需要局部降级时,应给高风险子 Runnable 配置 with_fallbacks(),或在该步骤内部捕获可恢复异常并返回明确的降级值。
RunnableParallel 更适合网络和磁盘 I/O。纯 Python CPU 密集计算不会因为线程并发稳定获得线性加速,应改用进程池、任务队列或专门计算服务。
排障清单
- 输出少字段:确认每个映射值都是可调用的 Runnable,且没有在下游覆盖整个结果字典。
- 并发后更慢:检查任务是否过短、是否争用同一连接池,以及外部接口是否发生排队或限流。
- 输入类型错误:所有并行分支默认收到同一输入;需要不同字段时,在各分支前增加提取或转换 Runnable。
- 偶发整体失败:定位具体分支异常,分别配置超时、重试、回退和可观测标签,不要只在最外层无限重试。
速查:同输入、无依赖、要汇总时用 RunnableParallel;有依赖时用顺序链。
根据输入或中间结果动态选择后续执行路径。
按条件选择分支
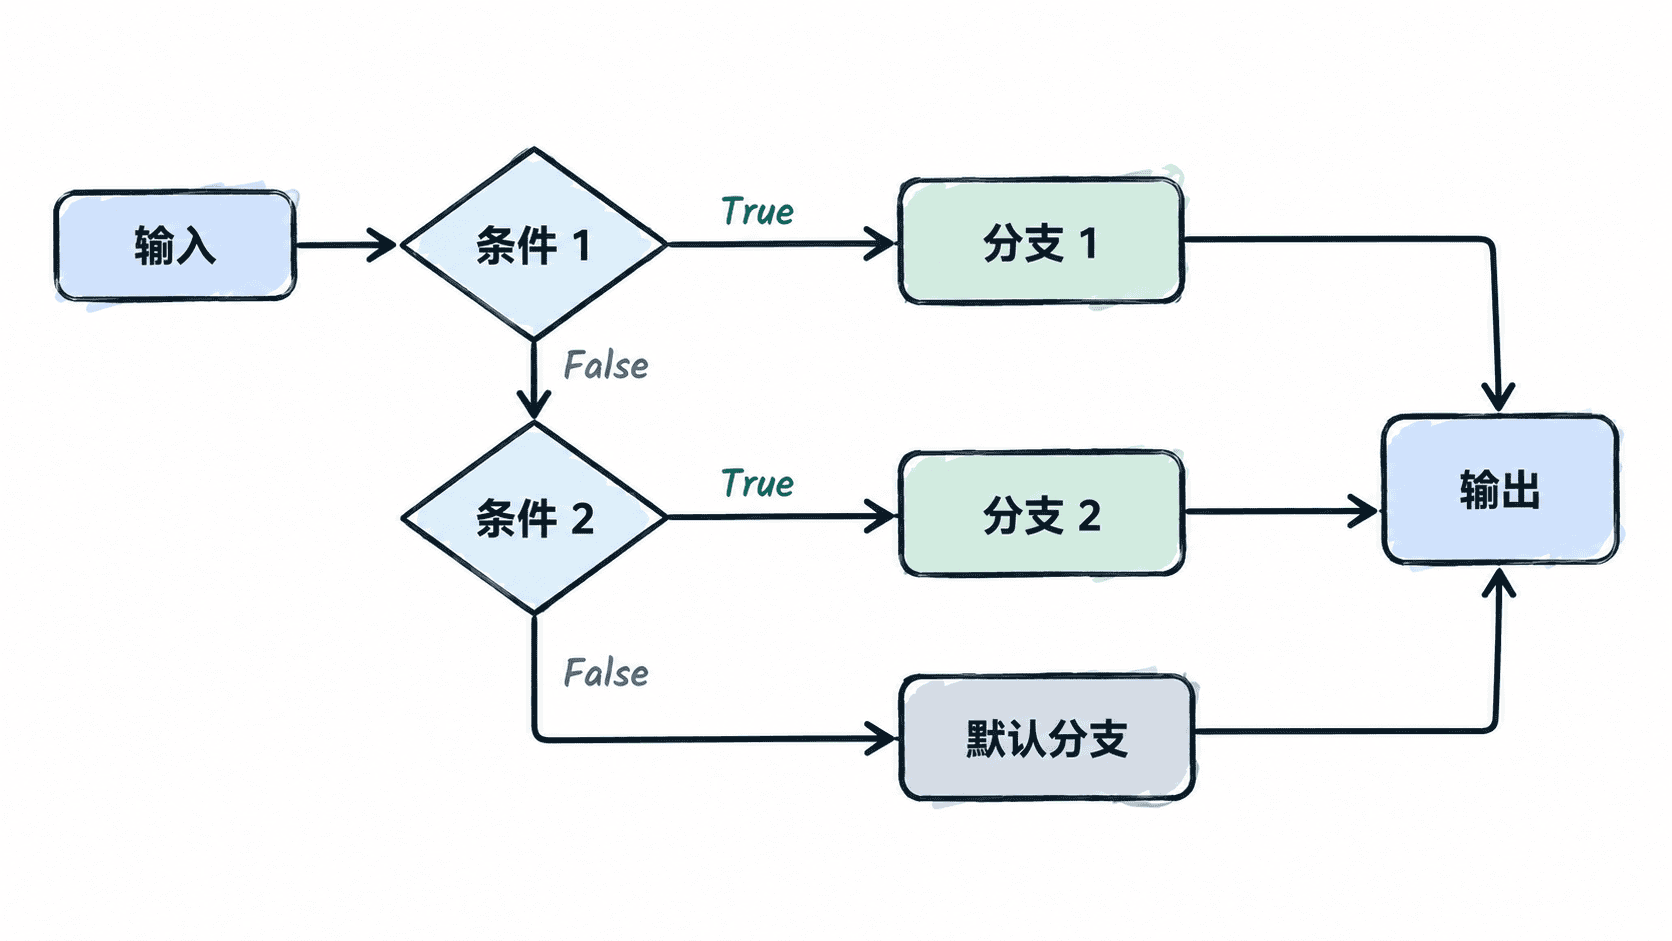
当同一条链需要根据输入或上一步结果走不同处理逻辑时,可用 RunnableBranch。它按声明顺序检查条件,命中第一个返回 True 的分支;全部未命中时执行最后的默认分支。
基本用法
构造形式为 RunnableBranch((condition_1, runnable_1), (condition_2, runnable_2), ..., default_runnable)。条件可以是返回布尔值的可调用对象或 Runnable;分支与默认项都要能接收同一种输入。
选择规则
- 条件按声明顺序求值,第一个命中即停止继续判断。
- 默认分支必须放在最后,用来覆盖所有未命中的输入。
- 各分支最好返回相同结构,否则后续链需要额外做类型或字段归一化。
invoke() 返回被选中分支的结果。条件函数或被选中分支抛出的异常会继续向外传播,除非外层另行配置重试或降级。
主示例
from langchain_core.runnables import RunnableBranch, RunnableLambda

route = RunnableBranch(
    (
        lambda x: x['score'] >= 0.8,
        RunnableLambda(lambda x: '直接回答:' + x['question']),
    ),
    (
        lambda x: x['score'] >= 0.5,
        RunnableLambda(lambda x: '补充检索:' + x['question']),
    ),
    # 未命中前两个条件时进入默认分支
    RunnableLambda(lambda x: '人工复核:' + x['question']),
)

tests = [
    {'question': '退款多久到账?', 'score': 0.92},
    {'question': '套餐是否支持企业版?', 'score': 0.63},
    {'question': '这个结果是否准确?', 'score': 0.31},
]

for item in tests:
    print(route.invoke(item))
预期输出
直接回答:退款多久到账?
补充检索:套餐是否支持企业版?
人工复核:这个结果是否准确?
风险与边界
条件存在重叠时,顺序就是业务优先级,应把更具体、更严格的条件放在前面。条件函数应尽量保持快速、无副作用;如果路由依据需要一次昂贵计算,先把结果写入输入字段,再用 RunnableBranch 只负责选择路径。
RunnableBranch 位于 langchain_core.runnables。项目若锁定较老的 LangChain 版本,应以当前依赖中的 langchain-core API 为准,避免直接照搬旧命名空间示例。
在模型或处理步骤失败时自动切换备用实现。
配置降级链路
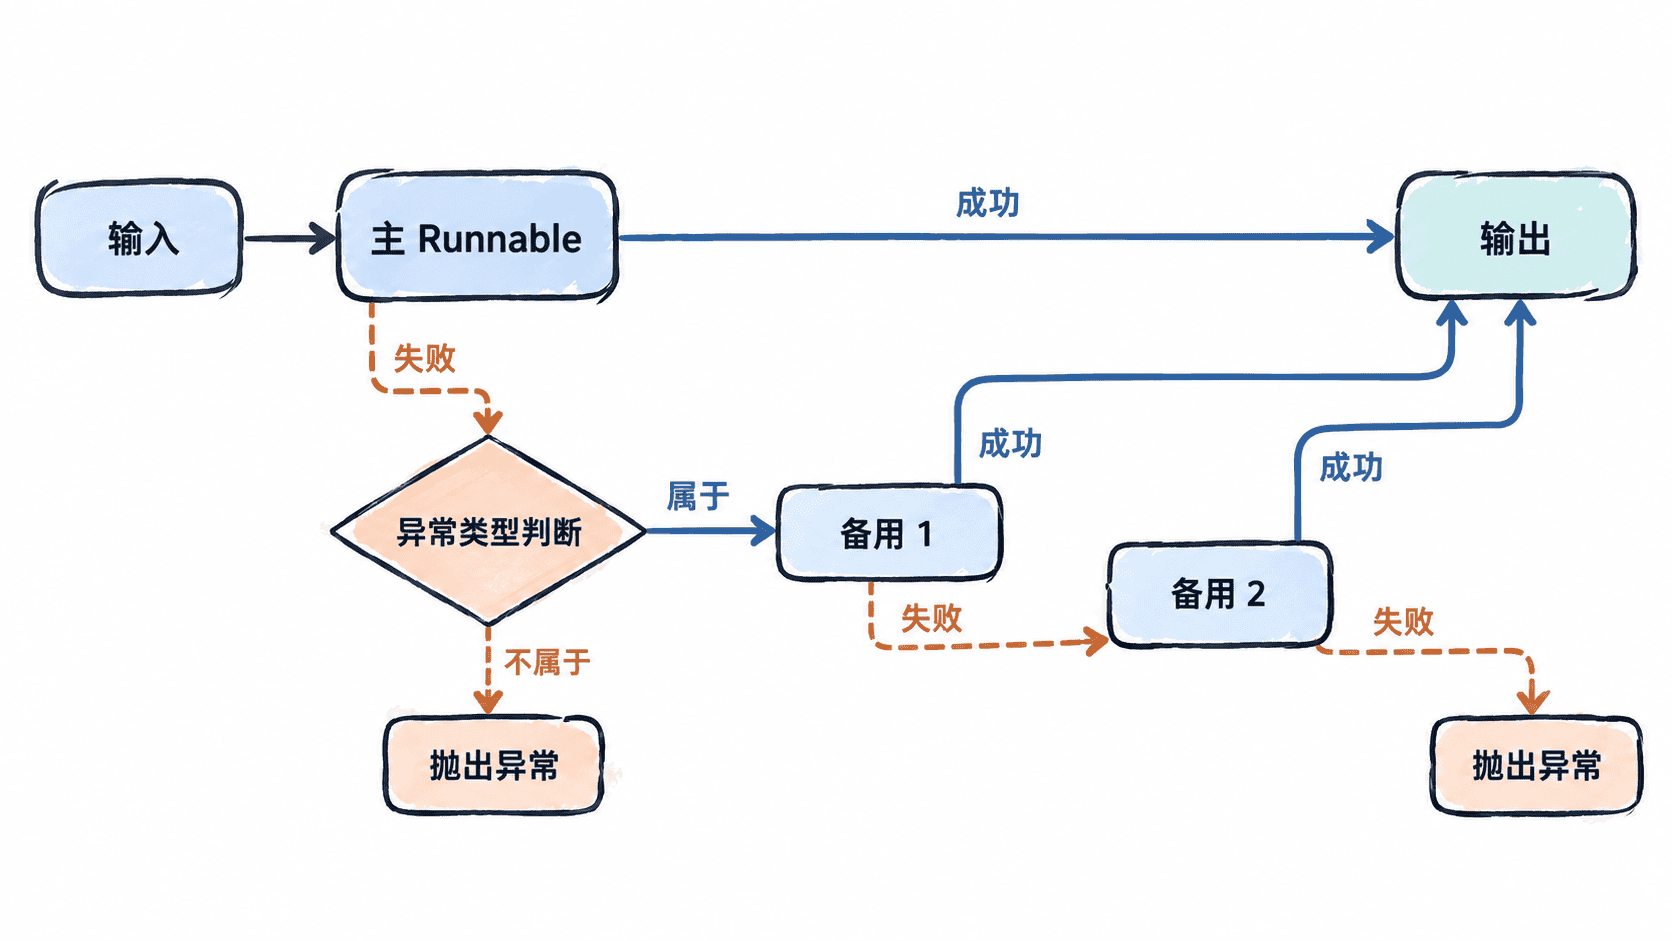
当主模型、外部 API 或处理 Runnable 抛出可恢复异常时,可用 with_fallbacks() 依次尝试备用实现。它适合做“主实现失败 → 备用实现接管”,不会把正常但质量较差的返回值自动判定为失败。
基本用法
调用形式为 primary.with_fallbacks(fallbacks, *, exceptions_to_handle=(Exception,), exception_key=None),返回带降级策略的新 Runnable,原对象不会被原地修改。
| 参数 | 含义 |
|---|---|
fallbacks |
按顺序尝试的备用 Runnable 列表 |
exceptions_to_handle |
触发降级的异常类型元组;未包含的异常会立即继续抛出 |
exception_key |
可选;把已捕获异常写入字典输入的指定键,供备用实现读取 |
如果设置了 exception_key,主 Runnable 与所有备用 Runnable 都应接收字典输入。成功时返回第一个成功 Runnable 的输出;若所有候选都失败,调用仍以异常结束。
主示例
from langchain_core.runnables import RunnableLambda

def primary(payload: dict) -> str:
    # 模拟主依赖超时;真实项目中通常来自模型或外部 API
    if payload['force_timeout']:
        raise TimeoutError('primary timed out')
    return '主链路处理:' + payload['query']

def backup(payload: dict) -> str:
    return '备用链路处理:' + payload['query']

# 只把明确可降级的超时交给备用链路
chain = RunnableLambda(primary).with_fallbacks(
    [RunnableLambda(backup)],
    exceptions_to_handle=(TimeoutError,),
)

print(chain.invoke({'query': '解释 LCEL', 'force_timeout': True}))
预期输出
备用链路处理:解释 LCEL风险与恢复
不要为了“保证成功”无差别捕获所有异常。对生产链路应尽量收窄 exceptions_to_handle,让参数错误、类型错误等编程缺陷直接暴露;备用实现也应保持与主实现兼容的输入输出结构。
短暂网络抖动更适合先重试,再在重试耗尽后降级;跨模型或跨服务切换则更适合 with_fallbacks()。若备用实现改变了能力或质量等级,应把这种降级状态同步到日志、追踪或业务响应中。
一次提交多组输入并控制批处理并发量。
批量处理输入
当同一个 LangChain Runnable 需要处理多组互不依赖的输入时,使用 batch() 可以一次提交整个输入列表,并通过 max_concurrency 限制并行任务数,避免把模型、数据库或外部 API 压满。
基本语法
Runnable.batch(inputs, config=None, *, return_exceptions=False, **kwargs) 会为输入列表执行同一个 Runnable,并返回与输入对应的结果列表。异步代码可使用 abatch();如果要按完成先后消费结果,可改用 batch_as_completed()。
关键选项
| 参数 | 作用 | 常用取值 |
|---|---|---|
inputs |
待处理的输入列表 | list |
config |
运行配置,可设置并发上限等 | {"max_concurrency": 4} |
return_exceptions |
失败时是否把异常对象放回结果列表 | 默认 False |
max_concurrency 控制同时执行的调用数,不等于总批次大小。批量输入很多时,应按下游服务的速率限制和连接池容量设置,而不是简单设成输入数量。
常用示例
from langchain_core.runnables import RunnableLambda

def normalize(text: str) -> str:
    # Runnable 只负责单条输入;batch() 负责并行调度多条输入。
    return text.strip().upper()

pipeline = RunnableLambda(normalize)
results = pipeline.batch(
    [" alpha ", "beta", " gamma "],
    config={"max_concurrency": 2},
)

print(results)
预期输出:
['ALPHA', 'BETA', 'GAMMA']风险与恢复
默认 return_exceptions=False 时,单个任务失败可能让整次 batch() 直接抛出异常。需要逐条保留失败结果时可显式设置 return_exceptions=True,并在业务层区分正常值与异常对象。对有副作用的写操作不要只靠提高并发提速,还要确认接口是否支持幂等、重试和限流。
异步调用组件使用异步接口提高高并发模型调用的吞吐量。
异步调用组件
用于同时发起多次模型或链调用,避免请求在网络等待期间串行阻塞。单次调用用 ainvoke,批量并发优先用 abatch;异步主要提升吞吐量,不会缩短单个模型请求本身的生成时间。
基本语法
await runnable.ainvoke(input) 返回一个完整结果;await runnable.abatch(inputs, config={"max_concurrency": 4}) 并发处理一组输入,并按输入顺序返回结果;需要谁先完成就先处理时,使用 abatch_as_completed,它返回原输入索引和结果。
高频用法
下面并发处理三个问题,并限制最多两个请求同时执行。提前在环境变量中设置 OPENAI_API_KEY。
import asyncio

from langchain_openai import ChatOpenAI

QUESTIONS = [
    "用一句话解释幂等性。",
    "用一句话解释数据库索引。",
    "用一句话解释限流。",
]

async def main() -> None:
    model = ChatOpenAI(
        model="gpt-5-mini",
        temperature=0,
        timeout=30,
        max_retries=2,
    )

    # 限制并发,避免瞬间打满供应商配额或本机连接池。
    results = await model.abatch(
        QUESTIONS,
        config={"max_concurrency": 2},
        return_exceptions=True,
    )

    for index, result in enumerate(results):
        if isinstance(result, Exception):
            print(f"[{index}] ERROR: {type(result).__name__}: {result}")
        else:
            print(f"[{index}] {result.text}")

if __name__ == "__main__":
    asyncio.run(main())
预期输出
[0] <MODEL_OUTPUT_FOR_IDEMPOTENCY>
[1] <MODEL_OUTPUT_FOR_DATABASE_INDEX>
[2] <MODEL_OUTPUT_FOR_RATE_LIMITING>实际措辞可能不同;[0]、[1]、[2] 与 QUESTIONS 的输入顺序一致。若改用 abatch_as_completed,应使用其返回的索引恢复业务顺序。
风险与边界
并发过高会触发 429、连接池耗尽和费用突增。触发条件通常是无上限地创建任务,或每个 Web 请求都再次放大并发;安全做法是同时设置 max_concurrency、应用级信号量和账户配额告警。
重试会放大瞬时流量。模型读取类调用通常可安全重试,但链中包含发消息、扣款、写数据库等副作用工具时,可能重复执行;应为副作用操作增加幂等键,或把重试限制在模型调用层。
abatch 的默认实现通常是并发执行多个 ainvoke,不等同于供应商离线 Batch API,也不保证批量折扣。需要低成本异步作业时,应改用对应供应商的原生批处理能力。
排障清单
- 出现
coroutine was never awaited:检查是否漏写await。 - 出现
asyncio.run() cannot be called from a running event loop:Jupyter 中直接执行await main();FastAPI 等异步框架中直接等待协程。 - 频繁 429:降低
max_concurrency,检查供应商每分钟请求数和令牌数限制。 - 请求越来越慢:复用模型实例,检查 HTTP 连接池、超时和下游同步阻塞代码。
兼容性
Runnable、模型、检索器和 LCEL 链通常都提供 ainvoke、abatch 与 abatch_as_completed。生产环境优先使用 Python 3.11 及以上;旧版代码中的 acall、arun 等专用接口不宜作为新代码的统一入口。
流式返回内容逐块接收模型输出并实时更新客户端界面。
流式返回内容
用于在模型生成过程中持续把文本增量推送给客户端,降低首屏等待感。模型组件使用 astream 读取 AIMessageChunk;Web 端常通过 SSE 或 WebSocket 转发,客户端收到一块就追加一块。
基本语法
核心循环是 async for chunk in model.astream(input)。文本读取使用 chunk.text,并跳过空文本块;分块边界由模型和网络决定,可能落在一个词或一句话中间,不能把单个块当成完整语义单元。
高频用法
下面提供可运行的 FastAPI SSE 接口。保存为 app.py,安装 fastapi、uvicorn 和 langchain-openai,并设置 OPENAI_API_KEY。
import json
from collections.abc import AsyncIterator

from fastapi import FastAPI, Query
from fastapi.responses import StreamingResponse
from langchain_openai import ChatOpenAI

app = FastAPI()
model = ChatOpenAI(
    model="gpt-5-mini",
    temperature=0,
    timeout=30,
    max_retries=2,
)

async def generate_sse(question: str) -> AsyncIterator[str]:
    async for chunk in model.astream(question):
        if not chunk.text:
            continue

        # 每个 SSE 事件发送合法 JSON,避免换行和中文破坏协议边界。
        payload = json.dumps({"delta": chunk.text}, ensure_ascii=False)
        yield f"data: {payload}\n\n"

    yield "event: done\ndata: {}\n\n"

@app.get("/chat/stream")
async def chat_stream(
    q: str = Query(min_length=1, max_length=2000),
) -> StreamingResponse:
    return StreamingResponse(
        generate_sse(q),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "X-Accel-Buffering": "no",
        },
    )
先启动服务:
uvicorn app:app --host 127.0.0.1 --port 8000预期输出
INFO:     Started server process [<ID>]
INFO:     Uvicorn running on http://127.0.0.1:8000
在另一个终端使用禁用客户端缓冲的 curl -N 验证:
curl -N -G --data-urlencode "q=用三点解释缓存穿透" http://127.0.0.1:8000/chat/stream预期输出
data: {"delta":"<FIRST_CHUNK>"}

data: {"delta":"<NEXT_CHUNK>"}

event: done
data: {}
实际文本和分块大小会变化。客户端按到达顺序拼接各事件中的 delta;收到 done 事件后结束加载状态。
输出字段说明
delta 是本次新增文本,不是完整答案。SSE 每条事件必须以两个换行结束;event: done 是示例定义的结束信号,不是 LangChain 自动生成字段。工具调用或多模态响应可能产生空文本块或非文本内容,应按消息类型单独处理。
风险与边界
流式输出只改善首块可见时间,不保证总耗时更短。反向代理、CDN 或压缩中间件开启缓冲时,客户端可能最后一次性收到全部内容;Nginx 应关闭该路由的 proxy_buffering,并保留 X-Accel-Buffering: no。
不要逐块解析模型生成的 JSON、SQL 或 Markdown 结构,因为任意块都可能是不完整片段。安全做法是界面先展示文本增量,最终完成后再对累积内容做一次结构校验;需要严格结构化结果时优先等待完整响应。
客户端断开后应停止下游生成,否则仍可能继续消耗令牌。生产接口还应增加鉴权、请求超时、并发上限和取消传播,不能直接暴露无限制的公开流式端点。
排障清单
- 内容最后一次性出现:确认模型支持流式、客户端使用
curl -N或流式读取,并检查代理缓冲。 - 页面出现重复文本:确认前端只追加
delta,不要同时追加增量和最终全文;检查 SSE 自动重连是否重复发起请求。 - 中文乱码:保持 UTF-8,并用 JSON 编码事件数据。
- 能看到文本但没有用量:按模型集成能力启用流式用量统计,并从最终元数据块读取。
兼容性
支持原生流式的聊天模型会逐块返回内容;不支持流式的组件可能退化为只返回一个完整块。普通模型文本用 astream 即可;需要同时观察 Agent 步骤、工具调用或自定义进度时,应使用对应 Agent 或 LangGraph 的事件流接口。