
图形渲染与 Shader / 系统课时
采样次数增加为何会变慢
采样次数增加为何会变慢
纹理采样不是一次普通变量读取。着色器每增加一次 texture 调用,都可能引入地址计算、纹理缓存访问、过滤以及显存数据传输。本节通过对照着色器拆解采样次数、缓存命中与带宽之间的关系,并给出实际项目中判断瓶颈的顺序。
学习目标
- 理解一次纹理采样在 GPU 中会产生哪些主要成本
- 区分采样次数、缓存命中率和显存带宽造成的性能压力
- 用最小化对照着色器判断增加采样是否真的成为瓶颈
先分清算力压力和访存压力
纹理采样变多后,GPU 时间上升并不意味着纹理单元本身一定已经饱和。一个采样至少要计算 UV 地址、查询缓存、按过滤模式取得纹素,缓存未命中时还要从更低层缓存甚至显存读取数据。不同阶段的成本会叠加,但实际瓶颈通常由其中最慢的一环决定。
如果着色器同时包含大量光照、分支或复杂数学运算,增加一两个采样可能并不明显;而在计算很轻、覆盖像素很多的全屏效果中,同样的采样增量更容易暴露为带宽或纹理单元压力。因此不能只数代码里的 texture 调用,还要结合分辨率、纹理尺寸和实际 GPU 指标判断。
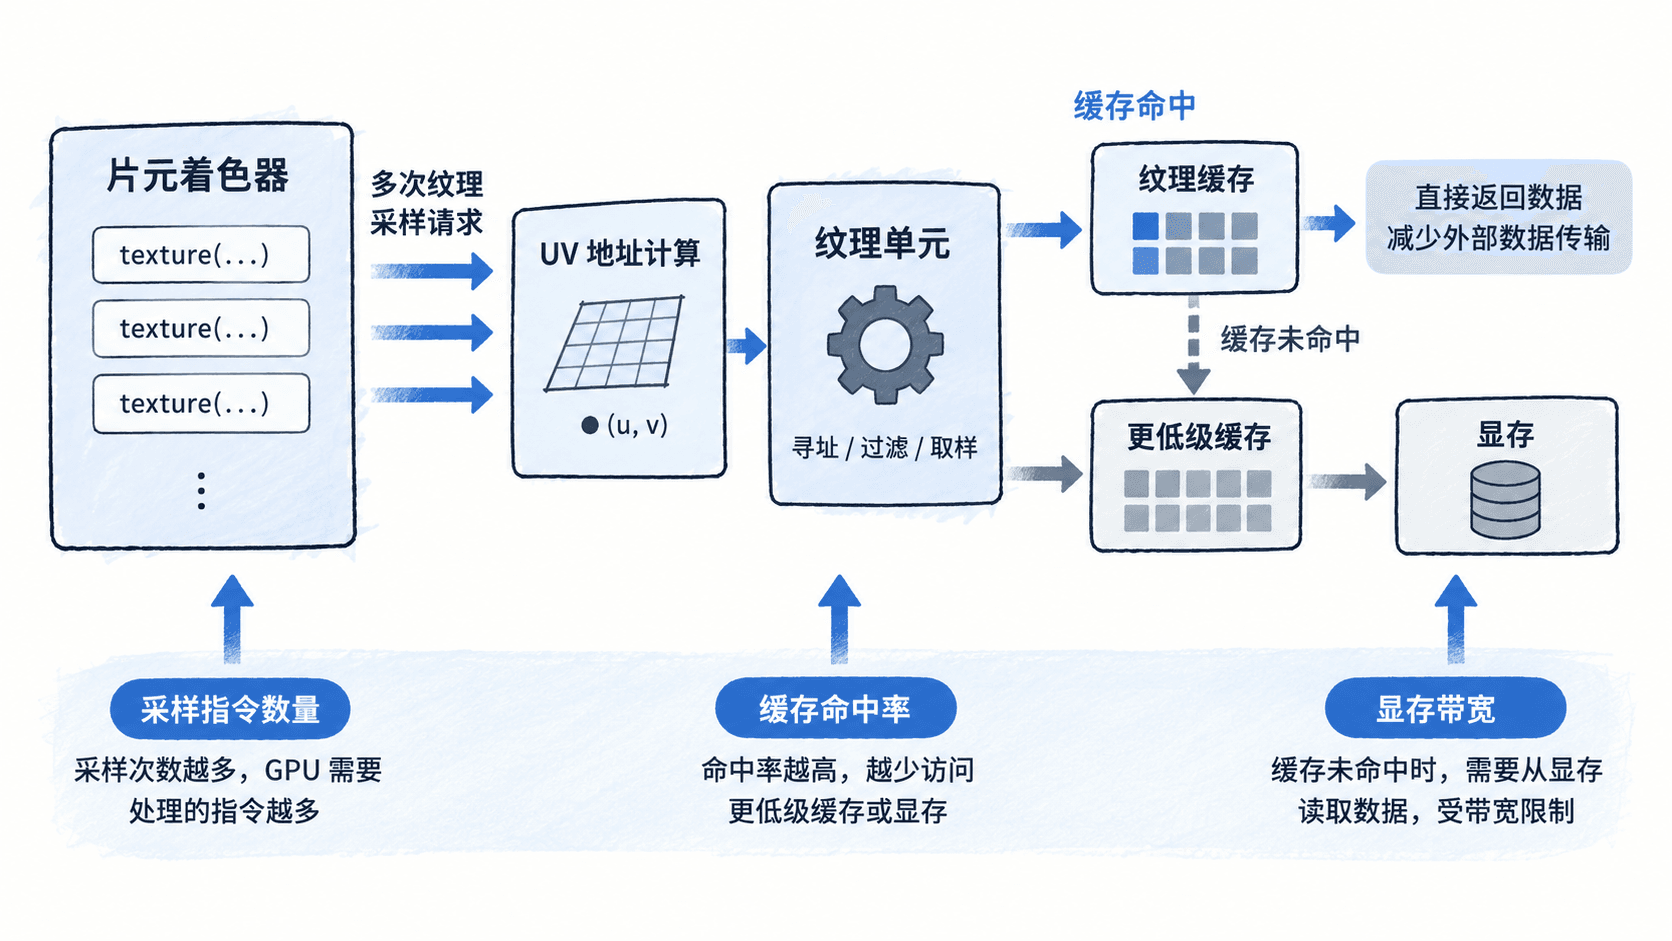
为什么相同采样次数成本也不同
连续像素访问相邻 UV 时具有较好的空间局部性,邻近纹素更可能已经位于纹理缓存中。相反,如果 UV 跳跃很大、随机访问高分辨率纹理,或者多个采样分别访问不同的大纹理,缓存复用率就会下降,实际需要从显存搬运的数据量明显增加。
过滤方式也会改变内部工作量。双线性过滤需要组合邻近纹素,三线性过滤还会在两个 mip 层之间插值,各向异性过滤则可能沿纹理投影方向取得更多样本。源码中的一次 texture 调用因此不等于底层只读取一个纹素,分析性能时应同时检查过滤模式与采样方向。
用最小对照确认采样是否是瓶颈
排查时可以先保持几何、分辨率、混合和其他数学运算不变,只修改采样数量。下面是 GLSL 片段示例,它依赖引擎已经提供 uBase、vUV 和片元输出接口,用于比较一次采样与四次邻域采样的相对开销。
uniform sampler2D uBase;
in vec2 vUV;
out vec4 fragColor;

void main() {
    vec2 texel = 1.0 / vec2(textureSize(uBase, 0));

    // 四个相邻位置用于制造稳定且可控的额外采样。
    vec4 c0 = texture(uBase, vUV);
    vec4 c1 = texture(uBase, vUV + vec2(texel.x, 0.0));
    vec4 c2 = texture(uBase, vUV + vec2(0.0, texel.y));
    vec4 c3 = texture(uBase, vUV + texel);

    fragColor = (c0 + c1 + c2 + c3) * 0.25;
}
预期结果是画面呈现四个邻近纹素的平均颜色。将它与只输出 texture(uBase, vUV) 的版本在相同场景中比较,如果 GPU 片元阶段时间稳定上升,同时带宽或纹理单元相关指标也增加,就能较有把握地把问题收敛到采样路径。具体耗时数值取决于 GPU、分辨率和资源状态,不应跨设备直接比较绝对值。
缓存和带宽要结合资源一起看
减少采样次数当然有效,但有时换资源比删代码收益更大。两次访问小型、连续、带 mip 的纹理,可能比一次随机访问超大纹理更友好;压缩格式能够减少显存传输量,但是否节省带宽还取决于 GPU 对该格式的原生支持和实际解码路径。
排查时可以按这个顺序收敛:先确认采样数量,再检查纹理尺寸与 mip,再观察访问是否连续,最后查看过滤和格式。若降低渲染分辨率后 GPU 时间明显下降,而 CPU 时间基本不变,也说明问题很可能位于片元覆盖、采样或带宽一侧。
哪些优化通常最值得先做
优先删除视觉贡献很低的重复采样,例如多个阶段重复读取同一张遮罩;能够离线合并的灰度通道可以考虑打包到一张纹理中,以减少独立资源访问。远距离纹理应确保 mip 链有效,否则不仅画面容易闪烁,还会读取远超当前屏幕需求的高分辨率数据。
不要为了减少一次采样而盲目增加大量数学计算,也不要只根据源码中的采样次数判断性能。有效优化应以 GPU 分析结果为依据:确认瓶颈确实随采样数量、资源带宽或缓存行为变化,再决定减少采样、调整纹理资源还是修改过滤策略。