
可观测性与稳定性 / 系统课时
设计持续性能优化方案
设计持续性能优化方案
本篇解决性能优化容易陷入临时救火的问题,帮助建立从监控发现、容量评估到优化验证的长期治理流程。完成学习后,可以把一次性能调优转化为持续改进体系。
学习目标
- 理解持续性能优化体系的核心组成部分
- 掌握通过指标、容量和实验建立优化闭环的方法
- 能够设计适用于生产环境的性能治理流程
从一次优化到持续治理
生产系统的性能问题通常不是单次调整就能永久解决。业务增长、流量变化、代码演进和基础设施调整都会改变系统运行状态,因此性能优化需要从一次性的参数修改转变为持续治理过程。
持续性能优化的核心是建立反馈闭环:通过监控发现异常,通过分析定位瓶颈,通过优化改善指标,再通过验证确认效果。这个过程不断循环,让系统性能随着业务发展保持可控。
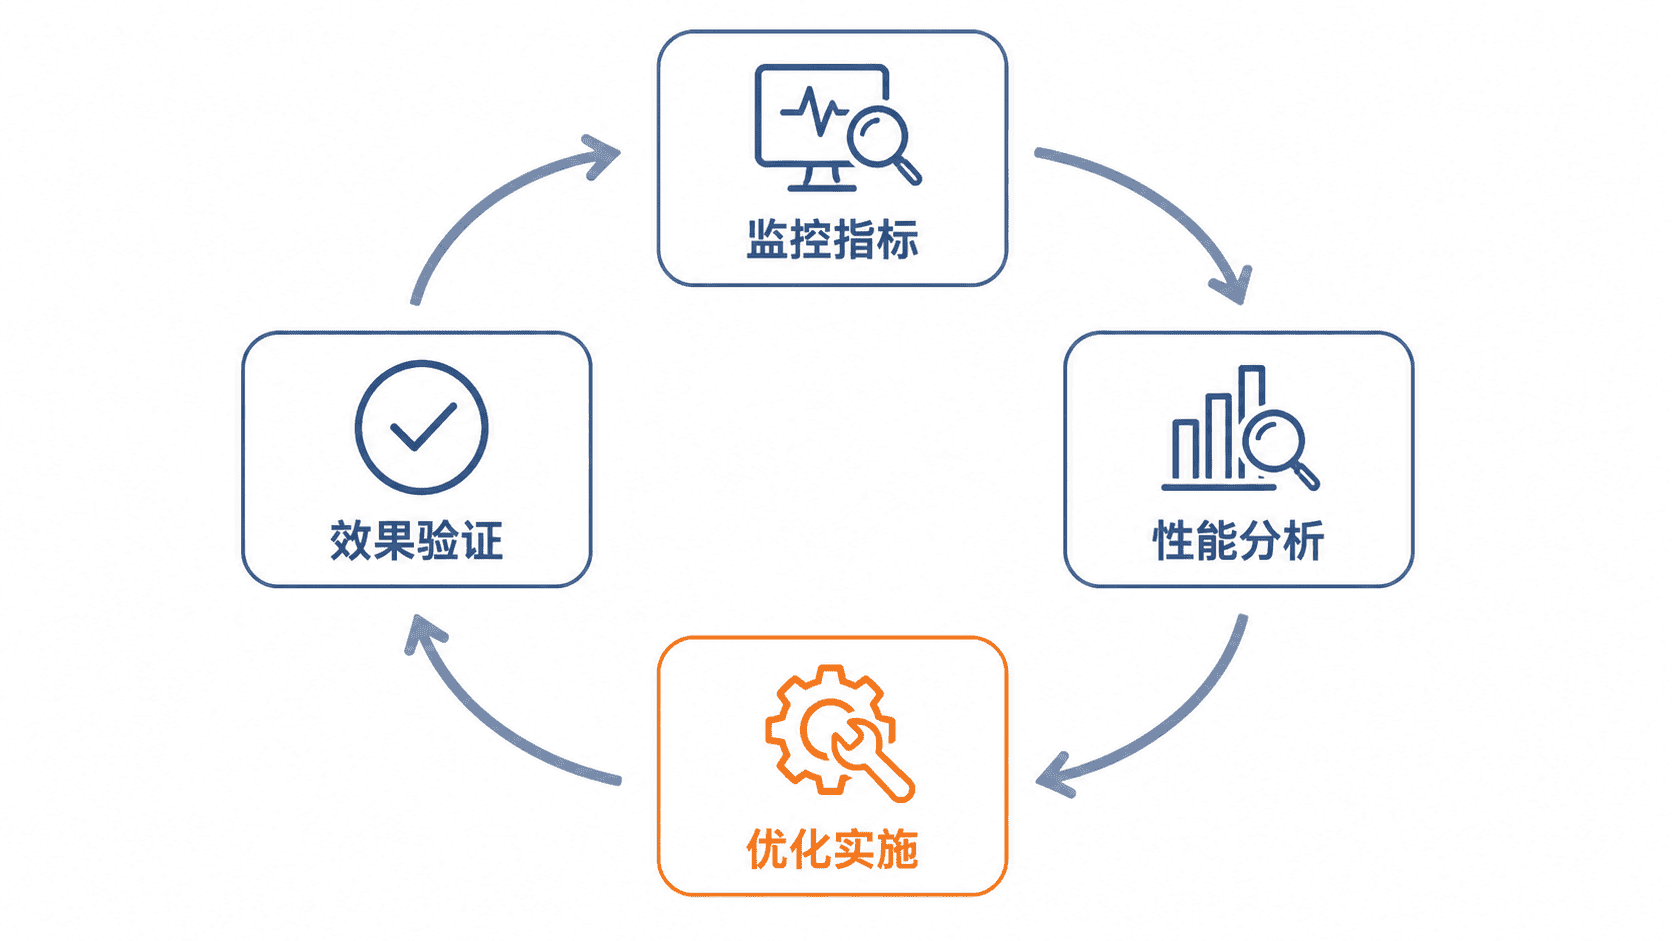
建立性能指标体系
持续优化首先需要稳定的观测基础。没有可靠指标,就无法判断优化是否有效,也无法提前发现容量风险。
常见指标可以分为四类:
- 资源指标:CPU、内存、磁盘、网络使用情况
- 应用指标:请求延迟、吞吐量、错误率
- 服务指标:线程池状态、连接池使用率、队列长度
- 业务指标:订单量、任务数量、用户访问峰值
不同指标承担不同职责。例如 CPU 使用率升高只是现象,结合请求延迟和线程状态,才能判断是否存在计算瓶颈、锁竞争或任务堆积。
性能治理中通常关注指标趋势,而不是单个时间点的数据。短时间突增可能是正常流量波动,持续增长则可能意味着容量不足。
使用容量规划预防瓶颈
容量规划的目标是在问题发生前预测系统承载能力。它需要结合历史数据、业务增长和资源变化进行评估。
一个简单容量评估可以基于当前峰值和增长比例计算:
例如当前服务峰值需要 8 个 CPU 核心,预计业务增长 50%,则未来容量需求约为 12 个 CPU 核心。实际生产环境还需要考虑峰值倍率、故障冗余和扩容时间。
容量评估不只是增加机器,还包括发现架构限制。例如数据库连接数不足、缓存命中率下降、消息队列积压等问题,都可能成为新的瓶颈。
建立优化实验流程
性能优化需要避免“修改后感觉更快”的主观判断。每次优化都应该有明确目标、实验范围和验证指标。
一个完整优化流程通常包含:
- 记录优化前基线数据,包括吞吐量、延迟和资源消耗。
- 提出明确假设,例如减少锁竞争会降低请求延迟。
- 在可控环境中实施调整。
- 对比优化前后的关键指标。
- 确认收益后再推广到生产环境。
例如调整 JVM 参数、修改数据库索引或优化系统调用,都应该通过数据验证,而不是仅依据经验判断。
下面示例展示一个简单的性能记录脚本,用于保存关键指标采样结果。
#!/usr/bin/env bash

OUTPUT="performance-report-<TIME>.txt"

# 记录系统关键性能指标,便于优化前后对比
{
  echo "CPU"
  uptime
  echo "Memory"
  free -m
  echo "Disk"
  df -h
} > "$OUTPUT"

echo "report saved: $OUTPUT"
预期输出
report saved: performance-report-<TIME>.txt实际文件名中的 <TIME> 会根据执行时间变化。
将优化纳入工程流程
长期性能治理需要进入日常开发和运维流程,而不是只在故障发生时执行。
可以在团队中建立以下机制:
- 版本发布前进行关键性能指标检查
- 定期分析资源增长趋势
- 为核心接口维护性能基线
- 对重大架构调整进行容量评估
- 保存历史优化记录和验证结果
持续优化的重点不是不断调整参数,而是让系统具备发现问题、分析问题和验证改进的能力。当性能数据成为工程决策依据时,优化才能从经验驱动转变为数据驱动。