
FPGA 与数字 IC 设计 / 系统课时
建立时序收敛迭代流程
建立时序收敛迭代流程
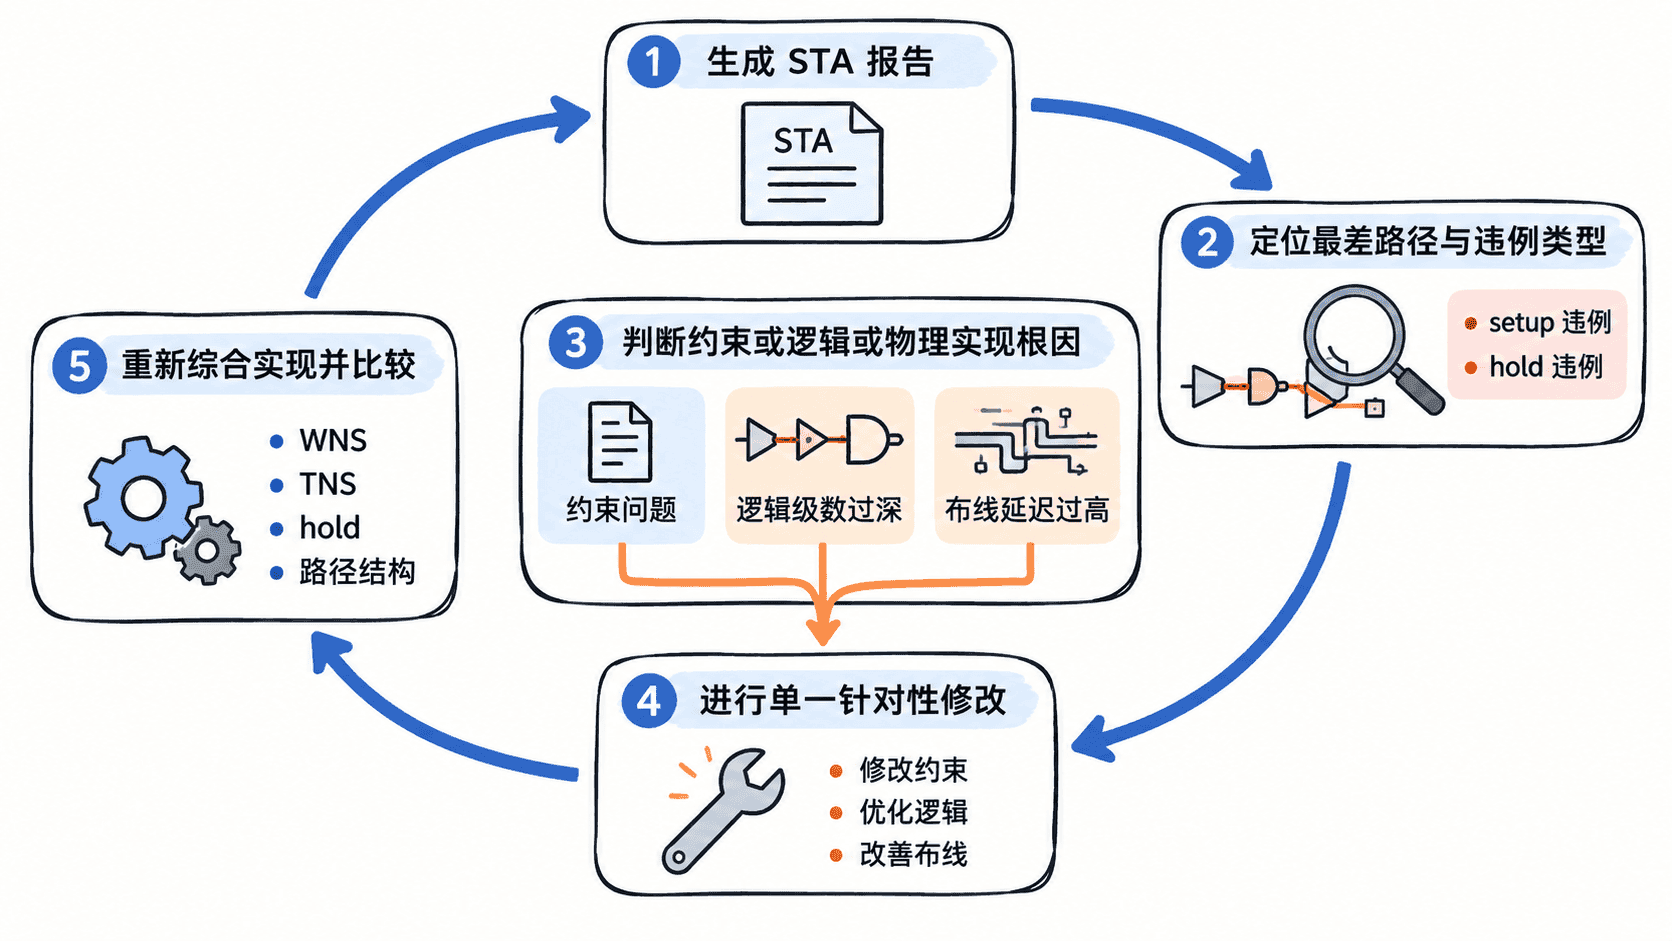
时序收敛不是反复修改 RTL 直到工具不再报红,而是一个可验证的工程闭环:先固定分析基线,再定位最关键的违例,针对根因做最小修改,重新实现并比较结果。建立这套流程后,每次修改都能回答“为什么改、改善了什么、是否引入新问题”。
学习目标
- 建立从时序报告到设计修改、重新实现和结果验证的迭代闭环。
- 根据关键路径特征选择约束、逻辑、布局布线或流水线方向的优化手段。
- 用可比较的指标判断一次修改是否真正推动了时序收敛。
先固定一份可比较的时序基线
一次有效迭代必须从相同分析条件出发。至少记录实现版本、约束版本、目标器件、实现策略,以及 setup 和 hold 的最差裕量。如果每轮都同时更换 RTL、约束和实现策略,即使 WNS 改善,也很难知道是哪项修改产生了作用。
在 Vivado 已完成实现的工程中,可以先打开实现结果并提取最差 setup 路径。下面的 Tcl 示例同时把关键路径保存成独立报告,便于修改前后对照。
open_run impl_1
set worst_path [lindex [get_timing_paths -delay_type max -max_paths 1] 0]
if {$worst_path eq ""} {
    error "No setup timing path found."
}
set slack [get_property SLACK $worst_path]
puts "worst_setup_slack=${slack}ns"
report_timing -of_objects $worst_path -file worst_setup_path.rpt
预期输出
worst_setup_slack=<SLACK>ns<SLACK> 是当前实现结果中的实际裕量,可能为正数或负数。脚本同时生成 worst_setup_path.rpt,其中保存这条路径的起点、终点、逻辑级数、单元延迟和布线延迟。
按根因而不是按数值修改设计
看到负裕量后,不应直接把目标周期调大。先阅读关键路径,判断延迟主要来自哪里。组合逻辑级数很深时,应考虑重新组织逻辑或增加流水级;布线延迟占比很高时,应检查高扇出网络、跨区域连接、拥塞和物理布局;路径本身不应该参与该时钟关系时,则应重新检查时钟、例外路径或接口约束。
一次迭代尽量只解决一个主要问题。例如某条路径经过多级算术逻辑,最合理的实验通常是插入寄存器或重构运算,而不是同时修改约束、换实现策略并增加寄存器。这样才能把时序变化和设计动作建立因果关系。
用修改前后证据判断是否有效
重新综合和实现后,首先比较 WNS、TNS 和 hold 裕量,但不要只看一个数字。某次修改可能让最差路径从 -0.40 ns 提升到 -0.05 ns,却把大量其他路径推成轻微违例,此时总体 TNS 可能反而恶化。还要确认新的最差路径是否已经转移到其他逻辑区域。
验证时重点回答三个问题:原来的关键路径是否仍然存在;原路径的逻辑延迟和布线延迟分别发生了什么变化;新的最差路径是否属于同一类根因。若路径连续几轮都被相同结构限制,继续调整实现参数往往收益有限,应回到 RTL 或微架构层处理。
什么时候结束迭代
达到 WNS 大于等于 0 只是基本条件。真正结束前还要确认 hold 没有新增违例、主要时钟域都被正确分析、关键路径没有依赖错误的例外约束,并且结果在预期实现流程中可以稳定复现。如果只有某一次实现偶然通过,而重新运行后又出现明显负裕量,说明设计仍处于脆弱边界。
成熟的时序收敛流程不是“发现负裕量就改代码”,而是持续执行同一条证据链:固定基线、识别关键路径、判断根因、做最小修改、重新实现、比较指标。只要每一轮都能说明变化来自哪里,时序优化就从试错变成了可控制的工程过程。