
PCB 与硬件设计 / 系统课时
用日志关联抗扰扰动与系统异常
用日志关联抗扰扰动与系统异常
抗扰测试中最难处理的往往不是“设备出错”,而是无法证明错误与哪一次 EFT、ESD、射频或电压跌落有关。本篇建立一套可落地的事件日志:统一时间基准、记录注入事件、复位原因、通信计数和供电状态,让每个异常都能回溯到对应扰动。
学习目标
- 为扰动事件和系统异常设计统一的时间戳与事件标识。
- 用复位原因、通信错误和供电采样组成可检索的故障证据链。
- 根据一次完整测试日志判断异常发生在扰动之前、期间还是之后。
先让测试仪器和设备日志使用同一条时间线
如果 EMC 仪器记录“第 27 次脉冲发生异常”,设备只打印“UART error”,两边没有共同标识,就很难确认因果。预兼容测试至少记录 testId、injectionSeq 和单调递增时间 uptimeMs。其中 uptimeMs 应来自不会因 RTC 校时而跳变的系统时基。
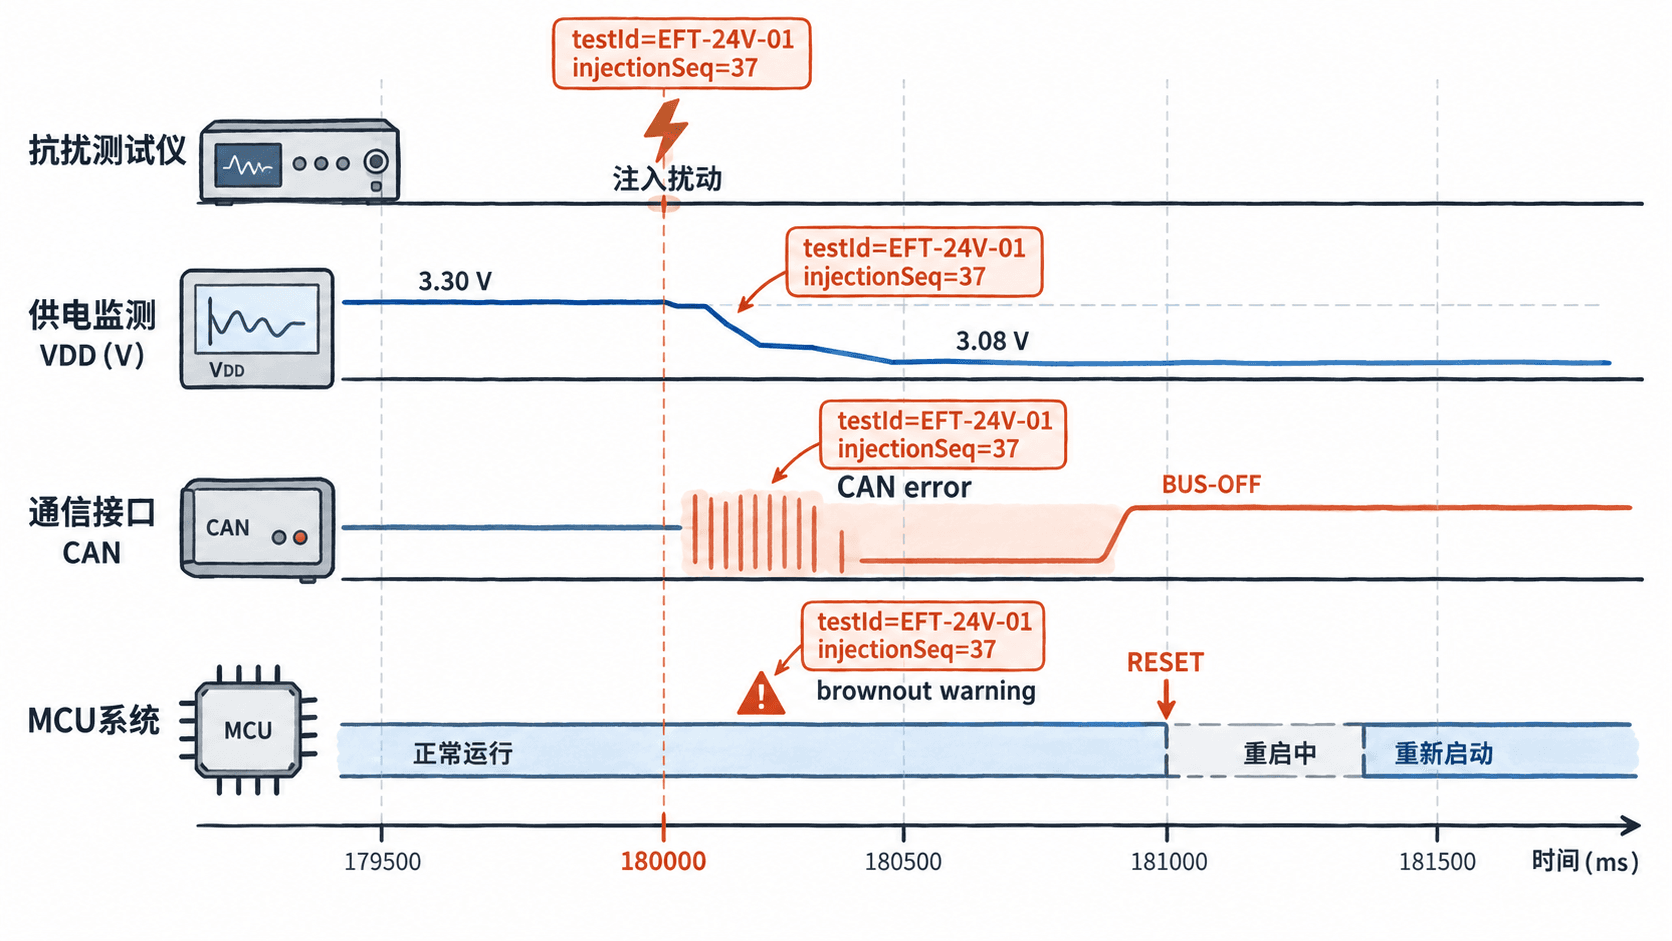
一次 EFT 测试可以约定 testId=EFT-24V-01,每组脉冲开始前由测试控制程序或人工触发输入把序号写入设备,例如 injectionSeq=37。设备内部后续产生的欠压、总线错误和复位前快照都带上这个序号。
| 字段 | 示例 | 用途 |
|---|---|---|
uptimeMs |
184233 |
判断事件先后,分辨毫秒级关联 |
testId |
EFT-24V-01 |
区分测试项目和工况 |
injectionSeq |
37 |
对应某一次或某一组扰动 |
event |
CAN_BUS_OFF |
统一异常类别 |
value |
vdd=3.08 |
保存现场关键量 |
在固件里保存复位原因和故障前快照
复位之后再打印日志已经太晚,因此需要把关键状态写进复位后仍可读取的位置,例如 MCU 的备份寄存器、retention RAM 或小块非易失存储。不要在每次错误时立即擦写 Flash;高频 EFT 测试可能数秒内产生数百次事件,容易阻塞系统并消耗擦写寿命。
下面用标准 C 演示最小日志模型。实际项目把 read_vdd_mv()、复位原因寄存器和持久化函数替换为目标 MCU 的真实驱动接口。
#include <stdio.h>
#include <stdint.h>

typedef struct {
    uint32_t uptime_ms;
    uint32_t injection_seq;
    uint16_t vdd_mv;
    uint16_t can_error_count;
    uint32_t reset_flags;
} FaultSnapshot;

int main(void) {
    FaultSnapshot s = {
        .uptime_ms = 184233,
        .injection_seq = 37,
        .vdd_mv = 3080,
        .can_error_count = 12,
        .reset_flags = 0x02
    };

    printf("t=%lu seq=%lu VDD=%u CAN_ERR=%u RESET=0x%02lX\n",
           (unsigned long)s.uptime_ms,
           (unsigned long)s.injection_seq,
           s.vdd_mv,
           s.can_error_count,
           (unsigned long)s.reset_flags);
    return 0;
}
预期输出:
t=184233 seq=37 VDD=3080 CAN_ERR=12 RESET=0x02reset_flags=0x02 在不同 MCU 上没有统一含义,必须按芯片参考手册解析。例如很多 MCU 会分别提供上电复位、看门狗复位、欠压复位和软件复位标志,不能把示例数值直接当作真实寄存器定义。
把通信错误和供电异常记录成事件而不是一句文本
排障时应记录“发生了什么”和“当时的计数器是多少”,而不只是输出 communication failed。以 CAN 为例,可以同时保存接收错误计数、发送错误计数、BUS-OFF 状态和恢复次数;UART 可保存帧错误、奇偶校验错误和溢出次数;以太网可保存链路变化、CRC 错误和驱动重置事件。
供电侧同样如此。假设 MCU 标称 3.3 V,日志周期采样为 1 ms,可以设置两级软件观测阈值:VDD_WARN=3.15 V 用于记录可疑下降,真正的 BOR 阈值仍由芯片硬件配置决定。一次异常日志可写成:
184200 TEST_EVENT test=EFT-24V-01 seq=37 phase=INJECT
184228 POWER_WARN seq=37 vdd_mv=3150
184231 CAN_ERROR seq=37 tx_err=96 rx_err=0
184233 CAN_BUS_OFF seq=37 tx_err=255 rx_err=0
184235 RESET_PENDING seq=37 vdd_mv=3080
<BOOT> RESET_CAUSE flags=0x02 last_seq=37
这段是日志格式示例,不是可执行命令。它表达的关键关系是:扰动在 184200 ms 注入,28 ms 后供电先跌破观测阈值,随后 CAN 错误计数快速增长,最终发生复位。相比只看到“设备重启”,这里已经能形成可验证的排查方向。
按固定顺序判断扰动与故障是否真的相关
拿到日志后不要直接把时间接近等同于因果。建议按照以下顺序判断:
- 先确认
testId与injectionSeq一致,排除上一轮测试残留日志。 - 检查异常时间是否落在定义的关联窗口内。对于本地 MCU 日志,可先用扰动前
20 ms到扰动后200 ms作为工程筛查窗口,再依据实际接口超时和保护动作延长。 - 比较重复性。例如同一注入位置、同一极性连续测试 20 次,其中 17 次都在
30±5 ms后出现 CAN BUS-OFF,关联性明显高于只发生 1 次的随机异常。 - 检查前置事件。如果每次 BUS-OFF 前都出现 VDD 下跌,应先查供电耦合;如果 VDD 始终稳定而接收错误计数先增长,应优先检查接口共模耦合、收发器和参考地路径。
用日志闭合整改验证
一次有效闭环至少需要比较扰动条件、异常指标和恢复时间。假设原方案在 ±2 kV EFT、5 kHz 脉冲频率下测试 60 s,记录到 8 次通信中断、2 次复位,最长业务恢复时间为 4.8 s;增加入口共模滤波并调整回流后,以完全相同工况复测 60 s,结果应继续用相同事件字段记录,而不是换一套日志格式。
验收时可以把指标定为:复位次数 0,BUS-OFF 次数 0,允许出现但可自动恢复的瞬时通信错误不超过预先定义阈值,并记录最大恢复时间。例如整改后出现 3 次单帧错误但均在 20 ms 内恢复,且没有 BUS-OFF 或复位,就能明确区分“仍有可观测扰动”与“系统功能失效”。
最终保留的证据应能回答三个问题:哪一次扰动发生了什么异常,异常前最先变化的是供电、接口还是软件状态,以及整改后同样的注入条件下这些事件是否消失。做到这一点,日志才真正从调试输出变成 EMC 整改闭环中的测量工具。