
交互与用户体验 / 系统课时
检验分类的互斥性与覆盖率
检验分类的互斥性与覆盖率
一套分类方案看起来整齐,不代表实际内容都能顺利归入其中。上线前需要检查三个问题:内容是否有归属、是否存在多个同样合理的主分类、同层类别的抽象层级是否一致。本篇以电商帮助中心的30条内容为例,完成分类检验、指标计算和边界修正。
学习目标
- 使用代表性内容样本检验分类的覆盖率与互斥性。
- 计算归类指标,识别重复归类、分类缺口和层级混杂。
- 制定可执行的分类边界规则,并通过复测验证修正效果。
准备具有边界压力的内容样本
检验对象是同一层级的分类,例如帮助中心的一级类别。先明确内容范围:本案例覆盖订单、支付、物流、售后、发票和账户相关的帮助文章,分类对象为每篇文章,不是文章中的关键词。
从现有内容库选取30条样本,按照以下结构组织:
| 样本类型 | 数量 | 选取方式 |
|---|---|---|
| 高频常见内容 | 16条 | 按近30天访问量选取常见问题 |
| 跨领域边界内容 | 8条 | 选取可能属于两个类别的文章 |
| 低频与异常内容 | 6条 | 选取搜索失败、投诉或罕见操作相关内容 |
| 合计 | 30条 | 去重后每篇文章只算一个样本 |
这是用于发现结构问题的压力测试样本,而非按流量比例进行的随机抽样,因此不能直接把测试比例当成全站的真实比例。
建立一张归类记录表,包含内容ID、文章标题、用户主任务、候选类别、归类理由和问题类型。首轮允许记录多个候选类别,不要为了得到漂亮的指标而提前强行选择一个。
例如,用户查找“退款何时到账”,主任务是追踪退款结果;即使涉及支付渠道,也不能只凭出现“支付”一词就将其归入支付类。归类应以用户准备完成的任务为依据。
记录首次归类中的冲突与缺口
假设现有一级类别为“订单操作、物流配送、售后服务、发票申请”。对30条内容进行首次归类后,分别记录每个类别接收了多少次归类,以及哪些内容无法得到明确归属。
| 归类结果 | 内容条数 | 典型情况 |
|---|---|---|
| 仅归入一个类别 | 20 | 查询物流轨迹 |
| 同时归入两个类别 | 6 | 退款到账、丢件补发、发票下载 |
| 无法归入任何类别 | 4 | 支付失败、账户登录等问题 |
| 合计 | 30 | 每条内容只计入一种结果状态 |
按类别统计,订单操作被选中10次、物流配送8次、售后服务9次、发票申请5次,共32次归类。这与30条内容并不矛盾:26条内容至少被归类一次,其中6条各被归入两个类别,因此共有32次归类。
具体冲突可以这样记录:
| 内容标题 | 首轮候选类别 | 暴露的问题 |
|---|---|---|
| 退款到账时间 | 订单操作、售后服务 | 两个类别边界重叠 |
| 包裹丢失后申请补发 | 物流配送、售后服务 | 物流异常与售后处理混杂 |
| 下载订单发票 | 订单操作、发票申请 | 订单相关内容边界过宽 |
| 支付失败怎么办 | 无 | 缺少支付主题类别 |
| 无法登录账户 | 无 | 缺少账户主题类别 |
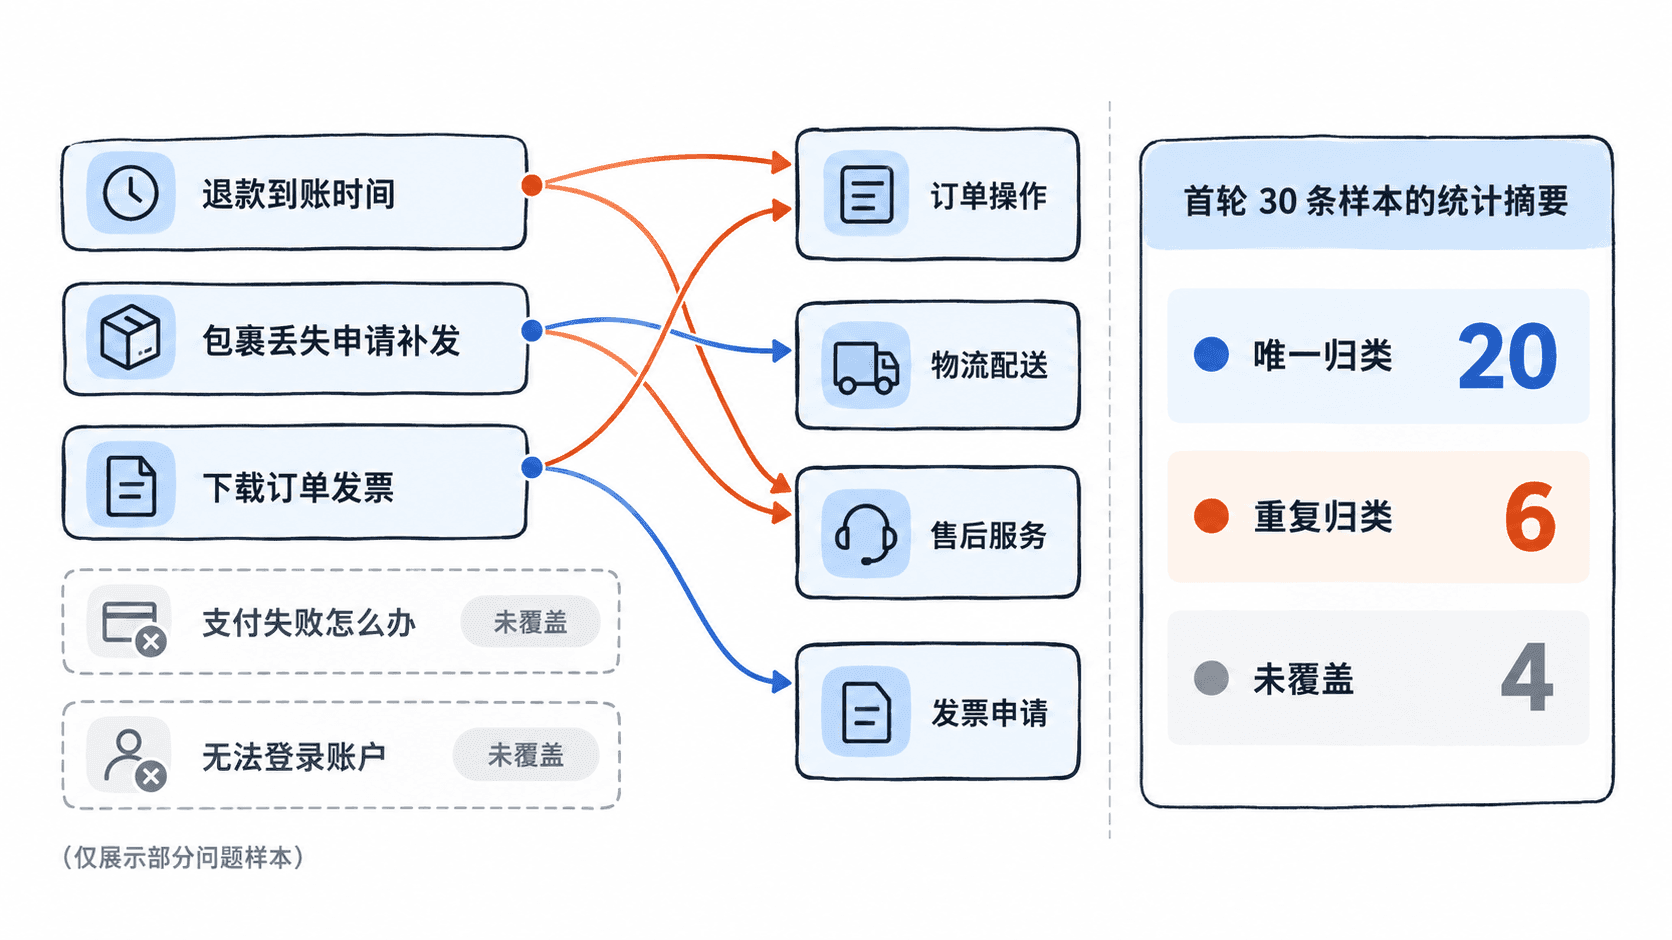
这次记录还暴露出层级问题:“订单操作”和“物流配送”描述较广的业务领域,而“发票申请”只是具体动作。把业务领域和单个操作并列,会使类别的内容规模、边界和未来扩展方式不一致。
计算覆盖率与互斥性指标
覆盖率衡量多少内容至少有一个合理归属;唯一归类率衡量已被覆盖的内容中,多少内容只有一个主分类候选。为了防止用减少归类来虚增互斥性,还需要联合检查无歧义覆盖率。
根据首轮记录计算:
| 指标 | 计算方式 | 首轮结果 |
|---|---|---|
| 覆盖率 | 26 ÷ 30 × 100% | 86.7% |
| 唯一归类率 | 20 ÷ 26 × 100% | 76.9% |
| 重复归类率 | 6 ÷ 26 × 100% | 23.1% |
| 无歧义覆盖率 | 20 ÷ 30 × 100% | 66.7% |
其中26是至少拥有一个候选类别的内容数量,20是只有一个候选类别的内容数量。重复归类率与唯一归类率使用相同分母,两者之和为100%,前提是每条已覆盖内容都被划入唯一或重复两种状态之一。
本案例将覆盖率不低于95%、唯一归类率不低于90%作为内部评审门槛。对于30条样本,覆盖率要达到95%,至少需要29条得到归类。这些门槛是项目自行设定的验收标准,不是行业统一规定。
还要检查同层类别的抽象层级。可使用三个可复核的问题:类别名称描述的是业务主题还是具体操作?同一类别能否容纳多个相关任务?是否有某个类别明显属于另一个类别的下级?例如“发票申请”与“发票与凭证”相比,前者只覆盖申请动作,后者还可容纳发票下载、抬头修改和票据查询,更适合作为一级主题分类。
修正主分类边界与抽象层级
针对首轮问题,将一级类别调整为六个业务主题:订单管理、支付结算、配送物流、售后处理、发票与凭证、账户与安全。这些名称均描述内容归属领域,而不是把单个操作与宽泛领域并列。
每篇文章必须拥有一个主分类。遇到跨主题内容时,根据用户当前要解决的核心任务选主类,再通过标签与相关文章链接提供其他查找入口。
| 内容或用户任务 | 修正后的主分类 | 边界规则 |
|---|---|---|
| 取消订单、修改订单信息 | 订单管理 | 以订单操作结果为目标 |
| 支付失败、重新付款 | 支付结算 | 以完成支付为目标 |
| 查询包裹当前位置 | 配送物流 | 以追踪物流状态为目标 |
| 包裹丢失后申请补发 | 售后处理 | 以申请补救处理为目标 |
| 查询退款到账时间 | 售后处理 | 以确认退款处理结果为目标 |
| 下载发票、修改发票抬头 | 发票与凭证 | 以获取或管理票据为目标 |
| 无法登录、修改密码 | 账户与安全 | 以恢复账户访问为目标 |
例如“退款到账时间”只归入售后处理,可以附加“退款进度”“支付渠道”标签,并从支付结算类别中的相关帮助文章建立链接。标签允许多个,主分类仍然唯一,两者不应混为一套层级。
当一个标题同时覆盖两个独立任务,例如“查询物流和申请丢件赔偿”,应检查文章是否需要拆成两篇:一篇解释物流追踪,另一篇解释赔偿申请。拆分前先确认内容确实能独立解决两个不同任务,不能仅为追求互斥率而制造重复文章。
复测分类结果并确定验收条件
修正规则后,使用原来的30条样本复测,避免通过更换困难样本来抬高结果。每条内容都应记录最终主分类、适用的边界规则,以及是否需要补充标签或相关文章入口。
本案例假设完成上述修正,并解决其余同类冲突后,示范复测结果为30条全部覆盖、30条均只有一个主分类:覆盖率达到100%,唯一归类率达到100%,无歧义覆盖率也达到100%。这些数字仅表示案例样本的复测状态,不等于证明完整内容库不存在遗漏。
为了避免评审者依赖个人理解,安排两名未参与分类修订的人员独立归类。假设30条中有2条判断不同,则一致率为28 ÷ 30,即93.3%。即使各人都只选了一个类别,这2条仍说明归属规则存在解释空间,应保留分歧记录并补充具体的主任务判定条件。
正式通过前再检查三项结果:
- 原有30条样本满足项目设定的覆盖率与唯一归类率门槛,未覆盖内容有明确处理结果。
- 六个一级类别都按业务主题划分,没有将具体动作与主题领域混放,也没有明显的上下级类别并列。
- 新增的跨域内容可以依据现有书面规则选出一个主类;无法选定时,先记录争议并修正规则,再决定是否扩展分类。
最后将修正后的类别定义、正反例和冲突裁决规则保存为分类规范。后续每次新增一批内容,都可以抽取边界样本重复这一检验;当多个新增主题持续无法归类时,再考虑调整结构,而不是立即添加一个新类别。