
多人游戏与网络同步 / 系统课时
超时重试怎样避免请求风暴
超时重试怎样避免请求风暴
网络抖动时,最危险的做法不是“失败”,而是所有客户端在同一时刻立即重试。本篇把重试当成流量控制机制:限制次数、增加退避与抖动,并在请求失去业务意义时立刻取消,从而让异常网络下的请求量可控。
学习目标
- 解释固定间隔重试为什么会放大瞬时流量
- 用指数退避、随机抖动和最大次数实现受控重试
- 为离房、请求被替代和服务端限流设置明确停止条件
先把重试当成流量控制问题
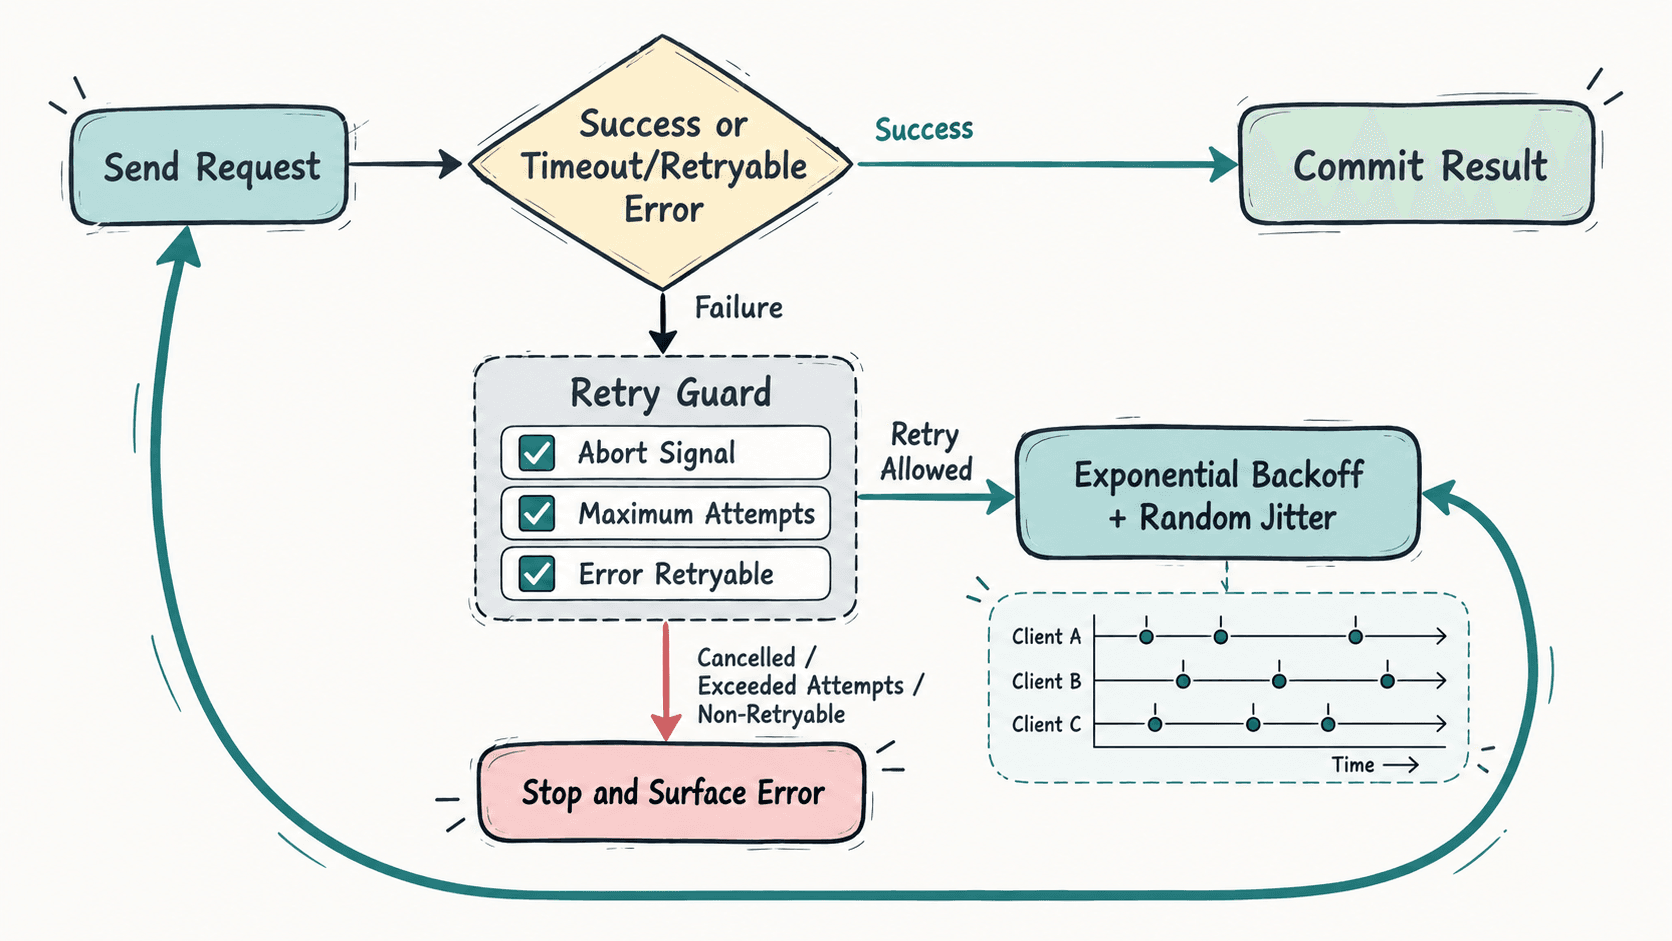
一次超时并不代表服务端没有处理请求,也不代表下一次请求会更快成功。如果 1 万个客户端都在 5 秒超时后立即重发,它们会再次同时打到服务端,形成新的峰值;峰值让响应继续变慢,又触发下一轮超时,这就是请求风暴。
可靠的客户端重试至少要同时控制三件事:总共重试几次、每次等多久、什么时候不再重试。常见策略是指数退避让等待时间逐次增长,再叠加随机抖动,让不同客户端不要在同一毫秒醒来。
用指数退避加抖动
下面的 Node.js 示例模拟前两次请求超时、第三次成功。baseDelayMs * 2 ** retryIndex 负责逐次拉开间隔,随机抖动再增加 0 到 baseDelayMs 毫秒。maxAttempts 限制总尝试次数,AbortSignal 同时用于终止退避等待和向实际请求传递取消意图。
function sleep(ms, signal) {
  return new Promise((resolve, reject) => {
    const timer = setTimeout(() => {
      signal?.removeEventListener("abort", onAbort);
      resolve();
    }, ms);

    function onAbort() {
      clearTimeout(timer);
      reject(new Error("aborted"));
    }

    if (signal?.aborted) return onAbort();
    signal?.addEventListener("abort", onAbort, { once: true });
  });
}

async function retry(operation, {
  maxAttempts = 4,
  baseDelayMs = 100,
  maxDelayMs = 2000,
  signal,
} = {}) {
  for (let attempt = 1; attempt <= maxAttempts; attempt += 1) {
    if (signal?.aborted) throw new Error("aborted");

    try {
      // 实际项目可把 signal 继续传给 fetch,使进行中的请求也能取消。
      return await operation(attempt, signal);
    } catch (error) {
      const retryable = error.message === "timeout";
      const lastAttempt = attempt === maxAttempts;

      console.log(`attempt=${attempt} failed: ${error.message}`);
      if (!retryable || lastAttempt || signal?.aborted) throw error;

      // 指数退避降低频率,jitter 把不同客户端的下一次尝试分散开。
      const retryIndex = attempt - 1;
      const backoff = Math.min(
        maxDelayMs,
        baseDelayMs * 2 ** retryIndex
      );
      const jitter = Math.floor(Math.random() * baseDelayMs);
      const delayMs = backoff + jitter;

      console.log(`sleep=${delayMs}ms`);
      await sleep(delayMs, signal);
    }
  }
}

let calls = 0;
const controller = new AbortController();

async function joinRoom() {
  calls += 1;
  if (calls < 3) throw new Error("timeout");
  return { roomId: "room-42" };
}

retry(joinRoom, {
  maxAttempts: 4,
  baseDelayMs: 100,
  signal: controller.signal,
})
  .then((result) => console.log(`result=${result.roomId}`))
.catch((error) => console.error(`final=${error.message}`));预期输出如下。<TIME> 会落在本次计算得到的延迟范围内,实际值每次运行可能不同。
attempt=1 failed: timeout
sleep=<TIME>ms
attempt=2 failed: timeout
sleep=<TIME>ms
result=room-42
这段逻辑的重点不是某个固定毫秒数,而是让失败越持续,客户端越少频繁尝试;同时用抖动把大量客户端的下一次尝试分散开。
哪些失败值得重试
重试只应覆盖短暂且可能自行恢复的失败。网络超时、连接瞬断、部分 503 通常可以进入重试判断;参数错误、权限不足、房间已关闭等业务拒绝通常不该重试,因为重复发送不会改变结果。
遇到服务端明确给出的限流或恢复时间时,应优先遵守服务端策略。例如 HTTP 429 或部分 503 响应可能携带 Retry-After,客户端应使用该时间,而不是坚持自己的更短退避间隔。对创建房间、加入房间这类会改变服务端状态的请求,还要配合幂等键或服务端去重,避免“第一次其实成功、客户端因超时又重发”产生重复副作用。
什么时候必须立即取消
即使还有剩余次数,只要原请求已经失去业务意义,就应停止。典型条件包括用户离开当前大厅、开始加入另一个房间、页面销毁、登录态失效,或更新的请求已经取代旧请求。
客户端最好让每个可取消流程持有自己的 AbortController,状态迁移时统一调用 abort()。上面的 sleep 会立即结束退避等待;如果实际 HTTP 请求也把同一个 signal 传给 fetch,进行中的请求同样可以被取消。
实际项目还可以再加两层保护:按接口设置重试预算,避免某个故障接口长期消耗请求额度;限制全局并发,避免不同功能各自“合理重试”叠加后仍把连接池和服务端压满。