
游戏策划与系统设计 / 系统课时
怎样根据测试结果迭代战斗
怎样根据测试结果迭代战斗
战斗测试的价值不在于收集“爽不爽”的评价,而是把模糊感受转成可验证的问题,再用一次小修改判断假设是否成立。本节建立从现象、假设、修改到复测的短周期流程,避免凭直觉连续改动多个参数。
学习目标
- 把主观反馈转换成可复现、可测量的战斗问题
- 用单变量修改验证问题根因,而不是同时重做整套参数
- 建立能够连续执行的测试、修改与复测闭环
把反馈改写成可验证问题
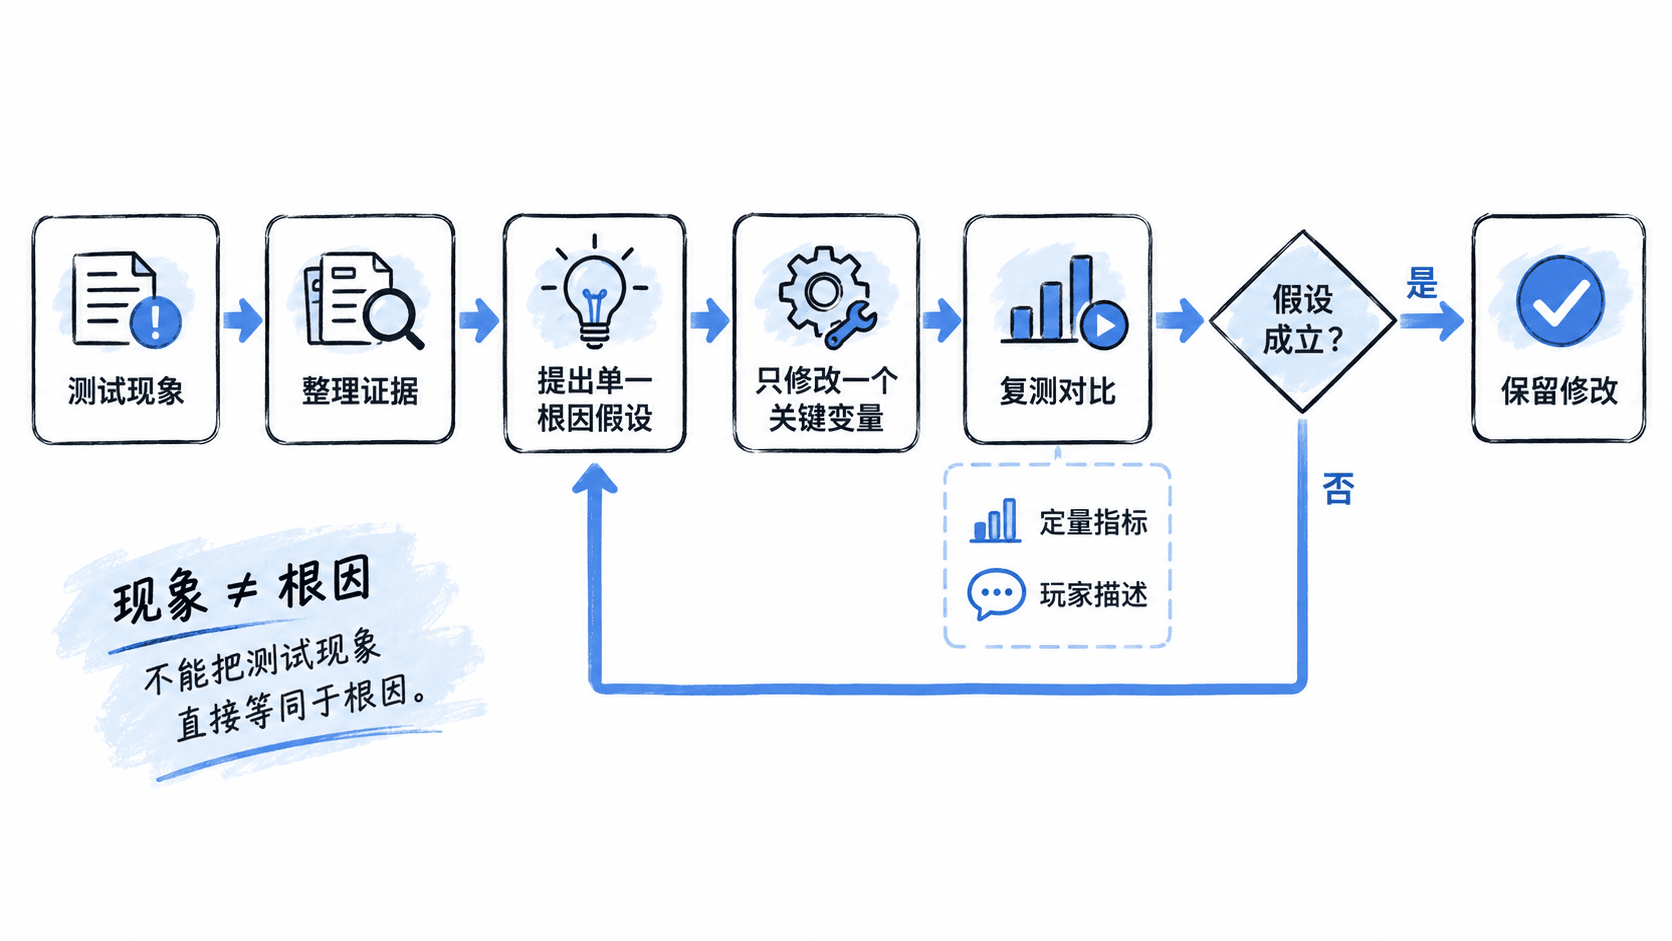
测试者说“攻击很飘”“敌人太难”“闪避不好用”时,记录到的只是现象,不是根因。设计者应先补齐发生条件:使用什么动作、面对什么敌人、在什么距离、失败发生在哪个阶段,以及这个现象出现了多少次。
例如“重攻击不好用”至少可能来自前摇过长、攻击距离不足、敌人打断频率过高或命中后的收益太低。若直接同时提高伤害、缩短前摇并增加霸体,即使体验变好,也无法知道真正解决问题的是哪一项。
用证据判断问题是否稳定存在
一次偶然失败不能直接驱动参数修改。先固定角色、敌人、装备和测试场景,再重复同一段战斗,记录能够对应假设的指标。常用指标包括命中率、受击次数、击杀耗时、资源剩余量以及某个动作被打断的比例。
下面的 Python 示例用一组固定测试数据统计平均击杀耗时和重攻击被打断比例。实际项目可以把同样逻辑接到战斗日志或表格导出数据中。
from statistics import mean

runs = [
    {"kill_time": 31.2, "heavy_attempts": 5, "heavy_interrupted": 3},
    {"kill_time": 29.8, "heavy_attempts": 4, "heavy_interrupted": 2},
    {"kill_time": 32.0, "heavy_attempts": 6, "heavy_interrupted": 4},
]

average_kill_time = mean(run["kill_time"] for run in runs)
total_attempts = sum(run["heavy_attempts"] for run in runs)
total_interrupted = sum(run["heavy_interrupted"] for run in runs)
interrupt_rate = total_interrupted / total_attempts

print(f"average_kill_time={average_kill_time:.1f}s")
print(f"heavy_interrupt_rate={interrupt_rate:.1%}")
预期输出
average_kill_time=31.0s
heavy_interrupt_rate=60.0%
如果玩家持续反馈“重攻击经常来不及出手”,同时多轮测试中的打断率都较高,就可以形成更具体的假设:问题可能不是伤害不足,而是动作暴露时间与敌人攻击节奏不匹配。
一次只改一个关键变量
验证阶段优先选择最靠近假设的变量,并保持其他条件不变。假设是“重攻击前摇过长导致频繁被打断”,第一轮可以只缩短前摇,而不要同时调整伤害、硬直、敌人攻速和资源消耗。
| 测试现象 | 根因假设 | 首轮修改 | 重点观察 |
|---|---|---|---|
| 重攻击经常被打断 | 前摇超过安全窗口 | 缩短重攻击前摇 | 打断率、使用频率 |
| 闪避后仍频繁受击 | 无敌窗口与动画节奏不匹配 | 调整无敌窗口位置 | 闪避成功率 |
| 敌人显得突然出招 | 攻击预警不足 | 延长预警阶段 | 首次受击率、识别反馈 |
| 普通攻击没有力度 | 命中反馈不足 | 调整命中停顿 | 玩家对命中清晰度的描述 |
修改量也不宜一步拉到目标极限。第一次迭代的任务是证明方向,而不是立即找到最终数值。小幅修改后如果指标明显朝预期变化,才能继续微调;如果指标不动,就应回头检查假设。
让每轮测试都有明确结论
每轮迭代开始前写下“修改什么、为什么修改、预期哪个指标变化”。复测时使用相同场景,并同时保留数据与玩家描述。数据可以证明现象是否稳定变化,描述则能发现数值之外的节奏、可读性和心理预期问题。
一个有效的短周期可以控制为:复现问题、提出一个主要假设、修改一个关键变量、使用相同场景复测、决定保留或撤销修改。连续两轮都无法支持假设时,不要继续堆参数,应重新分析问题发生的动作阶段、敌我交互或反馈链路。
战斗迭代最终要留下的是可追溯的因果关系:知道哪项修改解决了什么问题,也知道哪些尝试无效。这样后续即使继续调整数值或加入新敌人,也不会因为缺少依据而反复推翻已经验证过的设计。