
游戏叙事与剧情 / 系统课时
根据测试结果重写任务目标
根据测试结果重写任务目标
玩家测试真正有价值的产物,不是“好不好玩”的结论,而是能指向具体修改的证据。本课把观察、访谈和行为数据转成目标表达、任务路径、反馈或奖励层面的改写项,并用下一轮测试验证修改是否解决了原问题。
学习目标
- 能把模糊的体验反馈拆成可定位的任务问题
- 能判断问题应修改目标、路径、反馈还是奖励
- 能写出带证据、改动与验证指标的迭代方案
先把反馈变成可验证的问题
测试记录常见两种无效写法:“玩家觉得无聊”和“目标不够清楚”。前者没有指出发生在任务哪一段,后者也没有说明玩家究竟理解错了什么。可执行的问题描述至少要包含发生位置、玩家行为、预期行为、证据四部分。
例如,测试者接到“找到失踪的侦察兵”后在营地搜索了 4 分钟,却没有离开起始区域。访谈中 3 人都认为侦察兵“应该还在营地附近”。这说明问题不是单纯的移动速度,而是任务目标没有给出足以引导行动方向的信息。
用四个层面定位该改哪里
同一个“玩家卡住”现象,可能来自不同设计层。目标表达负责让玩家知道要做什么;路径负责提供可执行的行动方向;反馈负责确认玩家是否走对;奖励负责解释为什么值得继续。
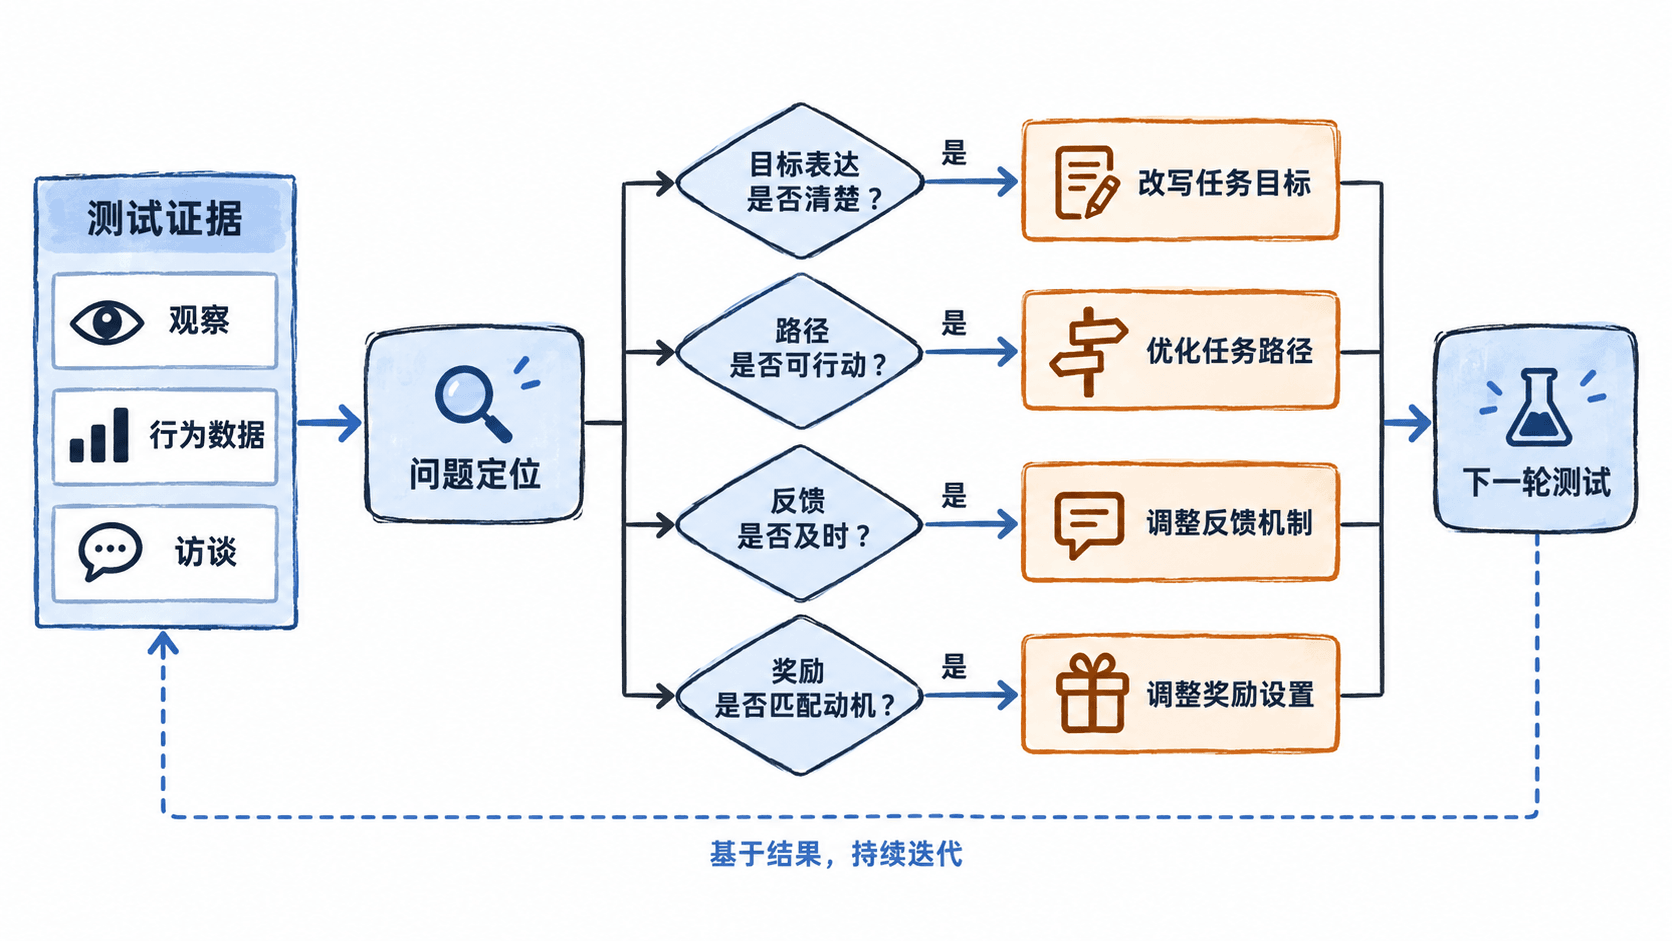
判断时优先修改离根因最近的层,不要一次把四层全部推翻。目标已经清楚但玩家不知道去哪,就补路径线索;玩家走对却没有确认感,就补即时反馈;玩家明白任务也能完成,却频繁中途放弃,再检查奖励与动机是否匹配。
把问题写成迭代单
一条迭代项应让策划、程序、测试都能直接执行。下面的数据结构示例把证据、修改和复测条件放在一起,适合录入需求系统或版本评审文档。
{
  "issue": "玩家误以为侦察兵仍在营地附近",
  "evidence": {
    "playersAffected": "3/5",
    "observedBehavior": "接任务后在营地内搜索超过 4 分钟"
  },
  "rootLayer": "goal",
  "change": "将目标改为“沿北门外的车辙寻找失踪的侦察兵”",
  "supportingFeedback": "北门出口出现短暂方向提示",
  "successMetric": "下一轮至少 4/5 玩家在 60 秒内离开营地"
}这不是运行代码,而是迭代单的数据结构示例。它的验证方法很直接:把修改后的任务交给新的测试者,记录是否达到 successMetric,并检查是否引入新的误导。
重写目标时保留玩家决策空间
目标改写不是把答案直接告诉玩家。好的任务目标提供“行动边界”,而不是替玩家完成推理。例如“去北门外找侦察兵”比“在坐标 X=42、Y=18 点击倒下的侦察兵”保留了更多探索空间。
重写前后的差异应能回答三个问题:玩家现在是否知道要做什么,是否知道从哪里开始行动,是否仍需要自己判断如何完成。只要第三个问题变成“完全不需要判断”,通常说明引导过度。
用单变量复测确认因果
一次改动太多,会让你无法知道究竟哪项修改有效。若核心问题是目标措辞,先只改目标和最低限度的配套反馈,保持敌人数量、路线长度和奖励不变。
复测时同时看行为与主观反馈。行为指标可以是首次正确行动时间、错误路径次数、放弃率;主观问题则聚焦“你为什么往这个方向走”“你当时认为任务要你做什么”。两者一致时,才更有把握认为改写命中了根因。
最终的迭代方案应形成完整闭环:测试证据指向问题,问题映射到具体设计层,修改项改变可观察行为,再由下一轮数据确认结果。这样重写任务目标才不是凭感觉润色,而是一次可验证的设计决策。