
游戏叙事与剧情 / 系统课时
复杂分支怎样做回归测试
复杂分支怎样做回归测试
复杂分支最怕“修好一条线,弄坏另一条线”。这一课把剧情回归测试拆成关键路径、状态组合和边界条件三层,并用一个可执行的小型测试器验证:修改条件、奖励或结局规则后,原有路线是否仍满足设计约束。
学习目标
- 为非线性剧情挑出必须长期稳定的关键路径与断言
- 用等价类和边界值压缩状态组合,而不是穷举所有变量
- 建立可重复执行的自动化回归检查,并定位失败发生在哪个节点
先把“剧情正确”改写成可验证条件
剧情测试不是确认“文本读起来不错”,而是确认一组结构规则没有被破坏。对每条关键路径,都要写清起点状态、玩家选择、预期节点和最终状态。
例如一条“帮助守卫后进入城堡”的路径,可以定义三个断言:选择 help_guard 后信誉至少增加 1;信誉达到 2 时才能进入 castle_gate;没有钥匙时不得直接抵达 treasury。这些断言比“正常走一遍”更稳定,因为修改对白不会影响它们,而条件逻辑变更会立刻暴露。
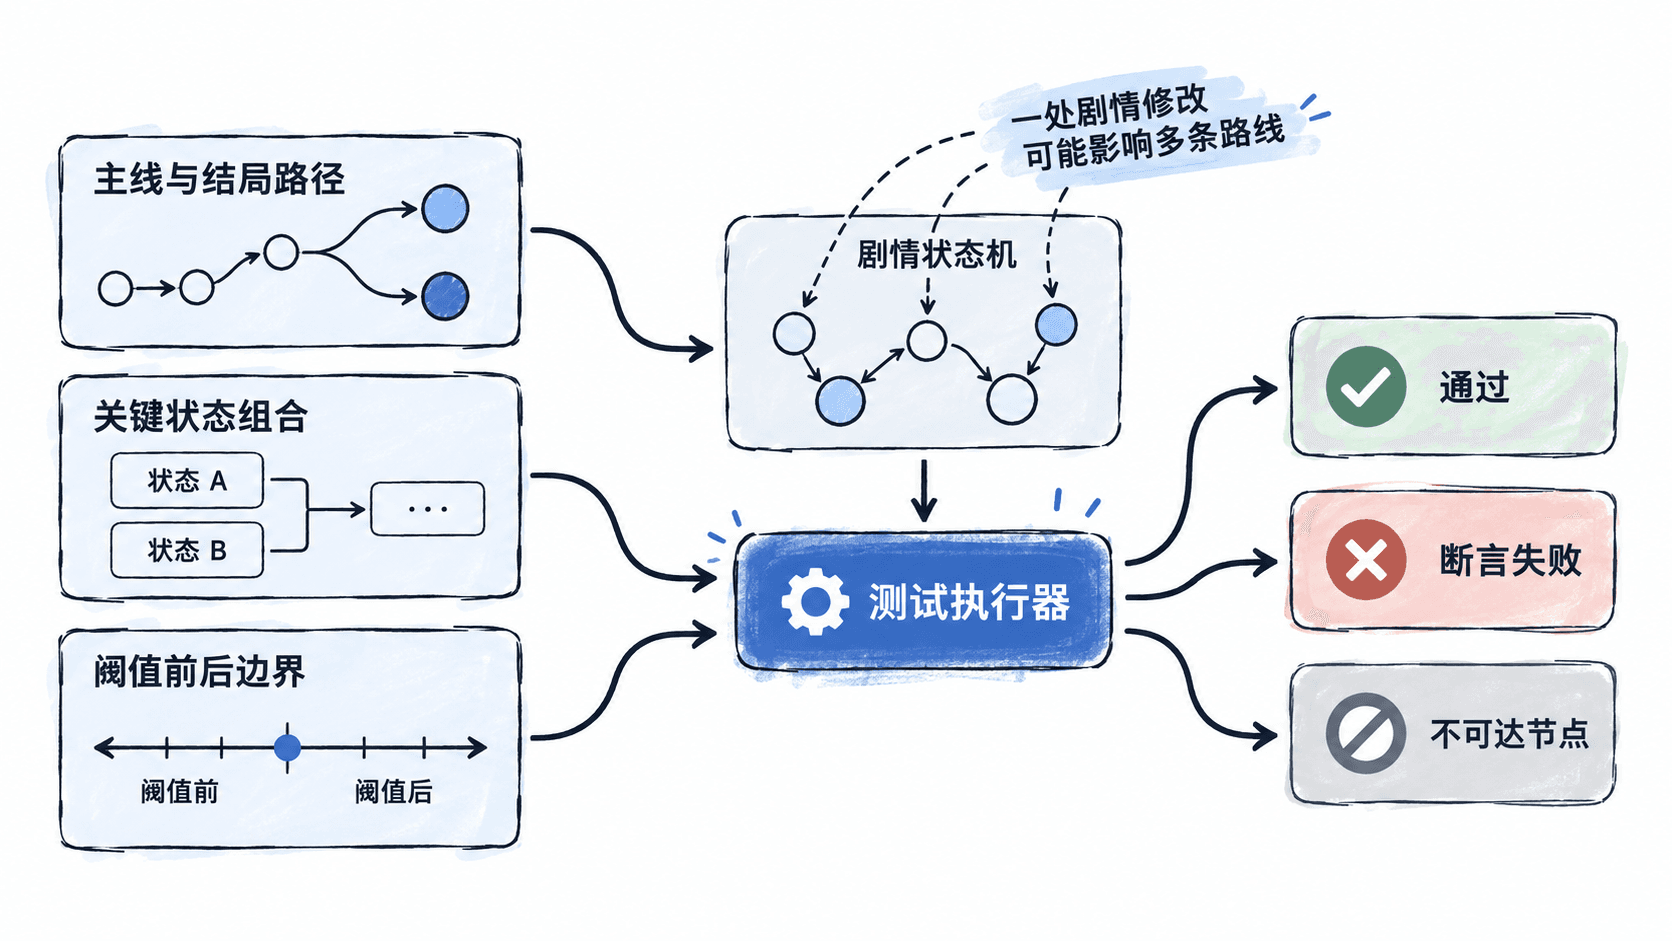
回归集合优先覆盖四类路线:主线必经路径、重要结局路径、曾经出过问题的路径,以及多条件交汇的高风险路径。低价值的装饰分支可以留给人工抽查,不必让测试规模失控。
用代表性组合代替状态穷举
假设剧情有 trust、has_key、alarm 三个状态。它们组合后很快会膨胀,所以不要测试所有整数值,而应按规则切成等价类。
如果城门条件是 trust >= 2,真正值得保留的是阈值附近的 1、2、3;如果宝库条件是 has_key == true and alarm == false,则至少覆盖“有钥匙且未警报”“无钥匙”“已警报”三类。这样测试的是条件边界,而不是随机状态。
建一个最小可执行回归器
下面用 Python 表示三个剧情节点,并对关键路径执行断言。示例只关注结构逻辑,不涉及对白内容。
from dataclasses import dataclass, replace

@dataclass(frozen=True)
class State:
    trust: int = 0
    has_key: bool = False
    alarm: bool = False

def step(node: str, choice: str, state: State) -> tuple[str, State]:
    if node == "square" and choice == "help_guard":
        return "castle_gate", replace(state, trust=state.trust + 1)

    if node == "castle_gate" and choice == "enter":
        if state.trust >= 2:
            return "hall", state
        return "square", state

    if node == "hall" and choice == "open_treasury":
        if state.has_key and not state.alarm:
            return "treasury", state
        return "hall", state

    raise ValueError(f"unsupported transition: {node=} {choice=}")

def test_regression() -> None:
    # 边界:trust=1 时帮助守卫后恰好达到门槛 2。
    node, state = step("square", "help_guard", State(trust=1))
    assert node == "castle_gate"
    assert state.trust == 2

    node, state = step(node, "enter", state)
    assert node == "hall"

    # 关键限制:没有钥匙时不得进入宝库。
    node, _ = step("hall", "open_treasury", State(trust=2, has_key=False))
    assert node == "hall"

    print("3 regression assertions passed")

if __name__ == "__main__":
    test_regression()
预期输出
3 regression assertions passed这个测试器的重点不是代码量,而是把剧情规则变成稳定断言。项目中可以进一步把节点、条件和效果放进数据文件,再由同一个测试框架读取,避免每次新增分支都手写执行逻辑。
修改后按影响面选择回归范围
一次改动不必总跑全部剧情。先判断它改了什么,再决定回归集合。
修改单句对白时,通常只需人工检查显示和上下文;修改节点出口时,要回归所有经过该节点的关键路径;修改全局状态含义时,要回归所有读取该状态的条件;修改结局判定时,则必须覆盖结局前的主要状态组合和阈值边界。
排查失败时优先记录“起始状态、选择序列、首次偏离节点、实际状态、预期状态”。不要只记最终结局不对,因为真正的断点往往发生在更早的位置。
把边界条件留在测试集中
最容易被后续修改破坏的通常不是正常路径,而是阈值和互斥条件。例如 trust >= 2 被误改成 trust > 2,主线高信誉玩家可能仍能通过,只有恰好等于 2 的玩家会被卡住。
因此,每个数值门槛至少保留“门槛前、门槛值、门槛后”三个样本;每个布尔组合至少覆盖允许与拒绝两侧;每个一次性事件要验证重复触发不会再次发奖励或推进状态。做到这些,剧情回归测试才真正能保护复杂分支,而不是重复试玩已经最熟悉的那条路线。