
游戏叙事与剧情 / 系统课时
避免好感度变成刷分机制
避免好感度变成刷分机制
当玩家发现“每天送同一种礼物最快”“反复对话就能堆满好感”时,关系系统就从角色互动退化成了效率计算。本节从好感来源、重复行为和奖励频率三个角度检查数值规则,并给出限制机械刷取、保留玩家选择空间的设计方法。
学习目标
- 判断一个好感系统是否正在鼓励单一行为反复刷取
- 用来源结构、重复衰减和奖励节奏降低最优刷分路线
- 在限制刷取的同时保留正常互动的正反馈
先找出玩家为什么会刷
刷分通常不是玩家“玩错了”,而是系统给出了过于明确的最优解。假设送普通礼物每次增加 5 点好感,每天可以无限送;剧情选择一次增加 15 点,却只能触发一次。理性玩家很快会发现,与其等待剧情,不如连续送礼。
检查时先记录每一种好感来源的三个属性:单次收益、可重复次数、触发成本。真正危险的往往不是“单次加得多”,而是单位时间收益高、几乎没有限制,并且可以稳定重复。
| 来源 | 单次变化 | 重复性 | 主要风险 |
|---|---|---|---|
| 剧情选择 | +10~+20 | 低 | 通常较低 |
| 日常对话 | +1~+3 | 高 | 容易机械点击 |
| 赠送礼物 | +3~+10 | 高 | 容易寻找最高性价比礼物 |
| 完成委托 | +5~+15 | 中 | 可能演变成任务刷取 |
| 关键行为事件 | 正负皆可 | 低 | 更适合承载关系转折 |
如果某一种高重复来源长期贡献了绝大多数好感,那么玩家体验到的就不是“建立关系”,而是在执行固定兑换公式。
打断单一行为的无限收益
最直接的方法不是彻底禁止重复行为,而是让重复行为的边际收益下降。比如角色第一次收到喜欢的礼物增加 8 点,短时间内第二次只增加 3 点,继续重复则不再增加。这样仍然认可玩家的行为,却不会让同一个动作无限占优。
可以把规则理解为三层控制:先判断行为是否有资格产生变化,再根据近期重复次数调整收益,最后检查当天或当前阶段是否达到该来源的有效上限。
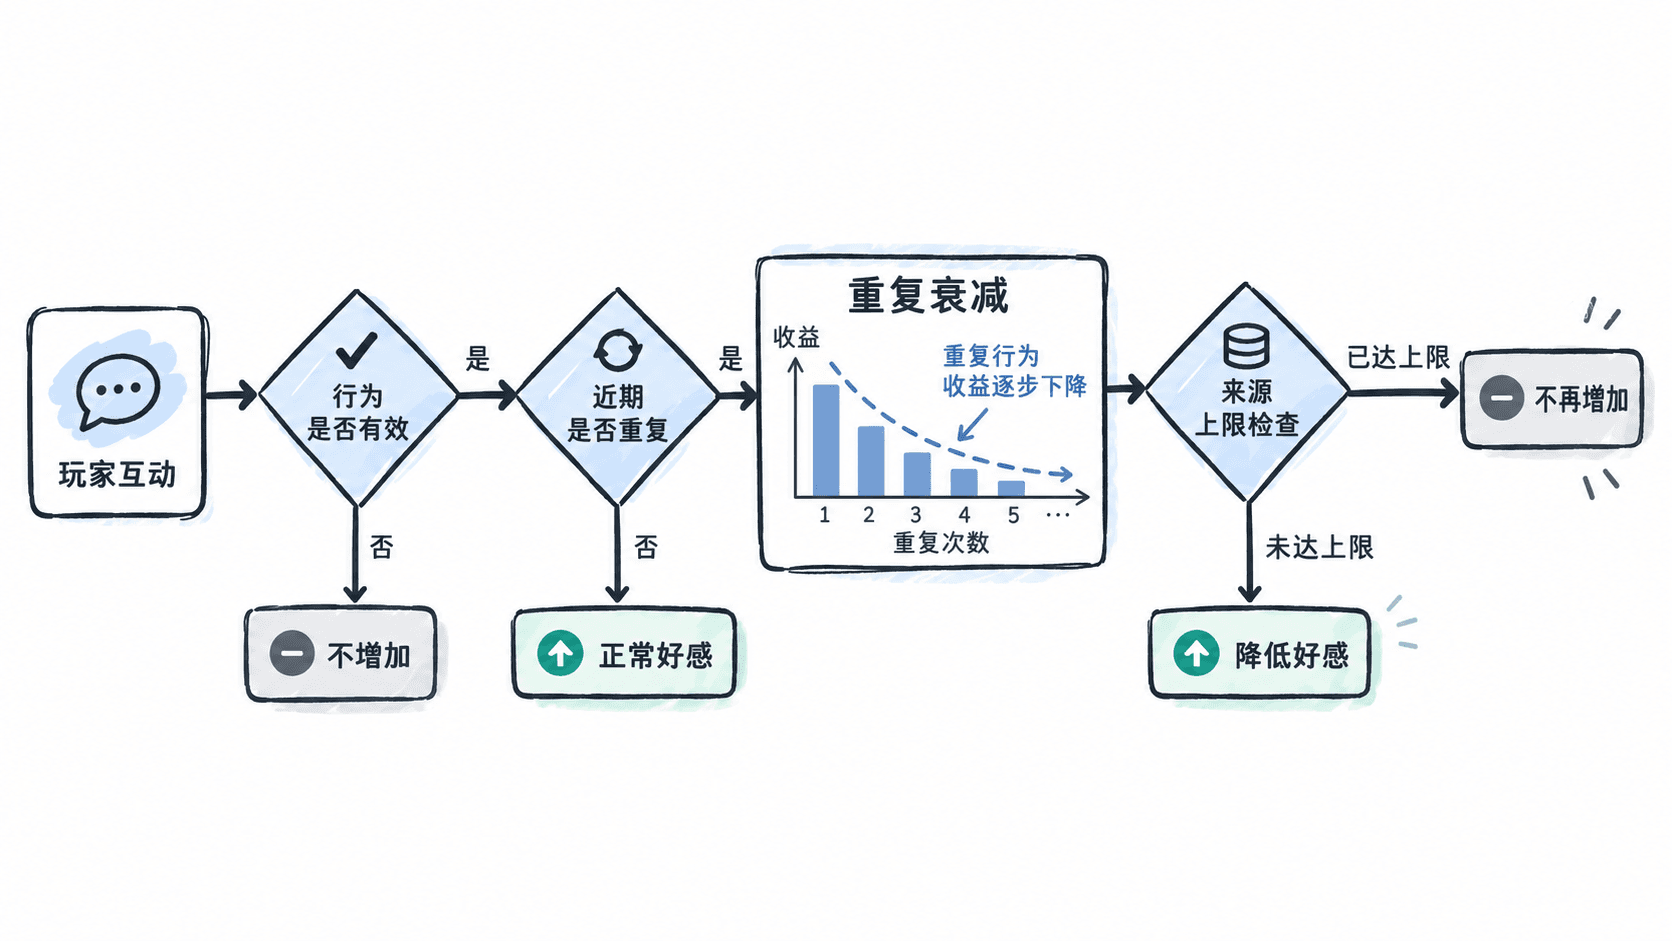
例如,一名角色每天第一次普通聊天获得 2 点,第二次获得 1 点,此后不再增加;但玩家仍然可以继续对话获取剧情信息。这样限制的是数值收益,而不是把互动本身锁死。
控制奖励频率而不是只压低数值
另一个常见问题是把每次互动都立即兑换成好感。玩家按一次对话、完成一个小动作、送一个廉价物品,都能看到数字上涨,于是系统不断训练玩家追求“更多触发次数”。
可以把低价值行为改成条件积累。例如连续几次正常交流只记录“近期互动积极”,达到一个有意义的情境后再改变关系;关键选择、帮助角色解决问题、违背承诺等高信息量事件,则可以直接产生较明显的关系变化。
这样一来,好感变化的频率会下降,但每次变化更容易被玩家理解为“角色为什么改变了对我的态度”。数值不再是所有行为的即时返现,而是关系状态的结果。
用来源占比检查系统是否失衡
测试阶段不要只看“多久能升满”,还要观察不同来源贡献了多少好感。假设一次完整游玩中,某角色累计获得 300 点正向变化,其中 240 点来自重复送礼,那么即使总成长速度符合预期,来源结构依然已经失衡。
一个实用的检查方法是让测试者自由游玩,然后统计高频行为。如果多数玩家无需理解角色、无需做选择,只靠一种低成本重复操作就能稳定推进关系,就应该优先调整该来源的次数、衰减或触发条件,而不是简单把全部好感需求从 500 提高到 1000。
提高总需求只会让玩家刷得更久;真正有效的设计,是让不同关系阶段需要不同类型的互动,并让关键关系变化来自具有情境意义的行为。玩家最终应该记住“我做了什么让这个角色改变”,而不是“我刷了多少次”。