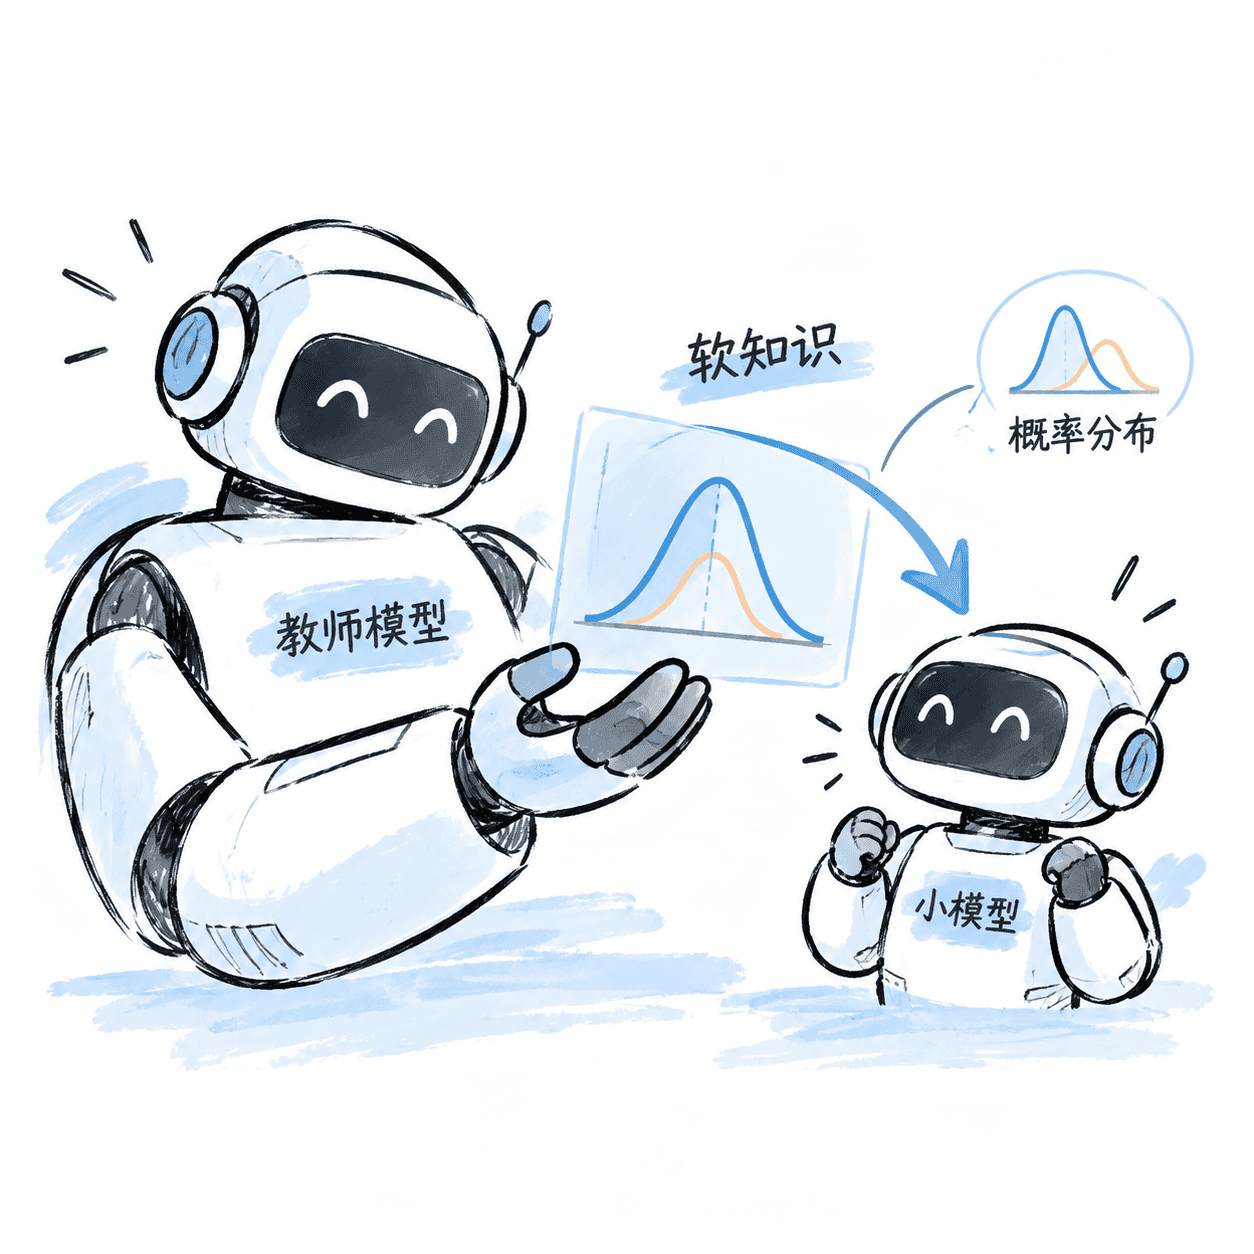
微调和 RAG 到底该怎么选
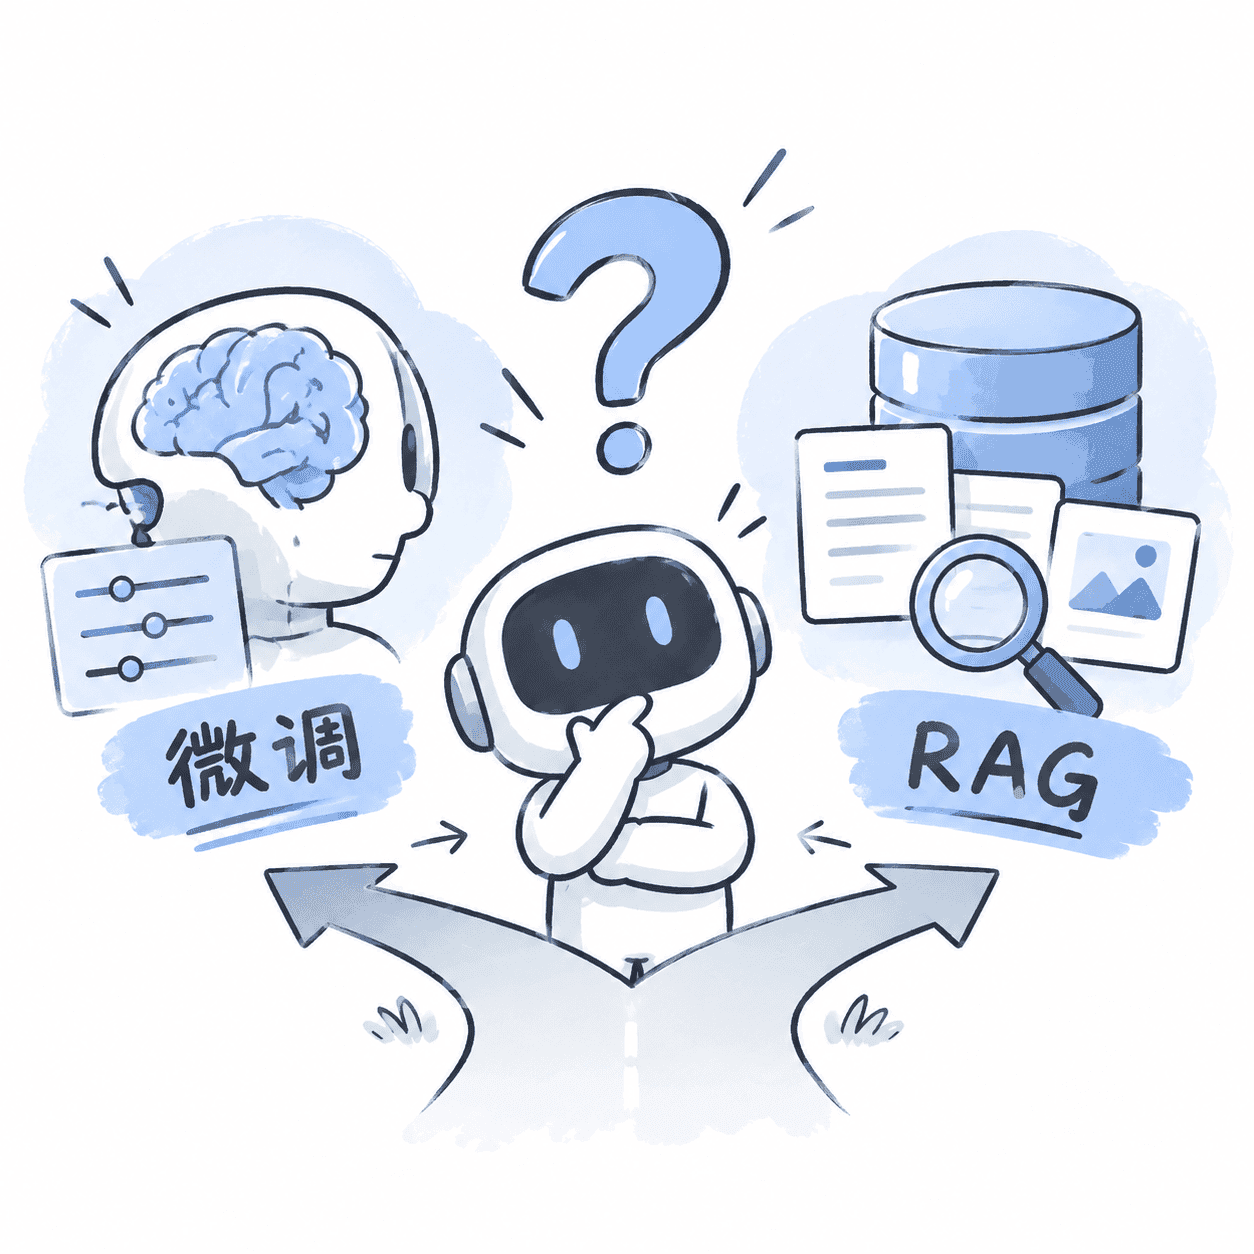
企业知识问答、垂直助手和专用模型常在微调与 RAG 之间反复权衡。理解两种方案分别改变模型行为还是补充外部知识,并比较时效性、可追溯性、成本与维护方式后,就能判断该单独使用哪一种,以及什么时候值得组合使用。
技术文章 · 技术实践
TOPIC / 技术方向
一个方向,串起完整学习路径。
企业知识问答、垂直助手和专用模型常在微调与 RAG 之间反复权衡。理解两种方案分别改变模型行为还是补充外部知识,并比较时效性、可追溯性、成本与维护方式后,就能判断该单独使用哪一种,以及什么时候值得组合使用。
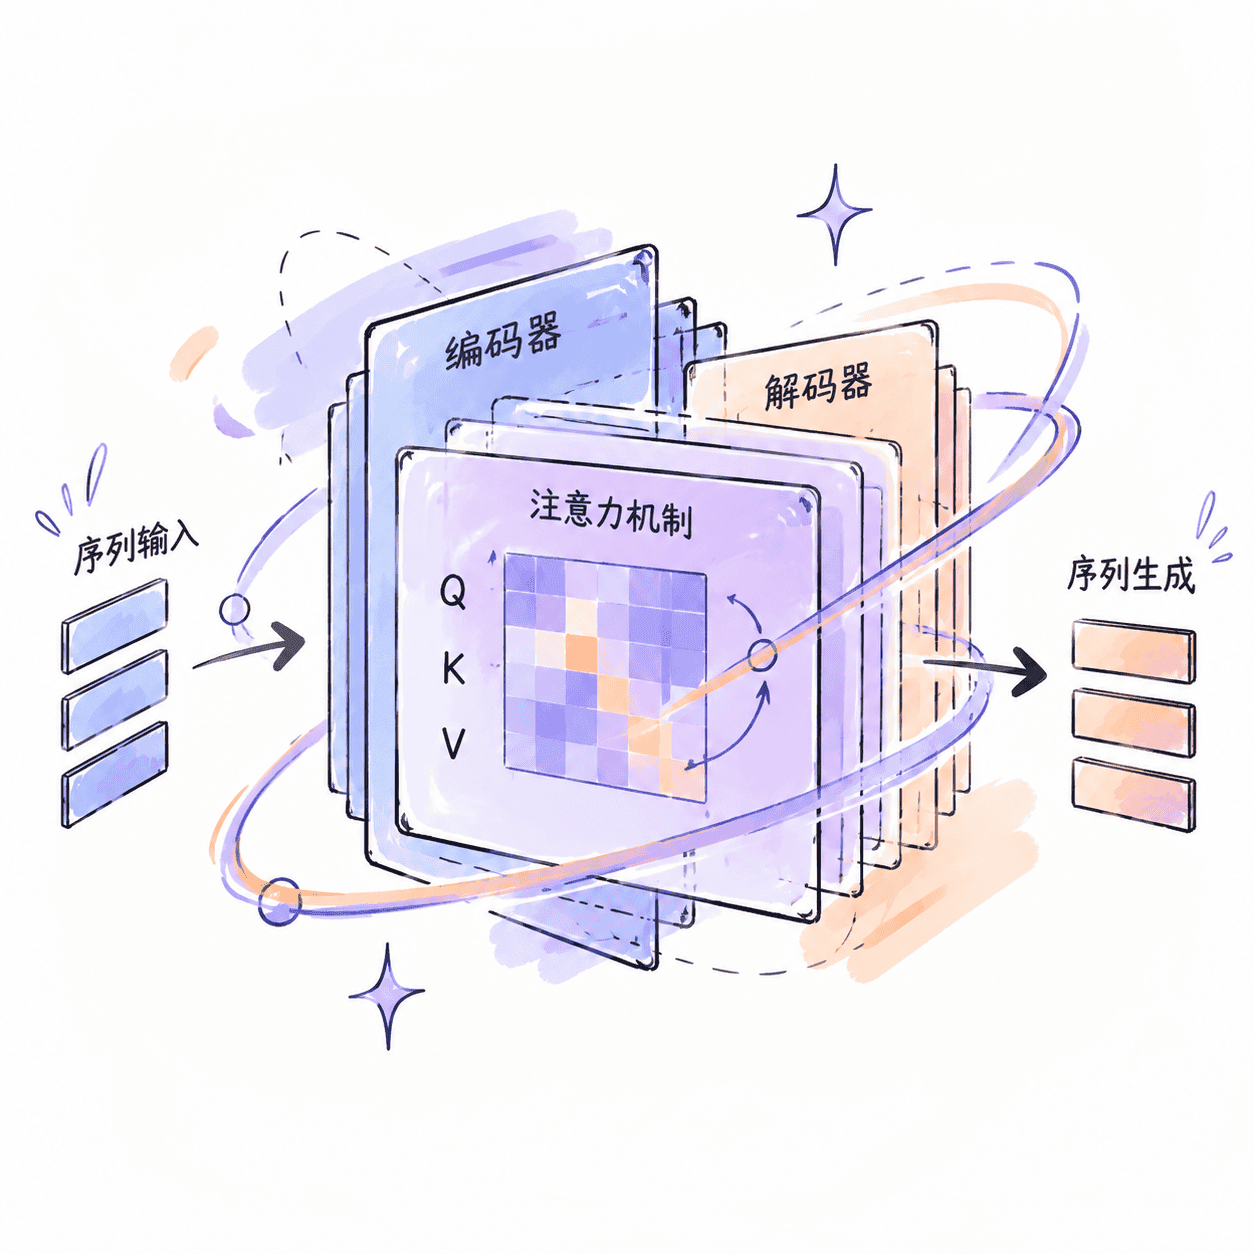
本课程面向具备 Python、线性代数和基础深度学习知识的开发者,从序列建模问题出发,逐步讲解注意力机制、位置编码、编码器与解码器结构、训练优化和生成策略。课程结合 PyTorch 手写实现、预训练模型微调、评估部署与故障排查,帮助学习者建立从数学原理到工程落地的完整知识体系。
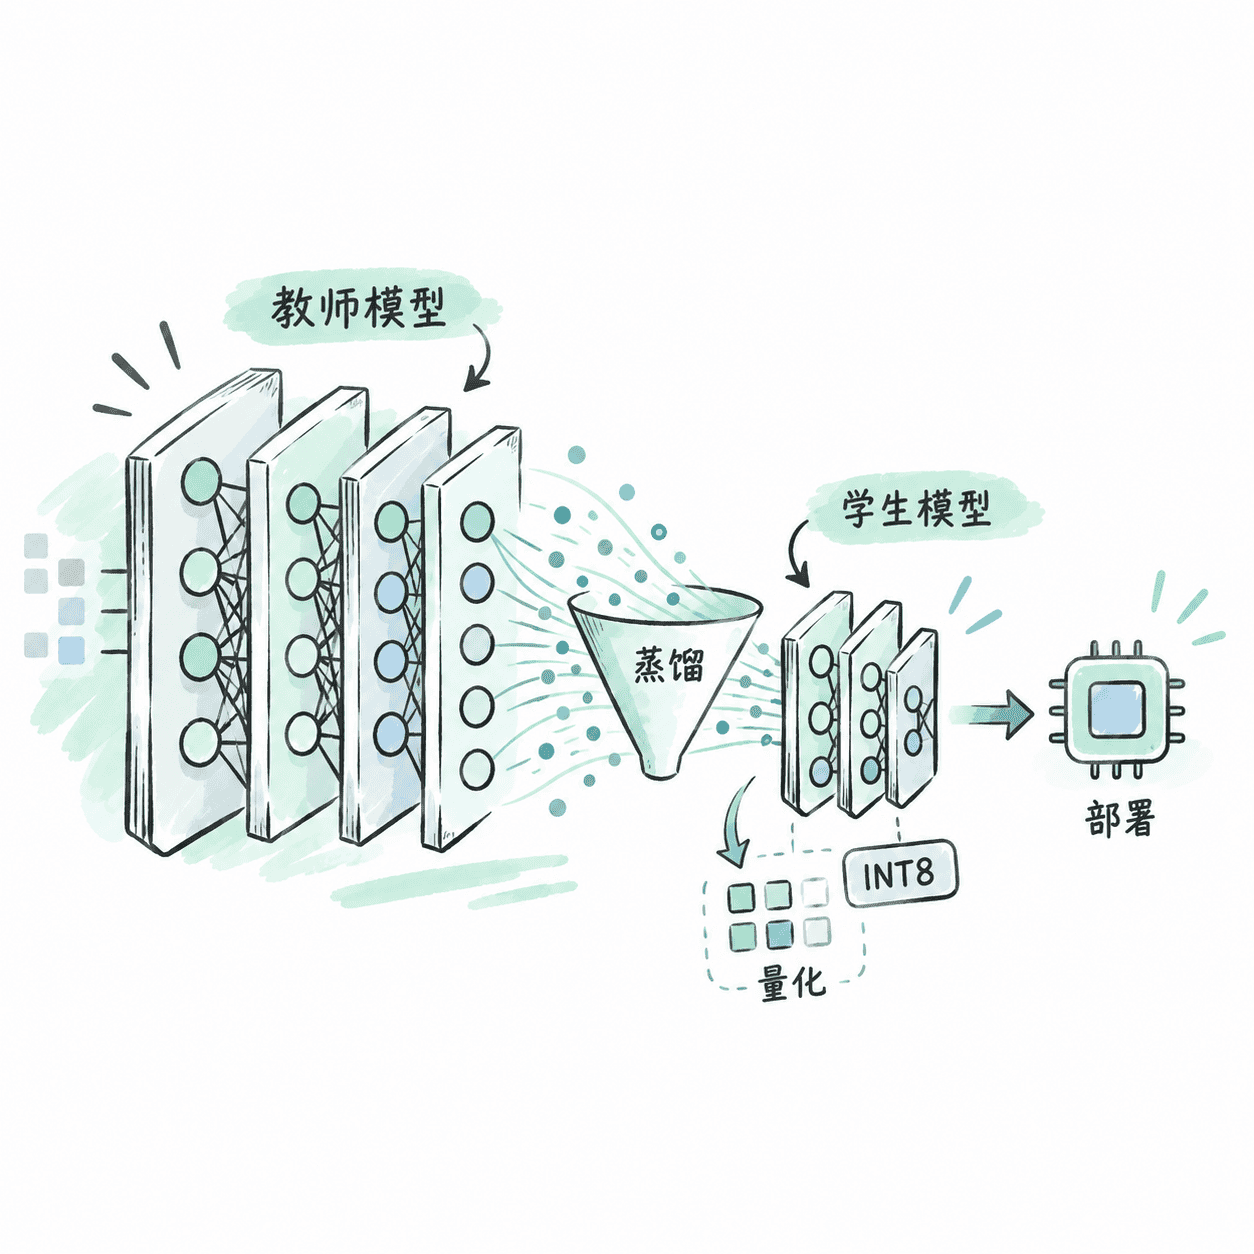
大模型效果达标后,显存、延迟和成本常成为上线瓶颈。课程以 PyTorch 2.x、Transformers 4.x 为基线,覆盖蒸馏、INT8/INT4、GPTQ/AWQ、QAT 与 vLLM/GGUF 部署,完成压缩训练、量化和基准验收。
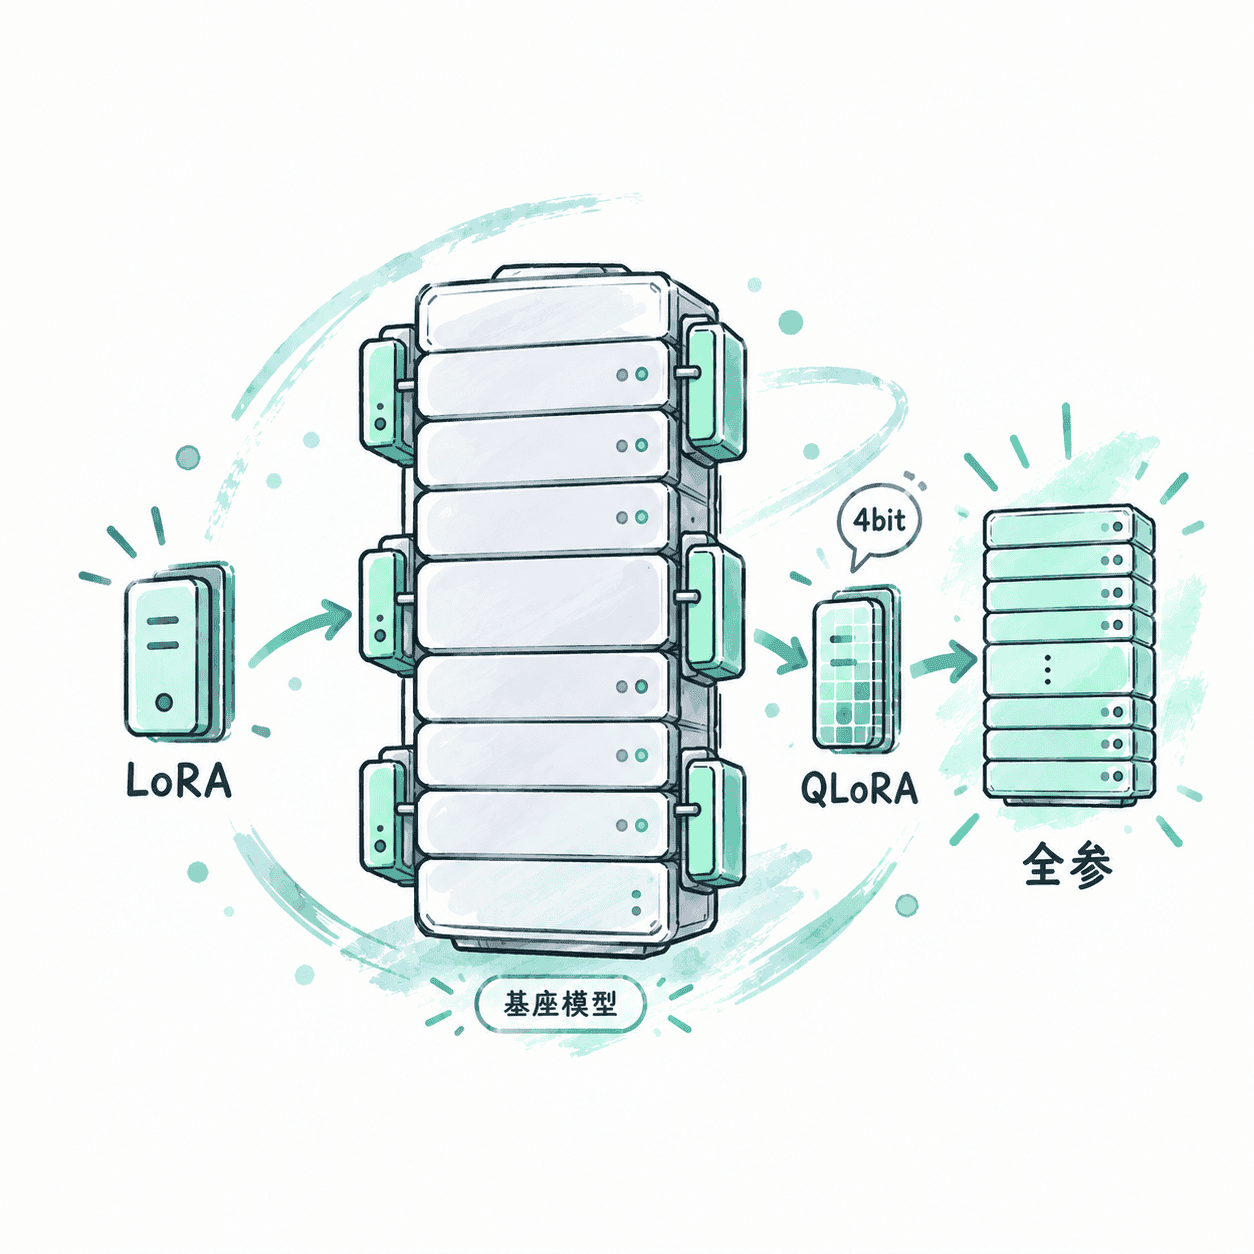
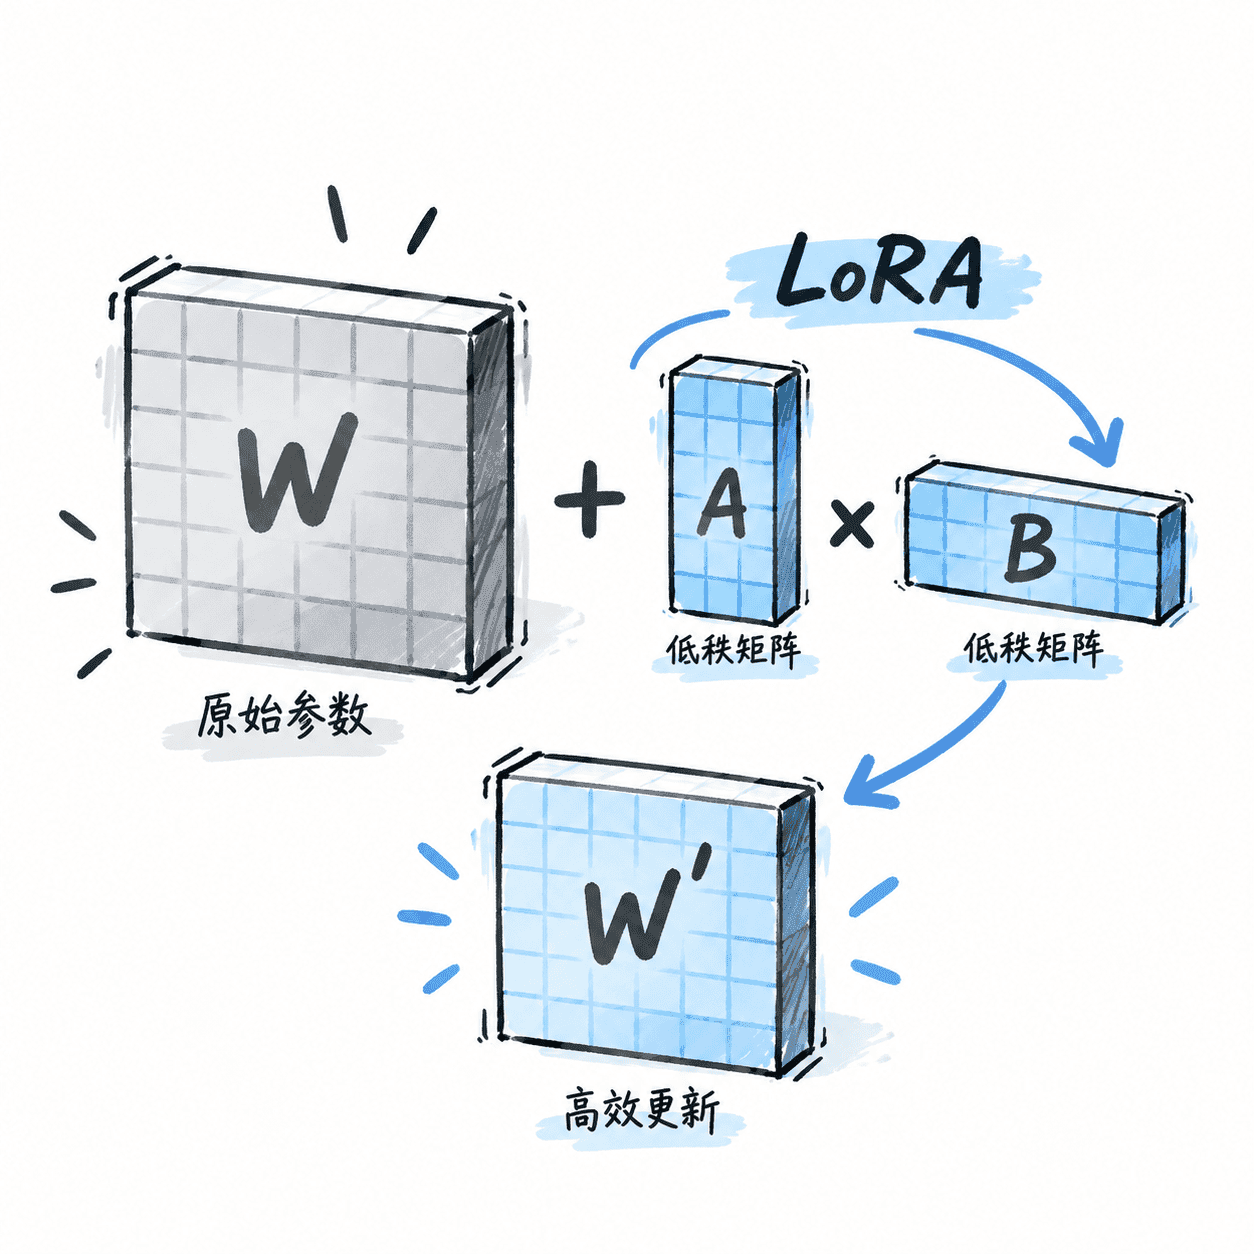
大模型微调常受显存、数据质量和训练稳定性限制。课程采用 Transformers 5.x、PEFT 0.20+ 与 TRL 1.x,完成 LoRA、QLoRA 和全参数训练,对比质量、速度与资源成本,并交付可复现的最佳模型。
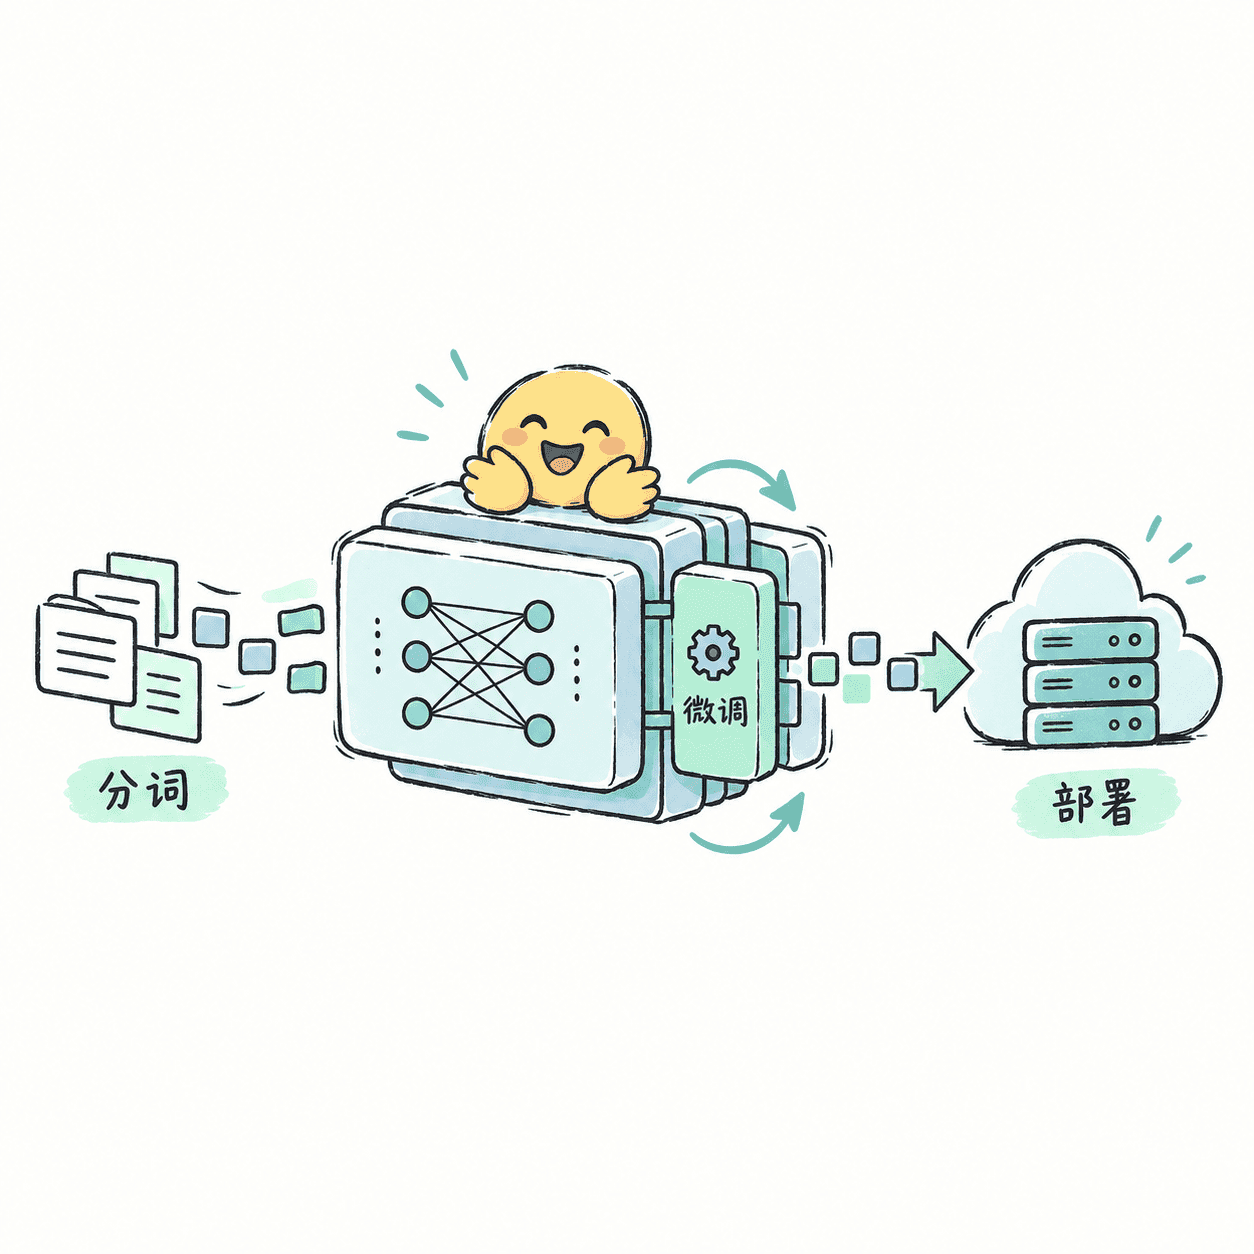
模型能在 Notebook 里跑起来,并不等于能稳定训练和上线。课程以文本与生成模型为主线,覆盖 Hub 与 Auto API、Tokenizer、Datasets、Trainer、PEFT/LoRA、量化、评估和服务部署,把公开预训练模型变成可复现、可微调、可压测并能上线交付的模型服务。
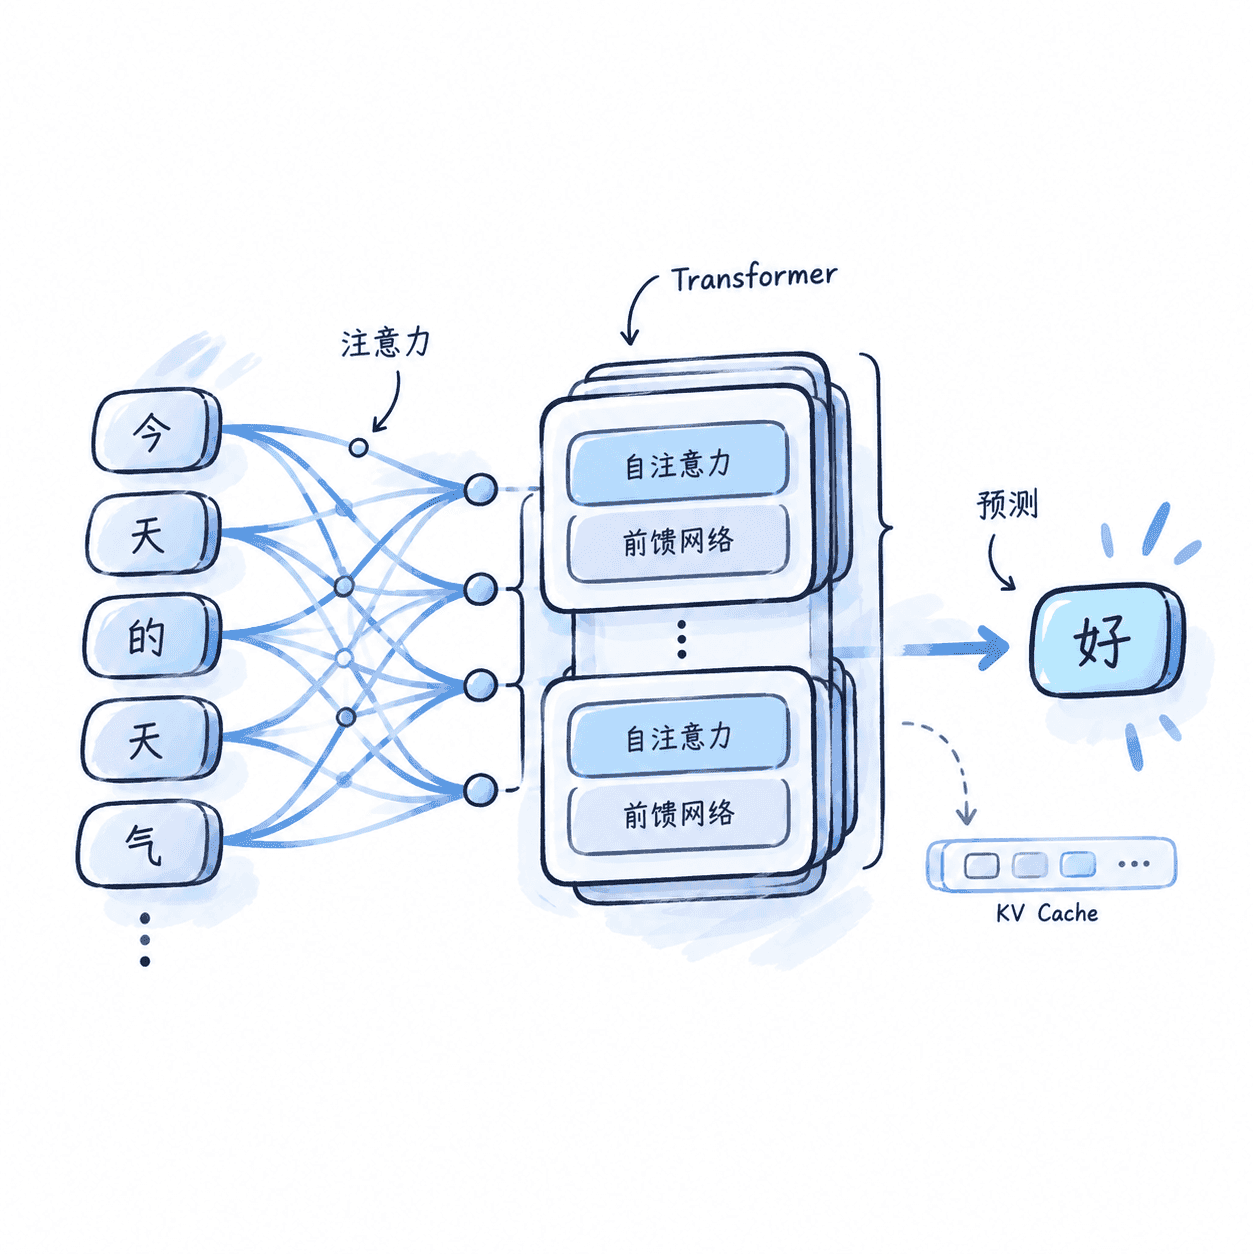
调用大模型不难,难的是解释模型为何这样生成。内容从词元和注意力出发,拆解 Transformer、GPT 自回归目标、预训练、对齐与 KV Cache,并用微型 GPT 复现链路,使学习者能从张量和概率分布解释模型行为,判断训练与推理取舍。
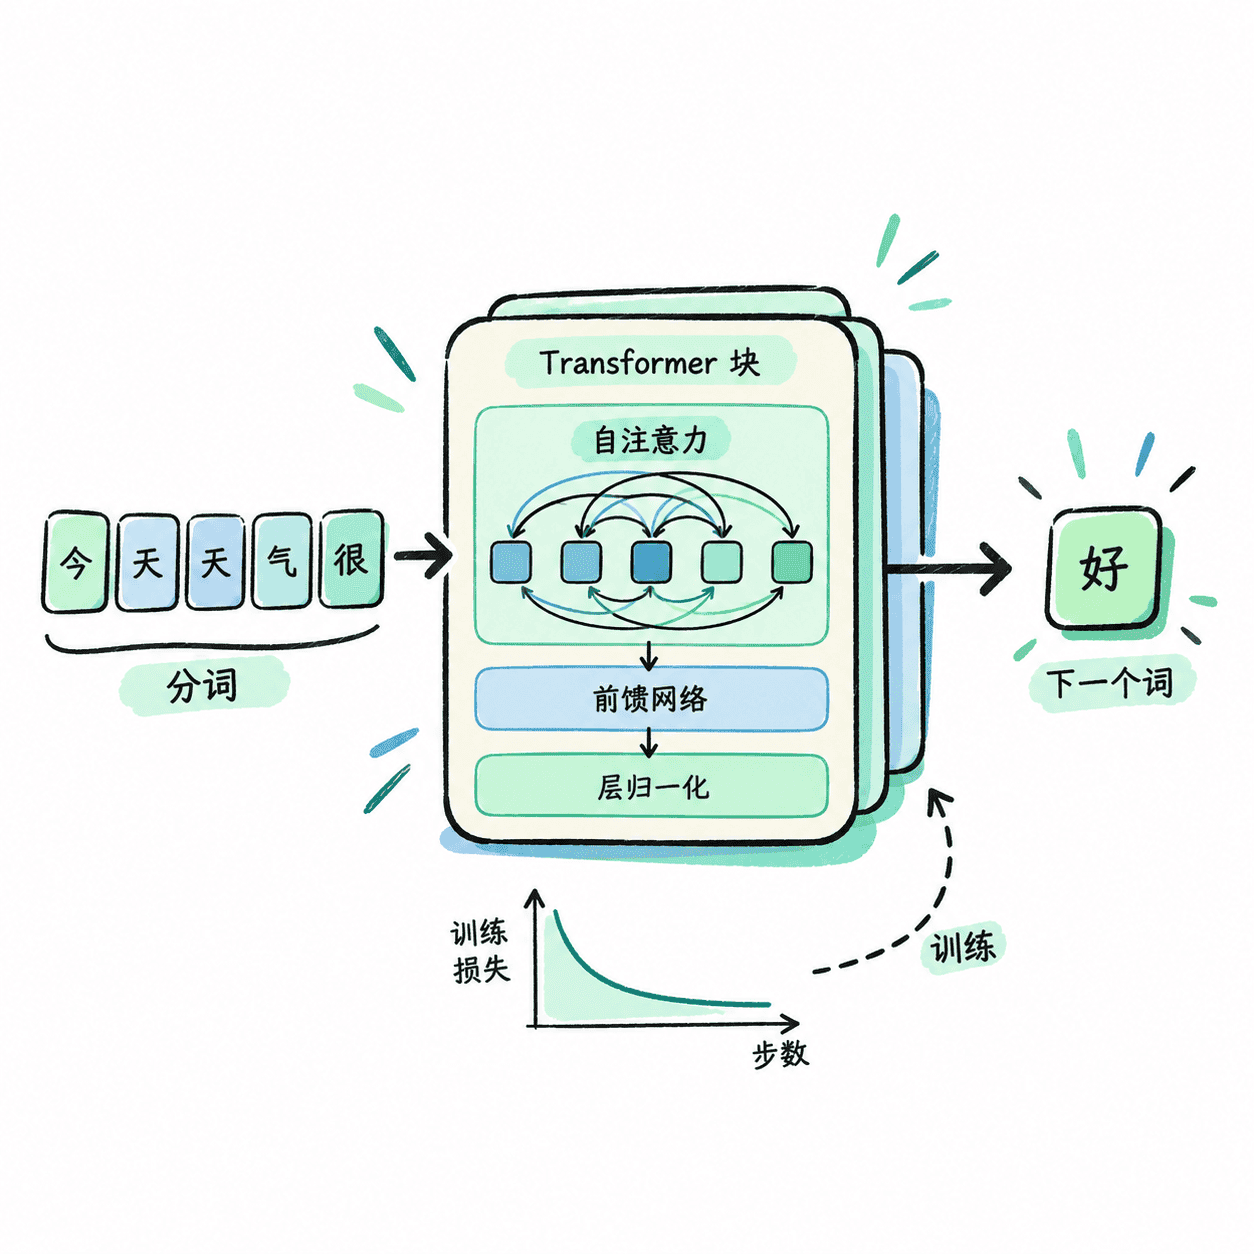
直接调用大模型 API 很难解释注意力、损失与训练稳定性为何这样工作。课程沿 nanoGPT 的极简路线,从数据编码、自注意力和 Transformer Block 开始亲手组装 GPT,再补齐训练循环、混合精度、多卡训练、检查点、GPT-2 权重加载与采样,最终能独立训练、评估和排查一个小型语言模型。
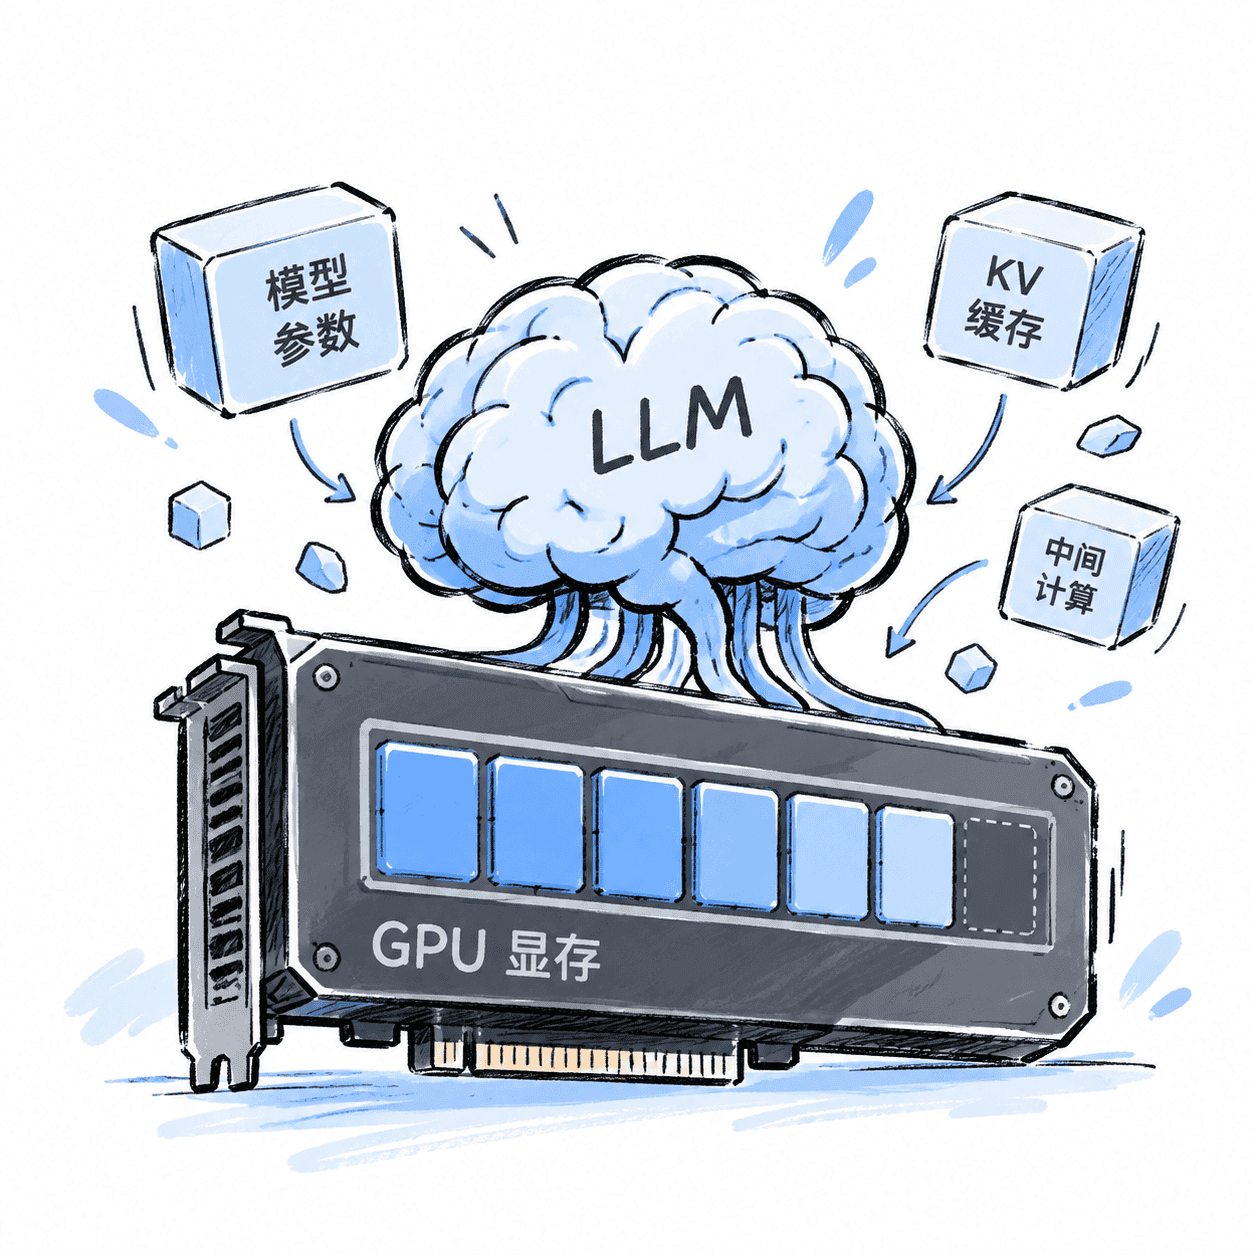
大模型上线后,显存、首 Token 延迟、吞吐和多卡通信直接决定成本与体验。课程覆盖显存估算、量化、KV Cache、连续批处理、主流推理引擎、多卡多机、压测与 Kubernetes 部署,学完能完成容量评估、引擎选型和生产调优。