
Redis 与缓存 / 知识点
Redis 开发常用命令速查
地理与近似统计
BF.EXISTS key item查询某成员是否可能已加入 Bloom 过滤器,适合减少后端数据库无效查询;返回否可视为确定不存在,返回是仍需进一步核实。
检查布隆过滤器成员
需要在查询数据库前快速筛除未登记的用户 ID、资源 ID 或其他成员标识时,使用 `BF.EXISTS` 检查 Bloom 过滤器。命令只判断成员是否可能已加入过滤器,不读取原始对象,也不能直接证明数据库中的记录存在。
基本语法
BF.EXISTS key item- `key`:Bloom 过滤器的 Redis 键名,例如 `demo:bloom:seen`。查询操作不会自动创建过滤器。
- `item`:待检查成员,例如 `user:42`。必须与写入时使用的成员标识保持一致,包括大小写、前缀和编码方式。
命令需要 Redis 实例支持 Bloom 功能,例如提供 RedisBloom 能力的部署。它属于只读操作,单次查询的时间复杂度为 ,其中 是相关子过滤器使用的哈希函数数量。
可验证示例
在已启用 Bloom 功能的测试实例上,选择一个尚不存在的专用测试键,先查询、再插入、最后复查。以下命令使用 `redis-cli --raw` 固定输出格式,避免不同终端对整数结果的展示差异。
# 使用尚不存在的测试键,先检查未加入的成员
redis-cli --raw BF.EXISTS demo:bloom:check:81 user:42

# BF.ADD 在键不存在时自动创建过滤器并加入成员
redis-cli --raw BF.ADD demo:bloom:check:81 user:42
redis-cli --raw BF.EXISTS demo:bloom:check:81 user:42
预期输出(假设测试键原先不存在):
0
1
1
第一行 `0` 表示当前过滤器中没有该成员,第二行 `1` 表示本次 `BF.ADD` 将成员判定为新加入,第三行 `1` 表示再次查询时该成员可能存在。
对于已经建立的业务过滤器,可以直接执行元数据中的命令 `BF.EXISTS demo:bloom:seen user:42`,无需先执行 `BF.ADD`。实际返回值取决于过滤器当前内容。
返回值与业务判断
| 返回值 | 含义 | 建议处理 |
|---|---|---|
| `0` | 成员确定不在当前过滤器中,也可能是过滤器键不存在等情况 | 确认过滤器已正确构建且数据同步完整后,可以跳过不必要的数据库查询 |
| `1` | 成员可能已加入过滤器,存在假阳性概率 | 继续查询数据库或其他权威数据源核实 |
在 RESP2 中通常返回整数 `0` 或 `1`;RESP3 和部分客户端封装可能将结果表示为布尔值 `false` 或 `true`,判断语义相同。
例如,数据库已经存在 `user:42`,并且该成员已成功写入过滤器,`BF.EXISTS` 应返回 `1`。对于从未加入的成员,正常情况下返回 `0`,但如果过滤器的哈希位恰好全部匹配,也可能返回 `1`。因此,**命中不等于真实存在**。
风险与排查
- **过滤器未初始化**:当 `key` 不存在时,`BF.EXISTS` 返回 `0`。官方定义中,键包含错误类型的数据时也可能返回 `0`。关键业务不能仅凭这个返回值认定数据库没有记录,应确保过滤器已经正确初始化。
- **数据写入遗漏**:Bloom 过滤器通常不会对已成功加入的成员产生假阴性,但如果数据库新增记录没有同步写入过滤器,就可能错误地跳过真实记录。应补录遗漏成员,必要时从权威数据重建过滤器。
- **假阳性**:过滤器可能将未加入的成员判断为 `1`。不能单独使用此结果完成权限校验、账号存在性确认或需要精确判断的去重操作。
- **命令不可用**:如果出现 `ERR unknown command 'BF.EXISTS'`,检查当前 Redis 实例是否支持 Bloom 命令。可通过 `MODULE LIST` 检查模块信息,但内置功能的展示方式可能不同,应结合实际部署方式确认。
- **误用其他命令**:`EXISTS key` 检查 Redis 键是否存在,`BF.EXISTS key item` 检查 Bloom 过滤器中的成员;两者不能互相替代。
命令的返回类型和兼容性可参考 Redis BF.EXISTS 官方文档。
性能排查与集群观察
INFO [section [section ...]]读取连接、内存、持久化和复制等运行指标,适合问题初筛和日常观察;字段会随版本变化,生产监控应按指标名解析而非依赖文本位置。
查看服务整体状态
当 Redis 出现连接数异常、内存持续上涨、请求变慢、持久化失败或主从复制中断时,使用 INFO 读取服务运行指标。它可以按分区查询当前节点的状态,帮助快速判断问题属于连接、内存、持久化、复制还是请求处理,并确定后续排查方向。
基本语法
INFO [section [section ...]]section:可选分区名称,例如memory、clients、stats、persistence、replication。- 不指定分区:返回默认分区集合,相当于
INFO default。 - 指定多个分区:返回这些分区的信息,例如
INFO memory replication。 all:返回所有常规分区,但不包含模块生成的扩展信息。everything:包含所有常规分区和模块生成的信息,适用于支持该选项的 Redis 版本。
在 redis-cli 交互终端中可以直接输入 INFO memory;在操作系统终端中需要加上 redis-cli 前缀。实际连接的服务器由客户端连接参数决定。
常用分区与关键指标
| 分区 | 关键字段 | 排查用途 |
|---|---|---|
server |
redis_version、uptime_in_seconds |
确认版本和运行时长,判断是否近期重启 |
clients |
connected_clients、blocked_clients |
观察连接数量及阻塞中的客户端 |
memory |
used_memory、used_memory_peak、maxmemory |
判断内存占用、历史峰值与配置上限 |
persistence |
rdb_last_bgsave_status、aof_last_write_status |
检查 RDB 保存和 AOF 写入状态,AOF 指标需结合启用情况判断 |
replication |
role、master_link_status |
确认主从角色及副本到主节点的连接状态 |
stats |
instantaneous_ops_per_sec、rejected_connections、evicted_keys |
观察请求速率、连接拒绝和键淘汰情况 |
commandstats |
cmdstat_XXX 中的 calls、usec_per_call |
检查各类命令的执行次数和平均 CPU 耗时 |
master_link_status 主要用于副本节点;部分字段只有启用对应功能时才出现。不要把缺失字段直接解释为服务故障。
查询示例与预期结果
前置条件:已经安装 redis-cli,并且本机 127.0.0.1:6379 上有可访问的 Redis 服务。远程实例需要配置相应的主机、端口和身份认证。
# 查看本机 Redis 的内存指标,不修改服务配置或数据
redis-cli INFO memory
预期结果:返回以 # Memory 开头的文本。以下仅摘录关键字段,实际输出包含更多行,数值取决于当前节点。
# Memory
used_memory:<BYTES>
used_memory_human:<SIZE>
used_memory_peak:<BYTES>
maxmemory:<BYTES>
其中 <BYTES> 表示运行时返回的实际字节数,<SIZE> 表示人类可读的内存大小,并非 Redis 返回的固定文字。
读取时重点关注:
used_memory:Redis 分配器统计的当前内存使用量,单位为字节。used_memory_peak:记录的内存使用峰值,可以与当前值比较,判断是否经历过内存高峰。maxmemory:配置的 Redis 内存上限;值为0表示未设置此项限制,不代表机器拥有无限内存。used_memory_rss:操作系统视角的 Redis 常驻物理内存,可以辅助判断实际内存占用。maxmemory_policy:达到配置的内存上限时采用的淘汰策略,可能影响写入结果。
如果要观察其他类别,可以把示例中的 memory 换成 clients、stats、persistence 或 replication,再按对应字段读取结果。
指标异常时如何判断
内存接近上限
当 used_memory 持续接近 maxmemory 时,先确认 maxmemory_policy,再结合 stats 分区中的 evicted_keys 判断是否发生键淘汰。对于不允许淘汰的策略,达到内存限制可能导致部分写入命令失败。
如果 used_memory_rss 明显高于 used_memory,还应结合 used_memory_peak、内存分配器指标和操作系统监控分析。历史内存高峰、分配器保留内存以及碎片都可能造成差异,不能仅凭一个比例认定存在内存泄漏。
连接或请求异常
连接问题优先查看 connected_clients、blocked_clients 和 rejected_connections。其中 rejected_connections 是累计计数,应比较不同采样时间的增量,而不能只根据非零值判断当前仍有连接被拒绝。
请求变慢时,可以对照 instantaneous_ops_per_sec 与 commandstats。usec_per_call 表示命令平均执行 CPU 时间,不等同于客户端端到端请求延迟;必要时继续使用慢日志和延迟诊断命令定位。
持久化或复制异常
若 rdb_last_bgsave_status 显示失败,应进一步检查持久化配置、Redis 日志和磁盘状态。启用 AOF 的实例还应关注相应的 AOF 状态字段。
对于副本节点,若 master_link_status 为 down,应继续检查主节点可达性、复制配置及复制偏移相关指标。单次状态快照不能确定故障持续时间。
风险与使用边界
- 节点范围:
INFO描述的是当前连接的 Redis 实例,并非整个 Redis Cluster 的汇总状态。集群排查需要分别采集相关节点。 - 权限限制:如果遇到
NOPERM,应检查当前用户的 ACL 授权,由管理员按最小权限原则处理,不要为诊断直接授予全部命令权限。 - 字段兼容性:不同 Redis 版本、部署模式和已加载模块可能提供不同字段。监控程序应按字段名解析,忽略未知字段,并允许非必需字段缺失。
- 结果时效:部分指标是瞬时值,部分是累计计数。判断趋势时应记录采样时间,对累计计数计算采样区间增量,并注意实例重启可能导致计数重置。
速查提示:初筛先执行 INFO 查看默认分区;确定问题类别后使用 INFO memory、INFO clients 或其他对应分区缩小范围,再结合日志与历史监控数据确认原因。
SLOWLOG GET [count]读取最近超过慢日志阈值的命令记录,适合定位服务端执行耗时;慢日志不包含网络往返延迟,排查请求慢仍需结合客户端侧指标。
查看近期慢命令
当 Redis 请求延迟升高、怀疑某些命令执行过慢时,使用 SLOWLOG GET 读取近期慢日志。通过执行耗时、命令参数和客户端来源,可以识别需要优化的操作。该命令只读取日志,不修改业务数据,也不包含网络往返耗时。
基本语法
SLOWLOG GET [count]| 参数 | 含义 | 默认值或约束 |
|---|---|---|
count |
最多返回多少条近期慢日志 | 默认 10 |
count=1 |
只读取最新一条记录 | 适合快速检查 |
count=-1 |
返回当前保留的全部记录 | 可能产生较大输出 |
返回的记录按时间从新到旧排列。实际返回数量不会超过当前慢日志保留的记录数。
SLOWLOG GET 从 Redis Open Source 2.2.12 开始支持,读取时间复杂度为 O(N),其中 N 是返回的记录数。
读取慢日志
前置条件:已安装 redis-cli,目标 Redis 实例可以访问,当前用户具有执行 SLOWLOG GET 的权限。
在本机默认 Redis 实例上执行:
# 查看最近最多 10 条慢命令记录
redis-cli SLOWLOG GET 10
预期结果:返回最多 10 条慢日志记录。以下是 Redis 4.0 及之后、8.10 之前版本的单条记录示意,实际 ID、时间、命令和客户端信息取决于实例。
1) 1) (integer) <ID>
   2) (integer) <TIME>
   3) (integer) <DURATION_US>
   4) 1) "HGETALL"
      2) "user:42"
   5) "127.0.0.1:<PORT>"
   6) ""
其中 <ID> 是慢日志记录编号,<TIME> 是 Unix 时间戳(秒),<DURATION_US> 是执行耗时(微秒),<PORT> 是客户端连接端口。以上占位符代表实际运行时变化的值。
各字段的含义如下:
| 字段位置 | 含义 | 排查用途 |
|---|---|---|
| 1 | 慢日志唯一递增 ID | 标识记录,避免重复处理 |
| 2 | 命令执行时间戳 | 对齐应用日志和监控时间 |
| 3 | 服务端执行耗时,单位微秒 | 判断命令是否存在明显耗时 |
| 4 | 命令名称和参数数组 | 确定需要检查的命令及访问对象 |
| 5 | 客户端 IP 和端口 | 定位请求来源 |
| 6 | 客户端名称 | 关联通过 CLIENT SETNAME 设置名称的应用连接 |
例如第三个字段为 25000,表示命令执行耗时约 25 毫秒,而不是 25000 毫秒。
Redis 4.0 之前的记录没有客户端地址和名称字段;Redis 8.10.0 起新增第七个字段,表示原始命令参数总数。不同版本、部署产品的返回字段可能不同,不应假定每条记录固定包含六个字段。
如果没有符合条件的记录,redis-cli 通常显示 (empty array),这不等于所有请求都没有延迟。
检查慢日志阈值与容量
慢日志由执行时间阈值和最大保留条数控制。如果预期的慢命令没有出现,先检查配置,而不是直接修改阈值。
# 查看当前保留的慢日志条数
redis-cli SLOWLOG LEN

# 查询执行时间阈值,单位为微秒
redis-cli CONFIG GET slowlog-log-slower-than

# 查询慢日志最多保留多少条记录
redis-cli CONFIG GET slowlog-max-len
预期结果:
SLOWLOG LEN返回整数,表示当前慢日志条数。CONFIG GET slowlog-log-slower-than返回配置名和对应阈值。CONFIG GET slowlog-max-len返回配置名和当前最大保留条数。
阈值的含义需要特别注意:
- 正整数:记录服务端执行耗时超过该微秒阈值的命令。
0:记录所有命令,可能显著增加日志处理开销。-1:关闭慢日志记录。
例如阈值为 10000 时,执行时间超过 10 毫秒的命令会进入慢日志。日志按配置的最大条数保留,旧记录可能被新记录淘汰。
根据记录定位问题
拿到慢日志后,优先检查耗时最高的命令,并结合命令类型、参数规模和调用频率判断问题来源。
- 根据时间戳关联应用请求日志,确认慢命令发生在哪次业务操作期间。
- 查看第三个字段的微秒耗时,识别明显偏高的执行记录。
- 查看第四个字段的命令及参数,检查是否存在大集合操作、全量扫描或高成本脚本执行。
- 利用客户端地址和名称定位调用服务,对照应用侧的请求数量、超时和重试情况。
- 优化可疑命令后,在相近负载下重新读取慢日志,比较记录数量及执行耗时。
注意,单次慢日志记录不能直接证明某条命令是整体性能下降的唯一原因。必要时结合 INFO commandstats、应用端延迟指标及 LATENCY 相关诊断结果进行交叉验证。
风险与边界
SLOWLOG GET 本身是只读操作,但慢日志内容可能包含命令参数和业务数据片段,导出或共享时应注意敏感信息保护。命令参数在某些版本或配置下还可能被截断,不能保证完整记录所有请求参数。
慢日志只统计服务端命令执行阶段的耗时,不包括客户端通信、网络传输和响应发送等时间。因此,应用请求耗时很高但慢日志没有异常时,应继续排查网络往返、连接池等待、客户端处理和服务器其他延迟来源。
速查提示:优先读取最近 10 条,检查第三个字段的微秒耗时,再结合命令、时间和客户端来源定位问题;日志为空时先核实阈值与目标节点。
MEMORY USAGE key [SAMPLES count]估算键数据和管理开销占用的字节数,适合大键排查及缓存成本评估;复杂集合的采样结果可能是近似值,应结合类型和成员数分析。
估算指定键内存占用
排查大键或估算单条缓存成本时,用 MEMORY USAGE 查询键名、值和相关管理结构在 Redis 中占用的内存分配量,单位为字节。它比 STRLEN 更适合衡量键的内存成本,但不等于进程的实际物理内存(RSS)占用。
基本语法
MEMORY USAGE key [SAMPLES count]
key:要检查的完整键名,不支持通配符匹配;不存在时返回空回复。SAMPLES count:对包含多个元素的聚合类型进行抽样估算。默认采样 5 个内部元素;SAMPLES 0表示遍历全部内部元素。对普通字符串键无需依赖此选项。- 返回值:键存在时返回字节数整数;键不存在时返回空回复,具体显示形式取决于客户端和协议版本。
查询与验证
确保 redis-cli 已连接到目标实例和数据库,且具备查询权限,再执行以下只读命令:
# 先确认键类型,避免把不存在的键误判为零内存
redis-cli TYPE demo:user:42

# 默认抽样,适合快速排查
redis-cli MEMORY USAGE demo:user:42

# 全量计算聚合类型的内部元素开销
redis-cli MEMORY USAGE demo:user:42 SAMPLES 0
预期输出(假设该键存在且类型为 hash;数字随数据、编码和 Redis 环境变化):
hash
(integer) <BYTES_ESTIMATE>
(integer) <BYTES_FULL>第一行用来判断值类型;第二行是默认抽样估算值;第三行使用全量元素计算。<BYTES_ESTIMATE> 和 <BYTES_FULL> 为运行时得到的字节数,可能相同。
若键不存在,TYPE 返回 none,两次内存查询均返回空回复,常见 RESP2 交互式输出为 (nil)。这不代表键的内存占用为零,而是当前数据库没有该键。
如何判读与规避风险
对于较大的 Hash、List、Set、Sorted Set,默认采样适合快速筛查。元素大小差异较大时,可适当提高 SAMPLES;需要核对单键的完整元素开销时,再使用 SAMPLES 0。
命令的时间复杂度与采样元素数量有关。全量遍历超大集合可能造成 Redis 主线程延迟,应避开业务高峰,优先在测试实例或低峰期执行。已经使用 SAMPLES 0 的排查任务若出现延迟问题,可恢复使用默认采样或较小的采样数量。
不要把单键结果当作实例总内存或 RSS,也不要认为返回的字节数是固定的。Redis 版本、内部编码、内存分配器及数据变动都会影响结果。排查实例内存异常时,可配合以下命令查看全局内存指标:
redis-cli INFO memory
redis-cli MEMORY STATS预期结果:INFO memory 返回包含 used_memory、used_memory_rss 等字段的内存信息;MEMORY STATS 返回实例内存分配及碎片相关指标。具体数值随运行环境变化,不能直接与单键结果一一对应。
MEMORY USAGE 自 Redis 4.0.0 起可用,命令只读,不修改键,因此无需回滚。它适合定位单键内存成本,不适合代替全实例内存和碎片分析。
LATENCY DOCTOR读取 Redis 延迟监测事件及建议,适合排查 fork、命令阻塞等尖峰;需要相关监测配置和事件数据,不能直接反映所有网络层延迟。
分析延迟尖峰来源
当 Redis 请求偶发卡顿、响应时间突然升高时,使用 LATENCY DOCTOR 分析服务器内部已记录的延迟尖峰。它会汇总事件类型、发生频率、延迟统计和排查建议,帮助判断问题是否来自慢命令、fork 或持久化 I/O。
该命令只分析 Redis 延迟监测器采集到的事件,不能直接测量客户端网络往返延迟,也不会自动修复性能问题。
基本语法
redis-cli LATENCY DOCTOR命令不接受额外参数,返回一份人类可读的诊断报告。示例默认连接本机 Redis,远程实例需要通过 redis-cli 的 -h、-p 等选项指定连接信息。
预期结果:如果已有延迟事件,报告会列出相应的事件类型、统计数据及建议;如果监测未启用或没有足够的事件数据,则无法生成有效的尖峰分析。
该功能从 Redis Open Source 2.8.13 开始提供,执行账号需要具备相应命令权限。
确认延迟监测已启用
LATENCY DOCTOR 依赖 latency-monitor-threshold 配置。该参数单位为毫秒,默认值为 0,表示关闭延迟监测。
redis-cli CONFIG GET latency-monitor-threshold预期结果:返回 latency-monitor-threshold 及当前数值。如果结果为 0,说明当前未启用采样;如果为正整数,则表示记录超过相应阈值的延迟事件。
如果当前值为 0,且已获得配置修改授权,可以选择合适的阈值开启监测。例如记录超过 100 毫秒的事件:
redis-cli CONFIG SET latency-monitor-threshold 100预期输出:
OK配置成功后,Redis 才开始采集满足阈值条件的新事件。历史上发生但未被记录的尖峰无法补录,因此刚开启监测时没有诊断数据属于正常情况。
读懂诊断报告
报告通常按事件类型组织,给出事件次数、平均延迟、平均偏差、事件发生间隔和历史最大延迟等信息。具体输出内容取决于已采集的数据。
重点关注以下事件:
| 事件类型 | 表示什么 | 优先检查 |
|---|---|---|
command |
普通命令执行出现明显阻塞 | 慢日志、大集合操作、复杂度较高的命令 |
fast-command |
通常较快的命令出现执行延迟 | CPU 负载、异常大对象、运行环境 |
fork |
创建后台子进程时产生延迟 | RDB 保存、AOF 重写、内存规模 |
aof-write |
AOF 写入操作耗时较高 | 磁盘 I/O、写入负载 |
expire-cycle |
过期键清理周期产生延迟 | 大量键集中到期、过期处理负载 |
eviction-cycle |
内存淘汰周期产生延迟 | 内存压力、淘汰策略与数据规模 |
例如报告显示 command 有多次超过阈值的尖峰,说明应优先检查命令执行路径,而不是直接修改网络配置。
如果主要事件为 fork,则需要结合后台持久化任务及 latest_fork_usec 判断创建子进程是否耗时过长。该指标单位为微秒,不能直接当作毫秒读取。
报告中的建议是排查线索,不代表已经证明唯一根因。不同类型的事件可能同时发生,也可能共同受到 CPU 或磁盘资源竞争影响。
交叉验证与定位
LATENCY DOCTOR 适合快速判断问题类别,但要确定具体操作和时间,需要配合其他只读诊断命令。
# 查看各事件最近一次尖峰及历史最大值
redis-cli LATENCY LATEST
redis-cli LATENCY HISTORY command

# 对照慢命令记录和最近一次 fork 耗时
redis-cli SLOWLOG GET 10
redis-cli INFO stats
预期结果与读取方法:
LATENCY LATEST:返回已记录事件的名称、最近发生时间、最近延迟及历史最大延迟。时间使用 Unix 时间戳,延迟单位为毫秒。LATENCY HISTORY command:返回command事件的时间戳与延迟值配对记录。如果没有该类事件,结果可以为空。SLOWLOG GET 10:最多返回最近 10 条慢命令记录,用来定位具体命令。慢日志耗时单位为微秒,不包含网络传输时间。INFO stats:查找latest_fork_usec、total_forks等字段,辅助分析fork相关尖峰。
如果 LATENCY DOCTOR 显示命令阻塞,但慢日志没有记录,需要检查 slowlog-log-slower-than。慢日志阈值使用微秒,而延迟监测阈值使用毫秒,两者不一致可能导致只在其中一处看到事件。
延迟历史按事件分别保存有限数量的采样,同一秒内多次尖峰会合并保留最大值,因此不能把事件记录数直接当作真实请求数量或完整的延迟分布。
风险与恢复
LATENCY DOCTOR 本身不修改业务数据,也不会清空监测结果,但诊断过程中需要注意配置变更和证据保留。
- 没有报告不等于没有延迟:确认监测阈值、开启时间和事件是否达到采样条件,再排查网络、客户端连接池及系统调度。
- 不要直接清空证据:
LATENCY RESET会删除指定事件或全部事件的监测历史。事故调查完成并保存必要数据前,不建议执行。 - 不要未经评估修改持久化策略:如果报告提示 AOF 或
fork问题,应先结合磁盘、内存与持久化指标确认原因,避免以牺牲数据安全换取延迟改善。 - 集群需要逐节点检查:延迟监测数据属于 Redis 实例本地信息,单个节点的报告不能代表整个集群。
如果排查前阈值为 0,排查完成后可以恢复原配置:
redis-cli CONFIG SET latency-monitor-threshold 0预期输出:
OK该操作会关闭后续延迟事件采集。如果原先阈值不是 0,应恢复实际记录的原始数值,不要直接关闭已有监控。托管服务还可能限制 CONFIG SET 权限,需要通过对应平台调整配置。
速查提示:先检查监测开关,再执行 LATENCY DOCTOR,根据事件名称使用 LATENCY HISTORY、SLOWLOG 和 INFO 交叉验证。若报告没有事件,应先补齐监测数据,而不是据此认定 Redis 不存在延迟问题。
CLIENT LIST [TYPE <NORMAL | MASTER | REPLICA | PUBSUB>] [ID client-id [client-id ...]]列出服务端已连接客户端的来源、空闲时间和状态,适合排查连接泄漏或阻塞连接;字段可能随版本增加,输出包含敏感连接信息。
检查客户端连接
当连接数异常增长、出现大量空闲连接或请求长时间等待时,使用 CLIENT LIST 查看当前 Redis 实例的连接快照,找出来源地址、连接时长及缓冲区异常。命令只查询连接信息,不会断开客户端。
基本语法
CLIENT LIST [TYPE <NORMAL | MASTER | REPLICA | PUBSUB>] [ID client-id [client-id ...]]
- 不带选项:列出当前实例的全部连接。
TYPE:按NORMAL、MASTER、REPLICA或PUBSUB过滤;执行MONITOR的连接也属于NORMAL类。ID:只显示给定客户端 ID,可指定多个整数 ID;无匹配时返回空结果。两个过滤条件可以组合使用。
常用示例与预期结果
前置条件是已安装 redis-cli,目标 Redis 可连接,当前用户有执行 CLIENT LIST 的权限。下面默认连接本机 127.0.0.1:6379;检查其他实例时要使用实际主机和端口。
redis-cli --raw CLIENT LIST TYPE NORMAL预期结果:每个普通客户端占一行,包含以空格分隔的 id=...、addr=...、age=...、idle=...、flags=...、cmd=... 等字段。执行查询的 redis-cli 连接通常也在结果中;ID、地址、时长与记录数量均随运行环境变化。无权限时会收到 NOPERM 类错误,而非连接清单。
关键字段速读
| 字段 | 含义 | 排查用途 |
|---|---|---|
id、addr、name |
连接 ID、对端地址、可选客户端名 | 区分重复连接及应用来源,名称可为空 |
age、idle |
已连接时间、空闲时间,单位秒 | 识别长期存活或久未活动的连接 |
flags |
状态标志,可由多个字符组成 | b 表示等待阻塞操作,P 表示 Pub/Sub,N 表示无特殊标志 |
qbuf |
查询缓冲区长度,单位字节 | 观察尚待处理的输入数据 |
oll、omem |
输出队列长度、输出缓冲区内存字节数 | 排查回复积压或客户端读取缓慢 |
cmd、db、user |
最近执行的命令、数据库编号、认证用户 | 补充定位连接用途;部分字段依赖版本 |
如何判断异常
- 在多个时间点重复查看连接快照,核对同一应用来源的连接数量与
id变化,并与连接池上限和重连日志对照;idle高不等于一定发生泄漏。 flags包含b时,结合cmd确认是否属于预期的阻塞读取;不要仅凭阻塞标志判断故障。cmd是最近命令,不保证代表当前正在执行的操作。oll或omem持续升高时,检查客户端读取速度、网络状况和消息量。需要精确追踪某条连接时,使用已查出的真实整数 ID 配合ID过滤。
权限、版本与风险
CLIENT LIST 从 Redis 2.4 起可用,TYPE 过滤从 5.0 起可用,ID 过滤从 6.2 起可用。返回字段随版本变化;自动解析时应跳过未知字段并允许字段缺失。
该命令扫描连接列表,复杂度为 ,连接很多时不要高频轮询。结果可能泄露客户端地址和认证用户名,需限制访问及日志传播。遇到 NOPERM 应核对 ACL 并申请最小必要权限,不要直接开放全部管理命令。Redis Cluster 下应分别连接各节点检查;本命令不修改连接,无需恢复操作。
CONFIG GET parameter [parameter ...]读取指定运行配置或匹配模式,适合核对内存上限、淘汰策略和超时设置;部分配置可能受权限限制,不应将配置输出全部公开。
查询运行配置项
当需要核对 Redis 实例当前生效的内存上限、淘汰策略、连接超时等设置时,使用 `CONFIG GET` 读取运行时配置。它不会修改配置,适合在性能排查、部署验收和配置变更后确认实际值。
基本语法
在 Redis CLI 中执行:
CONFIG GET parameter [parameter ...]这里的命令需要在 `redis-cli` 交互环境中执行;若直接在操作系统终端运行,应在命令前添加 `redis-cli`。
- `parameter`:必填,配置项名称或 glob 风格匹配模式。
- `[parameter ...]`:可选,追加其他配置项名称或匹配模式;一次查询多个参数需要 Redis 7.0 及以上版本。
- `*`:匹配任意长度字符,例如 `maxmemory*` 可以匹配 `maxmemory` 和 `maxmemory-policy`。
命令返回匹配到的配置名称及其当前值。使用 RESP2 时通常表现为名称和值交替排列的数组;RESP3 使用映射结构。未匹配到配置项时返回空结果,不代表命令执行失败。
常用配置项
| 配置项 | 含义 | 排查重点 |
|---|---|---|
| `maxmemory` | Redis 内存使用上限,单位为字节 | 是否设置内存限制,`0` 表示未配置 Redis 自身的内存上限 |
| `maxmemory-policy` | 达到内存上限时采用的淘汰策略 | 是否为 `noeviction`,是否符合缓存淘汰需求 |
| `timeout` | 普通客户端空闲连接超时时间,单位为秒 | `0` 表示不因该参数设置空闲超时 |
| `tcp-keepalive` | TCP keepalive 探测间隔相关配置,单位为秒 | 是否启用连接保活机制 |
| `appendonly` | 是否启用 AOF 持久化 | 当前运行实例是否开启 AOF |
配置名称及其可用性取决于 Redis 版本和部署环境。托管 Redis 服务可能只开放部分配置项。
常用示例
连接到具有查询权限的 Redis 实例后,在操作系统终端执行以下命令。示例假定 `redis-cli` 可以通过默认连接参数访问目标实例。
# 使用 --raw 输出便于阅读的配置名称和值
redis-cli --raw CONFIG GET maxmemory maxmemory-policy
预期结果(示例,假设实例未设置内存上限,淘汰策略为 `noeviction`):
maxmemory
0
maxmemory-policy
noeviction
实际数值由运行实例决定,不应将示例输出当作固定返回值。
结果说明:
- `maxmemory = 0`:Redis 自身未设置最大内存限制,不代表容器或操作系统没有内存限制。
- `maxmemory-policy = noeviction`:配置了非零内存上限且达到相关内存限制时,不通过淘汰键释放空间,可能拒绝需要增加内存的写入操作。
需要查看一组相关配置时,可将参数写成 `maxmemory*`;需要核对单个参数时,优先使用准确名称,避免返回无关信息。
版本与权限
`CONFIG GET` 从 Redis 2.0.0 开始提供,Redis 7.0.0 起支持一次传入多个参数或匹配模式。
对于 Redis 6.x 及更早版本,应将 `maxmemory` 和 `maxmemory-policy` 分别查询。如果执行多参数命令出现参数数量错误,先确认服务端版本,再改为单参数查询。
该命令虽然不修改配置,但属于管理类命令,ACL 分类包含 `@admin`、`@slow` 和 `@dangerous`。普通业务账号可能无法调用。
- 返回 `NOPERM`:当前 ACL 用户没有足够权限,应由管理员检查授权;Redis 7.0 及以上可以按需单独授权 `CONFIG GET` 子命令,避免开放全部配置修改权限。
- 返回未知命令或命令不可用:检查服务端版本、命令重命名设置及托管服务限制。
- 返回空结果:检查参数名称和匹配模式,确认该版本是否提供相应配置项。
风险与排查边界
`CONFIG GET` 读取的是当前运行时有效配置,不保证与磁盘上的 `redis.conf` 完全一致。运行期间通过 `CONFIG SET` 修改的值可能尚未持久化,重启后的实际值还取决于配置文件、启动参数及部署平台。
如果查询值与预期不符,先核对目标实例和启动配置,再检查是否存在运行时修改;不要直接通过 `CONFIG SET` 试错。`CONFIG GET` 本身不产生配置变更,因此无需回滚。
速查提示:优先执行 `CONFIG GET maxmemory maxmemory-policy` 核对内存限制与淘汰行为;若使用 Redis 7.0 之前的版本,分别查询这两个配置项。
CLUSTER KEYSLOT key计算指定键在 Redis Cluster 中所属哈希槽,适合检查多键操作为何跨槽失败;相同哈希标签能帮助相关键路由到同一槽。
定位集群键槽
遇到 Redis Cluster 的 CROSSSLOT 错误,或要确认多个键能否执行同槽多键操作时,用 CLUSTER KEYSLOT 逐个计算槽号。它只计算路由位置,不读取键值、不要求键存在,也不修改数据。
基本语法
CLUSTER KEYSLOT key
key:待计算的完整键名;这是唯一的必填参数。在 Shell 中遇到空格或特殊字符应加引号。- 返回值:
0~16383的整数槽号,不是节点编号或键的实际存储地址。 - 计算规则:通常为
CRC16/XMODEM(key) % 16384;存在有效哈希标签时,只对{}中的非空内容计算。命令自 Redis 3.0 起可用,计算复杂度随键名的字节长度线性增长。
同槽验证
前提是能访问启用 Cluster 的 Redis 节点,并已安装 redis-cli。将下面的 <HOST>、<PORT> 替换为实际主机和端口;各环境连接信息可能不同。
# 使用相同标签验证同槽,再用不同标签作对照
REDIS_HOST='<HOST>'
REDIS_PORT='<PORT>'
redis-cli --raw -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER KEYSLOT 'demo:cart:{42}'
redis-cli --raw -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER KEYSLOT 'demo:order:{42}'
redis-cli --raw -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER KEYSLOT 'demo:cart:{43}'预期输出(三条命令依次返回,--raw 使结果显示为纯整数):
8000
8000
3937
前两键均以 42 为哈希输入,因而落在槽 8000;第三键使用 43,落在槽 3937。槽号相同是多键操作在 Cluster 中执行的必要条件,但不意味着键已存在。
标签与排错
demo:cart:{42}和demo:order:{42}使用相同标签;demo:cart:42没有标签,改为按完整键名计算,不能据此认定同槽。- 标签必须是首个
{与其后第一个}之间的非空内容。foo{}{42}的第一对括号为空,将按整个键名哈希,并不会自动采用第二对括号。 - 遇到
CROSSSLOT,逐一检查命令涉及的键槽。若需改名以统一标签,应评估旧键的数据迁移与业务引用更新;仅修改新键命名规则不会迁移旧数据。 - 若报集群功能未启用,检查是否连到了非 Cluster 实例;若需要定位具体节点,另查
CLUSTER SLOTS,或在 Redis 7.0 及以上使用CLUSTER SHARDS。槽的负责节点可能因故障转移或迁移而变化。
CLUSTER SHARDS查询分片负责的槽区间和节点角色,适合核对集群路由与故障切换状态;只适用于集群部署,客户端仍需正确处理拓扑变化。
查看集群分片拓扑
当 Redis Cluster 出现 MOVED 重定向、客户端路由异常或主从故障切换时,使用 CLUSTER SHARDS 查询当前分片拓扑。结果可以帮助确认每段哈希槽由哪个分片负责、分片内有哪些主节点和副本,以及节点是否具备服务条件。该命令只读,不会修改槽位分配。
基本语法
CLUSTER SHARDS命令不接受额外参数,从 Redis Open Source 7.0.0 开始支持。必须连接启用了 Cluster 模式的 Redis 节点,并具有相应的命令执行权限。
查询时间复杂度为 ,其中 为集群节点总数。它适合客户端初始化、拓扑刷新和运维排查,不建议在每次业务请求前重复执行。
返回结构与关键字段
结果按分片组织,每个分片包含 slots 和 nodes 两部分。一个分片对应一组共享槽位的主从节点,同一时刻最多只有一个主节点,可以有零个或多个副本。
| 字段 | 含义与读取方式 |
|---|---|
slots |
分片负责的槽位区间,按起点、终点成对排列,包含两个端点 |
nodes |
该分片的节点列表,每个节点包含独立的属性集合 |
id |
节点唯一标识,可用于核对故障切换前后的节点身份 |
role |
master 表示主节点,replica 表示副本节点 |
endpoint |
客户端首选访问地址,可能出现空值或异常占位值 |
port / tls-port |
普通 TCP 或 TLS 端口,至少提供其中一种 |
health |
online、failed 或 loading,用于判断节点是否适合接收流量 |
replication-offset |
复制偏移量,可辅助比较副本的复制进度 |
节点还可能包含 ip、hostname 等属性。部分字段是可选的,客户端解析时不应假定所有节点都有完全相同的属性集合。
Redis Cluster 的哈希槽编号范围为 0 到 16383,共 16384 个。slots 可以包含多个不连续区间,例如 [0,1000,2000,3000] 表示两个闭区间,而不是四个独立槽位。
分片与主从节点的对应关系
一个典型的三主三副本集群可以将槽位划分为 0–5460、5461–10922 和 10923–16383 三段,每段由一个主节点负责,并配有一个副本。实际集群的分片数量、槽段划分和副本数量均以查询结果为准。
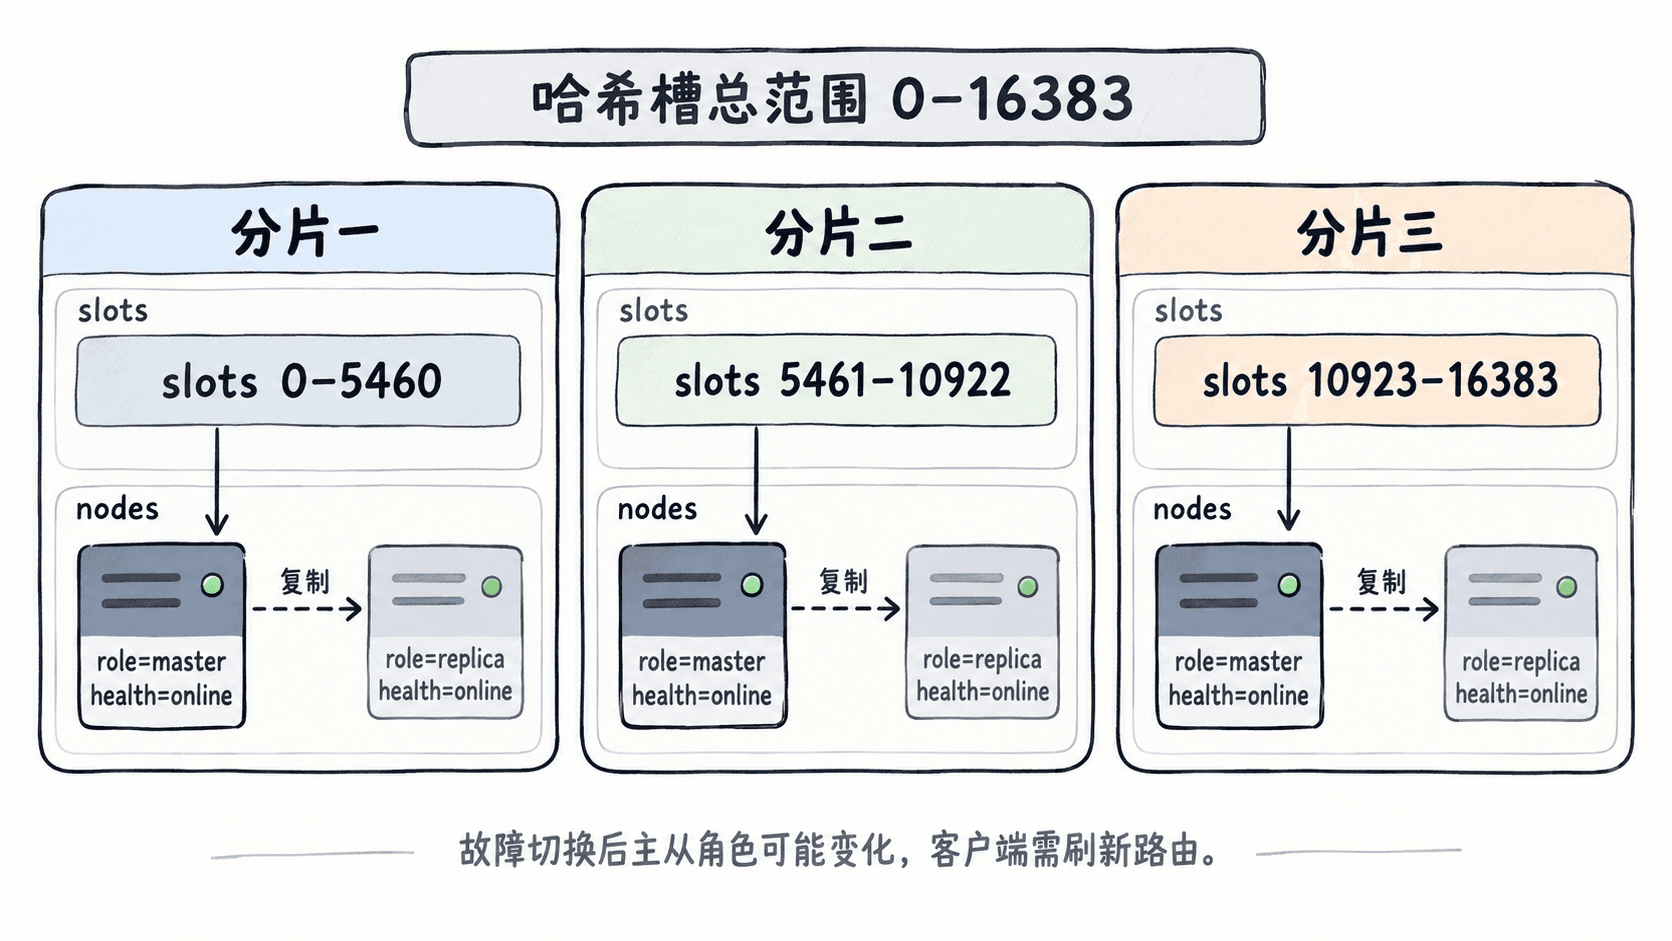
读取拓扑时,应先根据 slots 定位分片,再读取该分片 nodes 内角色为 master 的节点。副本节点与主节点处于同一分片,但不能简单地将所有副本视为可写目标。
发生故障切换后,原副本可能成为新的主节点。此时槽位范围未必变化,但 role、health 和可写节点地址可能已经改变,因此不能仅比较槽位区间判断拓扑是否更新。
查询示例与结果验证
前置条件:已有运行中的 Redis 7.0 或更高版本 Cluster,且本机能够连接其中一个节点。下面通过 redis-cli 查询分片,再检查集群整体状态。
# 将 <PORT> 替换为实际 Cluster 节点端口
redis-cli -h 127.0.0.1 -p <PORT> CLUSTER SHARDS

# 对照集群状态验证槽位是否全部正常分配
redis-cli -h 127.0.0.1 -p <PORT> CLUSTER INFO
预期结果:第一条命令返回一个或多个分片的嵌套结构,每个分片都有 slots 与 nodes。在 RESP2 下,属性通常表现为交替排列的字段名和值;在 RESP3 下使用映射结构。节点 ID、地址、槽段和返回顺序随实际拓扑变化,不存在固定的完整输出。
第二条命令在集群健康、所有槽位均正常分配时,返回结果中通常包含以下字段:
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
这只是 CLUSTER INFO 的部分输出,实际还会包含其他统计字段。检查时应同时确认槽位区间覆盖完整、各分片存在可服务的主节点,以及需要访问的节点地址和端口对客户端可达。
异常判断与恢复
| 现象 | 可能原因 | 处理方式 |
|---|---|---|
ERR unknown subcommand |
服务端版本较旧 | 检查版本;Redis 7.0 以下可改查 CLUSTER SLOTS |
ERR This instance has cluster support disabled |
连接的是非 Cluster 实例 | 检查目标实例及 Cluster 配置,连接正确节点 |
NOAUTH 或权限错误 |
尚未认证或 ACL 不允许执行 | 使用具备查询权限的账号重新连接 |
health=failed |
节点被集群判定为故障 | 检查节点进程、网络连通性和故障切换状态 |
health=loading |
节点尚未准备好提供服务 | 等待加载完成并重新查询,避免向其发送业务流量 |
endpoint 为空或为 ? |
地址未知或主机名公告配置异常 | 检查节点公告地址和客户端的地址解析规则 |
若客户端持续收到 MOVED 重定向,应按重定向信息更新路由,并重新获取拓扑。若集群状态异常,先排查节点与槽位状态,待故障恢复后再次执行 CLUSTER SHARDS 核对,不要仅凭该查询结果直接修改槽位归属。
速查判断:先看 slots 确认路由范围,再看 nodes.role 找到当前主节点,最后结合 health、访问端点和 CLUSTER INFO 判断是否能够正常提供服务。