
Redis 与缓存 / 知识点
Redis 开发常用命令速查
可确认的流式队列
XREADGROUP GROUP group consumer [COUNT count] [MAXCOUNT maxcount] [MAXSIZE maxsize] [BLOCK milliseconds] [CLAIM min-idle-time] [NOACK] STREAMS key [key ...] id [id ...]以组内消费者身份读取并登记待确认消息,适合可重试的后台任务;使用 > 读取新消息,处理完成后必须显式确认以避免长期积压。
按消费者组领取消息
当多个后台进程需要分担 Redis Stream 中的任务,并在失败后补处理时,使用 XREADGROUP 以组和消费者身份领取消息。默认情况下,已投递但未执行 XACK 的消息 ID 会留在待确认列表(PEL)中,可供后续检查和重试。
基本语法
XREADGROUP GROUP <group> <consumer> [COUNT <count>] [BLOCK <milliseconds>] STREAMS <key> <id>以上为常用格式示意;完整语法还支持 MAXCOUNT、MAXSIZE、CLAIM、NOACK 和多个 Stream。GROUP 所指的消费者组必须已存在,消费者名称首次出现时会自动登记。STREAMS 后先列所有键,再提供一一对应的 ID;在 Shell 中传递特殊 ID > 时,需写成 '>',避免被解释为输出重定向。
决定领取范围的选项
| 选项 | 含义与限制 |
|---|---|
STREAMS key > |
领取该组尚未投递过的新消息;同组消费者分摊任务。 |
STREAMS key 0 |
只读取当前消费者自己的未确认消息,不会自动接管其他消费者的任务。 |
COUNT n |
每个 Stream 最多返回 n 条,不保证达到上限。 |
BLOCK ms |
没有可读的新消息时最多等待 ms 毫秒;0 表示无限等待。读取自身 PEL 时忽略此选项。 |
NOACK |
新领取的消息不进入 PEL;处理失败可能无法恢复,不适用于可靠任务。 |
CLAIM ms |
Redis 8.4 起支持;与 > 配合时优先接管空闲达到阈值的 PEL 消息,再读取新消息。 |
MAXCOUNT n / MAXSIZE bytes |
Redis 8.10 起支持;分别限制多流合计返回条数与响应字节预算。MAXCOUNT 与 COUNT 同时使用时不能更小;MAXSIZE 允许至少返回一条超过预算的大消息。 |
消息、PEL 与确认关系
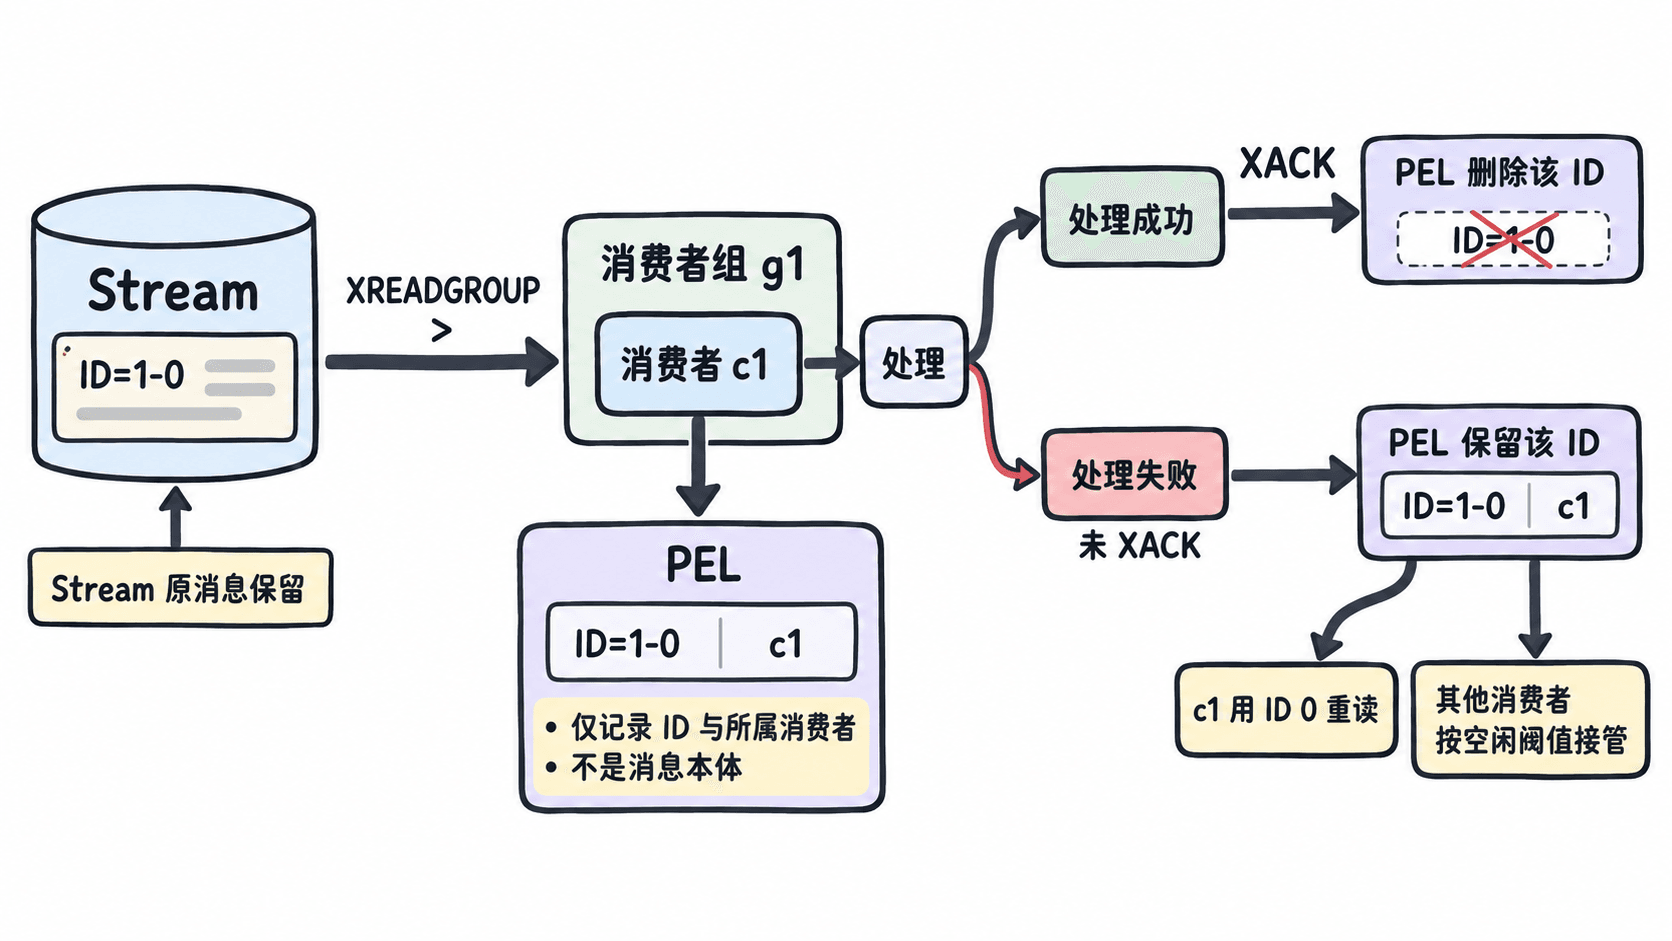
领取成功不代表业务处理成功。XREADGROUP 把消息关联到消费者和 PEL;只有在任务完成后执行 XACK key group id,才会移除该组中的未确认记录,不会删除 Stream 原消息。未确认任务也不会仅因再次使用 > 就自动重新派发。
可复现的领取与确认
前提:Redis 5.0 及以上版本、可连接的本地 redis-cli,并确保测试键 demo:xreadgroup:61 尚不存在。为使输出可验证,示例使用固定消息 ID 1-0,仅用于空测试流。
# 建立组并允许创建空流;起点 0 可读取随后写入的消息
redis-cli XGROUP CREATE demo:xreadgroup:61 g1 0 MKSTREAM
redis-cli XADD demo:xreadgroup:61 1-0 kind email
# Shell 中的 '>' 必须加引号;领取后先检查 PEL
redis-cli XREADGROUP GROUP g1 c1 COUNT 1 STREAMS demo:xreadgroup:61 '>'
redis-cli XPENDING demo:xreadgroup:61 g1
# 未确认前,同一消费者可通过 ID 0 重读自己的 PEL
redis-cli XREADGROUP GROUP g1 c1 COUNT 1 STREAMS demo:xreadgroup:61 0
redis-cli XACK demo:xreadgroup:61 g1 1-0
redis-cli XPENDING demo:xreadgroup:61 g1
预期结果:建组返回 OK,写入返回 1-0;两次读取都包含消息 1-0、字段 kind 和值 email。首次 XPENDING 的未确认总数为 1;XACK 返回 1;最后一次 XPENDING 的未确认总数为 0。生产环境通常使用 XADD ... * 自动生成 ID,确认时传入实际收到的 <ID>。
失败处理与边界
- 遇到
NOGROUP:先确认流键和组名是否正确,必要时用XGROUP CREATE创建组。已有组重复创建会返回BUSYGROUP,不要误以为必须重置数据。 - 消费者重启:先用
XPENDING查看积压,再用STREAMS key 0重读该消费者自己的未确认任务;其他消费者遗留的任务可用 Redis 6.2 起支持的XAUTOCLAIM接管,或在 Redis 8.4 起使用CLAIM ms。 - 发生重复执行:消息可能在业务成功后、确认前因进程退出而被再次领取。按业务任务 ID 实现幂等处理,业务提交成功后再执行
XACK;不要使用NOACK回避积压。
BLOCK 超时返回空结果不表示出错。各新增选项的版本适用性可核对 Redis XREADGROUP 官方文档。
XACK key group id [id ...]将指定消息从消费组的待确认列表中移除,适合工作者成功完成业务处理后提交确认;它不删除 Stream 原始记录,失败重试要保持业务幂等。
确认消费组消息
工作者通过 XREADGROUP 领取 Redis Stream 消息并成功完成业务处理后,使用 XACK 把消息 ID 从当前消费组的待确认列表(PEL)移除。命令返回实际确认的条数,不会删除 Stream 中的原始记录。
基本语法
XACK key group id [id ...]
key:Stream 的键名;group:消息所属的消费组名称。id [id ...]:一个或多个消息 ID,须属于该消费组的 PEL;可以批量确认。- 返回整数:
1表示本例中的单条消息成功确认;0表示该 ID 本次未从 PEL 移除,例如已确认过或未处于待确认状态。批量确认时返回成功移除的 ID 数量,而非传入数量。
可运行示例
前置条件:Redis 5.0 或更高版本已启动,可用 redis-cli 连接;在 Bash 中执行以下脚本。示例使用一次性的 demo:xack 键,末尾自动清理。
set -euo pipefail
stream="demo:xack:$RANDOM:$$"
group="workers"
redis-cli XGROUP CREATE "$stream" "$group" 0 MKSTREAM >/dev/null
id=$(redis-cli --raw XADD "$stream" '*' task send-email)
# 先通过消费组领取消息,它才会进入本组的 PEL
redis-cli --raw XREADGROUP GROUP "$group" worker-1 COUNT 1 STREAMS "$stream" '>' >/dev/null
# 演示中视为业务处理成功;真实工作者必须先完成业务再确认
echo "acked=$(redis-cli --raw XACK "$stream" "$group" "$id")"
echo "pending=$(redis-cli --raw XPENDING "$stream" "$group" | sed -n '1p')"
echo "length=$(redis-cli --raw XLEN "$stream")"
echo "acked_again=$(redis-cli --raw XACK "$stream" "$group" "$id")"
redis-cli DEL "$stream" >/dev/null
预期输出:
acked=1
pending=0
length=1
acked_again=0
pending=0 表示该消费组已无待确认消息,length=1 说明确认操作并未删除原始记录。重复确认返回 0,不会重新产生待确认记录。
确认与重试路径
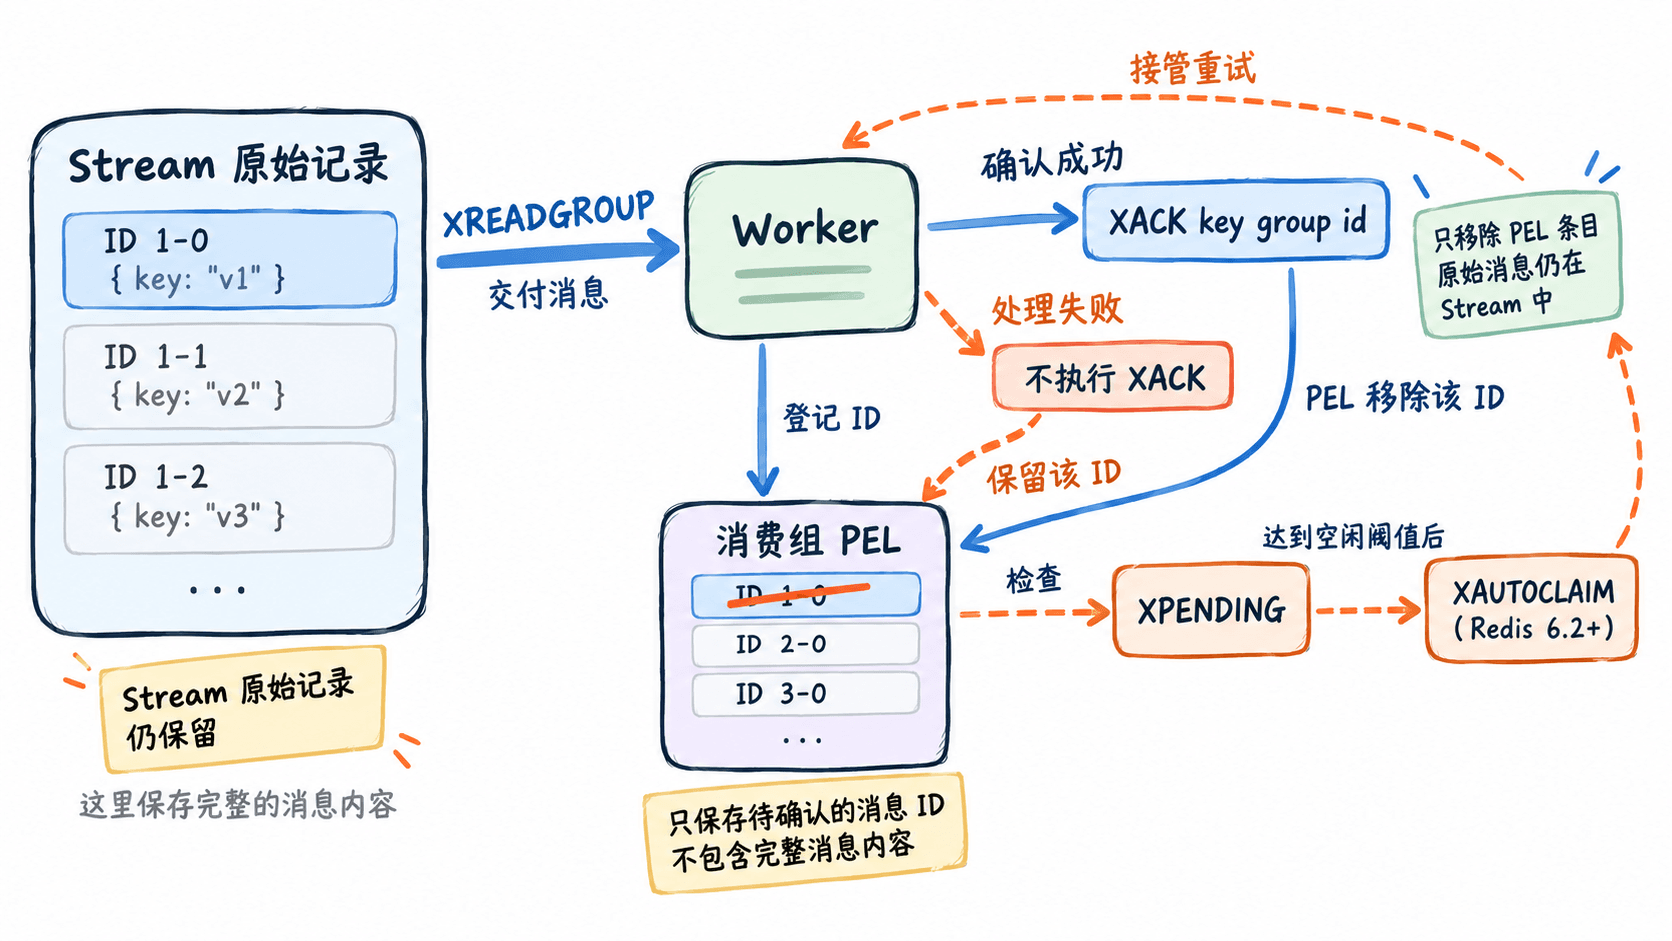
同一条 Stream 消息在不同消费组中有独立的待确认状态。XACK 仅作用于指定 group 的 PEL;在一个消费组确认成功,不代表其他消费组也已完成处理。
风险与恢复
- 处理失败:不要执行
XACK。先用XPENDING key group查看未确认数量,再依据业务重试策略由原消费者处理或通过XAUTOCLAIM接管超时消息(需要 Redis 6.2+)。重试处理必须支持业务幂等。 - 返回
0:检查使用的key、group和消息 ID 是否一致,并确认该 ID 曾由此消费组读取、尚在 PEL 中。重复确认属于正常的0返回场景。 - 提前误确认:
XACK没有撤销命令;后续不能依靠该 ID 的 PEL 状态自动重试。若业务未完成,应根据保留的原始消息重新投递或执行补偿,并使用业务唯一标识防止重复副作用。
生产环境不要在写入业务结果之前确认消息;清理、裁剪 Stream 是独立操作,不要将 XACK 当作删除命令。
XPENDING key group [[IDLE min-idle-time] start end count [consumer]]查看消费组待确认消息数量和归属,适合排查消费者崩溃或处理超时;摘要与明细形态不同,判断积压需结合空闲时长和重试次数。
检查未确认消息
当 Redis Streams 消费者读取消息后迟迟没有执行 XACK,或怀疑消费者崩溃、处理超时时,使用 XPENDING 检查消费组的待确认消息。它可以定位积压数量、消息归属、空闲时长和投递次数,为后续重试或消息接管提供依据。
基本语法
# 摘要模式:查看整个消费组的待确认情况
redis-cli XPENDING demo:jobs workers

# 明细模式:最多查看 10 条待确认消息
redis-cli XPENDING demo:jobs workers - + 10
XPENDING 有两种返回形态:
- 摘要模式:只传入
key和group,返回待确认消息总数、最小和最大消息 ID,以及各消费者的待确认数量。 - 明细模式:指定 ID 范围和数量上限,逐条返回消息 ID、所属消费者、空闲时长(毫秒)和投递次数。
XPENDING 是只读检查命令,不会确认、删除、重新投递或转移消息所有权。
关键参数
| 参数 | 含义 | 使用要点 |
|---|---|---|
key |
Stream 的键名 | 必须是实际存在的 Stream |
group |
消费组名称 | 必须是该 Stream 上已创建的消费组 |
start |
查询起始消息 ID | - 表示最小 ID,默认包含边界 |
end |
查询结束消息 ID | + 表示最大 ID,默认包含边界 |
count |
最多返回的明细条数 | 例如 10,不是积压总数 |
consumer |
可选的消费者名称 | 只查看该消费者名下的待确认消息 |
IDLE min-idle-time |
最小空闲时长 | 单位为毫秒,Redis 6.2 起支持 |
例如,IDLE 60000 只筛选距离最近一次投递至少经过 60 秒的待确认消息。空闲时间过长可能意味着处理卡住,但也可能是正常的长任务,不能仅凭这一项判定消费者失效。
明细模式还支持以左括号开头的消息 ID 表示排除起始边界,例如 (1-0。此功能从 Redis 6.2 开始支持,适合按 ID 分页检查大量待确认消息。
可验证示例
前置条件:本地 Redis 服务正在运行,已安装 redis-cli。以下示例使用独立测试键 demo:xpending:jobs,先清理测试数据,再创建一条消息并读取但不确认。请勿在包含业务数据的同名键上执行 DEL。
# 清理专用测试键,保证示例可重复执行
redis-cli DEL demo:xpending:jobs
redis-cli XADD demo:xpending:jobs 1-0 task send-email
redis-cli XGROUP CREATE demo:xpending:jobs workers 0

# worker-a 读取消息,但故意不执行 XACK
redis-cli XREADGROUP GROUP workers worker-a COUNT 1 STREAMS demo:xpending:jobs '>'

# 分别检查摘要和明细,强制使用可读的数组格式
redis-cli --no-raw XPENDING demo:xpending:jobs workers
redis-cli --no-raw XPENDING demo:xpending:jobs workers - + 10预期结果:DEL 返回 0 或 1,XADD 返回 1-0,XGROUP CREATE 返回 OK;XREADGROUP 返回包含 task 和 send-email 的消息。因为没有执行 XACK,摘要查询应返回:
1) (integer) 1
2) "1-0"
3) "1-0"
4) 1) 1) "worker-a"
      2) "1"
其中,第一个数字 1 是整个消费组的待确认消息总数;两个 1-0 分别是最小和最大待确认消息 ID;最后的 worker-a 和 1 表示该消费者持有一条待确认消息。
明细查询的预期结果为:
1) 1) "1-0"
   2) "worker-a"
   3) (integer) <IDLE_MS>
   4) (integer) 1
<IDLE_MS> 表示实际返回的空闲毫秒数,每次执行可能不同。最后的 1 是投递次数,表示该消息已经被投递一次,并不是失败次数。
消息被重新投递或由其他消费者认领时,投递计数可能增加。高投递次数可以作为排查重复消费的线索,但不能直接等同于业务处理失败次数。
筛选超时与定位积压
实际排查时,先使用摘要模式确认积压规模和主要持有者,再用明细模式缩小范围。
# 查看空闲至少 60 秒的待确认消息
redis-cli XPENDING demo:jobs workers IDLE 60000 - + 10

# 只查看 worker-a 名下的待确认消息
redis-cli XPENDING demo:jobs workers - + 10 worker-a
预期结果:第一条命令最多返回 10 条空闲时间达到 60000 毫秒的明细;如果没有符合条件的消息,返回空数组。第二条命令最多返回 10 条属于 worker-a 的待确认消息,不包含其他消费者的消息。
筛选结果为空并不一定意味着没有积压:可能只是消息尚未达到空闲阈值,或当前指定消费者没有待确认消息。应回到不带筛选条件的摘要查询确认总数。
风险与恢复
- 确认后才移除:业务处理成功后使用
XACK清除对应消费组的待确认记录;XACK不删除 Stream 中的消息。切勿仅因为空闲时间长就直接确认,否则可能丢失尚未完成的任务。 - 消费者崩溃:确认原消费者无法继续处理后,可使用
XCLAIM转移指定消息,或在 Redis 6.2 及以上版本使用XAUTOCLAIM批量接管满足空闲阈值的消息。接管后仍需执行实际业务处理,并在成功后确认;处理程序应具备幂等能力。 - 消费组不存在:出现
NOGROUP时,使用XINFO GROUPS检查 Stream 的消费组名称,不要盲目创建新组覆盖既有消费进度。 - 大量积压:
count只限制单次返回数量,建议分批分页查看。带IDLE的查询需要扫描候选记录,大规模待确认列表上应避免频繁执行超大范围检查。
XAUTOCLAIM key group consumer min-idle-time start [COUNT count] [JUSTID]扫描并接管闲置超过阈值的待确认消息,适合故障消费者恢复;返回续扫游标,需持续扫描并处理重复投递与任务执行幂等性。
认领超时未确认消息
当消费者崩溃或长时间未确认任务时,用 XAUTOCLAIM 从消费组的待确认列表(PEL)中扫描超过空闲阈值的消息,将其归属转移给健康消费者。认领不等于处理成功,完成业务操作后还要执行 XACK。
基本语法
XAUTOCLAIM key group consumer min-idle-time start [COUNT count] [JUSTID]key/group:已有的 Stream 键与消费者组;命令不会替你创建组。consumer:接管消息的新消费者名称。min-idle-time:最小空闲时间,单位毫秒;生产中按最长正常处理时间设置,避免抢走正在执行的任务。start:本轮扫描起点,首次用0-0;后续传入返回的游标。COUNT count:单次最多认领的条数,默认100;内部最多检查count × 10条 PEL 记录,实际返回可能少于count。JUSTID:只返回消息 ID、不返回字段内容,且不增加投递计数;需要直接处理消息体时不要使用。
返回值与扫描游标
返回结果依次包含下次扫描起点和已认领消息。不使用 JUSTID 时消息包含 ID 与字段值;使用后仅有 ID。Redis 7.0 起还有第三部分:原消息已被删除或裁剪、同时从 PEL 清理的 ID。
游标 0-0 表示当前这一轮已扫描到末尾,不表示 PEL 永远为空。稍后可能有其他消息达到空闲阈值,下一轮仍可从 0-0 开始。一次返回少于 COUNT 条,也不能据此判断扫描结束。
可复现示例
前置条件:Redis 6.2+、可执行 redis-cli,并确认测试实例中 demo:xautoclaim:64 尚不存在。以下故意使用 min-idle-time=0 模拟接管,仅用于隔离测试环境。
# 新建消费组和一条固定 ID 的测试消息
redis-cli XGROUP CREATE demo:xautoclaim:64 workers 0 MKSTREAM
redis-cli XADD demo:xautoclaim:64 1-0 job invoice-1
# worker-a 领取但不确认,模拟处理中断
redis-cli XREADGROUP GROUP workers worker-a COUNT 1 STREAMS demo:xautoclaim:64 '>'
sleep 1
redis-cli XAUTOCLAIM demo:xautoclaim:64 workers worker-b 0 0-0 COUNT 10
redis-cli XPENDING demo:xautoclaim:64 workers - + 10
# 演示假定任务已处理成功,再执行确认
redis-cli XACK demo:xautoclaim:64 workers 1-0
redis-cli XPENDING demo:xautoclaim:64 workers预期结果:XGROUP CREATE 返回 OK,XADD 返回 1-0;XAUTOCLAIM 认领消息 1-0(字段 job=invoice-1),返回游标 0-0。第一次 XPENDING 显示所有者变为 worker-b,投递次数为 2;XACK 返回 1,第二次 XPENDING 的待确认总数为 0。Redis 7.0+ 的认领响应第三部分在此例中为空。
恢复链路与风险
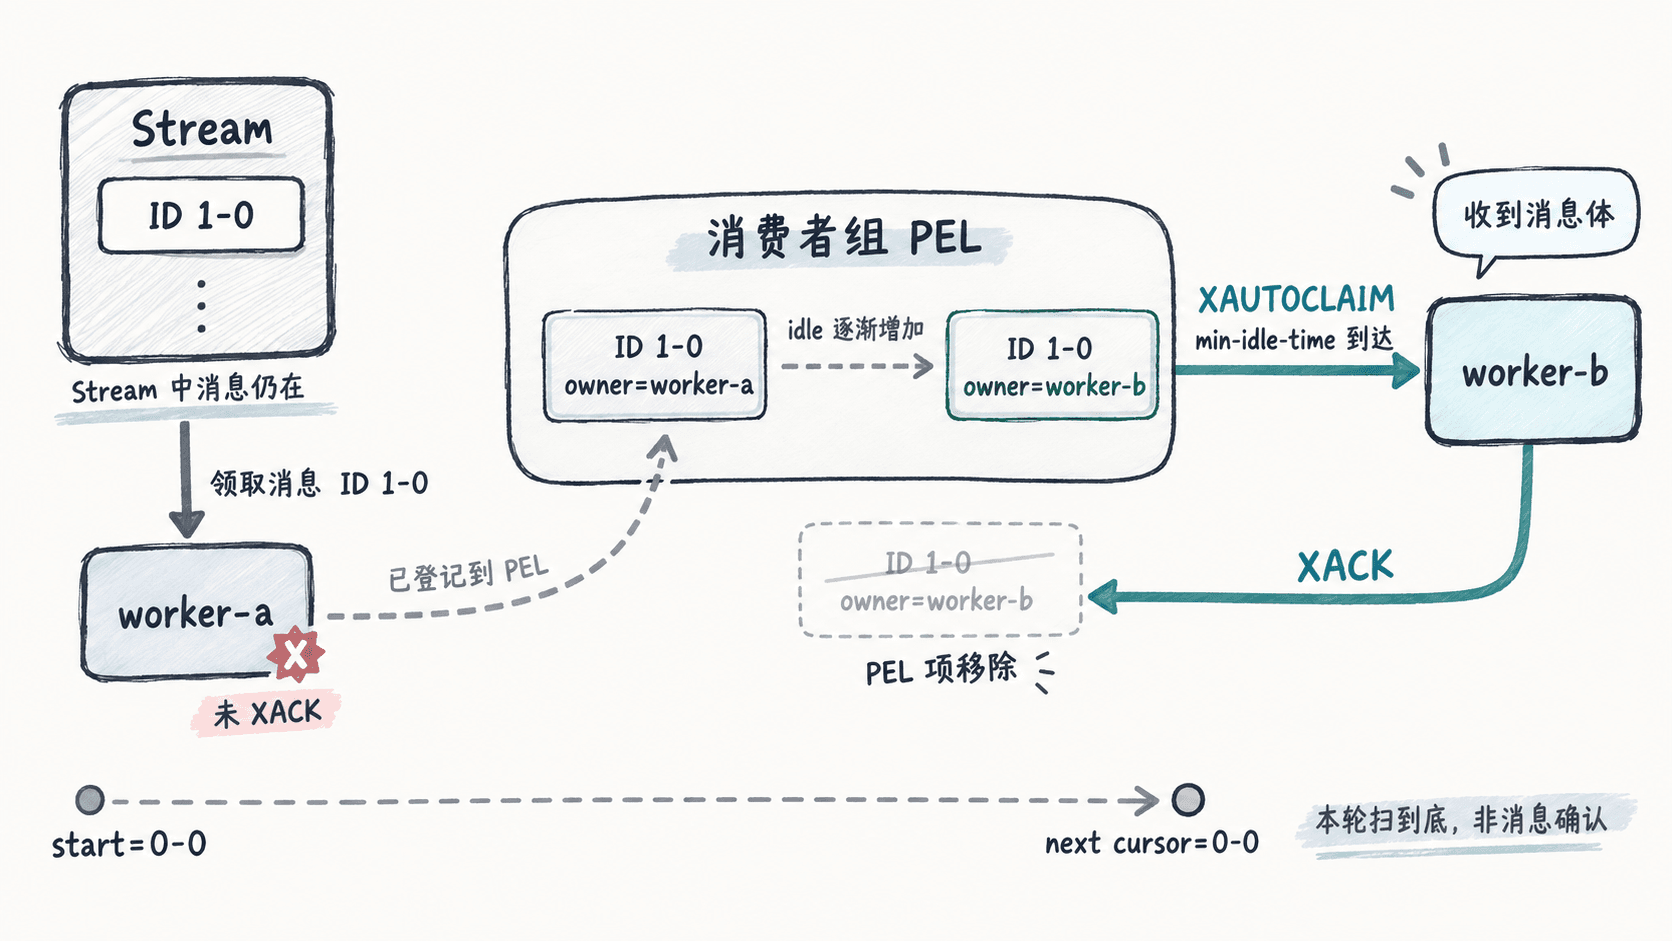
实际恢复程序应按返回游标持续调用,直到遇到 0-0 再结束本轮;周期性重新启动扫描。每条消息需按任务 ID 做幂等处理,只有业务处理成功才 XACK。若重复失败,应记录投递次数、设置重试上限,并转入人工排查或专门的失败处理流程。
若返回 NOGROUP,先核对键名与消费者组是否存在,别在生产环境盲目新建同名组。XACK 只从该组的 PEL 移除确认记录,不会删除 Stream 消息;如需检查待确认积压,可运行 XPENDING key group。
XTRIM key <MAXLEN | MINID> [= | ~] threshold [LIMIT count] [KEEPREF | DELREF | ACKED]按长度或最小消息 ID 清理旧 Stream 记录,适合限制内存和保留期限;必须明确待确认引用的处理策略,避免未消费完的数据被提前删除。
裁剪 Stream 保留量
需要限制 Redis Stream 的记录数量,或按消息 ID 清理旧数据时使用 XTRIM。它从流的最旧记录开始裁剪,返回实际删除条数;若 Stream 已绑定消费者组,必须同时考虑待确认消息的 PEL 引用,否则可能造成无法重试的任务丢失。
基本语法
XTRIM key <MAXLEN | MINID> [= | ~] threshold [LIMIT count] [KEEPREF | DELREF | ACKED]这是一条命令格式,尖括号和方括号用于标注可选项,不要照字面输入。
MAXLEN:按保留条数裁剪。threshold为非负整数,优先删除最旧的消息。MINID:删除 ID 小于threshold的记录,等于边界 ID 的记录保留;适合用消息 ID 设定下界。=:精确裁剪,默认值;~:近似裁剪,利用内部节点批量回收,可能保留更多记录。LIMIT count:限制近似裁剪一次检查的条目数,0表示不限制;不能把它当作保留条数。- 返回值:本次实际删除的 Stream 记录数量;
0不一定是错误,也可能因未超出阈值或确认条件未满足而没有删除。
消费者组引用策略
| 策略 | Stream 记录 | 消费者组 PEL | 使用边界 |
|---|---|---|---|
KEEPREF(默认) |
按阈值删除 | 保留被删记录的待确认引用 | 可能出现 PEL 中有 ID、消息体已不存在 |
DELREF |
按阈值删除 | 同时删除所有组中的相关引用 | 即使尚未确认,也失去原有重试线索 |
ACKED |
仅删除所有消费者组均已确认的合格记录 | 不强行移除未确认引用 | 保护未完成任务,但保留量可能高于 MAXLEN |
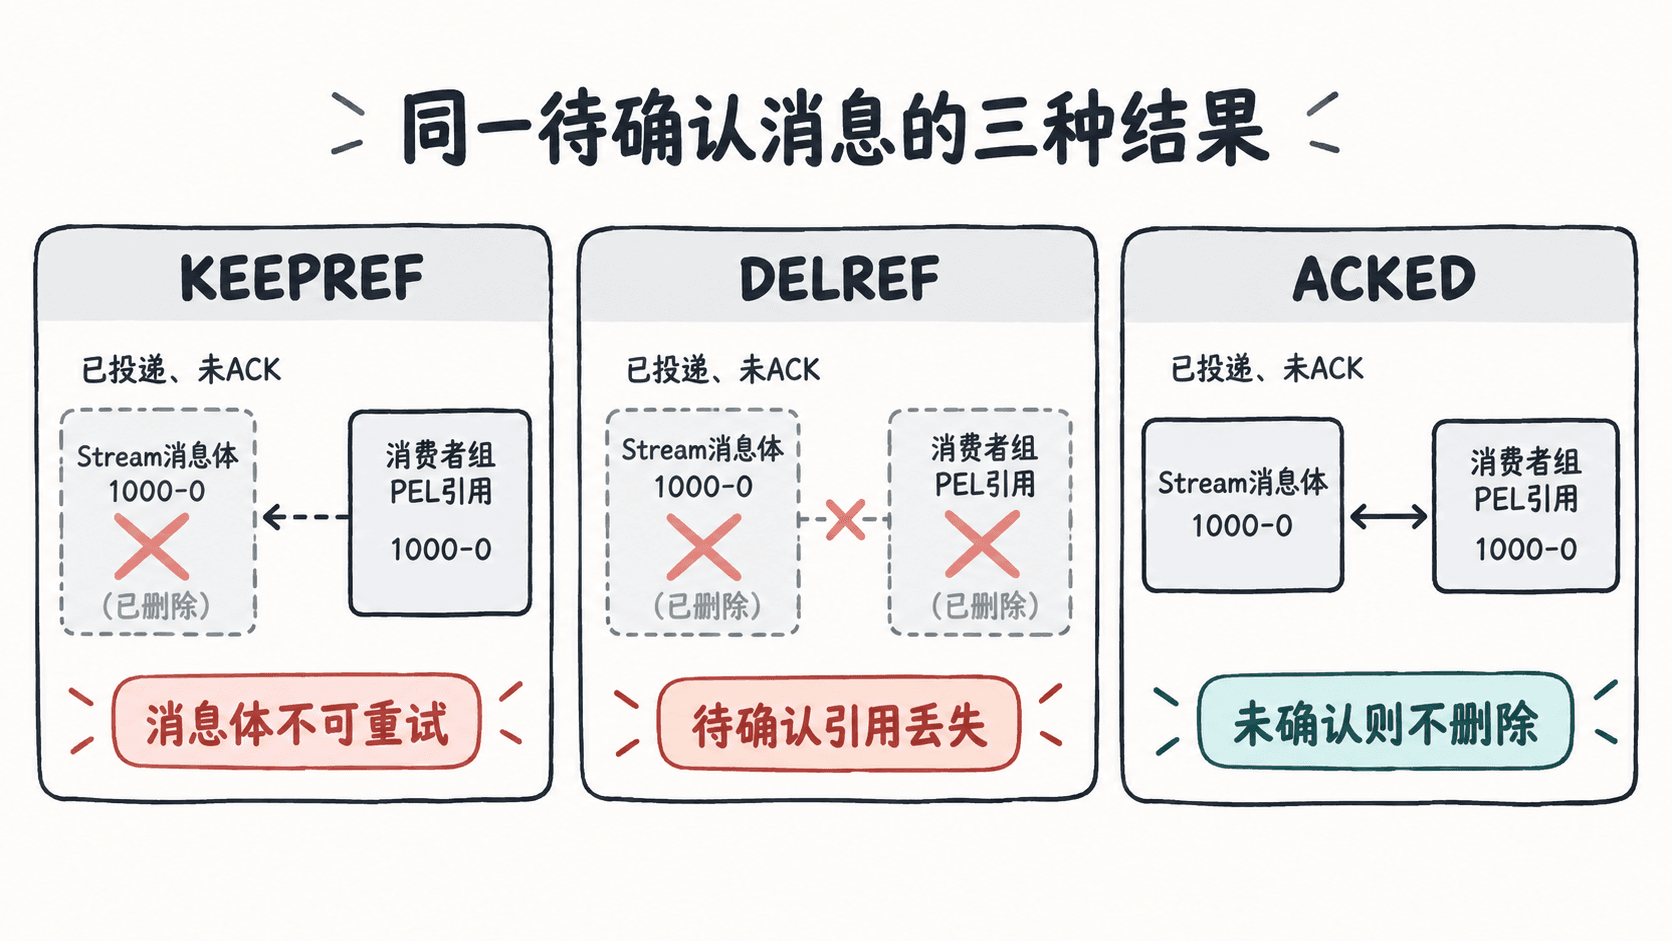
ACKED 只保证满足确认条件的旧记录可被清理,不保证一定达到指定长度。没有消费者组时,这三种引用策略不影响裁剪结果。
可验证示例
以下在 Redis 8.2+ 和可连接的本地 redis-cli 环境中运行。脚本使用带时间戳后缀的独立测试键,不触及业务 Stream;先让第一条消息处于待确认状态,再验证 ACKED 的保护行为。
# 以新测试键验证未确认消息不会被 ACKED 裁剪
key="demo:xtrim:$(date +%s%N)"
redis-cli XADD "$key" 1000-0 event A >/dev/null
redis-cli XADD "$key" 1001-0 event B >/dev/null
redis-cli XGROUP CREATE "$key" workers 0 >/dev/null
redis-cli XREADGROUP GROUP workers c1 COUNT 1 STREAMS "$key" '>' >/dev/null

redis-cli --raw XTRIM "$key" MAXLEN = 1 ACKED
redis-cli --raw XLEN "$key"
# 确认第一条消息后,再尝试裁剪
redis-cli --raw XACK "$key" workers 1000-0
redis-cli --raw XTRIM "$key" MAXLEN = 1 ACKED
redis-cli --raw XLEN "$key"
预期输出(依次对应最后五条查询与变更命令):
0
2
1
1
1
首次裁剪返回 0,因为最旧消息仍待确认;XACK 返回 1 后,第二次裁剪删除一条,XLEN 降为 1。可再用 XRANGE 检查剩余消息是否为 1001-0;生产环境应结合 XPENDING 和 XINFO GROUPS 检查各组积压情况。
风险、版本与恢复
XTRIM 会真正删除消息体,不能用 XACK 或恢复 PEL 引用把数据找回来。执行前先确认下游消费与归档进度;误删后的恢复依赖提前准备的备份或上游事件重放,无法保证原 ID、消费者状态自动复原。
Redis 5.0 起支持 XTRIM 与 MAXLEN,6.2 起支持 MINID 和 LIMIT,8.2 起才支持 KEEPREF、DELREF、ACKED。旧版本不要直接套用本例的 ACKED 命令。MINID 按消息 ID 比较而不是按键 TTL 删除,使用自定义 ID 时尤其不能将其等同于时间到期。
事务与原子逻辑
WATCH key [key ...]在执行事务前监视一个或多个键,若提交前被其他客户端修改则中止执行;适合乐观并发控制,但失败后需要在业务侧重新读取并重试。
监视事务依赖键
当业务需要先读取 Redis 中的值,再根据读取结果执行事务写入时,使用 WATCH 防止并发修改导致旧数据被覆盖。它提供乐观并发控制:提交前只要任意被监视键发生变化,EXEC 就会放弃整个事务队列,业务需要重新读取并尝试提交。
基本语法
WATCH key [key ...]key:必须指定的被监视键。[key ...]:可选的其他被监视键,可以一次监视多个键。- 返回值:成功建立监视后返回
OK,不代表事务已经执行。
WATCH 必须在 MULTI 之前调用,并且与后续的读取、MULTI、EXEC 使用同一个 Redis 连接。一个连接可以多次调用 WATCH,新增的键会加入当前监视集合。
正确的业务顺序是:
- 调用
WATCH监视所有影响决策的键。 - 使用
GET、HGET等命令读取当前值,并在业务侧计算目标结果。 - 调用
MULTI,将写入命令加入事务队列。 - 调用
EXEC,根据返回值判断提交是否成功。
WATCH 不会阻止其他客户端写入,也不会锁定键。它只让当前连接上的事务提交变成有条件的操作。
提交与冲突验证
前置条件:本机 Redis 服务已启动,redis-cli 可以连接到默认实例。以下使用独立的 demo:watch:qty 测试键,先演示正常提交,再通过同一连接主动修改被监视键来稳定复现冲突。
# 初始化测试数据
redis-cli SET demo:watch:qty 10

# WATCH、读取和事务提交必须使用同一个连接
redis-cli --no-raw <<'REDIS'
WATCH demo:watch:qty
GET demo:watch:qty
MULTI
SET demo:watch:qty 9
EXEC
WATCH demo:watch:qty
GET demo:watch:qty
SET demo:watch:qty 7
MULTI
SET demo:watch:qty 6
EXEC
GET demo:watch:qty
REDIS
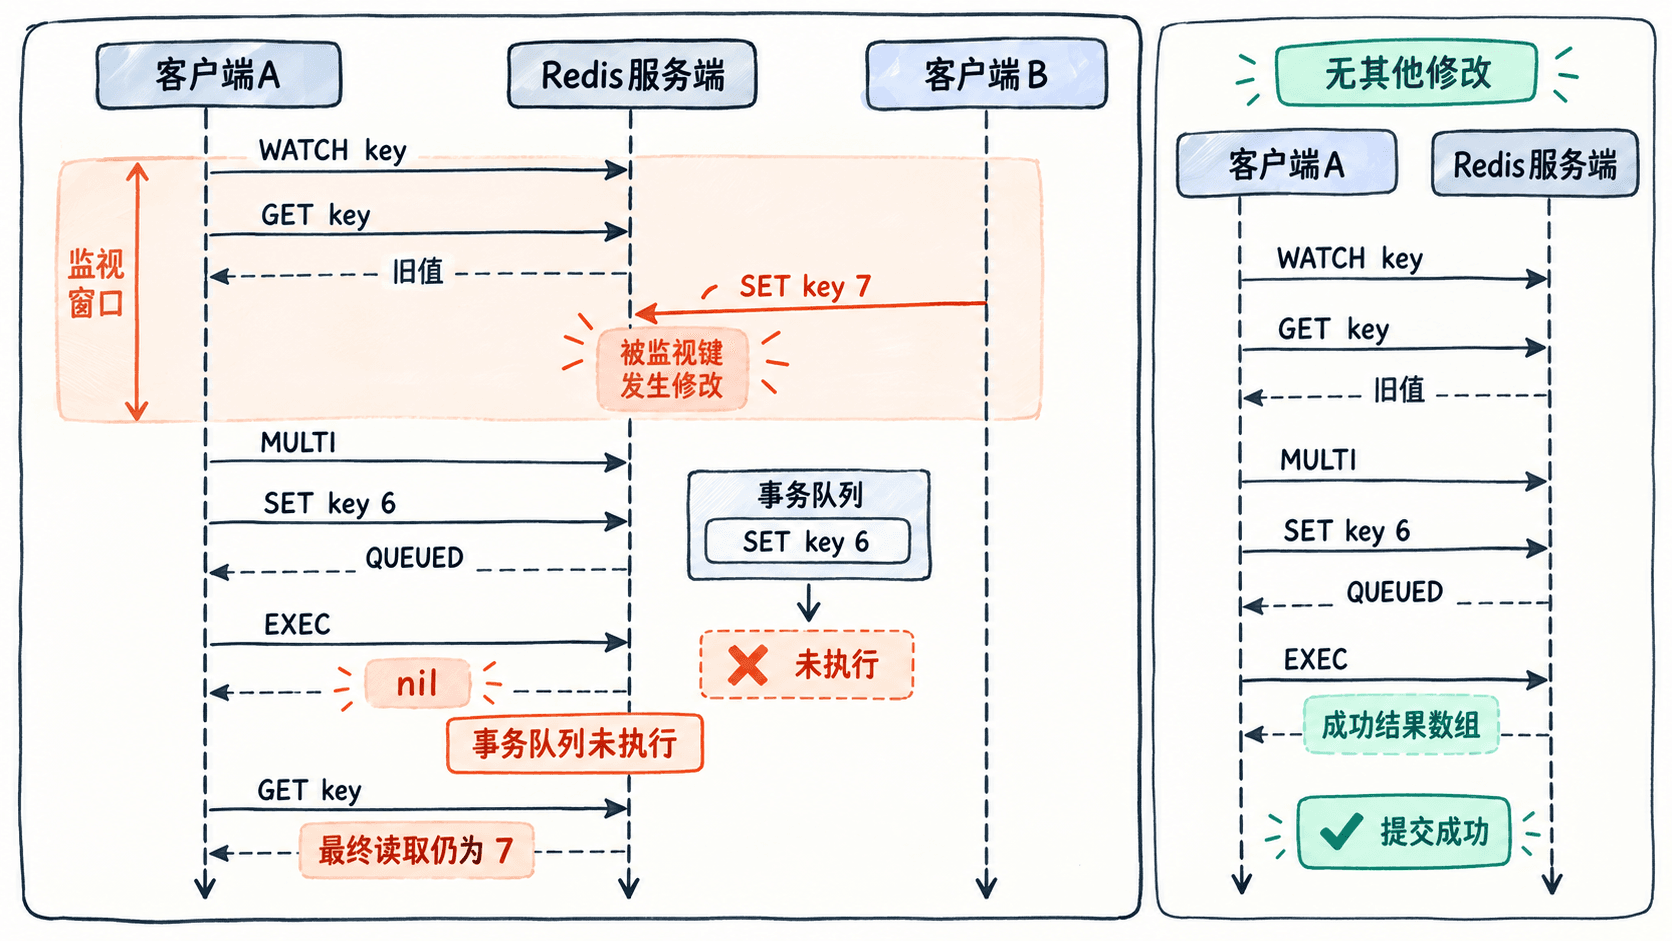
预期结果:初始化返回 OK;第一轮 GET 返回 10,EXEC 返回包含一个 OK 的数组,表示写入 9 成功。第二轮读取 9 后,在 WATCH 与 EXEC 之间主动执行 SET ... 7,因此第二次 EXEC 返回 (nil),排队写入的 6 不会执行,最终 GET 返回 7。
这里故意使用同一客户端修改键,便于不依赖并发时机地复现。实际业务中,如果另一个客户端在监视期间修改相同键,也会造成相同的事务中止结果。
结果判定与重试
WATCH 的冲突判断发生在 EXEC 执行时,而不是 MULTI 或写入命令排队时。即使 SET 已返回 QUEUED,只要监视条件失败,队列中的命令就不会执行。
EXEC 结果 |
含义 | 业务处理 |
|---|---|---|
| 非空数组 | 监视检查通过,事务队列已执行 | 检查数组中各命令的执行结果 |
| Nil(RESP2)或 Null(RESP3) | 被监视键发生修改,事务中止 | 重新读取数据并重试整个事务 |
| 命令执行错误 | 事务内部某条命令执行失败 | 按具体错误处理,不能直接当作监视冲突 |
发生监视冲突后,不能直接重发原来的 MULTI 和写入命令,因为原先读取的数据已经可能过期。应重新执行以下操作:
- 重新建立
WATCH,读取当前键值。 - 根据最新数据重新计算目标值和业务条件。
- 重新执行
MULTI、写入命令与EXEC。 - 再次冲突时采用有限次数重试和短暂退避;超过上限则向调用方报告并发冲突。
例如库存初始为 10,客户端 A 读取后计划扣减 1,客户端 B 先将库存改为 7。A 的事务中止后,必须重新读取 7,验证库存是否仍满足条件,再决定是否写入 6,而不能直接提交旧计算结果 9。
边界与恢复
- 监视范围:只监视本次事务决策依赖的键。若读取两个键共同决定写入结果,应同时监视这两个键;任意一个变化都可能导致提交失败。
- 修改来源:其他客户端写入、当前客户端在事务外写入,以及 Redis 自身的过期或淘汰行为都可能使监视条件失效。Redis 6.0.9 起,被监视键过期也会导致事务中止;更早版本对此行为不同。
- 连接限制:监视状态属于 Redis 连接。分别执行独立的
redis-cli WATCH ...和redis-cli EXEC不能组成有效的监视事务;连接断开后也不能沿用原监视状态。 - 主动取消:不再需要监视时使用
UNWATCH;EXEC或DISCARD结束事务时也会清除监视状态。 - 失败恢复:监视冲突导致的事务中止不会执行已排队的写入,因此不需要回滚这些写入。重新读取、校验并重试即可。但已经在
MULTI外执行的命令不会被撤销。 - 事务错误:
WATCH不是通用回滚机制。即使监视检查通过,事务内命令仍可能出现运行时错误,Redis 不会因此自动回滚其他已执行命令。
测试结束后,可运行 redis-cli DEL demo:watch:qty 清理示例键。预期返回 1 表示删除成功,返回 0 表示键已不存在;不要对真实业务键执行该清理命令。
速查提示:WATCH 判断的是从建立监视到执行 EXEC 期间键是否被修改,不是比较键的最终值是否相等。提交失败后必须重新读取和重新计算,不能复用旧结果。
MULTI进入事务命令排队模式,后续命令会先入队再由 EXEC 统一执行;适合多命令原子提交,但不提供关系型数据库那样的自动回滚。
开启命令事务队列
需要将多条 Redis 命令作为一个原子操作批次提交时,使用 MULTI 开启事务队列。后续命令先排队,直到执行 EXEC 才按顺序真正运行。适合同时更新多个关联键,但不会自动回滚已经执行的写入。
基本语法
MULTIMULTI 不接受参数,成功时返回 OK,表示当前客户端连接已进入事务模式。
MULTI:开启当前连接的事务队列。QUEUED:普通命令已成功入队,尚未执行,不代表业务操作成功。EXEC:依次执行已排队命令,返回各命令的执行结果。DISCARD:清空尚未执行的事务队列,并退出事务模式。
事务状态属于客户端连接。不能分别使用独立的 redis-cli MULTI 和 redis-cli EXEC 进程来完成同一事务,因为两次调用通常使用不同连接。
完整示例与预期结果
前置条件:本机 Redis 服务运行在默认地址 127.0.0.1:6379,已安装 redis-cli,当前连接具有写入权限。示例使用独立的演示键,执行前应确认不会覆盖现有业务数据。
# 使用同一个 redis-cli 连接提交整个事务
redis-cli <<'REDIS'
MULTI
SET demo:txn:counter 10
INCR demo:txn:counter
GET demo:txn:counter
EXEC
GET demo:txn:counter
REDIS
预期结果:
MULTI返回OK,表示事务队列已开启。SET、INCR和事务内的GET分别返回QUEUED,此时它们尚未执行。EXEC返回三个按入队顺序排列的结果:SET的OK、INCR的整数11、GET的字符串11。- 最后一条独立的
GET返回11,证明事务中的写入已经生效。
不同终端模式下,redis-cli 对数组、整数和字符串的显示格式可能不同,但上述返回值及顺序应一致。
注意:事务内部的 GET 在入队时不会立即返回键值,因此不能直接利用该返回值在同一个事务队列中决定下一条命令。
原子执行与并发边界
MULTI 只负责开启排队模式,真正的原子执行发生在 EXEC 阶段。在普通 Redis 单实例中,事务内的命令按顺序执行,其他客户端的命令不会插入这组命令之间。
这不代表事务自动具有读取快照或并发冲突检测能力。如果业务需要先读取值、再判断条件、最后写入,可以在 MULTI 之前使用 WATCH key 监视相关键。若被监视的键在提交前发生变化,EXEC 会放弃事务,客户端需要重新读取并重试。
Redis Open Source Cluster 中,事务涉及的多个键还需满足同一哈希槽等集群约束;单实例跨键事务的写法不能直接假定适用于跨槽操作。
风险与恢复
- 提交前取消:在同一连接中执行
DISCARD,返回OK,清空未执行的命令并退出事务模式。已经存在于 Redis 中的数据不会因这次取消而改变。 - 入队阶段出错:命令语法错误等问题可能使事务无法通过
EXEC提交,并返回EXECABORT。应检查错误命令,退出当前事务状态后重新组织事务。 - 执行阶段出错:检查
EXEC返回数组中的每项结果。已经成功执行的写入不会自动撤销,应根据业务记录的旧值执行补偿操作,或使用已验证的备份恢复方案。 - 并发修改冲突:使用
WATCH时,若EXEC因被监视的键发生变化而返回空结果,应重新读取最新数据、重新计算并重试,而不是假定事务已成功。
MULTI 自 Redis Open Source 1.2.0 起可用。速查时记住:MULTI 开始排队,EXEC 执行队列,DISCARD 仅能取消尚未提交的队列;提交后的变更不能通过 DISCARD 撤销。
EXEC执行 MULTI 期间排队的命令并恢复普通模式,适合完成一次原子命令批次;若 WATCH 检测到键变化,整个批次会被放弃并返回空结果。
提交排队事务
当同一 Redis 连接已经通过 MULTI 将多条命令加入事务队列,需要一次性执行这些命令时,使用 EXEC。Redis 会按入队顺序连续执行命令,执行期间不会插入其他客户端的命令;完成后连接恢复普通命令模式。
如果此前使用 WATCH 监视键,则 EXEC 还会检查这些键是否发生变化。发现冲突时放弃整个事务,避免基于过期数据提交更新。
基本语法
EXECEXEC 不接受参数,必须在已经执行 MULTI 的同一连接中调用。通过独立的 redis-cli EXEC 进程提交另一连接中的事务是不成立的。
相关命令的职责如下:
MULTI:开启事务,后续普通命令进入队列并返回QUEUED。EXEC:提交并执行队列中的命令,然后退出事务模式。DISCARD:放弃尚未执行的队列,并退出事务模式。WATCH key [key ...]:在MULTI之前监视键,使事务提交具有条件检查能力。
正常执行时,EXEC 返回一个数组,每个元素对应一条入队命令的执行结果,顺序与入队顺序一致。成功提交空事务时返回空数组;没有处于事务模式时执行 EXEC 会收到错误。
提交示例
前置条件:本机 Redis 服务已启动,redis-cli 可以连接到默认地址 127.0.0.1:6379。以下示例会覆盖测试键 demo:exec:count,应在测试环境运行。
# 使用同一个 redis-cli 连接完成整个事务
redis-cli --raw <<'REDIS'
SET demo:exec:count 0
MULTI
INCR demo:exec:count
INCR demo:exec:count
EXEC
GET demo:exec:count
REDIS预期输出(--raw 模式):
OK
OK
QUEUED
QUEUED
1
2
2
第一个 OK 表示测试键初始化成功,第二个 OK 表示进入事务模式。两个 QUEUED 表示递增命令已经排队,此时尚未执行。
EXEC 返回的 1 和 2 分别对应两次 INCR 的执行结果。最后的 GET 在事务结束后执行,返回字符串值 2,验证两次递增均已生效。
提交结果与并发冲突
使用 WATCH 时,需要区分事务正常提交与并发修改导致的提交失败。假设客户端 A 先监视 demo:exec:count,随后客户端 B 在 A 执行 EXEC 之前修改该键。
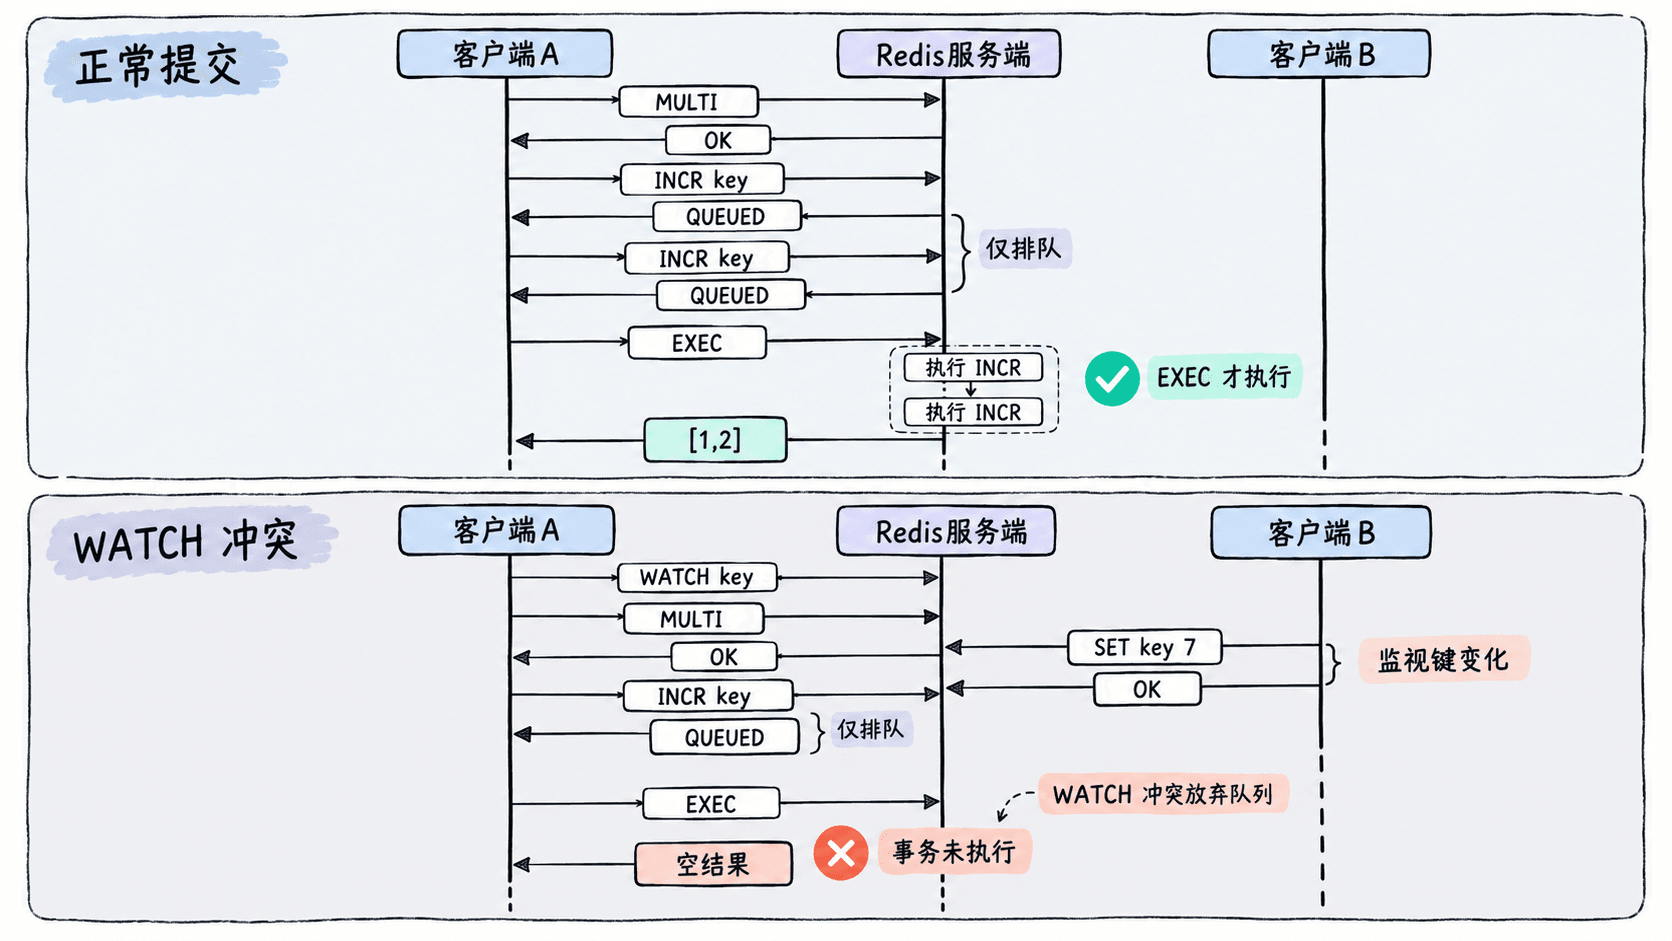
可按以下结果判断提交状态:
| 返回情况 | 含义 | 处理方式 |
|---|---|---|
| 数组回复 | 事务已进入执行阶段 | 逐项检查命令结果 |
| 空数组 | 空事务正常提交 | 无命令需要执行 |
| RESP2 的 Nil 或 RESP3 的 Null | WATCH 检测到冲突,事务整体放弃 |
重新读取数据并重试 |
EXECABORT 错误 |
队列阶段发生错误,事务被拒绝执行 | 修正入队命令后重新开始 |
| 数组中包含错误回复 | 对应命令执行失败,其他命令仍可能成功 | 检查实际写入结果并补偿 |
redis-cli 对空结果的显示会随协议模式和输出选项变化。应用程序应区分空数组、空值和包含错误元素的数组,不能仅凭结果是否为空字符串判断事务成功。
风险与恢复
事务不会自动回滚
Redis 事务保证排队命令连续执行,但不提供传统数据库式的自动回滚。如果某条命令在执行阶段发生类型错误,例如对字符串键执行列表操作,其他已排队命令仍会继续执行。
自 Redis 2.6.5 起,服务器会记录事务排队阶段的错误,并在 EXEC 时拒绝执行整个事务。需要区分排队错误与执行阶段错误,不能把两者都当作 WATCH 冲突处理。
提交失败后的处理
- 如果尚未执行
EXEC,可以使用DISCARD放弃整个队列,避免错误操作被提交。 - 如果
EXEC因WATCH冲突返回空值,应重新执行WATCH、读取当前值、计算更新、MULTI排队和EXEC;重试次数应设置上限。 - 如果
EXEC返回包含错误的数组,先检查各项结果及相关键的最终值。已成功执行的写操作不会自动撤销,必要时执行经过验证的补偿命令。 - 如果提交时发生网络中断,客户端可能无法确认服务器是否已经执行事务,不要直接无条件重放非幂等写操作;应先核对业务状态或使用幂等请求标识。
速查:MULTI 负责排队,EXEC 负责执行,DISCARD 负责提交前放弃;配合 WATCH 时,空值回复表示并发检查未通过,应用端需要重新读取并决定是否重试。
DISCARD清空 MULTI 中尚未执行的命令并退出事务模式,适合构造交易失败时主动取消;它不能撤销已被 EXEC 执行的写入。
放弃未提交的事务
当 MULTI 中已经排队的命令不应继续提交时,使用 DISCARD 取消整个待执行事务。成功后,命令队列被清空,当前连接退出事务模式,后续命令恢复正常执行。它适用于业务校验失败、交易参数需要重新计算或主动取消尚未提交的操作。
基本语法
DISCARD这是 Redis 命令,需在 redis-cli 交互会话或保持同一连接的 Redis 客户端中执行,不能直接作为独立的操作系统 Shell 命令运行。
DISCARD 不接受参数,也不需要指定键名。执行前,当前连接必须已通过 MULTI 进入事务模式。
- 成功返回
OK:待执行命令队列已清空,事务模式结束。 - 尚未执行的写入不会生效:此前返回
QUEUED的命令被直接丢弃。 - 同时取消 WATCH 监视:如果当前连接使用了
WATCH,被监视的键也会解除监视。 - 事务外调用报错:没有活动的
MULTI事务时,不能执行DISCARD。
该命令自 Redis 2.0.0 起可用,时间复杂度为 O(N),其中 N 是被丢弃的排队命令数量。
完整示例与预期结果
以下示例需要一个可写的测试 Redis 实例,并已安装 redis-cli。假设可以使用默认连接参数访问 Redis,且演示键没有其他客户端同时修改。
# 使用同一连接完成入队、取消和结果验证
redis-cli --raw <<'REDIS'
SET demo:discard:69 10
MULTI
SET demo:discard:69 7
DISCARD
GET demo:discard:69
DEL demo:discard:69
REDIS
预期输出:
OK
OK
QUEUED
OK
10
1
结果依次表示:
- 第一个
OK:事务外的SET已执行,原始值设为10。 - 第二个
OK:MULTI成功开启事务模式。 QUEUED:将值改为7的操作仅进入队列,没有真正执行。- 第三个
OK:DISCARD清空队列并结束事务。 10:执行GET后仍能读取原始值,证明排队的写入没有发生。1:最后使用DEL删除演示键,成功删除一个键。
这里通过一次 redis-cli 会话执行全部命令,是因为事务状态属于客户端连接。不能用多个独立的 redis-cli MULTI、redis-cli SET、redis-cli DISCARD 进程来模拟同一个事务。
与 EXEC、UNWATCH 的区别
| 命令 | 对排队命令的影响 | 对事务状态的影响 |
|---|---|---|
EXEC |
执行已排队命令 | 结束事务并清除 WATCH 监视 |
DISCARD |
丢弃所有已排队命令,不执行 | 结束事务并清除 WATCH 监视 |
UNWATCH |
不清空命令队列 | 仅解除当前连接的键监视,不用于取消事务 |
如果使用 WATCH 保护并发修改,执行 DISCARD 后再次尝试交易时,需要重新建立监视、重新读取相关数据,再通过 MULTI 构造新的事务。原来的监视关系不会自动保留。
风险与恢复
如果业务校验发现错误,但还没有发送 EXEC,应立即在同一连接上执行 DISCARD,避免错误命令继续留在队列里。取消成功后,可以重新检查业务条件,重新执行 MULTI 并构造正确的命令。
如果 EXEC 已经执行,则无法使用 DISCARD 回滚结果。需要根据业务记录执行补偿写入,或在符合恢复条件时从备份恢复数据。Redis 事务不提供传统数据库式的自动回滚机制。
对于连接池或长连接客户端,还应避免把未完成的事务连接直接交给其他业务请求。发生异常时,应在连接仍有效且事务尚未提交的情况下取消事务;无法确认连接状态时,应关闭该连接并重新建立连接。
速查:MULTI 之后、EXEC 之前需要放弃整个事务,用 DISCARD;已经执行 EXEC,则不能靠 DISCARD 撤销。
EVAL script numkeys [key [key ...]] [arg [arg ...]]在服务端执行一段 Lua 逻辑,适合把小范围多步判断合并为原子操作;脚本执行会占用服务端处理时间,务必控制耗时与键访问范围。
执行临时 Lua 脚本
需要把“读取当前值、判断条件、更新键”合成一次不可插入的服务端操作时,使用 EVAL。它适合短小的限额判断、条件更新等逻辑;脚本执行期间,其他客户端命令不能穿插执行。
基本语法
EVAL script numkeys [key [key ...]] [arg [arg ...]]
script:Lua 源码,Redis 使用内置 Lua 5.1 解释器。numkeys:紧随其后的键名数量;不访问任何键时填0。key ...:按顺序映射到脚本的KEYS[1]、KEYS[2]等。arg ...:普通参数,映射到ARGV[1]、ARGV[2]等;不要把键名藏在这里。redis.call(...):调用 Redis 命令,遇到命令错误会中止脚本并返回错误。
最小连通性检查是 EVAL 'return 1' 0,预期返回整数 1。
条件递增示例
前置条件:已安装 redis-cli,能够访问测试用 Redis 实例。以下先将演示键设为 2,只有当前值小于上限 3 时才递增。
# 仅在测试实例执行:SET 会覆盖演示键原值
redis-cli --raw SET demo:eval:quota 2
# KEYS[1] 是计数键,ARGV[1] 是上限
script='local n = tonumber(redis.call("GET", KEYS[1]) or "0"); if n < tonumber(ARGV[1]) then return redis.call("INCR", KEYS[1]) end; return n'
redis-cli --raw EVAL "$script" 1 demo:eval:quota 3
redis-cli --raw EVAL "$script" 1 demo:eval:quota 3
redis-cli --raw GET demo:eval:quota预期输出(--raw 模式,依次对应四次 redis-cli 调用):
OK
3
3
3
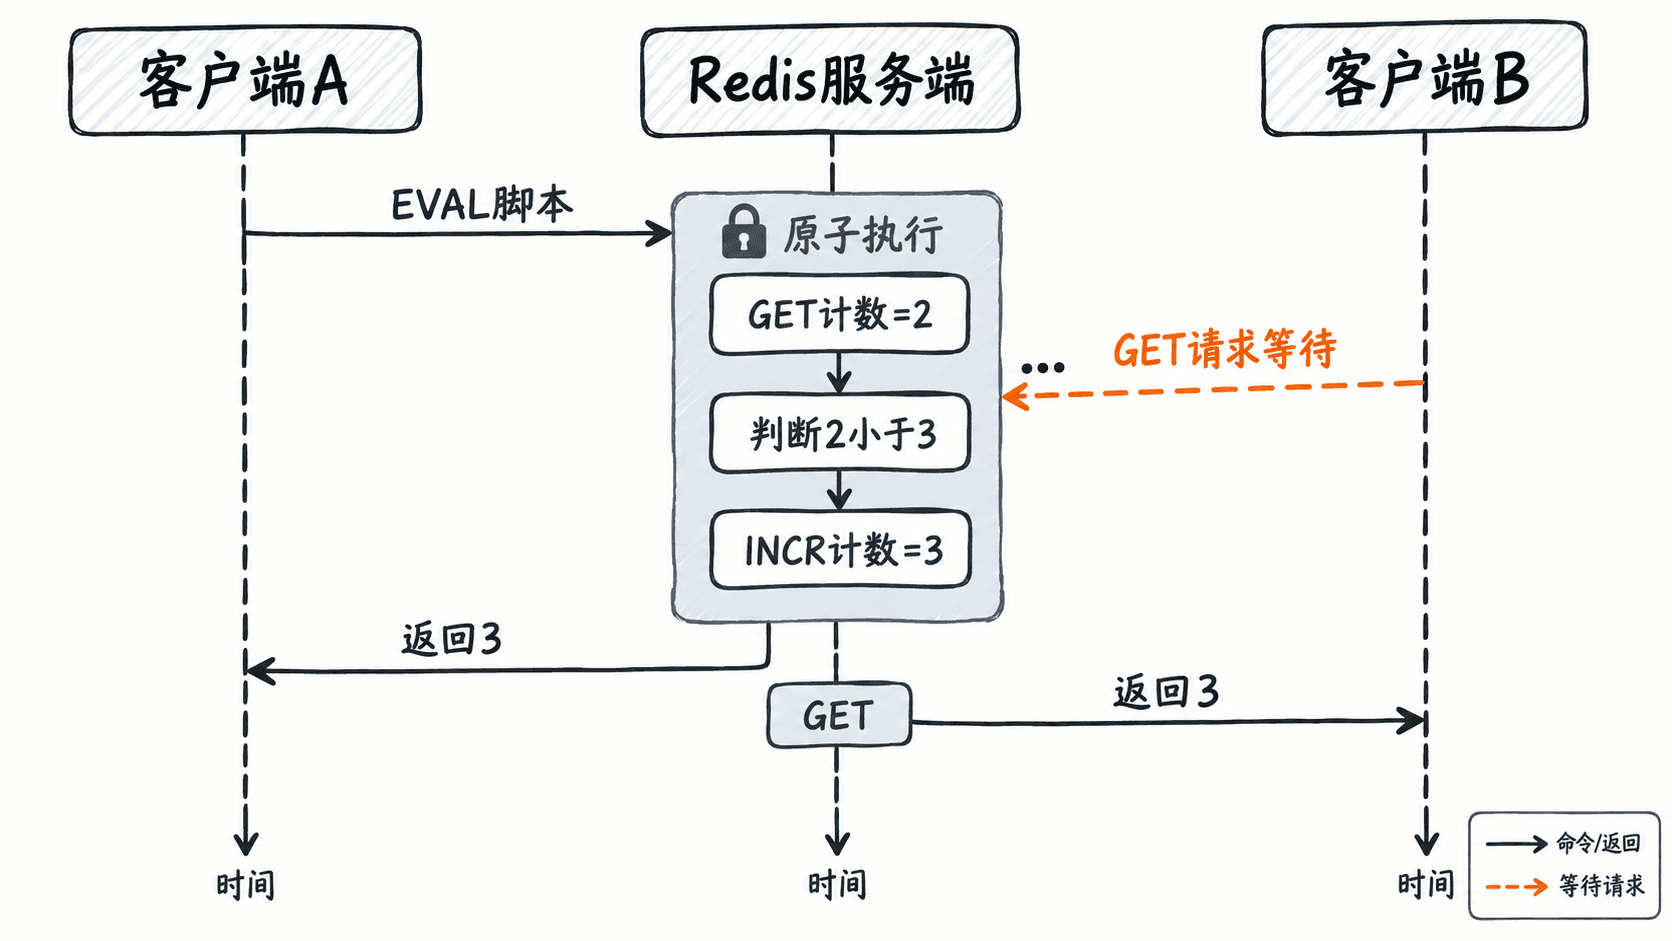
第一次 EVAL 将计数从 2 加到 3;第二次因已达到上限而直接返回 3。最后的 GET 验证键值仍为 3。脚本的返回值由 return 表达式决定,不是固定的成功状态码。
原子执行边界
EVAL 内部的 GET、条件判断和 INCR 在同一次脚本执行中完成。即使客户端 B 在脚本运行时发出读取请求,Redis 也不会在脚本内部插入该请求;B 只能在本次脚本完成后得到结果。
风险与恢复
- 阻塞时间:脚本运行期间其他客户端命令需等待。不要在脚本中进行大量遍历或无界循环;慢脚本可能使 Redis 长时间无法响应。
- 原子性不等于回滚:如果脚本已写入数据,随后又触发错误,先前写入不会自动撤销。先检查相关键的实际状态,再按业务规则补偿;不要盲目重试可能重复写入的脚本。
- 键范围:所有访问的键名都应由
key ...显式传入;Redis Cluster 中,同一脚本传入的多个键应属于同一哈希槽。键类型不是字符串或现有值不是数字时,本例可能报错,先检查数据类型和值。
EVAL 自 Redis 2.6.0 起可用。若脚本会频繁复用,可考虑 SCRIPT LOAD 配合 EVALSHA;不能假定脚本缓存永久存在。
SCRIPT LOAD script将 Lua 脚本加载到服务器缓存并返回 SHA1,适合频繁调用的固定原子逻辑;脚本缓存可能被清空,业务侧仍需准备重新加载或直接执行。
预加载 Lua 脚本
当一段固定 Lua 脚本需要反复执行,希望避免每次通过 EVAL 发送完整脚本内容时,先用 SCRIPT LOAD 将脚本编译并放入 Redis 脚本缓存。命令返回脚本的 SHA1 摘要,后续可使用 EVALSHA 按摘要执行,减少重复传输。
SCRIPT LOAD 只加载脚本,不执行脚本中的业务操作,也不会因为脚本包含写命令而立即修改数据。
基本语法
SCRIPT LOAD script这里展示的是 Redis 命令语法;在系统终端中执行时,需要使用 redis-cli 等客户端发送命令。
script:必填,完整的 Lua 脚本文本。传入的是脚本源码,不是脚本文件路径。- 返回值:40 位十六进制 SHA1 摘要,用于后续
EVALSHA调用。 - 时间复杂度:
O(N),其中N为脚本内容的字节数。
Redis 根据脚本的实际字节内容计算 SHA1。相同内容重复加载会得到相同摘要;增加空格、换行或修改代码,都可能产生不同摘要。脚本已经存在时,重复加载不会执行脚本,也不需要先删除旧缓存。
加载、检查与执行
前置条件:Redis 服务已启动,系统已安装 redis-cli,且客户端能够连接默认的本地 Redis 实例。需要访问其他实例时,应为各条 redis-cli 命令使用一致的连接参数。
下面使用没有外部依赖、不读取或修改任何键的 Lua 脚本进行验证。
# 只缓存 Lua 脚本,并获取服务器返回的 SHA1
sha=$(redis-cli --raw SCRIPT LOAD 'return 1')
printf 'SHA1=%s\n' "$sha"

# 检查脚本是否存在,再按 SHA1 执行
redis-cli --raw SCRIPT EXISTS "$sha"
redis-cli --raw EVALSHA "$sha" 0
预期输出:
SHA1=e0e1f9fabfc9d4800c877a703b823ac0578ff8db
1
1
三个结果分别表示:
SCRIPT LOAD返回脚本return 1对应的固定 SHA1。SCRIPT EXISTS返回1,说明当前 Redis 实例的脚本缓存中存在该摘要。EVALSHA返回整数1,这是 Lua 脚本真正执行后的结果。
EVALSHA 的基本语法为 EVALSHA sha1 numkeys [key ...] [arg ...]。示例中的 0 表示脚本没有访问 Redis 键,因此不需要传入键名。
对于实际业务脚本,应使用 KEYS 接收键名、ARGV 接收业务参数,避免每次将变化的参数拼入 Lua 源码,否则即使业务逻辑相同,也会产生大量不同的脚本摘要。
缓存失效与恢复
SCRIPT LOAD 建立的是服务器脚本缓存,不是持久化的脚本部署。Redis 重启、故障转移或执行 SCRIPT FLUSH 后,不能假定原来的 SHA1 仍然对应已加载的脚本。切换到另一台 Redis 节点时也应重新确认脚本是否存在。
如果直接使用 EVALSHA 调用未缓存的脚本,Redis 会返回类似以下错误:
NOSCRIPT No matching script. Please use EVAL.这表示当前服务器找不到对应的脚本缓存,并不代表脚本源码已经损坏。应用应保留原始 Lua 源码,并按以下顺序恢复:
- 捕获
EVALSHA返回的NOSCRIPT错误。 - 使用原始源码重新执行
SCRIPT LOAD,取得当前服务器返回的 SHA1。 - 使用取得的 SHA1 和原来的键、参数重新执行
EVALSHA。 - 确认业务返回值符合预期,并记录必要的错误信息供排查。
也可以在缓存缺失时直接使用 EVAL 发送完整源码执行。多数成熟 Redis 客户端提供脚本注册、自动加载和缓存缺失重试机制,优先使用对应客户端已验证的接口。
使用边界与注意事项
- 不要只保存 SHA1:摘要不能还原脚本源码,应用必须能够重新取得对应 Lua 内容。
- 预加载不等于执行:原子业务逻辑在
EVALSHA实际运行时才生效,SCRIPT LOAD成功只说明脚本已加载。 - 批处理需提前准备:在 Pipeline 或
MULTI/EXEC中调用EVALSHA前,应确保目标节点已经加载脚本;不能依赖在同一批处理内部临时捕获NOSCRIPT再安全重试。 - 不要随意清空生产脚本缓存:
SCRIPT FLUSH会影响服务器上的其他缓存脚本,可能造成多个业务同时出现NOSCRIPT。 - Redis Cluster 需关注目标节点:预加载不能视为所有节点永久共享同一份缓存,实际执行节点必须具有相应脚本,业务涉及的键也必须符合集群路由约束。
EVALSHA sha1 numkeys [key [key ...]] [arg [arg ...]]通过已缓存脚本的 SHA1 执行 Lua 逻辑,减少每次传输脚本正文;脚本不存在会返回 NOSCRIPT,应由客户端负责重新加载。
按脚本摘要执行
同一段 Lua 脚本需要反复执行时,先通过 SCRIPT LOAD 将脚本加载到 Redis 并取得 SHA1 摘要,再使用 EVALSHA 调用。这样无需每次发送完整脚本正文,适合计数更新、条件写入等重复执行的原子操作。脚本缓存丢失时需要处理 NOSCRIPT 错误。
基本语法
EVALSHA sha1 numkeys [key [key ...]] [arg [arg ...]]| 参数 | 含义 | 约束 |
|---|---|---|
sha1 |
已缓存 Lua 脚本的 SHA1 摘要 | 40 位十六进制字符串,通常由 SCRIPT LOAD 返回 |
numkeys |
后续键名的数量 | 非负整数,必须与实际传入的键数量一致 |
key |
脚本访问的 Redis 键 | 按顺序映射到 Lua 的 KEYS[1]、KEYS[2] 等 |
arg |
传递给脚本的普通参数 | 按顺序映射到 Lua 的 ARGV[1]、ARGV[2] 等 |
numkeys 只统计键名,不包含普通参数。例如 EVALSHA <sha1> 1 counter 5 表示传入一个键 counter 和一个普通参数 5。若脚本不访问任何键,可以设置 numkeys=0。
EVALSHA 的返回值由 Lua 脚本的 return 决定,可以是整数、字符串、数组或空值等;如果摘要不存在,则返回 NOSCRIPT 错误,而不是执行脚本。
常用示例
以下示例要求本机已有可连接的 Redis 服务,并已安装 redis-cli。脚本使用 INCRBY 给演示计数器增加指定数值,所有命令在 Bash 中依次执行。
# 初始化演示键;SET 会覆盖该键已有的值
redis-cli --raw SET demo:evalsha:count 0

# 加载脚本但不执行,动态取得真实 SHA1 摘要
sha=$(redis-cli --raw SCRIPT LOAD 'return redis.call("INCRBY", KEYS[1], ARGV[1])')

# 检查缓存,再通过摘要执行脚本
redis-cli --raw SCRIPT EXISTS "$sha"
redis-cli --raw EVALSHA "$sha" 1 demo:evalsha:count 5
redis-cli --raw GET demo:evalsha:count
预期输出:
OK
1
5
5
SCRIPT EXISTS 返回 1,说明该 SHA1 对应的脚本存在于当前 Redis 实例的缓存中。EVALSHA 返回 5,最后的 GET 再次确认键值为 5。示例使用 --raw 让命令结果直接显示为原始值;交互式 redis-cli 的整数结果通常带有 (integer) 标记。
SCRIPT LOAD 只缓存脚本,不会执行 INCRBY。实际计数增加发生在 EVALSHA 调用时。后续再次执行同一脚本,可以复用已取得的 SHA1,但每次执行仍会产生脚本本身的计算和写入开销。
缓存失效与恢复
Redis 的脚本缓存不是持久化业务数据。服务重启、故障转移或执行 SCRIPT FLUSH 后,原先缓存的脚本可能不存在。客户端需要识别 NOSCRIPT,重新加载原始脚本,并使用返回的 SHA1 重试执行。
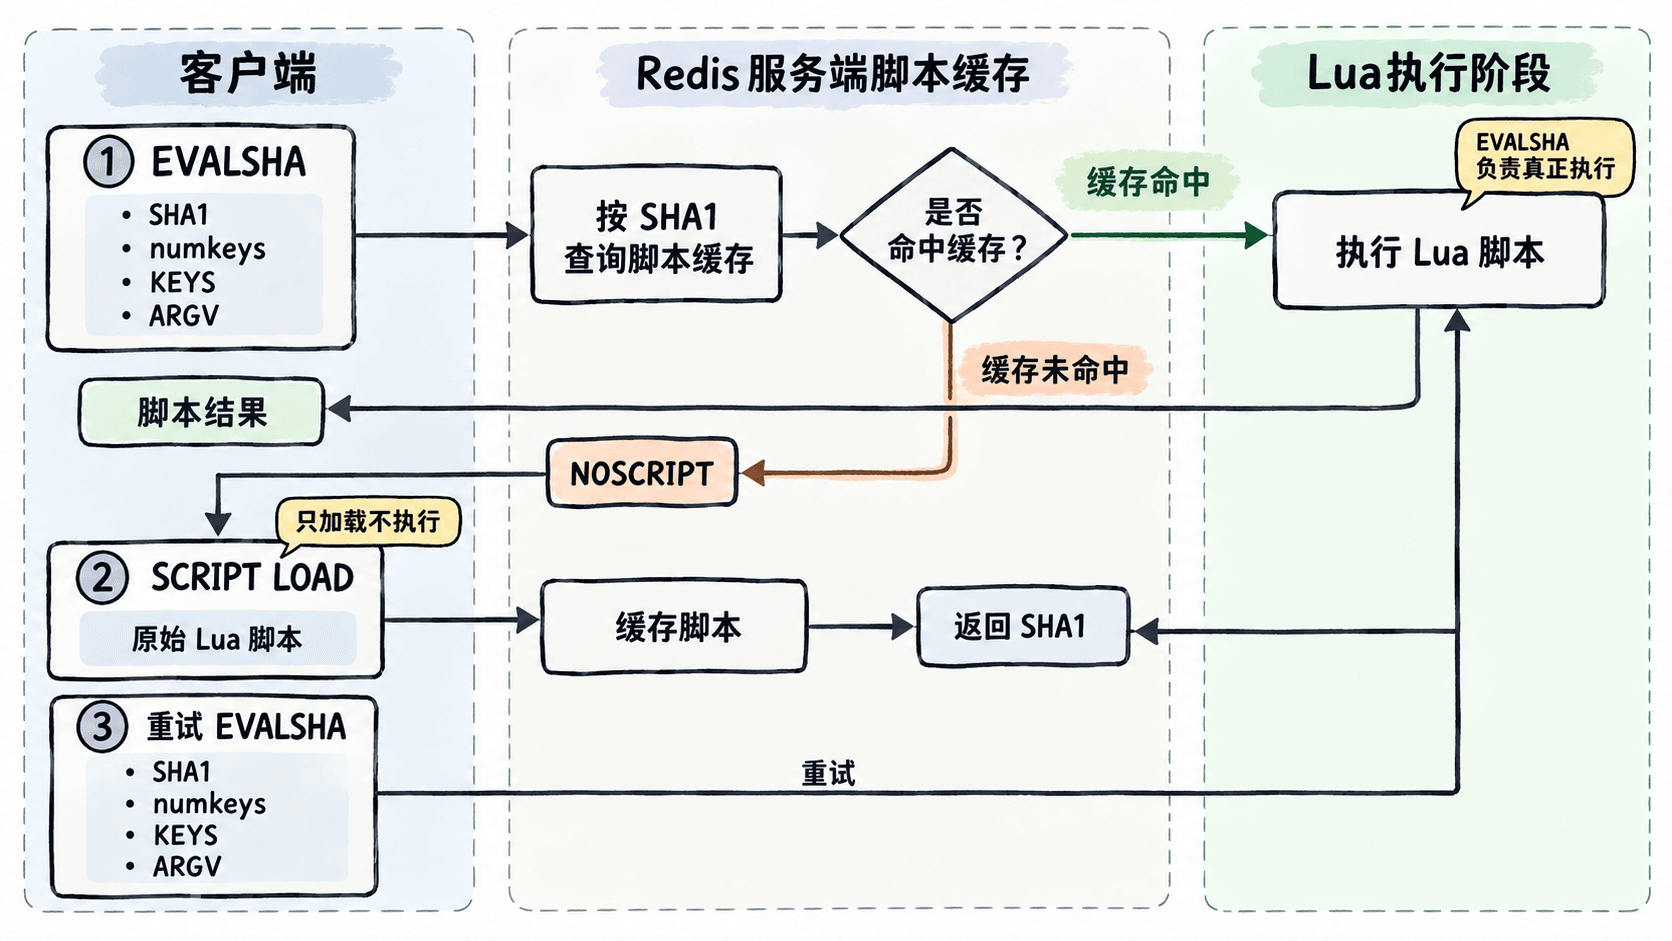
推荐的客户端处理顺序:
- 首先使用已保存的 SHA1 调用
EVALSHA。 - 成功时直接使用脚本的返回值,不需要重新上传脚本。
- 收到明确的
NOSCRIPT错误时,使用原始 Lua 正文执行SCRIPT LOAD。 - 保存新返回的 SHA1,使用相同的键和参数重试
EVALSHA。 - 如果重新加载或重试仍然失败,返回实际错误并按应用的重试策略处理,不要无限循环。
SCRIPT LOAD 返回的摘要由脚本正文计算得到。只要正文完全相同,摘要就相同;修改脚本后应使用新正文对应的摘要。客户端还必须保留原始脚本,不能只保存 SHA1,否则缓存丢失时无法恢复。
风险与边界
- 原子性不等于事务回滚:Redis 执行 Lua 脚本时,不会让其他命令插入脚本的执行过程,但如果脚本在部分写入后发生运行时错误,已经完成的写入不会自动撤销。
- 避免长时间执行:Lua 脚本运行期间会阻塞 Redis 的正常命令处理。不要在脚本中进行大范围遍历或耗时计算,尤其要避免数据量不受控制的循环。
- 明确声明访问键:脚本访问的键应通过
KEYS传入,业务参数通过ARGV传入。在 Redis Cluster 中,相关键还必须满足同一哈希槽的限制,不能靠动态拼接键名绕过键声明。 - 缓存按目标实例管理:不能假设某个实例加载的脚本一定存在于其他节点。发生节点切换或缓存清空时,应允许客户端重新加载。
- 谨慎处理重复执行:对于写入脚本,只应在能够确认未执行的
NOSCRIPT情况下直接重新加载并重试。网络超时后若执行结果不明确,不能盲目重复调用非幂等脚本,否则可能造成重复扣减或计数增加。
EVALSHA 自 Redis 2.6.0 起支持。速查要点:先加载、记住 SHA1、按摘要执行;只有明确收到 NOSCRIPT 才按缓存缺失流程恢复。 具体命令与兼容性可参阅 Redis EVALSHA 官方文档。
FCALL function numkeys [key [key ...]] [arg [arg ...]]调用已加载的 Redis Function,适合复用经版本管理的服务端原子逻辑;函数必须预先注册,且需要正确声明键参数以满足集群路由要求。
调用已注册函数
当 Redis 服务端已经加载函数库,需要复用计数更新、条件写入等原子逻辑时,使用 FCALL 按函数名执行。客户端只需传入键名和业务参数,不必重复发送 Lua 源码。函数执行期间不会与其他客户端命令交错,返回值由函数自身决定。
FCALL 自 Redis 7.0 起可用,执行前必须确认函数已通过 FUNCTION LOAD 注册到目标 Redis 部署。
基本语法
FCALL function numkeys [key [key ...]] [arg [arg ...]]| 参数 | 含义 | 约束 |
|---|---|---|
function |
已注册的函数名称 | 必须与 redis.register_function 注册的名称一致 |
numkeys |
后续键名参数的数量 | 非负整数,必须与实际提供的键名数量一致 |
key |
函数允许访问的 Redis 键名 | 必须显式传入,集群中还需满足路由约束 |
arg |
传递给函数的普通业务参数 | 数量由函数逻辑决定,不应传递需要访问的键名 |
Redis Lua 函数接收两个参数表:第一个是 keys,第二个是 args。例如 FCALL demo_incrby 1 demo:fcall:counter 3 中,1 表示后面恰好有一个键名,demo:fcall:counter 是键名,3 是普通参数。
numkeys 为 0 时表示不传递键名,例如执行一个不访问 Redis 键的纯计算函数。不能为了省略键名声明而把实际访问的键名放进 arg。
完整调用示例
以下示例适用于已启动的 Redis 7.0+ 测试实例,且本机已安装 redis-cli。默认连接本机 127.0.0.1:6379,无需认证;其他部署需要调整连接和认证参数。
先注册一个按指定增量修改计数器的 Lua 函数,再使用 FCALL 调用并读取最终结果。为保证输出可验证,示例先将独立测试键初始化为 10。
# 加载演示函数库;REPLACE 只用于同名演示库的重复加载
redis-cli --raw -x FUNCTION LOAD REPLACE <<'LUA'
#!lua name=anystack_fcall_demo
redis.register_function('demo_incrby', function(keys, args)
  local delta = tonumber(args[1])
  if not delta then
    return redis.error_reply('delta must be numeric')
  end
  return redis.call('INCRBY', keys[1], delta)
end)
LUA

# 键名作为第一个 key 参数,增量 3 作为普通参数
redis-cli --raw SET demo:fcall:counter 10
redis-cli --raw FCALL demo_incrby 1 demo:fcall:counter 3
redis-cli --raw GET demo:fcall:counter
预期输出:
anystack_fcall_demo
OK
13
13
第一行表示函数库加载成功,第二行表示计数器初始化成功。第三行是 FCALL 返回的更新结果,第四行是 GET 读到的实际值,两者都是 13。
在函数内部,keys[1] 对应 demo:fcall:counter,args[1] 对应字符串 3。tonumber 将其转换为数字,再由 INCRBY 完成递增。函数返回的是 Redis 命令的执行结果,而不是固定格式的状态对象。
示例中的函数库名和测试键名均为演示值。执行前应确认测试环境没有其他业务依赖该同名函数库,也不要将测试键替换成真实业务计数器。
返回结果与执行边界
FCALL 不规定统一返回类型。函数返回整数、字符串、数组等不同 Lua 值时,Redis 会按照相应规则转换为 RESP 回复,由客户端呈现为对应类型。不能假定每次调用都会返回 OK 或一个整数。
- 正常返回:返回函数通过
return提供的结果。示例中返回更新后的整数13。 - 函数不存在:服务器返回错误,应先通过
FUNCTION LIST检查目标函数是否已注册。 - 业务参数无效:示例中无法转换为数字的增量会触发
redis.error_reply,调用方收到错误回复。 - 执行命令失败:例如计数器包含不能转换为整数的字符串,
INCRBY会报错,函数通过redis.call将错误向外传播。
函数执行具有原子性,但原子执行不等于事务回滚。如果函数先成功修改了某个键,随后另一条命令报错,之前已经完成的修改不会自动撤销。因此涉及多次写入时,应先验证参数和关键前置条件,再执行实际写入。
函数的时间复杂度取决于内部逻辑。执行期间 Redis 不会穿插处理其他客户端命令,因此应避免长时间循环、大范围键扫描和其他耗时操作。
集群路由与只读调用
在 Redis Cluster 中,客户端需要根据声明的键名确定请求路由。函数实际访问的全部键名都必须由 FCALL 的键参数显式传入,不应在函数内部动态拼接新键名再访问。
对于通常的多键调用,所有键需要位于同一哈希槽。例如可以使用具有相同哈希标签的 order:{42}:stock 和 order:{42}:reserved。如果键位于不同槽,可能遇到跨槽错误,不能通过把第二个键移入普通参数来绕过限制。
只读函数可使用 FCALL_RO,但函数必须按只读要求注册,例如通过 redis.register_function 的 flags 声明 no-writes,且不能执行修改数据的命令。示例中的 demo_incrby 会执行 INCRBY,因此必须使用 FCALL,不能改用 FCALL_RO。
常见错误与恢复
| 现象 | 优先检查 | 处理方式 |
|---|---|---|
| 找不到函数 | 函数名、函数库是否已加载 | 使用 FUNCTION LIST 核实;缺失时重新部署正确版本的函数库 |
| 键参数数量错误 | numkeys 与实际键名数量 |
按函数实际访问的键数量重新组织调用参数 |
| 集群跨槽错误 | 多个键是否属于同一哈希槽 | 调整键设计或将操作拆分,不能假定跨槽操作具有统一原子性 |
| 权限拒绝 | 当前用户的命令和键访问 ACL | 按最小权限原则补齐所需授权 |
| 函数报运行时错误 | 参数类型、键的数据类型、函数内部命令 | 检查输入和已产生的数据变化,修复后再调用 |
FUNCTION LOAD REPLACE 会替换目标同名函数库,可能改变或移除该库中原有函数。生产环境应将函数库源码纳入版本管理,验证兼容性后再执行替换。
如果只需要清理本示例,可在确认没有其他调用者依赖后,使用 FUNCTION DELETE anystack_fcall_demo 删除演示函数库,并使用 DEL demo:fcall:counter 删除演示键。删除函数库会同时移除其中注册的函数,但不会自动撤销函数已经执行过的数据修改。
速查时优先确认三件事:函数已经加载、numkeys 与键参数一致、所有访问键满足集群路由要求。这三项正确后,再检查业务参数和函数内部执行结果。
地理与近似统计
GEOADD key [NX | XX] [CH] longitude latitude member [longitude latitude member ...]将成员经纬度写入地理索引,适合附近门店与车辆位置候选;坐标顺序是经度在前、纬度在后,需确保位置数据授权和更新频率合理。
记录成员地理坐标
需要将门店、配送员或车辆的位置写入 Redis 地理索引时,使用 GEOADD。它可以一次添加多个成员,也可以更新已有成员的坐标,随后通过 GEOPOS 验证位置,或使用 GEOSEARCH 查询附近候选点。
同一个地理索引中,每个 member 只有一份当前位置。重复写入已有成员默认覆盖原坐标,不会自动保留移动轨迹。
基本语法
GEOADD key [NX | XX] [CH] longitude latitude member [longitude latitude member ...]key:保存地理索引的 Redis 键,底层使用有序集合(Sorted Set)。longitude:经度,合法范围为 -180~180。latitude:纬度,合法范围为 -85.05112878~85.05112878。member:成员的唯一标识,例如门店编号或车辆 ID。[longitude latitude member ...]:可以继续追加多个坐标三元组,完成批量写入。
坐标顺序始终是经度在前、纬度在后。例如 101.6869 3.1390 center 表示成员 center 位于经度约 101.6869、纬度约 3.1390 的位置。不能把常见的“纬度、经度”展示顺序直接复制为命令参数。
关键选项与返回值
| 选项 | 行为 | 适用场景 |
|---|---|---|
| 默认 | 添加新成员,已有成员则更新坐标 | 持续上报当前位置 |
NX |
只添加不存在的成员,不更新已有成员 | 首次注册门店坐标 |
XX |
只更新已有成员,不创建新成员 | 更新已登记车辆的位置 |
CH |
返回实际发生变化的成员数量,包括新增与坐标更新 | 判断本次写入是否改变了索引 |
NX 与 XX 互斥,不能同时指定。CH 可以与其中任意一个组合使用。
默认返回值是新增成员数量,而不是成功处理的参数组数。例如,更新一个已存在成员的坐标,默认仍返回 0;添加 CH 后,如果其实际存储坐标发生变化,则返回 1。写入与原位置相同的坐标不计入变化数量。
高频示例与预期结果
前置条件:本机 Redis 服务可访问,已经安装 redis-cli,服务器版本至少为 Redis 6.2,以支持 NX、XX 和 CH。下面仅操作演示键 demo:places,使用 --raw 简化返回值显示。
# 仅清空演示键,保证新增数量可复现
redis-cli --raw DEL demo:places
redis-cli --raw GEOADD demo:places 101.6869 3.1390 center 101.6900 3.1400 east
redis-cli --raw ZCARD demo:places

# 验证 NX 跳过已有成员,XX CH 统计坐标更新
redis-cli --raw GEOADD demo:places NX 101.7000 3.1400 center
redis-cli --raw GEOADD demo:places XX CH 101.7000 3.1400 center
redis-cli --raw GEOPOS demo:places center
预期结果(按命令执行顺序解释):
DEL:0 或 1,取决于演示键此前是否存在
首次 GEOADD:2,新增 center 和 east
ZCARD:2,索引中共有两个成员
GEOADD NX:0,center 已存在,因此没有覆盖
GEOADD XX CH:1,center 的坐标发生变化
GEOPOS:返回接近 101.7000、3.1400 的经纬度
GEOPOS 返回的坐标顺序也是经度、纬度。Redis 使用地理位置编码保存坐标,因此读出的浮点数可能与写入值存在微小差异,不应要求字符串完全相等。
实际项目中,门店位置通常可以按门店 ID 更新;车辆位置则可按车辆 ID 重复执行 GEOADD。如果需要查找半径内的候选成员,应使用 GEOSEARCH,而不是对整个索引逐个读取坐标后在客户端计算距离。
风险、限制与恢复
- 坐标越界:经度或纬度超出允许范围时,Redis 返回错误。写入前应验证数值范围和经纬度顺序。
- 键类型冲突:如果目标键已经保存了不兼容的数据类型,例如 String,命令会返回
WRONGTYPE。可以用TYPE key检查,避免覆盖其他业务数据。 - 误写坐标:Redis 不会保存旧坐标供自动回滚。应从可信业务数据源取回正确位置,重新执行
GEOADD覆盖错误值。 - 移除成员:地理索引底层是有序集合,可使用
ZREM key member删除指定成员,无须删除整个索引。 - 过期位置:
GEOADD不会自动清理长时间未更新的成员。需要由业务记录最后更新时间,并使用ZREM清理过期成员;Redis 普通键过期机制不能直接为每个地理成员设置独立 TTL。
版本适用范围
GEOADD 自 Redis 3.2.0 起可用;NX、XX、CH 从 Redis 6.2.0 起支持。使用旧版本时可以进行基本坐标写入,但不能直接套用这些选项。官方参数说明参见 Redis GEOADD 文档。
速查:新增或更新位置用 GEOADD,检查坐标用 GEOPOS,检查成员数量用 ZCARD,删除单个位置用 ZREM。
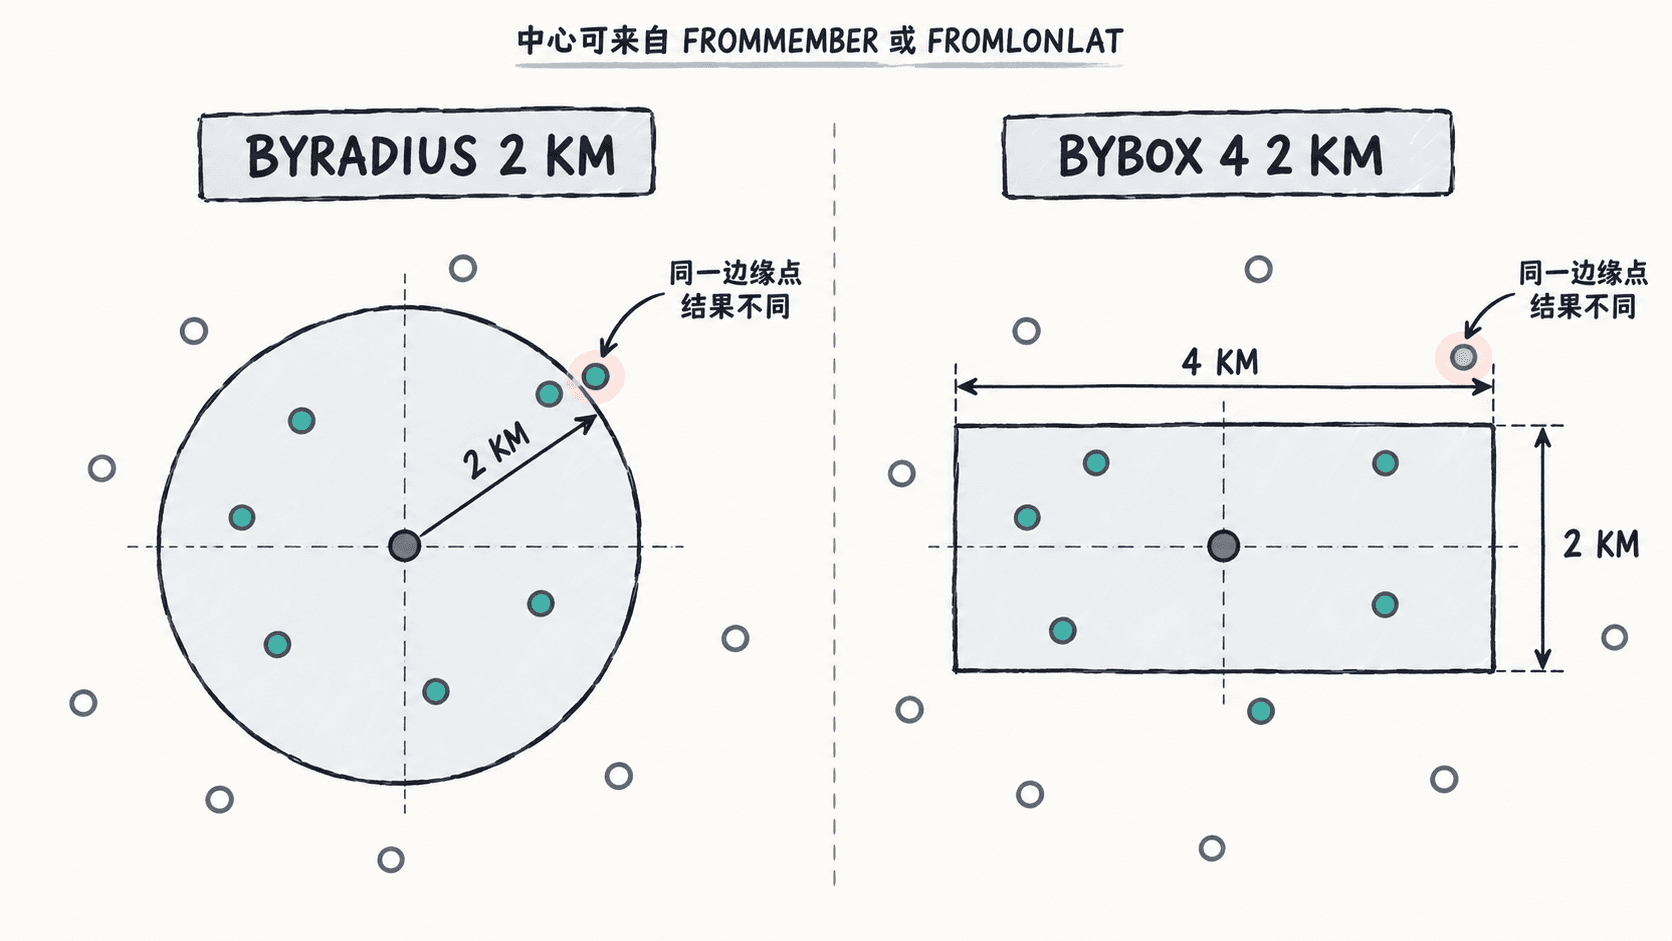
GEOSEARCH key <FROMMEMBER member | FROMLONLAT longitude latitude> <BYRADIUS radius <M | KM | FT | MI> | BYBOX width height <M | KM | FT | MI>> [ASC | DESC] [COUNT count [ANY]] [WITHCOORD] [WITHDIST] [WITHHASH]按中心成员或坐标搜索半径及矩形区域内的成员,适合附近服务筛选;距离和排序受地理索引精度限制,使用 COUNT 可减少结果规模。
查询范围内地理成员
需要从已写入 Redis 的地理位置索引中筛选附近门店、骑手或服务点时,使用 GEOSEARCH。指定中心与圆形或矩形范围后,可限定数量、按距离排序,并按需附带坐标和距离;查询本身不会修改索引。
基本语法
GEOSEARCH key <FROMMEMBER member | FROMLONLAT longitude latitude> <BYRADIUS radius <M | KM | FT | MI> | BYBOX width height <M | KM | FT | MI>> [ASC | DESC] [COUNT count [ANY]] [WITHCOORD] [WITHDIST] [WITHHASH]这是语法模板,不可直接执行。key 指向由 GEOADD 写入位置的地理索引;必须从两种中心指定方式中选一种,再从两种范围形状中选一种。FROMLONLAT 的坐标顺序始终是经度在前、纬度在后;FROMMEMBER 则以索引中已有的成员为中心。
关键选项
| 参数 | 用途与约束 |
|---|---|
BYRADIUS radius unit |
以中心为圆心按半径搜索,例如 2 KM。 |
BYBOX width height unit |
以中心为矩形中心,指定宽度和高度,例如 4 2 KM。 |
M / KM / FT / MI |
米、千米、英尺、英里;WITHDIST 返回相同单位的距离。 |
ASC / DESC |
按中心距离由近到远或由远到近排序;不指定时不要依赖结果顺序。 |
COUNT n [ANY] |
至多返回 n 个成员;ANY 可提前停止搜索,但可能漏掉更近的成员,不适合严格的最近点查询。 |
WITHDIST / WITHCOORD / WITHHASH |
分别附加中心距离、经纬度、52 位地理哈希编码分数;不加时只返回成员名。 |
可验证示例
前置条件是 Redis 6.2 或更高版本、可连接的 redis-cli,以及尚不存在的测试键 demo:places。以下坐标为演示数据,不代表真实服务点。
# 在空测试键写入:原点、约 0.56 KM 外的近点、范围外的远点
redis-cli GEOADD demo:places 101.6869 3.1390 origin 101.6919 3.1390 nearby 101.7500 3.2000 outside
# 按距离升序查询中心 2 KM 内成员,并返回距离
redis-cli GEOSEARCH demo:places FROMLONLAT 101.6869 3.1390 BYRADIUS 2 KM ASC WITHDIST预期结果:GEOADD 在空键上返回 (integer) 3;GEOSEARCH 依次返回 origin、nearby,每项附带以 KM 计的距离(分别约 0 和 0.56),不会返回 outside。具体距离小数可能因地理坐标量化而略有不同。若键中已有其他成员,结果和新增计数也会随之变化。
风险与排查
GEOSEARCH 只读,但示例的 GEOADD 会新增成员,并覆盖同名成员的旧坐标,务必只在测试数据上运行;需要撤销示例写入时,确认成员属于演示数据后使用 ZREM demo:places origin nearby outside,不要直接删除共享键。
查询为空时,先用 TYPE demo:places 确认数据类型为 zset,用 GEOPOS demo:places origin 检查中心成员是否存在,再核对经纬度顺序、范围单位和半径;FROMMEMBER 的成员必须预先写入索引。需要真正的最近 n 个成员时,优先使用 ASC COUNT n 而不是 COUNT n ANY。地理索引距离有精度限制,严格地理围栏应在业务层复核边界。命令自 Redis 6.2.0 起可用,具体见官方说明。
PFADD key element [element ...]把标识加入 HyperLogLog 以估算不同元素个数,适合海量独立访客统计;结构无法列出实际成员,也不适合精确去重或权限判断。
登记近似独立访客
需要统计网站、应用或活动的独立访客数(UV),但不需要保存完整访客名单时,使用 PFADD 将访客标识登记到 Redis HyperLogLog。随后通过 PFCOUNT 获取不同访客数量的近似值,适合大规模、允许少量统计误差的场景。
基本语法
PFADD key element [element ...]key:HyperLogLog 的键名,建议包含业务名称和统计周期,例如stats:uv:20261012。element:要登记的访客标识,可以一次传入多个。相同标识重复登记,不会按重复次数累加独立访客数。[element ...]:可选的额外元素;支持批量登记,也允许不传元素,此时仅在键不存在时创建空 HyperLogLog。
键不存在时,Redis 自动创建 HyperLogLog,不需要预先初始化。登记本身不会设置过期时间;需要按天保留数据时,应另外配置 TTL。
常用示例与验证
前置条件:Redis 服务正常运行,已安装 redis-cli,并且当前连接的实例可写入测试数据。以下示例要求 demo:visitors 最初不存在,避免已有数据影响结果。
# 确认测试键尚未存在
redis-cli EXISTS demo:visitors

# 登记两个不同访客
redis-cli PFADD demo:visitors user:1 user:2
redis-cli PFCOUNT demo:visitors

# 重复登记已经出现过的访客
redis-cli PFADD demo:visitors user:2
redis-cli PFCOUNT demo:visitors
预期输出(按命令顺序,非交互模式下每条命令输出一行):
0
1
2
0
2
第一行 0 表示测试键原先不存在。如果第一行是 1,应先改用一个未使用的测试键,不要直接覆盖已有业务数据。
第一次 PFADD 返回 1,表示创建了键或更新了内部寄存器;PFCOUNT 返回 2,表示当前估算有两个不同访客。再次登记 user:2 返回 0,估算数量保持为 2。
对于这个小样本,通常会得到上述结果。大规模真实数据的 PFCOUNT 是近似统计,不能保证始终等于精确去重后的数量。
返回值与统计精度
PFADD 返回整数,必须区分结构变化与业务上的新增访客:
| 返回值 | 含义 |
|---|---|
1 |
创建了新 HyperLogLog,或至少一个内部寄存器发生变化 |
0 |
本次操作未改变内部寄存器 |
HyperLogLog 通过固定数量的寄存器估算基数,典型标准误差约为 0.81%。稠密表示的核心寄存器约占 12 KiB,稀疏表示在低基数时通常更节省空间,因此适合高基数统计。
统计人数时使用 PFCOUNT key,而不是累计 PFADD 返回值。PFCOUNT 给出的是估计值,不能据此确认某个指定访客是否存在。
统计口径与使用边界
同一个 key 对应一个统计范围。若要统计每日 UV,可以按日期拆分键,例如 stats:uv:20261012 与 stats:uv:20261013,每天分别登记用户标识。
需要跨天统计时,可以使用 PFCOUNT 对多个 HyperLogLog 键计算并集的近似基数,不能直接把每日结果相加,因为同一个用户可能在多天出现。
访客标识必须保持稳定。同一用户在不同请求中使用不同随机 ID,会被当作不同元素;不同用户共用一个标识,则会被当作同一元素。这类口径错误无法通过提高 HyperLogLog 精度解决。
HyperLogLog 不保存可遍历的原始成员集合,不能执行按访客查询、删除指定访客或获取成员列表。需要准确成员关系时,应使用 Redis Set 的 SADD、SISMEMBER 等命令。
风险与恢复
- 键类型冲突:如果目标键存放了不兼容的数据,
PFADD可能返回类型或格式错误。使用TYPE key辅助检查;但 HyperLogLog 底层属于 Redis String,TYPE返回string并不能证明内容是有效 HyperLogLog。不要直接删除或覆盖来源不明的键。 - 误登记无法单独撤销:HyperLogLog 不支持删除某个元素。如果误把测试用户或错误标识加入正式统计,只能在保留原始事件数据的前提下重新构建新的统计键,再切换读取目标;无法从现有结构还原完整成员名单。
- 统计周期混用:将不同日期的数据写入同一个长期键,会得到累计近似 UV,而不是每日 UV。应按周期分配独立键,并根据保留策略通过
EXPIRE设置过期时间。 - 不能用于精确业务判断:会员唯一性、优惠券领取限制、权限校验和计费等要求准确去重的场景,不应仅依赖 HyperLogLog。
PFADD 负责登记,PFCOUNT 负责读取估算数量。需要验证操作是否正确,应检查统计键、标识生成口径和 PFCOUNT 结果,而不是把 PFADD 的 0 或 1 当作精确新增人数。
适用版本:Redis Open Source 2.8.9 及之后版本。参考:Redis PFADD 官方文档。
PFCOUNT key [key ...]读取一个或多个 HyperLogLog 的近似基数,适合报表型去重统计;结果存在估算误差,不能代替财务计数、库存或强一致去重。
查询近似去重总量
需要统计独立访客数、去重搜索词数或多个时间段的去重总量时,使用 `PFCOUNT` 读取 HyperLogLog 的近似基数。单键返回该键的估算去重数量,多键返回所有指定键的并集估算数量,同一元素不会因出现在多个键中而重复计数。
基本语法
PFCOUNT key [key ...]| 参数 | 含义 | 约束 |
|---|---|---|
| `key` | 要统计的 HyperLogLog 键 | 必填,至少一个 |
| `[key ...]` | 参与并集统计的其他 HyperLogLog 键 | 可选,可指定多个 |
命令返回整数形式的近似基数。单键不存在时返回 `0`;多个键中存在缺失键时,缺失键按空集合处理。传入不符合 HyperLogLog 格式的值可能报错,不能直接对普通 Set 或任意字符串执行统计。
例如,`PFCOUNT demo:visitors` 查询一个访客统计键;`PFCOUNT demo:visitors:day1 demo:visitors:day2` 计算两天的近似去重总人数,而不是简单相加每天的统计值。
常用示例
前置条件:Redis 服务已启动,`redis-cli` 可以连接目标实例。以下命令使用独立的演示键,先清理旧测试数据,再分别写入两组存在交集的用户标识。
# 仅清理演示键,避免旧数据影响验证
redis-cli --raw DEL demo:pfcount:check:a demo:pfcount:check:b

# 两组数据都包含 u2,用于验证并集去重
redis-cli --raw PFADD demo:pfcount:check:a u1 u2
redis-cli --raw PFADD demo:pfcount:check:b u2 u3

# 分别查询单键和多键并集的近似基数
redis-cli --raw PFCOUNT demo:pfcount:check:a
redis-cli --raw PFCOUNT demo:pfcount:check:a demo:pfcount:check:b
预期输出(两个演示键原本不存在时):
0
1
1
2
3
第一行是 `DEL` 删除的键数量。如果测试键此前存在,该值可能为 `1` 或 `2`。两次 `PFADD` 返回 `1`,表示 HyperLogLog 内部估算状态发生变化,并不表示只新增了一个实际元素。
第一个 `PFCOUNT` 返回 `2`,对应 `u1`、`u2`;第二个返回 `3`,对应并集中的 `u1`、`u2`、`u3`。这个小样本的结果与实际去重数量一致,但不代表大规模数据下始终精确。
单键与多键的区别
| 比较项 | 单键 `PFCOUNT` | 多键 `PFCOUNT` |
|---|---|---|
| 统计范围 | 一个 HyperLogLog | 多个 HyperLogLog 的并集 |
| 时间复杂度 | 平均 `O(1)` | `O(N)`,N 为键数量,常数开销较大 |
| 计算方式 | 可利用基数缓存 | 临时合并计算并集,不缓存并集结果 |
| 典型用途 | 单日独立访客数 | 多日累计独立访客数 |
多键统计不会创建持久化的合并结果键。如果需要反复读取同一组键的并集,可以考虑通过 `PFMERGE` 保存合并结果,再对目标键执行 `PFCOUNT`;但源数据变化后,必须重新合并才能反映最新结果。
在 Redis Cluster 中,多键操作需要满足相同哈希槽约束,否则可能出现 `CROSSSLOT` 错误。跨槽数据应由应用层规划聚合方式,不能直接假定任意多个键都可一次统计。
误差、风险与恢复
Redis HyperLogLog 的基数估算标准误差约为 **0.81%**。这是统计意义上的误差指标,并非每次结果都保证落在真实值的 ±0.81% 范围内。因此,`PFCOUNT` 适合趋势分析和报表,不适合库存扣减、财务核算或必须精确判断用户是否存在的场景。
遇到异常结果时,先检查写入端是否对预期键执行了 `PFADD`,再核对统计周期、键名、用户标识编码及多键范围。重复写入相同元素通常不会增加去重估算值;不同格式的用户标识则可能被当作不同元素。
如果误删 HyperLogLog,无法仅凭历史 `PFCOUNT` 数值恢复原始元素,只能依靠备份或上游事件数据重建。若业务要求精确去重,应保留能够重算的原始数据,或使用适合精确计数的数据结构。
**速查:** 单键查当前近似基数,多键查并集近似基数;不能把多个单键结果直接相加当作跨周期去重总量。命令自 Redis 2.8.9 起可用。
SETBIT key offset value设置字符串指定偏移位为零或一,适合签到和布尔状态压缩存储;偏移按位计且可能扩展内存,必须先约束最大标识空间。
标记一个位图位置
需要记录用户签到、功能开关或其他布尔状态时,使用 SETBIT 将 Redis 字符串中指定的位设置为 1 或 0。命令返回修改前的旧值,可判断某位置是否已经被标记;使用 GETBIT 可验证最终状态。
基本语法
SETBIT key offset value| 参数 | 含义 | 约束 |
|---|---|---|
key |
存储位图的 Redis String 键 | 不存在时自动创建 |
offset |
从零开始的位偏移 | 整数,范围为 0~4294967295 |
value |
写入的位值 | 只能为 0 或 1 |
offset 的单位是位,不是字节。设置为 1 表示标记,设置为 0 表示清除该位;其他已有位保持不变。
命令返回整数 0 或 1,表示写入前该位置的旧值,不是写入是否成功的布尔结果。该命令自 Redis Open Source 2.2.0 起可用,单个位写入的通常时间复杂度为 O(1),但首次扩展大字符串可能产生明显的内存分配开销。
常用示例与预期结果
假设 Redis 已在本地默认端口运行,且 demo:attendance 不存在或属于专门用于位图的字符串键。将编号 42 的签到状态设置为已签到,再读取并重复设置。
# 标记编号 42,并读取写入后的状态
redis-cli --raw SETBIT demo:attendance 42 1
redis-cli --raw GETBIT demo:attendance 42

# 再次写入相同状态,观察旧值
redis-cli --raw SETBIT demo:attendance 42 1
预期输出(假设执行前第 42 位为 0):
0
1
1
第一行 0 表示此前未标记;第二行 1 表示现在已经标记;第三行 1 表示重复设置时该位原本就是 1。
如果执行前该位已经是 1,则第一行也返回 1,后两行不变。业务可以利用首次写入返回的旧值,判断是否发生了从 0 到 1 的状态变化,避免将重复请求误判为新的签到。
位偏移与存储空间
Redis Bitmap 实际由 String 承载。SETBIT 在指定位置超出当前字符串长度时,会自动扩展字符串,并将新增区域中未设置的位填充为 0。
例如设置 offset=42:
- 位下标从
0开始,编号42位于第6个字节(字节下标5)。 - 若键原本不存在,写入后字符串内容长度为
6字节,不包含 Redis 对象和键的额外内存开销。 - 若把偏移设置成
8000000,字符串内容至少需要1000001字节,即使实际上只写入了一个1。
SETBIT 允许的最大偏移为 2^32 - 1,单个位图对应的最大字符串内容长度为 512 MiB。首次写入极大的偏移可能触发大块内存分配,阻塞 Redis 请求处理。
因此不能未经约束就把稀疏的数据库主键直接当作位偏移。应先确定最大编号、预计容量和编号是否连续;必要时采用紧凑编号映射,或按照业务范围拆分多个位图键。
业务边界与恢复
按日签到时,应将不同日期的数据放入不同键,例如 attendance:20261012,同一个编号对应同一天的同一个位。实际业务还需设置合适的过期时间,因为 SETBIT 不会自动为新键设置 TTL。
- 写错偏移:如果保存了操作返回的旧值,可使用
SETBIT key offset 旧值恢复原来的位;否则需要核对可信业务记录后再修正。 - 清除不等于释放内存:把某位设置为
0不会缩短字符串。若需要回收过大的位图,应检查其他位是否仍在使用,再考虑迁移或删除整个键。 - 键类型冲突:目标键不是 String 时会返回
WRONGTYPE。即使TYPE显示为string,也不能证明该键专用于位图;应采用独立键名前缀,避免破坏普通字符串内容。 - 并发重复写入:单次
SETBIT是原子操作,可使用返回的旧值识别重复置位,但不能单独保证写入 Redis 之外的数据库或其他系统时具备跨系统事务一致性。
BITCOUNT key [start end [BYTE | BIT]]统计位图中值为一的位数,适合签到总量和简单状态计数;指定区间时需要区分字节与位偏移,避免造成范围统计偏差。
统计位图已设置位
需要统计 Redis Bitmap 中有多少个位被设置为 1 时,使用 BITCOUNT。常用于签到人数、活跃用户数和状态标记计数。它返回指定范围内值为 1 的位数,不修改原数据;指定区间时必须确认偏移单位是字节还是位。
基本语法
BITCOUNT key [start end [BYTE | BIT]]| 参数 | 含义 | 默认行为 |
|---|---|---|
key |
要统计的 Bitmap 键,底层为 Redis String | 必填 |
start |
统计区间起始偏移,索引从 0 开始 |
省略时统计整个值 |
end |
统计区间结束偏移,包含该位置 | 与 start 一起指定 |
BYTE |
将 start、end 解释为字节偏移 |
默认单位 |
BIT |
将 start、end 解释为位偏移 |
Redis 7.0.0 起支持 |
只传 key 时统计整个字符串的所有置位。指定范围时,start 和 end 必须同时出现,区间两端均包含在统计范围内。
需要特别区分:BITCOUNT key 0 7 表示前 8 个字节,而 BITCOUNT key 0 7 BIT 才表示前 8 个位。一个字节包含 8 位,混用单位可能使统计范围扩大 8 倍。
负偏移从数据末尾反向计算。默认字节模式下,-1 表示最后一个字节;BIT 模式下,-1 表示最后一个位。
可运行示例
以下示例使用本地测试 Redis,要求安装 redis-cli,并且本地默认连接参数能够访问测试实例。使用独立示例键,避免覆盖业务数据。
# 写入两个字节:A=01000001,@=01000000
redis-cli --raw SET demo:attendance:bitcount:sample 'A@'
redis-cli --raw BITCOUNT demo:attendance:bitcount:sample
redis-cli --raw BITCOUNT demo:attendance:bitcount:sample 0 0
# 对比字节区间与位区间的不同统计结果
redis-cli --raw BITCOUNT demo:attendance:bitcount:sample 0 0 BIT
redis-cli --raw BITCOUNT demo:attendance:bitcount:sample 0 7 BIT
redis-cli --raw BITCOUNT demo:attendance:bitcount:sample -1 -1
预期输出(与上述命令逐行对应):
OK
3
2
0
2
1
结果解释:
- 整个字符串共 16 位,其中 3 位为
1,所以整体统计结果是3。 0 0默认表示第一个字节,其二进制值为01000001,有 2 位为1。0 0 BIT只检查第一个位,该位是0,因此返回0。0 7 BIT检查前 8 位,返回2。-1 -1默认检查最后一个字节01000000,返回1。
签到统计中的使用方式
假设每天使用一个独立 Bitmap 键,用户 ID 映射为固定的非负位偏移。通过 SETBIT 把当天签到用户对应的位设置为 1,再通过 BITCOUNT 获取当天已标记用户的数量。
这种做法成立的前提是同一用户始终映射到同一个位偏移,并且不同用户不会意外共用偏移。重复把同一位设置为 1 不会使统计值继续增加,因此统计的是已标记位置数量,而不是签到请求次数。
如果需要统计指定用户 ID 区间,Redis 7.0.0 及以上版本可以使用 BIT 模式按位偏移统计。低于 Redis 7.0.0 的版本不能使用 BYTE | BIT 选项,只能直接统计全量或按字节范围统计。按字节统计时,区间边界不能精确排除边界字节内的其他用户位。
返回值与边界
- 正常返回:整数,表示统计范围内值为
1的位数;没有置位时返回0。 - 键不存在:按空字符串处理,返回
0,不会自动创建键。 - 类型不匹配:如果键对应的数据类型不是 String,会返回
WRONGTYPE错误。 - 性能:统计复杂度为
O(N),其中N与实际扫描的数据量有关。全量扫描超大 Bitmap 会增加 Redis 命令执行时间。 - 版本:
BITCOUNT自 Redis 2.6.0 可用,显式BYTE或BIT单位选项从 Redis 7.0.0 开始支持。
风险与排查
发现统计结果不符合预期时,优先检查位偏移是否从 0 开始、区间结束位置是否包含在内,以及是否误将位范围当成字节范围。若重复签到导致业务计数异常,还应确认应用是否使用统一且无冲突的用户 ID 到位偏移映射。
执行 BITCOUNT 本身不需要恢复数据;如果误执行示例中的 SET 覆盖了原有键,应从事先保留的备份或原始业务数据恢复,不能通过 BITCOUNT 还原。
速查:全量计数用 BITCOUNT key;字节范围计数用 BITCOUNT key start end;精确位范围计数在 Redis 7.0.0 及以上使用 BITCOUNT key start end BIT。
BF.ADD key item向 Bloom 过滤器加入成员,适合低成本的可能存在性预过滤;过滤器存在误判概率,不支持当作精确记录,需确认部署支持相应命令。
向布隆过滤器添加元素
需要以较低内存开销记录某个标识是否可能出现过时,使用 BF.ADD 将元素加入 Redis Bloom 过滤器。常用于请求去重预筛选、缓存穿透防护和已处理对象的快速判断。它提供概率型存在性判断,不能代替精确的数据库记录或具有强一致性要求的去重约束。
基本语法
BF.ADD key item| 参数 | 含义 | 约束 |
|---|---|---|
key |
Bloom 过滤器的 Redis 键名 | 必须不存在或已经是 Bloom 过滤器 |
item |
要加入的元素 | 使用业务标识,例如 user:42 |
BF.ADD 每次只添加一个元素,不支持一次传入多个 item。需要批量添加时使用 BF.MADD。
如果 key 不存在,Redis 会使用当前 Bloom 配置的默认误判率、初始容量和扩容策略自动创建过滤器。如果业务需要指定容量和误判率,应先使用 BF.RESERVE 创建过滤器,再调用 BF.ADD。
添加与验证
前置条件:Redis 实例支持 Bloom 命令,客户端具有相应写入权限。以下示例使用 redis-cli,假设 demo:bloom:seen 尚不存在,并且没有其他客户端同时修改该键。
# 首次加入用户标识
redis-cli BF.ADD demo:bloom:seen user:42
# 再次加入相同标识,观察重复添加的返回值
redis-cli BF.ADD demo:bloom:seen user:42
# 查询该标识是否可能存在
redis-cli BF.EXISTS demo:bloom:seen user:42
预期输出(普通 redis-cli 的整数显示形式):
1
0
1
第一条返回 1,表示元素成功加入;第二条返回 0,表示过滤器判断元素可能已经存在;第三条返回 1,表示该元素可能存在于过滤器中。
如果过滤器在执行前已经包含相关元素,首次添加也可能返回 0。在采用 RESP3 的客户端协议或不同语言驱动时,对应结果也可能显示为布尔值 true、false。
返回值与判断边界
| 返回结果 | 含义 | 业务处理建议 |
|---|---|---|
BF.ADD 返回 1 |
元素成功加入 | 可视为过滤器此前未识别该元素 |
BF.ADD 返回 0 |
元素可能已经存在 | 不能直接证明业务记录确实存在 |
BF.EXISTS 返回 1 |
元素可能存在 | 必要时查询数据库进行精确确认 |
BF.EXISTS 返回 0 |
元素在当前过滤器中不存在 | 可排除当前过滤器已登记该元素的情况 |
Bloom 过滤器可能产生假阳性,即元素实际上没有加入过,但查询仍返回可能存在。因此,BF.ADD 返回 0 不等价于业务上的精确重复。
例如,用 Bloom 过滤器预筛选用户是否领取过优惠券时,可以先检查过滤器;对于可能已领取的用户,再查询数据库确认。最终领取资格应由数据库记录和唯一约束决定,不能仅依赖 Bloom 判断。
容量与使用限制
BF.ADD 本身没有指定误判率或容量的参数。如果需要控制这些参数,应在首次添加之前创建过滤器。
- 误判率:由过滤器创建时的配置决定,并非每次添加独立指定。误判率越低,通常需要越多内存。
- 容量:表示预期容纳的元素数量。默认可扩容的过滤器达到容量后会增加子过滤器;配置为不可扩容时,容量耗尽可能导致添加失败。
- 重复添加:多次添加同一元素不会提供精确的重复次数统计,需要计数时应选择其他数据结构。
- 删除限制:标准 Bloom 过滤器不支持安全地删除单个已加入元素,也不支持枚举全部原始成员。
对于预计存储大量元素的业务,应提前估算规模并配置过滤器,避免频繁扩容带来的额外内存和查询开销。
常见错误与恢复
- 提示
unknown command:检查当前 Redis 部署是否提供 Bloom 命令。不同版本和部署方式的模块集成情况可能不同,不能假定所有 Redis 实例都支持BF.ADD。 - 提示
WRONGTYPE:目标键已被其他数据类型占用。先检查键类型,再选择正确的过滤器键名;不要直接删除未知业务键。 - 添加失败或过滤器已满:检查过滤器是否设置了不可扩容模式及容量限制。必要时创建容量更合适的新过滤器。
- 误加元素:不能通过
BF.ADD的反向操作撤销单个元素。应根据权威业务数据重建新过滤器,验证后再切换业务使用的键。
速查:BF.ADD key item 添加元素;返回 1 表示成功加入,返回 0 表示可能已经存在;使用 BF.EXISTS 检查存在性,不能把阳性结果当作精确命中。
命令行为参考:Redis 官方 BF.ADD 文档。