
Redis 与缓存 / 知识点
Redis 故障排查手册
手册条目
确认 RDB、AOF 的启用状态、最近执行结果和数据安全风险。
检查 Redis 持久化状态
用于确认当前实例是否启用 RDB、AOF,最近一次落盘是否成功,以及故障或重启时可能丢失哪些数据。先读取运行状态,再核对生效配置;以下检查均为只读,不会主动触发快照或 AOF 重写。
快速检查
命令默认连接本机 127.0.0.1:6379。远程实例补充 -h <HOST> -p <PORT>;启用 ACL 时补充 --user <USER>,密码优先通过 REDISCLI_AUTH 传入,避免出现在进程列表和终端历史中。
export REDISCLI_AUTH='<PASSWORD>'  # 无密码实例可删除此行

redis-cli --raw INFO persistence   | grep -E '^(rdb_changes_since_last_save|rdb_bgsave_in_progress|rdb_last_save_time|rdb_last_bgsave_status|aof_enabled|aof_rewrite_in_progress|aof_last_bgrewrite_status|aof_last_write_status):'

redis-cli --raw CONFIG GET save
redis-cli --raw CONFIG GET appendonly
redis-cli --raw CONFIG GET appendfsync
redis-cli --raw CONFIG GET dir
redis-cli --raw CONFIG GET dbfilename
redis-cli --raw CONFIG GET appenddirname
redis-cli --raw LASTSAVE
预期输出示例:
rdb_changes_since_last_save:42
rdb_bgsave_in_progress:0
rdb_last_save_time:<TIME>
rdb_last_bgsave_status:ok
aof_enabled:1
aof_rewrite_in_progress:0
aof_last_bgrewrite_status:ok
aof_last_write_status:ok
save
3600 1 300 100 60 10000
appendonly
yes
appendfsync
everysec
dir
/var/lib/redis
dbfilename
dump.rdb
appenddirname
appendonlydir
<TIME>
<TIME> 是 Unix 时间戳,实际值不同。appenddirname 在旧版本中可能不返回内容;这不等于 AOF 异常,应结合 Redis 版本和 aof_enabled 判断。
关键字段怎么读
| 字段或配置 | 正常判断 | 异常含义 |
|---|---|---|
rdb_last_bgsave_status |
ok |
err 表示最近一次后台快照失败 |
rdb_bgsave_in_progress |
通常为 0 |
1 表示正在保存,先等待完成再定性 |
rdb_changes_since_last_save |
越小表示 RDB 越新 | 持续增大表示最新变更尚未进入 RDB |
aof_enabled |
1 表示已启用 |
0 表示未使用 AOF |
aof_last_write_status |
ok |
err 表示最近 AOF 写入出现错误 |
aof_last_bgrewrite_status |
ok |
err 表示最近 AOF 重写失败 |
save |
非空表示存在 RDB 自动保存规则 | 空字符串表示未配置自动 RDB 快照 |
appendfsync |
always、everysec 或 no |
决定 AOF 的同步频率与数据丢失窗口 |
LASTSAVE 只表示最近一次成功生成 RDB 的时间,不代表 AOF 已同步。判断 AOF 必须同时查看 aof_enabled、aof_last_write_status 和重写状态。
数据安全边界
仅启用 RDB 时,故障后可能丢失最近一次成功快照之后的变更;rdb_changes_since_last_save 可帮助判断当前缺口。仅启用 AOF 时,数据安全取决于 appendfsync:always 更稳但写延迟更高,everysec 通常把突然宕机的数据窗口控制在约一秒,no 由操作系统决定刷盘时机。
RDB 与 AOF 都关闭时,进程退出、主机重启或内存丢失后无法从本地磁盘恢复数据。两者同时启用时,重启通常优先使用更完整的 AOF 恢复;复制、Sentinel 或 Cluster 提供可用性,不等同于可回滚的离机备份。
风险与权限
INFO persistence 和 CONFIG GET 不修改数据,但常被 ACL 归为管理或危险命令,受限账号可能返回 NOPERM。不要为了“验证”直接执行 CONFIG SET、BGSAVE 或 BGREWRITEAOF;它们会改变运行状态或增加磁盘、内存压力。
运行时通过 CONFIG SET 修改的值不一定写回配置文件,重启后可能恢复旧值。确需变更时,应同步修改实际加载的配置文件,或在确认权限、配置路径和回滚方案后使用 CONFIG REWRITE。
排障结论
出现 rdb_last_bgsave_status:err、aof_last_write_status:err,或 RDB/AOF 同时关闭时,应按数据安全事件处理:先限制重启和故障切换操作,保留现有持久化文件,再定位磁盘、权限、内存及配置问题。
定位快照保存失败、后台进程异常和目录权限问题。
排查 Redis RDB 失败
用于定位 BGSAVE 失败、MISCONF 写入被拒绝、快照长时间不更新等问题。排查顺序应是确认失败状态、读取 Redis 日志、检查目标目录与系统资源,修复后再手动生成一次快照验证。
确认失败状态
先读取 RDB 状态和生效配置,不要立即修改 stop-writes-on-bgsave-error。命令默认连接本机实例;远程、TLS 或 ACL 环境需补充对应连接参数。
export REDISCLI_AUTH='<PASSWORD>'  # 无密码实例可删除此行

redis-cli --raw INFO persistence   | grep -E '^(rdb_bgsave_in_progress|rdb_last_bgsave_status|rdb_last_bgsave_time_sec|rdb_last_save_time|rdb_changes_since_last_save):'

redis-cli --raw CONFIG GET dir
redis-cli --raw CONFIG GET dbfilename
redis-cli --raw CONFIG GET save
redis-cli --raw CONFIG GET stop-writes-on-bgsave-error
预期输出示例:
rdb_bgsave_in_progress:0
rdb_last_bgsave_status:err
rdb_last_bgsave_time_sec:<SECONDS>
rdb_last_save_time:<TIME>
rdb_changes_since_last_save:18527
dir
/var/lib/redis
dbfilename
dump.rdb
save
3600 1 300 100 60 10000
stop-writes-on-bgsave-error
yes
rdb_last_bgsave_status:err 表示最近一次后台快照失败;rdb_bgsave_in_progress:1 仅表示仍在执行,应先观察日志和完成状态。rdb_changes_since_last_save 持续增加,说明未进入最新 RDB 的变更正在扩大。
检查日志、磁盘和权限
将 <SERVICE> 替换为实际 systemd 单元,例如 redis-server、redis 或 redis@cache。脚本只读检查磁盘容量、inode、挂载属性、Redis 进程用户和目录逐级权限,不会创建或删除文件。
#!/usr/bin/env bash
set -euo pipefail

export REDISCLI_AUTH='<PASSWORD>'  # 无密码实例可删除此行
SERVICE='<SERVICE>'
RDB_DIR="$(redis-cli --raw CONFIG GET dir | sed -n '2p')"
PID="$(redis-cli --raw INFO server | awk -F: '$1=="process_id"{gsub("\r","",$2); print $2}')"
REDIS_USER="$(ps -o user= -p "$PID" | xargs)"

printf 'rdb_dir=%s pid=%s user=%s\n' "$RDB_DIR" "$PID" "$REDIS_USER"
df -h "$RDB_DIR"
df -i "$RDB_DIR"
findmnt -no TARGET,FSTYPE,OPTIONS --target "$RDB_DIR"
namei -l "$RDB_DIR"
sudo -u "$REDIS_USER" sh -c 'test -w "$1" && test -x "$1"' sh "$RDB_DIR"   && echo 'redis-dir-access=ok'   || echo 'redis-dir-access=failed'

journalctl -u "$SERVICE" --since '30 minutes ago' --no-pager   | grep -Ei 'rdb|bgsave|fork|permission|space|read-only|i/o error|oom' || true
预期输出示例(磁盘空间耗尽):
rdb_dir=/var/lib/redis pid=<PID> user=redis
Filesystem      Size  Used Avail Use% Mounted on
/dev/<DEVICE>    50G   50G     0 100% /
Filesystem     Inodes IUsed IFree IUse% Mounted on
/dev/<DEVICE>     3M   420K  2.6M   14% /
/ ext4 rw,relatime
f: /var/lib/redis
drwxr-xr-x root  root  /
drwxr-xr-x root  root  var
drwxr-xr-x root  root  lib
drwxr-x--- redis redis redis
redis-dir-access=ok
<TIME> redis-server[<PID>]: Failed opening the temp RDB file temp-<PID>.rdb for saving: No space left on device
容量未满仍可能是 inode 耗尽、只读挂载、父目录缺少执行权限、SELinux/AppArmor 拒绝、底层 I/O 错误,或容器卷实际挂载到其他文件系统。以 Redis 日志中的第一条明确错误为主线,不要只看目录表面权限。
按错误处理
No space left on device:同时检查容量和 inode,清理可确认删除的日志或旧备份,并为 RDB 目录设置容量告警。不要直接删除当前 dump.rdb;它可能是唯一可恢复副本。
Permission denied:确认 Redis 实际运行用户对 dir 有写和执行权限,父目录逐级具备执行权限,并检查安全上下文。只修正目标目录的属主、权限或策略,禁止用 chmod -R 777 扩大攻击面。
Read-only file system 或 I/O error:先处理文件系统、云盘或宿主机故障,再恢复写入。强行重挂载或反复执行 BGSAVE 可能扩大损坏范围。
fork: Cannot allocate memory、子进程被 OOM 杀死:检查主机可用内存、容器限制、内核日志和写入高峰。RDB 依赖 fork 与写时复制,大数据集在高写入期需要额外内存余量;只有日志明确指向内存分配策略时,才评估调整 vm.overcommit_memory。
修复后验证
确认磁盘、权限或内存问题已经解除后,再触发一次 BGSAVE。大实例应在低峰执行,并持续观察延迟、内存和磁盘 I/O;若 AOF 重写正在进行,先等待完成,或明确需要排队时使用 BGSAVE SCHEDULE。
export REDISCLI_AUTH='<PASSWORD>'  # 无密码实例可删除此行

before="$(redis-cli --raw LASTSAVE)"

redis-cli BGSAVE

while [ "$(redis-cli --raw INFO persistence   | awk -F: '$1=="rdb_bgsave_in_progress"{gsub("\r","",$2); print $2}')" = "1" ]; do
  sleep 1
done

redis-cli --raw INFO persistence   | grep -E '^(rdb_bgsave_in_progress|rdb_last_bgsave_status|rdb_last_save_time):'

after="$(redis-cli --raw LASTSAVE)"
printf 'before=%s after=%s\n' "$before" "$after"
预期输出:
Background saving started
rdb_bgsave_in_progress:0
rdb_last_save_time:<TIME_2>
rdb_last_bgsave_status:ok
before=<TIME_1> after=<TIME_2>
验证通过的条件是 rdb_last_bgsave_status:ok、后台进程归零,并且 <TIME_2> 晚于 <TIME_1>。同时确认目标目录产生了新的 RDB 文件,日志中没有紧随其后的写盘错误。
风险与边界
BGSAVE 会 fork 子进程并产生写时复制和磁盘写入压力;数据集大、写入密集或内存接近上限时,可能引发延迟抖动甚至 OOM。生产环境优先在低峰验证,并预留内存和磁盘空间。
把 stop-writes-on-bgsave-error 临时设为 no 只能绕过写保护,不能修复持久化;继续写入会扩大未落盘数据量。仅在业务明确接受数据丢失风险、已有外部副本并启用告警时作为应急措施,根因修复后应恢复原策略并重新验证 RDB。
systemd、findmnt、namei 和 journalctl 适用于常见 Linux 主机。Docker 应检查容器日志与绑定卷,Kubernetes 应检查 Pod 日志、PVC 和节点事件;托管 Redis 可能禁止 CONFIG 或 BGSAVE,此时使用服务商提供的持久化状态、事件和备份功能。
检查追加写入、文件重写、加载失败和文件损坏问题。
排查 AOF 异常
用于处理 AOF 追加失败、重写失败、重启加载失败或文件疑似损坏。先确认 Redis 实际使用的持久化路径和状态,再检查磁盘、权限与服务日志;文件修复必须在停服并完成备份后进行。
命令定位
先读取 INFO persistence 和 AOF 相关配置,避免按默认路径误判。aof_last_write_status 反映最近一次 AOF 写入,aof_last_bgrewrite_status 反映最近一次后台重写;任一为 err 都要继续查日志和文件系统。:contentReference[oaicite:0]{index=0}
redis-cli INFO persistence | grep -E '^(loading|aof_)'
redis-cli --raw CONFIG GET appendonly
redis-cli --raw CONFIG GET dir
redis-cli --raw CONFIG GET appenddirname
redis-cli --raw CONFIG GET appendfilename
预期输出
loading:0
aof_enabled:1
aof_rewrite_in_progress:0
aof_last_bgrewrite_status:ok
aof_last_write_status:ok
aof_current_size:12582912
aof_base_size:8388608
appendonly
yes
dir
/var/lib/redis
appenddirname
appendonlydir
appendfilename
appendonly.aof
读取时先确认 aof_enabled:1。aof_rewrite_in_progress:1 表示正在重写,不应重复触发;aof_current_size 明显大于 aof_base_size 只表示增量较多,需结合自动重写阈值和磁盘余量判断,不等同于损坏。
高频用法
定位实际文件并查看最近错误。Redis 7 及以上通常把 base、incremental 和 manifest 放在 dir/appenddirname;旧版本通常使用 dir/appendfilename。:contentReference[oaicite:1]{index=1}
REDIS_DIR=$(redis-cli --raw CONFIG GET dir | tail -n1)
AOF_DIRNAME=$(redis-cli --raw CONFIG GET appenddirname | tail -n1)
AOF_FILENAME=$(redis-cli --raw CONFIG GET appendfilename | tail -n1)

# Redis 7+ 通常使用目录;旧版本通常使用单文件。
if [ -n "$AOF_DIRNAME" ]; then
  AOF_PATH="$REDIS_DIR/$AOF_DIRNAME"
else
  AOF_PATH="$REDIS_DIR/$AOF_FILENAME"
fi

printf 'AOF path: %s\\n' "$AOF_PATH"
sudo ls -lah "$AOF_PATH"
sudo journalctl -u redis-server --since "30 min ago" --no-pager | grep -Ei 'aof|rewrite|short read|bad file format|no space|permission|read-only'
预期输出
AOF path: /var/lib/redis/appendonlydir
total 13M
-rw-r----- 1 redis redis 8.0M <TIME> appendonly.aof.1.base.rdb
-rw-r----- 1 redis redis 4.0M <TIME> appendonly.aof.1.incr.aof
-rw-r----- 1 redis redis   88 <TIME> appendonly.aof.manifest
<TIME> redis-server[<ID>]: Background append only file rewriting terminated with success
若日志出现 No space left on device,先处理容量或 inode;出现 Permission denied,检查目录属主、权限和 SELinux/AppArmor;出现 Read-only file system,先修复挂载或底层存储,不能只改 Redis 配置。
磁盘和权限恢复后,可主动重写并观察状态。watch 中看到 aof_rewrite_in_progress:0 且 aof_last_bgrewrite_status:ok 才算完成,按 Ctrl+C 退出。
redis-cli BGREWRITEAOF
watch -n 1 "redis-cli INFO persistence | grep -E '^(aof_rewrite_in_progress|aof_last_bgrewrite_status|aof_current_size|aof_base_size)'"
预期输出
Background append only file rewriting started
aof_rewrite_in_progress:0
aof_last_bgrewrite_status:ok
aof_current_size:8454144
aof_base_size:8388608
加载失败或疑似损坏时,先停服、备份,再只读检查。Redis 7 及以上应把 manifest 传给 redis-check-aof,工具会按 manifest 检查关联的 base 与 incremental 文件;旧版本传单个 AOF 文件。:contentReference[oaicite:2]{index=2}
REDIS_DIR=$(redis-cli --raw CONFIG GET dir | tail -n1)
AOF_DIRNAME=$(redis-cli --raw CONFIG GET appenddirname | tail -n1)
AOF_FILENAME=$(redis-cli --raw CONFIG GET appendfilename | tail -n1)

if [ -n "$AOF_DIRNAME" ]; then
  TARGET="$REDIS_DIR/$AOF_DIRNAME/$AOF_FILENAME.manifest"
  BACKUP="$REDIS_DIR/${AOF_DIRNAME}.bak-$(date +%Y%m%d%H%M%S)"
  sudo systemctl stop redis-server
  sudo cp -a "$REDIS_DIR/$AOF_DIRNAME" "$BACKUP"
else
  TARGET="$REDIS_DIR/$AOF_FILENAME"
  BACKUP="${TARGET}.bak-$(date +%Y%m%d%H%M%S)"
  sudo systemctl stop redis-server
  sudo cp -a "$TARGET" "$BACKUP"
fi

sudo redis-check-aof "$TARGET"
预期输出
Start checking Multi Part AOF
Start to check BASE AOF (RDB format).
BASE AOF appendonly.aof.1.base.rdb is valid
Start to check INCR files.
INCR AOF appendonly.aof.1.incr.aof is valid
All AOF files and manifest are valid
风险与边界
在线 AOF 仍在追加时复制、编辑或执行修复,可能得到相互不一致的 manifest 和分片;安全替代是先暂停写入或停服,再对完整目录做原样备份。redis-check-aof --fix 会从检测到的非法位置截断后续内容,损坏点越靠前,潜在数据丢失越大;应先运行不带 --fix 的检查,评估偏移量,并优先从可靠备份或健康副本恢复。:contentReference[oaicite:3]{index=3}
磁盘接近满、内存紧张或 fork 受限时触发 BGREWRITEAOF,可能因临时 base 文件、持续增量和写时复制开销再次失败;先释放足够磁盘余量并检查内存。不要通过删除在线 AOF、关闭 appendonly 或修改 manifest 来“快速恢复”,这些操作可能造成持久化缺口或重启数据丢失。
排障清单
- 确认
appendonly、dir、appenddirname、appendfilename的实际值。 - 检查
aof_last_write_status、aof_last_bgrewrite_status和 Redis 日志中的首个 I/O 错误。 - 同时检查磁盘容量、inode、只读挂载、目录权限和安全策略。
- 重写失败先修复环境,再触发一次
BGREWRITEAOF并等待状态回到ok。 - 加载失败先停服备份;Redis 7+ 检查 manifest,旧版本检查单文件。
- 修复后启动服务,核对 key 数、关键业务 key、复制状态和新的 AOF 写入状态。
兼容性
Redis 7.0 起采用多部分 AOF;更早版本通常是单文件。appenddirname 在旧版本可能返回空结果。systemd 单元可能叫 redis、redis-server 或实例化名称,执行停启和查日志前先用 systemctl list-units 'redis*' 确认。
判断磁盘满对持久化、日志、复制和服务可写性的影响。
处理磁盘空间不足
用于判断磁盘满、inode 耗尽或文件系统只读对 Redis 持久化、日志、复制和写请求的影响。处理顺序是先定位 Redis 实际挂载点,再阻止空间继续增长、释放经过确认的文件,最后验证持久化和业务写入恢复。
命令定位
不要只看根分区。先从 Redis 的 dir 找到实际文件系统,同时检查字节容量、inode、挂载参数、持久化状态和复制状态。
REDIS_DIR=$(redis-cli --raw CONFIG GET dir | tail -n1)
printf 'Redis dir: %s\\n' "$REDIS_DIR"

df -hT "$REDIS_DIR"
df -ih "$REDIS_DIR"
findmnt -T "$REDIS_DIR" -no TARGET,SOURCE,FSTYPE,OPTIONS
redis-cli INFO persistence | grep -E '^(rdb_|aof_)'
redis-cli INFO replication | grep -E '^(role|connected_slaves|master_link_status|master_sync_in_progress)'
sudo journalctl -u redis-server --since "30 min ago" --no-pager | grep -Ei 'no space left|read-only file system|short write|aof|bgsave|rdb'
预期输出
Redis dir: /var/lib/redis
Filesystem     Type  Size  Used Avail Use% Mounted on
/dev/sdb1      ext4   20G   20G  120M 100% /var/lib/redis
Filesystem     Inodes IUsed IFree IUse% Mounted on
/dev/sdb1        1.3M   42K  1.2M    4% /var/lib/redis
/var/lib/redis /dev/sdb1 ext4 rw,relatime
rdb_last_bgsave_status:err
aof_last_write_status:err
role:master
connected_slaves:2
<TIME> redis-server[<ID>]: Write error saving DB on disk: No space left on device
Use% 满而 IUse% 正常表示字节容量不足;IUse% 满则是小文件过多;挂载参数含 ro 表示文件系统只读。rdb_last_bgsave_status:err、aof_last_write_status:err 或 aof_last_bgrewrite_status:err 表明故障已经影响持久化。:contentReference[oaicite:4]{index=4}
高频用法
先找出同一文件系统中的大目录、大文件和“已删除但仍被进程占用”的文件。-x 与 -xdev 避免跨到其他挂载点。
sudo du -xhd1 "$REDIS_DIR" | sort -h
sudo find "$REDIS_DIR" -xdev -type f -printf '%s\\t%p\\n' | sort -nr | head -20 | numfmt --field=1 --to=iec
sudo lsof +L1 | grep "$REDIS_DIR" || true
预期输出
4.1G    /var/lib/redis/appendonlydir
9.8G    /var/lib/redis
8.0G /var/lib/redis/old-backups/dump-<TIME>.rdb
1.2G /var/lib/redis/appendonlydir/appendonly.aof.1.incr.aof
redis-server <ID> redis 7w REG 8,17 2.0G 0 <ID> /var/lib/redis/redis.log (deleted)
优先停止无界增长源,例如异常日志、重复备份或导出任务。对仍被进程占用的 deleted 文件,单纯 rm 不会再次释放空间;应让对应进程重新打开日志,或在变更窗口重启该进程。不要把 Redis 正在使用的 AOF、manifest、RDB 或临时重写文件当作普通旧文件删除。
当 Redis 与 systemd journal 位于同一文件系统,且旧日志允许清理时,可用容量上限回收日志;若不在同一文件系统,此操作不会改善 Redis 挂载点。
sudo journalctl --disk-usage
sudo journalctl --vacuum-size=500M
df -h "$REDIS_DIR"
预期输出
Archived and active journals take up 3.2G in the file system.
Vacuuming done, freed 2.7G of archived journals.
Filesystem      Size  Used Avail Use% Mounted on
/dev/sdb1        20G   17G  2.8G  86% /var/lib/redis
释放空间后,按已启用的持久化模式触发一次验证。AOF 与 RDB 后台任务不要并发触发;watch 中相应状态回到 ok 后按 Ctrl+C 退出。
AOF_ENABLED=$(redis-cli --raw CONFIG GET appendonly | tail -n1)

if [ "$AOF_ENABLED" = "yes" ]; then
  redis-cli BGREWRITEAOF
else
  redis-cli BGSAVE
fi

watch -n 1 "redis-cli INFO persistence | grep -E '^(rdb_bgsave_in_progress|rdb_last_bgsave_status|aof_rewrite_in_progress|aof_last_bgrewrite_status|aof_last_write_status)'"
预期输出
Background append only file rewriting started
rdb_bgsave_in_progress:0
rdb_last_bgsave_status:ok
aof_rewrite_in_progress:0
aof_last_bgrewrite_status:ok
aof_last_write_status:ok
持久化恢复后再做短生命周期写入探针,确认客户端不再收到 MISCONF 或 AOF 写错误。
redis-cli SET __disk_recovery_probe__ ok EX 60
redis-cli DEL __disk_recovery_probe__
预期输出
OK
(integer) 1
影响判断
RDB 保存失败且 stop-writes-on-bgsave-error yes 时,修改数据的命令可能返回 MISCONF;该保护用于暴露持久化故障。关闭此选项只会绕过保护,不会修复磁盘,也会让新写入继续停留在内存中。:contentReference[oaicite:5]{index=5}
AOF 追加、fsync 或重写可能失败,重启时还可能遇到尾部截断或文件损坏。磁盘式全量复制通常需要生成并传输 RDB,空间不足会使全量同步失败;使用无盘复制的实例仍需检查日志、AOF 和其他本地写入。:contentReference[oaicite:6]{index=6}
Redis 进程仍存活不代表安全:读请求可能继续成功,而持久化已经停止;主节点内存写入和副本复制也可能暂时继续,导致“服务可用但恢复点持续变旧”。必须把磁盘、持久化状态和复制状态一起验证。
风险与边界
在 100% 使用率时直接触发 BGREWRITEAOF 或 BGSAVE,可能创建新的临时文件并加重故障;安全替代是先停止增长源并释放可验证的余量。不要删除当前 AOF 目录、manifest、活动 RDB 或未知临时文件,否则可能造成重启失败或数据丢失。
不要把 CONFIG SET stop-writes-on-bgsave-error no 当成常规修复。只有业务明确接受持久化缺口、已有外部数据源可重建、并设置了持续告警时才可临时使用;磁盘恢复后应立即恢复保护并验证一次成功保存。
释放到 99% 并不足以保证恢复。应预留新 base/RDB、持续增量、日志和业务增长所需空间,并设置容量与 inode 双阈值告警。文件系统因底层错误切为只读时,删除文件通常无效,应先处理块设备、云盘、PVC、配额或宿主机故障。
排障清单
- 用 Redis
dir定位真实挂载点,不按默认目录猜测。 - 区分容量满、inode 满、配额满和只读挂载。
- 找出大文件、异常增长源和 deleted-open 文件。
- 先停止增长,再清理经过确认的日志、旧备份或非活动产物。
- 确认挂载恢复为
rw,Redis 用户对目录有写入和重命名权限。 - 触发一种持久化验证,等待状态回到
ok,再执行写入探针。 - 检查副本链路、全量同步失败记录、关键 key 和监控告警。
兼容性
find -printf、numfmt 和 findmnt 常见于 GNU/Linux;BusyBox 或精简容器可能缺少这些选项。容器环境要同时检查容器内路径、宿主机 bind mount、Docker overlay、Kubernetes PVC 容量和存储配额。systemd 单元名可能不是 redis-server,应按实际部署替换。
确认主从角色、复制链路、偏移量和同步状态是否正常。
检查 Redis 主从复制
用于确认节点角色、主从连接、同步阶段和复制偏移是否正常。优先在主节点与目标副本分别执行 INFO replication,再用 ROLE 交叉验证;不要只看 Sentinel 或编排平台显示的拓扑。
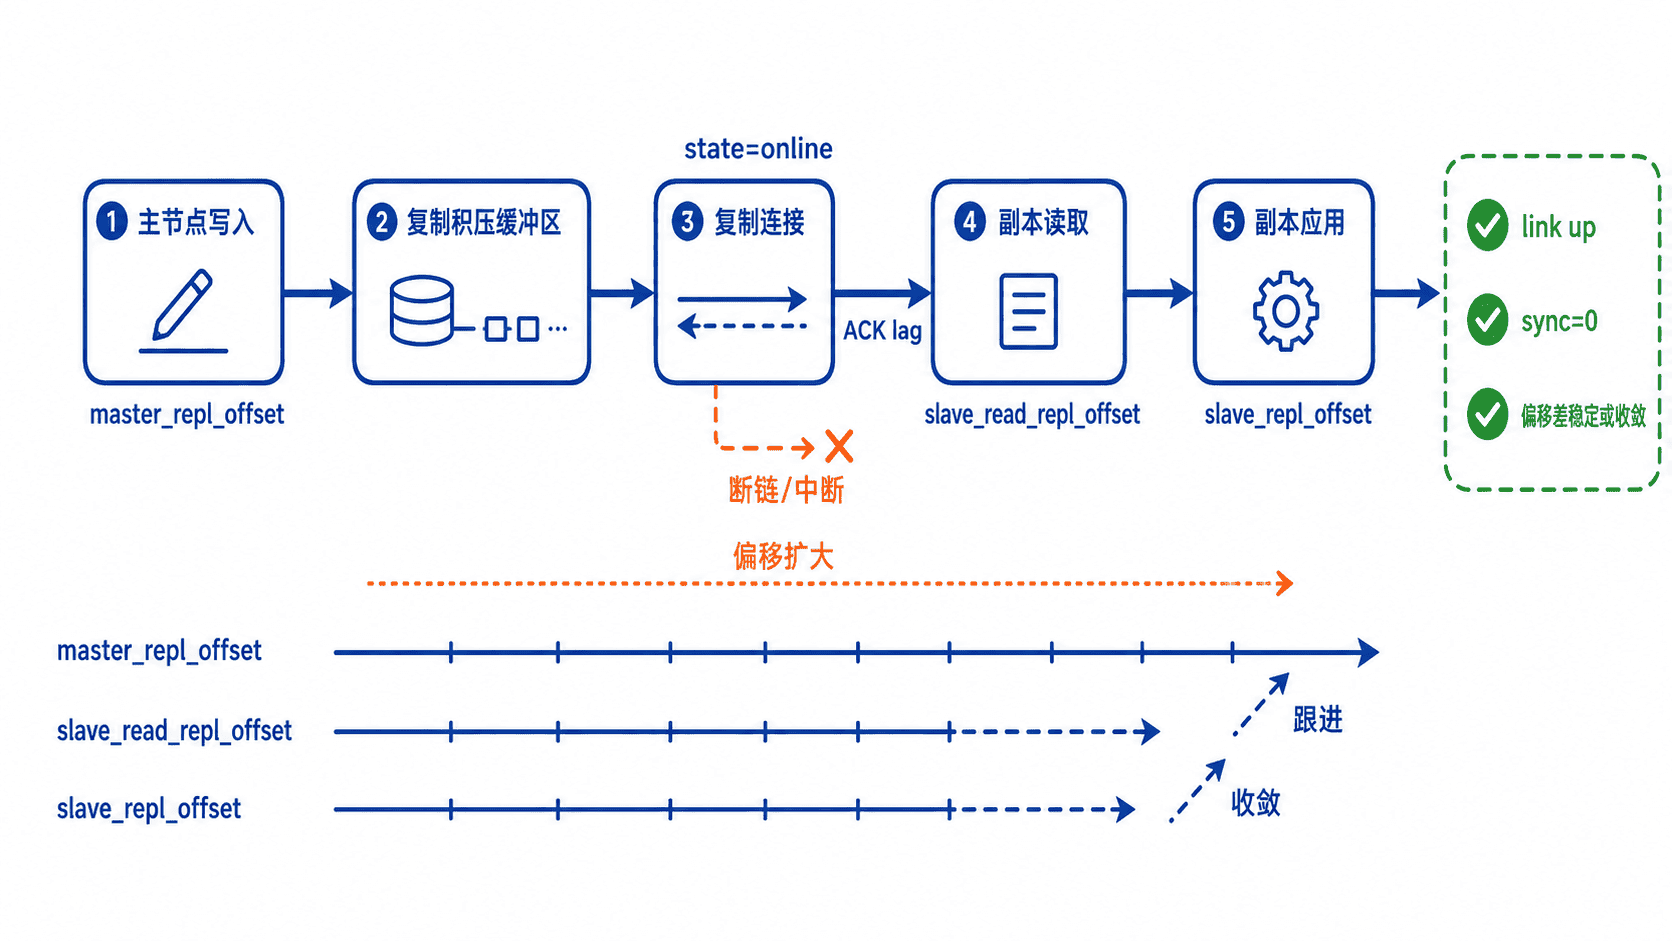
命令定位
INFO replication 提供完整复制状态,适合日常巡检和故障定位;ROLE 返回更精简的角色、上游地址及偏移量,适合快速确认连接到的实例是否正确。以下示例使用环境变量传递密码,避免密码出现在进程参数和 shell 历史中。
export REDISCLI_AUTH='<PASSWORD>'

echo '== primary =='
redis-cli -h 10.0.0.11 -p 6379 --raw INFO replication

echo '== replica =='
redis-cli -h 10.0.0.12 -p 6379 --raw INFO replication
预期输出(偏移量、复制 ID 等动态值以占位符表示):
== primary ==
# Replication
role:master
connected_slaves:1
slave0:ip=10.0.0.12,port=6379,state=online,offset=<REPLICA_OFFSET>,lag=0
master_repl_offset:<MASTER_OFFSET>
repl_backlog_active:1

== replica ==
# Replication
role:slave
master_host:10.0.0.11
master_port:6379
master_link_status:up
master_last_io_seconds_ago:0
master_sync_in_progress:0
slave_read_repl_offset:<READ_OFFSET>
slave_repl_offset:<APPLIED_OFFSET>
主节点应看到目标副本为 state=online;副本应看到 master_link_status:up 且 master_sync_in_progress:0。实际 IP、偏移量和复制 ID 会不同。
高频检查
先确认 role 是否符合预期,避免把旧主节点、错误端口或代理地址当成目标实例。随后检查副本的上游地址与端口,确认没有复制到错误主节点。
持续写入期间,主副本偏移量很难瞬间完全相等;关键是差值较小且不会连续扩大。主节点 slave0 中的 lag 是最近一次 ACK 距今的秒数,不是落后的字节数。需要快速交叉验证时执行:
export REDISCLI_AUTH='<PASSWORD>'
redis-cli -h 10.0.0.12 -p 6379 ROLE
预期输出:
1) "slave"
2) "10.0.0.11"
3) (integer) 6379
4) "connected"
5) (integer) <APPLIED_OFFSET>
输出中的 connected 表示复制连接已建立;最后一个整数是副本复制偏移。部分版本仍在协议字段中使用 slave,不代表配置错误。
输出字段说明
connected_slaves 是主节点当前已连接副本数;state=online 表示副本已进入在线复制。master_link_status 为 down 时应立即检查网络、认证、TLS、上游地址和主节点存活状态。
master_sync_in_progress:1 表示正在全量同步,此时延迟和资源占用通常会上升。slave_read_repl_offset 表示副本已从网络读取的位置,slave_repl_offset 表示副本已处理的位置;两者差距持续增大,通常说明副本处理速度不足。
repl_backlog_active:1 表示主节点复制积压缓冲区已启用。副本短暂断线后能否部分重同步,还取决于断线期间产生的数据量是否仍落在 backlog 覆盖范围内。
风险与边界
INFO 和 ROLE 是只读低开销命令,可直接用于生产巡检。不要在排查阶段随意执行 REPLICAOF、SLAVEOF 或故障转移命令;目标地址写错、角色切换或触发全量同步,可能导致数据覆盖、写入中断和网络突增。安全做法是先保存两端状态,再按变更窗口由 Sentinel、Cluster 或既定切换流程操作。
不要使用 redis-cli -a '<PASSWORD>' 直接传密钥;密码可能暴露在命令历史和进程列表中。优先使用 REDISCLI_AUTH、--askpass,并在完成后执行 unset REDISCLI_AUTH。
排障清单
- 主节点
role:master,副本role:slave,上游 IP 和端口符合预期。 - 主节点能看到目标副本且
state=online,副本显示master_link_status:up。 master_sync_in_progress为0,master_last_io_seconds_ago没有持续增长。- 主、副本偏移差在重复采样中稳定或收敛,而不是连续扩大。
- 频繁出现全量同步时,再检查
INFO stats中的sync_full、sync_partial_ok、sync_partial_err以及 backlog 容量。 - 修复后同时验证复制状态和业务读结果,避免只恢复链路但仍读取旧副本或本地缓存。
兼容性
Redis 新版文档通常使用 replica 术语,但 INFO replication 和 ROLE 的部分字段仍可能保留 slave 命名。Redis Cluster 需要逐个分片检查主节点及其副本;Sentinel 展示的是监控和选主视角,不能替代目标实例上的实际复制状态。
定位网络、磁盘、负载或副本处理能力导致的同步滞后。
排查 Redis 复制延迟
用于区分“数据尚未传到副本”和“数据已到副本但尚未处理”两类延迟。先同时采集主节点与副本偏移量,再结合连接、全量同步、CPU、磁盘和网络指标判断瓶颈,避免只凭 lag 字段下结论。
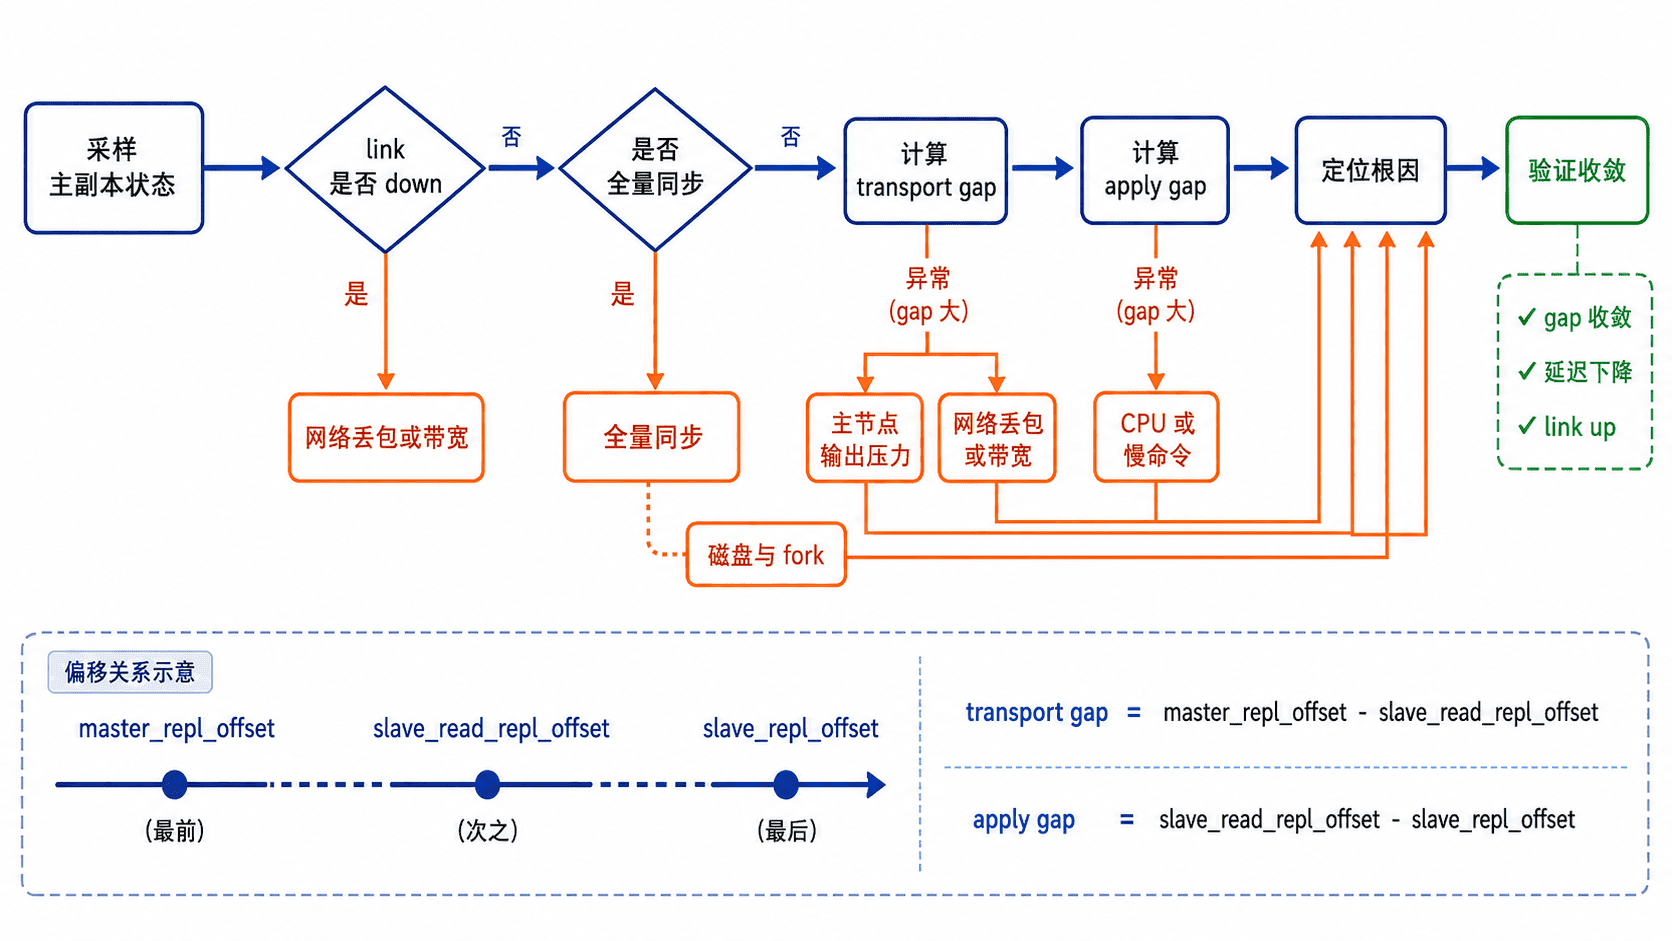
延迟分层
总复制缺口可近似拆成两段:主节点偏移减去副本已读取偏移,表示传输侧缺口;副本已读取偏移减去副本已处理偏移,表示应用侧缺口。三次查询不是原子快照,因此应观察连续趋势,而不是把单次差值当成精确结论。
传输缺口持续扩大,优先检查网络吞吐、丢包、主节点输出压力和副本读取事件是否被阻塞。应用缺口持续扩大,优先检查副本 CPU、长耗时命令、持久化 I/O、fork 与写时复制压力。
采样偏移量
以下脚本从副本先取读取与处理偏移,再从主节点取最新偏移,输出两个分段缺口。脚本只读,不修改 Redis 配置。
#!/usr/bin/env bash
set -euo pipefail

export REDISCLI_AUTH='<PASSWORD>'
MASTER_HOST='10.0.0.11'
REPLICA_HOST='10.0.0.12'
PORT='6379'

get_field() {
  redis-cli -h "$1" -p "$PORT" --raw INFO replication |
    awk -F: -v key="$2" '$1 == key { gsub(//, "", $2); print $2 }'
}

link_status="$(get_field "$REPLICA_HOST" master_link_status)"
syncing="$(get_field "$REPLICA_HOST" master_sync_in_progress)"
last_io="$(get_field "$REPLICA_HOST" master_last_io_seconds_ago)"
read_offset="$(get_field "$REPLICA_HOST" slave_read_repl_offset)"
applied_offset="$(get_field "$REPLICA_HOST" slave_repl_offset)"
master_offset="$(get_field "$MASTER_HOST" master_repl_offset)"

for value in "$master_offset" "$read_offset" "$applied_offset"; do
  [[ "$value" =~ ^[0-9]+$ ]] || {
    echo 'offset field missing or non-numeric; verify role and connectivity' >&2
    exit 1
  }
done

transport_gap=$((master_offset - read_offset))
apply_gap=$((read_offset - applied_offset))
total_gap=$((master_offset - applied_offset))

printf 'link_status=%s\n' "$link_status"
printf 'master_sync_in_progress=%s\n' "$syncing"
printf 'master_last_io_seconds_ago=%s\n' "$last_io"
printf 'master_offset=%s\n' "$master_offset"
printf 'replica_read_offset=%s\n' "$read_offset"
printf 'replica_applied_offset=%s\n' "$applied_offset"
printf 'transport_gap_bytes=%s\n' "$transport_gap"
printf 'apply_gap_bytes=%s\n' "$apply_gap"
printf 'total_gap_bytes=%s\n' "$total_gap"
预期输出:
link_status=up
master_sync_in_progress=0
master_last_io_seconds_ago=0
master_offset=<MASTER_OFFSET>
replica_read_offset=<READ_OFFSET>
replica_applied_offset=<APPLIED_OFFSET>
transport_gap_bytes=<BYTES>
apply_gap_bytes=<BYTES>
total_gap_bytes=<BYTES>
实际偏移和字节差会随写入变化。连续执行 5~10 次时,健康副本的总缺口通常保持较小或逐步收敛;持续单调增大才是需要处理的信号。
读取结果
link_status=down 或 master_last_io_seconds_ago 持续增长,说明复制流已中断或长时间无数据到达。先确认主节点可达、端口与认证一致,再检查 TLS、ACL、路由、防火墙、连接重置和主节点是否发生切换。
master_sync_in_progress=1 表示副本正在全量同步。此时重点观察主节点生成快照或无盘同步的资源压力、副本接收与加载速度、磁盘空间,以及同步期间是否再次断线。
传输缺口大而应用缺口小,表示副本处理得动但收不到足够快;应用缺口大,表示数据已经进入副本但主线程处理不过来。两者都大时,通常需要同时排查链路和副本资源。
定位常见瓶颈
网络侧从副本所在主机测量到主节点的 RTT、重传和可用带宽;容器或跨可用区部署还要核对限速、NAT、服务网格和连接跟踪。主节点侧关注 instantaneous_output_kbps、连接数及是否同时向多个副本或客户端大量发送数据。
副本侧对比多次 INFO cpu 采样,计算 CPU 增量而不是只看累计值;检查 SLOWLOG GET、大 key 操作和 Lua 脚本是否长时间占用主线程。再查看 INFO persistence 中的后台保存、AOF 重写及最近状态,结合系统磁盘延迟判断 I/O 或写时复制是否拖慢事件循环。
若断线后频繁进入全量同步,检查主节点 backlog 是否覆盖断线期间的复制流,并核对 sync_full、sync_partial_ok、sync_partial_err 的增长趋势。仅扩大 backlog 不能解决持续网络中断或副本长期处理不足。
风险与边界
复制偏移量单位是复制流字节,不是键数量,也不是直接的时间延迟。只有在写入速率相对稳定时,才能用“字节缺口 ÷ 每秒复制字节”粗略估算时间;写入突发、重连或全量同步期间不要这样换算。
不要在高负载生产实例上使用 MONITOR 追踪复制命令;它会显著增加输出和 CPU 压力,反而放大延迟。安全替代方案是使用 SLOWLOG、LATENCY LATEST、指标采样和短时网络观测。也不要为验证延迟随意执行大批量写入或 WAIT,这些操作可能阻塞业务客户端并改变现场负载。
排障清单
- 先确认角色和上游地址没有因故障转移而变化。
- 连续采样连接状态、同步状态和三类偏移,记录缺口是否扩大。
- 传输缺口扩大时检查 RTT、重传、带宽、主节点输出和副本 socket 读取。
- 应用缺口扩大时检查副本 CPU、慢命令、Lua、AOF、后台保存和磁盘延迟。
- 频繁全量同步时检查断线原因、backlog 覆盖范围和全量同步资源。
- 修复后确认总缺口持续收敛,并从业务侧验证副本读取的新数据已可见。
分析复制积压缓冲区、断线时间和复制标识变化。
处理频繁全量同步
用于定位副本断线后为什么没有执行部分重同步,而是反复传输 RDB。重点核对 sync_full 增量、复制积压缓冲区覆盖范围、断线期间产生的数据量,以及复制标识是否因重启、故障转移或重新编排而变化。
命令定位
先在主节点连续采样复制偏移量,再查看全量与部分同步计数。认证信息优先放入 REDISCLI_AUTH,避免密码出现在进程参数和 Shell 历史中。
export REDIS_HOST=127.0.0.1
export REDIS_PORT=6379
export REDISCLI_AUTH='<PASSWORD>'

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw INFO replication \
  | grep -E '^(role|connected_slaves|master_replid2?|master_repl_offset|second_repl_offset|repl_backlog_(active|size|first_byte_offset|histlen)):'

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw INFO stats \
  | grep -E '^sync_(full|partial_ok|partial_err):'

start_offset=$(redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw INFO replication \
  | awk -F: '/^master_repl_offset:/{gsub("\r","",$2); print $2}')
sleep 10
end_offset=$(redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw INFO replication \
  | awk -F: '/^master_repl_offset:/{gsub("\r","",$2); print $2}')
printf 'write_bytes_per_second=%s\n' "$(((end_offset-start_offset)/10))"
预期输出
role:master
connected_slaves:2
master_replid:<REPLID>
master_replid2:<REPLID2_OR_ZERO>
master_repl_offset:<CURRENT_OFFSET>
second_repl_offset:<SECOND_OFFSET>
repl_backlog_active:1
repl_backlog_size:268435456
repl_backlog_first_byte_offset:<FIRST_OFFSET>
repl_backlog_histlen:<HISTORY_BYTES>
sync_full:12
sync_partial_ok:3
sync_partial_err:9
write_bytes_per_second=<BYTES_PER_SECOND><REPLID>、偏移量和速率会随实例变化。若 sync_full、sync_partial_err 持续增长,而 sync_partial_ok 很少增长,说明副本请求的复制历史经常无法从积压缓冲区恢复。
判断链路
部分重同步必须同时满足两个条件:副本携带的复制标识仍被主节点识别,并且请求偏移量仍落在 repl_backlog_first_byte_offset 到 master_repl_offset 的历史范围内。断线期间的偏移差大于 repl_backlog_histlen 时,只能重新全量同步。
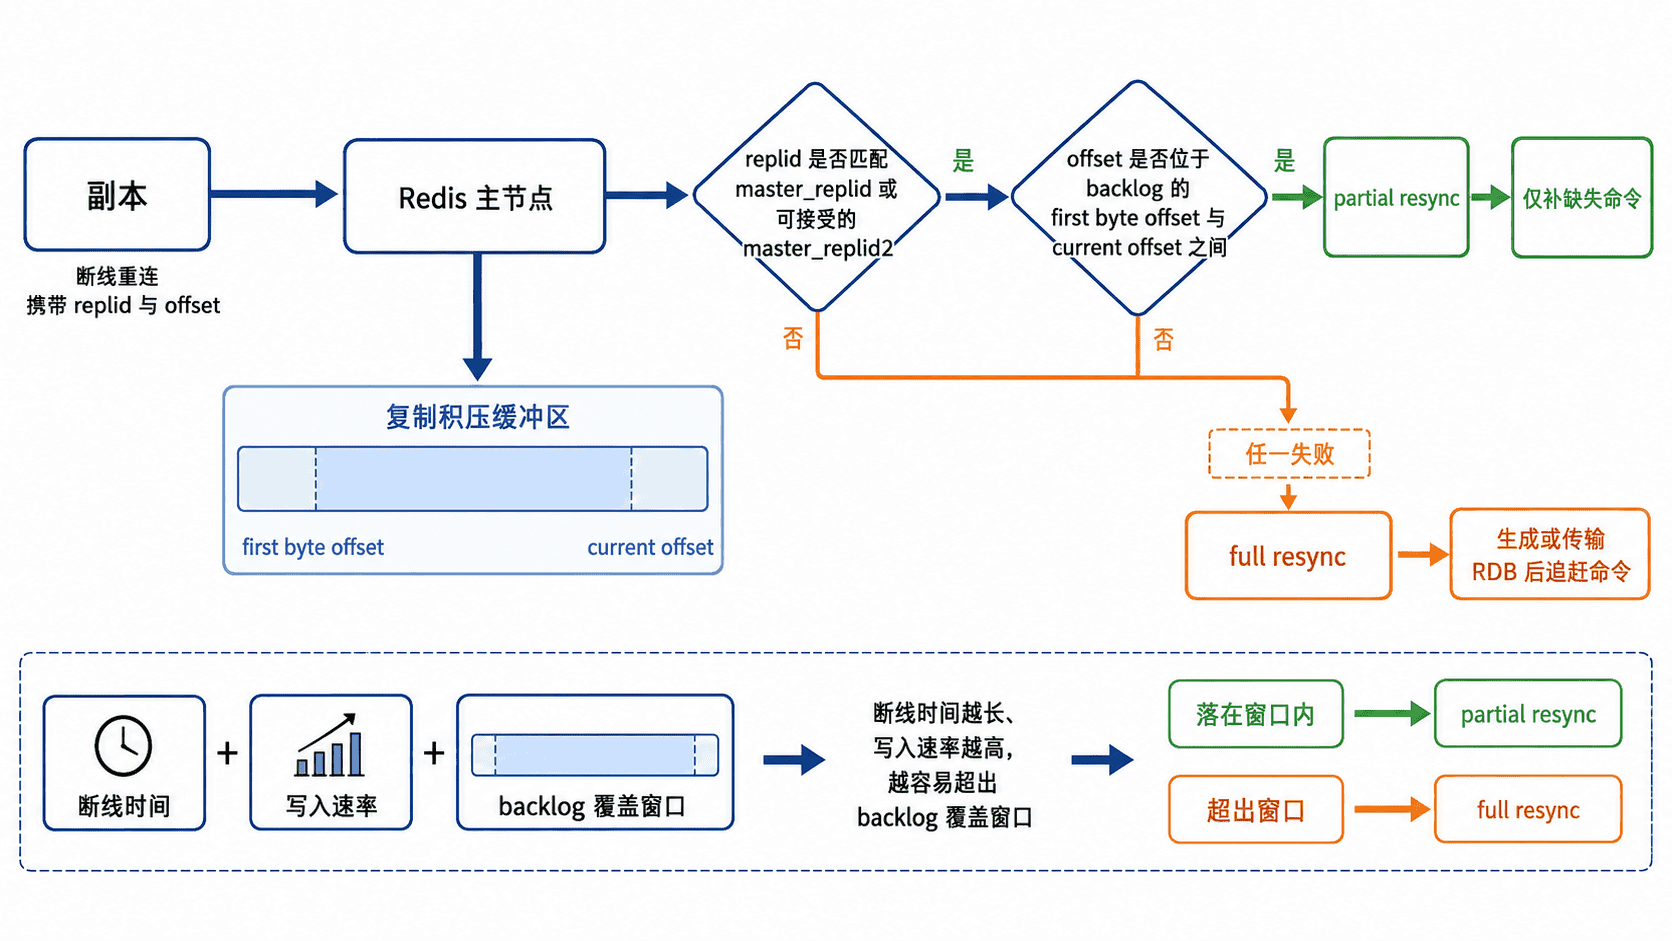
复制标识变化要结合事件判断。主节点重启通常丢失旧复制历史;副本晋升后会使用新的主复制标识,并可能通过 master_replid2 和 second_repl_offset 暂时兼容旧历史。若编排系统频繁重建实例,即使网络稳定也可能反复全量同步。
调整与验证
积压缓冲区可按“峰值复制字节速率 × 允许断线秒数 × 1.5~2 的安全系数”估算。确认实例有足够内存后再临时调整,并观察下一次短暂断线是否转为 sync_partial_ok。
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CONFIG SET repl-backlog-size 536870912
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CONFIG SET repl-backlog-ttl 3600
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw CONFIG GET 'repl-backlog-*'
预期输出
OK
OK
repl-backlog-size
536870912
repl-backlog-ttl
3600
这里将缓冲区设为 512 MiB,并在没有副本连接后一小时释放。验证时同时比较 sync_full、sync_partial_ok、主从链路抖动和断线时长,不能只看缓冲区大小。
风险与边界
增大 repl-backlog-size 会直接占用更多内存;在接近 maxmemory 或宿主机内存上限时,可能引发键淘汰、延迟抖动甚至 OOM。安全做法是先预留内存,再分级放大并在业务低峰观察 RSS、延迟和淘汰计数。
将 repl-backlog-ttl 设为 0 会在无副本连接时永久保留缓冲区,适合需要长期等待副本回归且内存充足的场景。CONFIG SET 可能不会跨重启保留,生产环境应同步到配置文件或托管服务参数组;不要在未备份和未审批时直接执行 CONFIG REWRITE。
排障清单
- 网络抖动时检查副本的
master_link_status、master_last_io_seconds_ago与断线持续时间。 - 主节点重启、容器重建或故障转移后,核对
master_replid、master_replid2和相关时间点。 - 比较偏移增长速率与 backlog 覆盖秒数,确认峰值期间仍能覆盖预期断线窗口。
- 排查磁盘慢、fork 延迟或带宽不足导致全量同步本身失败并再次触发同步。
- 调整后至少制造一次受控短断线,确认
sync_partial_ok增长且sync_full不再增加。
兼容性
Redis 4.0 及以上使用双复制标识支持故障转移后的部分重同步。旧版本字段和行为可能不同;云托管 Redis 还可能禁止 CONFIG SET,此时应通过实例参数模板调整。集群模式下要逐个主分片检查,因为每个主节点都有独立的复制历史和积压缓冲区。
查看哨兵监控目标、主观下线、客观下线和领导者选举状态。
检查哨兵状态
用于判断 Redis Sentinel 当前监控的主节点是谁、是否进入主观下线或客观下线,以及故障转移是否卡在选举或副本提升阶段。检查时必须从多个 Sentinel 节点交叉取证,单个节点的视图不足以代表整个仲裁结果。
状态检查
先查询当前 Sentinel 的身份、主节点地址、关键状态字段和仲裁可用性。以下命令对一个 Sentinel 执行,生产排障时应在所有 Sentinel 节点重复运行并比较结果。
export SENTINEL_HOST=127.0.0.1
export SENTINEL_PORT=26379
export MASTER_NAME=mymaster

printf 'sentinel_id='
redis-cli -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" --raw SENTINEL MYID

printf 'master_addr='
redis-cli -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" --raw \
  SENTINEL GET-MASTER-ADDR-BY-NAME "$MASTER_NAME" | paste -sd: -

redis-cli -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" --raw \
  SENTINEL MASTER "$MASTER_NAME" | awk '
NR % 2 == 1 { key=$0; next }
key=="name" || key=="ip" || key=="port" || key=="flags" ||
key=="config-epoch" || key=="quorum" || key=="num-slaves" ||
key=="num-other-sentinels" { printf "%s=%s\n", key, $0 }
'

redis-cli -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" \
  SENTINEL CKQUORUM "$MASTER_NAME"
预期输出
sentinel_id=<SENTINEL_ID>
master_addr=10.0.0.20:6379
name=mymaster
ip=10.0.0.20
port=6379
flags=master
config-epoch=12
num-slaves=2
num-other-sentinels=2
quorum=2
OK 3 usable Sentinels. Quorum and failover authorization can be reached
flags=master 表示当前视图正常;出现 s_down 代表本 Sentinel 已主观判定目标不可达,出现 o_down 代表达到配置的 quorum。CKQUORUM 成功还会确认故障转移授权所需的多数派可达。
下线与选举链路
主观下线是单个 Sentinel 根据 down-after-milliseconds 做出的本地判断;客观下线需要足够多 Sentinel 对同一主节点达成 quorum。真正启动故障转移时,还需要当前配置纪元中的多数派授权并选出领导者。
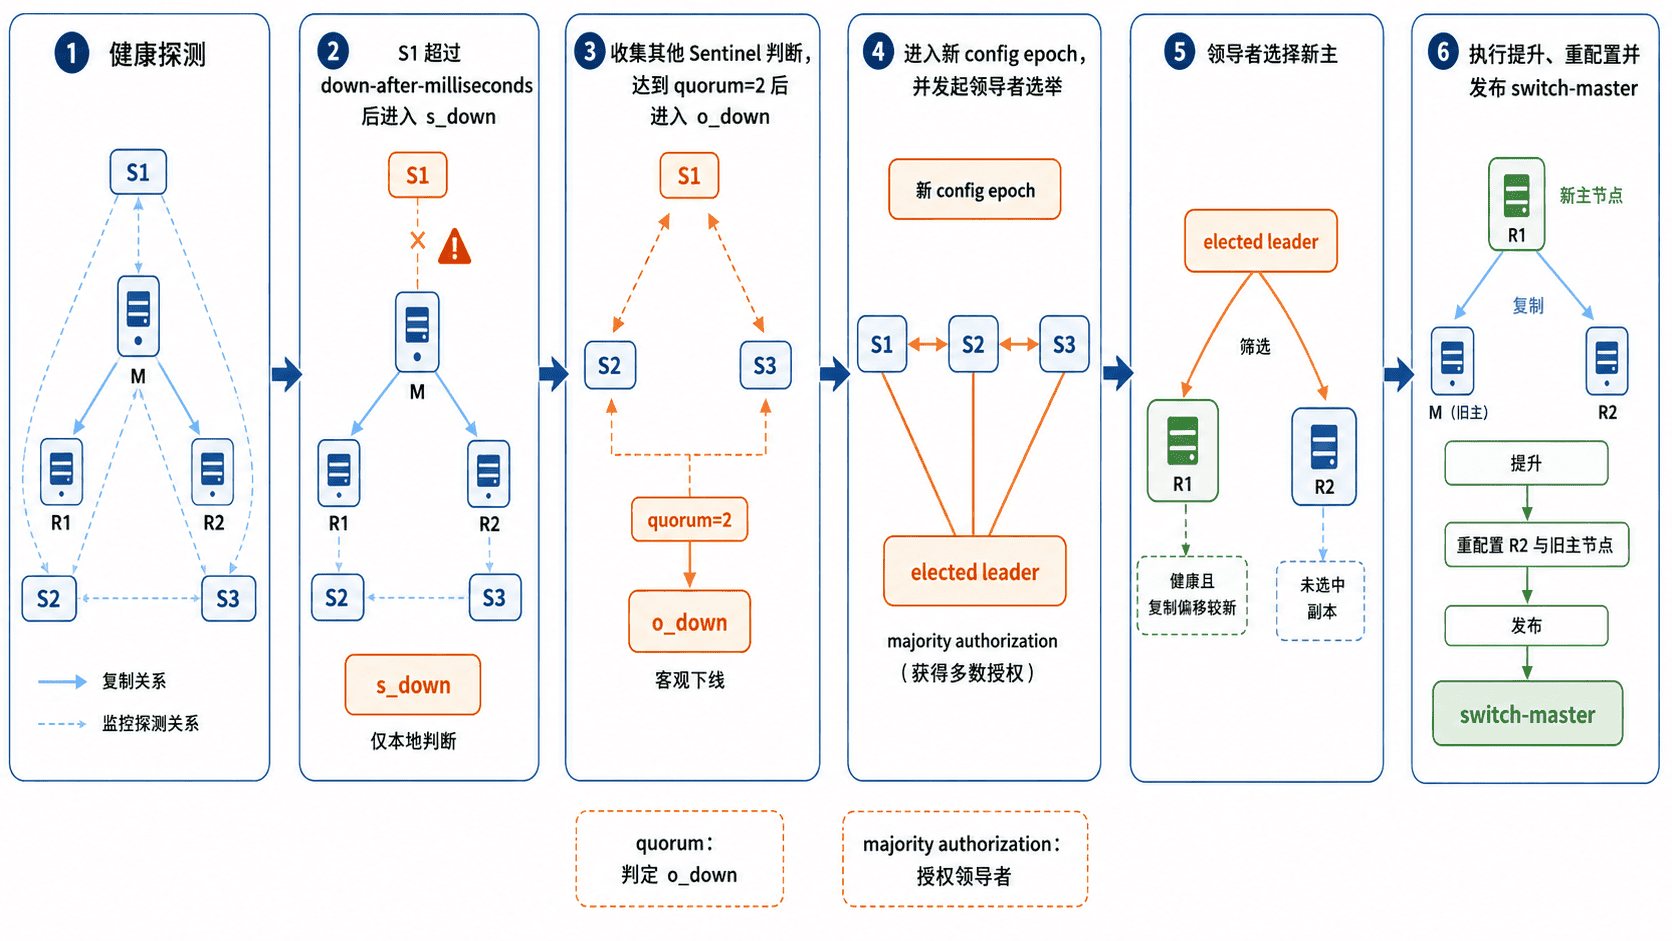
若不同 Sentinel 返回的 master_addr 或 config-epoch 不一致,通常表示节点间通信中断、部分节点刚恢复、配置传播尚未完成,或存在旧 Sentinel 仍在监控同名但不同地址的主节点。先恢复 Sentinel 之间的 TCP 连通与名称配置,再判断是否需要人工干预。
观察故障转移事件
Sentinel 会通过 Pub/Sub 发布状态事件。订阅关键频道可实时确认故障转移停在哪一步;该命令会持续阻塞,按 Ctrl+C 退出。
redis-cli -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" --raw SUBSCRIBE \
  +sdown +odown +new-epoch +vote-for-leader +elected-leader \
  +failover-state-select-slave +selected-slave +switch-master
预期输出
message
+sdown
master mymaster 10.0.0.20 6379
message
+odown
master mymaster 10.0.0.20 6379 #quorum 2/2
message
+elected-leader
master mymaster 10.0.0.20 6379
message
+selected-slave
slave 10.0.0.21:6379 10.0.0.21 6379 @ mymaster 10.0.0.20 6379
message
+switch-master
mymaster 10.0.0.20 6379 10.0.0.21 6379
地址、纪元和事件顺序会随现场变化。只有 +sdown 而没有 +odown,优先检查 Sentinel 数量、quorum、节点间连通和时钟停顿;已有 +odown 但没有 +elected-leader,重点检查多数派是否可达;已选出领导者但没有 +switch-master,继续检查候选副本健康、复制偏移、优先级和提升超时。
风险与边界
降低 down-after-milliseconds 会让短时网络抖动更容易触发误切换,可能造成写入中断、频繁主从切换和旧主恢复后的数据分叉。安全做法是先量化正常抖动时长,并同时检查 Sentinel 到主节点及 Sentinel 彼此之间的网络质量。
SENTINEL FAILOVER 会主动发起故障转移,SENTINEL RESET 会清理匹配主节点的已发现状态。两者都不应作为“刷新状态”的常规命令;执行前要冻结或协调写入口、确认候选副本可用,并准备在客户端侧验证新主地址。
排障清单
- 所有 Sentinel 的监控名称、主地址、端口、quorum 和认证配置必须一致。
num-other-sentinels应与预期拓扑相符;数量偏少时检查 announce 地址、NAT、防火墙和端口映射。- 对比各节点
config-epoch、flags和GET-MASTER-ADDR-BY-NAME,识别落后或孤立视图。 - 检查副本是否在线、复制延迟是否可接受、
replica-priority是否为0,避免没有可提升候选。 - 客户端必须通过 Sentinel 重新发现主节点;只修复 Sentinel 而客户端仍写旧地址,故障不会真正恢复。
兼容性
较新的 Redis 使用 SENTINEL REPLICAS <master-name> 查看副本,旧环境常见 SENTINEL SLAVES <master-name>。托管服务可能隐藏 Sentinel 端口或限制管理命令,此时应使用服务商提供的故障转移事件和主节点发现接口。容器或 NAT 环境还要正确配置 announce 地址与端口,否则 Sentinel 彼此看到的拓扑可能不可达。
检查哨兵仲裁数量、副本可用性、网络和故障转移超时。
排查 Redis Sentinel 故障转移失败
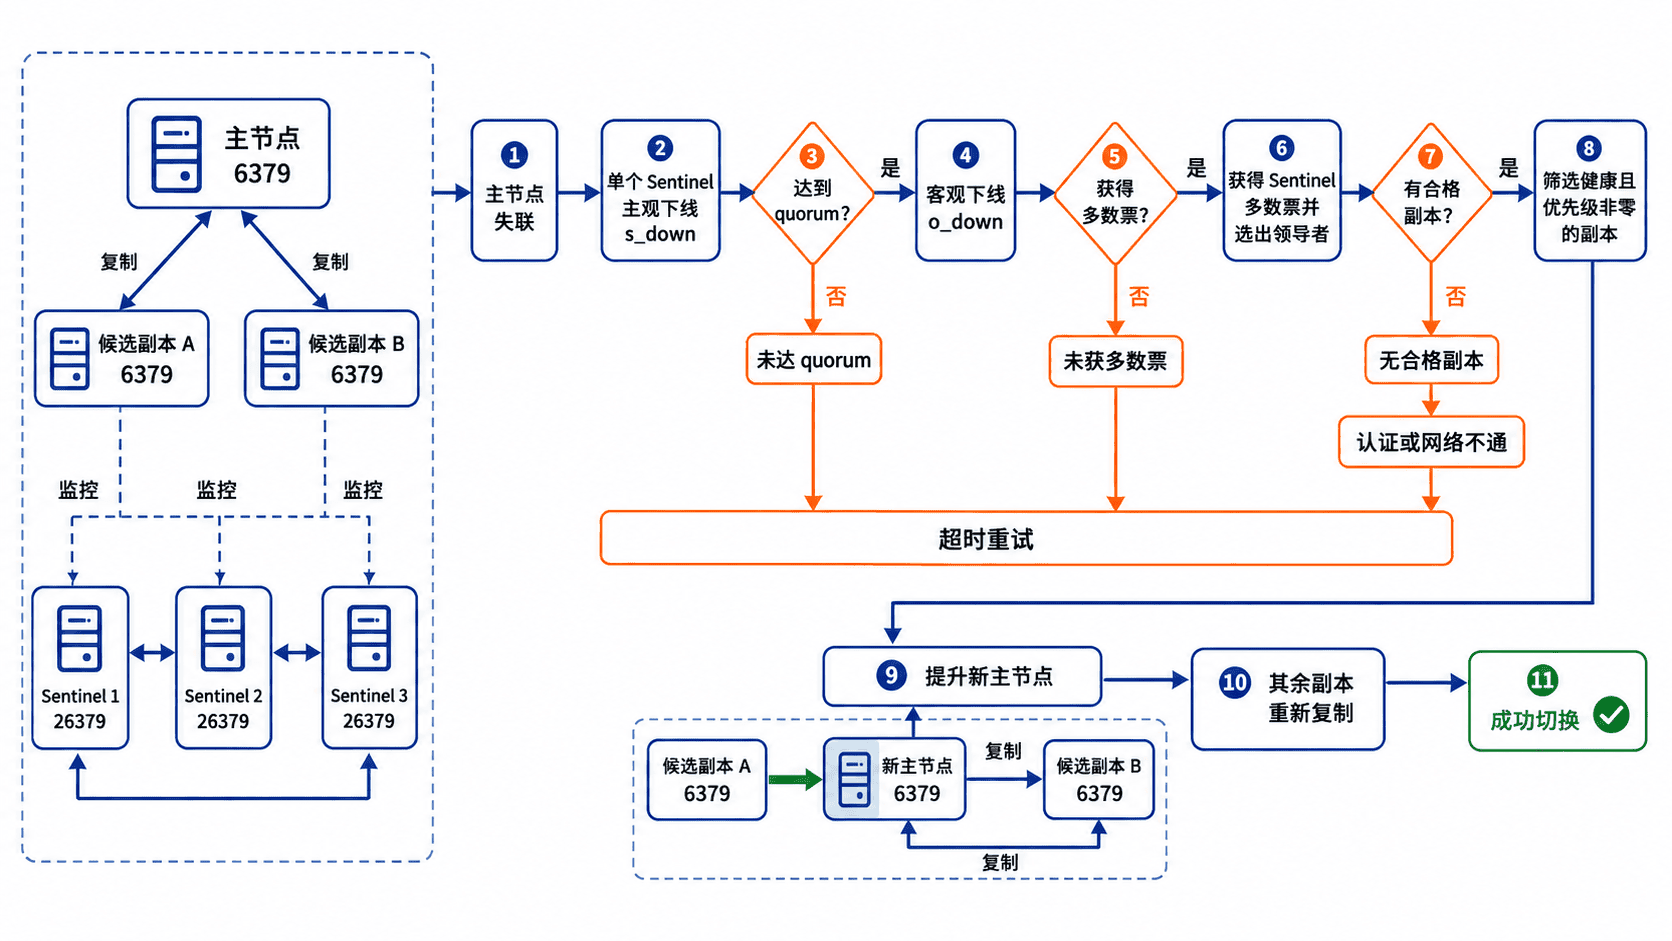
当主节点不可达但副本未被提升时,先确认 Sentinel 是否同时具备故障判定仲裁和领导者选举多数票,再检查候选副本、节点互通与超时配置。不要一开始就执行强制切换;先定位流程卡在检测、授权、选主还是重配置阶段。:contentReference[oaicite:0]{index=0}
命令定位
从任意一个监控该主节点的 Sentinel 执行 SENTINEL CKQUORUM、SENTINEL MASTER 和 SENTINEL REPLICAS。Sentinel 默认监听 26379,MASTER_NAME 必须与 sentinel monitor 中的名称完全一致;启用 ACL 或 TLS 时,应给每个 redis-cli 调用补充现场认证参数。:contentReference[oaicite:1]{index=1}
高频用法
下面一次读取仲裁结果、主节点视图和候选副本关键字段。示例依赖 Linux 常见的 paste、grep,变量替换为现场值后可直接执行。
SENTINEL_HOST=10.0.0.11
SENTINEL_PORT=26379
MASTER_NAME=mymaster

redis-cli -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" \
  SENTINEL CKQUORUM "$MASTER_NAME"

redis-cli --raw -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" \
  SENTINEL MASTER "$MASTER_NAME" \
  | paste - - \
  | grep -E '^(flags|num-slaves|num-other-sentinels|quorum|down-after-milliseconds|failover-timeout)[[:space:]]'

redis-cli --raw -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" \
  SENTINEL REPLICAS "$MASTER_NAME" \
  | paste - - \
| grep -E '^(name|flags|master-link-status|master-link-down-time|slave-priority|slave-repl-offset|replica-announced)[[:space:]]'预期输出为以下正常形态,<REPLICA_HOST> 和 <OFFSET> 会随环境变化。
OK 3 usable Sentinels. Quorum and failover authorization can be reached
flags  master
num-slaves  2
num-other-sentinels  2
quorum  2
down-after-milliseconds  5000
failover-timeout  60000
name  <REPLICA_HOST>:6379
flags  slave
master-link-down-time  0
master-link-status  ok
slave-priority  100
slave-repl-offset  <OFFSET>
replica-announced  1
CKQUORUM 返回 OK 表示当前 Sentinel 视图既能达到故障判定所需的 quorum,也能达到授权故障转移所需的多数票;它不代表副本一定可被提升。:contentReference[oaicite:2]{index=2}
输出字段说明
num-other-sentinels不包含当前 Sentinel,需加一后与部署数量核对;quorum仅用于确认主节点客观下线,真正执行故障转移还需要 Sentinel 多数票。:contentReference[oaicite:3]{index=3}flags出现s_down表示当前 Sentinel 主观判定不可达,出现o_down表示已达到仲裁;长期只有s_down,通常指向 Sentinel 之间不通或数量不足。:contentReference[oaicite:4]{index=4}- 候选副本应无下线或断连标志,
master-link-status为ok,slave-priority大于0,并尽量拥有更新的slave-repl-offset;字段仍沿用slave-*名称。:contentReference[oaicite:5]{index=5}
排障清单
CKQUORUM失败时,先核对所有 Sentinel 的主节点名称、quorum 配置和已发现数量,再检查 Sentinel 之间的26379/TCP双向连通;只恢复主节点到单个 Sentinel 的网络不能完成多数票授权。:contentReference[oaicite:6]{index=6}- 仲裁正常但没有可提升副本时,检查副本进程、数据端口、认证、复制链路、优先级和复制偏移量。
replica-priority 0会阻止该副本被提升;仅增加 Sentinel 数量不能解决候选副本不可用。:contentReference[oaicite:7]{index=7} - 已选中副本却未完成提升时,检查 Sentinel 到副本数据端口的网络与认证,并按日志事件定位:
+sdown、+odown、+try-failover、+elected-leader、+selected-slave、+promoted-slave。停在某一事件后,优先修复该阶段依赖,不要重复强制切换。:contentReference[oaicite:8]{index=8} - 频繁误判或重复重试时,检查
down-after-milliseconds是否小于正常网络抖动窗口,以及failover-timeout是否足以覆盖选举、提升和重配置。调大参数会延长真实故障恢复,调小则可能增加误切换或失败重试。:contentReference[oaicite:9]{index=9}
风险与边界
在主节点仍可写、网络存在分区或副本明显落后时执行 SENTINEL FAILOVER,可能造成不必要的角色切换、短暂写入中断,并扩大异步复制下已确认写入丢失的窗口。安全替代方案是先通过 CKQUORUM、副本链路和偏移量确认条件,在维护窗口冻结或收敛写流量后再做受控切换。:contentReference[oaicite:10]{index=10}
不要为清状态随意执行 SENTINEL RESET;它会清除匹配主节点的已发现副本、其他 Sentinel 和进行中的故障转移状态。修改 SENTINEL SET 也不会自动传播到其他 Sentinel,应逐台应用并重新核对视图。:contentReference[oaicite:11]{index=11}
兼容性
SENTINEL REPLICAS 从 Redis 5.0 起可用,更老版本使用 SENTINEL SLAVES。Redis 6.2 起可使用 Sentinel ACL 管理命令;升级混合版本集群时,应以最低版本支持的子命令和认证方式为准。:contentReference[oaicite:12]{index=12}
确认集群状态、节点数量、槽位覆盖和主从分布是否正常。
检查 Redis Cluster 健康
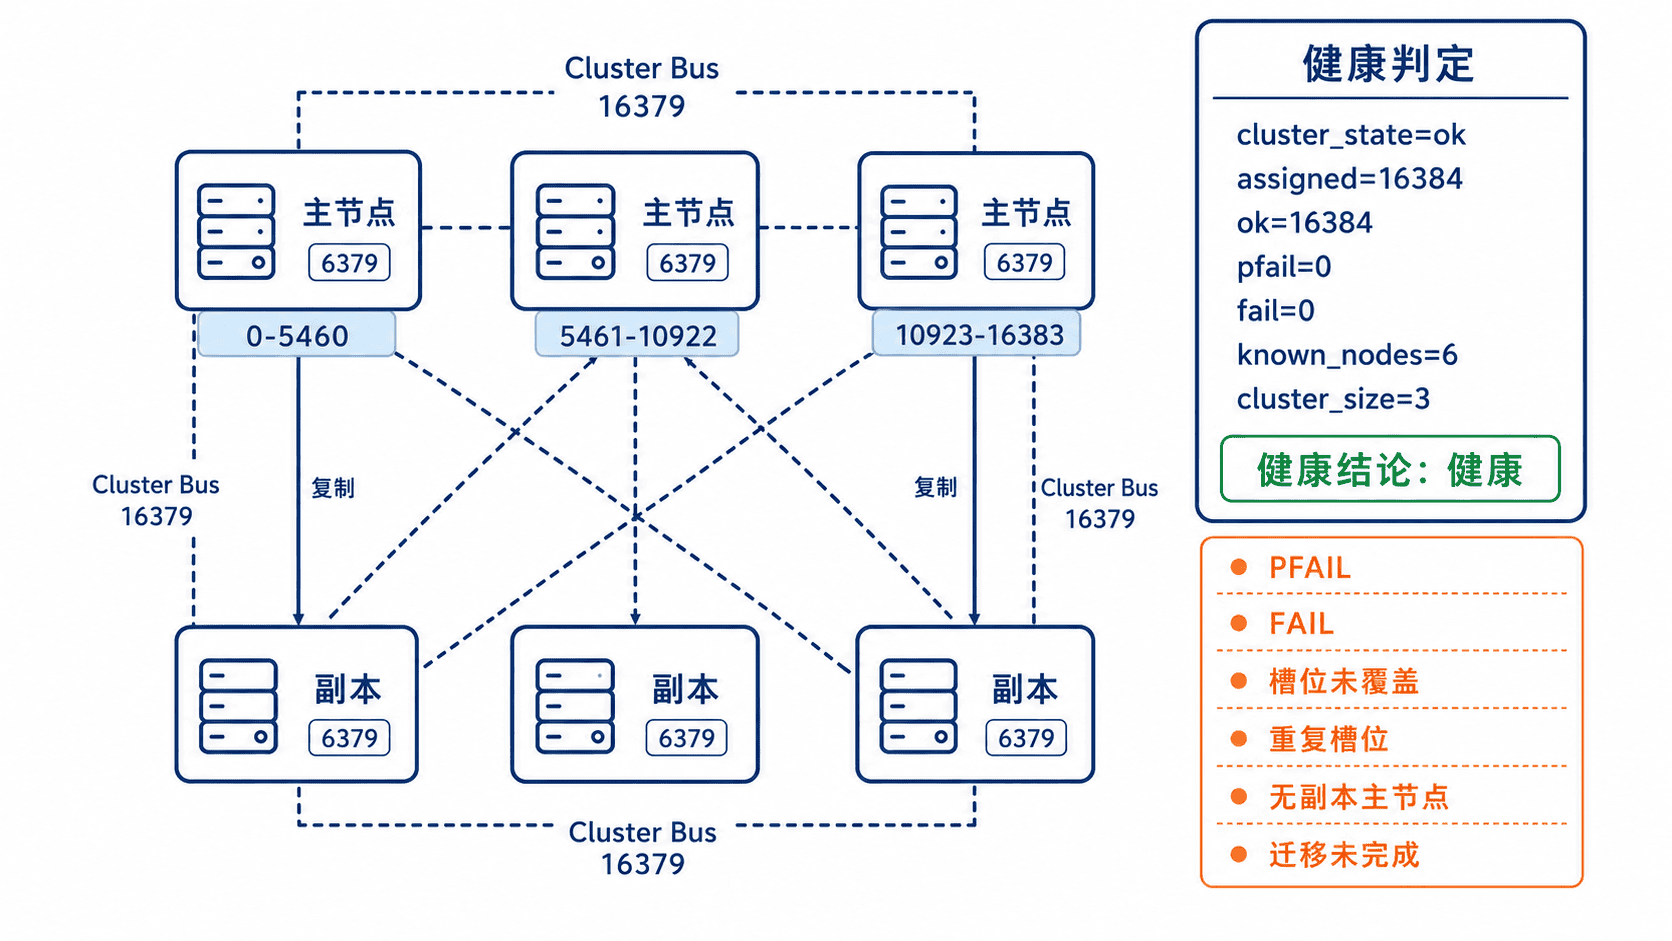
检查集群健康时,先用 CLUSTER INFO 判断整体状态和槽位,再用 CLUSTER NODES 核对节点角色、连接和槽位归属,最后用 redis-cli --cluster check 检查各节点是否认同同一份槽位配置。单个 PING 成功不能证明集群健康。:contentReference[oaicite:13]{index=13}
命令定位
从任意一个集群节点执行管理命令即可;CLUSTER INFO 和 CLUSTER NODES 反映的是被查询节点当前看到的集群视图。出现异常时,应至少再查询一个不同主节点,避免把局部过期视图当成全局事实。:contentReference[oaicite:14]{index=14}
高频用法
下面过滤出最关键的健康字段、节点角色与槽位,并执行完整槽位一致性检查。示例依赖 Linux 常见的 grep、awk。
NODE_HOST=10.0.0.11
NODE_PORT=6379

redis-cli --raw -h "$NODE_HOST" -p "$NODE_PORT" CLUSTER INFO \
  | grep -E '^(cluster_state|cluster_slots_assigned|cluster_slots_ok|cluster_slots_pfail|cluster_slots_fail|cluster_known_nodes|cluster_size):'

redis-cli --raw -h "$NODE_HOST" -p "$NODE_PORT" CLUSTER NODES \
  | awk '{printf "%s %s %s %s %s", $1,$2,$3,$4,$8; for(i=9;i<=NF;i++) printf " %s",$i; print ""}'

redis-cli --cluster check "$NODE_HOST:$NODE_PORT" \
  | grep -E '^\[(OK|ERR)\]|^>>> Check'
预期输出为以下正常形态,节点 ID 与地址占位符会随环境变化。
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
<NODE_ID_1> <NODE_HOST_1>:6379@16379 myself,master - connected 0-5460
<NODE_ID_2> <NODE_HOST_2>:6379@16379 master - connected 5461-10922
<NODE_ID_3> <NODE_HOST_3>:6379@16379 master - connected 10923-16383
<REPLICA_ID_1> <REPLICA_HOST_1>:6379@16379 slave <NODE_ID_1> connected
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
正常结论是 cluster_state:ok、全部 16384 个槽位已分配且健康、pfail 与 fail 都为 0,并且 --cluster check 未报告开放槽位、重复归属或配置分歧。:contentReference[oaicite:15]{index=15}
输出字段说明
cluster_state:fail表示至少存在未绑定槽位、服务槽位的节点被标记为FAIL,或当前节点无法联系到主节点多数派;它不是单纯的进程存活状态。:contentReference[oaicite:16]{index=16}cluster_slots_assigned应为16384,cluster_slots_ok应与之相等;cluster_slots_pfail是当前节点暂时无法联系对应节点的槽位数,cluster_slots_fail是已确认故障的槽位数。:contentReference[oaicite:17]{index=17}cluster_known_nodes是当前节点知道的节点总数,可能包含HANDSHAKE节点;cluster_size是至少负责一个槽位的主节点数量,不等于所有节点数量。:contentReference[oaicite:18]{index=18}CLUSTER NODES中master、slave表示角色,fail?表示PFAIL,fail表示已确认故障,connected表示 Cluster Bus 链路状态;第九列以后是主节点负责的槽位或迁移标记。:contentReference[oaicite:19]{index=19}
排障清单
cluster_state:fail且cluster_slots_assigned小于16384时,先查明缺失槽位原属哪个主节点以及是否存在未完成迁移。不要直接把缺失槽位分给任意节点,否则可能制造双重归属或让原数据不可达。:contentReference[oaicite:20]{index=20}cluster_slots_pfail大于0时,检查节点间 Cluster Bus。未显式配置cluster-port时,总线端口通常是数据端口加10000,例如6379对应16379;同时检查丢包、时延、防火墙和地址宣告是否正确。:contentReference[oaicite:21]{index=21}cluster_slots_fail大于0或节点带fail标志时,确认故障主节点是否有在线副本、集群是否具备主节点多数派,并检查副本是否已完成自动提升。某个主节点没有副本时,其故障会直接影响对应槽位可用性。:contentReference[oaicite:22]{index=22}known_nodes与规划不符时,重点查handshake、noaddr、重复旧节点和各主节点视图差异。--cluster check报开放槽位或配置不一致时,先停止正在进行的扩缩容或迁移,再确定唯一正确的槽位所有者。:contentReference[oaicite:23]{index=23}- 主从分布不均或某主节点无副本时,应在恢复健康后重新分配副本;先处理网络、故障节点和槽位一致性,再做均衡,避免在异常状态下同时改变拓扑和数据归属。:contentReference[oaicite:24]{index=24}
风险与边界
CLUSTER NODES 是单节点视图,不能单独证明所有节点已收敛;即使配置 cluster-require-full-coverage no 后部分槽位仍可服务,也不代表集群健康。应结合多节点视图、CLUSTER INFO 和 --cluster check 判断。:contentReference[oaicite:25]{index=25}
在槽位所有者不明确、迁移未完成或仍有网络分区时执行 redis-cli --cluster fix、CLUSTER SETSLOT、ADDSLOTS、DELSLOTS、CLUSTER FORGET 或 CLUSTER RESET,可能造成错误路由、双重归属、节点被永久移除或数据不可达。安全替代方案是先备份、暂停拓扑变更、对比多个主节点视图并确认唯一槽位所有者,再在维护窗口做受控修复。:contentReference[oaicite:26]{index=26}
兼容性
CLUSTER INFO 和 CLUSTER NODES 从 Redis 3.0 起可用。面向客户端获取槽位映射时,当前文档建议优先使用 CLUSTER SHARDS;CLUSTER NODES 仍适合运维排障、配置检查和拓扑核对。:contentReference[oaicite:27]{index=27}
定位槽位缺失、重复分配、迁移中断和导入状态残留。
排查槽位异常
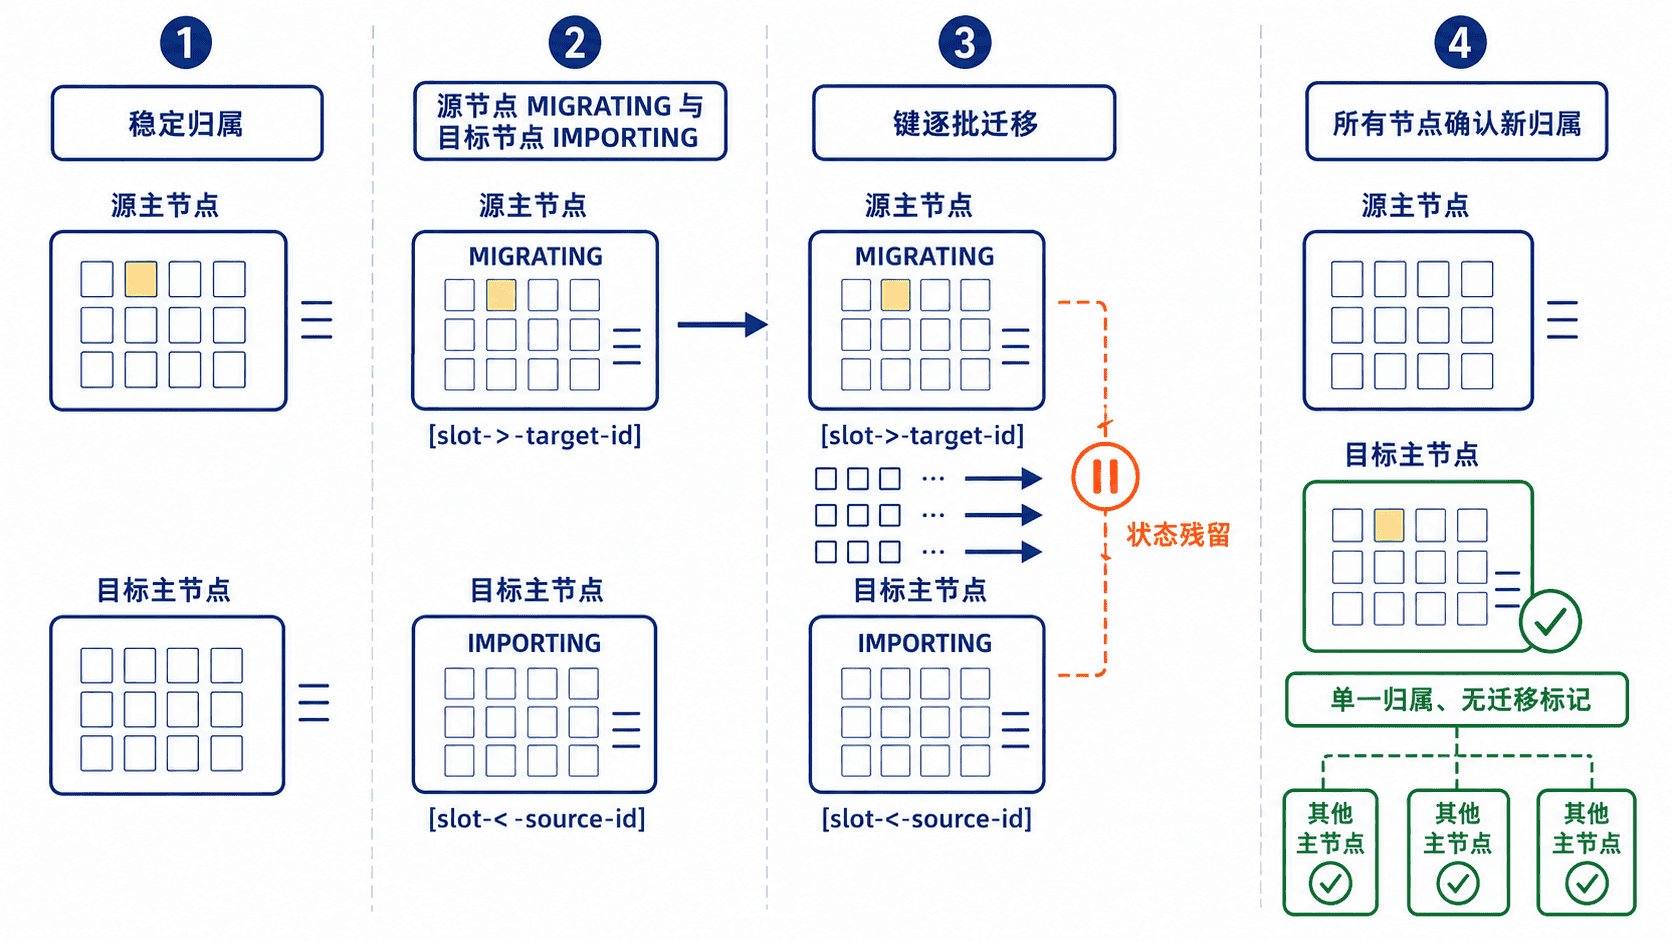
用于定位 Redis Cluster 的 16384 个槽位是否完整覆盖、各节点槽位视图是否一致,以及迁移或导入状态是否残留。先执行只读检查,再核对异常槽位的源、目标和键数量;只有拓扑、数据与备份都确认后,才进入修复。
命令定位
CLUSTER INFO 查看当前节点认知的集群健康度,CLUSTER NODES 查看节点、槽位范围及迁移标记,redis-cli --cluster check 汇总检查覆盖和配置一致性。排障入口应选择一个可达的主节点,而不是只检查副本或单个故障节点。
REDIS_HOST=127.0.0.1
REDIS_PORT=7000

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER INFO
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER NODES
redis-cli --cluster check "$REDIS_HOST:$REDIS_PORT"
预期输出(健康集群节选)
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
[OK] All 16384 slots covered.
cluster_slots_assigned 小于 16384 表示当前视图存在未分配槽位;cluster_slots_pfail 或 cluster_slots_fail 非零表示槽位落在疑似故障或已故障节点。即使槽位总数完整,仍需用 --cluster check 识别节点间配置不一致或重复归属。
高频用法
先筛出迁移和导入标记。源节点上的 [slot->-target-id] 表示槽位正在迁出,目标节点上的 [slot-<-source-id] 表示槽位正在导入。正常迁移应成对出现;只剩一侧、长时间不消失或不同节点对同一槽位意见不一致,通常说明迁移中断或配置传播异常。
REDIS_HOST=127.0.0.1
REDIS_PORT=7000

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER NODES \\
  | grep -E '\[[0-9]+(->-|-<-)[0-9a-f]+\]'
预期输出(存在槽位 5001 的迁移状态)
<SOURCE_ID> 10.0.0.11:7000@17000 master - 0 <TIME> 7 connected 0-5001 [5001->-<TARGET_ID>]
<TARGET_ID> 10.0.0.12:7000@17000 master - 0 <TIME> 8 connected 5002-10000 [5001-<-<SOURCE_ID>]
节点 ID、地址和 <TIME> 以现场输出为准。随后分别在源、目标节点统计该槽位的本地键数,确认数据是否仍在移动。这里的计数是节点本地视角,不能单独作为槽位归属依据;Redis 8.4 原子槽位迁移期间,部分槽位命令还可能过滤迁移中的键。
SLOT=5001
SOURCE_HOST=10.0.0.11
TARGET_HOST=10.0.0.12
REDIS_PORT=7000

printf 'source_count='
redis-cli --raw -h "$SOURCE_HOST" -p "$REDIS_PORT" CLUSTER COUNTKEYSINSLOT "$SLOT"
printf 'target_count='
redis-cli --raw -h "$TARGET_HOST" -p "$REDIS_PORT" CLUSTER COUNTKEYSINSLOT "$SLOT"
预期输出
source_count=<SOURCE_COUNT>
target_count=<TARGET_COUNT>
<SOURCE_COUNT> 与 <TARGET_COUNT> 以现场数据为准;数值持续变化说明迁移仍在进行,长期不变但标记未清除需要继续核对迁移状态。
最后从至少两个主节点重复执行 CLUSTER NODES,并核对 redis-cli --cluster check。若只有某个节点仍显示旧归属,优先排查节点间连接、集群总线端口、防火墙和配置传播;若所有节点都显示缺失或冲突,再评估数据恢复与槽位修复。
风险与边界
不要在主节点不可达、仍有并发 reshard、未确认键分布或没有备份时直接运行 redis-cli --cluster fix,也不要凭单个节点输出手工执行 CLUSTER SETSLOT。这些操作会改变槽位所有权并迁移键,判断错误可能造成重定向循环、写入短暂失败、键滞留在错误节点,严重时形成数据丢失窗口。
安全做法是先停止自动扩缩容和迁移任务,保留 RDB/AOF 或存储快照,恢复所有主节点可达性,记录各主节点的 CLUSTER NODES、槽位键数和节点 ID,再在维护窗口使用集群管理命令修复并重新执行 --cluster check。cluster-config-file 由 Redis 自维护,不应手工编辑。
排障清单
cluster_slots_assigned是否为16384,cluster_slots_fail是否为0。--cluster check是否报告未覆盖槽位、节点配置不一致或槽位冲突。- 同一迁移槽位是否同时存在源端
->-与目标端-<-标记。 - 源、目标主节点是否都可达,集群总线端口是否互通。
- 修复前是否暂停迁移、保存快照并记录节点 ID 与键计数。
- 修复后是否连续多次得到
cluster_state:ok和[OK] All 16384 slots covered.。
兼容性
Redis Cluster 从 Redis 3.0 起提供上述基础命令。Redis 7.0 起新工具优先使用 CLUSTER SHARDS,CLUSTER SLOTS 已弃用。Redis 8.4 起若使用原子槽位迁移,还应执行 CLUSTER MIGRATION STATUS ALL 检查任务状态、错误和重试次数,不能只依赖传统的 migrating/importing 标记。
分析 MOVED、ASK 和 CROSSSLOT 错误对应的客户端或槽位问题。
定位重定向错误
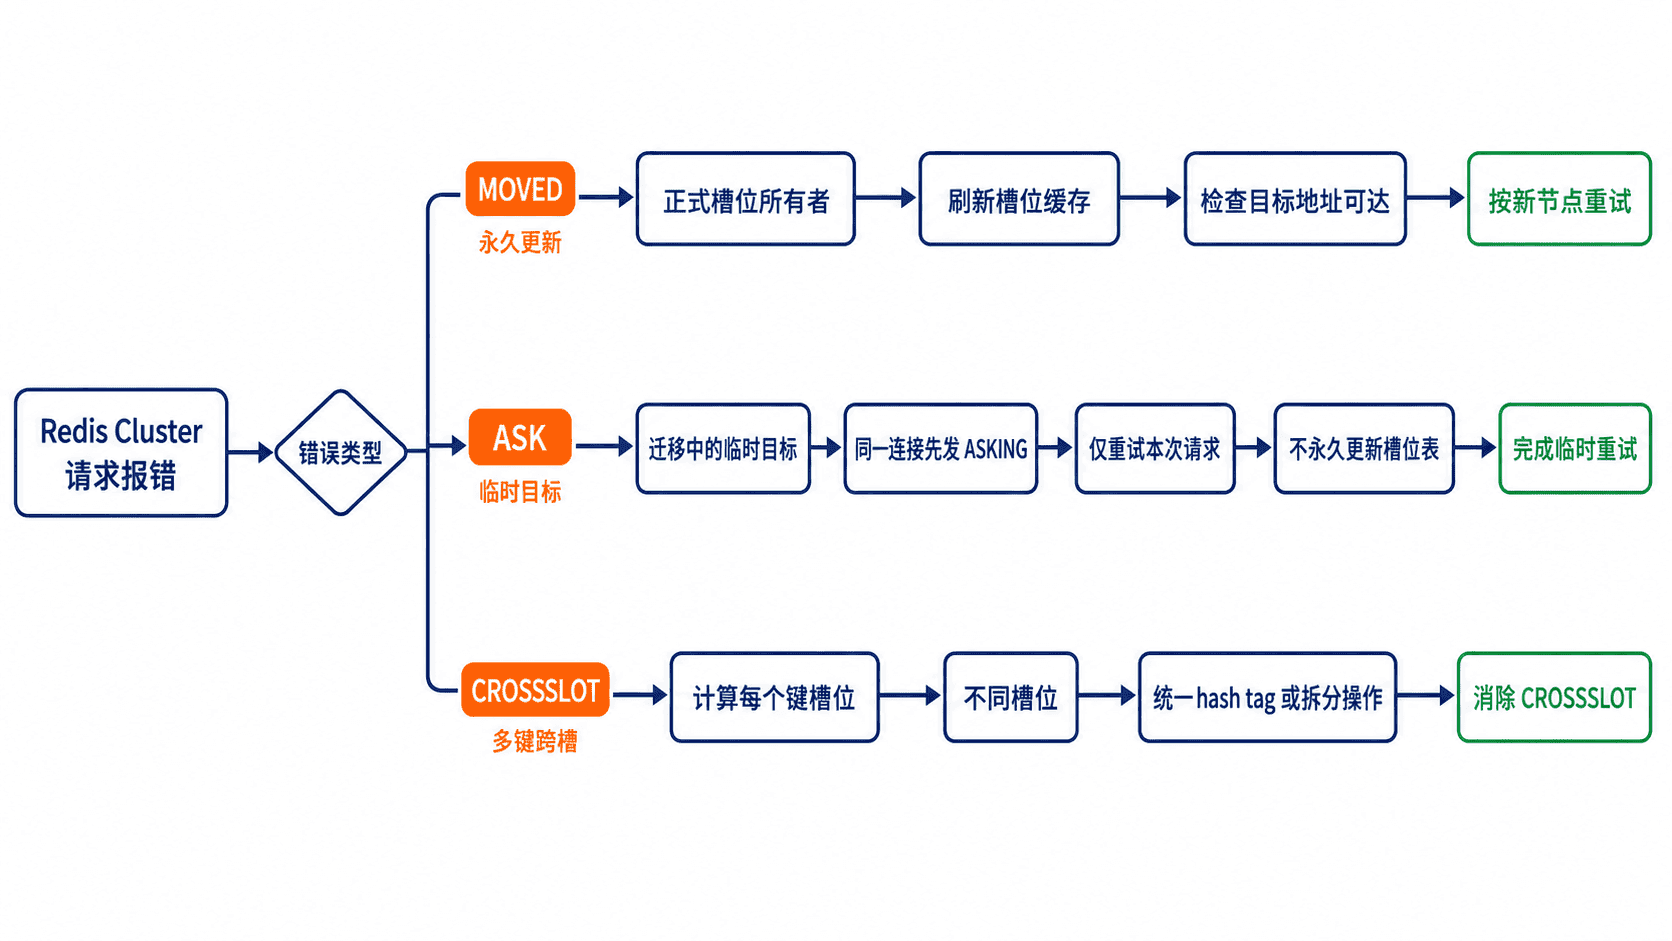
用于快速区分 MOVED、ASK 和 CROSSSLOT:MOVED 指向槽位的正式所有者,ASK 是迁移期间的临时转发,CROSSSLOT 则表示一个多键操作涉及不同槽位。先按错误类型判断客户端行为,再检查槽位、拓扑或键命名。
快速判别
| 错误 | 含义 | 优先检查 |
|---|---|---|
MOVED <slot> <host:port> |
当前节点不是该槽位的正式所有者 | 客户端是否启用 Cluster 模式、槽位缓存是否刷新、目标地址是否可达 |
ASK <slot> <host:port> |
槽位正在迁移,本次请求临时去目标节点 | 客户端是否在同一连接发送 ASKING 后重试、迁移是否长时间未结束 |
CROSSSLOT Keys in request don't hash to the same slot |
多键命令、事务或脚本中的键不在同一槽位 | 各键的 CLUSTER KEYSLOT、是否使用一致且非空的 hash tag |
定位 MOVED
先关闭 redis-cli 的自动重定向观察原始错误,再使用 -c 验证集群感知客户端能否自动跟随。若 -c 成功而应用持续报错,问题通常在应用客户端未启用 Cluster 模式、槽位缓存未刷新,或连接池仍复用旧拓扑。
REDIS_HOST=127.0.0.1
REDIS_PORT=7000

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" SET foo bar
redis-cli -c -h "$REDIS_HOST" -p "$REDIS_PORT" SET foo bar
预期输出
(error) MOVED 12182 <HOST>:<PORT>
-> Redirected to slot [12182] located at <HOST>:<PORT>
OK
MOVED 中的地址是节点对外公布的地址。若目标在容器内网、NAT 地址或错误端口上,客户端即使正确解析重定向也无法连接,应检查 cluster-announce-ip、cluster-announce-port、DNS、路由和安全组,而不是反复重试原节点。
定位 ASK
ASK 只在槽位迁移期间生效。客户端必须在目标节点的同一连接上先发送一次 ASKING,再发送原命令;这次重试成功后仍应保留原槽位映射,等待后续 MOVED 或拓扑刷新确认正式归属。
下面是片段示例,仅用于已经捕获 ASK <slot> <host:port> 且槽位仍在迁移时的手工验证;ASK_HOST、ASK_PORT 和 KEY 必须取自实际错误与请求。
ASK_HOST='<HOST>'
ASK_PORT='<PORT>'
KEY='<KEY>'

redis-cli --raw -h "$ASK_HOST" -p "$ASK_PORT" <<EOF
ASKING
GET $KEY
EOF
预期输出
OK
<VALUE>
若应用把 ASK 当成永久映射缓存,迁移结束后可能继续访问错误节点;若未在同一连接发送 ASKING,目标节点可能再次返回重定向。ASK 持续时间明显超过计划迁移窗口时,应转而检查源、目标节点的 migrating/importing 标记和迁移任务状态。
定位 CROSSSLOT
先直接计算每个键的槽位。foo 与 bar 分别位于不同槽位,因此多键命令失败;带有相同 {...} hash tag 的键只对花括号内的非空内容计算槽位,可用于必须原子执行的多键操作。
REDIS_HOST=127.0.0.1
REDIS_PORT=7000

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER KEYSLOT foo
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" CLUSTER KEYSLOT bar
redis-cli -c -h "$REDIS_HOST" -p "$REDIS_PORT" MGET foo bar
预期输出
(integer) 12182
(integer) 5061
(error) CROSSSLOT Keys in request don't hash to the same slot
使用相同 hash tag 后,两键都会落在槽位 15880,多键命令可以执行。
REDIS_HOST=127.0.0.1
REDIS_PORT=7000

redis-cli -c -h "$REDIS_HOST" -p "$REDIS_PORT" \\
  MSET '{user:42}:profile' active '{user:42}:orders' 3
redis-cli -c -h "$REDIS_HOST" -p "$REDIS_PORT" \\
  MGET '{user:42}:profile' '{user:42}:orders'
预期输出
OK
1) "active"
2) "3"
风险与边界
不要把所有业务键都塞进同一个 hash tag 来消除 CROSSSLOT。触发条件是大量键共享同一标签,后果是单槽位和单主节点形成热点,失去集群水平分片能力。安全替代是只让确实需要同槽原子操作的一小组键共享标签,其余操作拆分、改用应用层编排或重新设计数据模型。
不要对 MOVED 和 ASK 做无限立即重试。拓扑抖动、目标不可达或迁移卡住时,这会放大连接数、延迟和节点压力。客户端应限制重定向次数,刷新槽位表,采用退避,并记录错误中的槽位与目标地址供排障。
排障清单
redis-cli -c是否能成功,而应用客户端是否明确启用了 Cluster 模式。MOVED目标地址是否能从应用运行环境直接连接。- 客户端是否在收到
MOVED后刷新槽位缓存,而不是永久固定启动节点。 - 客户端处理
ASK时是否在同一连接发送ASKING,且没有永久改写槽位表。 CROSSSLOT涉及的每个键是否通过CLUSTER KEYSLOT验证。- hash tag 是否一致、非空,并且不会把过多键集中到单个槽位。
兼容性
MOVED、ASK、ASKING、CLUSTER KEYSLOT 和 hash tag 规则自 Redis Cluster 3.0 起可用。不同语言客户端的重定向次数、拓扑刷新周期和连接池行为不同,生产环境应按所用客户端版本核对 Cluster 支持,不要用单机客户端加手工重试替代集群感知客户端。
排查集群总线、节点地址通告、网络分区和失败节点状态。
处理集群节点失联
用于节点在 CLUSTER NODES 中出现 fail?、fail、noaddr 或 disconnected,以及客户端持续收到 CLUSTERDOWN 时。先从健康节点确认故障范围,再检查数据端口、集群总线、通告地址和网络分区;不要一开始就删除节点或改槽位。CLUSTER NODES 展示的是当前被查询节点的本地视图,因此至少从两个健康主节点各执行一次。:contentReference[oaicite:0]{index=0}
快速定位
先读取集群总体状态和失联节点行。将 <HEALTHY_NODE_IP>、<PORT> 替换为任一可达节点;需要认证时优先通过安全的密钥注入设置 REDISCLI_AUTH,不要把密码直接写进命令历史。
redis-cli -h <HEALTHY_NODE_IP> -p <PORT> CLUSTER INFO
redis-cli -h <HEALTHY_NODE_IP> -p <PORT> CLUSTER NODES
预期输出(故障示例,ID 和时间值会不同):
cluster_state:fail
cluster_slots_assigned:16384
cluster_slots_ok:10923
cluster_slots_pfail:0
cluster_slots_fail:5461
cluster_known_nodes:6

<NODE_ID> 10.0.0.12:6379@16379 master,fail - <PING_MS> <PONG_MS> 7 disconnected 0-5460
cluster_slots_fail 非零表示已有槽位落在 FAIL 节点上;fail? 是当前观察节点的可能故障判断,fail 表示故障已被多个主节点确认。link-state=disconnected 指集群总线连接断开,不等同于 Redis 进程一定停止。:contentReference[oaicite:1]{index=1}
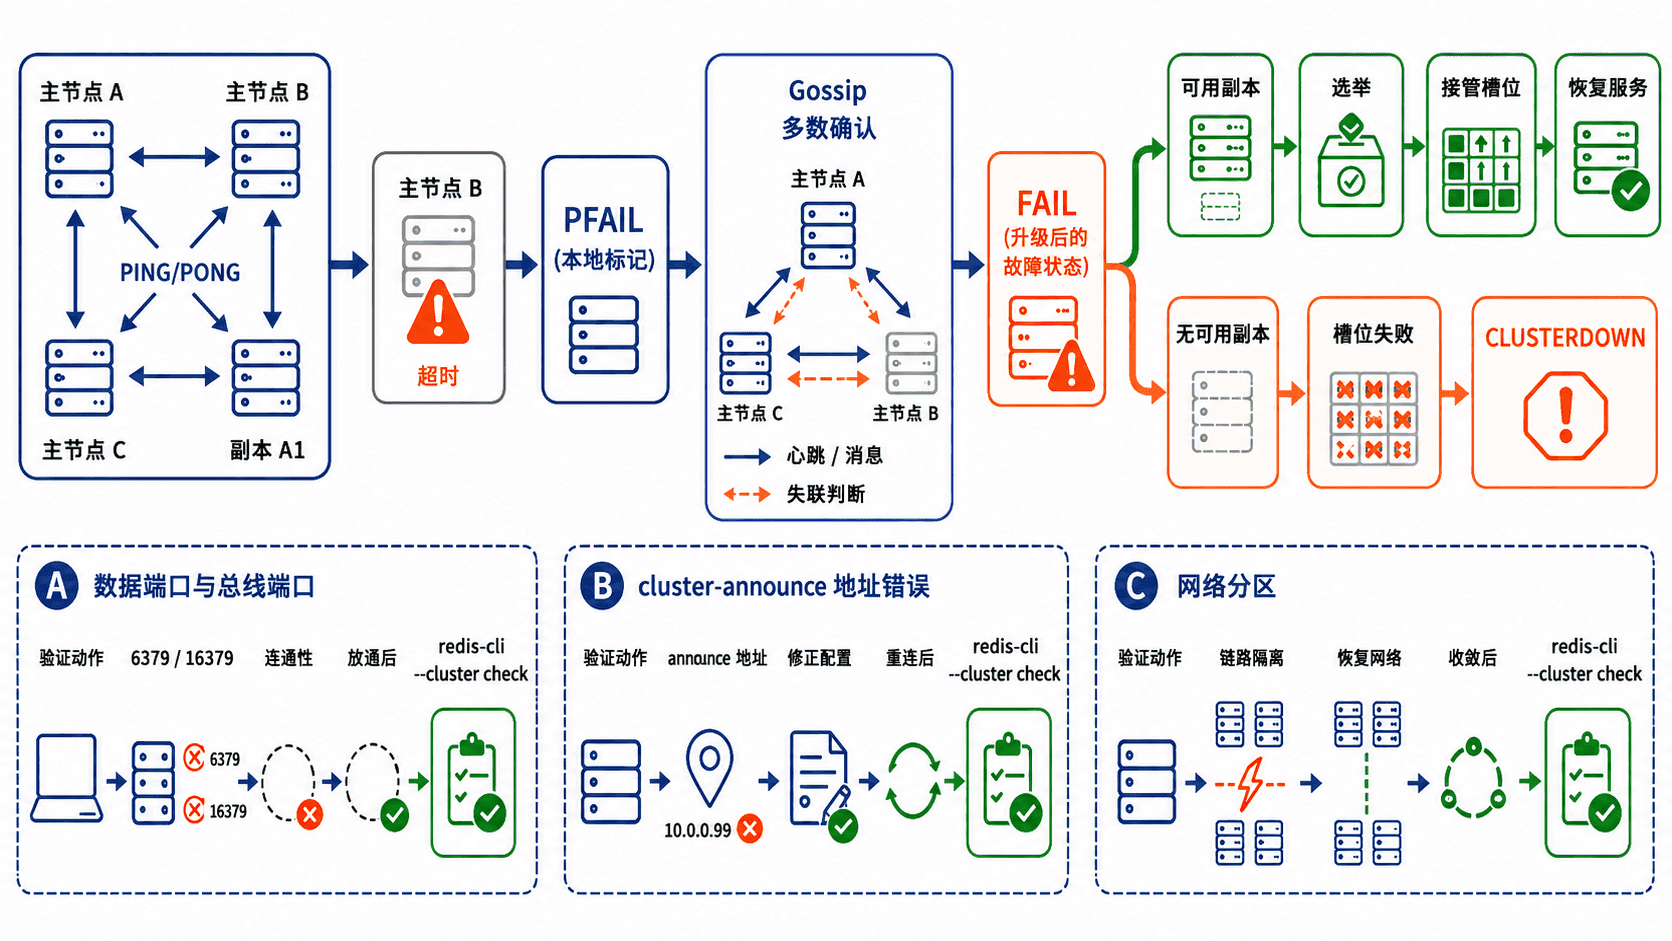
检查总线与地址通告
Redis Cluster 节点间使用独立 TCP 总线;未显式配置 cluster-port 时,默认总线端口是数据端口加 10000。数据端口可达但总线端口不通时,客户端可能还能连接单节点,而节点间故障检测、拓扑传播和故障转移会失效。:contentReference[oaicite:2]{index=2}
redis-cli -h <HEALTHY_NODE_IP> -p <PORT> CONFIG GET port
redis-cli -h <HEALTHY_NODE_IP> -p <PORT> CONFIG GET cluster-port
redis-cli -h <HEALTHY_NODE_IP> -p <PORT> CONFIG GET 'cluster-announce-*'

nc -vz -w 2 <LOST_NODE_IP> <DATA_PORT>
nc -vz -w 2 <LOST_NODE_IP> <BUS_PORT>
预期输出(总线被拦截示例):
port
6379
cluster-port
0
cluster-announce-ip
10.0.0.12
Connection to 10.0.0.12 6379 port [tcp/*] succeeded!
nc: connect to 10.0.0.12 port 16379 (tcp) timed out
cluster-port=0 表示使用派生端口;若 CLUSTER NODES 发布的是容器内 IP、旧 IP、错误端口或 :0@0,检查 cluster-announce-ip、cluster-announce-port 和 cluster-announce-bus-port。在 NAT、容器端口映射或多网卡环境中,通告值必须是其他集群节点实际可达的地址。
按现象处理
- 数据端口和总线端口都失败:检查进程、主机路由、安全组、防火墙、网络策略及监听地址。
- 数据端口成功、总线失败:放通节点间双向总线端口,并核对
cluster-port;启用 TLS 集群总线时同时核对各节点 TLS 配置。 - 端口可达但发布地址错误:修正通告配置后滚动重启受影响节点,避免同时重启同一分片的主副本。
- 不同健康主节点看到不同状态:优先按网络分区处理,恢复主节点多数派互通后等待 Gossip 收敛,不要立即强制改槽。
- 原主节点恢复后仍显示旧拓扑:先确认它是否已作为新主节点的副本加入,再决定是否执行受控的角色调整。
恢复验证
redis-cli -h <HEALTHY_NODE_IP> -p <PORT> CLUSTER INFO
redis-cli --cluster check <HEALTHY_NODE_IP>:<PORT>
预期结果:
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
[OK] All 16384 slots covered.
同时确认业务客户端不再出现 CLUSTERDOWN,所有主节点槽位无重叠、无缺失,恢复节点的角色与复制上游符合预期。官方升级验证流程也使用 CLUSTER INFO 和 redis-cli --cluster check 作为集群检查手段。:contentReference[oaicite:3]{index=3}
风险与边界
在网络分区、节点视图未收敛或仍有主副本切换时执行 CLUSTER RESET HARD、CLUSTER FORGET、CLUSTER SETSLOT 或强制故障转移,可能造成节点身份丢失、槽位冲突、二次切换或数据回退。安全做法是先保存各节点 CLUSTER NODES、CLUSTER INFO 和配置,再恢复网络与通告地址,最后依据统一拓扑执行最小变更。
集群总线只应在集群节点之间开放,不能暴露给公网。若多数主节点不可达或故障主节点没有合格副本,Redis Cluster 可能停止服务;此时先恢复多数派或节点副本,不要用关闭完整槽位覆盖来掩盖数据不可用。
对比主从数据量、关键键值和持久化恢复结果,识别数据偏差。
验证数据一致性
用于主从切换、网络中断、持久化恢复或疑似丢写后,判断主副本是否追平、关键键值是否一致,以及备份文件能否恢复。验证应按“复制状态与偏移 → 分片键数 → 关键键内容与 TTL → 隔离恢复”逐层收敛;在线写入不停时,各命令读取的不是同一原子快照,只能作为趋势和抽样证据。Redis 复制默认是异步的,偏移追平也不等于历史上绝无丢写。:contentReference[oaicite:4]{index=4}
前置条件
先确认比较的是同一分片的一对主副本,而不是不同槽位的两个节点。Redis Cluster 只使用数据库 0;DBSIZE 在集群中统计当前连接节点的本地键数,不会自动汇总全群,因此必须逐个主节点及其副本成对比较。:contentReference[oaicite:5]{index=5}
在可控窗口暂停写入,或至少记录验证开始和结束时间。若业务持续更新、键持续过期,少量偏移差、键数差和 TTL 差可能是采样时间差,不应立即判定数据损坏。
检查复制链路与偏移
redis-cli -h <MASTER_IP> -p <PORT> INFO replication \
  | grep -E '^(role|connected_slaves|master_repl_offset|slave[0-9]+):'

redis-cli -h <REPLICA_IP> -p <PORT> INFO replication \
  | grep -E '^(role|master_link_status|master_sync_in_progress|slave_repl_offset):'
预期输出(动态值会不同):
role:master
connected_slaves:1
master_repl_offset:<MASTER_OFFSET>
slave0:ip=<REPLICA_IP>,port=<PORT>,state=online,offset=<REPLICA_OFFSET>,lag=0
role:slave
master_link_status:up
master_sync_in_progress:0
slave_repl_offset:<REPLICA_OFFSET>
master_link_status 应为 up,master_sync_in_progress 应为 0。在短暂停写后,主节点 master_repl_offset 与副本 slave_repl_offset 应相等;持续写入时应关注差值是否稳定回落,而不是要求每次采样绝对为零。字段定义以 INFO replication 为准。:contentReference[oaicite:6]{index=6}
对比键数与关键键
下面脚本比较本地 DBSIZE,并对传入的关键键核对类型、DUMP 序列化摘要和毫秒 TTL。将环境变量替换为实际地址后,把关键键作为参数传入。摘要相同表示该次采样的序列化字节相同;摘要不同还需按数据类型做语义复核,不能仅凭摘要认定逻辑值不同。
#!/usr/bin/env bash
set -euo pipefail

: "${MASTER_HOST:?set MASTER_HOST}"
: "${REPLICA_HOST:?set REPLICA_HOST}"
PORT="${PORT:-6379}"

mcli=(redis-cli -h "$MASTER_HOST" -p "$PORT" --raw)
rcli=(redis-cli -h "$REPLICA_HOST" -p "$PORT" --raw)

printf 'dbsize master=%s replica=%s\n' "$("${mcli[@]}" DBSIZE)" "$("${rcli[@]}" DBSIZE)"

for key in "$@"; do
  mt=$("${mcli[@]}" TYPE "$key")
  rt=$("${rcli[@]}" TYPE "$key")
  mh=$("${mcli[@]}" DUMP "$key" | sha256sum | awk '{print $1}')
  rh=$("${rcli[@]}" DUMP "$key" | sha256sum | awk '{print $1}')
  mttl=$("${mcli[@]}" PTTL "$key")
  rttl=$("${rcli[@]}" PTTL "$key")

  if [[ "$mt" == "$rt" && "$mh" == "$rh" ]]; then equal=yes; else equal=no; fi
  printf '%s type=%s/%s value_equal=%s pttl=%s/%s\n' \
    "$key" "$mt" "$rt" "$equal" "$mttl" "$rttl"
done
运行示例:
MASTER_HOST=10.0.0.11 REPLICA_HOST=10.0.0.21 PORT=6379 \
  bash compare-redis.sh 'order:<ID>' 'session:<ID>'
预期输出:
dbsize master=125043 replica=125043
order:<ID> type=hash/hash value_equal=yes pttl=-1/-1
session:<ID> type=string/string value_equal=yes pttl=287415/287392
PTTL=-1 表示键没有过期时间,-2 表示键不存在。带过期时间的键允许出现接近采样耗时的差值;若类型不同、摘要不同、仅一侧为 -2,应记录键名和业务写入链路后进一步核对。DUMP 不包含过期时间,所以必须与 PTTL 一起检查。:contentReference[oaicite:7]{index=7}
验证持久化恢复
先对备份副本做格式检查,再在隔离目录和非生产端口启动恢复实例。不要直接对生产 AOF 使用 --fix,因为该选项会截断或重写文件;结构检查通过也只说明文件可解析,不能证明恢复后的业务数据完整。
redis-check-rdb <RDB_COPY_PATH>
redis-check-aof <AOF_COPY_PATH>
预期结果(不同版本措辞可能不同):
RDB looks OK!
AOF is valid
随后在隔离恢复实例上重复 DBSIZE 和关键键脚本,并核对恢复时间点前应存在的业务记录、索引和 TTL。对于 Redis 7 及以上的多段 AOF,应复制完整 AOF 目录和 manifest,而不是只拿其中一个增量文件。
写入链路抽查
对允许写入测试键的环境,可在同一个 redis-cli 连接中写入后执行 WAIT,确认至少一个副本已确认该连接此前的写入。
redis-cli -h <MASTER_IP> -p <PORT> <<'EOF'
SET consistency:probe <ID>
WAIT 1 1000
EOF
预期输出:
OK
1返回值小于要求的副本数表示超时前确认不足。WAIT 能提高故障切换时的数据安全性,但不会把 Redis 变成强一致系统,也不能证明旧数据没有偏差。:contentReference[oaicite:8]{index=8}
风险与边界
不要在高峰期执行 KEYS *、遍历全库并逐键 DUMP,或在持续写入时把一次差异直接认定为数据损坏;这些操作可能阻塞事件循环、放大网络与 CPU 压力,且会混入并发写入、惰性过期和主动过期造成的假差异。安全替代方案是按分片使用 SCAN 小批量抽样、优先检查关键业务键,或对同一时间点的 RDB/AOF 副本做离线全量校验。:contentReference[oaicite:9]{index=9}
如果主副本 Redis 版本不同,DUMP 的序列化字节可能因格式版本变化而不同;此时应改用同类型命令做语义比较,或在同版本隔离实例中恢复后比对。最终结论至少同时满足:复制链路正常、偏移在静默窗口追平、每分片键数合理、关键键值和 TTL 符合预期、持久化副本可在隔离环境恢复。
比较运行配置与配置文件,发现临时修改或节点参数不一致。
检查 Redis 配置漂移
用于确认节点当前生效参数是否与其他节点或配置文件一致。排查时先采集只读快照,再定位参数来源;不要一上来执行 CONFIG SET 或 CONFIG REWRITE,否则可能覆盖现场并扩大漂移。
命令定位
CONFIG GET 返回当前进程的生效值,适合比较节点间差异。INFO server 中的 config_file 可定位启动配置文件,但最终值还可能被 include、命令行参数、容器启动参数或运行期 CONFIG SET 覆盖。
比较节点运行配置
只比较与故障相关的白名单参数,避免 CONFIG GET * 带来敏感信息暴露和无关噪声。下面脚本按固定顺序生成快照,并显示两个节点的差异。
#!/usr/bin/env bash
set -euo pipefail

PORT="${PORT:-6379}"
NODE_A="${NODE_A:-redis-a}"
NODE_B="${NODE_B:-redis-b}"
KEYS=(appendonly appendfsync maxmemory maxmemory-policy save timeout tcp-keepalive)

snapshot() {
  local host="$1" key value
  for key in "${KEYS[@]}"; do
    value="$(redis-cli -h "$host" -p "$PORT" --raw CONFIG GET "$key" | sed -n '2p')"
    printf '%s	%s
' "$key" "$value"
  done
}

snapshot "$NODE_A" > /tmp/redis-a.config.tsv
snapshot "$NODE_B" > /tmp/redis-b.config.tsv
diff -u /tmp/redis-a.config.tsv /tmp/redis-b.config.tsv || true
预期输出:完全一致时 diff 无输出;存在漂移时会显示删除行和新增行,例如:
--- /tmp/redis-a.config.tsv
+++ /tmp/redis-b.config.tsv
@@
-maxmemory-policy	allkeys-lru
+maxmemory-policy	noeviction
- 表示节点 A 的值,+ 表示节点 B 的值。认证环境可预先设置 REDISCLI_AUTH='<PASSWORD>';ACL 用户还需在 redis-cli 参数中增加 --user <USER>。
对照配置文件
先读取进程实际使用的主配置文件,再同时查看文件中的显式配置和运行值。文件未出现某项不等于未生效,因为 Redis 可能正在使用默认值或包含文件中的值。
HOST="${HOST:-127.0.0.1}"
PORT="${PORT:-6379}"
KEYS=(maxmemory maxmemory-policy appendonly appendfsync save)

CONF="$(redis-cli -h "$HOST" -p "$PORT" --raw INFO server   | awk -F: '/^config_file:/{sub(/\r$/, "", $2); print $2}')"
printf 'config_file=%s
' "${CONF:-<EMPTY>}"

if [[ -n "$CONF" && -r "$CONF" ]]; then
  grep -Ein '^[[:space:]]*(include|maxmemory|maxmemory-policy|appendonly|appendfsync|save)[[:space:]]+' "$CONF" || true
else
  printf '配置文件为空或不可读,请检查 systemd、容器或托管参数组。
'
fi

for key in "${KEYS[@]}"; do
  redis-cli -h "$HOST" -p "$PORT" --raw CONFIG GET "$key"
done
预期输出类似:
config_file=/etc/redis/redis.conf
12:maxmemory 2gb
13:maxmemory-policy allkeys-lru
maxmemory
2147483648
maxmemory-policy
allkeys-lru
appendonly
yes
appendfsync
everysec
save
3600 1 300 100 60 10000
配置文件中的 2gb 与运行值 2147483648 语义相同,比较时要统一单位;重复指令通常以后出现的值为准,还要继续检查 include 指向的文件。
风险与边界
执行 CONFIG SET 会立即改变运行状态,触发条件是误把诊断命令当成修复命令;后果可能是淘汰策略、持久化或超时行为立刻变化。安全替代是先保存快照和变更单,再通过配置管理统一修改。
执行 CONFIG REWRITE 会改写配置文件;在包含文件、只读挂载、容器镜像或云托管环境中,可能改动指令布局、写入错误位置或根本无法持久。安全替代是修改声明式配置、参数组或编排清单,并通过滚动重启验证。
排障清单
确认比较的是同一角色、同一版本和同一业务分片;检查 config_file、systemd ExecStart、容器启动参数和 include;对单位、空值和默认值做语义归一;最后把运行快照、配置仓库版本和变更记录三方对齐。托管 Redis 可能禁用 CONFIG,此时以平台参数组和监控导出的生效值为准。
在重启前检查持久化、复制、流量切换和恢复条件,降低数据风险。
安全重启 Redis 节点
用于计划内重启、升级或故障恢复。目标是在停止进程前确认持久化可用、复制链路健康、流量已切走,并在启动后验证角色、数据和客户端连接,避免把一次重启变成数据丢失或长时间不可用。
重启前检查
先查看持久化任务、最近写入状态和复制角色。目标节点若是主节点,必须先确认有可提升的健康副本;若是副本,必须确认主链路正常且没有正在进行的全量同步。
HOST="<TARGET_HOST>"
PORT="${PORT:-6379}"

{
  redis-cli -h "$HOST" -p "$PORT" --raw INFO persistence
  redis-cli -h "$HOST" -p "$PORT" --raw INFO replication
} | grep -E '^(rdb_bgsave_in_progress|rdb_last_bgsave_status|aof_enabled|aof_rewrite_in_progress|aof_last_write_status|role|master_link_status|master_sync_in_progress|master_last_io_seconds_ago):'
预期输出类似:
rdb_bgsave_in_progress:0
rdb_last_bgsave_status:ok
aof_enabled:1
aof_rewrite_in_progress:0
aof_last_write_status:ok
role:slave
master_link_status:up
master_sync_in_progress:0
master_last_io_seconds_ago:0
*_in_progress 应为 0,最近持久化状态应为 ok。动态时间和角色以现场为准;若出现 master_link_status:down、同步进行中或持久化错误,应先修复再重启。
角色与流量决策
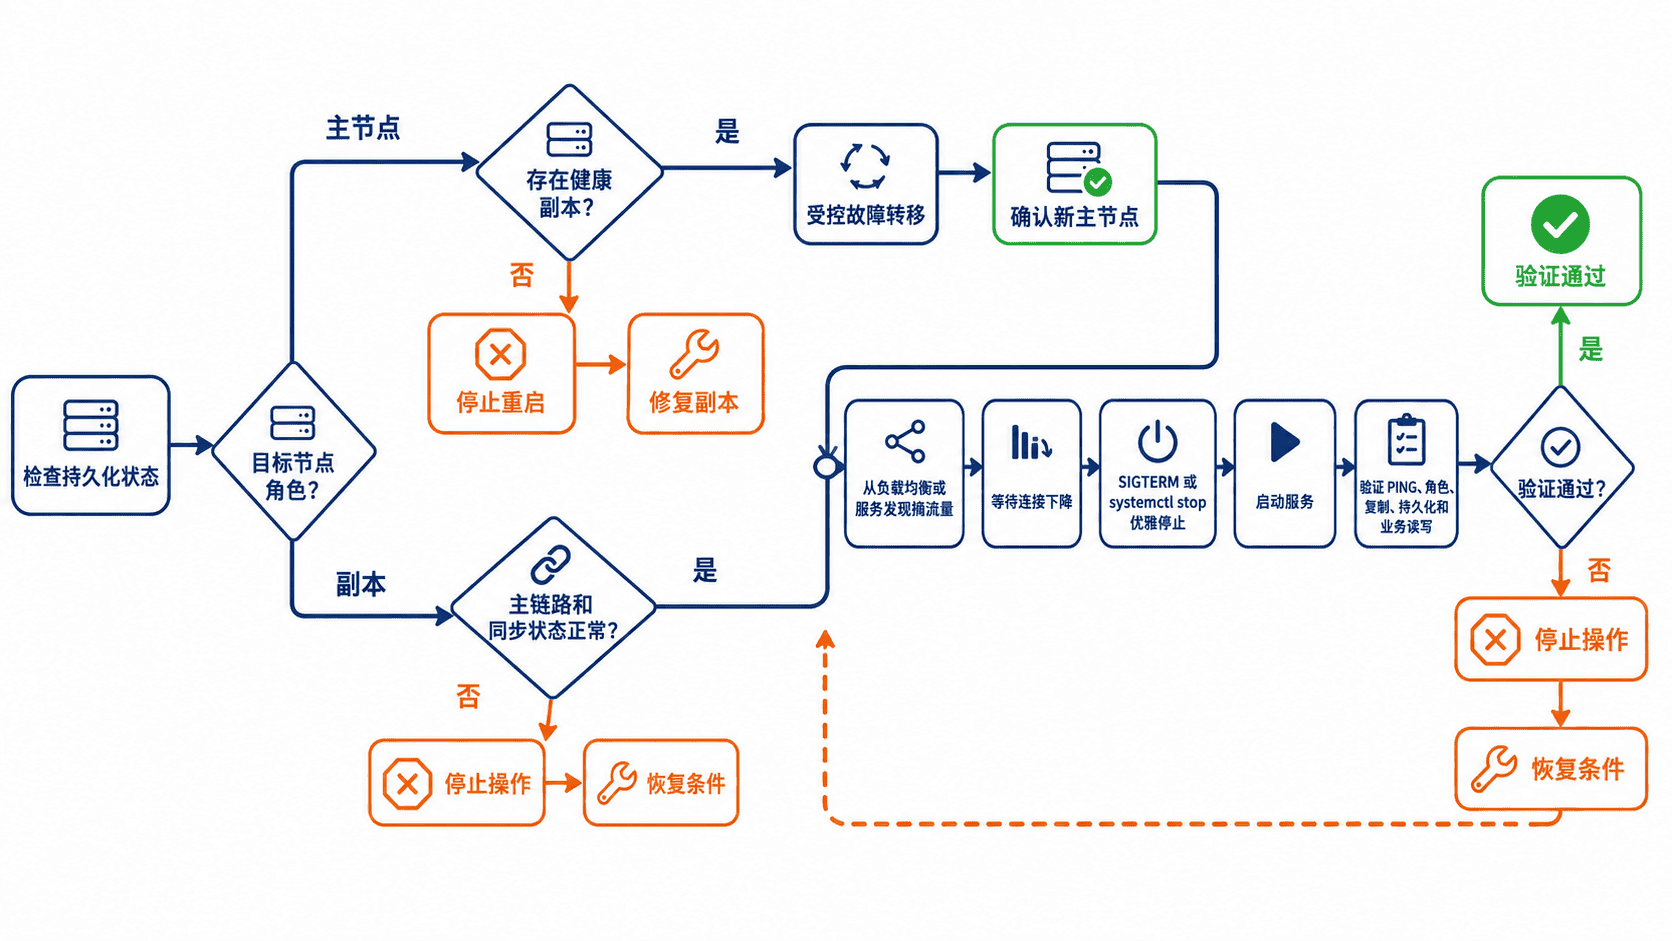
主节点不要直接重启。Sentinel 环境可先触发受控故障转移,再轮询确认主地址已经变化;Redis Cluster 或云托管环境应使用各自的故障转移入口。
SENTINEL_HOST="<SENTINEL_HOST>"
MASTER_NAME="<MASTER_NAME>"

redis-cli -h "$SENTINEL_HOST" -p 26379 SENTINEL FAILOVER "$MASTER_NAME"
sleep 2
redis-cli -h "$SENTINEL_HOST" -p 26379 --raw SENTINEL GET-MASTER-ADDR-BY-NAME "$MASTER_NAME"
预期输出:
OK
<NEW_MASTER_IP>
<PORT>
OK 只表示 Sentinel 接受请求,不代表切换已经完成。必须确认返回地址不再是目标节点,并检查新主节点可写、旧主节点已降级后再继续。
优雅停止与启动
完成摘流量或故障转移后,在目标主机使用服务管理器停止进程。systemd 会按单元定义的 ExecStop 或终止信号等待进程退出,通常比 kill -9 更安全;服务名按发行版可能是 redis-server、redis 或实例化单元。
#!/usr/bin/env bash
set -euo pipefail

SERVICE="${SERVICE:-redis-server}"
PORT="${PORT:-6379}"
ready=0

systemctl stop "$SERVICE"
systemctl is-active "$SERVICE" || true
systemctl start "$SERVICE"

for _ in $(seq 1 30); do
  if redis-cli -h 127.0.0.1 -p "$PORT" PING 2>/dev/null | grep -qx PONG; then
    ready=1
    break
  fi
  sleep 1
done

if [[ "$ready" -ne 1 ]]; then
  printf 'ERROR: Redis 未在检查窗口内就绪。
' >&2
  exit 1
fi

systemctl is-active "$SERVICE"
redis-cli -h 127.0.0.1 -p "$PORT" PING
预期输出:
inactive
active
PONG
如果检查窗口内未返回 PONG,不要立即反复重启;先检查服务日志、端口占用、配置错误、磁盘空间和持久化文件加载进度。
启动后验证
确认 PING 只是第一步,还要核对角色、复制状态、加载状态和持久化状态。副本应重新连接主节点;曾经的主节点应保持副本角色,除非编排系统明确把它切回主节点。
HOST="<TARGET_HOST>"
PORT="<PORT>"

{
  redis-cli -h "$HOST" -p "$PORT" --raw INFO server
  redis-cli -h "$HOST" -p "$PORT" --raw INFO replication
  redis-cli -h "$HOST" -p "$PORT" --raw INFO persistence
} | grep -E '^(uptime_in_seconds|role|master_link_status|loading|rdb_last_bgsave_status|aof_last_write_status):'
预期输出类似:
uptime_in_seconds:<SECONDS>
role:slave
master_link_status:up
loading:0
rdb_last_bgsave_status:ok
aof_last_write_status:ok
随后观察客户端错误率、延迟、连接数和复制偏移是否恢复稳定;仅在验证通过后把节点重新加入流量。
风险与边界
存在写流量且没有健康副本时重启主节点,可能造成写入中断;未启用可靠持久化时还可能丢失内存数据。安全替代是先恢复副本、冻结写入或安排维护窗口。
在 BGSAVE、AOF 重写或数据加载期间强制终止,可能延长恢复、丢失尚未落盘的数据,甚至留下需要修复的持久化文件。安全替代是等待任务结束、放宽 systemd 停止超时并坚持使用优雅停止;不要使用 kill -9。
未摘流量直接重启会触发客户端连接风暴和重试放大;容器设置自动重启时,手工 SHUTDOWN 还可能被编排器立即拉起。安全替代是先调整服务发现或编排副本数,并以平台提供的滚动重启流程为准。
在人工切换主节点前确认副本状态、数据偏移和客户端影响。
安全执行故障切换
用于计划维护或人工接管时,把写流量从旧主节点平稳转移到已追平的副本。先确认复制链路、偏移、控制面和客户端发现机制,再执行协调切换;不要把直接执行 REPLICAOF NO ONE 当作常规首选方案。
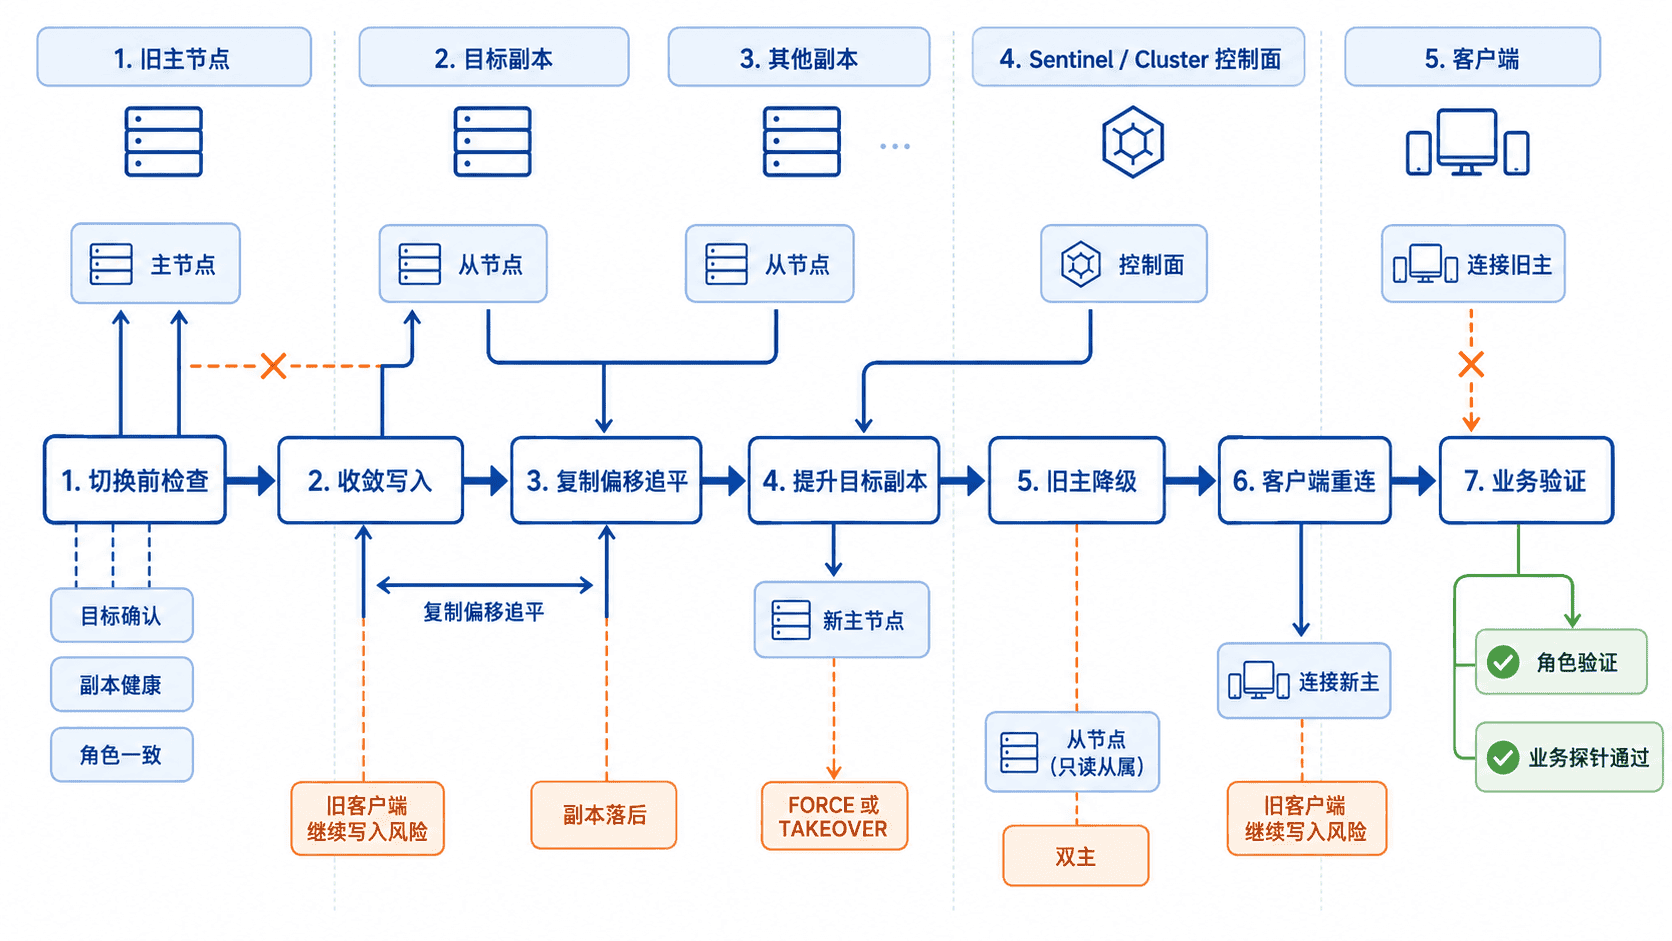
切换前确认
记录旧主、目标副本和客户端实际入口。目标副本必须链路正常、不在全量同步中,复制偏移应与旧主一致或只存在可接受的小幅差值;同时确认当前没有其他故障切换正在执行。
# 旧主节点:读取目标副本在线状态和复制偏移
redis-cli -h <OLD_PRIMARY> -p <PORT> INFO replication \
  | grep -E '^(role|master_failover_state|connected_slaves|master_repl_offset|slave[0-9]+):'

# 目标副本:链路必须为 up,且不能处于全量同步
redis-cli -h <TARGET_REPLICA> -p <PORT> INFO replication \
  | grep -E '^(role|master_link_status|master_sync_in_progress|slave_repl_offset|slave_read_repl_offset):'
预期输出
role:master
master_failover_state:no-failover
connected_slaves:1
master_repl_offset:<OFFSET>
slave0:ip=<TARGET_REPLICA>,port=<PORT>,state=online,offset=<OFFSET>,lag=0
role:slave
master_link_status:up
master_sync_in_progress:0
slave_repl_offset:<OFFSET><OFFSET>、副本数量和编号会随实例变化。若 master_link_status:down、master_sync_in_progress:1、副本不在线或偏移持续扩大,应先修复复制链路,不要进入切换步骤。严格控制数据损失的维护窗口还应在应用入口停止新写入,并等待在途请求结束。
执行协调切换
非 Cluster 的 Redis 6.2 及以上可在旧主节点执行 FAILOVER,明确指定目标副本并设置等待上限。下面的命令在 10 秒内无法追平时回滚,不使用可能丢数据的 FORCE。
redis-cli -h <OLD_PRIMARY> -p <PORT> \
  FAILOVER TO <TARGET_REPLICA> <PORT> TIMEOUT 10000
预期输出
OKOK 只表示请求已被接受,不表示角色已经完成交换。Sentinel 拓扑应由 Sentinel 发起人工切换,Redis Cluster 应在准备提升的副本上执行其 Cluster 手工切换命令;不要绕过现有高可用控制面直接改角色。
验证角色和客户端
完成条件是目标副本已经成为主节点、旧主已成为其副本、客户端入口能够读写新主节点。业务探针必须通过客户端真实使用的服务发现地址、VIP 或代理入口执行,而不是只连新主节点本机验证。
redis-cli -h <TARGET_REPLICA> -p <PORT> INFO replication \
  | grep -E '^(role|connected_slaves|master_repl_offset):'
redis-cli -h <OLD_PRIMARY> -p <PORT> INFO replication \
  | grep -E '^(role|master_host|master_link_status):'
redis-cli -h <CLIENT_ENDPOINT> -p <PORT> SET <PROBE_KEY> <PROBE_VALUE> EX 30
redis-cli -h <CLIENT_ENDPOINT> -p <PORT> GET <PROBE_KEY>
预期输出
role:master
connected_slaves:<COUNT>
master_repl_offset:<OFFSET>
role:slave
master_host:<TARGET_REPLICA>
master_link_status:up
OK
<PROBE_VALUE>
若客户端仍访问旧主,应立即从负载均衡、VIP、DNS 或静态配置中隔离旧地址,并检查客户端是否支持 Sentinel 或 Cluster 拓扑刷新。探针键设置 30 秒过期,避免留下长期测试数据。
风险与边界
FORCE在等待超时后可能提升尚未追平的目标副本,触发条件是显式指定目标、超时和强制参数;后果是尾部写入丢失。安全替代是收敛写入、等待副本追平并使用默认协调流程。- Cluster 的
TAKEOVER会绕过正常授权,网络分区时可能形成双主。只有在旧主节点已被隔离、权威数据副本已确认且按灾备预案执行时才考虑使用。 FAILOVER ABORT在failover-in-progress阶段可能引入多主。仅在确认状态仍为waiting-for-sync时优先中止;其他状态先隔离客户端流量并确认哪个节点数据最新。- 复制是异步的,偏移相等只是切换时刻的观察结果。需要严格无损时,应暂停业务写入并对关键请求采用应用级确认、幂等和重试控制。
排障清单
- 长时间停在
waiting-for-sync:检查目标副本链路、偏移增长、磁盘 I/O、CPU、网络丢包和复制超时,不要盲目延长写暂停。 - 新主已提升但其他副本仍跟随旧主:确认切换结束且权威主节点唯一后,再把其他副本重新指向新主。
- 命令返回
OK但角色未变化:持续检查INFO replication、目标节点日志和高可用控制面状态;OK不是成功完成证明。 - 应用大量报错:核对连接池是否刷新、重试是否幂等、代理是否缓存旧地址,以及 Cluster 客户端是否正确处理重定向。
兼容性
FAILOVER 适用于 Redis 6.2 及以上的非 Cluster 主从复制。Sentinel 和 Redis Cluster 使用各自的故障切换流程;托管 Redis 可能禁用管理命令,应通过云厂商控制面执行并按同样方式验证副本状态、客户端入口和业务探针。
在保留原始文件和备份的前提下检查并修复 RDB 或 AOF 文件。
恢复损坏数据文件
用于 Redis 因 RDB 或 AOF 损坏而无法启动时,在保留原始证据的前提下完成检查、有限修复和离线验证。核心原则是先停写并复制文件,只修改工作副本;RDB 检查器不负责修复,AOF 的 --fix 本质上是截断损坏尾部。
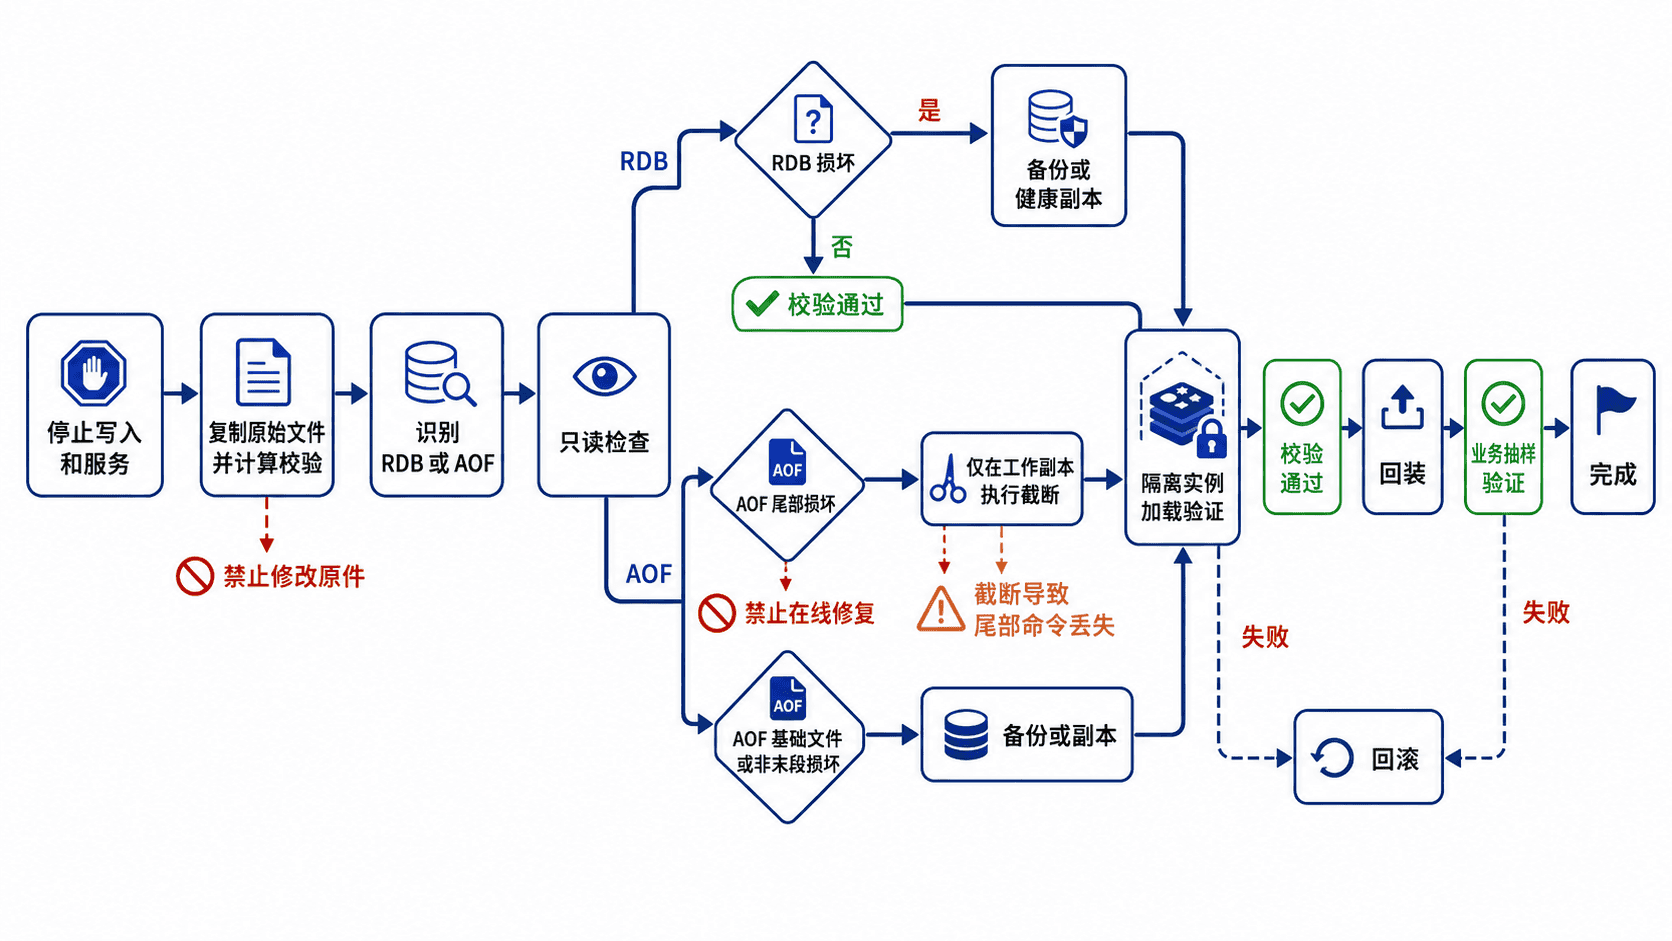
确认实际持久化路径
实例仍能响应时,先读取运行配置;若已经无法启动,则从生效的 redis.conf、启动参数和日志确认。开启 AOF 时,Redis 启动通常优先加载 AOF,因此只修复 dump.rdb 可能无法解决启动失败。
for key in dir dbfilename appendonly appenddirname appendfilename; do
  redis-cli -h <HOST> -p <PORT> --raw CONFIG GET "$key"
done
预期输出
dir
<DATA_DIR>
dbfilename
dump.rdb
appendonly
yes
appenddirname
appendonlydir
appendfilename
appendonly.aof
旧版本可能没有 appenddirname,未配置 AOF 时 appendonly 会显示 no。<DATA_DIR>、文件名和端口以实际配置为准,不要根据默认路径直接覆盖文件。
停止服务并制作工作副本
先停止 Redis,确认没有进程继续写入文件,再复制持久化对象。RDB 的 <PERSISTENCE_PATH> 是 dump.rdb;Redis 7 及以上多段 AOF 应复制整个 appendonlydir,包括 manifest、BASE 和所有 INCR 文件。
sudo systemctl stop <SERVICE>
sudo install -d -m 700 <WORKDIR>/original <WORKDIR>/working
sudo cp -a <PERSISTENCE_PATH> <WORKDIR>/original/
sudo cp -a <WORKDIR>/original/. <WORKDIR>/working/
sudo find <WORKDIR>/original -type f -exec sha256sum {} \; \
  | sort > <WORKDIR>/original.sha256
pgrep -a redis-server || true
预期输出
<无 redis-server 进程输出>systemctl 服务名和路径需要替换为实际值。若 pgrep 仍显示进程,先确认是否为同一实例;未完全停止前不要运行修复工具。原始目录应保持只读并单独备份,后续命令只针对 working。
检查 RDB
redis-check-rdb 会解析格式、对象和校验和,但不会修改文件,也没有通用的安全修复模式。使用与数据文件相同版本或更高且兼容的 Redis 工具检查工作副本。
redis-check-rdb <WORKDIR>/working/dump.rdb预期输出
[offset 0] Checking RDB file <WORKDIR>/working/dump.rdb
...
[offset <OFFSET>] \o/ RDB looks OK! \o/
[info] <KEY_COUNT> keys read
若出现 RDB ERROR DETECTED、Unexpected EOF 或 RDB CRC error,不要用文本工具截断二进制文件。安全恢复顺序是使用已验证备份、从健康副本重新生成快照,或在保留原件后交给专门的数据抢救流程;任意“手工修补”都可能扩大不可恢复范围。
检查并有限修复 AOF
先不带 --fix 检查。Redis 7 及以上多段 AOF 应把 <AOF_OR_MANIFEST> 指向 appendonly.aof.manifest;旧式单文件 AOF 则直接指向 appendonly.aof。
redis-check-aof <AOF_OR_MANIFEST>预期输出
Start checking Multi Part AOF
...
All AOF files and manifest are valid
旧式 AOF 的成功提示会显示单文件有效。若检查报告尾部存在无效字节,并且已接受这些尾部命令丢失,只能在工作副本上执行交互式截断。
# 先记录 diff 和 ok_up_to,再在提示中人工确认 y
redis-check-aof --fix <AOF_OR_MANIFEST>
预期输出
AOF analyzed: filename=<FILE>, size=<BYTES>, ok_up_to=<OFFSET>, ok_up_to_line=<LINE>, diff=<BYTES>
This will shrink the AOF <FILE> from <BYTES> bytes, with <BYTES> bytes, to <BYTES> bytes
Continue? [y/N]: y
Successfully truncated AOF <FILE>
diff 表示将被丢弃的尾部字节。多段 AOF 只允许截断最后一个有效序列文件;BASE、manifest、缺失文件或非末段 INCR 损坏时,工具通常会拒绝修复,此时应恢复完整备份或从健康副本重建,不要默认手改 manifest。
隔离加载验证
修复后不要直接覆盖生产文件。使用空闲本地端口和工作目录启动隔离实例,确认能够完整加载,再核对键数量、关键键类型、TTL 和业务抽样。下面脚本通过 MODE 选择 RDB 或 Redis 7 及以上多段 AOF。
MODE="rdb"                 # 可改为 aof
TEST_PORT="<TEST_PORT>"
WORKDIR="<WORKDIR>"
AOF_DIRNAME="<AOF_DIRNAME>"
AOF_FILENAME="<AOF_FILENAME>"

if [ "$MODE" = "rdb" ]; then
  PERSIST_ARGS=(--dir "$WORKDIR/working" --dbfilename dump.rdb --appendonly no)
else
  PERSIST_ARGS=(--dir "$WORKDIR/working" --dbfilename __unused__.rdb \
    --appendonly yes --appenddirname "$AOF_DIRNAME" --appendfilename "$AOF_FILENAME")
fi

redis-server --bind 127.0.0.1 --protected-mode yes --port "$TEST_PORT" \
  --daemonize yes --pidfile "$WORKDIR/verify.pid" \
  --logfile "$WORKDIR/verify.log" "${PERSIST_ARGS[@]}"

redis-cli -h 127.0.0.1 -p "$TEST_PORT" PING
redis-cli -h 127.0.0.1 -p "$TEST_PORT" DBSIZE
redis-cli -h 127.0.0.1 -p "$TEST_PORT" INFO persistence \
  | grep -E '^(loading|aof_enabled):'
redis-cli -h 127.0.0.1 -p "$TEST_PORT" SHUTDOWN NOSAVE
预期输出
PONG
<KEY_COUNT>
loading:0
aof_enabled:<0_OR_1>
若日志提示模块类型无法加载,应使用生产相同的 Redis 版本、模块和必要配置重新验证。通过后再在维护窗口回装恢复副本,保留损坏文件以便回滚,并恢复正确的属主、权限和安全上下文。
风险与边界
- 在运行中的文件上检查或修复会与 Redis 写入竞争,可能得到不一致副本甚至扩大损坏。安全替代是停止实例或使用存储快照后处理副本。
redis-check-aof --fix会不可逆地截断尾部,触发条件是人工确认修复;后果是ok_up_to之后的写命令全部丢失。必须先备份、评估diff,并优先选择健康副本或更新备份。- RDB 损坏没有等价的自动截断修复。强行裁剪、十六进制编辑或关闭校验只能掩盖错误,不能证明数据结构完整。
- 同时启用 RDB 和 AOF 时要确认实际加载源;修复错误文件会造成“文件已修好但服务仍启动失败”的误判。
- 使用过旧的检查器可能无法识别新格式或模块数据。优先使用生成文件的同版本二进制,并在升级前完成隔离加载测试。
排障清单
- 检查器提示找不到 AOF 文件:核对 manifest 中的文件名、复制目录是否完整,以及 BASE 和所有 INCR 是否一起保留。
- 检查通过但 Redis 仍无法启动:查看隔离实例日志,排查权限、目录、模块、ACL 文件、磁盘空间和配置指向错误。
- 键数量明显减少:停止回装,比较备份时间点、AOF 截断位置和关键业务键;不要用当前结果覆盖最后一份完整副本。
- 回装后立即再次损坏:检查磁盘、文件系统、异常关机、容器卷挂载和持久化目录权限,先修复底层原因再恢复写流量。
兼容性
Redis 7 及以上默认采用 manifest 管理的多段 AOF,检查时应传入 manifest;较旧版本通常使用单个 appendonly.aof。不同大版本的 RDB、AOF 和模块格式可能存在兼容限制,生产恢复应使用匹配版本验证,并保留原始文件和可回退路径。