
Redis 与缓存 / 知识点
Redis 故障排查手册
手册条目
通过进程、端口和 PING 响应快速判断 Redis 服务是否正常运行。
检查 Redis 服务是否存活
应用报连接拒绝、超时或缓存不可用时,依次确认进程、监听端口和 PING 响应。只有三层都正常,才能判断指定 Redis 端点真正可用;只看到进程不代表已成功监听或能处理请求。
命令定位
先核对应用实际使用的主机、端口、TLS 和认证方式。默认数据端口是 6379,生产环境可能已修改;容器或 Kubernetes 场景应在应用所在网络位置执行,避免“宿主机可通、应用侧不通”的误判。
主检查
HOST="${HOST:-127.0.0.1}"
PORT="${PORT:-6379}"

printf '== process ==\n'
ps -eo pid,args | grep -E '[r]edis-server|[r]edis-sentinel' || true

printf '== listen ==\n'
ss -lntp 2>/dev/null | awk -v port="$PORT" '$4 ~ (":" port "$")'

printf '== ping ==\n'
redis-cli -h "$HOST" -p "$PORT" -t 3 --raw PING
预期输出
== process ==
<PID> /usr/bin/redis-server 127.0.0.1:6379
== listen ==
LISTEN 0 511 127.0.0.1:6379 0.0.0.0:* users:(("redis-server",pid=<PID>,fd=<FD>))
== ping ==
PONG<PID>、<FD> 是动态值。进程行表示 Redis 已启动,监听行表示目标端口已建立套接字,PONG 表示 TCP 连接和 Redis 协议均正常。
输出读取
NOAUTH Authentication required. 说明服务存活但请求未认证,应通过受保护的 REDISCLI_AUTH 重试。Connection refused 通常表示目标可达但端口未监听;Connection timed out 更偏向路由、防火墙、网络策略或实例严重阻塞;主机名解析错误则先检查 DNS 和服务发现。
若进程存在但没有监听,检查启动日志、配置语法、端口占用和文件权限。若端口存在但 PING 超时,再查看 CPU、内存、连接数、慢命令和持久化阻塞,不要立即把问题归因于网络。
风险与边界
在命令行使用 redis-cli -a <PASSWORD> 会把密码暴露在 shell 历史或进程参数中;安全替代是从密钥系统注入 REDISCLI_AUTH,检查后执行 unset REDISCLI_AUTH。高频循环 PING 会持续创建连接并放大故障实例压力,应使用单次探测或带退避的监控。
仅凭进程名执行 kill -9 可能中断写入、触发故障转移并增加数据丢失风险。先确认节点角色、持久化和切换策略,再通过服务管理器做受控重启。
排障清单
- 核对应用连接地址、端口、TLS 和认证参数。
- 确认 Redis 进程或容器状态,并查看最近启动日志。
- 检查监听地址是否允许当前来源访问。
- 从应用同一网络位置执行
PING。 - 按认证失败、拒绝连接、超时或 DNS 错误进入对应分支。
兼容性提示:精简镜像可能没有 ss,可改用 netstat -lntp 或 lsof -nP -iTCP:<PORT> -sTCP:LISTEN。
查看 Redis 版本、部署角色以及单机、哨兵或集群运行模式。
确认 Redis 版本与运行模式
排查命令差异、升级兼容或拓扑异常时,读取 INFO 中的版本、复制角色和集群开关。版本看 redis_version,节点职责看 role,Cluster 看 cluster_enabled;Sentinel 是独立进程,必须查询它自己的端口。
主检查
下面同时查询数据端口和常见 Sentinel 端口。启用 ACL、TLS 或自定义端口时,应补充与应用一致的连接参数。
HOST="${HOST:-127.0.0.1}"
PORT="${PORT:-6379}"
SENTINEL_PORT="${SENTINEL_PORT:-26379}"

redis-cli -h "$HOST" -p "$PORT" -t 3 INFO server   | tr -d '\r' | grep -E '^(redis_version|redis_mode):'

redis-cli -h "$HOST" -p "$PORT" -t 3 INFO replication   | tr -d '\r' | grep -E '^(role|master_host|master_port|master_link_status|connected_slaves):'

redis-cli -h "$HOST" -p "$PORT" -t 3 INFO cluster   | tr -d '\r' | grep -E '^cluster_enabled:'

if redis-cli -h "$HOST" -p "$SENTINEL_PORT" -t 1 --raw PING >/dev/null 2>&1; then
  redis-cli -h "$HOST" -p "$SENTINEL_PORT" INFO server     | tr -d '\r' | grep -E '^(redis_version|redis_mode):'
else
  echo 'sentinel=not-detected'
fi
预期输出
redis_version:7.2.4
redis_mode:standalone
role:master
connected_slaves:1
cluster_enabled:0
sentinel=not-detected
该示例表示 Redis 7.2.4 的普通主节点,连接了一个副本,未启用 Redis Cluster,且指定 Sentinel 端口未发现进程。版本号、节点数量和地址是动态值,实际输出可能不同。
字段说明
| 字段 | 判断方法 |
|---|---|
redis_version |
实例实际运行版本,排障时以它为准,不要只看镜像标签或安装包。 |
redis_mode |
常见值为 standalone、cluster、sentinel,只反映当前查询端点。 |
role |
master 为主节点;副本端可能仍显示兼容值 slave。 |
master_link_status |
副本到主节点的链路状态,up 才表示当前连通。 |
cluster_enabled |
1 为 Cluster 节点,0 为未启用 Cluster。 |
模式判断
redis_mode:standalone、cluster_enabled:0 且 role:master 表示普通主节点;role:slave 表示普通复制副本。redis_mode:cluster 或 cluster_enabled:1 表示 Cluster 节点,应继续检查 CLUSTER INFO 和 CLUSTER NODES。
不能因数据端口显示 standalone 就断定没有 Sentinel。Sentinel 管理的是外部故障转移,数据节点仍可能显示 standalone;只有连接 Sentinel 实际端口并看到 redis_mode:sentinel,才能确认该端点身份。
风险与边界
使用写命令“试探角色”可能污染数据,副本还会返回只读错误;安全替代是使用 INFO、ROLE、CLUSTER INFO 等只读命令。只看版本号也不足以决定升级,代理、客户端、模块和持久化格式可能有独立兼容要求。
未确认主从和故障转移关系前重启主节点,可能触发切换、写入中断或数据回退。先保存版本、模式、角色、复制状态和模块信息,再按部署方案执行变更。
排障清单
- 从应用实际连接的数据端口读取版本和模式。
- 用
INFO replication确认角色、上游和复制链路。 - 用
cluster_enabled判断是否进入 Cluster 排障。 - 按真实地址单独查询 Sentinel,不要只猜默认端口。
- 将结果与编排配置、服务发现和监控拓扑交叉核对。
检查客户端到 Redis 节点之间的地址解析、端口和网络链路。
验证客户端到 Redis 的网络连通性
用于区分 DNS、TCP 端口、TLS 与 Redis 协议层故障。按“地址解析 → 建立 TCP → 发送 Redis 命令”的顺序检查。只要收到 PONG、NOAUTH、WRONGPASS 或 NOPERM,都说明网络链路和 Redis 协议入口已经可达,应继续排查认证或权限。
命令定位
必须在真正发起连接的运行环境中执行,例如应用容器、Kubernetes Pod、跳板机或宿主机。不要只在 Redis 服务器本机测试;本机成功无法证明客户端所在网络命名空间、路由、安全组和 NetworkPolicy 正常。
基本检查
下面的命令依次验证解析结果、TCP 三次握手和 Redis 协议响应。可通过环境变量覆盖默认地址与端口。
# 在应用实际运行的主机或容器内执行
REDIS_HOST="${REDIS_HOST:-127.0.0.1}"
REDIS_PORT="${REDIS_PORT:-6379}"

getent ahosts "$REDIS_HOST" | head -n 3
nc -vz -w 3 "$REDIS_HOST" "$REDIS_PORT"
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw PING
预期输出
<IP> STREAM <HOST>
Connection to <HOST> <PORT> port [tcp/*] succeeded!
PONG<IP>、服务名和提示文本会因系统实现而不同。最后一行是 NOAUTH Authentication required. 也代表链路已通,只是服务要求认证;WRONGPASS 或 NOPERM 同样不是网络故障。
常用参数
redis-cli -h 指定目标主机,-p 指定端口,--tls 用于 TLS 连接,--cacert <PATH> 指定受信任 CA。nc -z 只探测端口不发送业务数据,-v 显示结果,-w 3 将等待时间限制为约 3 秒。
Redis Cluster 返回 MOVED 或 ASK 时,说明当前节点可达但客户端未跟随重定向;使用 redis-cli -c 复测。连接托管 Redis 的 TLS 端口时,必须同时使用 --tls,否则可能出现连接被重置或协议错误。
结果判读
| 现象 | 结论 | 下一步 |
|---|---|---|
getent 无输出或提示未知主机 |
DNS 或服务发现失败 | 检查主机名、/etc/resolv.conf、容器 DNS 和服务记录 |
nc 提示 succeeded |
TCP 端口可达 | 继续执行 redis-cli PING |
Connection refused |
已到达目标主机,但端口无监听或被主动拒绝 | 在服务端检查监听地址、端口、进程和 bind 配置 |
timed out |
报文被丢弃或路由不通 | 检查防火墙、安全组、NetworkPolicy、路由和 NAT |
PONG、NOAUTH、WRONGPASS、NOPERM |
Redis 协议入口可达 | 转向认证、ACL 或客户端配置排查 |
Connection reset by peer |
常见于 TLS/明文端口不匹配或中间设备重置 | 核对端口、--tls、证书和代理配置 |
风险与边界
nc 成功只证明 TCP 建连,不能证明目标一定是 Redis,也不能证明认证、读写权限或集群重定向正常。安全替代方案是继续发送只读的 PING,不要为了“验证端口”执行 FLUSHALL、大范围 KEYS * 或写入生产键。
不要对未授权网段批量扫描端口;这可能触发告警或违反安全策略。限定为已知 Redis 地址和端口,并优先从应用同一网络位置执行单点验证。
兼容性
getent 常见于 Linux;macOS 可用 dscacheutil -q host -a name "$REDIS_HOST" 或 dig +short "$REDIS_HOST"。不同 nc 实现的超时参数略有差异。redis-cli --tls 需要客户端编译时启用 TLS 支持;若命令不识别该参数,应安装与服务版本匹配的 Redis CLI。
定位密码、用户名、ACL 权限或认证顺序导致的连接失败。
排查 Redis 认证失败
用于区分“未发送认证”“用户名或密码错误”“用户被禁用”以及“认证成功但 ACL 不允许命令或键”。先确认网络已能返回 Redis 错误,再使用与应用完全相同的主机、端口、TLS、用户名和密码复测。
基本验证
Redis 6 及以上通常使用 ACL 用户名和密码。密码通过 REDISCLI_AUTH 传入,避免直接出现在命令历史和进程参数中。
REDIS_HOST="${REDIS_HOST:-127.0.0.1}"
REDIS_PORT="${REDIS_PORT:-6379}"
REDIS_USER="${REDIS_USER:-default}"
: "${REDIS_PASSWORD:?请先执行 export REDIS_PASSWORD='实际密码'}"

# 使用与应用相同的用户验证认证和最小命令权限
REDISCLI_AUTH="$REDIS_PASSWORD" \
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" \
  --user "$REDIS_USER" --raw PING
预期输出
PONGPONG 表示认证成功且该用户允许执行 PING。若返回 NOPERM this user has no permissions to run the 'ping' command,认证通常已经成功,只是 ACL 未授予 PING;应改用应用实际执行的命令和键范围验证,而不是继续更换密码。
错误判读
| 错误 | 常见原因 | 处理方向 |
|---|---|---|
NOAUTH Authentication required. |
客户端没有发送 AUTH,或连接池在加载凭据前已建立连接 |
检查连接 URI、客户端认证配置和连接池初始化顺序 |
WRONGPASS invalid username-password pair or user is disabled. |
用户名错误、密码不匹配、用户为 off,或连到了凭据不同的节点 |
核对目标节点、用户名、密钥版本和 ACL 用户状态 |
NOPERM ... |
认证成功,但命令、键模式或 Pub/Sub 频道不在授权范围 | 检查 commands、keys、channels 规则 |
ERR AUTH <password> called without any password configured for the default user. |
客户端向未设置密码的 default 用户发送了旧式认证 |
移除多余密码配置,或在服务端按安全要求启用 ACL |
某些请求成功、某些请求 WRONGPASS |
集群节点、哨兵或副本的凭据不一致,或密码轮换未完全发布 | 逐个核对节点配置并重建旧连接 |
管理员侧检查
仅使用具备 ACL 管理权限的账号查看目标用户,不要用业务账号临时扩大权限。以下命令会读取用户状态、密码哈希和授权规则。
REDIS_HOST="${REDIS_HOST:-127.0.0.1}"
REDIS_PORT="${REDIS_PORT:-6379}"
REDIS_ADMIN_USER="${REDIS_ADMIN_USER:-default}"
REDIS_USER="${REDIS_USER:-app}"
: "${REDIS_ADMIN_PASSWORD:?请先设置管理员密码}"

# 只读检查目标用户,不在排障阶段直接修改 ACL
REDISCLI_AUTH="$REDIS_ADMIN_PASSWORD" \
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" \
  --user "$REDIS_ADMIN_USER" --raw ACL GETUSER "$REDIS_USER"
预期输出
flags
on
passwords
<REDACTED_PASSWORD_HASH>
commands
<ACL_COMMAND_RULES>
keys
<ACL_KEY_PATTERNS>
channels
<ACL_CHANNEL_PATTERNS>
重点检查 flags 是否包含 on;commands 是否允许应用命令;keys 是否覆盖实际键前缀;使用 Pub/Sub 时还要检查 channels。输出字段和顺序可能随 Redis 版本及用户规则变化,密码哈希不得粘贴到公开工单。
认证顺序与连接池
AUTH 对每条 TCP 连接单独生效。应用更新密码后,旧连接不会自动重新认证;如果密码已轮换但连接池仍复用旧连接,可能出现新旧请求结果不一致。安全做法是更新密钥后有序重建连接池,并确认重试不会继续使用旧配置。
Redis Cluster 会把请求重定向到其他节点,所有可能接收连接的节点都必须存在一致的 ACL 用户。Sentinel 模式还要区分连接 Sentinel 的凭据和连接数据节点的凭据,不能只修改其中一侧。
风险与边界
不要使用 redis-cli -a 明文密码、把密码写进 URI 后粘贴到日志,或通过聊天工具发送完整连接串;这些内容可能进入 shell 历史、进程列表、监控和工单。优先使用短生命周期环境变量、密钥挂载或 --askpass,验证后执行 unset REDIS_PASSWORD REDIS_ADMIN_PASSWORD。
不要通过 ACL SETUSER app on >password ~* +@all 作为快速修复;这会把用户扩大为近似全权限,可能造成越权读写和高危管理命令暴露。安全替代方案是按应用需要授予最小命令集合、明确键前缀和频道模式,并在变更前保留可回滚配置。
兼容性
Redis 5 及更早版本没有 ACL 用户名,通常只对 default 用户执行 AUTH password;此时省略 --user。Redis 6 及以上支持 AUTH username password 和 ACL GETUSER。TLS 实例还需在所有复测命令中加入 --tls、CA 证书及必要的客户端证书参数。
查看当前连接、历史峰值和连接上限,判断是否存在连接耗尽。
检查 Redis 客户端连接数
用于确认当前并发连接是否接近 maxclients、是否已经发生连接拒绝,以及过去某个时间窗口内的并发峰值。Redis 本身只保存当前连接数和累计拒绝次数,不保存“历史最大并发连接数”;历史峰值必须从监控时序数据计算。
当前连接、上限与拒绝次数
在 Redis 所在主机或具备访问权限的运维机执行。将 HOST、PORT 替换为实际地址;启用 ACL 时追加 --user <USER>,并通过 REDISCLI_AUTH 注入密码,避免把密码直接写进命令参数。
HOST="127.0.0.1"
PORT="6379"

# 先看当前并发与上限,再确认是否出现过配额拒绝。
redis-cli -h "$HOST" -p "$PORT" INFO clients | grep -E '^(connected_clients|blocked_clients|maxclients):'
redis-cli -h "$HOST" -p "$PORT" INFO stats | grep -E '^(total_connections_received|rejected_connections):'
redis-cli -h "$HOST" -p "$PORT" CONFIG GET maxclients
预期输出(示例,实际数值会不同):
connected_clients:<CURRENT_CLIENTS>
maxclients:<MAX_CLIENTS>
blocked_clients:<BLOCKED_CLIENTS>
total_connections_received:<TOTAL_ACCEPTED>
rejected_connections:<REJECTED_TOTAL>
1) "maxclients"
2) "<MAX_CLIENTS>"
connected_clients 是当前已建立的客户端连接;maxclients 是 Redis 允许的客户端上限;rejected_connections 是本次 Redis 进程启动以来,因达到客户端上限而累计拒绝的连接数。total_connections_received 是累计成功接收的连接,不是并发峰值。
读取历史峰值
Redis 不会记录历史最大 connected_clients。已经接入 Prometheus 与 Redis Exporter 时,可对连接数时间序列取窗口最大值;标签名称按实际监控配置调整。
max_over_time(redis_connected_clients{instance="<INSTANCE>"}[24h])预期结果(示例):
<PEAK_CLIENTS_IN_24H>结果表示最近 24 小时采样到的最大并发连接数。没有监控数据时,只能从现在开始采样,无法从 total_connections_received 反推出历史并发峰值。
判断是否接近耗尽
先计算连接使用率:connected_clients / maxclients。低于 80% 通常有余量;持续高于 80% 应检查连接池和突发流量;高于 95% 且仍在上升,应按连接耗尽处理。该阈值是运维经验值,连接创建速率高或业务突发明显时应提前告警。
rejected_connections 只看绝对值容易误判,应比较相邻采样是否继续增长。若当前连接不高但该值曾增长,说明历史上触顶过;若 blocked_clients 高,重点排查阻塞命令或长时间等待,而不是直接认定连接泄漏。
风险与安全处理
不要仅为消除告警直接执行 CONFIG SET maxclients。当系统文件描述符上限不足时,提高 maxclients 可能导致 Redis、持久化文件或网络套接字打开失败。安全做法是先核对 Redis 进程的 LimitNOFILE、系统 ulimit -n、连接池总量和监控峰值,再分阶段调整并验证。
不要批量执行 CLIENT KILL TYPE normal 清连接。触发条件是连接已接近上限且存在大量空闲或异常客户端;直接清理可能中断请求、事务、订阅和阻塞读取。优先停止失控客户端、缩小连接池,并通过 CLIENT LIST 按来源、空闲时间和连接类型精确处理。
排障清单
connected_clients是否持续上升且不随流量回落。- 所有应用实例的连接池上限之和是否已经接近
maxclients。 rejected_connections是否在故障窗口内新增。- 是否存在大量
idle时间很长的连接、阻塞客户端或 Pub/Sub 长连接。 - 托管 Redis 是否禁止
CONFIG GET;若禁止,以控制台配置和监控指标为准。
速查结论:当前容量看 connected_clients / maxclients,是否已经触顶看 rejected_connections 的增量,历史峰值看监控时间序列,三者不能互相替代。
排查服务监听地址、保护模式、防火墙和最大客户端数限制。
定位 Redis 连接被拒绝
用于区分 TCP 端口未监听、监听地址不匹配、防火墙主动拒绝、Redis 保护模式拒绝和 maxclients 达限。先确认客户端收到的准确错误,再从客户端到 Redis 进程逐层验证,避免把所有失败都归因于防火墙。
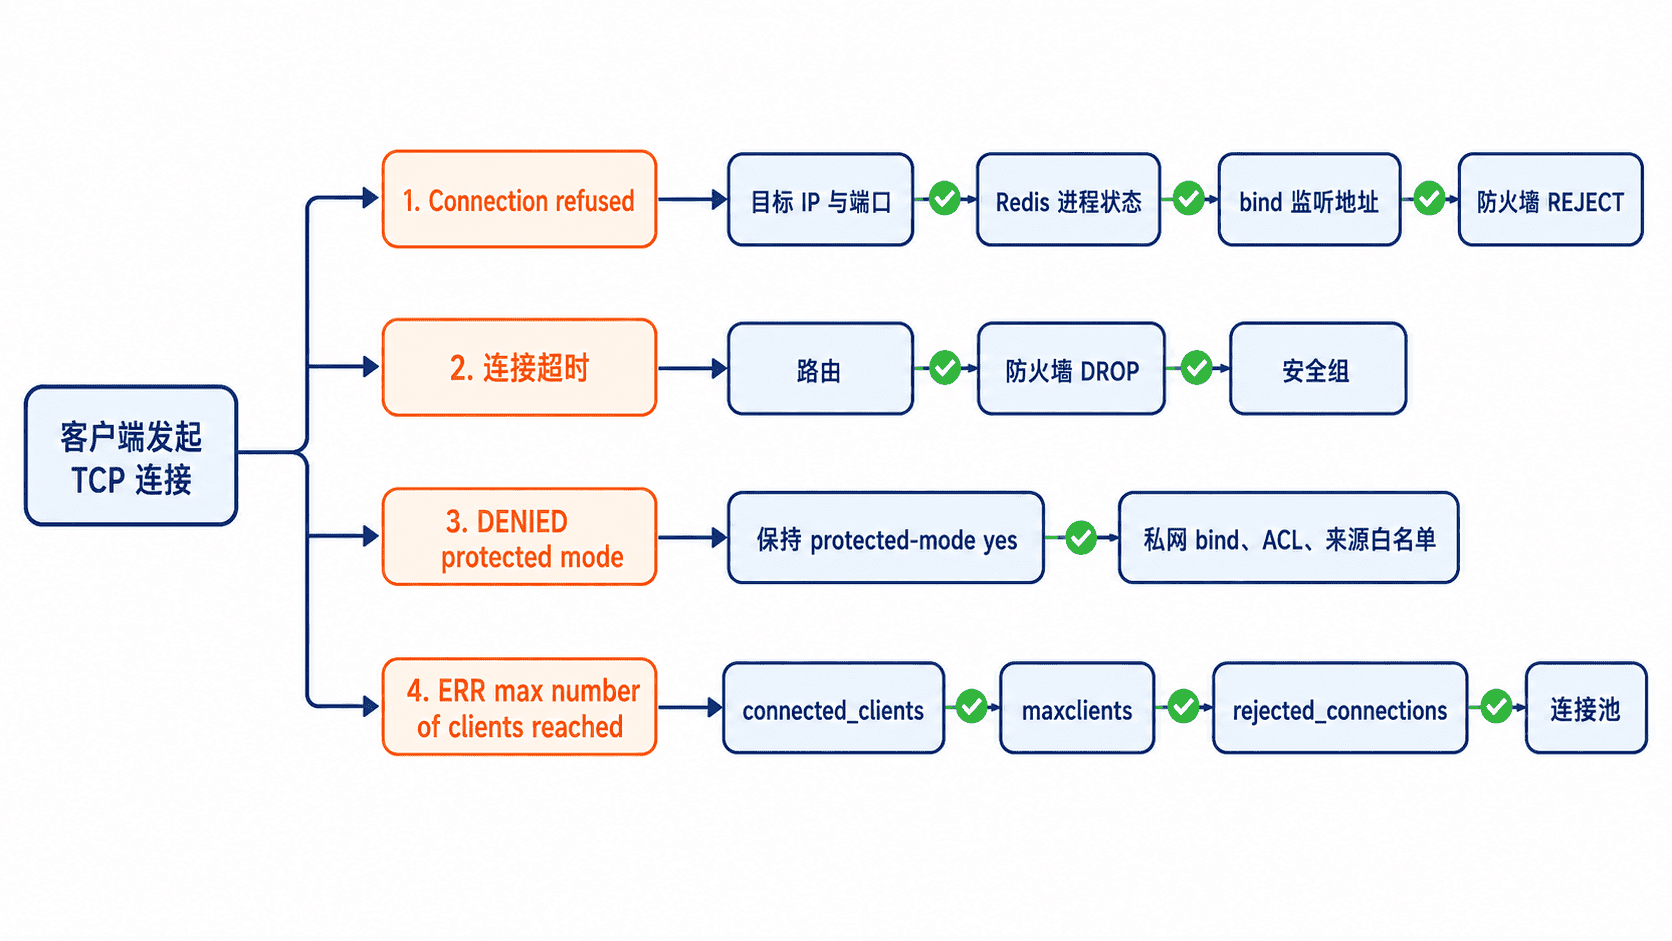
先按错误类型分流
从故障客户端直接执行连接测试。将地址替换为实际 Redis 私网地址,不要先修改服务端配置。
HOST="10.0.2.15"
PORT="6379"

# 限制等待时间,便于区分立即拒绝和连接超时。
timeout 3s redis-cli -h "$HOST" -p "$PORT" PING
预期输出之一:
Could not connect to Redis at 10.0.2.15:6379: Connection refusedConnection refused 通常表示目标地址可达,但该端口没有进程监听,或防火墙以 TCP Reset 主动拒绝。连接超时更像路由不通、防火墙丢弃或安全组未放行。DENIED Redis is running in protected mode 和 ERR max number of clients reached 都说明 TCP 已经建立,不能再按“端口未监听”处理。
检查进程与监听地址
登录 Redis 主机,确认服务状态、实际监听 IP 和生效配置。以下路径与服务名适用于常见 Linux 安装,发行版或容器环境可能不同。
PORT="6379"

# 先确认进程存活,再核对端口究竟绑定在哪个地址。
sudo systemctl is-active redis-server
sudo ss -lntp "sport = :$PORT"
sudo grep -E '^[[:space:]]*(bind|protected-mode|port|maxclients)([[:space:]]|$)' /etc/redis/redis.conf
预期输出(示例):
active
LISTEN 0 511 127.0.0.1:6379 0.0.0.0:* users:(("redis-server",pid=<PID>,fd=<FD>))
bind 127.0.0.1 -::1
protected-mode yes
port 6379
maxclients 10000
若 systemctl 非 active,先查看 journalctl -u redis-server 的启动错误。若只监听 127.0.0.1:6379,远程客户端必然无法连接;应把 bind 改为 Redis 主机的私网地址并重启,而不是直接绑定全部公网接口。
保护模式与访问控制
保护模式通常不会产生 TCP Connection refused,而是在连接建立后返回 DENIED。触发条件通常是 Redis 对外监听,但没有形成安全的绑定和认证配置。安全处理是保留 protected-mode yes,仅绑定私网地址,配置 ACL 用户和强密码,并在主机防火墙或云安全组中只放行业务网段。
不要用 protected-mode no 或 bind 0.0.0.0 作为快速修复。若端口可被公网访问,可能导致未授权读写、数据删除、敏感信息泄露或利用高危命令。临时验证应优先通过本机 redis-cli、跳板机或 SSH 隧道完成。
检查防火墙主动拒绝
当 Redis 已监听正确私网地址、本机 PING 成功、远程仍返回 Connection refused 时,检查主机规则是否存在 reject 或 TCP Reset。云环境还需核对安全组和网络 ACL;规则命中范围必须同时包含来源网段、目标端口和协议。
# 同时查找端口规则和会造成拒绝或超时的动作。
sudo nft list ruleset | sed -nE '/6379|reject|drop/p'
sudo ufw status numbered
预期输出(示例):
tcp dport 6379 ip saddr != 10.0.0.0/8 reject with tcp reset
Status: active
[ 1] 6379/tcp ALLOW IN 10.0.0.0/8
出现 reject with tcp reset 可直接解释“被拒绝”;drop 更常表现为超时。安全替代方案是只放行应用所在私网 CIDR,不要开放 0.0.0.0/0。修改后从原故障客户端重新执行 PING 验证。
检查最大客户端数
若错误为 ERR max number of clients reached,说明 Redis 端口和网络均正常,但连接配额已耗尽。使用已有管理连接或本机可用连接读取以下指标。
# 使用仍可用的本地或既有管理连接读取容量指标。
redis-cli -h 127.0.0.1 -p 6379 INFO clients | grep -E '^(connected_clients|maxclients):'
redis-cli -h 127.0.0.1 -p 6379 INFO stats | grep '^rejected_connections:'
预期输出(示例):
connected_clients:<CURRENT_CLIENTS>
maxclients:<MAX_CLIENTS>
rejected_connections:<REJECTED_TOTAL>
当 connected_clients 接近 maxclients 且 rejected_connections 持续增加时,先停止失控客户端或缩小连接池,再评估是否提高上限。只调大 maxclients 而不检查文件描述符限制,会把故障从“拒绝连接”扩大为套接字、持久化文件或日志打开失败。
兼容性与最终验证
容器部署应在宿主机检查端口映射,同时在容器内检查 Redis 监听地址;Kubernetes 还要检查 Service、Endpoint 和 NetworkPolicy。Redis 6 及以上优先使用 ACL,托管 Redis 的绑定地址、保护模式和 CONFIG 命令可能由平台接管。
修复后应同时验证三点:故障客户端 PING 返回 PONG,服务端监听地址符合预期,rejected_connections 不再增长。只验证其中一项,可能遗漏仍在生效的网络或容量限制。
使用运行指标快速识别内存、负载、连接、持久化和复制异常。
查看 Redis 整体运行状态
用于在告警或性能下降时快速判断 Redis 是否可达,并同时检查连接、内存、吞吐、持久化和复制。先看 PING,再读取一组关键 INFO 字段;不要只凭单个瞬时值下结论,应与上一采样点或正常基线比较。
命令定位
PING 只验证客户端能够完成一次请求,不能证明内存、持久化和复制正常。INFO all 会返回完整运行快照,适合临时排障;持续监控时应改为按需读取 clients、memory、stats、persistence 和 replication 分区,减少无关输出。
快速快照
以下命令默认连接本机 6379,也可以通过环境变量覆盖地址。生产环境需要认证时,应由密钥管理系统注入 REDISCLI_AUTH,不要把密码直接写在 -a 参数或脚本中。
REDIS_HOST=${REDIS_HOST:-127.0.0.1}
REDIS_PORT=${REDIS_PORT:-6379}

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" PING
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw INFO all | grep -E '^(redis_version|uptime_in_seconds|connected_clients|blocked_clients|maxclients|rejected_connections|used_memory_human|used_memory_rss_human|maxmemory_human|mem_fragmentation_ratio|instantaneous_ops_per_sec|total_error_replies|loading|rdb_bgsave_in_progress|rdb_last_bgsave_status|aof_enabled|aof_rewrite_in_progress|aof_last_bgrewrite_status|role|connected_slaves|master_link_status):'
预期输出
PONG
redis_version:<VERSION>
uptime_in_seconds:<SECONDS>
connected_clients:<COUNT>
blocked_clients:0
maxclients:<COUNT>
used_memory_human:<MEMORY>
used_memory_rss_human:<MEMORY>
maxmemory_human:<MEMORY>
mem_fragmentation_ratio:<RATIO>
instantaneous_ops_per_sec:<OPS>
rejected_connections:0
total_error_replies:<COUNT>
loading:0
rdb_bgsave_in_progress:0
rdb_last_bgsave_status:ok
aof_enabled:1
aof_rewrite_in_progress:0
aof_last_bgrewrite_status:ok
role:master
connected_slaves:<COUNT><VERSION>、<COUNT>、<MEMORY> 等实际值会不同。主节点通常没有 master_link_status;副本节点应重点确认该字段为 up。未启用 AOF 时,仍应结合 aof_enabled:0 判断相关重写状态是否有意义。
关键字段判读
connected_clients 接近 maxclients,并且 rejected_connections 持续增加,说明新连接已被拒绝。blocked_clients 非零可能来自 BLPOP 等预期阻塞,也可能是命令或依赖异常,需要结合客户端名称、命令延迟和业务行为确认。
used_memory_human 接近 maxmemory_human 时,实例可能进入键淘汰或 noeviction 拒写。used_memory_rss_human 明显高于 Redis 已用内存,常见于分配器碎片或删除大量键后驻留页未归还,应转入内存专项检查。
instantaneous_ops_per_sec 只代表当前负载快照;total_error_replies 是启动后的累计值,只有在相邻采样间持续增长才表示错误仍在发生。持久化状态出现 err、后台任务长时间为 1,或副本链路为 down,都应优先处理。
风险与边界
INFO all 是只读命令,但在高频轮询、模块较多或命令统计量很大时会产生额外 CPU、网络和日志解析开销。安全替代方案是按分区采集,并把采样周期交给监控系统控制;临时排障也不要以毫秒级循环反复执行。
只看到 PONG 不代表实例健康,只看到某次 ops/sec 很高也不能直接判定过载。应至少连续采样两到三个点,并同时核对 Redis 延迟、宿主机 CPU、磁盘延迟和网络丢包,避免把外部资源瓶颈误判为 Redis 内部故障。
排障清单
PING失败:先检查地址、端口、TLS、认证、网络策略和 Redis 进程。- 连接被拒绝:核对
maxclients、客户端连接复用和文件描述符上限。 - 内存逼近上限:检查淘汰策略、热键、大键、复制积压和客户端缓冲区。
- 持久化异常:查看 Redis 日志、磁盘空间、目录权限和后台保存错误。
- 复制异常:在副本确认
master_link_status、复制偏移和最近一次 I/O 时间。
分析已用内存、峰值内存、数据内存和系统内存之间的关系。
检查 Redis 内存使用
用于区分“数据确实变多”“Redis 元数据或客户端开销变大”“分配器碎片增加”和“进程 RSS 接近系统限制”。核心是同时读取 used_memory、used_memory_dataset、used_memory_peak、used_memory_rss、maxmemory 与分配器比率,而不是只看一个百分比。
指标关系
used_memory_dataset 表示数据集主体;used_memory 还包含字典、过期表、客户端缓冲区、复制积压等 Redis 管理开销;used_memory_peak 是本次进程启动以来的峰值。used_memory_rss 是操作系统看到的驻留内存,可能因分配器碎片和未归还页高于 used_memory。
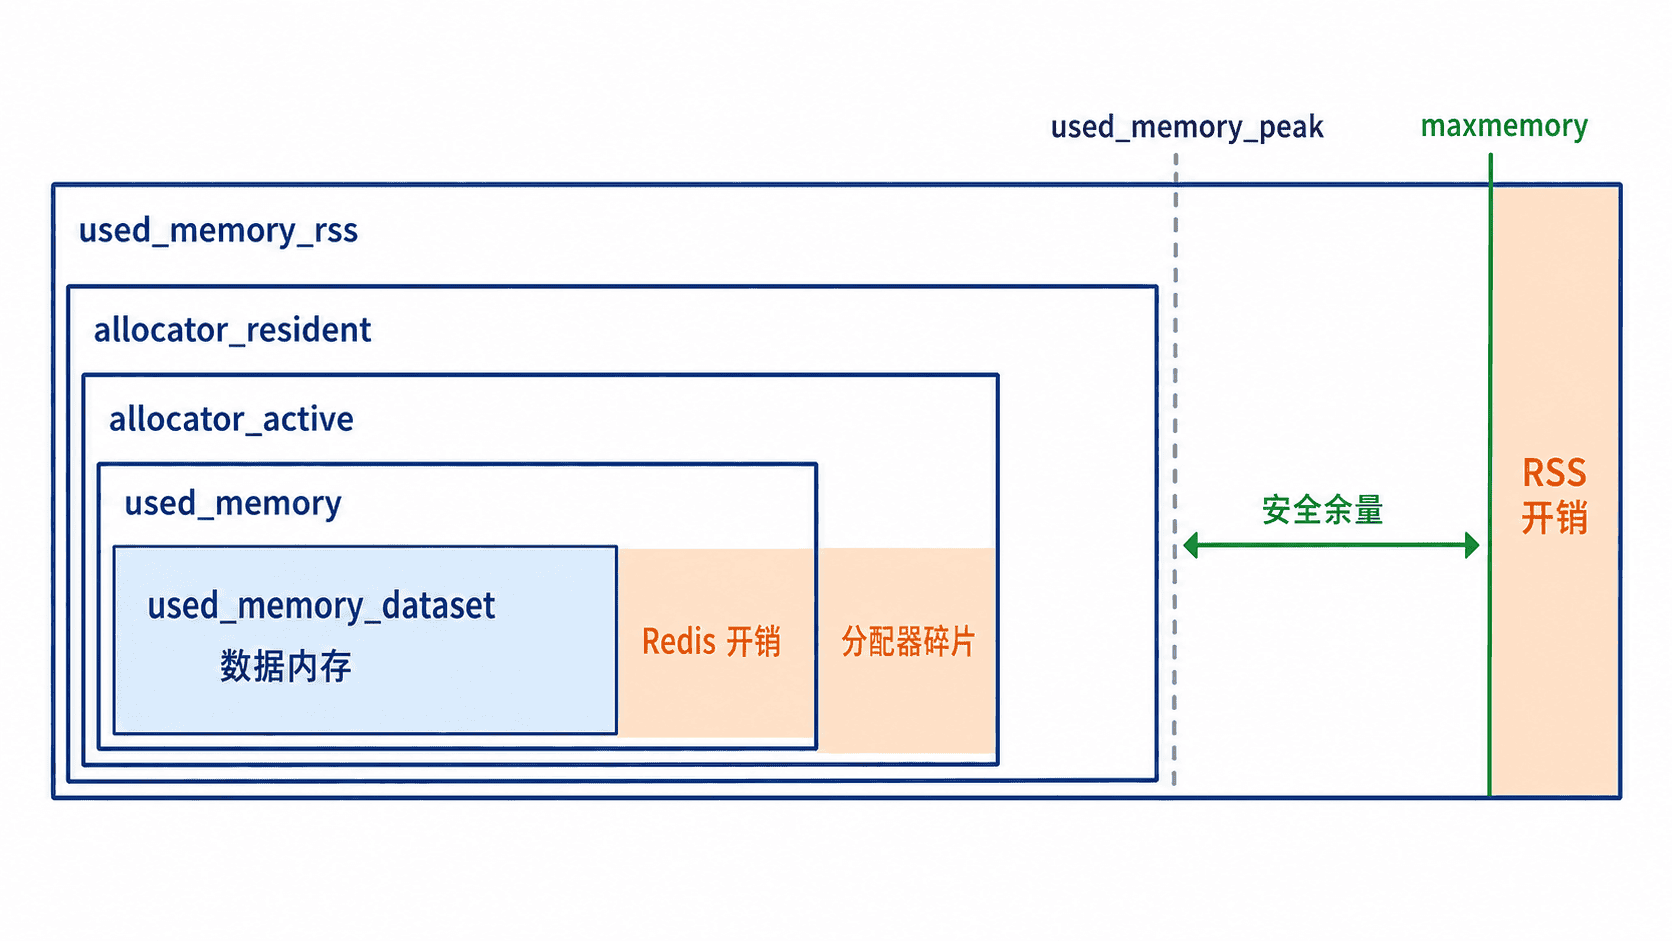
maxmemory 是 Redis 的逻辑限制;total_system_memory 是系统内存参考值,并不等于 Redis 可用额度。容器环境还要单独核对 cgroup 内存上限,因为系统总内存字段可能不能代表容器实际可使用的容量。
快速快照
以下命令提取排障所需的核心字段。grep 只负责缩短输出,不改变 Redis 返回值;需要完整拆分开销时,再查看 MEMORY STATS。
REDIS_HOST=${REDIS_HOST:-127.0.0.1}
REDIS_PORT=${REDIS_PORT:-6379}

redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" --raw INFO memory | grep -E '^(used_memory|used_memory_human|used_memory_rss|used_memory_rss_human|used_memory_peak|used_memory_peak_human|used_memory_dataset|used_memory_dataset_perc|total_system_memory_human|maxmemory|maxmemory_human|maxmemory_policy|allocator_frag_ratio|allocator_rss_ratio|rss_overhead_ratio|mem_fragmentation_ratio|mem_fragmentation_bytes|mem_not_counted_for_evict):'
预期输出
used_memory:<BYTES>
used_memory_human:<MEMORY>
used_memory_rss:<BYTES>
used_memory_rss_human:<MEMORY>
used_memory_peak:<BYTES>
used_memory_peak_human:<MEMORY>
used_memory_dataset:<BYTES>
used_memory_dataset_perc:<PERCENT>%
total_system_memory_human:<MEMORY>
maxmemory:<BYTES>
maxmemory_human:<MEMORY>
maxmemory_policy:<POLICY>
allocator_frag_ratio:<RATIO>
allocator_rss_ratio:<RATIO>
rss_overhead_ratio:<RATIO>
mem_fragmentation_ratio:<RATIO>
mem_fragmentation_bytes:<BYTES>
mem_not_counted_for_evict:<BYTES><BYTES>、<MEMORY>、<RATIO> 等实际值会随采样时刻变化。某些旧版本或不同分配器可能缺少部分 allocator_* 字段,此时仍可使用 used_memory、used_memory_rss 和 mem_fragmentation_ratio 做初步判断。
判读方法
当 maxmemory 大于零且 used_memory 持续逼近上限时,先看 maxmemory_policy。淘汰策略允许删除键时会出现淘汰压力;noeviction 会让需要新增内存的写命令报错。mem_not_counted_for_evict 不参与部分淘汰计算,但仍会占用进程和系统内存,不能忽略。
used_memory_dataset 同步增长,通常表示键或值本体增加;数据集占比不高但 used_memory 很大,常见于大量小键、客户端输出缓冲区、复制积压或其他管理开销。此时用 MEMORY STATS 继续定位 clients.*、replication.backlog、overhead.total 和 dataset.bytes。
used_memory 已回落但 used_memory_rss 仍高,且 allocator_frag_ratio、allocator_rss_ratio 或 rss_overhead_ratio 偏高,通常是碎片或空闲页尚未归还。used_memory_peak 很高只能说明历史峰值,进程重启后会重置,不能单独作为当前泄漏证据。
风险与边界
不要在未核对淘汰策略和业务容忍度时直接下调 maxmemory。当新上限低于当前占用,实例可能迅速进入淘汰或拒写压力,造成缓存命中率下降、延迟抖动或业务写失败。安全做法是先确认数据可淘汰性、预留复制与持久化缓冲,再分阶段调整并监控错误率。
不要把 MEMORY PURGE、重启或批量删除键当作第一步。它们可能造成阻塞、缓存雪崩、复制流量突增,且不保证 RSS 立即下降。先确认增长来源;确需释放页时,在低峰期验证分配器支持、延迟影响和副本恢复能力。
排障清单
- 逻辑上限压力:比较
used_memory、maxmemory、淘汰策略和写错误。 - 系统 OOM 风险:比较
used_memory_rss与宿主机或容器内存限制。 - 数据增长:确认
used_memory_dataset、键数量、大键和过期策略。 - 管理开销增长:使用
MEMORY STATS检查客户端、复制积压和键元数据。 - RSS 不回落:观察分配器比率、删除历史和峰值,不要仅凭一次采样重启。
判断内存碎片率异常是否由分配器、删除操作或系统回收造成。
识别 Redis 内存碎片
当 Redis 的进程 RSS 明显高于 used_memory 时,用本条区分分配器内部碎片、已释放但尚未归还操作系统的页面,以及分配器之外的 RSS 开销。不要只看碎片率;必须同时看字节差、历史峰值和持续趋势。
快速采样
以下命令只读取当前实例,不修改数据。通过认证、TLS、Unix Socket 或非默认端口连接时,将相应连接参数补到每个 redis-cli 后。
redis-cli --raw INFO memory | grep -E '^(used_memory:|used_memory_rss:|used_memory_peak:|allocator_allocated:|allocator_active:|allocator_resident:|allocator_frag_ratio:|allocator_frag_bytes:|allocator_rss_ratio:|allocator_rss_bytes:|rss_overhead_ratio:|rss_overhead_bytes:|mem_fragmentation_ratio:|mem_fragmentation_bytes:|active_defrag_running:|lazyfree_pending_objects:|mem_allocator:)'预期输出
used_memory:2147483648
used_memory_rss:3221225472
used_memory_peak:5368709120
allocator_allocated:2181038080
allocator_active:2684354560
allocator_resident:3154116608
allocator_frag_ratio:1.23
allocator_frag_bytes:503316480
allocator_rss_ratio:1.18
allocator_rss_bytes:469762048
rss_overhead_ratio:1.02
rss_overhead_bytes:67108864
mem_fragmentation_ratio:1.50
mem_fragmentation_bytes:1073741824
active_defrag_running:0
lazyfree_pending_objects:0
mem_allocator:jemalloc-5.3.0
示例中进程 RSS 比 Redis 已用内存多约 1 GiB;其中分配器内部空洞约 480 MiB,分配器保留但未归还系统的页面约 448 MiB,分配器之外的 RSS 差额较小。实际值会随采样时刻变化,应连续采样而不是据单点结论。Redis 官方也建议在 rss >> used 时结合 allocator_frag_*、used_memory_peak 和 MEMORY STATS 判断。:contentReference[oaicite:0]{index=0}
判断碎片来源
| 观察项 | 主要含义 | 常见判断 |
|---|---|---|
mem_fragmentation_ratio、mem_fragmentation_bytes |
Redis 进程 RSS 与逻辑已用内存的总体差距 | 比率高且字节差也大才值得处理;数据量很小时比率容易失真 |
allocator_frag_ratio、allocator_frag_bytes |
分配器活动页相对实际分配对象的空洞 | 删除、过期或尺寸变化频繁后持续偏高,通常是分配器内部碎片 |
allocator_rss_ratio、allocator_rss_bytes |
分配器驻留页相对活动页的差距 | 峰值或批量删除后偏高,说明页面已空闲但尚未归还操作系统 |
rss_overhead_ratio、rss_overhead_bytes |
进程 RSS 中不属于分配器驻留区的部分 | 持续偏高时检查模块、线程栈、共享库和容器统计口径 |
lazyfree_pending_objects |
异步删除等待释放的对象数 | 持续增长时先等待后台释放,不能立即判定为内存泄漏 |
大量删除后 used_memory 会先下降,而 RSS 可能保持接近历史峰值;分配器通常会优先复用这些页面,因此后续写入期间 RSS 不再增长,往往比“立刻归还系统”更重要。碎片率在历史峰值远高于当前用量时并不可靠。:contentReference[oaicite:1]{index=1}
高频处理
- 删除或过期抖动后:以固定间隔采样 5~15 分钟。若
used_memory回升时 RSS 基本不变,说明空闲页正在被复用,通常无需重启。 allocator_frag_bytes持续较大:在变更窗口评估启用或调优主动碎片整理,并同时观察 CPU、命令延迟和active_defrag_running;它主要处理分配器内部碎片,不保证消除所有 RSS 差额。- jemalloc 保留页导致主机吃紧:低峰期评估
MEMORY PURGE。该命令可能较慢,只在 jemalloc 下真正执行,其他分配器通常为空操作。:contentReference[oaicite:2]{index=2} - 系统可用内存已逼近安全线:先限流和停止非必要写入,再按高可用流程受控故障转移或重启;操作前确认副本同步、持久化状态和故障转移容量。
风险与边界
批量删除不是“降低碎片率”的可靠手段:它会降低分母,短时间内反而把 mem_fragmentation_ratio 推高。不要因单个比率超过经验阈值就执行重启,也不要在高峰期盲目提高主动整理 CPU 上限。
若 used_memory 明显大于 used_memory_rss,可能已有部分 Redis 内存被换出,通常伴随显著延迟,应转向检查 swap、容器内存限制和宿主机压力,而不是继续按碎片问题处理。:contentReference[oaicite:3]{index=3}
排障清单
先核对 used_memory_peak 是否解释当前 RSS,再按 allocator_frag_bytes、allocator_rss_bytes、rss_overhead_bytes 拆分差额;检查异步释放积压和近期批量删除;最后结合主机可用内存与延迟趋势决定是否整理、清理页面或受控重启。旧版本缺少部分 allocator_* 字段时,至少保留 used_memory、used_memory_rss、used_memory_peak 与操作系统 RSS 的趋势对比。
定位达到最大内存限制后写命令被拒绝的具体原因。
排查 Redis OOM 写入失败
出现 OOM command not allowed when used memory > 'maxmemory' 时,先确认实例是否真的越过 maxmemory,再判断是 noeviction、没有可淘汰键、淘汰速度跟不上,还是配置和运行节点不一致。读取命令通常仍可执行,不要把 OOM 当成连接故障反复重试写入。
快速确认
以下命令均为只读诊断;应在收到 OOM 的同一主节点或同一集群分片上执行,避免从副本或其他分片得到无关结果。
redis-cli --raw CONFIG GET maxmemory
redis-cli --raw CONFIG GET maxmemory-policy
redis-cli --raw INFO memory | grep -E '^(used_memory:|used_memory_dataset:|maxmemory:|maxmemory_policy:|mem_not_counted_for_evict:|mem_fragmentation_ratio:)'
redis-cli --raw INFO stats | grep -E '^(evicted_keys:|current_eviction_exceeded_time:|total_error_replies:)'
redis-cli --raw INFO errorstats | grep '^errorstat_OOM:' || true
预期输出
maxmemory
1073741824
maxmemory-policy
noeviction
used_memory:1090519040
used_memory_dataset:1006632960
maxmemory:1073741824
maxmemory_policy:noeviction
mem_not_counted_for_evict:8388608
mem_fragmentation_ratio:1.14
evicted_keys:0
current_eviction_exceeded_time:42000
total_error_replies:37
errorstat_OOM:count=37
示例表示实例已超过 1 GiB 限制,策略为 noeviction,没有发生键淘汰,并已持续超限约 42 秒;errorstat_OOM 可确认 OOM 错误累计次数。INFO 字段会随版本增减,脚本应允许缺失字段。:contentReference[oaicite:4]{index=4}
定位具体原因
| 现象 | 原因 | 处理方向 |
|---|---|---|
maxmemory_policy:noeviction 且已超限 |
Redis 不删除键,新增数据的命令被拒绝 | 立即止住非必要写入;扩容、删除确认可丢数据,或经评审改为合适的淘汰策略 |
volatile-* 且业务键没有 TTL |
没有符合条件的键可淘汰,行为接近 noeviction |
补齐 TTL,或改用经过业务确认的 allkeys-* 策略 |
evicted_keys 持续增加但仍 OOM |
写入突发或单条命令新增数据过大,淘汰跟不上 | 限流、拆小批次、降低单值大小并预留内存余量 |
used_memory_dataset 未明显逼近限制,但总内存超限 |
字典、客户端、复制或其他开销占用较多 | 用 MEMORY STATS 和 INFO clients 拆分开销,不能只按数据集大小估算 |
| 只有部分请求失败 | 请求落到已满的特定集群分片,或应用连接了不同实例 | 核对错误连接地址、节点角色、槽位和各分片的独立内存指标 |
noeviction 会拒绝需要新增缓存数据的命令,而只读取现有数据的命令仍可正常工作;volatile-* 在没有带过期时间的键时也会表现为无法淘汰。单条大写入还可能暂时大幅超过限制。:contentReference[oaicite:5]{index=5}
安全恢复顺序
- 暂停批量导入、回填、缓存预热和非关键写入,避免客户端无限重试放大压力。
- 判断 Redis 是权威数据存储还是可重建缓存。只有确认键可丢失时,才允许删除或切换淘汰策略。
- 对权威数据优先扩容、分片迁移或清理明确过期数据;对缓存可按访问模式选择
allkeys-lru、allkeys-lfu等策略,并设置足够 TTL。 - 恢复后观察
used_memory、evicted_keys、OOM 计数和应用错误率,确认不是短暂恢复后再次撞线。
复制或 AOF 使用的部分缓冲区不会计入触发淘汰的内存比较,因此 maxmemory 不能直接等于容器或主机的全部可用 RAM;可结合 mem_not_counted_for_evict 预留空间。:contentReference[oaicite:6]{index=6}
风险与边界
不要在生产环境直接用测试 SET 验证 OOM:启用淘汰策略时,它可能驱逐真实业务键;使用 noeviction 时,它只会制造更多错误。也不要在未确认数据性质前把策略从 noeviction 改成 allkeys-*,否则可能静默删除无 TTL 的持久数据。
CONFIG SET 只改变当前运行配置;若部署流程、配置文件或托管平台没有同步,重启或故障转移后可能回退。Redis Cluster 中每个主分片独立达到限制,整体平均内存充足并不能排除单分片 OOM。
排障清单
确认错误前缀确为 OOM,而不是 ACL、只读副本或磁盘错误;在报错节点核对 maxmemory 与策略;检查可淘汰键是否存在、淘汰计数是否增长、是否有大命令或写入尖峰;确定数据能否丢失后再选择扩容、清理、补 TTL 或变更策略。客户端对持续性 OOM 应快速失败或降级,不能按网络瞬时错误无限重试。Redis 将此类错误归为资源限制问题,通常需要修正容量或配置。:contentReference[oaicite:7]{index=7}
确认淘汰策略、淘汰数量和业务访问模式是否匹配。
检查 Redis 键淘汰
用于确认实例是否因达到 maxmemory 正在淘汰键,以及当前策略是否符合业务访问模式。先读取内存上限和淘汰策略,再比较一段时间内 evicted_keys 的增量,避免把历史累计值误判为当前故障。
快速检查
以下命令默认连接本机 6379。远程实例可补充 -h <HOST> -p <PORT> --user <USER>;密码优先通过 REDISCLI_AUTH 环境变量提供,避免写入命令历史。
redis-cli --raw CONFIG GET maxmemory
redis-cli --raw CONFIG GET maxmemory-policy
redis-cli --raw INFO memory | grep -E '^(used_memory|maxmemory|maxmemory_policy):'

# 连续取样,第二次减第一次即为观察窗口内的淘汰量
redis-cli --raw INFO stats | grep '^evicted_keys:'
sleep 10
redis-cli --raw INFO stats | grep '^evicted_keys:'
预期输出示例:
maxmemory
1073741824
maxmemory-policy
allkeys-lru
used_memory:1006632960
maxmemory:1073741824
maxmemory_policy:allkeys-lru
evicted_keys:24831
evicted_keys:24868
示例中 10 秒内新增淘汰 37 个键,说明当前正在持续回收数据。内存值、时间窗口和淘汰数量会随实例状态变化。
读取结果
maxmemory 为 0 表示 Redis 未配置数据集内存上限;此时通常不会因 maxmemory 触发键淘汰。used_memory 接近 maxmemory 且 evicted_keys 持续增长,表示写入正在推动淘汰流程。
evicted_keys 是实例启动以来的累计值,重启后会重新计数。单次看到较大数值不能证明当前仍在淘汰,必须比较两个时间点。缓存未命中增加也不能单独证明发生淘汰,还可能来自键过期、主动删除或请求了不存在的键。
策略与访问模式
| 策略 | 适合场景 | 不匹配时的表现 |
|---|---|---|
noeviction |
数据不能被自动删除 | 达到上限后,新增或扩容数据的写命令返回 OOM |
allkeys-lru、allkeys-lfu |
实例主要作为缓存,所有键都允许被淘汰 | 持久化业务键也可能被删除 |
volatile-lru、volatile-lfu、volatile-ttl |
同一实例混放数据,但只有设置 TTL 的键允许淘汰 | 可淘汰键太少时仍可能返回 OOM |
allkeys-random、volatile-random |
键价值接近且替换成本较低 | 访问高度倾斜时可能误删热点键 |
LRU 和 LFU 策略使用近似采样,不保证每次都选中理论上最冷的键。若业务存在少量高价值热点键,应同时检查数据隔离、容量余量和 TTL 设计。
风险与边界
当 ACL 禁止 CONFIG GET 时,命令会返回权限错误,可改从受控配置中心、托管平台参数页或管理员账号读取配置,不要为了排障临时放开高权限命令。
在流量高峰直接执行 CONFIG SET maxmemory-policy ... 会立即改变后续淘汰行为,可能造成关键键被删除或写入突然失败。安全做法是在配置管理中变更,先验证 TTL 覆盖和回滚方案,再通过测试实例或小流量实例观察。
盲目增大 maxmemory 可能挤压操作系统、容器和 Redis 后台任务的内存,最终触发进程被 OOM Killer 终止。扩容前应确认宿主机或容器的真实内存余量,并为复制、持久化和内存碎片保留空间。
排障清单
- 确认实例承载的是纯缓存、持久数据还是混合数据,并据此核对策略。
- 比较
evicted_keys增量与延迟、缓存命中率、OOM 错误是否在同一时间上升。 - 使用
volatile-*时确认业务确实为足够多的可淘汰键设置了 TTL。 - 淘汰持续过快时,优先处理大 Key、无效缓存、TTL 缺失和容量不足,而不是只调整策略。
- 策略正确但热点键频繁丢失时,考虑改用 LFU、拆分实例或为关键数据建立独立存储。
识别占用内存过高或操作耗时过长的键及其数据类型。
查找 Redis 大 Key
用于定位占用内存过高、元素数量过多或读取时返回数据量过大的键。生产环境建议先用 --bigkeys 低速扫描候选键,再针对少量候选执行 MEMORY USAGE 和类型长度命令,避免逐键获取完整内容。
安全初筛
--bigkeys 基于 SCAN 遍历当前数据库,不会像 KEYS * 一次性阻塞整个键空间。-i 0.01 会在扫描过程中主动放慢速度,繁忙实例可提高间隔或改在只读副本执行。
redis-cli -i 0.01 --bigkeys预期输出示例:
[00.00%] Biggest string found so far 'cache:homepage' with 8388608 bytes
[73.42%] Biggest list found so far 'queue:email' with 182340 items
-------- summary -------
Sampled 10000 keys in the keyspace!
输出中的键名、进度和数量会随数据变化。字符串按内容字节数比较,列表、哈希、集合、有序集合和 Stream 通常按元素数量比较,因此它只能筛选候选键,不能直接代表真实内存占用。
精确确认候选键
对候选键先查看类型,再读取内存估算和对应的长度。SAMPLES 5 只抽样部分嵌套元素,在准确度和执行成本之间取得折中。
key='cache:homepage'
redis-cli --raw TYPE "$key"
redis-cli --raw MEMORY USAGE "$key" SAMPLES 5
redis-cli --raw STRLEN "$key"
预期输出示例:
string
8404992
8388608
MEMORY USAGE 返回字节数,包含键、值以及 Redis 内部结构的开销,因此通常不小于 STRLEN。实际键名和数值会不同。不同类型应使用只返回长度、不返回完整内容的命令:
| 类型 | 长度命令 | 读取重点 |
|---|---|---|
| string | STRLEN <KEY> |
字符串内容字节数 |
| hash | HLEN <KEY> |
字段数量 |
| list | LLEN <KEY> |
列表元素数量 |
| set | SCARD <KEY> |
集合成员数量 |
| zset | ZCARD <KEY> |
有序集合成员数量 |
| stream | XLEN <KEY> |
Stream 条目数量 |
判断是否需要治理
大 Key 没有统一字节阈值,应结合网络带宽、命令延迟、持久化耗时、复制积压和业务超时判断。元素数量不多但单个元素很大时,集合长度可能正常而内存仍然很高;元素很多但值很小时,也可能因内部索引和对象开销占用大量内存。
操作耗时还取决于所执行的命令。HGETALL、SMEMBERS、LRANGE 0 -1、大范围 ZRANGE 等命令会一次返回完整集合,可能导致 Redis 主线程执行时间增长、网络突发和客户端内存上涨。排查时优先使用长度命令和小范围分页读取。
风险与安全替代
不要在生产主节点执行 KEYS *,键数量较多时会长时间占用 Redis 主线程。安全替代方案是使用 --bigkeys、--scan 或业务维护的键索引,并通过 -i、低峰执行或只读副本降低扫描影响。
--bigkeys 虽然采用渐进扫描,但完整遍历的总工作量仍与键数量相关,可能增加 CPU、网络和延迟。扫描期间键持续变化时,结果也不是严格一致的快照,必要时应重复取样确认。
不要对大 Key 直接执行同步 DEL 或读取完整值进行备份,触发条件是键内元素或内容非常大,后果可能是主线程出现明显停顿。删除前先确认业务归属和恢复方案,优先采用 UNLINK、分批裁剪或业务侧渐进迁移;使用 UNLINK 时仍需观察后台释放队列和实例内存。
MEMORY USAGE <KEY> SAMPLES 0 会检查全部嵌套元素,面对超大集合可能显著增加执行时间。生产排查先使用有限样本,只有在副本或维护窗口中才考虑全量统计。
排障清单
- 独立实例存在多个数据库时,用
-n <DB>逐库扫描,确认没有检查错数据库。 - Redis Cluster 需要分别连接每个主节点扫描;连接任一节点不会自动汇总整个集群的大 Key。
- 找到候选键后同时记录
TYPE、MEMORY USAGE、长度、TTL、访问命令和业务负责人。 - 未发现单个大 Key但内存仍高时,继续检查大量小 Key、内存碎片、客户端缓冲区、复制缓冲区和持久化开销。
- 治理时优先采用拆分集合、限制单键元素数、分页访问、合理 TTL 和异步清理,并在变更后重新测量延迟与内存。
发现访问频率异常集中的键,判断是否造成单线程负载瓶颈。
定位热 Key
用于确认少数键是否承受了远高于其他键的访问频率。优先使用 redis-cli --hotkeys 读取 LFU 访问计数;该结果适合做相对排序,不能直接当作每秒请求数。
前置检查
--hotkeys 仅在 maxmemory-policy 为 allkeys-lfu 或 volatile-lfu 时有效。先读取当前策略,不要为了临时排障直接修改生产配置。
export REDISCLI_AUTH='<PASSWORD>'
redis-cli -h <HOST> -p <PORT> --raw CONFIG GET maxmemory-policy
预期输出:
maxmemory-policy
allkeys-lfu
若返回其他策略,优先使用代理层、应用埋点或已有监控按键名统计流量。临时切换 LFU 会改变内存不足时的淘汰选择,而且刚切换后的计数还不足以代表稳定访问分布。
扫描热 Key
下面只扫描 product:* 命名空间,并在每 100 轮扫描后暂停 0.1 秒,适合先缩小范围再逐步扩大。
export REDISCLI_AUTH='<PASSWORD>'
redis-cli -h <HOST> -p <PORT> -n 0 \
  --hotkeys \
  --pattern 'product:*' \
  --count 1000 \
  -i 0.1
预期输出:
# Scanning the entire keyspace to find hot keys as well as
# average sizes per key type.  You can use -i 0.1 to sleep 0.1 sec
# per 100 SCAN commands (not usually needed).

-------- summary -------

hot key found with counter: <LFU_COUNTER>    keyname: "product:detail:42"
hot key found with counter: <LFU_COUNTER>    keyname: "product:stock:42"
counter 是经过衰减的 LFU 频率计数,数值越大表示近期相对更热。应在同一次扫描、同一实例内比较,不能把计数直接解释为 QPS;实际键名和计数会随流量变化。
复核与处置
对候选键使用 OBJECT FREQ 复核当前计数,并结合应用侧调用来源确认是否确为业务热点。
export REDISCLI_AUTH='<PASSWORD>'
redis-cli -h <HOST> -p <PORT> --raw OBJECT FREQ 'product:detail:42'
预期输出:
<LFU_COUNTER>确认热 Key 后,常见处理顺序是:为可容忍短暂陈旧的数据增加进程内缓存;合并并发回源请求;把单个大对象拆为可独立访问的键;使用带散列后缀的多副本键分摊读取。拆分前必须确认原子性、一致性和失效广播要求。
风险与边界
--hotkeys 基于增量扫描,不会像 KEYS * 一次阻塞整个键空间,但在数千万键实例上仍会增加 CPU、网络和命令处理量。生产环境应限定 --pattern、使用 -i 节流,并在延迟升高时立即中止。
Redis Cluster 中一次扫描只覆盖当前连接的节点;应对每个主节点分别执行。多 DB 实例还要逐个指定 -n。不要使用长时间 MONITOR 代替常规监控,它会复制全部命令流并显著放大服务端与客户端开销。
分析过期键数量、过期回收速度和集中失效带来的性能影响。
检查过期键堆积
用于判断大量带 TTL 的键是否集中失效,以及主动过期回收是否持续触达时间上限。先看键空间结构,再用两次采样计算增量,避免把自启动以来的累计值误判为当前故障。
快速查看过期状态
export REDISCLI_AUTH='<PASSWORD>'
redis-cli -h <HOST> -p <PORT> --raw INFO keyspace
redis-cli -h <HOST> -p <PORT> --raw INFO stats |
  grep -E '^(expired_keys|expired_stale_perc|expired_time_cap_reached_count|expire_cycle_cpu_milliseconds):'
预期输出:
# Keyspace
db0:keys=<KEYS>,expires=<EXPIRES>,avg_ttl=<AVG_TTL_MS>
expired_keys:<TOTAL_EXPIRED>
expired_stale_perc:<STALE_PERCENT>
expired_time_cap_reached_count:<TIME_CAP_COUNT>
expire_cycle_cpu_milliseconds:<EXPIRE_CPU_MS>
expires 是当前设置了 TTL 的键数,不等于已经过期但尚未释放的键数。expired_keys、expired_time_cap_reached_count 和 expire_cycle_cpu_milliseconds 都是累计值,必须观察一段时间内的增量;avg_ttl 为毫秒级平均剩余 TTL。
计算 10 秒回收速率
export HOST='<HOST>' PORT='<PORT>' REDISCLI_AUTH='<PASSWORD>'

read_expire_stats() {
  redis-cli -h "$HOST" -p "$PORT" --raw INFO stats |
    awk -F: '
      /^(expired_keys|expired_time_cap_reached_count|expire_cycle_cpu_milliseconds):/ {
        gsub("\r", "", $2)
        value[$1] = $2
      }
      END {
        printf "%s %s %s\n",
          value["expired_keys"],
          value["expired_time_cap_reached_count"],
          value["expire_cycle_cpu_milliseconds"]
      }'
}

read -r expired1 cap1 cpu1 <<< "$(read_expire_stats)"
sleep 10
read -r expired2 cap2 cpu2 <<< "$(read_expire_stats)"

printf 'expired_per_sec=%d time_cap_delta=%d expire_cpu_ms_delta=%d\n' \
  "$(((expired2 - expired1) / 10))" \
  "$((cap2 - cap1))" \
  "$((cpu2 - cpu1))"
预期输出:
expired_per_sec=<RATE> time_cap_delta=<COUNT> expire_cpu_ms_delta=<MS>expired_per_sec 突然升高说明当前有大量键被回收;time_cap_delta 持续增长且与延迟尖峰同时出现,说明主动过期循环频繁提前停止;expire_cpu_ms_delta 可用于判断回收任务在采样窗口内消耗的 CPU 时间。
抽样检查 TTL 是否集中
下面最多抽样 500 个键,将正 TTL 按 5 分钟分桶。它会为每个样本额外发送一次 PTTL,只用于小样本验证。
export HOST='<HOST>' PORT='<PORT>' REDISCLI_AUTH='<PASSWORD>' SAMPLE=500

redis-cli -h "$HOST" -p "$PORT" --scan --count 1000 |
  head -n "$SAMPLE" |
  while IFS= read -r key; do
    ttl=$(redis-cli -h "$HOST" -p "$PORT" --raw PTTL "$key")
    if [ "$ttl" -gt 0 ]; then
      printf '%s\n' "$ttl"
    fi
  done |
  awk '{
    minute = int($1 / 60000)
    bucket = int(minute / 5) * 5
    count[bucket]++
  }
  END {
    for (bucket in count) {
      printf "%d-%d min    %d\n", bucket, bucket + 4, count[bucket]
    }
  }' |
  sort -n
预期输出:
0-4 min    <COUNT>
5-9 min    <COUNT>
10-14 min    <COUNT>
单个桶明显聚集,尤其是大量键落在同一分钟附近,通常意味着写入端使用了相同 TTL 或相同绝对过期时间。应在业务允许范围内为新写入 TTL 增加随机抖动,而不是在故障期间批量改写全部键。
风险与边界
不要在生产大库使用 KEYS * 后逐键执行 TTL,这会阻塞或制造命令风暴。抽样脚本也不适合包含换行或二进制字节的键名;此类键应通过客户端程序按 RESP 协议抽样。
调高 hz 或 active-expire-effort 会加快回收,但也会增加 CPU 使用和延迟波动。应先确认指标增量,再小步调整并持续观察。键删除后 RSS 未必立即下降,判断回收效果应同时看 used_memory、延迟和过期速率。
Redis Cluster 的 INFO 与 SCAN 都是节点级视角,应逐个主节点检查。较旧版本可能缺少部分过期统计字段,缺失字段不能按零处理。
通过延迟监控区分命令执行、事件循环和外部环境抖动。
分析 Redis 命令延迟
用于 P99 抖动、客户端偶发超时或 Redis 响应突然升高时,按“端到端往返、Redis 内部事件、主机调度基线”三层取证,区分慢命令与事件循环阻塞、宿主机抖动、网络或客户端等待。
命令定位
| 观测层 | 命令 | 结论范围 |
|---|---|---|
| 客户端到 Redis 往返 | redis-cli --latency |
客户端调度、网络、Redis 响应的总和 |
| Redis 内部事件 | LATENCY LATEST、HISTORY、DOCTOR |
命令、fork、AOF、过期和淘汰等阻塞 |
| Redis 主机基线 | redis-cli --intrinsic-latency <SECONDS> |
内核、虚拟化和邻居负载造成的调度抖动 |
先在业务主机运行 --latency,再在 Redis 主机重复。只有远端高而本机低时,优先查网络、代理和连接池;两处都高时继续查内部事件与主机基线。
读取内部延迟事件
latency-monitor-threshold 单位为毫秒,0 表示关闭。下面临时捕获超过 10 ms 的事件,并在采集后恢复原值。
OLD_THRESHOLD=$(redis-cli --raw CONFIG GET latency-monitor-threshold | tail -n 1)
redis-cli CONFIG SET latency-monitor-threshold 10
redis-cli --no-raw LATENCY LATEST
redis-cli LATENCY DOCTOR
redis-cli CONFIG SET latency-monitor-threshold "$OLD_THRESHOLD"
预期输出(已有一次 command 事件时):
OK
1) 1) "command"
   2) (integer) <UNIX_TIME>
   3) (integer) 12
   4) (integer) 58
<DOCTOR_REPORT>
OK
四个字段依次是事件名、最近时间、最近延迟毫秒数和历史最大毫秒数。需要确认是否连续发生时执行 LATENCY HISTORY command;事件名为 fork、aof-write、expire-cycle 或 eviction-cycle 时,应对齐对应子系统指标。
测量往返与主机基线
第一条在业务主机执行;第二条必须在 Redis 主机执行,它不连接 Redis,测试期间会持续占用一个 CPU 核。
redis-cli -h 127.0.0.1 -p 6379 --latency
redis-cli --intrinsic-latency 30
预期输出:
min: 0, max: 4, avg: 0.20 (3000 samples)
Max latency so far: <MAX_US> microseconds.
<TOTAL_RUNS> total runs (avg latency: <AVG_US> microseconds / <AVG_NS> nanoseconds per run).
Worst run took <RATIO>x longer than the average latency.
--latency 单位为毫秒,重点看 max 是否与告警时间重合。若内部事件正常但 intrinsic 最大值已接近业务 P99,优先处理 CPU steal、宿主机争用、容器限额或 NUMA;若 Redis 本机往返低、业务主机往返高,则查跨区、重传、代理和连接等待。
风险与边界
阈值过低会产生大量样本并掩盖真正尖峰,建议按业务 SLO 短时采集。不要在导出前执行 LATENCY RESET,否则历史和最大值会被清空;安全替代是先保存 LATEST、HISTORY 和 DOCTOR。--intrinsic-latency 容量紧张时只运行 10~30 秒并避开高峰。
--latency 只用 PING 测往返,不代表具体业务命令;内部监控也只记录超过阈值的事件。两者正常而业务仍慢时,应继续检查客户端 GC、连接池排队、网络重传和代理延迟。
兼容性
LATENCY 监控适用于支持该命令的 Redis Open Source 版本,LATENCY HISTOGRAM 需要 Redis 7.0 及以上。托管服务可能限制 CONFIG SET、管理员 ACL 或部分子命令,出现 NOPERM 时应改用平台监控或申请临时最小权限。
使用慢日志定位高耗时命令、异常参数和调用来源。
查看 Redis 慢查询
用于 Redis CPU 升高、单线程阻塞或业务请求偶发变慢时,从慢日志定位高耗时命令、异常参数规模和调用来源。慢日志只计算 Redis 执行命令的时间,不包含网络收发,因此没有记录也不能排除端到端延迟。
命令定位
SLOWLOG LEN 查看记录数,SLOWLOG GET <COUNT> 读取最近记录,SLOWLOG RESET 清空记录。slowlog-log-slower-than 是微秒阈值,slowlog-max-len 是环形队列容量;容量满后新记录会淘汰最旧记录。
主示例
先读取阈值和容量,再取最近两条。生产环境使用较小的 COUNT,避免一次返回过多参数。
redis-cli --no-raw CONFIG GET slowlog-log-slower-than
redis-cli --no-raw CONFIG GET slowlog-max-len
redis-cli SLOWLOG LEN
redis-cli --no-raw SLOWLOG GET 2
预期输出(动态值使用占位符):
1) "slowlog-log-slower-than"
2) "10000"
1) "slowlog-max-len"
2) "128"
(integer) 1
1) 1) (integer) <ID>
   2) (integer) <UNIX_TIME>
   3) (integer) 15342
   4) 1) "MGET"
      2) "user:1"
      3) "user:2"
   5) "10.0.2.15:<PORT>"
   6) "api-cache"
   7) (integer) 3
10000 表示超过 10 ms 才记录;15342 微秒约为 15.342 ms。旧版本通常只有前六个字段,Redis 8.10 及以上还可能返回第七个原始参数总数。
输出字段说明
| 位置 | 含义 | 读取方法 |
|---|---|---|
| 1 | 递增 ID | 保存上次最大 ID,避免重复采集 |
| 2 | Unix 秒级时间 | 对齐应用日志、CPU 和延迟告警 |
| 3 | 执行耗时,微秒 | 除以 1000 转成毫秒 |
| 4 | 命令及参数 | 检查 key 数量、范围和批量大小 |
| 5 | 客户端 IP 与端口 | 定位来源主机或代理 |
| 6 | 客户端名称 | 通过 CLIENT SETNAME 标记服务 |
| 7 | 原始参数总数 | 新版本用于识别参数被截断的批量命令 |
若客户端名称为空,应在连接建立后设置稳定服务名。参数可能因长度或数量限制被截断,不能把日志中显示的参数数目直接当作原始命令规模。
高频用法
事故现场先看 SLOWLOG LEN。若长度长期贴近上限,说明旧记录正在被覆盖,应立即以 SLOWLOG GET 20 小批量采集,并按“耗时、参数规模、客户端来源”归类。需要建立新观察窗口时,先导出当前记录并记下最大 ID,再执行 SLOWLOG RESET。
排查时重点找重复出现的高耗时命令,而不是只看单条最大值。相同命令耗时随参数量或 key 大小上升,通常指向大 key、超大范围或高复杂度访问;只集中在某个客户端,则优先定位该服务的调用路径。
风险与边界
将阈值设为 0 会记录所有命令,可能导致快速覆盖、额外开销和 key 或参数暴露;安全替代是按业务 SLO 临时设置 5~20 ms,并记录原值后恢复。设为 -1 会关闭慢日志,故障期间可能丢失证据。
SLOWLOG GET -1 可能返回大响应,安全替代是每次读取 10~50 条并定期采集。SLOWLOG RESET 不可恢复,执行前必须导出。业务慢但慢日志为空时,应结合 LATENCY LATEST、客户端耗时、连接池和网络指标继续判断。
兼容性
SLOWLOG GET、LEN 和 RESET 在常见 Redis Open Source 版本中可用,但返回字段会随版本演进。托管服务可能隐藏客户端字段、限制配置范围或禁止脚本调用,解析程序应按字段数量兼容处理。
排查大范围扫描、集合运算、脚本和阻塞式命令造成的卡顿。
定位阻塞命令
用于 Redis 突然卡顿、请求超时或单核 CPU 飙高时,先从 SLOWLOG 找到实际占用事件循环的命令,再用 INFO commandstats、CLIENT LIST 和短时采样确认来源。重点排查全量扫描、大集合返回、集合运算、排序以及耗时脚本;不要把 BLPOP、XREAD BLOCK 这类“阻塞客户端”的命令直接等同于“阻塞 Redis 服务端”。
快速定位
先读取慢日志、命令累计耗时和正在等待的客户端。密码通过 REDISCLI_AUTH 传递,避免出现在进程参数中;使用默认用户或 Redis 6 以前版本时删除 --user '<USER>'。
export REDISCLI_AUTH='<PASSWORD>'
REDIS=(redis-cli -h '<HOST>' -p '<PORT>' --user '<USER>')

# 慢日志给出命令执行耗时;commandstats 用于判断长期热点。
"${REDIS[@]}" SLOWLOG GET 5
"${REDIS[@]}" INFO commandstats
"${REDIS[@]}" INFO clients | grep '^blocked_clients:'

# 仅提取正在等待阻塞式操作的普通客户端。
"${REDIS[@]}" --raw CLIENT LIST | awk '
{
  id=addr=flags=cmd=""
  for (i=1; i<=NF; i++) {
    split($i, f, "=")
    if (f[1]=="id") id=f[2]
    else if (f[1]=="addr") addr=f[2]
    else if (f[1]=="flags") flags=f[2]
    else if (f[1]=="cmd") cmd=f[2]
  }
  if (flags ~ /b/) printf "id=%s addr=%s flags=%s cmd=%s\n", id, addr, flags, cmd
}'
预期输出
1) 1) (integer) <ID>
   2) (integer) <TIME>
   3) (integer) 185432
   4) 1) "EVALSHA"
      2) "<SHA1>"
      3) "1"
      4) "orders"
   5) "10.0.0.12:53428"
   6) "api-01"
# Commandstats
cmdstat_evalsha:calls=120,usec=850000,usec_per_call=7083.33,rejected_calls=0,failed_calls=0
# Clients
blocked_clients:37
id=<ID> addr=10.0.0.21:55120 flags=b cmd=xread
SLOWLOG 第 3 项是微秒耗时,185432 表示约 185 毫秒;第 4 项是命令及参数,后两项通常是客户端地址和名称。usec_per_call 高且调用量大,说明该命令可能持续占用主线程。blocked_clients 和 flags=b 只表示客户端正在等待数据,通常不会让服务器停止处理其他请求。
高频判断
优先关注 KEYS、超大 SMEMBERS、HGETALL、LRANGE 0 -1、ZRANGE 全量返回、SUNION、SINTER、SDIFF、SORT、EVAL 和 EVALSHA。渐进式扫描也不是绝对安全:SCAN 的单次 COUNT 过大、集合极大或脚本内部循环无上限,仍会形成明显延迟尖峰。
| 现象 | 判断依据 | 安全替代 |
|---|---|---|
| 全库或全集合读取 | 慢日志参数范围过大,返回元素数量异常 | 使用 SCAN、SSCAN、HSCAN、ZSCAN,限制单批数量 |
| 集合交并差或排序耗时 | usec_per_call 高,命令随集合规模变慢 |
离线预计算、分片处理或在低峰执行 |
| Lua/函数长时间运行 | 慢日志出现 EVALSHA,CPU 同步升高 |
限制遍历规模,拆分脚本并设置业务超时 |
| 大量阻塞客户端 | blocked_clients 高、flags=b |
检查连接池容量、阻塞超时和消费者是否存活 |
慢日志为空时,先检查阈值:CONFIG GET slowlog-log-slower-than 返回单位为微秒,负值表示关闭记录,0 表示记录所有命令。调整阈值前先保存原值,故障窗口结束后恢复,避免低阈值长期产生大量记录。
最后手段:短时采样
只有慢日志和应用链路都无法定位时,才短时间运行 MONITOR。下面示例在 Linux 上采样 5 秒并只保留高风险命令;timeout 到时退出属于预期行为。
export REDISCLI_AUTH='<PASSWORD>'
timeout 5s redis-cli -h '<HOST>' -p '<PORT>' --user '<USER>' MONITOR |
  grep -Ei '"(keys|smembers|hgetall|lrange|zrange|sunion|sinter|sdiff|sort|eval|evalsha)"'
预期输出
<TIME> [0 10.0.0.12:53428] "EVALSHA" "<SHA1>" "1" "orders"
<TIME> [0 10.0.0.18:41762] "HGETALL" "session:<ID>"
输出中的时间、数据库编号、客户端地址和参数以现场为准。命中后应回到应用日志或客户端名称确认调用方,不要仅凭命令名称直接终止连接。
风险与边界
SLOWLOG 只统计服务器执行命令的时间,不包含向客户端发送回复的网络耗时,因此慢客户端、拥塞和输出缓冲区堆积可能不会被它直接识别。MONITOR 会复制并推送几乎所有命令,在高 QPS 实例上可能明显降低吞吐,也可能暴露业务参数;安全替代是先使用慢日志、命令统计和应用追踪,确需采样时限定秒级窗口并避免保存原始数据。
不要在取证前执行 SLOWLOG RESET,否则会删除关键证据。发现危险命令后,先限制返回规模、拆分批次或下线调用入口;只有确认客户端可安全重试时,才考虑按 CLIENT ID 精确断开连接。
排障清单
- 将慢日志时间戳与应用 P99、CPU 和故障时间窗口对齐。
- 根据命令参数定位键,再用
TYPE、HLEN、SCARD、ZCARD、LLEN或XLEN判断规模,避免再次全量读取。 - 区分“命令占用主线程”和“客户端等待阻塞操作”,不要误杀正常队列消费者。
- 修复后确认新增慢日志消失、
usec_per_call不再快速增长,业务延迟恢复。
兼容性
SLOWLOG 可用于较老版本,但旧版本可能不返回客户端地址和名称。CLIENT LIST TYPE 从 Redis 5.0 起可用,ACL 的 --user 用法需要 Redis 6.0 及以上。不同版本会增加 CLIENT LIST 字段,解析脚本应忽略未知字段并允许字段缺失。
检查普通客户端、订阅客户端和副本的输出缓冲区限制。
排查缓冲区溢出
用于 Redis 内存突然上涨、Pub/Sub 订阅者频繁断线、副本连接重置或日志出现 output buffer limit 时,检查三类客户端的输出缓冲区限制和当前 omem。核心是找出“服务端产生回复快于客户端读取”的连接,而不是直接把限制调大。
查看限制与占用
client-output-buffer-limit 按 normal、pubsub、replica 分类,每类依次为硬限制、软限制和软限制持续秒数,字节值为 0 表示对应限制关闭。下面同时读取全局配置、近期峰值、客户端内存和单连接排行。
export REDISCLI_AUTH='<PASSWORD>'
REDIS=(redis-cli -h '<HOST>' -p '<PORT>' --user '<USER>')

"${REDIS[@]}" CONFIG GET client-output-buffer-limit
"${REDIS[@]}" INFO clients |
  grep -E '^(connected_clients|client_recent_max_output_buffer):'
"${REDIS[@]}" INFO memory |
  grep -E '^(mem_clients_normal|mem_clients_slaves|mem_total_replication_buffers):'

# 按单连接输出缓冲区内存 omem 从大到小排列。
"${REDIS[@]}" --raw CLIENT LIST | awk '
{
  id=addr=flags=cmd=""; omem=0
  for (i=1; i<=NF; i++) {
    split($i, f, "=")
    if (f[1]=="id") id=f[2]
    else if (f[1]=="addr") addr=f[2]
    else if (f[1]=="flags") flags=f[2]
    else if (f[1]=="cmd") cmd=f[2]
    else if (f[1]=="omem") omem=f[2]
  }
  printf "%s id=%s addr=%s flags=%s cmd=%s\n", omem, id, addr, flags, cmd
}' | sort -nr | head -n 10
预期输出
1) "client-output-buffer-limit"
2) "normal 0 0 0 replica 268435456 67108864 60 pubsub 33554432 8388608 60"
connected_clients:420
client_recent_max_output_buffer:73400320
mem_clients_normal:18874368
mem_clients_slaves:0
mem_total_replication_buffers:75497472
73400320 id=<ID> addr=10.0.0.8:53012 flags=P cmd=subscribe
68157440 id=<ID> addr=10.0.0.9:6379 flags=S cmd=replconf
10485760 id=<ID> addr=10.0.0.10:49152 flags=N cmd=hgetall
配置数值和字段顺序以现场为准。示例中的 Pub/Sub 限制为硬上限 32 MiB、软上限 8 MiB 持续 60 秒;副本为 256 MiB、64 MiB 持续 60 秒;普通客户端示例未设置限制。排行第一列是 omem 字节数,P 表示 Pub/Sub,S 表示副本连接,N 表示普通客户端。
输出字段说明
obl 是固定输出缓冲区当前长度,oll 是固定缓冲区放不下后排队的回复列表长度,omem 是该客户端输出缓冲区占用内存,排查时优先按它排序。tot-mem 还包含输入缓冲区等连接开销;events 含 w 通常表示连接有待发送数据;cmd 是最近执行的命令,不一定是缓冲区增长的唯一来源。
client_recent_max_output_buffer 只能说明当前连接中的近期最大值,不能替代单连接定位。Redis 7.0 起副本缓冲区与复制积压缓冲区存在共享,mem_clients_slaves 可能为 0,此时应同时观察 mem_total_replication_buffers、复制延迟和 CLIENT LIST TYPE REPLICA。
查找已被断开的连接
连接超过硬限制会尽快关闭;连续超过软限制达到指定秒数也会关闭。客户端已经消失时,从 Redis 日志确认触发记录,systemd 服务名按实际环境替换。
journalctl -u '<REDIS_SERVICE>' --since '-30 min' |
  grep -Ei 'output buffer|scheduled to be closed' |
  tail -n 20
预期输出
<TIME> <HOSTNAME> redis-server[<PID>]: Client id=<ID> addr=10.0.0.8:53012 ... scheduled to be closed ASAP for overcoming of output buffer limits.日志格式会随 Redis 版本和发行版变化,但通常包含客户端 ID、地址、缓冲区信息和超过限制的原因。用 ID 或地址回查应用实例、订阅者名称或副本节点。
高频原因与处理
普通客户端常见于 HGETALL、SMEMBERS、超大范围查询或流水线一次提交过多,客户端读取慢时会持续积压。改为分页或增量扫描,限制单次返回量,并检查连接池是否及时消费响应。
Pub/Sub 客户端通常因消费者停顿、长时间 GC、网络抖动或消息突发而积压。先修复接收循环和下游处理速度;订阅连接断开后,断线期间的消息不会自动补发,需要可靠消费时改用 Redis Streams 等可持久化方案。
副本缓冲区上涨通常伴随网络带宽不足、链路抖动或副本处理落后。先检查复制延迟、网络和全量同步频率;仅提高限制可能把断线延后,却增加主节点内存压力。
风险与边界
直接提高硬限制或关闭限制,会让慢消费者持续占用内存,最终可能触发键淘汰、OOM 或进程被系统终止。直接降低限制则可能立即断开大缓冲连接,导致 Pub/Sub 消息丢失、副本重连甚至全量同步。安全做法是先定位客户端并修复消费能力,再在压测数据基础上分级调整,保留足够但有界的峰值空间。
CONFIG SET 的运行时修改不一定持久化;自建实例还需修改配置文件或评估 CONFIG REWRITE,托管服务应使用控制台参数组。执行 CLIENT KILL 前必须确认连接类型和可重试性,不要批量终止副本或订阅连接。
排障清单
- 对照配置上限、单连接
omem、客户端总内存和关闭日志,确认是否真正触发溢出。 - 按
flags分类:普通客户端查大回复和读取速度,Pub/Sub 查消费停顿,副本查网络与复制延迟。 - 修复后连续观察
omem是否回落、断线日志是否停止、Redis 内存是否恢复稳定。 - Redis 7.0 及以上可评估
maxmemory-clients作为普通客户端总内存保护,但它不能替代每类输出缓冲区限制,也不用于驱逐主从复制连接。
兼容性
旧版配置和日志可能使用 slave 表示副本,新版通常使用 replica;INFO memory 的 mem_total_replication_buffers 从 Redis 7.0 起提供。CLIENT LIST 字段会随版本增加,生产脚本应按键名解析,不应依赖固定字段顺序。
结合命令统计、系统指标和热点调用定位 CPU 使用率过高。
检查 Redis CPU 异常
当 Redis 所在主机 CPU 持续升高、单核接近打满或响应延迟同步抬升时,用本条先确认 CPU 消耗来自 Redis 服务进程、持久化子进程还是宿主机其他任务,再定位高频或高耗时命令。INFO cpu 返回累计 CPU 秒数,不是即时百分比,必须结合时间差读取。
快速采样
在可连接 Redis 的主机执行。示例用 5 秒窗口计算 Redis 服务进程消耗的“单核百分比”,并按累计执行时间列出命令统计前十项。密码通过 REDISCLI_AUTH 传入,避免直接出现在命令参数中;无 ACL 用户时删除 --user <USER>。
export REDISCLI_AUTH='<PASSWORD>'
REDIS=(redis-cli -h <HOST> -p <PORT> --user <USER> --no-auth-warning)

cpu_seconds() {
  "${REDIS[@]}" --raw INFO cpu |
    awk -F: '
      /^used_cpu_sys:/  {gsub("\r", "", $2); sys=$2}
      /^used_cpu_user:/ {gsub("\r", "", $2); usr=$2}
      END {printf "%.6f\n", sys + usr}'
}

c1=$(cpu_seconds)
sleep 5
c2=$(cpu_seconds)
awk -v a="$c1" -v b="$c2" 'BEGIN {printf "Redis process CPU over 5s: %.1f%% of one core\n", (b-a)/5*100}'

echo "Top commands by cumulative CPU usec:"
"${REDIS[@]}" --raw INFO commandstats |
  awk -F'[:,=]' '/^cmdstat_/ {
    printf "%12d %-24s calls=%s avg_us=%s\n", $5, substr($1, 9), $3, $7
  }' |
  sort -nr | head -10

echo "Recent slowlog entries:"
"${REDIS[@]}" SLOWLOG GET 5
unset REDISCLI_AUTH
预期输出示例:
Redis process CPU over 5s: 96.4% of one core
Top commands by cumulative CPU usec:
      982340 evalsha                  calls=83 avg_us=11835.42
      421700 zrange                   calls=3012 avg_us=140.01
       81200 get                      calls=81200 avg_us=1.00
Recent slowlog entries:
1) 1) (integer) 142
   2) (integer) <UNIX_TIME>
   3) (integer) 11835
   4) 1) "EVALSHA"
      2) "<SHA1>"
      3) "1"
      4) "hot:key"
   5) "10.0.0.21:53144"
   6) "api-1"
96.4% 表示采样窗口内 Redis 服务进程接近占满一个逻辑 CPU;若结果超过 100%,通常是后台线程也在消耗 CPU。commandstats 的 calls、usec、usec_per_call 都是启动后的累计值,只能用于初筛,当前热点应比较两个时间点的增量,并用慢日志确认。慢日志中的耗时只统计命令在服务端执行的时间,不含网络收发。
宿主机交叉验证
必须在 Redis 所在宿主机且处于相同 PID 命名空间内执行。它用于区分主线程打满、其他 Redis 线程消耗,以及节点上存在无关高 CPU 进程。
export REDISCLI_AUTH='<PASSWORD>'
PID=$(redis-cli -h <HOST> -p <PORT> --user <USER> --raw INFO server |
  awk -F: '/^process_id:/ {gsub("\r", "", $2); print $2}')

ps -L -p "$PID" -o pid,tid,psr,pcpu,stat,comm --sort=-pcpu | head
ps -eo pid,ppid,pcpu,pmem,stat,comm --sort=-pcpu | head
unset REDISCLI_AUTH
预期输出示例:
    PID     TID PSR %CPU STAT COMMAND
  <PID>   <TID>   3 99.1 Sl   redis-server
  <PID>   <TID>   1  3.2 Sl   redis-server

    PID    PPID %CPU %MEM STAT COMMAND
  <PID>       1 99.8 18.4 Ssl  redis-server
  <ID>     <ID> 12.1  2.0 Sl   <OTHER_PROCESS>
主线程接近一个核心且持久化子进程不活跃,优先排查命令执行;Redis CPU 不高而宿主机总 CPU 高,优先处理其他进程、虚拟机争抢或容器 CPU 限额。容器环境应改用 docker stats、kubectl top 和对应 cgroup 指标,不能直接把宿主机百分比当作容器可用配额。
定位高耗调用
calls 增长快但 usec_per_call 很低,通常是请求量或命令解析开销过高;优先合并为 MGET、MSET 等批量命令,减少无效轮询,并检查客户端是否发生重试风暴。仅增加连接数或流水线不能消除服务端实际计算量。
usec_per_call 高、慢日志持续出现同一命令时,检查大集合操作、全量扫描、Lua/Function 脚本、模块查询和热点大键。生产环境不要用 KEYS * 复现问题,改用带合理 COUNT 的 SCAN,并限制单次返回元素数或拆分大键。
CPU 与命令统计不匹配时,再看 INFO stats 中的过期、淘汰和事件循环指标,以及 INFO memory 的主动碎片整理状态。若 rdb_bgsave_in_progress 或 aof_rewrite_in_progress 为 1,同时出现子进程 CPU,转入 fork 与写时复制排查。
风险与边界
MONITOR 会持续复制全部命令流,触发条件是在线执行该命令;后果可能是额外 CPU、网络输出和敏感参数泄露。安全替代方案是先用 INFO commandstats、SLOWLOG GET 和延迟监控,必要时只在隔离副本短时采样。
CONFIG RESETSTAT 会清空命令统计和其他累计基线,事故中执行会丢失证据;替代方案是在外部保存两次快照后计算增量。redis-cli --intrinsic-latency 会主动占满一个 CPU 核,只有在 Redis 宿主机、低峰期和明确变更窗口内运行。
慢日志可能包含键名、脚本参数或业务数据,采集后应按权限保存并脱敏。Redis Cluster 必须逐个分片和主节点检查,集群聚合 CPU 正常并不能排除单一热点分片。
排障清单
- 对齐应用延迟、Redis 进程 CPU 与宿主机 CPU 的同一时间窗口。
- 区分主线程、后台线程、持久化子进程和其他系统进程。
- 用命令统计增量锁定高频或高耗命令,再用慢日志和大键证据确认。
- 修复后重复相同 5 秒采样,并确认 CPU、慢日志新增量和尾延迟同时下降。
速查结论:先判断“谁在耗 CPU”,再判断“哪类命令或后台任务在耗 CPU”,不要仅凭一次累计统计直接下结论。
分析后台保存或重写期间 fork 延迟及写时复制内存压力。
排查 Redis fork 耗时
当 BGSAVE、BGREWRITEAOF、副本全量同步或模块后台任务期间出现延迟尖峰、内存突增甚至 OOM 时,用本条区分 fork 本身的主线程停顿、后台持久化耗时和写时复制内存压力。核心证据是 latest_fork_usec、持久化状态、CoW 指标以及同时间窗口的系统内存与交换活动。
先看 fork 与持久化状态
以下命令只读取现状。延迟历史只有在 latency-monitor-threshold 大于 0,且 fork 耗时超过阈值时才会记录;阈值单位为毫秒。
export REDISCLI_AUTH='<PASSWORD>'
REDIS=(redis-cli -h <HOST> -p <PORT> --user <USER> --no-auth-warning)

"${REDIS[@]}" --raw INFO stats |
  grep -E '^(latest_fork_usec|total_forks):'

"${REDIS[@]}" --raw INFO persistence |
  grep -E '^(current_cow_peak|current_cow_size|rdb_bgsave_in_progress|rdb_last_bgsave_time_sec|rdb_last_cow_size|aof_rewrite_in_progress|aof_last_rewrite_time_sec|aof_last_cow_size):'

"${REDIS[@]}" CONFIG GET latency-monitor-threshold
"${REDIS[@]}" LATENCY HISTORY fork
unset REDISCLI_AUTH
预期输出示例:
latest_fork_usec:84231
total_forks:17
current_cow_peak:201326592
current_cow_size:134217728
rdb_bgsave_in_progress:1
rdb_last_bgsave_time_sec:18
rdb_last_cow_size:188743680
aof_rewrite_in_progress:0
aof_last_rewrite_time_sec:42
aof_last_cow_size:268435456
1) "latency-monitor-threshold"
2) "10"
1) 1) (integer) <UNIX_TIME>
   2) (integer) 84
latest_fork_usec:84231 表示最近一次 fork 约为 84.231 ms,这是主线程建立子进程时的停顿,不等于整个 RDB 保存或 AOF 重写耗时。rdb_last_bgsave_time_sec 和 aof_last_rewrite_time_sec 反映子进程工作持续时间;持续越久,父进程写入触发 CoW 的窗口通常越长。
fork 与 CoW 链路
fork 后父子进程先共享内存页,Redis 主进程继续处理写命令;某个共享页被父进程修改时,内核复制该页形成写时复制。数据集越大,fork 复制页表的成本通常越高;写入越密集、后台任务越久,current_cow_size 和峰值越容易增长。
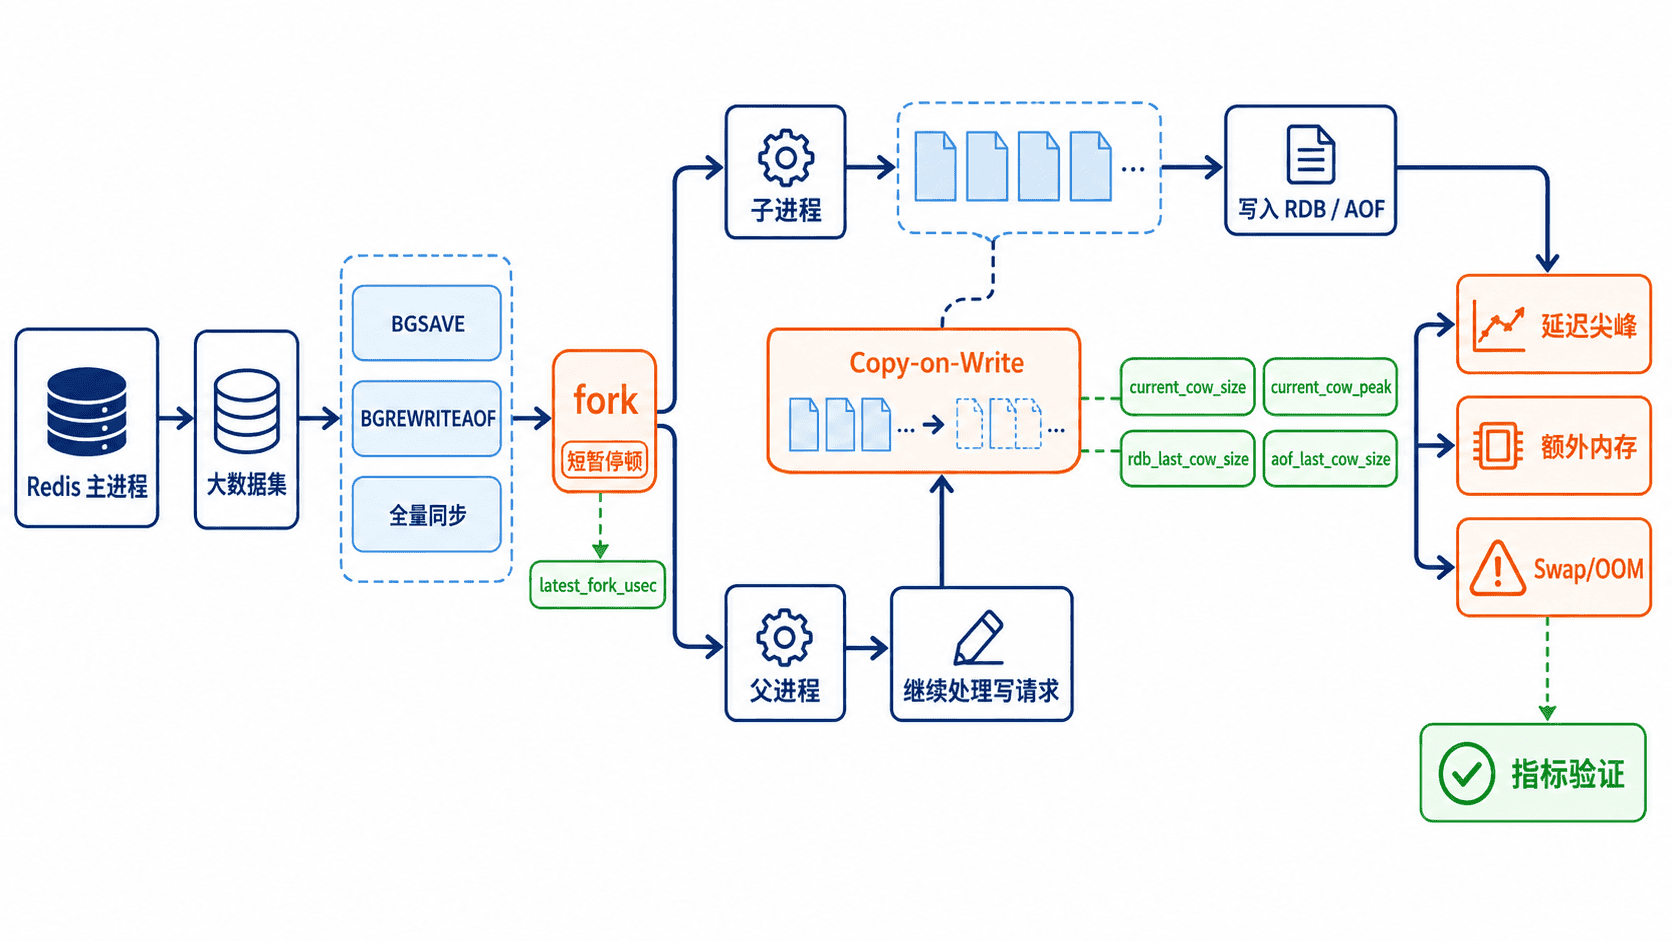
current_cow_size 是当前后台子进程运行期间已复制的内存,current_cow_peak 是本次任务峰值;rdb_last_cow_size 和 aof_last_cow_size 用于复盘上一次任务。父子进程大量页面仍然共享,因此不能把两者的 RSS 直接相加当作实际物理内存占用,应以 MemAvailable、CoW 指标、cgroup 使用量和 swap 为准。
宿主机验证
在 Redis 宿主机且处于相同 PID 命名空间内采样。重点观察可用内存、换入换出、运行队列和 Redis 子进程;容器中应同时读取 cgroup 内存上限与 memory.events。
export REDISCLI_AUTH='<PASSWORD>'
PID=$(redis-cli -h <HOST> -p <PORT> --user <USER> --raw INFO server |
  awk -F: '/^process_id:/ {gsub("\r", "", $2); print $2}')

ps -o pid,ppid,stat,pcpu,pmem,rss,vsz,comm -p "$PID" --ppid "$PID"
grep -E '^(VmRSS|VmSwap):' "/proc/$PID/status"
free -h
vmstat 1 5
cat /sys/kernel/mm/transparent_hugepage/enabled
unset REDISCLI_AUTH
预期输出示例:
    PID    PPID STAT %CPU %MEM      RSS      VSZ COMMAND
  <PID>       1 Ssl  92.0 41.8 <RSS_KB> <VSZ_KB> redis-server
<CHILD_PID> <PID> R   88.0 40.9 <RSS_KB> <VSZ_KB> redis-rdb-bgsave
VmRSS:    <RSS_KB> kB
VmSwap:         0 kB
               total        used        free      shared  buff/cache   available
Mem:           <TOTAL>      <USED>      <FREE>     <SHARED>   <CACHE>      <AVAILABLE>
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 3  0      0 <FREE> <BUFF> <CACHE>    0    0  <BI>  <BO> <IN> <CS> <US> <SY> <ID> <WA> <ST>
always madvise [never]
si 或 so 持续大于 0、VmSwap 增长或 MemAvailable 接近安全下限,说明 CoW 已演变为系统内存压力;此时继续触发后台任务可能导致长尾延迟或 OOM。运行队列 r 明显超过可用 CPU,且子进程 CPU 很高,说明持久化任务正在与主线程争抢调度资源。
处理顺序
先停止人为重复触发 BGSAVE、BGREWRITEAOF,并确认是否存在定时任务、AOF 自动重写、模块 fork 或副本反复全量同步。不要在压力期间通过再次执行后台保存来“验证”,应依靠现有 INFO、延迟历史和系统采样。
再按最近多次任务的 CoW 峰值预留内存余量,而不是只看 used_memory。余量不足时优先扩容、分片、降低写入突发或缩短后台任务持续时间;磁盘吞吐不足会延长子进程存活时间,使更多写操作有机会触发 CoW。
若 latest_fork_usec 随数据集增大持续上升,评估拆分实例、减少单实例数据集和页表规模。若副本断线反复触发全量同步,修复网络与复制积压区配置,并错开多个副本的重连,避免形成连续 fork。
透明大页处于启用状态且 Redis 日志给出相关警告时,应按操作系统或云厂商规范在维护窗口关闭并重启 Redis 验证。不要只临时写内核文件后就认为配置已永久生效。
风险与边界
在业务高峰执行 BGSAVE 或 BGREWRITEAOF 会触发新的 fork;当数据集大、可用内存低或写流量高时,后果可能是延迟尖峰、CoW 暴涨、swap 或 OOM。安全替代方案是先读取现有指标,在低峰和容量评估完成后再做受控验证。
关闭 RDB、AOF,修改 save、AOF 重写阈值或 no-appendfsync-on-rewrite 会改变数据持久性和故障恢复边界。只有在明确 RPO、备份和回滚方案后调整;仅为降低一次 fork 延迟而临时关闭持久化,可能造成不可接受的数据丢失。
CONFIG SET latency-monitor-threshold <MS> 是运行时配置变更,阈值为 0 时监控关闭。需要新增证据时先取得变更许可,设置符合业务 SLO 的阈值;不要顺手执行 CONFIG REWRITE,以免把临时参数永久写入配置。
旧版本或托管服务可能缺少部分 CoW 字段,或限制 CONFIG、LATENCY 与进程级访问。Redis Cluster 必须逐节点检查;一个分片的 fork 尖峰不会可靠地反映在集群平均值中。
速查结论:latest_fork_usec 判断“fork 停了多久”,持久化时长判断“子进程活了多久”,CoW 与系统内存指标判断“这段时间复制了多少页、是否逼近 OOM”。