
大模型应用开发 / 知识点
OpenAI API 开发速查手册
手册条目
client = OpenAI(max_retries=0, timeout=<SECONDS>)
except openai.APIStatusError as exc:   # 408 / 409 / 429 / 5xx 指数退避 + 抖动,优先读 retry-after
识别限流响应并使用指数退避、抖动和并发控制进行重试。
处理限流与重试
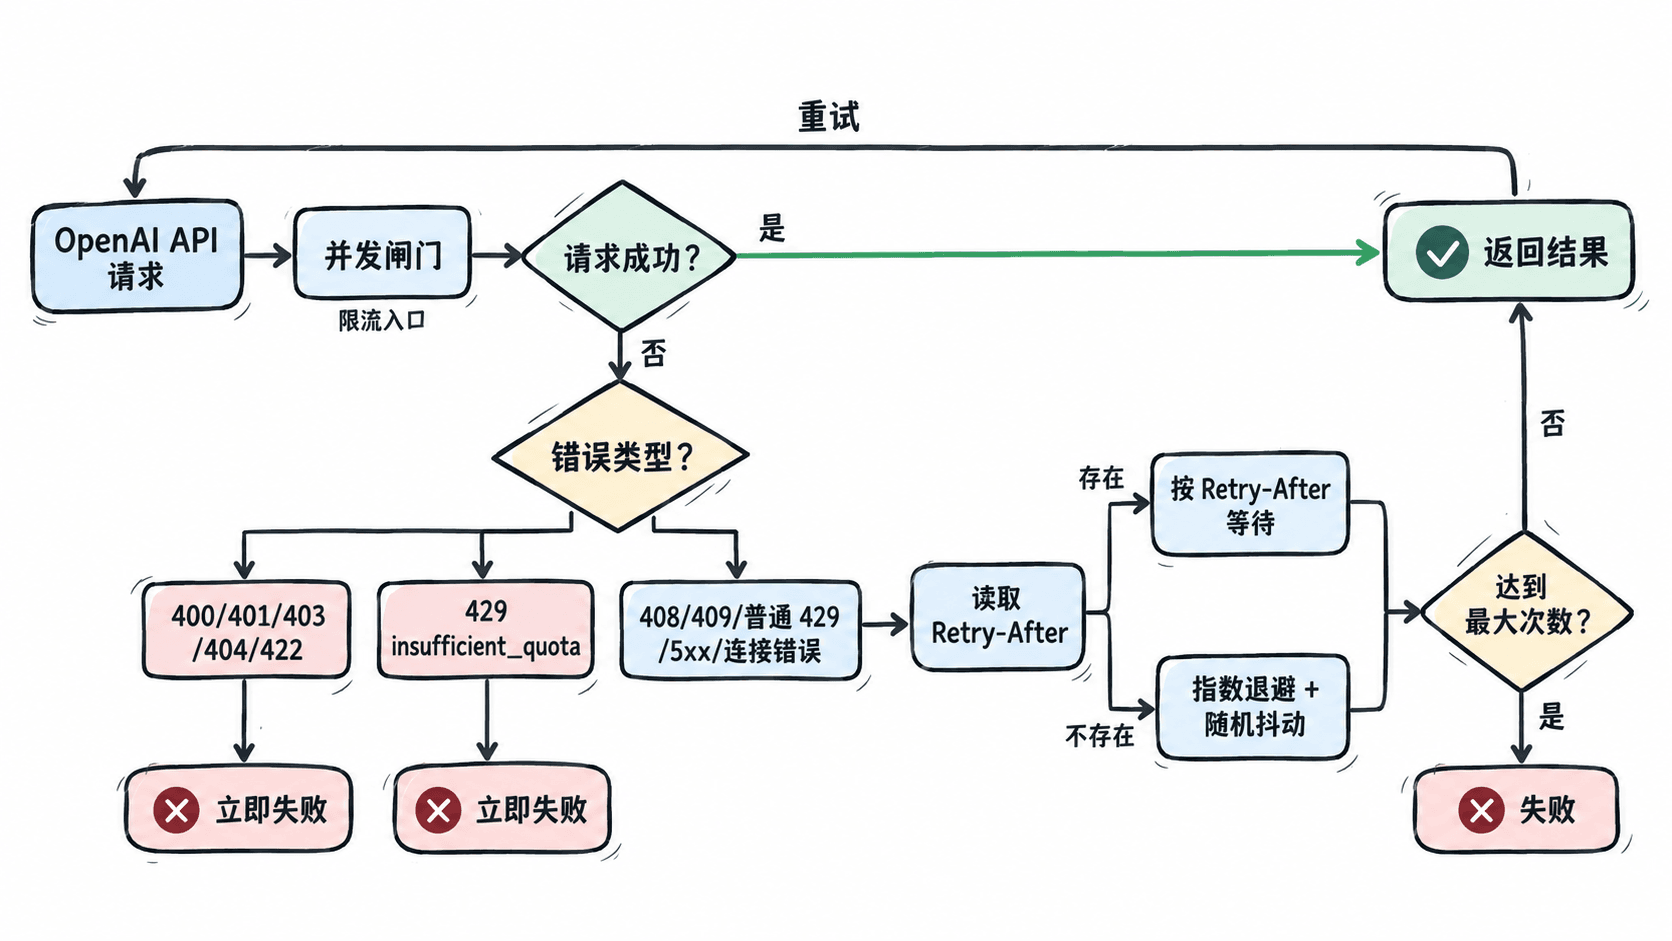
遇到 429、连接中断、超时或服务端 5xx 时,用“有限次数重试 + 指数退避 + 随机抖动 + 并发上限”恢复瞬时故障;参数、认证、权限和额度耗尽错误应立即失败,不要盲目重试。OpenAI Python SDK 默认会对连接错误、408、409、429 和 5xx 自动重试 2 次;自行实现重试时应关闭 SDK 内置重试,避免尝试次数相乘。:contentReference[oaicite:0]{index=0}
重试判定
可重试:408、409、普通 429、5xx、APIConnectionError 和 APITimeoutError。不可重试:400、401、403、404、422,以及 429 中表示额度或账单问题的 insufficient_quota。
指数退避可写为 min(上限, 基础等待 × 2^attempt) + 随机抖动。若响应包含 Retry-After,优先按该值等待;同时记录 x-ratelimit-remaining-* 和 x-ratelimit-reset-*,可在触发 429 前主动降速。:contentReference[oaicite:1]{index=1}
可运行示例
脚本关闭 SDK 内置重试,由应用统一控制总尝试次数;BoundedSemaphore 限制同时在途请求数。它只限制并发,不等同于完整的 RPM/TPM 限速器。
import os
import random
import threading
import time

import openai
from openai import OpenAI

MAX_ATTEMPTS = 6
MAX_IN_FLIGHT = 4
MAX_DELAY_SECONDS = 30.0

client = OpenAI(max_retries=0, timeout=30.0)
gate = threading.BoundedSemaphore(MAX_IN_FLIGHT)

def retry_delay(exc: Exception, attempt: int) -> float:
    response = getattr(exc, "response", None)
    retry_after = response.headers.get("retry-after") if response else None
    if retry_after:
        try:
            return min(float(retry_after), MAX_DELAY_SECONDS)
        except ValueError:
            pass

    exponential = min(0.5 * (2**attempt), MAX_DELAY_SECONDS)
    return exponential + random.uniform(0.0, 0.5)

def create_response(prompt: str):
    with gate:
        for attempt in range(MAX_ATTEMPTS):
            try:
                return client.responses.create(
                    model=os.environ["OPENAI_MODEL"],
                    input=prompt,
                )
            except openai.APIStatusError as exc:
                # 配额耗尽和其他确定性 4xx 不会因等待而恢复。
                if exc.status_code == 429 and exc.code == "insufficient_quota":
                    raise
                retriable = exc.status_code in {408, 409, 429} or exc.status_code >= 500
                if not retriable or attempt == MAX_ATTEMPTS - 1:
                    raise
                delay = retry_delay(exc, attempt)
                print(
                    f"retry attempt={attempt + 1} "
                    f"wait={delay:.2f}s status={exc.status_code}"
                )
                time.sleep(delay)
            except openai.APIConnectionError as exc:
                if attempt == MAX_ATTEMPTS - 1:
                    raise
                delay = retry_delay(exc, attempt)
                print(
                    f"retry attempt={attempt + 1} "
                    f"wait={delay:.2f}s status=network"
                )
                time.sleep(delay)

    raise RuntimeError("unreachable")

if __name__ == "__main__":
    response = create_response("只输出 OK,不要添加标点。")
    print(f"success request_id={response._request_id}")
    print(response.output_text)
运行前设置有效密钥和当前项目可用的模型:
export OPENAI_API_KEY="<API_KEY>"
export OPENAI_MODEL="<MODEL_ID>"
python retry_openai.py
预期输出;请求 ID 和等待时间以实际值为准:
success request_id=<REQUEST_ID>
OK
发生瞬时限流时,成功行之前会出现一至多行 retry attempt=...。
并发与容量控制
并发上限要按共享的项目级限制设置,而不是每个进程各自设置相同上限。多实例部署应使用集中式队列或令牌桶协调 RPM/TPM;仅靠进程内信号量会让总并发随实例数增长。
请求较大时,TPM 往往先耗尽。可通过缩短输入、限制输出、平滑队列消费和减少突发并发降低 429。失败请求也可能计入限额,因此无上限的快速重试会进一步放大限流。
风险与边界
- 触发条件:SDK 内置重试和业务重试同时开启。后果:实际请求次数成倍增加,延迟和费用失控。替代方案:只保留一层重试,并设置总尝试次数与总耗时上限。
- 触发条件:对
401、403、参数错误或insufficient_quota重试。后果:持续失败并挤占线程。替代方案:立即失败,修正密钥、权限、参数或账单。 - 触发条件:超时后请求可能已被服务端接收。后果:重复生成、重复计费,工具调用还可能产生重复业务动作。替代方案:记录请求 ID,并在应用侧为写操作增加业务幂等键和去重。
- 触发条件:大量客户端在同一时刻按固定间隔重试。后果:形成重试风暴。替代方案:加入随机抖动,并通过队列平滑流量。
速查:重试只处理“暂时不可用”,并发控制负责“不要同时压上去”,额度、权限和参数问题必须直接修复。
except openai.APIStatusError as exc: exc.status_code, exc.request_id, exc.body
extra_headers={"X-Client-Request-Id": "<TRACE_ID>"}
根据状态码、错误类型、响应体和请求参数定位调用失败原因。
定位 API 错误
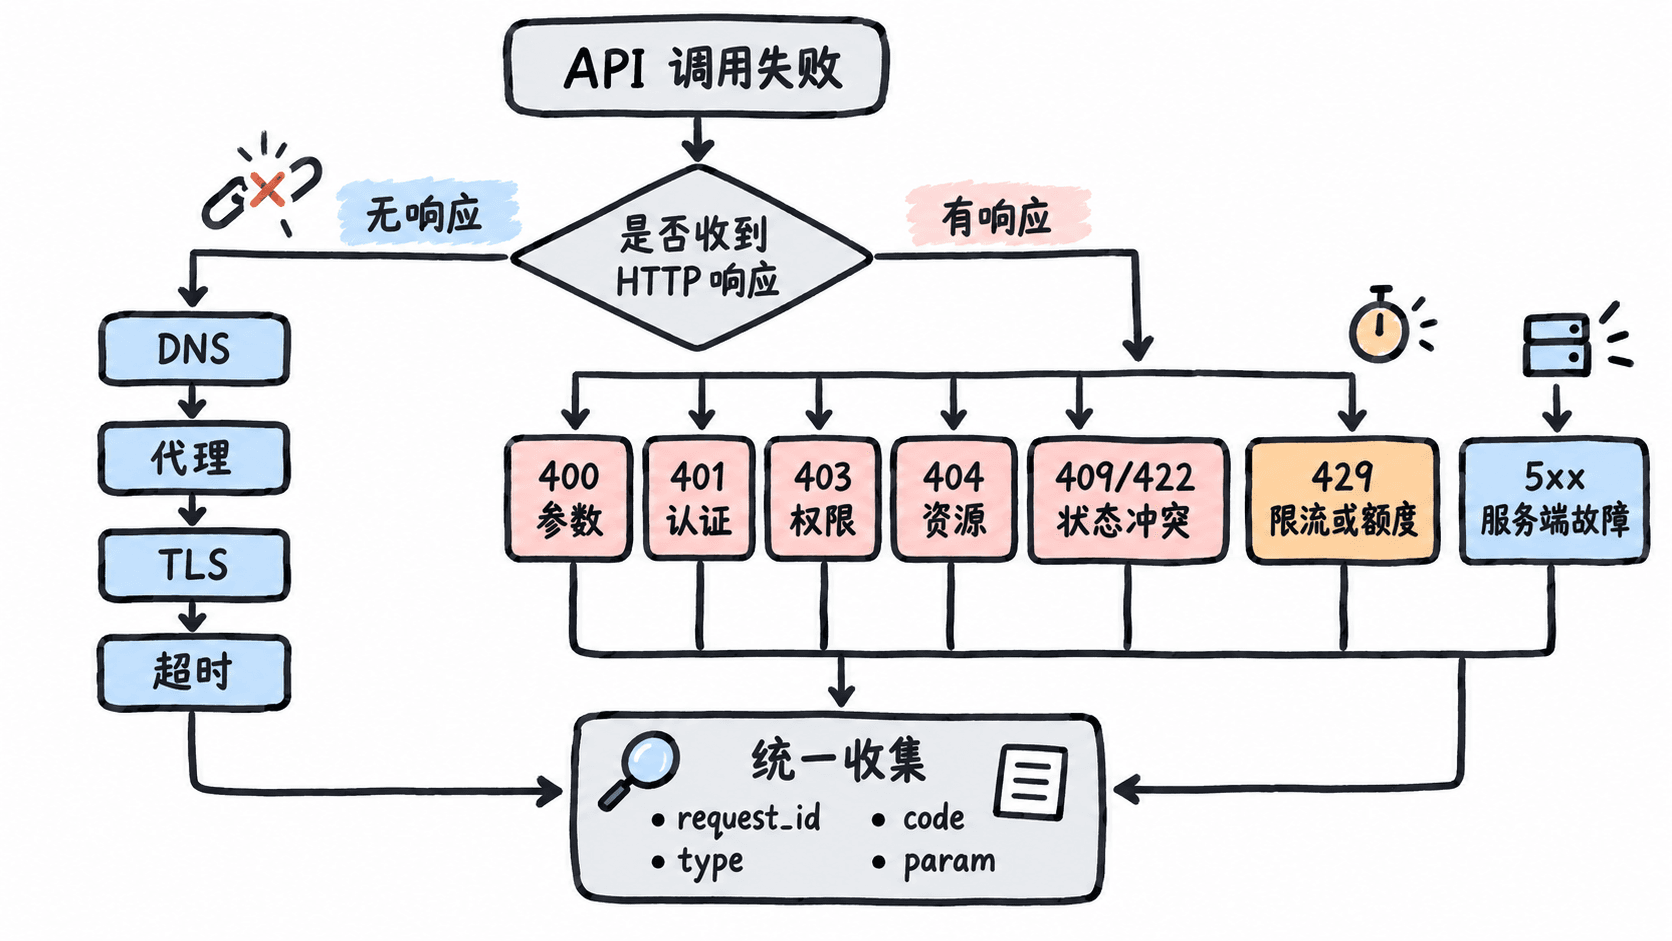
调用失败时,先固定记录异常类、HTTP 状态码、request_id、结构化错误字段和最小化请求参数,再决定是修正请求、调整权限、降速重试还是上报服务端故障。不要只根据错误消息字符串判断,因为稳定的定位依据是状态码和 type、code、param 等字段。:contentReference[oaicite:2]{index=2}
状态码定位
| 状态或异常 | 常见方向 | 首要动作 |
|---|---|---|
400 BadRequestError |
参数格式、上下文长度、字段组合错误 | 对照接口定义缩减为最小请求 |
401 AuthenticationError |
密钥无效、缺失或加载错环境 | 检查密钥来源,禁止打印完整密钥 |
403 PermissionDeniedError |
项目、组织、模型或资源权限不足 | 核对项目与访问权限 |
404 NotFoundError |
模型、资源 ID 或路径不存在 | 核对模型名、资源归属和 API 路径 |
409 ConflictError |
资源状态冲突 | 读取错误体,确认当前资源状态 |
422 UnprocessableEntityError |
请求结构可解析但语义不合法 | 检查字段取值和组合约束 |
429 RateLimitError |
RPM/TPM 限流或额度问题 | 区分普通限流与 insufficient_quota |
5xx InternalServerError |
服务端瞬时故障 | 有上限退避重试并保留请求 ID |
APIConnectionError |
DNS、代理、TLS、网络或超时 | 检查网络链路和底层异常 |
官方 Python SDK 按这些状态映射异常类;没有 HTTP 响应的连接错误不会有状态码。:contentReference[oaicite:3]{index=3}
采集诊断信息
成功响应可从顶层对象的 _request_id 读取 x-request-id;失败请求应从 APIStatusError.request_id 读取。生产环境还可发送唯一的 X-Client-Request-Id 关联内部 trace,但它只用于追踪,不是幂等或去重机制。OpenAI 建议在生产环境记录请求 ID。:contentReference[oaicite:4]{index=4}
下面的脚本关闭自动重试,让第一次错误原样暴露,并仅输出排障所需字段,不记录密钥或完整输入。
import json
import os

import openai
from openai import OpenAI

client = OpenAI(max_retries=0, timeout=20.0)

def compact_error(exc: Exception) -> dict:
    fields = {
        "exception": type(exc).__name__,
        "status": getattr(exc, "status_code", None),
        "request_id": getattr(exc, "request_id", None),
        "type": getattr(exc, "type", None),
        "code": getattr(exc, "code", None),
        "param": getattr(exc, "param", None),
        "message": getattr(exc, "message", str(exc)),
    }
    return {key: value for key, value in fields.items() if value is not None}

try:
    response = client.responses.create(
        model=os.environ["OPENAI_MODEL"],
        input="只输出 OK。",
        extra_headers={
            "X-Client-Request-Id": os.getenv("TRACE_ID", "trace-demo-001")
        },
    )
    print(
        json.dumps(
            {"ok": True, "request_id": response._request_id},
            ensure_ascii=False,
        )
    )
except openai.APIStatusError as exc:
    print(json.dumps(compact_error(exc), ensure_ascii=False))
    raise SystemExit(1)
except openai.APIConnectionError as exc:
    print(json.dumps(compact_error(exc), ensure_ascii=False))
    raise SystemExit(2)
使用无效密钥可安全验证 401 采集路径,不会产生模型调用费用:
OPENAI_API_KEY="invalid" OPENAI_MODEL="<MODEL_ID>" TRACE_ID="trace-demo-001" python diagnose_openai.py预期输出;错误文案和请求 ID 以实际响应为准:
{"exception":"AuthenticationError","status":401,"request_id":"<REQUEST_ID>","type":"invalid_request_error","code":"invalid_api_key","message":"<ERROR_MESSAGE>"}排障清单
- 确认实际请求的基础地址、路径、HTTP 方法和 SDK 版本,排除代理改写或旧接口混用。
- 记录状态码、异常类、
request_id、type、code、param,但脱敏密钥、Authorization 头、用户输入和文件内容。 - 将请求缩减到最小:一个有效模型、一个短输入、无工具、无流式、无可选参数;最小请求成功后逐项加回参数。
- 对照参数约束检查模型是否支持当前输入类型、工具和输出设置;资源 ID 还要确认所属项目和环境。
429查看是请求数、令牌数还是额度问题;5xx和网络错误执行有限重试;确定性4xx直接修正。- 仍无法定位时,提供时间、脱敏请求、SDK 版本、区域、
x-request-id或X-Client-Request-Id给支持人员。
风险与边界
- 触发条件:把完整请求体、响应体或 Authorization 头写入日志。后果:密钥、个人数据或业务内容泄露。替代方案:字段白名单、内容摘要和统一脱敏。
- 触发条件:只匹配英文错误文案。后果:服务端文案变化后告警和分流失效。替代方案:优先使用异常类、状态码和结构化字段。
- 触发条件:为复现错误直接修改生产请求。后果:重复计费或产生真实业务副作用。替代方案:在隔离环境使用最小请求和测试资源。
- 触发条件:把
X-Client-Request-Id当作幂等键。后果:同一业务动作仍可能重复执行。替代方案:由业务系统自行生成并校验幂等键。
速查:先拿到 request_id 和结构化错误字段,再缩减请求;没有这些证据时,不要凭猜测修改重试或参数。
X-Client-Request-Id: <UUID>      # 请求头,自定义追踪号
x-request-id: req_<ID>           # 响应头,平台请求标识
response._request_id             # Python SDK
保存平台返回的请求标识,便于日志关联和问题追踪。
记录请求标识
为每次 OpenAI API 调用同时保存平台生成的 x-request-id 和本方生成的 X-Client-Request-Id,这样既能关联应用日志,也能在超时、网关断连等拿不到响应头的场景中继续追踪请求。
应记录的标识
x-request-id:OpenAI 在响应头中返回的唯一请求标识,提交支持工单或定位 HTTP 错误时优先提供。X-Client-Request-Id:调用方主动放入请求头的标识,必须每次请求唯一;只允许 ASCII,长度不得超过 512 个字符,否则请求会返回 HTTP 400。trace_id或operation_id:本系统内部链路标识,用于串联入口请求、重试任务和下游调用。一次业务操作发生多次重试时,保留同一个operation_id,但每次实际 HTTP 尝试生成新的X-Client-Request-Id。:contentReference[oaicite:0]{index=0}
基本用法
下面调用只读取模型列表,不产生模型推理结果;-D 保存响应头,-o 保存响应体,便于分别记录状态与请求标识。
set -euo pipefail

client_request_id="$(python3 -c 'import uuid; print(uuid.uuid4())')"
headers_file="$(mktemp)"
body_file="$(mktemp)"

curl -sS \
  -D "$headers_file" \
  -o "$body_file" \
  "https://api.openai.com/v1/models" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "X-Client-Request-Id: $client_request_id"

openai_request_id="$(
  awk 'BEGIN { IGNORECASE=1 }
       /^x-request-id:/ { gsub("\r", "", $2); print $2 }' "$headers_file"
)"

printf 'client_request_id=%s\nopenai_request_id=%s\n' \
  "$client_request_id" "$openai_request_id"

rm -f "$headers_file" "$body_file"
预期输出
client_request_id=<ID>
openai_request_id=req_<ID>
<ID> 为动态值,实际格式可能不同;不要依赖 req_ 前缀做校验或业务解析。
日志字段
生产日志至少保留 timestamp、service、trace_id、operation_id、client_request_id、openai_request_id、endpoint、status_code、latency_ms 和 retry_count。成功响应、HTTP 4xx/5xx 都应记录请求标识;Python 官方 SDK 的顶层响应对象可读取 _request_id,捕获 APIStatusError 时可读取异常的 request_id。:contentReference[oaicite:1]{index=1}
日志中不要写入 Authorization、API 密钥、完整提示词或用户敏感数据。请求标识用于关联,不是认证凭证,也不能代替业务幂等键。
排障清单
- API 返回 4xx/5xx:记录状态码、错误类型、错误消息、
x-request-id,再按同一时间窗口检索本地trace_id。 - 请求超时或连接中断:响应头可能未到达,改用已发送的
X-Client-Request-Id判断 OpenAI 是否收到请求。 - 自动重试:为每次 HTTP 尝试生成不同的客户端请求标识,同时保留统一的业务操作标识,避免多次尝试在日志里互相覆盖。
- 请求头为空:检查反向代理、HTTP 客户端或日志中间件是否丢弃了
x-request-id,并确认读取的是响应头而不是 JSON 响应体。
速查:外部排障提供 x-request-id;拿不到响应时提供 X-Client-Request-Id;内部检索始终从 trace_id 或 operation_id 开始。
export OPENAI_API_KEY="<API_KEY>"   # 只放在服务端环境变量或密钥管理服务
OpenAI().models.list()              # 验证密钥可用
避免在浏览器、移动端、代码仓库和日志中暴露长期密钥。
保护 API 密钥
长期 API 密钥只能保存在受控的服务端运行环境中。浏览器、移动端、代码仓库、构建产物和日志都不应出现明文密钥;客户端应用应调用自己的后端,再由后端访问 OpenAI API。
安全部署边界
- 服务端从
OPENAI_API_KEY环境变量或密钥管理服务读取,不把密钥写进源码、镜像、配置模板或启动参数。 - 开发、测试、生产使用不同 Project 和不同密钥,分别设置权限、速率与消费边界;团队成员不要共享个人密钥。
- 按实际调用范围使用受限权限,减少密钥泄露后的可用接口和影响范围。
- 浏览器或移动端直接携带长期密钥时,攻击者可从网络请求、安装包或运行时内存中提取密钥,后果可能包括未授权调用、异常费用和服务中断;安全替代方案是由受认证的自有后端代理请求。:contentReference[oaicite:2]{index=2}
安全验证示例
以下示例在终端中静默读取密钥,只通过环境变量交给官方 Python SDK,并仅输出请求标识,不打印密钥。
set -euo pipefail

python3 -m venv .venv
. .venv/bin/activate
python -m pip install -q --upgrade openai

read -rsp "OPENAI_API_KEY: " OPENAI_API_KEY
printf '\n'
export OPENAI_API_KEY

python - <<'PY'
import os
from openai import OpenAI

if not os.environ.get("OPENAI_API_KEY"):
    raise SystemExit("OPENAI_API_KEY is missing")

response = OpenAI().models.list()
print(f"authentication_ok request_id={response._request_id}")
PY

unset OPENAI_API_KEY
预期输出
authentication_ok request_id=req_<ID><ID> 为动态请求标识。若密钥无效、已撤销或不属于目标 Project,SDK 会返回认证或权限错误;排查时只记录错误类型和请求标识,不打印密钥。
仓库与日志防护
.env、本地密钥文件和导出的 Secret 必须加入忽略规则,仓库中只保留不含值的示例文件。
.env
.env.*
secrets/
*.secret
!.env.example
.env.example 只写 OPENAI_API_KEY=。提交前使用仓库的 Secret Scanning 或 CI 密钥扫描;日志中对疑似密钥字段直接删除,不做“仅显示前后几位”的常规打印,因为截断值仍可能扩大泄露面。
泄露处置
发现密钥进入公开仓库、安装包、网页源码、聊天记录或日志后,应立即删除或撤销旧密钥,创建新密钥并更新服务端密钥存储,然后重新部署。仅删除 Git 文件或重写历史不能让旧密钥失效。随后检查 Project 用量、费用、异常接口和调用时间,并收紧权限与消费告警。OpenAI 官方也建议在怀疑泄露时立即轮换或删除密钥。:contentReference[oaicite:3]{index=3}
风险与安全替代
| 触发条件 | 可能后果 | 安全替代 |
|---|---|---|
| 密钥写入前端或移动端 | 可被提取并冒用 | 客户端调用自有后端,由后端持有密钥 |
| 密钥提交到仓库或镜像 | 历史版本、缓存和制品持续泄露 | 环境变量、Secret Manager、构建时密钥注入 |
| 多人或多环境共用一个密钥 | 无法准确追责,泄露影响扩大 | 每个 Project、环境或服务使用独立密钥 |
| 日志打印请求头或环境变量 | 日志平台、告警和工单二次扩散 | 字段级脱敏并禁止记录 Authorization |
速查:不下发客户端、不进入仓库、不写入日志;独立密钥、最小权限、立即轮换。
GET /v1/models
OpenAI-Organization: <ORG_ID>
OpenAI-Project: <PROJECT_ID>
使用项目、角色和服务账户控制资源访问与密钥权限。
配置项目权限
用项目隔离环境与资源,用角色控制人员权限,用服务账户承载生产程序,再把 API 密钥收紧到所需端点。完成后,测试、生产和不同业务线不会共用同一把高权限密钥。
权限边界
组织角色决定能否管理全局资源,项目角色决定能否操作某个项目。组织 Owner 可创建和查看全部项目、用户与密钥;组织 Reader 只能进入已加入的项目。项目 Owner 可管理成员、项目设置与支出限制;项目 Member 可调用 API、使用项目资源并创建项目级密钥。
服务账户是供后端程序使用的项目级身份,只能访问创建它的项目。只有组织或项目所有者可以创建服务账户。默认项目继承组织配置,成员和服务账户管理方式与普通项目不同,生产系统应优先新建独立项目。
配置步骤
- 按环境创建独立项目,例如
app-dev、app-staging、app-prod,不要让测试密钥访问生产文件、向量库或微调资源。 - 在
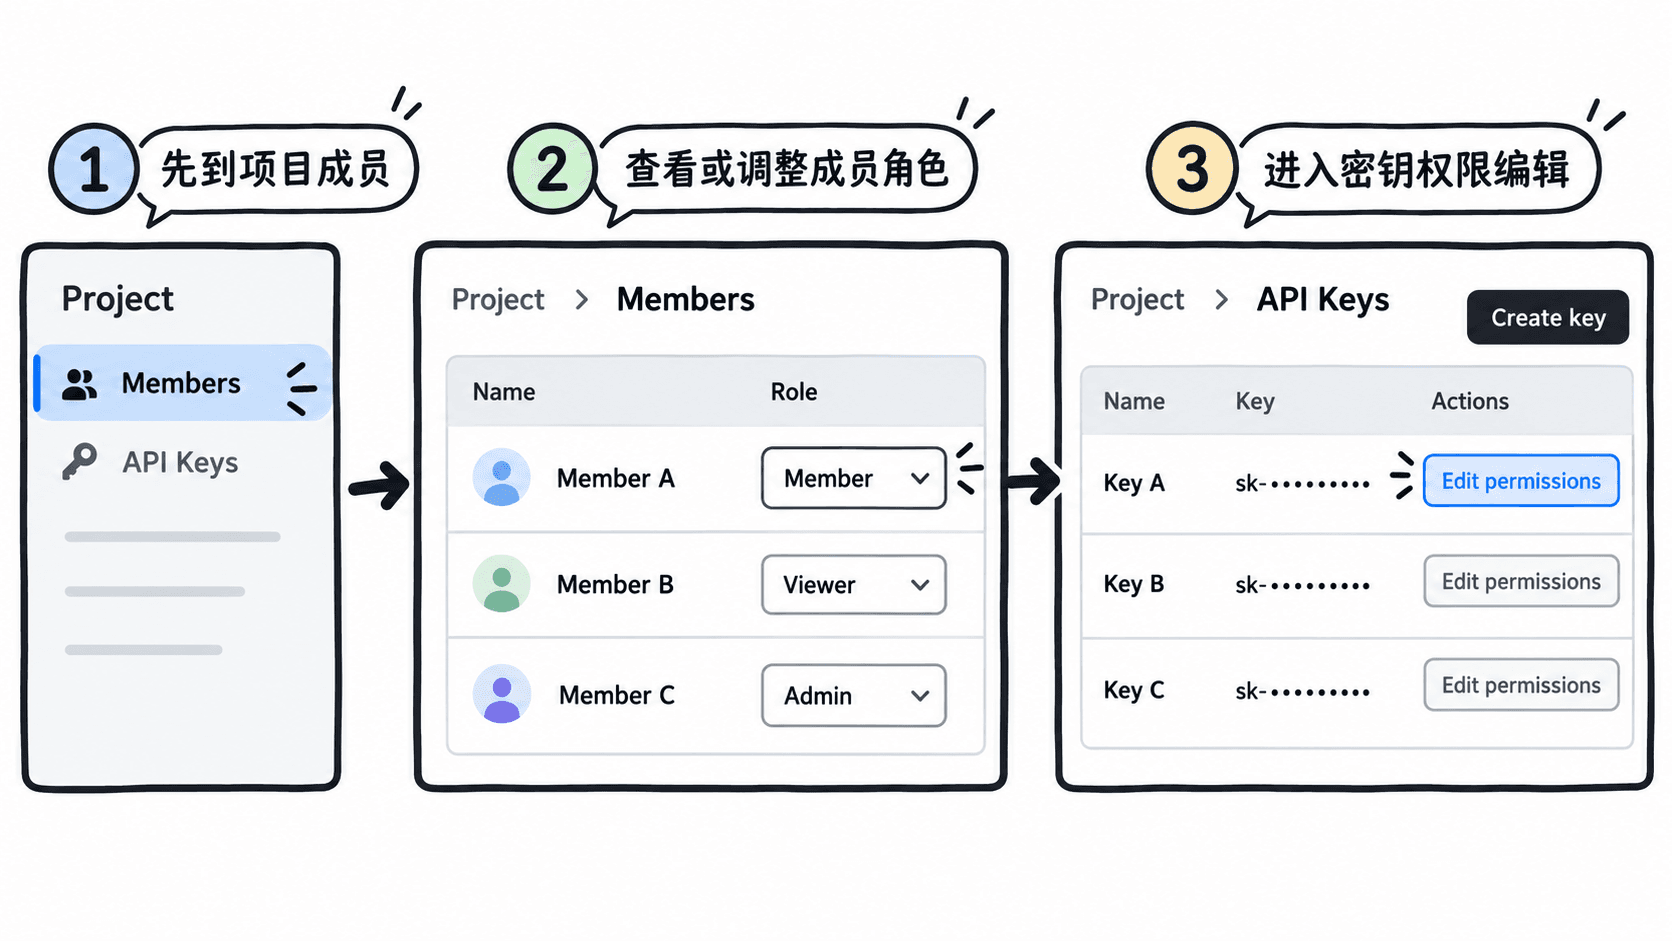
Project → Members中添加人员。日常开发授予Member,只有确实需要管理成员、限制和归档项目的人才授予Owner。 - 在生产项目中创建服务账户。密钥只显示一次,应立即写入服务器密钥管理服务,不要粘贴到源码、工单或聊天记录。
- 在
Project → API Keys中编辑密钥权限。优先选择Restricted,按资源设置None、Read或Write;只读巡检任务可选Read Only,不要默认长期保留All。
验证权限
下面命令验证密钥是否能在目标项目读取模型列表。使用旧式用户密钥或一个账号加入多个项目时,显式传入组织和项目头;项目级服务账户密钥通常已绑定项目,但保留项目头便于排错。
export OPENAI_API_KEY="<SECRET_KEY>"
export OPENAI_ORG_ID="<ORG_ID>"
export OPENAI_PROJECT_ID="<PROJECT_ID>"

curl -sS -i https://api.openai.com/v1/models \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "OpenAI-Organization: $OPENAI_ORG_ID" \
  -H "OpenAI-Project: $OPENAI_PROJECT_ID"
预期输出
HTTP/2 200
...
{"object":"list","data":[{"id":"<MODEL_ID>","object":"model",...}]}
200 表示身份、项目和读取权限匹配;模型 ID 与响应头会随账号和时间变化。若限制了模型读取权限,应改用该密钥实际允许的端点做最小验证。
风险与边界
- 触发条件:前端、移动端或公开仓库内包含 API 密钥。可能后果:任何人都能冒用额度并访问项目资源。安全替代:只在服务端读取环境变量或密钥管理服务,由后端代理请求。
- 触发条件:生产密钥保持
All权限。可能后果:密钥泄露后可读写更多资源,扩大数据和费用损失。安全替代:使用专用服务账户和Restricted权限,并按任务拆分密钥。 - 触发条件:多人共用个人密钥。可能后果:无法准确归因、离职后难以彻底回收。安全替代:人员使用各自项目身份,程序使用独立服务账户。
- 触发条件:把归档项目当作临时停用开关。可能后果:归档后不能恢复,项目资源也无法继续使用。安全替代:先撤销密钥、移除成员或暂停部署,再确认是否归档。
排障清单
遇到 401,检查密钥是否复制完整、是否已撤销以及进程是否读取了正确环境变量。遇到 403,检查密钥权限、成员角色、OpenAI-Project 与 OpenAI-Organization 是否指向同一归属。
资源在控制台可见但 API 返回不存在时,通常是项目不一致;文件、向量库、线程等项目资源不能被其他项目的普通成员访问。生产变更后应记录服务账户、角色和密钥的创建、修改、撤销时间,并通过审计日志或内部变更单复核。
POST /v1/responses
{"model": "<MODEL>", "input": "<TEXT>", "store": false}
根据业务要求配置数据保留、区域、日志和隐私控制。
管理数据与隐私
先区分请求内容、功能持久化状态和管理审计日志,再分别设置保留、区域与应用侧日志策略。这样可以避免把“未用于训练”“不保存响应”和“零数据保留”误认为同一件事。
数据类型与默认行为
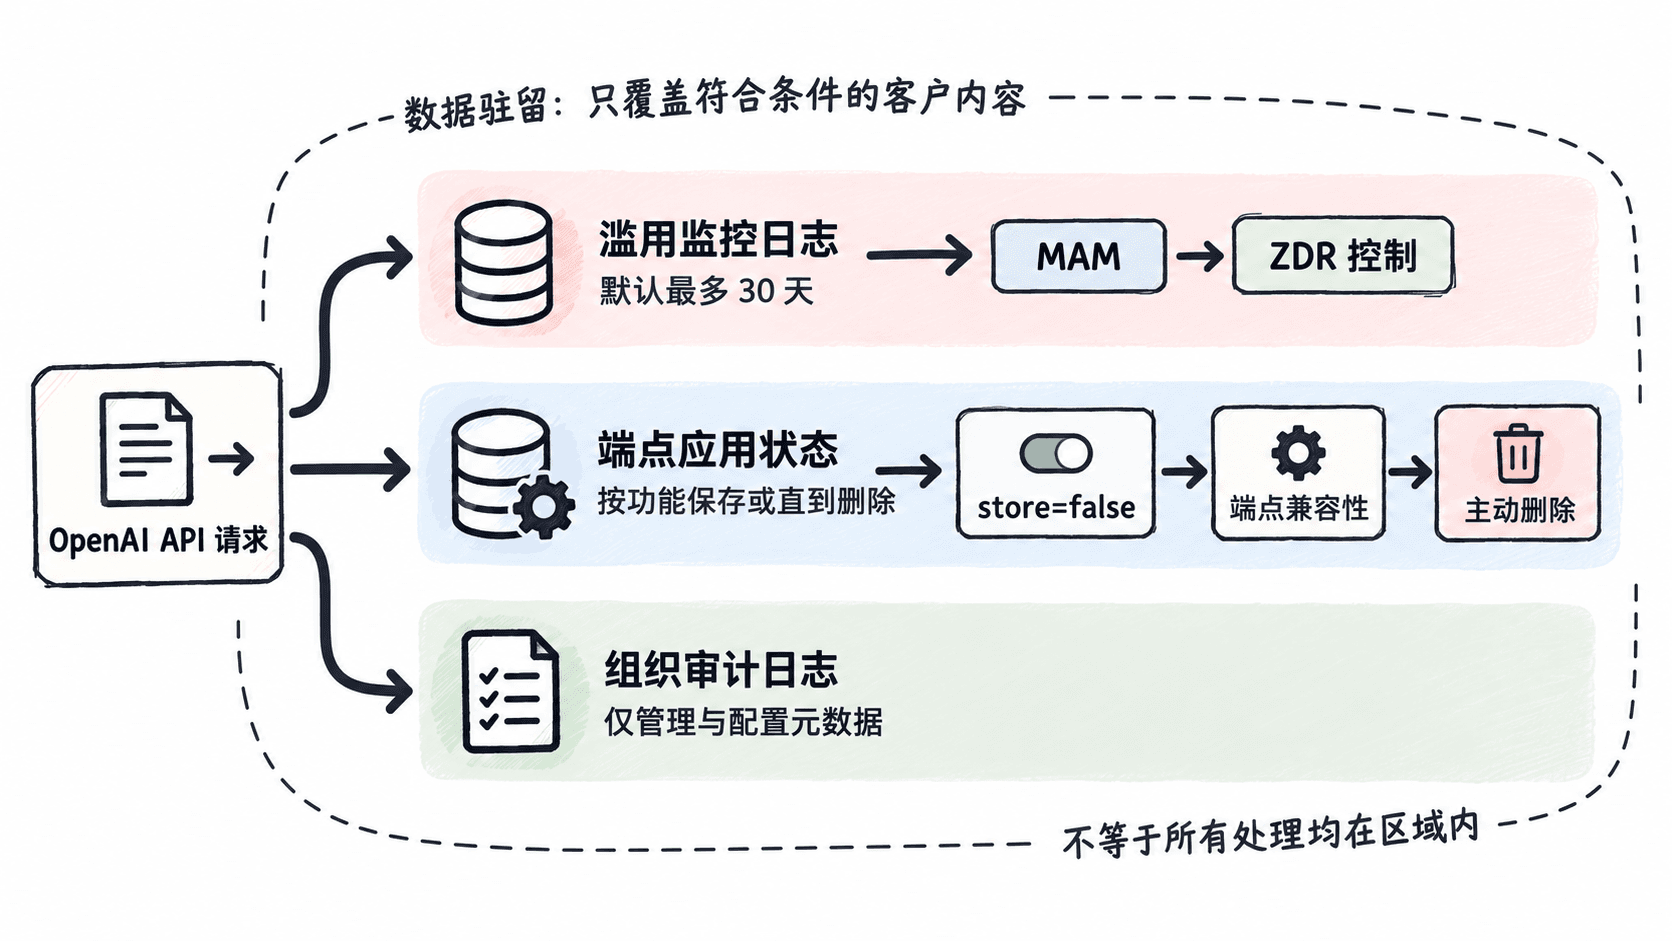
OpenAI API 数据默认不用于训练或改进模型,除非组织明确选择共享。API 使用过程中仍可能产生三类数据:用于安全与滥用检测的监控日志、某些端点完成任务所需的应用状态,以及记录用户、项目、密钥和配置变更的审计日志。
默认情况下,滥用监控日志可能包含提示词、响应及派生元数据,并最多保留 30 天;法律义务或严重安全事件可能改变该期限。应用状态由端点决定,例如文件、向量库、会话或批处理可能持续保存到删除。审计日志属于管理元数据,与请求正文和零数据保留控制分开。
保留与区域配置
符合条件的组织可申请 Modified Abuse Monitoring(MAM)或 Zero Data Retention(ZDR)。获批后,在 Settings → Organization → Data controls → Data Retention 中设置组织级策略,并让项目继承,或为单个项目明确选择 MAM、ZDR 或关闭增强控制。
ZDR 会把客户内容排除在滥用监控日志之外,并使 Responses 与 Chat Completions 的 store 按 false 处理。但不支持 ZDR 的端点或能力仍可能保存应用状态,因此必须逐端点核对兼容表,不能只看组织开关。
数据驻留按项目配置,通常在创建新项目时选择区域,并使用该区域对应的 API 域名。区域存储不必然代表区域处理;系统数据、计费和使用元数据也不一定受所选区域约束。非美国区域、模型、端点和工具的支持范围会变化,生产上线前应按当前官方矩阵确认。
请求侧最小化
Responses API 调用不需要后续读取结果时,显式设置 store: false。这只控制该响应的应用状态持久化,不会自动关闭默认滥用监控日志,也不能替代 ZDR。
export OPENAI_API_KEY="<SECRET_KEY>"

curl -sS -i https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-mini",
    "store": false,
    "input": "仅回复 OK"
  }'
预期输出
HTTP/2 200
...
{"id":"<ID>","object":"response","status":"completed",...}
实际响应 ID、模型快照、令牌统计和请求头会不同。验证时除检查 200 外,还应确认应用没有保存完整请求体,并在控制台或内部审计记录中确认请求使用了预期项目。
日志与删除策略
应用日志默认只记录 x-request-id、项目、模型、耗时、状态码和令牌用量,不记录完整提示词、文件内容、Authorization 头或个人敏感信息。确需排障采样时,应先脱敏、限制访问并设置短期自动删除。
使用 Files、Vector Stores、Conversations、Batches 或其他持久化能力时,建立资源清单和删除任务;业务数据库删除记录并不等于 OpenAI 项目中的资源已删除。审计日志不受 ZDR 影响,且不保证永久可用;有长期合规要求时,应定期导出到自己的不可篡改存储。
风险与边界
- 触发条件:看到
store: false就认定请求完全不留痕。可能后果:默认滥用监控日志仍可能保留内容。安全替代:敏感场景申请 MAM 或 ZDR,并核对端点资格。 - 触发条件:启用 ZDR 后继续使用不兼容的持久化端点。可能后果:应用状态仍保存到删除,违反内部保留承诺。安全替代:选择兼容端点,或建立明确的资源删除与验证流程。
- 触发条件:选择驻留区域后仍调用默认域名,或使用不支持区域处理的工具。可能后果:数据路径不符合预期区域要求。安全替代:使用项目指定的区域域名,并逐项核对模型、端点和第三方工具。
- 触发条件:把提示词、响应或密钥写入长期日志。可能后果:敏感数据在自有系统中扩散,即使平台侧已启用 ZDR 也无法消除。安全替代:结构化最小日志、字段脱敏、访问控制和自动过期。
排障清单
发现数据仍可查询时,先判断它属于滥用日志还是应用状态,再检查端点是否支持 ZDR、请求是否设置 store: false、资源是否需要显式删除。区域请求异常时,检查项目创建区域、域名、模型快照和工具支持范围是否一致。
上线前至少留存一份“端点—数据类型—保留期限—删除方式—区域—责任人”清单。控制台选项和支持矩阵可能更新,合规结论应以当前组织合同、批准状态和官方数据控制文档为准。
client.responses.create(model="<MODEL>", input=[{"role": "developer", "content": <PROMPT>}, {"role": "user", "content": case["input"]}])
score = grade(response.output_text, case["expected"])
使用固定数据集和评分器持续评估提示、模型与代理工作流。
建立模型评测
用于在每次调整提示词、模型或代理流程后,用同一批样本和同一套评分规则生成可比较的结果。生产环境应把评测脚本接入 CI;候选版本低于基线或最低阈值时直接阻止发布。
截至 2026-08-02,OpenAI 托管 Evals 平台已进入退役期:计划于 2026-10-31 对现有用户转为只读,并于 2026-11-30 关闭。新项目不要长期依赖 /v1/evals,优先保留可迁移的 JSONL 数据集和本地或 CI 评分脚本;Dashboard Datasets 只适合过渡期快速试验。
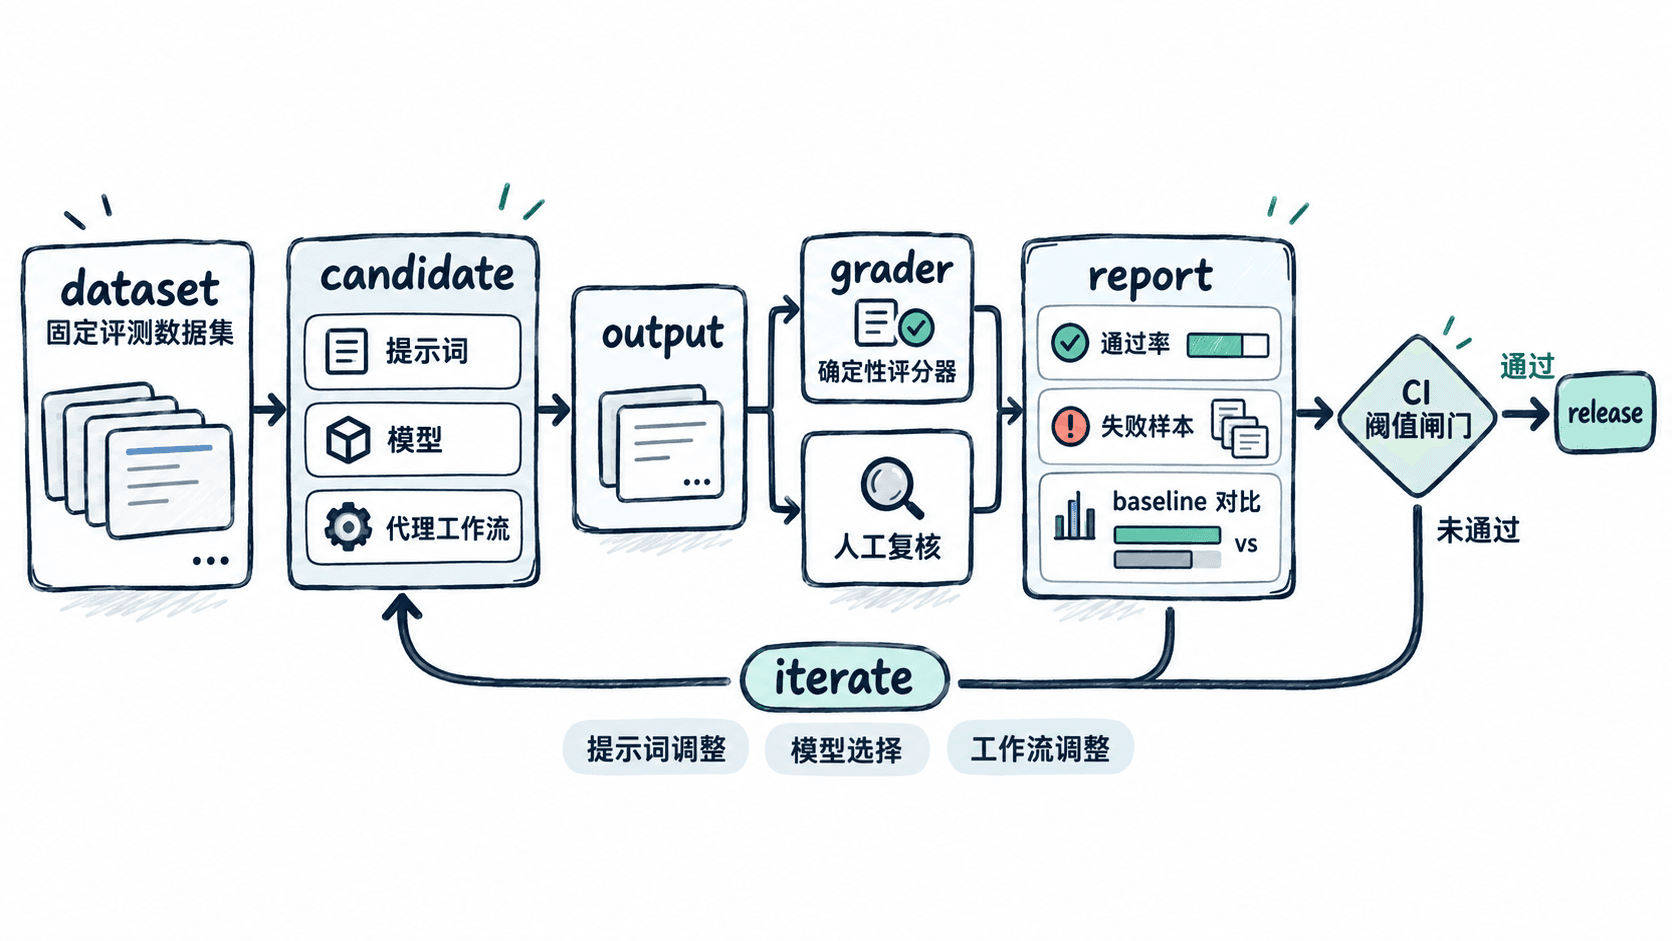
基本流程
固定四样东西:样本输入、人工确认的期望结果、评分器和版本信息。每次运行只替换候选提示词、模型或工作流,随后按样本记录实际输出、是否通过和失败原因。
分类、字段抽取等任务优先用精确匹配、集合比较或 JSON Schema 校验;摘要、风格和有用性等主观任务可使用模型评分器,但必须先用人工标注样本校准,避免评分器与真实业务标准偏离。
主示例
先保存固定数据集。每行是一个独立 JSON 对象,id 用于定位回归样本,expected 是人工确认的标准答案。
{"id":"ticket-001","input":"显示器按下电源键后没有任何反应","expected":"hardware"}
{"id":"ticket-002","input":"编辑器升级后启动时报插件加载失败","expected":"software"}
{"id":"ticket-003","input":"请推荐附近适合聚餐的餐厅","expected":"other"}
下面的脚本调用 Responses API,逐条执行分类并使用精确匹配评分。EVAL_THRESHOLD 控制 CI 闸门;得分低于阈值时进程退出码为 1。
from __future__ import annotations

import json
import os
import sys
from pathlib import Path

from openai import OpenAI

DATASET = Path(os.getenv("EVAL_DATASET", "eval_cases.jsonl"))
MODEL = os.getenv("EVAL_MODEL", "gpt-5.6")
PROMPT_VERSION = os.getenv("PROMPT_VERSION", "ticket-v1")
THRESHOLD = float(os.getenv("EVAL_THRESHOLD", "1.0"))
ALLOWED_LABELS = {"hardware", "software", "other"}

DEVELOPER_PROMPT = (
    "Classify the support ticket as exactly one lowercase label: "
    "hardware, software, or other. Return only the label."
)

client = OpenAI()

def load_cases(path: Path) -> list[dict[str, str]]:
    cases: list[dict[str, str]] = []
    with path.open("r", encoding="utf-8") as file:
        for line_number, line in enumerate(file, start=1):
            if not line.strip():
                continue
            item = json.loads(line)
            if item["expected"] not in ALLOWED_LABELS:
                raise ValueError(f"line {line_number}: invalid expected label")
            cases.append(item)
    if not cases:
        raise ValueError("evaluation dataset is empty")
    return cases

def predict(ticket: str) -> str:
    response = client.responses.create(
        model=MODEL,
        input=[
            {"role": "developer", "content": DEVELOPER_PROMPT},
            {"role": "user", "content": ticket},
        ],
    )
    return response.output_text.strip().lower()

def main() -> None:
    cases = load_cases(DATASET)
    passed = 0

    for item in cases:
        actual = predict(item["input"])
        ok = actual == item["expected"]
        passed += int(ok)
        result = "PASS" if ok else "FAIL"
        print(
            f'{item["id"]} expected={item["expected"]} '
            f"actual={actual} {result}"
        )

    accuracy = passed / len(cases)
    print(
        f"summary model={MODEL} prompt={PROMPT_VERSION} "
        f"passed={passed}/{len(cases)} accuracy={accuracy:.4f}"
    )
    if accuracy < THRESHOLD:
        sys.exit(1)

if __name__ == "__main__":
    main()
运行前设置 OPENAI_API_KEY,并确保数据文件名为 eval_cases.jsonl。
EVAL_MODEL=gpt-5.6 EVAL_THRESHOLD=1.0 python eval.py预期输出(三个样本全部命中时):
ticket-001 expected=hardware actual=hardware PASS
ticket-002 expected=software actual=software PASS
ticket-003 expected=other actual=other PASS
summary model=gpt-5.6 prompt=ticket-v1 passed=3/3 accuracy=1.0000若模型输出变化,actual、通过数和准确率会随之变化;低于阈值时应保留失败样本并返回非零退出码,而不是修改期望答案迎合候选版本。
输出字段说明
passed/total 是总体通过数,accuracy 用于基线对比,prompt 和 model 用于复现结果。生产报告还应保存失败样本 ID、原始输出、延迟、令牌用量和运行时间,但不要把密钥或完整敏感输入写入公开 CI 日志。
风险与边界
训练集、调试样本和最终评测集混用会造成虚高分数。安全做法是保留独立的回归集,并持续加入线上真实失败样本;新增样本后同时记录业务规则变化。
模型评分器可能偏爱冗长答案或与被测模型共享同类偏差。高风险任务应组合确定性规则、另一模型评分和抽样人工复核,不要仅凭单一模型评分自动上线。
数据集过小或只覆盖正常路径时,通过率无法代表生产质量。至少覆盖常见输入、边界条件、拒答、安全约束和工具调用失败,并按业务重要性分别设阈值。
client.files.create(file=open("<TRAIN.jsonl>", "rb"), purpose="fine-tune")
client.fine_tuning.jobs.create(training_file="<FILE_ID>", model="<BASE_MODEL>", method={"type": "supervised"})
client.fine_tuning.jobs.retrieve("<JOB_ID>")
准备训练数据并创建、验证和使用定制微调模型。
创建微调模型
用于把稳定、重复且可示范的任务行为固化到定制模型中,例如分类、固定格式输出、细粒度翻译或长期存在的指令遵循问题。先建立独立评测基线,再证明微调模型优于基础模型;不要用微调保存频繁变化的业务知识。
截至 2026-08-02,OpenAI 正在逐步关闭微调平台:新用户已无法开通,现有用户仅能在过渡期继续创建训练任务;已生成模型可使用到其基础模型退役。无权限或新项目应优先采用更强基础模型、少样本提示、结构化输出或 RAG。
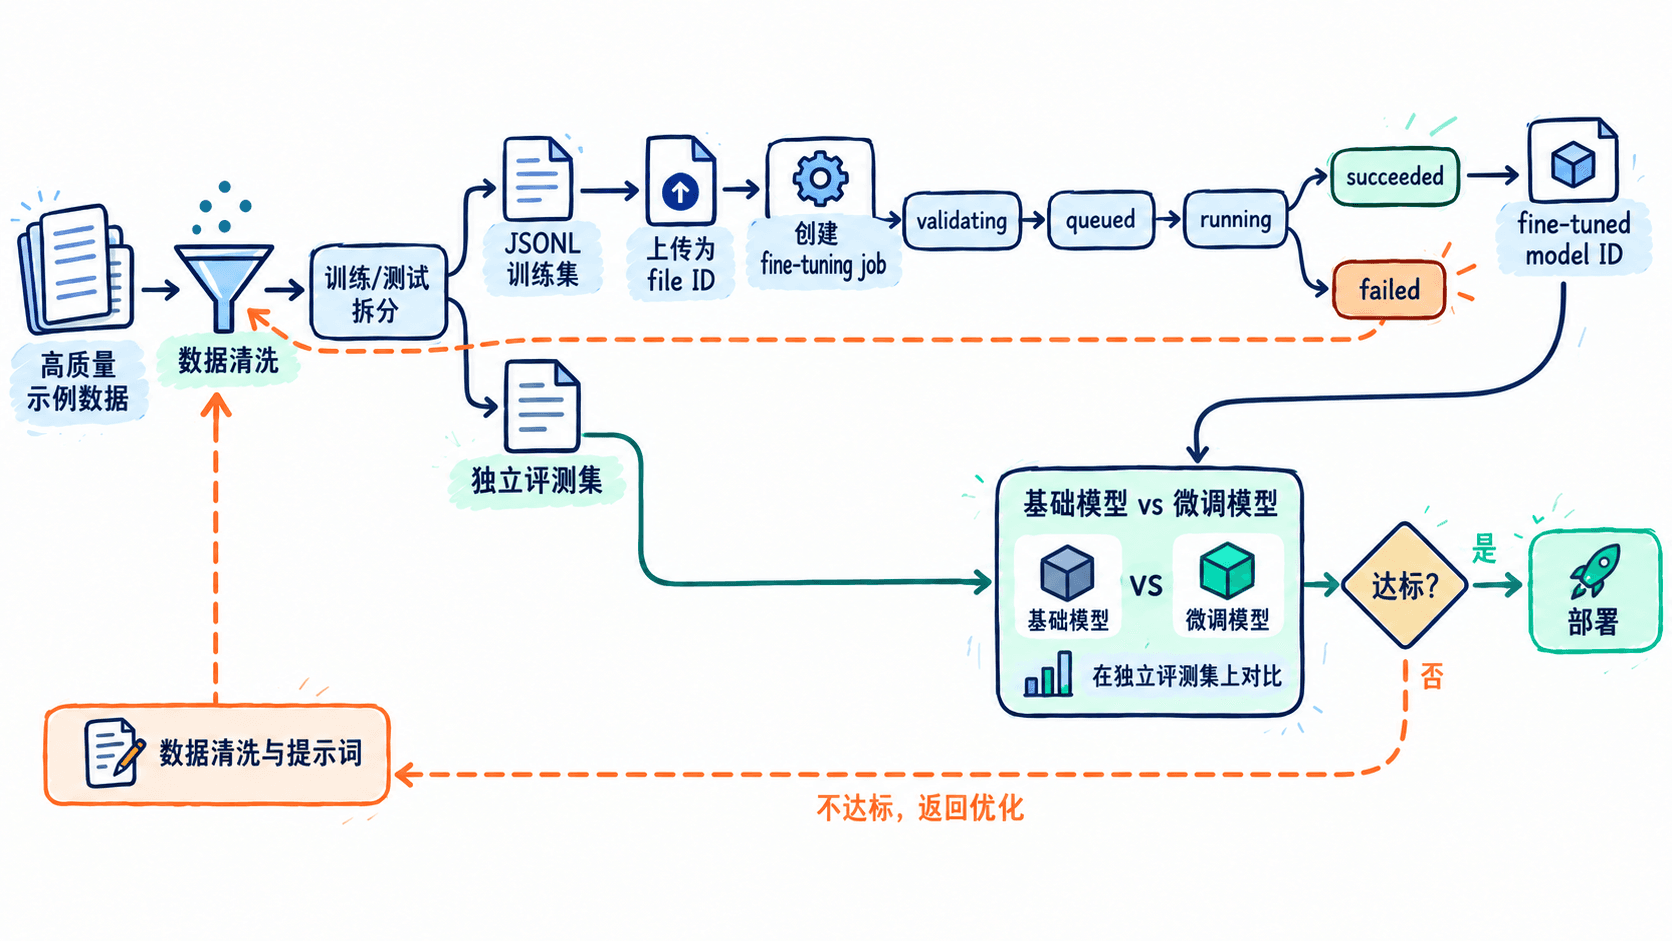
前置判断
监督微调文件必须使用 JSONL,每行一个完整的聊天样本,并至少包含 10 行。少量任务可先从约 50 条高质量示范开始;数据质量、覆盖面和标注一致性通常比盲目增加数量更重要。
训练集只用于学习,测试集只用于比较基础模型与微调模型。若目标是回答最新商品、政策或内部文档,改用检索增强;微调不会自动同步知识变化。
准备训练数据
下面创建 10 条三分类示例。开发者指令应与线上调用保持一致,助手答案只保留期望标签。
cat > train.jsonl <<'JSONL'
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"我的银行卡被重复扣款两次"},{"role":"assistant","content":"billing"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"发票金额与订单金额不一致"},{"role":"assistant","content":"billing"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"退款已经批准但余额还没有到账"},{"role":"assistant","content":"billing"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"应用升级后一直停在启动页面"},{"role":"assistant","content":"technical"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"调用接口持续返回五百错误"},{"role":"assistant","content":"technical"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"上传附件时提示网络连接中断"},{"role":"assistant","content":"technical"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"我忘记密码并且收不到重置邮件"},{"role":"assistant","content":"account"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"需要修改账号绑定的手机号"},{"role":"assistant","content":"account"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"登录后提示账号已被锁定"},{"role":"assistant","content":"account"}]}
{"messages":[{"role":"developer","content":"Classify the request as exactly one lowercase label: billing, technical, or account."},{"role":"user","content":"订阅取消后仍然收到了续费通知"},{"role":"assistant","content":"billing"}]}
JSONL
wc -l train.jsonl
预期输出:
10 train.jsonl创建、监控并使用模型
该脚本上传训练文件、创建监督微调任务、轮询到终态,并在成功后用返回的模型 ID 发起一次推理。任务会产生训练费用;先在非生产项目和小数据集上验证。
from __future__ import annotations

import os
import time
from pathlib import Path

from openai import OpenAI

TRAIN_FILE = Path(os.getenv("TRAIN_FILE", "train.jsonl"))
BASE_MODEL = os.getenv("BASE_MODEL", "gpt-4.1-nano-2025-04-14")
POLL_SECONDS = int(os.getenv("POLL_SECONDS", "30"))
TERMINAL_STATUSES = {"succeeded", "failed", "cancelled"}

client = OpenAI()

def main() -> None:
    if not TRAIN_FILE.exists():
        raise FileNotFoundError(TRAIN_FILE)

    with TRAIN_FILE.open("rb") as file:
        uploaded = client.files.create(file=file, purpose="fine-tune")
    print(f"uploaded_file={uploaded.id}")

    job = client.fine_tuning.jobs.create(
        training_file=uploaded.id,
        model=BASE_MODEL,
        method={"type": "supervised"},
    )
    print(f"fine_tuning_job={job.id} status={job.status}")

    last_status = job.status
    while job.status not in TERMINAL_STATUSES:
        time.sleep(POLL_SECONDS)
        job = client.fine_tuning.jobs.retrieve(job.id)
        if job.status != last_status:
            print(f"status={job.status}")
            last_status = job.status

    if job.status != "succeeded" or not job.fine_tuned_model:
        error_message = job.error.message if job.error else "no error details"
        raise RuntimeError(f"job ended with {job.status}: {error_message}")

    model_id = job.fine_tuned_model
    print(f"fine_tuned_model={model_id}")

    response = client.responses.create(
        model=model_id,
        input=[
            {
                "role": "developer",
                "content": (
                    "Classify the request as exactly one lowercase label: "
                    "billing, technical, or account."
                ),
            },
            {"role": "user", "content": "为什么这个月扣了两次订阅费"},
        ],
    )
    print(f"prediction={response.output_text.strip().lower()}")

if __name__ == "__main__":
    main()
运行脚本:
python fine_tune.py预期输出格式如下,ID、状态停留时间和状态切换次数以实际任务为准:
uploaded_file=<FILE_ID>
fine_tuning_job=<FT_JOB_ID> status=validating_files
status=<QUEUED_OR_RUNNING>
status=succeeded
fine_tuned_model=<FT_MODEL_ID>
prediction=billing
验证与上线
不要用训练文件证明效果。使用独立测试集分别运行基础模型和微调模型,对比总体准确率、各类别召回率、格式合规率、延迟和成本;只有核心指标超过预设阈值且关键失败样本没有回归时才替换生产模型。
保留 training_file、基础模型快照、任务 ID、微调模型 ID、数据版本和评测报告。线上调用必须使用返回的完整 fine_tuned_model,不要根据示例自行拼接模型名称。
风险与排障
invalid_file_format 通常由非 JSONL、空行中的非法字符、角色字段错误或少于 10 个样本触发。先逐行执行 JSON 解析,再确认每行都有 messages 和期望的 assistant 回答。
任务进入 failed 时读取作业的 error 和事件列表,不要重复提交相同文件。model_not_found 或不支持微调时,改用组织当前可选的基础模型快照,而不是删除版本后缀猜测模型名。
训练数据含冲突标签、过多拒答或不真实答案时,模型会复制这些缺陷;可能造成过拟合、错误拒答或幻觉。安全替代方案是先修正和去重数据,缩小任务范围,并用少样本提示或 RAG 验证是否已足够。
微调模型会随基础模型退役而不可用。生产系统应保存基础模型回退路径、独立评测集和迁移脚本,禁止把单一微调模型当作永久依赖。
client.responses.create(model="<MODEL>", instructions="<原 system 消息>", input="<原 user 消息>", store=True, previous_response_id="<RESPONSE_ID>")将 Chat Completions 调用和对话状态迁移到 Responses API。
迁移到 Responses API
将 Chat Completions 迁移为 Responses API 时,核心不是只替换端点,而是同时调整输入字段、输出读取方式和多轮状态保存。简单文本调用可直接迁移;函数工具、结构化输出和历史消息需要逐项改造。
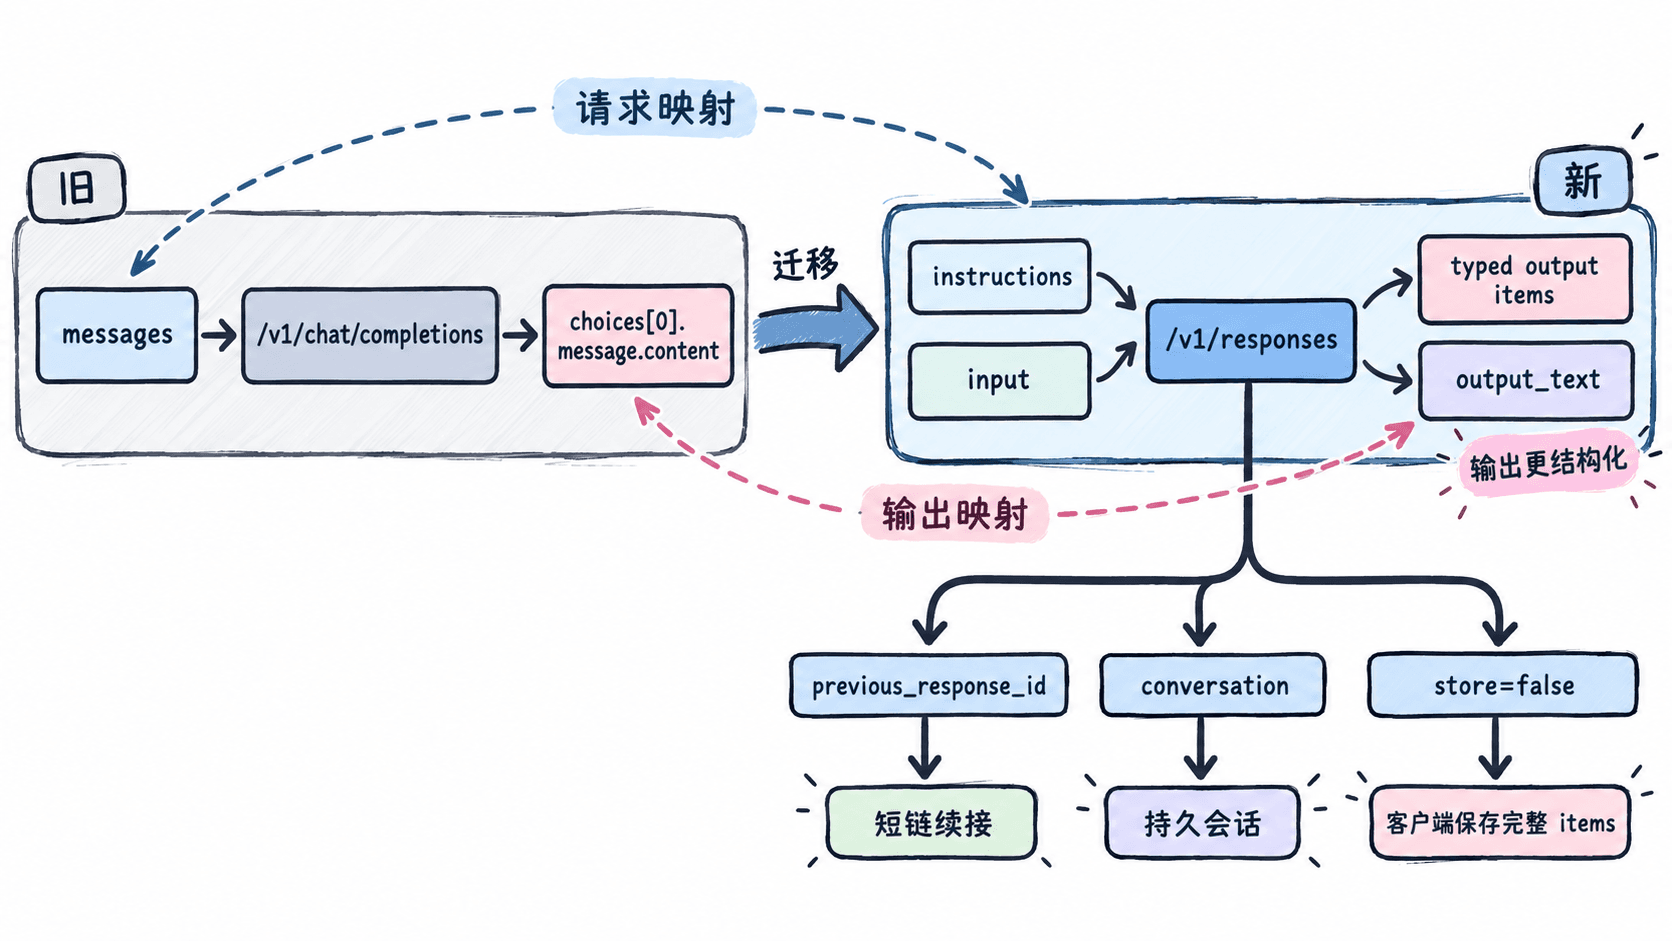
字段迁移
| Chat Completions | Responses API | 迁移要点 |
|---|---|---|
POST /v1/chat/completions |
POST /v1/responses |
SDK 改为 client.responses.create() |
messages |
input |
纯文本消息数组通常可直接作为 input |
system 消息 |
instructions 或输入项 |
固定系统约束优先放 instructions |
choices[0].message.content |
response.output_text |
仅取最终文本时使用便捷字段 |
choices |
output items |
工具调用、推理项和消息需按 type 处理 |
| 手工追加历史消息 | previous_response_id、conversation 或完整 items |
三种状态策略只选一种主路径 |
response_format |
text.format |
结构化输出的请求结构不同 |
Responses API 每次只返回一个生成结果,不再提供 n 并行候选。需要多个候选时,由客户端发起多次独立请求并自行排序。
主示例:迁移两轮对话
运行前设置 OPENAI_API_KEY。示例使用服务端保存的响应 ID 续接上下文,适合短会话或单链路问答。
import os

from openai import OpenAI

client = OpenAI()
model = os.getenv("OPENAI_MODEL", "gpt-5.6")

# 使用服务端响应 ID 串联下一轮,避免手工拼接历史。
first = client.responses.create(
    model=model,
    instructions="你是生产排障助手,回答必须给出可执行检查步骤。",
    input="服务出现 HTTP 502,先给出三个检查方向。",
    store=True,
)

second = client.responses.create(
    model=model,
    previous_response_id=first.id,
    input="把第二个方向展开成 Linux 命令。",
    store=True,
)

print(f"first_id={first.id}")
# output_text 只适合读取最终文本;工具调用应遍历 output items。
print(f"first_text={first.output_text}")
print(f"second_text={second.output_text}")
预期输出
first_id=resp_<ID>
first_text=<三个 HTTP 502 检查方向>
second_text=<针对第二个方向的 Linux 检查命令>
<ID> 和模型文本每次可能不同。业务日志至少记录响应 ID、模型、耗时和错误类型,避免记录密钥或未经脱敏的用户内容。
状态选择
previous_response_id 最省代码,适合同一条响应链继续追问;调用方只保存上一次响应 ID。需要跨设备、跨任务长期复用同一上下文时,创建 Conversation,并在后续请求传入 conversation。
合规要求禁止服务端存储时,设置 store=False,由应用保存并重新提交完整 input/output items。此时不要只保存 output_text,否则工具调用、推理项或其他上下文会丢失。
风险与边界
仅把 messages 改成 input,但仍读取 choices,会触发字段不存在或空结果。安全做法是先封装统一的文本读取函数,同时保留对 response.output 的类型分派。
函数工具和结构化输出的 JSON 结构与 Chat Completions 不完全相同。直接复用旧工具定义可能导致 400、参数校验失败或工具无法执行;应按 Responses 的扁平函数定义和 text.format 重写,并对每个工具做回归测试。
Responses 默认可能保存响应。传入敏感数据且未评估存储策略时,可能违反内部合规要求;安全替代是显式设置 store=False,并在自有存储中实施加密、脱敏和生命周期控制。
排障清单
- 返回 400 且提示未知字段:确认使用
input,不要把旧请求体原样发送到/v1/responses。 - 文本为空:检查
response.status、response.error和response.output,不要只假设一定存在output_text。 - 第二轮失忆:确认传入正确的
previous_response_id、conversation,或重新提交完整历史 items。 - 工具循环卡住:检查
function_call的call_id是否与后续function_call_output一一对应。 - 迁移后结果差异大:固定模型、提示词、工具 schema 和测试样本,再比较输出与 token 使用量。
agent = Agent(name="<NAME>", model="<MODEL>", instructions="<原 Assistant 指令>", tools=[FileSearchTool(vector_store_ids=["<VECTOR_STORE_ID>"])])
Runner.run_sync(agent, "<输入>", session=SQLiteSession("<原 Thread ID>"))
将线程、运行、文件和工具能力迁移到 Responses API 与 Agents SDK。
迁移 Assistants API
Assistants API 已弃用,并计划于 2026 年 8 月 26 日关闭。迁移时要把 Assistant、Thread、Run、Run Step、文件检索和函数工具分别落到 Responses API、Conversations API 或 Agents SDK,不能只替换一个调用方法。
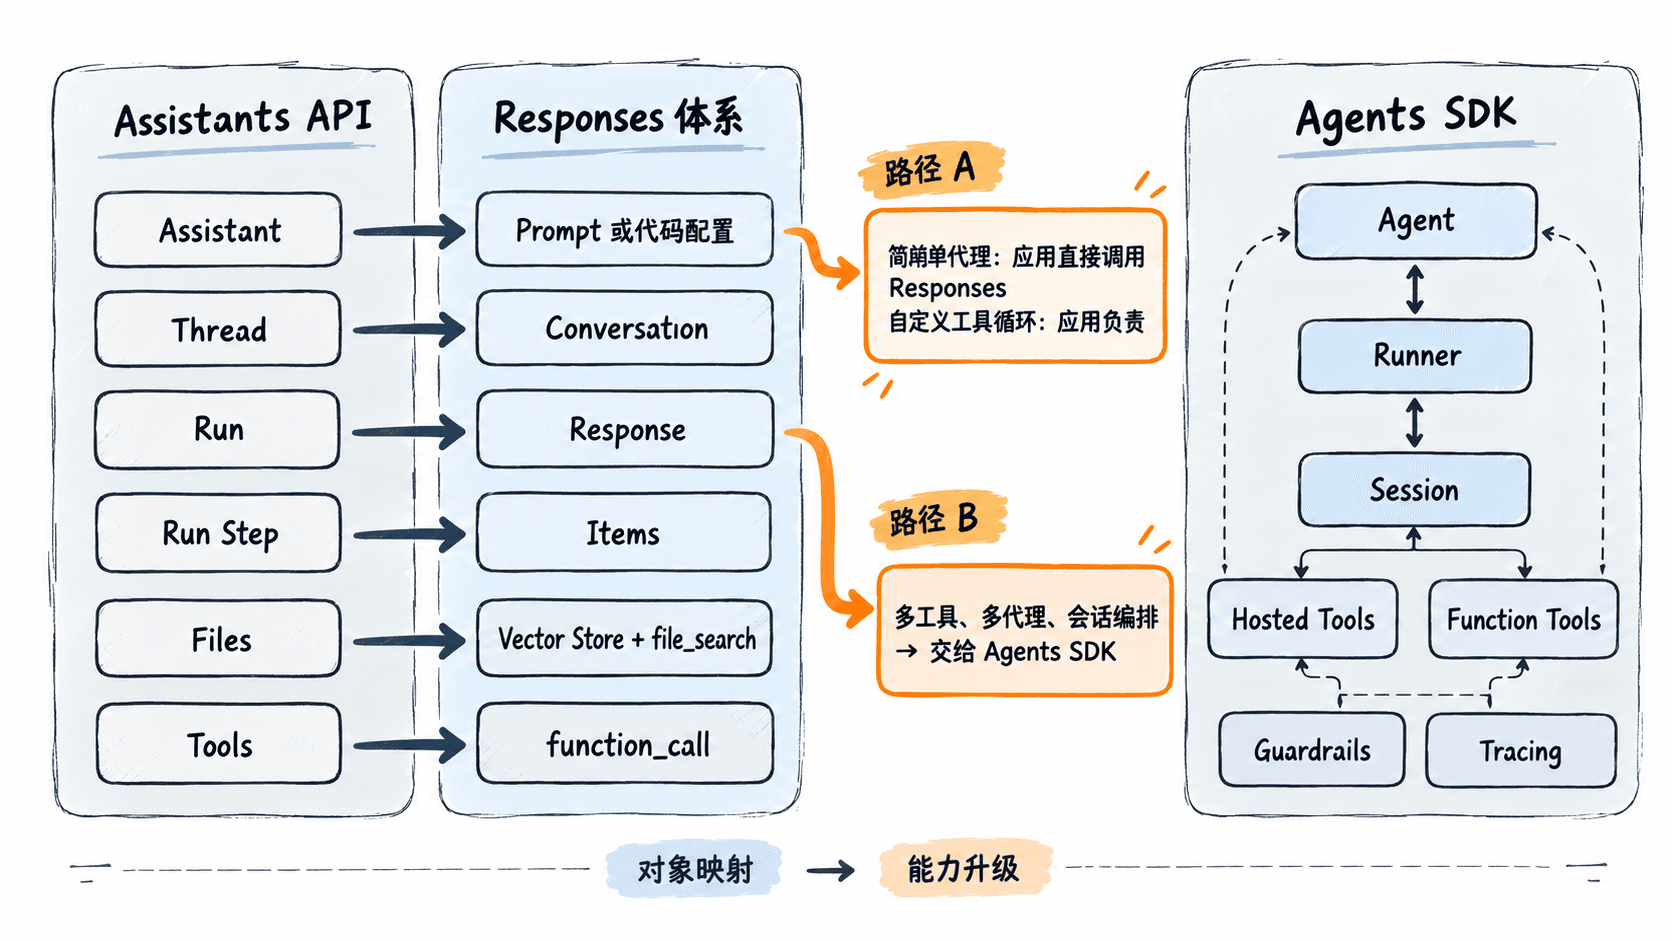
对象映射
| Assistants API | 迁移目标 | 处理方式 |
|---|---|---|
| Assistant | Prompt 配置或 Agents SDK Agent |
将 instructions、model、tools 拆为可版本化配置 |
| Thread | Conversation 或 SDK Session | 保存消息、工具调用和工具输出等 items |
| Run | Response 或 Runner.run() |
直接调用 Responses,或让 Runner 管理执行循环 |
| Run Step | Response items / RunResult | 按 type 读取消息、工具调用、工具输出和状态 |
| File Search 文件 | File API + Vector Store + file_search |
文件入库完成后传 vector_store_ids |
| Function Tool | Responses function tool 或 SDK @tool |
直接模式手工回传工具结果,SDK 模式自动循环 |
| Code Interpreter、Web Search、MCP | Responses hosted tools 或 SDK hosted tools | 按新工具类型重新声明权限与参数 |
简单问答、少量工具且需要完全控制状态时,直接使用 Responses API。存在多轮工具调用、handoff、guardrail、会话存储或 tracing 时,使用 Agents SDK 可减少自建运行循环。
主示例:会话、文件检索和函数工具
前置条件是已经把文件加入 Vector Store,并等待文件状态变为 completed。环境变量 OPENAI_VECTOR_STORE_ID 应为 vs_<ID>;示例用 SQLite Session 替代 Thread,并由 Runner 自动执行工具循环。
import os

from agents import Agent, FileSearchTool, Runner, SQLiteSession
from agents.decorators import tool

# Vector Store 中的文件必须已完成索引。
vector_store_id = os.environ["OPENAI_VECTOR_STORE_ID"]
model = os.getenv("OPENAI_MODEL", "gpt-5.6")

@tool
def lookup_order(order_id: str) -> str:
    """查询演示订单状态。生产环境应调用真实订单服务。"""
    demo_orders = {"A100": "paid", "A101": "refunded"}
    return demo_orders.get(order_id, "not_found")

# Runner 负责执行工具并把结果回传模型,避免手写工具循环。
agent = Agent(
    name="Support Assistant",
    model=model,
    instructions=(
        "回答退款问题时先检索知识库;涉及订单状态时调用 lookup_order。"
        "明确区分制度规则与实时订单状态。"
    ),
    tools=[
        FileSearchTool(
            vector_store_ids=[vector_store_id],
            max_num_results=3,
        ),
        lookup_order,
    ],
)

# Session ID 应稳定映射业务会话,用来替代旧 Thread。
session = SQLiteSession("support-user-42")
result = Runner.run_sync(
    agent,
    "先根据知识库说明退款条件,再查询订单 A100 当前状态。",
    session=session,
)

print(result.final_output)
预期输出
<根据向量库内容生成的退款条件;订单 A100 状态为 paid>最终措辞取决于向量库内容和模型输出。若知识库没有相关资料,应返回资料不足,而不是编造退款规则。
迁移顺序
先冻结旧 Assistant 的 instructions、模型、工具 schema 和输出样本,建立回归基线。随后让所有新会话写入 Conversation 或 SDK Session,旧 Thread 只按活跃度回填,避免一次性搬迁全部历史。
文件迁移时复用或新建 Vector Store,把旧文件关联到目标知识库并等待索引完成。最后迁移函数工具、并行调用、审批和错误恢复,再切换流量;切换期间同时记录旧 Run 与新 Response 的延迟、token 和业务成功率。
风险与边界
在 2026 年 8 月 26 日后仍调用 Assistants API,会直接造成生产请求失败。安全替代是在关闭日前完成双写或灰度切流,并准备按用户或租户快速回退到已验证的新实现。
Thread 不会自动转换为 Conversation。直接丢弃旧 Thread 会造成历史上下文缺失;安全做法是新会话先迁移,只回填仍活跃的 Thread,并按时间升序转换文本、图片和工具相关内容。
File Search 不能只传旧 Assistant 的文件 ID。文件未加入 Vector Store 或索引未完成时,检索结果会为空;应等待状态 completed 后再开放流量,并监控检索命中率。
直接调用 Responses 时,应用必须处理 function_call、执行业务函数,再用相同 call_id 提交 function_call_output。遗漏任一步会让执行停在工具调用阶段;复杂工具循环优先交给 Agents SDK Runner。
SDK Session 与 conversation_id、previous_response_id 属于不同状态策略,同一次运行不要混用。混用可能产生重复历史或参数冲突;生产中应为每条链路固定一种状态所有权。
排障清单
- 新会话不记忆:确认复用了同一个 Conversation ID 或 Session ID,而不是每次重新创建。
- 文件检索为空:检查文件、Vector Store 关联关系、索引状态和
vector_store_ids。 - 工具被重复执行:为有副作用的工具增加幂等键,并记录工具调用 ID。
- Runner 超过最大轮次:检查工具返回是否可被模型理解,以及 instructions 是否造成循环调用。
- 输出与旧 Assistant 不一致:对齐模型、instructions、工具 schema、历史顺序和结构化输出约束后再比较。
- 生产难以追踪:保留 Response ID、Session/Conversation ID、工具调用耗时和 tracing 标识,敏感参数先脱敏。
OPENAI_MODEL_PRIMARY=<固定的模型快照>
OPENAI_MODEL_FALLBACK=<备用模型>
client.responses.create(model=<PRIMARY 或 FALLBACK>, input=...)
固定生产模型版本并为模型升级、替换和弃用制定兼容方案。
处理模型弃用
用于在模型进入弃用期后,完成影响盘点、候选模型评测、灰度切换和回滚准备,避免到停用日期才发现请求失败。OpenAI 会在弃用页列出停用日期和推荐替代项;除安全或合规原因外,通用可用模型通常至少提前 6 个月通知,专用变体通常至少提前 3 个月通知。:contentReference[oaicite:0]{index=0}
固定生产模型
把生产模型标识集中到环境变量或配置中心,不要散落在代码、Prompt 模板和任务脚本中。对支持固定版本标识的模型,生产优先固定版本;稳定别名可以用于开发跟踪,但切换前仍要经过评测门禁。
openai:
  model:
    primary: "${OPENAI_MODEL_PRIMARY}"
    fallback: "${OPENAI_MODEL_FALLBACK:}"
  migration:
    candidate: "${OPENAI_MODEL_CANDIDATE:}"
生效行为:正常流量只使用 primary;candidate 仅用于离线评测或影子调用;fallback 为空时禁止静默降级。验证时打印启动后的最终模型配置,但日志中不得输出 API Key。
迁移流程
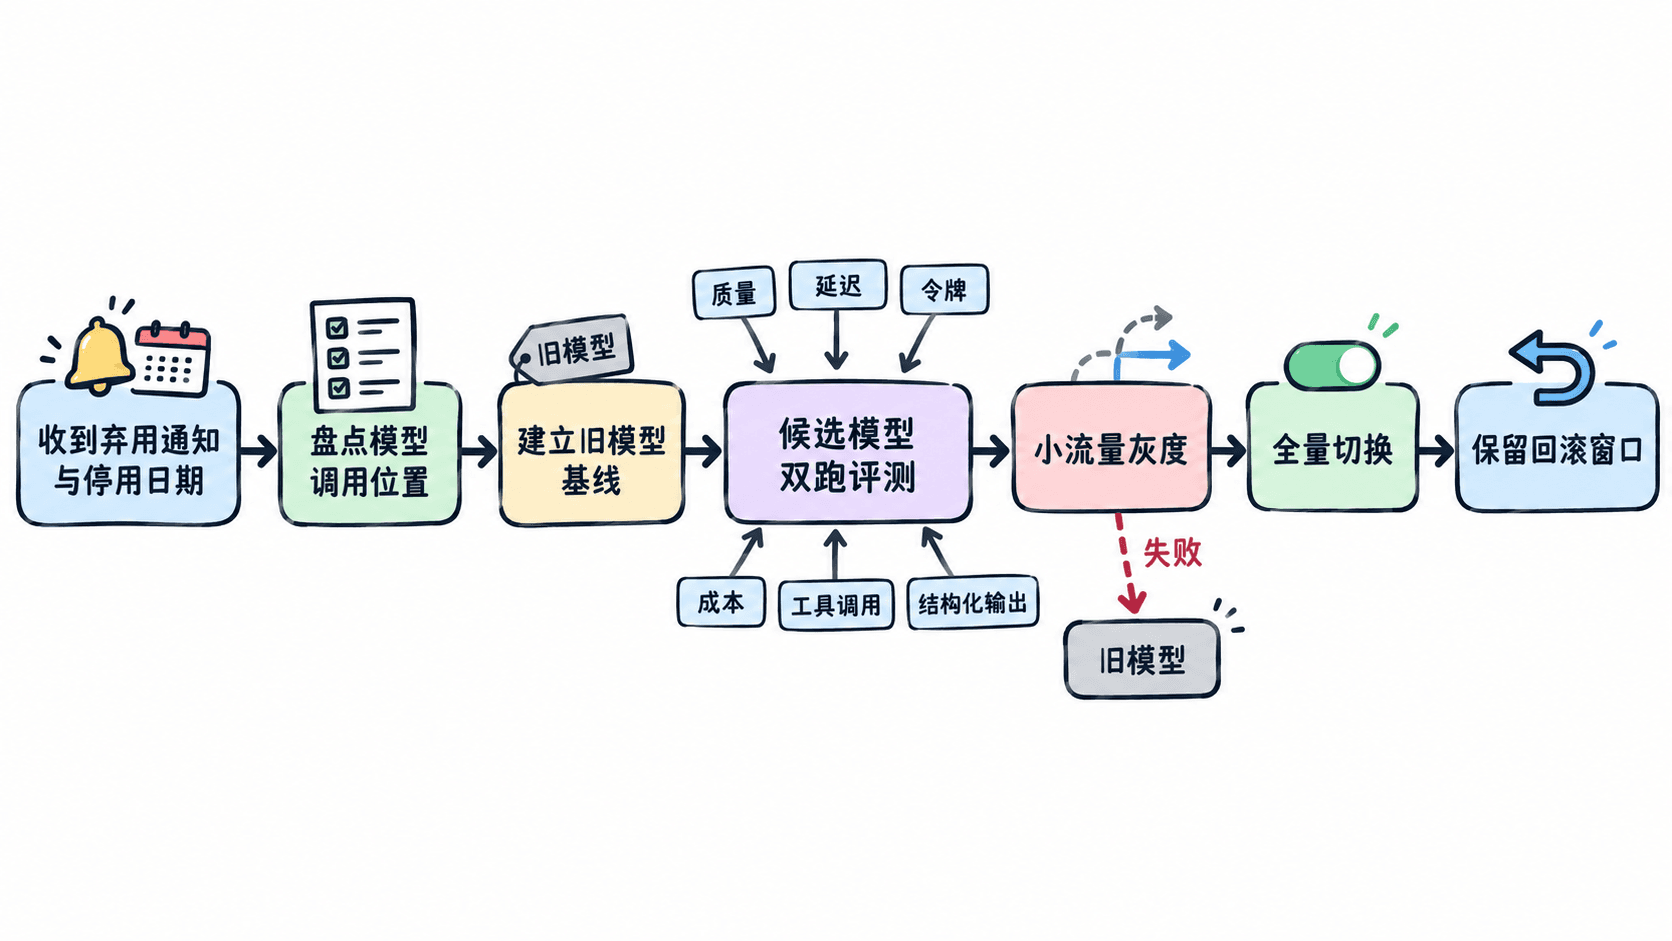
先搜索模型标识在源码、配置中心、定时任务、批处理、微服务和第三方工作流中的全部引用,再记录接口类型、Prompt 版本、工具定义、输出解析器及负责人。随后使用同一批代表性样本双跑旧模型与候选模型,只改变模型和确实不兼容的参数。
官方部署指南建议迁移初次比较时保持原工作负载角色和推理设置,并比较任务成功率、延迟、输入输出及推理令牌、缓存写入和单次成功任务成本。:contentReference[oaicite:1]{index=1}
双跑验证
保存为 compare_models.py,运行前安装最新版 openai 包,并设置 OPENAI_API_KEY、OPENAI_MODEL_CURRENT、OPENAI_MODEL_CANDIDATE。
import os
import time
from openai import OpenAI

client = OpenAI()
prompt = "将工单内容分类为 billing、technical 或 other,只输出分类名。工单:登录后页面持续返回 502。"
models = {
    "current": os.environ["OPENAI_MODEL_CURRENT"],
    "candidate": os.environ["OPENAI_MODEL_CANDIDATE"],
}

for label, model in models.items():
    started = time.perf_counter()
    response = client.responses.create(model=model, input=prompt)
    latency_ms = int((time.perf_counter() - started) * 1000)
    print(
        f"{label} model={model} latency_ms={latency_ms} "
        f"text={response.output_text.strip()}"
    )
预期输出:
current model=<CURRENT_MODEL> latency_ms=<N> text=technical
candidate model=<CANDIDATE_MODEL> latency_ms=<N> text=technical
<N> 与模型标识按实际环境变化。真实迁移不能只看单条结果,应使用覆盖正常、边界、拒答、长上下文、工具失败和结构化输出的评测集,并设置可量化的通过阈值。
风险与边界
- 停用日期已到仍调用旧模型:请求可能因模型已从 API 移除而失败;安全替代是提前完成候选评测、灰度和配置切换。:contentReference[oaicite:2]{index=2}
- 直接替换模型并同时修改 Prompt:质量变化无法归因,回滚也困难;先只换模型,稳定后再单独优化 Prompt。
- 自动回退到任意模型:可能改变输出格式、工具行为、成本或合规边界;只允许经过评测的白名单回退,并在每次触发时告警。
- 只验证 HTTP 200:模型可能仍返回不可解析内容;必须同时检查业务正确率、JSON Schema、工具参数、延迟分位数和单位成本。
速查原则:弃用通知当天完成影响盘点,停用日前完成双跑、灰度、全量切换和回滚演练。
: "${OPENAI_API_KEY:?}" "${OPENAI_MODEL:?}"
POST /v1/responses   # 冒烟请求:核对状态码、x-request-id、耗时与 usage
在生产发布前检查安全、配额、超时、监控、评测和降级策略。
完成 OpenAI API 上线检查
用于生产发布前做最后门禁,确认密钥、项目隔离、配额、超时、重试、监控、评测和降级都已落地。官方建议将测试与生产放在独立项目中,并分别限制访问权限、速率和支出,避免测试流量影响线上。:contentReference[oaicite:3]{index=3}
发布门禁
| 检查项 | 通过条件 | 不通过时处理 |
|---|---|---|
| 密钥与权限 | Key 仅存在于服务端密钥管理系统,按项目和服务最小授权 | 撤销暴露 Key,轮换后再发布 |
| 配额与成本 | 已确认速率限制、月度预算、告警阈值及扩容流程 | 降并发或申请额度,禁止带缺口上线 |
| 超时与重试 | 连接、总请求和业务超时均有限值;重试有次数、总时长和抖动 | 补齐超时,移除无限重试 |
| 质量与安全 | 代表性评测集通过,输入输出安全策略已验证 | 阻断发布并修复失败样本 |
| 可观测性 | 能查询状态码、延迟、模型、响应 ID、令牌、重试和降级次数 | 先补日志、指标与告警 |
| 降级与回滚 | 可关闭 AI 功能、切换已验证模型或转人工队列 | 完成演练后再放量 |
API Key 不应写入源码或公开仓库,应通过环境变量或密钥管理服务注入;生产和预发项目应分离。:contentReference[oaicite:4]{index=4}
上线冒烟验证
脚本依赖 curl 和 jq,使用 Responses API 发起最小请求。官方当前部署清单将 Responses API 作为新集成的起点。:contentReference[oaicite:5]{index=5}
set -euo pipefail

: "${OPENAI_API_KEY:?missing OPENAI_API_KEY}"
: "${OPENAI_MODEL:?missing OPENAI_MODEL}"

body="$(mktemp)"
headers="$(mktemp)"
trap 'rm -f "$body" "$headers"' EXIT

payload="$(jq -nc --arg model "$OPENAI_MODEL" \
  '{model: $model, input: "只回复 READY"}')"

status="$(curl -sS \
  --connect-timeout 5 \
  --max-time 30 \
  -D "$headers" \
  -o "$body" \
  -w '%{http_code}' \
  https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "$payload")"

if [ "$status" != "200" ]; then
  cat "$body" >&2
  exit 1
fi

text="$(jq -r '[.output[]? | select(.type == "message") |
  .content[]? | select(.type == "output_text") | .text] | join("")' "$body")"
response_id="$(jq -r '.id' "$body")"

test "$text" = "READY"
printf 'status=%s response_id=%s text=%s\n' "$status" "$response_id" "$text"
预期输出:
status=200 response_id=<ID> text=READY<ID> 为动态响应标识。冒烟通过只证明认证、网络、模型访问和基础解析正常,不能替代负载测试、业务评测和故障演练。
超时、重试与配额
遇到临时 429 时,优先遵循有效的 Retry-After,否则使用带随机抖动的指数退避,同时限制尝试次数和总重试时间;不要重试配额、账单或需要人工处理的错误。失败请求也会计入每分钟限制,持续立即重发会放大故障。:contentReference[oaicite:6]{index=6}
支出告警只通知而不会停止流量;硬支出上限达到后会使受影响请求返回 429,因此应在硬上限前设置多级告警,并确认降级路径不会造成请求风暴。:contentReference[oaicite:7]{index=7}
监控与告警
至少记录 status_code、latency_ms、模型标识、响应 ID、输入输出令牌、重试次数、错误类型、降级结果和业务成功标记。告警应覆盖错误率突增、P95/P99 延迟、429、鉴权失败、解析失败、单位请求成本和评测指标下降。
安全场景应在上线前验证输入输出过滤和滥用处理;OpenAI 提供可用于减少不安全内容的 Moderation API。:contentReference[oaicite:8]{index=8}
风险与边界
- Key 出现在浏览器、移动端或仓库:可能被盗用并产生数据与费用风险;只允许服务端持有,并立即轮换已泄露 Key。
- 将全部错误都重试:配额或账单错误不会自行恢复,可能形成重试风暴;仅对白名单临时错误重试。
- 硬支出上限贴近正常峰值:达到阈值后生产请求会被中断;先设置告警缓冲,再准备排队、只读、模板回复或转人工方案。
- 只有技术冒烟没有业务评测:接口可用但结果可能不可用;发布门禁必须包含代表性样本、结构校验和回归阈值。
最终放量前执行一次“超时、429、模型不可用、解析失败、成本超限”故障演练,并确认告警、降级和回滚均能在预定时间内生效。