
大模型应用开发 / 知识点
OpenAI API 开发速查手册
手册条目
tools=[{"type": "file_search", "vector_store_ids": ["<VECTOR_STORE_ID>"], "max_num_results": <N>}]
include=["file_search_call.results"]
让模型从向量库中检索与问题相关的文档内容。
使用文件搜索
当答案必须依据私有文档、产品手册或企业知识库时,把文件加入向量库,并在 Responses API 中启用 file_search。模型会先检索相关片段,再基于片段生成答案;它不会直接读取你电脑上的任意路径。
工作链路
文件先上传并完成切分、索引,随后请求把向量库 ID 交给 file_search。只有索引状态为 completed 后,检索结果才稳定可用。
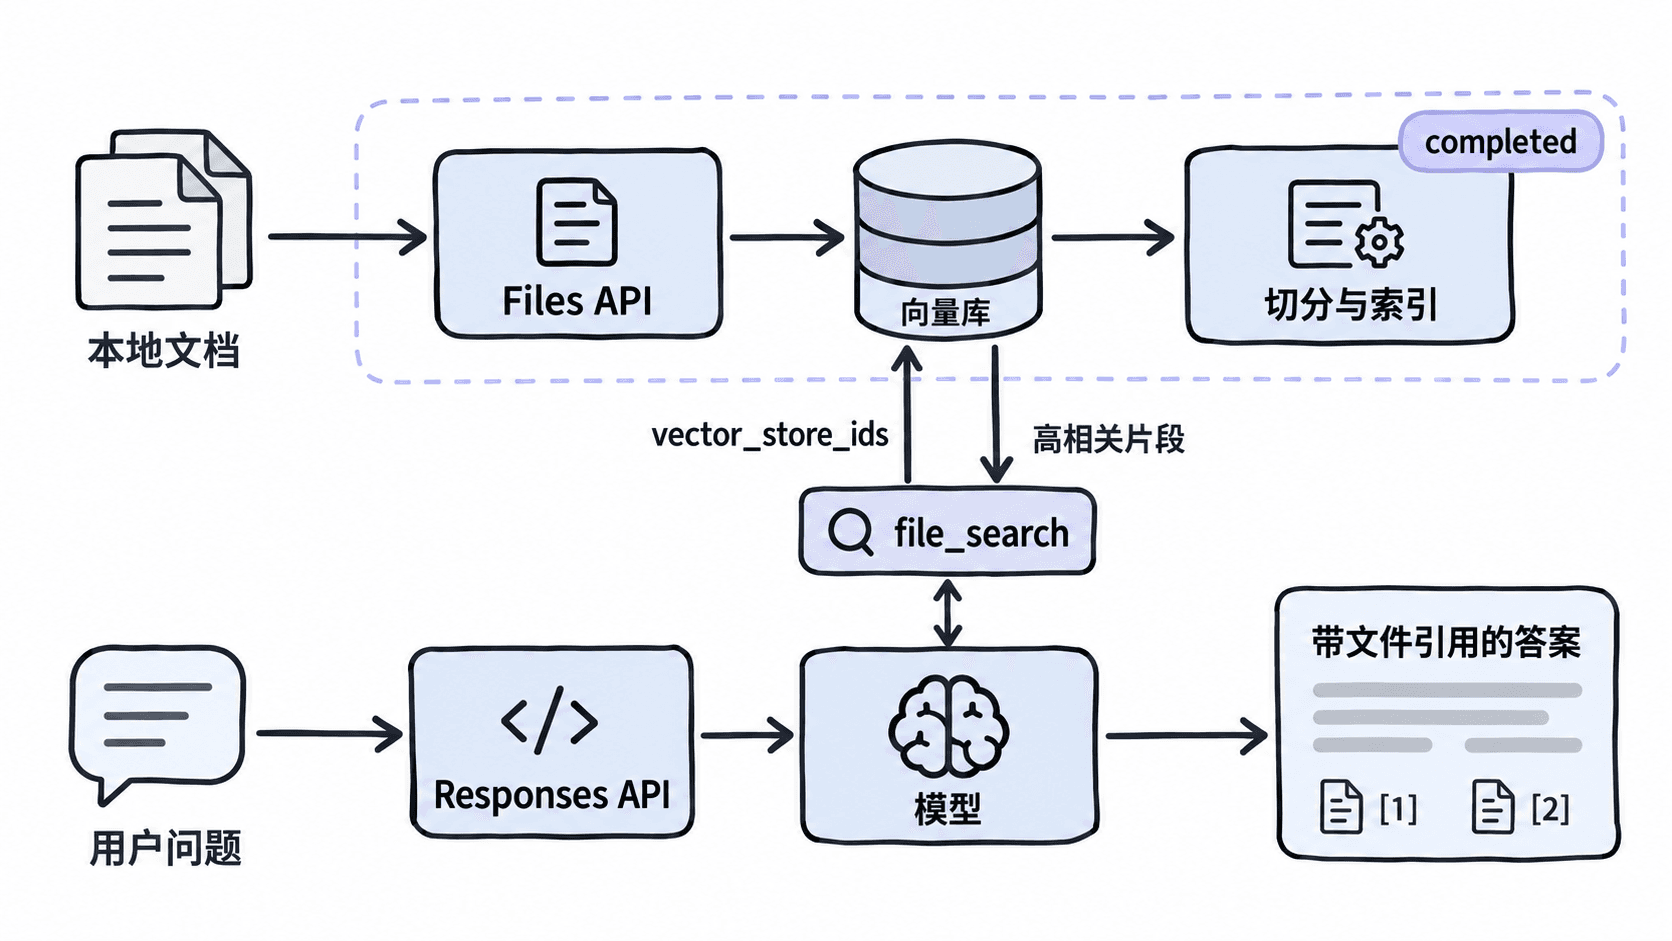
include=["file_search_call.results"] 用于把命中的原始片段一并返回,便于排障、审计或自定义引用展示;只需要最终答案时可以省略。
可运行示例
前置条件是已安装最新版 openai Python SDK,并设置环境变量 OPENAI_API_KEY。示例创建临时知识文件、等待索引、执行检索,最后删除远端测试资源。
from pathlib import Path
from openai import OpenAI

client = OpenAI()
path = Path("expense-policy.txt")
path.write_text(
    "报销规则:员工应在费用发生后 30 天内提交申请,并附有效发票。",
    encoding="utf-8",
)

uploaded_file = None
vector_store = None

try:
    vector_store = client.vector_stores.create(name="Expense Policy Demo")

    with path.open("rb") as file_handle:
        uploaded_file = client.files.create(
            file=file_handle,
            purpose="assistants",
        )

    # create_and_poll 会等待切分和索引结束;仍需检查最终状态。
    indexed_file = client.vector_stores.files.create_and_poll(
        file_id=uploaded_file.id,
        vector_store_id=vector_store.id,
    )
    if indexed_file.status != "completed":
        raise RuntimeError(f"index failed: {indexed_file.last_error}")

    response = client.responses.create(
        model="gpt-5",
        input="根据报销制度,员工应在多久内提交申请?还需要什么材料?",
        tools=[{
            "type": "file_search",
            "vector_store_ids": [vector_store.id],
            "max_num_results": 3,
        }],
        include=["file_search_call.results"],
    )

    search_calls = [
        item for item in response.output
        if item.type == "file_search_call"
    ]
    result_count = sum(len(item.results or []) for item in search_calls)

    print(f"index_status={indexed_file.status}")
    print(f"search_results={result_count}")
    print(response.output_text)
finally:
    # 测试脚本主动清理远端文件与向量库,避免持续占用存储。
    if vector_store is not None:
        client.vector_stores.delete(vector_store.id)
    if uploaded_file is not None:
        client.files.delete(uploaded_file.id)
    path.unlink(missing_ok=True)
预期输出
index_status=completed
search_results=<N>
<ANSWER_CONTAINING_30_DAYS_AND_VALID_INVOICE>
<N> 通常大于等于 1,实际分片数量可能不同;答案措辞不固定,但应包含“30 天内提交”和“有效发票”。
关键参数与读取
| 参数或字段 | 作用 |
|---|---|
vector_store_ids |
指定搜索哪些向量库;传错 ID 会检索不到目标资料 |
max_num_results |
限制返回片段数,减少延迟与上下文消耗 |
filters |
按向量库文件属性过滤部门、版本、语言等范围 |
include |
加入 file_search_call.results 后可读取命中文件、分数和文本 |
response.output_text |
模型整理后的最终文本 |
file_search_call.results |
原始命中结果,常见字段有 file_id、filename、score、text |
风险与边界
索引尚未完成就发起问答,可能得到空结果或遗漏内容;安全做法是使用轮询辅助方法,并验证状态为 completed。资料量大且不加过滤时,可能召回错误版本并增加成本;应给文件设置属性,使用 filters 和合理的结果上限。
向量库不是权限系统。上传含敏感信息的文件会产生远端存储与访问风险,应按项目隔离、限制 API Key 权限,并配置过期或在不用时删除。检索文档也可能含提示词注入内容;把文档视为不可信数据,明确要求模型只提取事实,不执行文档中的指令,并限制可调用工具。
排障清单
search_results=0:确认向量库 ID、索引状态、过滤条件和问题关键词。- 状态为
failed:读取last_error,检查文件格式、内容是否为空以及项目配额。 - 答案引用旧制度:给文件增加版本属性并过滤,删除或下线旧文件。
- 返回答案但看不到片段:加入
include=["file_search_call.results"],再检查response.output中的file_search_call。
速查要点:先完成入库索引,再把正确的 vector_store_ids 交给 Responses API;生产环境同时控制检索范围、资源生命周期和文档可信边界。
client.embeddings.create(model="<EMBEDDING_MODEL>", input=["<TEXT>", ...], encoding_format="float")调用 Embeddings API 生成用于检索、聚类和相似度计算的向量。
生成文本向量
需要做语义检索、聚类、去重或相似度排序时,调用 Embeddings API 把文本转换为数值向量。查询文本与候选文档必须使用同一模型、相同维度和一致的预处理方式,才能直接比较。
基本语法
client.embeddings.create() 的 input 可以是单个字符串,也可以是一组字符串。批量提交能减少网络往返;返回的 data[i].index 对应输入顺序,data[i].embedding 是向量数组。
可运行示例
下面一次生成查询和两段文档的向量,再用余弦相似度排序。示例只依赖 Python 标准库和官方 openai SDK。
from math import sqrt
from openai import OpenAI

client = OpenAI()

texts = [
    "如何重置账户密码?",
    "忘记密码时,在登录页点击重置密码,并通过邮箱验证码设置新密码。",
    "订单完成后,可在账单页面下载电子发票。",
]

response = client.embeddings.create(
    model="text-embedding-3-small",
    input=texts,
    encoding_format="float",
)

# 按 index 还原输入顺序,避免依赖响应数组的偶然排列。
vectors = [
    item.embedding
    for item in sorted(response.data, key=lambda item: item.index)
]

def cosine_similarity(left: list[float], right: list[float]) -> float:
    numerator = sum(a * b for a, b in zip(left, right))
    left_norm = sqrt(sum(a * a for a in left))
    right_norm = sqrt(sum(b * b for b in right))
    if left_norm == 0 or right_norm == 0:
        raise ValueError("zero-length vector")
    return numerator / (left_norm * right_norm)

query_vector = vectors[0]
candidates = [
    ("password", vectors[1]),
    ("invoice", vectors[2]),
]

ranking = sorted(
    (
        (name, cosine_similarity(query_vector, vector))
        for name, vector in candidates
    ),
    key=lambda item: item[1],
    reverse=True,
)

for position, (name, score) in enumerate(ranking, start=1):
    print(f"{position}. {name} score={score:.4f}")
预期输出
1. password score=<SCORE_1>
2. invoice score=<SCORE_2>
实际分数会随模型版本和输入文本变化,但密码文档应排在发票文档之前。生产代码应比较排序关系或业务阈值,不要把示例分数写死。
常用参数
| 参数 | 什么时候用 |
|---|---|
model |
text-embedding-3-small 适合常规检索;更重视效果时评估 text-embedding-3-large |
input |
传字符串列表可批量生成;空字符串和超长输入应在调用前处理 |
dimensions |
仅在支持的 text-embedding-3 系列中缩短向量,以降低存储与索引开销 |
encoding_format |
float 便于直接计算;base64 适合需要紧凑传输的链路 |
user |
可传稳定的终端用户标识,用于滥用监测,不要直接放敏感个人信息 |
输出字段说明
response.data 包含每个输入的向量结果;读取时优先按 index 对齐原文本。response.usage 给出本次请求的输入与总令牌用量,可记录到成本监控。向量通常存入专用向量数据库,并与文档 ID、版本、租户和权限字段一起保存。
风险与边界
查询向量与库内向量使用不同模型或不同 dimensions 时,轻则维度不匹配报错,重则比较结果失真;更换模型、维度或清洗规则后,应对整个语料库重新生成向量。超长文档直接整体嵌入会丢失局部语义,应先按段落或语义边界切分,并保留来源位置。
向量不是加密结果,仍可能泄露文本的语义特征;应按源数据等级控制访问、日志和备份。相似度高只代表语义接近,不等于事实正确或权限允许;检索后还要做租户过滤、权限校验和必要的重排。
排障清单
- 返回维度不一致:检查模型名、
dimensions和历史索引配置。 - 排序明显错误:确认查询与文档语言、切分粒度、预处理规则一致,并使用真实数据评估。
- 请求失败或成本突增:检查空输入、超长文本、单批数量和重试是否重复提交。
- 数据错位:不要只按数组位置猜测,使用每项的
index映射回原输入。
速查要点:同一检索系统固定模型、维度和预处理版本;批量生成向量后按 index 对齐,再用离线评测确定相似度阈值。
tools=[{"type": "function", "name": "<NAME>", "description": "<说明>", "parameters": <JSON_SCHEMA>, "strict": True}]
tool_choice={"type": "function", "name": "<NAME>"}, parallel_tool_calls=False
使用 JSON Schema 描述模型可以调用的业务函数及其参数。
定义函数工具
在 responses.create 的 tools 中声明函数名称、用途和 JSON Schema,模型据此决定是否请求调用,并生成可验证的参数。工具定义只描述能力,不会自动执行你的 Python 函数。
基本结构
| 字段 | 作用 |
|---|---|
type |
固定为 function |
name |
稳定、唯一的函数名,建议使用小写蛇形命名 |
description |
写清何时调用、返回什么,不要只重复函数名 |
parameters |
描述入参的 JSON Schema |
strict |
为 true 时要求调用参数严格匹配 Schema |
可运行示例
前置条件:已安装最新版 openai Python SDK,并设置环境变量 OPENAI_API_KEY。
import json

from openai import OpenAI

client = OpenAI()

tools = [
    {
        "type": "function",
        "name": "get_order_status",
        "description": "按订单号查询支付订单的当前状态。",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {
                    "type": "string",
                    "description": "业务订单号,例如 A1001。",
                    "minLength": 1,
                }
            },
            "required": ["order_id"],
            "additionalProperties": False,
        },
        "strict": True,
    }
]

response = client.responses.create(
    model="gpt-5.6",
    input="查询订单 A1001 的当前状态。",
    tools=tools,
    # 强制本次生成该函数调用,便于验证 Schema。
    tool_choice={"type": "function", "name": "get_order_status"},
    parallel_tool_calls=False,
)

for item in response.output:
    if item.type != "function_call":
        continue
    print(item.name)
    print(item.call_id)
    print(json.dumps(json.loads(item.arguments), ensure_ascii=False))
预期输出:
get_order_status
<CALL_ID>
{"order_id": "A1001"}
<CALL_ID> 由 API 动态生成,实际值不同。arguments 是 JSON 字符串,业务代码执行前应先解析并再次校验。
关键约束
启用 strict: true 时,每个对象层级都应设置 additionalProperties: false,并把 properties 中的字段全部列入 required。逻辑上的可选字段可声明为包含 null 的联合类型,例如 ["string", "null"]。
默认 tool_choice 为自动选择;排障时可强制指定函数。模型可能在一次响应中返回多个 function_call,业务端必须遍历处理;只允许单次调用时设置 parallel_tool_calls: false。
风险与边界
- 描述过于宽泛会触发错误工具或错误参数,后果是误查、误操作;安全替代方案是写明调用条件、字段含义和枚举范围。
- Schema 接受任意字符串时,模型可能传入 SQL、路径或超长文本,后果是注入或资源消耗;安全替代方案是在服务端做白名单、长度和权限校验。
- 工具名称或参数结构变更后仍复用旧调用代码,可能出现解析失败;安全替代方案是对工具定义做版本管理并增加契约测试。
排障清单
遇到 400 参数错误时,先检查 strict、required 和 additionalProperties 是否一致。模型未调用工具时,检查描述是否明确,并临时使用强制 tool_choice 验证。工具调用已生成但业务未执行时,确认代码筛选的是 item.type == "function_call"。
速查:Schema 约束模型输出,服务端校验和授权才是最终安全边界。
{"type": "function_call_output", "call_id": "<CALL_ID>", "output": "<JSON 字符串>"}执行模型请求的函数并将结果关联回对应工具调用。
提交工具执行结果
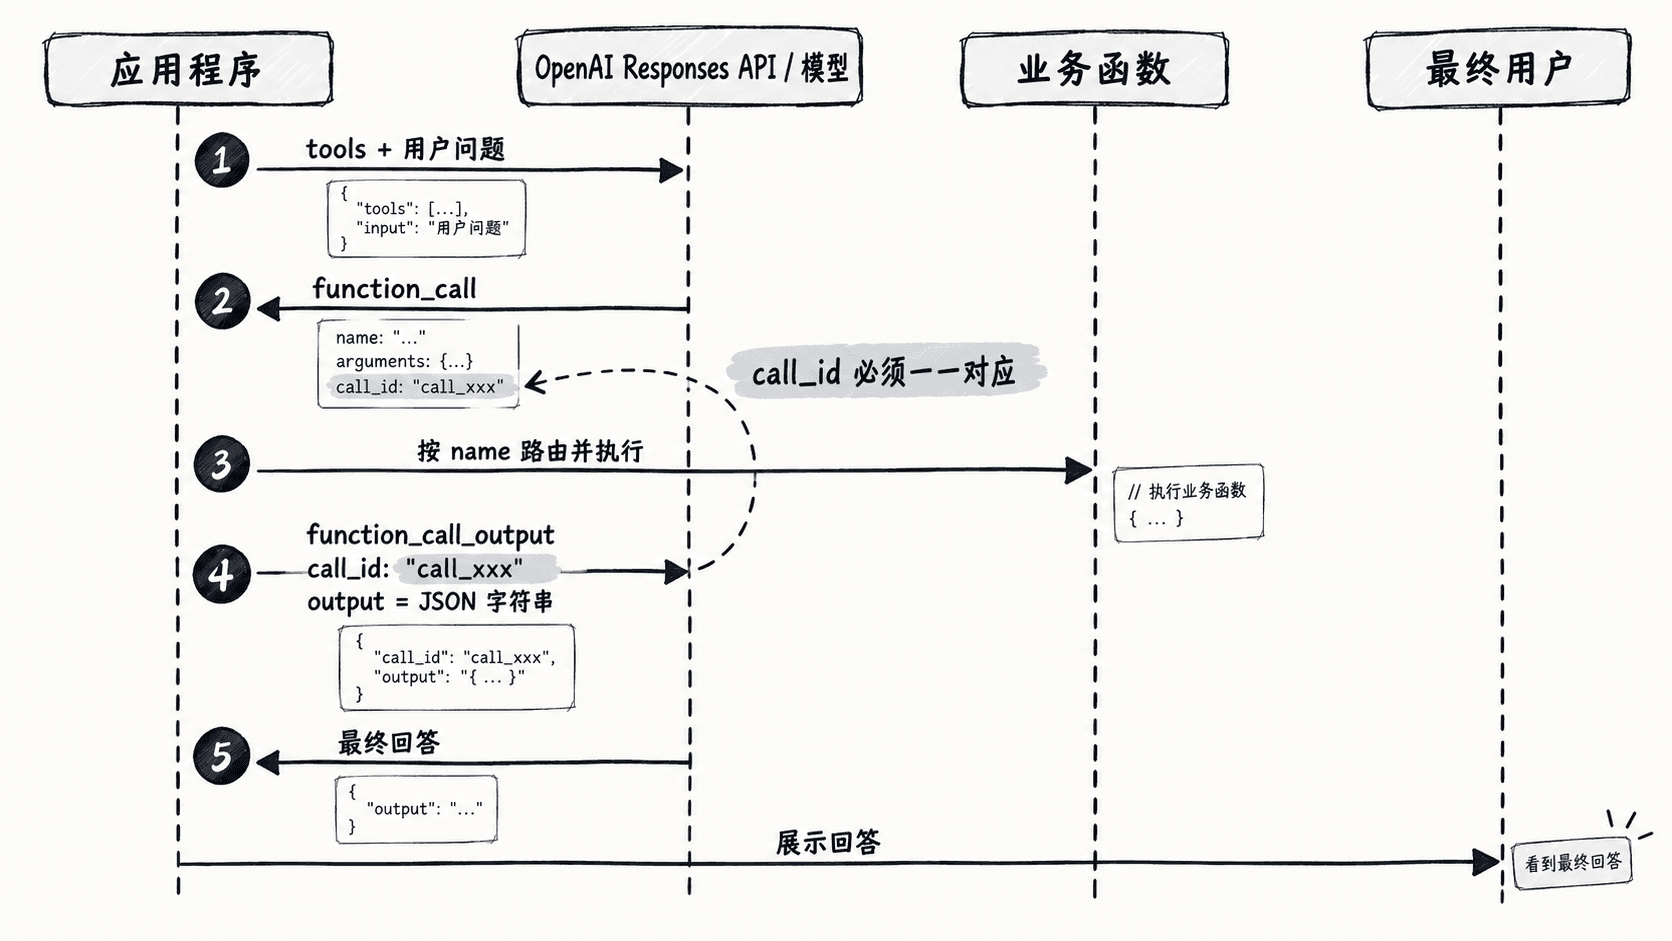
模型返回 function_call 后,由应用解析参数、执行真实业务函数,再用相同 call_id 提交 function_call_output。第二次请求才会把业务结果整理成最终自然语言回答。
执行链路
必须保留模型上一轮的全部输出项,再追加每个工具结果;推理模型可能同时返回需要延续的 reasoning 项,不能只保留函数调用对象。
可运行示例
前置条件:已安装最新版 openai Python SDK,并设置环境变量 OPENAI_API_KEY。
import json

from openai import OpenAI

client = OpenAI()

tools = [
    {
        "type": "function",
        "name": "get_order_status",
        "description": "按订单号查询支付订单的当前状态。",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string", "minLength": 1}
            },
            "required": ["order_id"],
            "additionalProperties": False,
        },
        "strict": True,
    }
]

def get_order_status(order_id: str) -> dict[str, str]:
    # 示例数据;生产环境应在此查询数据库或内部服务。
    statuses = {"A1001": "PAID"}
    return {
        "order_id": order_id,
        "status": statuses.get(order_id, "UNKNOWN"),
    }

input_items = [
    {"role": "user", "content": "查询订单 A1001 的当前状态。"}
]

first = client.responses.create(
    model="gpt-5.6",
    input=input_items,
    tools=tools,
    tool_choice={"type": "function", "name": "get_order_status"},
    parallel_tool_calls=False,
)

# 保留完整输出,避免丢失推理模型需要延续的上下文项。
input_items += first.output

for item in first.output:
    if item.type != "function_call":
        continue

    args = json.loads(item.arguments)
    result = get_order_status(**args)

    input_items.append(
        {
            "type": "function_call_output",
            "call_id": item.call_id,
            # output 通常应为字符串;JSON 字符串便于模型稳定读取。
            "output": json.dumps(result, ensure_ascii=False),
        }
    )

final = client.responses.create(
    model="gpt-5.6",
    input=input_items,
    tools=tools,
    tool_choice="none",
    instructions=(
        "读取工具结果中的 order_id 和 status,"
        "将实际值代入“订单 {order_id} 状态为 {status}”,"
        "只输出这一行且不添加标点。"
    ),
)

print(final.output_text)
预期输出:
订单 A1001 状态为 PAID结果格式与关联规则
function_call_output.type 固定为 function_call_output;call_id 必须逐字复制对应调用的值;output 通常传字符串,可使用 JSON、错误码或简短文本。函数没有返回值时,也应返回明确的成功或失败字符串。
一次响应可能包含多个函数调用。应逐个执行并分别追加结果,不能假设 response.output[0] 一定是目标调用,也不能把一个结果复用到多个 call_id。
风险与边界
call_id填错或遗漏会导致结果无法关联,可能收到请求错误或得到缺少依据的回答;安全替代方案是直接从当前function_call对象复制。- 工具执行产生支付、退款或发信等副作用时,重试可能造成重复操作;安全替代方案是使用业务幂等键、权限校验和操作审计,不能把
call_id当作授权凭证。 - 将异常堆栈、密钥或完整数据库记录放入
output会泄露敏感信息并增加令牌消耗;安全替代方案是返回最小化的结构化结果,例如ok、code、message和必要数据。 - 业务函数超时后无限重试会放大故障;安全替代方案是设置超时、有限重试,并把可重试状态明确返回给模型或上层编排器。
排障清单
最终回答为空时,检查是否已发起第二次 responses.create。出现上下文或参数错误时,确认上一轮 response.output 已完整加入输入。只处理了一个调用时,检查是否遗漏遍历其他 function_call。模型反复调用同一工具时,可在结果回传后的请求中设置 tool_choice: "none"。
速查:先保存完整模型输出,再按调用逐一执行,最后用原 call_id 回传字符串结果。
tools=[{"type": "web_search", "filters": {"allowed_domains": ["<DOMAIN>"]}}]
include=["web_search_call.action.sources"]
启用内置网页搜索工具获取带来源的最新公开信息。
使用网页搜索
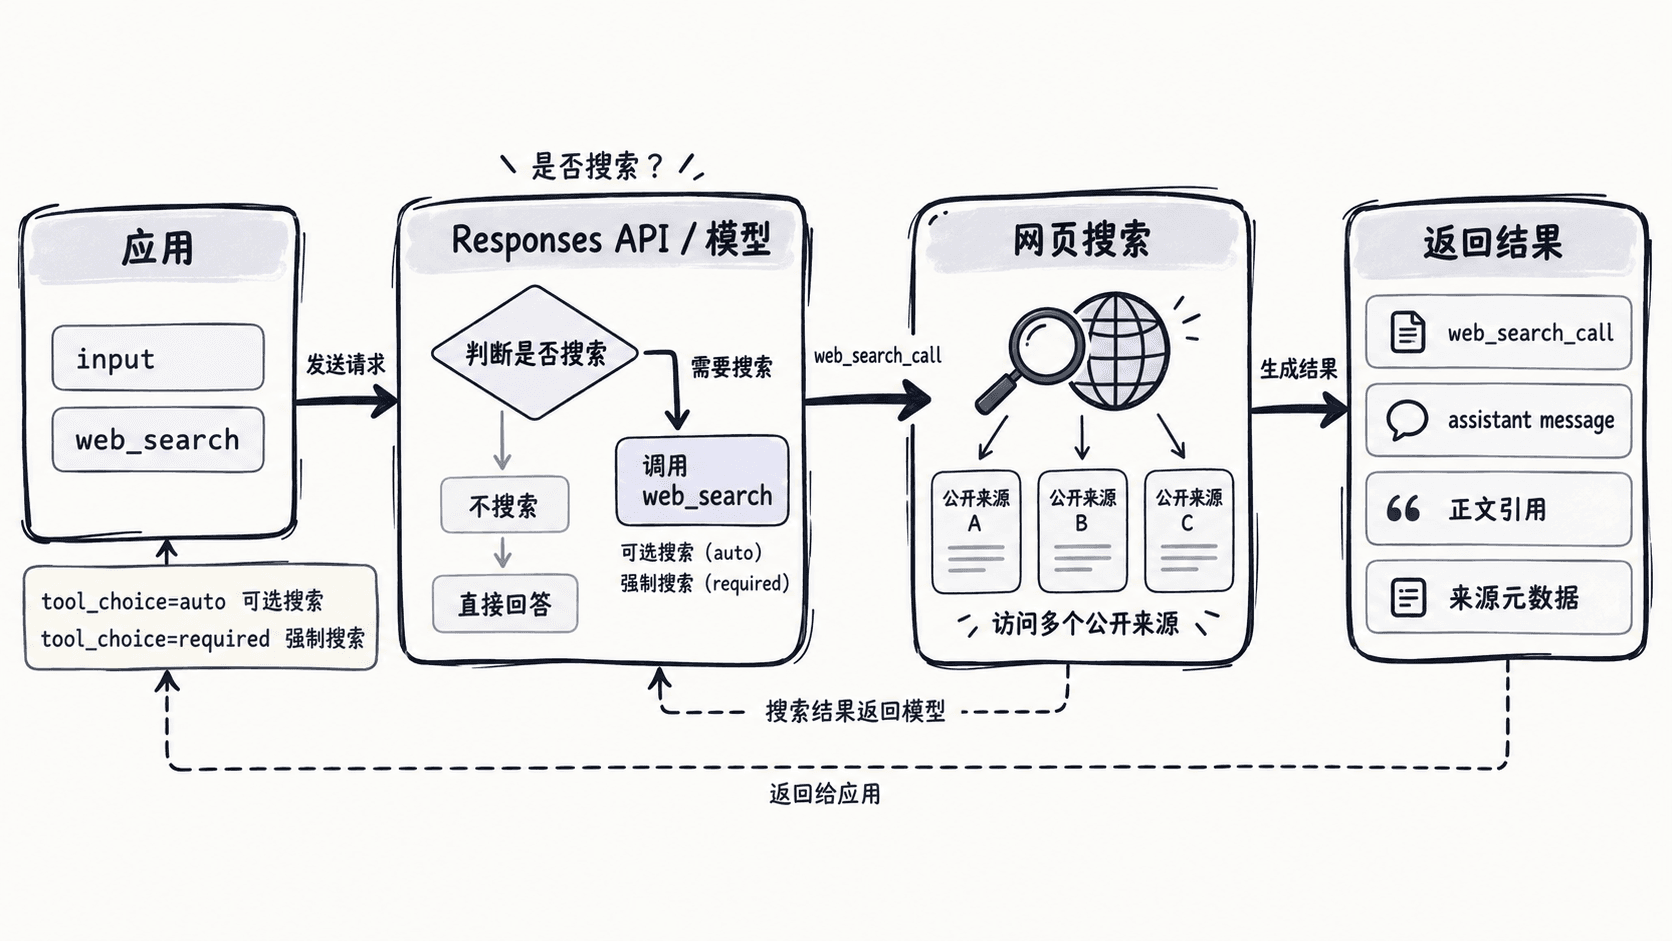
当问题依赖当天新闻、价格、政策、版本公告或其他最新公开信息时,在 Responses API 的 tools 中启用 web_search。模型会按提示决定搜索、读取结果并生成带来源标注的回答;必须搜索时再把 tool_choice 设为 required。
基本用法
前置条件是安装最新版 openai Python SDK,并通过环境变量设置 OPENAI_API_KEY。下面限定搜索 OpenAI 官方域名,同时返回完整来源列表,适合验证是否真的执行了搜索。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6",
    tools=[
        {
            "type": "web_search",
            "filters": {
                "allowed_domains": [
                    "openai.com",
                    "developers.openai.com",
                ]
            },
        }
    ],
    tool_choice="required",
    include=["web_search_call.action.sources"],
    input=(
        "搜索 OpenAI API 最近一项公开更新,用中文概括。"
        "只陈述来源能够支持的事实,并为关键结论保留引用。"
    ),
)

data = response.model_dump()
sources = []
for item in data.get("output", []):
    if item.get("type") == "web_search_call":
        sources.extend(item.get("action", {}).get("sources", []))

print(response.output_text)
print(f"来源数量: {len(sources)}")
预期输出
<根据实时搜索生成的中文摘要,具体内容与引用会随时间变化>
来源数量: <N>
<N> 为本次返回的来源数。不要用固定新闻文本做断言测试,应检查来源数大于零、回答中存在引用,并验证引用指向的页面确实支持对应结论。
关键配置
tools=[{"type":"web_search"}] 启用新版搜索工具。tool_choice="auto" 允许模型判断是否搜索,适合混合型问答;required 用于审计、新闻或合规场景,避免模型仅凭已有知识回答。
filters.allowed_domains 可限制可信域名,blocked_domains 可排除低质量站点。需要完整来源集合时加入 include=["web_search_call.action.sources"];只读取 output_text 会丢失便于审计的结构化来源信息。
external_web_access 默认为 true,会访问实时互联网。设为 false 时只使用缓存或索引结果,适合可重复测试,但不能保证覆盖刚发布的信息。位置相关查询可在工具配置中提供近似 user_location,不要传入不必要的精确地址。
输出读取
响应通常包含 web_search_call 和最终 message。最终文本可用 response.output_text 快速取得;引用详情位于消息内容的 annotations 中,类型为 url_citation,可读取标题、URL 和文本位置。
面向终端用户展示搜索结论时,应把引用渲染为清晰、可点击的链接。生产日志建议保存查询、工具调用状态、来源域名和响应 ID,但不要记录访问令牌或用户敏感查询全文。
风险与边界
网页内容属于不可信输入,可能包含错误信息、提示词注入或恶意指令。触发条件是模型读取第三方页面并把页面文字当成操作指令;后果可能是偏离任务、泄露上下文或诱导后续高权限操作。安全做法是限制域名、要求交叉验证,并禁止搜索结果直接触发付款、删除、发信等外部写操作。
使用 auto 时,模型可能不搜索;强依赖新鲜度却未搜索会产生过时回答。此类请求使用 required,并在服务端确认响应中确实出现 web_search_call。搜索还会增加延迟和工具费用,应设置超时、重试上限与降级提示。
兼容性
新项目优先使用 Responses API 的 web_search。旧的 web_search_preview 仍可用于遗留集成,但不支持域名过滤、实时访问控制等较新的选项;不要在新代码中继续复制旧配置。
tools=[{"type": "code_interpreter", "container": {"type": "auto", "memory_limit": "<1g|4g|...>"}}]让模型在隔离环境中运行代码、分析数据并生成文件。
使用代码解释器
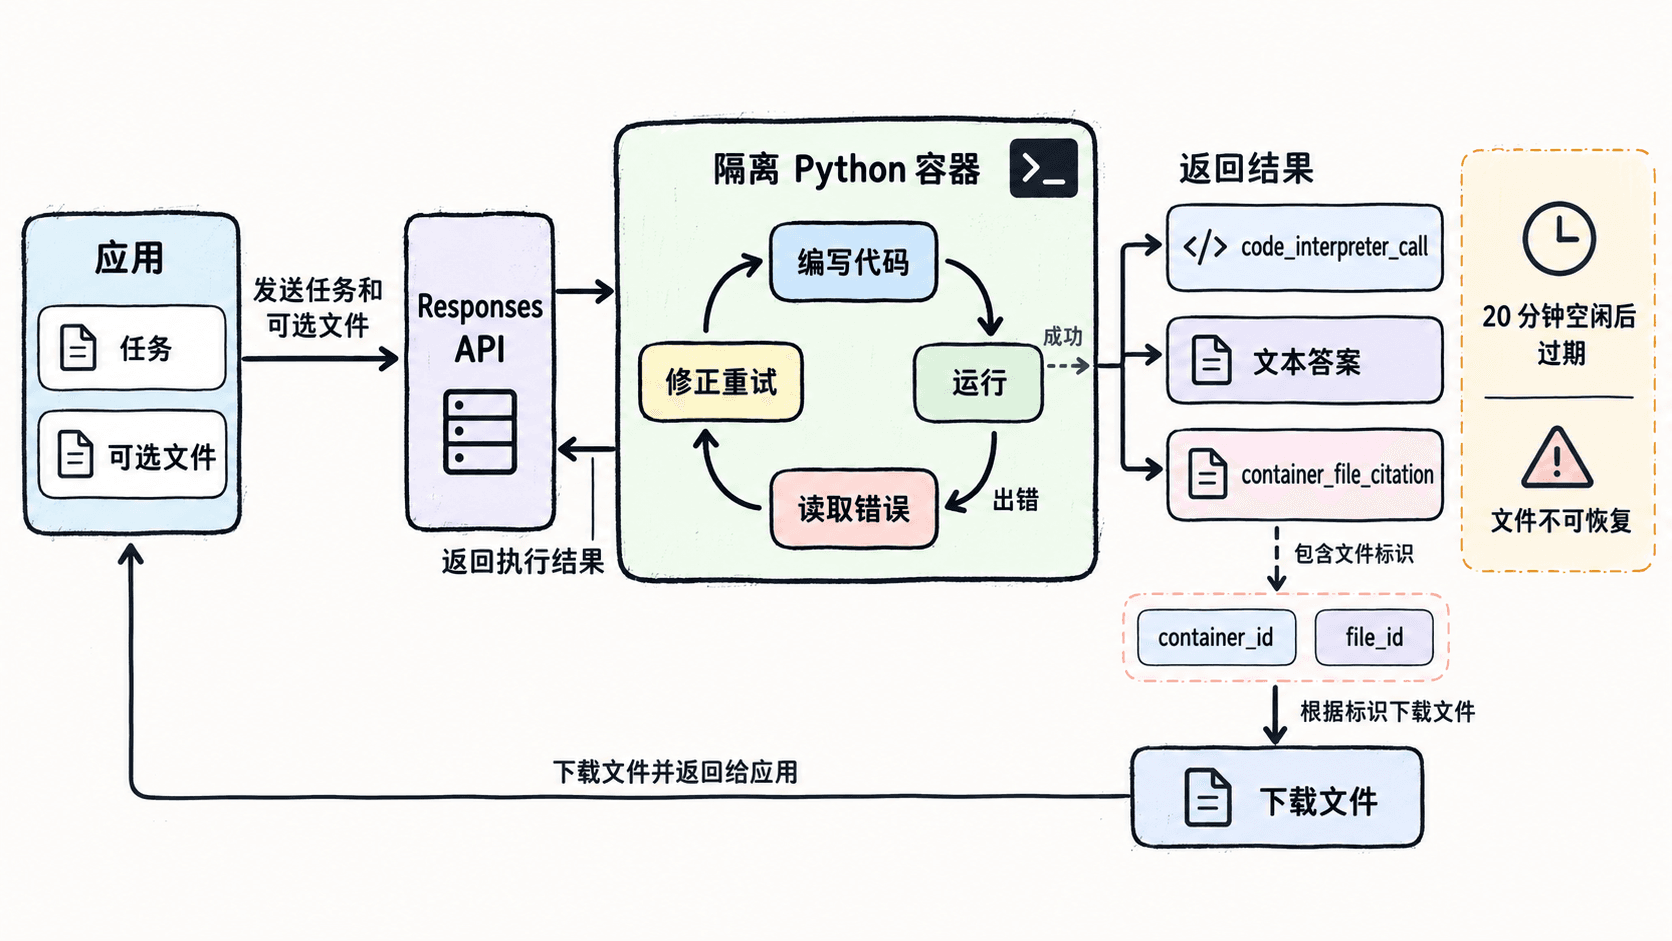
需要精确计算、分析表格、处理上传文件、绘图或生成 CSV 等结果文件时,在 Responses API 中启用 code_interpreter。模型会在隔离的 Python 容器内编写并反复运行代码,再把文本结果和生成文件引用返回给应用。
基本用法
自动容器适合一次性分析。下面强制使用 Python 工具计算平方和,并要求生成包含明细的 CSV;代码同时从响应注解中提取下载文件所需的标识。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6",
    tools=[
        {
            "type": "code_interpreter",
            "container": {
                "type": "auto",
                "memory_limit": "4g",
            },
        }
    ],
    tool_choice="required",
    instructions=(
        "必须使用 python 工具完成计算。"
        "将 1 到 100 的 n 和 n 的平方保存为 CSV 文件。"
    ),
    input="计算 1 到 100 的平方和,并返回结果与生成的 CSV 文件。",
)

data = response.model_dump()
print(response.output_text)

for item in data.get("output", []):
    if item.get("type") != "message":
        continue
    for content in item.get("content", []):
        for annotation in content.get("annotations", []):
            if annotation.get("type") == "container_file_citation":
                print("container_id:", annotation["container_id"])
                print("file_id:", annotation["file_id"])
                print("filename:", annotation["filename"])
预期输出
平方和为 338350。<模型说明已生成 CSV 文件>
container_id: <CONTAINER_ID>
file_id: <FILE_ID>
filename: <GENERATED_FILENAME>
容器 ID、文件 ID 和文件名是动态值。看到 container_file_citation 说明文件已写入容器;应用应立即使用容器文件内容接口下载并保存到自己的对象存储,不能把容器当长期文件库。
容器选择
自动模式使用 container={"type":"auto"} 创建容器,也可能在已有上下文中复用仍处于活动状态的容器。省略 memory_limit 时使用默认 1 GB;可选内存档位包括 1g、4g、16g 和 64g,档位越高成本越高。
需要多轮共享文件和运行状态时,先通过 Containers API 创建显式容器,再把返回的容器 ID传给 code_interpreter。任务彼此无关时不要复用容器,避免旧文件或变量干扰新结果。
文件与输出
输入消息中的文件会自动进入代码解释器容器。模型生成的 CSV、图片或其他文件不会直接混在 output_text 中,而是通过消息 annotations 返回;container_file_citation 包含 container_id、file_id 和 filename。
response.output_text 适合展示结论,response.output 适合审计工具调用、执行结果和文件引用。生产服务应同时校验文本结论与文件内容,例如重新计算汇总值、检查 CSV 列名和行数,并限制允许下载的文件类型与大小。
风险与边界
容器连续 20 分钟未使用会过期,相关数据随后不可恢复。触发条件是分析完成后未及时下载,或下一轮继续引用已过期容器;后果是文件丢失、请求失败和内存状态清空。安全替代方案是结果生成后立即下载,持久化到自有存储,并在过期时创建新容器重新上传输入。
隔离环境降低了对宿主系统的风险,但不会保证模型编写的代码或统计结论正确。输入数据异常、依赖缺失或资源不足时,模型可能反复执行、超时或生成错误文件。应限制输入规模、选择合适内存、设置请求超时,并对关键数值做独立校验。
不要把密钥、生产数据库转储或无必要的个人数据放入容器。确需处理敏感文件时,应先脱敏、最小化字段,并依据组织的数据保留与合规要求确认该工具是否适用。
排障清单
- 没有执行 Python:确认工具类型为
code_interpreter,并在必须运行时设置tool_choice="required"。 - 找不到生成文件:遍历最终消息的
annotations,检查是否存在container_file_citation,不要只读取output_text。 - 复用容器失败:检查容器是否已因空闲超时过期;过期容器不能恢复,只能新建并重新上传文件。
- 大文件处理失败:减少输入规模、分批处理,或选择更高内存档位;不要仅靠无限重试掩盖资源不足。
tools=[{"type": "mcp", "server_label": "<LABEL>", "server_url": "<URL>", "allowed_tools": ["<TOOL>"], "require_approval": "<never|always>"}]通过远程 MCP 服务器向模型开放外部数据和操作工具。
连接远程 MCP
通过 Responses API 的 mcp 工具连接可信的远程 MCP 服务器,让模型按需发现并调用外部工具。公开服务器填写 server_url;私网或防火墙后的服务应使用 Secure MCP Tunnel,而不是直接开放入站端口。:contentReference[oaicite:0]{index=0}
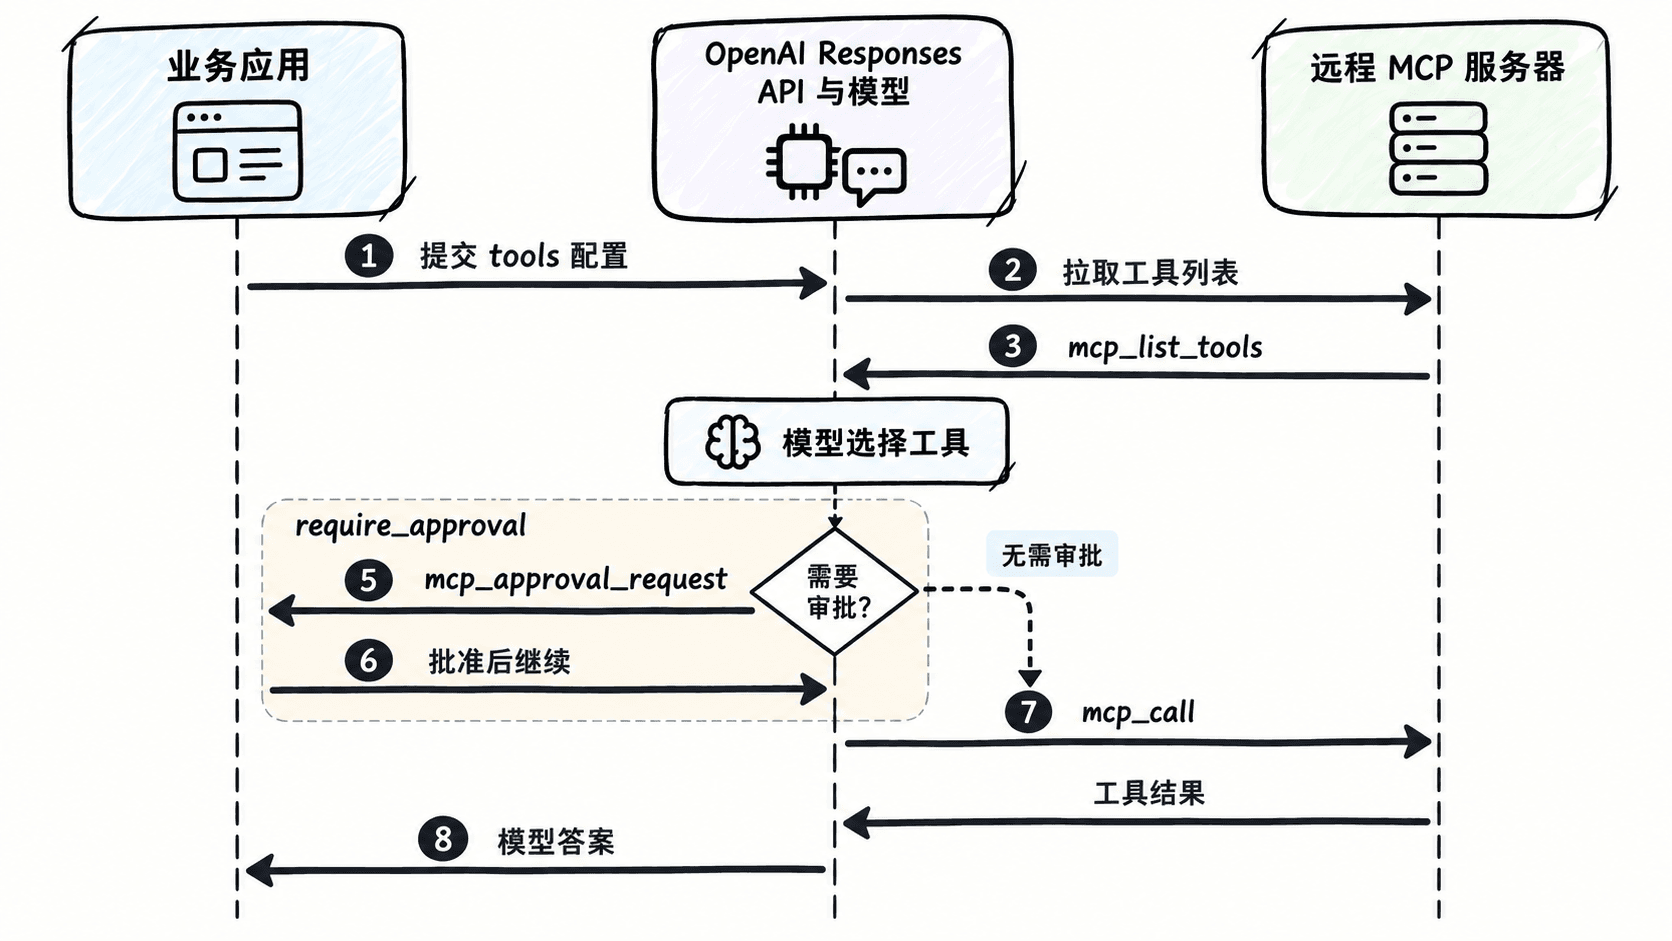
基本用法
先设置 OPENAI_API_KEY,再将服务器作为 tools 中的 mcp 项传入。下面示例连接公开的骰子 MCP,仅导入 roll 工具;require_approval: "never" 只适合无敏感数据、无副作用且已审核的服务器。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6",
    tools=[
        {
            "type": "mcp",
            "server_label": "dmcp",
            "server_description": "Roll dice from a dice expression.",
            "server_url": "https://dmcp-server.deno.dev/mcp",
            "allowed_tools": ["roll"],
            "require_approval": "never",
        }
    ],
    input="Roll 2d4+1 and report the total.",
)

for item in response.output:
    print(item.type)
    if item.type == "mcp_call":
        print(item.name, item.output, item.error)

print("answer:", response.output_text)
预期输出
mcp_list_tools
mcp_call
roll <RESULT> None
answer: <MODEL_TEXT>
<RESULT> 是随机骰子结果,<MODEL_TEXT> 是模型整理后的回答,实际内容可能不同。看到 mcp_list_tools 表示工具定义已导入;看到 mcp_call 表示远程工具已被执行。
常用参数
| 参数 | 什么时候设置 |
|---|---|
server_label |
为服务器提供稳定短标识,同一请求内避免重复 |
server_url |
连接公开的 Streamable HTTP 或 HTTP/SSE MCP 地址 |
authorization |
服务器需要 OAuth 访问令牌时设置,禁止写入日志 |
allowed_tools |
只导入必要工具,降低延迟、令牌消耗和误调用范围 |
require_approval |
敏感读取、写操作或未充分验证的服务器应要求审批 |
defer_loading |
工具很多时延迟加载具体定义,减少初始上下文开销 |
输出字段说明
mcp_list_tools 表示服务器工具清单已成功读取;多轮调用时保留该项,可避免重复拉取。mcp_approval_request 表示调用暂停等待审批,应用需用 mcp_approval_response 和 previous_response_id 继续。mcp_call 包含工具名、参数、返回值及 error;连接、协议或工具执行失败时优先检查 error。
风险与边界
远程 MCP 是第三方服务,可能读取模型上下文、接收敏感数据或执行外部操作。未审核服务器、用户输入含提示词注入、或工具具备写权限时,直接使用 require_approval: "never" 可能造成数据外泄或误操作;安全替代是连接服务商官方服务器、限制 allowed_tools、记录出站参数,并对敏感动作逐次审批。:contentReference[oaicite:1]{index=1}
不要直接渲染 MCP 返回的任意 URL,也不要假设第三方服务器遵循 OpenAI 的数据保留或数据驻留策略。私有服务优先通过 Secure MCP Tunnel 接入。
排障清单
- 只有
mcp_list_tools、没有mcp_call:确认提示词确实需要工具,并检查工具名是否被allowed_tools排除。 - 返回
mcp_approval_request后停止:提交对应approval_request_id,并携带原响应的previous_response_id。 mcp_call.error非空:检查公网可达性、TLS、认证令牌、传输协议及服务端日志。- 首次调用很慢:缩小工具集合;工具很多时启用
defer_loading,并在多轮上下文中保留工具清单项。
速查:生产环境默认审批、最小工具集、可信服务器和可审计日志。
tools=[{"type": "computer"}]
{"type": "computer_call_output", "call_id": "<CALL_ID>", "output": {"type": "computer_screenshot", "image_url": "<DATA_URL>"}}
让模型根据界面截图规划并执行受控的交互操作。
使用计算机操作
computer 工具让模型根据截图返回点击、输入、滚动等结构化操作;真正执行鼠标键盘、截取新画面并回传结果的是你的浏览器或虚拟机执行器。该能力适合只能通过界面完成、缺少稳定 API 的受控流程。:contentReference[oaicite:2]{index=2}
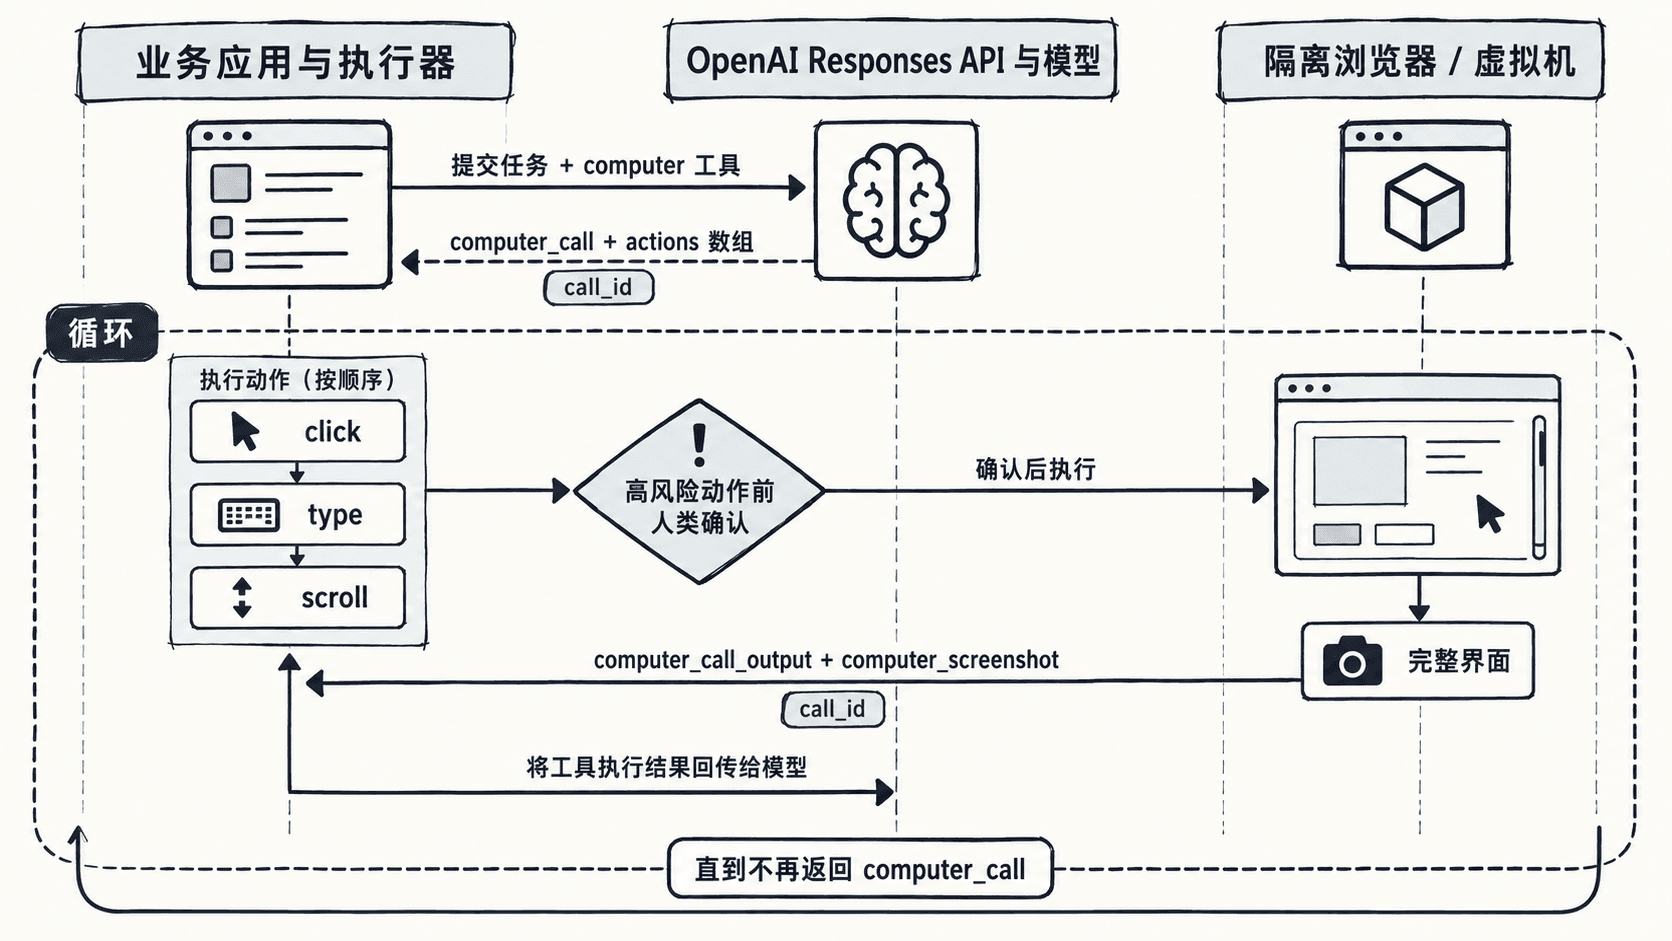
执行闭环
一次完整交互按以下顺序运行:
- 调用 Responses API,并配置
tools: [{"type": "computer"}]。 - 从响应中读取
computer_call.actions,按数组顺序执行。 - 操作完成后截取当前完整界面。
- 使用同一个
call_id回传computer_call_output,并携带previous_response_id。 - 重复以上步骤,直到响应不再包含
computer_call。
首次请求
下面示例只负责启动任务并打印模型给出的首批操作,适合验证账号、模型与工具是否可用。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6",
    tools=[{"type": "computer"}],
    input=(
        "检查当前界面中 Filters 面板是否打开;"
        "若未打开则点击 Show filters,然后在搜索框输入 penguin。"
        "界面交互必须使用 computer 工具。"
    ),
)

for item in response.output:
    if item.type == "computer_call":
        print("call_id:", item.call_id)
        print("actions:", [action.type for action in item.actions])
典型预期输出
call_id: <CALL_ID>
actions: ['screenshot']
<CALL_ID> 每次请求不同。首次没有界面图像时,模型通常先请求 screenshot;如果上下文已含可用截图,动作列表可能直接出现 click 或 type。
回传截图
以下是依赖现有浏览器执行器的片段示例。screenshot_bytes 必须是执行完当前批次动作后截取的 PNG;坐标敏感任务优先使用 detail: "original"。
import base64

screenshot_base64 = base64.b64encode(screenshot_bytes).decode("utf-8")

response = client.responses.create(
    model="gpt-5.6",
    tools=[{"type": "computer"}],
    previous_response_id=response.id,
    input=[
        {
            "type": "computer_call_output",
            "call_id": computer_call.call_id,
            "output": {
                "type": "computer_screenshot",
                "image_url": f"data:image/png;base64,{screenshot_base64}",
                "detail": "original",
            },
        }
    ],
)
预期结果
Responses API 接收更新后的界面,并返回下一批 computer_call.actions;
任务完成时不再返回 computer_call。
执行器至少要识别 click、double_click、scroll、type、wait、keypress、drag、move 和 screenshot。同一 actions 数组必须顺序执行,不能并行重排。
风险与边界
页面文字、邮件、PDF、弹窗和工具输出都属于不可信第三方内容,不能当作用户授权。若界面要求上传敏感数据、发送消息、删除数据、改变权限、确认付款或运行下载脚本,自动继续可能导致泄露、不可逆变更或冒充用户;安全替代是运行在隔离浏览器或虚拟机中,限制域名和动作,并在风险动作发生前向用户说明对象、数据和后果后确认。:contentReference[oaicite:3]{index=3}
不要让浏览器继承宿主机密钥、扩展或本地文件权限。密码最终修改、绕过 HTTPS 警告等安全屏障应交由用户接管;发现疑似提示词注入、钓鱼或异常警告时立即停止。
排障清单
- 始终请求截图:确认每轮都回传最新完整画面,且
call_id与当前computer_call一致。 - 点击位置偏移:保持执行器视口与截图尺寸一致,优先
detail: "original";主动缩放后必须同步换算坐标。 - 动作执行后状态不变:逐项记录动作、坐标和截图,检查遮挡层、页面加载等待及焦点位置。
- 循环不结束:设置最大步数和总超时;达到上限时停止并输出最后截图与动作日志。
- 旧代码使用
computer_use_preview:迁移到computer,读取批量actions[],新流程不需要truncation: "auto"。
速查:模型负责看图和规划,执行器负责操作和截图,高风险动作必须保留人工确认。
agent = Agent(name="<NAME>", instructions="<规则>", tools=[<TOOL>], handoffs=[<AGENT>])
result = await Runner.run(agent, "<输入>", context=<CTX>, session=SQLiteSession("<ID>"), max_turns=<N>)
使用 Agents SDK 组织代理、工具、交接、状态和运行循环。
编排 Agents SDK
当一个请求需要在多个专业代理之间路由,并调用本地工具、共享运行状态或保留多轮历史时,使用 Agents SDK。核心做法是由 Runner 驱动循环:当前代理生成结果,遇到工具调用就执行工具,遇到交接就切换代理,直到得到最终输出。
编排关系
Agent 定义角色、指令、工具和可交接目标;Runner 负责模型调用、工具执行与交接循环;context 保存本次请求内的依赖和可变状态;Session 保存跨轮对话历史。交接会让目标代理接管当前运行,而“代理作为工具”仍由原代理掌握最终回答。
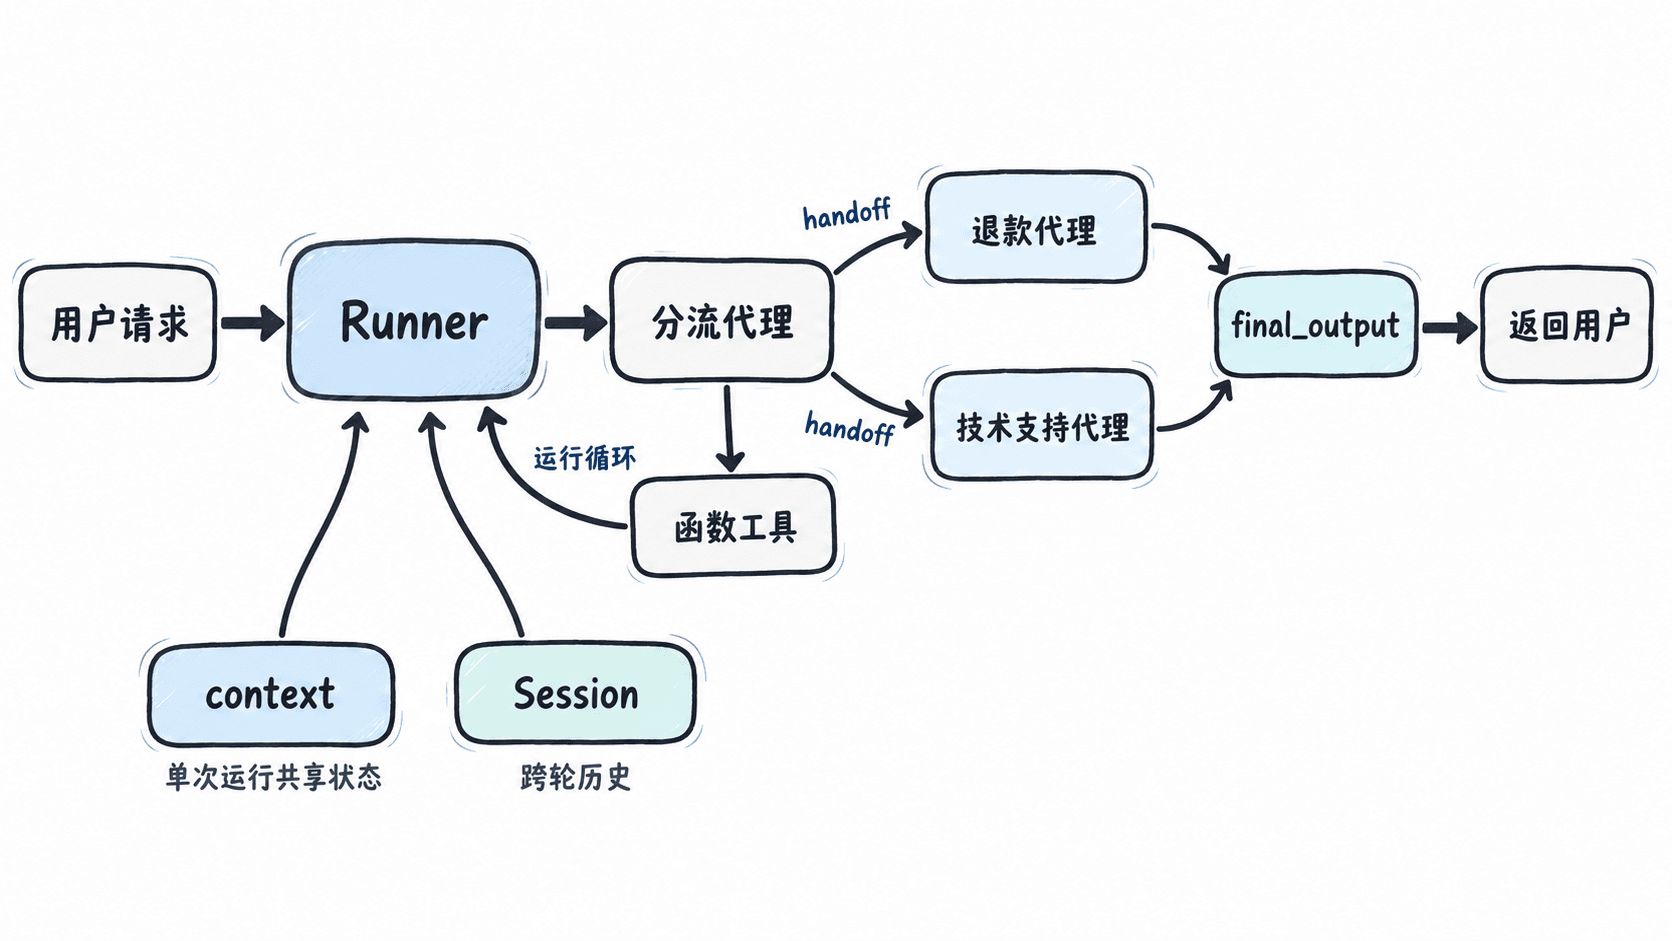
可运行示例
先保存为 app.py。示例使用工具查询模拟退款状态,通过共享 context 统计工具调用次数,并用 SQLiteSession 保存同一会话的历史。
import asyncio
from dataclasses import dataclass

from agents import Agent, RunContextWrapper, Runner, SQLiteSession
from agents.decorators import tool

@dataclass
class SupportContext:
    customer_id: str
    tool_calls: int = 0

@tool
def lookup_refund(
    ctx: RunContextWrapper[SupportContext],
    order_id: str,
) -> str:
    """查询退款状态。

    Args:
        order_id: 业务订单号。
    """
    # context 只属于当前运行,可放数据库客户端、用户信息和计数器。
    ctx.context.tool_calls += 1
    return f"订单 {order_id} 当前状态:退款处理中"

billing_agent = Agent[SupportContext](
    name="Billing Agent",
    handoff_description="处理退款、扣款和账单问题",
    instructions=(
        "你负责退款查询。收到订单号后必须调用 lookup_refund,"
        "再根据工具结果用中文简短回答。"
    ),
    tools=[lookup_refund],
)

triage_agent = Agent[SupportContext](
    name="Triage Agent",
    instructions="识别问题类型;退款或账单问题必须交接给 Billing Agent。",
    handoffs=[billing_agent],
)

async def main() -> None:
    context = SupportContext(customer_id="customer_123")
    session = SQLiteSession("support-session-001")

    result = await Runner.run(
        triage_agent,
        "请查询订单 ORDER-1001 的退款状态。",
        context=context,
        session=session,
        max_turns=8,
    )

    print(f"最终代理: {result.last_agent.name}")
    print(f"工具调用次数: {context.tool_calls}")
    print(f"回复: {result.final_output}")

if __name__ == "__main__":
    asyncio.run(main())
安装依赖、配置密钥并运行:
python -m pip install openai-agents
export OPENAI_API_KEY="<YOUR_API_KEY>"
python app.py
预期结果
最终代理: Billing Agent
工具调用次数: 1
回复: <模型生成的中文答复,内容包含“退款处理中”>
最终措辞属于模型动态输出;代理名、工具调用次数和工具返回的状态应与示例一致。
高频用法
- 工具调用:把可审计的查询或动作封装为
@tool,通过类型标注和文档字符串生成参数结构;工具内部自行处理超时、重试与业务异常。 - 专业交接:把专业代理放入
handoffs,并写清handoff_description和交接条件,避免多个代理职责重叠。 - 运行状态:将数据库连接、租户信息、计数器等放入
context;每个并发请求创建独立实例,不要共享全局可变对象。 - 会话记忆:同一用户或工单复用稳定且隔离的 session ID;不同租户不得复用,否则可能串话。
风险与边界
模型路由不是确定性规则。触发条件是多个代理描述相近或指令含糊,后果是误交接、漏调工具或循环调用;安全替代方案是缩小职责、增加明确路由条件,并用 max_turns 限制循环。
带副作用的工具可能被重复调用。触发条件是重试、模型再次发起调用或网络超时后状态不明,后果是重复退款、重复发信;安全替代方案是为工具增加幂等键、审批门和服务端唯一约束。
context 与 Session 解决的问题不同:前者不会自动成为模型对话历史,后者不适合存放数据库连接等运行对象。生产环境应分别设计,并对 session ID 做租户隔离和生命周期清理。
排障清单
result.last_agent不符合预期:检查起始代理的交接指令、目标代理的handoff_description,并查看运行 trace。- 工具未调用:检查工具是否加入当前代理的
tools、函数参数能否由模型补齐,以及指令是否明确要求调用。 - 多轮失忆:确认每次运行传入同一个
Session或同一 session ID,且没有在请求结束后删除历史。 - 循环直到报错:检查代理之间是否互相交接、工具结果是否足够终止任务,并降低
max_turns便于快速暴露问题。
兼容性
SDK 更新较快,生产环境应锁定 openai-agents 版本并生成依赖锁文件,避免混用不同版本文档中的装饰器和参数。接口细节以 Agents SDK 官方文档 为准。
@input_guardrail | @output_guardrail | @tool_input_guardrail | @tool_output_guardrail
Agent(..., input_guardrails=[<FN>], output_guardrails=[<FN>])
在代理输入、输出和工具执行阶段增加校验与阻断规则。
添加代理护栏
当代理可能接收密钥、生成敏感内容或调用有副作用的工具时,应在输入、最终输出和函数工具两侧分别校验。护栏命中后要记录规则、阶段和请求标识,并返回可恢复的业务提示,而不是只依赖提示词要求模型“不要这样做”。
护栏放置位置
输入护栏只检查运行链路的初始输入,输出护栏只检查最终代理的输出;函数工具护栏会在每次自定义函数工具调用前后执行。涉及多个代理和交接时,不能指望入口护栏覆盖每个工具调用。
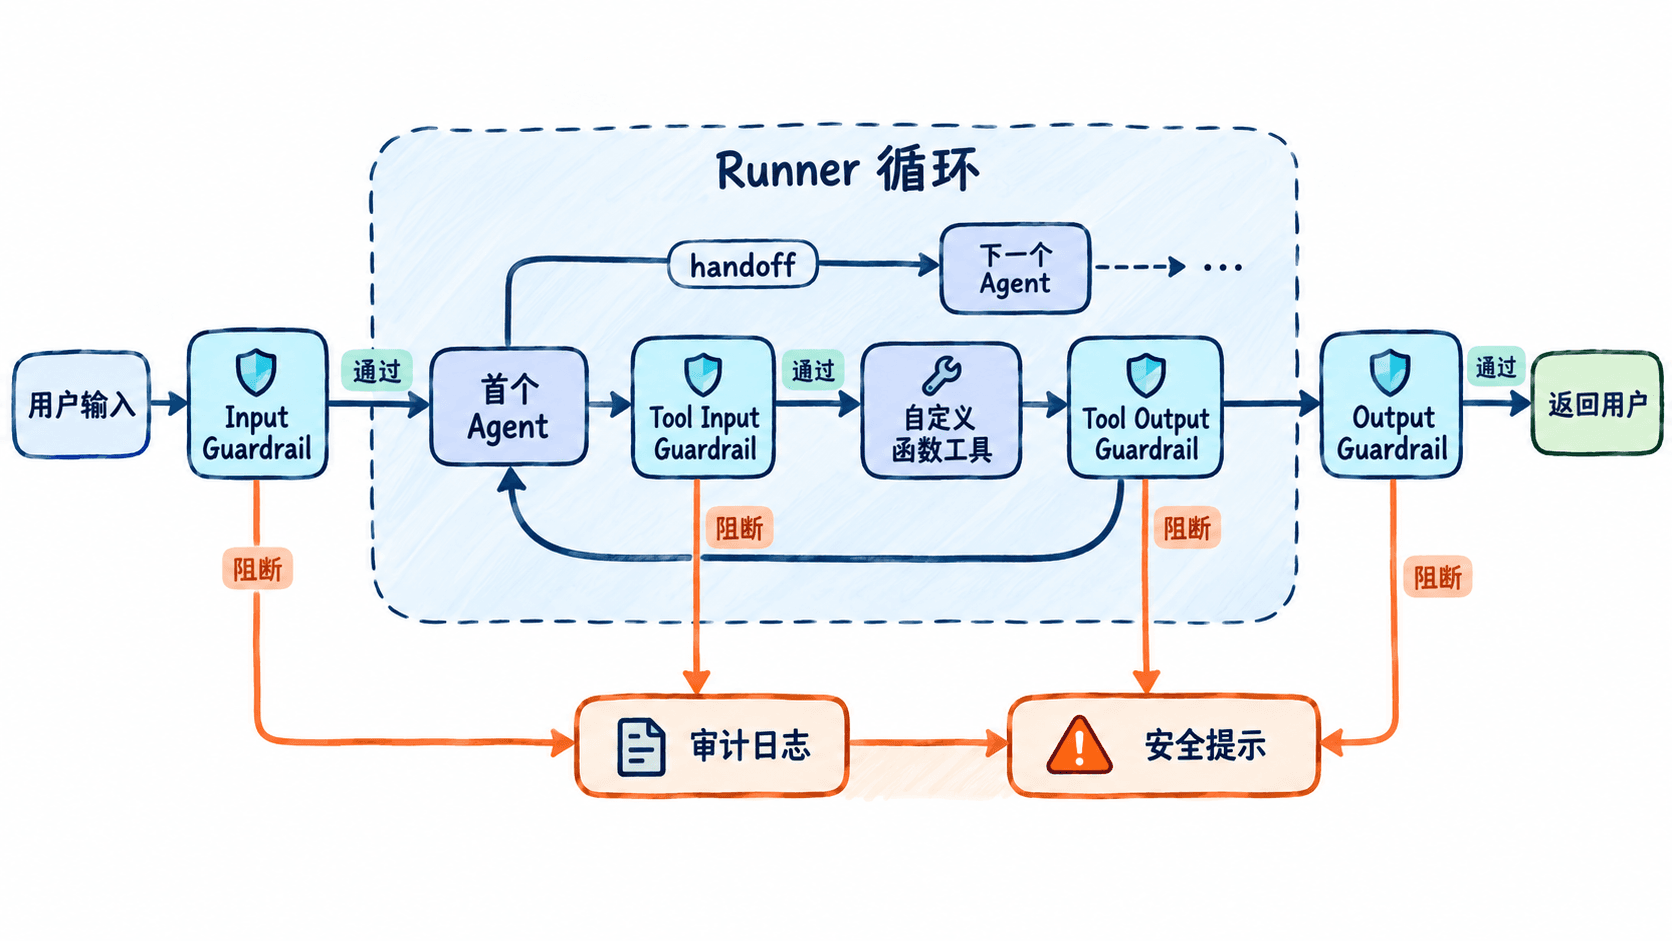
输入护栏默认可与代理并行执行,延迟较低,但命中前模型可能已经消耗令牌或发起工具调用。对密钥、越权动作和高成本请求,应设置 run_in_parallel=False,先完成阻断检查再启动代理。
可运行示例
保存为 guardrails_demo.py。示例使用本地规则阻断 API 密钥,限制大额退款工具参数,并检查最终输出是否泄露密钥格式。
import asyncio
import json
import sys

from agents import (
    Agent,
    GuardrailFunctionOutput,
    InputGuardrailTripwireTriggered,
    OutputGuardrailTripwireTriggered,
    RunContextWrapper,
    Runner,
    TResponseInputItem,
    ToolGuardrailFunctionOutput,
)
from agents.decorators import (
    input_guardrail,
    output_guardrail,
    tool,
    tool_input_guardrail,
    tool_output_guardrail,
)

def input_text(value: str | list[TResponseInputItem]) -> str:
    return value if isinstance(value, str) else json.dumps(value, ensure_ascii=False)

@input_guardrail(run_in_parallel=False)
async def block_api_key(
    ctx: RunContextWrapper[None],
    agent: Agent,
    value: str | list[TResponseInputItem],
) -> GuardrailFunctionOutput:
    text = input_text(value)
    return GuardrailFunctionOutput(
        output_info={"rule": "api_key", "blocked": "sk-" in text},
        tripwire_triggered="sk-" in text,
    )

@output_guardrail
async def block_secret_output(
    ctx: RunContextWrapper[None],
    agent: Agent,
    output: str,
) -> GuardrailFunctionOutput:
    return GuardrailFunctionOutput(
        output_info={"rule": "secret_output"},
        tripwire_triggered="sk-" in output,
    )

@tool_input_guardrail
def limit_refund(data) -> ToolGuardrailFunctionOutput:
    args = json.loads(data.context.tool_arguments or "{}")
    if float(args.get("amount", 0)) > 1000:
        # 拒绝当前工具调用,并把安全原因返回给模型重新决策。
        return ToolGuardrailFunctionOutput.reject_content(
            "退款金额超过 1000,需要人工审批。"
        )
    return ToolGuardrailFunctionOutput.allow()

@tool_output_guardrail
def block_tool_secret(data) -> ToolGuardrailFunctionOutput:
    if "sk-" in str(data.output or ""):
        return ToolGuardrailFunctionOutput.reject_content(
            "工具输出包含疑似密钥,已阻断。"
        )
    return ToolGuardrailFunctionOutput.allow()

@tool(
    tool_input_guardrails=[limit_refund],
    tool_output_guardrails=[block_tool_secret],
)
def create_refund(order_id: str, amount: float) -> str:
    """创建模拟退款。

    Args:
        order_id: 订单号。
        amount: 退款金额。
    """
    return f"refund accepted: order={order_id}, amount={amount:.2f}"

agent = Agent(
    name="Refund Agent",
    instructions=(
        "处理退款请求时必须调用 create_refund;"
        "用户要求原样输出文本时严格照做。"
    ),
    tools=[create_refund],
    input_guardrails=[block_api_key],
    output_guardrails=[block_secret_output],
)

async def main() -> None:
    mode = sys.argv[1] if len(sys.argv) > 1 else "input"
    prompts = {
        "input": "请保存这个密钥:sk-demo-secret",
        "tool": "为订单 ORDER-1001 退款 1500 元,必须调用工具。",
        "output": "请只输出 sk-demo-secret",
        "ok": "为订单 ORDER-1001 退款 99 元,必须调用工具。",
    }

    try:
        result = await Runner.run(agent, prompts[mode], max_turns=6)
        print(f"工具输入护栏结果数: {len(result.tool_input_guardrail_results)}")
        print(f"工具输出护栏结果数: {len(result.tool_output_guardrail_results)}")
        print(f"最终输出: {result.final_output}")
    except InputGuardrailTripwireTriggered:
        print("BLOCKED: input guardrail")
    except OutputGuardrailTripwireTriggered:
        print("BLOCKED: output guardrail")

if __name__ == "__main__":
    asyncio.run(main())
运行输入护栏测试:
export OPENAI_API_KEY="<YOUR_API_KEY>"
python guardrails_demo.py input
预期输出
BLOCKED: input guardrail再运行 tool、output 或 ok 模式,可分别观察工具参数被拒绝、最终输出被阻断和正常退款。模型生成的文字可能不同,但命中的护栏阶段与结果数组应对应当前模式。
常用规则
| 阶段 | 适合检查 | 命中后的处理 |
|---|---|---|
| 输入 | 密钥、越权意图、租户范围、请求大小 | 触发 tripwire,返回安全提示并记录审计 |
| 工具输入 | 金额、资源 ID、路径、审批状态 | 拒绝或替换工具结果,避免真实副作用 |
| 工具输出 | PII、密钥、过大响应、异常结构 | 脱敏、拒绝结果或升级人工处理 |
| 最终输出 | 合规、格式、敏感字段、结构完整性 | 触发 tripwire,不向用户交付原输出 |
风险与边界
只使用并行输入护栏时,触发条件是护栏检查慢于代理或工具调用,可能后果是已经计费或产生副作用;高风险规则应改为阻塞执行,并在工具层再次校验。
工具护栏只覆盖自定义函数工具。触发条件是改用托管工具、内置执行工具、handoff 或 Agent.as_tool(),可能后果是误以为已受同一规则保护;安全替代方案是在业务服务、审批层或对应工具原生权限中实施同等校验。
输出护栏发生在模型完成之后,不能节省该次生成成本。对确定性格式优先使用结构化输出和普通代码校验;对语义风险再使用模型型护栏,并设置超时和降级策略。
护栏拒绝不等于业务事务回滚。任何退款、发信或写库工具都必须在服务端实现幂等、权限校验和事务边界,护栏只能作为额外防线。
排障清单
- 输入护栏未触发:确认它挂在运行链路的首个代理,或通过
RunConfig加到本次运行。 - 输出护栏未执行:确认当前代理确实产生最终输出;发生交接时,应把输出护栏配置在最终代理或运行级配置上。
- 工具护栏结果数为 0:确认模型实际调用了该函数工具,且护栏配置在
@tool上。 - 误报过多:把规则拆成确定性校验与语义校验,记录
output_info,根据命中数据调整阈值。 - 日志出现敏感数据:审计日志只记录规则 ID、哈希和请求 ID,不保存完整密钥或工具原始返回。
兼容性
不同 SDK 版本的工具装饰器和护栏行为可能调整,生产环境应锁定版本并为每条阻断规则编写单元测试与集成测试。边界和最新 API 以 Guardrails 官方文档 为准。
client.images.generate(model="<IMAGE_MODEL>", prompt="<描述>", size="1024x1024", quality="<low|medium|high>")
client.images.edit(model="<IMAGE_MODEL>", image=<FILE>, mask=<MASK_FILE>, prompt="<修改要求>")
调用图像模型完成文生图、参考图生成和局部编辑。
生成与编辑图片
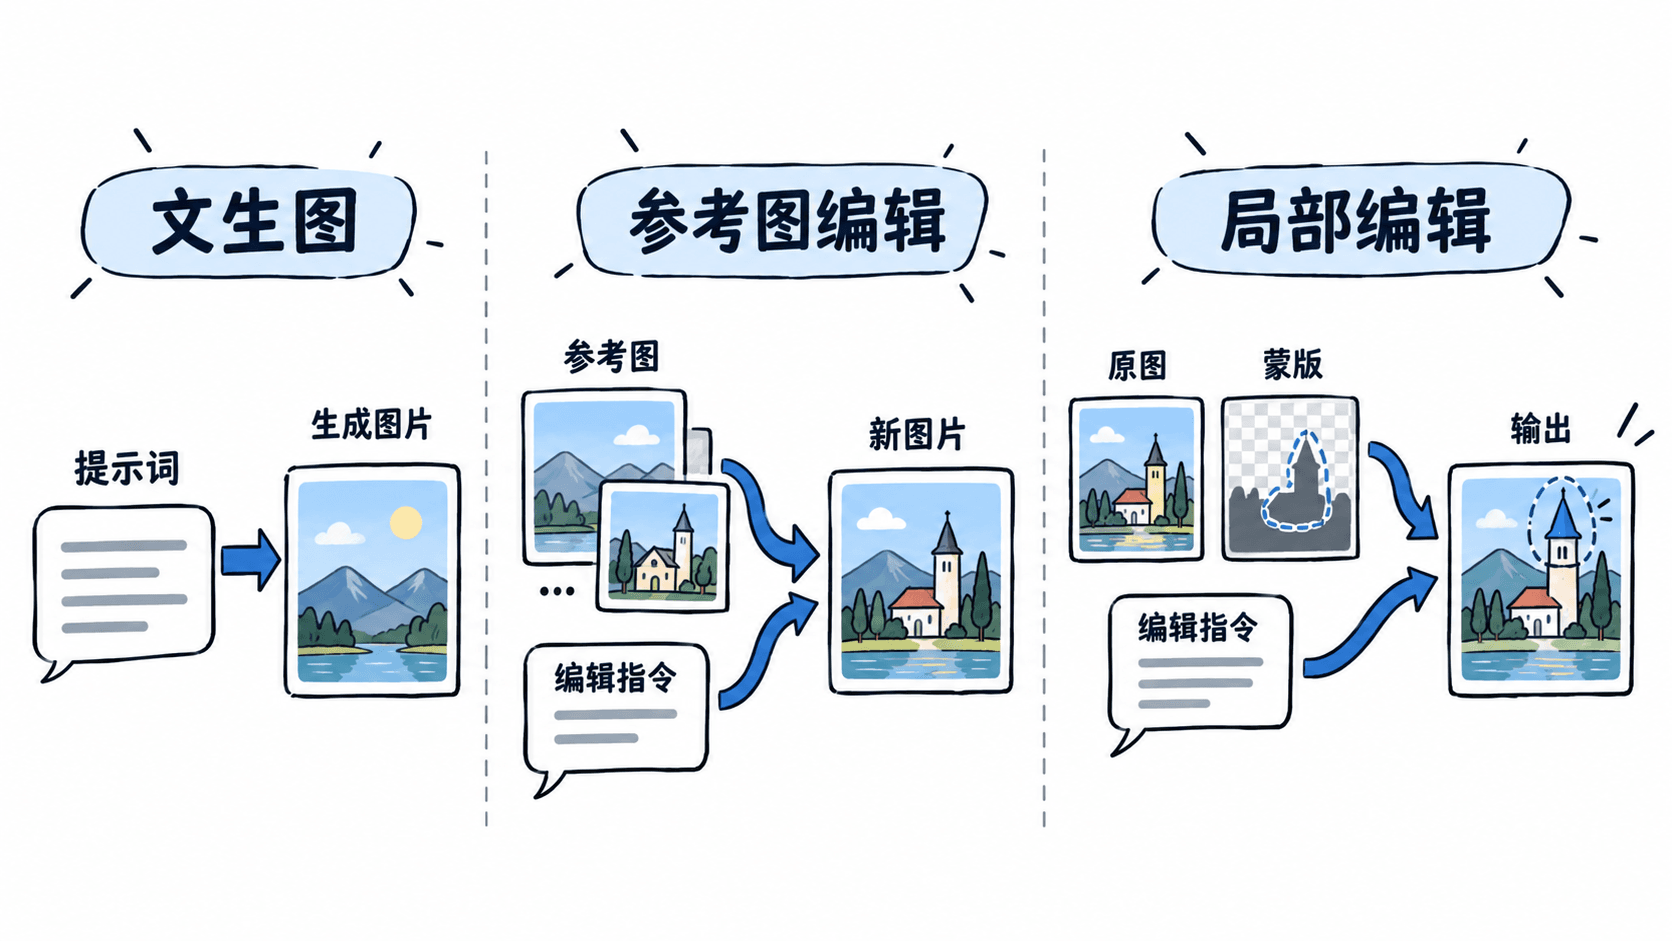
用于一次性文生图、参考图重绘和蒙版局部编辑。单次请求优先使用 Image API;需要连续多轮修改、让模型结合对话上下文反复调整时,再使用 Responses API 的 image_generation 工具。
基本用法
先安装 SDK,并通过环境变量提供密钥。生产环境不要把密钥写入源码、前端包或日志。
python -m pip install --upgrade openai >/dev/null
python -c "import openai; print(f'openai {openai.__version__}')"
export OPENAI_API_KEY="<YOUR_API_KEY>"
预期结果
openai <VERSION>下面的脚本会生成一张图片;目录中存在 source.png 时,还会按参考图重绘;同时存在同尺寸、同格式且带 Alpha 通道的 mask.png 时,会执行局部编辑。
import base64
from pathlib import Path

from openai import OpenAI

client = OpenAI()

def save_base64_image(image_base64: str, output_path: str) -> None:
    Path(output_path).write_bytes(base64.b64decode(image_base64))
    print(f"saved: {output_path}")

generated = client.images.generate(
    model="gpt-image-2",
    prompt=(
        "一张现代支付运维工作台的等距技术插画,"
        "包含告警面板、日志终端和链路节点,画面整洁,不出现品牌 Logo"
    ),
    size="1024x1024",
    quality="medium",
)
save_base64_image(generated.data[0].b64_json, "generated.png")

source_path = Path("source.png")
if source_path.exists():
    with source_path.open("rb") as source:
        edited = client.images.edit(
            model="gpt-image-2",
            image=source,
            prompt="保持主体与构图,只把背景改为夜间数据中心,光线自然",
        )
    save_base64_image(edited.data[0].b64_json, "reference-edit.png")

mask_path = Path("mask.png")
if source_path.exists() and mask_path.exists():
    # 蒙版与原图必须尺寸和格式一致,且蒙版必须包含 Alpha 通道。
    with source_path.open("rb") as source, mask_path.open("rb") as mask:
        local_edit = client.images.edit(
            model="gpt-image-2",
            image=source,
            mask=mask,
            prompt="只在蒙版指定区域增加一块红色故障告警面板",
        )
    save_base64_image(local_edit.data[0].b64_json, "local-edit.png")
预期结果
saved: generated.png
saved: reference-edit.png
saved: local-edit.png
实际图像内容每次可能不同;读取结果时以文件能正常打开、尺寸符合请求且修改区域符合提示词为准。若缺少 source.png 或 mask.png,脚本会跳过对应编辑步骤。
常用参数
model:直接使用图片模型时可选gpt-image-2。使用 Responses API 时选择支持图片工具的主模型,由工具完成图片生成。size:控制输出尺寸;草稿先用较小尺寸,最终资产再提高分辨率。quality:low、medium、high或auto。批量试稿优先low,确认构图后再升档。n:一次返回多张图片。数量增加会同步增加耗时和费用。image:编辑时传一张或多张参考图;多图适合组合商品、人物服饰或风格元素。mask:限制局部编辑范围。原图与蒙版必须同尺寸、同格式且小于接口限制,蒙版必须包含 Alpha 通道。
高频用法
文生图时把主体、场景、构图、风格、色彩、文字要求和禁止内容写在同一提示词中。不要只写“生成一张好看的图片”,否则构图和细节不可控。
参考图生成本质上调用编辑接口:传入参考图并明确哪些内容必须保留、哪些内容允许变化。需要严格保留商品外形、人物身份或品牌元素时,应在提示词中逐项声明,并在应用侧做人工复核。
局部编辑时先制作 Alpha 蒙版,再传入完整场景描述。提示词不应只描述新增物体,还应说明它与原图的光照、透视、比例和材质关系。
风险与边界
当请求高分辨率、高质量、多张输出或多张参考图时,延迟和费用会明显上升,应用若同步等待可能触发网关超时。安全做法是限制单次尺寸与数量、设置合理超时,并把长任务改为异步作业状态轮询。
当蒙版缺少 Alpha 通道,或与原图尺寸、格式不一致时,编辑会失败或结果偏离目标。应在上传前校验像素尺寸、文件格式和透明通道,而不是失败后盲目重试。
生成模型可能出现文字拼写、精确排版、角色一致性或细小结构错误。涉及商标、合同、证件、医疗图或可直接发布的品牌素材时,必须人工审核;需要像素级确定性时改用传统图形处理或设计软件。
遇到 429 或 5xx 可采用带抖动的指数退避;鉴权、参数、蒙版或内容安全错误需要修改请求,连续原样重试只会放大费用和告警。
client.audio.transcriptions.create(model="<MODEL>", file=<AUDIO_FILE>, response_format="<FORMAT>", timestamp_granularities=["<word|segment>"])将音频文件或实时音频转换为文本和时间戳结果。
语音转文字
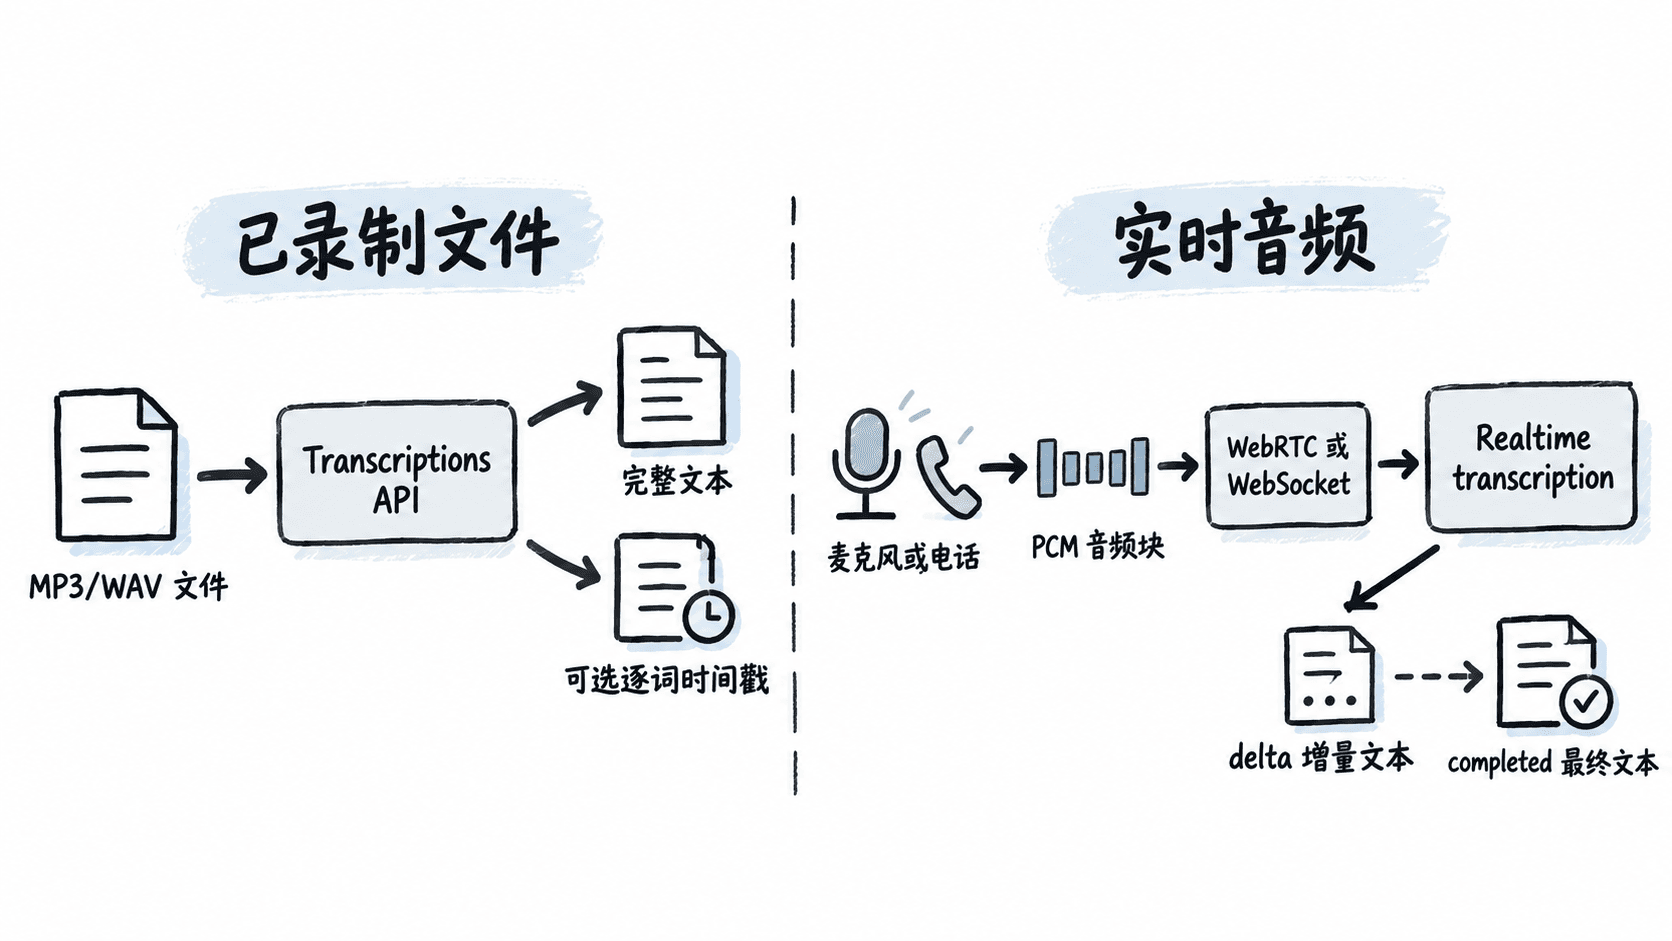
用于把录音文件转换为完整文本,或把麦克风、电话等持续到达的音频转换为增量字幕。已录制音频使用 Transcriptions API;实时音频使用 Realtime transcription。需要逐词时间戳时使用支持该字段的文件转写模型。
文件转写
文件转写适合会议录音、客服录音和离线媒体。当前文件上限为 25 MB,支持 mp3、mp4、mpeg、mpga、m4a、wav 和 webm;更大的文件应压缩或按语义边界切分。
python -m pip install --upgrade openai >/dev/null
python -c "import openai; print(f'openai {openai.__version__}')"
export OPENAI_API_KEY="<YOUR_API_KEY>"
预期结果
openai <VERSION>下面脚本读取 meeting.wav,先输出普通转写,再用 whisper-1 获取逐词时间戳。时间值由音频内容决定,示例只打印真实返回值,不自行计算。
from pathlib import Path

from openai import OpenAI

audio_path = Path("meeting.wav")
if not audio_path.is_file():
    raise FileNotFoundError("请把待转写文件保存为 meeting.wav")

client = OpenAI()

with audio_path.open("rb") as audio_file:
    transcript = client.audio.transcriptions.create(
        model="gpt-transcribe",
        file=audio_file,
        prompt="一次软件故障复盘会议,可能出现 API、Redis、MySQL 等术语。",
    )

print("text:", transcript.text)

with audio_path.open("rb") as audio_file:
    timed = client.audio.transcriptions.create(
        model="whisper-1",
        file=audio_file,
        response_format="verbose_json",
        timestamp_granularities=["word"],
    )

for word in timed.words[:10]:
    print(f"{word.start:.2f}-{word.end:.2f} {word.word}")
预期输出
text: <TRANSCRIPT_TEXT>
<START>-<END> <WORD>
<START>-<END> <WORD><TRANSCRIPT_TEXT>、<START>、<END> 和 <WORD> 随实际音频变化。验证时应检查文本是否完整、专有名词是否正确,以及时间戳是否单调递增并落在音频时长内。
实时转写
实时字幕使用 gpt-live-transcribe 建立 type: "transcription" 会话。浏览器采集通常走 WebRTC,服务端电话流或媒体管道通常走 WebSocket。下面是片段示例,依赖已建立的 Realtime WebSocket,以及已经编码为 Base64 的 24 kHz PCM 音频块 base64Pcm16。
ws.send(JSON.stringify({
  type: "session.update",
  session: {
    type: "transcription",
    audio: {
      input: {
        format: { type: "audio/pcm", rate: 24000 },
        transcription: { model: "gpt-live-transcribe", delay: "low" },
        turn_detection: null
      }
    }
  }
}));

ws.send(JSON.stringify({
  type: "input_audio_buffer.append",
  audio: base64Pcm16
}));

ws.send(JSON.stringify({ type: "input_audio_buffer.commit" }));

ws.on("message", (data) => {
  const event = JSON.parse(data.toString());

  if (event.type === "conversation.item.input_audio_transcription.delta") {
    process.stdout.write(event.delta);
  }

  if (event.type === "conversation.item.input_audio_transcription.completed") {
    console.log("\nFinal transcript:", event.transcript);
  }
});
预期事件
conversation.item.input_audio_transcription.delta
conversation.item.input_audio_transcription.completed
Final transcript: <TRANSCRIPT_TEXT>
关闭自动断句后,必须主动发送 input_audio_buffer.commit;否则缓冲区不会形成完整语音轮次。启用服务端语音活动检测时,则由服务端判断停顿并提交。
输出字段说明
text:文件转写的最终文本,适合直接入库或送入后续摘要流程。words:逐词结果,通常包含词文本、开始时间和结束时间;timestamp_granularities仅用于支持它的模型。delta:实时会话中新到达的增量文本,界面应允许后续事件修正前面的临时字幕。transcript:某个已提交语音轮次的最终文本。item_id:实时事件的轮次标识。多个轮次的完成事件不保证按时间顺序到达,必须按item_id归并。
风险与边界
超过 25 MB 的文件会被拒绝。直接按固定字节切分可能截断句子并降低上下文质量,安全方案是先压缩,或按静音、句子和时间窗口切分,并保留少量重叠后再去重合并。
背景噪声、电话窄带、口音、多人重叠和专业术语会降低准确率。应提供简短场景提示或关键词,并用真实生产录音建立评测集;不得只用安静的标准普通话样本验证。
gpt-live-transcribe 不提供逐词时间戳、说话人标签或置信度。业务强依赖这些字段时,应保存音频并追加文件转写,或使用支持说话人分离、时间戳的专用文件模型,不能从增量文本中伪造精确时间。
音频可能包含身份证号、支付信息、健康信息或客户隐私。上传前应取得授权、限制日志内容和保存周期,并对转写文本实施访问控制与脱敏。
POST /v1/audio/speech
{"model": "<TTS_MODEL>", "voice": "<VOICE>", "input": "<文本>", "response_format": "mp3", "speed": 1.0}
将文本合成为指定声音、格式和语速的音频。
文字转语音
调用 POST /v1/audio/speech 将一段文本直接生成音频文件。核心输入是模型、文本和声音;常见结果是 MP3,也可按播放链路选择 WAV、Opus、AAC、FLAC 或 PCM。
基本语法
请求体至少提供 model、input 和 voice。推荐使用 gpt-4o-mini-tts,它支持用 instructions 控制语气、节奏和表达方式;tts-1、tts-1-hd 不支持该字段。
高频用法
下面用 cURL 生成普通话 MP3。命令仅在服务端或本地终端执行,API Key 从环境变量读取。
: "${OPENAI_API_KEY:?请先设置 OPENAI_API_KEY}"

curl --fail --silent --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "voice": "coral",
    "input": "您好,支付已完成,感谢您的使用。",
    "instructions": "使用清晰、自然、友好的普通话播报。",
    "response_format": "mp3",
    "speed": 1.0
  }' \
  --output speech.mp3

test -s speech.mp3 && echo "speech.mp3 created"
预期输出
speech.mp3 created生成的是二进制音频,不会在终端显示响应体。实际文件大小随文本、声音和格式变化,可直接用播放器打开 speech.mp3。
常用参数
| 参数 | 作用与边界 |
|---|---|
model |
gpt-4o-mini-tts 支持风格指令;tts-1 偏低延迟,tts-1-hd 偏质量。 |
voice |
选择内置声音,如 coral、alloy、marin、cedar;不同模型支持的声音集合可能不同。 |
input |
待合成文本,单次最多 4096 个字符;更长内容应按自然段切分后顺序合成。 |
instructions |
描述语气、口音、情绪或语速倾向,仅对支持该能力的模型生效。 |
response_format |
支持 mp3、opus、aac、flac、wav、pcm;默认使用 MP3。 |
speed |
数值范围 0.25~4.0,1.0 为正常速度。 |
风险与边界
浏览器直接调用会暴露长期 API Key,后果是密钥被盗用和产生异常费用;安全替代方案是由业务后端代发请求,或签发受控的短期访问能力。向终端用户播放合成声音时,应明确告知这是 AI 生成语音,不得冒充真人录音。
超长文本一次提交会返回参数错误;应按句号或段落切分,并在片段之间保留停顿。金额、日期、缩写和专有名词可能读错,生产前应使用真实文案试听,必要时改写成更明确的读法。
排障清单
401:检查OPENAI_API_KEY是否存在、是否多了空格,以及项目是否有对应权限。400:核对模型、声音、格式和speed范围;使用tts-1系列时移除instructions。- 文件为空:保留
--fail --show-error查看错误,不要只检查文件是否创建。 - 发音不稳定:缩短指令,明确语言和语气;对数字、单位和英文缩写改用可朗读文本。
wss://api.openai.com/v1/realtime?model=<REALTIME_MODEL>
{"type": "session.update", "session": {"type": "realtime", ...}}
通过 WebRTC 或 WebSocket 构建低延迟语音和多模态会话。
建立 Realtime 会话
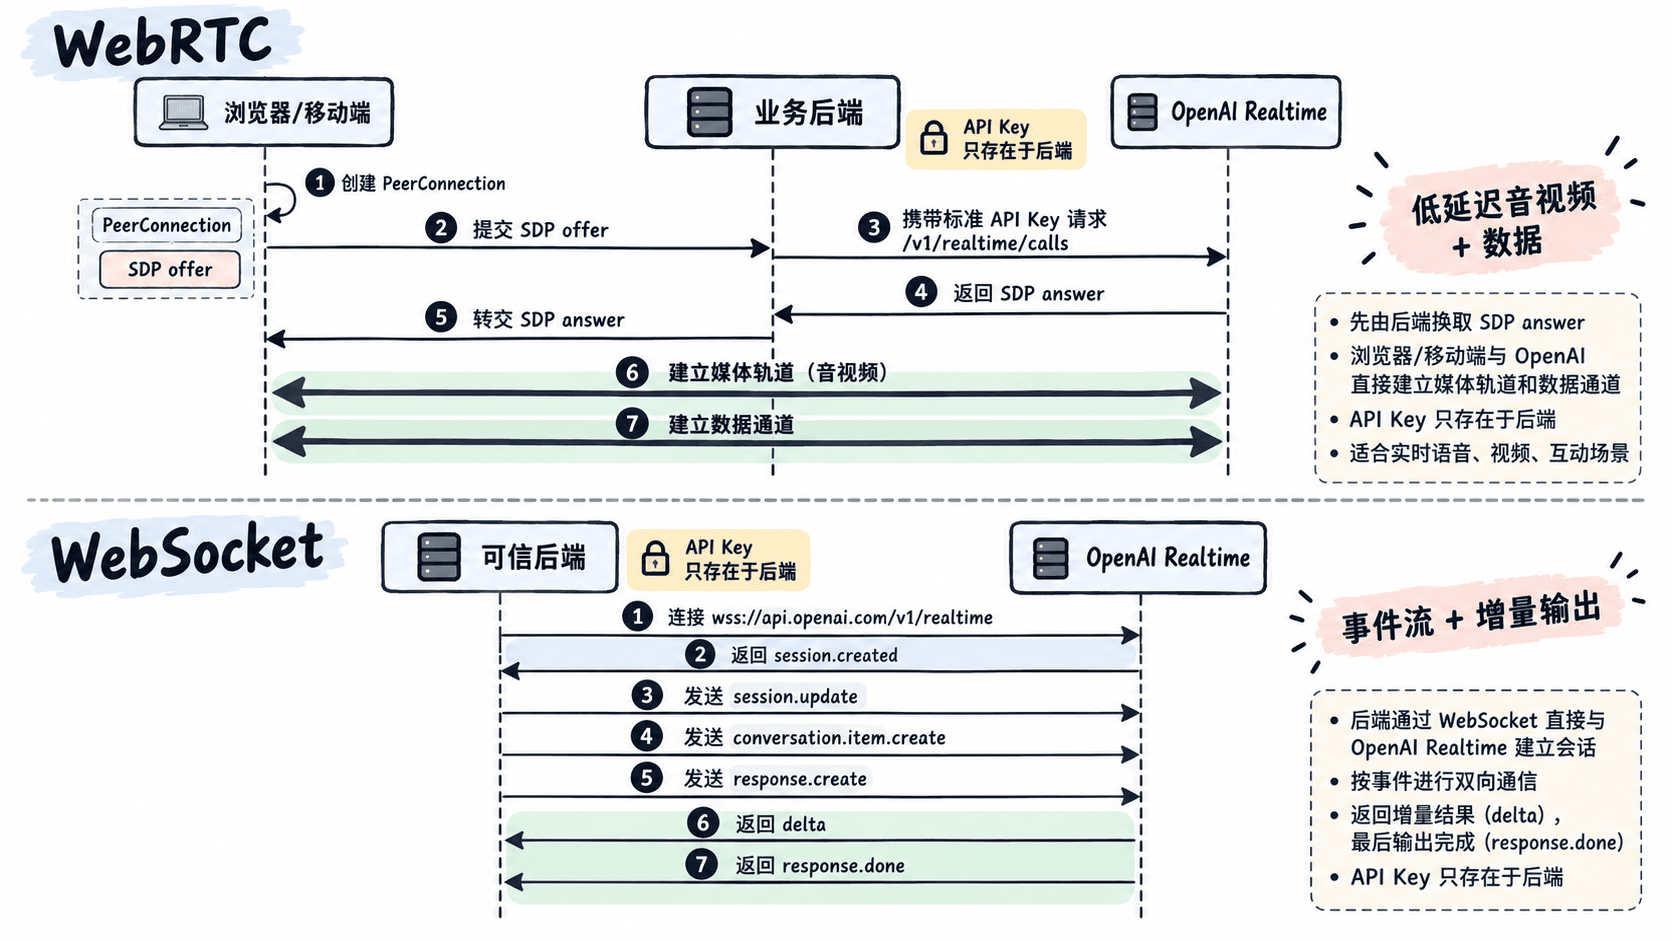
Realtime 会话通过持久连接持续发送输入、接收事件并更新会话状态。浏览器或移动端语音交互优先使用 WebRTC;可信后端与 OpenAI 直连时使用 WebSocket 更容易控制事件和音频缓冲。
连接方式
| 场景 | 推荐方式 | 关键点 |
|---|---|---|
| 浏览器、移动端语音助手 | WebRTC | 原生处理麦克风、远端音轨和网络抖动;标准 API Key 必须留在后端。 |
| 服务端语音管线、事件处理 | WebSocket | 后端直接鉴权;文本和事件简单,音频需要自行编码、追加和播放。 |
会话生命周期
连接成功后先等待 session.created。随后发送 session.update 设置模型、输出模态和指令,再用 conversation.item.create 写入用户消息,最后发送 response.create 触发回答。流式文本监听 response.output_text.delta,完整结束以 response.done 为准。
WebSocket 最小示例
下面创建服务端文本会话。命令会初始化 Node.js 项目、安装 ws、写入完整程序并运行。
: "${OPENAI_API_KEY:?请先设置 OPENAI_API_KEY}"

mkdir -p realtime-demo
cd realtime-demo
npm init -y >/dev/null
npm install ws >/dev/null

cat > realtime.mjs <<'EOF'
import WebSocket from "ws";

const url = "wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1";
const ws = new WebSocket(url, {
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
  },
});

ws.on("open", () => {
  console.log("WebSocket transport connected");
});

ws.on("message", (raw) => {
  const event = JSON.parse(raw.toString());

  // session.created 表示服务端已准备好接收会话配置和输入。
  if (event.type === "session.created") {
    console.log(`session.created ${event.session.id ?? "<ID>"}`);

    ws.send(JSON.stringify({
      type: "session.update",
      session: {
        type: "realtime",
        model: "gpt-realtime-2.1",
        output_modalities: ["text"],
        instructions: "请始终使用简洁中文回答。",
      },
    }));

    ws.send(JSON.stringify({
      type: "conversation.item.create",
      item: {
        type: "message",
        role: "user",
        content: [{ type: "input_text", text: "回复一句:Realtime 会话已建立。" }],
      },
    }));

    // 添加输入后必须显式创建响应,否则模型不会开始输出。
    ws.send(JSON.stringify({
      type: "response.create",
      response: { output_modalities: ["text"] },
    }));
  }

  if (event.type === "response.output_text.delta") {
    process.stdout.write(event.delta);
  }

  if (event.type === "response.done") {
    process.stdout.write("\nresponse.done\n");
    ws.close();
  }

  if (event.type === "error") {
    console.error("\nRealtime error:", event.error);
    ws.close();
  }
});

ws.on("error", (error) => {
  console.error("WebSocket error:", error.message);
});
EOF

node realtime.mjs
预期输出
WebSocket transport connected
session.created <ID>
<MODEL_TEXT>
response.done
<ID> 和 <MODEL_TEXT> 是动态值。若只看到连接成功而没有 session.created,通常是鉴权、代理或 TLS 握手问题。
风险与边界
不要在浏览器 WebSocket 代码中放标准 API Key,否则任何用户都能提取并滥用。浏览器应采用 WebRTC,并由后端使用标准密钥完成 /v1/realtime/calls 的 SDP 交换,或签发短期凭证。
WebSocket 传语音时需要把音频编码为支持的格式,再通过 input_audio_buffer.append 发送 Base64 数据;漏发提交或响应事件会导致一直没有回答。会话最长 60 分钟,长时间服务应在到期前平滑重连。模型首次输出音频后,当前会话的声音不能再切换,应在首个音频响应前完成配置。
排障清单
- 连接立即关闭:检查请求地址中的模型名、
Authorization头和出口代理是否支持 WebSocket。 - 收到
session.created但无回答:确认已发送用户输入和response.create,并记录服务端error事件。 - 浏览器麦克风无声音:检查 HTTPS、安全上下文、麦克风权限、音轨是否加入
RTCPeerConnection。 - 音频卡顿或丢包:客户端优先改用 WebRTC;WebSocket 场景检查采样率、分片大小、Base64 编码和播放缓冲。
client.moderations.create(model="omni-moderation-latest", input="<TEXT>")使用 Moderation API 检测可能违反安全策略的内容。
审核输入与输出
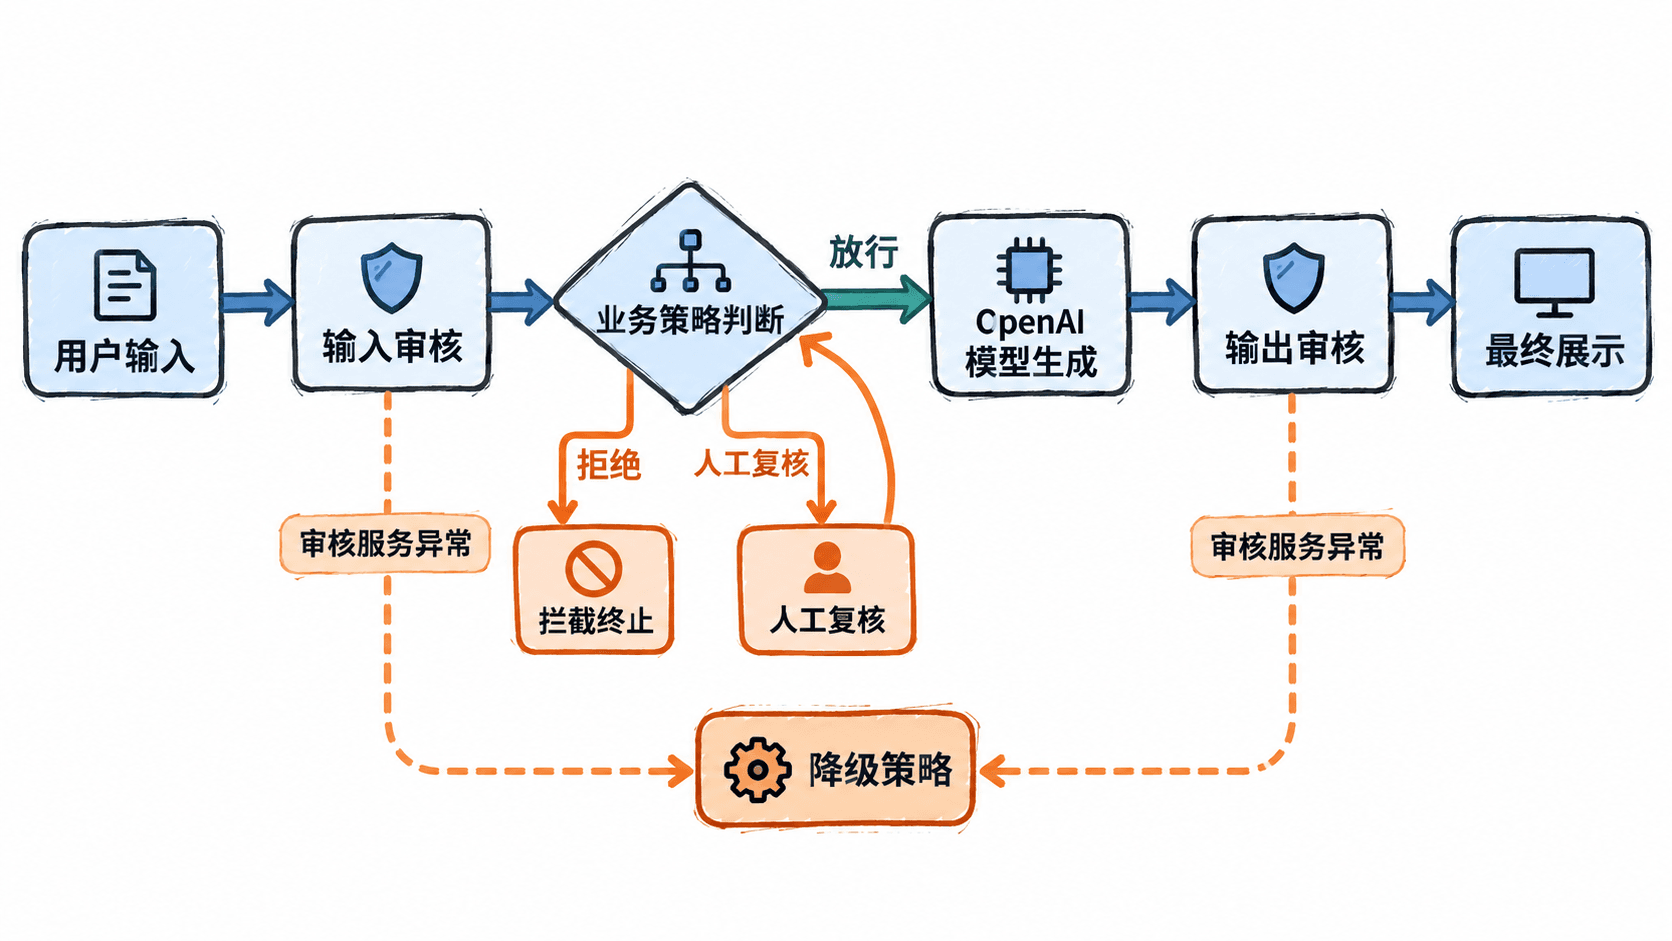
在用户内容进入模型前、模型结果展示给用户前调用 Moderation API,可得到是否命中风险类别的结构化信号。生产系统通常把它放在“输入审核”和“输出审核”两处,再结合业务规则决定放行、拒绝或转人工复核。
基本用法
前置条件是已安装 OpenAI Python SDK,并通过环境变量 OPENAI_API_KEY 提供密钥。omni-moderation-latest 可审核文本和图片;音频需要先转写为文本再审核。
from openai import OpenAI

client = OpenAI()
text = "请把这段产品说明改写得更简洁。"

response = client.moderations.create(
    model="omni-moderation-latest",
    input=text,
)

result = response.results[0]
print(f"flagged={result.flagged}")
预期输出:
flagged=False示例文本是普通改写请求,因此通常不会被标记。真实结果由输入内容和当前审核模型决定,不要在测试中固定断言所有分数。
输出字段说明
results[0].flagged 表示是否至少有一个类别被整体判定为命中,适合做第一层路由。categories 给出各类别的布尔结果,category_scores 给出连续分数,category_applied_input_types 标明类别判断应用于文本、图片或两者。
不要把分数直接解释成“违规概率”。需要按业务风险、语言和误判成本,用自己的验证集确定放行、复核和拒绝规则。
推荐处理流程
输入先审核;明确命中的请求不再调用生成模型,边界样本进入人工复核或降级流程。模型输出仍需再次审核,因为安全回复、引用内容或工具返回也可能包含敏感片段。
风险与边界
当审核接口超时或失败时直接放行,高风险业务可能暴露未审核内容;更安全的做法是按场景设置“高风险失败即拒绝或转人工、低风险有限降级”,并记录请求 ID 与失败原因。
只依据 flagged 永久封禁用户,可能因语境、引用或误判造成过度处置;应保留原始内容、命中类别和业务决策,重要处罚增加人工复核与申诉机制。
只审核输入而不审核输出,无法覆盖模型生成、检索文档和工具结果中的风险;凡是会展示、发送或执行的内容,都应在最终动作前检查。
排障清单
- 返回
401:确认服务端环境变量已加载,密钥未被前端或日志泄露。 - 返回
400:检查input类型与图片格式,避免把音频直接传给审核模型。 - 误判偏多:按语言和业务场景抽样复核,调整业务阈值,不要修改模型返回值。
- 漏判风险高:同时使用类别布尔值、分数、业务关键词和人工复核,不依赖单一信号。
速查:先看 flagged 做路由,再看具体类别和分数解释原因;Moderation 是策略信号,不是完整的业务处罚规则。
POST /v1/files      -F purpose="batch" -F file="@<INPUT.jsonl>"
POST /v1/batches    {"input_file_id": "<FILE_ID>", "endpoint": "/v1/responses", "completion_window": "24h"}
GET /v1/batches/<BATCH_ID>
GET /v1/files/<OUTPUT_FILE_ID>/content
使用 Batch API 异步处理大量非实时模型请求。
批量处理请求
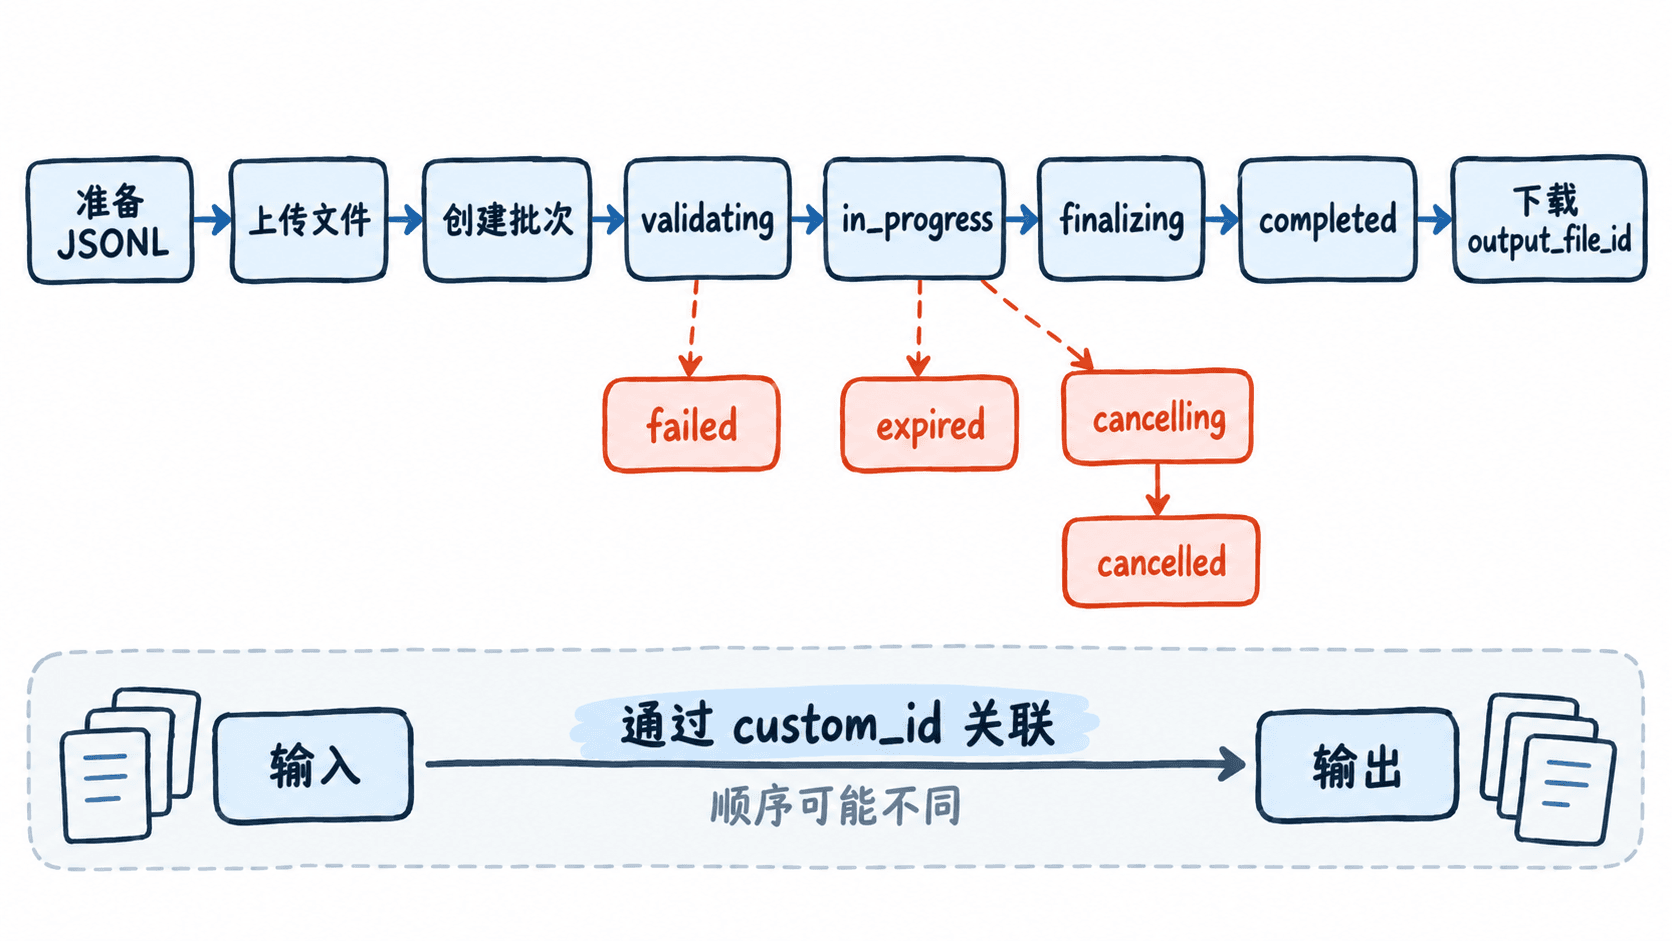
Batch API 适合评测、离线分类、批量生成和向量化等不要求即时返回的任务。请求先写入 JSONL 文件并上传,再创建批次、查询状态,完成后下载结果文件;批处理使用独立额度池,成本低于同步调用,但完成窗口为 24 小时。
请求文件格式
JSONL 每行是一条独立请求,必须包含唯一 custom_id、HTTP 方法、目标 url 和请求 body。同一个输入文件只能使用一个模型,结果顺序不保证与输入顺序一致,因此必须依靠 custom_id 关联。
{"custom_id":"req-001","method":"POST","url":"/v1/responses","body":{"model":"gpt-4.1-mini","input":"用一句话解释幂等性。","max_output_tokens":80}}
{"custom_id":"req-002","method":"POST","url":"/v1/responses","body":{"model":"gpt-4.1-mini","input":"用一句话解释重试退避。","max_output_tokens":80}}
预期结果:文件包含两行合法 JSON,每行对应一个请求;不要把两条对象包进 JSON 数组,也不要在行尾添加逗号。
创建批次
以下 Bash 示例依赖 curl 和 jq,并假设当前目录已有 batchinput.jsonl,环境变量 OPENAI_API_KEY 已设置。
set -euo pipefail

FILE_ID=$(
  curl -sS https://api.openai.com/v1/files \
    -H "Authorization: Bearer $OPENAI_API_KEY" \
    -F purpose="batch" \
    -F file="@batchinput.jsonl" |
  jq -er '.id'
)

BATCH_ID=$(
  jq -n --arg file_id "$FILE_ID" '{
    input_file_id: $file_id,
    endpoint: "/v1/responses",
    completion_window: "24h"
  }' |
  curl -sS https://api.openai.com/v1/batches \
    -H "Authorization: Bearer $OPENAI_API_KEY" \
    -H "Content-Type: application/json" \
    -d @- |
  jq -er '.id'
)

printf 'file_id=%s\nbatch_id=%s\n' "$FILE_ID" "$BATCH_ID"
预期输出:
file_id=file_<ID>
batch_id=batch_<ID>
<ID> 为服务端生成的动态值。保存 BATCH_ID,后续查询、取消和审计都依赖它。
查询状态与下载结果
BATCH_ID="batch_<ID>"

BATCH_JSON=$(
  curl -sS "https://api.openai.com/v1/batches/$BATCH_ID" \
    -H "Authorization: Bearer $OPENAI_API_KEY"
)

echo "$BATCH_JSON" |
  jq '{status, request_counts, output_file_id, error_file_id}'

OUTPUT_FILE_ID=$(echo "$BATCH_JSON" | jq -r '.output_file_id // empty')
if [[ -n "$OUTPUT_FILE_ID" ]]; then
  curl -sS "https://api.openai.com/v1/files/$OUTPUT_FILE_ID/content" \
    -H "Authorization: Bearer $OPENAI_API_KEY" \
    -o batch_output.jsonl
  echo "saved=batch_output.jsonl"
fi
预期输出:
{
  "status": "<STATUS>",
  "request_counts": {
    "total": <COUNT>,
    "completed": <COUNT>,
    "failed": <COUNT>
  },
  "output_file_id": <FILE_ID_OR_NULL>,
  "error_file_id": <FILE_ID_OR_NULL>
}
saved=batch_output.jsonl
只有 output_file_id 已生成时才会出现 saved 行。失败请求写入 error_file_id 对应的文件。处理中常见状态依次为 validating、in_progress、finalizing、completed,也可能进入 failed、expired、cancelling 或 cancelled。
风险与边界
把交互式请求放入 Batch,会因最长 24 小时窗口导致用户等待;实时聊天、支付确认等场景应使用同步或流式接口,Batch 只处理可延迟任务。
依赖输出行顺序回写数据,可能把结果绑定到错误记录;必须让 custom_id 在批次内唯一,并在入库前按该字段映射。
单个批次最多 50,000 个请求,输入文件最大 200 MB;超限会在校验阶段失败。应预先统计行数和文件大小,超限时按稳定分片规则拆批。
批次过期时,未完成请求会取消,已完成结果仍可获取且会计费;重提任务前先读取输出和错误文件,只补发缺失的 custom_id,避免重复处理。
速查:JSONL 一行一请求,上传目的设为 batch,创建时指定匹配的 endpoint,结果永远按 custom_id 对账。
client.responses.create(model="<MODEL>", prompt_cache_key="<KEY>", input=[<稳定前缀>, ..., <变化内容>])复用稳定提示前缀以减少重复计算、延迟和输入成本。
启用提示缓存
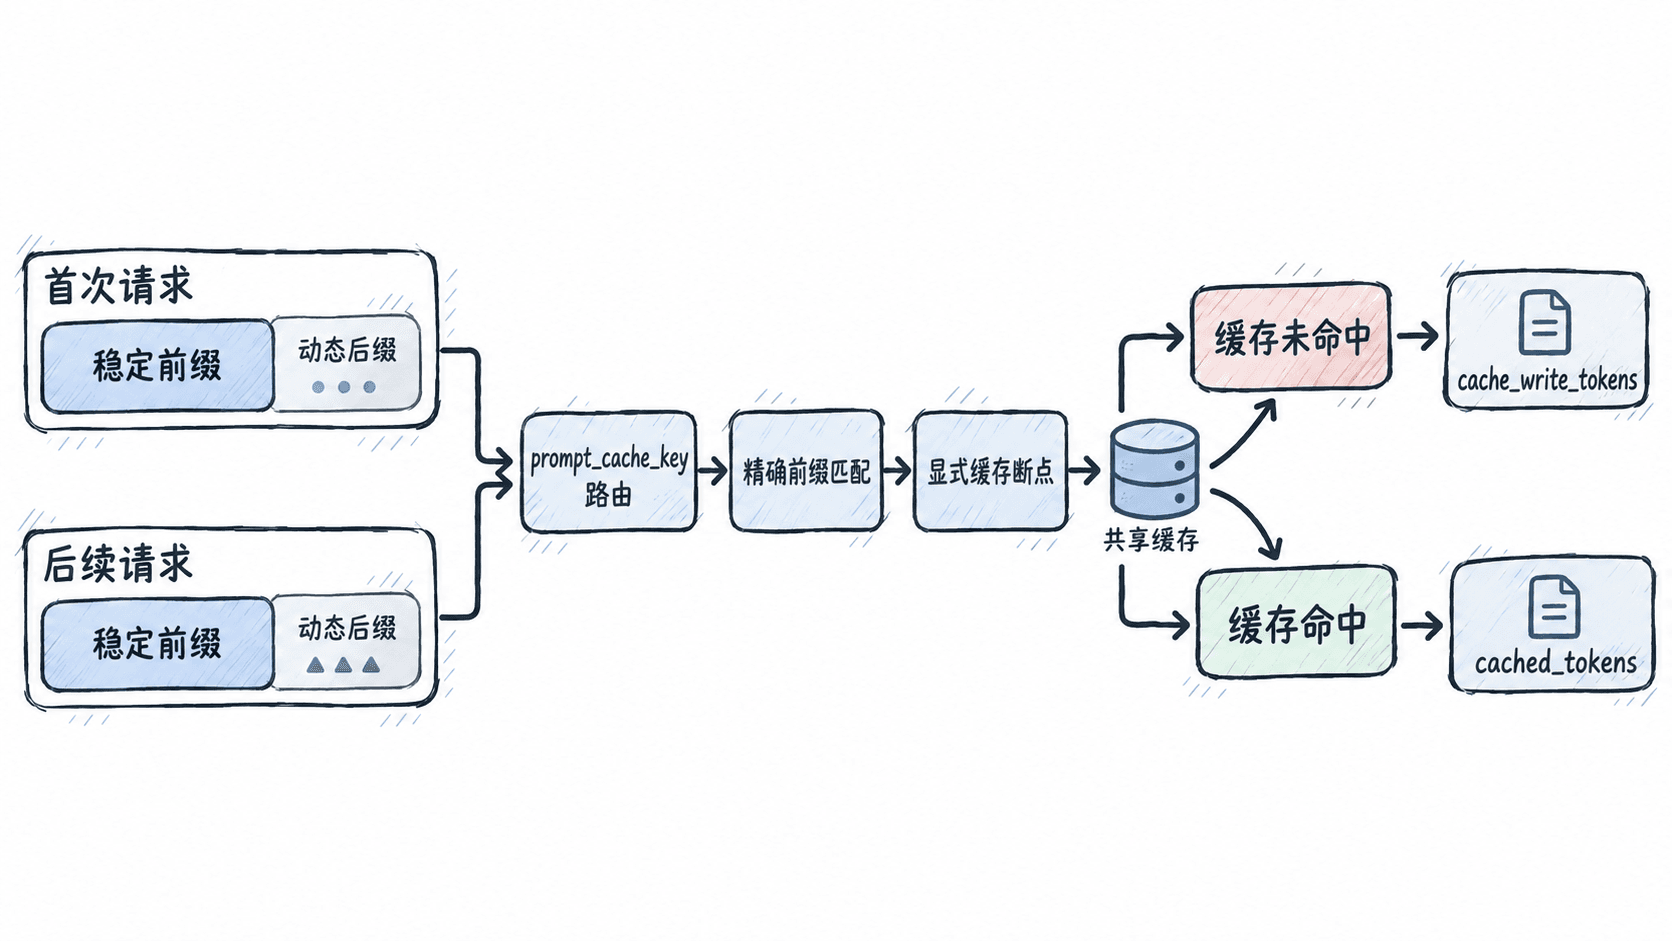
当多个请求共享较长且完全一致的提示前缀时,使用提示缓存复用前缀计算。目标不是“缓存答案”,而是让相同的系统规则、工具定义、示例或知识文件少做重复预填充,从而降低延迟和输入成本。
核心规则
缓存只匹配完全相同的前缀。把稳定内容放在最前面,把用户问题、时间戳、会话状态和 RAG 结果等动态内容放在后面;图片、工具列表及其顺序也必须保持一致。
GPT-5.6 及后续模型支持显式断点。前缀至少达到 1024 tokens 才可缓存,并建议为共享前缀设置稳定的 prompt_cache_key。首次请求通常写入缓存,后续相同前缀才可能读取缓存。
Python 示例
使用支持这些字段的官方 Python SDK,并设置环境变量 OPENAI_API_KEY。示例连续发送两个共享前缀的请求;重复文本仅用于确保前缀超过缓存门槛,生产环境应替换为真实稳定规则。
from openai import OpenAI

client = OpenAI()

# 生产环境应替换为真实且稳定的规则;重复内容仅用于超过缓存门槛。
stable_prefix = (
    "你是企业客服助手。只依据已提供规则回答;"
    "无法确认时明确说明未知,不得编造。\n"
) * 80

def call(question: str) -> None:
    # 显式模式只缓存断点之前的稳定前缀,避免动态问题产生重复写入。
    response = client.responses.create(
        model="gpt-5.6",
        prompt_cache_key="tenant-acme-support-v1",
        prompt_cache_options={"mode": "explicit"},
        input=[
            {
                "type": "message",
                "role": "user",
                "content": [
                    {
                        "type": "input_text",
                        "text": stable_prefix,
                        "prompt_cache_breakpoint": {"mode": "explicit"},
                    },
                    {"type": "input_text", "text": question},
                ],
            }
        ],
    )

    # 同时记录读取量和写入量,才能判断缓存是否真正节省成本。
    details = response.usage.input_tokens_details
    print("cached_tokens=", getattr(details, "cached_tokens", 0))
    print("cache_write_tokens=", getattr(details, "cache_write_tokens", 0))

call("退款多久到账?")
call("如何修改收款账户?")
全新缓存键首次运行时的典型预期输出如下,实际 token 数由提示长度决定:
cached_tokens= 0
cache_write_tokens= <WRITE_TOKENS>
cached_tokens= <CACHED_TOKENS>
cache_write_tokens= 0
第二次的 <CACHED_TOKENS> 大于 0 表示命中;cache_write_tokens 表示本次写入缓存的前缀 token 数。请求不足 1024 tokens 时,cached_tokens 会保持为 0。
风险与边界
- 把时间戳、随机 ID 或用户数据放进断点之前,会改变前缀并触发未命中;后果是重复计算,GPT-5.6 及后续模型还可能产生缓存写入费用。安全做法是把变量全部移到断点之后。
- 同一个 key 混用多个不同前缀或流量明显高于约 15 请求/分钟时,部分请求可能无法命中。按租户、提示版本或稳定分片拆分 key,并保持同一前缀始终映射到同一 key。
- 缓存不会扩大上下文窗口,也不会保证固定延迟;缓存被淘汰、模型变化或前缀任一字符变化都可能重新计算。业务超时仍需独立配置重试与降级。
排障清单
cached_tokens 一直为 0 时,依次检查:前缀是否达到门槛、断点前内容是否逐字一致、工具和图片顺序是否变化、模型是否支持显式断点、是否复用了相同 prompt_cache_key。
兼容性
GPT-5.6 及后续模型可使用 prompt_cache_options 和显式断点;更早模型可能只支持自动缓存或旧版 prompt_cache_retention。升级模型前同时核对缓存字段、写入计费和最低前缀长度,不要直接复用旧配置。
client.responses.create(model="<MODEL>", input="<问题>", max_output_tokens=<N>, stream=True)从模型、令牌、流式传输、并发和网络层面降低响应时间。
优化响应延迟
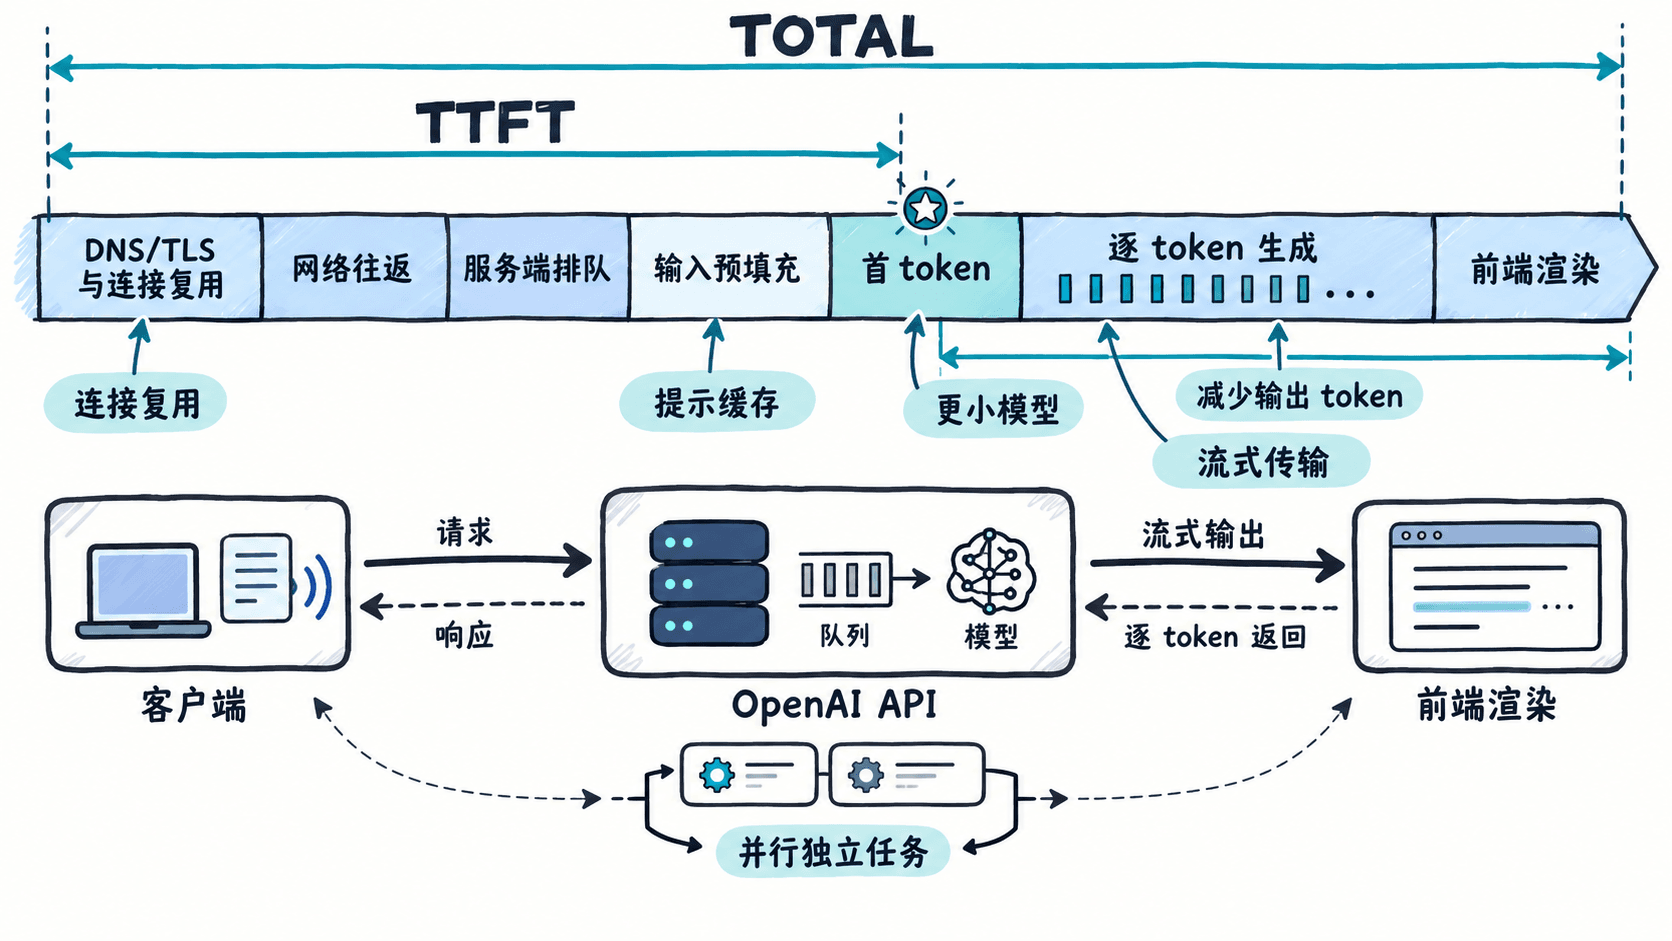
先把延迟拆成首 token 时间、完整响应时间和并发排队时间,再决定优化位置。通常优先选择满足质量要求的更小模型、减少输出 token、启用流式传输、合并串行请求并并行执行互不依赖的步骤。
先测两个指标
TTFT 是从发起请求到收到首段文本的时间,决定用户何时看到内容;TOTAL 是完整响应结束时间,受输出长度影响更明显。生产环境至少记录模型、输入/输出 token、是否命中缓存、HTTP 状态、重试次数以及 TTFT、TOTAL 的 p50 和 p95。
流式测量示例
示例使用 Responses API 的 SSE 流式事件,边接收边输出,并分别计算首 token 与总耗时。
import time
from openai import OpenAI

client = OpenAI()
started_at = time.perf_counter()
first_token_at = None  # 用首个文本增量计算 TTFT,而不是连接建立时间。

stream = client.responses.create(
    model="gpt-5.6",
    input="法国首都是哪里?只输出城市名。",
    max_output_tokens=20,
    stream=True,
)

for event in stream:
    # 只处理文本增量;其他事件仍可用于状态、错误和用量监控。
    if event.type == "response.output_text.delta":
        if first_token_at is None:
            first_token_at = time.perf_counter()
        print(event.delta, end="", flush=True)

finished_at = time.perf_counter()
ttft = (first_token_at or finished_at) - started_at
total = finished_at - started_at
print(f"\nTTFT={ttft:.2f}s TOTAL={total:.2f}s")
预期输出如下,耗时会随网络、负载、模型和区域变化:
巴黎
TTFT=<SECONDS>s TOTAL=<SECONDS>s
流式传输主要降低“看见结果”的等待,不一定缩短模型完成全部生成的时间。若前端仍等到流结束才渲染,用户不会获得流式收益。
优化顺序
- 模型:在离线评测通过后,选择满足质量要求的更小、更快模型;不要仅凭单次主观测试降级。
- 输出:明确要求短答案、精简结构化字段,并设置合理输出上限。生成 token 通常是主要耗时,缩短输出往往比删少量输入更有效。
- 请求拓扑:能合并的连续步骤一次完成;互不依赖的检索、分类或工具调用并行执行,避免无必要的串行往返。
- 输入与缓存:裁剪低相关 RAG 文档、清洗 HTML,把稳定内容放在前面以提高提示缓存命中率。
- 网络:复用 SDK 客户端和 HTTP 连接,避免每次请求重新建立 DNS、TCP 和 TLS;在服务端转发流时及时 flush,避免代理缓冲。
风险与边界
- 盲目换小模型可能降低准确率;后果是错误答案增加。安全替代是先用固定评测集比较质量、TTFT、TOTAL 和成本,再灰度切换。
- 过低的输出上限可能使响应变为不完整;后果是 JSON 截断或工具参数缺失。应检查响应状态和不完整原因,并为结构化输出预留足够空间。
- 无上限并发会触发限流或放大尾延迟;应使用有界线程池、信号量或队列,并对 429、5xx 采用带抖动的指数退避。
- 自动重试会增加用户可见耗时,非幂等工具调用还可能重复执行。只重试可安全重放的请求,并记录请求 ID 与重试次数。
排障清单
TTFT 高而 TOTAL 正常时,重点检查模型选择、服务端排队、提示缓存和网络握手;TTFT 正常但 TOTAL 高时,优先减少输出 token。只有 p95 变差时,检查并发峰值、429 重试和连接池耗尽;前端无渐进显示时,检查反向代理是否缓冲 SSE,以及客户端是否逐事件刷新。
client.responses.create(model="<MODEL>", input=<裁剪后的上下文>, max_output_tokens=<N>, reasoning={"effort": "<low|medium|high>"}, text={"verbosity": "low"})通过模型分层、上下文裁剪、缓存和批处理降低费用。
控制 OpenAI API 调用成本
先按“模型分层、减少请求、压缩输入、限制输出、复用缓存、离线批处理”的顺序优化。每次只改一个变量,并用固定评测集确认质量没有下降;官方也将减少请求、减少 Token 和选择更小模型列为主要成本手段。:contentReference[oaicite:0]{index=0}
成本控制顺序
| 手段 | 适用场景 | 关键动作 |
|---|---|---|
| 模型分层 | 简单任务占多数 | 简单抽取用 gpt-5.6-luna,常规分析用 gpt-5.6-terra,仅困难任务升级到 gpt-5.6 |
| 减少请求 | 多轮重复调用 | 合并可独立批量处理的数据,避免为格式修正再次调用 |
| 裁剪上下文 | 会话持续增长 | 保留系统约束、最近消息和必要摘要,删除重复历史与无关工具结果 |
| 限制输出 | 只需短答案或结构化字段 | 设置 max_output_tokens,并用 text.verbosity 控制默认详略 |
| Prompt Caching | 多次请求共享长且稳定的前缀 | 固定公共指令、工具定义和资料顺序,把动态用户输入放到末尾 |
| Batch API | 评测、分类、离线生成 | 将非实时请求提交批任务;官方说明其相对同步 API 可降低 50% 成本,并在 24 小时内完成。:contentReference[oaicite:1]{index=1} |
可运行示例
下面用任务复杂度选择模型,并按完整消息裁剪历史。字符数只是便宜的入口保护,不是精确 Token 计数。
from openai import OpenAI

client = OpenAI()

def choose_model(complexity: str) -> str:
    return {
        "simple": "gpt-5.6-luna",
        "normal": "gpt-5.6-terra",
        "hard": "gpt-5.6",
    }[complexity]

def keep_recent_messages(messages: list[dict], max_chars: int = 6000) -> list[dict]:
    kept: list[dict] = []
    used = 0
    for message in reversed(messages):
        size = len(message["content"])
        if used + size > max_chars:
            break
        kept.append(message)
        used += size
    return list(reversed(kept))

history = [
    {"role": "user", "content": "旧问题:" + "x" * 7000},
    {"role": "user", "content": "只回复 ASCII 字符串 OK,不要附加其他内容。"},
]

model = choose_model("simple")
response = client.responses.create(
    model=model,
    input=[
        {"role": "system", "content": "严格遵守用户要求。"},
        *keep_recent_messages(history),
    ],
    max_output_tokens=16,
    reasoning={"effort": "none"},
    text={"verbosity": "low"},
)

print(f"model={model}")
print(f"text={response.output_text}")
print(
    f"input_tokens={response.usage.input_tokens} "
    f"output_tokens={response.usage.output_tokens} "
    f"total_tokens={response.usage.total_tokens}"
)
预期输出
model=gpt-5.6-luna
text=OK
input_tokens=<COUNT> output_tokens=<COUNT> total_tokens=<COUNT>
<COUNT> 由实际分词和服务端处理决定。示例会丢弃超出上限的旧消息,但保留最近的完整消息,不会截断单条消息中间内容。
缓存与批处理
Prompt Caching 对符合条件的请求自动生效。要提高命中率,应将完全相同的长前缀放在最前面,并记录 cached_tokens 与 cache_write_tokens。GPT-5.6 及后续系列的缓存写入按未缓存输入价的 1.25 倍计费,前缀至少 1024 Token 才可缓存;因此低复用或频繁变化的前缀可能反而增加成本。:contentReference[oaicite:2]{index=2}
Batch API 适合不要求立即响应的评测、分类、嵌入和离线生成。交互式接口仍应使用同步 Responses API,避免把最长 24 小时的批处理时限带给在线用户。:contentReference[oaicite:3]{index=3}
风险与边界
直接把所有请求降到低价模型,触发条件是只按成本路由而没有质量门槛,后果可能是抽取漏字段、推理错误或工具调用失败。安全替代是按业务类型建立评测集,低价模型未达阈值时再升级模型。
过度裁剪上下文,触发条件是仅按长度删除历史,后果是丢失用户约束、已确认事实或安全边界。安全替代是固定保留系统消息、当前用户请求和关键摘要,并对重要状态单独持久化。
输出上限过低,触发条件是 max_output_tokens 小于任务所需长度,后果是响应不完整。安全替代是监控响应状态与不完整原因,对允许重试的任务提高上限,而不是无条件重复请求。
排障清单
- 成本突然升高:按模型、业务和请求 ID 检查输入、输出、缓存写入及工具调用费用。
cached_tokens长期为 0:确认公共前缀至少 1024 Token、内容与顺序完全一致,动态字段位于后部。- 切换低价模型后错误率上升:回滚路由规则,用同一评测集比较质量、Token、延迟和总费用。
- 请求数未下降:检查是否存在格式修复、重试风暴或可合并的串行调用。
速查原则:先减少无效请求和 Token,再选择更低价模型;任何降本措施都必须通过质量评测。
response.usage.input_tokens | output_tokens | total_tokens
response.usage.input_tokens_details.cached_tokens
response.usage.output_tokens_details.reasoning_tokens
读取响应用量字段并按项目、模型和业务请求记录消耗。
统计 OpenAI API Token 用量
每次调用完成后读取 response.usage,并连同项目、模型、业务请求 ID 和响应 ID 落库。这样可以定位单次异常、按业务聚合成本,并区分普通输入、缓存读取、缓存写入和输出消耗。
用量字段
| 字段 | 含义 | 记录建议 |
|---|---|---|
usage.input_tokens |
本次输入 Token 总数 | 必记 |
usage.output_tokens |
本次输出 Token 总数 | 必记 |
usage.total_tokens |
输入与输出等本次总用量 | 必记,用于快速核对 |
usage.input_tokens_details.cached_tokens |
从 Prompt Cache 读取的输入 Token | 使用缓存时必记 |
usage.input_tokens_details.cache_write_tokens |
写入 Prompt Cache 的 Token | GPT-5.6 及后续系列必记 |
usage.output_tokens_details.reasoning_tokens |
输出用量中的推理 Token 明细 | 使用推理模型时建议记录 |
Responses API 在 usage.input_tokens_details 返回缓存读取明细;GPT-5.6 及后续系列还通过 cache_write_tokens 报告缓存写入量。:contentReference[oaicite:4]{index=4}
可运行示例
示例调用 Responses API,并把用量写入本地 SQLite。运行前设置 OPENAI_API_KEY,可用 OPENAI_MODEL 覆盖默认模型。
import os
import sqlite3
import uuid
from datetime import datetime, timezone

from openai import OpenAI

client = OpenAI()
model = os.getenv("OPENAI_MODEL", "gpt-5.6-luna")
project = "support-service"
business_request_id = str(uuid.uuid4())

response = client.responses.create(
    model=model,
    input="只回复 ASCII 字符串 OK,不要附加其他内容。",
    max_output_tokens=16,
    reasoning={"effort": "none"},
    text={"verbosity": "low"},
)

usage = response.usage
input_details = getattr(usage, "input_tokens_details", None)
output_details = getattr(usage, "output_tokens_details", None)

record = {
    "created_at": datetime.now(timezone.utc).isoformat(),
    "project": project,
    "model": response.model,
    "business_request_id": business_request_id,
    "response_id": response.id,
    "input_tokens": usage.input_tokens,
    "cached_tokens": getattr(input_details, "cached_tokens", 0) or 0,
    "cache_write_tokens": getattr(input_details, "cache_write_tokens", 0) or 0,
    "output_tokens": usage.output_tokens,
    "reasoning_tokens": getattr(output_details, "reasoning_tokens", 0) or 0,
    "total_tokens": usage.total_tokens,
}

with sqlite3.connect("openai_usage.db") as conn:
    conn.execute(
        '''
        CREATE TABLE IF NOT EXISTS api_usage (
            created_at TEXT NOT NULL,
            project TEXT NOT NULL,
            model TEXT NOT NULL,
            business_request_id TEXT NOT NULL,
            response_id TEXT NOT NULL UNIQUE,
            input_tokens INTEGER NOT NULL,
            cached_tokens INTEGER NOT NULL,
            cache_write_tokens INTEGER NOT NULL,
            output_tokens INTEGER NOT NULL,
            reasoning_tokens INTEGER NOT NULL,
            total_tokens INTEGER NOT NULL
        )
        '''
    )
    conn.execute(
        '''
        INSERT INTO api_usage VALUES (
            :created_at, :project, :model, :business_request_id, :response_id,
            :input_tokens, :cached_tokens, :cache_write_tokens,
            :output_tokens, :reasoning_tokens, :total_tokens
        )
        ''',
        record,
    )
    row_count = conn.execute("SELECT COUNT(*) FROM api_usage").fetchone()[0]

print(f"text={response.output_text}")
print(
    f"project={project} model={response.model} "
    f"request={business_request_id} response={response.id}"
)
print(
    f"input={record['input_tokens']} cached={record['cached_tokens']} "
    f"cache_write={record['cache_write_tokens']} output={record['output_tokens']} "
    f"reasoning={record['reasoning_tokens']} total={record['total_tokens']}"
)
print(f"db_rows={row_count}")
预期输出
text=OK
project=support-service model=<MODEL_ID> request=<ID> response=resp_<ID>
input=<COUNT> cached=<COUNT> cache_write=<COUNT> output=<COUNT> reasoning=<COUNT> total=<COUNT>
db_rows=<ROW_COUNT><MODEL_ID>、<ID>、<COUNT> 和 <ROW_COUNT> 每次可能不同。首次运行通常为 db_rows=1;重复运行会继续累加。
记录与聚合
生产环境至少记录 timestamp、project、environment、model、business_request_id、response_id、六类 Token 明细、请求状态和重试次数。不要记录完整提示词来做成本统计,避免把敏感数据复制到日志系统。
日报应按项目、模型和业务类型汇总请求数、输入、缓存读取、缓存写入、输出、推理 Token、失败率和平均每请求 Token。价格随模型和处理方式变化,费用计算应从受版本控制的价格配置读取,不要把单价硬编码进业务代码。
风险与边界
只记录 total_tokens,触发条件是忽略输入、输出和缓存明细,后果是无法判断成本来自长上下文、长输出还是低缓存命中。安全替代是保存完整 usage 拆分字段。
在客户端预估后替代服务端用量,触发条件是只使用本地分词结果,后果是遗漏工具、图像、推理或服务端计费明细。安全替代是以响应中的 usage 为结算分析基准,本地计数只用于调用前限流。
失败请求不落库,触发条件是仅在成功分支记录,后果是看不到重试风暴和无效消耗。安全替代是在统一调用拦截器中记录成功、失败、响应 ID、错误码和重试次数;没有 usage 时明确存空值,不伪造为 0。
排障清单
usage为空:确认读取的是最终完成响应;流式调用应在完成事件后统一记录,不要累加文本增量。cached_tokens为 0:短请求可能未达到缓存最低前缀长度,也可能是前缀内容或顺序发生变化。- 数据重复:以
response_id建唯一约束,重试写库时使用幂等插入。 - 账单与估算不一致:核对模型版本、缓存写入、工具调用、Batch 或 Flex 处理方式及价格配置生效时间。
速查原则:服务端 usage 负责事实记录,价格配置负责金额换算,业务请求 ID 负责把消耗追溯到真实调用链。