数据结构与算法 / 知识点
数据结构与算法复杂度速查
算法选择
在 n 足够大时,通常按 O(1)、O(log n)、O(n)、O(n log n)、O(n²)、O(2ⁿ)、O(n!) 判断增长快慢;小规模时常数因子仍可能改变实际表现。
时间复杂度比较顺序
需要快速比较两个算法随输入规模增长时谁更容易失控,可先按渐进增长率排序;这个顺序适合做大规模输入下的第一轮筛选,但不能直接等同于真实运行时间。
怎么判读
| 复杂度 | 增长特征 | 常见判断动作 |
|---|---|---|
O(1) |
工作量基本不随 n 增长 |
通常优先保留 |
O(log n) |
n 成倍增加时只增加少量步骤 |
很适合大规模输入 |
O(n) |
工作量与输入规模近似成正比 | 通常可以接受 |
O(n log n) |
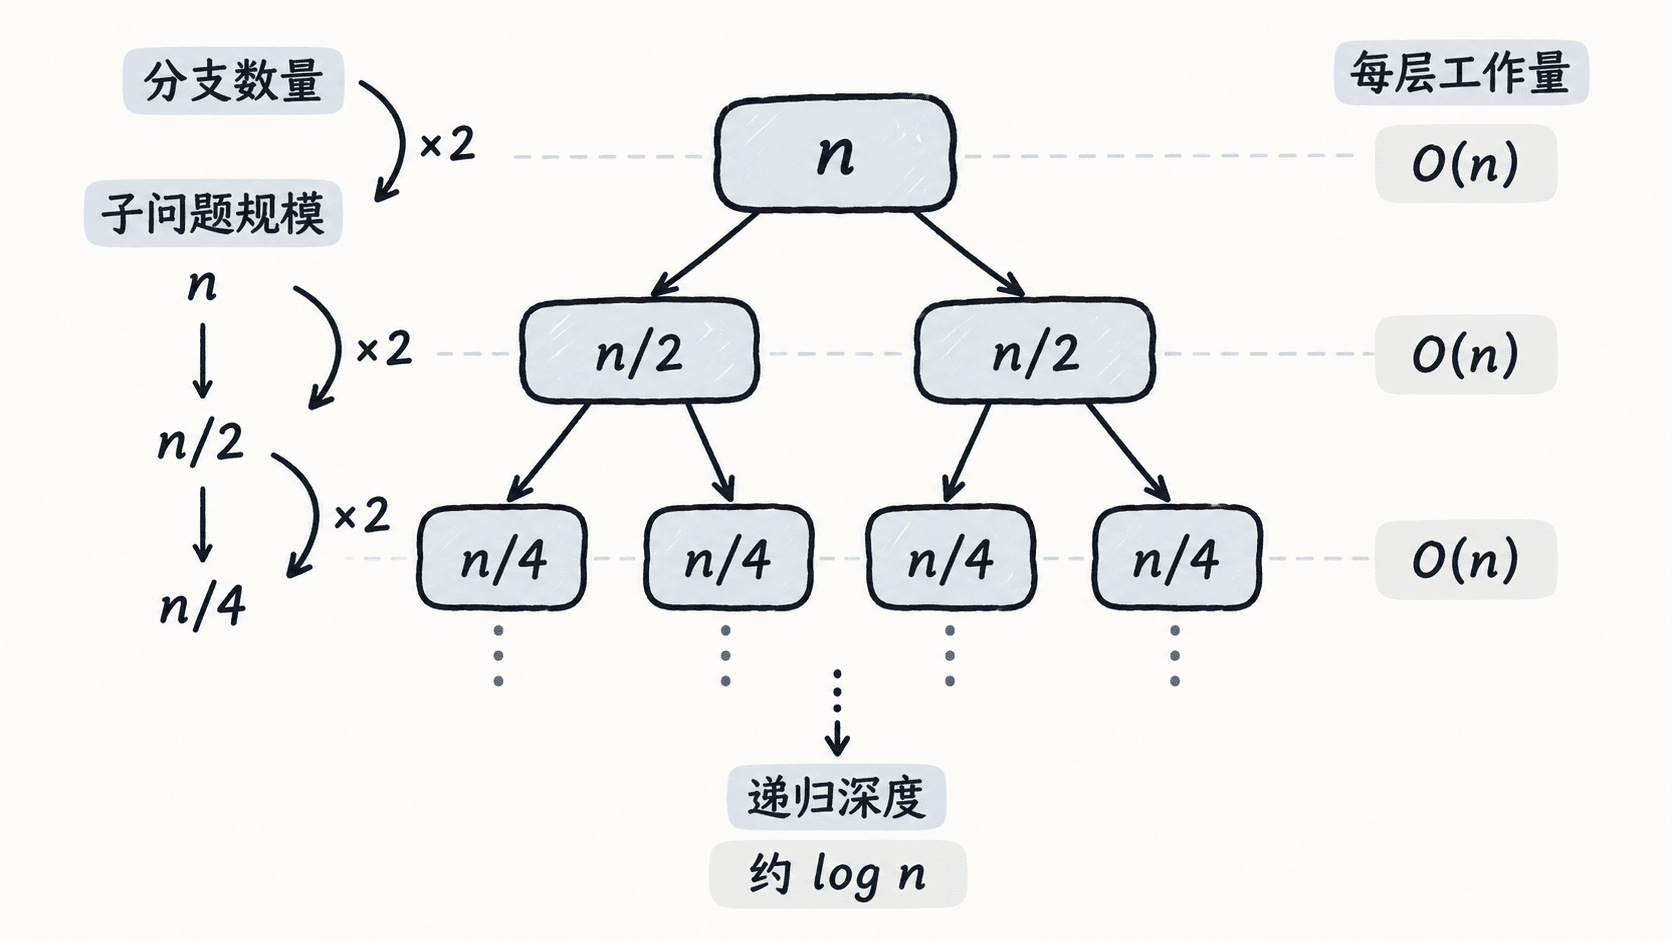
比线性增长更快,但远低于平方级 | 常见于高效排序、分治算法 |
O(n²) |
n 翻倍时工作量约增至四倍 |
大输入前先估算规模上限 |
O(2ⁿ) |
每增加一个规模单位都可能近似翻倍 | 只适合很小的 n 或需要剪枝、状态压缩 |
O(n!) |
增长速度极快 | 通常只能处理极小规模 |
当 n 足够大时,常用增长顺序是 O(1) < O(log n) < O(n) < O(n log n) < O(n²) < O(2ⁿ) < O(n!)。比较时先看增长阶,再看题目的最大输入规模是否会让操作次数进入不可接受区间。
容易误判的情况
相同 Big-O 不代表实际速度相同。例如两个 O(n) 算法可能分别执行约 2n 和 100n 次核心操作;在 n 较小时,常数因子、缓存局部性、函数调用和内存分配都可能主导结果。
反过来,小规模输入下一个 O(n²) 实现也可能暂时比复杂但常数较大的 O(n log n) 实现更快。因此复杂度排序回答的是增长趋势,不是某次运行的绝对耗时。
选择动作
先用最大输入规模排除明显不可行的增长阶,再在剩余方案中比较常数开销、额外空间、数据分布和实现复杂度。若两个方案复杂度相同,应通过基准测试或实际工作负载继续判断,而不是仅凭 Big-O 得出速度结论。