
数据结构与算法 / 知识点
数据结构与算法复杂度速查
查找与排序
在有序且可随机访问的数据上,每轮缩小约一半搜索区间,时间复杂度为 O(log n);边界定义错误是实现中最常见的风险。
二分查找
需要在已排序且支持高效随机访问的数据中定位目标值时查这一项。二分查找每轮排除约一半候选区间,典型时间复杂度为 O(log n);判断能否使用时,先确认有序性,再检查区间边界和返回条件是否一致。
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
| 数据已按比较规则排序 | 满足二分查找的核心前提 | 可继续检查访问方式和边界定义 |
| 数组、切片等可随机访问结构 | 读取中间位置通常为 O(1) |
二分查找通常能保持 O(log n) 时间 |
| 每轮根据中点排除约一半区间 | 搜索范围指数级缩小 | 预计最多进行对数级比较 |
| 数据无序 | 无法根据一次比较安全排除半边 | 不应直接使用二分查找 |
| 链式结构需要逐节点走到中点 | 找中点本身可能不是 O(1) |
不应只根据比较次数宣称整体为 O(log n) |
复杂度范围
在长度为 n 的有序随机访问序列中,每轮将候选元素数量从 n 缩小到约 n/2。经过 k 轮后剩余规模约为 n/2^k,因此找到目标或确认不存在所需轮数为对数级,最坏时间复杂度为 O(log n)。
迭代实现通常只维护左右边界和中点,额外空间为 O(1)。如果使用递归实现,调用栈深度随搜索轮数增长,额外空间通常为 O(log n)。
边界检查
实现出错往往不是复杂度判断错误,而是区间约定前后不一致。闭区间 [left, right] 常配合 left <= right;左闭右开区间 [left, right) 常配合 left < right。更新边界时也必须遵循同一约定,否则可能漏掉端点、重复检查中点或出现死循环。
快速判断
看到“有序数组中查找目标值、边界位置、首个满足条件的位置”一类问题时,可以优先考虑二分思路。若输入无序且只查询一次,先排序再二分未必划算,因为排序通常还需要 O(n log n) 时间。
从头到尾检查元素直到命中目标,最坏时间复杂度为 O(n);适合无序、小规模或只扫描一次的数据,额外空间通常为 O(1)。
线性查找
需要在无序数据、规模较小的数据或只进行一次查找时,可以查这一项。线性查找按顺序逐个比较元素,命中后即可停止;若目标不存在,最坏情况下必须检查全部 n 个元素,因此最坏时间复杂度为 O(n)。
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
| 数据无序 | 无法根据一次比较排除大段候选元素 | 直接顺序扫描通常最简单 |
| 只进行一次查找 | 建立索引或先排序的成本可能无法摊薄 | 优先考虑线性查找 |
| 数据规模很小 | O(n) 的常数开销通常较低 |
不必为了复杂度等级引入额外结构 |
| 目标靠近序列开头 | 可能很快命中 | 实际比较次数可能远小于 n |
| 目标不存在或位于末尾 | 几乎需要检查所有元素 | 按最坏 O(n) 估算 |
| 同一数据需要大量重复查询 | 每次都重新扫描会累积较高成本 | 考虑排序、哈希表或其他索引结构 |
复杂度范围
若目标位于第一个位置,最佳情况下只比较一次,可记为 O(1);若目标不存在或位于最后一个位置,需要检查最多 n 个元素,最坏时间复杂度为 O(n)。在目标位置近似均匀分布的简单模型下,平均仍需检查与 n 成比例的元素,因此平均量级也是 O(n)。
顺序扫描通常只需要保存当前位置和目标值,额外空间为 O(1)。这个结论假设查找过程没有额外复制整个输入或创建与 n 同规模的辅助结构。
与二分查找区分
二分查找依赖有序数据和高效随机访问,可以把搜索范围反复减半;线性查找不要求输入有序,也不需要访问中间位置。对于一次性的无序输入,线性扫描可能比“先排序再二分”更直接,因为后者还要承担排序成本。
快速判断
看到“无序集合中找一个元素”“数据很少”“只扫描一次”时,先考虑线性查找。看到“同一批数据需要大量重复查询”时,则应进一步判断是否值得建立哈希索引、保持有序或使用其他专门的数据结构。
围绕基准元素进行分区并递归排序,平均时间为 O(n log n),最坏可退化到 O(n²);基准选择和实现方式会显著影响实际表现。
快速排序
需要判断快速排序的时间、空间代价或是否存在退化风险时查这一项。它依靠基准元素把序列分成两侧再递归处理,平均时间复杂度为 O(n log n),但分区长期严重失衡时会退化到 O(n²)。
复杂度怎么查
| 情况 | 时间复杂度 | 判读与动作 |
|---|---|---|
| 分区较均衡 | O(n log n) | 常见平均情况,可作为一般性能估计 |
| 每次接近一边为空 | O(n²) | 出现严重不均衡分区,应检查基准选择和输入特征 |
| 原地分区实现 | 额外空间主要来自递归栈 | 平均递归深度通常为 O(log n),极端退化时可达 O(n) |
为什么会退化
一次分区需要扫描当前区间。如果基准能把数据大致分成两部分,递归层数约为 O(log n),各层总扫描量约为 O(n),因此得到 O(n log n)。如果基准反复成为当前区间的极小值或极大值,问题规模只减少 1,递归层数增长到 O(n),总时间随之退化到 O(n²)。
判读线索
已排序或近似有序输入并不必然导致退化,关键取决于具体基准策略。若实现固定选择首元素或尾元素作为基准,这类输入更容易形成极端不平衡分区;随机基准、随机打乱或更稳健的取样策略可降低持续命中坏分区的概率。
快速排序通常不是稳定排序;对稳定性有硬性要求时不能只依据平均复杂度选择它。不同库实现还可能采用插入排序、小数组优化或最坏情况保护,因此实际空间与退化行为应以具体实现为准。
通过分治和有序合并稳定排序,时间复杂度在最好、平均和最坏情况下通常都是 O(n log n);数组实现一般需要 O(n) 辅助空间。
归并排序
需要确认归并排序的稳定复杂度、辅助空间或是否适合要求稳定性的排序场景时查这一项。它把序列递归拆分,再把两个有序部分合并,因此最好、平均和最坏时间通常都保持 O(n log n)。
复杂度怎么查
| 项目 | 典型复杂度或性质 | 判读与动作 |
|---|---|---|
| 最好时间 | O(n log n) | 标准归并流程通常仍会完成各层拆分与合并 |
| 平均时间 | O(n log n) | 可作为常规运行时间估计 |
| 最坏时间 | O(n log n) | 输入顺序通常不会把它退化到 O(n²) |
| 数组辅助空间 | O(n) | 内存紧张时需要把额外缓冲区计入成本 |
| 稳定性 | 可稳定 | 合并时相等元素优先取左侧即可保持原相对顺序 |
为什么保持 O(n log n)
每一层合并会处理全部 n 个元素,总工作量为 O(n)。把序列持续二分后,递归层数约为 O(log n),因此总时间为 O(n log n)。这一结构不依赖基准选择,所以不会像典型快速排序那样因持续失衡分区退化到 O(n²)。
判读线索
如果题目同时要求稳定排序和可预测的最坏时间,归并排序通常值得优先纳入候选;如果处理普通数组且额外 O(n) 缓冲空间不可接受,则需要重新评估实现方式或选择其他算法。
链表上的归并排序可以通过调整指针完成合并,辅助空间特征与数组版本不同。具体库实现还可能使用迭代归并、复用缓冲区或混合策略,因此空间开销应以实际实现为准。
先建立堆,再反复取出堆顶完成排序,时间复杂度为 O(n log n);原地版本额外空间较低,但通常不具备稳定排序特性。
堆排序
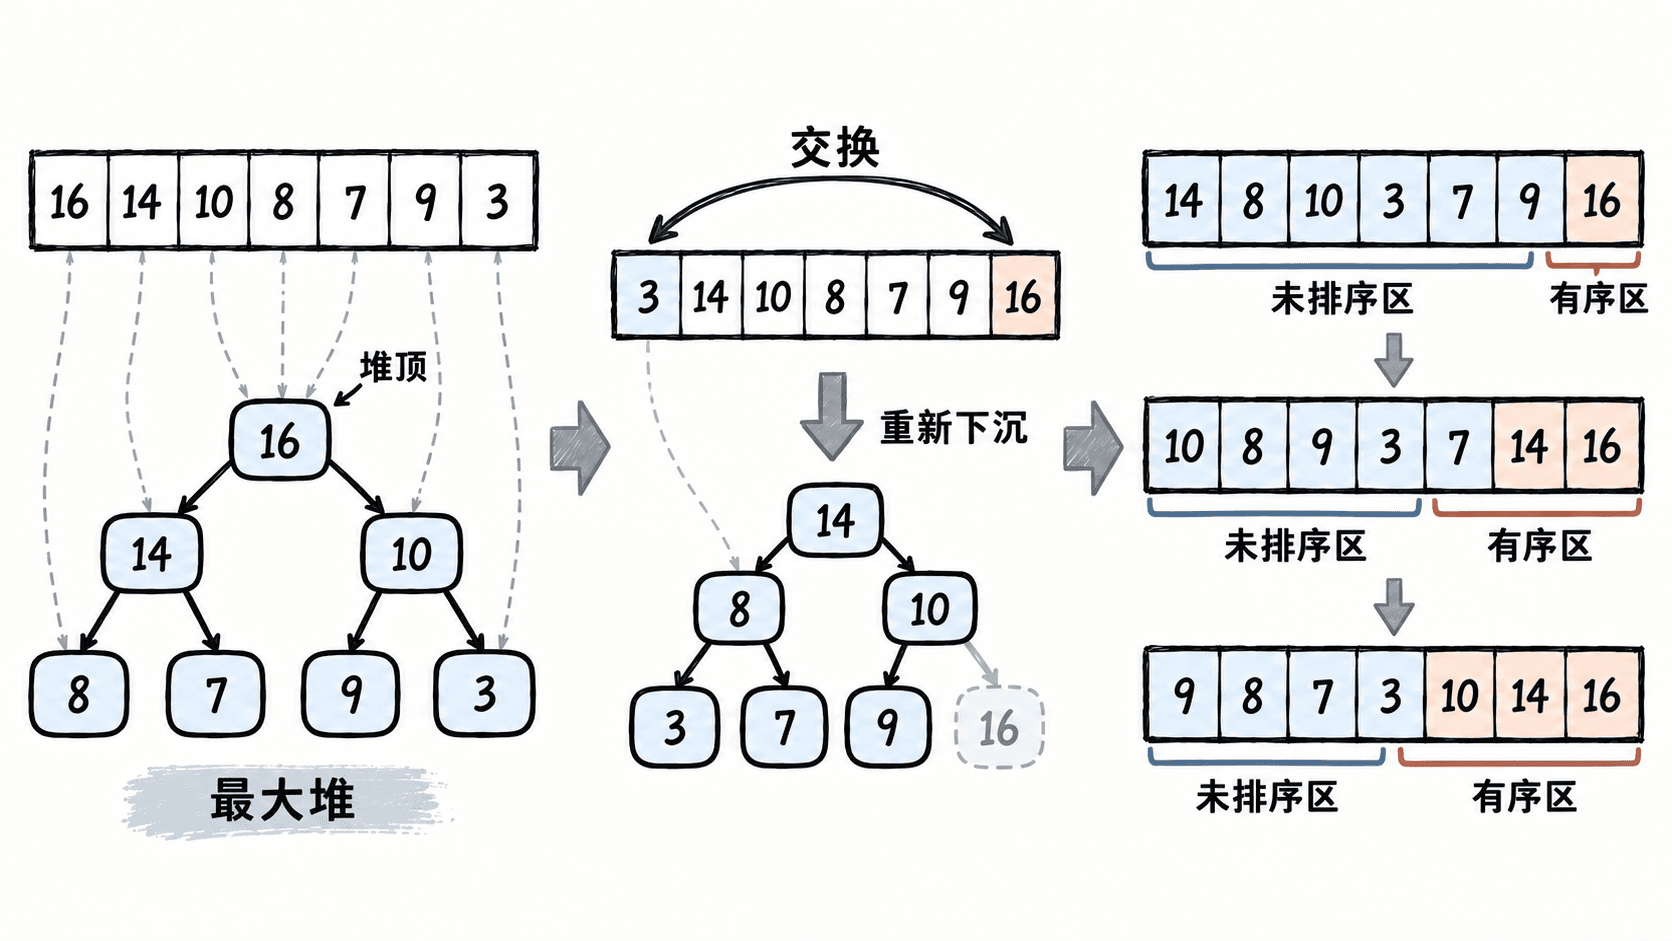
需要判断堆排序的复杂度、空间占用或稳定性时查这一项。数组原地实现通常先用线性时间建堆,再重复交换堆顶并恢复堆性质,因此整体时间稳定在 O(n log n)。
复杂度怎么判读
| 项目 | 结果 | 判读线索 |
|---|---|---|
| 建堆 | O(n) | 自底向上调整内部节点,不是对每个元素都执行完整的 O(log n) 上浮 |
| 排序阶段 | O(n log n) | 约 n 次取出堆顶,每次恢复堆性质最多沿树高移动 O(log n) |
| 总时间 | O(n log n) | 最好、平均和最坏量级通常相同 |
| 额外空间 | O(1) | 典型数组原地实现只使用常数级临时变量 |
| 稳定性 | 不稳定 | 堆顶与尾部元素的远距离交换可能改变相等元素的原始顺序 |
快速验证
下面的数组原地实现使用最大堆生成升序结果,可用于验证基本行为。
def heap_sort(values):
    n = len(values)

    def sift_down(root, end):
        # 在 [0, end) 范围内恢复最大堆性质。
        while True:
            child = root * 2 + 1
            if child >= end:
                return
            if child + 1 < end and values[child] < values[child + 1]:
                child += 1
            if values[root] >= values[child]:
                return
            values[root], values[child] = values[child], values[root]
            root = child

    for root in range(n // 2 - 1, -1, -1):
        sift_down(root, n)

    for end in range(n - 1, 0, -1):
        values[0], values[end] = values[end], values[0]
        sift_down(0, end)

items = [7, 1, 9, 3, 4]
heap_sort(items)
print(items)
预期输出:
[1, 3, 4, 7, 9]什么时候优先考虑
当需要 O(n log n) 的最坏时间上界,同时希望采用数组原地排序、避免 O(n) 级辅助数组时,堆排序具有明确优势。若业务要求稳定排序,典型堆排序不满足要求,应改用具有稳定性保证的排序方案。
这里的空间结论针对常见的迭代式数组原地实现;若实现使用递归或额外容器,实际辅助空间会随实现改变。
树与图
按层遍历图结构,每个顶点和边通常各处理常数次,时间复杂度为 O(V+E);适合无权图最短路与层级关系搜索。
广度优先搜索 BFS
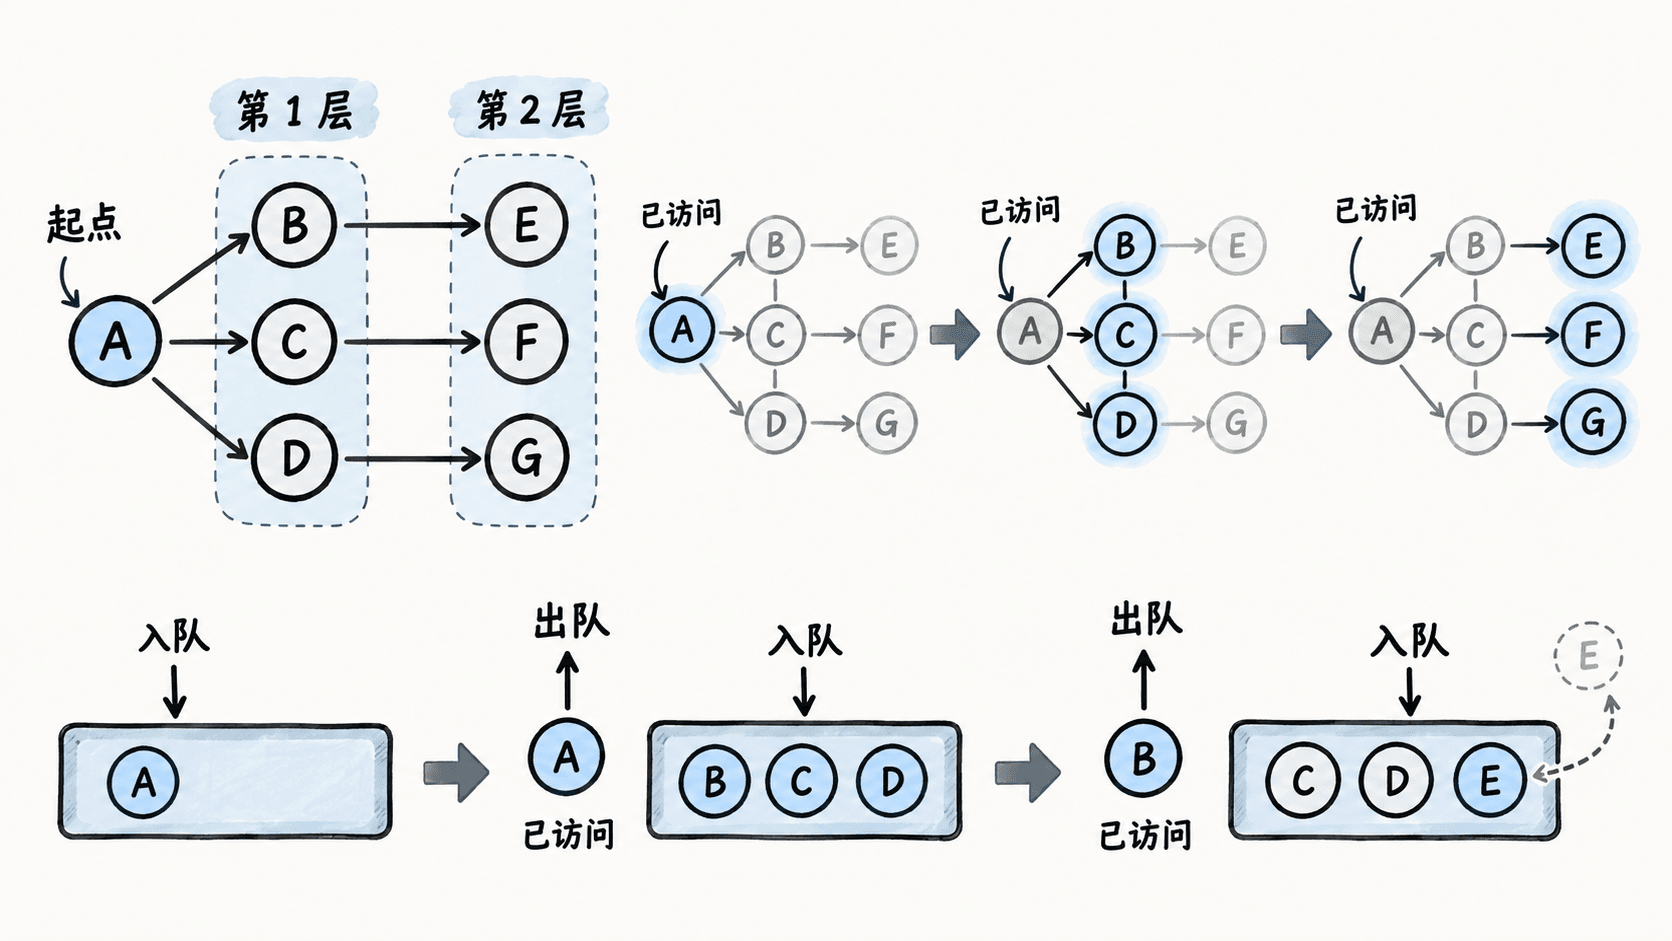
需要判断图的按层遍历、无权最短路或 BFS 复杂度时查这一项。使用邻接表并保证每个顶点只入队一次时,顶点与邻接边都只被常数次处理,因此时间复杂度为 O(V+E)。
复杂度怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
| 每个顶点首次发现时入队 | 顶点处理总量为 O(V) | 入队时立即标记已访问,避免重复入队 |
| 扫描当前顶点的邻接表 | 所有邻接表累计处理量为 O(E) | 使用邻接表可保持 O(V+E) |
| 队列保存待访问顶点 | 辅助空间最坏可达 O(V) | 大图需要关注队列和访问标记的内存占用 |
| 边没有权重或权重统一 | 首次到达层数就是最少边数 | 可直接用于无权图最短路 |
快速验证
下面从顶点 0 出发计算无权图中各顶点的最少边数。访问标记在入队时建立,可避免同一顶点重复进入队列。
from collections import deque

graph = {
    0: [1, 2],
    1: [3],
    2: [3, 4],
    3: [],
    4: [],
}

distance = {0: 0}
queue = deque([0])

while queue:
    node = queue.popleft()
    for neighbor in graph[node]:
        # 首次发现时记录距离并入队,保证每个顶点最多入队一次。
        if neighbor not in distance:
            distance[neighbor] = distance[node] + 1
            queue.append(neighbor)

print([distance[i] for i in range(5)])
预期输出:
[0, 1, 1, 2, 2]什么时候成立
O(V+E) 通常指使用邻接表的实现。若改用邻接矩阵,每访问一个顶点都扫描整行,时间复杂度通常变为 O(V²)。对于无向图,邻接表会保存一条无向边的两个方向,但总扫描量仍属于 O(E) 的同一渐进量级。
BFS 能直接得到无权图或等权图的最少边数路径;普通 BFS 不适用于一般带权图的最短路问题。
沿路径深入后回溯,遍历邻接表表示的图通常为 O(V+E);适合连通性、环检测、拓扑相关问题和回溯搜索框架。
深度优先搜索 DFS
需要判断 DFS 的遍历成本、实现是否会重复访问节点,或估算大图上的时间与空间时查这一条。邻接表配合访问标记完整遍历图时,时间通常为 O(V+E)。
复杂度怎么判读
| 条件 | 时间复杂度 | 判读与动作 |
|---|---|---|
| 邻接表,完整遍历 | O(V+E) |
每个顶点至多处理一次,每条边至多检查常数次 |
| 邻接矩阵,完整遍历 | O(V²) |
每访问一个顶点都要扫描整行矩阵 |
| 只从单一起点搜索 | 与实际可达子图有关 | 未访问到的顶点和边不会产生遍历成本 |
| 递归实现 | 额外调用栈最坏 O(V) |
深链或退化图要注意递归深度限制 |
这里的 V 表示顶点数,E 表示边数。若目标是遍历整个非连通图,需要从每个尚未访问的顶点再次启动 DFS,但邻接表下总成本仍为 O(V+E)。
快速确认
下面用邻接表遍历一个有向图,每个顶点只在第一次到达时继续递归。
from collections import defaultdict

graph = defaultdict(list, {
    "A": ["B", "C"],
    "B": ["D"],
    "C": [],
    "D": [],
})
visited = set()
order = []

def dfs(node):
    if node in visited:
        return
    visited.add(node)
    order.append(node)
    for nxt in graph[node]:
        dfs(nxt)

dfs("A")
print(" ".join(order))
预期输出:
A B D C若删除 visited 检查,在存在环的图中可能不断重复访问甚至递归不终止,因此复杂度判断中的“每个顶点至多处理一次”也不再成立。
判读线索与建议动作
发现复杂度高于预期时,先检查图的存储方式和访问标记。邻接矩阵会自然带来 O(V²) 扫描;邻接表实现若反复清空或遗漏访问集合,也可能造成大量重复工作。
DFS 适合连通性、环检测、拓扑相关处理以及以“选择后继续深入、失败再回退”为核心的搜索。若问题要求按距离层级逐层访问,应优先考虑 BFS,而不是仅根据两者同为线性遍历就互换。
适用范围以上述邻接表或邻接矩阵的常见图表示为准;若邻接查询本身具有额外成本,应把该成本计入总复杂度。
在非负边权图中用优先队列不断确定当前最短距离,邻接表配二叉堆时常写作 O((V+E) log V);负权边需改用其他算法。
Dijkstra 最短路
需要估算单源最短路性能、确认堆优化复杂度,或判断某张图能否使用 Dijkstra 时查这一条。邻接表配二叉堆的常见实现时间为 O((V+E) log V),前提是所有参与松弛的边权非负。
复杂度怎么判读
| 实现条件 | 时间复杂度 | 建议动作 |
|---|---|---|
| 邻接表 + 二叉堆 | O((V+E) log V) |
稀疏图的常用实现 |
| 邻接矩阵 + 线性找最小值 | O(V²) |
稠密图或规模较小时可以接受 |
| 存在负权边 | 不满足 Dijkstra 前提 | 改用支持负权边的最短路算法 |
二叉堆版本中,顶点和边通过邻接表扫描,距离改善时把新的候选距离压入优先队列。由于标准库堆通常不直接执行 decrease-key,实践中常允许同一顶点出现多个候选项,并在弹出时丢弃已经过期的距离。
快速确认
下面使用 Python 的 heapq 计算从 A 到其他顶点的最短距离。图中边权全部非负。
import heapq


graph = {
    "A": [("B", 1), ("C", 4)],
    "B": [("C", 2), ("D", 5)],
    "C": [("D", 1)],
    "D": [],
}

def dijkstra(start):
    dist = {node: float("inf") for node in graph}
    dist[start] = 0
    heap = [(0, start)]

    while heap:
        current_dist, node = heapq.heappop(heap)
        if current_dist != dist[node]:
            continue
        for nxt, weight in graph[node]:
            candidate = current_dist + weight
            if candidate < dist[nxt]:
                dist[nxt] = candidate
                heapq.heappush(heap, (candidate, nxt))
    return dist

result = dijkstra("A")
for node in sorted(result):
    print(f"{node}: {result[node]}")
预期输出:
A: 0
B: 1
C: 3
D: 4
输出表明 A → B → C → D 的累计距离为 4,比直接经过较大权重边到达 D 更短。
出现条件与判读线索
看到“非负边权、单源最短路、邻接表、优先队列”时,通常可以直接联想到堆优化 Dijkstra。若代码在弹出堆顶后没有过滤旧候选项,结果可能仍能得到正确距离,但会做更多无效松弛;若错误地把某个顶点第一次入堆就视为最终确定,则可能得到错误结果。
遇到负权边时不要通过调整堆或增加访问标记来修补。Dijkstra 依赖已经取出的最小候选距离不会再被后续路径降低,这一性质在负权边存在时不再保证。
结合路径压缩与按秩或按大小合并后,单次操作摊销复杂度为 O(α(n));常用于动态连通性、最小生成树和集合合并问题。
并查集操作
需要判断 find、union 是否接近常数时间,或估算大量集合合并的总代价时查这一项。标准并查集同时使用路径压缩与按秩或按大小合并后,连续操作的摊销复杂度为 ,其中 是增长极慢的反 Ackermann 函数;工程上通常可视为近似 ,但它并不是严格的常数复杂度。
怎么判读
| 条件或线索 | 复杂度含义 | 建议动作 |
|---|---|---|
find 使用路径压缩,union 按秩或大小合并 |
单次操作摊销 | 可用于大规模动态连通、Kruskal 等高频合并场景 |
| 只做朴素父指针合并 | 树可能退化成链 | 不要套用“近似 ”结论,先检查实现 |
| 需要存父节点和秩或大小 | 空间通常 | 把额外数组计入空间预算 |
这里的摊销结论针对一串操作,而不是保证每一次 find 都只走常数步。对 次 find/union 操作,常见写法是总时间 。
快速确认
下面的 Python 示例实现路径压缩与按大小合并,并执行两次合并和两次连通性查询。
class DSU:
    def __init__(self, n):
        self.parent = list(range(n))
        self.size = [1] * n

    def find(self, x):
        if self.parent[x] != x:
            self.parent[x] = self.find(self.parent[x])
        return self.parent[x]

    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False
        if self.size[ra] < self.size[rb]:
            ra, rb = rb, ra
        self.parent[rb] = ra
        self.size[ra] += self.size[rb]
        return True

uf = DSU(4)
uf.union(0, 1)
uf.union(1, 2)
print(uf.find(0) == uf.find(2))
print(uf.find(0) == uf.find(3))
预期输出:
True
False
适用范围
O(\alpha(n)) 依赖路径压缩与按秩或按大小合并这类经典优化同时存在。若实现只使用其中一项、支持回滚并查集、可持久化并查集,或修改了父指针维护方式,应按对应实现重新分析复杂度,不能直接沿用这一结论。
动态规划逐步允许更多中间点参与路径更新,时间复杂度为 O(V³),空间通常为 O(V²);适合顶点数较小且需要全部点对距离的场景。
Floyd-Warshall 全源最短路
需要一次得到所有顶点对最短距离,并判断 是否能接受时查这一项。Floyd-Warshall 用动态规划依次把每个顶点加入“允许作为中间点”的集合,时间复杂度固定为 ;若原地更新距离矩阵,额外空间通常由 的距离表主导,即 。
怎么判读
| 条件或线索 | 含义 | 建议动作 |
|---|---|---|
| 需要全部点对最短距离 | 一次运行直接得到完整距离矩阵 | 顶点数较小时可优先考虑 Floyd-Warshall |
| 图较稠密,边数接近 | 三重循环的简单实现更有竞争力 | 结合 的实际规模评估运行时间 |
| 仅需单源或少量源点 | 计算了大量无用点对 | 改用适合边权条件的单源最短路算法 |
| 存在负权边但没有负环 | 算法仍可计算最短距离 | 运行后检查对角线以识别负环 |
核心更新是:以顶点 k 作为新允许的中间点时,比较当前 dist[i][j] 与经过 k 的 dist[i][k] + dist[k][j],取更小值。三层顶点循环因此形成 时间复杂度。
快速确认
下面示例计算 4 个顶点的全源最短距离,并保留不可达关系为 INF。
INF = float("inf")
dist = [
    [0, 5, INF, 10],
    [INF, 0, 3, INF],
    [INF, INF, 0, 1],
    [INF, INF, INF, 0],
]

n = len(dist)
for k in range(n):
    for i in range(n):
        for j in range(n):
            dist[i][j] = min(dist[i][j], dist[i][k] + dist[k][j])

for row in dist:
    print(["INF" if x == INF else int(x) for x in row])
预期输出:
[0, 5, 8, 9]
['INF', 0, 3, 4]
['INF', 'INF', 0, 1]
['INF', 'INF', 'INF', 0]
负环与适用范围
算法允许负权边,但若存在可达负环,相关最短距离没有有限下界。完成三重循环后,只要发现某个 dist[v][v] < 0,就说明存在负环。标准复杂度结论针对邻接矩阵式动态规划实现;当 很大且图稀疏时,通常应根据边权条件改用多次单源最短路等方案。
算法范式
通常由状态数量乘以每个状态的转移成本决定,而不是简单看递归层数;分析时先明确状态空间,再统计每个状态被计算多少次。
动态规划时间复杂度
遇到动态规划题需要估算运行量时,先数实际会计算多少个状态,再数每个状态需要尝试多少次转移。常用判断式是“状态数 × 单状态转移成本”,不能只看递归深度或循环层数。
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
一维状态 dp[i],共有 n 个有效位置 |
状态数通常为 O(n) |
再统计每个 i 检查多少候选转移 |
二维状态 dp[i][j],两个维度分别为 n、m |
状态数上界通常为 O(n*m) |
检查是否所有组合都会实际计算 |
每个状态枚举 k 个选择 |
单状态转移通常为 O(k) |
总体常写为 O(状态数*k) |
| 转移还包含线性扫描、集合操作等 | 单次转移本身不是常数时间 | 把该操作的复杂度继续乘入 |
| 使用记忆化搜索 | 重复递归可能被缓存消除 | 数不同状态,而不是递归调用路径总数 |
快速确认
下面的完全背包式最少硬币示例有 target 个非初始状态,每个状态最多检查 len(coins) 种硬币,因此时间复杂度上界为 O(target*len(coins))。
coins = [1, 3, 4]
target = 6
inf = target + 1
dp = [0] + [inf] * target
transitions = 0

for amount in range(1, target + 1):
    for coin in coins:
        if coin <= amount:
            transitions += 1
            dp[amount] = min(dp[amount], dp[amount - coin] + 1)

print("min_coins =", dp[target])
print("transitions =", transitions)
预期输出:
min_coins = 2
transitions = 13
这里理论上每个状态最多尝试 3 种硬币,但小金额会跳过部分转移,所以实际执行了 13 次有效转移;复杂度分析仍使用随输入规模增长的上界。
容易误判的地方
循环层数不能直接等同于复杂度。若一个二维状态只访问稀疏的合法组合,实际状态数可能明显少于两个维度乘积;反过来,即使只有一层状态循环,只要每个状态内部还扫描 n 个候选,总时间仍可能达到 O(n^2)。
滚动数组通常只减少空间,不自动减少时间;把二维 dp 压成一维后,如果状态数和转移次数没有变化,时间复杂度通常保持不变。
适用范围
该方法适用于表格递推和带记忆化的动态规划。分析时应分别确认状态是否唯一计算、每个状态枚举的转移数量,以及转移内部是否还执行非恒定成本操作;具体复杂度最终取决于状态定义和实现。
复杂度主要取决于搜索树的分支数和深度,组合枚举常达到指数或阶乘级;剪枝、排序、约束传播和记忆化可显著缩小实际搜索空间。
回溯搜索复杂度
遇到排列、组合、子集或约束搜索时,应按搜索树估算复杂度:看每层能产生多少分支、最大深度是多少,以及哪些节点会被剪枝。不能仅凭递归函数只有几行就判断为线性复杂度。
怎么判读
| 搜索形态 | 典型规模 | 判读重点 |
|---|---|---|
每层固定约有 b 个分支,深度为 d |
最坏可接近 O(b^d) |
是否存在提前终止或强剪枝 |
枚举长度为 n 的全部子集 |
叶子数量为 2^n |
每个元素通常有选或不选两种分支 |
枚举 n 个不同元素的全部排列 |
叶子数量为 n! |
各层分支依次约为 n,n-1,...,1 |
| 组合搜索 | 与组合数相关 | 不应一律写成 2^n,要看实际选择规则 |
| 每个节点还扫描全部候选 | 节点成本额外增加 | 将单节点处理成本计入总时间 |
快速确认
下面程序枚举 3 个不同元素的全部排列,并统计实际访问的搜索树节点。简单实现中每个节点还会扫描 n 个候选,因此常用上界可写成 O(n*n!);若只讨论生成的排列数量,则有 n! 个叶子。
nums = [1, 2, 3]
nodes = 0
solutions = 0
used = [False] * len(nums)


def dfs(path):
    global nodes, solutions
    nodes += 1

    if len(path) == len(nums):
        solutions += 1
        return

    for i in range(len(nums)):
        if used[i]:
            continue
        used[i] = True
        path.append(nums[i])
        dfs(path)
        path.pop()
        used[i] = False


dfs([])
print("nodes =", nodes)
print("solutions =", solutions)
预期输出:
nodes = 16
solutions = 6
6 个叶子对应 3! 个排列;16 个节点还包含根节点和所有部分排列。输入增大后,节点数会随排列搜索树迅速增长。
剪枝怎么影响结果
剪枝通常改变实际访问的节点数,但只有能证明新的搜索上界时,才应据此改写渐进复杂度。排序后提前停止、约束传播或上下界判断可能让实际运行快很多,却不一定改变最坏情况仍为指数级或阶乘级这一事实。
记忆化只在不同搜索路径会到达相同子问题时有效。若状态由“当前位置 + 已选集合”等信息唯一决定,可以考虑缓存;如果每条路径本身都必须枚举并输出,缓存不能消除最终结果数量带来的成本。
适用范围
该判读方式适用于 DFS 回溯、排列组合枚举和约束满足类搜索。报告复杂度时应说明讨论的是最坏上界还是剪枝后的实际节点量,并把构造或复制结果的成本一并计入;不同约束条件下不能机械套用同一个指数表达式。
左右指针通常只向前移动,每个元素进入和离开窗口的次数有限,因此常可做到 O(n);关键是保证指针不会反复回退扫描。
滑动窗口复杂度
判断滑动窗口是否为 时,重点不要看代码里有没有嵌套 while,而要统计左右指针在整个执行期间一共移动多少次。若两个指针都只向前移动且不回退,每个元素进入、离开窗口的次数都是常数次,总移动量通常不超过输入规模的常数倍,因此整体可做到 。
怎么判读
| 线索 | 复杂度含义 | 建议动作 |
|---|---|---|
| 右指针从头到尾只前进一次,左指针也只前进 | 指针总移动次数为 | 通常可直接判为 |
| 外层移动右指针,内层不断收缩左边界 | 即使存在嵌套循环,只要左指针不回退,累计仍是 | 按累计移动次数分析,不要直接判成 |
| 每轮重新把左指针移回旧位置并重复扫描 | 同一元素可能被反复访问 | 需要重新计算,最坏可能达到 |
| 每次移动还执行平衡树、堆等 操作 | 窗口移动本身是线性,但单次维护不是常数时间 | 常见总复杂度变为 |
出现条件
典型线性滑动窗口适用于连续子数组、连续子串等区间问题。常见结构是右边界不断扩张,在条件不满足时推进左边界收缩窗口;只要两端都保持单调前进,并且加入或移除一个元素的维护成本为 ,就能得到 的时间复杂度。
固定长度窗口也是同样的判断方式:窗口每移动一次,只加入一个新元素并移除一个旧元素,共移动约 次,因此在常数时间维护窗口状态时仍是 。
容易误判的地方
看到双层循环不等于 。例如右指针执行 次,左指针虽然写在内层循环中,但整个程序期间最多也执行 次,因此两者是相加关系,而不是 的相乘关系。
反过来,如果某轮扩张后又把指针重置并重新扫描已经处理过的大段区间,就失去了这个摊还线性保证。此时应统计单个元素可能被重新访问多少次,而不能继续套用“滑动窗口通常 ”的结论。
适用范围
这里的 指窗口边界移动和常数时间状态维护的总成本。若窗口内部每次还需要排序、线性搜索、复制整个区间或维护对数复杂度的数据结构,应把这些操作的成本一并计入。空间复杂度也不能由“滑动窗口”名称直接推出,应根据实际保存的窗口状态和辅助数据结构单独判断。
两个指针协同移动时,若每个指针整体只遍历输入一遍,常见时间复杂度为 O(n);判断重点是是否存在嵌套回退导致重复扫描。
双指针复杂度
判断双指针是否为 时,核心是统计两个指针在整个算法中的累计移动次数。无论是同向移动还是从两端向中间移动,只要每个指针都沿一个方向单调前进、整体最多越过输入一次,总移动次数就是 ,因此常见双指针算法可以在线性时间内完成扫描。
怎么判读
| 线索 | 复杂度含义 | 建议动作 |
|---|---|---|
| 左右指针分别从两端向中间靠拢 | 两个指针合计最多移动约 次 | 通常判为 |
| 快慢指针都只向前,不重新回到已扫描位置 | 每个指针最多遍历输入一次 | 通常判为 |
| 外层每前进一步,都把另一个指针重置后重新扫描 | 同一段数据可能被重复遍历 | 最坏情况可能是 |
| 双指针前必须先排序 | 指针扫描是 ,但排序通常更贵 | 总复杂度通常由排序决定,为 |
| 每次移动还执行非 的辅助操作 | 指针次数仍是线性,但单步成本增加 | 将单步成本乘入总复杂度 |
常见移动方式
相向双指针常用于有序数组中的配对、去重或区间判断。一个指针从左向右、另一个从右向左,任一步通常都会让至少一个指针靠近终点,因此累计移动次数受输入长度限制。
同向双指针常见于快慢指针、读写指针和部分区间扫描。即使一个指针偶尔在另一个指针停住时连续移动,只要它不会回退到已经处理的位置,累计移动量仍然是线性的。
容易误判的地方
两个指针不意味着固定是 。如果代码对每个左指针位置都从头启动右指针,相当于进行了多轮完整扫描,复杂度就可能退化为 。判断时应关注“每个位置被访问多少次”,而不是变量数量。
还要区分双指针阶段和完整算法。例如“两数之和”若输入已经有序,双指针扫描可以是 ;若算法必须先对无序输入排序,排序通常需要 ,因此完整流程不能只写成 。
适用范围
“通常 ”只描述指针单调移动且每步处理成本为常数的情形。若算法需要输出大量结果,实际运行时间还至少受输出数量影响;若使用哈希表、排序、树结构或其他辅助处理,也应把这些成本分别计入,而不能只依据“双指针”这一算法形式判断复杂度。
先用 O(n) 时间构建累计数组,再把区间和查询降为 O(1);适合大量静态区间查询,但更新频繁时通常需要其他结构。
前缀和复杂度
查询区间累计值时查这个条目,可以快速判断是否适合使用前缀和,以及预处理、查询和更新各自的复杂度。
复杂度对照
| 操作 | 复杂度 | 含义 |
|---|---|---|
| 构建前缀数组 | 遍历原数组一次生成累计结果 | |
| 单次区间和查询 | 使用两个前缀值相减得到结果 | |
| 单点修改 | 普通数组前缀和需要重新影响后续累计值 |
判读线索
| 场景 | 是否适合 | 原因 |
|---|---|---|
| 数组固定,查询次数很多 | 适合 | 一次预处理换取大量快速查询 |
| 数据持续修改 | 谨慎使用 | 更新会导致前缀结果失效 |
| 需要区间和、区间计数 | 常用 | 可将区间问题转化为差值计算 |
快速确认
nums = [2, 4, 6, 8]
prefix = [0]

# 构建前缀和数组
for value in nums:
    prefix.append(prefix[-1] + value)

left, right = 1, 3
result = prefix[right + 1] - prefix[left]
print(result)
预期结果
18建议动作
如果查询远多于更新,优先考虑前缀和;如果存在大量动态修改,需要改用支持更新的数据结构,例如树状数组或线段树。具体选择取决于查询类型和修改频率。
元素入栈和出栈次数通常各不超过一次,因此整体可达 O(n);常用于下一个更大元素、柱状图和区间边界等问题。
单调栈复杂度
处理需要维护元素相对大小关系的问题时查这个条目,可以快速判断单调栈为什么通常不是 ,以及什么时候适合使用。
复杂度对照
| 操作 | 复杂度 | 含义 |
|---|---|---|
| 每个元素入栈 | 所有元素最多进入栈一次 | |
| 每个元素出栈 | 每个元素最多被移除一次 | |
| 总体时间复杂度 | 入栈和出栈次数合计线性 | |
| 额外空间复杂度 | 极端情况下栈保存全部元素 |
判读线索
| 问题特征 | 适用情况 | 判断依据 |
|---|---|---|
| 找下一个更大或更小元素 | 适合 | 需要维护未确定答案的元素 |
| 柱状图最大矩形 | 适合 | 利用边界变化确定区间 |
| 任意两两比较 | 不适合 | 会退化为更高复杂度 |
快速确认
nums = [2, 1, 5, 3]
stack = []
result = [-1] * len(nums)

for i, value in enumerate(nums):
    while stack and nums[stack[-1]] < value:
        index = stack.pop()
        result[index] = value
    stack.append(i)

print(result)
预期结果
[5, 5, -1, -1]建议动作
看到“下一个”“最近”“左边界/右边界”“保持递增或递减序列”等关键词时,可以优先检查单调栈方案。需要支持频繁插入删除或任意查询时,不应强行使用单调栈。
维护窗口内单调候选值,使每个元素进入和离开队列有限次,总体通常为 O(n);典型用途是滑动窗口最大值和最小值。
单调队列复杂度
遇到滑动窗口最值或需要持续维护区间候选值时,可查这个复杂度。关键结论是:虽然一次插入可能连续弹出多个旧候选,但每个元素在整个过程中只会进入队列一次、离开队列至多一次,因此总时间通常是 O(n),而不是 O(nk)。
怎么判读
| 线索 | 含义 | 复杂度或动作 |
|---|---|---|
| 每个元素入队一次 | 新元素只在扫描到自身时加入 | 累计 O(n) |
| 队尾元素被永久淘汰 | 被弹出的元素不会再次进入 | 所有队尾弹出累计 O(n) |
| 队首按窗口边界过期 | 每个下标最多从队首移除一次 | 所有过期删除累计 O(n) |
| 队列只保存当前窗口候选 | 队列长度不会超过窗口规模 | 空间通常 O(k) |
不要把内部 while 循环单独乘上外层的 n。摊还分析关注整个执行过程中的操作总次数:同一个下标一旦被弹出,就不会再次参与后续弹出。
快速确认
下面用递减单调队列求长度为 3 的滑动窗口最大值。队列保存下标而不是只保存数值,这样才能准确判断元素是否已经离开窗口。
from collections import deque


def sliding_max(nums, k):
    q = deque()
    result = []

    for i, value in enumerate(nums):
        # 删除已经离开当前窗口的下标
        while q and q[0] <= i - k:
            q.popleft()

        # 保持对应值从队首到队尾单调递减
        while q and nums[q[-1]] <= value:
            q.pop()

        q.append(i)
        if i >= k - 1:
            result.append(nums[q[0]])

    return result


print(sliding_max([1, 3, -1, -3, 5, 3, 6, 7], 3))
预期输出:
[3, 3, 5, 5, 6, 7]复杂度边界
设输入长度为 n、窗口长度为 k。扫描本身执行 n 次;每个下标至多入队一次,并且至多因失去候选资格或窗口过期而离队一次,所以总时间为 O(n)。队列只保存仍可能成为答案的窗口内下标,空间上界通常为 O(k)。
如果每次窗口移动后重新扫描全部 k 个元素求最大值,则会退化为 O(nk)。如果使用堆维护窗口最值,常见实现通常是 O(n log k);单调队列的优势来自能够永久淘汰不可能再次成为最值的候选。
基于入度或 DFS 对有向图进行线性遍历,邻接表表示下通常为 O(V+E);只适用于 DAG 的拓扑序问题,并可用于依赖调度。
拓扑排序复杂度
需要判断依赖调度、课程先修关系或构建顺序的成本时,可查这个结论。使用邻接表实现 Kahn 入度算法或标准 DFS 拓扑排序时,每个顶点和每条边只需处理常数次,因此时间复杂度通常为 O(V+E)。
怎么判读
| 线索 | 含义 | 复杂度或动作 |
|---|---|---|
| 初始化全部顶点 | 创建入度、访问状态或结果数组 | O(V) |
| 扫描全部邻接边 | 建立入度或执行 DFS 邻接遍历 | O(E) |
| 每个顶点只出队或完成一次 | 不重复处理已完成顶点 | 累计 O(V) |
| 每条边只用于一次入度更新或遍历 | 不重新扫描整个图 | 累计 O(E) |
最终处理顶点少于 V |
图中存在有向环 | 不存在完整拓扑序 |
这里的 V 是顶点数,E 是有向边数。O(V+E) 的结论依赖邻接表一类能够按实际边数遍历的表示方式;若使用邻接矩阵并逐行检查所有可能边,遍历成本通常会变为 O(V²)。
快速确认
下面使用 Kahn 算法。先统计所有顶点入度,把入度为 0 的顶点放入队列;每取出一个顶点,就删除它对后继顶点的入度贡献。
from collections import deque


def topological_sort(vertex_count, edges):
    graph = [[] for _ in range(vertex_count)]
    indegree = [0] * vertex_count

    for src, dst in edges:
        graph[src].append(dst)
        indegree[dst] += 1

    queue = deque(i for i, degree in enumerate(indegree) if degree == 0)
    order = []

    while queue:
        node = queue.popleft()
        order.append(node)
        for nxt in graph[node]:
            indegree[nxt] -= 1
            if indegree[nxt] == 0:
                queue.append(nxt)

    return order if len(order) == vertex_count else None


edges = [(0, 1), (0, 2), (1, 3), (2, 3)]
print(topological_sort(4, edges))
预期输出:
[0, 1, 2, 3]同一个 DAG 可能存在多个合法拓扑序,因此其他实现得到不同顺序并不代表错误;验证时应检查每条边 u -> v 是否都满足 u 出现在 v 之前。
复杂度边界
建立邻接表和入度需要访问 V 个顶点及 E 条边,成本为 O(V+E)。排序过程中每个顶点最多进入并离开队列一次,每条边也只导致一次入度递减,因此总时间仍为 O(V+E);邻接表、入度数组、队列和结果通常需要 O(V+E) 空间。
如果处理结束后结果长度小于 V,说明至少有一部分顶点因环而始终无法降到零入度。此时不能把当前结果当成完整拓扑序,应先定位并处理环。
通过哈希表、缓存、预计算或额外数组减少重复计算,常把时间成本降下来;评估方案时同时检查内存上限、数据规模和生命周期。
空间换时间判断
当算法反复查询同一结果、重复扫描数据或重复计算子问题时,可以检查是否值得增加辅助空间来减少工作量。判断重点不是“能不能加缓存”,而是额外内存能否把高频重复操作转换成更便宜的查表、索引或预计算。
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
| 同一键被反复查询 | 查询结果存在复用机会 | 考虑哈希表、索引或缓存 |
| 相同子问题被多次求解 | 时间消耗来自重复计算 | 考虑记忆化或动态规划 |
| 每次请求都扫描固定数据 | 重复遍历可以提前消除 | 考虑预计算结果或辅助数组 |
| 查找要求从线性扫描降到近似常数时间 | 需要建立额外映射 | 评估哈希表所需空间与碰撞成本 |
| 输入本身已经接近内存上限 | 额外结构可能导致内存压力 | 优先考虑原地算法、压缩状态或分块处理 |
常见交换方式
| 做法 | 典型时间收益 | 额外空间代价 | 适合条件 |
|---|---|---|---|
| 哈希表 | 把重复查找从遍历改为按键访问 | 通常随保存元素数量增长 | 需要频繁成员判断、去重或键值映射 |
| 缓存或记忆化 | 避免相同输入重复计算 | 保存已计算结果 | 子问题会重复出现且结果可复用 |
| 预计算 | 把运行期计算提前完成 | 保存预计算结果 | 查询次数多,基础数据变化较少 |
| 前缀和等辅助数组 | 把区间重复计算改为少量数组访问 | 通常增加与输入规模同阶的空间 | 大量查询共享同一份静态数据 |
空间换时间并不保证复杂度一定下降一个数量级。例如哈希表平均查询通常很快,但仍有构建成本、内存常数和最坏情况;缓存如果命中率低,也可能只增加内存占用而没有明显收益。
决策顺序
先找出耗时是否来自“重复”。如果每个状态或元素本来就只处理一次,增加缓存通常不能减少渐进时间复杂度。确认存在重复后,再估算额外结构的规模:保存一个状态需要多少字节、最多保存多少状态、这些状态要存活多久。
随后比较总资源约束。若时间限制紧但内存充足,可以接受辅助数组或哈希表;若数据规模已经逼近内存限制,应避免把一个大输入再完整复制一份。长生命周期服务还要考虑缓存淘汰,否则一次算法调用可接受的空间,在持续运行时可能变成累积占用。
适用范围
这是一种算法与工程设计的判断方法,不对应固定阈值。竞赛题应以题目内存限制和输入规模为准;在线服务还要考虑并发请求、缓存共享和生命周期。只有当额外空间确实消除了重复计算、扫描或查询时,才称得上有效的空间换时间。
算法选择
先结合题目给出的 n、时间限制和语言环境估算可接受复杂度,再筛选算法;不要只背复杂度名称,应把规模与增长速度一起判断。
输入规模反推算法上限
看到输入上限后,先比较候选复杂度在该规模下会产生多少工作量,再决定哪些算法值得继续考虑。这个方法用于快速排除明显不可行的方案,而不是把某个 与某个复杂度机械绑定。
怎么判读
| 输入特征 | 优先检查的复杂度 | 判读线索 |
|---|---|---|
| 很小,约几十以内 | 指数、状态压缩、较高次多项式 | 重点计算实际状态数,而不是只看复杂度名称 |
| 约几百到几千 | 、部分 | 检查循环常数、数据结构操作和时间限制 |
| 达到 量级 | 、 | 通常应警惕完整双重遍历 |
| 达到 或更高 | 、接近线性的方案 | 内存访问、I/O 和常数成本也可能成为瓶颈 |
表中的规模只是筛选线索,不是通用性能承诺。不同语言、机器、时间限制、输入分布以及单次操作成本都会改变可接受范围。
用数量级排除方案
例如 时,完整双重循环对应约 级别的两两组合,而 约为 。即使忽略具体硬件,这两个数量级已经相差数千倍,因此排序、堆、平衡树或分治等 方案通常比直接枚举所有二元组合更值得优先检查。
同理,看到 时,不应立即排除 。此时状态数约为 ,是否可行还取决于每个状态做多少工作、是否能剪枝以及时间限制。若复杂度写成 ,还要把额外的 因子一起计算,不能只看指数部分。
反推步骤
先取题目给出的最大输入,而不是样例规模。然后列出候选方案的主要增长项,例如 、、、 或状态数乘转移数。把最大 代入做数量级估算,即可先淘汰明显过大的方案。
接着检查隐藏成本:哈希操作、字符串比较、大整数运算、递归、对象分配和随机访问都不是同样便宜。最后再结合时间限制和语言环境做验证;如果允许本地测试,应使用接近最大规模的数据,而不是用小样例判断性能。
适用范围
该方法适合算法题、面试和性能方案初筛。它不能代替基准测试,也不存在跨语言通用的“每秒固定执行多少次”标准。涉及严格时限时,应以目标运行环境、题目限制和真实操作成本为最终依据。