
Redis 与缓存 / 技术文章
缓存数据迁移为什么要做双写兼容
这篇文章面向正在做 Redis Key 改名、数据结构替换或缓存架构升级的后端开发者。你会理解为什么缓存迁移不能“一刀切”,双写和兼容读取分别保护什么风险,并掌握一套包含灰度切换、TTL 同步、校验和回滚的低风险迁移方法。
缓存迁移最怕新旧版本同时存在
缓存迁移通常不是一次脚本执行,而是一段过渡期。线上可能同时运行旧版本和新版本应用,旧代码仍然读写旧 Key,新代码已经开始使用新 Key 或新数据结构。
如果直接切换,新版本只写新结构,而旧版本仍然只读旧结构,那么两边看到的数据就会迅速分叉。
例如旧版本使用:
user:session:list新版本改成:
user:session:set片段示例:这里仅展示 Key 结构变化。
如果发布过程中两版应用同时接流量,而新版本只写 Set,旧版本继续读 List,那么旧版本会漏掉迁移后的新增数据。
迁移前先核对新旧数据结构的语义。List 保留顺序和重复项,Set 去重且不保证迭代顺序。只有业务只关心成员是否存在时,才能直接做这种映射。另外,旧应用若仍能独自写旧 Key,新版双写也收不到这些变更。应先覆盖全部写入入口,或用权威数据源的可靠增量流补齐。
双写解决“新增数据继续一致”
双写通常意味着,在迁移窗口内,每一次新增、删除或更新都同时作用于旧结构和新结构。
例如从 List 迁移到 Set 时:
redis-cli RPUSH user:session:list session-1
redis-cli SADD user:session:set session-1
预期输出:
(integer) <LIST_LENGTH>
(integer) 1
<LIST_LENGTH> 会随当前 List 长度变化,1 表示该成员首次加入 Set。
双写的重点不是永久维护两份数据,而是给历史回填和灰度切读争取时间。只要迁移还没完成,新发生的数据就不能只进入其中一边。
兼容读取解决“历史数据还没搬完”
只双写还不够,因为旧数据可能已经存在几天、几周甚至几个月。
如果新版本一上线就只读新 Key,而历史数据还没回填完成,就会把“尚未迁移”误判成“数据不存在”。
因此常见做法是:
- 优先读取新结构
- 新结构命中,直接返回
- 新结构未命中,再回退旧结构
- 如果旧结构存在,可以顺便补写新结构
回退旧结构前,应区分“尚未迁移”“确认不存在”和“已删除”。若新结构已经处理删除,旧结构的残留不能再次返回或补写。可以用版本与删除标记保护回填,或仅在确认迁移未完成的范围内允许回旧。对多成员集合,也不能仅凭新 Key 存在就假定该集合已经迁全。
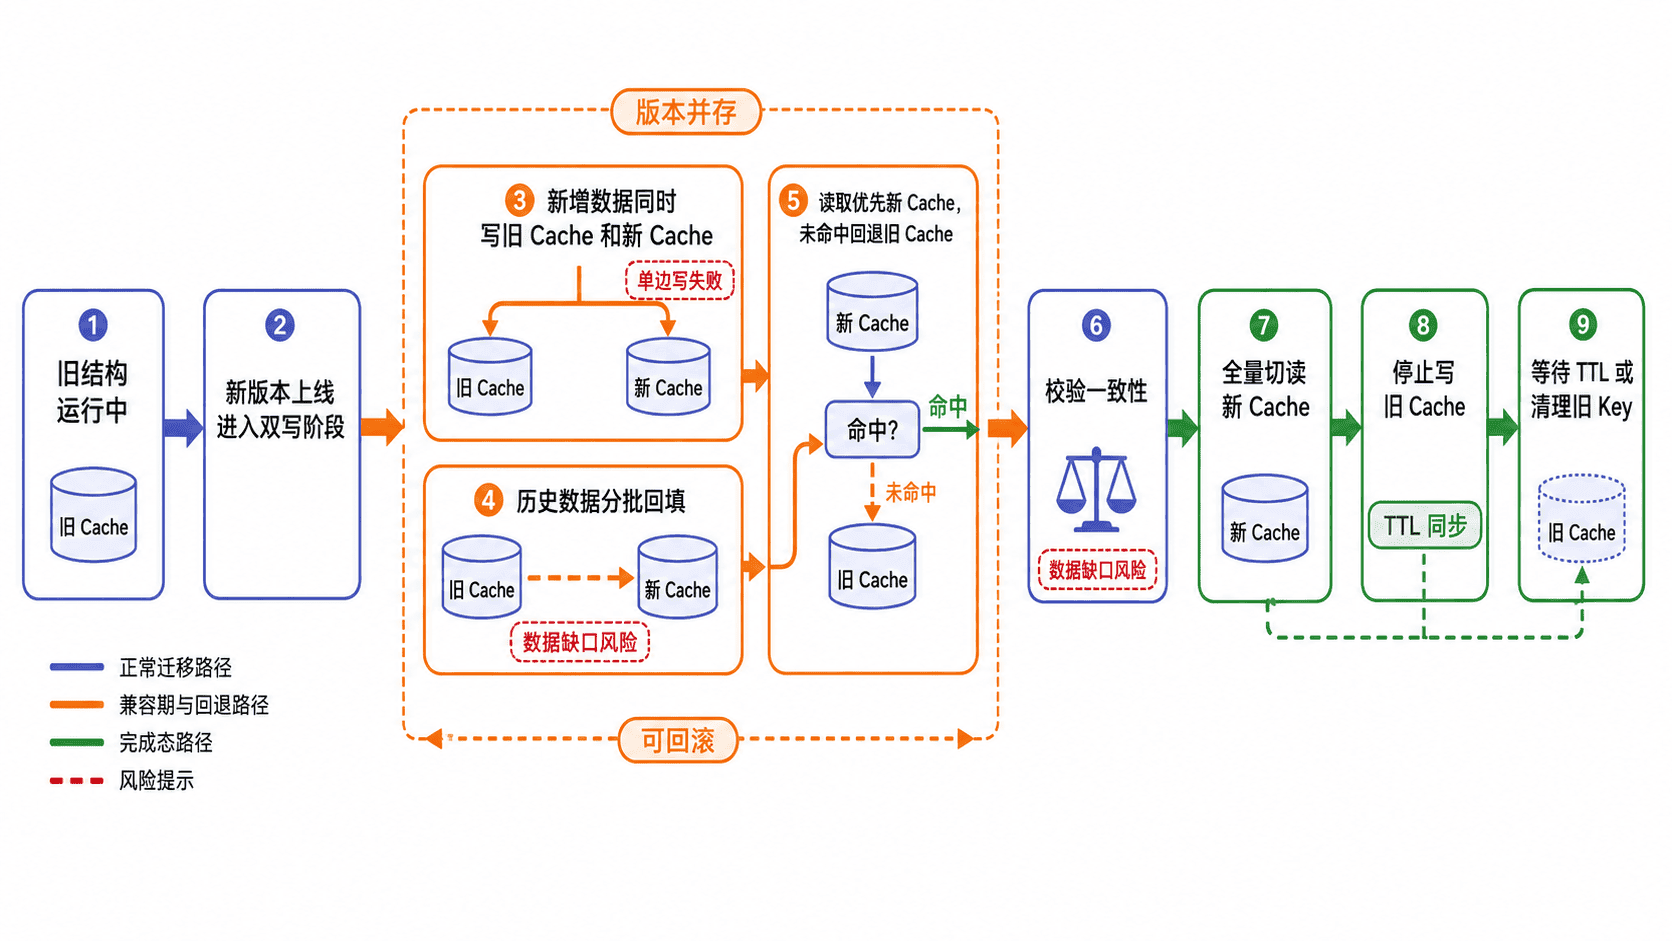
为什么不能先全量搬完再切换
理论上可以停机、全量迁移、一次切换,但大多数线上系统不具备这个条件。
只要迁移期间业务还在持续写入,历史数据搬运和实时变更就会并行发生。即使你在 10:00 开始迁移,10:05 才搬完,这 5 分钟内新产生的数据也必须被正确处理。
所以迁移真正难的不是“把旧数据复制一份”,而是保证历史数据迁移和实时增量变更不会互相覆盖或遗漏。
写入同步负责增量,回填负责存量,兼容读取保护过渡期。纯派生缓存也可以让新 Key 从权威数据按需重建,无需逐项双写。决定采用回填时,应避免历史快照覆盖已经处理过的较新变更。
TTL 也必须跟着迁移
缓存迁移最容易漏掉的不是 Value,而是 TTL。
假设旧 Key 还有 7 天过期,新 Key 回填后却没有设置 TTL,那么迁移就把一份临时缓存变成了永久数据。
PTTL 返回正数时表示剩余毫秒,-1 表示无过期时间,-2 表示 Key 不存在。若剩余时间已耗尽,跳过回填。不要把负值直接传给 PEXPIRE。在 Redis 7.0 及以上,可以用 PEXPIRETIME 读取绝对过期时刻,并按它设置新 Key,避免把搬运耗时加进新生命周期。读取值、读取过期时刻与提交目标之间仍要有一致性保护。单实例可用经过校验的原子脚本,同一 Redis Cluster 中的多 Key 操作还需满足同槽限制。跨实例时要另外处理并发更新和时钟偏差。参见 PTTL及 Redis Cluster 规范。
下面用固定时间验证一个成员的迁移决策。数字仅代表记录版本和时间,不访问 Redis。
def backfill(old, new, now):
    version, value, expires_at = old
    if new is not None and new[0] >= version:
        return new
    if expires_at is not None and expires_at <= now:
        return new
    return old  # 保留绝对过期时刻


snapshot = (1, "session-1", 1000)
deleted = (2, None, None)  # 已提交的删除标记
assert backfill(snapshot, deleted, 900) == deleted
assert backfill(snapshot, None, 1000) is None
assert backfill(snapshot, None, 900) == (1, "session-1", 1000)
assert backfill((1, "persistent", None), None, 900) == (1, "persistent", None)
print("删除标记保留、过期跳过、绝对期限和无过期状态均通过")
这里的删除标记应至少保留到旧读写和回填都不能再带回历史版本。生产实现须把版本比较和提交合成一个原子操作,并按业务约定处理无过期记录。
如果业务会主动续期,那么迁移期间还需要让续期逻辑同时作用于新旧结构,或者明确哪一套 TTL 是最终权威。
双写期间必须允许回滚
高质量迁移一定要能回滚。
如果新结构上线后发现性能、数据语义或兼容逻辑存在问题,最安全的状态是:旧结构仍然保持完整,读路径可以快速切回。
这也是为什么通常不建议“切新读”和“删除旧 Key”在同一批发布中完成。
更稳妥的顺序是:
- 先覆盖所有增删改及续期入口,启用双写或可靠增量同步
- 回填历史数据
- 灰度读新,未命中回旧
- 全量读新
- 观察稳定
- 停止写旧
- 最后清理旧数据
只有确认旧结构仍完整同步,并验证回切后的功能与容量,才适合直接切回。停止旧写后若又要回滚,应先补齐停止期间的变更或从权威源重建。
双写失败必须能被发现
双写最大的隐患,是其中一边失败后系统仍然继续运行。
例如旧 List 写成功,新 Set 写失败,如果没有监控,迁移可能表面上“正常运行”,实际新结构已经持续缺数据。
因此迁移期至少应该监控:
- 新旧写入失败率
- 新结构回退旧结构的比例
- 新旧成员数量差异
- 抽样成员一致性
- TTL 差异
- 新旧 Key 内存增长趋势
如果“回退旧结构”的比例长时间不下降,说明历史回填或双写仍有缺口,不能贸然停止旧路径。
什么时候才可以停止双写
停止双写应该满足几个条件:
- 历史数据回填完成
- 新结构独立运行已稳定一段时间
- 新旧数据抽样校验一致
- 兼容读取的旧结构回退率接近预期低位
- 所有在线版本都已经支持新结构
- 已确认回滚窗口可以结束
完成这些条件后,才可以停止写旧结构。
旧 Key 也不一定要立刻删除。如果本来就有 TTL,通常可以让它自然过期;如果是 Big Key 并且需要主动清理,可以使用 UNLINK 降低同步释放内存的风险。
双写兼容的本质是把大切换拆成小切换
缓存迁移真正危险的,是把数据结构变化、应用发布、历史搬运和流量切换绑在同一时刻。
双写兼容的价值,就是把一次不可逆的大切换拆成多个可观察、可验证、可回滚的小阶段。
最终可以记住一句话:双写保护实时增量,回填处理历史存量,兼容读取保护迁移窗口,TTL 和回滚保护故障边界。 当新结构被证明可以独立工作以后,旧结构才应该真正退出。