
Redis 与缓存 / 技术文章
缓存和数据库双写为什么容易不一致
这篇文章面向已经使用 Redis 做业务缓存、但对“双写不一致”还停留在概念层面的后端开发者。你会看清数据库和缓存为什么很难做到真正原子更新,理解并发、失败和重试如何制造脏数据,并知道 Cache Aside 为什么通常采用“先更新数据库,再删除缓存”。
双写不一致的根因是两个系统没有共同事务
所谓“双写”,通常指一次业务变更同时修改数据库和缓存。例如用户修改昵称后,系统既要更新数据库中的用户记录,也要让 Redis 中的用户缓存失效或同步成新值。
问题在于,数据库事务只能保证数据库内部的原子性,Redis 命令也只能保证 Redis 自己的执行结果。数据库提交和缓存更新之间没有天然的共同事务边界。
只要两个操作不是一个真正的原子动作,就一定存在时间窗口:
更新数据库成功
↓
更新或删除缓存
片段示例:上面的顺序依赖真实业务代码、数据库事务和 Redis 客户端,只用于说明双写边界。
如果数据库成功后进程崩溃、网络超时或 Redis 操作失败,两个系统就会停留在不同状态。
先更新缓存,再更新数据库更危险
假设当前商品价格是 100,系统先把缓存更新为 80,再去修改数据库。
如果缓存更新成功,但数据库事务失败,那么 Redis 中已经是 80,数据库仍然是 100。后续读请求如果命中缓存,就会看到一个从未真正提交过的业务状态。
这种顺序的问题是:缓存可能提前暴露数据库尚未确认的结果。
因此对于大多数 Cache Aside 场景,不建议采用“先更新缓存,再更新数据库”作为默认方案。
先更新数据库,再更新缓存也不绝对安全
把顺序改成“先数据库,后缓存”,虽然避免了缓存提前暴露未提交数据,但仍然存在失败窗口。
例如:
数据库:100 → 80,提交成功
↓
进程崩溃
↓
缓存仍然是 100
片段示例:这里描述的是故障时序,不是可独立执行程序。
此时数据库已经是最新值,但缓存继续提供旧数据。如果 TTL 很长,这个旧值可能持续存在很久。
所以“先数据库后缓存”只是缩小了一类风险,并没有消灭双写不一致。
为什么通常选择删除缓存,而不是更新缓存
Cache Aside 更常见的做法是:
- 更新数据库并确认事务已提交。
- 删除受影响的缓存键。
- 缓存未命中时,从满足读一致性要求的数据源读取并回填。
原因很简单:删除缓存只表达一个事实——这份副本已经不可信,需要重新构建。
而直接更新缓存则要求业务同时正确维护两份状态。如果缓存结构是数据库多张表聚合、字段计算或复杂 JSON,更新逻辑很容易和真实读逻辑逐渐偏离。
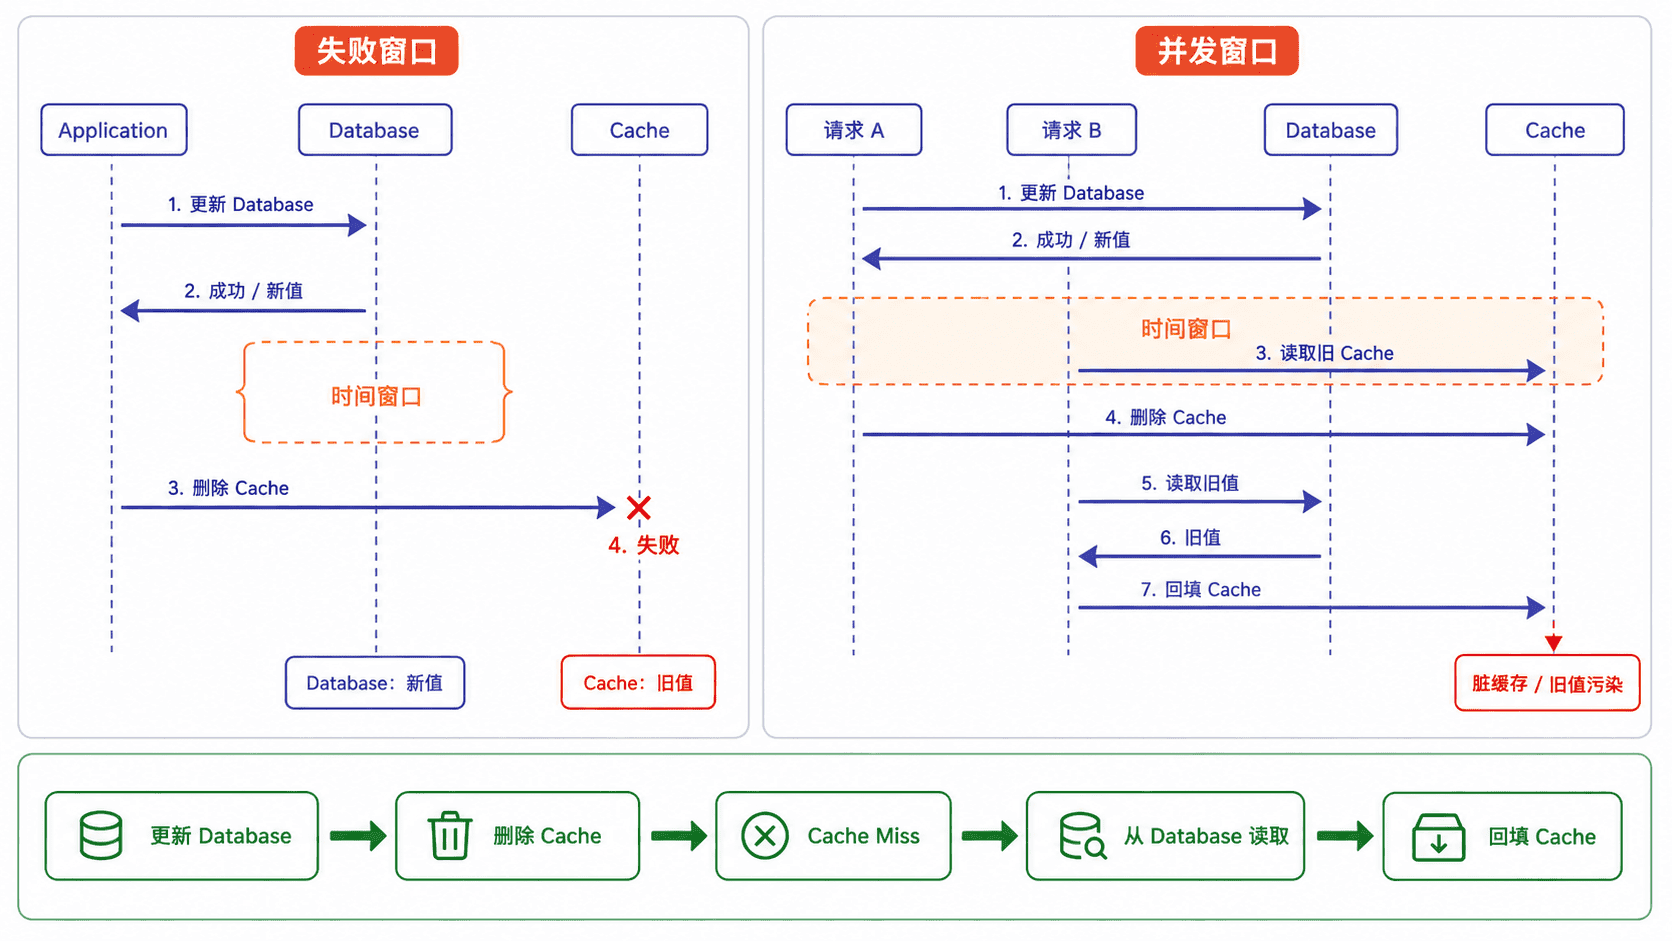
并发才是最容易被忽略的问题
即使单线程顺序看起来正确,并发请求仍可能制造脏缓存。
例如缓存当前为空:
- 请求 A 开始查询数据库,读到旧值 100
- 请求 B 更新数据库,把价格改为 80
- 请求 B 删除缓存
- 请求 A 查询完成,把刚才读到的旧值 100 写回缓存
最终结果变成:数据库是 80,缓存却重新被写成了 100。
并发读可能在删除之后才回填旧数据。窗口受读事务、网络、调度和副本延迟影响,不能假定一定很短。下面用两个确定的时序复现问题。第二个时序假设失效事件已应用,并在回填前保留该键的最低可接受版本。
snapshot = (1, 100)  # 请求 A 先从数据库读到版本 1
database = (2, 80)   # 请求 B 提交版本 2,并让缓存失效

cache = snapshot     # 无保护时,A 晚到并回填旧版本
print(f"无保护:数据库 {database[1]},缓存 {cache[1]}")

minimum_version = database[0]
cache = None
if snapshot[0] >= minimum_version:
    cache = snapshot
assert cache is None
if database[0] >= minimum_version:
    cache = database
assert cache == (2, 80)
print(f"版本检查:拒绝旧回填,最终缓存 {cache[1]}")无保护:数据库 80,缓存 100
版本检查:拒绝旧回填,最终缓存 80实际实现需要单调的数据版本,并在缓存侧原子检查版本下界与回填写入。下界也要覆盖旧请求可能到达的时间。失效事件未送达、下界丢失或读取落后副本时,仍可能看到旧值。参见 Azure Cache-Aside 的一致性边界。
删除缓存失败必须有补偿机制
如果数据库更新成功,但缓存删除失败,系统不能只记录一条日志就结束。
常见补偿手段包括:
- 删除失败后有限次数重试
- 将待失效记录与业务变更写入同一数据库事务,再由发布器投递并幂等消费。单纯在提交后发送消息,提交与发送之间仍有崩溃窗口。参见 AWS 事务发件箱模式。
- 订阅数据库变更日志,再次触发缓存失效
- 给缓存设置合理 TTL,让脏数据最终自动淘汰
- 对关键业务增加版本号,避免旧数据覆盖新数据
这些机制的目标都不是让双写瞬间变成强一致,而是确保失败不会永久残留。
延迟双删解决的是特定并发窗口
所谓延迟双删,通常指:
- 更新数据库
- 删除一次缓存
- 等待一个短时间窗口
- 再删除一次缓存
第二次删除的目的,是把并发读请求在窗口中重新写入的旧缓存清掉。
但它不是万能方案。延迟时间很难精确确定,进程崩溃也可能让第二次删除根本没有发生。因此它更适合作为特定场景下的补充,而不是缓存一致性的唯一保障。
如果业务对一致性要求很高,更应该考虑基于消息、变更日志或版本控制的可靠失效机制。
先明确你真正需要的一致性级别
不是所有缓存都需要同样严格的一致性。
商品描述、文章详情这类数据短暂旧几秒通常可以接受;账户余额、支付状态、库存扣减等关键事实则不能依赖缓存作为最终判断依据。
设计前应该先问:
- 缓存允许旧多久?
- 旧数据会不会导致资金、库存或权限错误?
- 删除缓存失败后有没有可靠补偿?
- 并发读取是否可能把旧数据重新写回?
- TTL 是否符合单次缓存副本的保留要求?是否存在落后副本或旧请求反复回填,导致陈旧时间跨过一次 TTL?
- 真正的业务事实是否始终以数据库或权威服务为准?
最终可以记住一句话:缓存和数据库双写容易不一致,不是因为某个写法“代码顺序错了”,而是因为两个独立系统之间天然存在失败和并发时间窗口。 正确设计的重点,是让数据库保存事实、缓存只保存副本,并用删除、重试、TTL 和补偿机制把不一致窗口控制在业务可接受范围内。