
Java 后端 / 知识点
Spring Boot 开发速查手册
手册条目
配置 Mapper 接口并执行 XML 或注解 SQL。
使用 MyBatis
用于在 Spring Boot 中定义 Mapper 接口并执行注解 SQL 或 XML SQL。最小可用链路是:数据源配置正确、Mapper 被扫描、SQL 与返回类型匹配,然后通过接口方法完成查询或写入。
最小配置
以下示例假定项目已引入 mybatis-spring-boot-starter 和 MySQL 驱动,数据库中存在 sys_user 表。生产环境建议由 Flyway 或 Liquibase 管理表结构,不要依赖应用启动时自动建表。
spring:
  datasource:
    url: jdbc:mysql://127.0.0.1:3306/demo?useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai
    username: demo
    password: <PASSWORD>
    driver-class-name: com.mysql.cj.jdbc.Driver

mybatis:
  mapper-locations: classpath*:mapper/**/*.xml
  configuration:
    map-underscore-to-camel-case: true
生效结果:Spring Boot 创建数据源,MyBatis 加载 mapper 目录下的 XML,并可把 user_name 映射为 userName。密码应改为环境变量或密钥配置,不能提交到仓库。
注解 SQL
适合字段少、SQL 简短且不需要动态 SQL 的场景。Mapper 可用 @Mapper 标记;项目中有多个 Mapper 时,也可以由启动类统一使用 @MapperScan。
package com.example.demo.user;

import org.apache.ibatis.annotations.Mapper;
import org.apache.ibatis.annotations.Param;
import org.apache.ibatis.annotations.Select;

@Mapper
public interface UserMapper {

    @Select("""
        SELECT id, user_name
        FROM sys_user
        WHERE id = #{id}
        """)
    User findById(@Param("id") Long id);

    record User(Long id, String userName) {
    }
}
这里使用 #{id} 进行预编译参数绑定;查询无记录时,findById 返回 null。
高频使用
把 Mapper 注入 Spring 管理的 Service,并在业务层处理未查询到记录的情况。
package com.example.demo.user;

import org.springframework.stereotype.Service;

@Service
public class UserService {

    private final UserMapper userMapper;

    public UserService(UserMapper userMapper) {
        this.userMapper = userMapper;
    }

    public UserMapper.User getRequiredUser(long id) {
        UserMapper.User user = userMapper.findById(id);
        if (user == null) {
            throw new IllegalArgumentException("user not found: " + id);
        }
        return user;
    }
}
预期结果:
getRequiredUser(1) -> User[id=1, userName=alice]
getRequiredUser(999) -> IllegalArgumentException: user not found: 999
实际 ID 和用户名取决于数据库数据。
XML SQL
动态条件、批量操作、复杂关联或需要集中维护的 SQL 更适合 XML。namespace 必须与 Mapper 接口全限定名一致,语句 id 必须与方法名一致。
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE mapper
    PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
    "https://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.example.demo.user.UserXmlMapper">

    <select id="findByName" resultType="com.example.demo.user.UserXmlMapper$User">
        SELECT id, user_name
        FROM sys_user
        WHERE user_name = #{name}
        LIMIT 1
    </select>
</mapper>package com.example.demo.user;
import org.apache.ibatis.annotations.Mapper;
import org.apache.ibatis.annotations.Param;
@Mapper
public interface UserXmlMapper {
User findByName(@Param("name") String name);
record User(Long id, String userName) {
}
}预期结果:
findByName("alice") -> User[id=1, userName=alice]启动或调用时报 Invalid bound statement 时,优先检查 XML 路径、namespace、语句 id 和 Mapper 方法名是否一一对应。
高频排障
Invalid bound statement:检查mapper-locations是否覆盖 XML 文件,以及namespace、id是否匹配。- 参数找不到:多参数方法显式添加
@Param,SQL 中使用相同名称。 - 字段为
null:检查列名、别名、map-underscore-to-camel-case和 Java 属性名;复杂映射使用resultMap。 - 事务未生效:写操作放在 Spring 管理的 Service 中,并从外部 Bean 调用带
@Transactional的公开方法;同类自调用不会经过事务代理。
风险与边界
不要把外部输入直接放进 ${value}。它会把文本原样拼入 SQL,可能导致 SQL 注入或语法破坏;优先使用 #{value} 参数绑定。表名、排序字段等确实无法参数化的位置,必须先映射到后端白名单,再使用 ${}。
批量查询如果没有分页、上限或有效条件,可能占满连接和堆内存。生产环境应设置合理返回上限、建立匹配索引,并在上线前检查实际执行计划。
为不同数据库分别配置连接池和事务管理器。
配置多数据源
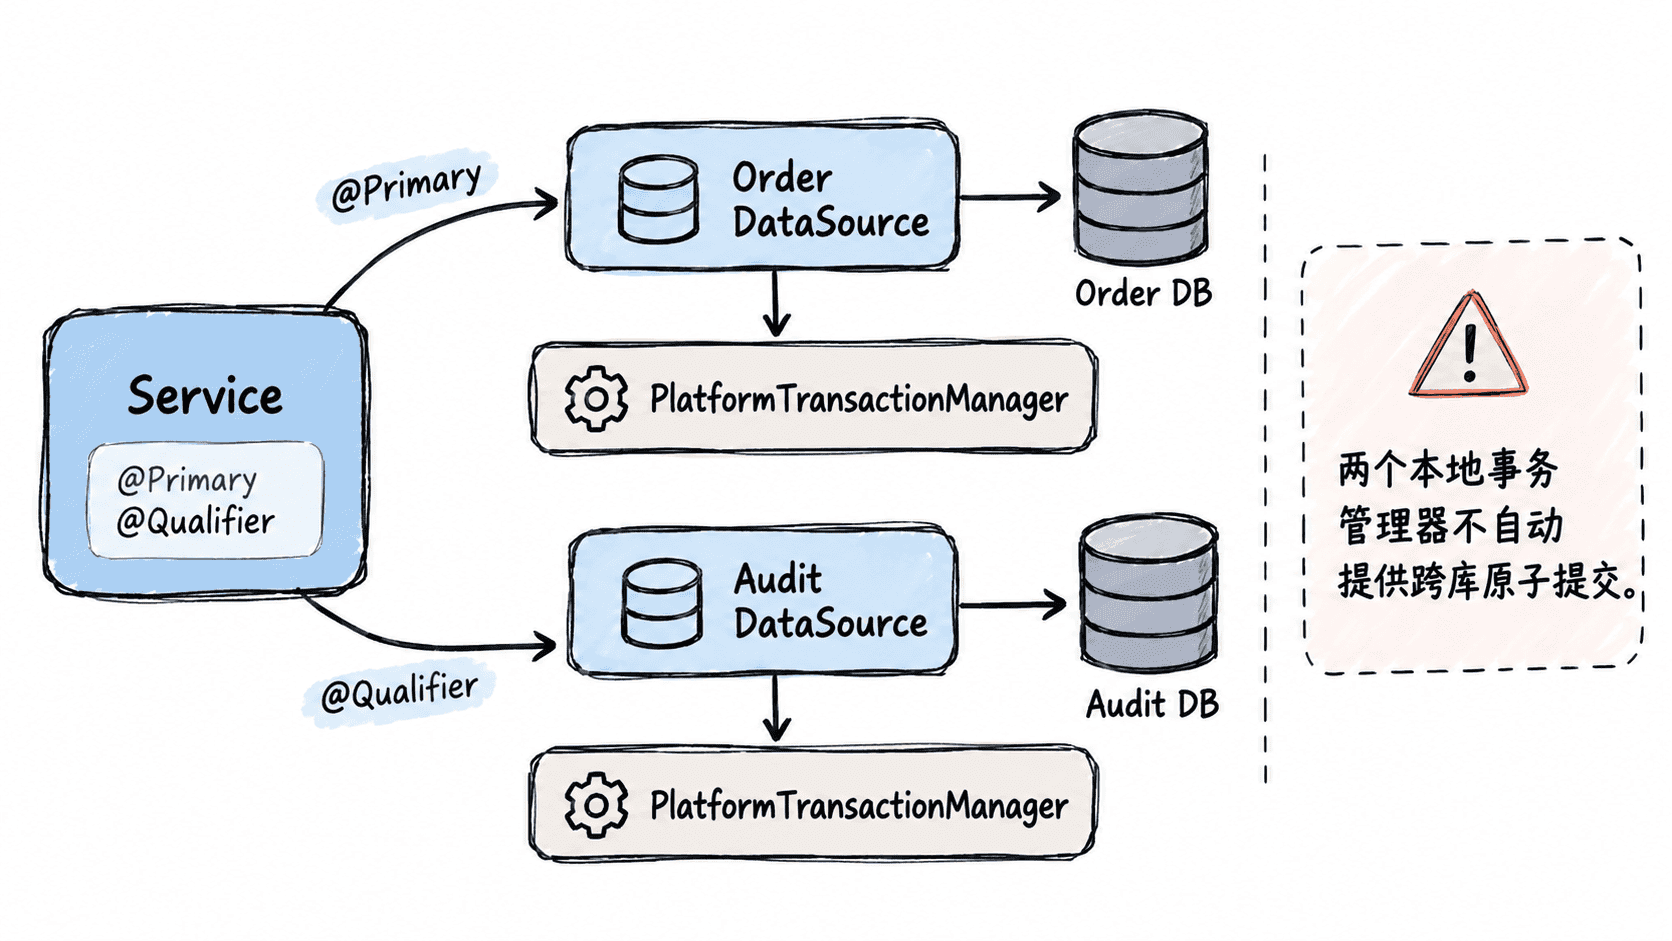
当一个 Spring Boot 应用同时访问订单库、审计库等不同数据库时,应让每个数据库拥有独立的 DataSource 连接池,并显式绑定对应的 PlatformTransactionManager。这样可以避免事务误落到错误的数据源,也便于分别控制连接池和超时。
配置关系
@Primary 只用于确定未写限定符时的默认 Bean;@Qualifier 才负责把数据源、事务管理器和访问代码准确配对。多数据源场景不要依赖 Bean 名称猜测,也不要默认认为一个本地事务管理器可以同时保证两个数据库的原子提交。
主配置
片段示例:项目需包含 Spring JDBC、HikariCP 与 H2 驱动。这里用两个内存库演示独立连接池和事务管理器的配置;真实项目只需替换 JDBC URL 与凭据。
app:
  datasource:
    orders:
      jdbc-url: jdbc:h2:mem:orders;DB_CLOSE_DELAY=-1
      username: sa
      password: ""
      maximum-pool-size: 10
    audit:
      jdbc-url: jdbc:h2:mem:audit;DB_CLOSE_DELAY=-1
      username: sa
      password: ""
maximum-pool-size: 5生效行为:app.datasource.orders 与 app.datasource.audit 分别绑定到两个 HikariDataSource。由于这里直接绑定 Hikari 属性,应使用 jdbc-url 而不是通用的 url。
import com.zaxxer.hikari.HikariDataSource;
import javax.sql.DataSource;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.boot.jdbc.DataSourceBuilder;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.Primary;
import org.springframework.jdbc.datasource.DataSourceTransactionManager;
import org.springframework.transaction.PlatformTransactionManager;

@Configuration(proxyBeanMethods = false)
public class MultiDataSourceConfig {

    @Bean("ordersDataSource")
    @Primary
    @ConfigurationProperties("app.datasource.orders")
    HikariDataSource ordersDataSource() {
        return DataSourceBuilder.create()
                .type(HikariDataSource.class)
                .build();
    }

    @Bean("auditDataSource")
    @ConfigurationProperties("app.datasource.audit")
    HikariDataSource auditDataSource() {
        return DataSourceBuilder.create()
                .type(HikariDataSource.class)
                .build();
    }

    @Bean("ordersTransactionManager")
    @Primary
    PlatformTransactionManager ordersTransactionManager(
            @Qualifier("ordersDataSource") DataSource dataSource) {
        return new DataSourceTransactionManager(dataSource);
    }

    @Bean("auditTransactionManager")
    PlatformTransactionManager auditTransactionManager(
            @Qualifier("auditDataSource") DataSource dataSource) {
        return new DataSourceTransactionManager(dataSource);
    }
}
生效行为:未指定事务管理器的 @Transactional 默认使用 ordersTransactionManager;访问审计库的服务应显式写 @Transactional(transactionManager = "auditTransactionManager"),并确保 DAO、JdbcTemplate 或 Mapper 使用 auditDataSource。
预期结果:
ordersDataSource -> HikariDataSource
ordersTransactionManager -> ordersDataSource

auditDataSource -> HikariDataSource
auditTransactionManager -> auditDataSource
实际启动日志可能包含连接池初始化细节,但核心验证是两个数据源均能成功建立连接,且事务管理器与目标数据源一一对应。
典型失败处理
配置完成后建议分别执行一次最小读写验证。若访问审计库却命中了订单库,检查 @Qualifier、事务管理器名称以及 DAO 所注入的 DataSource 是否来自同一分支。
跨库场景中,一个方法即使先后操作两个数据库,也不会因为存在两个 DataSourceTransactionManager 就自动获得跨库原子性。需要分布式一致性时,应根据业务要求选择对应方案。
风险与边界
多个连接池会叠加数据库连接数预算。生产环境应分别设置最大连接数、连接超时和监控指标,避免总连接数超过数据库承载能力。
如果使用 JPA,还需要为每个数据源建立对应的 EntityManagerFactory 与 JPA 事务管理器,不能直接照搬 JDBC 配置。
使用 Transactional 保证一组数据库操作原子执行。
开启声明式事务
在需要“全部成功或全部回滚”的 Service 方法上使用 @Transactional。Spring Boot 已配置单数据源时通常会自动提供事务管理器,无须手工提交或回滚。事务入口应位于由 Spring 管理的 Bean 方法上,并确保调用经过 Spring 代理。
基本用法
@Transactional 通常放在 Service 层的 public 方法上。下面用 H2 和 JdbcTemplate 验证一个转账操作:第二次更新后抛出运行时异常,两次数据库更新都会回滚。
import java.math.BigDecimal;

import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.context.annotation.Import;
import org.springframework.jdbc.core.JdbcTemplate;
import org.springframework.stereotype.Service;
import org.springframework.test.context.jdbc.Sql;
import org.springframework.transaction.annotation.Transactional;

import static org.assertj.core.api.Assertions.assertThat;
import static org.junit.jupiter.api.Assertions.assertThrows;

@SpringBootTest(properties = {
        "spring.datasource.url=jdbc:h2:mem:txdb;MODE=MySQL;DB_CLOSE_DELAY=-1",
        "spring.datasource.driver-class-name=org.h2.Driver"
})
@Import(TransferTransactionTest.TransferService.class)
@Sql(statements = {
        "DROP TABLE IF EXISTS account",
        "CREATE TABLE account(id BIGINT PRIMARY KEY, balance DECIMAL(10,2))",
        "INSERT INTO account(id, balance) VALUES (1, 100.00), (2, 50.00)"
})
class TransferTransactionTest {

    @Autowired
    private TransferService transferService;

    @Autowired
    private JdbcTemplate jdbcTemplate;

    @Test
    void rollbackWhenTransferFails() {
        assertThrows(IllegalStateException.class,
                () -> transferService.transfer(1L, 2L, new BigDecimal("10.00")));

        BigDecimal sourceBalance = jdbcTemplate.queryForObject(
                "SELECT balance FROM account WHERE id = 1",
                BigDecimal.class);
        BigDecimal targetBalance = jdbcTemplate.queryForObject(
                "SELECT balance FROM account WHERE id = 2",
                BigDecimal.class);

        assertThat(sourceBalance).isEqualByComparingTo("100.00");
        assertThat(targetBalance).isEqualByComparingTo("50.00");
    }

    @Service
    static class TransferService {

        private final JdbcTemplate jdbcTemplate;

        TransferService(JdbcTemplate jdbcTemplate) {
            this.jdbcTemplate = jdbcTemplate;
        }

        @Transactional
        public void transfer(Long fromId, Long toId, BigDecimal amount) {
            jdbcTemplate.update(
                    "UPDATE account SET balance = balance - ? WHERE id = ?",
                    amount, fromId);
            jdbcTemplate.update(
                    "UPDATE account SET balance = balance + ? WHERE id = ?",
                    amount, toId);

            // 模拟转账后的业务校验失败,两次更新应一起回滚。
            throw new IllegalStateException("post-check failed");
        }
    }
}
执行测试:
./mvnw -Dtest=TransferTransactionTest test预期输出:
Tests run: 1, Failures: 0, Errors: 0, Skipped: 0测试通过表示异常发生后,两个账户余额仍分别为 100.00 和 50.00。实际 Maven 输出还可能包含 Spring Boot 启动日志。
常用参数
| 参数 | 适用场景 | 关键行为 |
|---|---|---|
rollbackFor = Exception.class |
业务会抛出受检异常 | 默认主要对 RuntimeException 和 Error 触发回滚 |
readOnly = true |
纯查询方法 | 向事务管理器和数据库提供只读提示,不等同于禁止写入 |
timeout = 5 |
需要限制事务执行时间 | 指定事务超时时间,单位为秒,具体行为受事务管理器支持情况影响 |
transactionManager = "xxx" |
存在多个事务管理器 | 明确选择对应事务管理器 |
风险与边界
同类内部直接调用事务方法不会经过 Spring 代理,private 方法也不能作为可靠的事务入口。需要不同事务边界时,应将方法拆到独立 Bean,再从其他 Bean 调用。
方法内部捕获异常后正常返回时,Spring 可能认为调用成功并提交。需要回滚时通常继续抛出异常;若必须在当前事务内主动标记回滚,可使用 TransactionAspectSupport.currentTransactionStatus().setRollbackOnly()。
本地事务不能把 HTTP、第三方支付或普通消息发送一起纳入同一个原子提交。远程调用成功而数据库随后回滚时可能产生状态不一致,需要结合本地消息表、事务消息、幂等和补偿机制处理。
排障清单
- 确认事务类由 Spring 扫描并管理,而不是手工
new。 - 确认调用经过 Spring 代理,没有发生同类自调用。
- 检查异常类型是否满足回滚规则,以及异常是否被吞掉。
- 检查底层数据表、存储引擎和数据源是否真正支持事务。
- 多数据源场景确认使用了正确的
PlatformTransactionManager。
速查:事务边界通常放在 Service 层,只包含必须保持一致的数据库操作;远程调用和慢任务尽量移出事务边界,避免长时间持有数据库资源。
根据嵌套调用场景选择合适的事务传播行为。
设置事务传播
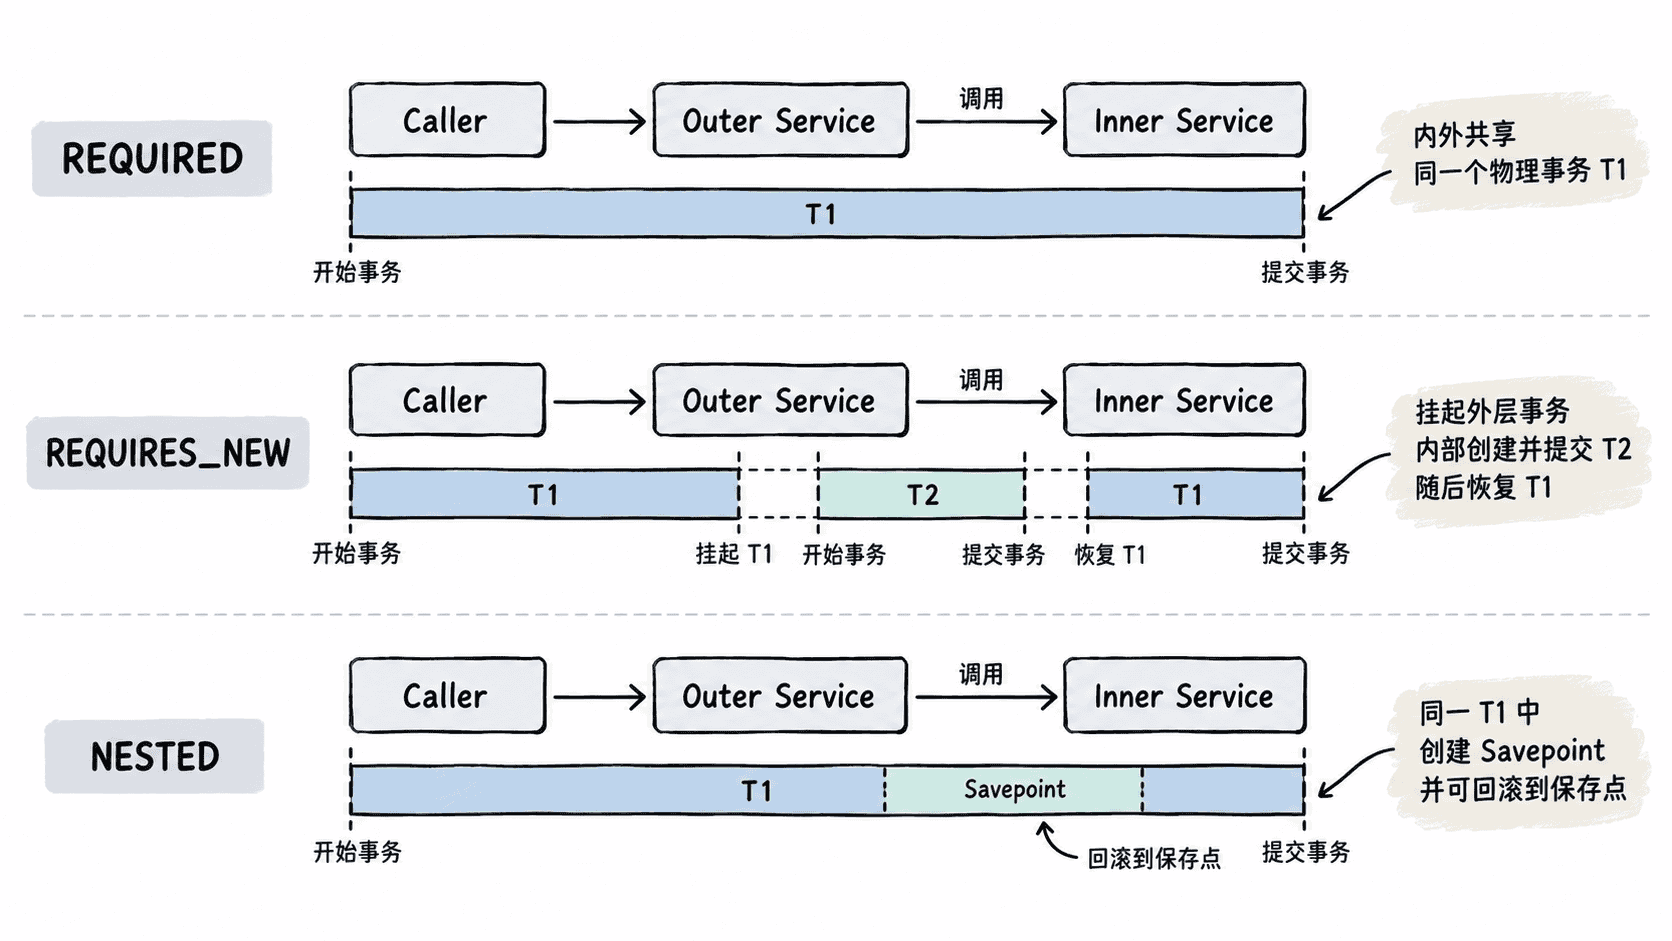
当一个事务方法调用另一个事务方法时,传播行为决定内部调用如何处理当前事务。默认的 REQUIRED 适合大多数同一业务单元;只有确实需要独立提交、局部回滚或明确禁止事务时,才应改用其他传播级别。
传播行为速查
| 传播行为 | 已存在事务时 | 不存在事务时 | 典型用途 |
|---|---|---|---|
REQUIRED |
加入当前事务 | 新建事务 | 默认业务操作 |
REQUIRES_NEW |
挂起外部事务并新建独立事务 | 新建事务 | 必须独立提交的审计、补偿记录 |
NESTED |
在当前物理事务中创建保存点 | 新建事务 | 需要局部回滚且事务管理器支持保存点 |
SUPPORTS |
加入当前事务 | 非事务执行 | 事务可有可无的操作 |
NOT_SUPPORTED |
挂起当前事务 | 非事务执行 | 明确不希望占用事务的操作 |
MANDATORY |
加入当前事务 | 抛出异常 | 强制由上层开启事务 |
NEVER |
抛出异常 | 非事务执行 | 明确禁止事务上下文 |
主示例
片段示例:以下代码依赖已有的 OrderRepository 与 AuditRepository,并假设应用使用单个默认事务管理器。关键点是把需要不同传播行为的方法放到另一个 Spring Bean,确保调用经过事务代理。
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Propagation;
import org.springframework.transaction.annotation.Transactional;

@Service
class AuditService {
    private final AuditRepository auditRepository;

    AuditService(AuditRepository auditRepository) {
        this.auditRepository = auditRepository;
    }

    @Transactional(propagation = Propagation.REQUIRES_NEW)
    public void recordCancellation(long orderId) {
        auditRepository.insertCancellation(orderId);
    }
}

@Service
class OrderService {
    private final OrderRepository orderRepository;
    private final AuditService auditService;

    OrderService(OrderRepository orderRepository, AuditService auditService) {
        this.orderRepository = orderRepository;
        this.auditService = auditService;
    }

    @Transactional
    public void cancel(long orderId) {
        orderRepository.markCancelled(orderId);
        auditService.recordCancellation(orderId);
        throw new IllegalStateException("simulate outer rollback");
    }
}
预期结果:调用 cancel(<ID>) 时,外层订单更新位于事务 T1;recordCancellation 挂起 T1 并使用独立事务 T2。T2 正常返回后先提交,随后外层异常使 T1 回滚,因此审计记录保留而订单状态修改回滚。<ID> 的实际值由测试数据决定。
代理边界
@Transactional 默认通过 Spring AOP 代理生效。若在同一个对象内部使用 this.recordCancellation(...) 自调用,调用不会经过代理,REQUIRES_NEW 也就不会创建新的事务。最简单的做法是像主示例一样把不同传播行为的方法拆到另一个 Spring Bean。
如果应用存在多个事务管理器,还应同时指定 transactionManager,否则传播行为可能作用在错误的事务管理器上。传播级别只描述事务参与方式,不会自动解决跨数据库一致性问题。
风险与恢复
REQUIRES_NEW 在外层事务仍占用数据库连接时,内部事务通常还需要额外连接。高并发且连接池容量不足时,可能出现连接等待甚至资源耗尽,因此应结合峰值并发评估连接池容量。
NESTED 依赖事务管理器对保存点的支持,常见于 JDBC 场景;它不是“重新开启一个独立事务”。REQUIRED 的内部调用如果把共享事务标记为 rollback-only,即使外层捕获了内部异常,最终提交阶段仍可能出现 UnexpectedRollbackException。遇到这种情况,应先检查异常处理和事务边界,而不是直接把传播行为改成 REQUIRES_NEW。
速查:先判断内部操作是否必须独立提交,再选择传播级别;只要内外操作必须作为一个原子业务单元提交,优先保持默认的 REQUIRED。
根据并发一致性要求选择事务隔离级别。
设置事务隔离级别
当同一批数据会被并发读取或修改时,用事务隔离级别控制事务之间的可见性。优先沿用数据库默认值,只在业务确实需要不同一致性边界时针对具体事务调整。
基本语法
在 Spring 事务方法上通过 @Transactional(isolation = ...) 指定隔离级别。未显式配置时使用 Isolation.DEFAULT,实际级别由数据库和数据源决定。
package com.example.demo.service;

import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Isolation;
import org.springframework.transaction.annotation.Transactional;

@Service
public class InventoryService {

    @Transactional(isolation = Isolation.REPEATABLE_READ)
    public void reserveStock(long productId, int quantity) {
        // 事务内只保留必须原子完成的数据库操作。
        int affected = updateStock(productId, quantity);
        if (affected != 1) {
            throw new IllegalStateException("库存不足或商品不存在");
        }
    }

    private int updateStock(long productId, int quantity) {
        // 片段示例:实际项目中应由 Mapper/Repository 执行带库存条件的 UPDATE。
        return 1;
    }
}
预期结果:进入 reserveStock 时由 Spring 开启 REPEATABLE_READ 事务;方法正常返回时提交,抛出未检查异常时回滚。updateStock 只是片段占位,接入数据库后应根据真实 UPDATE 的受影响行数判断库存是否扣减成功。
隔离级别选择
| 隔离级别 | 适用场景 | 主要边界 |
|---|---|---|
READ_UNCOMMITTED |
极少数允许读取未提交数据的场景 | 可能读到未提交数据 |
READ_COMMITTED |
接受同一事务内后续查询看到新提交结果 | 可避免脏读,但仍可能不可重复读 |
REPEATABLE_READ |
同一事务内需要稳定的快照读取 | 并发写入仍需结合锁和条件更新处理 |
SERIALIZABLE |
必须把冲突操作进一步串行化的关键流程 | 并发度最低,等待、超时和死锁风险更高 |
DEFAULT |
沿用数据库默认配置 | 必须结合具体数据库确认实际级别 |
隔离级别主要解决事务可见性问题,不能替代唯一约束、条件更新、乐观锁或分布式锁。库存扣减、余额变更等场景仍应优先使用原子 SQL,例如 UPDATE ... WHERE stock >= ?,让数据库直接保证条件成立时才更新。
配置边界
已有外层事务时,内层事务方法通常参与外层事务,因此不能仅靠在内层方法上指定 isolation 来改变已经启动的事务隔离级别。确需独立事务时,可评估 Propagation.REQUIRES_NEW,但要考虑额外连接占用和提交顺序。
同一个类内部直接调用带 @Transactional 的方法通常不会经过 Spring 代理,因此新注解和对应事务属性可能不会生效。应从其他 Bean 调用,或把事务方法拆到独立的 @Service 中。
风险与边界
把隔离级别提高到 SERIALIZABLE 会扩大并发冲突成本,可能导致等待、死锁或事务超时。更常见的做法是保持数据库默认隔离级别,再通过唯一索引、条件更新和短事务解决具体竞争问题。
事务隔离级别也不意味着所有读写都天然安全。例如,先查询库存、再在应用代码中计算、最后普通更新,仍可能产生并发覆盖;应把关键条件放进同一条原子更新语句,或使用合适的锁定读取。
排障清单
- 确认目标方法是否经过 Spring 代理并真正创建了事务。
- 查询数据库当前隔离级别,核对连接池、会话或数据源配置是否覆盖预期值。
- 检查事务是否过长,避免在事务内调用远程接口、发送消息或执行慢查询。
- 出现锁等待时,先定位阻塞 SQL 和持锁事务,不要直接为了消除等待而降低隔离级别。
速查提示:隔离级别越高不代表业务一定越安全;先用数据库约束和原子更新保证业务正确性,再按一致性要求调整事务可见性。
使用 TransactionTemplate 明确控制事务边界和返回值。
手动控制事务
当事务边界、返回值或异常处理不能用单个 @Transactional 清晰表达时,使用 TransactionTemplate 在代码中显式控制事务。它适合短小、同步且边界明确的数据库操作。
基本用法
TransactionTemplate.execute 在当前线程内执行事务回调,并返回回调结果;回调正常结束后提交,运行时异常等事务回调异常会触发回滚。没有返回值时可使用 executeWithoutResult。
package com.example.demo.service;

import org.springframework.stereotype.Service;
import org.springframework.transaction.support.TransactionTemplate;

@Service
public class OrderService {

    private final TransactionTemplate transactionTemplate;
    private final OrderRepository orderRepository;

    public OrderService(TransactionTemplate transactionTemplate,
                        OrderRepository orderRepository) {
        this.transactionTemplate = transactionTemplate;
        this.orderRepository = orderRepository;
    }

    public Long createOrder(String merchantOrderNo) {
        return transactionTemplate.execute(status -> {
            Long orderId = orderRepository.insert(merchantOrderNo);
            if (orderId == null) {
                // 明确标记当前事务回滚,再返回失败结果。
                status.setRollbackOnly();
                return null;
            }
            return orderId;
        });
    }

    public interface OrderRepository {
        Long insert(String merchantOrderNo);
    }
}预期结果:insert 返回订单 ID 时事务提交并返回该 ID;返回 null 时通过 setRollbackOnly() 标记回滚,createOrder 最终返回 null。上例中的 OrderRepository 是片段接口,实际项目需要由 JDBC、MyBatis、JPA 等持久化组件实现。
常用配置
可以在执行前设置传播行为、隔离级别和超时时间。TransactionTemplate 通常作为单例 Bean 使用,因此不要在并发请求执行期间修改同一个模板实例的配置;需要不同策略时应分别创建并注入多个模板。
package com.example.demo.config;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.transaction.PlatformTransactionManager;
import org.springframework.transaction.TransactionDefinition;
import org.springframework.transaction.support.TransactionTemplate;

@Configuration
public class TransactionConfig {

    @Bean("shortTransactionTemplate")
    TransactionTemplate shortTransactionTemplate(
            PlatformTransactionManager transactionManager) {
        TransactionTemplate template = new TransactionTemplate(transactionManager);
        template.setPropagationBehavior(TransactionDefinition.PROPAGATION_REQUIRED);
        template.setIsolationLevel(TransactionDefinition.ISOLATION_READ_COMMITTED);
        template.setTimeout(5);
        return template;
    }
}
生效行为:使用该模板的回调以 READ_COMMITTED 隔离级别参与或创建事务,并设置 5 秒事务超时。具体超时异常类型和表现由底层事务管理器与数据访问技术共同决定,验证时应通过真实数据库阻塞场景观察实际结果。
高频用法
需要先提交数据库、再执行外部通知时,应把远程调用放在事务回调之外,避免网络等待长期占用数据库连接和锁。
public Long createAndNotify(TransactionTemplate transactionTemplate,
                            OrderRepository orderRepository,
                            java.util.function.LongConsumer notifyDownstream) {
    Long orderId = transactionTemplate.execute(status ->
            orderRepository.insert("M202608020001"));

    if (orderId == null) {
        throw new IllegalStateException("订单创建失败");
    }

    // 数据库事务已经结束,再执行通知。
    notifyDownstream.accept(orderId);
    return orderId;
}
预期结果:订单写入成功后事务先提交,再调用 notifyDownstream;通知失败不会回滚已经提交的订单,因此需要配合重试表、消息队列或补偿任务处理最终一致性。
风险与边界
在事务回调中捕获异常后继续正常返回,会被视为成功并可能提交已有变更。需要回滚时,应重新抛出异常,或调用 status.setRollbackOnly() 并返回明确的失败结果。
TransactionTemplate 只管理当前线程绑定的事务。把数据库操作转移到异步线程、线程池或其他独立执行上下文后,原事务不会自动传播;需要在新的执行上下文中重新建立事务边界。
不要在事务回调中执行 HTTP 请求、文件上传、长时间计算或消息同步发送。回调持续过久会延长连接和锁的占用时间,进一步造成连接池耗尽、锁等待和批量超时;应让回调只包含必须原子提交的数据库操作。
排障清单
- 确认注入的是正确的
PlatformTransactionManager,多数据源项目尤其要核对事务管理器与数据源的绑定关系。 - 检查异常是否在回调内被吞掉,或者被错误转换成正常返回值。
- 发现事务未回滚时,检查是否调用了
setRollbackOnly(),以及异常是否发生在事务完成之前。 - 出现连接池耗尽时,统计事务回调耗时,并排查远程调用、慢 SQL 和锁等待。
速查提示:TransactionTemplate 的价值在于让事务边界显式可见;回调内只做必须原子完成的数据库工作,通知、远程调用和补偿处理尽量放到事务结束之后。
使用 Flyway 或 Liquibase 管理数据库结构版本。
执行数据库迁移
数据库结构需要随应用版本持续演进时,应把 DDL 写成可追踪的迁移文件,由 Flyway 或 Liquibase 按版本执行,而不是在生产环境手工修改表结构。最终应能确认迁移已成功登记,并且重复启动不会再次执行同一版本。
使用时机
适合新增表、字段、索引以及其他需要随代码发布的结构变更。已有数据库接入迁移工具前,应先确认当前结构基线,避免把历史结构误当成待执行变更。
基本用法
以 Flyway 为主示例。Spring Boot 项目加入 Flyway 依赖并正确配置数据源后,应用启动时会扫描默认迁移目录 classpath:db/migration,按版本顺序执行尚未应用的脚本。具体数据库还应按所用 Flyway 版本确认所需数据库支持模块。
以下是 pom.xml 依赖片段,依赖已有可工作的 Spring Boot Maven 项目和对应数据库驱动:
<dependency>
    <groupId>org.flywaydb</groupId>
    <artifactId>flyway-core</artifactId>
</dependency>
创建 src/main/resources/db/migration/V1__create_customer.sql:
CREATE TABLE customer (
    id BIGINT PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);文件名中的版本必须唯一;V1 表示版本,双下划线后的内容用于描述本次迁移。已经在共享环境执行过的版本脚本原则上不要直接修改,应增加新的迁移版本修正结构。
执行与验证
在已经配置好数据源的项目根目录启动应用:
./mvnw spring-boot:run预期结果:应用正常启动,Flyway 完成待执行迁移且没有迁移校验或 SQL 执行错误。具体日志文本会随 Flyway 和 Spring Boot 版本变化,不应依赖某一条固定日志判断成功。
随后查询 Flyway 历史表:
SELECT version, description, success
FROM flyway_schema_history
ORDER BY installed_rank;
预期结果:成功执行上述迁移后,结果中存在版本 1、描述对应 create customer 且状态为成功的记录;布尔值的显示形式由具体数据库客户端决定。
Liquibase 对应方式
选择 Liquibase 时,应使用 changelog 描述变更,并由 Spring Boot 在启动阶段执行尚未应用的 changeSet。Liquibase 通过 DATABASECHANGELOG 等内部表记录已经执行的变更,不应再同时让 Flyway 管理同一批结构版本。
风险与恢复
生产迁移优先采用向后兼容的渐进变更,例如先增加可空字段,完成应用切换后再收紧约束。删除列、重命名字段、大表索引和类型转换可能长时间占用锁或产生较高 I/O,应先评估数据库自身的 DDL 能力并准备恢复方案。
使用缓存注解减少重复查询和计算。
启用应用缓存
当同一参数会反复触发昂贵查询或计算,而且结果允许在一段时间内复用时,可以启用 Spring Cache。核心目标是让首次调用计算结果,后续相同缓存键直接读取缓存,并为更新、删除和过期设计明确的失效策略。
基本配置
Spring Boot 项目首先加入缓存 starter:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-cache</artifactId>
</dependency>
上面是 pom.xml 依赖片段,依赖已有可工作的 Spring Boot Maven 项目。随后在配置类或启动类上启用缓存注解处理:
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.cache.annotation.EnableCaching;

@EnableCaching
@SpringBootApplication
public class Application {
    public static void main(String[] args) {
        SpringApplication.run(Application.class, args);
    }
}
预期结果:应用能够正常启动,且缓存相关自动配置没有初始化错误。未显式指定 Redis、Caffeine 等实现时,Spring Boot 会根据项目依赖选择可用的缓存管理器;生产环境应根据容量、过期策略和多实例一致性要求明确选择实现。
缓存方法结果
下面是依赖 Spring 应用上下文和已有业务对象的片段示例,重点展示缓存键与失效策略,不作为独立可运行程序:
import org.springframework.cache.annotation.CacheEvict;
import org.springframework.cache.annotation.Cacheable;
import org.springframework.stereotype.Service;

@Service
public class UserService {

    @Cacheable(cacheNames = "users", key = "#id")
    public User findById(long id) {
        // 只有缓存未命中时才访问真实数据源
        return userRepository.findById(id);
    }

    @CacheEvict(cacheNames = "users", key = "#p0.id")
    public void update(User user) {
        userRepository.save(user);
    }
}
预期结果:同一个 id 首次调用 findById 时执行方法体并写入 users 缓存;后续相同 id 的调用直接返回缓存值。执行 update 后对应缓存条目被驱逐,下一次读取会重新访问数据源。实际代码还需要注入已有 userRepository 并提供 User 类型。
@Cacheable 的 cacheNames 指定缓存区域,key 决定区域内的条目键;命中缓存后默认不会再次执行方法体。更新场景使用 @CacheEvict 删除旧值,适合由数据库写入后重新读取的场景;如果业务更适合直接把新值写回缓存,也可以使用 @CachePut。
验证缓存是否生效
完成真实 Repository 实现后启动应用:
./mvnw spring-boot:run预期结果:应用正常启动且缓存配置没有初始化错误。随后通过同一业务入口连续两次调用 findById 并传入相同 id,第一次应进入数据库查询,第二次应命中缓存而不再执行该查询。
验证命中与未命中时,优先使用数据库查询统计、测试桩计数或具体缓存实现提供的指标,而不是依赖固定日志文本,因为 Spring Cache 本身不保证统一的命中日志格式。
常见误用
Spring Cache 默认依赖 Spring AOP 代理拦截注解方法。同一个对象内部通过 this.findById(...) 自调用时,调用通常不会经过代理,因此可能绕过 @Cacheable。另外,缓存方法如果返回的是会被原地修改的可变对象,还需要考虑缓存值被调用方意外改变的问题。
连接 Redis 并配置序列化、超时和连接池。
配置 Redis
用于让 Spring Boot 3.x 通过默认 Lettuce 客户端连接 Redis,并统一键、值、哈希字段的序列化方式,同时限制连接与命令等待时间。以下配置适合单机或代理地址;哨兵、集群应改用对应节点配置。
添加依赖
片段示例:将依赖放入现有 pom.xml 的 <dependencies>。连接池参数只有在类路径中提供 Commons Pool 2 时才会生效。
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>
<dependency>
    <groupId>org.apache.commons</groupId>
    <artifactId>commons-pool2</artifactId>
</dependency>
预期结果:应用启动时自动配置 RedisConnectionFactory;存在 commons-pool2 时可使用 Lettuce 连接池配置。
配置连接与超时
片段示例:写入 application.yml。生产环境应由环境变量或密钥服务提供密码,不要把真实凭据提交到仓库。
spring:
  data:
    redis:
      host: ${REDIS_HOST:127.0.0.1}
      port: ${REDIS_PORT:6379}
      password: ${REDIS_PASSWORD:}
      database: 0
      connect-timeout: 2s
      timeout: 1s
      lettuce:
        pool:
          max-active: 16
          max-idle: 8
          min-idle: 2
          max-wait: 500ms
预期结果:应用按指定地址建立 Redis 连接;建立连接等待不超过 connect-timeout,命令读等待受 timeout 限制;连接池存在且启用时,池耗尽后的等待受 max-wait 限制。示例值只是起点,应按实际延迟、并发量和故障切换时间调优。
配置序列化
默认 RedisTemplate 的 Java 原生序列化结果不可读,也不适合接收不可信数据。下面固定键和哈希字段为 UTF-8 字符串,值和哈希值使用 JSON;定义该 Bean 后,会替换自动配置的同名 redisTemplate。
package com.example.demo.config;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.redis.connection.RedisConnectionFactory;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.data.redis.serializer.GenericJackson2JsonRedisSerializer;
import org.springframework.data.redis.serializer.StringRedisSerializer;

@Configuration
public class RedisConfig {

    @Bean
    public RedisTemplate<String, Object> redisTemplate(
            RedisConnectionFactory connectionFactory) {
        RedisTemplate<String, Object> template = new RedisTemplate<>();
        StringRedisSerializer keySerializer = new StringRedisSerializer();
        GenericJackson2JsonRedisSerializer valueSerializer =
                new GenericJackson2JsonRedisSerializer();

        template.setConnectionFactory(connectionFactory);
        // 键和哈希字段保持可读,便于 redis-cli 排障。
        template.setKeySerializer(keySerializer);
        template.setHashKeySerializer(keySerializer);
        // 普通值和哈希值统一使用 JSON,避免不同操作产生两套格式。
        template.setValueSerializer(valueSerializer);
        template.setHashValueSerializer(valueSerializer);
        template.afterPropertiesSet();
        return template;
    }
}
预期结果:通过该 Bean 写入的数据使用统一序列化规则;普通键和哈希字段可直接按字符串查看,Java 对象值保存为 JSON。已有数据若使用其他序列化器,不能直接混读,应先做兼容读取或按键前缀迁移。
验证连接
先用与应用相同的主机、端口和认证策略验证 Redis 可达性。启用认证时应通过受控方式提供凭据,不要把真实密码固定写进命令历史。
redis-cli -h 127.0.0.1 -p 6379 PING预期输出
PONGPONG 只证明当前网络与认证可用,不代表序列化和连接池配置全部正确。最终仍应启动应用并执行一次实际读写验证。
风险与排障
- 超时过小会在网络抖动或故障切换时频繁报错,过大又会让请求线程长期堆积;应同时观察 Redis 延迟、连接池等待和应用线程数。
max-wait使用负值可能导致池耗尽后无限等待,进而拖垮接口线程。生产环境应优先有限等待并快速失败。- 同一键由不同服务使用不同序列化器,会出现乱码、反序列化异常或类型不一致。应统一模板和键前缀,格式变更采用新版本前缀迁移。
Connection refused优先检查主机、端口、网络和安全组;NOAUTH检查认证配置;RedisCommandTimeoutException先查慢命令与网络延迟,再决定是否调整超时。
兼容性速查:以上配置按 Spring Boot 3.x / Spring Data Redis 3.x 编写。升级到其他大版本时,应重新核对 Redis 配置属性和 JSON 序列化 API,并先验证旧数据兼容性。
使用 RedisTemplate 读写字符串、哈希和集合。
操作 Redis 数据
使用 RedisTemplate 完成字符串、哈希和集合的读写,并为临时数据设置过期时间。下面用三个 demo: 前缀键完成一次完整验证,执行结束后主动清理测试数据。
常用操作
opsForValue() 对应普通键值,适合缓存对象、状态和计数;opsForHash() 适合按字段读写对象;opsForSet() 对应无序且去重的集合。Set 返回顺序不稳定,需要稳定展示时应在应用层排序。
完整示例
示例依赖已注册的 RedisTemplate<String, Object> Bean 和可用的 Redis 连接,使用 Spring Boot 3.x 对应的 Java 17 或更高版本运行。
package com.example.demo;

import java.time.Duration;
import java.util.List;
import java.util.Map;
import java.util.Set;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.data.redis.core.RedisTemplate;

@SpringBootApplication
public class RedisDataDemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(RedisDataDemoApplication.class, args);
    }

    @Bean
    CommandLineRunner redisDemo(RedisTemplate<String, Object> redisTemplate) {
        return args -> {
            String stringKey = "demo:greeting";
            String hashKey = "demo:user:1001";
            String setKey = "demo:tags";

            // 临时数据写入时设置 TTL,避免测试键长期占用内存。
            redisTemplate.opsForValue().set(
                    stringKey, "hello", Duration.ofMinutes(5));
            redisTemplate.opsForHash().putAll(
                    hashKey, Map.of("name", "Alice", "level", "VIP"));
            redisTemplate.expire(hashKey, Duration.ofMinutes(10));
            redisTemplate.opsForSet().add(
                    setKey, "java", "redis", "spring", "java");
            redisTemplate.expire(setKey, Duration.ofMinutes(10));

            Object greeting = redisTemplate.opsForValue().get(stringKey);
            Object name = redisTemplate.opsForHash().get(hashKey, "name");
            Object level = redisTemplate.opsForHash().get(hashKey, "level");
            Set<Object> members = redisTemplate.opsForSet().members(setKey);
            List<String> tags = members == null
                    ? List.of()
                    : members.stream().map(String::valueOf).sorted().toList();

            System.out.println("string=" + greeting);
            System.out.println("hash.name=" + name);
            System.out.println("hash.level=" + level);
            System.out.println("set=" + tags);

            // 只删除本示例创建的键,不使用 FLUSHDB。
            redisTemplate.delete(List.of(stringKey, hashKey, setKey));
        };
    }
}
预期输出
string=hello
hash.name=Alice
hash.level=VIP
set=[java, redis, spring]
示例结束后,三个测试键应被删除;如果应用同时运行其他 CommandLineRunner,日志行的整体顺序可能不同,但上述四行内容应保持一致。
返回值与边界
get() 和 HashOperations.get() 在键或字段不存在时返回 null;SetOperations.add() 返回本次真正新增的成员数量,重复成员不计数;members() 会读取整个集合,集合很大时不应一次性拉取,应改用游标扫描或重新设计访问方式。
需要原子计数时使用 increment(),不要先 get() 再在 Java 中加一后 set()。需要“仅首次写入”时可使用 setIfAbsent(),并同时设置 TTL,避免并发覆盖。
风险与边界
- 同一个键从字符串改成 Hash 或 Set 会触发
WRONGTYPE。先确认键用途和前缀,迁移时使用新键,不要在不清楚影响范围时直接删除生产键。 - 未设置 TTL 的缓存可能持续增长并造成内存压力。缓存数据应在写入时携带明确的
Duration,确需长期保存的数据则应有容量和清理策略。 get后计算再set不是原子操作,并发下可能丢更新。计数优先使用increment,多步骤条件更新再考虑 Lua、事务或业务锁。- 生产环境不要用
KEYS *或FLUSHDB做排障;前者可能阻塞实例,后者会清空整个数据库。优先使用明确键名或业务前缀配合SCAN。
排障清单
读不到数据时,依次核对数据库索引、键前缀、TTL 和实际连接的 Redis 实例。出现乱码或反序列化异常时,检查写入端与读取端是否使用一致的键、值和哈希序列化器;测试环境可删除对应测试键后重写,生产环境应先执行数据迁移,不能直接清库。
使用 Async 将非阻塞业务交给线程池执行。
执行异步任务
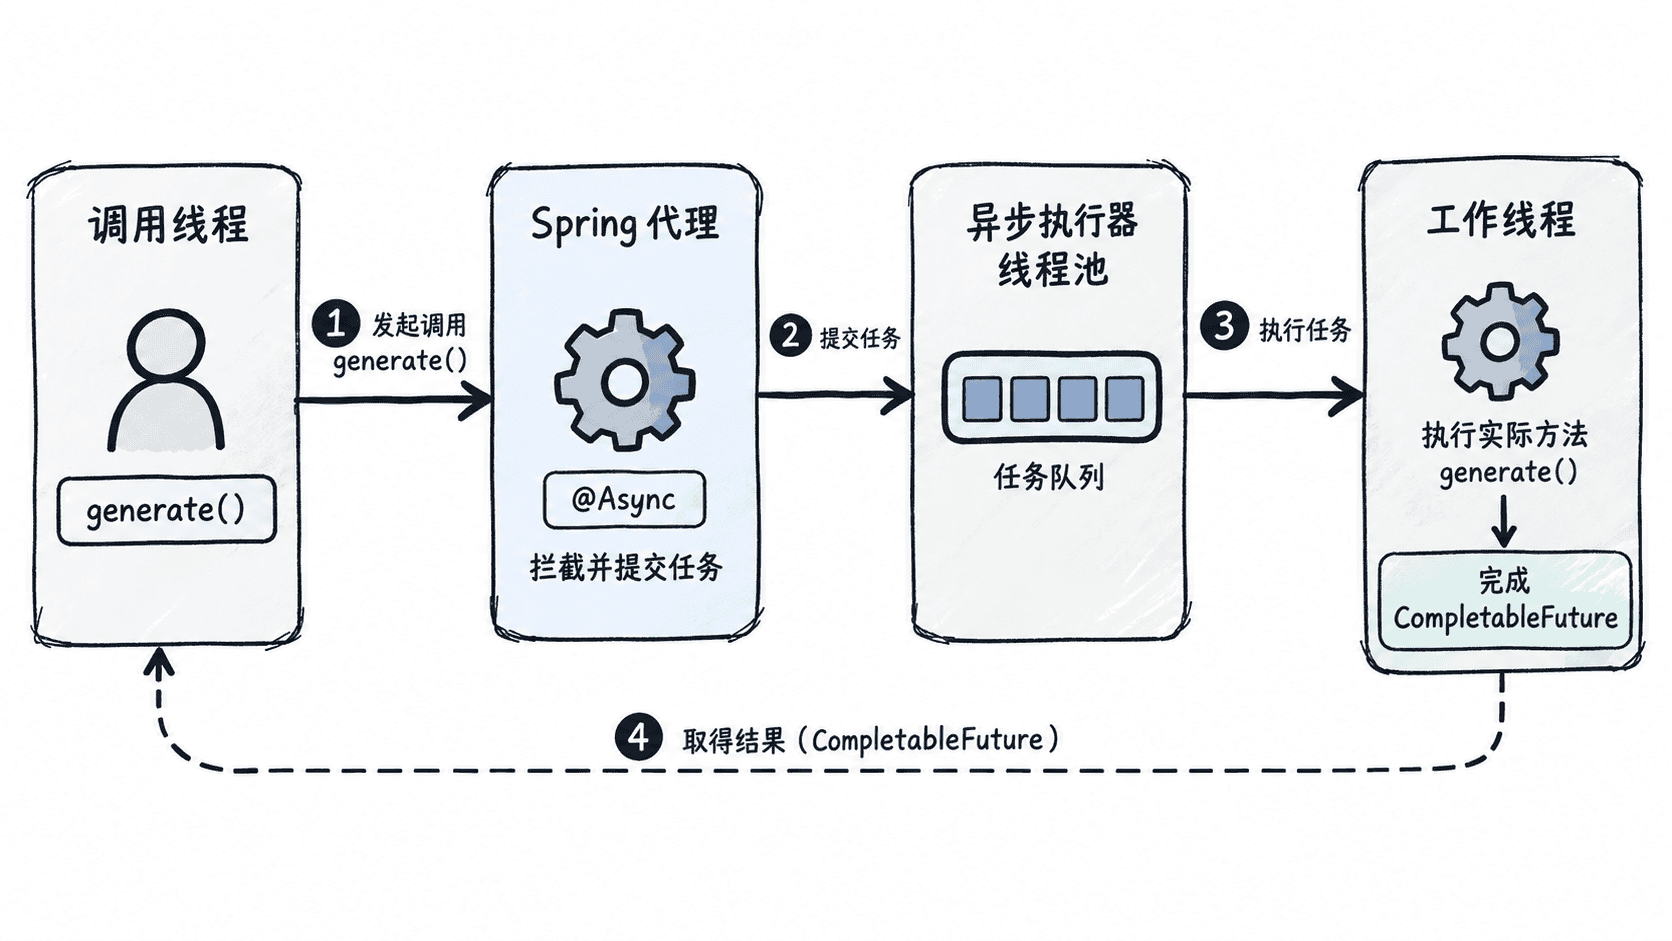
当某段业务不要求当前请求线程等待完成时,可以使用 Spring 的 @Async 将方法提交给异步执行器。启用异步能力后,调用仍必须经过 Spring 代理;同一个对象内部直接调用自身方法不会触发异步执行。
基本写法
在配置类或启动类启用异步能力,再把需要异步执行的公开方法标记为 @Async。常见返回类型包括 void、Future 和 CompletableFuture;需要把结果或异常传回调用方时,优先使用 CompletableFuture。
主示例
下面示例启用异步能力,并让 ReportService.generate() 返回 CompletableFuture。服务通过 Spring Bean 管理,调用会经过代理后进入异步执行器。
package com.example.demo;

import java.util.concurrent.CompletableFuture;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.scheduling.annotation.Async;
import org.springframework.scheduling.annotation.EnableAsync;
import org.springframework.stereotype.Service;

@SpringBootApplication
@EnableAsync
public class AsyncDemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(AsyncDemoApplication.class, args);
    }

    @Bean
    CommandLineRunner run(ReportService reportService) {
        return args -> {
            CompletableFuture<String> future = reportService.generate();
            System.out.println("caller=" + Thread.currentThread().getName());
            System.out.println("result=" + future.join());
        };
    }
}

@Service
class ReportService {

    @Async
    public CompletableFuture<String> generate() {
        // 通过 Spring 代理进入异步执行器,避免在调用线程中直接完成。
        System.out.println("worker=" + Thread.currentThread().getName());
        return CompletableFuture.completedFuture("done");
    }
}
预期输出:调用线程与工作线程名称不同;日志先后顺序可能因调度时机而变化。
caller=<VALUE>
worker=<VALUE>
result=done
示例中的 join() 只是为了让命令行程序等待并验证结果。真实请求链路若目标是尽快返回,不应提交异步任务后立即 join(),否则当前线程仍会等待任务结束。
使用边界
@Async 适合邮件通知、报表生成、非强一致审计等能够与主流程解耦的任务。它不会自动提升整体性能:任务仍会消耗线程、CPU、内存及下游连接,线程池不足时还可能出现排队或拒绝。
最常见的误用是内部调用,例如 this.generate()。这种调用绕过 Spring 代理,因此不会切换到异步线程。需要异步执行时,应让调用从另一个 Spring Bean 进入目标方法。
异常与事务
返回 CompletableFuture 时,异步任务失败会体现为 Future 的异常状态,调用方在 join() 或 get() 时才能感知异常。void 异步方法无法把异常直接返回给调用者,应通过日志、监控或 AsyncUncaughtExceptionHandler 统一处理。
事务上下文也不会自然跨线程传播。若异步方法需要事务,应在异步方法所在 Bean 上建立明确的事务边界,而不是依赖调用线程已经开启的事务。
设置线程数、队列容量、拒绝策略和线程名称。
配置业务线程池
当异步任务需要可控的并发度、排队上限和过载行为时,应显式配置 ThreadPoolTaskExecutor,并通过 @Async("businessExecutor") 指定执行器,避免不同业务任务共享不可控的默认执行环境。
核心参数
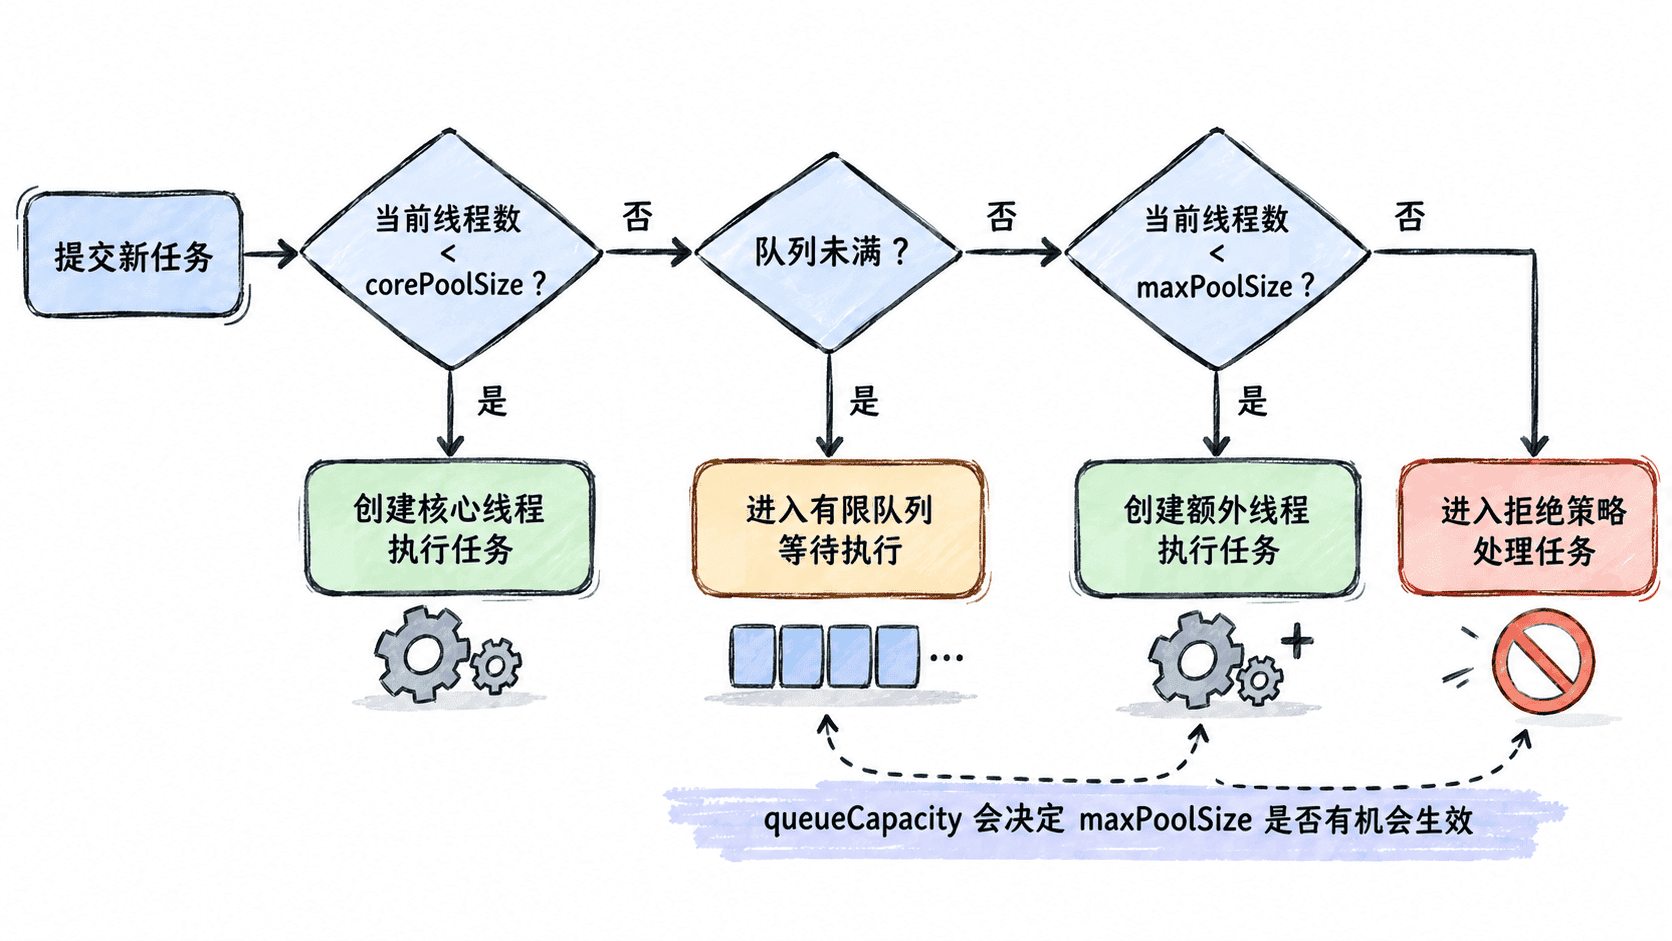
任务提交后,线程池通常先补足核心线程;核心线程达到上限后进入队列;队列满后才继续创建线程直到 maxPoolSize;线程和队列都无法接收时执行拒绝策略。因此,maxPoolSize 只有在有限队列被填满后才真正参与扩容。
| 配置 | 作用 | 关注点 |
|---|---|---|
corePoolSize |
核心工作线程数 | 以稳定并发量和 CPU 能力为基线 |
maxPoolSize |
队列满后允许扩展的线程上限 | 过大可能放大下游压力 |
queueCapacity |
等待执行的任务数量上限 | 过大队列会掩盖拥塞并增加等待时间 |
RejectedExecutionHandler |
线程与队列都满后的处理方式 | 明确抛错、反压还是丢弃 |
threadNamePrefix |
工作线程名前缀 | 便于日志和监控定位 |
主示例
下面配置一个独立的业务线程池,并让 @Async 方法显式使用它。示例采用 AbortPolicy:过载时拒绝提交并抛出异常,便于上层感知失败并执行降级,而不是静默丢失任务。
package com.example.demo;

import java.util.concurrent.CompletableFuture;
import java.util.concurrent.Executor;
import java.util.concurrent.ThreadPoolExecutor;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.scheduling.annotation.Async;
import org.springframework.scheduling.annotation.EnableAsync;
import org.springframework.scheduling.concurrent.ThreadPoolTaskExecutor;
import org.springframework.stereotype.Service;

@SpringBootApplication
@EnableAsync
public class ThreadPoolDemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(ThreadPoolDemoApplication.class, args);
    }

    @Bean("businessExecutor")
    Executor businessExecutor() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(4);
        executor.setMaxPoolSize(8);
        executor.setQueueCapacity(100);
        executor.setThreadNamePrefix("biz-");
        executor.setRejectedExecutionHandler(new ThreadPoolExecutor.AbortPolicy());
        executor.setWaitForTasksToCompleteOnShutdown(true);
        executor.setAwaitTerminationSeconds(30);
        executor.initialize();
        return executor;
    }

    @Bean
    CommandLineRunner run(OrderService orderService) {
        return args -> System.out.println("result=" + orderService.process().join());
    }
}

@Service
class OrderService {

    @Async("businessExecutor")
    public CompletableFuture<String> process() {
        // 线程名前缀用于快速确认任务进入指定业务线程池。
        System.out.println("worker=" + Thread.currentThread().getName());
        return CompletableFuture.completedFuture("done");
    }
}
预期输出:线程名以 biz- 开头,数字后缀由运行时分配。
worker=biz-<VALUE>
result=done
拒绝策略与容量
AbortPolicy 适合希望快速暴露过载、由上层执行降级或重试的场景。CallerRunsPolicy 会让提交任务的线程自己执行任务,从而形成反压,但如果提交线程是 Web 请求线程,也可能显著拉长请求延迟。丢弃型策略只有在业务明确允许丢任务时才应使用。
线程数不是越大越好。CPU 密集任务通常受核心数约束;I/O 密集任务可以适度增加线程,但必须同时考虑数据库连接池、HTTP 连接池和下游限流,否则只是把瓶颈转移到其他资源。
风险与恢复
生产环境应监控活跃线程数、队列长度、任务耗时和拒绝次数。若持续出现队列接近上限或拒绝,先判断是流量突增、单任务变慢还是下游阻塞,再选择扩容、限流、降级或拆分任务。
使用 Scheduled 按固定间隔或 Cron 表达式执行任务。
创建定时任务
用于在 Spring Boot 应用内周期执行清理、统计、补偿等轻量任务。启用调度后,可用固定延迟、固定频率或 Cron 表达式控制执行时机。
基本用法
在配置类或启动类添加 @EnableScheduling,再把无参方法标记为 @Scheduled。任务类必须由 Spring 容器管理,方法返回值会被忽略。
package com.example.demo;

import java.time.LocalTime;
import java.util.concurrent.atomic.AtomicInteger;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.scheduling.annotation.EnableScheduling;
import org.springframework.scheduling.annotation.Scheduled;
import org.springframework.stereotype.Component;

@SpringBootApplication
@EnableScheduling
public class DemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(DemoApplication.class, args);
    }

    @Bean
    CommandLineRunner ready() {
        return args -> System.out.println("application ready");
    }
}

@Component
class CleanupTask {

    private final AtomicInteger executions = new AtomicInteger();

    // 从上一次执行结束后再等待 5 秒,适合不希望任务重叠的场景。
    @Scheduled(initialDelay = 1000, fixedDelay = 5000)
    void cleanExpiredData() {
        int count = executions.incrementAndGet();
        System.out.printf("%s cleanup #%d%n", LocalTime.now(), count);
    }
}
预期输出
application ready
<TIME> cleanup #1
<TIME> cleanup #2
<TIME> 为实际执行时间。首次执行约在应用启动 1 秒后;后续执行会在上一次任务结束后再等待 5 秒。
调度方式
fixedDelay:从上一次执行结束后开始计时,适合清理、轮询和补偿等任务。fixedRate:按任务开始时间计算周期,适合执行时间较短、希望保持固定节奏的任务。cron:按日历时间触发,适合每天、每周或工作日任务。initialDelay:延迟第一次执行,避免应用启动后立即争抢数据库或网络资源。
Cron 使用 6 段格式“秒 分 时 日 月 星期”。下面是片段示例,需放入现有 Spring Bean:
@Scheduled(cron = "0 0 1 * * *", zone = "Asia/Kuala_Lumpur")
void buildDailyReport() {
    // 每天当地时间 01:00 执行。
}
生效行为:任务每天当地时间 01:00 触发。验证时可临时改为 */10 * * * * *,观察是否每 10 秒触发一次,确认后恢复正式表达式。
线程池配置
多个慢任务同时运行时,调度线程可能成为瓶颈。可以通过配置扩大调度线程池,并设置线程名前缀,便于从日志和线程栈定位具体任务。
spring:
  task:
    scheduling:
      pool:
        size: 4
      thread-name-prefix: schedule-
      shutdown:
        await-termination: true
        await-termination-period: 30s
生效行为:调度器最多可同时使用 4 个线程执行不同任务;应用关闭时最多等待 30 秒让任务结束。可在线程日志中检查线程名是否类似 schedule-1、schedule-2。
风险与边界
多实例部署时,每个实例都会执行同一任务,可能造成重复扣款、重复发消息或重复生成报表。需要集群内只执行一次时,应增加分布式锁或改用集中式调度方案。
不要只依赖进程内调度承担不可丢失的关键任务。进程宕机、发布重启或长时间停顿期间的触发不会自动补跑;更稳妥的方式是把待处理记录持久化,并让任务按状态幂等扫描。
fixedRate 只描述触发周期,不等于业务层面的“强制并发执行”。使用多线程调度、@Async 或多实例部署后,任务可能出现并发处理,仍需用业务唯一键、状态机或锁保证幂等。
排障清单
- 完全不执行:检查
@EnableScheduling、任务类是否为 Spring Bean,以及方法是否被条件配置排除。 - Cron 时间不符:检查
zone、服务器时区和表达式的秒字段。 - 任务越跑越晚:检查调度线程是否被长任务占用,以及数据库、外部接口和线程池是否存在阻塞。
- 异常后无业务结果:记录任务开始、成功、失败和耗时,并配置告警,不要只依赖默认日志。
- 多节点重复执行:确认是否存在分布式锁,并检查锁租约是否覆盖最长执行时间。
速查:轻量且可容忍漏触发的应用内任务适合 @Scheduled;关键、分布式或需要补偿记录的任务应使用持久化调度方案。
通过事件机制解耦业务操作和后续处理。
发布应用事件
当一个业务动作完成后,需要让通知、审计、缓存刷新等组件继续处理,但又不希望业务服务直接依赖这些组件时,可以通过 ApplicationEventPublisher 发布应用事件。默认事件分发是同步的,解耦的是组件依赖,而不是执行线程。
使用时机
发布方只负责描述“发生了什么”,监听方通过 @EventListener 订阅事件。一个事件可以有多个监听器,因此适合扩展后续处理;如果后续逻辑必须等数据库事务成功提交后再执行,应改用 @TransactionalEventListener。
基本用法
核心 API 是 ApplicationEventPublisher.publishEvent(Object event)。事件可以是普通 Java 对象或 record,通常只携带监听器真正需要的数据,避免把 Service、Repository 或可变实体对象直接塞进事件。
package com.example.demo;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.ApplicationEventPublisher;
import org.springframework.context.annotation.Bean;
import org.springframework.context.event.EventListener;
import org.springframework.stereotype.Component;
import org.springframework.stereotype.Service;

@SpringBootApplication
public class EventDemoApplication {
    public static void main(String[] args) {
        SpringApplication.run(EventDemoApplication.class, args);
    }

    @Bean
    CommandLineRunner demo(OrderService orderService) {
        return args -> orderService.createOrder(1001L);
    }
}

record OrderCreatedEvent(long orderId) {}

@Service
class OrderService {
    private final ApplicationEventPublisher publisher;

    OrderService(ApplicationEventPublisher publisher) {
        this.publisher = publisher;
    }

    void createOrder(long orderId) {
        System.out.println("order saved: " + orderId);
        // 发布业务事实,发布方不需要知道有哪些后续处理器。
        publisher.publishEvent(new OrderCreatedEvent(orderId));
    }
}

@Component
class OrderCreatedListener {
    @EventListener
    void handle(OrderCreatedEvent event) {
        System.out.println("send notification: " + event.orderId());
    }
}
预期输出
order saved: 1001
send notification: 1001
忽略 Spring Boot 自身启动日志。默认事件分发同步执行,因此监听器输出会出现在 publishEvent 返回之前。
事务场景
普通 @EventListener 不会等待事务提交。事件发布发生在事务方法内部时,监听器可能在事务真正提交前执行;因此“只有提交成功才发送通知”这类需求不应依赖普通事件监听器。
使用 @TransactionalEventListener 时,可以把监听动作绑定到事务阶段。例如需要提交成功后再处理时,显式指定 TransactionPhase.AFTER_COMMIT:
import org.springframework.context.event.EventListener;
import org.springframework.transaction.event.TransactionPhase;
import org.springframework.transaction.event.TransactionalEventListener;

@EventListener
void handle(OrderCreatedEvent event) {
    // 普通事件监听:不等待事务提交。
}

@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)
void handleAfterCommit(OrderCreatedEvent event) {
    // 仅在关联事务成功提交后执行。
}
预期结果
普通 @EventListener:发布事件后即可执行监听器
@TransactionalEventListener(AFTER_COMMIT):事务成功提交后才执行监听器
上面的代码是片段示例,依赖已有的 Spring 事务配置和业务事件对象;同一个监听器不应同时保留两种处理语义,否则可能重复处理。
风险与边界
不要把 publishEvent 理解成消息队列发送或异步任务提交。默认监听器与发布者运行在同一线程,监听器执行缓慢会直接增加调用耗时,监听器抛出的未处理异常也可能回传到发布方。
如果业务要求可靠投递、跨进程消费、失败重试或进程重启后仍可继续处理,应用事件本身并不能替代持久化消息机制。对于事务一致性场景,还要明确事件是在提交前还是提交后执行,并为重复处理设计幂等规则。
在数据库事务成功提交后处理通知或消息发送。
事务提交后执行
通知、消息发送或外部系统调用只有在数据库事务真正提交成功后才允许发生时,可以使用 @TransactionalEventListener 并指定 TransactionPhase.AFTER_COMMIT。这样事务回滚时监听器不会执行,避免数据库失败却已经向外部系统发送成功通知。
核心写法
在 @Transactional 方法中通过 ApplicationEventPublisher 发布事件,再由事务事件监听器接收。AFTER_COMMIT 是 @TransactionalEventListener 的默认阶段,也可以显式声明以清楚表达意图。
@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)
void handle(OrderCreatedEvent event) {
    // 仅在发布事件所在事务成功提交后执行。
}
这是片段示例,需要放在 Spring 管理的 Bean 中,并且事件必须在受 Spring 事务管理的事务上下文中发布。
提交后时序
事件在事务内部发布时不会立即调用 AFTER_COMMIT 监听器。Spring 会把监听动作绑定到当前事务同步过程;只有提交成功后才触发监听器,回滚路径则跳过该监听器。
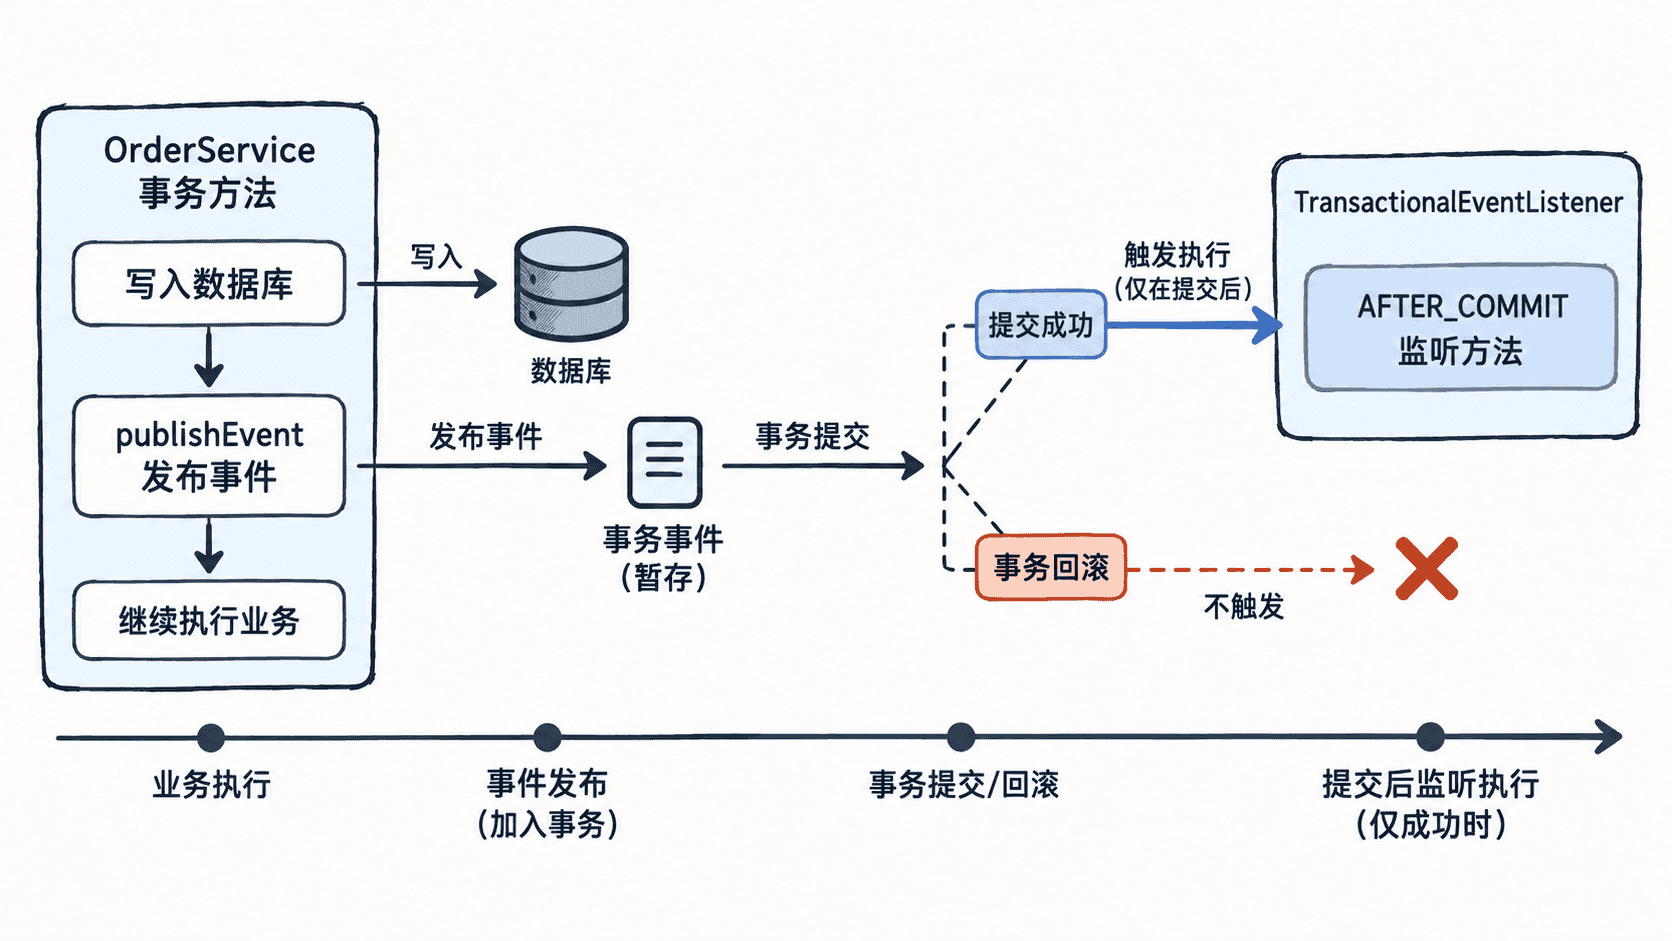
主示例与预期结果
下面示例假定项目已经配置 spring-boot-starter-jdbc 和可用 DataSource。事务方法先写入数据库再发布事件;监听器只有在该事务成功提交后才打印结果。
package com.example.demo;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.ApplicationEventPublisher;
import org.springframework.context.annotation.Bean;
import org.springframework.jdbc.core.JdbcTemplate;
import org.springframework.stereotype.Component;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Transactional;
import org.springframework.transaction.event.TransactionPhase;
import org.springframework.transaction.event.TransactionalEventListener;

@SpringBootApplication
public class TransactionEventApplication {
    public static void main(String[] args) {
        SpringApplication.run(TransactionEventApplication.class, args);
    }

    @Bean
    CommandLineRunner demo(JdbcTemplate jdbcTemplate, OrderService orderService) {
        return args -> {
            jdbcTemplate.execute("create table if not exists orders (id bigint primary key)");
            jdbcTemplate.update("delete from orders");
            orderService.createOrder(1001L);
            System.out.println("service returned");
        };
    }
}

record OrderCreatedEvent(long orderId) {}

@Service
class OrderService {
    private final JdbcTemplate jdbcTemplate;
    private final ApplicationEventPublisher publisher;

    OrderService(JdbcTemplate jdbcTemplate, ApplicationEventPublisher publisher) {
        this.jdbcTemplate = jdbcTemplate;
        this.publisher = publisher;
    }

    @Transactional
    public void createOrder(long orderId) {
        jdbcTemplate.update("insert into orders(id) values (?)", orderId);
        // 这里只发布事件,不执行提交后的监听逻辑。
        publisher.publishEvent(new OrderCreatedEvent(orderId));
        System.out.println("event published in tx: " + orderId);
    }
}

@Component
class OrderCreatedListener {
    @TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)
    void afterCommit(OrderCreatedEvent event) {
        System.out.println("after commit: " + event.orderId());
    }
}预期输出:忽略框架启动日志,关键输出顺序如下。after commit 出现在事务方法内部日志之后,并在代理方法返回调用方之前执行。
event published in tx: 1001
after commit: 1001
service returned
风险与边界
默认情况下,如果发布事件时不存在活动事务,@TransactionalEventListener 不会执行;只有明确设置 fallbackExecution = true 才会允许无事务场景触发,因此不要用它替代普通 @EventListener。
AFTER_COMMIT 表示原事务已经完成。若监听器还需要写数据库并保证这部分写入独立提交,应为该写操作开启新的事务,例如使用 Propagation.REQUIRES_NEW;不要误以为提交后监听器仍能向已经完成的原事务追加可提交修改。
对于必须可靠投递到外部消息系统的场景,仅靠提交后监听仍存在进程崩溃导致消息丢失的窗口。需要更强可靠性时,应考虑事务 Outbox 等持久化方案。
使用 RestClient 发起同步 HTTP 请求并处理响应。
调用外部 HTTP 接口
使用 RestClient 发起阻塞式 HTTP 请求,并同时读取状态码、响应头和响应体。适合普通同步调用;高并发异步、流式下载或长连接场景应改用 WebClient。
基本用法
下面示例在本机启动一个临时 HTTP 服务,再通过 RestClient 提交 JSON。可直接放入已包含 spring-boot-starter-web 的 Spring Boot 3.2+ 项目运行。
import com.sun.net.httpserver.HttpServer;
import java.net.InetSocketAddress;
import java.nio.charset.StandardCharsets;
import java.time.Duration;
import org.springframework.http.HttpStatusCode;
import org.springframework.http.MediaType;
import org.springframework.http.ResponseEntity;
import org.springframework.http.client.SimpleClientHttpRequestFactory;
import org.springframework.web.client.RestClient;

public class RestClientDemo {

    public static void main(String[] args) throws Exception {
        HttpServer server = HttpServer.create(new InetSocketAddress(0), 0);
        server.createContext("/api/orders", exchange -> {
            exchange.getRequestBody().readAllBytes();
            byte[] response = "{\"code\":\"00\",\"message\":\"accepted\"}"
                    .getBytes(StandardCharsets.UTF_8);
            exchange.getResponseHeaders().set("Content-Type", "application/json");
            exchange.sendResponseHeaders(201, response.length);
            exchange.getResponseBody().write(response);
            exchange.close();
        });
        server.start();

        try {
            int port = server.getAddress().getPort();
            SimpleClientHttpRequestFactory factory = new SimpleClientHttpRequestFactory();
            factory.setConnectTimeout(Duration.ofSeconds(2));
            factory.setReadTimeout(Duration.ofSeconds(3));

            RestClient client = RestClient.builder()
                    .baseUrl("http://localhost:" + port)
                    .requestFactory(factory)
                    .defaultHeader("X-Trace-Id", "trace-demo")
                    .build();

            ResponseEntity<ApiResponse> response = client.post()
                    .uri("/api/orders")
                    .contentType(MediaType.APPLICATION_JSON)
                    .body(new CreateOrder("M1001", 1200))
                    .retrieve()
                    .onStatus(HttpStatusCode::isError, (request, error) -> {
                        throw new IllegalStateException("HTTP " + error.getStatusCode());
                    })
                    .toEntity(ApiResponse.class);

            ApiResponse body = response.getBody();
            if (body == null) {
                throw new IllegalStateException("Empty response body");
            }

            System.out.println("status=" + response.getStatusCode().value());
            System.out.println("code=" + body.code());
            System.out.println("message=" + body.message());
        } finally {
            server.stop(0);
        }
    }

    record CreateOrder(String merchantOrderNo, long amount) {
    }

    record ApiResponse(String code, String message) {
    }
}
预期输出:
status=201
code=00
message=accepted
本例端口由操作系统动态分配,实际端口值可能不同,但不会影响上述输出。
调用链速查
baseUrl 保存公共地址,uri 只写接口路径;contentType 声明请求体格式,body 交给消息转换器序列化。retrieve() 后必须继续调用 body、toEntity 或 toBodilessEntity 等终止方法,才会真正发送并消费响应。
只关心响应体时使用 body(ResponseType.class);还需要状态码和响应头时使用 toEntity(ResponseType.class)。处理泛型响应,例如 List<Order>,使用 ParameterizedTypeReference。
默认情况下,读取到 4xx 或 5xx 响应会抛出 RestClientException 的子类。需要映射业务异常时使用 onStatus;改用 exchange 后应自行检查状态码,因为状态处理器不会自动应用。
风险与边界
在数据库事务中同步调用外部接口,遇到慢响应会同时占用请求线程、数据库连接和事务锁,可能导致线程池或连接池耗尽。安全做法是设置连接与读取超时,并尽量在事务提交后调用,或改成消息驱动。
对 POST、扣款、发货等非幂等操作直接重试,可能造成重复执行。只有在下游支持幂等键时才重试,并限制次数、退避时间和可重试状态码。
不要把令牌、银行卡号、身份证号或完整响应体直接写入日志。生产日志应保留 URL、状态码、耗时、追踪 ID 和脱敏后的业务键。
排障清单
- 连接超时:检查 DNS、目标地址、代理、防火墙和连接超时设置。
- 读取超时:确认下游处理耗时,并检查读取超时是否过短。
- 4xx:记录状态码和脱敏响应体,重点检查认证头、路径参数和请求格式。
- 5xx:结合追踪 ID 查询下游日志;只对明确的临时故障进行有限重试。
- JSON 转换失败:核对
Content-Type、字段名、字段类型以及 Jackson 是否在依赖中。
兼容性
RestClient 从 Spring Framework 6.1 开始提供,对应 Spring Boot 3.2 及以上版本。旧项目可继续使用 RestTemplate,但新同步调用优先使用 RestClient;需要非阻塞或流式处理时使用 WebClient。
为外部 HTTP 请求配置连接和读取超时。
设置外部 HTTP 调用超时
为同步外部 HTTP 请求分别设置连接超时和读取超时,避免上游不可达或响应过慢时长期占用业务线程。下面示例基于 Spring Boot 3.2+ 的 RestClient,只依赖 spring-boot-starter-web。
基本配置
连接超时限制建立 TCP/TLS 连接的等待时间;读取超时限制连接建立后等待响应数据的时间。示例调用本机慢接口,并在 500ms 后触发读取超时。
import java.net.http.HttpClient;
import java.time.Duration;

import org.springframework.boot.CommandLineRunner;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.boot.web.servlet.context.ServletWebServerApplicationContext;
import org.springframework.context.annotation.Bean;
import org.springframework.http.client.JdkClientHttpRequestFactory;
import org.springframework.stereotype.Controller;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.ResponseBody;
import org.springframework.web.client.ResourceAccessException;
import org.springframework.web.client.RestClient;

@SpringBootApplication
public class TimeoutDemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(TimeoutDemoApplication.class, args);
    }

    @Bean
    RestClient externalRestClient() {
        HttpClient httpClient = HttpClient.newBuilder()
                .connectTimeout(Duration.ofSeconds(1))
                .build();

        JdkClientHttpRequestFactory factory =
                new JdkClientHttpRequestFactory(httpClient);
        // 连接建立后如果迟迟收不到响应数据,最多等待 500ms。
        factory.setReadTimeout(Duration.ofMillis(500));

        return RestClient.builder()
                .requestFactory(factory)
                .build();
    }

    @Bean
    CommandLineRunner verifyTimeout(
            RestClient client,
            ServletWebServerApplicationContext context) {
        return args -> {
            int port = context.getWebServer().getPort();
            String url = "http://127.0.0.1:" + port + "/slow";
            try {
                client.get().uri(url).retrieve().body(String.class);
                System.out.println("UNEXPECTED_SUCCESS");
            } catch (ResourceAccessException ex) {
                System.out.println("READ_TIMEOUT");
            }
        };
    }
}

@Controller
class SlowController {

    @GetMapping("/slow")
    @ResponseBody
    String slow() throws InterruptedException {
        Thread.sleep(1500);
        return "ok";
    }
}
预期输出:
READ_TIMEOUT读取方法:出现 READ_TIMEOUT 表示请求已连接到本机接口,但等待响应数据超过 500ms。实际端口和启动日志会随环境变化。
高频用法
生产环境通常按上游分别创建 RestClient Bean,例如支付通道 3 秒、文件服务 15 秒,不要让所有外部系统共用同一超时。调用方应注入已配置的 Bean,避免临时使用 RestClient.create() 绕过配置。
连接超时适合处理地址不可达、端口未监听或握手迟缓;读取超时适合处理连接已建立但上游处理过慢。超时后通常会抛出 ResourceAccessException,排障时继续检查根因是否为 HTTP 客户端或底层套接字超时。
风险与边界
超时设置过短会把正常抖动误判为失败;如果同时自动重试,还可能放大流量并造成上游压力。安全做法是依据上游 P95/P99 延迟设置预算,并限制重试次数、增加退避和熔断。
支付、下单、退款等非幂等请求发生读取超时时,不能直接认定上游未处理。可能出现“上游成功、本地超时”的未知状态,应使用请求号或幂等键查询最终结果,再决定是否补偿。
排障清单
- 配置未生效:确认业务注入的是目标
RestClientBean,没有自行新建客户端。 - 总是连接超时:检查 DNS、目标地址、端口、防火墙、代理和 TLS 握手。
- 总是读取超时:记录上游耗时,检查慢查询、线程池、连接池和响应体大小。
- 只有高峰期超时:同时检查本机业务线程池和上游容量,避免只盲目调大超时。
速查:先区分“连不上”还是“连上但返回慢”,再调整对应超时;超时不是失败结果,非幂等接口必须查单确认。
使用 Spring Security 配置接口访问控制。
添加接口认证
当接口需要区分公开、已登录和管理员访问时,用 Spring Security 的 SecurityFilterChain 统一声明认证方式与路径授权规则。下面用 HTTP Basic 做最小可验证示例,重点是建立访问控制骨架;实际系统可以在不改变授权规则的前提下替换认证机制。
前置条件
项目应已包含 spring-boot-starter-web 和 spring-boot-starter-security。示例显式定义用户来源与密码编码器,避免依赖开发期自动生成密码。HTTP Basic 仅适用于演示或受控场景,生产传输必须配合 HTTPS。
核心配置
将下面内容保存为项目组件扫描范围内的 SecurityConfig.java。规则按声明顺序匹配:公开接口放行,管理员接口要求 ADMIN 角色,其余 /api/** 只要求已认证,最后用 denyAll 关闭未声明入口。
package com.example.demo;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.config.Customizer;
import org.springframework.security.config.annotation.web.builders.HttpSecurity;
import org.springframework.security.core.userdetails.User;
import org.springframework.security.core.userdetails.UserDetails;
import org.springframework.security.core.userdetails.UserDetailsService;
import org.springframework.security.crypto.factory.PasswordEncoderFactories;
import org.springframework.security.crypto.password.PasswordEncoder;
import org.springframework.security.provisioning.InMemoryUserDetailsManager;
import org.springframework.security.web.SecurityFilterChain;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@Configuration
public class SecurityConfig {
    @Bean
    PasswordEncoder passwordEncoder() {
        return PasswordEncoderFactories.createDelegatingPasswordEncoder();
    }

    @Bean
    UserDetailsService users(PasswordEncoder encoder) {
        UserDetails user = User.withUsername("apiuser")
                .password(encoder.encode("demo-pass"))
                .roles("USER")
                .build();
        UserDetails admin = User.withUsername("admin")
                .password(encoder.encode("admin-pass"))
                .roles("ADMIN")
                .build();
        return new InMemoryUserDetailsManager(user, admin);
    }

    @Bean
    SecurityFilterChain securityFilterChain(HttpSecurity http) throws Exception {
        http
                .authorizeHttpRequests(auth -> auth
                        .requestMatchers("/api/public/**").permitAll()
                        .requestMatchers("/api/admin/**").hasRole("ADMIN")
                        .requestMatchers("/api/**").authenticated()
                        .anyRequest().denyAll())
                .httpBasic(Customizer.withDefaults());
        return http.build();
    }
}

@RestController
class DemoController {
    @GetMapping("/api/public/ping")
    String publicPing() {
        return "public";
    }

    @GetMapping("/api/hello")
    String hello() {
        return "ok";
    }

    @GetMapping("/api/admin/ping")
    String adminPing() {
        return "admin";
    }
}
hasRole("ADMIN") 实际匹配 ROLE_ADMIN 权限;roles("ADMIN") 会按同一约定创建该权限。若项目已有数据库、LDAP 或外部身份源,只需替换 UserDetailsService,路径授权规则可以继续复用。
验证访问控制
应用启动并监听 <PORT> 后执行:
curl -i http://localhost:<PORT>/api/hello
curl -i -u apiuser:demo-pass http://localhost:<PORT>/api/hello
curl -i -u apiuser:demo-pass http://localhost:<PORT>/api/admin/ping
curl -i -u admin:admin-pass http://localhost:<PORT>/api/admin/ping
预期结果:
1) 401 Unauthorized
2) 200 OK,响应体为 ok
3) 403 Forbidden
4) 200 OK,响应体为 admin
<PORT> 以应用实际监听端口为准。401 表示尚未通过认证,403 表示身份已确认但权限不足,这两个状态不要混用。
风险与恢复
不要把 permitAll() 放在过宽的路径上,也不要用 anyRequest().permitAll() 作为“临时排障”后忘记恢复。修改规则前先保留一条受保护接口做回归验证;若误封接口,优先回滚对应 requestMatchers 规则,而不是整体关闭 Spring Security。
速查:先明确哪些路径公开、哪些路径需要认证、哪些角色可以访问,再用一条未认证、一条低权限和一条管理员请求验证授权边界。
校验访问令牌并将用户身份写入安全上下文。
配置 JWT 认证
当客户端携带 Authorization: Bearer <JWT> 访问接口时,使用 Spring Security OAuth2 Resource Server 完成令牌提取、签名与声明校验,再把认证结果交给授权规则。这样不需要手写 JWT 过滤器,也不会把“解析字符串”误当成“完成认证”。
前置条件
项目需要 Resource Server 依赖,授权服务器应签发可验证的 JWT,并提供可信的签名公钥或 JWK 元数据。Maven 项目可加入:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-oauth2-resource-server</artifactId>
</dependency>
该 Starter 提供 Bearer Token 认证与 JWT 解码校验所需组件;依赖版本继续由当前 Spring Boot 的依赖管理统一控制。
认证链路
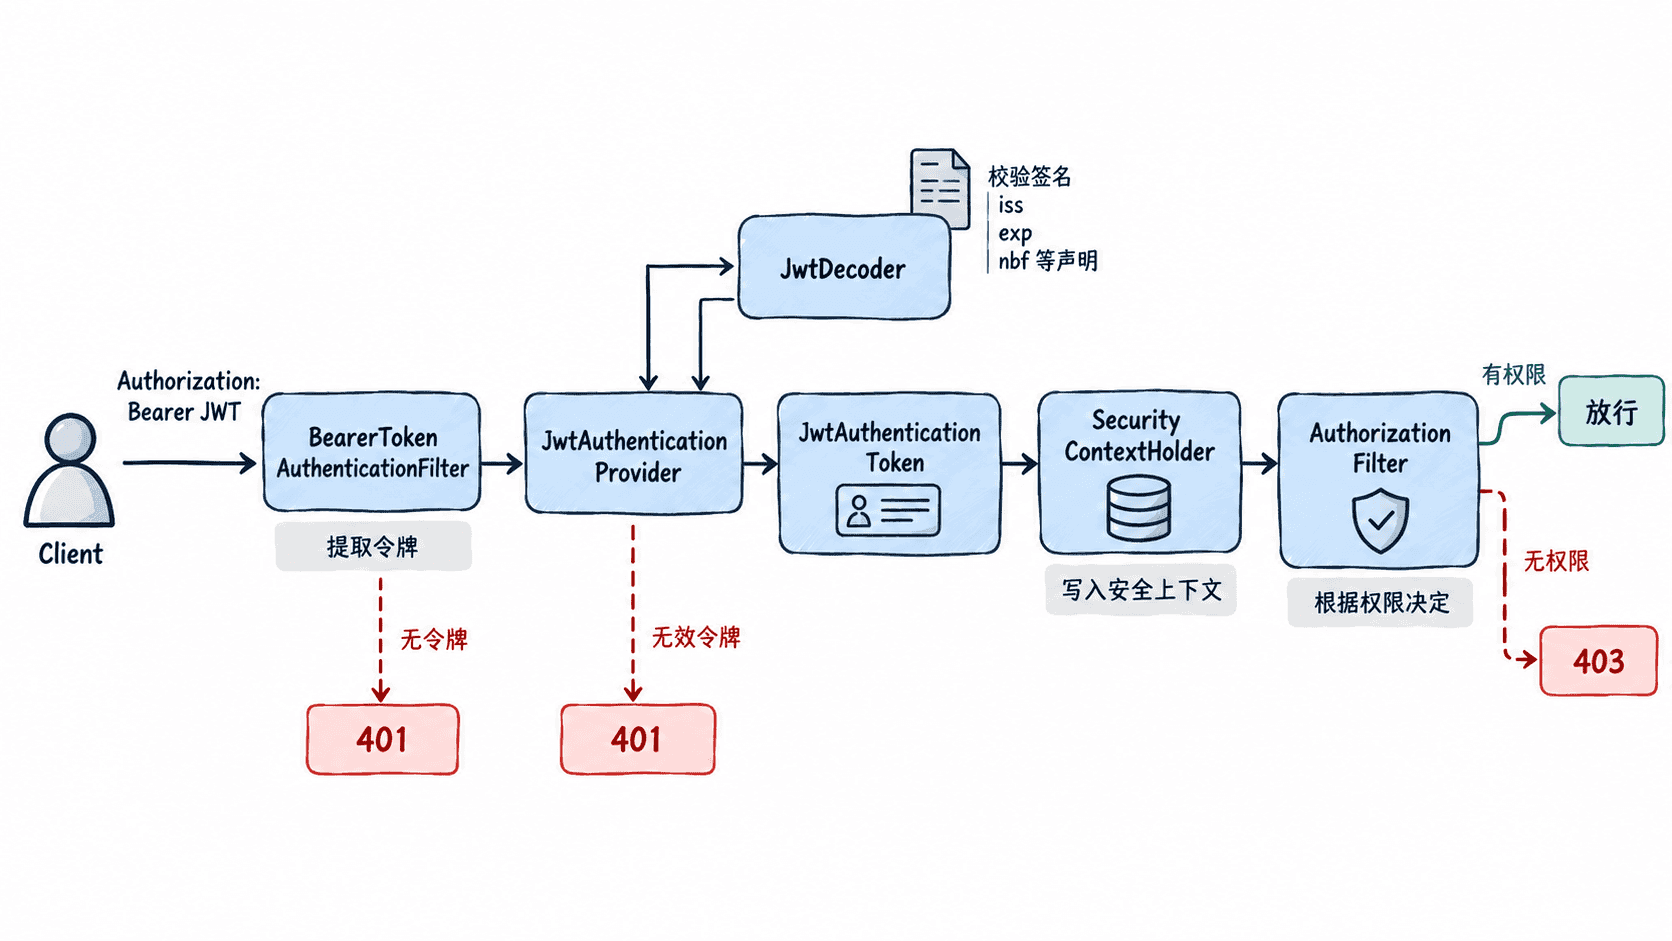
认证成功后,当前请求中的 Authentication 通常是 JwtAuthenticationToken,其 principal 是已校验的 Jwt。默认情况下,JWT 的 scope 会映射为带 SCOPE_ 前缀的权限,因此 orders.read 可用 hasAuthority("SCOPE_orders.read") 保护。
核心配置
先把发行者地址配置成 JWT iss 声明对应的可信地址:
spring:
  security:
    oauth2:
      resourceserver:
        jwt:
          issuer-uri: https://idp.example.com/issuer
再声明接口授权规则,并提供一个可读取当前 JWT 主体的验证接口:
package com.example.demo;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.config.Customizer;
import org.springframework.security.config.annotation.web.builders.HttpSecurity;
import org.springframework.security.core.annotation.AuthenticationPrincipal;
import org.springframework.security.oauth2.jwt.Jwt;
import org.springframework.security.web.SecurityFilterChain;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@Configuration
public class SecurityConfig {
    @Bean
    SecurityFilterChain securityFilterChain(HttpSecurity http) throws Exception {
        http
                .authorizeHttpRequests(auth -> auth
                        .requestMatchers("/api/public/**").permitAll()
                        .requestMatchers("/api/orders/**")
                        .hasAuthority("SCOPE_orders.read")
                        .anyRequest().authenticated())
                .oauth2ResourceServer(oauth2 ->
                        oauth2.jwt(Customizer.withDefaults()));
        return http.build();
    }
}

@RestController
class OrderController {
    @GetMapping("/api/orders/ping")
    String ping(@AuthenticationPrincipal Jwt jwt) {
        return "subject=" + jwt.getSubject() + ",status=ok";
    }
}
issuer-uri 让 Resource Server 只信任指定发行者,并根据其元数据获取密钥来校验 JWT。若令牌使用自定义权限声明,不要直接照搬 SCOPE_ 规则,应先配置 JwtAuthenticationConverter,明确声明到权限的映射。
验证认证与授权
准备一个有效且包含 orders.read scope 的 <JWT>,以及一个有效但不含该 scope 的 <JWT_WITHOUT_SCOPE>:
curl -i -H "Authorization: Bearer <JWT>" http://localhost:<PORT>/api/orders/ping
curl -i http://localhost:<PORT>/api/orders/ping
curl -i -H "Authorization: Bearer <JWT_WITHOUT_SCOPE>" http://localhost:<PORT>/api/orders/ping
预期结果:
1) 200 OK,响应体为 subject=<ID>,status=ok
2) 401 Unauthorized
3) 403 Forbidden<PORT>、<JWT> 和 <ID> 都以实际环境为准。若签名无效、令牌过期或 iss 不匹配,应按认证失败处理,而不是继续把其中的声明写入业务上下文。
风险与恢复
不要通过 Base64 解码后直接信任 JWT 内容,也不要把完整 Bearer Token 写入日志。密钥轮换、发行者迁移或权限声明变更时,应先在测试环境验证 401、403 和正常请求三条路径;出现大面积 401 时优先核对 issuer-uri、JWK 可达性、服务器时钟和令牌有效期,而不是绕过签名校验。
使用 PasswordEncoder 安全存储和校验用户密码。
配置密码加密
使用 PasswordEncoder 对注册密码做单向哈希,并在登录时用 matches 校验明文与数据库哈希。数据库只保存编码结果,业务代码不提供“解密密码”功能。
依赖与 Bean
只需要密码哈希能力、又不希望启用整套 Web 安全自动配置时,可单独引入 spring-security-crypto。
<dependency>
    <groupId>org.springframework.security</groupId>
    <artifactId>spring-security-crypto</artifactId>
</dependency>
在 Spring Boot 中暴露统一 Bean,避免注册、登录和改密各自创建不同编码器。
package com.example.password;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.crypto.factory.PasswordEncoderFactories;
import org.springframework.security.crypto.password.PasswordEncoder;

@Configuration
public class PasswordConfig {

    @Bean
    PasswordEncoder passwordEncoder() {
        return PasswordEncoderFactories.createDelegatingPasswordEncoder();
    }
}
该工厂默认返回带算法标识的 DelegatingPasswordEncoder,当前默认编码通常使用 bcrypt,并在结果前保留类似 {bcrypt} 的标识,便于兼容旧算法和后续升级。数据库字段建议使用 VARCHAR(255),保存完整字符串,不要删除前缀。
存储与校验
下面是可直接运行的核心示例。随机盐会让每次生成的哈希不同,因此只验证算法前缀和匹配结果,不比较两次编码后的字符串是否相同。
package com.example.password;

import org.springframework.security.crypto.factory.PasswordEncoderFactories;
import org.springframework.security.crypto.password.PasswordEncoder;

public final class PasswordEncoderDemo {

    private PasswordEncoderDemo() {
    }

    public static void main(String[] args) {
        PasswordEncoder encoder =
                PasswordEncoderFactories.createDelegatingPasswordEncoder();

        String rawPassword = "S3cure-Pass!";
        String storedPassword = encoder.encode(rawPassword);

        // 数据库保存 storedPassword;登录时只能用 matches 比对。
        String prefix = storedPassword.substring(
                0, storedPassword.indexOf('}') + 1);

        System.out.println("prefix=" + prefix);
        System.out.println("matches=" +
                encoder.matches(rawPassword, storedPassword));
    }
}
预期输出:完整哈希因随机盐而变化,但算法前缀和匹配结果稳定。
prefix={bcrypt}
matches=true
注册时调用 encode(rawPassword) 后入库;登录时调用 matches(inputPassword, storedPassword)。若 matches 成功且 upgradeEncoding(storedPassword) 返回 true,可在本次登录后重新编码并更新数据库,实现平滑升级。
风险与边界
用 encode(input).equals(stored) 比较会因随机盐导致正常密码也校验失败;安全替代是始终调用 matches。使用明文、NoOpPasswordEncoder、MD5 或普通 SHA 摘要时,数据库泄露后容易被高速撞库,应迁移到 bcrypt、PBKDF2、scrypt 或 Argon2 等自适应单向算法。
成本参数过低会降低抗破解能力,过高则可能在并发登录或恶意请求下耗尽 CPU。应在生产规格机器上压测验证耗时,并同时配置登录限流、失败次数控制和监控,而不是为了性能改回快速摘要。
原始密码、完整哈希和登录失败详情都不应写入日志。哈希虽然不能直接解密,仍可被离线猜测;安全替代是最小化访问权限、保护备份,并要求强密码或多因素认证。
排障清单
There is no PasswordEncoder mapped for the id "null":旧数据缺少{id}前缀;确认真实算法后补正确前缀或配置迁移编码器,禁止把非 bcrypt 数据直接标成{bcrypt}。- 正确密码始终返回
false:检查数据库字段是否截断、入库前是否被二次编码、输入是否额外包含空格或换行。 - 登录 CPU 飙高:检查 bcrypt 成本、突发并发和撞库流量;先限流并压测,再调整参数。
- 不同环境结果不一致:确认所有节点注入同一种
PasswordEncoder,并保存了包含算法前缀的完整值。
兼容性
PasswordEncoderFactories.createDelegatingPasswordEncoder() 适用于现代 Spring Security。迁移历史裸 bcrypt 哈希时,只有确认原值确实是 bcrypt 才能补 {bcrypt};其他格式应配置对应编码器,并在用户成功登录后逐步升级。