
Python / 知识点
Python 开发速查手册
手册条目
创建、解析、格式化和计算日期时间值。
Python 日期与时间速查
用于创建固定日期、解析字符串、格式化输出和计算时间间隔。优先使用 datetime、date 和 timedelta,业务代码不要用字符串直接做日期比较或加减。
基本语法
date 只表示年月日,datetime 表示日期和时间,timedelta 表示一段时长。解析固定格式文本用 datetime.strptime(),输出给程序交换时优先用 isoformat()。
from datetime import date, datetime, timedelta

def main() -> None:
    report_day = date(2026, 8, 5)
    started_at = datetime.strptime(
        "2026-08-05 17:30:00",
        "%Y-%m-%d %H:%M:%S",
    )

    # 日期和时间间隔可以直接相加;结果仍保持原来的类型。
    next_day = report_day + timedelta(days=1)
    expires_at = started_at + timedelta(hours=2, minutes=15)

    print(report_day.isoformat())
    print(started_at.strftime("%Y/%m/%d %H:%M"))
    print(next_day.isoformat())
    print(expires_at.isoformat(sep=" "))
    print((expires_at - started_at).total_seconds())

if __name__ == "__main__":
    main()
预期输出:
2026-08-05
2026/08/05 17:30
2026-08-06
2026-08-05 19:45:00
8100.0
最后一行是秒数;需要整数时可在确认不会丢失小数后使用 int()。
高频用法
- 读取 ISO 8601 文本:
datetime.fromisoformat("2026-08-05T17:30:00")。 - 获取当前本地时间:
datetime.now();只在明确接受“无时区时间”时使用。 - 计算截止时间:起始时间加
timedelta,不要手动处理跨月、闰年或月底。 - 比较先后:直接比较同类型的
date,或比较时区状态一致的datetime。
常用格式指令
| 指令 | 含义 | 示例 |
|---|---|---|
%Y |
四位年份 | 2026 |
%m |
两位月份 | 08 |
%d |
两位日期 | 05 |
%H:%M:%S |
24 小时时分秒 | 17:30:00 |
%z |
UTC 偏移 | +0800 |
解析失败会抛出 ValueError。外部输入应先确定唯一格式;同时接受多种格式时,按明确顺序逐个尝试并记录最终命中的格式。
风险与边界
当 datetime 没有 tzinfo 时,它是无时区时间。若把它当作 UTC 或本地时间跨系统传递,可能整体偏移数小时。安全做法是:纯日历日期使用 date;真实时间点使用带时区的 datetime,并在存储或接口中采用 ISO 8601。
timedelta.days 只返回整天部分,可能忽略不足一天的秒数。计算总秒数应使用 total_seconds();计算自然月或自然年不能用固定 30 天或 365 天替代,应按业务日历单独处理。
排障清单与兼容性
- 出现
ValueError: time data ... does not match format:逐字符核对分隔符、位数和格式指令。 - 比较时报
can't compare offset-naive and offset-aware datetimes:统一转换为带时区时间,不要删除tzinfo逃避错误。 - 结果差一天:检查是否把
datetime截断成date,或在跨时区转换前先取了日期。 datetime.fromisoformat()适合标准 ISO 8601 输入;非常规文本应使用明确的strptime()格式。
速查原则:日期用 date,时间点用带时区的 datetime,时长用 timedelta。
创建带时区的时间并在不同时区之间正确转换。
Python 时区处理速查
用于创建带时区的时间点,并在 UTC、业务所在地和用户所在地之间转换。Python 3.9 及以上优先使用标准库 zoneinfo,时区名称使用 America/Los_Angeles 这类 IANA 标识,不要写死 UTC-8。
创建与转换
先给“发生地时间”绑定对应时区,再用 astimezone() 转换。astimezone() 会保留同一真实时间点,并自动应用目标地区当日的夏令时规则。
from datetime import datetime
from zoneinfo import ZoneInfo

def main() -> None:
    los_angeles = ZoneInfo("America/Los_Angeles")
    shanghai = ZoneInfo("Asia/Shanghai")
    utc = ZoneInfo("UTC")

    meeting_la = datetime(2026, 1, 15, 9, 0, tzinfo=los_angeles)

    # 转换不会改变事件本身,只改变显示所用的时区和钟面时间。
    meeting_utc = meeting_la.astimezone(utc)
    meeting_shanghai = meeting_la.astimezone(shanghai)

    print(meeting_la.isoformat())
    print(meeting_utc.isoformat())
    print(meeting_shanghai.isoformat())
    print(meeting_la.strftime("%z"))

if __name__ == "__main__":
    main()
预期输出:
2026-01-15T09:00:00-08:00
2026-01-15T17:00:00+00:00
2026-01-16T01:00:00+08:00
-0800
第三行已跨到上海时间的次日。实际偏移会随日期和地区规则变化,不应把示例中的 -08:00 当作全年固定值。
高频用法
- 获取当前 UTC 时间:
datetime.now(ZoneInfo("UTC"))。 - 获取指定地区当前时间:
datetime.now(ZoneInfo("Asia/Shanghai"))。 - 存储或跨服务传输:先转 UTC,再保存带偏移的 ISO 8601 字符串。
- 展示给用户:从 UTC 时间调用
astimezone(用户时区),不要手动加减小时数。
夏令时与本地输入
夏令时切换可能产生“重复时间”和“不存在时间”。例如时钟回拨时,同一个本地钟面时间可能对应两个真实时刻,fold=0 与 fold=1 用于区分;时钟前拨时,部分本地时间根本不存在。
外部输入只有本地日期和时间时,必须同时取得时区名称,并由业务规则决定歧义时间选前一次还是后一次。更安全的链路是保存 UTC 时间点,展示时再转换;不要通过 replace(tzinfo=...) 把已代表某个时间点的无时区值强行改成另一时区。
风险与边界
触发条件:混用无时区和带时区 datetime。可能后果:比较直接报错,或在序列化、数据库写入时被错误解释。安全替代:入口处立即补齐明确时区,内部统一使用带时区值。
触发条件:使用固定偏移代替地区时区。可能后果:夏令时期间偏差一小时,历史规则变化也无法反映。安全替代:使用 IANA 名称和 ZoneInfo;固定偏移只适合协议明确要求恒定偏移的场景。
排障与兼容性
- 报
ZoneInfoNotFoundError:系统缺少 IANA 时区数据库。可安装tzdata,并重新启动运行进程。 - Windows 或精简容器中找不到时区:在项目依赖中加入
tzdata,不要依赖宿主机必然提供数据库。 - 转换后日期异常:确认原值绑定的是“发生地时区”,并检查是否先错误调用了
replace(tzinfo=...)。 - Python 3.8 及更早版本没有标准库
zoneinfo;升级 Python,或使用兼容回移包backports.zoneinfo。
速查原则:地区规则用 ZoneInfo,系统间交换用 UTC,面向用户展示时再转换。
从运行环境加载配置并为缺失变量设置默认值。
读取环境变量
用于让同一份 Python 程序从进程环境中读取端口、运行模式和密钥等配置。可选配置设置明确默认值,必填配置在启动阶段立即校验,避免程序进入业务流程后才暴露配置缺失。
基本语法
标准库 os 直接读取当前 Python 进程继承到的环境变量。os.getenv("NAME", "default") 和 os.environ.get("NAME", "default") 适合可选项;os.environ["NAME"] 在变量不存在时抛出 KeyError,适合确实要立即失败的场景。
环境变量的值始终是字符串。端口、超时、布尔开关等配置必须显式转换并校验范围,不能仅依赖 int() 或字符串真假判断。
高频用法
下面的脚本同时演示默认值、必填项、类型转换和安全输出。保存为 env_demo.py:
import os
from dataclasses import dataclass

@dataclass(frozen=True)
class Settings:
    environment: str
    port: int
    api_token: str

def read_settings() -> Settings:
    environment = os.getenv("APP_ENV", "development")
    raw_port = os.getenv("APP_PORT", "8000")
    api_token = os.getenv("API_TOKEN")

    # 必填配置在启动时失败,避免带着不完整配置继续运行。
    if not api_token:
        raise RuntimeError("缺少必填环境变量 API_TOKEN")

    try:
        port = int(raw_port)
    except ValueError as exc:
        raise RuntimeError(
            f"APP_PORT 必须是整数,实际值:{raw_port!r}"
        ) from exc

    if not 1 <= port <= 65535:
        raise RuntimeError("APP_PORT 必须在 1 到 65535 之间")

    return Settings(environment, port, api_token)

def main() -> None:
    settings = read_settings()
    print(f"environment={settings.environment}")
    print(f"port={settings.port}")
    # 只确认密钥已加载,不把密钥内容写入日志。
    print(f"api_token_loaded={bool(settings.api_token)}")

if __name__ == "__main__":
    main()
在 Bash、Zsh 或兼容 Shell 中为本次进程临时注入配置并运行:
API_TOKEN='demo-token-123' APP_ENV='production' APP_PORT='9000' python env_demo.py预期输出:
environment=production
port=9000
api_token_loaded=True
第一、二行是实际生效的运行模式和端口;第三行只表示密钥存在,不泄露密钥值。省略 APP_ENV 或 APP_PORT 时,脚本分别使用 development 和 8000。
风险与边界
- 必填变量缺失却继续启动时,认证、数据库连接或外部调用可能在运行中失败。安全做法是在配置加载阶段统一校验并立即终止。
- 把字符串直接当布尔值时,
bool("false")仍为True。应显式接受固定值,例如只允许true、false、1、0。 - 将密钥打印到日志、异常信息或诊断页面时,日志平台和运维人员可能获得明文凭据。应只记录是否加载,并优先使用云密钥管理服务或受权限保护的挂载文件。
- Python 标准库不会自动读取
.env文件。开发环境需要.env时可使用专用加载库,但生产环境应由容器、服务管理器或部署平台注入真实变量。
排障清单
- 确认变量设置在启动 Python 的同一终端、容器或服务单元中;父进程后设置的变量不会自动进入已运行的子进程。
- Linux 和 macOS 中,单独执行
NAME=value只设置 Shell 变量;供后续子进程使用时需要export NAME=value,或像主示例那样写成NAME=value command。 - 检查变量名大小写、前后空格和换行。环境变量名区分大小写的平台上,
APP_PORT与app_port不是同一项。 - 容器、CI 和 systemd 等环境通常有各自的注入位置;交互式终端中可见,不代表服务进程中也可见。
- 若转换失败,先记录非敏感变量的
repr()结果,排查空字符串、引号残留或不可见字符。
兼容性
os.getenv 和 os.environ 属于 Python 标准库,主流 Python 3 版本均可用。Shell 的变量设置语法不同:PowerShell 使用 $env:NAME = "value",Windows CMD 使用 set NAME=value;变量读取的 Python 代码无需修改。
为脚本定义选项、位置参数、默认值和帮助信息。
解析命令行参数
使用标准库 argparse 为脚本定义位置参数、可选项、默认值、类型校验和帮助信息。解析完成后得到结构化参数对象,非法输入会返回清晰错误并以非零状态退出。
基本语法
典型流程是创建 ArgumentParser、多次调用 add_argument(),最后执行 parse_args()。位置参数按出现顺序读取;以 - 或 -- 开头的是可选参数;-h 和 --help 默认自动生成。
常用设置如下:
| 设置 | 用途 |
|---|---|
type= |
将字符串转换为 int、Path 或自定义类型 |
default= |
参数未提供时使用默认值 |
choices= |
把输入限制在固定候选集合内 |
action="store_true" |
提供开关时设为 True,未提供时为 False |
required=True |
强制要求某个可选参数 |
metavar= |
控制帮助信息中的参数占位名称 |
高频用法
下面的脚本定义一个输入文件、输出格式、处理条数和详细日志开关。保存为 cli_demo.py:
import argparse
from pathlib import Path
from typing import Optional, Sequence

def positive_int(value: str) -> int:
    try:
        number = int(value)
    except ValueError as exc:
        raise argparse.ArgumentTypeError("必须是整数") from exc

    if number <= 0:
        raise argparse.ArgumentTypeError("必须大于 0")
    return number

def build_parser() -> argparse.ArgumentParser:
    parser = argparse.ArgumentParser(
        description="读取输入文件并按指定格式处理",
        allow_abbrev=False,
    )
    parser.add_argument("input", type=Path, help="待处理文件路径")
    parser.add_argument(
        "-f",
        "--format",
        choices=("json", "csv"),
        default="json",
        help="输出格式,默认 json",
    )
    parser.add_argument(
        "-l",
        "--limit",
        type=positive_int,
        default=10,
        metavar="N",
        help="最多处理 N 条记录,默认 10",
    )
    parser.add_argument(
        "-v",
        "--verbose",
        action="store_true",
        help="输出详细日志",
    )
    return parser

def main(argv: Optional[Sequence[str]] = None) -> int:
    args = build_parser().parse_args(argv)

    # 业务代码直接读取已经完成类型转换和校验的字段。
    print(f"input={args.input}")
    print(f"format={args.format}")
    print(f"limit={args.limit}")
    print(f"verbose={args.verbose}")
    return 0

if __name__ == "__main__":
    raise SystemExit(main())
运行脚本:
python cli_demo.py data.txt --format csv --limit 25 --verbose预期输出:
input=data.txt
format=csv
limit=25
verbose=True读取时,args.input 已是 Path 对象,args.limit 已是正整数,args.verbose 是布尔值。未提供 --format、--limit 或 --verbose 时,分别得到 json、10 和 False。
查看自动生成的帮助信息:
python cli_demo.py --help预期输出如下;具体换行位置可能随终端宽度变化:
usage: cli_demo.py [-h] [-f {json,csv}] [-l N] [-v] input

读取输入文件并按指定格式处理

positional arguments:
  input                 待处理文件路径

options:
  -h, --help            show this help message and exit
  -f, --format {json,csv}
                        输出格式,默认 json
  -l, --limit N         最多处理 N 条记录,默认 10
  -v, --verbose         输出详细日志
风险与边界
- 使用
type=bool时,任何非空字符串都可能被转成True,例如"false"也不代表关闭。布尔开关应使用action="store_true"、store_false或显式值解析函数。 parse_args()遇到未知参数或格式错误会打印错误并触发SystemExit,命令行程序通常应保留该行为。库函数和测试中应把argv显式传入main(argv),避免直接修改全局sys.argv。type=Path只负责构造路径对象,不会验证文件存在或权限可用。需要读取文件时,应在业务执行前检查is_file()并给出明确错误。parse_known_args()会放过未知参数。只有脚本需要把剩余参数转交给其他程序时才使用,否则拼写错误可能被静默忽略。
排障清单
- 出现
unrecognized arguments时,检查选项拼写、短选项是否冲突,以及参数是否被外层启动器提前消费。 - 位置参数缺失时,确认调用顺序与
add_argument()定义一致;带空格的路径必须由 Shell 正确引用。 - 参数值以负号开头时,可能被识别成新选项。必要时在位置参数前使用
--结束选项解析。 - 自定义类型校验应抛出
argparse.ArgumentTypeError,这样错误会进入统一帮助输出;直接抛普通异常会产生不友好的回溯。 - 单元测试可调用
main(["data.txt", "--limit", "5"]),验证返回码和输出,不依赖真实命令行环境。
兼容性
argparse 是 Python 3 标准库。示例使用的 typing.Optional 和 typing.Sequence 可兼容较早的 Python 3 版本;若使用 argparse.BooleanOptionalAction 自动生成 --feature 和 --no-feature,则需要 Python 3.9 或更高版本。
启动系统命令并安全获取退出码、标准输出和错误输出。
安全执行外部命令
需要从 Python 启动系统程序,并同时取得退出码、标准输出和错误输出时,使用 subprocess.run()。参数按列表传入,默认不经过 Shell,适合服务调用工具、构建脚本和运维探测。
基本语法
核心调用形式是 subprocess.run(args, capture_output=True, text=True, timeout=10, check=False)。其中 args 使用 ["程序", "参数1", "参数2"];capture_output 同时捕获标准输出和错误输出;text 返回字符串;timeout 限制运行时长;check 控制非零退出码是否抛出异常。
主示例
下面使用当前 Python 解释器启动子进程,因此 Windows、macOS 和 Linux 都可直接运行。
import subprocess
import sys

def main() -> None:
    command = [
        sys.executable,
        "-S",  # 禁用 site 初始化,避免环境启动钩子污染示例输出
        "-c",
        (
            "import sys; "
            "print('job started'); "
            "print('simulated failure', file=sys.stderr); "
            "sys.exit(3)"
        ),
    ]

    result = subprocess.run(
        command,
        capture_output=True,
        text=True,
        timeout=5,
        check=False,  # 先保留退出码和错误输出,再由调用方决定是否失败
    )

    print(f"returncode: {result.returncode}")
    print(f"stdout: {result.stdout.strip()}")
    print(f"stderr: {result.stderr.strip()}")

if __name__ == "__main__":
    main()
预期输出:
returncode: 3
stdout: job started
stderr: simulated failure
先看 returncode:0 通常表示成功,非零值由目标程序定义;业务结果从 stdout 读取,诊断信息从 stderr 读取。不要只根据输出是否为空判断成功。
高频用法
需要“失败即异常”时设置 check=True,并捕获 subprocess.CalledProcessError;异常对象仍包含 returncode、stdout 和 stderr。需要防止命令卡死时设置 timeout,捕获 subprocess.TimeoutExpired 后记录命令和超时时间。
输出很大或需要实时处理时,不要用 capture_output=True 一次性读入内存,应改用 subprocess.Popen() 逐行消费,或把 stdout、stderr 重定向到文件。只需继承当前终端输出时,可省略捕获参数。
风险与边界
当命令字符串包含外部输入且启用 shell=True 时,分号、管道符和重定向符可能被解释为额外命令,导致命令注入或误删文件。安全替代方案是保持 shell=False,把程序名和参数拆成列表,并对可执行程序使用固定路径或白名单。
持续产生大量输出时,完整捕获可能耗尽内存;等待交互输入的程序也可能一直阻塞。安全替代方案是设置 timeout、明确传入 input,或使用 Popen 流式读取。密码和令牌不得作为完整命令参数写入日志。
排障清单
FileNotFoundError:确认程序已安装,并用shutil.which()检查 PATH;必要时传绝对路径。- 退出码非零:同时查看
stderr,再按目标程序文档解释退出码。 - 中文乱码:目标编码已知时设置
encoding="utf-8",否则按程序实际编码调整。 - 工作目录错误:通过
cwd指定目录,并记录解析后的绝对路径。 - 环境变量缺失:复制
os.environ后只覆盖必要键,再通过env传入。
兼容性
subprocess.run() 适用于 Python 3.5 及以上;capture_output 和 text 参数适用于 Python 3.7 及以上。Windows 与 POSIX 的 Shell 语法不同,跨平台脚本应避免依赖 shell=True、管道和通配符展开。
设置日志级别、格式、输出目标和异常堆栈记录。
配置应用日志
需要统一设置日志级别、格式、控制台输出、文件轮转和异常堆栈时,使用标准库 logging。应用入口负责一次性配置,业务模块只通过 logging.getLogger(__name__) 获取记录器。
主示例
下面将 INFO 及以上日志同时写入控制台和 app.log。文件达到 1 MiB 后轮转,最多保留 3 个备份;logger.exception() 会自动附加当前异常堆栈。
import logging
import sys
from logging.handlers import RotatingFileHandler
from pathlib import Path

def configure_logging() -> logging.Logger:
    formatter = logging.Formatter(
        "%(asctime)s %(levelname)s %(name)s - %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S",
    )

    console = logging.StreamHandler(sys.stdout)
    console.setLevel(logging.INFO)
    console.setFormatter(formatter)

    rotating_file = RotatingFileHandler(
        Path("app.log"),
        maxBytes=1024 * 1024,
        backupCount=3,
        encoding="utf-8",
    )
    rotating_file.setLevel(logging.INFO)
    rotating_file.setFormatter(formatter)

    logger = logging.getLogger("app")
    logger.setLevel(logging.INFO)
    # 重复初始化时先移除并关闭旧处理器,避免重复输出和文件句柄泄漏
    for handler in logger.handlers[:]:
        logger.removeHandler(handler)
        handler.close()
    logger.propagate = False
    logger.addHandler(console)
    logger.addHandler(rotating_file)
    return logger

def main() -> None:
    logger = configure_logging()
    logger.info("service started")

    try:
        1 / 0
    except ZeroDivisionError:
        logger.exception("division failed")

    print("log file: app.log")

if __name__ == "__main__":
    main()
预期输出:
<TIME> INFO app - service started
<TIME> ERROR app - division failed
Traceback (most recent call last):
  File "<PATH>/logging_demo.py", line <LINE>, in main
    1 / 0
ZeroDivisionError: division by zero
log file: app.log<TIME>、<PATH> 和 <LINE> 会随运行环境变化。控制台与 app.log 都应出现两条日志及异常堆栈;轮转后会生成 app.log.1、app.log.2 等备份文件。
关键配置
| 配置点 | 作用 | 常用选择 |
|---|---|---|
| Logger 级别 | 进入处理链的最低级别 | 开发用 DEBUG,生产通常用 INFO |
| Handler 级别 | 单个输出目标的最低级别 | 控制台 INFO,告警文件可设 ERROR |
| Formatter | 定义时间、级别、记录器和消息格式 | 至少保留时间、级别、记录器和消息 |
propagate |
是否继续传给父记录器 | 独立配置处理器时设为 False |
| 文件轮转 | 限制文件体积和备份数量 | RotatingFileHandler 或按时间轮转 |
最终生效门槛同时受 Logger 和 Handler 级别限制。日志未出现时,两处都要检查。
高频用法
业务代码使用参数化日志,例如 logger.info("user=%s logged in", user_id),避免在日志被过滤时仍执行字符串拼接。捕获异常时在 except 块内使用 logger.exception("operation failed");普通错误且没有活动异常时使用 logger.error(),否则可能出现无意义的 NoneType: None。
第三方库日志过多时,单独提高其级别,例如 logging.getLogger("urllib3").setLevel(logging.WARNING)。容器化应用通常优先写标准输出,由日志代理统一采集,而不是在容器内长期保存文件。
风险与边界
入口和业务模块都添加 Handler,或记录器继续向根记录器传播时,同一事件会重复输出,造成告警放大和日志成本上升。安全替代方案是只在入口配置 Handler,模块只获取 Logger;自管 Handler 的记录器设置 propagate=False。
日志包含密码、令牌、身份证号或完整请求体时,敏感数据可能进入备份并长期留存。安全替代方案是使用字段白名单、脱敏值和请求 ID,不记录凭据;文件轮转只限制体积,不能替代保留周期和访问权限管理。
多进程同时写同一个轮转文件时,标准 RotatingFileHandler 可能发生竞争、丢行或轮转冲突。安全替代方案是各进程写标准流,由进程管理器或日志代理集中收集。
排障清单
- 完全没有日志:确认入口已调用配置函数,并检查 Logger 与 Handler 的级别。
- 日志重复:检查是否重复初始化、是否同时配置根记录器,以及
propagate是否为True。 - 文件未生成:检查当前工作目录、目录写权限和容器只读文件系统。
- 异常没有堆栈:确认调用发生在
except块内,并使用logger.exception()或exc_info=True。 - 日志文件过大:确认轮转 Handler 已实际挂载,并检查
maxBytes、backupCount。
速查原则:入口统一配置、模块按名称取 Logger、异常保留堆栈、敏感字段先脱敏、生产日志必须轮转或交给采集系统。
调用 HTTP 接口并处理参数、请求头、超时和响应数据。
发送 HTTP 请求
用于调用 HTTP 接口,并稳定处理查询参数、请求头、超时、状态码和 JSON 响应。生产代码的最低要求是显式设置超时、检查非 2xx 状态,并区分网络异常与响应解析异常。
基本语法
requests 会把 params 编码到 URL 查询串,把 headers 写入请求头。timeout=(连接超时, 读取超时) 分别限制建立连接和等待响应数据的时间;它不是整个请求的总时限。
常用响应入口如下:status_code 读取状态码,headers 读取响应头,text 按推断编码解码文本,content 返回原始字节,json() 解析 JSON。调用 raise_for_status() 后,4xx 和 5xx 会抛出 HTTPError。
可运行示例
下面先启动一个本地 HTTP 服务,再向它发送 GET 请求,因此不依赖外部网站;运行前需安装第三方包 requests。
import json
import threading
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from urllib.parse import parse_qs, urlparse

import requests

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        parsed = urlparse(self.path)
        payload = {
            "path": parsed.path,
            "query": parse_qs(parsed.query),
            "client": self.headers.get("X-Client"),
        }
        body = json.dumps(payload, ensure_ascii=False).encode("utf-8")

        self.send_response(200)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, format, *args):
        pass  # 关闭示例服务器的访问日志,保持输出稳定

server = ThreadingHTTPServer(("127.0.0.1", 0), Handler)
thread = threading.Thread(target=server.serve_forever, daemon=True)
thread.start()

url = f"http://127.0.0.1:{server.server_port}/api/items"
try:
    response = requests.get(
        url,
        params={"page": 2, "tag": ["python", "http"]},
        headers={"X-Client": "anystack"},
        timeout=(1, 3),  # 分别限制连接阶段和读取阶段
    )
    response.raise_for_status()
    data = response.json()

    print("status:", response.status_code)
    print("path:", data["path"])
    print("page:", data["query"]["page"])
    print("tag:", data["query"]["tag"])
    print("client:", data["client"])
finally:
    server.shutdown()
    server.server_close()
预期输出:
status: 200
path: /api/items
page: ['2']
tag: ['python', 'http']
client: anystack
params 中的列表会被编码为重复查询参数;服务端解析后得到两个 tag 值。实际调用远程接口时,URL、响应字段和状态码以接口契约为准。
高频用法
- 查询资源:使用
requests.get(url, params=..., headers=..., timeout=...),适合分页、筛选和搜索接口。 - 提交 JSON:使用
requests.post(url, json=payload, timeout=...);json=会序列化对象并设置 JSON 内容类型。 - 携带认证:优先把令牌放入
Authorization请求头,不要拼进 URL,以免被代理日志、浏览器历史或监控系统记录。 - 下载大文件:使用
stream=True并按块读取,避免一次把整个响应载入内存;同时限制最大文件大小和落盘路径。
风险与边界
未设置超时时,连接异常或服务端迟迟不返回可能长期占用线程;安全替代是每次请求都设置连接和读取超时。关闭 TLS 校验 verify=False 会使中间人攻击更容易成功;应修复证书链或显式提供可信 CA,而不是永久关闭校验。
raise_for_status() 只检查 HTTP 状态,不保证业务成功;还需按接口契约检查响应字段。自动重试仅适合幂等请求,并应限制次数、增加退避和抖动;对创建订单、扣款等非幂等请求盲目重试,可能产生重复操作。
排障清单
- 连接超时:检查 DNS、目标端口、防火墙、代理和服务是否监听。
- 读取超时:确认服务端处理耗时、响应体大小以及读取超时是否过短。
- 401 或 403:核对令牌、签名、权限范围和服务器时间偏差。
- 429 或 5xx:读取
Retry-After或错误码,按接口策略限速重试。 - JSON 解析失败:先检查状态码、
Content-Type和响应前几百字节,避免把 HTML 错误页当 JSON 解析。
兼容性
requests 不是 Python 标准库,部署环境必须显式声明并锁定依赖版本。无法引入第三方包时可改用 urllib.request,但参数编码、异常类型和会话复用方式不同,不能直接替换调用代码。
使用线程池并发处理网络请求和其他 I/O 密集任务。
并发执行线程任务
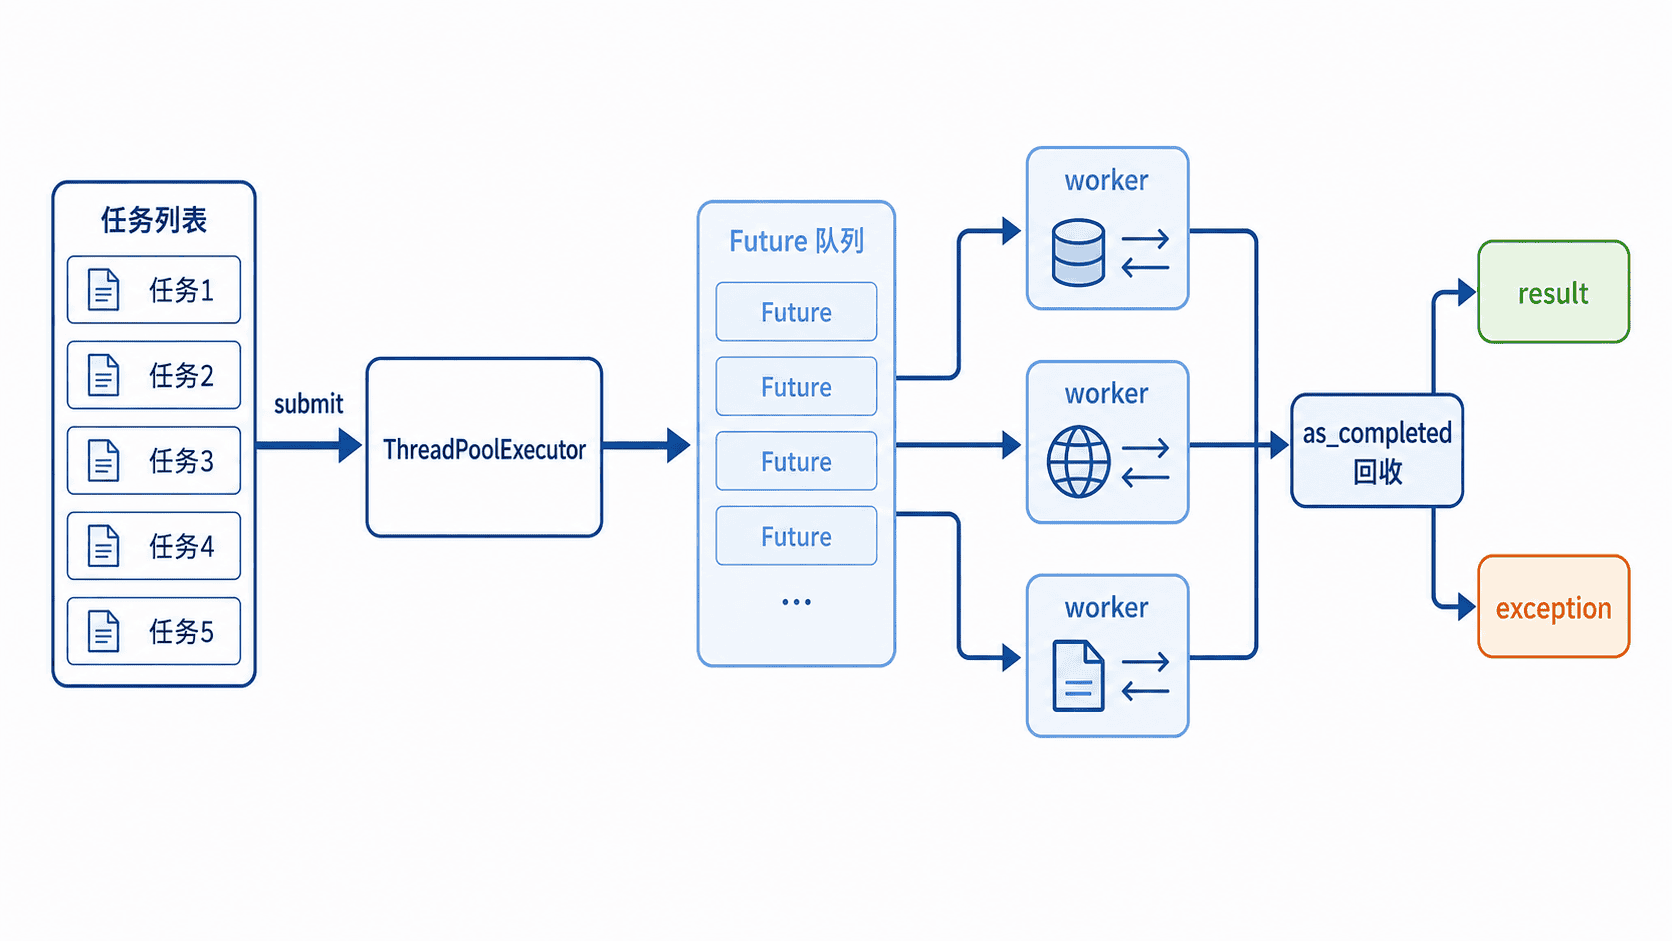
用于并发处理网络请求、文件读写、数据库等待等 I/O 密集任务。线程池负责复用线程,Future 负责表示单个任务的完成、返回值或异常;不要把它当作 CPU 密集计算的通用加速方案。
执行模型
主线程把任务提交给 ThreadPoolExecutor,每次提交返回一个 Future。工作线程从队列取任务执行;主线程可用 as_completed() 按完成顺序回收结果,并对每个任务单独处理异常。
基本语法
max_workers 控制同时运行的线程数;上下文管理器会在退出时调用 shutdown(wait=True),等待已提交任务结束并回收线程。submit() 适合逐任务控制,map() 适合同一函数批量处理输入且按输入顺序读取结果。
可运行示例
示例用 sleep() 模拟阻塞 I/O,并故意让一个任务失败。真实网络任务应在工作函数内部设置请求超时,避免某个线程永久占用工作槽。
from concurrent.futures import ThreadPoolExecutor, as_completed
from time import sleep

def io_task(task_id: int) -> str:
    sleep(0.05 * (5 - task_id))  # 模拟不同响应时间的远程 I/O
    if task_id == 3:
        raise RuntimeError("remote returned 503")
    return f"task-{task_id}: ok"

task_ids = [1, 2, 3, 4]
results = []

with ThreadPoolExecutor(max_workers=3, thread_name_prefix="io") as pool:
    future_to_id = {
        pool.submit(io_task, task_id): task_id
        for task_id in task_ids
    }

    for future in as_completed(future_to_id):
        task_id = future_to_id[future]
        try:
            results.append((task_id, future.result()))
        except Exception as exc:
            # 必须读取 Future 的结果,否则任务异常可能被悄悄忽略
            results.append((task_id, f"task-{task_id}: ERROR {exc}"))

for _, message in sorted(results):
    print(message)
预期输出:
task-1: ok
task-2: ok
task-3: ERROR remote returned 503
task-4: ok
任务实际完成顺序由调度和 I/O 延迟决定;示例最后按任务编号排序,因此输出稳定。删除 sorted() 后即可观察 as_completed() 返回的完成顺序。
高频用法
- 同一函数批量处理:使用
executor.map(func, items),结果按输入顺序产出;某个任务抛出的异常会在迭代到对应结果时重新抛出。 - 逐任务收集:使用
submit()配合as_completed(),适合记录进度、独立重试、区分成功与失败。 - 限制并发:根据下游接口限额、连接池大小、文件描述符和内存设置
max_workers,不是数值越大越快。 - 大批量任务:分批提交或使用有界队列,避免一次创建大量
Future导致内存增长和下游瞬时过载。
风险与边界
线程适合等待型任务。纯 Python CPU 密集计算受 GIL 限制,线程增加后通常不会线性加速;安全替代是 ProcessPoolExecutor、原生扩展或向量化计算。多个线程同时修改共享对象会产生竞态;优先让任务返回独立结果,必须共享时使用锁或线程安全队列。
工作线程内部等待同一线程池中的其他 Future,且池中没有空闲线程时可能死锁;应避免嵌套等待,或拆分执行阶段。忽略 Future.result() 会漏掉任务异常;至少要集中读取结果并记录任务标识、异常类型和重试次数。
排障清单
- 没有提速:确认瓶颈确实是 I/O 等待,而不是 CPU、锁竞争或下游限流。
- 任务卡住:检查网络超时、文件锁、数据库连接池和线程间循环等待。
- 内存持续增长:检查是否一次提交过多任务,以及结果是否被长期保存。
- 下游出现 429 或连接拒绝:降低
max_workers,增加速率限制和指数退避。 - 程序无法退出:确认线程池已关闭,并排查工作函数中的无限循环或无超时阻塞。
兼容性
concurrent.futures 属于 Python 标准库。在线程池中调用的对象不要求可序列化;若切换到进程池,函数和参数通常必须可序列化,并需要在可执行脚本中正确保护程序入口。
使用进程池并行处理可拆分的 CPU 密集任务。
并发执行进程任务
当工作主要消耗 CPU、每个任务彼此独立且能序列化时,用 concurrent.futures.ProcessPoolExecutor 把计算分发到多个 Python 进程。它可以绕开单个 CPython 进程的 GIL 限制;网络请求、文件等待等 I/O 密集任务通常应改用线程池或 asyncio。
命令定位
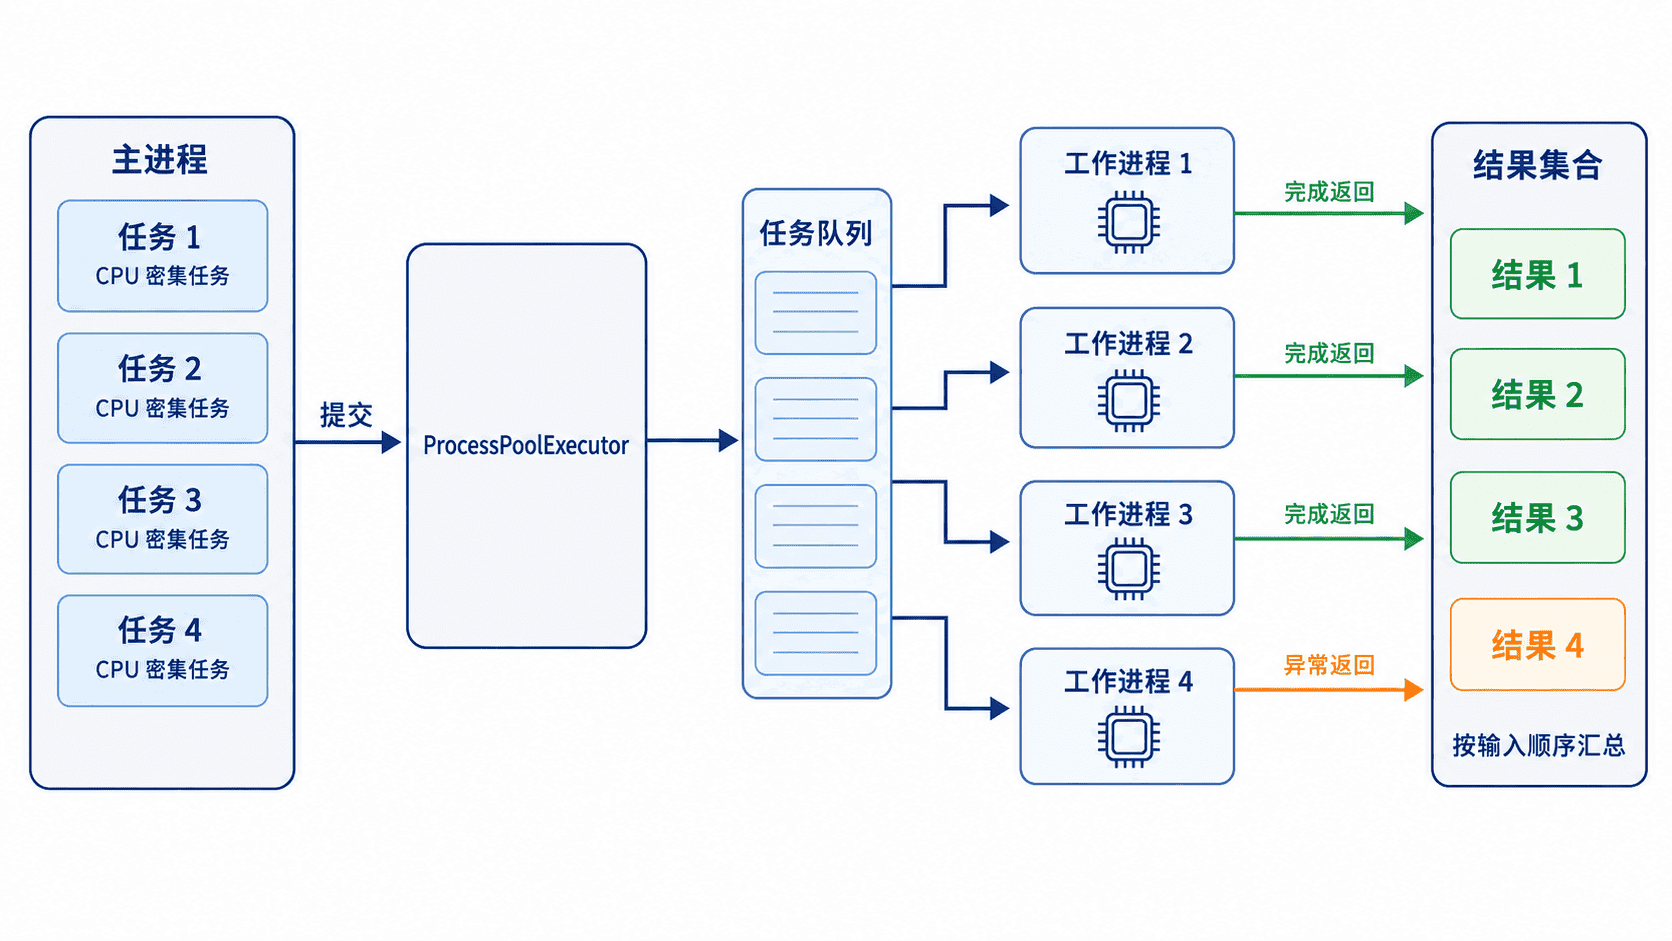
进程池适合图片转码、压缩、批量计算、解析大文件分片等可拆分任务。主进程负责提交和汇总,工作进程各自拥有解释器与内存空间,因此不会共享普通全局变量。
基本语法
下面的脚本把四段求平方和计算交给进程池。任务函数放在模块顶层,并使用 if __name__ == "__main__" 保护入口,兼容 Windows 和采用 spawn 启动方式的平台。
from concurrent.futures import ProcessPoolExecutor
import os

def sum_squares(limit: int) -> int:
    # 工作进程只接收可序列化参数,并返回可序列化结果。
    return sum(number * number for number in range(limit))

def main() -> None:
    limits = [10_000, 20_000, 30_000, 40_000]
    workers = min(4, os.cpu_count() or 1)

    with ProcessPoolExecutor(max_workers=workers) as pool:
        # map 按输入顺序返回结果;chunksize 控制批量分发粒度。
        results = list(pool.map(sum_squares, limits, chunksize=1))

    for limit, total in zip(limits, results):
        print(f"{limit}: {total}")

if __name__ == "__main__":
    main()
保存为 process_pool_demo.py 后运行:
python process_pool_demo.py预期输出:
10000: 333283335000
20000: 2666466670000
30000: 8999550005000
40000: 21332533340000
map 保证结果与 limits 顺序一致,不代表任务按该顺序完成。需要优先处理先完成的任务时,使用 submit 配合 as_completed。
常用参数
| 参数或方法 | 作用 | 速查 |
|---|---|---|
max_workers |
工作进程数 | 通常从 CPU 核数附近开始压测,过大可能增加切换和内存占用 |
map(..., chunksize=N) |
每次向工作进程分发的任务批量 | 大量短任务可增大 N,单个任务耗时差异大时保持较小 |
submit |
单独提交并获得 Future |
适合逐任务取消、超时或记录上下文 |
as_completed |
按完成顺序迭代 Future |
适合尽快消费结果和定位单个失败任务 |
高频用法
- 批量同构任务:用
map,代码最短且结果顺序稳定。 - 任务耗时不均:用
submit与as_completed,先处理已完成结果。 - 需要失败隔离:逐个调用
future.result()捕获异常,并记录对应输入。 - 大量小任务:先在主进程合并成较大的分片,减少序列化和进程间通信开销。
风险与边界
- 触发条件:向进程池传入 lambda、局部函数、打开的文件句柄或不可 pickle 对象。可能后果:提交时或取结果时抛出序列化异常。安全替代:把函数移到模块顶层,只传递基础数据、路径或轻量数据结构。
- 触发条件:任务参数或返回值很大。可能后果:序列化复制抵消并行收益,并造成内存峰值。安全替代:传文件路径、共享内存标识或分片索引,先基准测试单进程与多进程。
- 触发条件:在 Web 请求处理器内为每次请求新建进程池。可能后果:频繁拉起进程、资源耗尽和延迟抖动。安全替代:复用长生命周期池,或将重计算交给独立任务队列。
- 触发条件:工作函数再次创建同一类进程池。可能后果:进程爆炸、死锁或调度失控。安全替代:只由主进程管理进程池,工作函数保持纯计算。
排障清单
- 脚本无输出或递归启动:确认入口保护存在,尤其是 Windows。
- 报
Can't pickle:检查函数是否位于模块顶层,参数和返回值是否可序列化。 - 并行反而更慢:比较单任务耗时与序列化成本,合并短任务并调整
chunksize。 - 进程突然退出:捕获
future.result()异常,检查内存压力、原生扩展崩溃和被系统终止记录。 - CPU 未跑满:确认任务确实是 CPU 密集型,避免在工作进程中等待网络或磁盘。
兼容性
ProcessPoolExecutor 属于标准库 concurrent.futures。交互式解释器和部分 Notebook 环境中的临时函数可能无法被子进程导入,生产脚本应放入可导入模块运行。Python 3.11 及以上可使用更多工作进程生命周期控制参数;面向多版本环境时,以目标 Python 官方签名为准。
使用 async、await 和事件循环组织异步 I/O 操作。
编写异步任务
当程序需要同时等待多个网络、数据库、消息队列或文件 I/O 操作时,用 async def 定义协程、用 await 让出执行权,并由事件循环调度任务。异步并不会让 CPU 计算变快,它的价值是让同一线程在等待期间继续推进其他 I/O。
执行模型
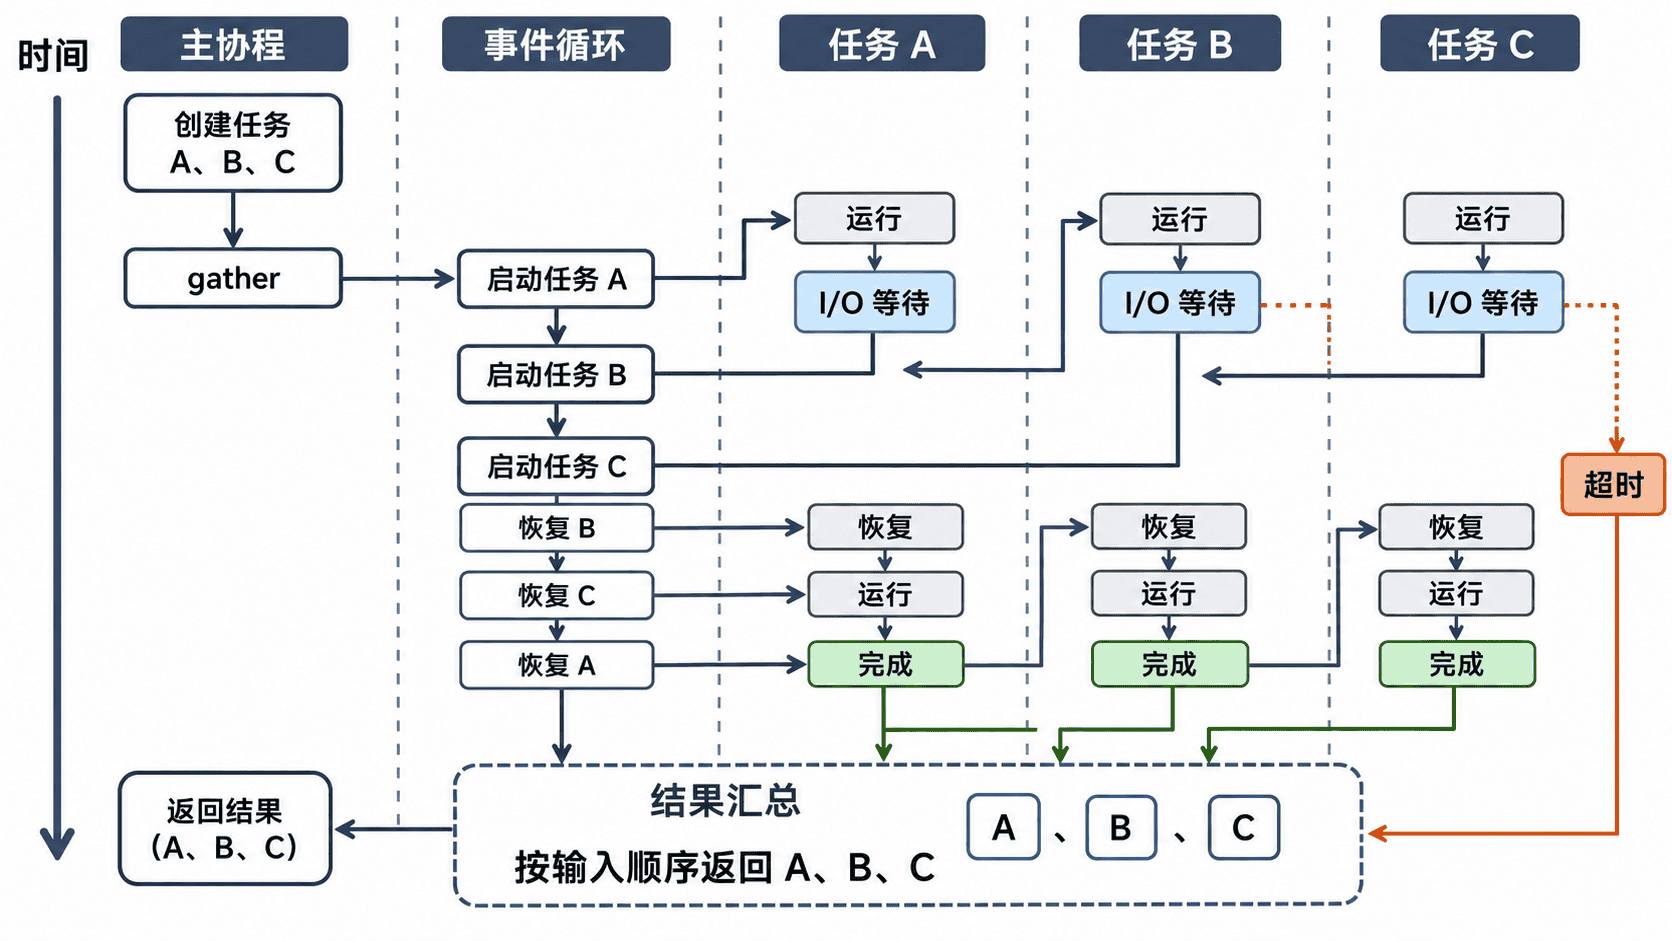
事件循环在一个线程中轮流推进多个协程:协程遇到可等待操作后暂停,I/O 就绪时再恢复。只有使用异步客户端或显式把阻塞调用移出事件循环,其他任务才有机会运行。
基本语法
下面用不同等待时间模拟三个 I/O 请求。asyncio.gather 并发等待全部协程,并按传入顺序返回结果;wait_for 给整组操作设置超时。
import asyncio

async def request(name: str, delay: float) -> str:
    # asyncio.sleep 模拟非阻塞 I/O;实际项目替换为异步客户端调用。
    await asyncio.sleep(delay)
    return f"{name}:ok"

async def main() -> None:
    jobs = [("A", 0.3), ("B", 0.1), ("C", 0.2)]

    try:
        results = await asyncio.wait_for(
            asyncio.gather(*(request(name, delay) for name, delay in jobs)),
            timeout=1.0,
        )
    except asyncio.TimeoutError:
        print("timeout")
    else:
        # B 实际先完成,但 gather 保持 jobs 的输入顺序。
        for result in results:
            print(result)

if __name__ == "__main__":
    asyncio.run(main())
保存为 async_demo.py 后运行:
python async_demo.py预期输出:
A:ok
B:ok
C:ok
实际完成顺序是 B、C、A,但输出按 jobs 顺序排列。若某个协程抛出异常,默认会由 gather 向调用方传播,应在业务边界记录输入、异常类型和重试决策。
常用接口
| 接口 | 作用 | 速查 |
|---|---|---|
asyncio.run(coro) |
创建事件循环并运行顶层协程 | 普通脚本入口首选,一次调用完成创建与清理 |
await coro |
等待协程并让出执行权 | 只能出现在异步函数或支持顶层 await 的环境 |
asyncio.create_task(coro) |
启动可独立推进的任务 | 必须保存引用,并在退出前等待或取消 |
asyncio.gather(...) |
并发等待一组可等待对象 | 返回顺序与输入一致,不等于完成顺序 |
asyncio.wait_for(awaitable, timeout) |
设置超时 | 超时会取消被等待对象,应处理清理逻辑 |
高频用法
- 并发请求多个独立资源:创建协程集合后交给
gather,避免逐个await造成串行等待。 - 限制并发量:在任务内部使用
asyncio.Semaphore,防止瞬间耗尽连接池、文件描述符或服务配额。 - 消费者流水线:用
asyncio.Queue连接生产者和消费者,并设置有界容量形成背压。 - 调用遗留阻塞 I/O:Python 3.9 及以上可用
asyncio.to_thread;CPU 密集计算应交给进程池。
风险与边界
- 触发条件:协程中调用
time.sleep、同步 HTTP 客户端或长时间同步文件操作。可能后果:整个事件循环停顿,所有请求延迟一起升高。安全替代:使用异步库、await asyncio.sleep,或通过asyncio.to_thread隔离阻塞 I/O。 - 触发条件:只调用异步函数却没有
await、create_task或gather。可能后果:协程根本未执行,并出现coroutine was never awaited。安全替代:明确任务所有者,并在作用域结束前等待它。 - 触发条件:无上限地创建任务。可能后果:连接数、内存和下游 QPS 同时失控。安全替代:使用信号量、有界队列和批次控制,并给每个外部调用设置超时。
- 触发条件:捕获
CancelledError后不重新抛出且不清理。可能后果:关闭过程卡住、连接泄漏或任务处于半完成状态。安全替代:在finally中释放资源,完成必要清理后继续传播取消。
排障清单
- 出现
coroutine was never awaited:找到返回协程对象的调用点,补上await或纳入任务管理。 - 报
no running event loop:确认create_task在已运行的异步上下文中调用。 - 报
asyncio.run() cannot be called from a running event loop:Notebook 中直接使用顶层await main(),不要嵌套启动事件循环。 - 并发仍然串行:检查是否在循环里逐个
await,以及客户端是否真正支持异步。 - 偶发任务泄漏:为任务保存引用,退出时统一等待、取消并收集异常。
兼容性
asyncio.run 自 Python 3.7 起可用,asyncio.to_thread 自 3.9 起可用,TaskGroup 与 asyncio.timeout 自 3.11 起提供结构化并发能力。需要兼容旧版本时,可继续使用 gather、wait_for 和显式任务清理。
执行全部或指定测试文件、测试类和测试函数。
运行单元测试
使用 pytest 快速执行整个测试集,或精确定位到测试文件、测试类和单个测试函数。统一使用 python -m pytest,可避免终端中的 pytest 命令指向错误的 Python 环境。
准备测试文件
下面的文件同时包含测试类和独立测试函数。将它保存为 tests/test_math.py;若当前环境尚未安装 pytest,先执行 python -m pip install pytest。
class TestMath:
    # 同一业务对象的断言可放入测试类,便于按类执行。
    def test_add(self):
        assert 1 + 2 == 3

# 独立函数可直接通过“文件::函数名”定位。
def test_subtract():
    assert 5 - 3 == 2
验证方法是运行后看到通过数量与预期一致;示例中的耗时属于动态值。
高频用法
执行当前目录下可发现的全部测试:
python -m pytest -q预期输出:
2 passed in <TIME>s只执行指定测试文件:
python -m pytest -q tests/test_math.py预期输出:
2 passed in <TIME>s只执行测试类:
python -m pytest -q tests/test_math.py::TestMath预期输出:
1 passed in <TIME>s只执行独立测试函数:
python -m pytest -q tests/test_math.py::test_subtract预期输出:
1 passed in <TIME>s节点定位符使用 文件路径::类名::方法名 或 文件路径::函数名。定位名称必须与收集到的节点完全一致;不确定时先用 python -m pytest --collect-only -q 查看。
常用参数
-q 精简输出,适合本地快速确认;-v 显示每个用例名称;-x 遇到首个失败立即停止;--maxfail=N 在累计 N 个失败后停止;-k 表达式 按名称筛选;-m 标记名 按 marker 筛选;--lf 仅重跑上次失败的测试。
需要确认选择范围时,先加 --collect-only -q,避免 -k 的子串匹配意外选中多个测试。合并代码或发布前应去掉筛选条件,再跑一次完整测试集。
输出与退出码
输出中的 passed、failed、skipped、error 分别表示通过、断言失败、主动跳过和测试准备或清理阶段异常。进程退出码 0 表示全部通过,1 表示存在失败,5 通常表示没有收集到测试;CI 应以退出码判断是否放行,而不是只搜索日志文本。
风险与边界
在包含真实数据库、消息队列或外部 API 的项目中执行全部测试,可能触发写入、扣费或发送通知。应使用隔离的测试环境、事务回滚和模拟对象,并显式禁用生产凭据。
-x、--lf、-k 和节点定位只覆盖部分测试,可能掩盖其他回归。它们适合定位问题,不应代替提交前的全量执行。
排障清单
出现 No module named pytest 时,确认安装命令和执行命令使用同一个解释器。出现 collected 0 items 时,检查文件名是否匹配 test_*.py 或 *_test.py、函数是否以 test_ 开头,以及当前工作目录是否为项目根目录。导入失败时,优先使用 python -m pytest,并检查包路径、虚拟环境和测试依赖是否完整。
用多组输入和预期结果复用同一个测试逻辑。
编写参数化测试
使用 pytest.mark.parametrize 把多组输入和预期结果绑定到同一个测试函数,适合边界值、等价类和异常输入验证。每组参数会生成一个独立测试节点,失败时能直接定位具体数据。
基本语法
装饰器第一个参数声明形参名称,第二个参数提供多组数据。参数名数量必须与每组数据的元素数量一致;pytest.param(..., id="...") 可生成稳定、可读的用例标识。
主示例
将下面内容保存为 tests/test_pricing.py。示例同时覆盖正常结果和异常输入,并用 pytest.approx 避免直接比较浮点数造成误判。
import pytest

def calculate_total(unit_price: int, quantity: int, discount: float = 0.0) -> float:
    # 在业务计算前拒绝非法边界,异常测试据此验证契约。
    if unit_price < 0 or quantity < 0:
        raise ValueError("price and quantity must be non-negative")
    return round(unit_price * quantity * (1 - discount), 2)

@pytest.mark.parametrize(
    ("unit_price", "quantity", "discount", "expected"),
    [
        # 显式 id 便于在 CI 日志中定位并单独重跑失败数据。
        pytest.param(100, 2, 0.0, 200.0, id="no_discount"),
        pytest.param(100, 2, 0.1, 180.0, id="ten_percent"),
        pytest.param(99, 3, 0.2, 237.6, id="decimal_result"),
    ],
)
def test_calculate_total(unit_price, quantity, discount, expected):
    result = calculate_total(unit_price, quantity, discount)
    # 浮点结果使用近似比较,避免二进制表示差异导致误报。
    assert result == pytest.approx(expected)

@pytest.mark.parametrize(
    ("unit_price", "quantity"),
    [
        pytest.param(-1, 1, id="negative_price"),
        pytest.param(1, -1, id="negative_quantity"),
    ],
)
def test_calculate_total_rejects_negative_values(unit_price, quantity):
    with pytest.raises(ValueError, match="must be non-negative"):
        calculate_total(unit_price, quantity)
执行全部参数组合:
python -m pytest -q tests/test_pricing.py预期输出:
5 passed in <TIME>s只重跑某一组参数:
python -m pytest -q "tests/test_pricing.py::test_calculate_total[ten_percent]"预期输出:
1 passed in <TIME>s参数设计
参数表应只放输入与预期结果,公共准备逻辑放在 fixture 或辅助函数中。id 建议使用稳定的英文短名,不依赖对象默认字符串,否则测试节点名称可能随实现变化,影响精确重跑和 CI 报告聚合。
多个 parametrize 装饰器会计算笛卡尔积。例如 3 个地区乘 4 种权限会生成 12 个用例。组合数较大时,应先删除无业务意义的组合,或改为显式列出关键场景。
风险与边界
直接用 == 比较浮点计算结果,可能因二进制精度产生偶发失败;使用 pytest.approx,并按业务精度设置容差。参数中若放入列表、字典等可变对象,测试函数对其原地修改后可能影响后续逻辑;应复制数据或通过 fixture 工厂创建新对象。
参数过多会显著拉长测试时间并降低失败信息可读性。应优先覆盖边界、代表值和已知缺陷,不要机械枚举所有排列。异常测试必须同时校验异常类型和关键消息,避免任意异常都被误判为通过。
排障清单
出现“参数数量不匹配”时,逐组核对元组长度与参数名数量。精确节点无法找到时,先执行 python -m pytest --collect-only -q tests/test_pricing.py,复制真实节点 ID。某一组参数难以识别时,为每个 pytest.param 增加唯一 id,不要依赖自动生成名称。
在测试中替换网络、文件、时间和第三方服务调用。
模拟外部依赖
当单元测试不能或不应访问真实网络、文件、系统时间或第三方服务时,使用 unittest.mock 临时替换依赖。目标是让测试快速、可重复,并同时验证调用参数;补丁应打在被测模块实际查找该对象的位置。
基本语法
patch() 可作为上下文管理器或装饰器,离开作用域后会自动恢复原对象。Mock 或 MagicMock 用于配置返回值、异常和调用断言;异步函数应使用 AsyncMock。
| 用法 | 作用 |
|---|---|
return_value=value |
固定一次调用的返回值 |
side_effect=exception |
模拟超时、拒绝或其他失败 |
autospec=True |
按真实对象签名约束调用 |
assert_called_once_with(...) |
验证调用次数和参数 |
高频用法
下面的脚本同时替换文件读取、HTTP 请求和系统时间。示例不会访问 /etc/app/token,也不会向网络发出请求。
from datetime import datetime, timezone
from pathlib import Path
from unittest.mock import MagicMock, patch
import json
import urllib.request

def build_report() -> dict[str, object]:
    token = Path("/etc/app/token").read_text(encoding="utf-8").strip()
    with urllib.request.urlopen(
        "https://example.invalid/status",
        timeout=2,
    ) as response:
        status = json.loads(response.read())
    checked_at = datetime.now(timezone.utc)
    return {
        "token": token,
        "service_ok": status["ok"],
        "checked_at": checked_at.isoformat(),
    }

def main() -> None:
    fixed_now = datetime(2026, 8, 5, 10, 0, tzinfo=timezone.utc)
    http_response = MagicMock()
    http_response.read.return_value = b'{"ok": true}'
    http_response.__enter__.return_value = http_response

    # 补丁仅在 with 作用域内生效,退出后自动恢复真实依赖。
    with (
        patch("__main__.Path.read_text", return_value="test-token") as mock_read,
        patch(
            "__main__.urllib.request.urlopen",
            return_value=http_response,
        ) as mock_open,
        patch("__main__.datetime") as mock_datetime,
    ):
        mock_datetime.now.return_value = fixed_now
        report = build_report()

    mock_read.assert_called_once_with(encoding="utf-8")
    mock_open.assert_called_once_with(
        "https://example.invalid/status",
        timeout=2,
    )
    print(report)

if __name__ == "__main__":
    main()
保存为 mock_demo.py 后运行:
python mock_demo.py预期输出:
{'token': 'test-token', 'service_ok': True, 'checked_at': '2026-08-05T10:00:00+00:00'}读取时先确认返回内容固定,再看两个 assert_called_once_with 是否通过;断言失败时脚本会直接报错而不会打印结果。在正式测试模块中,应把 __main__ 换成被测模块的可导入路径,例如 app.service.urllib.request.urlopen。
风险与边界
补丁目标写错时,模拟对象可能完全未生效,甚至触发真实网络或文件访问。安全做法是补丁“使用处”而不是“定义处”,并对关键依赖增加调用断言。大范围、长期补丁还会掩盖集成问题,应缩小 with patch(...) 作用域,并保留少量真实集成测试。
模拟对象不会自动跟随第三方 API 变更。接口签名或字段已经变化时,测试仍可能通过而生产失败;优先使用 autospec=True、spec_set 或契约测试约束模拟对象。涉及密钥、计费或写操作时,测试环境应额外禁止外网和真实凭据。
排障清单
ModuleNotFoundError:补丁字符串必须是 Python 可导入路径,不是文件系统路径。- 补丁未拦截调用:检查被测代码实际导入方式,并从该模块命名空间开始定位。
- 上下文管理器返回异常:为模拟响应配置
__enter__.return_value。 - 调用次数超出预期:检查重试、循环和隐式初始化,再决定断言应是一遍还是多遍。
- 异步函数出现未等待警告:改用
AsyncMock,并在异步测试中await被测调用。
兼容性
unittest.mock 自 Python 3.3 起属于标准库;AsyncMock 自 Python 3.8 起可用。示例按 Python 3.10 及以上编写;较旧版本可移除现代类型标注,并把括号式多上下文管理器改为一行多个 with 项或嵌套多个 with。
暂停程序执行并检查变量、调用栈和控制流程。
设置断点调试
当程序需要在某一行暂停并检查变量、调用栈或下一步控制流时,使用内置 breakpoint() 和标准库 pdb。断点适合本地复现和受控测试环境,不应直接遗留在无人值守的生产请求路径中。
主示例
下面在计算除法前暂停。调试器停住后,可读取局部变量,再继续执行。
def normalize(items: list[int]) -> float:
    total = sum(items)
    count = len(items)
    breakpoint()  # 在可能出现零除或异常数据的位置暂停。
    return total / count

if __name__ == "__main__":
    print(f"average={normalize([10, 20, 30]):.1f}")
保存为 debug_demo.py 后运行:
python debug_demo.py在 (Pdb) 提示符中依次输入 p total、p count 和 c。预期交互如下,<PATH> 会替换为实际文件路径:
> <PATH>/debug_demo.py(<LINE>)normalize()
-> breakpoint()  # 在可能出现零除或异常数据的位置暂停。
(Pdb) p total
60
(Pdb) p count
3
(Pdb) c
average=20.0
<PATH> 和 <LINE> 会替换为实际路径与行号。调试器显示触发断点的源码行;输入 c 后,程序才继续执行后续的 return。
常用调试命令
| 命令 | 读取或控制内容 |
|---|---|
p expr / pp expr |
求值并打印表达式;pp 更适合复杂对象 |
n |
执行当前行,在当前函数内前进 |
s |
进入即将调用的函数 |
c |
继续运行到下一个断点或程序结束 |
where |
显示完整调用栈 |
up / down |
在调用栈帧之间移动 |
l |
查看当前位置附近源码 |
q |
退出调试并终止当前程序 |
切换栈帧后,p 读取的是该帧的局部变量。修改变量可直接输入赋值语句,但这会改变后续执行结果,只适合验证假设,不能当作修复。
高频用法
- 已知可疑行:在该行前加入
breakpoint(),复现后查看输入和分支条件。 - 不想修改源码:使用
python -m pdb debug_demo.py从程序入口启动,再用break <行号>设置断点。 - 只关注特定数据:把断点放入条件分支,例如仅在某个请求 ID 或空列表出现时暂停。
- 异常难以复现:在本地保留原始输入和 traceback,再用
pdb重跑;生产环境优先采集日志、指标和错误快照。
风险与边界
请求进程、任务队列或 CI 执行到断点时会等待标准输入;无人操作将导致请求超时、工作线程占用或流水线挂起。安全替代方案是本地复现、结构化日志、受控错误快照,或在发布前通过检查规则阻止 breakpoint() 进入生产代码。
调试器中执行表达式会真正调用 Python 代码。打印属性可能触发属性访问器、数据库查询或其他副作用;不要在生产数据上调用未知方法,也不要修改共享状态。多线程和异步程序中,断点主要暂停当前执行路径,其他任务的时序可能继续变化,不能把观察到的状态视为原子快照。
排障清单
- 断点没有停住:确认该代码路径确实执行,并检查环境变量
PYTHONBREAKPOINT是否被设置为0。 - 一进入调试就退出:出现
BdbQuit通常是输入了q、终端关闭或标准输入不可用。 - 变量提示未定义:先用
where确认当前栈帧,再用up或down移动到变量所属函数。 - 源码行与运行行为不一致:检查解释器实际加载的文件路径、虚拟环境和部署版本。
- 调试期间状态持续变化:暂停外部流量或改用单线程、固定输入的最小复现脚本。
兼容性
pdb 是 Python 标准库。breakpoint() 自 Python 3.7 起可用;更旧版本使用 import pdb; pdb.set_trace()。设置 PYTHONBREAKPOINT=0 可全局禁用内置断点,适合 CI 或生产启动环境,但不会移除直接调用的 pdb.set_trace()。
从 traceback 中定位异常类型、触发位置和调用路径。
分析异常堆栈
用于从 Python traceback 中快速确认异常类型、最直接的触发语句和完整调用路径。先看最后一行,再向上找到最靠近异常的业务代码帧,最后检查调用者和异常链。
快速定位顺序
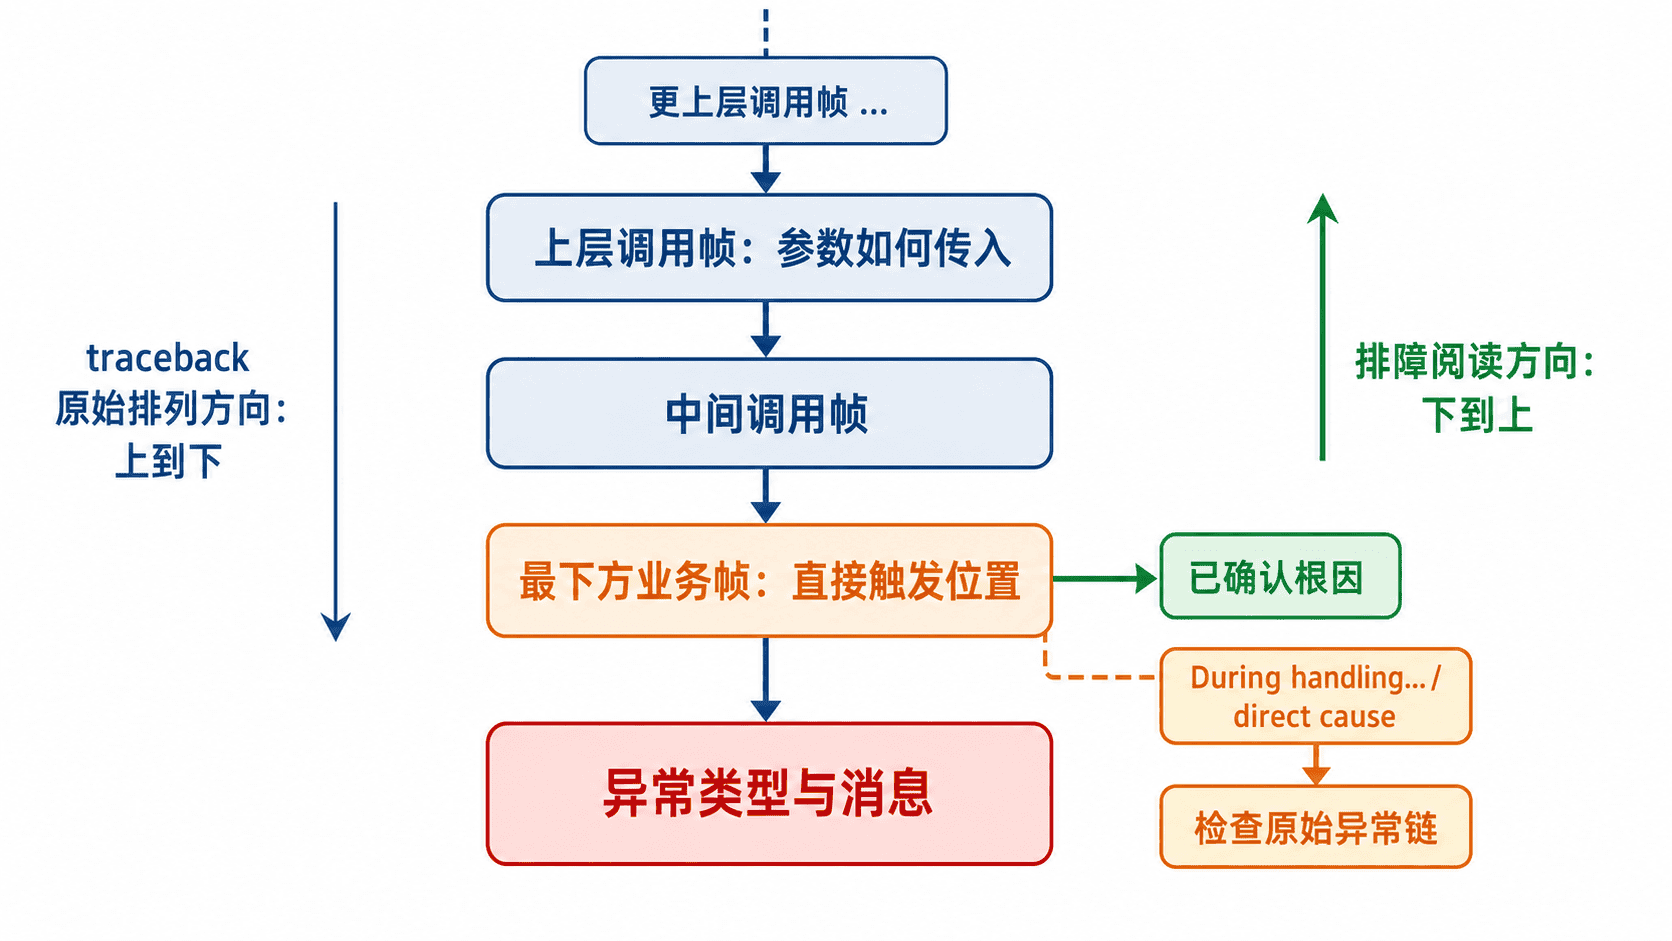
traceback 的帧按“较早调用 → 较晚调用”排列,最后一行是异常类型和消息。排障时按“异常末行 → 最下方业务帧 → 上层调用帧 → chained exception”读取,通常能最快找到根因。
可运行示例
保存为 trace_demo.py。示例故意把英文单词转换为整数,以生成包含四层调用关系的 traceback。
def parse_port(value: str) -> int:
    return int(value)

def load_config(config: dict[str, str]) -> int:
    return parse_port(config["port"])

def main() -> None:
    load_config({"port": "eighty"})

if __name__ == "__main__":
    main()
运行命令:
python trace_demo.py预期输出:
Traceback (most recent call last):
  File "<PATH>/trace_demo.py", line 11, in <module>
    main()
  File "<PATH>/trace_demo.py", line 8, in main
    load_config({"port": "eighty"})
  File "<PATH>/trace_demo.py", line 5, in load_config
    return parse_port(config["port"])
  File "<PATH>/trace_demo.py", line 2, in parse_port
    return int(value)
ValueError: invalid literal for int() with base 10: 'eighty'
<PATH> 会因保存目录不同而变化,行号应与示例文件一致。较新的 Python 版本可能额外显示波浪线或插入符定位,读取顺序不变。
输出读取方法
最后一行说明异常为 ValueError,失败值是 'eighty'。其上第一帧指向 parse_port() 的 int(value),这是直接触发位置;继续向上可确认错误值由 load_config() 读取,并由 main() 传入。
遇到 During handling of the above exception 或 The above exception was the direct cause 时,不要只看最后一个包装异常。先定位最早的原始异常,再判断后续异常是补充上下文还是掩盖根因。
高频排障
生产日志应在捕获异常的位置记录完整堆栈,而不是只记录 str(exc);标准日志可使用 logger.exception(...)。无法稳定复现时,先保存完整 traceback、输入摘要、版本和请求标识,再构造最小复现。
若最下方帧来自第三方库,先向上找到最后一个属于本项目的帧,检查传入参数、配置和调用前置条件。需要逐步查看变量时,可用 python -m pdb trace_demo.py 在本地复现,但不要直接在生产进程中交互调试。
风险与边界
把未脱敏的 traceback 上传到工单或外部服务,可能泄露文件路径、SQL、请求参数或采集器附带的局部变量。安全做法是保留异常类型、调用帧和必要上下文,同时遮蔽令牌、账号、业务数据与内部地址。
只修复最外层异常可能留下真实根因,尤其是使用宽泛 except Exception 后重新抛出新异常时。需要包装异常时使用 raise NewError(...) from exc 保留因果链,并避免空的 except 吞掉堆栈。
测量函数或代码片段的执行时间并减少偶然误差。
测量代码耗时
用于测量函数或代码片段的执行时间,并通过重复采样降低调度、缓存和后台负载造成的偶然误差。单次端到端计时用 time.perf_counter(),微基准优先用 timeit.repeat()。
选择计时方式
perf_counter() 是高分辨率单调时钟,适合测量一次完整操作,包含等待 I/O 的时间。timeit.repeat() 适合短函数:它会按指定次数执行多组样本,便于同时查看最佳值和中位数。
time.process_time() 只统计当前进程消耗的 CPU 时间,不包含休眠和大部分 I/O 等待。只有明确要排除等待时间时才使用它。
可运行示例
保存为 timing_demo.py。代码先执行一次端到端计时,再重复 7 组、每组 100 次,并换算为单次调用耗时。
from statistics import median
from time import perf_counter
from timeit import repeat

def work(limit: int) -> int:
    return sum(value * value for value in range(limit))

def main() -> None:
    start = perf_counter()
    result = work(10_000)
    elapsed = perf_counter() - start

    samples = repeat(lambda: work(10_000), repeat=7, number=100)
    per_call = [sample / 100 for sample in samples]

    print(f"single_result={result}")
    print(f"single_elapsed={elapsed:.6f}s")
    print(f"best_per_call={min(per_call):.6f}s")
    print(f"median_per_call={median(per_call):.6f}s")

if __name__ == "__main__":
    main()
运行命令:
python timing_demo.py预期输出:
single_result=333283335000
single_elapsed=<ELAPSED_S>s
best_per_call=<BEST_S>s
median_per_call=<MEDIAN_S>s
三个耗时值取决于 CPU、Python 版本和系统负载,实际值会不同;单位均为秒。
结果读取
single_elapsed 反映一次完整调用,容易受偶然抖动影响。best_per_call 更接近低干扰条件下的执行成本,median_per_call 更能代表典型表现;两者差距很大时,应增加重复次数并检查后台负载。
repeat=7 表示生成 7 组样本,number=100 表示每组执行 100 次。示例把每组总耗时除以 100,得到单次调用耗时;不要直接把整组时间误读成一次执行时间。
常用调整
函数首次调用会加载模块、建立连接或填充缓存时,先明确要测“冷启动”还是“稳定态”。测稳定态可在正式采样前执行一次预热;测冷启动则应让每组样本从相同初始状态开始。
短代码可提高 number,让每组总时长足够大;慢操作应降低 number,避免测试时间过长。I/O 或网络延迟通常不是稳定微基准,宜记录多次端到端延迟,并至少报告中位数和高分位值。
风险与边界
用 time.time() 测很短区间时,系统时钟校准可能造成跳变或精度不足;安全替代是 perf_counter()。只运行一次就下结论会把调度抖动当成代码差异,应重复采样并在相同环境中比较。
微基准只覆盖被测片段,可能忽略序列化、锁竞争、数据库和网络等待。优化前先确认真实瓶颈;端到端慢但局部函数很快时,应改用分析器或分阶段计时,而不是继续缩小微基准。
通过性能分析定位耗时函数、调用次数和优化目标。
分析性能热点
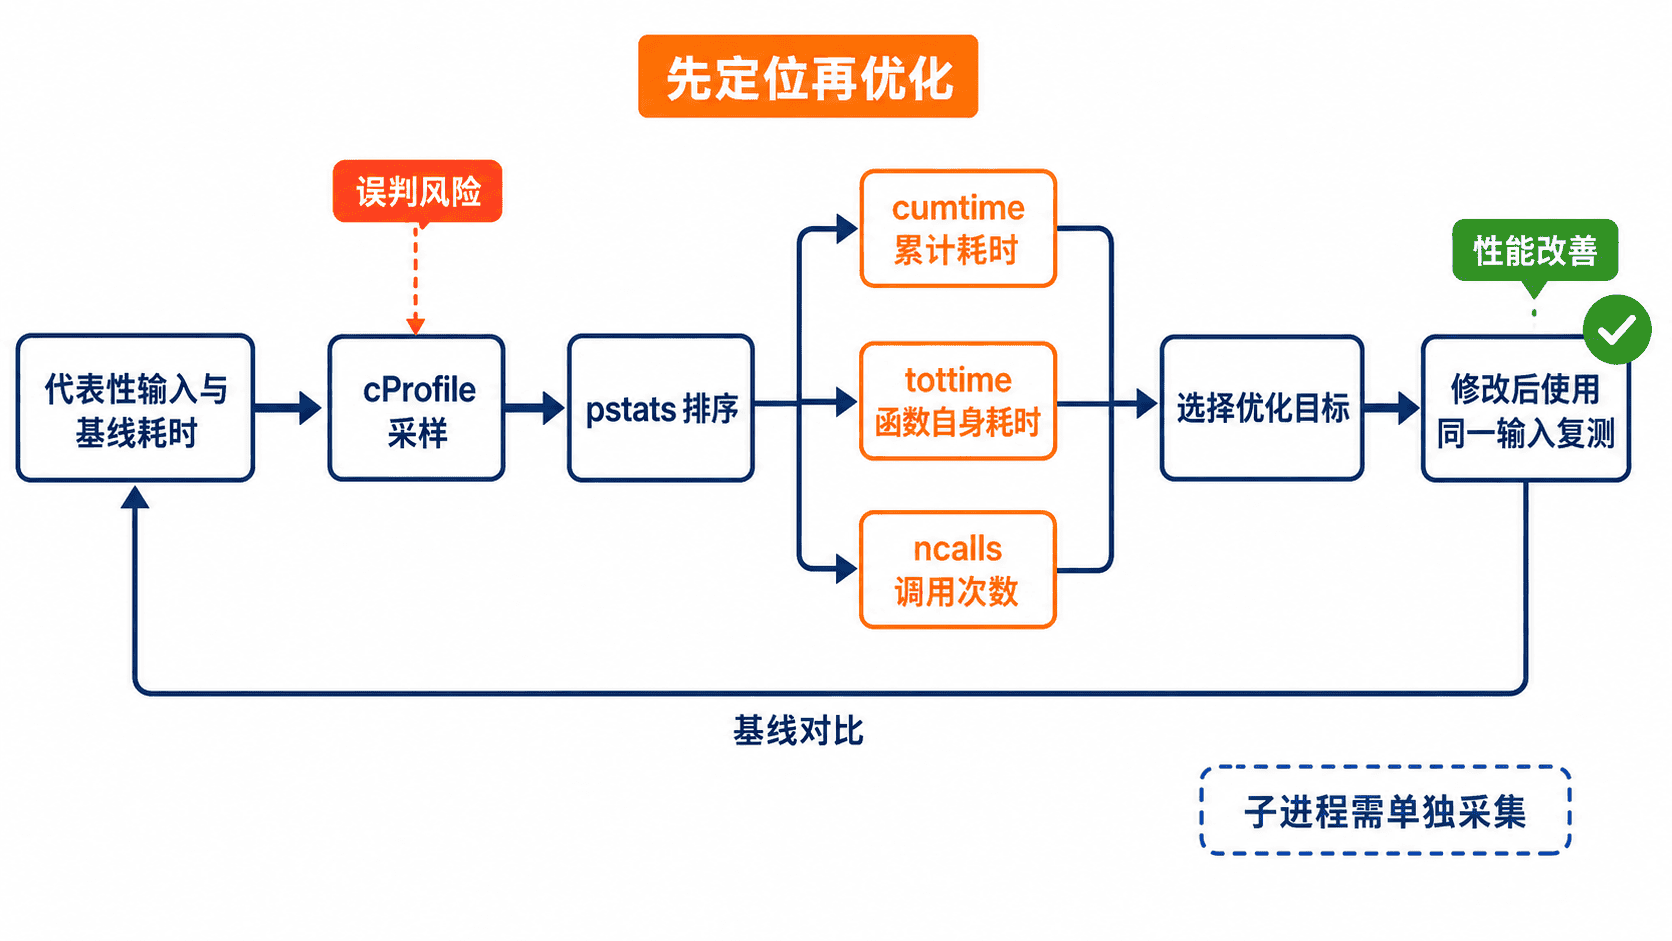
用于确认程序时间花在哪里:先用可复现输入采集调用统计,再按累计耗时、函数自身耗时和调用次数排序,最后只优化能显著影响端到端耗时的路径。
命令定位
CPU 密集、调用层级复杂且“感觉慢”但无法定位时,优先使用标准库 cProfile。先看按 cumulative 排序的调用链总耗时,再用 tottime 判断函数本身是否真正消耗 CPU;不要只看单次耗时。
基本语法
cProfile.Profile() 负责采集,pstats.Stats 负责排序和筛选。sort_stats("cumulative") 适合找上游慢路径,sort_stats("tottime") 适合找函数自身热点,print_stats(20) 可限制输出前 20 行。
高频用法
下面示例对固定计算负载采样,并打印累计耗时最高的 8 项。复制为 profile_demo.py 后直接运行。
import cProfile
import io
import pstats

def slow_transform(n: int) -> int:
    total = 0
    for i in range(n):
        total += (i % 97) ** 2
    return total

def run() -> int:
    # 固定输入和调用次数,便于优化前后做同条件对比。
    return sum(slow_transform(200_000) for _ in range(8))

def main() -> None:
    profiler = cProfile.Profile()
    profiler.enable()
    result = run()
    profiler.disable()

    stream = io.StringIO()
    stats = pstats.Stats(profiler, stream=stream)
    stats.sort_stats("cumulative").print_stats(8)
    print(f"result={result}")
    print(stream.getvalue())

if __name__ == "__main__":
    main()
运行命令:
python profile_demo.py预期输出:
result=4940246888
         <CALLS> function calls in <TIME> seconds

   Ordered by: cumulative time

   ncalls  tottime  percall  cumtime  percall filename:lineno(function)
        1   <TIME>   <TIME>   <TIME>   <TIME> <PATH>/profile_demo.py:<LINE>(run)
8 <TIME> <TIME> <TIME> <TIME> <PATH>/profile_demo.py:<LINE>(slow_transform)<CALLS>、<TIME>、<PATH> 和 <LINE> 会随解释器、机器及文件位置变化。示例中 slow_transform 调用 8 次且占据主要 tottime,因此它比 run 更适合作为代码级优化目标;run 的高 cumtime 主要来自下游调用。
输出字段说明
ncalls:调用次数;递归函数可能显示“总调用/原始调用”。tottime:函数自身耗时,不含其调用的其他函数。cumtime:函数及全部下游调用的累计耗时。percall:对应耗时除以调用次数,用于区分“单次很慢”和“次数过多”。
风险与边界
在生产主进程长时间开启确定性分析会增加 CPU 开销并放大延迟,尤其是高 QPS 服务。安全替代方案是在压测环境复现,或仅对单个请求、短时间窗口和单个工作进程采集。
I/O 等待可能让上层函数的 cumtime 很高,但这不等于该函数本身消耗 CPU。此时结合 tottime、外部依赖耗时和墙钟时间判断,避免把数据库、网络或锁等待误当成纯计算热点。
排障清单
- 结果没有明显热点:确认输入规模、请求路径和数据分布与真实慢场景一致。
- 子进程函数未出现:
cProfile只覆盖当前进程,应分别采集工作进程再汇总比较。 - 优化后无改善:使用同一输入重复测量,并同时核对总耗时、正确性和内存变化。
- 调用次数异常高:先检查循环、递归、重复序列化和缓存失效,再考虑微优化。
排查 UnicodeDecodeError、乱码和跨平台编码不一致。
处理文本编码
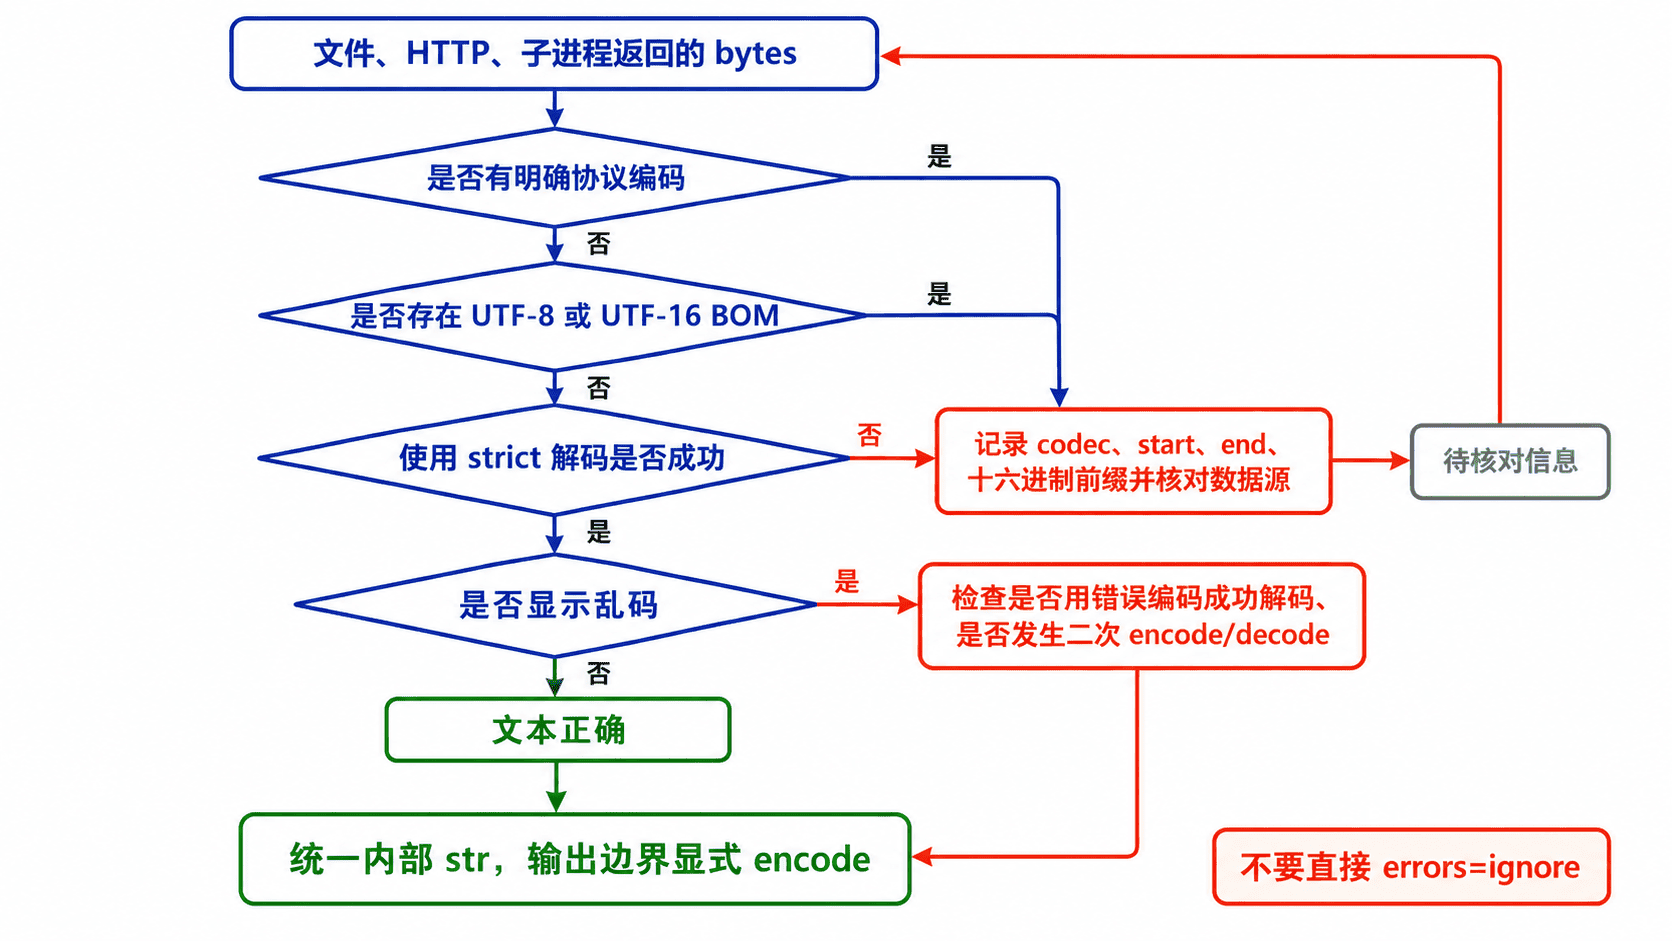
用于排查 UnicodeDecodeError、乱码和跨平台默认编码差异。核心做法是在字节进入程序的边界明确编码,严格解码并保留原始字节,而不是依赖系统默认值或静默丢弃错误。
命令定位
Python 内部文本使用 str,文件、网络和子进程边界常返回 bytes。从 bytes 到 str 必须 decode,从 str 到 bytes 必须 encode;编码名称应来自协议、文件规范或 BOM,而不是凭乱码外观猜测。
基本语法
常用形式是 data.decode("utf-8", errors="strict") 和 text.encode("utf-8", errors="strict")。strict 是默认行为,遇到非法字节立即报错,最适合排障;utf-8-sig 会在读取时移除 UTF-8 BOM。
高频用法
下面示例创建 UTF-8 文件,先故意用 ASCII 解码以提取错误位置,再按约定的 UTF-8 正确读取。辅助函数只识别常见 BOM;无 BOM 时按系统间约定的 UTF-8 处理,并不是通用编码探测器。复制为 encoding_demo.py 后运行。
from pathlib import Path

def decode_text(data: bytes) -> tuple[str, str]:
    if data.startswith(b"\xef\xbb\xbf"):
        return data.decode("utf-8-sig"), "utf-8-sig"
    if data.startswith((b"\xff\xfe", b"\xfe\xff")):
        return data.decode("utf-16"), "utf-16"
    return data.decode("utf-8"), "utf-8"

def main() -> None:
    path = Path("sample-utf8.txt")
    path.write_bytes("城市=北京\n".encode("utf-8"))
    raw = path.read_bytes()

    try:
        raw.decode("ascii")
    except UnicodeDecodeError as exc:
        # 只打印定位字段,避免把可能含敏感信息的完整原始数据写入日志。
        print(f"failed_codec={exc.encoding} range={exc.start}:{exc.end}")

    text, codec = decode_text(raw)
    print(f"detected={codec}")
    print(text.strip())

if __name__ == "__main__":
    main()
运行命令:
python encoding_demo.py预期输出:
failed_codec=ascii range=0:1
detected=utf-8
城市=北京
错误范围 0:1 表示第一个字节无法按 ASCII 解码。正确读取后,程序内部得到 Unicode str;后续写文件或发送网络请求时再按目标协议编码。
输出字段说明
UnicodeDecodeError 的 encoding 是失败的解码器,start 和 end 标出原始字节中的失败区间,reason 给出原因。排障日志可记录这些字段和少量十六进制前缀,但不要直接记录完整 object,其中可能包含口令、令牌或用户数据。
高频排查
- 文件读写:使用
Path.read_text(encoding="utf-8")和write_text(..., encoding="utf-8"),不要依赖操作系统默认编码。 - 带 BOM 文件:UTF-8 使用
utf-8-sig;UTF-16 应优先使用utf-16让解码器根据 BOM 判断字节序。 - 子进程输出:根据被调用程序的输出约定设置
encoding;约定不明确时先接收bytes,保存样本后再解码。 - 乱码但未报错:通常是错误编码仍能“成功”解码,需回到原始字节和来源协议核对,不能只做字符串替换。
风险与边界
errors="ignore" 会无提示删除无法解码的字节,errors="replace" 会写入替代字符,可能破坏主键、签名、金额或日志证据。安全替代方案是保持 strict,将失败数据连同来源和编码元数据送入隔离队列。
自动猜测编码只能给出概率,短文本和混合编码尤其容易误判。可靠顺序应是协议声明、文件规范、BOM、发送方配置,最后才是受控猜测;无论采用何种方法,都应保留原始字节以便复核。
兼容性
Windows、Linux、容器和不同启动方式的默认编码可能不同,UTF-8 模式也可能改变默认行为。示例中的 tuple[str, str] 类型标注需要 Python 3.9 及以上;更早版本可改用 typing.Tuple。跨平台程序应在每个文本边界显式写出编码。
定位 ModuleNotFoundError、循环导入和搜索路径问题。
排查模块导入失败
遇到 ModuleNotFoundError、导入到错误文件或“partially initialized module”时,先确认当前解释器、工作目录和模块搜索结果,再分别处理环境错位、名称遮蔽、包结构或循环导入。
先定位解释器与模块
下面的命令不会修改环境,用于确认“正在运行哪个 Python”以及目标模块能否被搜索到。将 missing_demo_module 替换为实际模块名。
python -c "import importlib.util, os, sys; name='missing_demo_module'; spec=importlib.util.find_spec(name); print(f'executable={sys.executable}'); print(f'cwd={os.getcwd()}'); print(f'spec={spec}'); print('status=missing' if spec is None else 'status=found')"预期输出:
executable=<PATH_TO_PYTHON>
cwd=<CURRENT_DIRECTORY>
spec=None
status=missing
executable 必须与预期虚拟环境一致;spec=None 表示当前 sys.path 中找不到目标。若显示了其他路径,说明模块存在,但可能导入了错误副本。
高频问题与处理
包安装到了另一个解释器
始终使用同一个解释器调用 pip,避免 pip 与 python 指向不同环境。
python -m pip --version
python -m pip show requests
python -c "import requests; print(requests.__file__)"
安装正确时的典型输出:
pip <PIP_VERSION> from <ENV_PATH>/site-packages/pip (python <PYTHON_VERSION>)
Name: requests
Version: <VERSION>
<ENV_PATH>/site-packages/requests/__init__.py
若 pip show 提示未找到,但项目声称已安装,优先修正解释器或重新激活虚拟环境,不要直接改全局环境。
本地文件遮蔽第三方包
项目中存在 requests.py、json.py 或同名目录时,当前目录通常优先于 site-packages,会导入错误文件。查看模块的 __file__;若路径落在项目目录,重命名冲突文件并删除对应 __pycache__ 后重试。
包结构或启动方式不正确
包内使用相对导入时,应从项目根目录以模块方式启动,例如 python -m app.main,不要直接执行 python app/main.py。同时确认包目录、大小写和导入路径一致;Linux 文件名区分大小写,开发机正常不代表生产机正常。
循环导入
错误中出现 partially initialized module 或 “cannot import name” 且两个模块互相引用时,通常是循环导入。优先把共享常量、数据类或接口抽到第三个低依赖模块;局部导入只能作为延迟依赖的临时方案,不能掩盖初始化顺序问题。
风险与边界
直接修改 sys.path 或全局 PYTHONPATH 可能让本机暂时可用,却在测试、容器或生产环境继续失败。更安全的做法是修正包结构,并在项目根目录执行 python -m pip install -e . 或使用标准构建安装。
捕获所有 ImportError 后继续运行会同时吞掉模块内部真实异常,造成“模块不存在”的误判。只在明确可选依赖时捕获,并记录完整异常链。
排障清单
- 核对
sys.executable、当前目录和虚拟环境。 - 用
find_spec()判断模块是否可见,再检查__file__是否指向预期位置。 - 搜索同名
.py文件、目录和残留__pycache__。 - 对包内脚本改用
python -m 包名。模块名启动。 - 根据完整 traceback 找到第一个互相导入的模块,拆分共享依赖。
- 在全新虚拟环境中复现;干净环境正常时,原环境存在路径或安装污染。
速查原则:先确认“谁在运行、从哪里找、实际导入了谁”,再改代码或重装依赖。
检查依赖关系、版本约束和环境污染导致的安装冲突。
排查依赖版本冲突
安装报 ResolutionImpossible、运行时出现版本不兼容,或同一项目在不同机器表现不一致时,先确认 pip 所属解释器,再用 pip check 找出已安装依赖的约束缺口和环境污染。
先确认环境与冲突
以下命令只读取当前环境。pip check 检查已安装包的元数据约束,pip show 用于查看直接依赖和反向依赖。
python -m pip --version
python -m pip check
python -m pip show requests urllib3
健康环境的关键输出:
pip <PIP_VERSION> from <ENV_PATH>/site-packages/pip (python <PYTHON_VERSION>)
No broken requirements found.
Name: requests
Version: <VERSION>
Requires: certifi, charset_normalizer, idna, urllib3
Required-by: <DEPENDENTS_OR_EMPTY>冲突环境中,pip check 通常会明确指出约束与实装版本,例如:
<PACKAGE_A> <VERSION_A> has requirement <PACKAGE_B><CONSTRAINT>, but you have <PACKAGE_B> <VERSION_B>.先读清“谁要求谁”,不要只升级报错行末尾的包;真正需要调整的可能是上游包、约束文件或整个环境。
定位约束来源
检查项目中的 pyproject.toml、requirements*.txt、constraints*.txt 和锁文件,区分直接依赖与传递依赖。pip show <PACKAGE> 的 Requires 表示它依赖谁,Required-by 表示谁依赖它。
若安装阶段出现 ResolutionImpossible,从错误中记录相互冲突的两个约束,例如一个包要求 urllib3<2,另一个要求 urllib3>=2。此类约束没有交集,反复重装不会解决,必须升级或降级其中一个上游依赖。
安全修复顺序
- 保存当前状态:记录 Python、pip 版本以及
python -m pip freeze输出,便于回滚和对比。 - 新建干净虚拟环境,只安装项目声明的直接依赖,不复制旧环境的全部包。
- 为关键直接依赖设置明确版本范围,必要时用 constraints 文件统一限制传递依赖。
- 安装后执行
python -m pip check、项目测试和核心启动命令。 - 验证通过后再更新锁文件或部署镜像,不要直接在生产环境边试边改。
下面是最小约束示例。requirements.txt 声明直接依赖,constraints.txt 只限制解析结果,不会单独安装其中的包。
# requirements.txt
requests==2.32.3

# constraints.txt
urllib3<3
安装命令:
python -m pip install -r requirements.txt -c constraints.txt
python -m pip check
预期结果:
Successfully installed requests-2.32.3 <OTHER_PACKAGES>
No broken requirements found.
实际安装列表和版本可能不同;最终以 pip check 无冲突、测试通过为准。
风险与边界
无边界执行 python -m pip install -U 会同时升级传递依赖,可能消除当前冲突却引入 API 破坏。安全替代方案是先在干净虚拟环境中固定直接依赖,审查解析结果并运行回归测试。
在污染环境中直接执行 pip freeze > requirements.txt 会把临时工具、错误版本和平台专用包一起固化。应从项目声明重建环境,验证后再生成锁定结果。
使用 sudo pip install 或向系统 Python 写入包可能破坏操作系统工具;优先使用 venv、容器或受项目管理的解释器。对系统标记为 externally managed 的环境,不要用强制参数绕过保护。
排障清单
- 确认
python -m pip --version的路径与运行项目的解释器一致。 - 执行
python -m pip check,记录所有冲突,不只处理第一条。 - 用
pip show查清直接依赖、传递依赖和反向依赖。 - 检查多个 requirements、constraints 或锁文件是否给出互斥约束。
- 在干净虚拟环境复现,排除历史安装残留。
- 修复后同时验证依赖检查、自动化测试和应用启动。
速查原则:先找出不相交的版本约束,再在干净环境中调整上游依赖;不要靠全量升级或强制重装碰运气。