
Java / 知识点
Java 开发速查手册
手册条目
ExecutorService pool = Executors.newFixedThreadPool(<线程数>);
Future<T> future = pool.submit(<Callable>);
pool.shutdown(); pool.awaitTermination(<时长>, TimeUnit.SECONDS);
创建 ExecutorService、提交任务并正确关闭线程池。
使用线程池
当一批任务需要复用有限数量的工作线程时,使用 ExecutorService 统一提交、等待和关闭,避免手工创建大量 Thread。下面示例固定使用 2 个线程处理 4 个任务,并保证程序退出前完成资源回收。
基本语法
execute 适合无返回值任务;submit 可提交 Runnable 或 Callable,并通过 Future 获取结果或异常。线程池创建后必须显式关闭,否则非守护线程可能阻止 JVM 退出。
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.Callable;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;
import java.util.concurrent.TimeUnit;

public class ThreadPoolDemo {
    public static void main(String[] args) throws Exception {
        ExecutorService pool = Executors.newFixedThreadPool(2);
        List<Future<String>> futures = new ArrayList<>();

        try {
            for (int i = 1; i <= 4; i++) {
                int taskId = i;
                Callable<String> task = () -> {
                    Thread.sleep(100);
                    return "task-" + taskId + " done";
                };
                futures.add(pool.submit(task));
            }

            // 按提交顺序读取结果;get() 会传播任务中的异常
            for (Future<String> future : futures) {
                System.out.println(future.get());
            }
        } finally {
            pool.shutdown();
            if (!pool.awaitTermination(3, TimeUnit.SECONDS)) {
                // 超时后中断仍未结束的任务,避免进程长期挂起
                pool.shutdownNow();
            }
        }
    }
}
预期输出:
task-1 done
task-2 done
task-3 done
task-4 done
任务实际执行顺序可能并行交错,但这里按 Future 的保存顺序读取,因此输出稳定。
常用选择
newFixedThreadPool(n):并发量固定,适合可控的 CPU 或阻塞任务;必须根据机器和下游容量设置n。newSingleThreadExecutor():严格串行执行,适合顺序敏感的后台任务。newScheduledThreadPool(n):延迟或周期任务;周期任务抛出未捕获异常后,后续调度可能停止。- 生产环境需要限制队列长度、命名线程或定义拒绝策略时,直接使用
ThreadPoolExecutor,不要依赖无界队列的便捷工厂方法。
风险与边界
Executors.newFixedThreadPool 使用无界队列。任务提交速度长期高于处理速度时,队列会持续增长,最终可能触发高内存占用或 OutOfMemoryError。安全替代方案是使用有界 BlockingQueue、合理的最大线程数和明确的 RejectedExecutionHandler。
调用 shutdownNow() 只会尝试中断任务,不能强制终止忽略中断的代码。阻塞操作应正确响应 InterruptedException,恢复中断状态或尽快退出。
不要在同一线程池中的任务里相互等待彼此的 Future。当所有工作线程都被等待操作占满时,可能形成线程饥饿死锁;应拆分线程池、改用异步组合,或避免任务间同步等待。
排障清单
- 程序执行完仍不退出:检查是否遗漏
shutdown(),或任务是否一直阻塞。 Future.get()长时间不返回:为外部调用设置超时,并使用get(timeout, unit)定位卡住的任务。- 线程数很多但吞吐不升:检查 CPU 饱和、数据库连接池、HTTP 连接池和下游限流,线程池不能突破下游容量。
- 偶发任务丢失:检查是否在任务完成前关闭进程,以及拒绝策略是否静默丢弃任务。
兼容性
ExecutorService、Future 和固定线程池可用于 Java 5 及以上版本。示例未依赖较新语法,可直接在 Java 8、11、17、21 中编译运行。
Thread.ofVirtual().start(<Runnable>);
try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) { executor.submit(<任务>); }
使用虚拟线程处理大量阻塞式并发任务。
使用虚拟线程
大量任务主要等待网络、数据库或文件 I/O 时,可为每个任务创建一个虚拟线程,以保留直观的阻塞式代码,同时降低平台线程占用。虚拟线程不提升单个任务速度,也不适合用来突破数据库连接数或远端接口限流。
基本语法
Java 21 可通过 Executors.newVirtualThreadPerTaskExecutor() 为每个提交任务创建一个虚拟线程。该执行器实现 AutoCloseable,使用 try 块可在退出时等待已提交任务完成并关闭执行器。
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;

public class VirtualThreadDemo {
    public static void main(String[] args) throws Exception {
        List<Future<String>> futures = new ArrayList<>();

        try (ExecutorService executor =
                     Executors.newVirtualThreadPerTaskExecutor()) {
            for (int i = 0; i < 5; i++) {
                int taskId = i;
                futures.add(executor.submit(() -> {
                    // 模拟阻塞式 I/O;等待期间不会长期占用平台线程
                    Thread.sleep(100);
                    return "task-" + taskId
                            + ", virtual=" + Thread.currentThread().isVirtual();
                }));
            }

            // 按提交顺序读取,避免并发完成顺序导致输出不稳定
            for (Future<String> future : futures) {
                System.out.println(future.get());
            }
        }
    }
}
预期输出:
task-0, virtual=true
task-1, virtual=true
task-2, virtual=true
task-3, virtual=true
task-4, virtual=true
高频用法
- 阻塞式 HTTP、JDBC、文件访问:保持“一请求一任务”的同步写法,通常不需要改造成回调链。
- 大量彼此独立的短任务:直接逐个提交,不要预先创建固定大小的虚拟线程池。
- 限制下游并发:虚拟线程数量可以很大,但数据库连接、第三方接口配额仍有限,应使用
Semaphore、连接池或限流器控制同时访问数。 - 需要返回值或传播异常:继续使用
Future.get();批量任务可保存Future列表后统一收集结果。
风险与边界
CPU 密集型任务的并行度仍受 CPU 核数限制。为这类任务创建成千上万个虚拟线程只会增加调度开销;安全替代方案是使用接近 CPU 核数的平台线程池或 Fork/Join 并行任务。
在 synchronized 代码块中执行长时间阻塞操作,或调用某些本地方法时,虚拟线程可能暂时固定在平台线程上。大量固定会降低扩展性;应缩短临界区,避免在锁内进行 I/O,并通过线程转储或 JFR 检查固定热点。
虚拟线程便宜但任务本身不免费。无限提交任务仍会消耗堆内存、连接和下游容量,可能造成超时雪崩。应保留请求超时、背压、并发上限和取消机制。
不要按平台线程池思路复用或缓存虚拟线程。虚拟线程的推荐模型是“每个任务一个线程”,资源限制应放在实际稀缺资源上。
排障清单
isVirtual()返回false:检查是否误用了固定线程池,或代码是否运行在 Java 21 以下。- 吞吐量没有提升:确认任务是否真的以阻塞等待为主,并检查数据库连接池、远端限流和带宽瓶颈。
- 延迟突然升高:检查是否无限制提交任务、下游连接耗尽,或大量任务同时超时重试。
- 线程转储中平台线程被长期占用:排查锁内 I/O、长时间
synchronized临界区和本地调用。
兼容性
虚拟线程在 Java 21 成为正式功能。Java 19 和 20 中属于预览功能,需要预览参数且 API 行为可能不同;生产环境优先使用 Java 21 或更高的长期支持版本。
编排异步任务并处理组合、超时和异常。
使用 CompletableFuture
多个异步结果需要汇合,或后一步依赖前一步结果时,用 CompletableFuture 表达依赖关系。执行器决定任务在哪运行,阶段操作决定结果如何传播;两者应分别设计。
组合与关键选项
| 操作 | 使用时机 |
|---|---|
supplyAsync(Supplier<U>, Executor) |
在指定执行器产生结果 |
thenApply(Function<T,U>) |
把已有结果同步映射为另一个值 |
thenCompose(Function<T,CompletionStage<U>>) |
下一步本身异步,展开嵌套阶段 |
thenCombine(CompletionStage<U>, BiFunction<T,U,V>) |
等待两个结果并合并 |
orTimeout(long, TimeUnit) |
到期仍未完成则异常完成当前 Future |
exceptionally(Function<Throwable,T>) |
对异常提供同类型恢复值 |
thenApply 等方法也能返回新的异常阶段,失败通常向后传播。join() 失败抛出 CompletionException,可读取 getCause();get() 使用受检异常并可响应等待线程的中断。非 Async 回调可能在完成前一阶段的线程或调用注册操作的线程执行,不承诺固定线程。
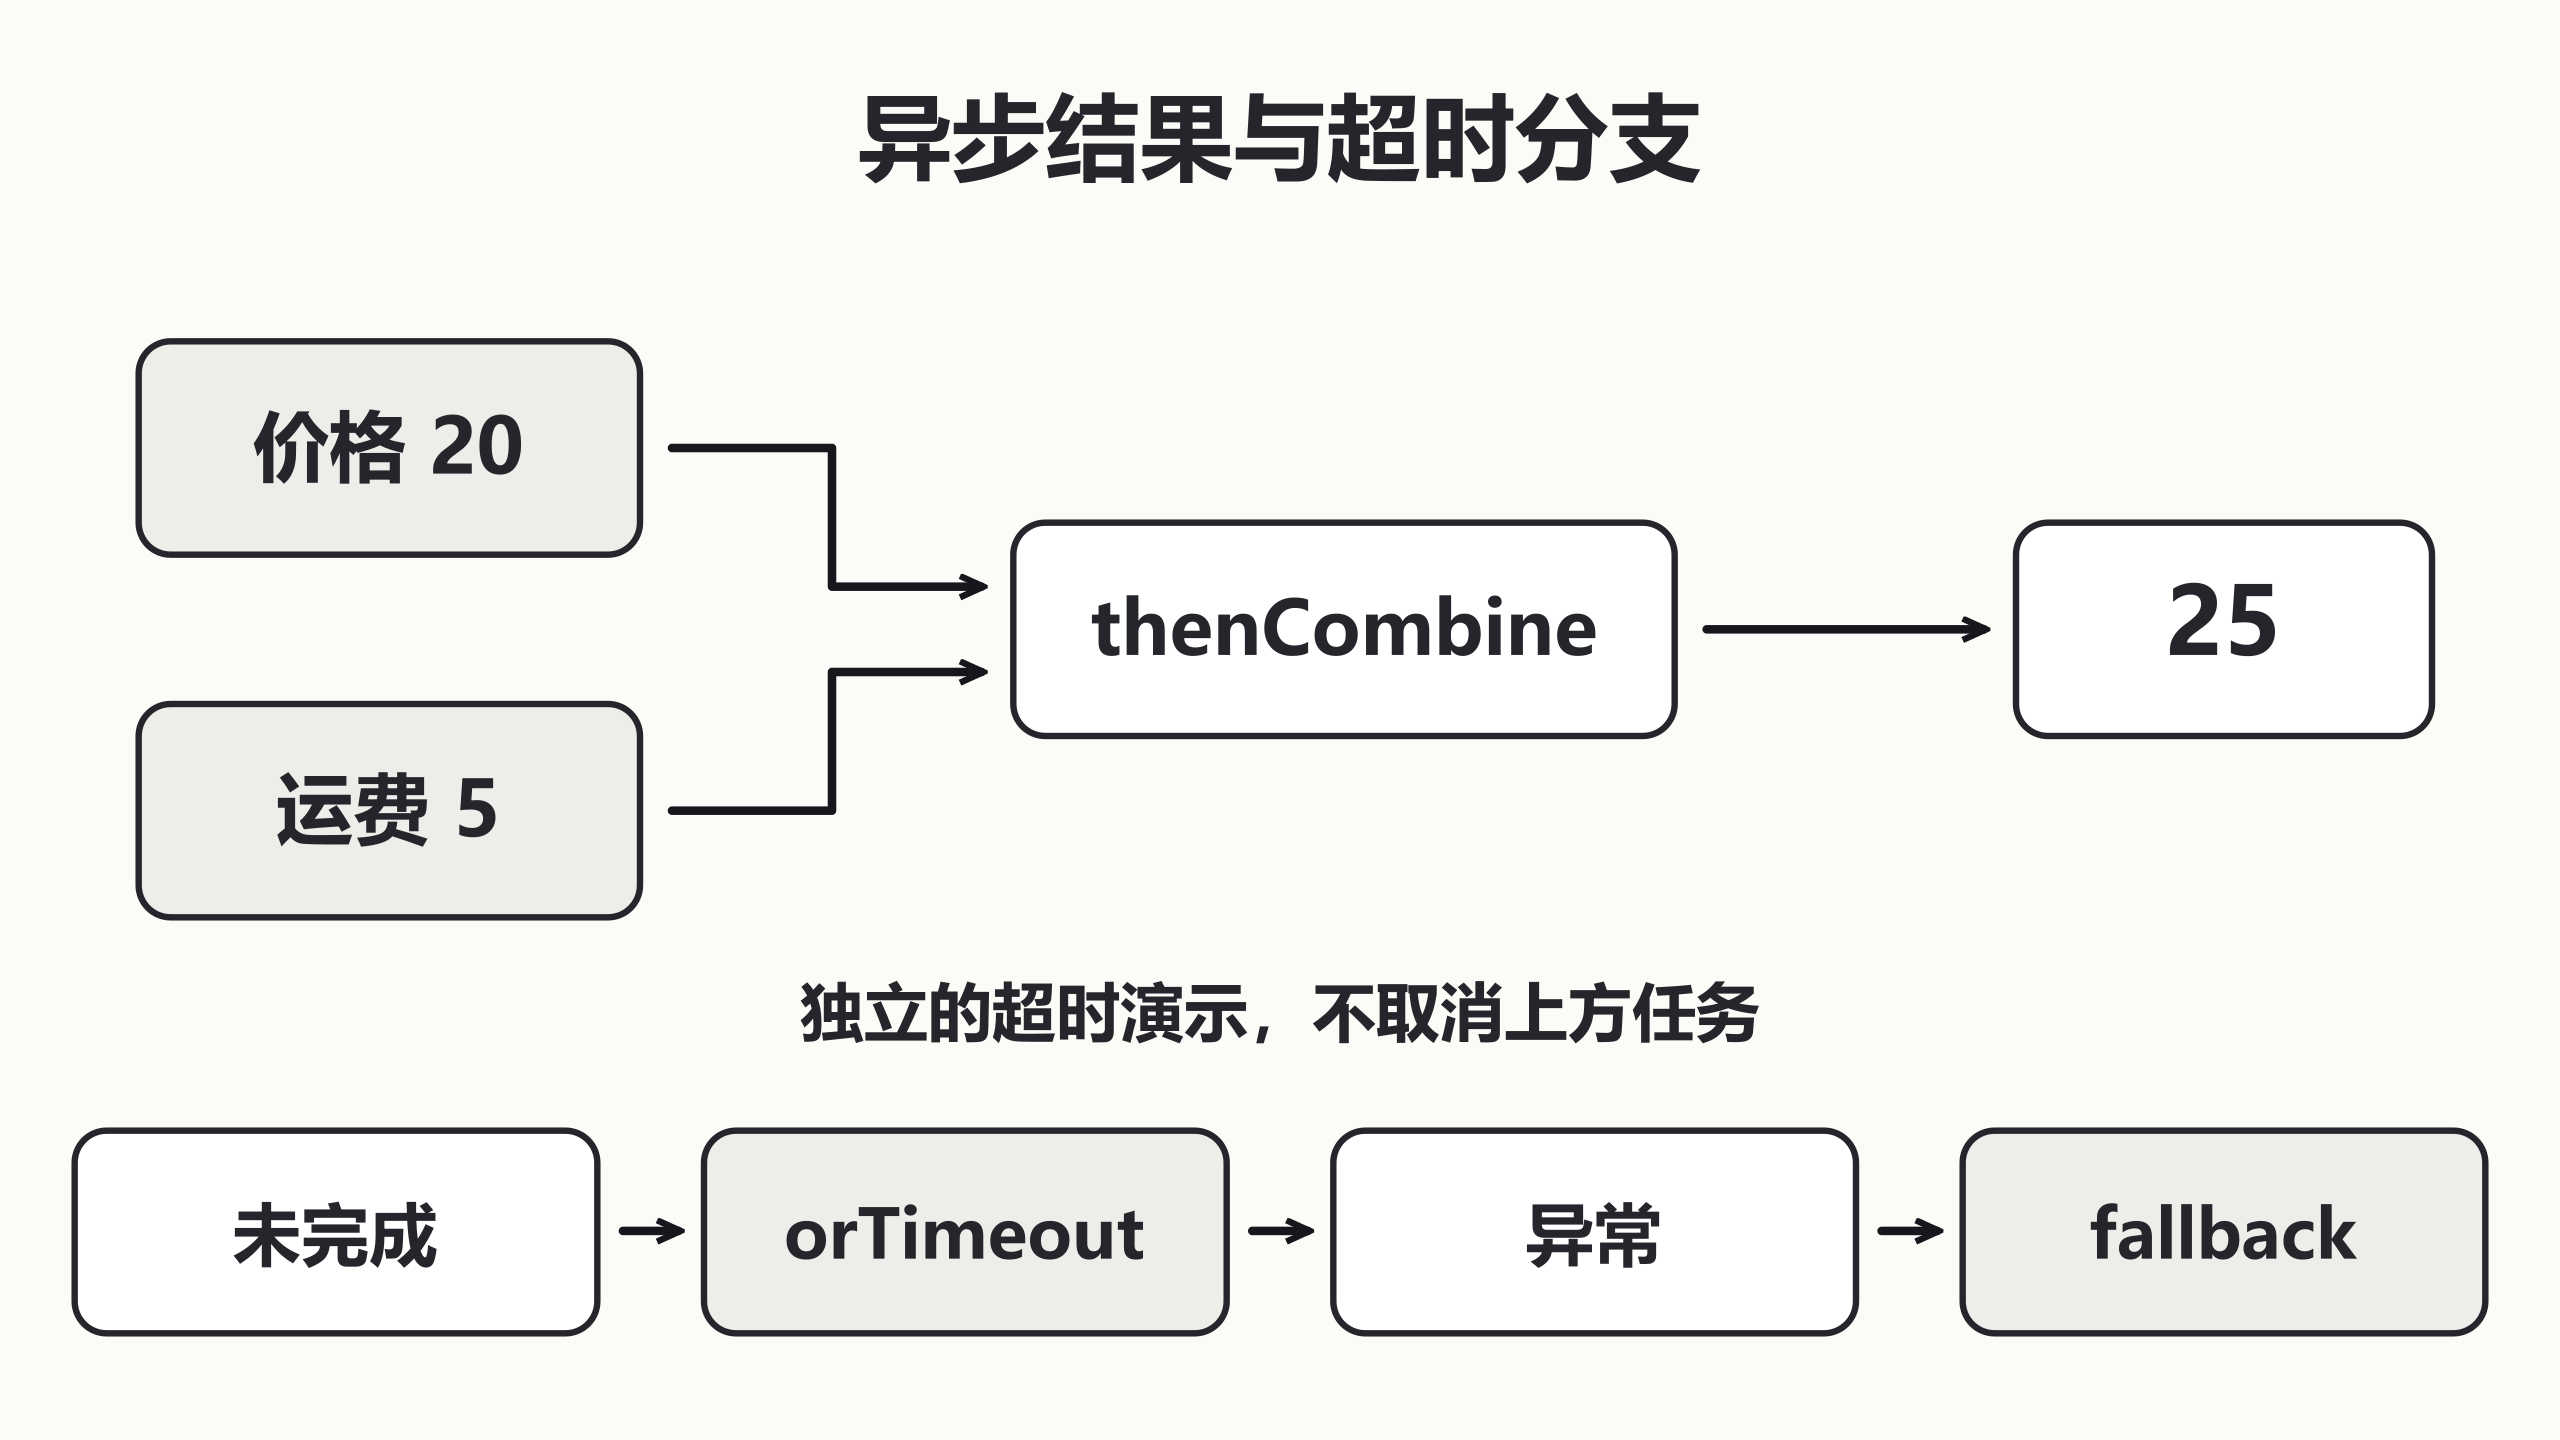
汇合与超时示例
保存为 FutureDemo.java。显式管理执行器;用一个始终未完成的 Future 稳定验证超时分支,不依赖网络快慢。
import java.util.concurrent.*;

public class FutureDemo {
    public static void main(String[] args) {
        try (ExecutorService pool = Executors.newFixedThreadPool(2)) {
            var price = CompletableFuture.supplyAsync(() -> 20, pool);
            var shipping = CompletableFuture.supplyAsync(() -> 5, pool);
            System.out.println(price.thenCombine(shipping, Integer::sum).join());
            // 没有生产者,必定走超时分支;不是付费或远程请求
            var pending = new CompletableFuture<String>();
            String value = pending.orTimeout(50, TimeUnit.MILLISECONDS)
                .exceptionally(error -> "fallback").join();
            System.out.println(value);
            System.out.println(pending.isCompletedExceptionally());
        } // Java 21 的 close 等待执行器任务结束
    }
}
预期结果:合并值为 25,未完成 Future 被超时异常完成。运行:
javac FutureDemo.java
java FutureDemo
预期输出:
25
fallback
true
风险与资源回收
orTimeout 不保证底层网络或计算停止,cancel(true) 也不保证 CompletableFuture 中的计算线程被中断。远程调用仍需连接、读取和总预算超时;任务要有自己的取消协议。不能把发生过副作用的写请求随意重复提交。
不要在有限线程池任务里 join 等待同池排队任务,应用 thenCompose 等方式表达依赖。恢复值必须具有业务含义,不能把鉴权失败或数据损坏一概伪装成成功。这里超时恢复仅示范机制;实际系统要记录根因,并明确哪些异常允许降级。Java 21 API 列出了阶段与超时约定。
保护共享状态并选择内置锁或显式锁。
使用 synchronized 与 Lock
多个线程共同执行“读取、修改、写回”时,必须用同一个锁保护整个状态变化。需要简单互斥时用 synchronized;需要可中断等待、超时尝试或多个条件队列时考虑 ReentrantLock。
锁的选择与用法
synchronized (lock) 在进入代码块时获取监视器,正常返回或抛异常都会释放。实例同步方法锁住 this;静态同步方法锁住对应类对象,二者不是同一把锁。不要锁住公开对象或字符串常量,避免外部代码意外参与竞争。
Lock.lock() 等待锁,unlock() 必须放在 finally 中;lockInterruptibly() 允许中断获取过程;tryLock(long, TimeUnit) 可超时并返回是否成功。只有成功获得锁后才能解锁,否则可能抛出 IllegalMonitorStateException。
验证计数完整性
保存为 LockDemo.java。两个线程分别给两个计数器递增,所有读写都通过各自同一把锁。
import java.util.concurrent.locks.ReentrantLock;

public class LockDemo {
    private final Object monitor = new Object();
    private final ReentrantLock lock = new ReentrantLock();
    private int syncCount;
    private int lockCount;
    void add() {
        synchronized (monitor) { syncCount++; }
        lock.lock();
        try { lockCount++; }
        finally { lock.unlock(); } // 包括异常路径也释放
    }
    void print() {
        synchronized (monitor) { System.out.println(syncCount); }
        lock.lock();
        try { System.out.println(lockCount); }
        finally { lock.unlock(); }
    }
    public static void main(String[] args) throws InterruptedException {
        LockDemo demo = new LockDemo();
        Runnable work = () -> { for (int i = 0; i < 1000; i++) demo.add(); };
        Thread a = new Thread(work), b = new Thread(work);
        a.start(); b.start();
        a.join(); b.join(); // 先等更新结束再检查结果
        demo.print();
    }
}
预期结果:两种方式均保留 2000 次更新。运行:
javac LockDemo.java
java LockDemo
预期输出:
2000
2000
风险与失败处理
volatile 只能解决适用场景的可见性与顺序,不能让 count++ 整体变成原子操作。读操作如果绕过锁,仍可能破坏一致性;多个相关字段应在同一临界区读取快照。
需要两把锁时固定获取顺序,避免线程 A 持锁甲等锁乙、线程 B 反过来。不要在锁内做慢网络请求。发生等待过长时采集线程转储检查持有者与等待者;盲目加大超时不会修复死锁。公平 ReentrantLock 会改变竞争策略,但不承诺操作系统调度公平,也不应作为性能优化默认开启。
private volatile boolean running = true;
private final AtomicInteger counter = new AtomicInteger();
counter.incrementAndGet() / counter.compareAndSet(<期望值>, <新值>)
保证可见性并完成常见的无锁原子更新。
使用 volatile 与原子类
当一个线程修改状态、其他线程需要立即观察时使用 volatile;当多个线程要对同一数值或引用执行无锁更新时使用 AtomicInteger、AtomicLong 或 AtomicReference。两者解决的问题不同:volatile 保证可见性和特定的有序性,原子类通过 CAS 保证单次复合更新不可分割。
基本语法
片段示例(需放在类中,并导入 java.util.concurrent.atomic.AtomicInteger):
private volatile boolean running = true;
private final AtomicInteger counter = new AtomicInteger();
前者用于发布状态,后者用于原子更新。读写 volatile 变量时,线程会按 Java 内存模型建立可见性关系;但 count++ 仍包含读取、加一、写回三个步骤,即使 count 被声明为 volatile 也会丢失更新。计数、自增、条件更新应改用原子类。
常用原子操作:
incrementAndGet():先加一,再返回新值。getAndIncrement():先返回旧值,再加一。compareAndSet(expect, update):仅当当前值等于期望值时更新。updateAndGet(fn):按函数计算新值,CAS 失败时可能重复执行函数。
高频用法
下面同时演示用 volatile 停止工作线程,以及用 AtomicInteger 完成并发计数。
import java.util.concurrent.atomic.AtomicInteger;

public class VolatileAtomicDemo {
    private static volatile boolean running = true;
    private static final AtomicInteger COUNTER = new AtomicInteger();

    public static void main(String[] args) throws InterruptedException {
        Thread worker = new Thread(() -> {
            while (running) {
                // 仅等待状态变化;真实业务不要长时间空转
                Thread.onSpinWait();
            }
        });

        worker.start();
        Thread.sleep(50);
        running = false;
        worker.join();

        Thread t1 = new Thread(() -> add(100_000));
        Thread t2 = new Thread(() -> add(100_000));
        t1.start();
        t2.start();
        t1.join();
        t2.join();

        System.out.println("worker stopped=" + !worker.isAlive());
        System.out.println("atomic count=" + COUNTER.get());
    }

    private static void add(int times) {
        for (int i = 0; i < times; i++) {
            COUNTER.incrementAndGet();
        }
    }
}
预期输出:
worker stopped=true
atomic count=200000
第一行说明主线程写入 running=false 后,工作线程能够观察到变化并退出;第二行说明两个线程的 20 万次自增没有丢失。
选择与边界
| 需求 | 推荐方式 | 不适合的写法 |
|---|---|---|
| 发布开关、配置快照、状态标记 | volatile |
用普通字段并依赖“通常能看到” |
| 精确自增、序号、并发状态转换 | 原子类 | volatile int 配合 ++ |
| 高并发统计且允许读取瞬时值 | LongAdder |
用它生成连续 ID |
| 多字段必须同时一致 | 锁或不可变对象整体替换 | 分别更新多个原子变量 |
AtomicReference 只保证引用替换原子,不会自动保护对象内部字段。多个字段存在一致性约束时,应把它们封装成不可变快照后整体 CAS,或直接使用 synchronized、Lock。
风险与排障清单
- 空转循环持续等待会占满 CPU;触发条件是线程长期执行
while (flag)。生产中优先使用CountDownLatch、Condition、阻塞队列或带超时的等待。 updateAndGet、getAndUpdate的函数可能因 CAS 竞争被重复调用;若函数包含扣款、发消息、写文件等副作用,可能重复执行。安全做法是只做纯计算,副作用放到成功更新之后。- 计数仍不正确时,检查是否混用了普通字段、是否在读取后又分步写回,以及原子变量是否被重新赋值。
- 线程无法退出时,检查循环是否实际读取了
volatile字段、是否被阻塞在其他调用中,并为join、锁等待和 I/O 设置超时。
兼容性
volatile 和基础原子类自 Java 5 起可用;示例中的 Thread.onSpinWait() 需要 Java 9 及以上。Java 8 可删除该调用,但空转等待仍会消耗 CPU,生产代码应改用阻塞同步工具。
速查:volatile 负责“看得见”,原子类负责“改得完整”;涉及多个变量的一致性时,不要强行无锁。
ConcurrentHashMap<K, V> map = new ConcurrentHashMap<>();  map.merge(k, 1, Integer::sum);
CopyOnWriteArrayList<E> / BlockingQueue<E> queue = new LinkedBlockingQueue<>(<容量>);
选择 ConcurrentHashMap、阻塞队列和写时复制集合。
使用并发集合
多线程共享容器时,优先使用 java.util.concurrent 中按访问模式设计的集合:并发读写键值数据用 ConcurrentHashMap,生产者与消费者之间传递任务用 BlockingQueue,读多写少的监听器或配置列表用 CopyOnWriteArrayList。
集合定位
| 场景 | 推荐类型 | 关键特性 |
|---|---|---|
| 高频并发查询和更新 | ConcurrentHashMap |
读操作通常不阻塞,支持原子 compute、merge |
| 有界任务缓冲 | ArrayBlockingQueue |
固定容量,可形成背压 |
| 通用阻塞队列 | LinkedBlockingQueue |
可指定容量,默认容量过大应谨慎 |
| 读多写极少的列表 | CopyOnWriteArrayList |
迭代使用快照,写入会复制底层数组 |
不要用 Collections.synchronizedMap 替代所有并发集合。它通过单锁串行化访问,复合遍历还需要手动同步;并发量较高时通常不如专用集合。
高频用法
下面演示原子累加、阻塞队列传递数据,以及写时复制列表的快照迭代。
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.CopyOnWriteArrayList;

public class ConcurrentCollectionsDemo {
    public static void main(String[] args) throws InterruptedException {
        ConcurrentHashMap<String, Integer> counts = new ConcurrentHashMap<>();

        Thread t1 = new Thread(() -> add(counts, 2_000));
        Thread t2 = new Thread(() -> add(counts, 2_000));
        t1.start();
        t2.start();
        t1.join();
        t2.join();

        ArrayBlockingQueue<String> queue = new ArrayBlockingQueue<>(2);
        List<String> consumed = new ArrayList<>();

        Thread consumer = new Thread(() -> {
            try {
                for (String value; !(value = queue.take()).equals("<END>"); ) {
                    consumed.add(value);
                }
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });

        consumer.start();
        queue.put("A");
        queue.put("B");
        queue.put("<END>");
        consumer.join();

        CopyOnWriteArrayList<String> listeners =
                new CopyOnWriteArrayList<>(List.of("log"));
        List<String> snapshot = new ArrayList<>();
        for (String listener : listeners) {
            snapshot.add(listener);
            listeners.add("metrics");
        }

        System.out.println("map count=" + counts.get("ok"));
        System.out.println("queue order=" + consumed);
        System.out.println("snapshot=" + snapshot);
        System.out.println("current=" + listeners);
    }

    private static void add(ConcurrentHashMap<String, Integer> map, int times) {
        for (int i = 0; i < times; i++) {
            // merge 将读取、计算和写回作为单键原子更新执行
            map.merge("ok", 1, Integer::sum);
        }
    }
}
预期输出:
map count=4000
queue order=[A, B]
snapshot=[log]
current=[log, metrics]
merge 避免了“先读取再写回”的竞态;ArrayBlockingQueue 保持 FIFO,队列满时 put 会等待;写时复制列表的迭代器读取创建时的快照,因此遍历期间新增的 metrics 只会出现在当前列表中。
常用操作与边界
ConcurrentHashMap 的单个 putIfAbsent、compute、merge 是原子的,但多键更新不是事务。需要同时修改多个键并保持一致时,应增加外部锁、改用单个不可变状态对象,或把一致性放到数据库事务中。
阻塞队列常用方法:
put、take:一直等待,适合必须交付的数据。offer(value, timeout, unit)、poll(timeout, unit):有超时,生产服务更容易降级和退出。add:队列满时抛出异常,通常不适合流量突增路径。remainingCapacity:仅是瞬时观察,不能据此先判断再无阻塞写入。
CopyOnWriteArrayList 每次写入都会复制整个数组。它适合监听器、路由规则快照等“小集合、读远多于写”的场景,不适合频繁增删或大列表。
风险与排障清单
ConcurrentHashMap中执行get后再put会产生检查后执行竞态;触发条件是多个线程更新同一键。改用computeIfAbsent、compute或merge。- 无界或超大
LinkedBlockingQueue在消费者变慢时会持续积压,最终导致高内存和长延迟。安全替代是设置明确容量,并用超时offer、拒绝策略或限流形成背压。 - 阻塞线程被中断后若吞掉
InterruptedException,应用可能无法正常停机。清理必要状态后调用Thread.currentThread().interrupt(),或把中断继续向上抛出。 CopyOnWriteArrayList写入延迟突然升高时,检查集合大小和修改频率;改用加锁的普通列表、并发队列或不可变快照批量替换。- 结果数量偶尔不一致时,确认业务是否误把
size()、遍历结果或多个独立操作当成同一时刻的事务快照。
兼容性
这些并发集合自 Java 5 起可用;示例中的 List.of 需要 Java 9 及以上。Java 8 可用 Arrays.asList("log") 创建初始列表,其余并发语义不变。
速查:先按访问模式选集合,再使用它提供的原子或阻塞方法;“线程安全集合”不等于“多步业务操作自动原子化”。
保存线程上下文并避免在线程池中产生数据泄漏。
使用 ThreadLocal
同一线程里的多个调用需要读取请求上下文时,可以用 ThreadLocal 保存该线程的值。线程池会复用线程,因此每次请求结束必须清理,避免下一个请求读到前一个请求的身份或追踪信息。
基本操作
ThreadLocal<T>.get() 返回当前线程的值,首次读取时使用 initialValue();默认初值为 null。set(T value) 设置当前线程值;remove() 移除该线程值,下一次读取会重新初始化。withInitial(Supplier<? extends S>) 可以提供每线程的初值工厂。
它不把同一个变量自动传播给新线程,也不替代共享对象的锁。若把同一个可变对象分别设置到多个线程,它们仍共享该对象。在线程池、异步阶段或响应式调用跨线程时,应显式传递上下文,或使用框架提供且已配置的传播机制。
在线程复用后验证清理
保存为 LocalContext.java。使用单线程池确保两次任务一定复用同一个工作线程,第二次任务检查是否还有旧值。
import java.util.concurrent.*;

public class LocalContext {
    private static final ThreadLocal<String> REQUEST = new ThreadLocal<>();
    public static void main(String[] args) throws Exception {
        try (ExecutorService pool = Executors.newSingleThreadExecutor()) {
            pool.submit(() -> {
                REQUEST.set("request-A");
                try {
                    System.out.println(REQUEST.get());
                } finally {
                    REQUEST.remove(); // 任务结束即清理,不能等线程池销毁
                }
            }).get();
            String next = pool.submit(() -> REQUEST.get()).get();
            System.out.println(next == null ? "clean" : next);
        } // Java 21 自动关闭执行器
    }
}
预期结果:第一个请求可读到自身上下文,复用线程的后续任务读取为空。运行:
javac LocalContext.java
java LocalContext
预期输出:
request-A
clean
泄漏与嵌套调用
不要只在成功返回前清理,异常路径也必须经过 finally。线程长期存活时,未清理的值可能保留大对象,也可能造成跨请求数据污染。将变量改成非静态不会自动解决问题,键引用与值引用的生命周期并不相同。
如果同一线程支持嵌套上下文,内层结束时通常应恢复进入前的值,而不是一律 remove;应把“设置、恢复”封装成受控作用域。使用 InheritableThreadLocal 也不能正确覆盖线程池里每次任务的上下文,线程创建时的继承与任务提交是两件事。
排查时在入口、出口和复用后的任务读取上下文,避免打印敏感身份信息。已出现污染时先修复所有清理路径,再验证复用与异常两种情况。Java 21 ThreadLocal 文档 给出读取、移除和重新初始化规则。
@Test void <方法名>() { assertEquals(<期望>, <实际>); }
assertThrows(<异常>.class, () -> <调用>);
mvn test / ./gradlew test
编写基础断言、异常测试和参数化单元测试。
编写 JUnit 5 测试
JUnit 5 单元测试应覆盖正常结果、异常分支和多组边界输入。下面给出一个可直接执行的 Maven 示例,运行后可从测试数量、失败数和错误数判断结果。
项目配置
创建 Maven 项目并保存以下 pom.xml。示例固定使用 JUnit Jupiter 5.10.2;现有项目可沿用自己的依赖管理版本。
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>example</groupId>
    <artifactId>junit-demo</artifactId>
    <version>1.0-SNAPSHOT</version>

    <properties>
        <maven.compiler.release>17</maven.compiler.release>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <junit.version>5.10.2</junit.version>
    </properties>

    <dependencies>
        <dependency>
            <groupId>org.junit.jupiter</groupId>
            <artifactId>junit-jupiter</artifactId>
            <version>${junit.version}</version>
            <scope>test</scope>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-surefire-plugin</artifactId>
                <version>3.2.5</version>
            </plugin>
        </plugins>
    </build>
</project>
test 作用域只在编译和执行测试时生效,不会打入生产运行依赖。Surefire 负责在 Maven 生命周期的 test 阶段发现并运行 JUnit 测试。
完整测试示例
将文件保存为 src/test/java/example/CalculatorTest.java。assertEquals 验证普通结果,assertThrows 验证异常类型和消息,@CsvSource 将四组输入分别执行为独立测试。
package example;

import org.junit.jupiter.api.Test;
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.CsvSource;

import static org.junit.jupiter.api.Assertions.assertEquals;
import static org.junit.jupiter.api.Assertions.assertThrows;

class CalculatorTest {
    private final Calculator calculator = new Calculator();

    @Test
    void addShouldReturnSum() {
        assertEquals(5, calculator.add(2, 3));
    }

    @Test
    void divideByZeroShouldThrow() {
        ArithmeticException exception = assertThrows(
                ArithmeticException.class,
                () -> calculator.divide(10, 0)
        );
        // 同时校验消息,防止误捕获其他算术异常
        assertEquals("/ by zero", exception.getMessage());
    }

    @ParameterizedTest(name = "{0} is even: {1}")
    @CsvSource({
            "2, true",
            "3, false",
            "0, true",
            "-5, false"
    })
    void shouldDetectEven(int input, boolean expected) {
        assertEquals(expected, calculator.isEven(input));
    }

    static final class Calculator {
        int add(int left, int right) {
            return left + right;
        }

        int divide(int dividend, int divisor) {
            return dividend / divisor;
        }

        boolean isEven(int value) {
            return value % 2 == 0;
        }
    }
}
在包含 pom.xml 的目录执行:
mvn test预期结果包含:
[INFO] Tests run: 6, Failures: 0, Errors: 0, Skipped: 0
[INFO] BUILD SUCCESS
参数化方法按四行数据执行四次,因此总数为 6。若断言不通过,Failures 增加;测试代码抛出未预期异常时,Errors 增加。
断言选择
- 值比较使用
assertEquals(expected, actual),参数顺序不要写反,否则失败信息难读。 - 只验证异常类型时使用
assertThrows;还需验证消息或业务字段时,接收其返回的异常对象继续断言。 - 多组结构相同的输入使用
@ParameterizedTest,避免复制多个仅数据不同的测试方法。 - 浮点数比较应提供误差范围,例如
assertEquals(0.3, actual, 1e-9),不要直接比较计算结果是否完全相等。
风险与边界
- 触发条件:测试依赖当前时间、随机数、网络、数据库或执行顺序。可能后果:本机通过、CI 偶发失败。安全替代:注入固定时钟、固定随机种子,并用 Fake、Stub 或临时测试容器隔离外部依赖。
- 不要只断言“没有抛异常”;至少验证返回值、状态变化或协作者调用结果,否则测试可能在逻辑失效后仍然通过。
- 参数化测试中每行数据都是独立用例。某一行失败时先读取显示名称和输入值,不要只看方法名。
- 单元测试不应共享可变静态数据;若必须准备公共资源,应在每次测试前重置,避免顺序依赖。
排障清单
- 显示
Tests run: 0时,检查文件名是否符合*Test、测试是否位于src/test/java,以及是否导入org.junit.jupiter.api.Test。 - 出现
No tests were executed时,检查 Surefire 与 JUnit 5 依赖是否同时存在,避免只引入旧版 JUnit 4。 - IDE 通过但 Maven 失败时,核对 IDE 使用的 JDK、项目
maven.compiler.release和命令行java -version是否一致。 - 参数无法转换时,检查
@CsvSource的列数、目标参数类型及空字符串写法。
速查结果:先看总测试数是否符合预期,再看 Failures、Errors 和 Skipped,最后定位首个失败用例的断言差异。
private static final Logger log = LoggerFactory.getLogger(<类名>.class);
log.info("<消息> key={}", <值>);  log.error("<消息>", <异常>);
选择日志级别、记录异常堆栈并使用上下文定位请求。
记录与分析日志
用于在生产环境按严重程度记录事件,并通过 traceId、线程名和异常堆栈把同一次请求的日志串起来。核心原则是:级别可筛选、字段可检索、异常必须保留完整堆栈。
日志级别怎么选
| 级别 | 什么时候记录 | 典型内容 |
|---|---|---|
ERROR |
当前操作失败,需要人工关注或告警 | 支付失败、数据库不可用、关键任务终止 |
WARN |
已降级或存在风险,但请求仍可继续 | 重试后成功、缓存失效、参数接近上限 |
INFO |
关键业务节点和状态变化 | 请求进入、订单状态变更、任务完成 |
DEBUG |
排障时需要的中间变量和分支 | 路由结果、计算明细、第三方响应摘要 |
TRACE |
极细粒度执行轨迹,仅短时启用 | 循环内步骤、框架内部调用 |
生产默认通常保留 INFO 及以上。不要把预期内的参数校验失败全部记为 ERROR,否则会稀释真正故障;也不要长期打开 DEBUG,否则可能增加磁盘、网络与检索成本。
可运行示例
下面使用 SLF4J、Logback 和 MDC。MDC 将 traceId 放入当前线程上下文,日志格式自动输出该值。
<!-- pom.xml -->
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>example</groupId>
  <artifactId>logging-demo</artifactId>
  <version>1.0.0</version>
  <properties>
    <maven.compiler.release>17</maven.compiler.release>
  </properties>
  <dependencies>
    <dependency>
      <groupId>ch.qos.logback</groupId>
      <artifactId>logback-classic</artifactId>
      <version>1.5.18</version>
    </dependency>
  </dependencies>
  <build>
    <plugins>
      <plugin>
        <groupId>org.codehaus.mojo</groupId>
        <artifactId>exec-maven-plugin</artifactId>
        <version>3.5.0</version>
      </plugin>
    </plugins>
  </build>
</project><!-- src/main/resources/logback.xml -->
<configuration>
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} %-5level [%thread] traceId=%X{traceId:-N/A} %logger{24} - %msg%n</pattern>
</encoder>
</appender>
<root level="INFO">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>// src/main/java/example/LoggingDemo.java
package example;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.slf4j.MDC;
public class LoggingDemo {
private static final Logger log = LoggerFactory.getLogger(LoggingDemo.class);
public static void main(String[] args) {
MDC.put("traceId", "req-1001");
try {
log.info("开始处理订单 orderNo={}", "P202608020001");
int amount = parseAmount("bad-value");
log.info("订单处理完成 amount={}", amount);
} catch (IllegalArgumentException ex) {
// 传入异常对象,Logback 才会输出异常类型、消息和完整调用栈。
log.error("订单处理失败 orderNo={}", "P202608020001", ex);
} finally {
// 线程池会复用线程,不清理会让后续请求继承错误的 traceId。
MDC.clear();
}
}
private static int parseAmount(String value) {
try {
return Integer.parseInt(value);
} catch (NumberFormatException ex) {
throw new IllegalArgumentException("金额格式非法: " + value, ex);
}
}
}mvn -q package
mvn -q exec:java -Dexec.mainClass=example.LoggingDemo预期输出如下,时间、线程名和堆栈行号可能不同。
<TIME> INFO  [example.LoggingDemo.main()] traceId=req-1001 example.LoggingDemo - 开始处理订单 orderNo=P202608020001
<TIME> ERROR [example.LoggingDemo.main()] traceId=req-1001 example.LoggingDemo - 订单处理失败 orderNo=P202608020001
java.lang.IllegalArgumentException: 金额格式非法: bad-value
    at example.LoggingDemo.parseAmount(LoggingDemo.java:<LINE>)
Caused by: java.lang.NumberFormatException: For input string: "bad-value"
读取时先按 traceId=req-1001 聚合同一次请求,再看第一条 ERROR 的异常类型和最底层 Caused by,最后回溯此前的 INFO、WARN 判断请求走过哪些关键节点。
高频用法
记录参数时使用占位符,不提前拼接字符串:
log.info("支付完成 orderNo={} amount={} currency={}", orderNo, amount, currency);记录异常时把异常对象作为最后一个参数:
log.error("调用通道失败 channel={} requestId={}", channel, requestId, ex);跨线程提交任务时,MDC 默认不会自动传播。应在提交前复制上下文,在任务结束时清理,或使用框架提供的任务装饰器;不能只在入口线程设置一次。
风险与边界
记录银行卡号、密码、令牌、身份证号或完整请求体会造成敏感信息泄露,且日志通常会被长期保存。安全做法是白名单记录业务标识,对账号和证件脱敏,对令牌完全省略。
在高频循环中打印 INFO 或开启全局 DEBUG 会导致日志量暴涨,可能占满磁盘并拖慢应用。应降低级别、采样记录,并配置按大小或日期滚动及保留天数。
只记录 ex.getMessage() 会丢失异常类型、调用链和根因。排障日志应记录完整异常对象;对同一异常只在最能说明失败边界的一层记录一次,避免重复堆栈。
排障清单
- 按
traceId、订单号或请求号检索完整时间线,不只看最后一条错误。 - 从最底层
Caused by开始确认根因,再判断上层包装异常。 - 核对错误发生前最后一个成功业务节点,以及线程名是否发生变化。
- 检查日志级别、Appender、磁盘空间和滚动策略,排除“代码已记录但文件未写入”。
- 线程池场景确认 MDC 已传播并在
finally中清理。
速查提示:日志应回答“哪次请求、哪个对象、执行到哪里、因为什么失败”,而不是只输出一句“系统异常”。
快速区分堆、栈、元空间和常见垃圾收集过程。
理解 JVM 内存与 GC
Java 进程内存持续增长时,先区分堆、线程栈、元空间与堆外区域。-Xmx 只限制 Java 堆,不能视为整个进程内存上限;GC 也不会修复仍被引用的对象持续增长。
区域与现象
| 区域 | 常见内容 | 首先查看 |
|---|---|---|
| Java 堆 | 普通对象、数组 | 堆使用、分配速率、存活对象 |
| 平台线程栈 | 方法帧与局部状态 | 线程数量、递归深度、-Xss |
| 元空间 | 类元数据 | 类加载数量、类加载器是否可回收 |
| 堆外与其他本地内存 | 直接缓冲区、代码缓存等 | 进程内存与本地分类统计 |
局部引用与所指对象不是同一个区域概念;JIT 优化也可能改变实际分配,不能用源码变量位置推断每个对象的物理位置。
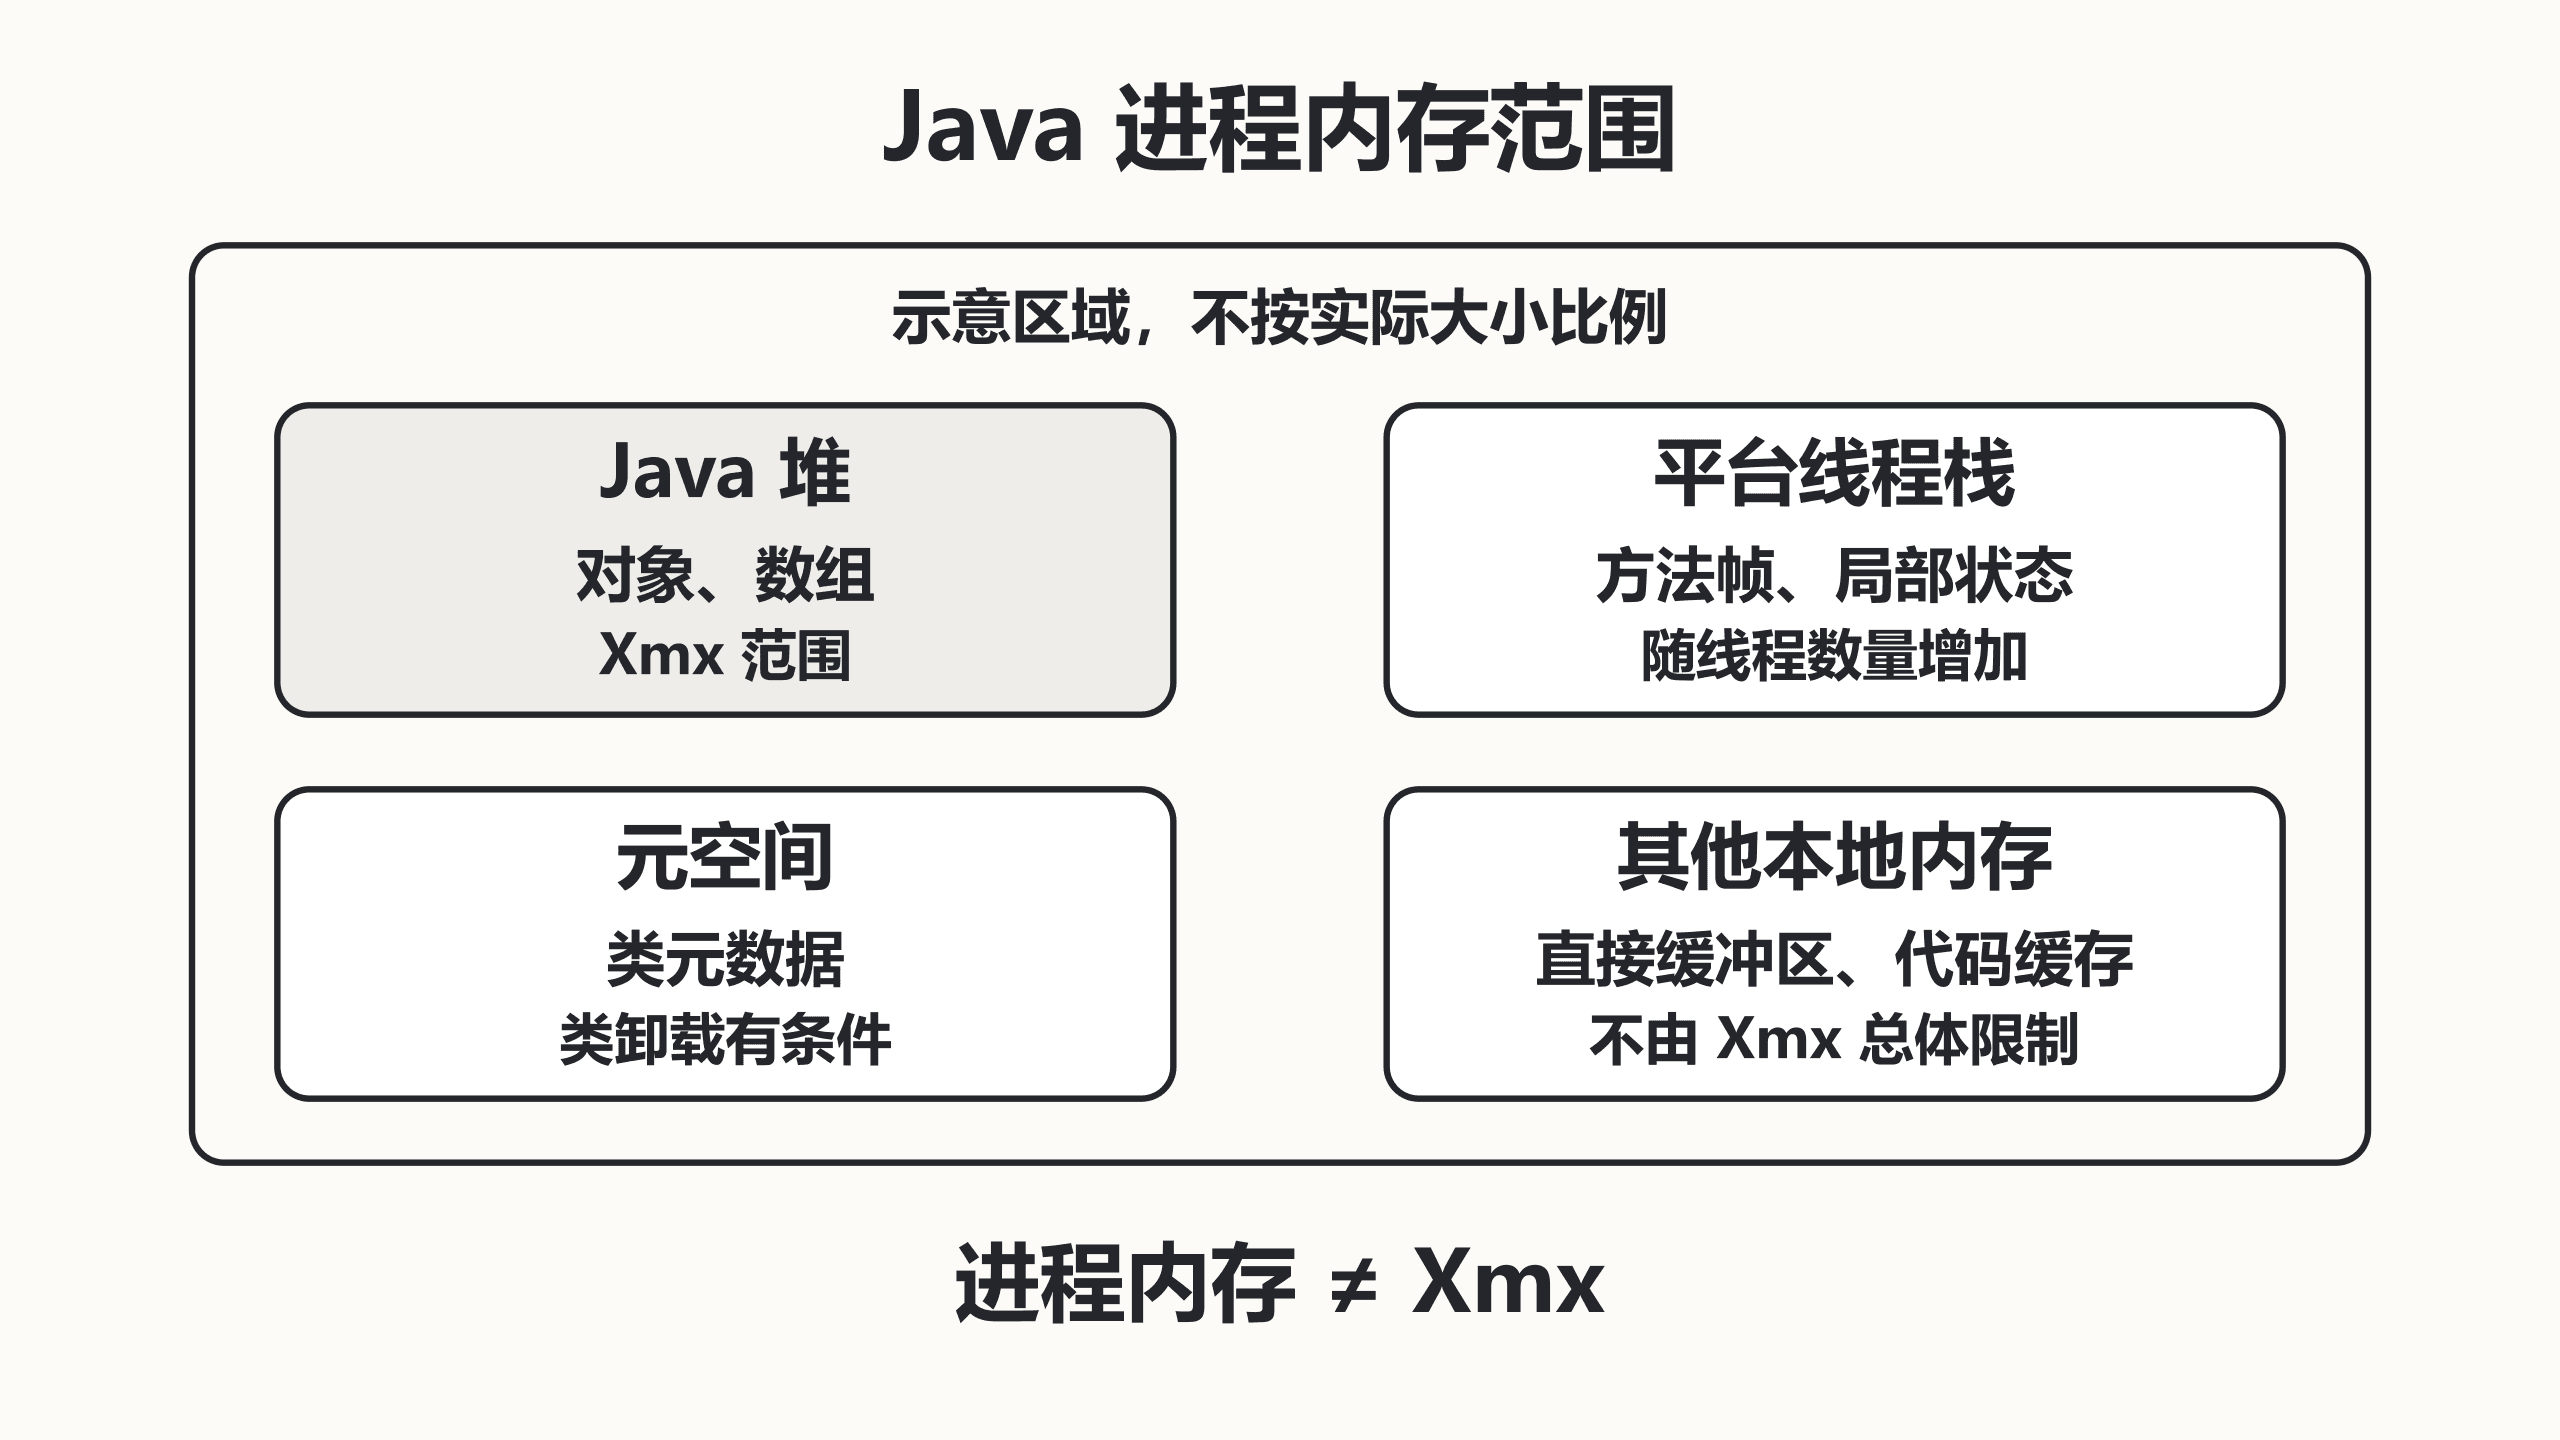
最小观察示例
保存为 MemoryRegions.java。分配少量堆数组与直接缓冲区,输出其逻辑容量;不把这些数值伪装成真实进程占用,也不强制制造 OOM。
import java.nio.ByteBuffer;

public class MemoryRegions {
    public static void main(String[] args) {
        byte[] heap = new byte[1024 * 1024];
        ByteBuffer direct = ByteBuffer.allocateDirect(1024 * 1024);
        // 明确两种容量,直接缓冲区仍有一个堆上的包装对象
        System.out.println("heap-array=" + heap.length);
        System.out.println("direct-capacity=" + direct.capacity());
        System.out.println("max-heap-positive=" +
            (Runtime.getRuntime().maxMemory() > 0));
    }
}
预期结果:两种缓冲容量都为 1 MiB。JDK 21 运行并记录 GC 日志:
javac MemoryRegions.java
java -Xms32m -Xmx64m -Xlog:gc:file=memory-gc.log MemoryRegions
预期输出:
heap-array=1048576
direct-capacity=1048576
max-heap-positive=true
预期结果:当前目录生成 memory-gc.log。程序很短,可能只有初始化记录,没有回收事件;这不代表参数未生效。
GC 与调参边界
对象从 GC 根不可达后才具备回收条件,释放时间不由局部变量出作用域直接保证。G1 等收集器会有年轻代或更广范围的回收活动,并包含并发阶段及暂停阶段;不能把所有日志里的回收事件都叫 Full GC。日志标识、暂停时长和回收前后占用应一起读。
先在固定负载下观察多轮回收后基线是否持续增长,再判断泄漏。频繁分配但回收后基线稳定可能是分配压力;堆稳定而进程内存上涨应继续检查线程和本地内存。只增大 -Xmx 可能挤占其他区域。修改参数前保留原值和基线,异常时恢复原启动配置并滚动重启,不在所有实例同时试验。
java [JVM参数] -jar <PATH>/app.jar [应用参数]
-Xms<大小> -Xmx<大小> -XX:+UseG1GC -XX:+HeapDumpOnOutOfMemoryError
配置堆大小、垃圾收集器、错误转储和系统属性。
配置常用 JVM 参数
用启动参数一次性控制堆大小、垃圾收集器、OOM 转储和系统属性;部署后再通过 JVM 自身命令核对实际生效值,避免只看启动脚本。
基本语法
JVM 参数必须放在 -jar 和应用参数之前;-Dkey=value 是系统属性,应用可通过 System.getProperty 读取。
java [JVM参数] -jar <PATH>/app.jar [应用参数]这是语法模板,不可直接执行。若把 -Xmx 或 -D 写到 JAR 之后,它们通常会被当作应用参数,堆大小和系统属性不会生效。
常用参数
| 参数 | 作用 | 速查建议 |
|---|---|---|
-Xms512m |
初始堆大小 | 稳定服务可与 -Xmx 设为相同值,减少运行期扩容 |
-Xmx1024m |
最大堆大小 | 必须为线程栈、Metaspace、直接内存和本地库留余量 |
-XX:+UseG1GC |
使用 G1 收集器 | 适合现代 JDK 的通用低停顿场景,调整前先观察 GC 指标 |
-XX:+HeapDumpOnOutOfMemoryError |
Java 堆 OOM 时生成转储 | 与可写的 HeapDumpPath 配套 |
-XX:HeapDumpPath=<PATH>/heapdump.hprof |
指定转储位置 | 使用绝对路径和独立数据盘 |
-Dspring.profiles.active=prod |
设置系统属性 | Spring Boot 用于激活 prod Profile |
可运行验证
下面的探针同时验证最大堆、垃圾收集器参数是否被接受,以及系统属性能否读取。
public class JvmProbe {
    public static void main(String[] args) {
        long maxMiB = Runtime.getRuntime().maxMemory() / 1024 / 1024;
        System.out.println("app.env=" + System.getProperty("app.env"));
        System.out.println("maxHeapMiB=" + maxMiB);
    }
}javac JvmProbe.java
java \
-Xms128m \
-Xmx256m \
-XX:+UseG1GC \
-XX:+HeapDumpOnOutOfMemoryError \
-XX:HeapDumpPath=./heapdump.hprof \
-Dapp.env=prod \
JvmProbe预期输出
app.env=prod
maxHeapMiB=256
把同类参数放到生产命令的 -jar 之前即可。此示例不会主动制造 OOM,因此正常情况下不会生成 heapdump.hprof。
运行时核对
jcmd <PID> VM.flags
jcmd <PID> VM.system_properties | grep '^spring.profiles.active='
预期输出
<PID>:
-XX:InitialHeapSize=<BYTES> -XX:MaxHeapSize=<BYTES> -XX:+UseG1GC ...
spring.profiles.active=prod<PID>、字节数和完整标志列表会随进程变化;重点确认最大堆、收集器和目标属性是否出现。
风险与边界
-Xmx 接近容器内存上限时,堆外内存、线程栈、Metaspace 和本地库仍会继续占用内存,可能触发容器 OOM Kill,且来不及生成堆转储。安全做法是为非堆内存留出余量,并结合容器限制压测。
转储路径不可写或磁盘不足时,OOM 发生后可能没有 .hprof,甚至进一步占满系统盘。优先写入独立数据盘,提前检查权限和剩余空间,并设置转储文件清理流程。
频繁更换垃圾收集器而不观察停顿和吞吐,可能让延迟更差。没有明确证据时先保留当前收集器,只调整堆容量,并通过 GC 日志或监控验证结果。
兼容性
G1 在现代 JDK 中可直接使用;老旧 JDK 的容器内存识别和日志参数存在差异。升级 JDK 后应重新执行 jcmd <PID> VM.flags,不要假设旧启动脚本的全部参数仍被接受。
结合 jcmd、jstack 和线程转储定位忙循环与锁等待。
排查高 CPU 与线程阻塞
Java 服务 CPU 高或请求停滞时,先确认目标进程,再对照线程 CPU 增量和多次线程转储。RUNNABLE 不直接证明正在消耗 CPU,BLOCKED 也不直接证明死锁,必须结合线程栈和锁持有者判断。
前置条件与采样目标
下面使用 JDK 21、Windows PowerShell 与同一用户运行的本机 JVM。使用目标 JDK 的诊断工具;附加可能被权限、容器边界或禁用 Attach 的参数阻止。不要对 PID 0 或按模糊主类名批量发送诊断命令,避免误采集其他实例。
建立可控现场
保存为 ThreadProbe.java,在第一个终端执行 java ThreadProbe.java。它仅运行约 20 秒:一个线程忙循环,另一个等待主线程持有的监视器。没有网络操作,不应把该忙循环放入生产服务。
import java.util.concurrent.atomic.AtomicBoolean;

public class ThreadProbe {
    public static void main(String[] args) throws Exception {
        Object lock = new Object();
        AtomicBoolean running = new AtomicBoolean(true);
        Thread busy = new Thread(() -> {
            while (running.get()) Thread.onSpinWait(); // 仅用于制造诊断现场
        }, "busy-demo");
        Thread blocked = new Thread(() -> {
            synchronized (lock) { System.out.println("lock-acquired"); }
        }, "blocked-demo");
        synchronized (lock) {
            busy.start();
            blocked.start();
            System.out.println("pid=" + ProcessHandle.current().pid());
            Thread.sleep(20_000); // 主线程持锁,供第二终端采样
            running.set(false);
        }
        busy.join(); blocked.join(); // 结束后不遗留测试线程
    }
}
预期输出:先输出 pid=<PID>,约 20 秒后输出 lock-acquired 并退出;实际 PID 每次不同。若来不及采样,重新运行这个测试程序获得新 PID。
关联 CPU 与线程栈
在第二个 PowerShell 终端输入刚才的 PID。脚本先取两次累计 CPU 时间之差,然后保存三次转储与一份 jstack,文件名带时间戳避免覆盖既有现场。
$jvmPid = [int](Read-Host 'ThreadProbe PID')
$before = @{}
(Get-Process -Id $jvmPid).Threads | ForEach-Object {
    $before[$_.Id] = $_.TotalProcessorTime.TotalMilliseconds
}
Start-Sleep -Seconds 1
(Get-Process -Id $jvmPid).Threads | ForEach-Object {
    if ($before.ContainsKey($_.Id)) {
        [pscustomobject]@{Tid=$_.Id; Nid=('0x{0:x}' -f $_.Id);
            CpuMs=($_.TotalProcessorTime.TotalMilliseconds - $before[$_.Id])}
    }
} | Sort-Object CpuMs -Descending | Select-Object -First 5
$stamp = Get-Date -Format 'yyyyMMdd-HHmmss-fff'
1..3 | ForEach-Object {
    jcmd $jvmPid Thread.print -l | Set-Content "threads-$stamp-$_.txt"
    Start-Sleep -Seconds 1
}
jstack -l $jvmPid | Set-Content "jstack-$stamp.txt"
预期结果:表格显示 Tid、十六进制 Nid 与近一秒的 CpuMs;忙循环线程通常居前,但不承诺名次或固定数值。当前目录产生四个非空转储文件。搜索 busy-demo,用其 nid 对照表格;搜索 blocked-demo,可见 BLOCKED、等待的监视器及持有该监视器的主线程。
证据解读与恢复
忙循环在多次转储里停留在同一段计算代码,并持续消耗 CPU,才支持该热点判断。WAITING 可能只是线程池空闲;显式锁等待常显示为停驻等待,不能只搜 BLOCKED。多个线程各自持锁并互等时,再结合死锁检测结果确认闭环。
线程转储会增加短暂开销,并可能包含路径或业务信息,应限制权限和保存期限。先结束测试现场、修复循环退出条件或缩短锁内操作,再在相同负载下复测。无法附加时核对进程是否已退出、用户权限与 JVM 配置,不盲目重启全部服务。jcmd 文档 说明了本机附加条件与命令选择方式。
采集堆转储并区分堆、元空间和直接内存问题。
排查内存泄漏与 OOM
出现 OutOfMemoryError 时,先保留完整错误文本、启动参数和容器内存限制,再决定采集什么。堆空间、元空间、直接内存或本地线程创建失败需要不同证据,不能全部归因于 Java 堆泄漏。
根据错误选择证据
| 现象 | 优先检查 | 不足以单独证明 |
|---|---|---|
Java heap space |
堆上限、存活对象和引用链 | 堆大就一定泄漏 |
Metaspace |
类加载器数量与类卸载 | 增大堆能解决 |
| 直接缓冲分配失败 | 直接缓冲使用、进程本地内存 | 堆转储等于全部本地字节 |
unable to create native thread |
线程数量、系统限制、进程可用内存 | 一定是堆耗尽 |
操作系统直接终止进程时可能没有 Java 异常或堆转储,要查看退出状态与系统/容器事件。一次内存峰值也不是泄漏;固定负载下,多轮回收后存活对象基线持续增长才是重要信号。
用小进程验证采集
保存为 HeapProbe.java,在第一个终端执行 java -Xmx64m HeapProbe.java。它只保留两个小数组供观察,不故意耗尽机器内存。
import java.util.ArrayList;
import java.util.List;

public class HeapProbe {
    private static final List<byte[]> KEEP = new ArrayList<>();
    public static void main(String[] args) throws Exception {
        KEEP.add(new byte[1024 * 1024]);
        KEEP.add(new byte[1024 * 1024]); // 静态集合保持可达,供查看引用链
        System.out.println("pid=" + ProcessHandle.current().pid());
        System.out.println("retained=" + KEEP.size());
        Thread.sleep(30_000); // 采集窗口结束后自动退出
    }
}预期输出:pid=<PID> 和 retained=2,约 30 秒后退出。PID 是动态值。另一个 PowerShell 终端执行下面脚本,只针对刚才的测试 PID。
$jvmPid = [int](Read-Host 'HeapProbe PID')
$stamp = Get-Date -Format 'yyyyMMdd-HHmmss-fff'
$dumpFile = Join-Path (Get-Location) "heap-$jvmPid-$stamp.hprof"
jcmd $jvmPid VM.flags
jcmd $jvmPid GC.heap_info
jcmd $jvmPid GC.heap_dump $dumpFile
Get-Item -LiteralPath $dumpFile | Select-Object Name,Length
预期结果:看到启动标志、堆使用信息与堆转储成功消息;最后表格列出新建 .hprof 文件且 Length 大于 0。具体大小与耗时受 JVM 状态影响,不能据此推断业务泄漏。附加失败时先核对 PID、进程是否退出与同用户权限。
从转储寻找保留原因
在支持 HPROF 的分析器中查看支配树、保留大小和到 GC 根的路径;本例两个数组由 HeapProbe.KEEP 保留。业务中要回答“谁持有、为什么还持有、何时应释放”,再核对缓存容量、监听器注销、线程上下文清理等生命周期。对比两份相同负载阶段的转储比只看一次对象数量更可靠。
必要时下次启动配置 -XX:+HeapDumpOnOutOfMemoryError 与 -XX:HeapDumpPath=<PATH>,将占位符替换为已有、可写且容量充足的受限目录。这是启动参数片段,不能附加到已运行进程;也不保证所有原生分配失败都能生成转储。Java 启动参数说明 给出这些选项的适用范围。
采集风险与恢复
堆转储可能暂停服务、占用大量磁盘并包含密码或个人数据。GC.heap_dump 默认会请求一次完整回收;先用目标进程的 help GC.heap_dump 核对选项。生产采集应选择有容量和访问控制的目录,避免覆盖旧证据,并评估暂停窗口。jcmd 命令说明 标注其影响等级。
确认泄漏后限制增长源、清理失效引用并复测;单纯扩大 -Xmx 只能推迟故障,还可能导致系统内存不足。临时重启应保留现场并按实例滚动进行,不能把重启当成修复结论。测试转储在不再需要后可按明确文件路径删除,不要递归清理整个工作目录。
定位 ClassNotFoundException、NoClassDefFoundError 和版本冲突。
排查类加载与依赖冲突
出现“找不到类”或方法链接失败时,先区分查找失败、初始化失败与版本不匹配。保留最早的异常及其 Caused by,后续重试中的异常名称可能只显示结果,掩盖第一次失败原因。
异常与定位方向
| 异常 | 典型方向 |
|---|---|
ClassNotFoundException |
显式按名称加载时没有找到目标类 |
NoClassDefFoundError |
运行需要的类定义不可用,或类先前初始化失败 |
NoSuchMethodError |
运行时类存在,但版本缺少已编译调用的方法 |
UnsupportedClassVersionError |
类文件版本超过运行时支持范围 |
异常类型不是唯一根因。NoClassDefFoundError 不能一概通过“补一个 JAR”处理;若类初始化已经失败,应回看第一次抛出的初始化异常。
对比查找与初始化失败
保存为 LoadingDemo.java。不依赖外部 JAR,演示按名称加载缺失类,以及同一 JVM 中类初始化首次与再次访问的区别。
public class LoadingDemo {
    static class BadConfig {
        static final int VALUE = load();
        static int load() {
            throw new IllegalStateException("invalid demo config");
        }
    }
    public static void main(String[] args) {
        try {
            Class.forName("demo.definitely.MissingClass");
        } catch (ClassNotFoundException ex) {
            System.out.println(ex.getClass().getSimpleName());
        }
        for (int i = 0; i < 2; i++) {
            try {
                System.out.println(BadConfig.VALUE);
            } catch (LinkageError error) {
                // 仅在这个教学入口捕获,比较两次访问的异常
                System.out.println(error.getClass().getSimpleName());
            }
        }
    }
}
预期结果:缺失类查找失败;首次初始化失败后,同一类在该加载器中不再成功初始化。JDK 21 执行:
javac LoadingDemo.java
java -Xlog:class+load=info:file=class-load.log -cp . LoadingDemo
预期输出:
ClassNotFoundException
ExceptionInInitializerError
NoClassDefFoundError
预期结果:当前目录另有 class-load.log,可查看加载来源;日志含 JDK 自身类,不要把所有记录都视为项目依赖。测试例子的根因是故意写入的无效初始化,不应在应用里捕获错误后继续假装配置可用。
检查真实依赖
先对照编译 JDK、运行 JDK、启动命令和部署包。可运行诊断命令 java -version;预期输出版本和运行时信息,其数值以实际环境为准。检查类所在 JAR 是否确实进入运行 classpath,测试依赖或仅编译期依赖不会自动成为生产运行依赖。
对同名类检查实际加载来源,再与构建工具的依赖树核对。修复冲突应统一版本或排除明确的传递依赖,而不是把多个版本随意放到 classpath 等待顺序碰巧正确。Windows classpath 多路径使用分号,Linux/macOS 使用冒号;路径含空格时正确引用整个参数。
恢复与复测
类初始化失败后,只修复外部配置并在同一加载器中再次访问通常无效,需要重新启动或重建对应加载器生命周期。部署修复后用全新进程验证正常路径和实际加载来源。保留旧构建产物以便回退,避免直接删除共享缓存或手工替换正在运行的 JAR,造成现场与构建结果不一致。
java -Dfile.encoding=UTF-8 -Duser.timezone=<时区> <主类>
Charset.defaultCharset() / ZoneId.systemDefault()
检查默认字符集、区域设置和 JVM 时区差异。
排查编码与时区问题
当同一份 Java 程序在本机、容器和服务器上出现乱码、日期偏移或“昨天/今天”判断不一致时,先打印 JVM 实际使用的字符集、区域和时区,再决定是修正启动参数还是在代码中显式指定。
快速诊断
下面程序不修改环境,只读取进程当前值。保存为 EnvCheck.java。
import java.nio.charset.Charset;
import java.time.ZoneId;
import java.time.ZonedDateTime;
import java.util.Locale;

public class EnvCheck {
    public static void main(String[] args) {
        System.out.println("defaultCharset=" + Charset.defaultCharset());
        System.out.println("file.encoding=" + System.getProperty("file.encoding"));
        System.out.println("defaultLocale=" + Locale.getDefault());
        System.out.println("systemZone=" + ZoneId.systemDefault());
        System.out.println("now=" + ZonedDateTime.now());
        System.out.println("TZ=" + System.getenv("TZ"));
    }
}
编译并运行:
javac EnvCheck.java
java EnvCheck
预期输出:
defaultCharset=UTF-8
file.encoding=UTF-8
defaultLocale=zh_CN
systemZone=Asia/Shanghai
now=<TIME>[Asia/Shanghai]
TZ=<VALUE_OR_NULL>
<TIME> 和环境变量值会随机器变化。重点对比发生问题的两个运行环境,而不是只看源码或配置文件。
显式固定运行环境
确认应用必须统一为 UTF-8、中文区域和上海时区时,可在启动命令中声明:
java -Dfile.encoding=UTF-8 -Duser.language=zh -Duser.country=CN -Duser.timezone=Asia/Shanghai EnvCheck预期输出:
defaultCharset=UTF-8
file.encoding=UTF-8
defaultLocale=zh_CN
systemZone=Asia/Shanghai
now=<TIME>[Asia/Shanghai]
TZ=<VALUE_OR_NULL>
启动参数影响整个 JVM。共享中间件客户端、定时任务或历史代码依赖旧默认值时,直接修改可能导致时间边界和文本解析行为整体变化,应先在测试环境回归。
代码中的安全写法
文件、HTTP 报文和签名计算不要依赖默认字符集,应显式传入 StandardCharsets.UTF_8。业务时间也应使用明确的 ZoneId,不要把服务器默认时区当作业务时区。
片段示例,依赖调用方处理 IOException:
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.time.LocalDate;
import java.time.ZoneId;

String content = Files.readString(Path.of("config.txt"), StandardCharsets.UTF_8);
LocalDate businessDate = LocalDate.now(ZoneId.of("Asia/Shanghai"));
生效行为是文本始终按 UTF-8 解码,业务日期不随宿主机时区变化。Files.readString 和 Path.of 需要 JDK 11 及以上。
排障清单
- 乱码只在控制台出现:分别检查源文件编码、编译编码、终端编码和日志采集器,不要只改
file.encoding。 - 容器与宿主机时间不同:检查镜像时区数据、
TZ环境变量和 JVM-Duser.timezone。 - 数据库时间偏移:同时核对数据库会话时区、JDBC 参数以及字段类型;
TIMESTAMP与DATETIME的转换语义不同。 - 定时任务提前或延后:检查调度表达式使用的 zone,并确认节点间配置一致。
- JDK 18 及以后默认字符集为 UTF-8;旧 JDK 更容易受操作系统区域设置影响,但显式指定仍是跨环境最稳妥的做法。
速查原则:先打印实际值,再比较环境;对外部数据和业务时间尽量显式指定字符集与时区。
@Override public boolean equals(Object o) { ... }
@Override public int hashCode() { return Objects.hash(<参与比较的字段>...); }
保持相等性契约并避免集合查询和去重异常。
避免 equals 与 hashCode 陷阱
对象被用作 HashMap 键、HashSet 元素或去重依据时,equals 与 hashCode 必须描述同一组身份字段。否则会出现“明明相等却查不到”、重复元素未去重或删除失败。
必须满足的契约
equals 应满足自反、对称、传递、一致,并对 null 返回 false。最关键的散列约束是:两个对象只要 equals 为 true,它们的 hashCode 就必须相同;哈希相同的对象则不一定相等。
用于比较的字段应保持稳定。对象放入散列集合后再修改这些字段,会改变桶位置,使后续查询和删除失效。
错误与正确示例
下面的 BrokenKey 只按 id 判断相等,却把 name 也放入哈希计算,直接违反契约;UserKey 使用不可变 record,由编译器基于同一组件生成两个方法。
import java.util.HashSet;
import java.util.Objects;
import java.util.Set;

public class EqualsHashCodeDemo {
    static final class BrokenKey {
        private final int id;
        private final String name;

        BrokenKey(int id, String name) {
            this.id = id;
            this.name = name;
        }

        @Override
        public boolean equals(Object obj) {
            return obj instanceof BrokenKey other && id == other.id;
        }

        @Override
        public int hashCode() {
            return Objects.hash(id, name); // 错误:比 equals 多用了 name
        }
    }

    record UserKey(int id) {}

    public static void main(String[] args) {
        BrokenKey a = new BrokenKey(1, "A");
        BrokenKey b = new BrokenKey(1, "B");
        Set<BrokenKey> broken = new HashSet<>();
        broken.add(a);
        broken.add(b);

        Set<UserKey> fixed = new HashSet<>();
        fixed.add(new UserKey(1));
        fixed.add(new UserKey(1));

        System.out.println("broken equals=" + a.equals(b));
        System.out.println("broken hash equal=" + (a.hashCode() == b.hashCode()));
        System.out.println("broken set size=" + broken.size());
        System.out.println("fixed set size=" + fixed.size());
    }
}
运行:
javac EqualsHashCodeDemo.java
java EqualsHashCodeDemo
预期输出:
broken equals=true
broken hash equal=false
broken set size=2
fixed set size=1
读取方法:前两行证明契约被破坏;第三行说明 HashSet 未能去重;最后一行是身份字段一致后的结果。
实现选择
值对象优先使用不可变 record,或使用 final 类并让两个方法引用完全相同的字段。可空字段使用 Objects.equals;数组内容比较使用 Arrays.equals 和 Arrays.hashCode,因为普通对象比较只会比较数组引用。
存在继承时要特别检查对称性。父类允许子类参与 equals,而子类又增加比较字段时,常出现 a.equals(b) 与 b.equals(a) 结果不同。身份语义不允许跨类型时,可使用 getClass() 严格限制类型,或直接禁止继承。
风险与边界
- 把可变字段放入哈希计算:字段修改后,集合可能查不到或删不掉该对象;安全替代是使用不可变键对象。
- 数据库实体用自增主键判等:持久化前后主键从空变为有值,会改变哈希;不要在主键稳定前把实体放入散列集合。
- 自动生成方法后新增字段:IDE、Lombok 或代码生成器可能让两个方法包含字段不一致;修改模型后应重新检查并运行契约测试。
- 哈希冲突不是错误:不同对象可以有相同哈希,集合最终仍会调用
equals区分,不能把哈希值当唯一标识。
兼容性
record 在 Java 16 起正式可用。Java 8 至 Java 15 可使用不可变 final 类,手工实现 equals 与 hashCode,并为集合查询、去重和字段修改场景补充测试。
速查原则:相等字段与哈希字段必须完全一致,作为集合键的字段在存放期间不得变化。
Objects.requireNonNull(<值>, "<说明>")
Optional.ofNullable(<值>).orElse(<默认值>)
-XX:+ShowCodeDetailsInExceptionMessages   // 增强型 NPE 信息,JDK 15 起默认开启
利用异常信息、边界校验和数据流定位 null 来源。
排查空指针异常
用于从异常堆栈定位触发点,再沿参数、返回值和对象字段反查 null 的来源。先修复数据边界,不要只在报错行随手补一个 if (x != null)。
定位顺序
先读取异常类型、消息和第一条业务代码栈帧。JDK 14 及以上通常会指出哪个变量在调用哪个方法时为 null;随后检查该行所有可能为空的表达式,沿调用链向上确认它来自入参、查询结果、集合元素还是未初始化字段。
public class NullPointerDemo {
    static String normalizeEmail(String email) {
        // 故意不校验,用于观察增强型 NPE 信息
        return email.trim().toLowerCase();
    }

    public static void main(String[] args) {
        String email = null;
        System.out.println(normalizeEmail(email));
    }
}
预期输出:
Exception in thread "main" java.lang.NullPointerException: Cannot invoke "String.trim()" because "email" is null
    at NullPointerDemo.normalizeEmail(NullPointerDemo.java:<LINE>)
    at NullPointerDemo.main(NullPointerDemo.java:<LINE>)
<LINE> 随源码行号变化。第一条业务栈帧是 normalizeEmail,消息已说明 email 为 null,应继续追查调用方为什么传入空值。
边界校验
在数据进入方法、服务或接口边界时尽早失败,并让异常消息携带字段名和业务标识。必须允许为空的数据使用显式分支或 Optional 表达,不要用异常代替正常分支。
import java.util.Objects;

public class NullSafeDemo {
    static String normalizeEmail(String email) {
        String value = Objects.requireNonNull(email, "email must not be null");
        return value.trim().toLowerCase();
    }

    public static void main(String[] args) {
        try {
            System.out.println(normalizeEmail(null));
        } catch (NullPointerException e) {
            System.out.println(e.getMessage());
        }
    }
}
预期输出:
email must not be null对外接口优先返回参数错误;内部不可为空的依赖可使用 Objects.requireNonNull。查询可能无结果时,返回 Optional、空集合或明确的“未找到”异常,三者只能选一种并保持一致。
高频来源
- 数据库查询未命中,却直接调用结果对象的方法。
Map.get()、数组或集合元素返回null,后续立即拆箱或调用方法。- 链式调用中间对象为空,例如
order.getCustomer().getName()。 - Spring Bean、配置项或延迟初始化字段未注入、未赋值或初始化失败。
风险与边界
触发条件是用全局默认值、空字符串或宽泛 try-catch 掩盖 null。后果是错误数据继续流转,真正故障位置被推迟,甚至造成金额、状态等业务字段误判。安全替代方案是在入口校验、领域对象构造和查询结果处明确约束,并保留原始堆栈。
排障清单
- 锁定第一条业务栈帧,不要只看最底部框架栈。
- 拆开过长链式调用,为中间值命名并记录关键业务 ID。
- 检查自动拆箱,例如
Integer count = null; int n = count;。 - 复现时使用与生产相同的请求参数、配置和数据快照。
- 修复后补充覆盖“缺字段、查询无结果、集合含空元素”的测试。
速查原则:先确认哪个表达式为空,再确认它为什么为空,最后在最靠近数据入口的位置建立约束。
ls /proc/<PID>/fd | wc -l
lsof -p <PID>
jcmd <PID> Thread.print
定位未关闭的流、文件、线程、连接和执行器。
排查资源泄漏
用于定位文件描述符、连接、线程或执行器持续增长的问题。先观察资源数量是否随请求增长且不回落,再用线程栈、系统句柄和池监控确认具体类型。
命令定位
Linux 生产环境先查看目标 JVM 的打开文件和线程数量。将 <PID> 替换为实际 Java 进程号。
printf 'open_files='
ls "/proc/<PID>/fd" | wc -l
printf 'threads='
ls "/proc/<PID>/task" | wc -l
lsof -p <PID> | tail -n 5
预期输出示例:
open_files=412
threads=186
java <PID> app  408r REG  <DEVICE> <SIZE> <NODE> /var/log/app/access.log
java <PID> app  409u IPv4 <DEVICE> 0t0 TCP <LOCAL>:<PORT>-><REMOTE>:<PORT> (ESTABLISHED)
数值应结合基线连续观察。文件数或线程数只增不降,且接近 ulimit -n、线程上限或连接池上限时,才说明存在明显泄漏风险。
线程与执行器检查
线程泄漏常见于每次请求都创建线程池、定时任务重复注册,或任务阻塞导致队列持续积压。连续抓取两到三次线程栈,确认同名线程是否增长以及是否长期停在同一阻塞点。
jcmd <PID> Thread.print > /tmp/threads-1.txt
sleep 10
jcmd <PID> Thread.print > /tmp/threads-2.txt
grep -c '^"' /tmp/threads-1.txt
grep -c '^"' /tmp/threads-2.txt
预期输出示例:
186
214
线程数增长只是信号。继续比较新增线程名和栈顶方法,重点排查 pool-*、自定义定时线程、阻塞 I/O 和未设置超时的远程调用。
安全关闭示例
流和 JDBC 资源优先使用 try-with-resources;执行器必须在生命周期结束时调用 shutdown(),并在超时后升级为 shutdownNow()。
import java.io.BufferedReader;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

public class ResourceSafeDemo {
    public static void main(String[] args) throws Exception {
        Path file = Files.createTempFile("resource-safe-", ".txt");
        Files.writeString(file, "ready\n");

        // try-with-resources 会在正常和异常路径都关闭文件句柄
        try (BufferedReader reader = Files.newBufferedReader(file)) {
            System.out.println(reader.readLine());
        }

        ExecutorService executor = Executors.newFixedThreadPool(1);
        try {
            executor.submit(() -> System.out.println("task done")).get();
        } finally {
            executor.shutdown();
            if (!executor.awaitTermination(3, TimeUnit.SECONDS)) {
                executor.shutdownNow();
            }
        }

        System.out.println("terminated=" + executor.isTerminated());
        Files.deleteIfExists(file);
    }
}
预期输出:
ready
task done
terminated=true
JDBC 的 Connection、Statement、ResultSet 应在同一个 try-with-resources 中声明;连接池场景中的 close() 是归还连接,不是销毁物理连接。
风险与边界
触发条件是直接增大文件句柄、线程数或连接池上限来压住告警。后果是泄漏速度暂时被掩盖,最终仍会出现 Too many open files、连接池耗尽、线程创建失败或频繁 Full GC。安全替代方案是先确定增长资源的创建栈和所有退出路径,再调整容量。
强制关闭线程、连接或文件可能中断正在处理的请求并造成数据不完整。生产操作前应确认资源归属,优先摘流、停止新任务、等待优雅关闭,再执行兜底终止。
排障清单
- 对比故障前后的文件描述符、线程数、连接池 active/idle/pending。
- 检查所有异常、超时、提前返回和取消路径是否执行关闭。
- 搜索
new Thread、newFixedThreadPool、Files.new*、DriverManager.getConnection等创建点。 - 为 HTTP、数据库和阻塞任务设置连接、读取、获取连接及任务超时。
- 修复后做持续压测,确认资源曲线达到平台期并能在流量下降后回落。
速查原则:先判断泄漏的是哪类资源,再找到创建点和缺失的释放路径,不要先扩容掩盖问题。
in.setObjectInputFilter(info -> <ALLOWED | REJECTED | UNDECIDED>);
-Djdk.serialFilter=<允许的类>;!*
识别原生反序列化风险并限制不可信对象输入。
规避 Java 序列化风险
当系统必须读取 Java 原生序列化数据时,先限制对象类型、深度、引用数和字节数,再调用 readObject();对浏览器、消息队列、缓存或跨服务传入的数据,优先改用带明确字段模型的 JSON、Protobuf 等格式。
风险边界
只要攻击者能控制序列化字节流,ObjectInputStream.readObject() 就可能实例化应用类路径中的任意可序列化类型。依赖中存在可利用调用链时,后果可能是远程命令执行;即使没有利用链,超深对象图或超大数组也可能造成 CPU、内存耗尽。
serialVersionUID、Base64、加密传输和类型强转都不能替代反序列化过滤。安全顺序应是:限制输入大小,安装过滤器,只允许业务白名单类型,最后读取对象。
可运行示例
下面的过滤器只允许 UserRecord、字符串和基本类型,并限制对象图规模;未列入白名单的 DangerousPayload 会在对象创建前被拒绝。
import java.io.ByteArrayInputStream;
import java.io.ByteArrayOutputStream;
import java.io.IOException;
import java.io.InvalidClassException;
import java.io.ObjectInputFilter;
import java.io.ObjectInputStream;
import java.io.ObjectOutputStream;
import java.io.Serializable;

public class SerializationGuardDemo {
    static final class UserRecord implements Serializable {
        private static final long serialVersionUID = 1L;
        private final String name;

        UserRecord(String name) {
            this.name = name;
        }

        @Override
        public String toString() {
            return "UserRecord{name='" + name + "'}";
        }
    }

    static final class DangerousPayload implements Serializable {
        private static final long serialVersionUID = 1L;
    }

    static byte[] serialize(Object value) throws IOException {
        ByteArrayOutputStream buffer = new ByteArrayOutputStream();
        try (ObjectOutputStream out = new ObjectOutputStream(buffer)) {
            out.writeObject(value);
        }
        return buffer.toByteArray();
    }

    static Object deserialize(byte[] data)
            throws IOException, ClassNotFoundException {
        if (data.length > 4096) {
            throw new IOException("serialized data too large");
        }

        try (ObjectInputStream in = new ObjectInputStream(
                new ByteArrayInputStream(data))) {
            in.setObjectInputFilter(info -> {
                if (info.depth() > 5 || info.references() > 20
                        || info.streamBytes() > 4096) {
                    return ObjectInputFilter.Status.REJECTED;
                }

                Class<?> type = info.serialClass();
                if (type == null) {
                    return ObjectInputFilter.Status.UNDECIDED;
                }
                if (type == UserRecord.class || type == String.class
                        || type.isPrimitive()) {
                    return ObjectInputFilter.Status.ALLOWED;
                }
                return ObjectInputFilter.Status.REJECTED;
            });
            return in.readObject();
        }
    }

    public static void main(String[] args) throws Exception {
        System.out.println(deserialize(serialize(new UserRecord("alice"))));

        try {
            deserialize(serialize(new DangerousPayload()));
        } catch (InvalidClassException ex) {
            System.out.println("已阻止不可信类型");
        }
    }
}
编译并运行:
javac SerializationGuardDemo.java
java SerializationGuardDemo
预期输出:
UserRecord{name='alice'}
已阻止不可信类型
第一行表示白名单对象正常恢复;第二行表示过滤器在反序列化阶段拒绝了未授权类型。
生产配置
全局过滤器适合为整个 JVM 设置保底限制,但应用内仍应按入口设置更窄的白名单。不要配置宽泛的包前缀,例如允许整个业务包或第三方依赖包;新增合法类型时应经过代码评审和回归测试。
接收网络或消息数据时,还要在创建 ObjectInputStream 前限制请求体、消息体或缓存值大小。过滤器只能约束反序列化过程,不能替代鉴权、签名校验和来源校验。
排障清单
- 出现
InvalidClassException: filter status: REJECTED:记录被拒绝的类名和入口,确认是否遗漏合法类型,不要直接改成全允许。 - 内存仍快速上涨:检查数组长度、输入总字节数和上游消息大小限制是否同时生效。
- 旧数据无法读取:先在隔离环境确认实际类型,再做一次性迁移;不要为兼容历史数据永久放宽生产白名单。
- 无法修改旧代码:在 JVM 启动参数中设置全局过滤策略,并尽快把外部输入迁移到非原生序列化格式。
兼容性提示:ObjectInputFilter 在 Java 9 起可直接使用;较旧 JDK 应升级或采用对应安全补丁提供的过滤机制。
Path target = ROOT.resolve(<用户输入>).normalize();
if (!target.startsWith(ROOT)) throw new SecurityException(...);
new ProcessBuilder(List.of("<命令>", <参数>))   // 参数逐个传入,不经 shell 拼接
安全处理外部命令、文件路径和用户提供的参数。
防范命令与路径注入
处理用户提供的命令参数或文件名时,固定可执行程序,把每个参数作为独立元素传给 ProcessBuilder;文件访问必须从固定根目录解析,并校验规范化路径和真实父目录都没有越界。
安全规则
命令注入通常由 sh -c、cmd /c 或字符串拼接触发。输入中出现 ;、&&、|、重定向符或命令替换语法时,Shell 会把它解释为新命令。安全替代方案是不用 Shell,固定程序绝对路径,并对参数长度、字符集和业务取值做白名单校验。
路径注入通常由 ../、绝对路径、符号链接或编码后的分隔符触发。只做字符串替换不可靠;应使用 Path.resolve()、normalize()、startsWith() 和真实路径校验,高风险写入还要防止检查后被替换的竞态条件。
可运行示例
示例固定调用 /usr/bin/printf,因此输入中的分号只会作为普通文本输出;文件名从 /tmp/app-exports 解析,越界路径会被拒绝。
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.LinkOption;
import java.nio.file.Path;

public class InjectionGuardDemo {
    private static final Path ROOT =
            Path.of("/tmp/app-exports").toAbsolutePath().normalize();

    static Path safeResolve(String userPath) throws Exception {
        Path relative = Path.of(userPath);
        if (relative.isAbsolute() || relative.getFileName() == null) {
            throw new IllegalArgumentException("invalid relative path");
        }

        Files.createDirectories(ROOT);
        Path rootReal = ROOT.toRealPath();
        Path normalized = ROOT.resolve(relative).normalize();
        if (!normalized.startsWith(ROOT)) {
            throw new IllegalArgumentException("path escapes root");
        }

        Path parent = normalized.getParent();
        Files.createDirectories(parent);
        Path parentReal = parent.toRealPath();
        if (!parentReal.startsWith(rootReal)) {
            throw new IllegalArgumentException("symbolic-link escape");
        }

        Path target = parentReal.resolve(normalized.getFileName());
        if (Files.exists(target, LinkOption.NOFOLLOW_LINKS)
                && Files.isSymbolicLink(target)) {
            throw new IllegalArgumentException("symbolic-link file is not allowed");
        }
        return target;
    }

    static String runFixedCommand(String userText) throws Exception {
        if (userText.length() > 200) {
            throw new IllegalArgumentException("argument is too long");
        }

        Process process = new ProcessBuilder(
                "/usr/bin/printf", "%s\n", userText)
                .redirectErrorStream(true)
                .start();

        String output;
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(
                        process.getInputStream(), StandardCharsets.UTF_8))) {
            output = reader.readLine();
        }

        int exitCode = process.waitFor();
        if (exitCode != 0) {
            throw new IllegalStateException("command failed: " + exitCode);
        }
        return output;
    }

    public static void main(String[] args) throws Exception {
        String text = "hello; touch /tmp/pwned";
        Path output = safeResolve("reports/result.txt");

        Files.writeString(output, runFixedCommand(text),
                StandardCharsets.UTF_8);
        System.out.println("command output: " + Files.readString(output));
        System.out.println("saved path: " + output);

        try {
            safeResolve("../../etc/passwd");
        } catch (IllegalArgumentException ex) {
            System.out.println("已阻止越界路径");
        }
    }
}
编译并运行:
javac InjectionGuardDemo.java
java InjectionGuardDemo
预期输出:
command output: hello; touch /tmp/pwned
saved path: /tmp/app-exports/reports/result.txt
已阻止越界路径分号未启动第二条命令,/tmp/pwned 不会被创建;实际保存路径固定在允许目录内。路径和控制台编码可能因系统环境不同而略有差异。
风险与边界
即使使用参数数组,也不能让用户控制可执行文件本身,否则攻击者可能选择危险程序。确需支持多种操作时,把外部值映射到内部枚举,例如 PING 只对应固定命令和固定参数模板。
normalize() 只能消除路径中的 . 和 ..,不能自动阻止符号链接跳转。删除、覆盖、解压上传包等高风险操作,应使用独立工作目录、最小系统权限,并优先采用 SecureDirectoryStream 或操作系统沙箱降低竞态风险。
排障清单
- 参数包含空格后命令失败:不要手工加引号;每个参数单独放入
ProcessBuilder列表。 - 路径校验通过却写到意外位置:检查根目录、父目录和挂载点是否被符号链接替换。
- Windows 无法运行示例:把固定程序替换为受控的绝对路径,仍保持“程序与参数分离”,不要改成
cmd /c拼接。 - 业务必须执行 Shell:只调用预先审核的脚本,参数使用严格白名单,并以低权限账户、超时和资源限制运行。
兼容性提示:示例使用 Path.of()、Files.writeString() 和 Files.readString(),需要 Java 11 或更高版本。