
CI/CD / 知识点
GitHub Actions 工作流语法速查
步骤与 Action
使用 run 执行 Runner 上的 Shell 命令,可通过多行块组合脚本;不同操作系统默认 Shell 不完全一致,跨平台工作流应显式核对。
执行 Shell 命令
需要在 Runner 上直接执行构建、测试、文件处理或诊断命令时查 run。它把当前 Step 的脚本文本交给所选 Shell 执行;跨操作系统或依赖特定语法时,应显式设置 shell。
怎么判读
| 写法或线索 | 含义 | 建议动作 |
|---|---|---|
run: command |
执行单条命令 | 适合短命令 |
run: | |
执行多行脚本 | 把同一处理阶段放在一个 Step |
shell: bash |
明确使用 Bash | 需要 Bash 语法或希望跨 Runner 保持一致时显式写出 |
未写 shell |
使用该 Runner 的默认 Shell | 跨 ubuntu、macos、windows 时不要假设行为完全一致 |
多个 run Step |
每个 Step 启动独立的 Shell 进程 | 跨 Step 传值用 $GITHUB_ENV、Step 输出或文件,不要只靠 export |
run 与 uses 表示两类不同的 Step 行为:一个 Step 通常执行脚本或调用 Action,不能把两者合并成同一个执行定义。
快速确认
下面的工作流可通过 Actions → 选择工作流 → Run workflow 手动触发,并显式使用 Bash:
name: run-demo

on:
  workflow_dispatch:

jobs:
  demo:
    runs-on: ubuntu-latest
    steps:
      - name: Execute shell commands
        shell: bash
        run: |
          set -euo pipefail
          message='hello-actions'
          echo "$message"
          echo "sum=$((2 + 3))"
预期输出:
hello-actions
sum=5
GitHub 日志还会包含 Runner 和 Step 自身的包装日志,具体前后缀会随 Runner 版本变化;确认这两行出现且 Step 为成功状态即可。
常见边界
多行 run 适合顺序执行的一组命令,但其中任一关键命令失败是否立即终止仍受 Shell 行为影响。对 Bash 可显式使用 set -euo pipefail,并避免把失败命令隐藏在不检查退出码的管道或条件中。
若命令需要在 Windows 上运行,应选择与脚本语法匹配的 shell,例如 pwsh;不要把 Bash 的变量、重定向或路径规则直接假定为 PowerShell 规则。
适用范围:GitHub Actions 工作流中的 jobs.<job_id>.steps[*].run。Runner 镜像内可用的命令、工具版本和默认 Shell 以所选 Runner 与 GitHub 当前文档为准。
使用 uses 在 Step 中调用可复用 Action,引用时应明确版本、标签或提交 SHA;生产流水线通常应避免直接依赖可移动分支。
调用第三方 Action
需要复用现成的构建、发布、扫描或环境配置逻辑时查 uses。远程 Action 通常写成 owner/repository@ref;生产流水线应核对发布者,并优先固定到可信的不可变提交 SHA,避免可移动标签被重新指向。
怎么判读
| 写法或线索 | 含义 | 建议动作 |
|---|---|---|
uses: owner/repo@v3 |
从仓库引用一个版本标签 | 适合快速接入,但标签是否可移动取决于维护者 |
uses: owner/repo@<COMMIT_SHA> |
固定到具体提交 | 生产环境优先使用已审核的完整提交 SHA |
uses: owner/repo/path@ref |
调用仓库子目录中的 Action | 核对该目录是否包含目标 Action 定义 |
with: |
向 Action 传输入参数 | 参数名和必填项以该 Action 的 action.yml、action.yaml 或官方文档为准 |
id: 后读取 steps.<id>.outputs.* |
使用 Action 暴露的输出 | 只读取该 Action 明确定义的输出键 |
同一 Step 同时写 run 与 uses |
执行模型冲突 | 拆成两个 Step |
不要把任意仓库标签视为稳定版本保证。标签、分支和发布策略由 Action 发布者维护;对安全敏感的工作流,应在审核源码后固定到具体提交。
快速确认
下面示例调用 Docker 维护的 Buildx Action,然后用下一步命令确认 Buildx 已可用:
name: uses-demo

on:
  workflow_dispatch:

jobs:
  demo:
    runs-on: ubuntu-latest
    steps:
      - name: Set up Docker Buildx
        uses: docker/setup-buildx-action@v3

      - name: Verify Buildx
        shell: bash
run: docker buildx version预期结果:Set up Docker Buildx Step 成功,随后 docker buildx version 返回 Buildx 版本信息并以退出码 0 结束。实际版本号由 Action 解析到的发行版本和 Runner 环境决定,不应在断言中写死。
选择引用方式
测试或内部原型可以先用维护者提供的主版本标签,例如 @v3,便于接收兼容更新。进入生产前,应确认仓库归属、维护状态、权限需求和源码变更,再把引用替换为已审核的完整提交 SHA;更新时重新审核并显式升级该 SHA。
若 Action 需要凭据,只通过 GitHub Secrets、环境保护或最小权限的 GITHUB_TOKEN 传入,不要把令牌直接写进 with、env 或仓库文件。
适用范围:GitHub Actions Step 级 uses 引用。具体 with 参数、输出键、运行时要求和支持版本属于各 Action 自身接口,必须以该 Action 当前文档与仓库定义为准。
在 Step 的 with 中传递 Action 声明的输入参数,输入名称必须与目标 Action 的接口匹配;它不同于调用可复用 Workflow 时的 Job 级 with。
传递 Action 输入
当一个 uses Step 需要向目标 Action 传入版本、路径、开关等参数时,查 with。键名必须来自该 Action 声明的 inputs;未知键、必填项和取值约束应以 Action 的 action.yml、action.yaml 或官方文档为准。
怎么判读
| 写法 | 含义 | 建议动作 |
|---|---|---|
steps[*].with |
给当前 Step 使用的 Action 传输入 | 按目标 Action 的输入接口填写 |
with.<input-name> |
一个具体 Action 输入 | 核对名称、是否必填和允许值 |
jobs.<job_id>.with |
调用可复用 Workflow 时传输入 | 不要与 Action Step 的 with 混用 |
Action 输入只对被调用的 Action 有意义。输入名称不是 GitHub Actions 的全局固定参数,因此不能看到 with 就凭经验填写 token、path 或其他键。
快速确认
下面使用 actions/checkout@v4 的 fetch-depth 输入,把完整 Git 历史检出后读取提交数量:
name: with-input-demo
on:
  workflow_dispatch:

jobs:
  verify:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout full history
        uses: actions/checkout@v4
        with:
          fetch-depth: 0

      - name: Count commits
run: git rev-list --count HEAD预期结果:Checkout full history Step 成功后,Count commits 输出当前仓库可达历史中的提交数量,例如:
<COMMIT_COUNT><COMMIT_COUNT> 的实际值取决于仓库历史;应为提交计数,而不是固定数字。
判读与处理
如果 Action 报告缺少输入或值无效,先查看该 Action 对应版本的输入声明,再核对键名、大小写和取值。表达式也可以作为输入值,但最终是否接受该值仍由 Action 自身决定。
适用范围
这里讨论的是 GitHub Actions Workflow 中 jobs.<job_id>.steps[*].with。调用可复用 Workflow 的 Job 级 with 属于另一套输入接口,应根据 workflow_call.inputs 单独核对。
在单个 Step 上定义 env,只让当前步骤进程直接获得这些变量;适合为单条命令注入临时参数或缩小敏感数据暴露范围。
设置 Step 级变量
当环境变量只应提供给某一个 Step,而不需要整个 Job 都可见时,在该 Step 上设置 env。它适合临时命令参数、工具配置,以及把变量暴露范围限制到最小执行单元。
怎么判读
| 位置 | 可用范围 | 同名变量优先级 |
|---|---|---|
Workflow 级 env |
Workflow 内各 Job 的 Step | 最低 |
Job 级 env |
当前 Job 的各 Step | 覆盖 Workflow 级 |
Step 级 env |
仅当前 Step | 覆盖 Job 和 Workflow 级 |
Step 执行时,env 中的值会进入该步骤的 runner 进程环境。下一 Step 不会因为前一步声明了 Step 级 env 而自动继承它。
快速确认
下面第一个 Step 能读取 TARGET,第二个 Step 验证该变量没有继续存在:
name: step-env-demo
on:
  workflow_dispatch:

jobs:
  verify:
    runs-on: ubuntu-latest
    steps:
      - name: Read step env
        env:
          TARGET: staging
          RETRIES: '3'
        run: printf '%s %s\n' "$TARGET" "$RETRIES"

      - name: Verify isolation
        shell: bash
        run: test -z "${TARGET:-}" && echo 'TARGET is unset'
预期输出:
staging 3
TARGET is unset
这说明 TARGET 和 RETRIES 直接提供给第一个 Step 的 shell,而第二个 Step 没有继承 TARGET。
什么时候使用
只供一条命令或一个 Action 使用的配置优先放在 Step 级 env;多个 Step 都需要时,再考虑 Job 级 env。如果后续 Step 必须接收运行期间计算出的新值,应使用 GitHub Actions 提供的跨 Step 变量或输出机制,而不是期待 Step 级 env 自动传播。
敏感值应从 secrets context 引用,而不是把明文秘密直接写进 Workflow:
- name: Call deployment command
  env:
    DEPLOY_TOKEN: ${{ secrets.DEPLOY_TOKEN }}
  run: ./deploy.sh
预期结果:当前 Step 的进程可以读取 DEPLOY_TOKEN;具体部署输出由 ./deploy.sh 决定。不要主动打印该变量,也不要把“只在一个 Step 中声明”误认为秘密对该 Step 内启动的子进程不可见。
适用范围
这里讨论 GitHub Actions Workflow 的 jobs.<job_id>.steps[*].env。shell 中读取变量的语法取决于 runner 和 shell,例如 Bash 使用 $NAME;如果需要在 Workflow 表达式中读取已定义的环境变量,则使用 env context。
为需要被后续表达式引用的 Step 设置 id,随后可通过 steps.<id>.outputs 读取其输出;未设置标识时无法稳定按名称访问步骤结果。
定义 Step 标识
当后续步骤需要读取某一步的输出或结论时,为该 Step 设置稳定的 id;引用使用 steps.<id>...,显示用的 name 不能替代 id。
怎么判读
| 写法 | 含义 | 建议动作 |
|---|---|---|
id: meta |
为当前 Step 定义表达式标识 | 后续统一用 steps.meta... 引用 |
steps.meta.outputs.version |
读取 meta Step 的 version 输出 |
确认该 Step 已写入同名输出 |
只有 name: |
仅设置 Actions 页面中的显示名称 | 需要跨步骤引用时补充 id |
快速确认
下面是可直接放入 .github/workflows/step-id-demo.yml 的最小工作流,手动触发后会由第二个 Step 读取第一个 Step 的输出。
name: step-id-demo
on:
  workflow_dispatch:

jobs:
  demo:
    runs-on: ubuntu-latest
    steps:
      - name: Produce version
        id: meta
        shell: bash
        run: echo "version=1.2.3" >> "$GITHUB_OUTPUT"

      - name: Read version
        shell: bash
        run: echo "version=${{ steps.meta.outputs.version }}"
预期结果:在 Read version Step 的日志中可看到:
version=1.2.3处理与边界
id 的价值是建立稳定引用键,而不是改善显示名称。引用时必须使用实际配置的标识,例如 steps.meta.outputs.version;若写错 id 或输出名,后续表达式就读不到目标值。
该写法适用于 GitHub Actions 工作流中的同一 Job 内 Step 引用。示例使用 ubuntu-latest 与 Bash;其他 Runner 或 Shell 只影响写出输出时的命令语法,不改变 steps.<id>.outputs.<name> 的引用形式。
输出与数据传递
步骤可向 GITHUB_OUTPUT 写入命名输出,再由 steps.<id>.outputs 暴露给后续配置;适合在计算版本、路径或部署参数后继续传递。
写入步骤输出
当一个 Step 计算出版本号、文件路径或部署参数并需要交给后续 Step 时,把 name=value 写入 GITHUB_OUTPUT,再通过 steps.<id>.outputs.<name> 读取。
值与含义
| 写法 | 含义 | 建议动作 |
|---|---|---|
echo "artifact_path=dist/app.tar.gz" >> "$GITHUB_OUTPUT" |
创建名为 artifact_path 的步骤输出 |
保持输出名稳定且避免覆盖无关值 |
id: build_meta |
为产出输出的 Step 设置引用标识 | 后续通过该 id 读取 |
steps.build_meta.outputs.artifact_path |
读取已写入的输出值 | 只在产出 Step 之后使用 |
快速确认
下面的完整工作流先写入路径,再在下一步读取它。
name: step-output-demo
on:
  workflow_dispatch:

jobs:
  demo:
    runs-on: ubuntu-latest
    steps:
      - name: Compute artifact path
        id: build_meta
        shell: bash
        run: echo "artifact_path=dist/app.tar.gz" >> "$GITHUB_OUTPUT"

      - name: Consume artifact path
        shell: bash
        run: echo "artifact_path=${{ steps.build_meta.outputs.artifact_path }}"
预期结果:在 Consume artifact path Step 的日志中可看到:
artifact_path=dist/app.tar.gz判读与常见失败
若后续读到空值,先检查产出 Step 是否实际执行,再核对 id、输出名和写入格式是否完全一致。GITHUB_OUTPUT 是 Runner 为当前 Step 提供的环境文件路径,Bash 中应追加写入,避免把它当作普通固定文件名。
示例适用于 GitHub Actions 当前工作流语法,并假设 ubuntu-latest 上使用 Bash。若改用 PowerShell,应按对应 Shell 的环境变量语法写入同一个 GITHUB_OUTPUT 文件;跨 Job 传递时还需要把 Step 输出映射为 Job 输出,不能直接依赖同一 Job 的 steps 上下文。
在 Job 的 outputs 中把步骤输出映射为 Job 输出,供后续 Job 通过 needs.<job_id>.outputs 读取;适合跨 Runner 传递控制数据。
声明 Job 输出
需要把一个 Job 计算出的短文本、版本号、布尔标记等交给后续 Job 时,在生产 Job 的 outputs 中把步骤输出映射为 Job 输出。步骤先写入 $GITHUB_OUTPUT,Job 再通过 steps.<step_id>.outputs.<name> 暴露该值。
值与含义
| 写法 | 含义 | 建议动作 |
|---|---|---|
echo "name=value" >> "$GITHUB_OUTPUT" |
在当前步骤声明步骤输出 | 为步骤设置稳定的 id |
outputs.<name>: ${{ steps.<step_id>.outputs.<name> }} |
把步骤输出提升为 Job 输出 | 只暴露后续 Job 真正需要的值 |
needs.<job_id>.outputs.<name> |
下游 Job 读取已暴露的 Job 输出 | 下游同时声明 needs |
Job 输出适合传递控制数据,不适合传递构建产物或大文件;文件应使用 artifact、缓存或外部存储。
可验证示例
下面的工作流由 produce 生成 artifact_name,再把它映射为 Job 输出;consume 通过依赖关系读取该值。
name: job-output-demo
on:
  workflow_dispatch:

jobs:
  produce:
    runs-on: ubuntu-latest
    outputs:
      artifact_name: ${{ steps.meta.outputs.artifact_name }}
    steps:
      - id: meta
        shell: bash
        run: echo "artifact_name=app-linux-amd64" >> "$GITHUB_OUTPUT"

  consume:
    runs-on: ubuntu-latest
    needs: produce
    steps:
      - name: Read job output
        env:
          ARTIFACT_NAME: ${{ needs.produce.outputs.artifact_name }}
        run: echo "artifact=$ARTIFACT_NAME"
预期结果
artifact=app-linux-amd64在 Actions 运行详情中打开 consume Job 的 Read job output 步骤即可核对该输出。
判读与边界
如果下游读到空值,先检查生产步骤是否有 id、写入 $GITHUB_OUTPUT 的键名是否与映射一致,以及 Job 的 outputs 是否引用了正确的 steps.<id>.outputs.<name>。Job 输出表达式会在生产 Job 结束时求值;可能包含 secret 的输出会受到 GitHub Actions 的敏感值保护,不应把 Job 输出当作跨 Job 传递密钥的通道。
当前 GitHub Actions 工作流语法还对 Job 输出大小和整个工作流的输出总量设有限制,因此这里只应传递小型字符串数据。GitHub Enterprise Server 的具体行为与限制以部署版本对应的官方文档为准。
后续 Job 可通过 needs.<job_id>.outputs.<name> 读取依赖 Job 暴露的数据,前提是该 Job 已声明 needs 依赖关系并正确映射输出。
读取前置 Job 输出
需要让后续 Job 根据前置 Job 产生的版本号、目标环境或控制标记继续执行时,使用 needs.<job_id>.outputs.<name> 读取 Job 输出。当前 Job 必须把生产者列入 needs,否则不要依赖该值可用。
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
needs: detect |
当前 Job 直接依赖 detect |
再通过 needs.detect 读取状态或输出 |
needs.detect.outputs.channel |
读取 detect 暴露的 channel |
确认上游存在同名 Job 输出 |
needs.detect.result |
前置 Job 的执行结果 | 与业务输出分开判断 |
| 依赖链中只有间接 Job | needs 上下文只包含当前 Job 的直接依赖 |
需要读取时把目标 Job 明确加入 needs |
needs.<job_id>.outputs.<name> 得到的是 Job 暴露的输出值;它不同于 needs.<job_id>.result,后者用于判断前置 Job 是 success、failure、cancelled 还是 skipped。
快速确认
下面让 detect 输出部署通道,deploy 声明直接依赖并读取该值。
name: needs-output-demo
on:
  workflow_dispatch:

jobs:
  detect:
    runs-on: ubuntu-latest
    outputs:
      channel: ${{ steps.select.outputs.channel }}
    steps:
      - id: select
        shell: bash
        run: echo "channel=stable" >> "$GITHUB_OUTPUT"

  deploy:
    runs-on: ubuntu-latest
    needs: detect
    steps:
      - name: Show upstream output
        env:
          CHANNEL: ${{ needs.detect.outputs.channel }}
        run: echo "deploy channel=$CHANNEL"
预期结果
deploy channel=stable如果该行出现在 deploy Job 日志中,说明 needs 依赖、上游 Job 输出映射和下游读取路径均已连通。
失败时先查什么
读不到值时,按路径从后向前核对:needs 中的 Job ID 是否正确、输出名称是否与上游 outputs 键一致、上游是否把步骤输出映射成了 Job 输出。仅在步骤中写入 $GITHUB_OUTPUT 并不会自动生成可跨 Job 读取的 needs.<job_id>.outputs 值。
默认情况下,依赖 Job 失败或被跳过会影响后续依赖 Job 的调度;如果业务要求失败后仍执行清理或诊断逻辑,需要另外设计 if 条件,不要把 Job 输出读取与失败处理混为一谈。适用范围为 GitHub Actions 的 Job 依赖与 needs 上下文;GitHub Enterprise Server 应以对应版本文档为准。
矩阵与并发
使用 strategy.matrix 根据多个变量组合自动展开 Job,适合同时测试不同 Node、Python、Java 或操作系统版本;单次运行存在矩阵任务数量上限。
配置矩阵任务
当同一套步骤需要覆盖多个运行环境或版本组合时,查 strategy.matrix。它会从变量值生成独立 Job,并通过 matrix.<变量名> 把当前组合传给 runs-on、步骤参数或表达式。
怎么判读
| 写法 | 含义 | 建议动作 |
|---|---|---|
matrix.os、matrix.node |
定义矩阵维度;各维度组合会展开为多个 Job | 先控制维度和值数量,避免无意放大任务数 |
${{ matrix.os }} |
读取当前 Job 对应的矩阵值 | 用在 runs-on、命令参数或步骤配置中 |
matrix.include |
为现有组合补字段,或追加不能合并的新组合 | 用于少量例外配置,不要复制整份矩阵 |
matrix.exclude |
从展开结果中移除匹配组合 | 排除已知不支持或无需测试的组合 |
矩阵任务数量还受 GitHub Actions 的平台限制约束;具体上限可能调整,应以目标 GitHub 环境当前的 Actions limits 与 workflow syntax 文档为准。
快速确认
下面的完整工作流定义两个操作系统和两个 Node 版本,因此会展开为 4 个 Job。保存为 .github/workflows/matrix-check.yml 后,可在 Actions 页面手动运行。
name: matrix-check

on:
  workflow_dispatch:

jobs:
  test:
    name: test-${{ matrix.os }}-node-${{ matrix.node }}
    runs-on: ${{ matrix.os }}
    strategy:
      matrix:
        os: [ubuntu-latest, windows-latest]
        node: [20, 22]
    steps:
      - name: Show matrix values
        run: echo "node=${{ matrix.node }} os=${{ matrix.os }}"
预期结果:本次运行出现 4 个 test-* Job,对应以下组合;实际开始与完成顺序取决于 Runner 可用性。
ubuntu-latest + Node 20
ubuntu-latest + Node 22
windows-latest + Node 20
windows-latest + Node 22
使用边界
矩阵负责“展开组合”,并不保证所有组合同时执行;并行程度仍取决于 Runner 可用性以及是否设置 strategy.max-parallel。当维度较多时,先计算组合数,再用 include 和 exclude 精确控制例外,避免一次运行生成不必要的 Job。
使用 strategy.max-parallel 限制同一矩阵中同时执行的 Job 数量,在 Runner 容量有限或下游服务有并发限制时可避免突发压力。
控制矩阵并行度
当矩阵已经会展开多个 Job,但 Runner 容量、测试数据库或外部 API 不能承受全部并发时,查 strategy.max-parallel。它只限制该矩阵同时运行的 Job 数,不改变矩阵最终生成的组合数量。
怎么判读
| 写法 | 含义 | 建议动作 |
|---|---|---|
省略 max-parallel |
GitHub 根据可用 Runner 尽可能并行调度矩阵 Job | 资源充足且下游可承受时使用 |
max-parallel: 1 |
该矩阵最多同时运行 1 个 Job | 用于必须串行访问共享测试资源的场景 |
max-parallel: N |
该矩阵最多同时运行 N 个 Job | 让 N 不超过 Runner 或下游服务的安全并发量 |
max-parallel 是上限,不是并行度保证;Runner 不足、队列拥塞或其他调度约束都可能让实际同时运行数低于该值。
快速确认
下面的工作流生成 4 个矩阵 Job,但最多只允许 2 个同时运行。每个 Job 等待 20 秒,便于在 Actions 运行详情中观察并发数。
name: matrix-max-parallel-check

on:
  workflow_dispatch:

jobs:
  probe:
    runs-on: ubuntu-latest
    strategy:
      max-parallel: 2
      matrix:
        shard: [1, 2, 3, 4]
    steps:
      - name: Hold the slot
        run: |
          echo "start shard=${{ matrix.shard }} time=$(date -u +%H:%M:%S)"
          sleep 20
          echo "end shard=${{ matrix.shard }} time=$(date -u +%H:%M:%S)"
预期结果:运行详情中最终有 4 个 probe 矩阵 Job,但任一时刻最多 2 个处于运行状态;日志时间会因调度而不同,可按下面形式读取。
start shard=<ID> time=<TIME>
end shard=<ID> time=<TIME>
使用边界
它只约束当前 strategy.matrix 展开的 Job,不是仓库级或组织级的全局并发限制,也不会为下游服务自动加锁。若多个工作流都会访问同一受限资源,还需要结合更高层的并发控制或资源侧限流。适用语法以当前 GitHub Actions workflow syntax 为准。
strategy.fail-fast 控制矩阵任务出现失败后的处理方式;开启时可取消尚未完成的同组任务,关闭后则更适合收集完整兼容性结果。
strategy.fail-fast
当矩阵中的一个任务失败后,需要判断其余组合是尽快停止还是继续跑完时,查 jobs.<job_id>.strategy.fail-fast。它作用于整个矩阵,默认值为 true;设为 false 可让其他矩阵任务继续执行,以收集完整测试结果。
值与处理方式
| 值 | 失败后的行为 | 适合场景 | 建议动作 |
|---|---|---|---|
true |
某个会导致失败的矩阵任务失败后,GitHub 会取消仍在运行或排队的同组矩阵任务 | 快速反馈、后续组合继续运行价值较低 | 保持默认值,减少无效运行时间 |
false |
一个组合失败不会触发其他矩阵组合的自动取消 | 多版本、多平台兼容性测试 | 让所有组合跑完,再统一查看失败分布 |
已经完成的任务不会因为后续失败而倒退为取消状态;实际能取消哪些任务还取决于失败发生时其他任务处于排队、运行还是已完成状态。
快速确认
下面的工作流故意让 20 组合失败,并把 fail-fast 关闭,因此 22 组合仍会执行完毕。
name: matrix-fail-fast-demo
on:
  workflow_dispatch:

jobs:
  test:
    runs-on: ubuntu-latest
    strategy:
      fail-fast: false
      matrix:
        version: [20, 22]
    steps:
      - name: Simulate matrix result
        shell: bash
        run: |
          if [ "${{ matrix.version }}" = "20" ]; then
            echo "version=20 failed"
            exit 1
          fi
echo "version=${{ matrix.version }} passed"预期结果:两个矩阵任务都会得到最终结果;version=20 对应任务失败,version=22 对应任务成功。由于至少存在一个未被忽略的失败任务,整个工作流运行仍会显示失败。
version=20 -> failure
version=22 -> success
workflow -> failure
与 continue-on-error 的边界
fail-fast 决定一个失败是否触发其他矩阵任务取消;jobs.<job_id>.continue-on-error 则决定当前任务的失败是否被允许。两者可以同时使用,例如把实验性组合设为 continue-on-error: true,其失败不会触发其他矩阵任务停止。
适用范围:GitHub Actions 工作流中的矩阵 strategy。具体取消时机受任务调度状态影响,应以对应 workflow run 的 Jobs 页面为最终判读依据。
使用 matrix.include 向已有矩阵增加或扩展组合,并可附带额外字段;适合为特定版本加入额外参数,而不是把全部组合写成笛卡尔积。
matrix.include
需要给已有矩阵中的特定组合增加额外字段,或补上一条基础矩阵无法产生的特殊组合时,查 jobs.<job_id>.strategy.matrix.include。include 是对象列表;每个对象会尽量合并到原始矩阵组合,无法在不改写原始矩阵值的情况下合并时,则形成新的组合。
怎么判读
include 情况 |
结果 | 建议动作 |
|---|---|---|
| 新字段不会覆盖原始矩阵值 | 字段加入符合条件的原始组合 | 用于附加标签、参数或配置 |
| 对象中的矩阵键只匹配部分原始组合 | 只扩展匹配的组合 | 用于给某个版本或平台增加专属字段 |
| 对象必须改写原始矩阵值才能合并 | 无法合并时创建新的矩阵组合 | 用于加入基础轴中不存在的特殊版本 |
多个 include 依次处理 |
后面的条目可覆盖前面由 include 新增的字段 |
顺序有意义,避免重复字段造成误判 |
include 不是简单的“追加若干行”。判断一个对象最终是扩展原组合还是创建新组合时,要同时看它包含的所有键值。
快速确认
下面只有一个基础轴 node。第一条 include 给已有的 node: 22 增加 label;第二条使用基础轴中不存在的 node: 24,因此新增一个组合。
name: matrix-include-demo
on:
  workflow_dispatch:

jobs:
  test:
    runs-on: ubuntu-latest
    strategy:
      matrix:
        node: [20, 22]
        include:
          - node: 22
            label: lts
          - node: 24
            label: next
    steps:
      - name: Show matrix values
        shell: bash
        env:
          NODE_VERSION: ${{ matrix.node }}
          LABEL: ${{ matrix.label }}
        run: |
          printf 'node=%s label=%s\n' "$NODE_VERSION" "${LABEL:-default}"
预期结果:最终生成 3 个矩阵任务。日志出现的先后顺序不固定,因为矩阵任务可以并行运行,但组合集合应等价于下面三行。
node=20 label=default
node=22 label=lts
node=24 label=next
选择 include 的线索
如果只是给某个现有组合补充字段,优先用 include,不用为了这个字段再增加一个完整矩阵轴。若要系统地产生所有值之间的组合,则应直接定义矩阵轴;若要删除已有组合,则使用 matrix.exclude,而不是试图通过 include 抵消它。
适用范围:GitHub Actions 的 jobs.<job_id>.strategy.matrix.include。不同 include 对象之间存在处理顺序,复杂矩阵应以实际展开后的 Jobs 列表验证最终组合。
使用 matrix.exclude 从矩阵组合中移除不需要运行的组合,适合跳过不兼容的平台、版本或特定参数组合。
排除矩阵组合
当矩阵生成了已知不兼容或无需执行的组合时,查 jobs.<job_id>.strategy.matrix.exclude;写入要排除的键值后,可以在不拆分 Job 的情况下减少实际生成的矩阵任务。
怎么判读
| 配置 | 含义 | 建议动作 |
|---|---|---|
exclude 含全部矩阵维度 |
移除与这些值匹配的具体组合 | 用于排除单个已知无效组合 |
exclude 只含部分维度 |
所有匹配这些键值的组合都被排除 | 适合整批跳过某个平台或版本 |
同时存在 include |
include 在 exclude 之后处理 |
检查是否又添加了原本排除的组合 |
exclude 采用部分匹配:条目中列出的键值全部匹配时,该矩阵组合即可被排除,因此不必总是写出所有维度。
快速确认
下面的工作流原本有 2 个操作系统乘 2 个 Node.js 版本,共 4 个组合;exclude 移除 Windows 与 Node.js 20 的组合。
name: matrix-exclude-demo
on:
  workflow_dispatch:

jobs:
  test:
    runs-on: ${{ matrix.os }}
    strategy:
      matrix:
        os: [ubuntu-latest, windows-latest]
        node: [20, 22]
        exclude:
          - os: windows-latest
            node: 20
    steps:
      - name: Show matrix values
        run: echo os=${{ matrix.os }} node=${{ matrix.node }}
预期结果:手动触发后只生成 3 个矩阵 Job。
ubuntu-latest / 20
ubuntu-latest / 22
windows-latest / 22
Job 的显示顺序可能不同,但不会生成 windows-latest / 20。
使用边界
如果目标是限制矩阵同时运行的数量,应使用 strategy.max-parallel,而不是 exclude。如果只是让某个已生成的 Job 在运行时根据条件跳过,则应考虑 Job 或步骤的 if;exclude 的作用发生在矩阵组合生成阶段。
这里描述的是 GitHub Actions 工作流中的 jobs.<job_id>.strategy.matrix.exclude。GitHub Enterprise Server 的具体可用行为应以对应服务器版本的 GitHub Actions 文档为准。
使用 concurrency 为工作流或 Job 建立并发组,同组最多保持一个运行中的任务;可用于避免同一生产环境出现并行部署。
限制并发运行
当多个工作流运行或 Job 可能同时修改同一环境、资源或部署目标时,查 concurrency;给它们设置相同并发组后,可以保证该组至多只有一个任务处于运行状态。
怎么判读
| 配置 | 含义 | 建议动作 |
|---|---|---|
顶层 concurrency |
控制整个 workflow run 的并发 | 适合整条部署流水线互斥 |
Job 下的 concurrency |
只控制对应 Job | 其他无关 Job 仍可继续运行 |
相同 group |
属于同一并发组 | 用环境、工作流或分支构造稳定组名 |
cancel-in-progress: false |
不主动取消正在运行的同组任务 | 适合不能中断的部署 |
cancel-in-progress: true |
新任务可取消正在运行的同组任务 | 适合只关心最新结果的检查或构建 |
默认情况下,同一并发组最多有一个运行中的任务和一个等待中的任务;新的同组等待任务可能替换并取消已有的等待任务,因此不要把默认 concurrency 当作严格 FIFO 队列。
快速确认
下面把整个工作流固定到 deploy-production 并发组,并用 60 秒步骤留出观察窗口。
name: concurrency-demo
on:
  workflow_dispatch:

concurrency:
  group: deploy-production
  cancel-in-progress: false

jobs:
  deploy:
    runs-on: ubuntu-latest
    steps:
      - name: Hold deployment slot
        run: |
          echo run=${{ github.run_id }}
          sleep 60
预期结果:第一次手动运行尚未结束时再次触发,第二次运行不会与第一次同时执行。
Run A: in progress
Run B: pending
状态名称和运行 ID 以 Actions 页面实际显示为准。如果继续触发更多同组运行,不应依赖等待任务按触发顺序逐个执行。
处理顺序
生产部署通常让 group 对应具体部署目标,并保持 cancel-in-progress: false,避免正在执行的发布被新提交中断。对于 lint、预览构建等只需要最新结果的任务,可考虑设置为 true。
并发组在同一仓库内生效,使用相同组名的其他工作流或 Job 也可能互相影响;组名不区分大小写。concurrency 与 GitHub Environment 的保护规则不是同一机制,仅配置 Environment 不会自动获得这里的并发互斥行为。
在并发组中启用 cancel-in-progress 后,新运行可取消当前正在执行的旧运行;适合提交频繁的分支 CI,但生产部署需谨慎评估取消副作用。
取消旧运行
当同一分支或同一部署目标频繁触发 GitHub Actions,而你只希望保留最新运行时,检查 concurrency.cancel-in-progress。它只会影响落入同一并发组的运行;启用后,新运行可取消该组内正在执行的旧运行。
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
concurrency.group 相同 |
运行被归入同一并发组 | 用分支、环境或其他稳定键限定取消范围 |
cancel-in-progress: true |
新运行可取消同组正在执行的旧运行 | 适合只关心最新提交结果的 CI |
cancel-in-progress: false 或未启用 |
正在执行的运行继续;同组只保留有限的待处理运行 | 需要完整执行历史或不能安全中断时使用 |
| 部署步骤有外部副作用 | 取消可能发生在部分变更已生效之后 | 不要直接套用分支 CI 策略;先确认部署可恢复或可重入 |
快速确认
把下面文件保存为 .github/workflows/cancel-demo.yml。同一分支连续触发两次时,两次运行会进入相同并发组。
name: Cancel demo
run-name: cancel demo - ${{ inputs.run_label }}

on:
  workflow_dispatch:
    inputs:
      run_label:
        description: Label used to distinguish test runs
        required: true
        type: string

concurrency:
  group: cancel-demo-${{ github.ref }}
  cancel-in-progress: true

jobs:
  wait:
    runs-on: ubuntu-latest
    steps:
      - name: Keep the first run active
        run: sleep 60
配置生效后,用 GitHub CLI 在同一分支快速触发两次并查看运行状态:
gh workflow run cancel-demo.yml -f run_label=first
gh workflow run cancel-demo.yml -f run_label=second
gh run list --workflow cancel-demo.yml --limit 5
预期结果:较旧且仍在执行的同组运行进入 cancelled,最新运行继续为 queued、in_progress 或最终 success。运行 ID、排队时间和完成时刻属于动态值,以实际仓库为准。
处理顺序
先确认哪些运行应该互斥,再设计 group;只需要淘汰旧分支 CI 时,可把分支引用放进组名。若只希望某个 Job 互斥,可把 concurrency 放在该 Job 上,避免取消整条 Workflow。
并发组内的执行顺序不应作为业务保证。对生产部署、数据库迁移、外部发布等不可随意中断的步骤,优先使用不会破坏外部状态的发布策略,并为中断后的重试或回滚留出恢复路径。
适用范围
以上语义适用于 GitHub Actions 的 Workflow/Job concurrency。具体上下文可用范围与语法以 GitHub Actions workflow syntax 为准。
复用与部署组合
在 Job 级使用 uses 调用可复用 Workflow,将共享流水线逻辑集中维护;调用时需遵循同仓库或跨仓库工作流文件的引用规则。
调用复用工作流
当多个 Workflow 需要共享一组 Job 时,检查 Job 级 uses。被调用文件必须声明 workflow_call;调用方直接把整个 Job 指向该工作流,而不是把它写进 steps。
怎么判读
| 写法或线索 | 含义 | 建议动作 |
|---|---|---|
uses: ./.github/workflows/reusable.yml |
调用同仓库、同一次提交中的可复用工作流 | 适合同仓库集中维护 |
uses: owner/repo/.github/workflows/reusable.yml@<ref> |
调用其他仓库或显式版本 | 生产场景优先固定到提交 SHA |
with: |
向被调用工作流传入已声明的 inputs | 名称和类型必须匹配 workflow_call.inputs |
secrets: 或 secrets: inherit |
传递所需 Secret | 只传最小权限集合;继承语义受组织/企业边界限制 |
uses 出现在 steps 下 |
这是 Action 调用位置,不是 reusable workflow 调用位置 | 把调用提升到 jobs.<job_id>.uses |
快速确认
先创建 .github/workflows/reusable-echo.yml:
name: Reusable echo

on:
  workflow_call:
    inputs:
      message:
        required: true
        type: string

jobs:
  echo:
    runs-on: ubuntu-latest
    steps:
      - name: Print message
        run: echo "message=${{ inputs.message }}"
再创建调用方 .github/workflows/caller.yml:
name: Call reusable workflow

on:
  workflow_dispatch:

jobs:
  call-echo:
    uses: ./.github/workflows/reusable-echo.yml
    with:
      message: hello-from-caller
推送两个文件后触发调用方并读取最新运行:
gh workflow run caller.yml
gh run list --workflow caller.yml --limit 1预期结果:caller.yml 的最新运行最终为 success;进入该运行的日志后,可以看到被调用 Job 输出 message=hello-from-caller。运行 ID、开始时间等动态值以实际仓库为准。
引用与边界
可复用工作流文件必须位于 .github/workflows,不能放在其子目录。使用 ./.github/workflows/... 时引用的是调用方同一次提交中的文件,不附加 @ref;跨仓库引用则使用 @ref,可指向提交 SHA、标签或分支。
jobs.<job_id>.uses 不接受上下文表达式来动态拼接路径或版本。调用 Job 也不是普通 runs-on Job:不要再给它添加 steps。如果需要继续处理结果,让被调用工作流声明 outputs,再由后续 Job 通过 needs 读取。
适用范围
以上规则适用于 GitHub Actions reusable workflows。仓库访问策略、Secret 继承范围和嵌套调用限制可能受 GitHub.com 或 GitHub Enterprise Server 版本影响,具体以 Reuse workflows 与 workflow syntax 为准。
可复用工作流通过 on.workflow_call.inputs 声明输入,调用方在 Job 的 with 中传值;输入类型和名称必须与被调用工作流的定义一致。
传递工作流输入
当可复用工作流需要由调用方提供非敏感参数时,查这个条目:在被调用工作流用 on.workflow_call.inputs 定义接口,在调用 Job 的 with 中传值,再通过 inputs 上下文读取。
值与含义
| 位置 | 含义 | 判读与动作 |
|---|---|---|
on.workflow_call.inputs.<input_id> |
被调用工作流声明一个输入 | 名称就是调用方 with 的键 |
type |
输入类型 | 声明输入时必须是 string、number 或 boolean |
required |
是否要求调用方提供 | 为 true 时调用方应显式传值 |
default |
未传值时使用的默认值 | 需要稳定默认行为时显式声明 |
jobs.<job_id>.with.<input_id> |
调用方提供输入 | 键名与类型必须匹配被调用工作流 |
inputs.<input_id> |
被调用工作流读取输入 | 用于步骤参数、表达式或命令 |
快速确认
先创建 .github/workflows/reusable.yml:
name: reusable-build

on:
  workflow_call:
    inputs:
      node_version:
        description: Node.js version
        required: true
        type: string

jobs:
  show-input:
    runs-on: ubuntu-latest
    steps:
      - name: Show input
        run: echo "node=${{ inputs.node_version }}"
再创建调用方工作流 .github/workflows/caller.yml:
name: call-reusable

on:
  workflow_dispatch:

jobs:
  call-build:
    uses: ./.github/workflows/reusable.yml
    with:
      node_version: "22"
预期结果:手动运行 call-reusable 后,被调用工作流的 Show input 步骤日志包含 node=22。若 with 使用未声明的输入名,或值类型与声明不匹配,应先修正调用方与 workflow_call.inputs 的接口定义。
处理顺序
先在被调用工作流确定输入名、类型、是否必填和默认值,再让调用方按同名键传值;最后在运行日志中确认被调用步骤拿到了预期值。普通配置值用 inputs,敏感数据不要放进 with,应改用 reusable workflow 的 secrets 机制。
可复用工作流可通过 workflow_call.secrets 声明需要接收的 Secret,调用方再按定义传递,从而明确敏感数据进入共享工作流的边界。
传递复用工作流 Secret
当共享工作流需要令牌、密码或其他敏感值时,查这个条目:在被调用工作流用 on.workflow_call.secrets 声明可接收的 Secret,调用 Job 再用 secrets 显式映射,步骤通过 secrets 上下文读取。
值与含义
| 位置 | 含义 | 判读与动作 |
|---|---|---|
on.workflow_call.secrets.<secret_id> |
被调用工作流声明 Secret 接口 | 名称决定调用方可传入的键 |
required: true |
调用必须提供该 Secret | 缺失时调用无法满足该接口要求 |
jobs.<job_id>.secrets.<secret_id> |
调用方把自己的 Secret 映射给被调用工作流 | 左侧键匹配声明名,右侧通常来自调用方 secrets 上下文 |
secrets.<secret_id> |
被调用工作流读取 Secret | 只在必要步骤中使用,避免写入日志 |
secrets: inherit |
继承调用方可用的 Secrets | 适用于支持继承的同组织或企业复用场景;显式映射更容易审计边界 |
快速确认
被调用工作流 .github/workflows/deploy-reusable.yml:
name: reusable-secret-check

on:
  workflow_call:
    secrets:
      deploy_token:
        required: true

jobs:
  verify-secret:
    runs-on: ubuntu-latest
    steps:
      - name: Check secret presence
        env:
          DEPLOY_TOKEN: ${{ secrets.deploy_token }}
        run: |
          test -n "$DEPLOY_TOKEN"
          echo "secret received"
调用方 .github/workflows/caller.yml:
name: call-secret-workflow

on:
  workflow_dispatch:

jobs:
  call-deploy:
    uses: ./.github/workflows/deploy-reusable.yml
    secrets:
      deploy_token: ${{ secrets.DEPLOY_TOKEN }}
预期结果:仓库已配置 DEPLOY_TOKEN 且调用有权限读取时,Check secret presence 步骤输出 secret received;示例不会打印 Secret 本身。未提供必需 Secret 时,应先检查调用方 Secret 是否存在、名称是否匹配,以及调用边界是否允许访问。
判读与边界
Secret 只会进入直接调用关系;存在 A 调 B、B 再调 C 的链路时,B 需要再次显式传给 C,不能假设自动向下透传。需要最小权限时优先逐项映射,而不是扩大继承范围。
在部署 Job 上配置 environment 后,可把该 Job 与目标环境的 Secret、变量和保护规则关联起来,适合 staging、production 等发布流程。
配置部署环境
当部署 Job 需要绑定 staging、production 等目标,并使用该环境的 Secret、变量或保护规则时,查 jobs.<job_id>.environment。引用环境后,保护规则先于 Runner 执行;通过后 Job 才能读取环境 Secret 并继续部署。
值与含义
| 写法或值 | 含义 | 建议动作 |
|---|---|---|
environment: production |
用字符串直接引用名为 production 的环境 |
只需环境名时优先使用 |
environment.name |
指定环境名称,可使用 GitHub 允许的表达式上下文 | 多环境共用工作流时按分支或矩阵生成名称 |
environment.url |
为部署记录提供目标 URL | 希望在部署记录或工作流图中直达目标时设置 |
| 环境 Secret | 只向引用该环境的 Job 提供 | 敏感值放 Secret,不要放普通变量 |
| 环境变量 | 通过 vars 上下文读取 |
放非敏感的主机名、区域、开关等配置 |
出现条件与执行顺序
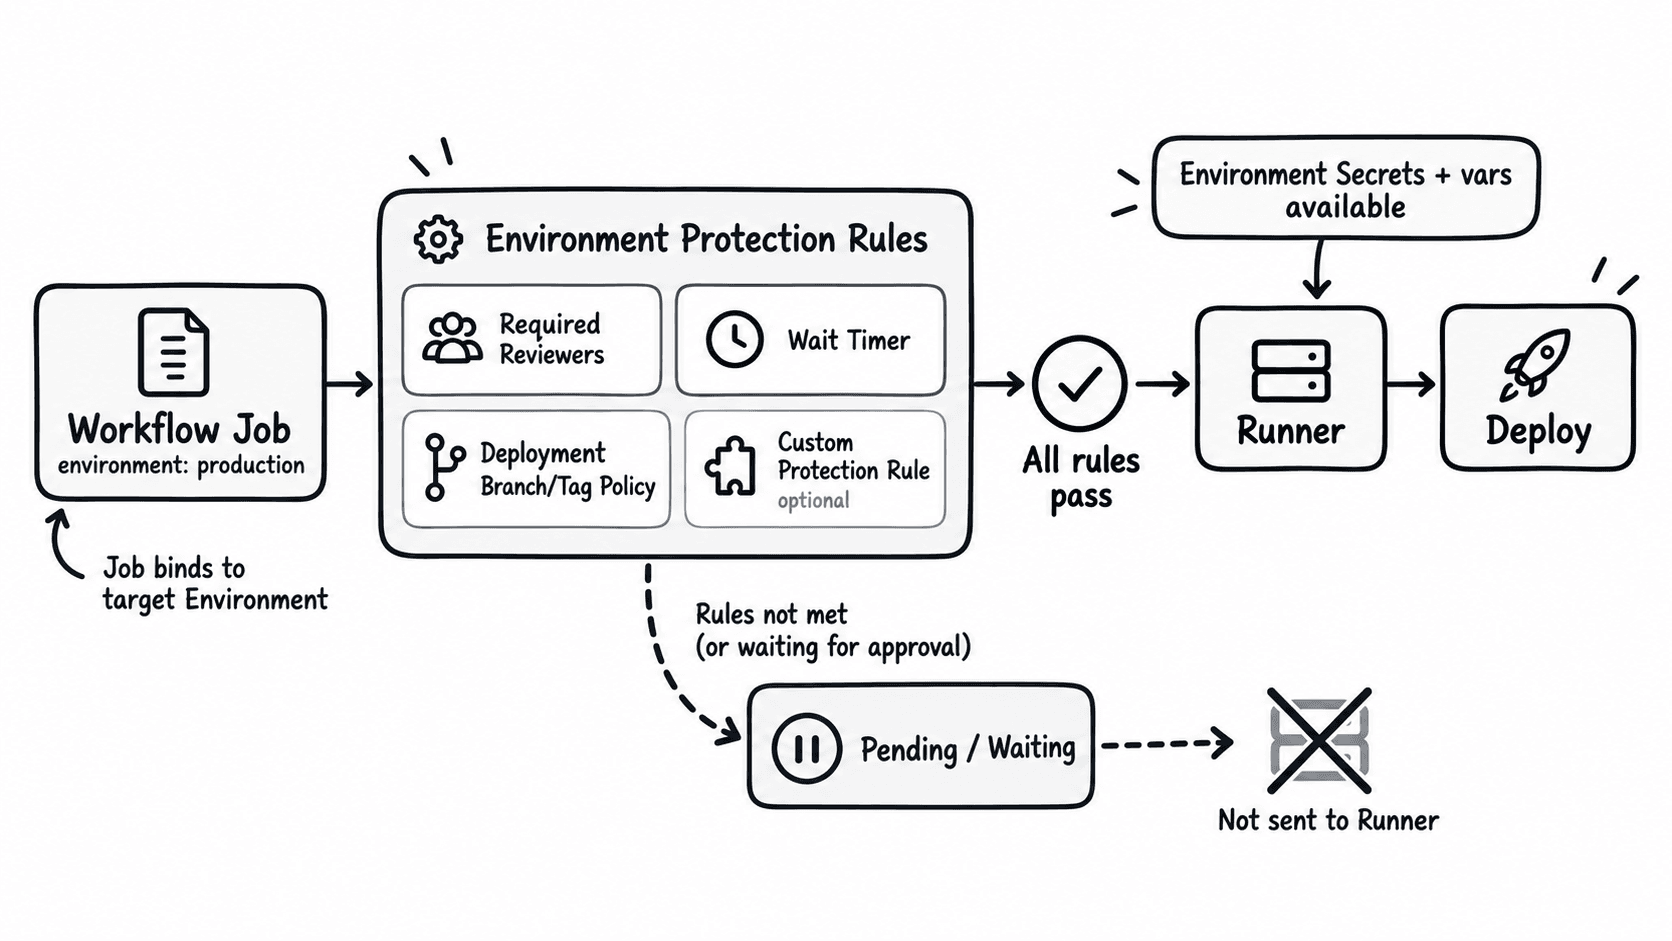
环境本身要先在仓库中配置好,才能稳定复用审核人、等待时间、分支或标签策略以及环境级 Secret。若环境没有配置保护规则,引用它不会凭空增加审批步骤;若配置了规则,Job 必须先通过适用规则。
可运行配置
前置条件:仓库已有 production 环境,并定义环境变量 DEPLOY_HOST 与环境 Secret DEPLOY_TOKEN。下面的工作流可手动触发,且不会打印 Secret 内容。
name: Environment demo

on:
  workflow_dispatch:

jobs:
  deploy:
    runs-on: ubuntu-latest
    environment: production
    env:
      DEPLOY_HOST: ${{ vars.DEPLOY_HOST }}
      DEPLOY_TOKEN: ${{ secrets.DEPLOY_TOKEN }}
    steps:
      - name: Verify environment configuration
        shell: bash
        run: |
          test -n "$DEPLOY_HOST"
          test -n "$DEPLOY_TOKEN"
          echo 'environment=production'
          echo 'host configured'
          echo 'secret available'
预期结果:若 production 有审批或等待规则,Job 会先处于等待状态;规则通过后才进入 Runner。配置项存在时日志为:
environment=production
host configured
secret available若任一变量为空,test -n 会让步骤失败,可据此确认环境配置没有正确提供给 Job。
判读与处理
| 现象 | 常见含义 | 建议动作 |
|---|---|---|
| Job 在进入 Runner 前等待 | 环境保护规则尚未全部通过 | 检查审批、等待计时、部署分支或标签策略 |
DEPLOY_TOKEN 为空 |
对应环境 Secret 未定义、名称不匹配或当前 Job 没有引用预期环境 | 核对环境名与 Secret 键名 |
| 分支无法部署到环境 | 环境的部署分支或标签策略不允许当前引用 | 调整触发分支或环境策略,不要绕过策略 |
| 需要环境配置但不想记录部署 | 可使用当前 GitHub Actions 支持的 environment.deployment: false |
先确认环境未启用与该模式不兼容的自定义部署保护规则 |
适用范围
以上语义按 GitHub Actions 当前 jobs.<job_id>.environment 与部署环境文档判读;环境功能、保护规则以及私有仓库可用性会受仓库可见性、方案和管理员配置影响。自定义部署保护规则仍可能带有预览或方案限制,遇到差异应以目标仓库当前 GitHub 文档与设置为准。GitHub Docs
在单个 Job 下声明 concurrency 可只限制该 Job 的并发,而不阻塞整个工作流;常用于生产部署、迁移或共享资源访问。
配置 Job 级并发组
当只有部署、迁移或共享资源访问这类单个 Job 必须串行,而同一工作流里的测试、检查等其他 Job 仍可并行时,查 jobs.<job_id>.concurrency。相同并发组在同一仓库内同时最多运行一个 Job 或工作流成员;Job 级配置不会自动阻塞整个工作流。
值与含义
| 配置 | 含义 | 建议动作 |
|---|---|---|
group |
定义并发组;相同组名会互相竞争运行资格 | 用稳定且能区分目标资源的键,例如 production-deploy |
cancel-in-progress: false |
新成员等待当前运行成员结束 | 部署、数据库迁移等不宜中途取消的任务优先使用 |
cancel-in-progress: true |
新成员可取消同组当前运行成员 | 只用于可安全中断、旧结果可直接丢弃的任务 |
| 默认等待队列 | 同组已有运行成员时,新成员进入等待;默认只保留一个等待成员 | 不要把它当成无限排队机制 |
group 名称不区分大小写。Job 级 group 与 cancel-in-progress 可使用 GitHub 文档允许的上下文表达式;不要依赖实际调度时间来实现业务顺序。
执行关系
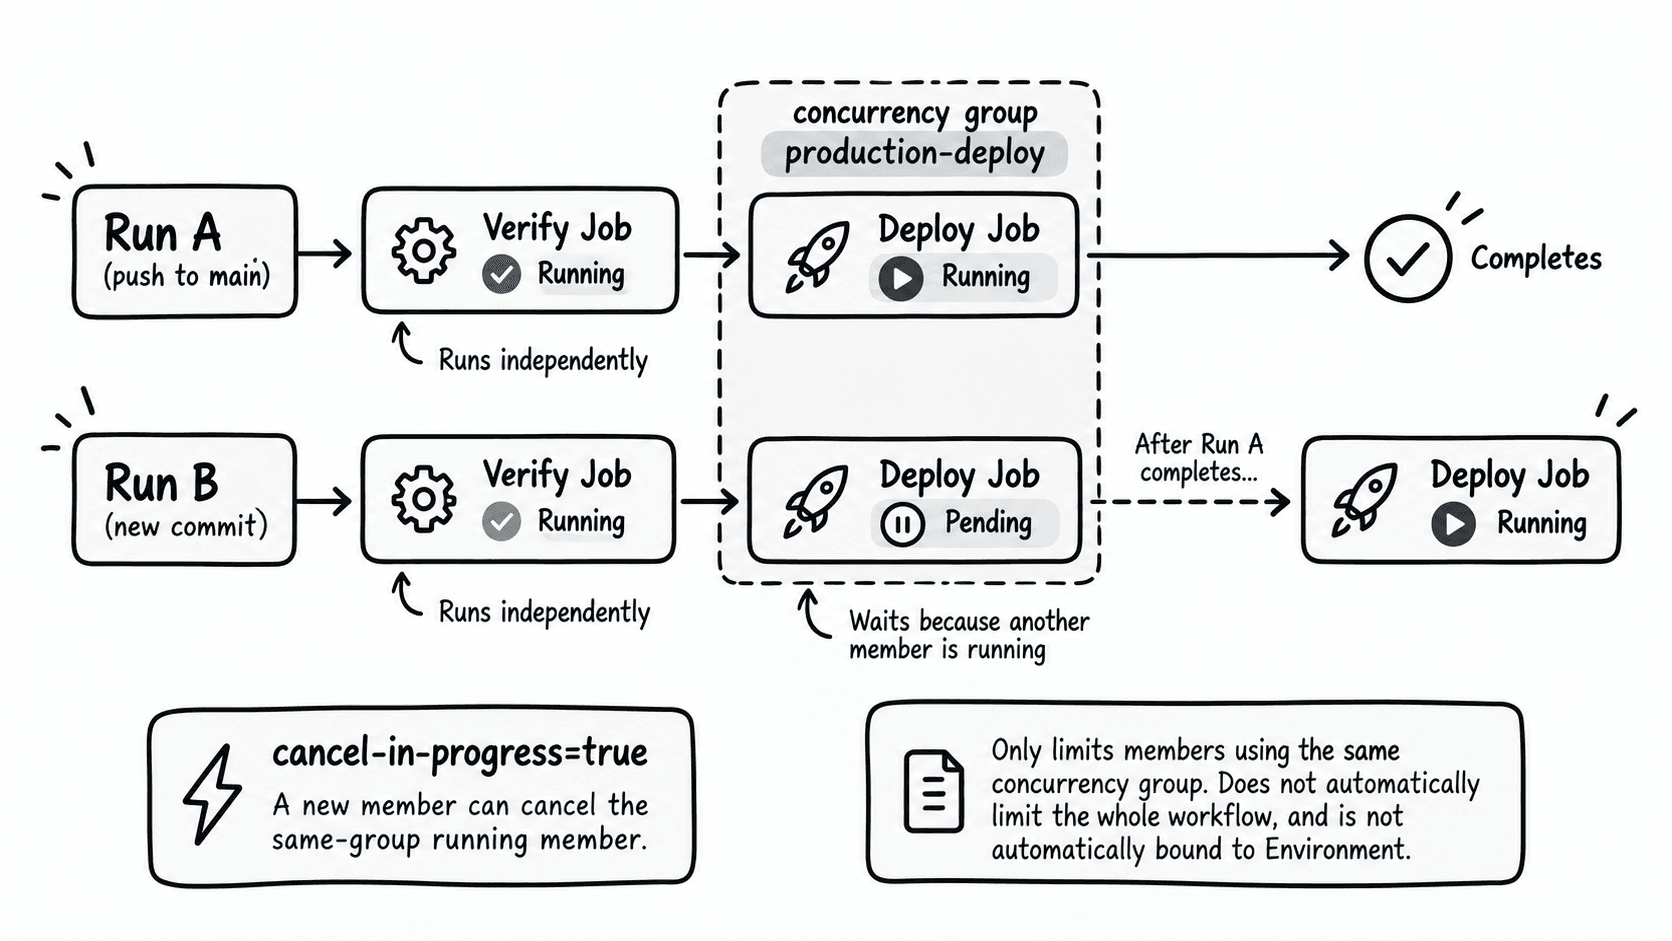
把 concurrency 放在 Job 下时,只有该 Job 参与并发组竞争。即使并发组名称写成 production,它也不会自动与名为 production 的 Environment 建立绑定;其他没有声明同组并发的 Job 仍按自身条件调度。
可运行配置
下面的工作流包含一个不受限制的 verify Job 和一个受 production-deploy 约束的 deploy Job。手动连续触发两次,并把第二次触发放在第一次 deploy 的 30 秒等待期内即可观察差异。
name: Job concurrency demo

on:
  workflow_dispatch:

jobs:
  verify:
    runs-on: ubuntu-latest
    steps:
      - name: Verify
        run: echo 'verify can run independently'

  deploy:
    runs-on: ubuntu-latest
    concurrency:
      group: production-deploy
      cancel-in-progress: false
    steps:
      - name: Simulate deployment
        shell: bash
        run: |
          echo 'deploy start'
          sleep 30
          echo 'deploy done'
预期结果:第二次运行的 verify 可以独立执行;若第一次 deploy 尚未结束,第二次 deploy 会等待。第一次结束后,第二次才继续并输出:
deploy start
deploy done
如果在已有一个 Running 和一个 Pending 的同组成员时再排入新的同组成员,默认等待策略会用新的等待成员替换旧的 Pending 成员;需要保留更多等待成员时,应先核对目标仓库当前 GitHub Actions 对并发队列选项的支持范围。
判读与处理
| 现象 | 常见含义 | 建议动作 |
|---|---|---|
| 只有部署 Job 等待,测试仍运行 | concurrency 正确放在 Job 级 |
保持 Job 级配置 |
| 新运行把正在执行的部署取消 | cancel-in-progress 为 true 或表达式求值为真 |
不可中断部署改为 false |
| 不同工作流里的 Job 互相等待 | 它们在同一仓库使用了相同 group |
在组名加入环境、分支或资源标识 |
| 使用 Environment 但仍出现并行部署 | Environment 与 concurrency 没有自动关联 |
在需要串行的部署 Job 上显式声明相同并发组 |
适用范围
以上按 GitHub Actions 当前工作流语法判读。Job 级并发组作用于同一仓库中使用相同组键的 Job 或工作流成员,组名不区分大小写;调度起始时间仍可能变化,因此不要把并发组当作严格的业务排序队列。GitHub Docs