
计算机网络 / 知识点
网络协议常用报文格式速查
链路层与网络层
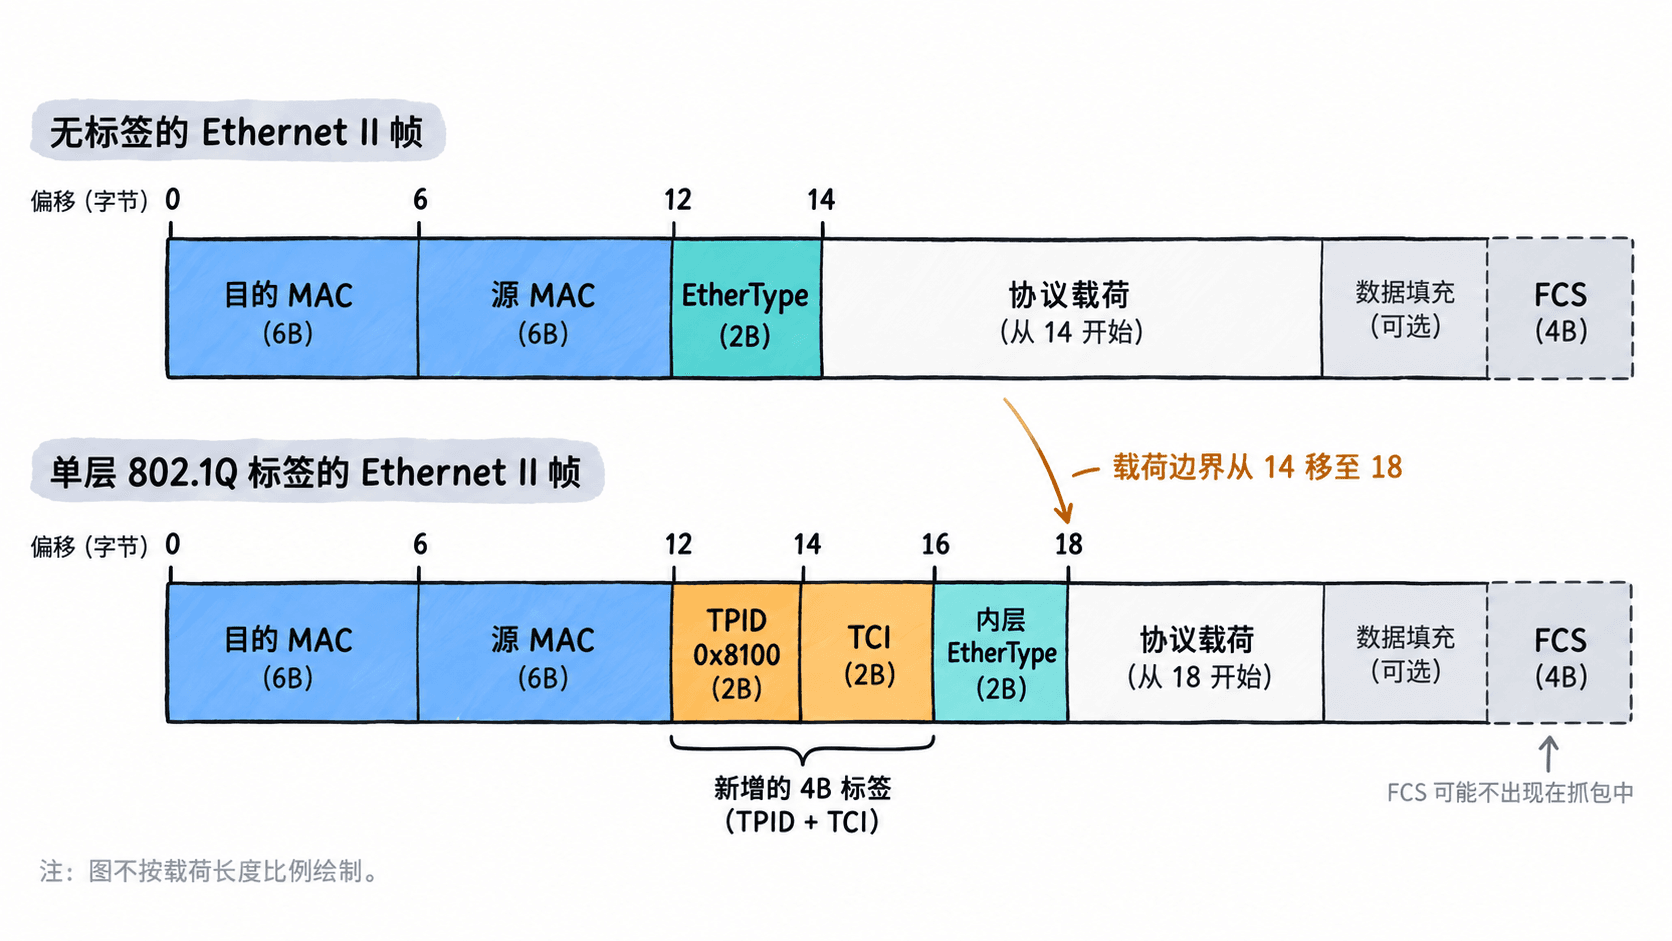
对照目的 MAC、源 MAC、EtherType 与载荷位置,适合从原始链路层字节流确认上层协议类型,并识别以太网帧头边界。
Ethernet II 帧
查看原始以太网字节、需要确认“谁发给谁、上层协议从哪里开始”时查本条。先定位目的 MAC,再读取 EtherType;遇到 VLAN 标签或长度型字段时,及时切换解析方式,避免整段载荷错位。
字段与字节位置
以下偏移从目的 MAC 首字节算起,适用于未带 VLAN 标签的常规 Ethernet II 帧。MAC 头共 14 字节;EtherType 按网络字节序读取,即高位字节在前。数据填充与 FCS 不属于这个 14 字节头。([RFC 编辑器][1])
| 偏移/长度 | 字段 | 含义与读取动作 |
|---|---|---|
| 0–5/6 字节 | 目的 MAC | 接收地址;全 ff 表示广播 |
| 6–11/6 字节 | 源 MAC | 发送地址,不要与目的地址交换 |
| 12–13/2 字节 | EtherType | 确定后续协议或标签类型 |
| 14 起/46–1500 字节 | 数据与填充 | 常规无标签帧的数据区;按上层协议确定有效数据边界 |
| 数据区之后/4 字节 | FCS | 帧校验序列;抓包可能不包含,不能盲删末尾 4 字节 |
类型值怎么判读
下表列出常用已分配类型,数值为十六进制;类型值说明后面承载什么,不等于后续内容一定完整、合法。([互联网号码分配局][2])
| EtherType | 含义 | 建议动作 |
|---|---|---|
0x0800 |
IPv4 | 从载荷起点核对 IPv4 首部 |
0x0806 |
ARP | 按 ARP 类型、长度和地址字段解析 |
0x86DD |
IPv6 | 按 IPv6 首部解析,不套 IPv4 偏移 |
0x8100 |
客户 VLAN 标签,C-Tag | 先读取标签,再识别内层类型 |
0x88A8 |
服务 VLAN 标签,S-Tag | 检查后续是否还有标签,不直接当 IP 头 |
同一位置若读出 0–1500,应按 IEEE 802.3 长度型封装继续检查;大于等于 1536(0x0600)才属于 EtherType 数值范围。1501–1535 是未定义区间,不能硬套任一正常格式,应先核对偏移与原始字节。([RFC 编辑器][3])
VLAN 会移动载荷边界
保留单层 VLAN 标签时,偏移 12–13 是标签协议标识 TPID,14–15 是标签控制信息 TCI,16–17 才是内层类型,协议载荷从 18 开始。每叠加一层标准 VLAN 标签,后续边界再向后移动 4 字节;遇到不认识的类型,应停止猜测其内部布局。([Wireshark Wiki][4])
离线核对字节
在 Python 3.8 或更高版本中运行以下完整程序,仅使用标准库,不发包。它构造一份固定样本并解析帧头;补零是样本构造步骤,不是修复真实抓包的方法。
import struct

# 固定样本:14 字节以太网头 + 28 字节 ARP,不含前导码和 FCS。
frame = bytes.fromhex(
    "ff ff ff ff ff ff 02 00 00 00 00 0a 08 06 "
    "00 01 08 00 06 04 00 01 "
    "02 00 00 00 00 0a c0 00 02 0a "
    "00 00 00 00 00 00 c0 00 02 01"
)
# 补 18 字节,使无 FCS 的样本长度达到 60 字节。
frame += bytes(60 - len(frame))
dst, src, ether_type = struct.unpack("!6s6sH", frame[:14])

# 本例不处理长度型帧或 VLAN,避免误用固定载荷偏移。
if ether_type < 0x0600 or ether_type in (0x8100, 0x88A8):
    raise ValueError("本例仅支持未带 VLAN 标签的 Ethernet II")

print(f"dst={dst.hex(':')}")
print(f"src={src.hex(':')}")
print(f"EtherType=0x{ether_type:04X}")
print("payload_offset=14")
print(f"captured_length={len(frame)}")
print(f"data_and_padding={len(frame) - 14}")
预期输出:
dst=ff:ff:ff:ff:ff:ff
src=02:00:00:00:00:0a
EtherType=0x0806
payload_offset=14
captured_length=60
data_and_padding=46
本例的 0x0806 对应 ARP,载荷偏移为 14。数据区的 46 字节由 28 字节 ARP 和 18 字节填充构成;程序没有生成或验证 FCS,也不代表网络上实际存在这些主机。
抓包边界与适用范围
常规无标签帧从目的 MAC 到 FCS 合计为 64–1518 字节;若仅去掉 FCS,则为 60–1514 字节。普通抓包通常也没有前导码和帧开始定界符 SFD,因此看到 60 字节不能直接判为短帧。巨型帧等扩展不适用这里的常规长度上限。([Wireshark Wiki][5])
排查错位时,先确认输入已经定位到以太网 MAC 头,再检查 VLAN 标签与捕获截断;不要把抓包文件头、记录头或其他链路头当作目的 MAC,也不要用补零掩盖缺失字节。
协议标识规则参考 RFC 9542,IPv4 承载规则参考 RFC 894;EtherType 分配以 IEEE 注册资料为准,IANA 的 IEEE 802 Numbers 页面用于对照。捕获是否保留 FCS、标签和填充,还需结合设备与驱动判断。([RFC 编辑器][3])
查询硬件类型、协议类型、操作码以及发送端和目标端地址字段,适合分析 IPv4 网络中的地址解析请求与应答。
ARP 报文
需要确认某个 IPv4 地址由哪个 MAC 应答,或区分普通解析、地址探测与地址通告时查本条。核对操作码和四个地址字段后,可读出“谁在询问谁、谁宣告了哪条映射”,避免混淆以太网目的地址与 ARP 目标地址。
字段与偏移
下表限定 Ethernet/IPv4,偏移从 ARP 报文本体首字节开始。外层 Ethernet 的 EtherType 是 0x0806,ARP 内部的 PTYPE 是 0x0800;后者表示正在解析 IPv4 地址,不表示 ARP 外面还有 IPv4 首部。([RFC 编辑器][1])
| 偏移/长度 | 字段 | 常见值与含义 |
|---|---|---|
| 0–1/2 字节 | HTYPE | 0x0001:Ethernet 硬件地址类型 |
| 2–3/2 字节 | PTYPE | 0x0800:IPv4 协议地址类型 |
| 4/1 字节 | HLEN | 6:每个硬件地址长 6 字节 |
| 5/1 字节 | PLEN | 4:每个 IPv4 地址长 4 字节 |
| 6–7/2 字节 | OPER | 1 请求,2 应答 |
| 8–13/6 字节 | SHA | 发送端 MAC |
| 14–17/4 字节 | SPA | 发送端 IPv4 地址 |
| 18–23/6 字节 | THA | 目标端 MAC;普通请求中可能尚未知 |
| 24–27/4 字节 | TPA | 目标端 IPv4 地址 |
HTYPE、PTYPE、OPER 均按网络字节序读取。报文本体由 8 字节固定首部、两个硬件地址和两个协议地址组成,在本表条件下才是 28 字节;其他地址类型必须根据 HLEN、PLEN 重新计算边界。以太网为满足最小帧长添加的填充,不是额外 ARP 字段。([RFC 编辑器][1])
操作码与出现条件
普通请求、应答按 RFC 826 判读;地址探测和下表的地址通告按 RFC 5227 判读。不要只看到广播或全零地址就认定报文异常。([RFC 编辑器][1])
| 观察到的值或条件 | 含义 | 建议动作 |
|---|---|---|
OPER=1,SPA 非零且与 TPA 不同 |
通常是普通地址解析请求 | 查看 TPA,确认正在查询哪个下一跳 |
OPER=2 |
ARP 应答 | 从 SPA 与 SHA 读取发送端宣告的映射 |
广播请求,SPA=0.0.0.0 |
ARP Probe,探测地址是否被占用 | 把 TPA 当作候选地址,不把 SPA 当作已配置地址 |
广播请求,SPA=TPA 且非零 |
RFC 5227 的 ARP Announcement | 按地址通告或冲突防御线索检查,不当作普通“查询自己” |
普通解析请求通常广播,应答通常单播。未知的 THA 常见为全零,但普通请求不要求它必须取零;探测报文则按 RFC 5227 建议置零。某些通告也使用无对应请求的 ARP 应答,不能仅凭 OPER=2 推定一定存在先前请求。([RFC 编辑器][1])
请求与应答的字段方向
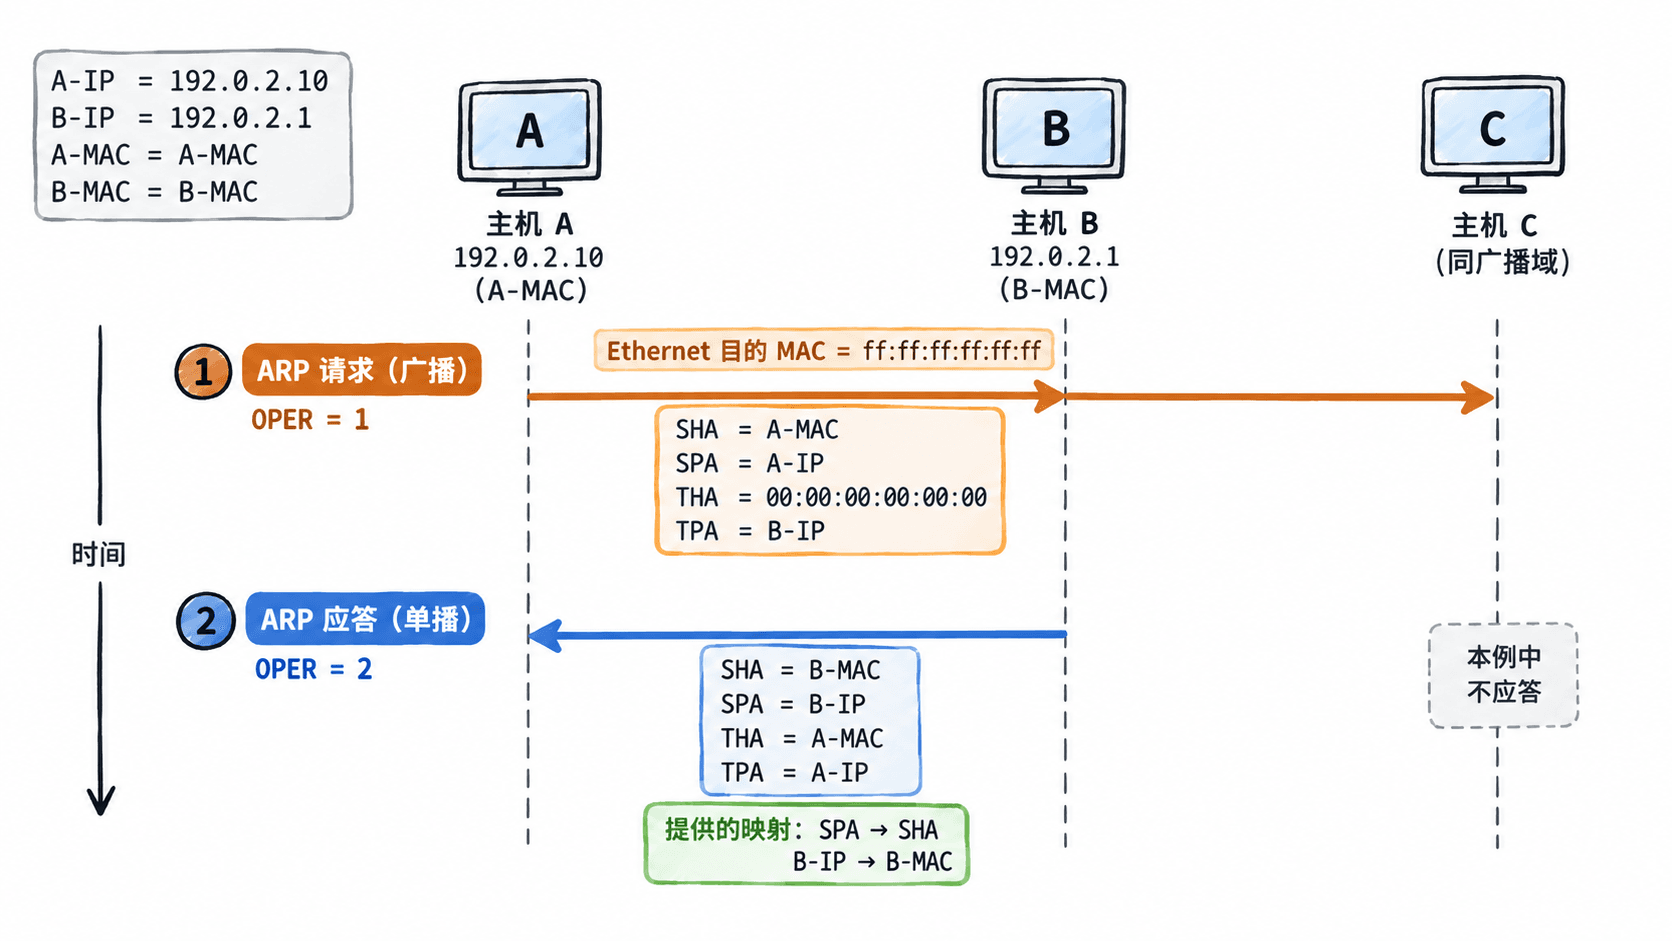
A 查询 B 时,请求中的 TPA 指向 B;B 回答时,自己的 SPA、SHA 才构成答案,而 THA、TPA 指回 A。以太网广播目的 MAC 与请求中的未知 THA 是不同字段,不能互相替代。([RFC 编辑器][1])
离线解析样本
在 Python 3.8 或更高版本中运行以下完整程序。样本是固定构造的 28 字节 ARP 请求本体,地址仅供演示,不含以太网头、填充或 FCS,不需要抓包权限。
import struct
from ipaddress import IPv4Address

# 固定的 ARP 请求本体;不含以太网头、填充或 FCS。
arp = bytes.fromhex(
    "00 01 08 00 06 04 00 01 "
    "02 00 00 00 00 0a c0 00 02 0a "
    "00 00 00 00 00 00 c0 00 02 01"
)
if len(arp) < 8:
    raise ValueError("ARP 固定首部不足 8 字节")
htype, ptype, hlen, plen, oper = struct.unpack("!HHBBH", arp[:8])

# 先校验地址类型与长度,才使用 Ethernet/IPv4 的地址布局。
if (htype, ptype, hlen, plen) != (1, 0x0800, 6, 4):
    raise ValueError("本例仅支持 Ethernet/IPv4 ARP")
required = 8 + 2 * hlen + 2 * plen
if len(arp) < required:
    raise ValueError("ARP 地址字段被截断")
sha, spa, tha, tpa = struct.unpack("!6s4s6s4s", arp[8:required])

name = {1: "REQUEST", 2: "REPLY"}.get(oper, "OTHER")
print(f"OPER={oper} ({name})")
print(f"SHA={sha.hex(':')}")
print(f"SPA={IPv4Address(spa)}")
print(f"THA={tha.hex(':')}")
print(f"TPA={IPv4Address(tpa)}")
print(f"ARP_length={required}")
预期输出:
OPER=1 (REQUEST)
SHA=02:00:00:00:00:0a
SPA=192.0.2.10
THA=00:00:00:00:00:00
TPA=192.0.2.1
ARP_length=28
该样本表示 192.0.2.10 询问 192.0.2.1 的 MAC;全零 THA 表示目标硬件地址尚未知。它不是应答,不能据此把目标 IP 的 MAC 记录为全零。
异常线索与适用范围
重复请求却看不到应答时,先确认抓包覆盖了回程,再检查 TPA 是否为路由选定的本链路下一跳、目标是否在线及 VLAN 是否一致。访问远端网络时,ARP 通常解析网关的 MAC,而不是远端服务器的 MAC;缓存已有映射时也可能不产生新请求。([RFC 编辑器][1])
基础字段与普通交互依据 RFC 826,探测和通告依据 RFC 5227。硬件类型及扩展操作码对照 IANA ARP Parameters;未知操作码不自动等于坏包,缓存老化与重试间隔也不是本报文格式规定的固定值。([互联网号码分配局][7])
对照版本、首部长度、总长度、分片、TTL、协议号与地址字段,适合解析 IPv4 数据报并判断可变长度首部和载荷边界。
IPv4 首部
读取 IPv4 抓包或十六进制数据时,用本条核对字段位置、实际首部长度和分片状态,确定载荷从哪里开始,以及哪些字节必须先重组才能继续解析。
字段与偏移对照
偏移从 IPv4 首字节的 0 开始,多字节整数按网络字节序,也就是大端读取。基础布局及长度定义依据 RFC 791 第 3.1 节。([RFC 编辑器][1])
| 字节偏移 | 字段与位宽 | 含义与建议动作 |
|---|---|---|
| 0 | Version 4 位、IHL 4 位 | 高 4 位必须为 4;低 4 位有效值 5~15,乘 4 得到首部字节数 |
| 1 | DSCP 6 位、ECN 2 位 | 分别取高 6 位与低 2 位,不把整个字节当作 DSCP |
| 2~3 | Total Length 16 位 | 当前数据报首部加载荷的总字节数;最大 65535,不得小于首部长度 |
| 4~5 | Identification 16 位 | 分片重组标识,不是传输层序号 |
| 6~7 | Flags 3 位、Fragment Offset 13 位 | 标志从高到低为保留位、DF、MF;保留位为 0;偏移单位为 8 字节 |
| 8 | TTL 8 位 | 转发时递减;不是已经经过的跳数 |
| 9 | Protocol 8 位 | 1 为 ICMP,6 为 TCP,17 为 UDP;据此选择上层解析器 |
| 10~11 | Header Checksum 16 位 | 只校验 IPv4 首部,包含选项,不包含载荷 |
| 12~15、16~19 | 源地址、目的地址,各 32 位 | 分别读取 4 字节,不按主机端整数顺序颠倒 |
| 20 至首部末尾 | Options 与 Padding,0~40 字节 | 仅当 IHL 大于 5 时存在;不能固定跳过 20 字节就读取载荷 |
DSCP/ECN 的拆分采用 RFC 3168,Protocol 数值以 IANA 登记表为准。转发路由器须将 TTL 至少减 1,降到 0 后不得继续转发。([RFC 编辑器][2])
载荷从哪里开始
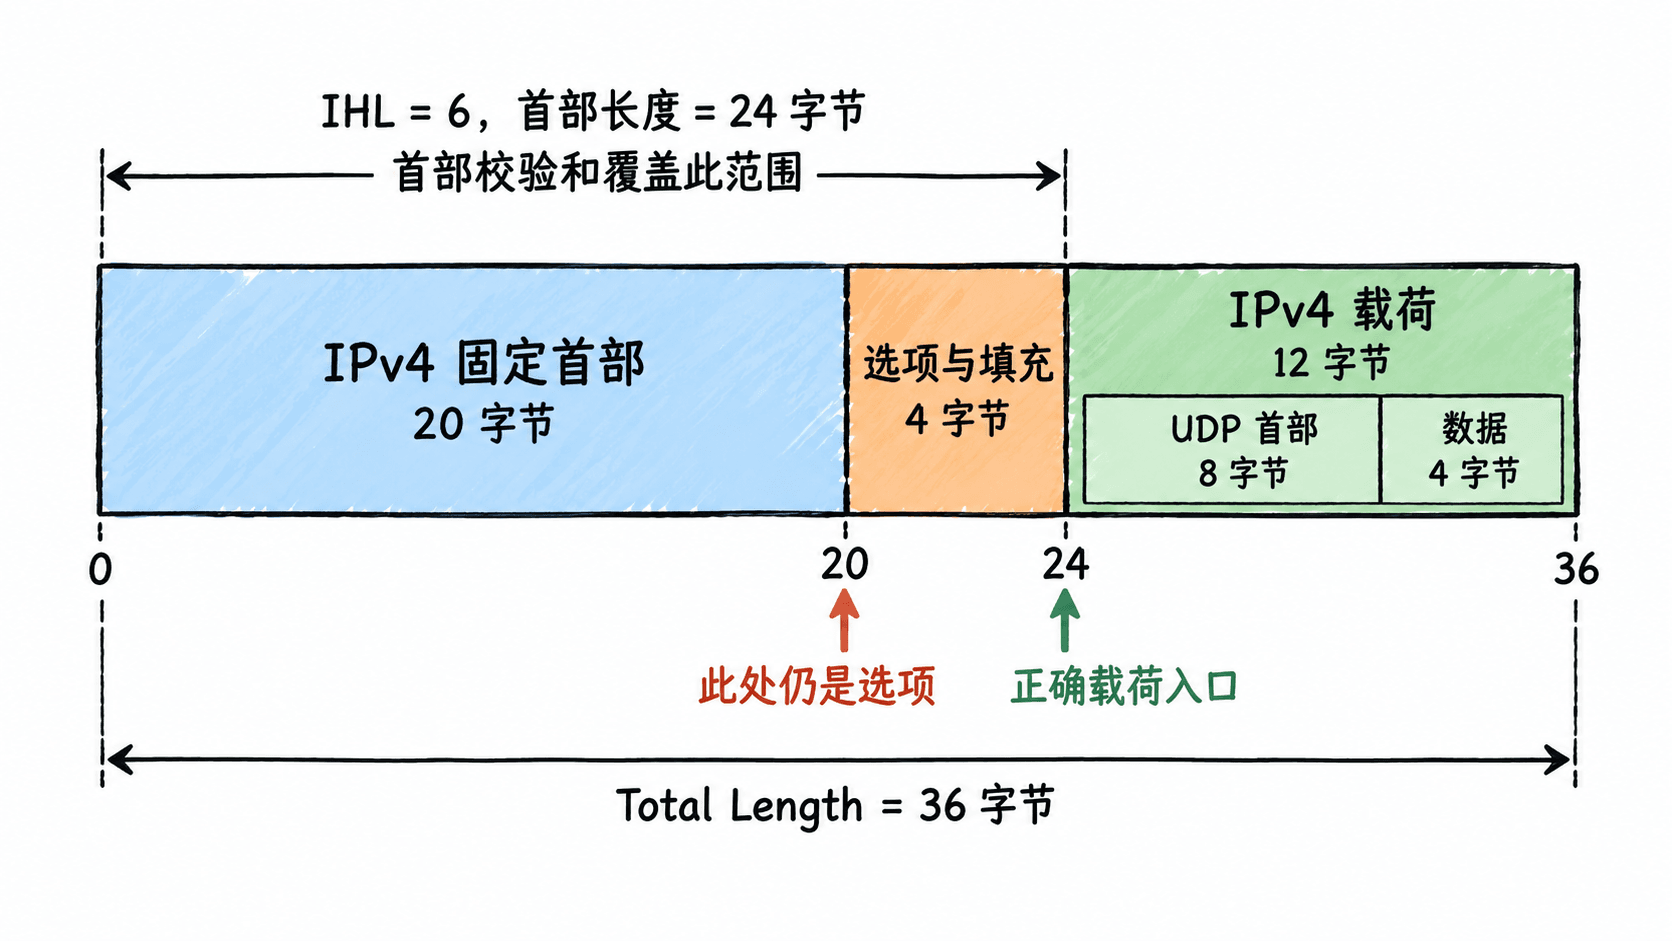
将 IHL 乘 4 得到首部长度,再从 Total Length 中减去它得到本数据报的 IPv4 载荷长度。分片报文里的 Total Length 也是当前片的长度,不是重组后的原始长度。([RFC 编辑器][1])
下面样本的 IHL 为 6,总长为 36 字节,因此首部占前 24 字节,后 12 字节才是 IPv4 载荷。偏移 20 仍处于选项区,直接从这里读取 UDP 会错位。
分片标志怎么判读
Fragment Offset 相对原始 IPv4 载荷起点计算,换成字节需乘 8。MF 表示后面还有分片,必须与偏移联合判断;除尾片外,分片载荷长度应为 8 字节的整数倍。([RFC 编辑器][1])
| MF 与偏移值 | 含义 | 建议动作 |
|---|---|---|
| MF=0,偏移=0 | 未分片数据报 | 检查长度后按 Protocol 解析 |
| MF=1,偏移=0 | 首片 | 确认上层首部齐全再读取;完整载荷仍需重组 |
| MF=1,偏移大于 0 | 中间片 | 不从本片开头读取端口,交给重组逻辑 |
| MF=0,偏移大于 0 | 尾片 | 不等于完整数据报,仍需关联其他分片 |
DF 为 1 表示禁止分片,不代表已经分片。重组时用源地址、目的地址、Protocol 和 Identification 关联;DF=1、MF=0、偏移=0 时,Identification 不具重组意义,不能用于去重。([RFC 编辑器][3])
最小验证
用 Python 3.8+ 运行以下完整脚本,仅使用标准库,不发送网络报文。地址和字段值均为固定教学样本;代码按实际 IHL 验证首部校验和,并截取声明长度内的载荷。校验和采用 16 位反码加法。([RFC 编辑器][4])
import struct
from ipaddress import IPv4Address

# 固定样本已去掉链路层封装;包含 4 字节选项与填充。
packet = bytes.fromhex(
    "460000240000400040114c91c0000201c6336402"
    "010100003039d431000c000074657374"
)
if len(packet) < 20:
    raise ValueError("IPv4 基础字段不完整")
fields = struct.unpack("!BBHHHBBH4s4s", packet[:20])
vihl, ds, total, ident, frag, ttl, proto, check, src, dst = fields
version, header_len = vihl >> 4, (vihl & 0x0f) * 4
if version != 4 or not 20 <= header_len <= 60:
    raise ValueError("版本或 IHL 无效")
if not header_len <= total <= len(packet):
    raise ValueError("声明长度无效,或样本已截断")

# 校验范围包含选项;回卷进位后的和应为 0xffff。
value = sum(struct.unpack(f"!{header_len // 2}H", packet[:header_len]))
while value >> 16:
    value = (value & 0xffff) + (value >> 16)
if value != 0xffff:
    raise ValueError("IPv4 首部校验和错误")

# DF、MF 与偏移共用两个字节;偏移须换算成字节。
df, mf = (frag >> 14) & 1, (frag >> 13) & 1
offset = (frag & 0x1fff) * 8
print(f"version={version} header={header_len} total={total} payload={total - header_len}")
print(f"DSCP={ds >> 2} ECN={ds & 3} ID={ident} DF={df} MF={mf} offset_bytes={offset}")
print(f"TTL={ttl} protocol={proto} checksum_ok={value == 0xffff}")
print(f"src={IPv4Address(src)} dst={IPv4Address(dst)}")
print(f"options={packet[20:header_len].hex()}")
print(f"payload_hex={packet[header_len:total].hex()}")
预期输出:
version=4 header=24 total=36 payload=12
DSCP=0 ECN=0 ID=0 DF=1 MF=0 offset_bytes=0
TTL=64 protocol=17 checksum_ok=True
src=192.0.2.1 dst=198.51.100.2
options=01010000
payload_hex=3039d431000c000074657374
这里的 12 字节仍包含 8 字节 UDP 首部和 4 字节数据,并非全部都是应用数据。该脚本不展开选项语义、不重组分片,也不验证 UDP。UDP 首部长度定义见 RFC 768。([RFC 编辑器][5])
异常与适用范围
本条适用于标准 IPv4 网络层数据报。替换真实抓包时,先按链路类型定位 IPv4 起点;长度不足应检查截断或起点错误,不要补零后冒充完整数据报。
本机发出的包可能在硬件补齐校验和之前就被捕获。出现校验和错误时,先检查卸载影响,必要时在接收端重新抓包;不能仅凭发送端抓包中的错误标记认定线上报文损坏。([Wireshark][6])
查询固定 40 字节基本首部中的流量类别、流标签、载荷长度、下一首部和地址字段,适合定位 IPv6 载荷及扩展首部入口。
IPv6 基本首部
读取 IPv6 抓包时,用本条核对固定首部字段、确认包尾,并从 Next Header 找到扩展首部入口。重点是分清基本首部、IPv6 载荷和最终上层报文,避免把扩展首部误读成 TCP 或 UDP。
固定首部字段对照
基本首部固定为 40 字节,没有 IHL 和首部校验和字段。下表偏移从 IPv6 首字节的 0 开始,多字节整数按大端读取;布局依据 RFC 8200 第 3 节。([RFC 编辑器][7])
| 字节或位位置 | 字段与位宽 | 含义与建议动作 |
|---|---|---|
| 字节 0 的高 4 位 | Version 4 位 | 必须为 6,否则停止按 IPv6 解释 |
| 字节 0 低 4 位及字节 1 高 4 位 | Traffic Class 8 位 | 跨两个字节,不能直接读取整个字节 1 |
| 字节 1 低 4 位至字节 3 | Flow Label 20 位 | 首个 32 位整数的低 20 位,用于流标记 |
| 4~5 | Payload Length 16 位 | 基本首部之后的字节数;包含扩展首部,不含前 40 字节 |
| 6 | Next Header 8 位 | 标识紧接着的首部,不保证就是最终传输层协议 |
| 7 | Hop Limit 8 位 | 每次转发减 1;为 0 或减至 0 时不得继续转发 |
| 8~23 | Source Address 128 位 | 读取 16 字节源地址 |
| 24~39 | Destination Address 128 位 | 当前目的地址;存在路由首部时,不一定是最终接收者 |
Traffic Class 同样拆成高 6 位 DSCP 与低 2 位 ECN。Flow Label 为 0 表示未标记;它不是端口号,也不直接承诺优先级或带宽。([RFC 编辑器][2])
Next Header 值与动作
下列数值属于 IANA Protocol Numbers 登记空间,与 IPv4 Protocol 共用。查到的是当前位置后面紧接的类型,不是在整包内搜索某种首部的指令。([互联网号码分配局][8])
| 值 | 后继类型 | 建议动作 |
|---|---|---|
| 6、17、58 | TCP、UDP、ICMPv6 | 到达相应上层入口,再按该协议检查长度 |
| 0 | Hop-by-Hop Options,逐跳选项 | 必须紧接 IPv6 基本首部;读取其长度和后继类型 |
| 43、60 | Routing、Destination Options | 按该类型读取长度,再沿内部 Next Header 继续 |
| 44 | Fragment,分片首部 | 固定 8 字节;检查分片偏移和 M 位,非首片不能直接当上层首部解析 |
| 50、51 | ESP、AH | 分别按 IPsec 格式处理,不套用普通选项首部长度算法 |
| 59 | No Next Header | 停止首部链解析,不再猜测 TCP 或 UDP |
逐跳选项、路由和目的选项首部的长度,均为 Hdr Ext Len 加 1 后乘 8 字节。不要把这一计算套到分片、AH 或 ESP;未知类型应记录并停止猜测。相应格式见 RFC 8200 第 4 节。([RFC 编辑器][7])
长度与扩展入口
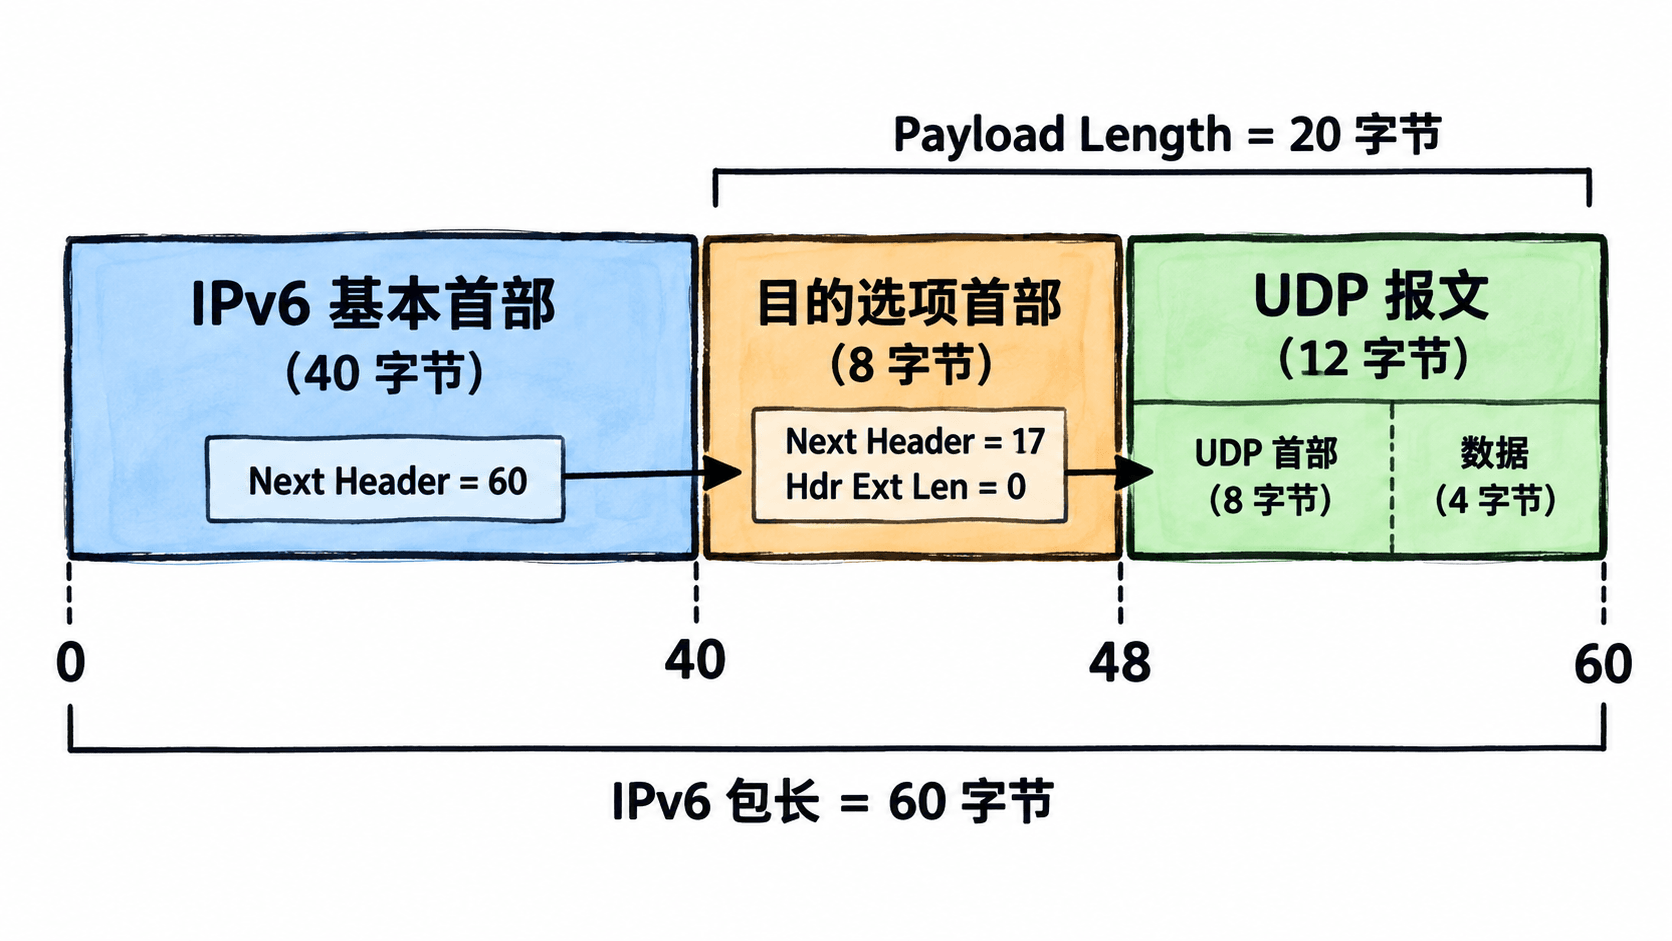
普通非 Jumbogram 报文的包长为 40 加 Payload Length。上层入口还要越过实际存在的扩展首部;每推进一次,都要确认首部长度没有越过声明包尾。([RFC 编辑器][7])
下面固定样本的 Payload Length 为 20:8 字节目的选项首部加 12 字节 UDP。因此包长为 60 字节,UDP 从偏移 48 开始,而不是偏移 40。
固定样本验证
用 Python 3.8+ 运行以下完整脚本,不需要网络权限。它只处理本例的“基本首部、目的选项、UDP”组合,其他首部组合与零载荷明确拒绝,不把这个演示当作通用 IPv6 解析器。
import struct
from ipaddress import IPv6Address

# 固定样本:40 字节基本首部、8 字节目的选项、12 字节 UDP。
packet = bytes.fromhex(
    "6b81234500143c40"
    "20010db8000000000000000000000001"
    "20010db8000000000000000000000002"
    "11000104000000003039d431000cb81c74657374"
)
if len(packet) < 40:
    raise ValueError("IPv6 基本首部不完整")
word, plen, nh, hop, src, dst = struct.unpack("!IHBB16s16s", packet[:40])
version = word >> 28
traffic_class, flow_label = (word >> 20) & 0xff, word & 0xfffff
end = 40 + plen
if version != 6 or plen == 0 or end > len(packet):
    raise ValueError("版本、长度无效,或超出本例支持范围")

# 本例仅处理目的选项后接 UDP,不对未知首部猜测长度。
if nh != 60 or plen < 8:
    raise ValueError("本例要求完整的目的选项首部")
upper_nh, units = packet[40:42]
ext_len = (units + 1) * 8
upper_offset = 40 + ext_len
if upper_nh != 17 or upper_offset + 8 > end:
    raise ValueError("后继不是 UDP,或剩余长度不足")

# 包尾由 Payload Length 决定,不把缓冲区尾部额外字节算入。
print(f"version={version} traffic_class=0x{traffic_class:02x} flow_label=0x{flow_label:05x}")
print(f"DSCP={traffic_class >> 2} ECN={traffic_class & 3} hop_limit={hop}")
print(f"payload_length={plen} packet_length={end}")
print(f"base_next={nh} extension_bytes={ext_len} upper_next={upper_nh}")
print(f"upper_offset={upper_offset} upper_bytes={end - upper_offset}")
print(f"src={IPv6Address(src)} dst={IPv6Address(dst)}")
print(f"upper_hex={packet[upper_offset:end].hex()}")
预期输出:
version=6 traffic_class=0xb8 flow_label=0x12345
DSCP=46 ECN=0 hop_limit=64
payload_length=20 packet_length=60
base_next=60 extension_bytes=8 upper_next=17
upper_offset=48 upper_bytes=12
src=2001:db8::1 dst=2001:db8::2
upper_hex=3039d431000cb81c74657374
base_next=60 定位目的选项,目的选项中的 upper_next=17 才定位 UDP。upper_offset=48 与图中的边界一致;脚本只验证长度并定位,不校验选项内容或 UDP 完整性。
特殊值与适用范围
Payload Length 为 0 不自动等于 Jumbogram。若报文携带 Jumbo Payload 选项,该字段必须为 0,实际长度由逐跳选项中的 Jumbo Payload Length 给出,并且大于 65535;不能只套用普通包长公式。该扩展依据 RFC 2675,本例不处理。([RFC 编辑器][9])
IPv6 的分片信息放在分片扩展首部中,不在基本首部中;分片由源节点完成,中间路由器不执行 IPv6 分片。上表不是完整协议号清单,新增类型以 IANA 登记及相应 RFC 为准。([RFC 编辑器][7])
对照 Next Header 串联的扩展首部结构,适合分析逐跳、路由、分片和目的选项等扩展信息,避免把扩展首部误判为传输层数据。
IPv6 扩展首部链
抓到 IPv6 报文却找不到 TCP、UDP 起点时查本条。先识别前一首部的 Next Header,再按对应格式计算长度,即可区分扩展信息、上层协议和不能直接解码的分片,避免把选项字节读成端口。
Next Header 数值对照
Next Header 是 8 位字段,描述后续内容,不是当前首部自身的类型。下表只列常用值; 表示 Hdr Ext Len, 表示 AH 的 Payload Len,长度均含当前扩展首部自身。编号依据 IANA 登记。([互联网号码分配局][1])
| 值 | 后续内容 | 长度与建议动作 |
|---|---|---|
0 |
Hop-by-Hop Options,逐跳选项 | 字节;必须紧接 IPv6 基本首部 |
43 |
Routing,路由首部 | 字节;继续核对 Routing Type 和 Segments Left |
44 |
Fragment,分片首部 | 固定 8 字节;先检查 Fragment Offset 和 M |
60 |
Destination Options,目的选项 | 字节;结合所在位置判断处理对象 |
51 |
AH,认证首部 | 字节;不要套用选项首部的长度公式 |
50 |
ESP,封装安全载荷 | 不能靠统一长度字段跳过;后续协议信息在 ESP 尾部 |
59 |
No Next Header | 停止上层解析;它不是一个额外占字节的首部 |
6、17、58 |
TCP、UDP、ICMPv6 | 已到相应上层协议入口,不再按扩展首部格式读取 |
选项、路由、分片与终止规则见 RFC 8200;AH 的长度单位是 4 字节,ESP 则需结合安全关联及尾部格式解析,加密时还需解密条件。([RFC 编辑器][2])
沿链确定字节位置
IPv6 基本首部固定 40 字节,基本首部的 Next Header 位于偏移 6。Payload Length 包含其后的扩展首部及上层报文,因此上层起点不一定是偏移 40;每次前进都必须核对当前首部长度与剩余字节。([RFC 编辑器][2])
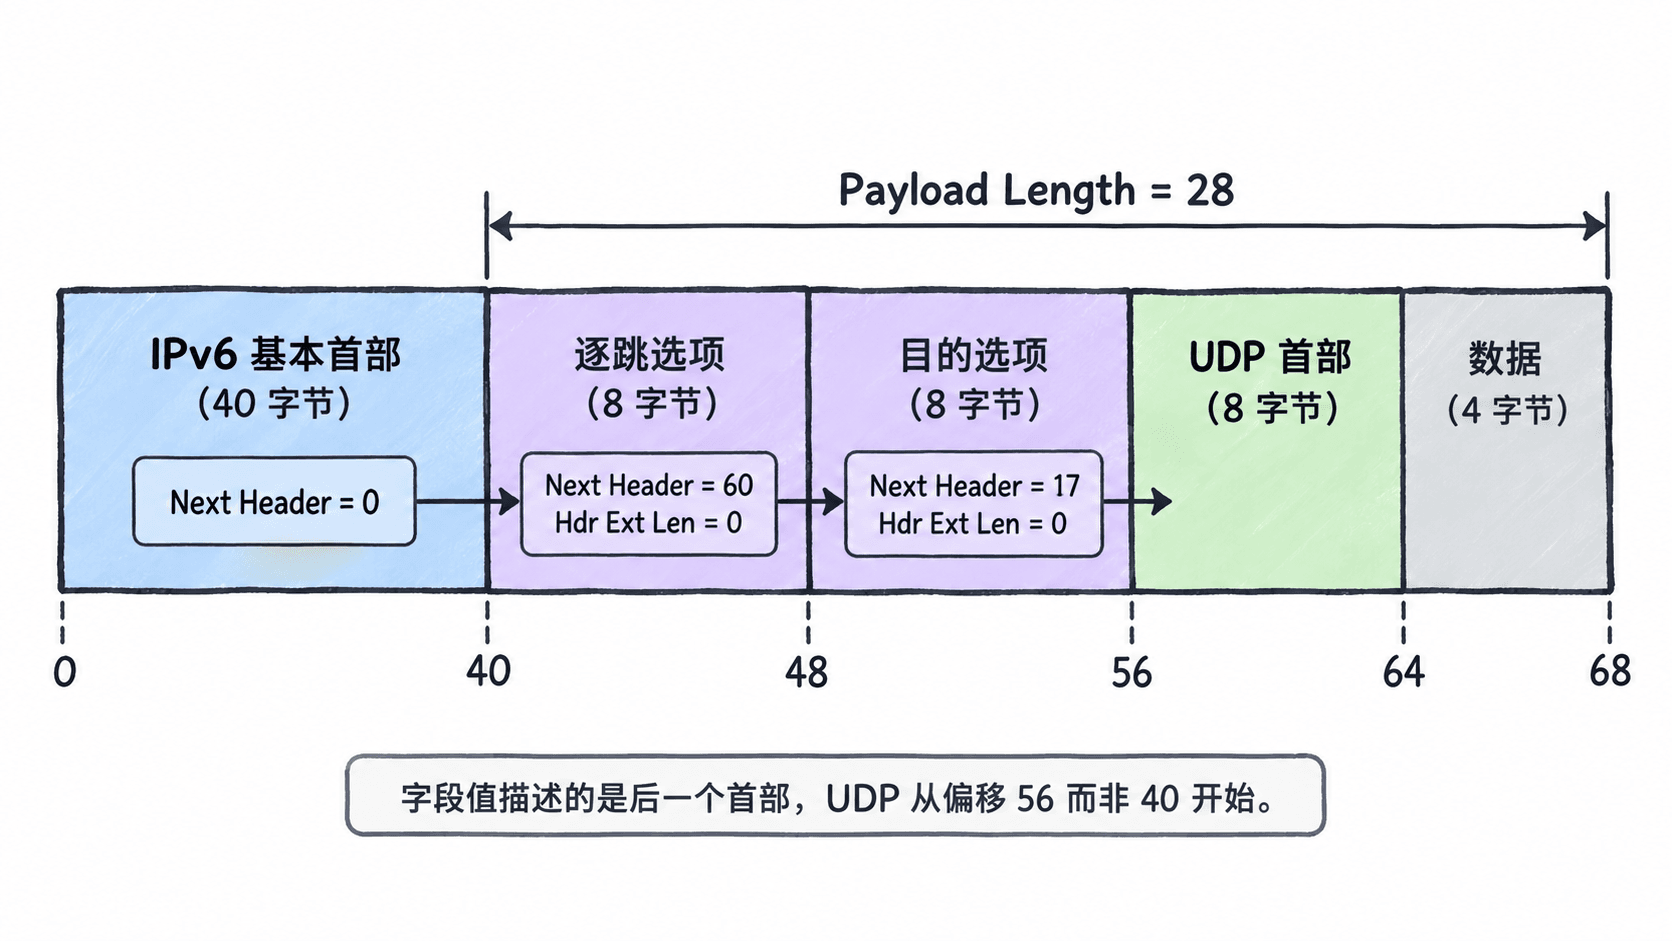
逐跳首部若存在,位置必须紧接基本首部。目的选项可分别放在路由首部前和最终上层首部前,不能只按名称去重;其余首部还须结合各自规范,不能把偏离推荐顺序一概判成非法。([RFC 编辑器][2])
离线确认上层起点
下面是可直接运行的 Python 3 程序,使用固定合成报文,不联网、不需要抓包权限。输入从 IPv6 基本首部开始,不包含链路层首部;示例仅演示三类共享长度格式的扩展首部后接 UDP,不是完整协议合法性校验器。
import struct

# 固定合成报文:IPv6、逐跳选项、目的选项、UDP。
packet = bytes.fromhex(
    "60000000 001c 00 40 "
    "20010db8 00000000 00000000 00000001 "
    "20010db8 00000000 00000000 00000002 "
    "3c00 010400000000 "
    "1100 010400000000 "
    "b3b0 2328 000c 25ef 54455354"
)
if len(packet) < 40 or packet[0] >> 4 != 6:
    raise ValueError("缺少完整 IPv6 基本首部")
payload_length = struct.unpack_from("!H", packet, 4)[0]
end = 40 + payload_length
if payload_length == 0 or end != len(packet):
    raise ValueError("本例要求非零载荷且数据报完整")

offset, nh = 40, packet[6]
names = {0: "Hop-by-Hop", 43: "Routing", 60: "Destination"}
# 仅演示这三类首部的长度定位,不套用于 Fragment、AH 或 ESP。
while nh in names:
    if offset + 2 > end:
        raise ValueError("扩展首部截断")
    next_header, hdr_ext_len = struct.unpack_from("!BB", packet, offset)
    size = (hdr_ext_len + 1) * 8
    if offset + size > end:
        raise ValueError("扩展首部长度越界")
    print(f"{names[nh]} offset={offset} length={size} next={next_header}")
    offset, nh = offset + size, next_header

# 先确认协议和最短长度,再读取端口,避免误读扩展数据。
if nh != 17 or offset + 8 > end:
    raise ValueError("本例仅支持完整 UDP 首部")
sport, dport, length, _ = struct.unpack_from("!HHHH", packet, offset)
if length < 8 or offset + length != end:
    raise ValueError("UDP 长度不匹配")
print(f"UDP offset={offset} src={sport} dst={dport} length={length}")
预期输出:
Hop-by-Hop offset=40 length=8 next=60
Destination offset=48 length=8 next=17
UDP offset=56 src=46000 dst=9000 length=12
这里的端口、偏移和长度都是样本固定值。两个扩展首部各占 8 字节,所以 UDP 起点是 56;程序没有验证选项内容或 UDP 校验和,也没有实现分片重组、巨型载荷和 IPsec 解析。
异常线索与动作
分片偏移以 8 字节为单位。M=1 表示还有后续分片,M=0 也可能只是末片。偏移大于 0 时,即使分片首部的 Next Header=17,其后也不是 UDP 首部起点;应按源地址、目的地址和 Identification 关联分片,再进行重组解析。([RFC 编辑器][2])
长度越界时,先核对抓包是否截断,再判断报文是否畸形。遇到不识别的协议号,先查登记及对应格式,不要假设所有扩展首部都有相同长度字段,更不要扫描疑似端口来猜测上层起点。
适用范围
基础布局按 RFC 8200 第 3、4 节判读,AH、ESP 分别按 RFC 4302、RFC 4303。本表不是全部扩展首部清单,新增类型需查 IANA 及其专用规范。([互联网号码分配局][1])
逐跳选项的处理还受 RFC 9673 和设备配置影响;看见逐跳首部,不代表沿途每台路由器都会执行其中每个选项。([IETF Datatracker][3])
查询 Type、Code、Checksum 与类型相关数据的布局,适合解析 Echo 请求应答及常见 IPv4 网络错误消息,并继续定位其附带的原始报文信息。
ICMPv4 报文
分析 Echo 请求应答或 IPv4 网络错误时查本条。先用 Type、Code 选择格式,再解释类型相关字段和数据区,就能分清回显数据与被引用的原始报文,并定位受影响的请求。
字段从哪里读
先确认外层 IPv4 的 Protocol=1。ICMP 起点由外层 IHL 乘以 4 得到,不应固定跳过 20 字节。下表偏移从 ICMP 的 Type 字节开始计算,多字节整数使用网络字节序。([互联网号码分配局][1])
| 字节偏移 | 字段 | 判读动作 |
|---|---|---|
0 |
Type,8 位 |
选择消息种类 |
1 |
Code,8 位 |
必须结合 Type 解释子原因 |
2–3 |
Checksum,16 位 |
对完整 ICMP 消息校验,不包含外层 IPv4 首部 |
4–7 |
类型相关字段 | Echo 为各 16 位的 Identifier、Sequence Number;错误消息按具体类型解释 |
8 起 |
类型相关数据 | Echo 为回显数据;常见 3、11、12 型错误消息在此引用原报文 |
ICMPv4 校验和覆盖整个 ICMP 消息,不使用 IP 伪首部。Echo 应答应保留请求的标识、序号和数据;标识与序号用于匹配请求,不是 TCP、UDP 端口。([RFC 编辑器][4])
Type、Code 与首要动作
以下为常见组合,不是完整编号表;未列出的代码不能套用相邻代码的解释。含义按 IANA 的 ICMP 参数登记判读。([互联网号码分配局][5])
| Type / Code | 含义或出现条件 | 建议动作 |
|---|---|---|
8 / 0 |
Echo 请求 | 用地址、标识、序号查找对应应答 |
0 / 0 |
Echo 应答 | 对照原请求及回显数据 |
3 / 0、3 / 1 |
分别为网络不可达、主机不可达 | 结合引用的目的地址检查路由及下一跳 |
3 / 2 |
协议不可达 | 核对被引用 IPv4 的 Protocol |
3 / 3 |
端口不可达 | 定位原目标端口,检查对应服务 |
3 / 4 |
需要分片,但原包设置了 DF | 读取下一跳 MTU,检查路径 MTU 与发送包大小 |
3 / 13 |
通信被管理策略禁止 | 按引用报文核对访问控制策略 |
11 / 0 |
转发过程中 TTL 耗尽 | 对照原请求检查路径;不能仅凭这一条认定存在环路 |
11 / 1 |
分片重组超时 | 检查相关分片是否完整到达 |
12 / 0 |
参数问题,Pointer 指示错误位置 | 读取偏移 4 的 Pointer,从原 IPv4 首部起点定位 |
对于 3 / 4,ICMP 偏移 6–7 是 16 位 Next-Hop MTU,单位为字节,包含 IP 首部但不含链路层首部。旧式消息可能填 0,表示未提供 MTU,不能把它解释为可用 MTU 为零。([RFC 编辑器][6])
错误消息如何引用原报文
RFC 792 的基本错误格式在 ICMP 偏移 8 起引用原 IPv4 首部及其后 8 字节。实际可能引用更多;这仍不是一份必然完整的原包,引用区之后也可能存在另行定义的扩展结构。([RFC 编辑器][4])
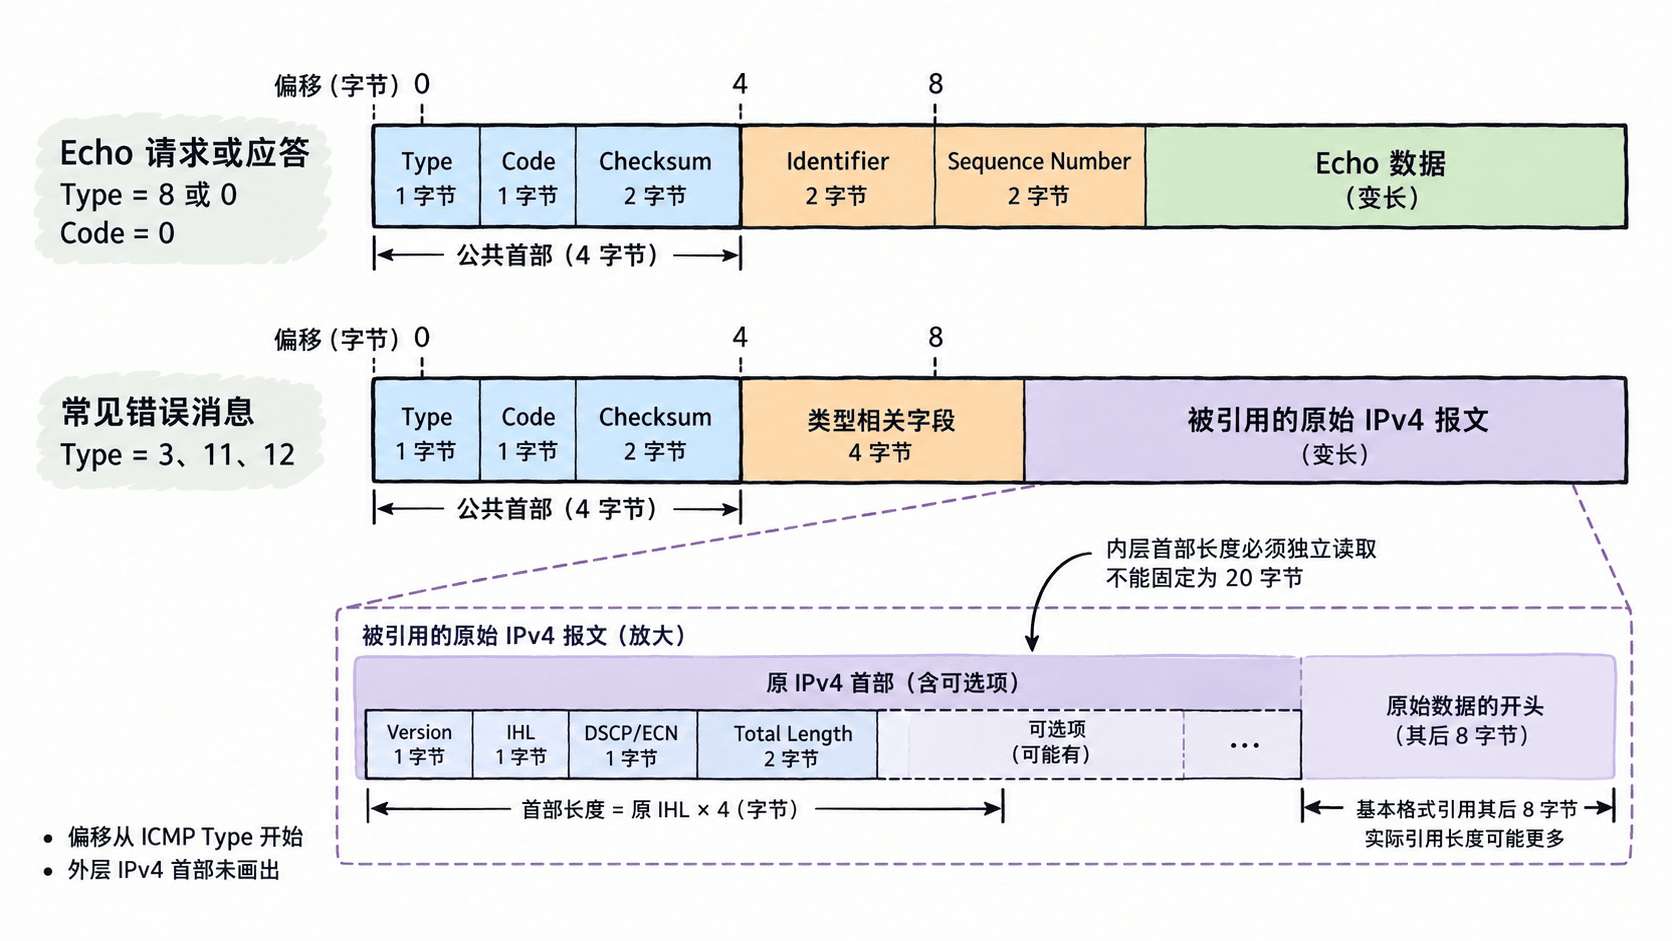
内层 IPv4 必须独立读取 IHL。只有原协议为 TCP、UDP,原分片偏移为 0 且引用字节足够时,才能继续读取端口;原协议为 ICMP 时则继续按 ICMP 格式匹配请求,不能把类型相关字段当作端口。([RFC 编辑器][7])
离线校验并读取引用内容
以下 Python 3 程序直接解析一条完整、固定的 ICMP 3 / 3 消息,不含外层 IPv4 首部。引用的原 IPv4 首部带 4 字节选项,故长度为 24 字节;原报文只引用 UDP 首部,不包含其全部数据。
import struct

def checksum(data: bytes) -> int:
    # 奇数字节仅在计算时补零;不修改线上报文长度。
    data += bytes(len(data) % 2)
    total = sum(int.from_bytes(data[i:i + 2], "big")
                for i in range(0, len(data), 2))
    while total >> 16:
        total = (total & 0xffff) + (total >> 16)
    return (~total) & 0xffff

# 从 ICMP Type 开始;引用的原 IPv4 首部包含 4 字节选项。
message = bytes.fromhex(
    "0303 de15 00000000 "
    "4600 0024 1234 4000 4011 3a5d c0000201 c6336402 "
    "01010000 "
    "9c40 829a 000c 0000"
)
if len(message) < 8:
    raise ValueError("ICMP 消息不足 8 字节")
kind, code, stored = struct.unpack_from("!BBH", message)
valid = checksum(message) == 0
if (kind, code) != (3, 3) or not valid:
    raise ValueError("需要校验通过的 Type=3、Code=3 样本")

# 引用区有自己的 IHL;不能固定跳过 20 字节。
quoted = message[8:]
if len(quoted) < 20 or quoted[0] >> 4 != 4:
    raise ValueError("原 IPv4 首部缺失")
ihl = (quoted[0] & 15) * 4
if ihl < 20 or len(quoted) < ihl + 8:
    raise ValueError("引用区不足以读取完整 UDP 首部")
fragment_offset = struct.unpack_from("!H", quoted, 6)[0] & 0x1fff
if quoted[9] != 17 or fragment_offset != 0:
    raise ValueError("引用内容不是可直接定位 UDP 的首片")
sport, dport = struct.unpack_from("!HH", quoted, ihl)
print(f"Type={kind} Code={code} checksum=0x{stored:04x} valid={valid}")
print(f"quoted_IHL={ihl} protocol={quoted[9]}")
print(f"UDP src={sport} dst={dport}")
预期输出:
Type=3 Code=3 checksum=0xde15 valid=True
quoted_IHL=24 protocol=17
UDP src=40000 dst=33434输出中的校验和与端口都是样本固定值。valid=True 只表示这条 ICMP 消息的校验和通过,不验证来源可信性,也不表示被引用的原始 UDP 数据已经完整。
判读边界与来源
抓包截断或外层 IPv4 分片尚未重组时,不要用不完整字节判定整个 ICMP 校验和错误;先取得完整消息,并按外层 IPv4 的总长度排除链路层填充,再计算。IPv4 长度含义及 ICMP 校验范围分别见 RFC 791、RFC 792。([RFC 编辑器][7])
本条只适用于 IPv4 Protocol=1 承载的 ICMP,不适用于 IPv6 Next Header=58 的 ICMPv6。若识别到 RFC 4884 扩展,应按其长度和扩展结构划分引用区,不能把所有剩余字节都当成原应用数据。([互联网号码分配局][1])
对照 Type、Code、Checksum 和消息主体结构,适合解析 IPv6 错误、Echo 与邻居发现相关消息,并区分不同消息类型的后续字段。
ICMPv6 报文
解析 IPv6 错误响应、Echo 或邻居发现报文时,先查 Type 与 Code,再按对应主体格式取字段;下面给出字节位置、常见值和离线校验样本,避免把不同消息都按 Echo 解码。
共用字段与主体位置
沿 IPv6 扩展首部定位上层协议号 58,不要固定在 IPv6 起点后第 40 字节取 ICMPv6。以下偏移均从 ICMPv6 的 Type 字节算 0,多字节字段按网络字节序读取。([RFC 编辑器][1])
| 字节偏移 | 字段 | 含义与读取动作 |
|---|---|---|
| 0 | Type,8 位 | 决定消息类型和主体格式 |
| 1 | Code,8 位 | Type 内的细分原因,不能脱离 Type 判读 |
| 2–3 | Checksum,16 位 | 校验 IPv6 伪首部与完整 ICMPv6 消息 |
| 4 起 | Message Body | 按类型读取,不存在统一的 Echo 标识符布局 |
共用首部只有 4 字节;Echo 的固定部分则为 8 字节。下面用 Echo、Packet Too Big 和邻居请求对比主体边界。([RFC 编辑器][1])
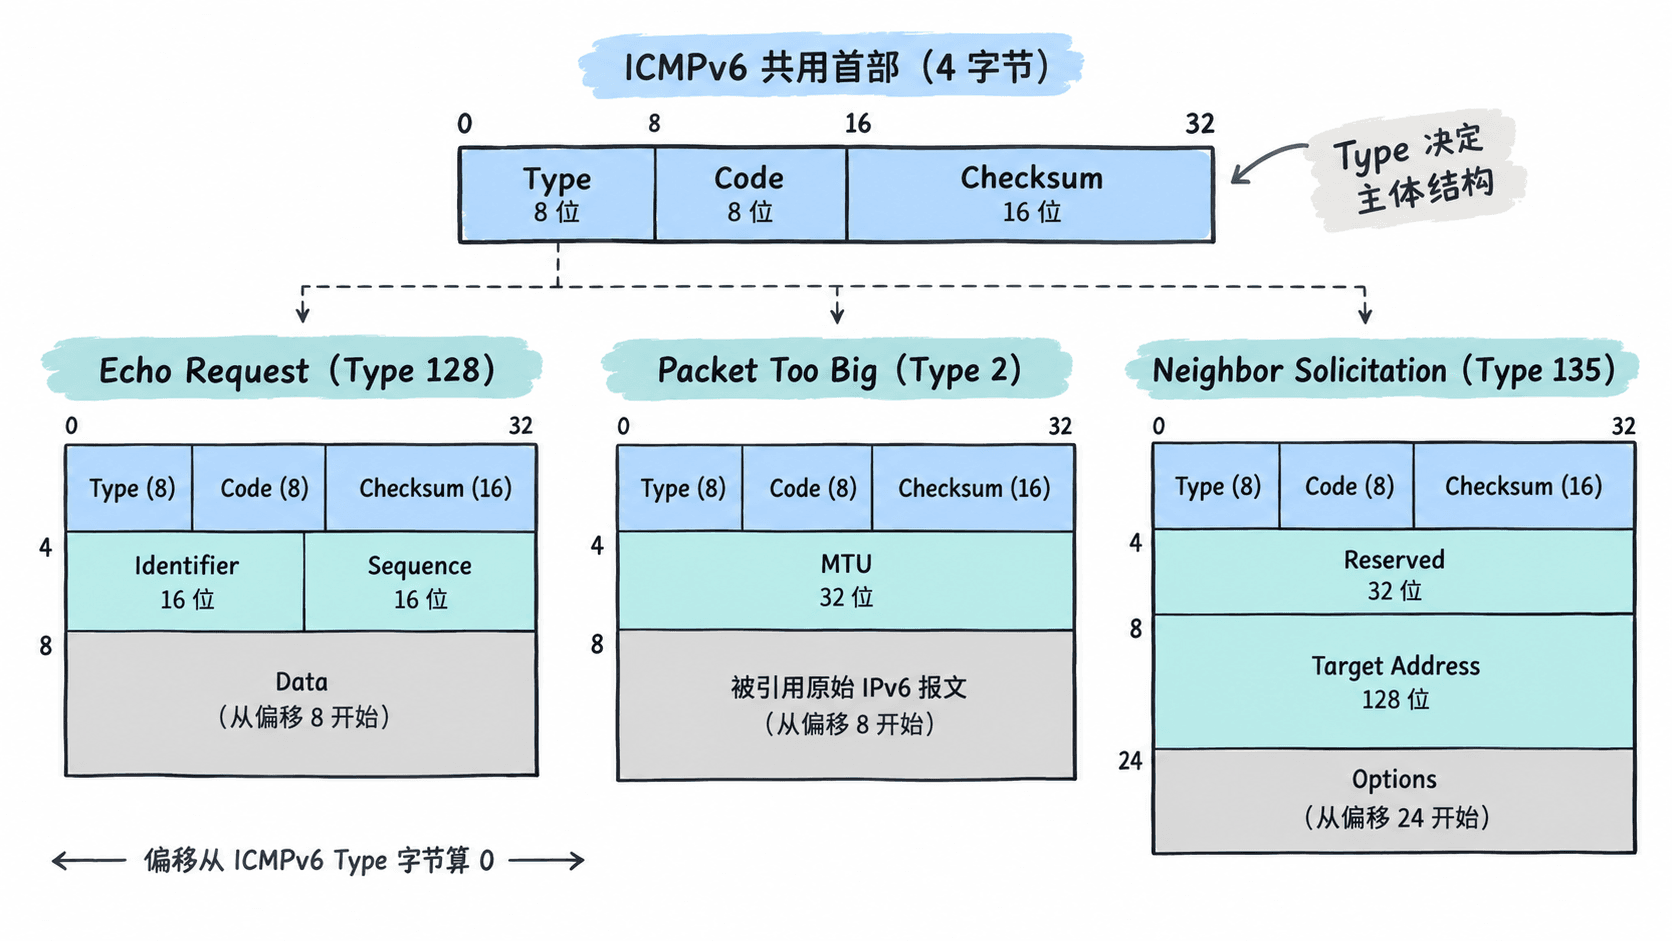
常见 Type、Code 与动作
Type 的 0–127 属于错误消息范围,128–255 属于信息消息范围,但并非所有值都已分配。以下只列常用值;消息名称和 Code 含义按 IANA 注册表查询。([互联网号码分配局][2])
| Type / Code | 含义及偏移 4 起的基础主体 | 建议动作 |
|---|---|---|
| 1 / 0、1、4 | 目的不可达:分别为无路由、策略禁止、端口不可达;未用字段 4 字节+原包引用 | 分别检查路由、过滤策略、服务监听 |
| 2 / 0 | Packet Too Big;MTU 4 字节+原包引用 | 核对被引用流量后检查路径 MTU |
| 3 / 0、1 | 分别为转发 Hop Limit 耗尽、分片重组超时;未用字段 4 字节+原包引用 | 分别检查转发路径、分片丢失 |
| 4 / 0、1、2 | 分别为首部字段错误、不识别 Next Header、不识别 IPv6 选项;Pointer 4 字节+原包引用 | Pointer 从被引用 IPv6 包起点计数,据此定位 |
| 128 / 0;129 / 0 | Echo 请求、应答;Identifier 2 字节+Sequence 2 字节+数据 | 结合地址、标识符、序号匹配请求和应答 |
| 133 / 0;134 / 0 | 路由器请求 RS、通告 RA;主体分别含 4 字节保留字段、12 字节路由器参数 | 选项分别从偏移 8、16 开始 |
| 135 / 0;136 / 0 | 邻居请求 NS、通告 NA;4 字节保留或标志字段+16 字节 Target Address | 核对目标地址;选项从偏移 24 开始 |
| 137 / 0 | Redirect;保留字段 4 字节+Target Address 16 字节+Destination Address 16 字节 | 核对通告来源与目的地址;选项从偏移 40 开始 |
表中错误与 Echo 主体按 RFC 4443 基础格式,邻居发现主体按 RFC 4861;不要把原包引用解码成当前消息的应用载荷。([RFC 编辑器][1])
抓包判读与处理
错误消息外层源地址可能是中间路由器,应从被引用原包关联实际出错流量。引用内容可能截断;没有看到传输层端口时,不要凭外层地址认定具体应用。([RFC 编辑器][1])
小包正常、大包失败且收到 Type 2 时,先检查通告 MTU、引用内容与近期发送记录,再调整路径 MTU。不要通过统一屏蔽 ICMPv6 处理此问题,也不要盲目信任无法关联的 MTU 通告。([RFC 编辑器][3])
邻居发现消息应核验外层 Hop Limit 为 255、Code 为 0、校验和及长度有效;RA、Redirect 的源地址还须为链路本地地址。选项 Length 以 8 字节为单位且包含选项头,0 非法;这些规则不能套给 Echo。([RFC 编辑器][4])
NS 的源地址为 :: 时,可能正在进行重复地址检测,并不必然是坏包;应结合 Target Address 和接口地址状态判断。([RFC 编辑器][5])
离线核对字段与校验和
IPv6 伪首部包含源地址、目的地址、32 位消息长度、24 位零和上层协议号;这里最后一项固定为 58,消息长度不含 IPv6 扩展首部。存在 Routing Header 时,目的地址须按最终目的地址规则确定。([RFC 编辑器][6])
下面是可直接执行的 Python 3 脚本,仅使用标准库,不发网络包。地址、Identifier、序号和数据均为固定测试值;样本没有扩展首部,解码器只处理基础 Echo 消息。
import ipaddress
import struct

def checksum(data: bytes) -> int:
    # 奇数字节只为求和补零,不改变伪首部中的报文长度。
    data += b"\x00" * (len(data) % 2)
    total = sum(struct.unpack(f"!{len(data) // 2}H", data))
    while total >> 16:
        total = (total & 0xffff) + (total >> 16)
    return (~total) & 0xffff

# 固定离线样本:raw 从 Type 开始,不含 IPv6 首部。
raw = bytes.fromhex("80 00 ce 3b 12 34 00 01 68 65 6c 6c 6f")
src = ipaddress.IPv6Address("2001:db8::1").packed
dst = ipaddress.IPv6Address("2001:db8::2").packed
if len(raw) < 8:
    raise ValueError("truncated Echo message")
kind, code, stored, ident, seq = struct.unpack("!BBHHH", raw[:8])
if (kind, code) not in ((128, 0), (129, 0)):
    raise ValueError("not a basic Echo message")

# IPv6 伪首部使用 ICMPv6 长度及上层协议号 58。
pseudo = src + dst + struct.pack("!I3xB", len(raw), 58)
print(f"type={kind} code={code} id=0x{ident:04x} seq={seq}")
print(f"payload={raw[8:]!r}")
print(f"checksum=0x{stored:04x} valid={checksum(pseudo + raw) == 0}")
预期输出:
type=128 code=0 id=0x1234 seq=1
payload=b'hello'
checksum=0xce3b valid=True
valid=True 表示完整样本连同伪首部通过校验,不代表真实目标可达。换成抓包数据时必须同时替换地址和完整 ICMPv6 字节;截断内容不能用于完整校验。
适用范围
本文覆盖 RFC 4443 基础错误与 Echo 格式,以及 RFC 4861 邻居发现格式,不涵盖全部错误扩展对象。遇到未列出的 Type、Code 或选项,按 IANA 对应条目的规范继续解析,不能直接判为非法。([互联网号码分配局][2])
传输层
对照端口、序列号、确认号、数据偏移、控制位、窗口和校验和字段,适合从抓包字节流定位 TCP 载荷并判断连接状态变化。
TCP 首部
从抓包字节流定位 TCP 载荷、核对确认号或判断连接控制信号时,先确认 TCP 起点,再读取 Data Offset 和控制位。以下按字段位置给出速查表,并用一个带 MSS 选项的 SYN 样本验证解码结果。
字节位置与载荷起点
以下偏移从 TCP 源端口字节算 0。传统 TCP 首部为 20–60 字节;Data Offset 的单位是 4 字节,不是字节,也不是整个 TCP 段长度。固定字段位置沿用基础 TCP 格式,扩展位分配另见下节。([RFC 编辑器][7])
| 字节偏移 | 字段 | 含义与读取动作 |
|---|---|---|
| 0–1;2–3 | 源端口、目的端口,各 16 位 | 与双方 IP 地址共同区分连接 |
| 4–7 | Sequence Number,32 位 | 按字节编号;SYN 段中为初始序列号 |
| 8–11 | Acknowledgment Number,32 位 | ACK 位为 1 才有效,表示下一期望序列号 |
| 12 的高 4 位 | Data Offset | 取值 5–15;乘 4 得到载荷相对起点 |
| 12 的低 4 位及 13 | 保留位与控制位 | 按位拆解,不当成普通整数状态码 |
| 14–15 | Window,16 位 | 本端通告的接收窗口,按无符号数读取 |
| 16–17 | Checksum,16 位 | 覆盖 IP 伪首部、TCP 首部和载荷 |
| 18–19 | Urgent Pointer,16 位 | URG 位为 1 才解释;相对序列号的偏移 |
| 20 至首部末尾 | Options 与 Padding | 不能当载荷;总长度由 Data Offset 限定 |
字段宽度与含义按 RFC 9293 §3.1。载荷起点等于 TCP 起点加首部长度;选项与填充最多占传统首部的 40 字节。([RFC 编辑器][8])
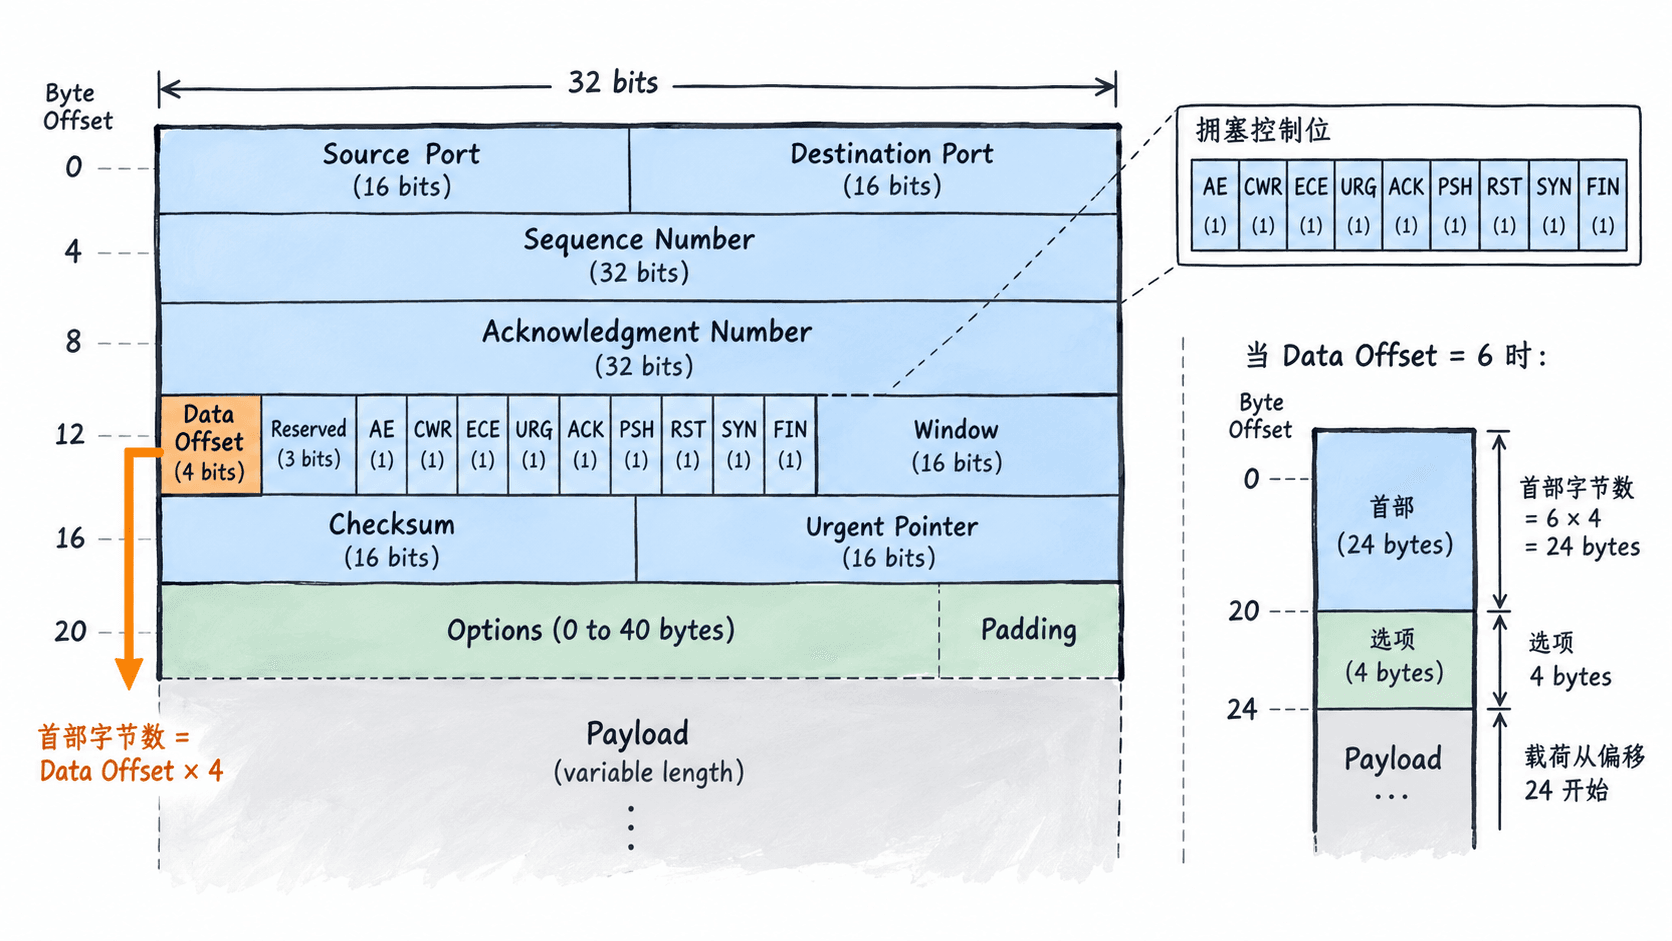
控制位与连接线索
下面掩码针对字节 12–13 按网络序组成的 16 位整数。当前分配中,Data Offset 后依次是 3 个保留位、AE,以及字节 13 的 8 个控制位。([互联网号码分配局][9])
| 位或掩码 | 含义 | 判读动作 |
|---|---|---|
SYN 0x002 |
同步初始序列号 | 与反向响应关联,不能单凭 SYN 断言连接建立 |
ACK 0x010 |
确认号有效 | 对照反向已发送的字节范围 |
FIN 0x001 |
本方向不再发送数据 | 另一方向仍可能发送,继续观察确认 |
RST 0x004 |
复位连接的控制信号 | 结合序号和接收端状态判断是否被接受 |
PSH 0x008 |
推送提示 | 不是应用消息结束标记 |
URG 0x020 |
紧急指针有效 | 不把 Urgent Pointer 当作载荷长度 |
ECE 0x040、CWR 0x080、AE 0x100 |
ECN 相关信号 | 结合协商模式解释,不作为重传标记 |
SYN、FIN 各消耗一个序列号,纯 ACK 不消耗。0x012 是 SYN+ACK,但报文中的标志组合不等于端点当前状态;基本控制语义沿用 TCP 规范。([RFC 编辑器][7])
AE 在旧资料中可能被标为 NS 或保留位。RFC 9768 定义的 AccECN 会联合使用 AE、CWR、ECE;协商后不能继续把三个比特都按传统 ECN 的独立标志解释。([RFC 编辑器][10])
选项与窗口换算
选项从偏移 20 开始。Kind 0 为 EOL、1 为 NOP,各占 1 字节;其他常见选项采用 Kind、Length、Data,Length 包含前两字节。解析不能越过 Data Offset 指定的首部边界。([RFC 编辑器][8])
| Kind | 常见总长度 | 含义与出现条件 |
|---|---|---|
| 2 | 4 字节 | MSS,通告可接收的 TCP 数据部分大小上限,不含 IP/TCP 首部;仅 SYN 段使用 |
| 3 | 3 字节 | Window Scale,握手中协商窗口缩放 |
| 4 | 2 字节 | SACK Permitted,握手中声明支持选择确认 |
| 5 | 2+8×N 字节 | SACK,携带 N 个已接收序列区间 |
| 8 | 10 字节 | Timestamps,时间戳与回显值 |
选项编号查 IANA;窗口缩放、时间戳按 RFC 7323,SACK 按 RFC 2018。SACK Permitted 与实际携带区间的 SACK 不是同一选项。([互联网号码分配局][9])
双方协商窗口缩放后,非 SYN 段的有效接收窗口为原始 Window 左移该报文发送方通告的缩放位数;SYN、SYN+ACK 自身的 Window 不缩放。缺少握手时不能猜倍率,Window 也不是拥塞窗口。([RFC 编辑器][11])
离线解码验证
下面是可直接执行的 Python 3 脚本,仅使用标准库。地址、端口、序号均为固定测试值;输入是完整 TCP 段,不含链路层或 IP 首部,不进行连接或端口探测。
import ipaddress
import struct

def checksum(data: bytes) -> int:
    # 奇数字节在求和时补零;进位回卷后取反。
    data += b"\x00" * (len(data) % 2)
    total = sum(struct.unpack(f"!{len(data) // 2}H", data))
    while total >> 16:
        total = (total & 0xffff) + (total >> 16)
    return (~total) & 0xffff

# 固定离线 SYN 样本,从 TCP 源端口开始,包含一个 MSS 选项。
segment = bytes.fromhex(
    "9c 40 01 bb 00 00 03 e8 00 00 00 00 60 02 fa f0 "
    "0f 1b 00 00 02 04 05 b4"
)
if len(segment) < 20:
    raise ValueError("truncated TCP header")
sport, dport, seq, ack, control, window, stored, urgent = (
    struct.unpack("!HHIIHHHH", segment[:20])
)
hlen = (control >> 12) * 4
if not 20 <= hlen <= 60 or hlen > len(segment):
    raise ValueError("invalid Data Offset or truncated segment")

# 这里使用 IPv4 伪首部;换成 IPv6 样本时不能沿用此格式。
src = ipaddress.IPv4Address("192.0.2.1").packed
dst = ipaddress.IPv4Address("198.51.100.2").packed
pseudo = src + dst + struct.pack("!BBH", 0, 6, len(segment))
print(f"ports={sport}->{dport} seq={seq} ack={ack}")
print(f"header_len={hlen} flags=0x{control & 0x1ff:03x} window={window}")
print(f"options={segment[20:hlen].hex()} payload_len={len(segment) - hlen}")
print(f"checksum=0x{stored:04x} valid={checksum(pseudo + segment) == 0}")
预期输出:
ports=40000->443 seq=1000 ack=0
header_len=24 flags=0x002 window=64240
options=020405b4 payload_len=0
checksum=0x0f1b valid=True
样本的首部长度为 24 字节,因此选项占 4 字节,载荷为空。020405b4 表示 Kind 为 2、Length 为 4、MSS 为 1460;0x002 仅置 SYN,输出的 ack=0 不具有确认含义。脚本展示固定样本解析,不是完整 TCP 选项解析器。
校验边界与适用范围
基础格式按 RFC 9293,扩展位按 IANA 与对应 RFC。校验必须使用对应 IP 版本的伪首部:TCP 协议号为 6,覆盖完整首部与载荷;它不是只校验前 20 字节。IPv6 的伪首部长度要排除前置扩展首部。([RFC 编辑器][8])
本机发送方向抓到校验异常时,先排除截断和校验和卸载,再在接收侧或独立抓包点复核;不要直接认定链路损坏。卸载可能使抓包内容中的校验值尚未由网卡补全。([Wireshark][12])
查询 MSS、窗口扩大、SACK 与时间戳等常见选项的 Kind、Length 和 Value 编码,适合分析握手协商以及可变长度 TCP 首部。
TCP 选项
分析 TCP 三次握手、数据包重传或首部长度异常时,查这里可以快速按 Kind、Length、Value 拆解可变长度选项,并判断 MSS、窗口扩大、SACK 与时间戳是否被协商。
常见 Kind 对照
| Kind | 选项 | Length | Value | 主要用途 |
|---|---|---|---|---|
0 |
EOL | 1 | 无 | 选项区域结束,必要时用于填充 |
1 |
NOP | 1 | 无 | 对齐填充 |
2 |
MSS | 4 | 16 位 MSS | 声明本端可接收的最大 TCP 段有效载荷 |
3 |
Window Scale | 3 | 8 位移位值 | 扩大 TCP 接收窗口表示范围 |
4 |
SACK Permitted | 2 | 无 | SYN 中声明支持 SACK |
5 |
SACK | 可变 | 若干个 32 位左右边界 | 报告已接收的非连续数据块 |
8 |
Timestamp | 10 | TSval、TSecr 各 32 位 | RTT 测量与旧报文保护等机制 |
怎么判读
TCP 选项从首部固定部分之后开始排列,每个常规选项至少包含 1 字节 Kind;除 EOL 和 NOP 外通常还包含 Length 字段。Length 表示整个选项所占字节数,包括 Kind 和 Length 自身。
SYN 报文常用于观察 MSS、Window Scale、SACK Permitted 和 Timestamp;后续报文中出现 SACK,通常说明连接双方已经具备相应协商条件。具体启用情况仍应以实际抓包为准。
快速确认
可直接从抓包文件查看 TCP 首部与选项,例如使用 Wireshark 的命令行导出字段:
tshark -r <PATH> -Y "tcp.flags.syn == 1" -T fields -e tcp.options预期结果:输出匹配 SYN 报文的 TCP 选项原始字段;字段格式依赖 TShark 版本和解析器,实际值应与抓包内容对应。
处理边界
先按 Kind → Length → Value 切分,再结合报文方向判断选项是本端声明、对端确认还是数据阶段携带。不要仅凭某一个选项存在就推断整条连接始终启用对应能力;例如窗口扩大值只有在 SYN 阶段协商后才用于该连接的窗口解释。
对照源端口、目的端口、长度和校验和四个字段,适合快速切分固定 8 字节 UDP 首部与应用层载荷,并核对长度字段。
UDP 首部
解析 UDP 报文时,先读取固定 8 字节首部,再按 Length 字段确认首部加应用层数据的总长度,从而快速定位端口、校验和以及载荷起点。
字段对照
| 字段 | 长度 | 含义 | 判读要点 |
|---|---|---|---|
| Source Port | 16 bit | 源端口 | 标识发送端应用使用的端口;可为 0 的场景存在,具体依协议使用情况判断 |
| Destination Port | 16 bit | 目的端口 | 标识接收端应用使用的端口 |
| Length | 16 bit | UDP 首部与数据总长度 | 最小值为 8;载荷长度为 Length - 8 |
| Checksum | 16 bit | UDP 校验和 | 用于检测传输中的比特错误;具体计算还涉及 IP 层伪首部 |
怎么判读
UDP 首部长度固定为 8 字节,因此应用层载荷总是紧跟在 Checksum 之后。Length 不是单纯的载荷长度,而是整个 UDP 数据报长度,因此实际切包时应验证 $payloadLength=Length-8$。
在 IPv4 与 IPv6 环境中,校验和规则存在差异;仅看到一个数值不能直接判断报文有效,还需要结合对应 IP 版本、源目的地址和 UDP 内容进行校验。
快速确认
抓包分析时,可以用 TShark 直接读取四个字段:
tshark -r <PATH> -Y "udp" -T fields -e udp.srcport -e udp.dstport -e udp.length -e udp.checksum预期结果:每个匹配的 UDP 报文按源端口、目的端口、UDP 长度和校验和依次输出;实际字段值取决于抓包内容。
长度核对
对一个 UDP 报文做十六进制解析时,先从报文的 UDP 首部起始位置读取 4 个 16 位字段。若 Length 为 N,则从 UDP 首部开始连续 N 字节属于该 UDP 数据报;超出的字节应由更外层协议或其他数据单元解释,而不是直接并入当前 UDP 载荷。
查询 QUIC 长首部中的 Header Form、版本、连接 ID 和包类型等关键结构,适合识别 Initial、0-RTT、Handshake 等长首部数据包。
QUIC 长首部
抓到 QUIC 建连阶段的数据包时,用长首部先确认版本、连接 ID 与包类型,再判断它属于 Initial、0-RTT、Handshake、Retry 或其他长首部报文。
关键字段
| 字段 | 含义 | 判读线索 |
|---|---|---|
| Header Form | 首字节最高位,长首部固定为 1 |
与短首部区分的第一步 |
| Fixed Bit | QUIC v1 中固定为 1 |
不符合时先检查是否为其他版本或异常报文 |
| Packet Type | 长首部类型字段 | 用于区分 Initial、0-RTT、Handshake、Retry |
| Version | 32 位 QUIC 版本 | 0x00000001 表示 QUIC v1 |
| DCID | Destination Connection ID | 判断包送往哪个连接上下文 |
| SCID | Source Connection ID | 判断发送方提供的连接 ID |
| 类型特有字段 | 随 Packet Type 变化 | Initial 含 Token;Retry 使用重试令牌和完整性校验字段 |
怎么识别
先看首字节的 Header Form;为 1 后,再读取 Packet Type 和 Version。随后按长度字段读取 DCID、SCID。真正解释后续字段时必须结合 Packet Type,因为 Initial、0-RTT、Handshake 和 Retry 的后续布局并不相同。
| Packet Type | 常见阶段 | 后续结构重点 |
|---|---|---|
| Initial | 首次握手 | Token、Payload Length、Packet Number、加密载荷 |
| 0-RTT | 客户端恢复连接时提前发送应用数据 | Payload Length、Packet Number、加密载荷 |
| Handshake | TLS 握手阶段 | Payload Length、Packet Number、加密载荷 |
| Retry | 服务端要求客户端重新发起握手 | Token 与 Retry Integrity Tag |
快速确认
分析抓包时,可优先检查这些值是否相互吻合:Version 可被识别、DCID/SCID 长度与实际字段一致、Packet Type 与后续字段布局匹配。不要只根据首字节的低位直接推断整个报文结构,因为长首部不同类型的后续字段存在差异。
建议动作
定位握手问题时,先记录 Version、DCID、SCID 和 Packet Type,再沿同一连接 ID 追踪后续包。若类型判断异常,优先核对版本、首字节和抓包解析器的协议版本设置,而不是直接把后续字节当作固定字段。
对照 QUIC 1-RTT 使用的短首部关键字段,适合在连接建立后识别目标连接 ID、密钥阶段和包号相关信息的所在位置。
QUIC 短首部
分析连接建立后的 QUIC 1-RTT 数据包时,用短首部确认连接 ID、Key Phase 和 Packet Number Length,并定位包号与加密载荷的位置。
关键字段
| 字段 | 含义 | 判读线索 |
|---|---|---|
| Header Form | 首字节最高位,短首部为 0 |
与长首部区分的第一步 |
| Fixed Bit | QUIC v1 中固定为 1 |
不符合时先检查版本或报文是否确为 QUIC |
| Spin Bit | 可选的自旋位 | 是否有效取决于实现与使用场景,不能作为连接状态唯一依据 |
| Reserved Bits | 保留位 | 受保护后才能按协议规则验证 |
| Key Phase | 当前 1-RTT 密钥阶段 | 用于识别密钥更新前后的阶段变化 |
| Packet Number Length | 包号编码长度信息 | 决定随后 Packet Number 占用的字节数 |
| DCID | Destination Connection ID | 短首部不携带 DCID 长度字段,长度来自连接上下文 |
| Packet Number | 当前数据包的包号字段 | 与解密和重建完整包号有关 |
出现条件
QUIC 的短首部用于 1-RTT 数据包,因此通常出现在连接建立后的加密数据传输阶段。与长首部不同,短首部不在每个包中携带 Version,也不包含 SCID;DCID 的长度需要结合已协商的连接状态解释。
怎么判读
先确认 Header Form 为 0,再读取首字节中的 Key Phase 与 Packet Number Length。随后按连接上下文取得 DCID 长度,读取 DCID 和 Packet Number。由于包号使用截断编码,抓包中看到的 Packet Number 字段本身不一定就是完整递增包号。
| 线索 | 含义 | 建议动作 |
|---|---|---|
Header Form = 0 |
短首部 | 进入 1-RTT 短首部解析路径 |
| Key Phase 改变 | 发生密钥更新阶段切换 | 结合连接前后数据包继续判断 |
| Packet Number Length 与解析结果不符 | 首部边界可能读错 | 重新核对连接状态和字段偏移 |
| DCID 无法确定长度 | 缺少连接上下文 | 不要按固定长度猜测,先恢复同一连接的协商信息 |
建议动作
排查 1-RTT 报文时,先用 DCID 将数据包归入连接,再检查 Key Phase 与 Packet Number。若解析器无法正确还原后续载荷,应优先核对连接上下文、密钥状态和包号重建,而不是仅凭裸包字节推断明文内容。
Web 与基础服务
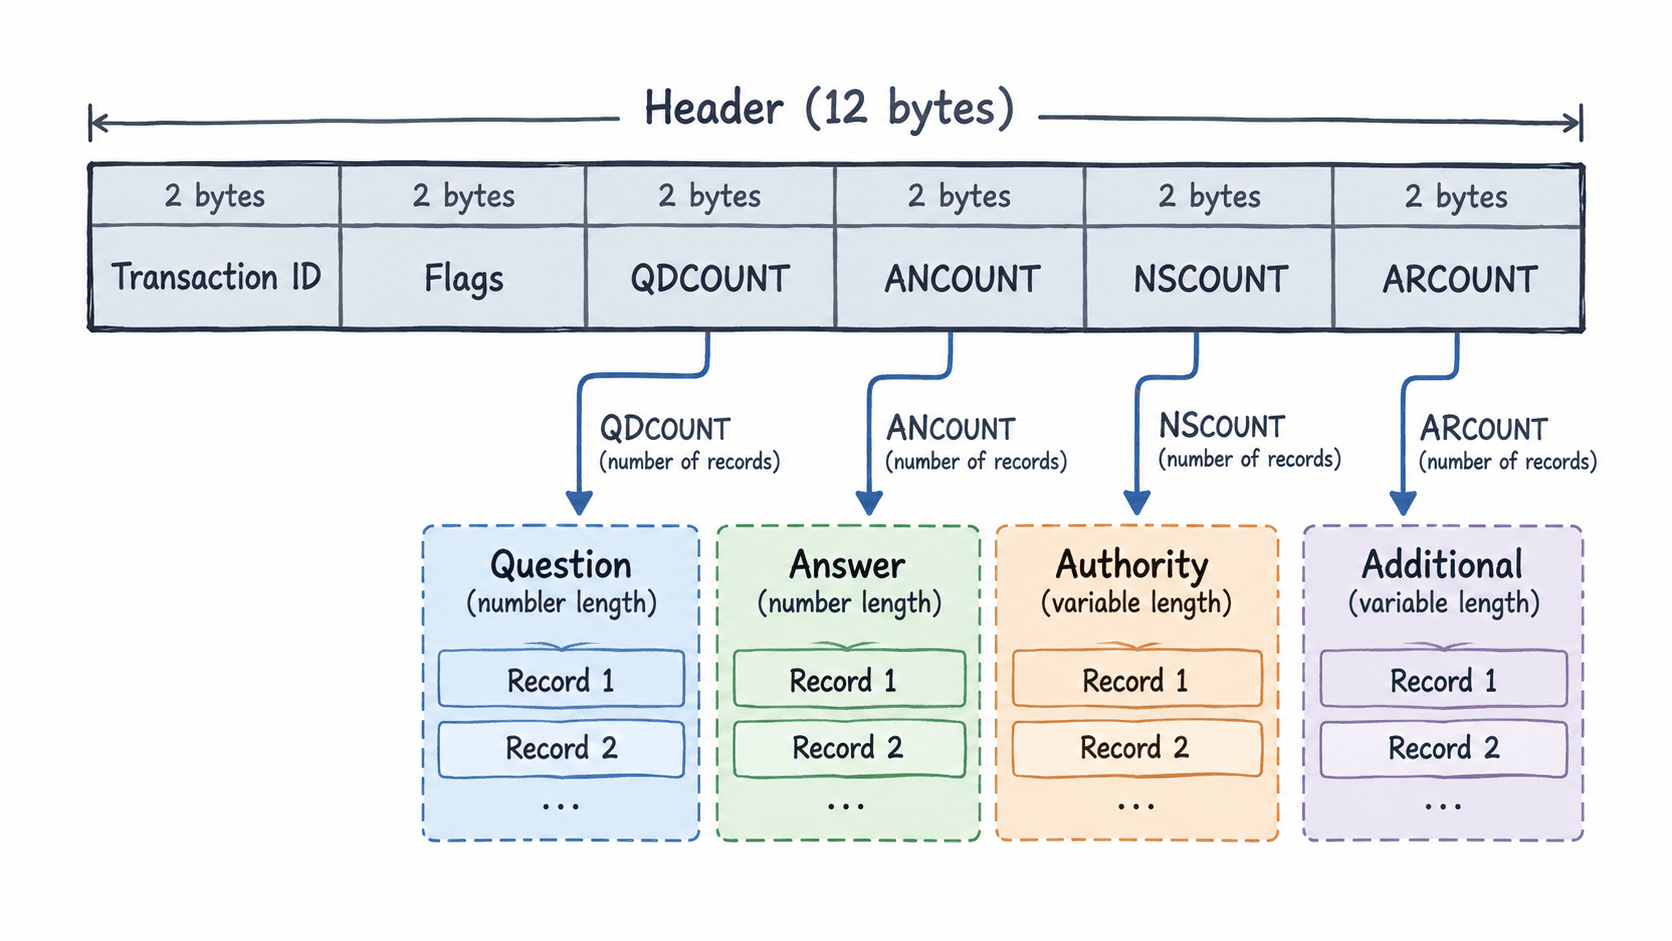
对照事务 ID、标志位、各区段计数以及 Question、Answer 等区段布局,适合解析 DNS 查询响应并判断记录从哪个区段开始。
DNS 消息
解析 DNS 报文时先看固定 12 字节首部,再按计数字段依次定位 Question、Answer、Authority 和 Additional;这样可以确认每个记录属于哪个区段。
消息布局
| 偏移范围 | 字段 | 长度 | 作用 |
|---|---|---|---|
| 0–1 | Transaction ID | 2 字节 | 匹配一次查询与响应 |
| 2–3 | Flags | 2 字节 | 查询/响应、递归、结果码等控制信息 |
| 4–5 | QDCOUNT | 2 字节 | Question 数量 |
| 6–7 | ANCOUNT | 2 字节 | Answer 数量 |
| 8–9 | NSCOUNT | 2 字节 | Authority 数量 |
| 10–11 | ARCOUNT | 2 字节 | Additional 数量 |
| 12 起 | Question | 变长 | 查询名、类型、类 |
| 后续 | Answer / Authority / Additional | 变长 | 按首部计数顺序读取 |
怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
| QDCOUNT > 0 | 存在查询问题 | 从 Question 开始解析 |
| ANCOUNT > 0 | 存在回答记录 | 按 Answer 记录数量继续读取 |
| NSCOUNT > 0 | 存在权威区记录 | 检查 Authority 区中的 NS/SOA 等记录 |
| ARCOUNT > 0 | 存在附加记录 | 继续读取 Additional,常见于地址或其他辅助信息 |
| ID 与原查询一致 | 可对应同一事务 | 将响应与发出的查询配对 |
| Flags 中响应状态异常 | 查询可能失败 | 结合 RCODE 与各区段判断原因 |
解析检查点
读取每个区段时不要根据记录内容猜测边界,先消耗对应数量的资源记录。一个 Answer 记录长度变化后,下一条记录的起点必须由前一条记录的实际编码长度确定。
DNS 消息中的域名可能使用名称压缩,因此 RR 内的域名字段不一定都是连续的标签编码;遇到指针形式时,应按 DNS 报文格式解析名称引用。
适用范围
这里描述的是经典 DNS 消息的通用报文结构,适合分析 UDP/TCP DNS 报文以及常见抓包内容。具体扩展记录的字段长度和含义应以对应 RR 类型的协议定义为准。
查询 QNAME 标签编码、QTYPE 与 QCLASS 的字节布局,适合手工解析域名查询内容,并正确处理域名标签长度和终止字节。
DNS 问题区
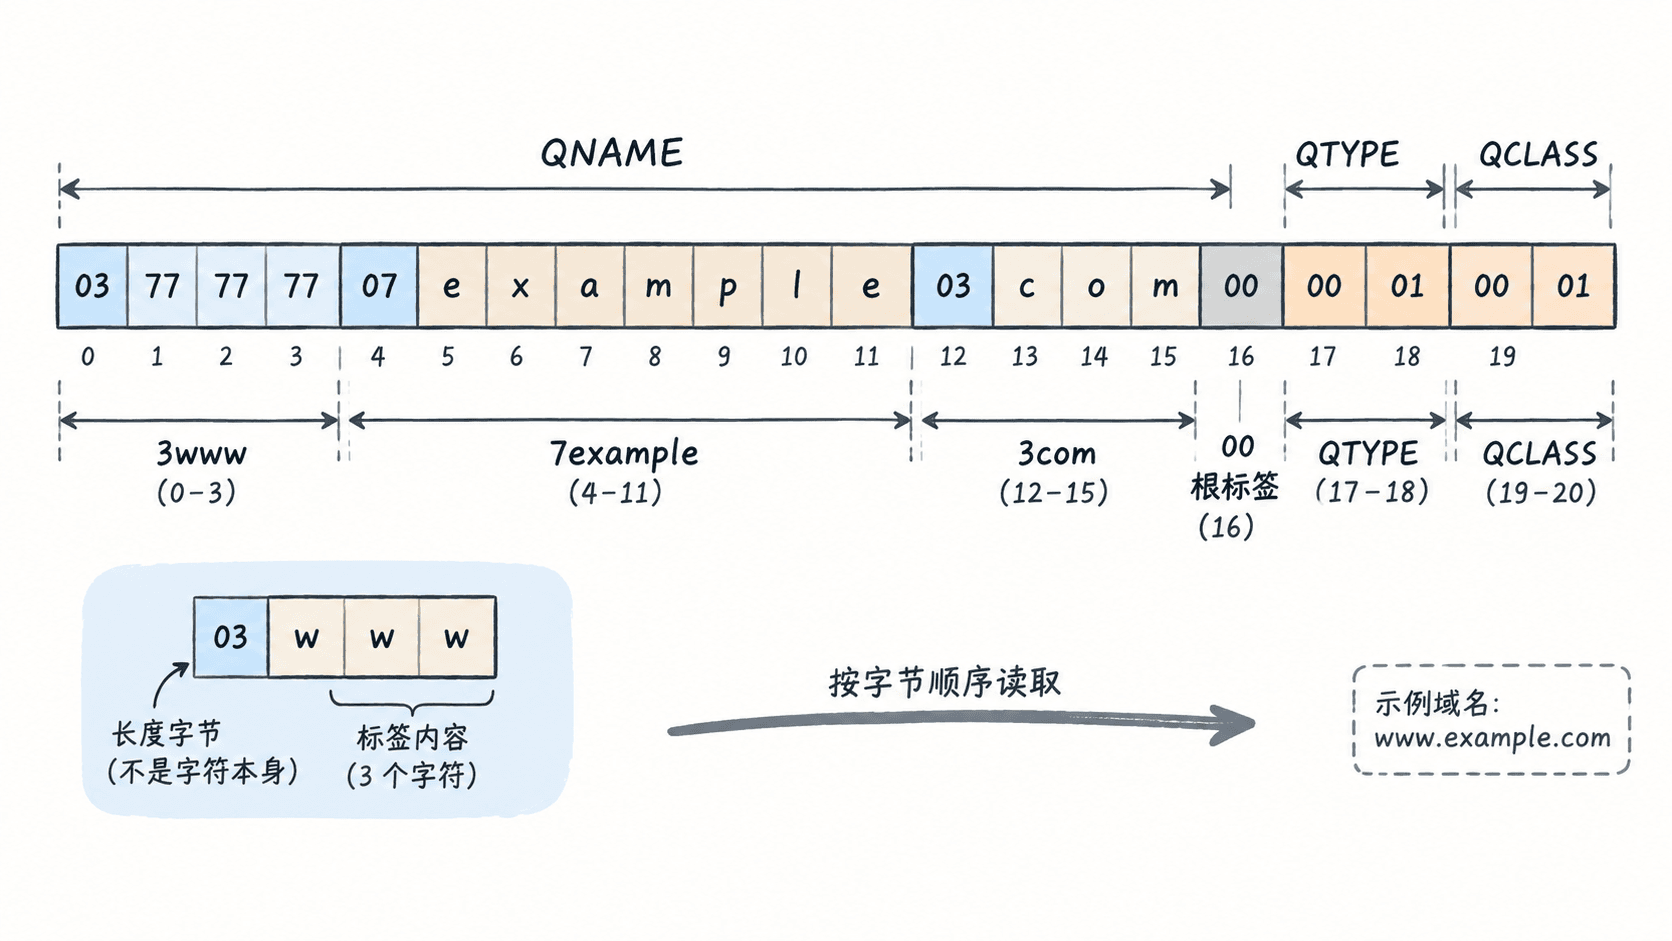
手工解析 DNS Query 时,先按 QNAME 的标签长度逐段读取,再读取 2 字节 QTYPE 和 2 字节 QCLASS;QNAME 最后以根标签的 0x00 结束。
字节布局
| 字段 | 编码 | 长度 | 判读方式 |
|---|---|---|---|
| QNAME | 长度字节 + 标签内容重复排列 | 变长 | 每个标签先读 1 字节长度,再读取对应数量的字符 |
| 终止字节 | 0x00 |
1 字节 | 表示域名结束 |
| QTYPE | 无符号整数 | 2 字节 | 指定查询记录类型,例如 A、AAAA、CNAME |
| QCLASS | 无符号整数 | 2 字节 | 指定查询类,互联网常见值为 IN |
最小例子
域名 www.example.com 的常见 QNAME 编码可写成:
03 77 77 77 07 65 78 61 6d 70 6c 65 03 63 6f 6d 00预期结果:先读 03,取出 www;再读 07,取出 example;再读 03,取出 com;最后 00 表示 QNAME 结束。
判读要点
QNAME 不能按固定长度读取,因为标签长度取决于每个域名部分。读取错误一个长度字节,就会连锁影响后面的标签、QTYPE 和 QCLASS 边界。
QTYPE 和 QCLASS 都是 16 位字段,应按网络字节序读取。完成 QNAME 后,只再消费固定 4 字节,就能得到 Question 的类型与类。
对照 NAME、TYPE、CLASS、TTL、RDLENGTH 和 RDATA 结构,适合解析 Answer 等区段中的资源记录,并按类型解释变长数据。
DNS 资源记录
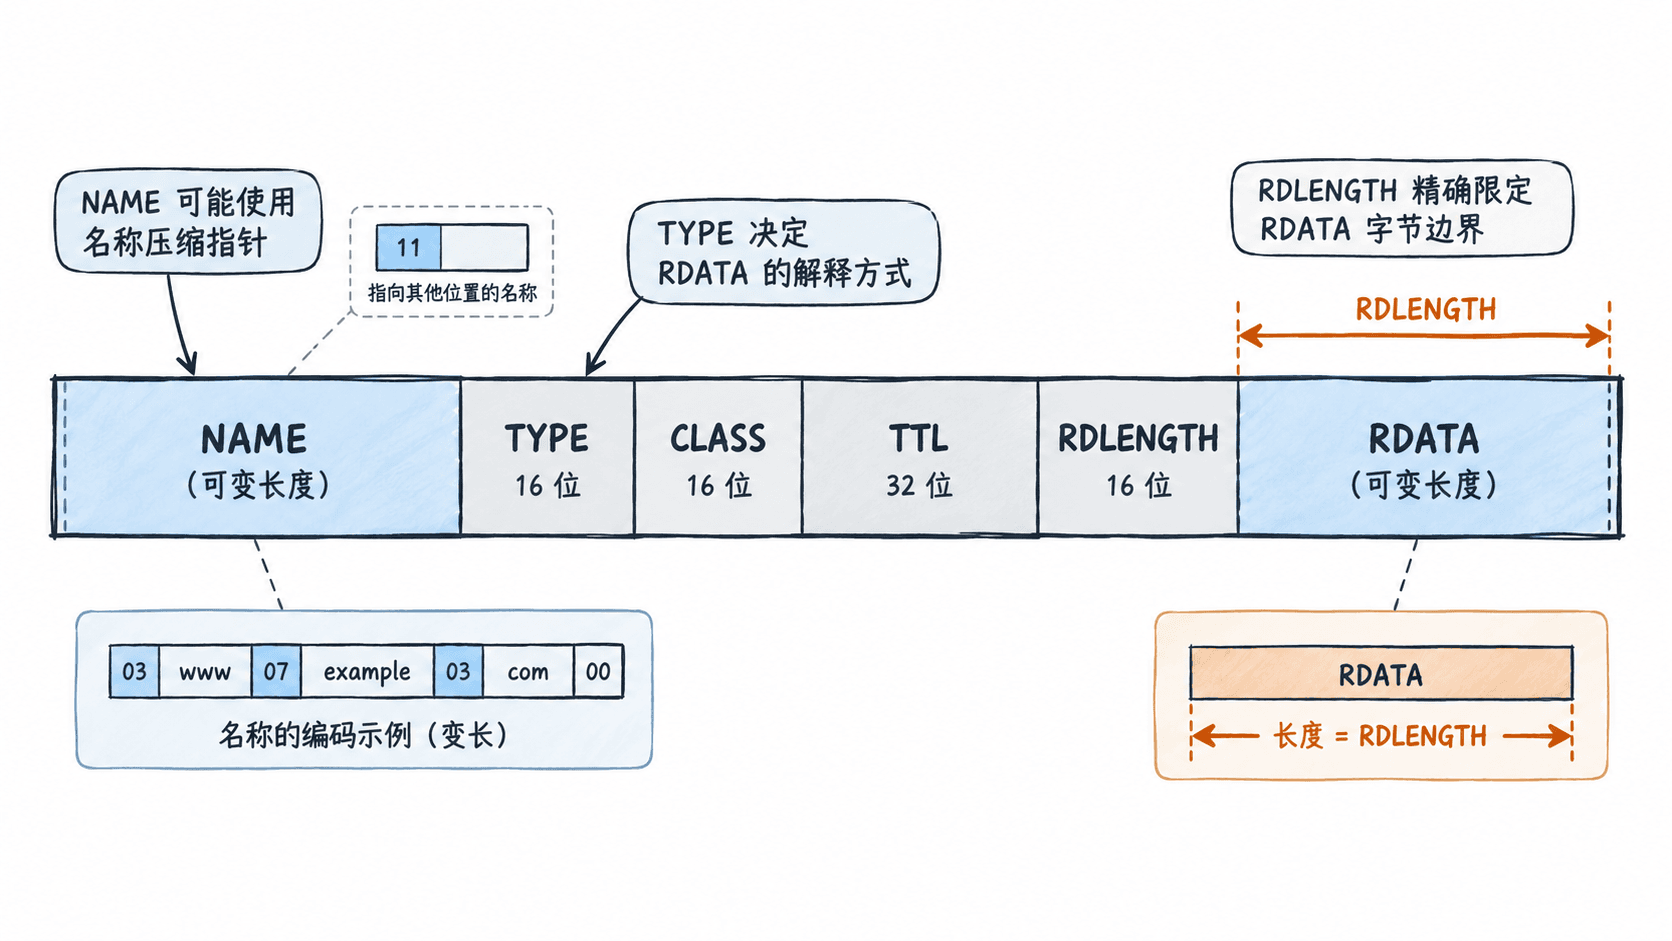
解析 DNS Answer、Authority 或 Additional 区段时查这条:先按固定字段读出 TYPE、CLASS、TTL 和 RDLENGTH,再用 TYPE 决定如何解释变长的 RDATA。NAME 本身也是变长字段,并且经常使用名称压缩指针。
字段怎么读
| 字段 | 长度 | 含义 | 判读动作 |
|---|---|---|---|
NAME |
可变 | 该记录对应的域名;可由标签序列或压缩指针编码 | 先完成域名解码,再定位后续固定字段 |
TYPE |
16 位 | 资源记录类型 | 决定 RDATA 的结构,例如 A=1、AAAA=28 |
CLASS |
16 位 | 类别 | 互联网 DNS 通常为 IN=1 |
TTL |
32 位 | 记录可缓存的秒数 | 用于判断缓存剩余寿命,不表示绝对时间 |
RDLENGTH |
16 位 | RDATA 的字节数 |
必须据此截取本条记录,不能靠猜测类型长度 |
RDATA |
可变 | 类型相关数据 | 按 TYPE 对应格式继续解析 |
出现条件与边界
资源记录出现在 DNS 消息的 Answer、Authority 和 Additional 区段;Question 区段使用的是 QNAME + QTYPE + QCLASS,不是完整 RR。NAME 可能以 0xC0 开头的两字节压缩指针引用消息内较早的域名位置,因此解析偏移必须基于整条 DNS 消息,而不是只看当前 RR 片段。
RDLENGTH 只说明 RDATA 占多少字节,不说明其语义。比如 A 的 RDATA 是 4 字节 IPv4 地址,而 MX、SOA、SRV 等类型具有不同结构;未知类型应保留原始字节,而不要按已知类型强行解释。
快速确认
下面构造一条含一个 Question 和一个 A Answer 的完整 DNS 响应,并从字节流中读取第一条资源记录:
import ipaddress
import struct

packet = bytes.fromhex(
    "123481800001000100000000"
    "076578616d706c6503636f6d0000010001"
    "c00c000100010000012c00045db8d822"
)

def read_name(data, offset):
    labels = []
    while True:
        length = data[offset]
        if length & 0xC0 == 0xC0:
            pointer = ((length & 0x3F) << 8) | data[offset + 1]
            name, _ = read_name(data, pointer)
            labels.append(name)
            return ".".join(labels), offset + 2
        if length == 0:
            return ".".join(labels), offset + 1
        offset += 1
        labels.append(data[offset:offset + length].decode("ascii"))
        offset += length

offset = 12
qname, offset = read_name(packet, offset)
offset += 4  # QTYPE + QCLASS

name, offset = read_name(packet, offset)
rtype, rclass, ttl, rdlength = struct.unpack("!HHIH", packet[offset:offset + 10])
offset += 10
rdata = packet[offset:offset + rdlength]

print(name, rtype, rclass, ttl, rdlength)
print(ipaddress.IPv4Address(rdata))
预期输出:
example.com 1 1 300 4
93.184.216.34
判读顺序
先解码 NAME 并确认下一个字段偏移,再读取固定 10 字节的 TYPE、CLASS、TTL、RDLENGTH,最后严格按 RDLENGTH 取出 RDATA。若抓包解析在某条 RR 后整体错位,优先检查名称压缩跳转和 RDLENGTH 是否被误读。
适用范围是经典 DNS 消息中的 Resource Record 基本格式;具体 TYPE 的 RDATA 结构应以 IANA DNS Parameters 与对应 RFC 为准。
对照请求行、头字段、空行和可选消息体的文本结构,适合检查原始 HTTP 请求边界、方法与目标,以及头部和正文是否正确分隔。
HTTP/1.1 请求报文
检查原始 HTTP/1.1 请求边界时查这条:请求由请求行、零个或多个头字段、一个空行,以及按消息分帧规则决定是否存在的消息体组成。定位问题时先找 CRLF CRLF,它是头部与正文的边界。
结构怎么读
| 部分 | 典型形式 | 判读动作 |
|---|---|---|
| 请求行 | method SP request-target SP HTTP-version CRLF |
先确认方法、请求目标和版本三段是否完整 |
| 头字段 | field-name ":" OWS field-value OWS CRLF |
逐行读取字段;字段名不区分大小写 |
| 空行 | CRLF |
标志头字段结束 |
| 消息体 | 可选字节序列 | 按 Transfer-Encoding 或 Content-Length 等分帧信息读取 |
HTTP/1.1 的行结束符是 CRLF。对请求报文,如果既没有适用的 Transfer-Encoding,也没有 Content-Length,则消息体长度为 0。发送端不要同时发送 Transfer-Encoding 和 Content-Length;接收端遇到这类组合应按潜在请求走私风险处理。
快速确认
下面用固定字节串解析请求行、头字段和正文边界,不依赖网络:
raw = (
    b"POST /submit HTTP/1.1\r\n"
    b"Host: example.test\r\n"
    b"Content-Type: text/plain\r\n"
    b"Content-Length: 5\r\n"
    b"\r\n"
    b"hello"
)

head, separator, body = raw.partition(b"\r\n\r\n")
lines = head.decode("ascii").split("\r\n")
method, target, version = lines[0].split(" ", 2)
headers = dict(line.split(": ", 1) for line in lines[1:])

print(method, target, version)
print(headers["Host"])
print(len(body), body.decode("ascii"))
print(int(headers["Content-Length"]) == len(body))
预期输出:
POST /submit HTTP/1.1
example.test
5 hello
True
判读线索
请求行拆不成三段时,先检查方法与目标之间是否只有空格分隔,以及行尾是否为 CRLF。头字段看似“吃进正文”时,检查空行是否缺失;正文被截断或粘连到下一请求时,检查 Content-Length、Transfer-Encoding 与实际字节数是否一致。
Host 是 HTTP/1.1 请求的重要路由字段;HTTP/1.1 客户端应发送 Host,服务端对缺失、重复或无效的 Host 应按协议要求拒绝请求。不要把 HTTP/2、HTTP/3 的伪首部格式套到 HTTP/1.1 文本报文上。
处理顺序
先确认请求行,再确认每个头字段都在空行之前结束,最后根据分帧字段读取消息体。若怀疑代理、网关和源站对边界理解不一致,应保存原始字节并对比各跳解析结果,而不是只看框架已经解析后的对象。
适用范围是 RFC 9112 定义的 HTTP/1.1 消息语法;具体方法语义、字段语义和状态处理还需结合 RFC 9110 及目标服务实现。
查询状态行、响应头、空行和可选消息体的排列规则,适合分析服务端原始响应,并结合长度或传输编码判断消息体边界。
HTTP/1.1 响应报文
分析原始 HTTP/1.1 响应时,先按状态行、响应头、空行、消息体的顺序切分,再根据响应语义和传输规则判断消息体是否存在以及边界在哪里。
报文结构
典型响应按以下顺序出现:
HTTP/1.1 200 OK\r\n
Content-Type: text/plain\r\n
Content-Length: 5\r\n
\r\n
hello
状态行由协议版本、状态码和原因短语组成;随后是零个或多个响应头;第一个空行结束首部区;消息体是可选的,不能仅凭“看到空行”就断定后面一定有实体数据。
边界怎么判读
| 线索 | 含义 | 建议动作 |
|---|---|---|
Content-Length: <N> |
指示消息体长度 | 按字节读取指定长度 |
Transfer-Encoding: chunked |
使用分块传输编码 | 按 chunk 格式解析,直到终止 chunk |
| 响应语义禁止消息体 | 即使报文存在首部,也可能没有消息体 | 先看状态码及请求方法语义 |
| 以上线索互相矛盾 | 可能存在非法或异常响应 | 不要自行拼接,记录原始字节并按协议规则排查 |
对于需要精确分析的场景,应以实际响应头和原始字节为准,而不是仅根据抓包工具的高层展示判断边界。
快速确认
printf 'HTTP/1.1 200 OK\r\nContent-Length: 5\r\n\r\nhello' | od -An -tx1c预期输出:输出中可看到状态行、Content-Length、两个连续的 CRLF,以及最后的 hello 字节;具体列宽会因 od 实现不同而变化。
处理顺序
定位服务端原始响应时,先确认状态行是否完整,再读取首部直到空行;若存在 Content-Length,按声明长度核对实际字节数;若使用 Transfer-Encoding: chunked,改按分块规则解析。具体首部字段及消息体语义以目标 HTTP/1.1 规范和实际响应为准。
对照固定 9 字节帧头中的 Length、Type、Flags、Reserved 与 Stream Identifier,适合切分 HTTP/2 二进制帧并识别所属流。
HTTP/2 帧头
解析 HTTP/2 原始字节流时,先读取固定的 9 字节帧头,再使用 Length 确定后续帧载荷长度,并结合 Type、Flags 和 Stream Identifier 判断帧语义与所属流。
9 字节布局
| 偏移 | 长度 | 字段 | 判读方式 |
|---|---|---|---|
| 0–2 | 3 字节 | Length |
载荷长度,不包含 9 字节帧头 |
| 3 | 1 字节 | Type |
指示帧类型 |
| 4 | 1 字节 | Flags |
按具体帧类型解释 |
| 5 | 1 位 | R |
保留位,应按规范处理 |
| 5–8 | 31 位 | Stream Identifier |
指示所属流;具体取值约束取决于帧类型 |
因此,单个帧的总长度为 9 + Length。切分时不能把 Length 误解为整个帧的长度。
怎么判读
先读取前 3 字节得到 Length,第 4 字节得到 Type,第 5 字节得到 Flags;最后 4 字节中最高位是保留位,其余 31 位组成流标识符。Flags 的有效含义不是全局统一的,必须结合具体 Type 判断。
快速确认
以下是一个人工检查用的帧头片段示例,假定前 3 字节表示长度 0x000005,类型为 0x01:
00 00 05 01 04 00 00 00 01预期结果:Length = 5、Type = 0x01、Flags = 0x04、保留位为 0、Stream Identifier = 1;完整帧还应继续包含 5 字节载荷。
排查线索
| 现象 | 常见判读方向 |
|---|---|
| 下一帧位置算错 | 检查是否错误地把 Length 当成总长度 |
| 流归属异常 | 检查最后 4 字节是否正确去除最高保留位 |
Flags 无法解释 |
先确认 Type,不要脱离帧类型单独解释标志位 |
| 解析到非法帧 | 同时核对连接前言、帧长度限制及对应帧类型规则 |
该 9 字节固定帧头适用于 HTTP/2 的标准帧格式;具体 Type、Flags 和流标识约束应按对应帧类型及 HTTP/2 规范判读。
查询 DATA 帧载荷及 PADDED、END_STREAM 等标志影响下的布局,适合定位实际数据与填充区域,并判断流是否发送结束。
HTTP/2 DATA 帧
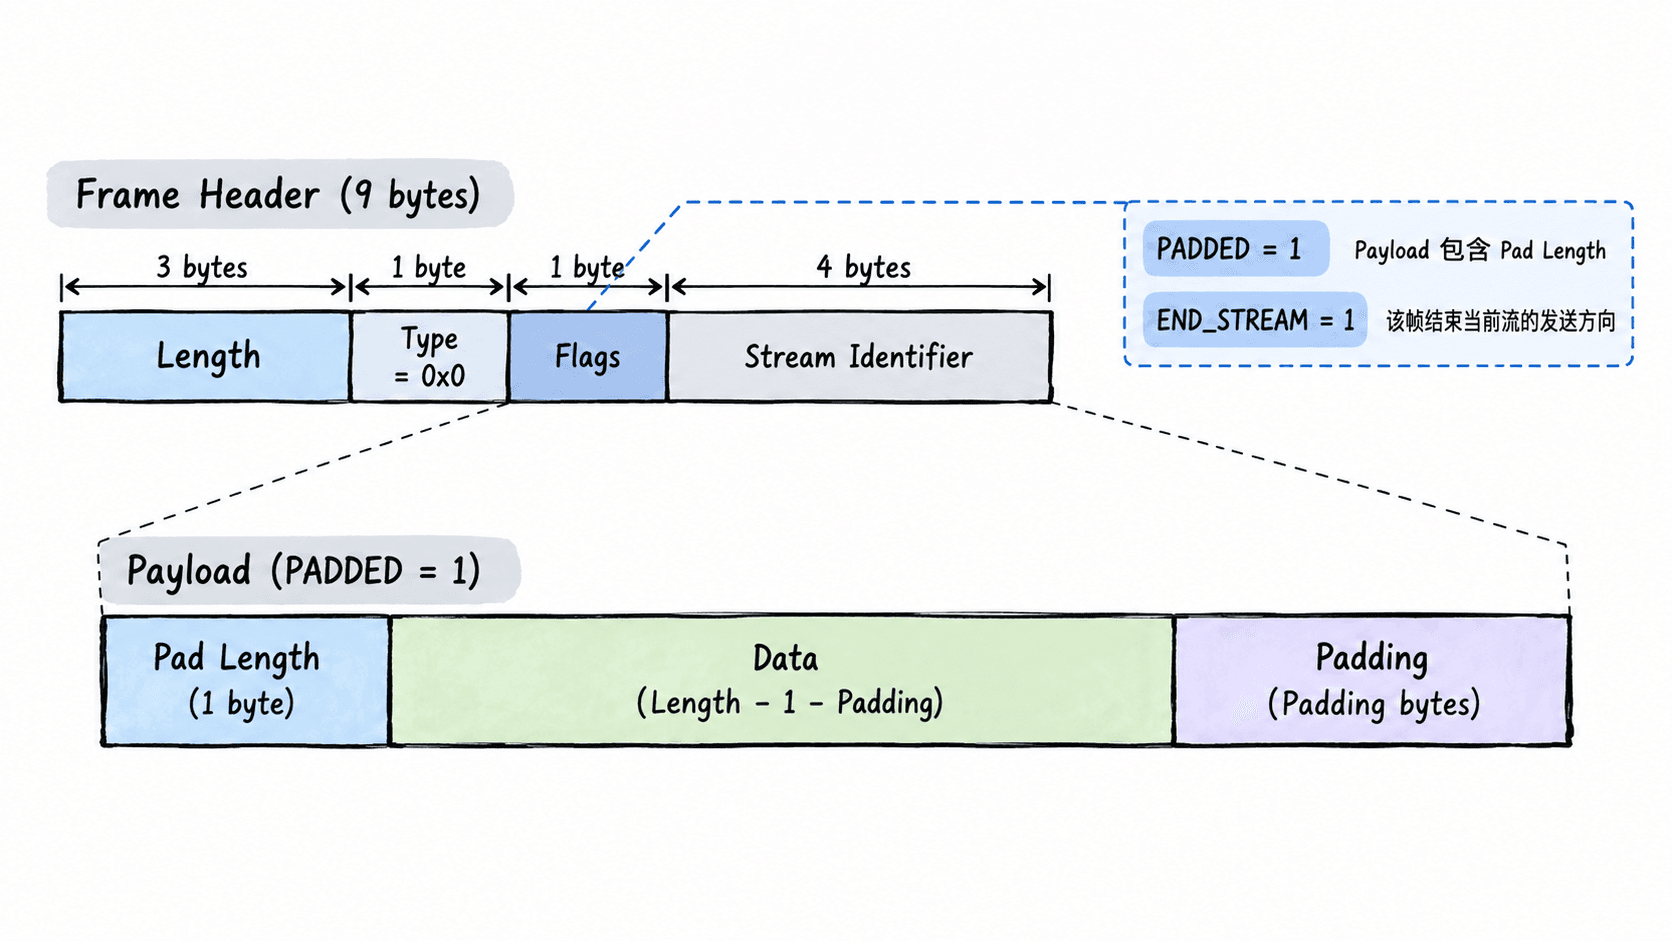
需要分析 HTTP/2 数据流、定位真实载荷或判断流是否结束时,重点检查 DATA 帧的 Flags、Length 与 Payload;其中 PADDED 会在载荷前增加 Padding Length,END_STREAM 表示该帧结束此流的发送方向。
字段与标志
DATA 帧固定包含 9 字节 Frame Header,随后是可变长度 Payload。Frame Header 中的 Length 表示当前帧的 Payload 长度,不包含 9 字节头部。
| 线索 | 含义 | 建议动作 |
|---|---|---|
Type=0x0 |
当前帧是 DATA | 按 DATA 帧格式继续解析 |
END_STREAM=1 |
此帧结束该方向上的流数据 | 将其视为该方向的结束标志,不再等待同方向新的 DATA |
PADDED=1 |
Payload 开头含 1 字节 Pad Length | 先读取 Pad Length,再扣除 Padding 后定位实际 Data |
PADDED=0 |
Payload 直接承载 Data | 从 Payload 起始位置读取数据 |
快速判读
解析 Length 时,先确认它覆盖的是整个 Payload。启用 PADDED 后,Payload 的结构变为 Pad Length + Data + Padding;Padding 的长度由最后的 Pad Length 字节数决定,因此不能把整段 Payload 都当作业务数据。
快速确认
curl --http2 -v https://<HOST>:<PORT>/<PATH>预期结果:客户端尝试使用 HTTP/2;-v 会输出连接协商及 HTTP 交互信息,但通常不会直接把 DATA 帧按字节字段拆开。需要核对实际帧结构时,应结合抓包文件或 HTTP/2 协议解析器读取。
tshark -r <PATH> -Y http2.data -V预期结果:对抓包中的 HTTP/2 DATA 帧逐项展开解析;重点查看 Frame Length、Flags、Stream Identifier,以及启用 Padding 时的 Padding Length、Data 和 Padding 字段。具体显示顺序以当前 Wireshark/TShark 版本为准。
处理边界
END_STREAM 表示流在该方向上的发送结束,不等同于“整个 HTTP 请求已成功完成”;请求与响应各自有独立的结束方向。判断异常时,还要结合 RST_STREAM、GOAWAY 以及应用层状态。
看到 PADDED=1 时不要直接按字符串或 JSON 解析整个 Payload;先依据 Padding Length 裁掉尾部填充,再读取真正的数据区域。
对照 HEADERS 帧中的头部块片段以及可选 Padding、Priority 相关字段,适合定位 HPACK 编码数据并判断头部块是否结束。
HTTP/2 HEADERS 帧
需要定位 HTTP/2 请求或响应头、确认 HPACK 头部块是否结束时,重点看 Type=0x1、END_HEADERS、PADDED 和 PRIORITY。HEADERS 的 Payload 不是可直接阅读的文本,而是按帧标志决定布局的头部块片段。
字段与标志
HEADERS 帧固定包含 9 字节 Frame Header。Payload 在没有可选字段时直接承载 Header Block Fragment;启用 PADDED 时先出现 Pad Length,启用 PRIORITY 时还包含 5 字节优先级信息,然后才是头部块片段。
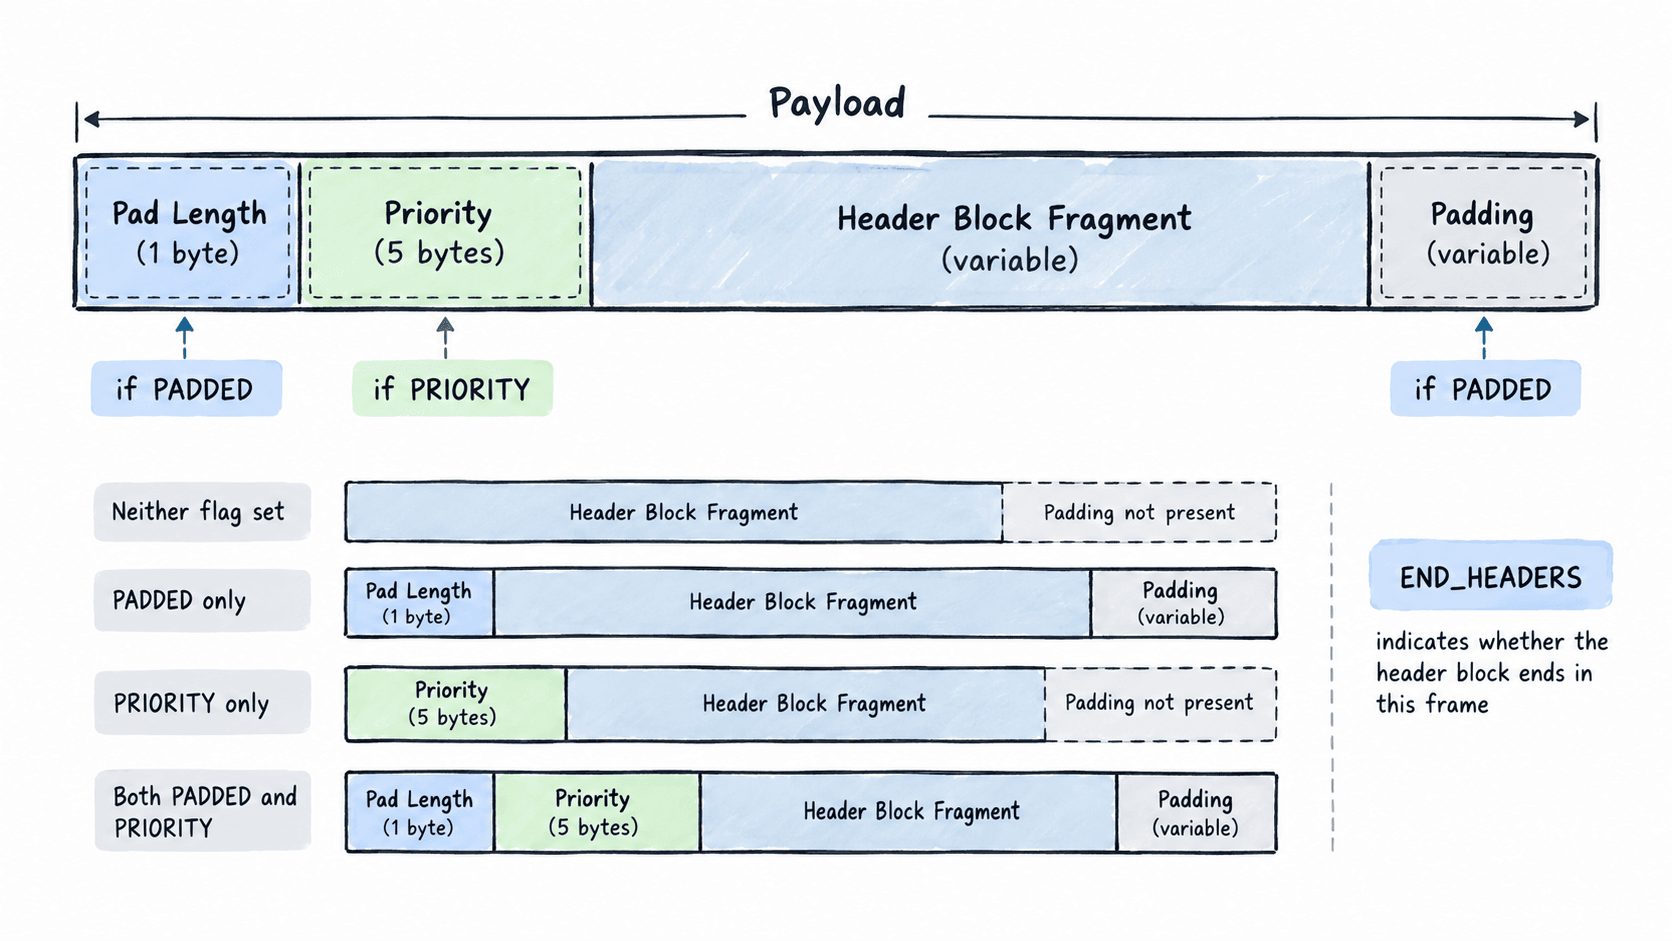
| 线索 | 含义 | 建议动作 |
|---|---|---|
Type=0x1 |
当前帧是 HEADERS | 按 HEADERS 布局解析 |
END_HEADERS=1 |
当前帧结束这个 Header Block | 当前头部块无需等待后续 CONTINUATION |
END_HEADERS=0 |
当前头部块尚未结束 | 继续寻找同一头部块的后续帧,通常检查 CONTINUATION |
PADDED=1 |
Payload 开头含 Pad Length | 先解析填充长度,再定位 Header Block Fragment |
PRIORITY=1 |
Payload 中包含优先级相关字段 | 先读取 5 字节优先级字段,再解析 Header Block Fragment |
快速判读
END_HEADERS 只描述 Header Block 是否结束,不表示 Stream 是否结束;后者由 END_STREAM 控制。两者可以独立出现,因此看到 END_HEADERS=1 时不要直接推断请求或响应已经完成。
HPACK 编码后的 Header Block Fragment 不能按普通文本搜索。抓包工具若能正确解码 HTTP/2 会显示解压后的头字段;分析原始报文时,则需要结合同一 HTTP/2 连接的 HPACK 上下文。
快速确认
curl --http2 -v https://<HOST>:<PORT>/<PATH>预期结果:客户端尝试使用 HTTP/2,并输出请求或响应头信息;该输出便于确认 HTTP/2 是否建立,但不会完整展示 HEADERS 帧的二进制字段布局。
tshark -r <PATH> -Y 'http2.type == 1' -V预期结果:对抓包中解析为 HEADERS 的 HTTP/2 帧进行详细展开;可检查 Frame Length、Flags、Stream Identifier,以及 END_HEADERS、PADDED、PRIORITY 和 Header Block Fragment 等解析结果。具体显示字段以当前 Wireshark/TShark 版本为准。
处理边界
END_HEADERS=0 时,不要把当前帧的 Header Block Fragment 当作完整头部集合;需要继续关联后续 CONTINUATION 帧。若抓包在中途缺失,HPACK 状态或头部块边界可能无法完整恢复。
PRIORITY 属于 HEADERS 帧的可选字段,不能因为某一抓包中存在它就把该布局视为所有 HEADERS 帧的固定格式。