
数据结构与算法 / 知识点
算法模板速查
数组与字符串
用于数组和字符串中处理有序关系或区间移动问题;适合替代嵌套循环降低时间复杂度,常见于滑动窗口和两数问题。
双指针扫描
目标是使用两个游标协同移动,在线性时间内完成数组或字符串中的查找、匹配和区间调整问题。完成后应能识别适合双指针的输入结构,并将常见的双重循环优化为一次扫描。
前置条件
- 数据通常具有顺序关系,例如升序数组、连续字符串或可通过移动边界缩小搜索范围的序列。
- 需要明确两个指针的职责,例如左右夹逼、快慢追踪或同向遍历。
- 移动规则必须保证不会跳过可能答案。
操作步骤
- 根据问题目标确定指针含义:左指针表示区间起点,右指针表示区间终点,或两个指针分别表示不同遍历速度。
- 初始化两个指针位置,并定义循环结束条件。
- 根据当前状态移动其中一个或两个指针,每次移动都减少剩余搜索空间。
- 在指针变化过程中更新答案或维护区间状态。
示例:在有序数组中查找两个数之和。
numbers = [1, 2, 4, 7, 11, 15]
target = 15
left, right = 0, len(numbers) - 1

while left < right:
    total = numbers[left] + numbers[right]
    if total == target:
        break
    if total < target:
        left += 1
    else:
        right -= 1

print((left, right))
预期结果
(1, 5)结果表示 2 + 13 的位置需要根据输入调整;本示例中的实际数组会输出对应满足条件的位置。验证时应检查指针移动是否覆盖所有可能组合。
验证与失败处理
检查循环是否始终向结束方向推进,避免两个指针停留在同一状态导致死循环。若结果遗漏边界值,优先检查初始化位置和移动条件,而不是增加额外遍历。
常见失败原因包括:
- 未利用数据有序性,导致指针移动依据不足。
- 移动指针时跳过了仍可能满足条件的元素。
- 将双指针错误应用到无法维护单调变化关系的问题。
恢复正常解法
如果无法证明指针移动不会丢失答案,应退回到更直接的方法,例如哈希表或完整遍历,再根据时间复杂度要求重新设计移动规则。
维护连续区间状态解决子串、子数组最优值问题;适合窗口可扩展或收缩且状态能增量更新的场景。
滑动窗口
目标是维护一个连续区间,并通过窗口扩张和收缩快速求解子数组、子串中的最大值、最小值或满足条件的区间。完成后应能判断窗口状态是否可以增量更新,并避免重复计算。
前置条件
- 问题对象必须是连续区间,例如连续子数组或连续子串。
- 窗口内状态可以通过加入右侧元素和移除左侧元素更新。
- 需要明确窗口扩张条件和收缩条件。
操作步骤
- 初始化左右边界,通常从空窗口开始。
- 移动右边界加入新元素,并更新窗口状态。
- 当窗口满足或违反目标条件时,根据规则移动左边界。
- 每次窗口变化后记录当前最优结果。
示例:计算字符串中不含重复字符的最长连续子串长度。
text = "abcabcbb"
seen = set()
left = 0
best = 0

for right, char in enumerate(text):
    while char in seen:
        seen.remove(text[left])
        left += 1
    seen.add(char)
    best = max(best, right - left + 1)

print(best)
预期结果
3输出表示最长连续区间为 abc,长度为 3。验证时可替换输入字符串,检查窗口是否始终保持无重复状态。
验证与失败处理
重点检查窗口状态更新是否与边界移动同步。如果收缩后结果错误,通常是删除旧元素、更新计数或移动左边界的顺序不正确。
常见失败原因包括:
- 将滑动窗口用于无法连续移动的问题。
- 每次移动都重新扫描窗口,退化为平方复杂度。
- 忘记处理空输入或单元素输入。
恢复正常解法
如果窗口状态无法增量维护,应改用前缀和、哈希结构或动态规划等方案。选择滑动窗口前,应先确认窗口扩张和收缩都能在有限状态下完成。
通过预处理累计信息快速计算区间结果;适合多次区间查询、子数组求和和差分转换问题。
前缀和
需要快速计算数组区间累计结果时,使用前缀和可以把重复遍历转换为一次预处理加快速查询。完成后可在 时间得到任意区间和。
前置条件
- 已确定数组元素顺序不会被频繁修改;如果存在大量修改,应考虑树状数组或线段树。
- 已明确区间边界采用左闭右闭还是左闭右开规则。
构造步骤
- 创建前缀数组
prefix,其中prefix[i]表示前i个元素的累计值。 - 查询区间
[left, right]时,使用右端累计值减去左侧累计值。 - 统一边界定义,避免下标偏移错误。
nums = [2, 4, 1, 7, 3]
prefix = [0]

for value in nums:
    prefix.append(prefix[-1] + value)

left, right = 1, 3
result = prefix[right + 1] - prefix[left]
print(result)
预期输出
12验证检查点
检查查询结果是否等于原数组对应区间直接求和结果。例如 [4, 1, 7] 的和为 12,应与前缀计算结果一致。
常见失败处理
- 结果少算第一个元素:通常是
prefix是否包含初始0导致的边界问题。 - 区间包含负数时结果异常:确认累计逻辑没有使用错误的初始化值。
恢复方式
如果后续存在数组更新操作,停止使用静态前缀和,改用支持动态修改的结构重新设计。
利用栈维护单调关系解决下一个更大或更小元素问题;适合线性扫描替代重复比较。
单调栈
需要查找下一个更大元素、下一个更小元素或维护区间极值关系时,使用单调栈可以把多次比较优化为一次线性扫描。
前置条件
- 问题需要维护元素之间的大小关系。
- 每个元素通常只需要被入栈和出栈一次。
- 已确定维护的是递增栈还是递减栈。
操作步骤
- 从左到右遍历数组。
- 当前元素到来时,与栈顶元素比较。
- 如果当前元素满足目标关系,持续弹出无效元素并记录答案。
- 将当前元素加入栈中,等待后续元素处理。
nums = [2, 1, 5, 3, 4]
result = [-1] * len(nums)
stack = []

for i, value in enumerate(nums):
    while stack and nums[stack[-1]] < value:
        index = stack.pop()
        result[index] = value
    stack.append(i)

print(result)
预期输出
[5, 5, -1, 4, -1]验证检查点
逐个检查元素:2 后第一个更大值是 5,1 后第一个更大值是 5,5 不存在更大值,结果应保持 -1。
失败处理
- 结果遗漏元素:检查弹栈条件是否与目标问题一致,例如求下一个更小值时需要反转比较方向。
- 栈无限增长:确认入栈保存的是索引还是值,并且已经在满足条件时移除无效元素。
恢复方式
如果题目需要同时处理区间更新、动态插入或删除,不再适合普通单调栈,应改用支持动态维护的数据结构。
搜索与枚举
在有序范围或满足单调条件的答案空间中快速定位目标;适合查找位置和答案值优化问题。
二分查找
二分查找用于在有序数据或满足单调性的搜索空间中快速缩小范围,最终定位目标位置或找到满足条件的最优答案。核心是把一次判断后的搜索区间缩小一半,将线性枚举优化为对数复杂度。
确定搜索模型
开始编码前,需要先明确二分作用于什么范围:
- 查找元素位置:目标值存在于有序数组中,返回目标下标。
- 查找边界位置:寻找第一个满足条件的位置或最后一个满足条件的位置。
- 答案二分:答案无法直接计算,但可以通过判断某个答案是否可行来缩小范围。
无论是哪种形式,都需要保证判断函数具有单调性,否则区间缩小后可能丢失正确答案。
编写二分流程
- 定义搜索区间的含义,例如闭区间
[left, right]表示当前可能包含答案的位置。 - 计算中间位置
mid,避免使用可能溢出的加法形式。 - 根据
mid对应值与目标的关系,排除不可能区域。 - 当区间为空时结束搜索,并返回约定结果。
def binary_search(nums, target):
    left, right = 0, len(nums) - 1

    # 闭区间写法:left <= right 保证最后一个候选位置也会被检查
    while left <= right:
        mid = left + (right - left) // 2
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1
        else:
            right = mid - 1

    return -1

print(binary_search([1, 3, 5, 7, 9], 7))
预期输出
3验证边界情况
检查二分是否正确时,重点覆盖以下情况:
- 空数组:应直接返回失败结果。
- 单元素数组:目标存在和不存在时都应正确结束。
- 首尾元素:确认边界更新没有跳过答案。
- 重复元素:如果需要第一个或最后一个位置,应改用边界二分模板。
常见错误处理
二分错误通常来自区间定义不一致。常见问题包括:
- 使用闭区间却写成
left < right,导致最后一个候选位置未检查。 - 更新
left或right时没有排除已经判断过的mid,造成死循环。 - 对答案型二分缺少可行性判断函数,无法保证搜索方向正确。
速查提示
写二分前先回答两个问题:当前区间代表什么,判断结果如何排除一半范围。只要区间语义保持一致,查找位置和答案优化问题都可以使用同一套思路扩展。
通过选择、递归、撤销构造所有可能方案;适合排列组合、路径和约束满足问题。
回溯搜索
回溯搜索用于解决需要枚举候选方案的问题。它通过逐步做出选择、检查约束、深入搜索,并在不满足条件或完成一条路径后撤销选择,最终得到全部合法结果。
适用场景
当问题具有“从多个选择中逐步构造答案”的特点时,可以使用回溯搜索,例如排列、组合、子集、棋盘放置和路径查找等问题。
使用前需要明确三个部分:当前状态如何表示、下一步有哪些选择、什么时候可以确认得到一个完整答案。
搜索过程
回溯的核心不是简单遍历,而是在搜索树中维护一个可恢复状态:
- 进入当前状态,判断是否已经得到完整方案。
- 如果未完成,枚举当前层的所有可选操作。
- 执行一次选择,更新路径或状态。
- 递归进入下一层继续搜索。
- 返回上一层前撤销选择,恢复现场。
这种“选择 → 搜索 → 撤销”的循环会覆盖所有可能分支,同时允许在选择阶段提前剪掉无效路径。
主示例
下面示例生成数组的所有排列。path 保存当前方案,递归返回后通过 pop 撤销最后一次选择。
def permutations(nums):
    result = []
    path = []
    used = [False] * len(nums)

    def dfs():
        if len(path) == len(nums):
            result.append(path.copy())
            return

        for index, value in enumerate(nums):
            if used[index]:
                continue
            used[index] = True
            path.append(value)
            dfs()
            path.pop()  # 恢复状态,尝试其他分支
            used[index] = False

    dfs()
    return result

print(permutations([1, 2, 3]))
预期输出
[[1, 2, 3], [1, 3, 2], [2, 1, 3], [2, 3, 1], [3, 1, 2], [3, 2, 1]]验证检查点
检查回溯实现时,重点确认:
- 递归终止条件能准确识别完整方案。
- 每次进入下一层前状态已更新。
- 每次递归返回后状态恢复,不影响其他分支。
- 剪枝条件不会误删合法答案。
常见问题处理
如果结果重复,通常是状态标记不足,需要记录已经使用的元素或限制重复选择。如果运行时间过长,应检查是否可以在进入递归前增加约束判断,例如剩余空间不足时直接停止搜索。
如果调试时发现路径内容异常,可以缩小输入规模,逐层打印选择和撤销过程,确认每一次递归进入和返回都保持状态一致。
沿路径递归探索状态空间;适合树遍历、图连通性和网格路径类问题。
深度优先搜索
深度优先搜索(DFS)用于从一个起点持续深入探索可达状态,直到无法继续后再回退。完成后应能根据问题选择递归或栈实现,并正确处理访问记录、路径维护和搜索剪枝。
适用场景
DFS 适合需要探索完整状态空间的问题,例如树遍历、图连通分量、迷宫搜索、排列组合生成和依赖关系检查。它的核心不是“找最深节点”,而是按照深度方向组织搜索顺序。
搜索过程中通常需要维护三类信息:当前状态、下一步选择和已访问状态。若问题需要恢复路径,还需要在进入和离开节点时修改、撤销路径数据。
实现步骤
- 确定搜索状态,以及从当前状态能够转移到哪些下一状态。
- 进入一个状态时执行处理逻辑,例如记录节点、判断目标或更新答案。
- 遍历所有可选方向,递归或使用栈继续搜索下一层。
- 如果问题需要回溯,在返回上一层前撤销当前选择,恢复搜索现场。
下面示例使用递归 DFS 遍历图结构。访问集合用于避免无向图或存在环的图中重复进入同一节点。
def dfs(graph, node, visited):
    if node in visited:
        return

    visited.add(node)
    for next_node in graph[node]:
        dfs(graph, next_node, visited)


graph = {
    "A": ["B", "C"],
    "B": ["D"],
    "C": [],
    "D": []
}

visited = set()
dfs(graph, "A", visited)
print(sorted(visited))
预期输出
['A', 'B', 'C', 'D']验证搜索结果
验证 DFS 时重点检查搜索范围和状态恢复是否正确:
- 图遍历问题:确认所有可达节点都被访问,且不存在重复处理。
- 路径问题:确认记录的路径满足目标条件,失败分支能够正确返回。
- 组合问题:确认结果数量正确,没有遗漏或重复生成。
对于递归实现,还需要测试较深输入,避免因为调用栈限制导致运行失败。
常见错误处理
- 无限递归:通常是缺少访问标记,或者状态转移没有减少剩余搜索范围。
- 结果错误:检查回溯时是否撤销了当前选择,避免上一条路径污染下一次搜索。
- 运行过慢:先确认搜索空间规模,再增加剪枝条件,例如提前排除不可能满足目标的分支。
选择递归还是栈实现
递归写法更接近 DFS 的定义,适合树结构和深度可控的问题;显式栈适合深度可能很大的图搜索,可以主动管理内存和停止条件。
实际使用时,应根据最大搜索深度、语言栈限制和问题状态复杂度选择实现方式。
按层扩展节点寻找最短路径;适合无权图、网格最少步数和状态转移问题。
广度优先搜索
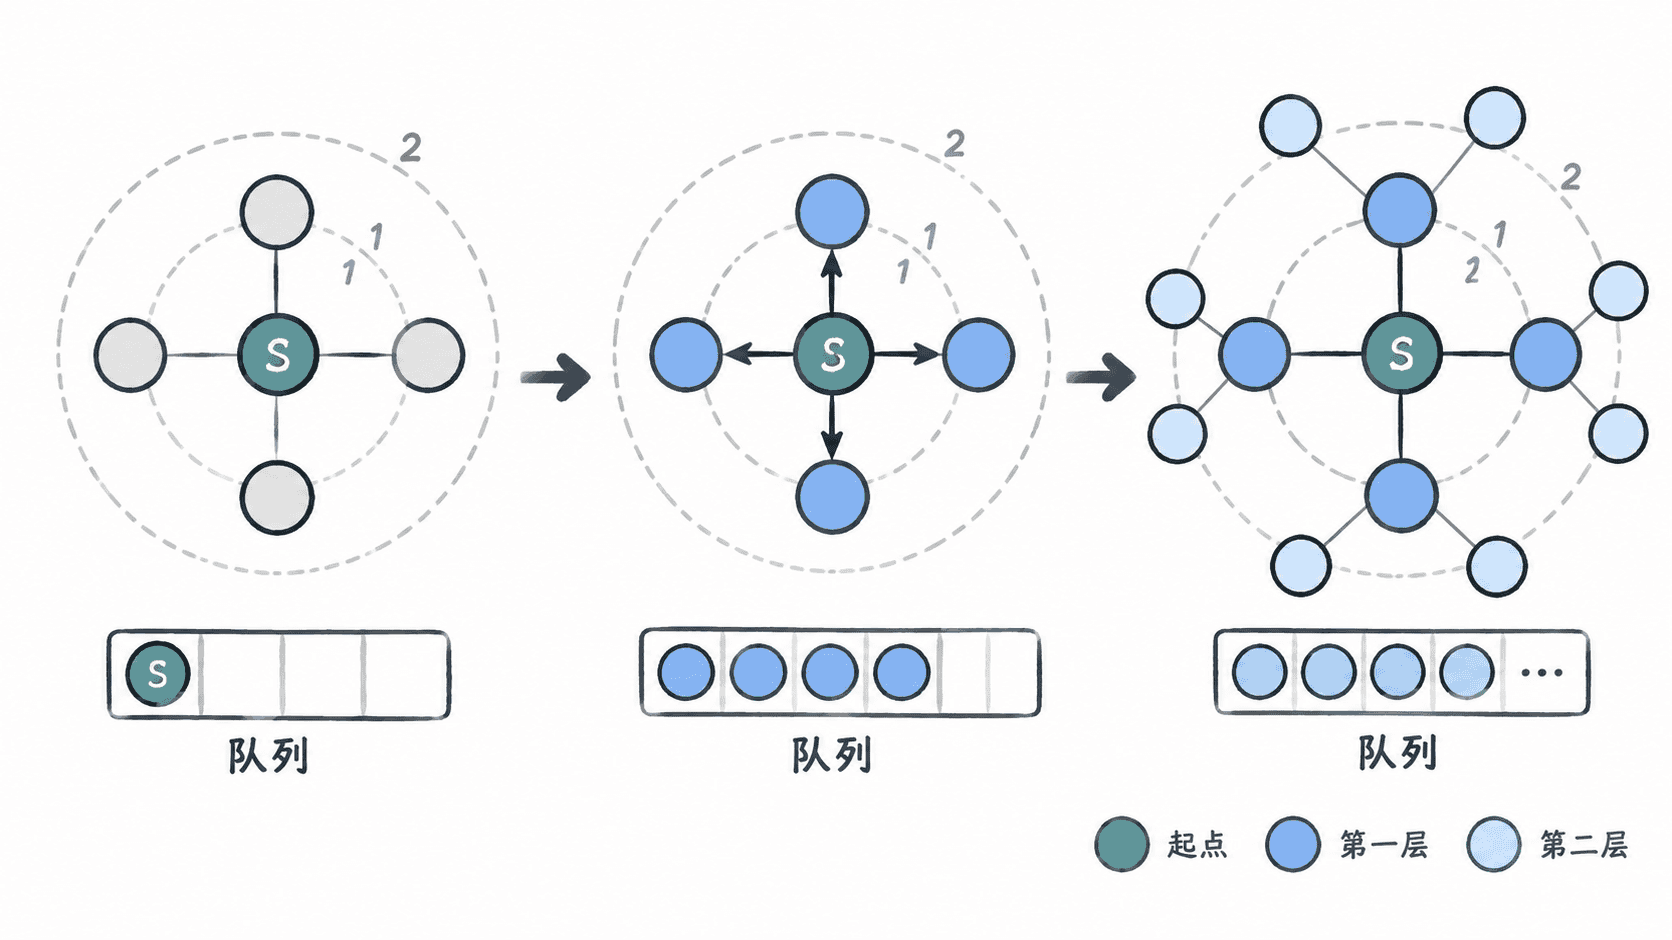
广度优先搜索(BFS)通过队列按距离层次访问状态,适用于求无权图最短路径、网格最少移动次数和状态转移中的最少步骤。完成后应能判断何时使用 BFS,并正确实现层序遍历与距离记录。
核心思路
BFS 的关键是保证先访问距离起点近的节点,再访问更远的节点。队列中的节点天然保持访问层级,因此某个状态第一次被发现时,对应的路径长度就是最短距离。
适用条件包括:
- 节点之间的移动代价相同。
- 可以明确表示当前状态以及下一步可达状态。
- 需要寻找最少次数、最短边数或最早到达结果。
实现步骤
- 创建队列保存待处理状态,并将起点加入队列。
- 创建访问集合,防止同一个状态重复进入搜索。
- 取出队首状态,检查是否达到目标。
- 遍历相邻状态,将未访问状态加入队尾,并记录距离加一。
下面示例在无权图中计算从 A 到目标节点 D 的最短边数。
from collections import deque


def bfs(graph, start, target):
    queue = deque([(start, 0)])
    visited = {start}

    while queue:
        node, distance = queue.popleft()
        if node == target:
            return distance

        for next_node in graph[node]:
            if next_node not in visited:
                visited.add(next_node)
                queue.append((next_node, distance + 1))

    return -1


graph = {
    "A": ["B", "C"],
    "B": ["D"],
    "C": ["D"],
    "D": []
}

print(bfs(graph, "A", "D"))
预期结果
2验证搜索结果
检查 BFS 是否满足以下条件:
- 目标节点第一次被取出时,距离就是最短距离。
- 每个状态只进入队列一次,避免重复扩展。
- 队列顺序符合从近到远的访问规则。
对于网格最短路,还需要额外验证边界判断和障碍过滤;对于多源 BFS,需要确认所有起点同时加入初始队列。
常见问题处理
如果结果不是最短路径,优先检查是否错误使用了栈、递归或带权优先队列;这些结构不会保持 BFS 的层序性质。
如果搜索范围过大,可以从状态设计入手减少无效节点,并加入明确的提前结束条件。若内存压力过高,检查是否因为缺少访问记录导致大量重复状态进入队列。
复杂度与边界
使用邻接表表示图时,BFS 的时间复杂度通常为 ,其中 是节点数量, 是边数量。空间复杂度为 ,主要用于队列和访问记录。
在有权图中,边权不相同时不能直接使用 BFS 求最短路径,应改用适合权重模型的算法。
图论算法
维护动态连通关系并快速合并集合;适合图连通性判断、朋友圈和最小生成树辅助场景。
并查集
并查集用于维护一组动态变化的集合关系。完成初始化、合并和查询后,可以快速判断两个元素是否连通,常用于无向图连通分量、朋友圈关系判断和 Kruskal 最小生成树算法。
构建集合模型
使用数组记录每个元素的父节点。初始化时,每个节点都是自己的代表节点,表示一个独立集合。
执行 find 时沿父节点不断向上查找根节点,根节点就是当前集合的代表。为了减少后续查询成本,查找过程中可以进行路径压缩,让访问过的节点直接指向根节点。
合并两个集合
合并操作先分别查找两个元素的代表节点。如果代表节点相同,说明两个元素已经属于同一集合,不需要重复合并。
如果代表节点不同,将一个集合挂载到另一个集合下。按秩合并或按大小合并可以避免形成过深的树结构,使多次操作后的平均性能保持稳定。
实现并查集
下面示例实现带路径压缩和按秩合并的并查集结构。
class UnionFind {
    private final int[] parent;
    private final int[] rank;

    UnionFind(int n) {
        parent = new int[n];
        rank = new int[n];
        for (int i = 0; i < n; i++) {
            parent[i] = i;
        }
    }

    int find(int x) {
        if (parent[x] != x) {
            parent[x] = find(parent[x]);
        }
        return parent[x];
    }

    boolean union(int a, int b) {
        int rootA = find(a);
        int rootB = find(b);
        if (rootA == rootB) {
            return false;
        }
        if (rank[rootA] < rank[rootB]) {
            parent[rootA] = rootB;
        } else if (rank[rootA] > rank[rootB]) {
            parent[rootB] = rootA;
        } else {
            parent[rootB] = rootA;
            rank[rootA]++;
        }
        return true;
    }
}
预期结果:创建并查集后,每个元素初始属于独立集合;执行 union(1, 2) 后,find(1) 和 find(2) 返回同一个代表节点。
应用判断
遇到以下问题时,可以优先考虑并查集:
- 只关心两个节点是否连通,不需要输出具体路径。
- 图中的边会不断加入,需要动态维护连通分组。
- 需要统计连通块数量,例如合并城市、社交关系或网络节点。
如果问题包含删除边、动态维护最短路径或需要恢复历史状态,并查集通常不是合适方案。
验证与常见错误
检查并查集实现时,重点确认:
- 初始化范围覆盖所有节点,避免数组越界。
find返回的是集合代表节点,而不是任意父节点。- 合并时连接的是两个集合的根节点,而不是输入节点本身。
- 重复合并同一集合时,不应重复增加连通数量。
并查集本身不保存操作历史。如果父节点关系被错误修改,通常需要重新初始化结构,并按原始关系重新执行合并。
根据有向无环图依赖关系确定执行顺序;适合课程安排、任务依赖和构建流程问题。
拓扑排序
拓扑排序用于把存在先后依赖的任务转换成可执行顺序。完成后可以得到满足所有依赖关系的节点序列;如果无法覆盖全部节点,则说明依赖图中存在循环。
适用场景
拓扑排序适合处理“先完成什么,后完成什么”的问题,例如课程先修关系、软件构建依赖、任务编排和流程审批。
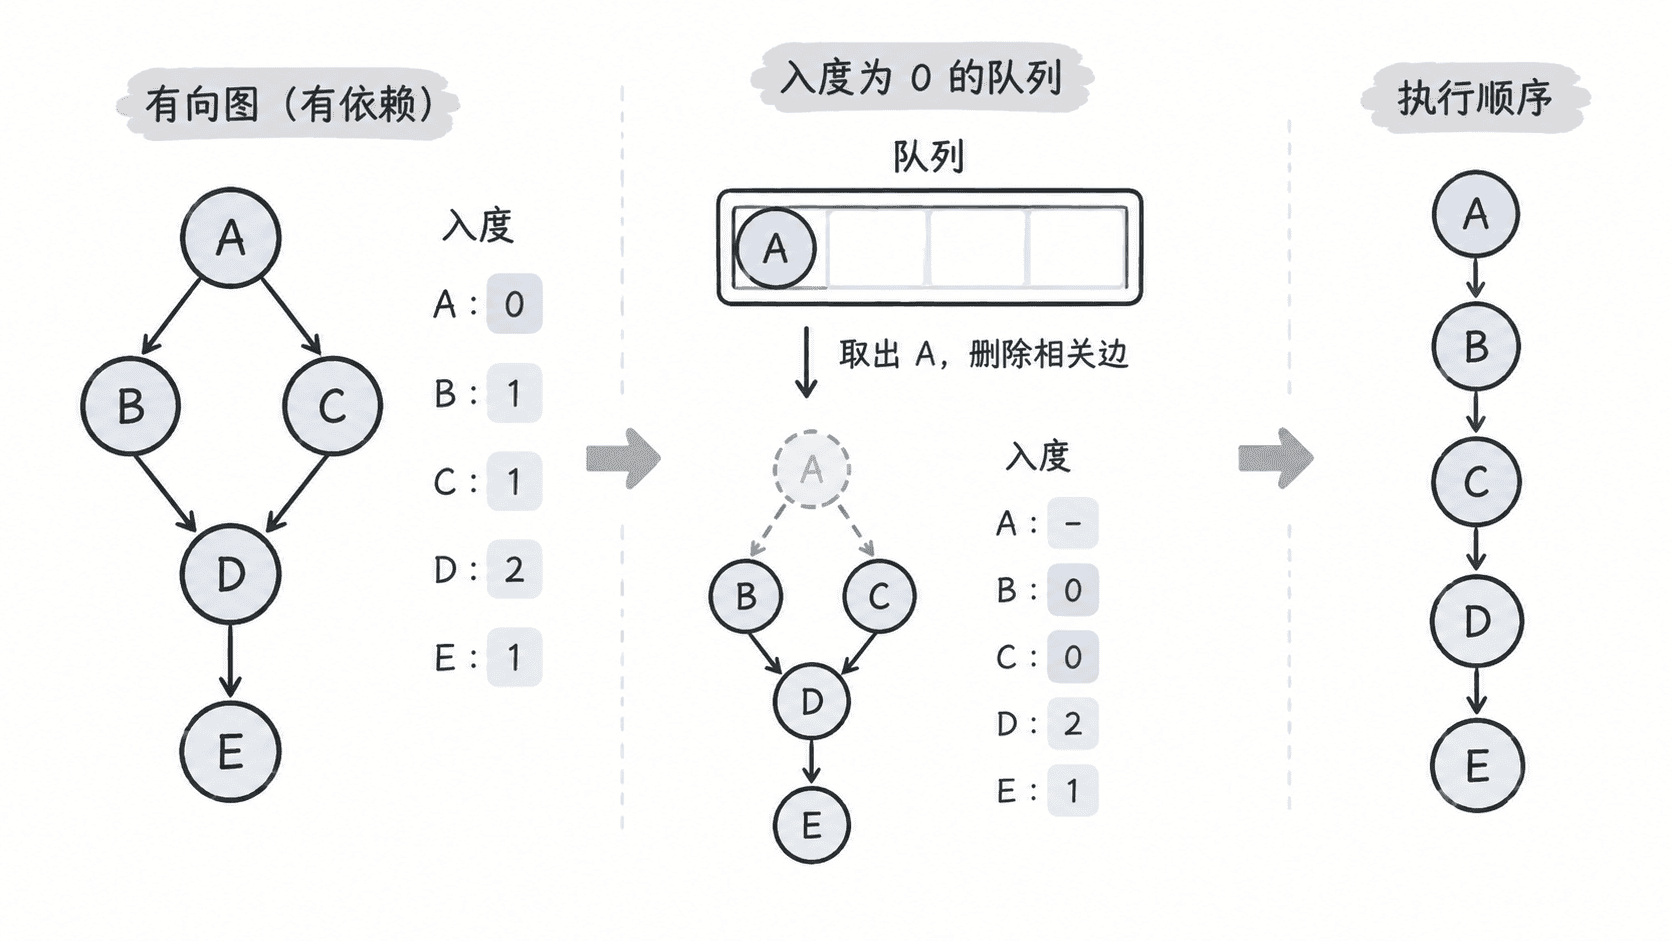
输入通常表示为有向图:节点代表任务,边 u -> v 表示任务 u 必须先于任务 v 完成。
核心步骤
- 遍历所有依赖边,统计每个节点的入度。
- 将所有入度为 0 的节点加入队列,它们是当前可以执行的任务。
- 每次取出一个节点加入结果,并减少它指向节点的入度。
- 当某个节点入度变为 0 时,将它加入队列继续处理。
- 如果最终结果包含全部节点,说明排序成功;否则存在环。
Java 实现
import java.util.*;

public class TopologicalSort {
    public static List<Integer> sort(int n, int[][] edges) {
        List<Integer>[] graph = new ArrayList[n];
        for (int i = 0; i < n; i++) {
            graph[i] = new ArrayList<>();
        }

        int[] indegree = new int[n];
        for (int[] edge : edges) {
            graph[edge[0]].add(edge[1]);
            indegree[edge[1]]++;
        }

        Queue<Integer> queue = new ArrayDeque<>();
        for (int i = 0; i < n; i++) {
            if (indegree[i] == 0) {
                queue.offer(i);
            }
        }

        List<Integer> order = new ArrayList<>();
        while (!queue.isEmpty()) {
            int node = queue.poll();
            order.add(node);
            for (int next : graph[node]) {
                if (--indegree[next] == 0) {
                    queue.offer(next);
                }
            }
        }

        return order.size() == n ? order : Collections.emptyList();
    }

    public static void main(String[] args) {
        int[][] edges = {{0, 1}, {0, 2}, {1, 3}, {2, 3}};
        System.out.println(sort(4, edges));
    }
}
预期输出:
[0, 1, 2, 3]验证与失败处理
验证结果时,需要确认每个节点只出现一次,并检查每条边 u -> v 中 u 在结果序列中的位置早于 v。
如果结果为空或节点数量不足:
- 检查依赖方向是否写反。
- 检查是否存在循环依赖,例如
A -> B -> C -> A。 - 检查入度统计是否遗漏边。
发现环时不能通过修改排序队列解决问题,需要回到依赖来源,删除错误依赖或拆分循环任务后重新排序。
计算图中节点之间的最低代价路径;需要根据边权和约束选择不同算法模板。
最短路径
完成最短路径模板选择后,可以根据图的边权特征确定算法,并得到指定起点到目标节点的最低代价路线。
前置条件
- 已明确图是有向图还是无向图。
- 已确认边权是否允许负数,是否需要处理负权环。
- 已确定目标是单源最短路径、全源最短路径还是仅查询部分节点。
操作步骤
- 边权全部非负时,优先使用 Dijkstra 算法维护当前最短距离。
- 边权可能为负但不存在负权环时,使用 Bellman-Ford 检查松弛结果。
- 需要计算任意两点距离且节点规模较小时,选择 Floyd-Warshall。
- 根据节点数量、边数量和查询次数调整实现方式。
片段示例:Dijkstra 求单源最短距离。
import heapq


def dijkstra(graph, start):
    dist = {node: float("inf") for node in graph}
    dist[start] = 0
    queue = [(0, start)]

    while queue:
        current, node = heapq.heappop(queue)
        if current > dist[node]:
            continue
        for target, weight in graph[node]:
            new_dist = current + weight
            if new_dist < dist[target]:
                dist[target] = new_dist
                heapq.heappush(queue, (new_dist, target))
    return dist


graph = {"A": [("B", 2), ("C", 5)], "B": [("C", 1)], "C": []}
print(dijkstra(graph, "A"))
预期输出
{'A': 0, 'B': 2, 'C': 3}验证检查点
- 检查起点距离是否为 0。
- 检查所有可达节点是否都有最小距离记录。
- 对存在多条路径的节点,使用小规模样例手算结果进行比对。
失败处理
如果结果出现负距离或与手算不一致,先检查算法是否适用于当前边权类型;如果存在负权边,不应继续使用 Dijkstra。
如果规模过大导致超时,需要重新评估算法复杂度或采用更适合查询模式的数据结构。
连接所有节点并最小化总边权;适合网络建设和无向带权图优化问题。
最小生成树
完成最小生成树构造后,可以在无向连通带权图中连接全部节点,并保证边权总和最小且不存在环。
前置条件
- 图必须是无向图。
- 需要确认图是否连通;非连通图只能得到最小生成森林。
- 边权用于表示连接成本、距离或资源消耗等可比较代价。
操作步骤
- 使用 Kruskal 算法时,按边权从小到大排序。
- 依次尝试加入边,使用并查集判断两个节点是否已经连通。
- 如果加入后不会形成环,则保留该边。
- 直到选出
节点数 - 1条边,得到最小生成树。
class UnionFind:
    def __init__(self, n):
        self.parent = list(range(n))

    def find(self, x):
        if self.parent[x] != x:
            self.parent[x] = self.find(self.parent[x])
        return self.parent[x]

    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False
        self.parent[rb] = ra
        return True


def kruskal(n, edges):
    uf = UnionFind(n)
    result = []
    for u, v, weight in sorted(edges, key=lambda x: x[2]):
        if uf.union(u, v):
            result.append((u, v, weight))
    return result

print(kruskal(4, [(0, 1, 1), (1, 2, 2), (2, 3, 3), (0, 3, 4)]))
预期输出
[(0, 1, 1), (1, 2, 2), (2, 3, 3)]验证检查点
- 结果边数应为节点数减一(连通图场景)。
- 所有节点应能通过结果边互相到达。
- 总边权应不大于任意其他合法生成树。
失败处理
如果最终边数不足,先检查输入图是否连通;如果结果包含环,检查并查集的合并判断逻辑。
对于稠密图或需要按节点扩展的场景,可以改用 Prim 算法,根据邻接表和优先队列优化。
树与递归
递归处理树节点关系;适合二叉树路径、子树信息和递归状态传递问题。
深度优先遍历树
深度优先遍历树用于沿一条分支深入访问节点,再返回处理其他分支。掌握后可以完成树的节点访问、路径搜索、子树统计以及递归状态传递等任务。
选择遍历策略
树遍历的关键不是写出递归,而是确定当前节点处理时机:
- 前序遍历:进入节点时处理,适合复制树、记录根到叶路径。
- 中序遍历:处理左子树后访问节点,适合二叉搜索树有序访问。
- 后序遍历:处理子树后汇总节点,适合计算高度、子树大小等依赖子结果的问题。
如果问题需要从子节点收集信息再决定当前节点结果,通常选择后序递归。
编写递归函数
实现 DFS 时先定义递归函数的职责,让一次调用只解决一个节点:
- 接收当前节点和必要状态。
- 处理空节点,返回基础结果。
- 按遍历顺序处理当前节点或子节点。
- 合并子树返回值,并作为当前调用结果返回。
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right


def max_depth(root):
    if root is None:
        return 0

    # 当前节点深度由左右子树最大深度决定
    return max(max_depth(root.left), max_depth(root.right)) + 1

root = TreeNode(1, TreeNode(2, TreeNode(3)), TreeNode(4))
print(max_depth(root))
预期输出
3验证遍历结果
检查递归逻辑时重点确认三个位置:
- 基础条件是否覆盖空节点,避免访问不存在的子节点。
- 节点处理位置是否符合目标顺序。
- 返回值是否真正代表当前子树的信息,而不是只保存局部结果。
处理深度过大问题
递归 DFS 会占用调用栈,树高度很大时可能触发递归深度限制。此时使用显式栈保存待访问节点,可以保持相同的深度优先顺序。
选择迭代方式时,需要额外记录节点状态;如果需要模拟后序遍历,还要区分“第一次到达节点”和“子树处理完成”两个阶段。
速查提示
树 DFS 的核心是定义递归返回值。先明确“一个节点需要从子树获得什么信息”,再决定遍历顺序和状态传递方式。
在树结构上合并子节点状态;适合树上选择、覆盖和路径优化问题。
树形动态规划
需要在树结构上综合子节点信息并得到全局最优结果时,使用树形动态规划。完成后可以把每个子树压缩成有限状态,再向父节点合并。
前置条件
- 已确定树的根节点或可以任选根进行处理。
- 已定义每个节点需要维护的状态,例如选中与不选中、覆盖与未覆盖、最大值与最小值。
- 状态数量必须有限,否则无法有效合并。
操作步骤
- 从叶子节点开始设计状态含义,明确每个状态代表的子树结果。
- 使用 DFS 后序遍历,先计算所有子节点状态。
- 根据父子关系转移状态,将子节点结果合并到当前节点。
- 根节点计算完成后,根据题目要求选择最终状态。
# 求二叉树最大深度,使用树形 DP 保存子树高度
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right


def max_depth(root):
    if root is None:
        return 0

    left = max_depth(root.left)
    right = max_depth(root.right)
    return max(left, right) + 1

root = TreeNode(1, TreeNode(2), TreeNode(3))
print(max_depth(root))
预期输出
2验证检查点
检查状态设计是否覆盖所有子树情况:
- 叶子节点是否有明确初始状态。
- 父节点是否只依赖子节点已经计算完成的结果。
- 根节点答案是否能由最终状态直接得到。
失败处理
如果转移关系复杂或状态数量不断增加,先重新定义状态含义,删除无法影响最终答案的维度。不要直接增加状态分支。
恢复方式
回退到最小状态集合,从叶子节点重新推导转移公式,再逐步增加必要状态。
动态规划
将复杂问题拆解为重复子问题并保存状态;适合最优决策、计数和路径规划问题。
动态规划
动态规划通过定义状态和状态之间的转移关系,把重复计算的问题转化为有序推导过程。完成设计后,应能明确 dp 表示什么、如何更新以及哪个状态对应最终答案。
识别适用问题
优先判断问题是否同时具备两个特征:
- 存在重复子问题:不同计算路径会访问相同规模的子问题。
- 存在最优子结构:大问题的最优解可以由小问题的最优解组合得到。
如果每个选择都会影响后续结果,需要记录历史信息时,通常需要设计状态保存这些影响。
设计状态与转移
状态定义决定了动态规划的方向。常见思路是先回答“完成某个阶段后,需要知道哪些信息才能继续计算”。
例如爬楼梯问题中,当前第 i 阶的方法数只依赖前两阶,因此可以定义:
dp[i]:到达第i阶的方法数量。- 转移关系:
dp[i] = dp[i - 1] + dp[i - 2]。
推导状态时应避免保存无关信息,否则会增加空间复杂度。
编写动态规划流程
- 明确状态含义,确保每个状态都能描述一个子问题。
- 根据最后一步行为推导转移关系。
- 设置最小规模问题的初始状态。
- 按依赖顺序计算状态,避免读取未完成结果。
- 返回表示目标问题的状态值。
主示例
下面使用滚动变量优化空间,只保存计算当前状态需要的前两个结果。
def climb_stairs(n):
    # 保存最近两个状态,避免创建完整 dp 数组
    if n <= 2:
        return n

    prev, curr = 1, 2
    for _ in range(3, n + 1):
        prev, curr = curr, prev + curr

    return curr

print(climb_stairs(5))
预期结果:
8验证与常见错误
检查动态规划是否正确时,可以从以下方向验证:
- 状态是否覆盖了题目要求的信息,而不是只描述当前局部情况。
- 转移是否来自明确的选择或决策过程。
- 初始化是否覆盖空输入、最小规模等边界条件。
常见错误包括先写循环再猜状态含义、初始化遗漏导致边界错误,以及状态设计过大造成不必要的内存消耗。
优化与调整
当完整 dp 数组只用于访问固定数量的历史状态时,可以使用滚动数组或变量压缩空间。若压缩后难以恢复路径,需要保留额外的决策信息。
设计错误时不要只修改转移公式,应重新检查状态定义,因为错误的状态通常会导致后续推导全部失效。
处理资源限制下的选择优化问题;适合 0-1 背包、完全背包和组合计数场景。
背包问题
背包问题用于解决“有限容量下如何选择物品”的优化问题。完成本类题目后,需要得到正确的状态定义、转移方式和遍历顺序,并根据物品是否可重复选择判断具体模型。
判断问题类型
先确认每个物品的使用规则:
- 0-1 背包:每件物品最多选择一次,常用于最大价值、最大收益问题。
- 完全背包:每件物品可以选择多次,常用于无限资源组合问题。
- 多重背包:每件物品有固定数量限制,需要额外处理数量约束。
如果题目要求统计方案数量、是否可达或最优价值,通常都可以转化为不同含义的动态规划状态。
设计状态与转移
一维状态常表示当前容量下的答案,例如 dp[j] 表示容量为 j 时能够获得的最大价值。
对于 0-1 背包,每加入一个物品时,需要从大容量向小容量更新,避免同一个物品在一次循环中被重复使用。
状态转移为:
其中 w 是物品重量,v 是物品价值。
实现 0-1 背包
下面示例计算容量限制为 5 时的最大价值:
def zero_one_knapsack(weights, values, capacity):
    # dp[j] 保存当前容量下的最大价值
    dp = [0] * (capacity + 1)

    for weight, value in zip(weights, values):
        # 倒序遍历保证当前物品不会被重复选择
        for j in range(capacity, weight - 1, -1):
            dp[j] = max(dp[j], dp[j - weight] + value)

    return dp[capacity]

result = zero_one_knapsack([2, 3, 4], [4, 5, 6], 5)
print(result)
预期结果:
9验证与排错
检查背包状态时重点关注三个位置:
- 状态是否覆盖题目要求,例如最大值、方案数或可达性是否使用了正确初始化。
- 遍历方向是否匹配选择规则,0-1 背包错误使用正序会导致重复选择。
- 边界容量是否处理,例如容量为 0 或物品重量超过容量的情况。
优化与恢复方法
如果一维压缩状态难以验证,可以先恢复二维状态 dp[i][j],明确“处理前 i 个物品、容量为 j”时的结果,再根据转移关系压缩空间。
速查时优先确认三个问题:物品能否重复、状态表示什么、容量遍历方向是什么。
解决序列中保持顺序的最优长度问题;适合最长递增子序列和公共子序列场景。
最长子序列
需要判断序列保持原顺序后的最大长度时,使用这类动态规划模板。完成后可以得到最长递增子序列(LIS)、最长公共子序列(LCS)等问题的最优长度或具体序列。
前置条件
- 已明确子序列不要求连续,只要求保持元素相对顺序。
- 已确定状态表示,例如
dp[i]表示以第i个元素结尾的最长长度。 - 若需要恢复路径,需要额外记录前驱位置。
操作步骤
- 定义状态:根据“当前位置的最优答案依赖哪些历史位置”建立状态。
- 推导转移:枚举可能接入当前元素的前序状态,选择最优值。
- 初始化边界:单个元素通常可以形成长度为 1 的子序列。
- 遍历所有状态,记录最终最大值或目标位置。
以最长递增子序列为例,状态转移为:当 nums[j] < nums[i] 时,dp[i] = max(dp[i], dp[j] + 1)。
def length_of_lis(nums):
    if not nums:
        return 0
    dp = [1] * len(nums)
    for i in range(len(nums)):
        for j in range(i):
            if nums[j] < nums[i]:
                dp[i] = max(dp[i], dp[j] + 1)
    return max(dp)

print(length_of_lis([10, 9, 2, 5, 3, 7, 101, 18]))
预期输出
4验证检查点
检查状态是否满足两个条件:当前答案只依赖已经计算完成的状态,并且每个合法选择都被枚举。如果结果偏小,优先检查转移条件是否遗漏等号或边界。
失败处理
- 如果题目要求连续子数组或连续子串,不应使用最长子序列模板,应改用滑动窗口或区间动态规划。
- 如果需要输出具体序列,增加前驱数组并从终点反向恢复。
恢复方式
发现状态定义错误时,保留原问题约束,重新从“最后一步如何得到答案”倒推状态含义,不要直接修改转移公式。
优化策略
通过局部最优选择构造全局答案;适合具有交换性或证明条件的问题。
贪心算法
贪心算法用于解决可以通过连续做出局部最优选择得到全局最优解的问题。完成判断后,可以设计选择规则、遍历候选项并直接构造最终答案。
判断是否适用
使用贪心前,需要确认问题具备以下条件:
- 存在明确的局部选择规则,例如最早结束、最小代价或最大收益。
- 当前选择不会破坏后续决策,满足贪心选择性质。
- 可以通过交换论证或其他证明方式说明该规则一定能得到最优解。
如果只能观察到样例符合规则,但无法证明选择正确,不应直接使用贪心。
设计选择策略
设计贪心解法时,先明确每一步要优化的目标,再确定候选项排序或筛选规则。常见策略包括:
- 优先选择结束时间最早的任务。
- 优先选择单位成本收益最高的资源。
- 优先处理限制最严格的候选项。
以区间调度为例,目标是选择最多数量的不重叠区间,因此每次保留结束时间最早的区间,为后续选择留下更多空间。
intervals = [(1, 3), (2, 4), (3, 5), (5, 7)]

# 按结束时间排序,保证每次选择后剩余空间最大
intervals.sort(key=lambda x: x[1])

count = 0
end = float('-inf')
for start, finish in intervals:
    if start >= end:
        count += 1
        end = finish

print(count)
预期输出
3验证正确性
验证贪心算法不能只看运行结果,需要检查选择规则是否覆盖所有情况。常用方法是交换论证:假设存在一个最优解,将其中第一个选择替换为当前贪心选择,证明替换后仍然保持最优。
如果无法完成证明,应重新分析问题是否需要动态规划、搜索或其他算法。
常见失败处理
- 局部最优选择会影响后续收益:重新定义状态,考虑动态规划。
- 排序规则改变后结果变化明显:检查选择条件是否真正对应最优目标。
- 存在多个相互影响的决策阶段:避免强行套用单次遍历模型。
贪心的核心不是“每一步选最好的”,而是证明“每一步的最好选择最终一定最好”。
利用二进制性质优化状态表示和计算;适合异或、掩码和快速判断类问题。
位运算技巧
使用位运算条目时,目标是快速完成二进制状态表示、集合压缩或特殊性质判断。完成后应能用整数保存状态,并验证运算结果符合题意。
前置条件
- 问题中的状态数量较小,适合使用二进制位表示。
- 已明确每一位代表的含义,例如第 位表示元素是否存在。
- 需要处理集合合并、去重、奇偶统计或快速判断等场景。
操作步骤
- 确定位与业务状态的映射关系,避免不同状态复用同一位。
- 根据需求选择运算方式:与运算判断状态,或运算合并状态,异或运算消除重复贡献。
- 使用掩码限制关注范围,完成后检查目标位是否符合预期。
mask = 0b1010
value = 0b1110

# 保留 mask 指定的位置
result = value & mask
print(bin(result))

# 异或用于相同值抵消
print(5 ^ 5)
预期结果:
0b1010
0
验证检查点
- 检查位编号是否从 0 开始并与实现一致。
- 检查移位操作是否可能产生越界或符号扩展问题。
- 对状态压缩问题,验证不同状态是否能唯一映射到不同整数。
失败处理
如果结果异常,优先检查位含义设计,而不是直接调整运算符。常见错误包括把异或当作普通加法、忽略负数补码表示,以及掩码范围设置错误。
恢复方式
当位压缩方案难以维护时,恢复为数组、集合等显式结构重新确认状态转移,再根据性能需求重新压缩。
维护动态最大值或最小值集合;适合 Top K、任务调度和流式数据选择问题。
堆优先队列
使用堆优先队列条目时,目标是维护动态集合中的最大值或最小值,并在数据变化时快速获取当前最优元素。完成后应能正确处理插入、删除和筛选流程。
前置条件
- 问题需要频繁获取最大值、最小值或第 K 个元素。
- 已确定排序需求,不需要每次操作都重新完整排序。
- 已选择最大堆或最小堆方向,并明确堆顶元素代表的含义。
操作步骤
- 根据目标选择堆类型:最小堆用于获取最小值,最大堆用于获取最大值。
- 数据到达时执行插入;超过容量限制时移除不需要的堆顶元素。
- 最终读取堆顶或堆内元素完成结果计算。
import heapq

nums = [5, 1, 9, 3]
heapq.heapify(nums)
smallest = heapq.heappop(nums)
print(smallest)
预期结果:
1验证检查点
- 检查堆顶是否符合当前任务要求,而不是误认为整个堆已经排序。
- Top K 问题中确认保留的是 K 个目标元素,而不是 K 个相反方向元素。
- 流式场景中确认每次更新后堆大小受控。
失败处理
如果结果错误,先检查堆方向是否选反。例如求最大的 K 个元素通常维护小根堆保存候选值,而不是直接使用大根堆全部排序。
恢复方式
当堆维护逻辑复杂或边界难以确认时,可先改用完整排序验证结果,再恢复为堆实现并对比时间复杂度。