
NoSQL 与搜索 / 知识点
向量数据库操作速查手册
手册条目
备份集合数据、字段定义和索引配置,降低误删除与故障风险。
备份向量数据
以下以自建 Milvus 和 milvus-backup 为例。适合在删除集合、升级集群或迁移前,将集合原始数据、字段与分区元数据、索引定义备份到独立对象存储;实际索引文件不会进入备份,恢复时需要重建。
命令定位
先准备与当前部署匹配的 backup.yaml。其中源 Milvus 地址、认证信息、源存储桶及 rootPath 必须与线上实例一致,备份存储应使用独立桶或独立前缀。先执行 check,连接检查失败时不要继续创建备份。
基本语法
milvus-backup --config <PATH>/backup.yaml check
milvus-backup --config <PATH>/backup.yaml create -n <BACKUP_NAME> --filter '<DATABASE>.<COLLECTION>'
milvus-backup --config <PATH>/backup.yaml list
--filter 可指定单个集合、逗号分隔的多个集合,或用带引号的 <DATABASE>.* 选择某数据库全部集合。省略过滤条件通常会备份配置可见范围内的全部集合。
高频用法
下面脚本先检查连接,再为 default.products 创建带时间戳的备份,并确认备份名已出现在列表中。执行目录需能访问 milvus-backup 和 backup.yaml。
set -euo pipefail

CONFIG="./backup.yaml"
COLLECTION="default.products"
BACKUP_NAME="products-$(date +%Y%m%d-%H%M%S)"

# check 同时验证 Milvus、源存储和备份存储,失败即终止。
milvus-backup --config "$CONFIG" check
milvus-backup --config "$CONFIG" create \
  -n "$BACKUP_NAME" \
  --filter "$COLLECTION"

# create 成功不等于已被后续流程发现,再用 list 做一次独立确认。
milvus-backup --config "$CONFIG" list | grep -Fq "$BACKUP_NAME"
printf 'BACKUP_OK name=%s collection=%s\n' "$BACKUP_NAME" "$COLLECTION"
预期输出
BACKUP_OK name=products-<TIME> collection=default.products<TIME> 为实际执行时间。看到该末行表示命令成功且备份可被列出;随后还应在对象存储的备份前缀中确认元数据文件和数据对象实际存在。
风险与边界
备份期间继续写入可能使业务侧“同一批数据”跨越备份边界。触发条件是有并发写入、删除或结构变更;后果是恢复后记录状态与业务事务点不完全一致。严格一致场景应短暂停写,或使用快照、CDC 等具备明确时间点语义的方案。
milvus-backup 保存原始数据与索引元数据,但不保存已构建的索引文件。若误以为恢复后可立即加载检索,可能遇到无索引或长时间重建。安全做法是记录索引参数,并在恢复时使用索引重建选项或显式创建索引。
不要把对象存储密钥提交到代码仓库。凭据泄露会导致备份数据被读取或删除;生产环境应使用环境变量、IAM 身份或密钥管理服务,并为备份桶配置版本控制、保留策略和最小权限。
排障清单
check报源路径为空或找不到段文件:核对源存储的地址、桶名和rootPath,注意空字符串、files与/files不是同一路径。list找不到刚创建的名称:确认创建与查询使用同一份配置、同一备份桶和同一前缀。- 备份大小异常小:检查目标集合是否有已落盘数据、过滤条件是否匹配正确数据库与集合,并查看日志中是否出现缺少 insert log。
- 备份完成后立即做一次隔离恢复演练;只有能恢复并通过数量、结构和检索校验的备份才可视为有效。
兼容性
恢复前按当前 milvus-backup 发布说明核对兼容矩阵,优先使用最新稳定版工具,并只向相同或更高版本的 Milvus 恢复。其他向量数据库应改用其官方快照或导出接口,不要直接套用本条命令。
将备份恢复到目标环境,并验证记录数量、字段结构和检索结果。
恢复备份数据
以下以自建 Milvus 和 milvus-backup 为例。恢复时先写入带后缀的新集合,再核对记录数、字段结构和一次真实向量检索;验证通过后再切换业务别名或连接配置,避免直接覆盖生产集合。
前置条件
目标环境的 backup.yaml 必须同时指向目标 Milvus 的实际数据存储和备份所在位置。目标实例应能读取恢复后的数据对象,且 Milvus 版本、字段类型与索引参数满足兼容要求。
基本语法
milvus-backup --config <PATH>/backup.yaml check
milvus-backup --config <PATH>/backup.yaml restore \
  -n <BACKUP_NAME> \
  --suffix <SUFFIX> \
  --rebuild_index
--suffix 将原集合恢复为新名称,例如 products 恢复为 products_restore。--rebuild_index 使用备份中的索引元数据重新构建索引;大集合会明显延长恢复时间并消耗 CPU、内存和对象存储带宽。
高频用法
先恢复到隔离集合,禁止一开始就删除同名生产集合。下面命令在恢复完整结束后输出确认行。
set -euo pipefail

CONFIG="./backup.yaml"
BACKUP_NAME="${BACKUP_NAME:?请先设置 BACKUP_NAME}"
SUFFIX="_restore"

# 先验证目标 Milvus、目标数据桶与备份桶均可访问。
milvus-backup --config "$CONFIG" check
milvus-backup --config "$CONFIG" restore \
  -n "$BACKUP_NAME" \
  --suffix "$SUFFIX" \
  --rebuild_index

printf 'RESTORE_OK backup=%s suffix=%s\n' "$BACKUP_NAME" "$SUFFIX"
预期输出
RESTORE_OK backup=<BACKUP_NAME> suffix=_restore该末行只代表恢复命令正常结束,不能替代数据校验。接着安装 pymilvus,设置目标集合、源集合记录数、向量字段和一条合法查询向量,再执行以下脚本。
import json
import os
from pymilvus import MilvusClient

uri = os.environ.get("MILVUS_URI", "http://localhost:19530")
token = os.environ.get("MILVUS_TOKEN", "root:Milvus")
collection = os.environ["COLLECTION"]
vector_field = os.environ["VECTOR_FIELD"]
expected_rows = int(os.environ["EXPECTED_ROWS"])
query_vector = json.loads(os.environ["QUERY_VECTOR_JSON"])

client = MilvusClient(uri=uri, token=token)
description = client.describe_collection(collection_name=collection)
stats = client.get_collection_stats(collection_name=collection)
actual_rows = int(stats["row_count"])
field_names = [field["name"] for field in description["fields"]]

# 数量必须与备份前基线一致;索引重建完成后再加载和检索。
assert actual_rows == expected_rows, (expected_rows, actual_rows)
assert vector_field in field_names, (vector_field, field_names)

client.load_collection(collection_name=collection)
hits = client.search(
    collection_name=collection,
    anns_field=vector_field,
    data=[query_vector],
    limit=3,
)
assert hits and hits[0], "检索没有返回结果"

top1_id = hits[0][0]["id"]
print(
    f"RESTORE_VERIFY_OK collection={collection} "
    f"rows={actual_rows} fields={len(field_names)} top1_id={top1_id}"
)
预期输出
RESTORE_VERIFY_OK collection=products_restore rows=<COUNT> fields=<COUNT> top1_id=<ID>实际数量、字段数和 ID 会不同。除了脚本断言,还应将 describe_collection 的字段名、类型、主键、向量维度与备份前清单逐项比对,并用业务固定查询集比较 Top-K ID、距离排序和过滤结果。
风险与边界
直接恢复为原集合名时,若同名集合仍存在,可能失败;若先删除原集合,恢复失败又会造成服务中断。安全替代方案是恢复到带后缀集合,验证通过后通过别名或受控发布切换流量,并保留原集合用于快速回滚。
恢复和索引重建会竞争计算、内存及对象存储带宽。触发条件是大集合、并行恢复或业务高峰;后果是查询延迟升高、导入任务超时。应在低峰执行、限制并发,并监控导入进度、节点内存和对象存储吞吐。
记录数一致不代表恢复正确。字段默认值、动态字段、分区、索引度量或应用查询参数不一致,仍可能导致召回结果变化。安全做法是同时校验结构、固定查询集和业务过滤条件,而不是只比较 row_count。
排障清单
- 报
not found:确认备份名、备份桶和备份前缀完全一致,并先用list验证目标配置能看到备份。 - 报
no binlog to import:目标milvus.storage.bucketName或rootPath与实际部署不一致,目标 Milvus 无法读取已复制数据。 - 集合存在但无法加载:通常是索引未重建或重建失败;检查恢复日志和索引状态,再补建索引。
- 数量不一致:确认备份前基线取值时间、是否存在并发写入,以及恢复是否包含了预期数据库和集合。
- 检索结果异常:核对向量字段、维度、度量类型、索引参数、查询向量生成模型和过滤表达式。
兼容性
优先恢复到与源端相同或更高版本的 Milvus,并使用与目标版本匹配的最新稳定版 milvus-backup。跨存储、跨账号或跨区域恢复前,先验证目标服务对备份对象拥有读取、写入和列举权限。
在不同实例或产品之间迁移向量、元数据和索引配置。
迁移集合数据
用于把向量、业务字段和索引配置从源实例迁到目标实例,并在切流前确认记录数、向量维度和文件校验和一致。跨产品迁移时优先使用 JSONL、Parquet 等中间格式,不直接复制底层存储文件。
迁移路径
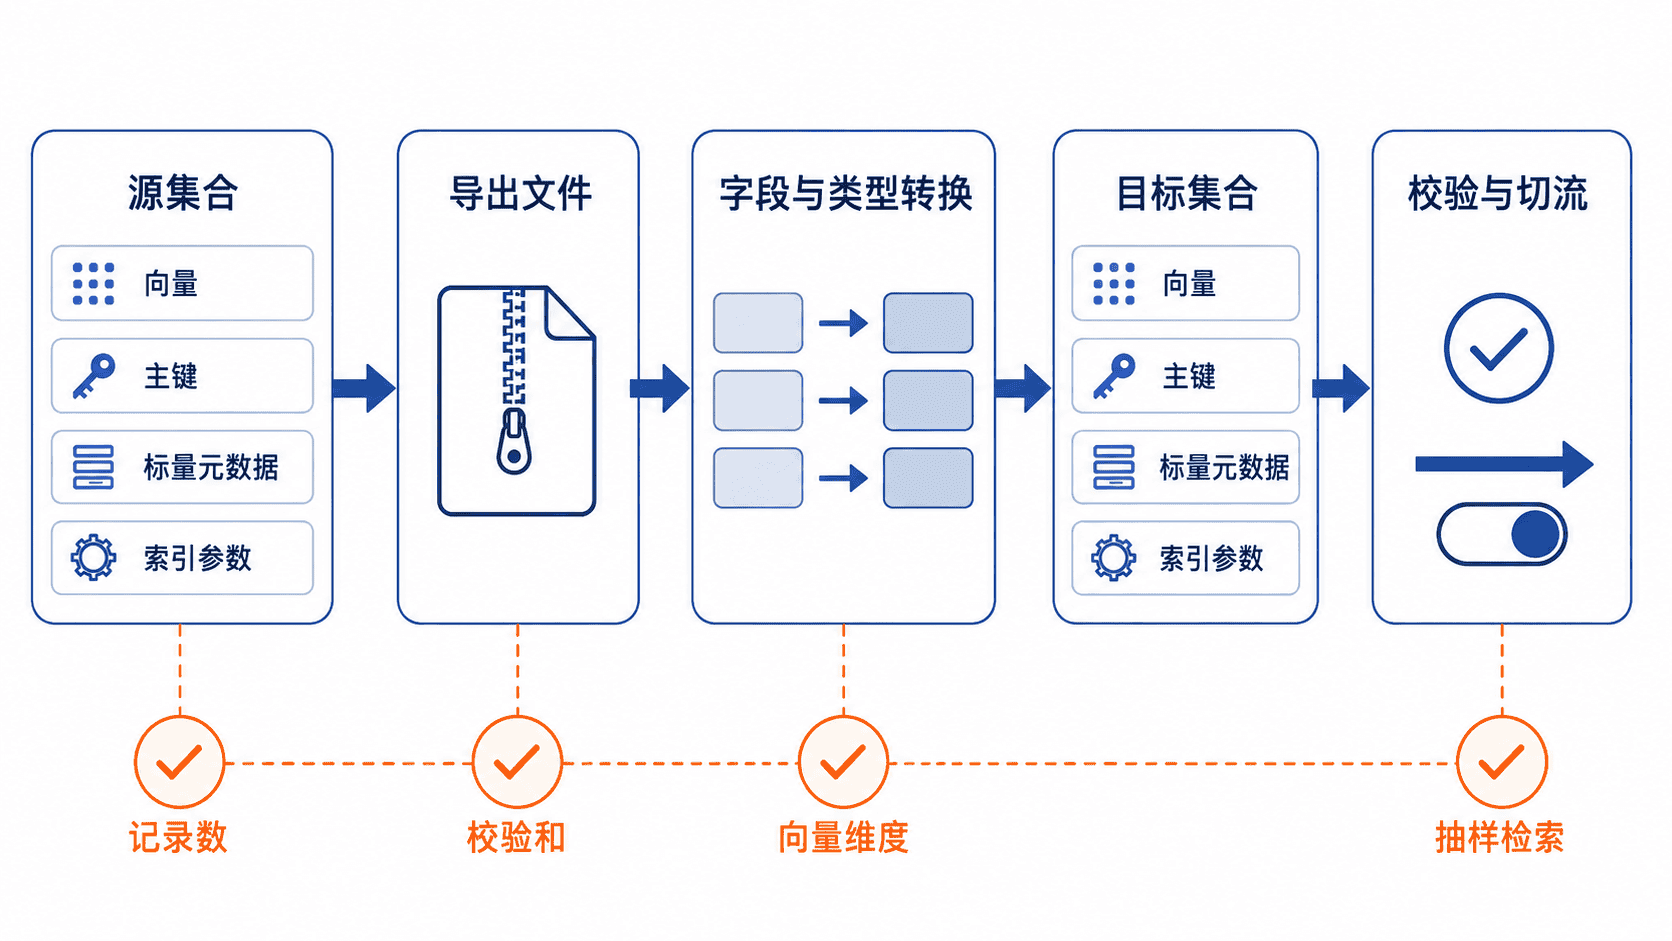
同产品同版本可优先使用官方快照或备份恢复;跨版本或跨产品应导出逻辑数据,重新建集合并重建索引。迁移期间选择停写、短暂停机或双写,避免导出完成后源端仍产生未同步数据。
迁移前校验
约定导出目录包含 manifest.json 和 data.jsonl。清单至少记录 recordCount、vectorDimension、metricType、primaryKey、dataSha256;每行数据包含主键、向量和业务字段。
下面脚本检查记录数、向量维度与 SHA-256,可在导入前后分别执行。Linux 需要 jq、sha256sum;macOS 将 sha256sum 替换为 shasum -a 256。
set -euo pipefail

export_dir="${1:-./vector-export}"
manifest="$export_dir/manifest.json"
data="$export_dir/data.jsonl"

test -f "$manifest"
test -f "$data"

expected_count="$(jq -r '.recordCount' "$manifest")"
expected_dim="$(jq -r '.vectorDimension' "$manifest")"
actual_count="$(wc -l < "$data" | tr -d ' ')"
bad_dim_count="$(
  jq -c --argjson dim "$expected_dim" \
    'select((.vector | length) != $dim)' "$data" |
  wc -l | tr -d ' '
)"
actual_sha="$(sha256sum "$data" | awk '{print $1}')"

printf 'records=%s expected=%s\n' "$actual_count" "$expected_count"
printf 'bad_vector_dimension=%s\n' "$bad_dim_count"
printf 'sha256=%s\n' "$actual_sha"

test "$actual_count" = "$expected_count"
test "$bad_dim_count" = "0"
jq -e --arg sha "$actual_sha" '.dataSha256 == $sha' "$manifest" >/dev/null

echo "validation=PASS"
预期输出
records=100000 expected=100000
bad_vector_dimension=0
sha256=<ID>
validation=PASS
records 必须与清单一致,bad_vector_dimension 必须为 0。sha256 的实际值会不同;最后出现 validation=PASS 才能继续导入或切流。
高频用法
同实例迁移优先用快照恢复,恢复后重建或检查索引状态。跨实例同产品迁移时,先在目标端创建相同字段类型和维度,再批量导入数据。跨产品迁移时,显式转换主键类型、数组或 JSON 字段,并把距离度量、归一化方式和索引参数记录在清单中。
导入完成后至少做四项核对:记录总数、随机主键回查、向量维度、固定查询集的 Top-K 结果。索引文件通常不可跨产品复用,应在目标端重新构建并等待可查询状态。
风险与边界
源端未停写且没有双写或增量补偿时,会遗漏导出后的新增和更新,导致切流后数据不完整。安全做法是记录导出水位,补传水位后的变更,再冻结写入完成最终追平。
直接复制底层数据目录可能因版本、存储格式或分片布局不同而损坏集合。只有官方文档明确支持的同版本恢复流程才能这样做;其他场景使用逻辑导出。
只比较记录数无法发现字段错位、向量被截断或距离度量变化。切流前保留源端只读窗口,并准备将读流量切回源端的回滚开关。
排障清单
导入数量不足时,先检查失败批次、重复主键和单批大小限制。检索结果明显变化时,核对向量是否归一化、距离度量是否一致、索引是否已完成。目标端延迟或内存突增时,降低导入并发并在数据导入完成后再集中建索引。
速查原则:先迁数据与字段,再重建索引;先完成可重复校验,再切换生产流量。
使用独立集合、分区或租户字段防止不同业务之间的数据串查。
隔离租户数据
用于防止不同租户在检索、查询、删除和更新时发生串查。隔离方案应同时约束数据存放位置、访问凭证和查询条件,不能只依赖调用方自觉传入 tenant_id。
选择隔离级别
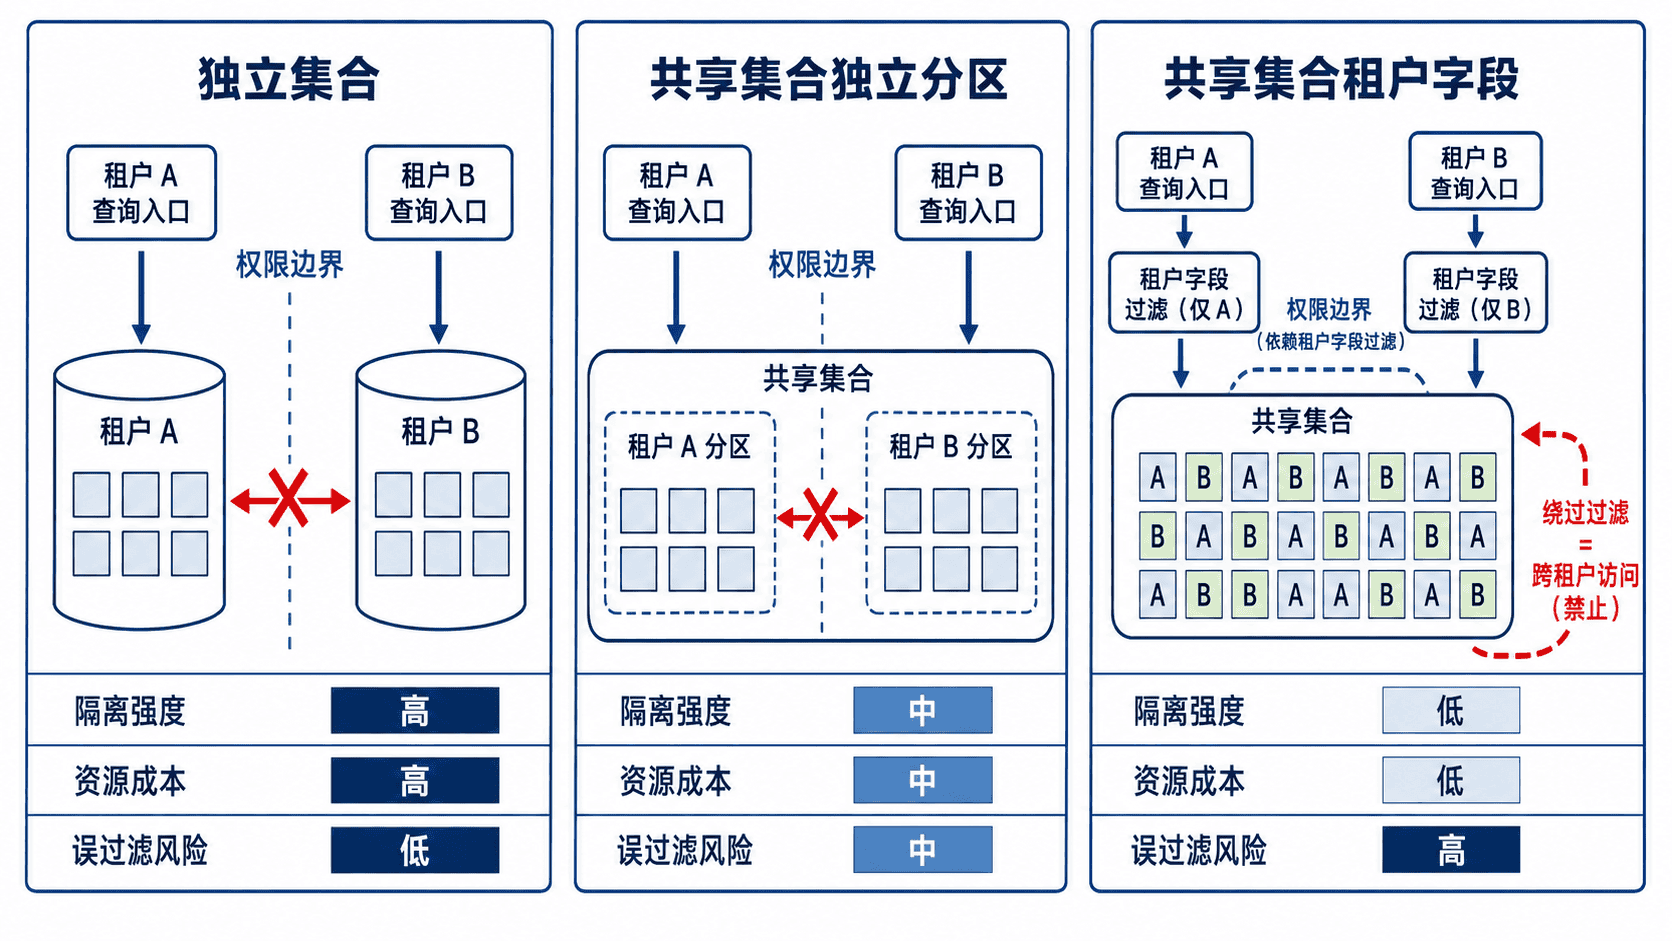
| 方案 | 隔离强度 | 适用场景 | 主要代价 |
|---|---|---|---|
| 独立集合或独立实例 | 高 | 强合规、大客户、独立备份与配额 | 集合数量和运维成本高 |
| 共享集合、独立分区 | 中 | 租户较多且数据库支持分区路由 | 分区权限未必等于安全边界 |
| 共享集合、租户字段 | 取决于应用约束 | 海量小租户、需要统一索引 | 漏加过滤条件会直接串查 |
需要强隔离时优先独立实例或集合,并为每个租户配置独立凭证和资源配额。共享集合模式必须把 tenant_id 设为必填字段,并在服务端统一注入过滤条件。
服务端强制过滤
下面示例生成安全的租户过滤表达式。调用方不能覆盖 tenant_id,租户标识和可过滤字段都经过白名单校验,避免遗漏条件或表达式注入。
import re
from typing import Mapping

SAFE_TOKEN = re.compile(r"^[A-Za-z0-9_-]{1,64}$")
ALLOWED_FIELDS = {"status", "category"}

def build_filter(tenant_id: str, extra: Mapping[str, str] | None = None) -> str:
    if not SAFE_TOKEN.fullmatch(tenant_id):
        raise ValueError("invalid tenant_id")

    clauses = [f'tenant_id == "{tenant_id}"']
    for field, value in (extra or {}).items():
        if field == "tenant_id":
            raise ValueError("tenant_id cannot be overridden")
        if field not in ALLOWED_FIELDS:
            raise ValueError(f"field not allowed: {field}")
        if not SAFE_TOKEN.fullmatch(value):
            raise ValueError(f"invalid value for {field}")
        clauses.append(f'{field} == "{value}"')

    return " and ".join(clauses)

if __name__ == "__main__":
    print(build_filter("tenant-a", {"status": "active"}))
    try:
        print(build_filter("tenant-a", {"tenant_id": "tenant-b"}))
    except ValueError as exc:
        print(f"blocked={exc}")
预期输出
tenant_id == "tenant-a" and status == "active"
blocked=tenant_id cannot be overridden
把返回表达式传给数据库的检索、标量查询、删除和更新接口。租户身份必须来自已验证的令牌或会话,不得直接信任请求体中的 tenant_id。
写入与主键约束
共享集合写入时,服务端应覆盖客户端提交的租户字段,并在审计日志中记录认证租户、目标集合和操作类型。若数据库只支持全局唯一主键,可使用 <TENANT_ID>:<BUSINESS_ID> 作为复合主键,或由服务端生成全局 ID,避免不同租户使用相同业务 ID 时互相覆盖。
删除和批量更新比查询更危险:必须同时包含租户条件,并限制最大影响条数。独立集合模式也要验证集合名来自租户映射表,禁止把用户输入直接拼成集合名。
风险与边界
共享集合漏加一次过滤条件就可能暴露其他租户数据,后果包括越权读取、误删和合规事件。安全替代方案是封装唯一的数据访问层,禁止业务代码直接调用底层客户端,并用自动化测试验证所有操作都带租户条件。
分区只能减少扫描范围时,不能视为权限系统;攻击者若能指定其他分区仍可能串查。应结合服务端分区映射、独立凭证或集合级权限。
把租户字段加入过滤条件会影响召回延迟和索引选择。租户数量大且单租户数据很少时,应测试过滤下推能力;若性能不稳定,可把大租户迁到独立集合。
排障清单
发现串查时立即停止相关读写接口,保存请求日志和查询条件,确认受影响租户范围。随后检查认证上下文、过滤器注入、缓存键、批处理任务和删除接口是否都包含租户维度。
验证隔离时至少覆盖四类测试:租户 A 查询不到租户 B 主键;相同业务 ID 不互相覆盖;缓存键包含租户;批量删除只影响当前租户。速查原则:租户身份由服务端决定,过滤条件由统一数据层注入,权限边界不能只靠分区名称。
按照最小权限原则限制集合读取、写入、删除和管理操作。
配置访问权限
用于把检索、写入、删除和管理能力拆给不同身份。最终应做到:查询服务只能读,导入任务只能写,删除任务单独授权,日常应用不持有管理员权限。
最小权限模型
建议至少拆分四类身份:
| 身份 | 允许操作 | 明确禁止 |
|---|---|---|
query-service |
列出集合、读取、向量检索 | 写入、删除、建索引、用户管理 |
ingest-job |
读取、插入、幂等更新 | 删除集合、权限管理 |
cleanup-job |
按过滤条件删除记录 | 建库、改结构、用户管理 |
platform-admin |
集合、索引和账号管理 | 供业务程序长期使用 |
数据库支持原生 RBAC 或云 IAM 时,应在数据库侧创建角色并绑定独立服务账号;应用代码中的权限判断只能用于提前报错,不能代替数据库强制授权。
可执行权限检查
下面的脚本可在发布前检查预期权限矩阵,直接复制运行:
python3 - <<'PY'
roles = {
    "reader": {"collection.read", "collection.list"},
    "writer": {"collection.read", "collection.list", "vector.insert", "vector.upsert"},
    "cleanup": {"collection.read", "vector.delete"},
    "admin": {"collection.manage", "index.manage", "user.manage"},
}
bindings = {
    "query-service": "reader",
    "ingest-job": "writer",
    "cleanup-job": "cleanup",
    "platform-admin": "admin",
}
checks = [
    ("query-service", "collection.read"),
    ("query-service", "vector.delete"),
    ("ingest-job", "vector.upsert"),
    ("cleanup-job", "vector.delete"),
    ("platform-admin", "user.manage"),
]
for principal, action in checks:
    role = bindings.get(principal)
    allowed = action in roles.get(role, set())
    print(f"{principal:14} {action:20} {'ALLOW' if allowed else 'DENY'}")
PY
预期输出:
query-service  collection.read      ALLOW
query-service  vector.delete        DENY
ingest-job     vector.upsert        ALLOW
cleanup-job    vector.delete        ALLOW
platform-admin user.manage          ALLOW
重点读取第二行:查询服务执行删除必须是 DENY。上线时把动作名替换为目标产品实际支持的权限项,再用低权限账号做真实读写验证。
落地要点
每个服务使用独立账号或短期令牌,凭据存入密钥管理服务,不写入镜像、配置仓库或日志。默认拒绝未声明操作;生产、测试和开发环境使用不同账号,并把集合或命名空间范围限制到业务实际需要。
删除权限不要并入普通写入角色。需要批量清理时,使用单独任务账号、固定过滤条件、最大删除量和审计日志;高风险操作再增加人工审批或双人复核。
风险与边界
业务账号获得通配符或管理员权限时,一旦凭据泄露,攻击者可能删除集合、重建索引或读取其他租户数据。安全替代方案是按服务拆账号、限定集合范围,并让管理操作只通过受控运维入口执行。
只在应用层校验权限、数据库仍使用共享高权限账号时,调用者可绕过检查直接访问数据库。必须把最终授权落实到数据库原生 RBAC、云 IAM 或网关策略。
排障清单
- 返回未认证错误:检查令牌是否过期、密钥是否挂载、连接端点是否匹配环境。
- 返回无权限错误:核对账号绑定角色、集合范围、租户或数据库名称,以及拒绝规则是否优先生效。
- 修改权限后仍失败:重新获取令牌,等待权限缓存刷新,并查看审计日志中的主体、资源和动作。
- 误删风险验证:确认查询账号删除操作失败,清理账号不能管理集合或用户。
不同向量数据库的角色名和动作名不一致,但都应保持“身份分离、默认拒绝、资源限域、删除单独授权”四条原则。
在写入向量数据库前识别、脱敏或排除隐私信息和敏感业务内容。
保护敏感数据
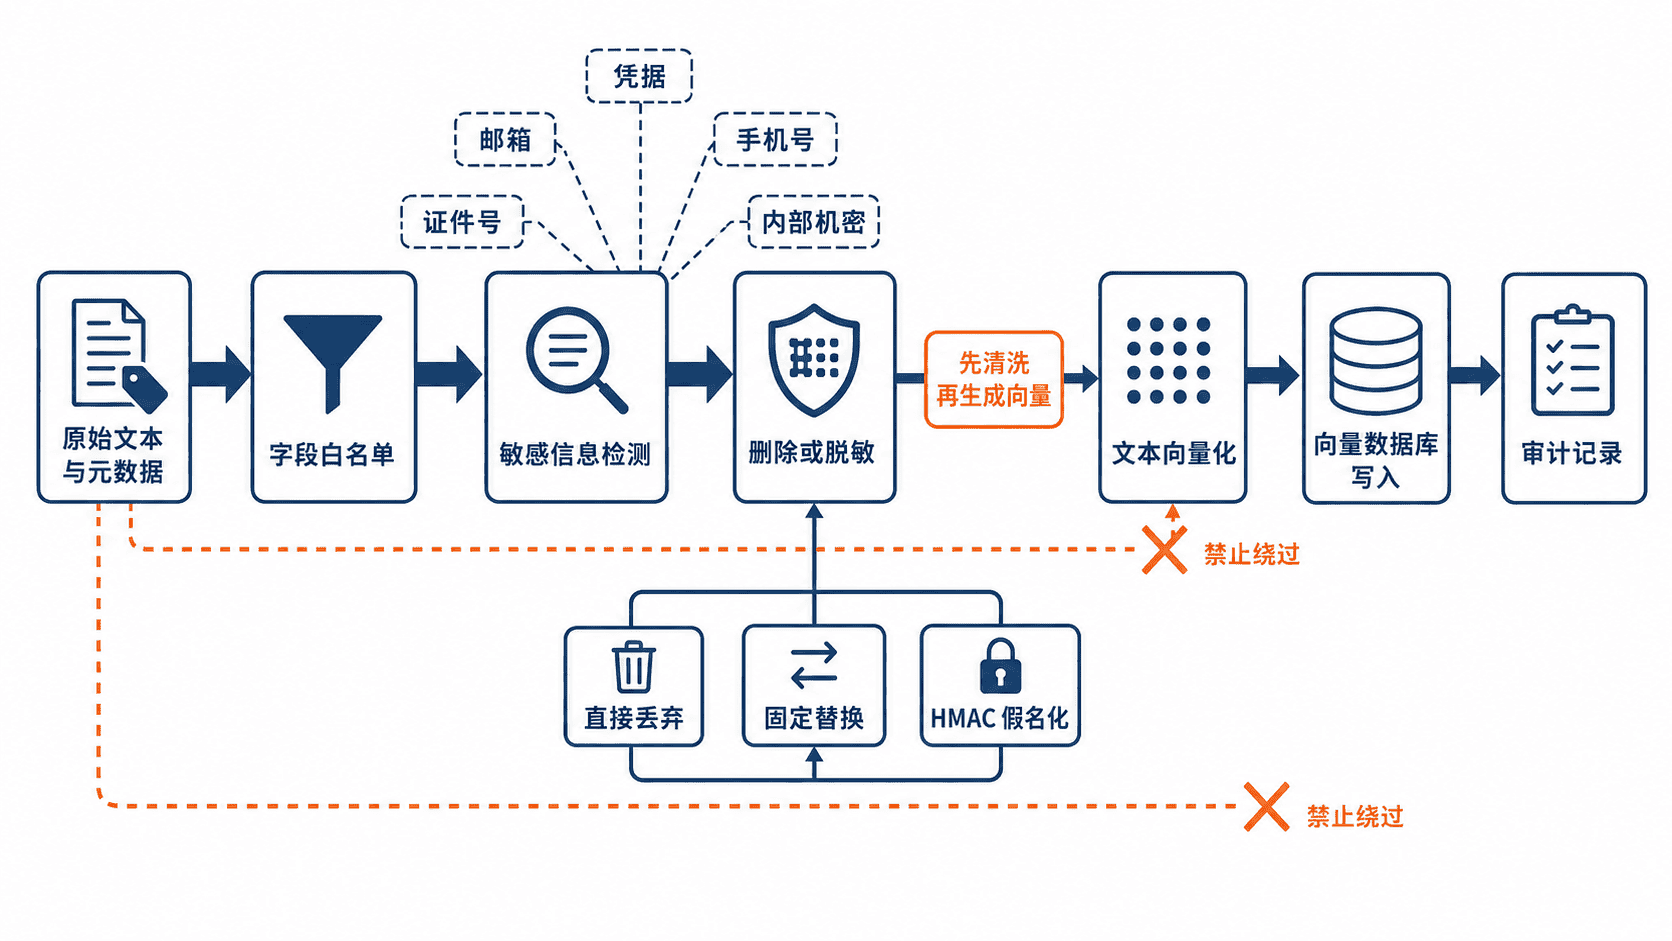
用于在文本、元数据或向量进入数据库前识别并处理隐私信息、凭据和敏感业务内容。最终结果应是:原始敏感值不落库,向量化输入已清洗,写入记录可审计并可按主体删除。
写入前规则
优先采用字段白名单,只允许业务检索真正需要的字段进入写入请求。密码、访问令牌、私钥、支付凭据和完整证件号应直接排除;邮箱、手机号、客户编号等确需关联的数据,使用固定替换或带密钥的假名化。
脱敏必须发生在生成向量之前。仅删除元数据、却把原始敏感文本送入嵌入模型,仍可能让向量、模型日志或缓存保留敏感信息。
可执行脱敏示例
保存为 sanitize.py。示例覆盖敏感字段、邮箱、手机号、令牌样式和用户编号假名化:
import hashlib
import hmac
import json
import os
import re
from typing import Any

DROP_KEYS = {"password", "secret", "token", "api_key", "access_key", "private_key", "card_number", "id_number"}
PSEUDONYM_KEYS = {"user_id", "customer_id"}
EMAIL_RE = re.compile(r"\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}\b")
PHONE_RE = re.compile(r"(?<!\d)1[3-9]\d{9}(?!\d)")
TOKEN_RE = re.compile(r"(?i)\b(?:sk|api)[-_][A-Za-z0-9]{8,}\b")

def pseudonymize(value: str, key: bytes) -> str:
    digest = hmac.new(key, value.encode("utf-8"), hashlib.sha256).hexdigest()
    return f"user_{digest[:16]}"

def sanitize(value: Any, key: bytes) -> Any:
    if isinstance(value, dict):
        cleaned = {}
        for field, item in value.items():
            normalized = field.lower()
            if normalized in DROP_KEYS:
                cleaned[field] = "<REDACTED>"
            elif normalized in PSEUDONYM_KEYS:
                cleaned[field] = pseudonymize(str(item), key)
            else:
                cleaned[field] = sanitize(item, key)
        return cleaned
    if isinstance(value, list):
        return [sanitize(item, key) for item in value]
    if isinstance(value, str):
        value = EMAIL_RE.sub("<EMAIL>", value)
        value = PHONE_RE.sub("<PHONE>", value)
        return TOKEN_RE.sub("<TOKEN>", value)
    return value

if __name__ == "__main__":
    key = os.environ["TOKENIZATION_KEY"].encode("utf-8")
    record = {
        "user_id": "u-1001",
        "email": "alice@example.com",
        "phone": "13800138000",
        "password": "not-for-storage",
        "text": "联系 alice@example.com,临时令牌 sk-live12345678",
        "vector": [0.12, -0.03],
    }
    print(json.dumps(sanitize(record, key), ensure_ascii=False, indent=2))
执行:
TOKENIZATION_KEY='demo-only-key' python3 sanitize.py预期输出:
{
  "user_id": "user_69c69caa3fc48cfa",
  "email": "<EMAIL>",
  "phone": "<PHONE>",
  "password": "<REDACTED>",
  "text": "联系 <EMAIL>,临时令牌 <TOKEN>",
  "vector": [
    0.12,
    -0.03
  ]
}
生产环境不要使用示例密钥;应从密钥管理服务注入高强度密钥,并限制读取权限。输出中的 vector 仅用于演示字段保留,真实流程应对清洗后的文本重新生成向量。
验证与审计
在写入客户端或网关增加拒绝规则:命中高风险字段时直接阻止写入,而不是静默放行。记录检测规则版本、处理动作、数据主体标识和请求追踪 ID,但审计日志本身不得保存原始敏感值。
抽样检查写入后的文本、元数据和模型调用日志;删除请求应同时覆盖原始记录、向量、缓存、派生索引和受保留策略约束的备份。
风险与边界
只依赖正则表达式会漏掉变形凭据、地址、自由文本中的机密内容,也可能误删正常数据。安全替代方案是“字段白名单 + 规则检测 + DLP/分类模型 + 人工复核”分层处理,并为高风险字段采用阻断策略。
直接使用普通哈希处理手机号或短编号时,可被字典枚举还原。应使用 HMAC 或受控令牌化;需要可逆恢复时使用专用加密服务,并将密钥与向量数据库分离。
向量不是匿名数据。敏感文本生成的嵌入仍可能泄露主题或被关联分析,因此高敏数据应在向量化前排除,或进入独立租户、独立密钥和更严格保留期的隔离存储。
排障清单
- 写入仍出现明文:确认脱敏函数位于嵌入调用之前,且批量、重试和离线导入走同一处理链。
- 检索效果突然下降:检查是否误删关键业务词,优先调整字段白名单和替换策略,不要关闭全部检测。
- 假名不稳定:核对各实例使用的密钥版本和编码方式;轮换密钥时保留版本号并规划重算。
- 删除后仍可检索:检查缓存、索引刷新、备份保留和异步删除任务是否完成。
为批量删除、集合删除和清空操作增加范围校验、审计与恢复措施。
控制删除风险
用于批量删除、按条件删除、清空集合等高风险操作。核心做法是把“范围、变更单、备份、确认令牌、审计”变成执行前的硬校验,任何一项不满足就拒绝执行。
基本语法
下面的通用包装脚本不依赖具体向量数据库。把厂商 CLI、HTTP 请求或维护脚本放在 -- 后;默认只做预演,只有同时设置 EXECUTE=yes 和正确确认令牌才会真正调用删除命令。
cat > safe-delete.sh <<'BASH'
#!/usr/bin/env bash
set -euo pipefail

: "${DELETE_SCOPE:?缺少 DELETE_SCOPE}"
: "${EXPECTED_SCOPE:?缺少 EXPECTED_SCOPE}"
: "${CHANGE_TICKET:?缺少 CHANGE_TICKET}"
: "${BACKUP_MARKER:?缺少 BACKUP_MARKER}"

# 声明范围必须与审批范围完全一致,并拒绝常见的全量值。
[[ "$DELETE_SCOPE" == "$EXPECTED_SCOPE" ]] || {
  echo "REFUSED scope_mismatch actual=$DELETE_SCOPE expected=$EXPECTED_SCOPE" >&2
  exit 20
}
[[ "$DELETE_SCOPE" != "*" && "$DELETE_SCOPE" != "all" ]] || {
  echo "REFUSED broad_scope=$DELETE_SCOPE" >&2
  exit 21
}
[[ -s "$BACKUP_MARKER" ]] || {
  echo "REFUSED backup_marker_missing=$BACKUP_MARKER" >&2
  exit 22
}
[[ "$CHANGE_TICKET" =~ ^CHG-[0-9]+$ ]] || {
  echo "REFUSED invalid_ticket=$CHANGE_TICKET" >&2
  exit 23
}
[[ "${1:-}" == "--" && $# -ge 2 ]] || {
  echo "usage: safe-delete.sh -- <delete-command> [args...]" >&2
  exit 24
}

# 先把最终命令写入审计日志;默认仅预演,不触发删除。
cmd=("${@:2}")
printf 'AUDIT ticket=%s scope=%s mode=%s command=' "$CHANGE_TICKET" "$DELETE_SCOPE" "${EXECUTE:-no}"
printf '%q' "${cmd[0]}"
for arg in "${cmd[@]:1}"; do
  printf ' %q' "$arg"
done
printf '\n'

if [[ "${EXECUTE:-no}" != "yes" ]]; then
  echo "DRY-RUN no deletion executed"
  exit 0
fi

# 真正执行时要求与删除范围绑定的二次确认令牌。
expected_token="DELETE:${DELETE_SCOPE}"
[[ "${CONFIRM_TOKEN:-}" == "$expected_token" ]] || {
  echo "REFUSED invalid_confirm_token" >&2
  exit 25
}

"${cmd[@]}"
echo "DONE deletion command completed"
BASH

chmod +x safe-delete.sh
printf '{"backup":"verified","scope":"tenant=acme"}\n' > backup.marker

DELETE_SCOPE='tenant=acme' EXPECTED_SCOPE='tenant=acme' CHANGE_TICKET='CHG-2048' BACKUP_MARKER='./backup.marker' ./safe-delete.sh -- printf 'deleted=%s\n' '120'
预期输出:
AUDIT ticket=CHG-2048 scope=tenant=acme mode=no command=printf deleted=%s\\n 120
DRY-RUN no deletion executed
确认范围和审计记录无误后,再用同一命令执行:
EXECUTE=yes CONFIRM_TOKEN='DELETE:tenant=acme' DELETE_SCOPE='tenant=acme' EXPECTED_SCOPE='tenant=acme' CHANGE_TICKET='CHG-2048' BACKUP_MARKER='./backup.marker' ./safe-delete.sh -- printf 'deleted=%s\n' '120'预期输出:
AUDIT ticket=CHG-2048 scope=tenant=acme mode=yes command=printf deleted=%s\\n 120
deleted=120
DONE deletion command completed
高频用法
批量删除前先运行预演,核对最终过滤条件、预计命中数和租户或分区范围。生产执行时应把实际删除命令替换到 -- 后,并将审计输出写入集中日志。
清空集合时不要把 *、all、空字符串或缺省条件当成合法范围。必须使用集合名、分区名或租户标识等可复核的精确范围。
定时清理任务应增加“最大允许删除量”。先统计候选数量,超过阈值立即退出;不要在删除后才根据受影响数量判断是否误删。
风险与边界
范围变量与实际删除命令中的过滤条件可能不一致,脚本只能证明“声明的范围”通过校验,不能自动理解厂商命令。安全替代方案是从同一份只读查询结果生成删除条件,并由第二人复核。
备份文件存在不等于可恢复。只有备份任务成功、校验值有效,并完成过抽样恢复验证,才能把标记文件写成可用状态。
批量删除可能产生延迟回收、索引重建或查询结果短暂不一致。业务仍在写入时应先停写或切换流量,再删除;否则可能出现旧数据重入或删除范围持续变化。
排障清单
- 出现
scope_mismatch:比较实际范围与审批范围,不要修改EXPECTED_SCOPE来绕过校验。 - 出现
backup_marker_missing:确认备份任务成功且标记文件非空;禁止临时touch空文件放行。 - 删除量异常:立即停止后续批次,保留审计日志,按备份或快照恢复。
- 命令成功但数据仍可查:检查数据库的一致性级别、延迟回收、缓存和索引刷新状态。
速查提示:先预演、再复核、最后执行;任何“为了赶时间而跳过备份或范围校验”的情况都应视为拒绝条件。
在确认依赖、完成备份并核对目标名称后删除不再使用的集合。
安全删除集合
用于删除已废弃的向量集合。执行前必须确认没有读写依赖、备份可恢复、目标名称完全匹配,并保留一次可审计的预演结果。
前置条件
准备一个非空备份标记文件和依赖确认文件。依赖文件只允许写 none;若仍有服务、别名、定时任务或数据管道引用该集合,应先迁移依赖而不是强制删除。
基本语法
下面的包装脚本要求同时传入“目标名称”和“审批名称”,避免复制错环境或变量展开为空。实际厂商删除命令放在 -- 后。
cat > safe-drop-collection.sh <<'BASH'
#!/usr/bin/env bash
set -euo pipefail

[[ $# -ge 6 ]] || {
  echo "usage: safe-drop-collection.sh <target> <approved> <backup.marker> <deps.txt> -- <drop-command>" >&2
  exit 30
}

target="$1"
approved="$2"
backup_marker="$3"
deps_file="$4"
shift 4

[[ "$1" == "--" ]] || {
  echo "REFUSED missing_separator" >&2
  exit 31
}
shift
cmd=("$@")

# 目标名必须与审批名完全一致,且只能使用可审计的安全字符。
[[ "$target" == "$approved" ]] || {
  echo "REFUSED name_mismatch target=$target approved=$approved" >&2
  exit 32
}
[[ "$target" =~ ^[a-zA-Z][a-zA-Z0-9_-]{2,127}$ ]] || {
  echo "REFUSED invalid_collection_name=$target" >&2
  exit 33
}
[[ -s "$backup_marker" ]] || {
  echo "REFUSED backup_not_verified=$backup_marker" >&2
  exit 34
}
[[ -f "$deps_file" && "$(tr -d '[:space:]' < "$deps_file")" == "none" ]] || {
  echo "REFUSED active_or_unreviewed_dependencies=$deps_file" >&2
  exit 35
}

# 先输出可复核的删除命令;未显式放行时只做预演。
printf 'CHECK target=%s backup=verified dependencies=none command=' "$target"
printf '%q' "${cmd[0]}"
for arg in "${cmd[@]:1}"; do
  printf ' %q' "$arg"
done
printf '\n'

if [[ "${EXECUTE:-no}" != "yes" ]]; then
  echo "DRY-RUN collection retained"
  exit 0
fi

# 确认令牌与集合名绑定,避免复用旧令牌误删其他集合。
[[ "${CONFIRM_TOKEN:-}" == "DROP:${target}" ]] || {
  echo "REFUSED invalid_confirm_token" >&2
  exit 36
}

"${cmd[@]}"
echo "DONE collection_drop_command_completed target=$target"
BASH

chmod +x safe-drop-collection.sh
printf '{"collection":"products_v1","restoreTest":"passed"}\n' > products_v1.backup.marker
printf 'none\n' > products_v1.deps

./safe-drop-collection.sh products_v1 products_v1 products_v1.backup.marker products_v1.deps -- printf 'dropped %s\n' 'products_v1'
预期输出:
CHECK target=products_v1 backup=verified dependencies=none command=printf dropped\ %s\\n products_v1
DRY-RUN collection retained
确认预演中的目标名称和实际厂商命令后执行:
EXECUTE=yes CONFIRM_TOKEN='DROP:products_v1' ./safe-drop-collection.sh products_v1 products_v1 products_v1.backup.marker products_v1.deps -- printf 'dropped %s\n' 'products_v1'预期输出:
CHECK target=products_v1 backup=verified dependencies=none command=printf dropped\ %s\\n products_v1
dropped products_v1
DONE collection_drop_command_completed target=products_v1
删除顺序
先停止写入和数据同步,避免删除期间继续写入。随后解除别名、路由、定时任务和应用配置中的引用,再创建备份或快照并完成恢复抽检。
运行包装脚本的预演,核对目标集合、备份状态、依赖文件和最终命令。生产执行后立即验证集合不存在,同时确认应用已切换到新集合且没有持续重试。
验证方法
厂商删除命令完成后,应使用对应的“集合存在性检查”或“列出集合”接口再次确认。不要只依据删除命令的退出码,因为部分系统可能异步提交删除任务。
同时检查应用错误率、查询延迟、索引构建任务和数据同步日志。若仍有请求访问旧集合,应先回滚路由或恢复集合,再处理遗漏依赖。
风险与边界
删除集合通常会同时移除向量、标量字段、索引和分区,恢复成本远高于按条件删除。名称核对错误可能导致整库级数据损失;安全替代方案是先改名或撤下别名,观察一个完整业务周期后再删除。
备份与源集合使用同一故障域时,节点、磁盘或账号事故可能同时破坏两者。备份应放在独立存储和独立权限域,并保存恢复步骤与校验结果。
不要在集合仍被别名、应用配置、CDC、ETL 或定时任务引用时删除。否则会引发持续重试、数据回灌或自动重建;应先冻结依赖,再执行删除。
排障清单
name_mismatch:重新从审批单复制集合名,不要修改两个参数使其“看起来一致”。active_or_unreviewed_dependencies:列出所有调用方并逐一迁移,确认文件只能在复核后写入none。- 删除后集合重新出现:检查自动建表、初始化脚本、同步任务或控制器。
- 删除成功但存储未立即下降:确认数据库是否延迟回收对象存储、日志或索引文件。
速查提示:集合删除应是依赖迁移完成后的最后一步,而不是清理流程的第一步。