
AI Agent / 知识点
AI Agent 工具调用速查手册
手册条目
根据任务是否依赖外部数据、精确计算或实际操作,判断应直接回答还是发起工具调用。
判断是否需要工具
先判断任务是否依赖模型上下文之外的事实、确定性计算或真实世界操作。只有工具能显著提高正确性、时效性或可验证性时才调用;否则直接回答,避免无意义的延迟和失败点。
判断标准
优先调用工具的典型条件:
- 结果依赖实时或私有数据,例如库存、天气、账户余额、内部工单。
- 需要精确计算、结构化查询或大规模检索,人工推算容易出错。
- 用户要求产生实际副作用,例如发邮件、创建日程、修改记录。
- 结论必须可追溯到工具返回值,而不能仅凭模型记忆。
通常直接回答的情况包括解释已有文本、改写、翻译、常识性推理,以及用户已经提供全部必要数据的任务。
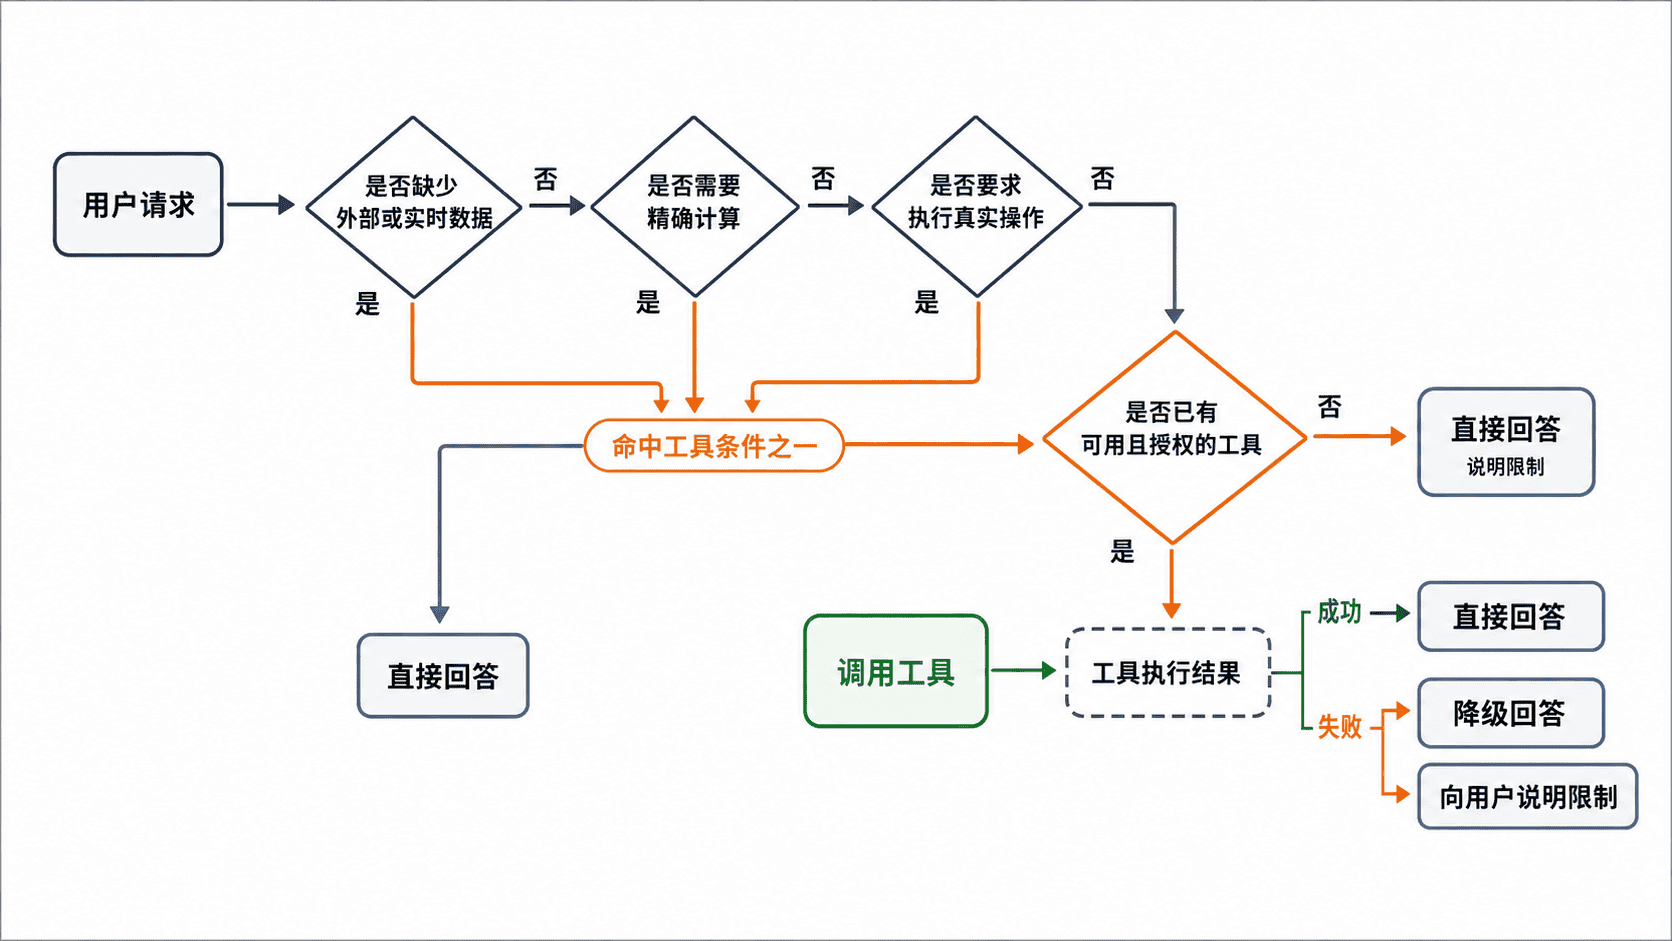
可运行判断器
下面的 TypeScript 示例把判断条件显式化,适合放在 Agent 路由层。实际项目应再叠加权限、成本和超时策略。
type Task = {
  needsExternalData: boolean;
  needsExactComputation: boolean;
  hasSideEffect: boolean;
  toolAvailable: boolean;
  toolAuthorized: boolean;
};

function decide(task: Task): "CALL_TOOL" | "ANSWER_DIRECTLY" | "ASK_FOR_PERMISSION" {
  const needsTool =
    task.needsExternalData ||
    task.needsExactComputation ||
    task.hasSideEffect;

  if (!needsTool) return "ANSWER_DIRECTLY";
  if (!task.toolAvailable) return "ANSWER_DIRECTLY";
  if (!task.toolAuthorized) return "ASK_FOR_PERMISSION";
  return "CALL_TOOL";
}

const cases: Task[] = [
  {
    needsExternalData: false,
    needsExactComputation: false,
    hasSideEffect: false,
    toolAvailable: true,
    toolAuthorized: true
  },
  {
    needsExternalData: true,
    needsExactComputation: false,
    hasSideEffect: false,
    toolAvailable: true,
    toolAuthorized: true
  },
  {
    needsExternalData: false,
    needsExactComputation: false,
    hasSideEffect: true,
    toolAvailable: true,
    toolAuthorized: false
  }
];

for (const task of cases) {
  console.log(decide(task));
}
预期输出
ANSWER_DIRECTLY
CALL_TOOL
ASK_FOR_PERMISSION
读取方法:第一项信息完整且无副作用,直接回答;第二项依赖外部数据,调用工具;第三项会产生真实操作但尚未授权,应先请求许可。
风险与边界
误判为“无需工具”通常发生在数据具有时效性或属于用户私域时,后果是回答过期、虚构或不可验证;安全替代方案是先调用只读查询工具,再基于返回值作答。
误判为“必须调用工具”通常发生在纯解释、改写或本地推理任务中,后果是增加延迟、费用和失败概率;安全替代方案是先检查用户输入是否已经包含完整材料。
涉及写入、支付、删除、发送或权限变更时,即使工具可用也不能自动执行。应先展示将要执行的动作和关键参数,获得明确授权后再调用。
排障清单
- 工具调用前,确认缺失信息确实无法从当前上下文得到。
- 检查工具是否可用、参数是否完整、权限是否满足。
- 调用失败时区分参数错误、权限错误、超时和上游无数据。
- 工具返回空结果时,不把“空”解释为“不存在”,先检查查询范围和过滤条件。
- 最终回答只引用已验证的返回值,并明确动态值可能随时间变化。
速查原则:外部事实、精确计算、真实操作三类需求优先考虑工具;无明确收益时直接回答。
将工具限定为单一、清晰且可验证的能力,避免一个工具同时承担多个独立任务。
设计工具职责
把每个工具限制为一个清晰、可验证的动作,并让工具名、输入参数和返回值共同表达边界。这样 Agent 更容易选对工具,失败时也能准确定位责任。
设计原则
一个工具应满足以下条件:
- 名称使用动词加对象,例如
getOrder、cancelOrder,避免manageOrder。 - 输入只包含执行该动作必需的字段,不夹带无关配置。
- 返回结构稳定,成功与失败可被程序区分。
- 写操作与读操作分离,避免一次调用同时查询、修改和通知。
- 每次调用都能通过返回值、日志或状态变化验证结果。
| 设计 | 推荐 | 不推荐 |
|---|---|---|
| 查询订单 | getOrder(orderId) |
manageOrder(action, payload) |
| 取消订单 | cancelOrder(orderId, reason) |
查询后按条件自动取消 |
| 发送通知 | sendOrderNotice(orderId, channel) |
取消订单时隐式发送所有通知 |
可运行示例
下面的 TypeScript 示例定义两个单一职责工具,并通过统一结果类型暴露可验证状态。代码不依赖第三方库,可直接使用 ts-node 或编译后运行。
type ToolResult<T> =
  | { ok: true; data: T }
  | { ok: false; errorCode: string; message: string };

type Order = {
  id: string;
  status: "PAID" | "CANCELLED";
};

const orders = new Map<string, Order>([
  ["order-1001", { id: "order-1001", status: "PAID" }]
]);

function getOrder(orderId: string): ToolResult<Order> {
  const order = orders.get(orderId);
  if (!order) {
    return {
      ok: false,
      errorCode: "ORDER_NOT_FOUND",
      message: "order does not exist"
    };
  }
  return { ok: true, data: order };
}

function cancelOrder(orderId: string, reason: string): ToolResult<Order> {
  if (!reason.trim()) {
    return {
      ok: false,
      errorCode: "INVALID_REASON",
      message: "reason is required"
    };
  }

  const order = orders.get(orderId);
  if (!order) {
    return {
      ok: false,
      errorCode: "ORDER_NOT_FOUND",
      message: "order does not exist"
    };
  }

  const cancelled = { ...order, status: "CANCELLED" as const };
  orders.set(orderId, cancelled);
  return { ok: true, data: cancelled };
}

console.log(getOrder("order-1001"));
console.log(cancelOrder("order-1001", "duplicate order"));
预期输出
{ ok: true, data: { id: 'order-1001', status: 'PAID' } }
{ ok: true, data: { id: 'order-1001', status: 'CANCELLED' } }
读取方法:查询工具只返回订单状态;取消工具只执行取消并返回变更后的订单。通知、退款等独立副作用不应隐藏在 cancelOrder 内。
边界检查
工具职责可以用一句话描述,并且句子中最好只有一个主要动词。若描述变成“查询并更新”“创建后发送”“检查并自动修复”,通常说明应该拆成多个工具或由 Agent 编排多个步骤。
参数中出现大量可选字段、action 枚举或任意 JSON,往往意味着工具边界过宽。安全替代方案是拆成多个窄工具,并为每个工具定义明确的必填字段和返回类型。
风险与边界
大而全工具常在一个调用中执行多个副作用。触发条件是输入含模糊动作、工具内部存在条件分支或隐式联动;可能后果是误操作、无法重试、审计困难。安全替代方案是把读、写、通知和批处理分开,并由 Agent 显式编排。
工具拆得过细也会造成调用链过长。触发条件是单个业务动作需要连续调用多个不可独立验证的小工具;可能后果是延迟升高、部分成功和补偿复杂。安全替代方案是以“可独立验证的业务动作”为最小边界,而不是以每个内部函数为工具。
排障清单
- Agent 经常选错工具:检查工具名和描述是否包含重叠动词。
- 参数频繁缺失:检查是否把多个动作塞进同一输入结构。
- 调用后无法确认成功:补充稳定的状态字段、错误码或资源标识。
- 重试导致重复写入:为写工具增加幂等键或先查后写策略。
- 一次失败影响多个系统:拆分副作用,并记录每一步结果。
速查原则:一个工具完成一个可独立验证的业务动作;复杂任务由 Agent 编排,而不是把流程藏进工具内部。
使用稳定且语义明确的名称,帮助模型区分相近工具并保持调用兼容性。
定义稳定的工具名称
工具名称是模型选择工具时最先识别的标识。目标是让名称长期稳定、含义唯一,并能直接区分相近能力,例如读取数据与修改数据必须使用不同动词。
命名规则
推荐使用 动词_对象 或 动词_对象_范围,统一采用小写蛇形命名。动词描述实际副作用,对象描述操作目标,只有确实存在多个范围时才增加第三段。
- 查询类优先使用
get、list、search。 - 创建和修改类使用
create、update、delete。 - 避免
handle、process、tool1、do_task等无法判断行为的名称。 - 同一 Agent 内不要混用
getUser、get-user、get_user。
主示例
下面的检查脚本验证名称格式,并发现重复名称。可直接保存为 check-tools.js 后运行。
const tools = [
  "search_orders",
  "get_order",
  "update_order_status",
  "search_orders"
];

const namePattern = /^[a-z][a-z0-9]*(?:_[a-z0-9]+)*$/;
const seen = new Set();

for (const name of tools) {
  if (!namePattern.test(name)) {
    console.log(`INVALID ${name}`);
    continue;
  }

  if (seen.has(name)) {
    console.log(`DUPLICATE ${name}`);
    continue;
  }

  seen.add(name);
  console.log(`OK ${name}`);
}
预期输出
OK search_orders
OK get_order
OK update_order_status
DUPLICATE search_orders读取方法:INVALID 表示格式不符合约定,DUPLICATE 表示同一工具集中存在重名;两者都应在注册工具前修复。
相近工具如何区分
名称必须体现真正不同的动作。search_orders 用于按条件搜索多个订单,get_order 用于按唯一 ID 读取单个订单,update_order_status 明确表示会修改状态。不要仅用 orders 或 order_tool,否则模型只能依赖较长描述猜测行为。
工具重构时优先保留原名称并扩展描述或参数。确需改名时,应同时更新提示词、评测集、调用路由、日志查询和兼容映射,避免旧会话或缓存仍调用旧名称。
风险与边界
触发条件:名称含义重叠、同名注册,或把只读工具改成带副作用但仍保留旧名称。可能后果:模型选错工具、重复调用、误写数据,或者线上调用因名称不存在而失败。安全替代方案是保持名称不可变,通过新增版本化工具完成迁移,并在下线旧名称前统计实际调用量。
名称不要承载易变化的信息,例如模型版本、日期、环境名或团队名。环境差异应放在参数或运行配置中,而不是创建 search_orders_prod_2026 这类短期名称。
排障清单
- 日志中出现“工具不存在”时,先核对注册名与模型可见名称是否逐字一致。
- 模型频繁混淆两个工具时,检查名称是否使用了相同动词或模糊对象。
- 改名后只有部分请求失败时,排查缓存提示词、旧工作流和灰度实例是否仍引用旧名称。
- 同一功能出现多个近似名称时,保留语义最明确者,并为旧名称设置受控兼容期。
速查:名称应做到看到标识就能回答“执行什么动作、作用于什么对象、是否可能修改数据”三个问题。
说明工具解决什么问题、何时使用以及何时不应使用,提高模型选中正确工具的概率。
编写可判定的工具描述
工具描述要让模型在不查看实现代码的情况下判断三件事:工具解决什么问题、什么条件下应调用、什么条件下不应调用。描述应补充名称无法表达的选择边界,而不是重复名称。
描述结构
一条实用描述通常包含以下信息,按一至三句话写完:
- 能力:返回或修改什么数据。
- 使用条件:用户提供了哪些信息,或任务处于什么阶段时调用。
- 禁用条件:哪些相近场景应改用其他工具。
- 关键约束:是否有副作用、权限要求、时间范围或结果上限。
例如 search_orders 不应只写“搜索订单”,而应说明可按客户、状态和时间范围查找多个订单,并明确“已知唯一订单 ID 时改用 get_order”。
主示例
下面的脚本对工具描述做最小完整性检查,确保每条描述至少包含用途、使用条件和禁用条件。保存为 lint-descriptions.js 后运行。
const tools = [
  {
    name: "search_orders",
    description:
      "按客户、状态或时间范围搜索多个订单;当用户不知道订单 ID 或需要结果列表时使用;已知唯一订单 ID 时不要使用,改用 get_order。"
  },
  {
    name: "get_order",
    description: "获取订单详情。"
  }
];

const checks = [
  { label: "用途", pattern: /搜索|获取|创建|更新|删除/ },
  { label: "使用条件", pattern: /当.+时使用|用于/ },
  { label: "禁用条件", pattern: /不要使用|不应使用|改用/ }
];

for (const tool of tools) {
  const missing = checks
    .filter((check) => !check.pattern.test(tool.description))
    .map((check) => check.label);

  console.log(
    missing.length === 0
      ? `OK ${tool.name}`
      : `INCOMPLETE ${tool.name}: ${missing.join(",")}`
  );
}
预期输出
OK search_orders
INCOMPLETE get_order: 使用条件,禁用条件读取方法:INCOMPLETE 不代表描述一定错误,但表示模型缺少稳定的工具选择边界,应在上线前人工补充。
写法对比
模糊描述:查询用户信息。。可判定描述:按唯一用户 ID 读取一个用户的基础资料;当请求已包含明确用户 ID 时使用;需要按姓名或邮箱查找候选用户时不要使用,改用 search_users;本工具只读,不修改用户数据。
第二种写法同时限定输入条件、替代工具和副作用,能减少模型在 get_users、search_users、update_user 之间误选。不要写“功能强大”“智能处理”“必要时调用”等无法验证的宣传性措辞。
风险与边界
触发条件:描述遗漏禁用场景、隐瞒副作用,或多个工具使用高度相似的描述。可能后果:模型在只读请求中调用写操作、把唯一 ID 查询错误地交给搜索工具,或因反复试错增加延迟和费用。安全替代方案是为每组相近工具写成互斥边界,并明确推荐的替代工具名称。
描述也不能承诺实现不具备的能力。若工具只返回最近 100 条记录,就应明确结果上限;若调用需要管理员权限,也应写明。否则模型可能构造无法满足的请求,随后通过重复调用放大故障。
排障清单
- 工具被错误选中时,比较它与正确工具的“使用条件”和“不要使用”部分是否互斥。
- 模型传入缺失参数时,检查描述是否明确调用前必须具备的信息。
- 写操作被意外调用时,在描述开头突出“会修改数据”,并增加只读替代工具。
- 描述持续增长仍无改善时,删除背景说明,保留能力、条件、禁用场景和约束。
- 上线新工具后误选率升高时,用真实失败样本更新描述和工具选择评测,而不是只改提示词语气。
速查:高质量描述应让评审者仅阅读名称与描述,就能判断何时调用、何时拒绝、应改用哪个工具,以及调用是否会产生副作用。
使用明确的类型、字段含义和层级结构约束工具调用参数。
定义参数 Schema
用于给工具参数建立可机器校验的契约,让模型知道字段名称、类型、含义、层级和边界,并让服务端在执行前拒绝结构错误的调用。
设计要点
字段名应表达业务含义,description 写清单位、格式和取值语义;数值使用 minimum、maximum,固定集合使用 enum,对象默认关闭未声明字段。
嵌套对象只在字段天然成组时使用。层级过深会增加模型漏填或放错位置的概率;通常控制在两到三层,并把常用参数放在顶层。
可运行验证
以下示例要求已安装 jsonschema。它定义天气查询参数,并验证一组合法调用。
from jsonschema import validate

schema = {
    "type": "object",
    "properties": {
        "city": {
            "type": "string",
            "minLength": 1,
            "description": "城市名称,例如 Shanghai"
        },
        "days": {
            "type": "integer",
            "minimum": 1,
            "maximum": 14,
            "description": "预报天数"
        },
        "units": {
            "type": "string",
            "enum": ["metric", "imperial"],
            "description": "温度单位"
        }
    },
    "required": ["city", "days"],
    "additionalProperties": False
}

payload = {"city": "Shanghai", "days": 3, "units": "metric"}
validate(instance=payload, schema=schema)
print(f"valid: {payload['city']}, {payload['days']} day(s)")
预期输出
valid: Shanghai, 3 day(s)读取方法:无异常表示结构通过校验;类型错误、越界值或多余字段会抛出 ValidationError,应在调用外部系统前终止执行并返回可修正的错误信息。
高频用法
- 标识符、日期和金额不要只写
string或number,应补充格式、单位和示例。 - 互斥参数不要同时设为必填,改用
oneOf或在服务端增加组合校验。 - 列表字段同时限制元素类型和数量,避免空数组或一次提交过多对象。
风险与排障
触发条件:Schema 过宽,例如允许任意字段或用字符串承载所有值。可能后果:模型生成看似合法但不可执行的参数,错误延迟到下游。安全替代:收紧类型、枚举、长度和额外字段策略。
触发条件:Schema 过度复杂或嵌套过深。可能后果:漏填、层级错位和重复追问增多。安全替代:拆分工具、压平高频字段,并用服务端校验补充跨字段规则。
排查时先记录原始参数和校验错误路径,再检查字段名是否一致、数字是否被序列化为字符串、对象是否包含未声明字段。
合理区分必填参数、可选参数和服务端默认值,减少无效调用及重复追问。
设置必填与默认值
用于决定模型必须提供什么、哪些字段可以省略,以及省略后由谁补值。目标是减少无效调用,同时避免为可推导参数反复追问。
划分规则
无法安全推断、且缺失后不能执行的字段设为必填,例如查询主体、目标资源或确认后的操作对象。可缺省且不会改变核心意图的字段设为可选。
默认值应由服务端统一应用,Schema 中的 default 主要用于说明和生成文档;多数 JSON Schema 校验器只校验,不会自动写入默认值。
null 与“字段缺失”应分别定义:缺失表示采用默认策略,null 表示调用方明确清空或不指定。若业务不接受 null,不要把类型声明为可空。
可运行验证
以下示例要求已安装 jsonschema。query 必填,limit 和 cursor 由服务端在校验后补默认值。
from jsonschema import Draft202012Validator

schema = {
    "type": "object",
    "properties": {
        "query": {"type": "string", "minLength": 1},
        "limit": {
            "type": "integer",
            "minimum": 1,
            "maximum": 100,
            "default": 20
        },
        "cursor": {
            "type": ["string", "null"],
            "default": None
        }
    },
    "required": ["query"],
    "additionalProperties": False
}

def apply_defaults(instance, schema):
    result = dict(instance)
    for name, rule in schema.get("properties", {}).items():
        if name not in result and "default" in rule:
            result[name] = rule["default"]
    return result

raw = {"query": "timeout"}
Draft202012Validator(schema).validate(raw)
effective = apply_defaults(raw, schema)
print(raw)
print(effective)
预期输出
{'query': 'timeout'}
{'query': 'timeout', 'limit': 20, 'cursor': None}
读取方法:第一行是模型实际提交值,第二行是服务端生效值。两者分开记录,便于判断问题来自模型参数还是默认值处理。
高频用法
- 搜索词、目标 ID、写操作确认信息通常必填。
- 分页大小、排序方式、超时阈值通常可选并设置保守默认值。
- 默认值会随环境变化时,不要固化在提示词中,应由服务端配置注入。
风险与边界
触发条件:客户端、Schema 和服务端各自维护一份默认值。可能后果:同一调用在不同入口产生不同结果。安全替代:服务端作为唯一生效来源,其他位置只展示说明。
触发条件:把高风险参数设为默认,例如默认执行删除、覆盖或大范围查询。可能后果:模型省略字段时触发破坏性行为或资源消耗。安全替代:高风险动作必须显式填写,并在执行前再次校验或确认。
触发条件:把业务必需字段错误地设为可选。可能后果:工具收到空语义请求并重复失败。安全替代:根据执行前置条件调整 required,并让错误信息明确指出缺失字段。
通过枚举、格式和数值边界减少模型生成不可执行参数的情况。
限制枚举与取值范围
当工具参数只有有限选项、固定格式或安全边界时,应把约束写进参数 Schema,而不是只放在描述文字里。这样可在调用前拒绝拼写错误、越界数值和不可执行组合。
基本写法
优先使用 enum 限制离散值,使用 minimum、maximum 限制数值,使用 pattern、format 限制字符串。必填参数放入 required,并通过 additionalProperties: false 拒绝模型自行补字段。
{
  "type": "object",
  "properties": {
    "environment": {
      "type": "string",
      "enum": ["dev", "staging", "prod"]
    },
    "replicas": {
      "type": "integer",
      "minimum": 1,
      "maximum": 20
    },
    "requestId": {
      "type": "string",
      "pattern": "^[a-z0-9-]{8,64}$"
    }
  },
  "required": ["environment", "replicas"],
  "additionalProperties": false
}生效行为:environment 只能取三个枚举值,replicas 必须为 1~20 的整数,未知字段会被拒绝。接入支持 JSON Schema 的工具框架后,用合法参数和故意越界参数各调用一次即可验证。
可运行验证
下面用 Python 模拟调用入口的二次校验。即使框架已做 Schema 校验,执行函数仍应保留关键边界检查,防止绕过或版本差异。
import re

ALLOWED_ENVIRONMENTS = {"dev", "staging", "prod"}

def validate_args(args: dict) -> None:
    environment = args.get("environment")
    replicas = args.get("replicas")
    request_id = args.get("requestId")

    if environment not in ALLOWED_ENVIRONMENTS:
        raise ValueError("environment must be dev, staging, or prod")
    if type(replicas) is not int or not 1 <= replicas <= 20:
        raise ValueError("replicas must be an integer between 1 and 20")
    if request_id is not None and not re.fullmatch(r"[a-z0-9-]{8,64}", request_id):
        raise ValueError("requestId format is invalid")

for payload in (
    {"environment": "prod", "replicas": 3, "requestId": "deploy-001"},
    {"environment": "production", "replicas": 50}
):
    try:
        validate_args(payload)
        print("accepted")
    except ValueError as exc:
        print(f"rejected: {exc}")
预期输出
accepted
rejected: environment must be dev, staging, or prod
读取方法:第一行表示合法参数可进入执行阶段;第二行说明校验在发现首个非法枚举后立即终止,因此不会继续报告 replicas 越界。
约束选择
- 离散选项少且稳定时用
enum,例如环境、排序方向、输出格式。 - 数值具有业务上限时同时写类型和边界,避免
"10"这类字符串混入。 - 标识符规则稳定时用
pattern;规则复杂或经常变化时,Schema 只做粗校验,精确校验留在执行层。 - 参数之间存在条件关系时,优先拆成不同工具或使用框架支持的条件 Schema,不要只靠一段自然语言描述。
风险与边界
枚举过宽会让模型生成后端不支持的值,导致调用失败;枚举过窄则会阻断新增能力。安全做法是由后端能力清单生成 Schema,并让工具版本与执行端同步发布。
仅依赖 Schema 校验时,旧客户端、代理层或手工请求可能绕过限制,最终造成越权操作或资源耗尽。执行函数必须再次检查权限、数值上限和资源归属,危险操作还应加入确认或审批。
正则过于复杂可能造成性能问题,也难以向模型解释。优先使用长度限制加简单模式,复杂格式由专用解析器处理并返回明确错误码。
排障清单
- 模型频繁输出近义值:缩短描述,并把所有合法值完整放入
enum。 - 数值仍以字符串出现:确认字段类型为
integer或number,不要同时允许string。 - 新字段悄悄进入后端:检查是否设置
additionalProperties: false。 - 合法调用被拒绝:核对工具 Schema、网关校验器和执行端是否使用同一版本。
速查:Schema 负责缩小生成空间,执行层负责最终安全校验;两层缺一不可。
返回稳定、精简且结构化的数据,使模型能够可靠理解执行结果并生成后续回答。
设计工具返回值
工具返回值应让模型快速判断“是否成功、结果是什么、下一步能做什么”。推荐使用稳定的结果信封,业务数据放在固定字段中,错误使用机器可读代码,避免把日志、堆栈和大段文本直接塞给模型。
推荐结构
统一返回 ok、data、error 和 meta。成功时 data 有值、error 为 null;失败时反过来。字段含义长期稳定,业务字段只在 data 内扩展。
{
  "ok": true,
  "data": {
    "deploymentId": "dep-123",
    "status": "queued"
  },
  "error": null,
  "meta": {
    "requestId": "req-456"
  }
}
meta 只保留追踪和分页等控制信息,不放模型回答所需的核心业务数据。时间、路径和内部节点名如无后续用途,应省略或归一化。
可运行示例
下面的工具函数始终返回同一种外形,并把内部异常转换成稳定错误码。示例可直接使用 Python 3 运行。
import json
from typing import Any

def create_result(ok: bool, data: Any = None, code: str | None = None,
                  message: str | None = None, request_id: str = "req-001") -> dict:
    return {
        "ok": ok,
        "data": data if ok else None,
        "error": None if ok else {"code": code, "message": message},
        "meta": {"requestId": request_id}
    }

def get_order(order_id: str) -> dict:
    if order_id == "order-100":
        return create_result(
            True,
            data={"orderId": order_id, "status": "paid", "amount": 99.0}
        )
    return create_result(
        False,
        code="ORDER_NOT_FOUND",
        message="No order matched the supplied orderId"
    )

print(json.dumps(get_order("order-100"), ensure_ascii=False, sort_keys=True))
print(json.dumps(get_order("missing"), ensure_ascii=False, sort_keys=True))
预期输出
{"data": {"amount": 99.0, "orderId": "order-100", "status": "paid"}, "error": null, "meta": {"requestId": "req-001"}, "ok": true}
{"data": null, "error": {"code": "ORDER_NOT_FOUND", "message": "No order matched the supplied orderId"}, "meta": {"requestId": "req-001"}, "ok": false}
读取方法:模型先看 ok;成功时只读取 data,失败时根据 error.code 决定重试、补参数或向用户解释。requestId 用于人工排障,不应替代错误码。
字段设计
ok:布尔值,避免模型从自然语言猜测成功与否。data:只返回完成当前任务和下一步推理所需的字段,名称保持稳定。error.code:使用固定枚举,如INVALID_ARGUMENT、NOT_FOUND、PERMISSION_DENIED、RATE_LIMITED、INTERNAL_ERROR。error.message:给模型和用户的简短说明,不暴露堆栈、SQL、密钥或内部地址。meta:放requestId、分页游标、是否还有下一页等控制信息。
列表结果应返回数组和显式分页信息;不要在某次返回数组、另一次返回以 ID 为键的对象。无结果时返回空数组,而不是 null、空字符串或“没有数据”文本。
风险与边界
返回完整数据库对象会增加令牌消耗,并可能泄露内部字段或个人数据。触发条件是工具直接序列化 ORM 实体或第三方响应;后果是模型误用字段、回答不稳定或发生数据泄露。安全替代方案是建立专用输出 DTO,只选择必要字段并做脱敏。
把异常堆栈直接作为 message 返回时,模型可能向用户复述文件路径、查询语句或凭据。应在服务端记录完整异常,对模型只返回稳定错误码、简短说明和 requestId。
返回结构随分支变化会迫使模型猜测字段位置。发布新字段时保持向后兼容;必须破坏结构时创建新工具版本,不要静默替换旧返回格式。
排障清单
- 模型把失败当成功:确认存在顶层布尔字段
ok,且失败时data固定为null。 - 模型无法决定下一步:补充稳定的
error.code,不要只返回自然语言。 - 回答过长或偏离主题:裁剪
data,移除日志、重复描述和未使用字段。 - 同一工具解析偶发失败:比较各分支返回结构,检查字段类型是否一致。
- 分页重复或漏数据:返回明确的
nextCursor和hasMore,不要让模型自行推算页码。
速查:稳定外形、精简数据、固定错误码和可追踪请求号,是可靠工具返回值的最小组合。
根据场景配置自动选择、强制调用、指定工具或禁止调用等决策模式。
控制工具选择模式
在模型调用前明确“能不能调用、必须调用哪个工具”,避免模型在不该调用时误触工具,或在必须取实时数据时直接凭上下文回答。
模式速查
| 模式 | 什么时候用 | 决策结果 |
|---|---|---|
auto |
默认场景,允许模型自行判断 | 可调用,也可直接回答 |
required |
本轮必须经过工具验证 | 必须产生至少一次工具调用 |
named |
已知唯一正确工具 | 只能调用指定工具 |
none |
禁止外部访问或只允许文本推理 | 不得产生工具调用 |
required 只表示“必须调用某个工具”,不一定限定具体工具;要锁定工具,应使用 named。
可运行策略层
下面用一个独立策略函数把业务场景映射为工具选择模式。它不依赖具体模型 SDK,可放在调用模型之前统一决策。
from dataclasses import dataclass
from typing import Literal, Optional

Mode = Literal["auto", "required", "named", "none"]

@dataclass(frozen=True)
class ToolPolicy:
    mode: Mode
    tool_name: Optional[str] = None

def choose_policy(intent: str, has_fresh_data: bool) -> ToolPolicy:
    if intent == "calculate":
        return ToolPolicy("named", "calculator")
    if intent == "lookup_current":
        return ToolPolicy("required")
    if intent == "summarize_private_text" and has_fresh_data:
        return ToolPolicy("none")
    return ToolPolicy("auto")

tests = [
    ("calculate", False),
    ("lookup_current", False),
    ("summarize_private_text", True),
    ("general_question", False),
]

for intent, has_fresh_data in tests:
    print(intent, "->", choose_policy(intent, has_fresh_data))
预期输出
calculate -> ToolPolicy(mode='named', tool_name='calculator')
lookup_current -> ToolPolicy(mode='required', tool_name=None)
summarize_private_text -> ToolPolicy(mode='none', tool_name=None)
general_question -> ToolPolicy(mode='auto', tool_name=None)
读取方法:出现 named 时同时检查 tool_name;required 且工具名为空,表示允许模型在已注册工具中选择,但不能跳过工具调用。
高频用法
默认自动选择
普通问答、可能需要也可能不需要外部信息时使用 auto。工具描述必须足够清晰,否则模型容易选错近义工具。
强制经过工具
价格、库存、权限状态、数据库记录等不能依赖旧上下文时使用 required。执行层仍需校验参数和权限,不能把“模型决定调用”当成授权。
锁定指定工具
用户已明确要求计算、查日历或查询订单时使用 named,可减少误选。指定的工具必须已注册;名称不一致通常会导致请求失败或模型无法完成。
禁止调用
处理已提供文本、敏感内容或离线推理时使用 none。如果回答依赖实时数据,禁止工具会导致信息缺失,应改为返回“无法验证”,而不是猜测。
风险与边界
触发条件:对所有请求统一使用 required。可能后果:无意义调用增加延迟和成本,并可能把敏感参数发送给外部系统。安全替代:只对需要实时性、权威数据或执行动作的意图强制调用。
触发条件:仅通过提示词要求“不要调用工具”,但执行层仍开放工具。可能后果:模型仍可能返回工具调用。安全替代:在请求参数和服务端策略两层同时设置 none,并拒绝执行任何意外工具调用。
触发条件:把 named 当作权限控制。可能后果:模型被锁定到某工具后,仍可能提交越权参数。安全替代:工具执行前独立完成身份、资源范围和参数白名单校验。
兼容性
不同模型 SDK 对模式字段的名称和结构可能不同,但语义通常可归一为自动、必选、指定和禁用四类。生产代码应在自有策略层使用统一枚举,再由适配器转换为供应商参数,避免业务逻辑直接依赖某个 SDK。
依次处理模型决策、参数解析、工具执行、结果回传和最终回答,形成完整调用循环。
完成调用闭环
一次完整工具调用不是“模型返回函数名”就结束,而是模型决策、参数校验、工具执行、结果回传、最终回答连续完成;任一步失败都要转换成模型可读且可审计的结果。
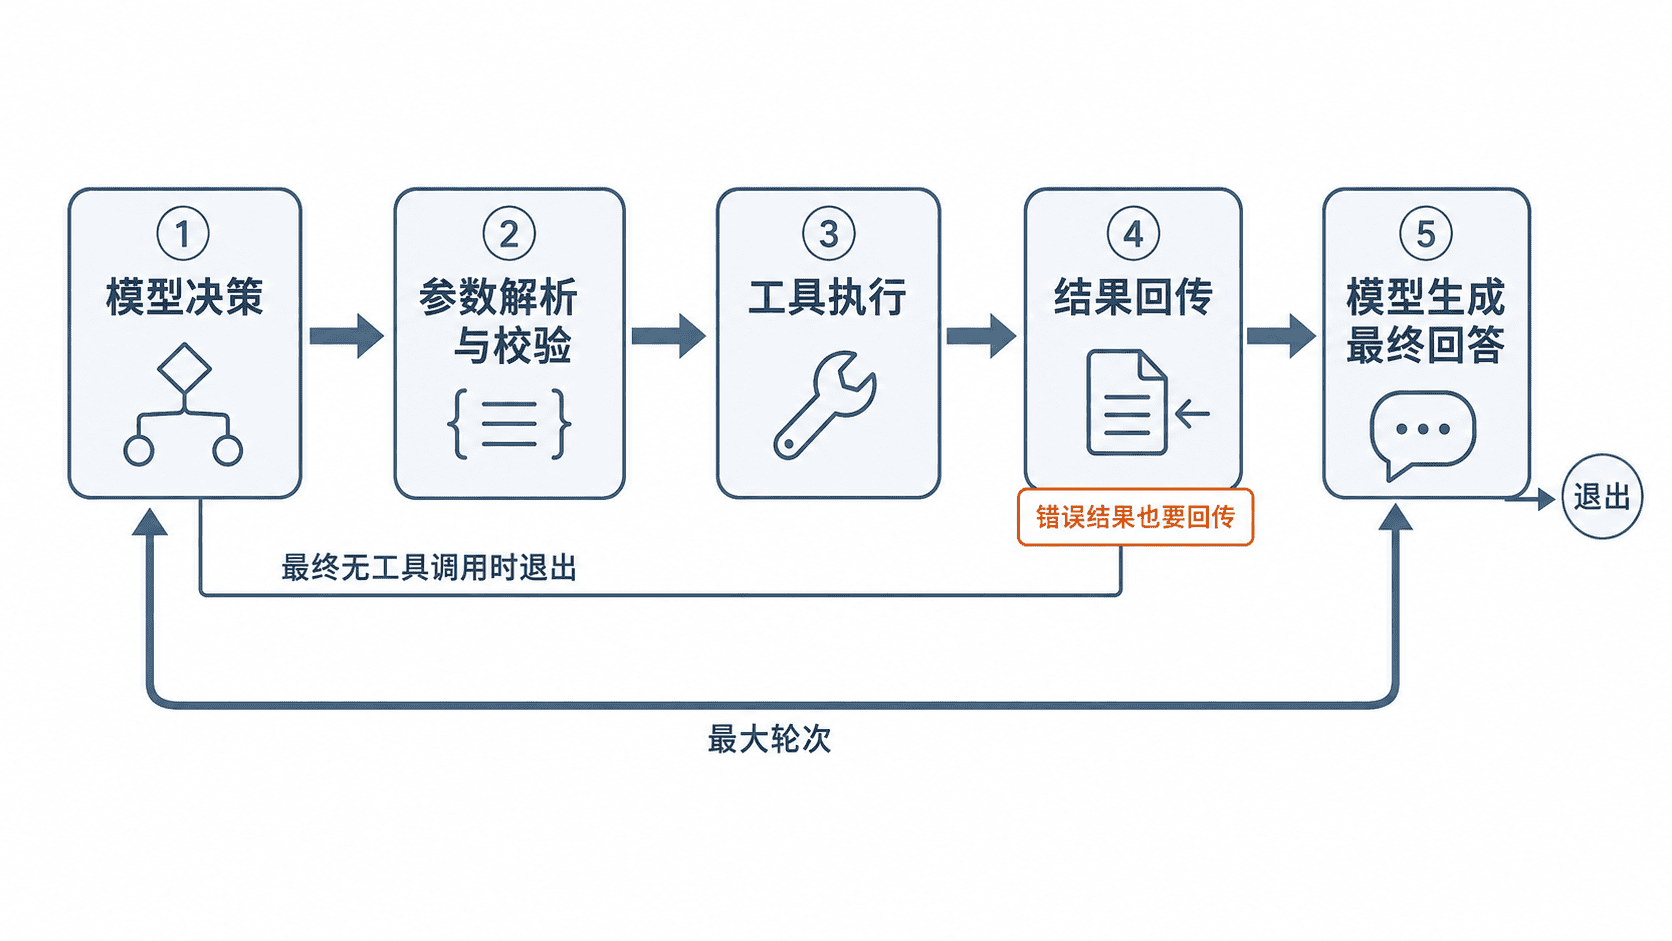
最小循环结构
执行器每轮只处理三种结果:最终文本、合法工具调用、不可恢复错误。工具结果必须追加回对话,再让模型继续决策,不能由执行器直接拼接成最终答案。
import json
from typing import Any

def get_weather(city: str) -> dict[str, Any]:
    # 示例工具固定返回,生产环境应替换为真实服务并设置超时。
    return {"city": city, "temperature_c": 26, "condition": "cloudy"}

TOOLS = {"get_weather": get_weather}

class MockModel:
    def respond(self, messages: list[dict[str, Any]]) -> dict[str, Any]:
        tool_messages = [m for m in messages if m["role"] == "tool"]
        if not tool_messages:
            return {
                "type": "tool_call",
                "id": "call-1",
                "name": "get_weather",
                "arguments": '{"city":"Shanghai"}',
            }

        result = json.loads(tool_messages[-1]["content"])
        return {
            "type": "final",
            "content": (
                f"{result['city']} 当前 {result['temperature_c']}°C,"
                f"天气为 {result['condition']}。"
            ),
        }

def run_agent(user_text: str, max_rounds: int = 4) -> str:
    model = MockModel()
    messages: list[dict[str, Any]] = [
        {"role": "user", "content": user_text}
    ]

    for _ in range(max_rounds):
        response = model.respond(messages)

        if response["type"] == "final":
            return response["content"]

        name = response.get("name")
        if response.get("type") != "tool_call" or name not in TOOLS:
            raise RuntimeError("模型返回了未知或不完整的工具调用")

        try:
            arguments = json.loads(response["arguments"])
            if set(arguments) != {"city"} or not isinstance(arguments["city"], str):
                raise ValueError("参数必须且只能包含字符串 city")
            result = TOOLS[name](**arguments)
            tool_content = json.dumps(result, ensure_ascii=False)
        except Exception as exc:
            # 错误也作为结构化工具结果回传,让模型决定重试或解释失败。
            tool_content = json.dumps(
                {"ok": False, "error": str(exc)},
                ensure_ascii=False,
            )

        messages.append(response)
        messages.append({
            "role": "tool",
            "tool_call_id": response["id"],
            "name": name,
            "content": tool_content,
        })

    raise RuntimeError("超过最大工具调用轮次")

print(run_agent("上海天气怎么样?"))
预期输出
Shanghai 当前 26°C,天气为 cloudy。读取方法:首轮模型返回 tool_call,执行器校验并运行 get_weather;工具结果以 role=tool 回传后,第二轮模型返回 final,循环结束。示例中的城市和天气为固定测试数据。
结果回传要求
工具消息至少应保留调用 ID、工具名和结构化结果。调用 ID 用于把并行或连续调用与原始请求对应;工具结果应优先使用 JSON,避免模型从非结构化日志中猜字段。
错误不要吞掉,也不要把异常堆栈原样暴露给模型。应转换为稳定结构,例如 {"ok":false,"error":"timeout"},必要时增加可重试标记和错误码。
风险与边界
触发条件:不限制循环轮次,且模型在失败后持续重试。可能后果:形成死循环、重复扣费或重复执行有副作用的操作。安全替代:设置最大轮次,并为写操作增加幂等键和人工确认。
触发条件:工具调用前只做 JSON 解析,不做字段、类型和权限校验。可能后果:错误参数导致服务异常,越权参数可能访问不属于当前用户的资源。安全替代:使用严格 schema 校验,并在工具内部再次校验身份和资源范围。
触发条件:网络超时后直接重放写操作。可能后果:订单、转账、消息发送等动作被执行两次。安全替代:只自动重试幂等读操作;写操作使用幂等键,并先查询原调用状态。
排障清单
- 模型反复调用同一工具:检查工具结果是否已按正确调用 ID 回传,以及结果中是否缺少模型需要的字段。
- 工具执行成功但模型称失败:检查结果是否被截断、序列化失败或以错误角色写入消息。
- 参数偶发无法解析:记录原始参数字符串,使用 schema 拒绝额外字段,并把简化错误回传给模型。
- 最终回答提前生成:需要权威数据的请求应强制工具调用,且执行器不能把首次文本响应误判为已完成。
速查原则:模型负责决定下一步,执行器负责校验、授权、执行和终止条件;两者职责不能互换。
在执行前完成 Schema 校验、业务规则校验和输入规范化,阻止错误参数进入工具。
校验调用参数
在 Agent 真正执行工具前,先完成输入规范化、Schema 校验和业务规则校验。只有返回成功结果的参数才能进入工具,避免类型错误、越权范围和脏数据触发真实操作。
校验顺序
按“规范化 → Schema 校验 → 业务规则校验”执行:先清理字符串空白、统一可确定的格式,再检查必填字段、类型和未知字段,最后验证权限、资源范围及跨字段关系。任一步失败都应停止调用。
可运行示例
下面校验搜索工具参数:query 必须是非空字符串,limit 必须是 1~50 的整数;缺少 limit 时使用安全默认值 10,并拒绝未声明字段。
function validateSearchArgs(input) {
  if (typeof input !== 'object' || input === null || Array.isArray(input)) {
    return { ok: false, errors: ['参数必须是对象'] };
  }

  const errors = [];
  const unknownKeys = Object.keys(input).filter(
    key => !['query', 'limit'].includes(key)
  );
  const query = typeof input.query === 'string' ? input.query.trim() : '';
  const limit = input.limit === undefined ? 10 : input.limit;

  if (unknownKeys.length > 0) {
    errors.push(`存在未知字段: ${unknownKeys.join(', ')}`);
  }
  if (query.length === 0) {
    errors.push('query 必须是非空字符串');
  }
  if (!Number.isInteger(limit) || limit < 1 || limit > 50) {
    errors.push('limit 必须是 1~50 的整数');
  }

  return errors.length > 0
    ? { ok: false, errors }
    : { ok: true, value: { query, limit } };
}

console.log(JSON.stringify(validateSearchArgs({ query: '  agent tools  ' })));
console.log(JSON.stringify(validateSearchArgs({ query: ' ', limit: 100 })));
将代码保存为 validate.js,执行 node validate.js。预期输出
{"ok":true,"value":{"query":"agent tools","limit":10}}
{"ok":false,"errors":["query 必须是非空字符串","limit 必须是 1~50 的整数"]}读取方法:ok 为 true 时,仅将规范化后的 value 交给工具;ok 为 false 时必须阻止调用,并将 errors 转换成用户可执行的修正提示。
业务规则校验
Schema 只能证明参数形状正确,还应继续检查:资源 ID 是否属于当前用户或租户、时间范围是否合理、分页和文件大小是否超限,以及 startTime 是否早于 endTime。发送、删除、支付等操作还应验证确认令牌与权限范围。
风险与边界
触发条件:把自动类型转换当成校验,例如将 '100' 静默转为数字,或直接忽略未知字段。可能后果:错误输入被掩盖,甚至让攻击者注入工具未预期的控制字段。安全替代方案:默认拒绝未知字段,只规范化无歧义内容,并在转换后重新校验。
触发条件:校验失败后让模型猜测参数并继续执行。可能后果:误删、误发、越权查询或产生额外费用。安全替代方案:有副作用或高成本的工具采用失败即停止,仅在参数低风险且默认值明确时自动补值。
排障清单
- 分别返回
INVALID_SCHEMA、BUSINESS_RULE_VIOLATION和UNAUTHORIZED,不要统一成“参数错误”。 - 日志记录原始参数摘要、规范化结果和失败规则,但必须隐藏令牌、密码和个人数据。
- 校验器与工具实现共享同一组范围常量,避免最大值或枚举定义漂移。
- 覆盖空字符串、未知字段、边界值、超长输入和跨字段冲突测试。
速查:先规范化,再校验结构,最后检查权限和业务关系;任何一步失败都不得执行工具。
根据参数的重要性选择追问用户、使用安全默认值或终止本次调用。
处理缺失参数
发现调用参数缺失时,先判断该字段是否影响用户意图、安全性或不可逆结果,再选择追问用户、使用安全默认值或终止调用,不能让模型直接猜测。
决策流程
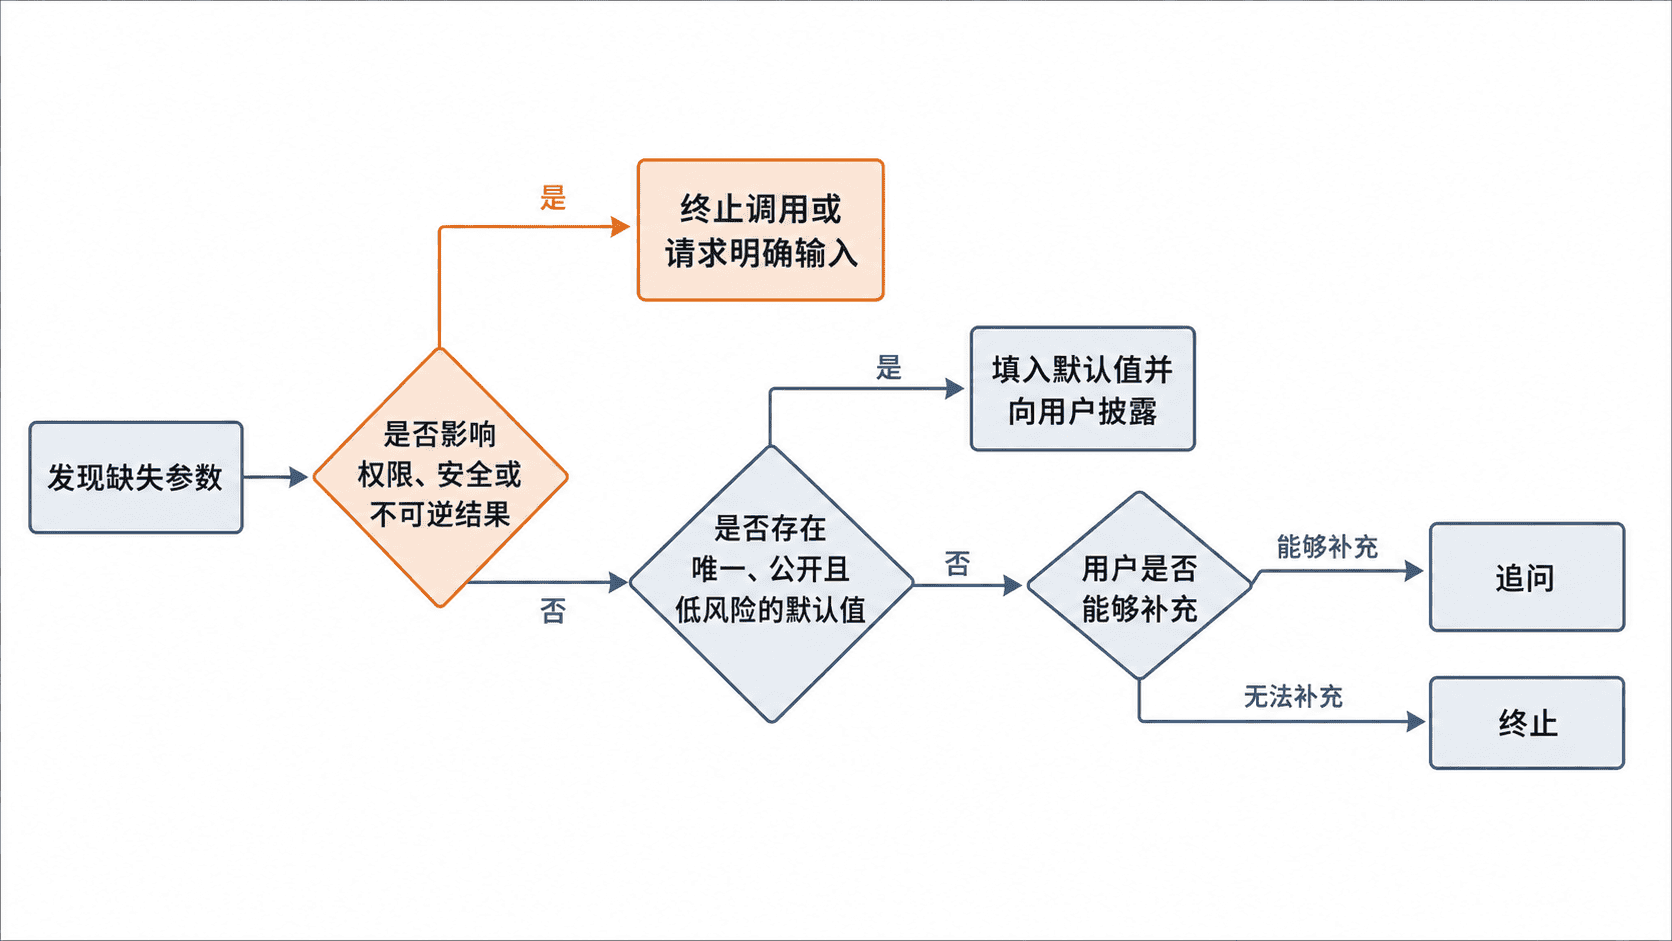
收件人、金额、删除目标、权限范围、运行环境和发布时间等关键字段必须追问或终止。仅影响展示、默认值唯一、行为可逆且成本较低的字段,才可以自动补默认值。
可运行示例
下面根据字段策略返回三种动作:ASK_USER 表示追问,USE_DEFAULT 表示填入安全默认值,ABORT 表示终止本次调用。
function resolveMissing(policy) {
  if (!policy.required) {
    return {
      action: 'USE_DEFAULT',
      value: policy.defaultValue,
      message: '可选参数未提供'
    };
  }

  // 敏感或不可逆参数绝不能由 Agent 猜测。
  if (policy.sensitive) {
    return policy.askable
      ? { action: 'ASK_USER', message: `请明确提供 ${policy.name}` }
      : { action: 'ABORT', message: `缺少 ${policy.name},已终止调用` };
  }

  if (policy.defaultValue !== undefined) {
    return {
      action: 'USE_DEFAULT',
      value: policy.defaultValue,
      message: `${policy.name} 使用安全默认值`
    };
  }

  return policy.askable
    ? { action: 'ASK_USER', message: `请补充 ${policy.name}` }
    : { action: 'ABORT', message: `缺少 ${policy.name},且无安全默认值` };
}

const cases = [
  { name: 'recipient', required: true, sensitive: true, askable: true },
  { name: 'pageSize', required: true, defaultValue: 20 },
  { name: 'approvalToken', required: true, sensitive: true, askable: false }
];

for (const item of cases) {
  console.log(JSON.stringify(resolveMissing(item)));
}
将代码保存为 missing.js,执行 node missing.js。预期输出
{"action":"ASK_USER","message":"请明确提供 recipient"}
{"action":"USE_DEFAULT","value":20,"message":"pageSize 使用安全默认值"}
{"action":"ABORT","message":"缺少 approvalToken,已终止调用"}
读取方法:收到 ASK_USER 时暂不执行工具,只询问对应字段;收到 USE_DEFAULT 时把 value 合并到参数并披露默认行为;收到 ABORT 时结束本轮调用,不进入自动重试循环。
追问与默认值
追问应准确指出缺少什么以及期望格式。例如“要发送到哪个邮箱地址?”比“请补充信息”更容易获得可执行答案。多个字段互相关联时可以一次列出,但不得再次询问当前会话中已经确认的参数。
安全默认值应同时满足:含义唯一、范围最小、操作可逆、成本可控且用户能够看到。例如分页大小可默认 20,但删除目标、付款金额和生产环境不能设置默认值。
风险与边界
触发条件:从历史记录、模型记忆或相似字段推断高风险参数。可能后果:消息发给错误对象、操作错误环境或执行未授权动作。安全替代方案:要求用户在当前上下文明确提供,必要时增加二次确认。
触发条件:合法默认值会扩大调用范围,例如缺少时间范围时查询全部记录。可能后果:调用超时、费用增加或返回过量敏感数据。安全替代方案:采用最近 24 小时、较小分页等最小范围,并明确告知用户。
触发条件:参数持续缺失时自动重复调用。可能后果:形成无效循环并持续消耗配额。安全替代方案:相同字段只追问一次;仍无法获得有效值时返回 ABORT。
排障清单
- 日志记录每个缺失字段最终采用的动作及规则编号。
- 默认值集中配置并带版本,避免不同 Agent 节点自行定义。
- 合并用户补充参数后重新执行完整校验,不能只检查新增字段。
- 对发送、支付、删除和发布类工具,确认关键值均来自当前明确输入。
速查:影响对象、安全或不可逆结果就追问或终止;只有唯一、低风险且可披露的值才能自动补全。
在后续工具依赖前一步结果时,按依赖顺序执行并传递必要数据。
编排串行调用
当后续工具必须使用前一步结果时,按依赖顺序逐个执行;每一步只传递下一步需要的字段,任一步失败就停止后续调用,避免用无效数据继续操作。
命令定位
典型链路是“查询实体 → 提取标识 → 调用下游工具 → 汇总结果”。串行调用的关键不是工具数量,而是后一步是否依赖前一步的输出。
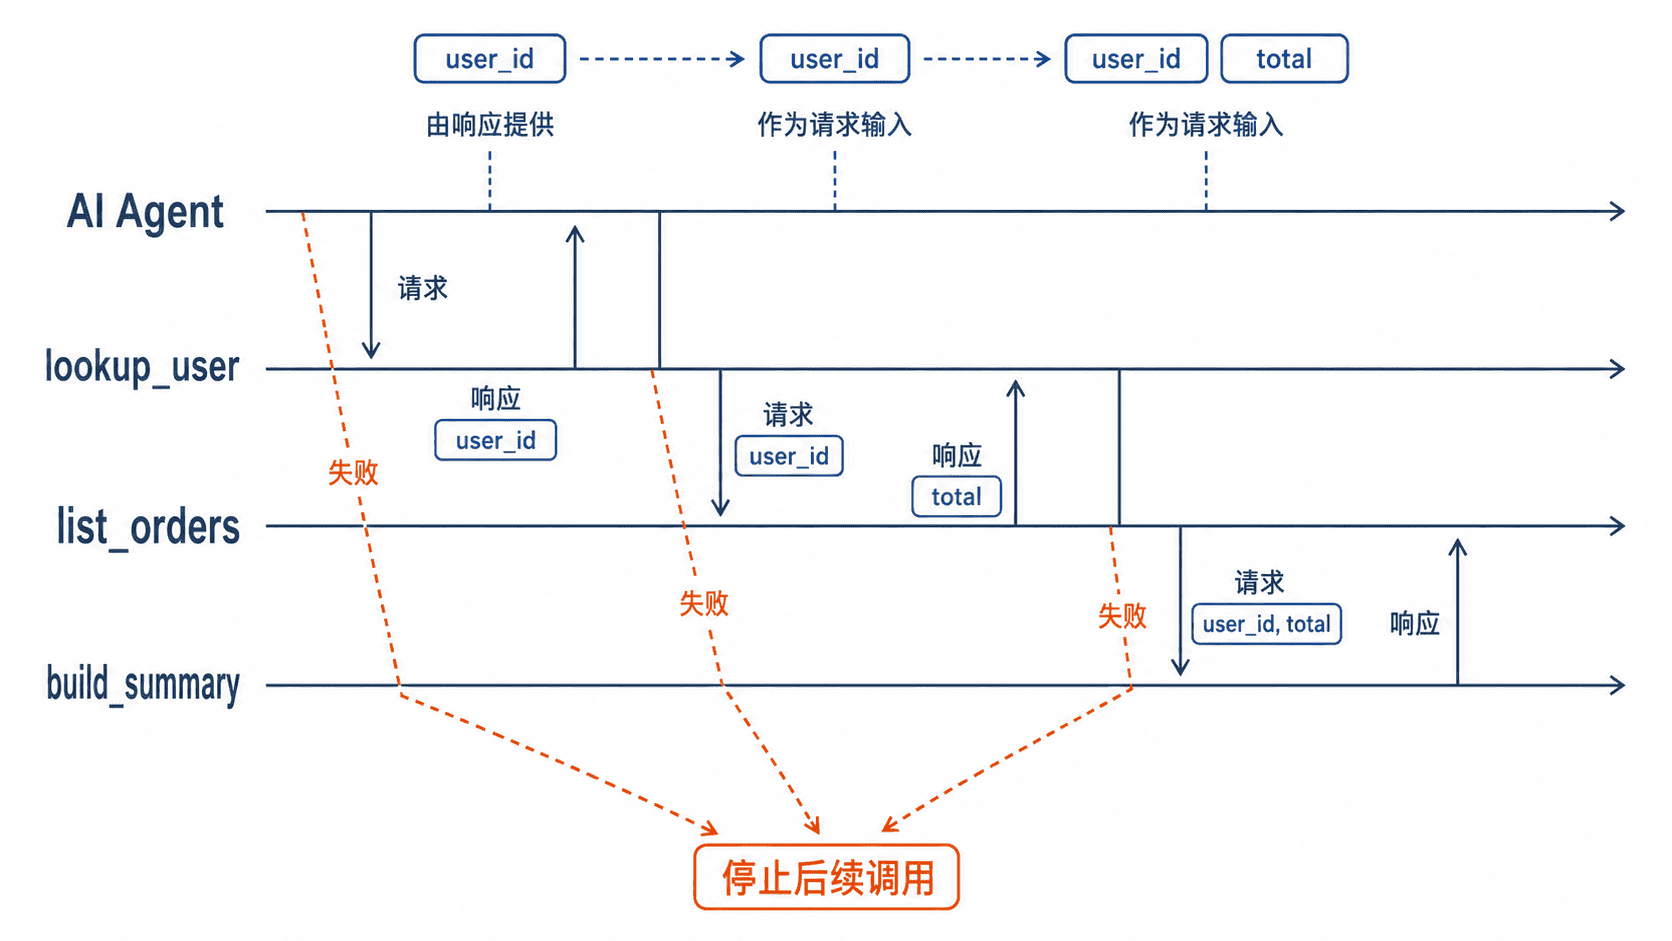
基本语法
下面用三个本地函数模拟工具。调用顺序由数据依赖决定,不能并行改写。
import json

def lookup_user(email: str) -> dict:
    return {"user_id": "u-1024", "name": "Alice"}

def list_orders(user_id: str) -> dict:
    # 下游只接收必要标识,避免传递整个用户对象
    return {"user_id": user_id, "count": 2, "total": 198.0}

def build_summary(name: str, total: float) -> dict:
    return {"message": f"{name} 的订单总额为 {total:.2f}"}

def main() -> None:
    user = lookup_user("alice@example.com")
    orders = list_orders(user["user_id"])
    summary = build_summary(user["name"], orders["total"])
    print(json.dumps(summary, ensure_ascii=False))

if __name__ == "__main__":
    main()
预期输出
{"message": "Alice 的订单总额为 198.00"}读取时确认最终结果来自 lookup_user → list_orders → build_summary,并且 user_id、total 分别被正确传入下一步。
高频用法
- 先查用户或资源 ID,再读取详情、订单或权限。
- 先上传文件,再把返回的文件地址交给解析工具。
- 先获取访问令牌,再调用受保护接口。
- 先执行只读校验,再触发扣款、发布、删除等有副作用操作。
风险与边界
当上一步返回空值、字段改名或类型不符时,继续调用会产生错误查询或误操作。安全做法是在每一步校验必需字段,并把工具输出转换为稳定的内部结构。
对有副作用的工具直接重试,可能导致重复扣款、重复创建或重复发送。应使用幂等键、执行状态记录,或先查询当前状态再决定是否重试。
不要把完整响应原样传给下游;这会放大隐私泄露、提示注入和上下文膨胀风险。只提取明确允许的字段,并限制字符串长度与数据类型。
排障清单
- 确认依赖顺序是否真实存在,能独立执行的步骤不要被误串行。
- 记录每步工具名、输入摘要、输出状态和关联 ID,不记录密钥与完整敏感内容。
- 检查失败后是否立即短路,避免下游收到
null、空字符串或旧缓存值。 - 为每一步设置独立超时;整体超时应覆盖完整链路,而不是只覆盖最后一次调用。
速查原则:先画出字段依赖,再决定顺序;没有拿到有效前置结果,就不要调用下一工具。
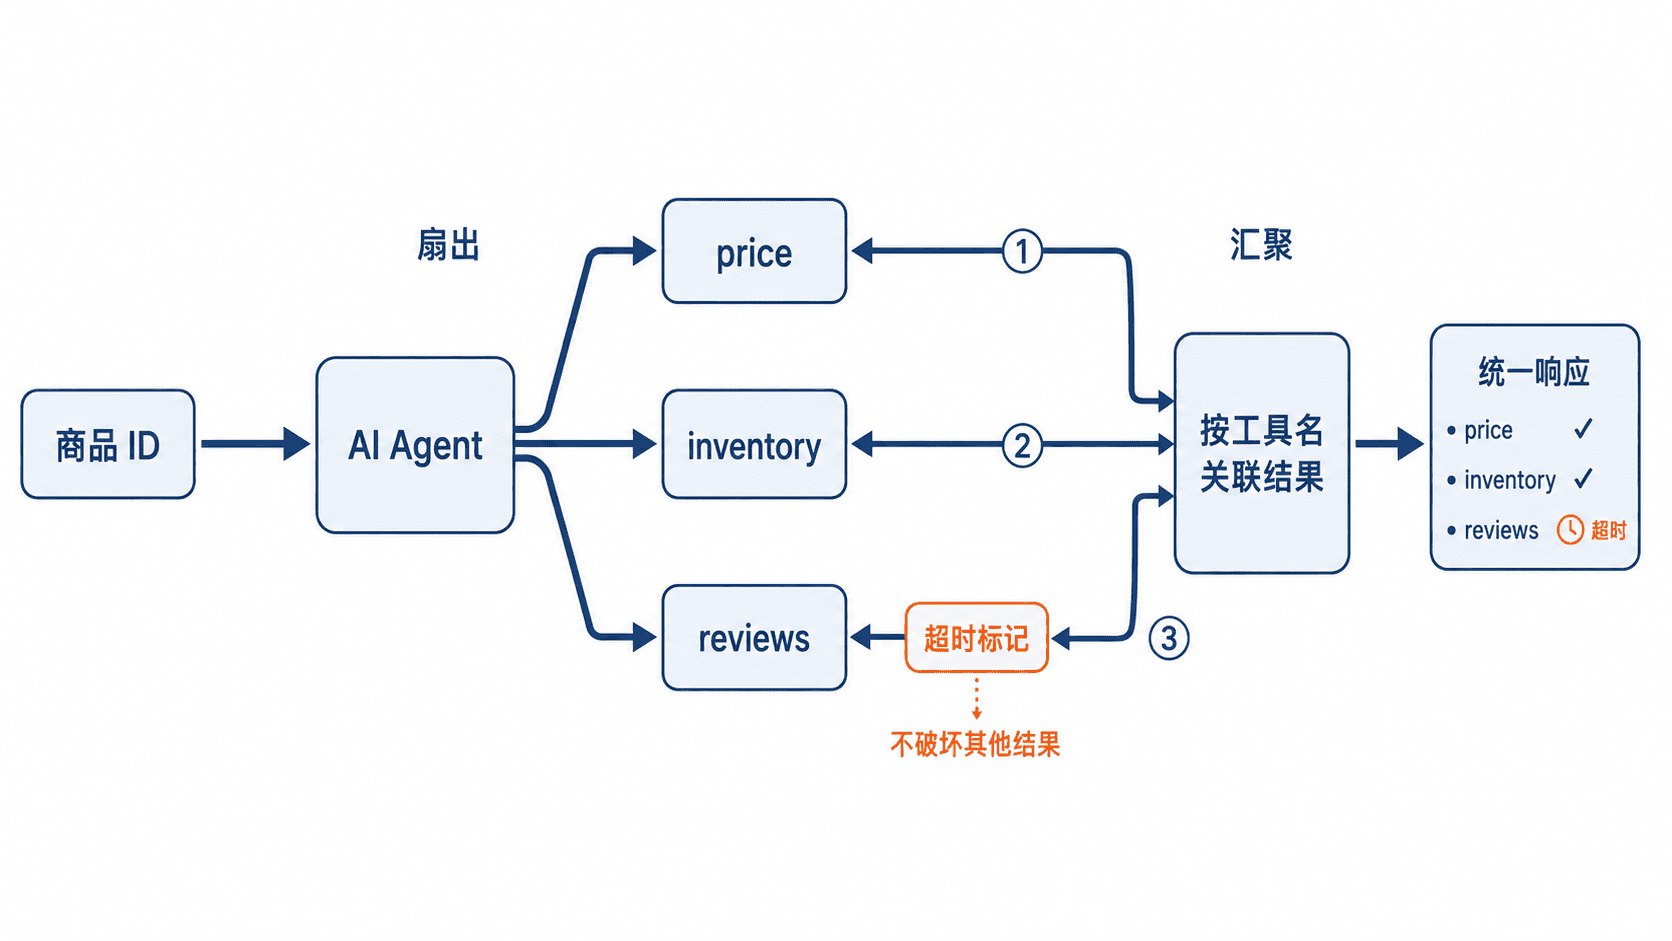
对相互独立的工具请求进行并发执行,并在结果返回后统一汇总。
执行并行调用
当多个工具互不依赖时,同时发起请求,并在全部或部分结果返回后统一汇总。这样可缩短总等待时间,但必须为每个结果保留工具标识、错误状态和超时信息。
命令定位
并行调用适合“同一输入查询多个来源”或“同时收集多个独立指标”。若工具 B 需要工具 A 的输出,就不能放入同一并行批次。
基本语法
下面使用 Python 标准库 asyncio 并发执行三个独立工具。asyncio.gather 返回值仍按任务提交顺序排列,因此汇总时使用工具名作为键,不依赖完成先后。
import asyncio
import json
from typing import Any

async def call_tool(name: str, delay: float, value: Any) -> dict:
    await asyncio.sleep(delay)
    return {"tool": name, "ok": True, "data": value}

async def main() -> None:
    tasks = [
        call_tool("price", 0.20, 99.0),
        call_tool("inventory", 0.10, 12),
        call_tool("reviews", 0.15, 4.8),
    ]
    results = await asyncio.gather(*tasks)
    merged = {item["tool"]: item["data"] for item in results}
    print(json.dumps(merged, ensure_ascii=False, sort_keys=True))

if __name__ == "__main__":
    asyncio.run(main())
预期输出
{"inventory": 12, "price": 99.0, "reviews": 4.8}读取时按键名识别来源;不要假设第一个完成的工具对应结果数组第一项。
高频用法
- 同时查询价格、库存、评价等独立信息。
- 同时调用多个搜索源,再统一去重和排序。
- 同时采集 CPU、内存、磁盘和网络指标。
- 同时执行多个只读校验,再综合决定是否继续。
输出字段说明
汇总结果至少保留 tool、ok、data 或 error。工具数量较多时再增加 request_id、duration_ms 和 timed_out,便于把异步返回与原始请求准确关联。
需要“允许部分成功”时,应把失败转换为普通结果对象,而不是让一个异常取消整个批次。需要“全有或全无”时,则应在任一失败后废弃整批结果,并明确回滚策略。
风险与边界
并发调用写操作可能同时修改同一资源,触发覆盖、重复创建或锁冲突。安全替代方案是只并发无共享状态的操作,或使用幂等键、版本号和事务协调。
无上限并发会耗尽连接池、触发工具限流或放大下游故障。应设置最大并发数、单工具超时、重试退避和整体截止时间;重试也必须计入并发上限。
直接按返回顺序拼接结果,可能把工具与数据错配。必须使用稳定的工具名或请求 ID 关联,且在汇总前校验结果类型。
排障清单
- 逐项确认工具之间没有数据依赖、顺序依赖或共享写冲突。
- 检查是否区分单个失败、部分成功和整批失败三种策略。
- 对照限流响应、连接池容量与并发上限,避免盲目增加线程或协程。
- 记录每个工具的开始时间、结束状态和请求 ID,定位慢调用而不是只看总耗时。
速查原则:独立请求才并行;并行后必须按标识汇聚,并把失败隔离在单个结果内。
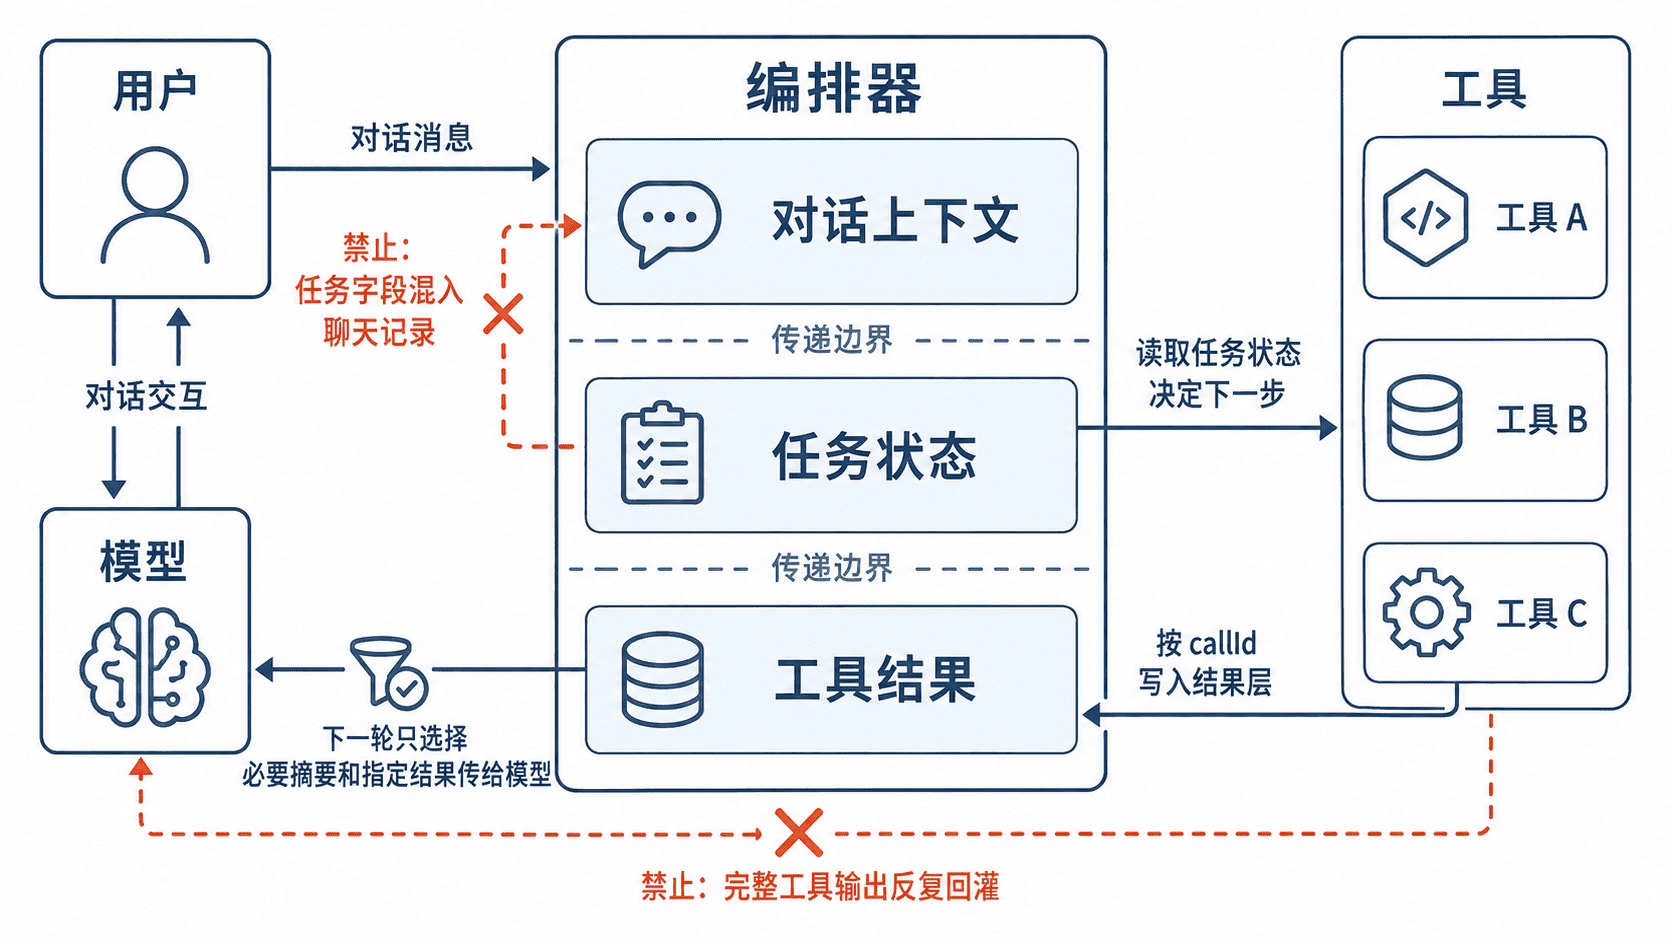
区分对话上下文、任务状态和工具结果,避免状态遗漏、污染或重复传递。
管理 Agent 状态
将 Agent 运行数据拆成对话上下文、任务状态和工具结果三层;每层只保存下一步真正需要的信息,并用调用 ID 去重,避免上下文膨胀、旧结果污染和工具重复执行。
状态分层
| 状态 | 保存内容 | 传递原则 |
|---|---|---|
| 对话上下文 | 用户意图、必要历史消息、约束 | 只传与当前决策相关的窗口或摘要 |
| 任务状态 | 当前步骤、计划、重试次数、完成标记 | 由编排器维护,不混入自然语言历史 |
| 工具结果 | callId、状态、结构化输出或结果引用 |
按需注入,禁止每轮重复附带全部结果 |
主示例
下面示例用独立字段保存三类状态,并通过 callId 拒绝重复工具结果。保存为 agent-state.js 后执行 node agent-state.js。
const state = {
  conversation: [],
  task: { step: "lookup-order", retries: 0, done: false },
  toolResults: new Map()
};

function addMessage(role, content) {
  state.conversation.push({ role, content });
}

function recordToolResult(callId, result) {
  // 同一调用只写入一次,防止重试回包覆盖已确认结果。
  if (state.toolResults.has(callId)) return false;
  state.toolResults.set(callId, result);
  return true;
}

function buildNextModelInput(requiredCallIds) {
  const recentMessages = state.conversation.slice(-4);
  const selectedResults = requiredCallIds
    .filter((id) => state.toolResults.has(id))
    .map((id) => ({ callId: id, result: state.toolResults.get(id) }));

  // 只注入当前步骤需要的状态,不直接序列化整个运行时对象。
  return {
    messages: recentMessages,
    task: { step: state.task.step, retries: state.task.retries },
    toolResults: selectedResults
  };
}

addMessage("user", "查询订单 A100");
recordToolResult("call-1", { status: "PAID", amount: 99 });
const acceptedAgain = recordToolResult("call-1", { status: "UNKNOWN" });

console.log("duplicate accepted:", acceptedAgain);
console.log(JSON.stringify(buildNextModelInput(["call-1"]), null, 2));
预期输出
duplicate accepted: false
{
  "messages": [
    {
      "role": "user",
      "content": "查询订单 A100"
    }
  ],
  "task": {
    "step": "lookup-order",
    "retries": 0
  },
  "toolResults": [
    {
      "callId": "call-1",
      "result": {
        "status": "PAID",
        "amount": 99
      }
    }
  ]
}
读取时先看 duplicate accepted 是否为 false,再确认下一轮输入只包含当前步骤和指定的 call-1 结果。
风险与边界
当工具返回大文本、二进制、密钥或个人数据时,直接写入对话上下文会造成令牌暴涨、敏感信息泄漏和后续判断偏移。安全做法是先校验和脱敏,只保存结构化摘要;大结果写入外部存储,状态中仅保留结果 ID、摘要和过期时间。
任务重试时若重新生成 callId,幂等去重会失效,可能重复扣款或重复写库。对有副作用的工具,应由业务幂等键约束执行,并把“工具是否已提交”作为任务状态单独保存。
排障清单
- 模型反复调用同一工具:检查
callId或业务幂等键是否在重试间保持稳定。 - 模型引用旧结果:检查任务切换时是否清理了步骤级结果,或是否误传了全部历史工具输出。
- 上下文持续增长:统计每轮注入的消息数和结果字节数,改为窗口、摘要或结果引用。
- 恢复执行后状态缺失:确认任务状态与工具结果已持久化,而不是只存在进程内存。
速查原则:聊天记录表达“说过什么”,任务状态表达“做到哪一步”,工具结果表达“外部执行得到了什么”。
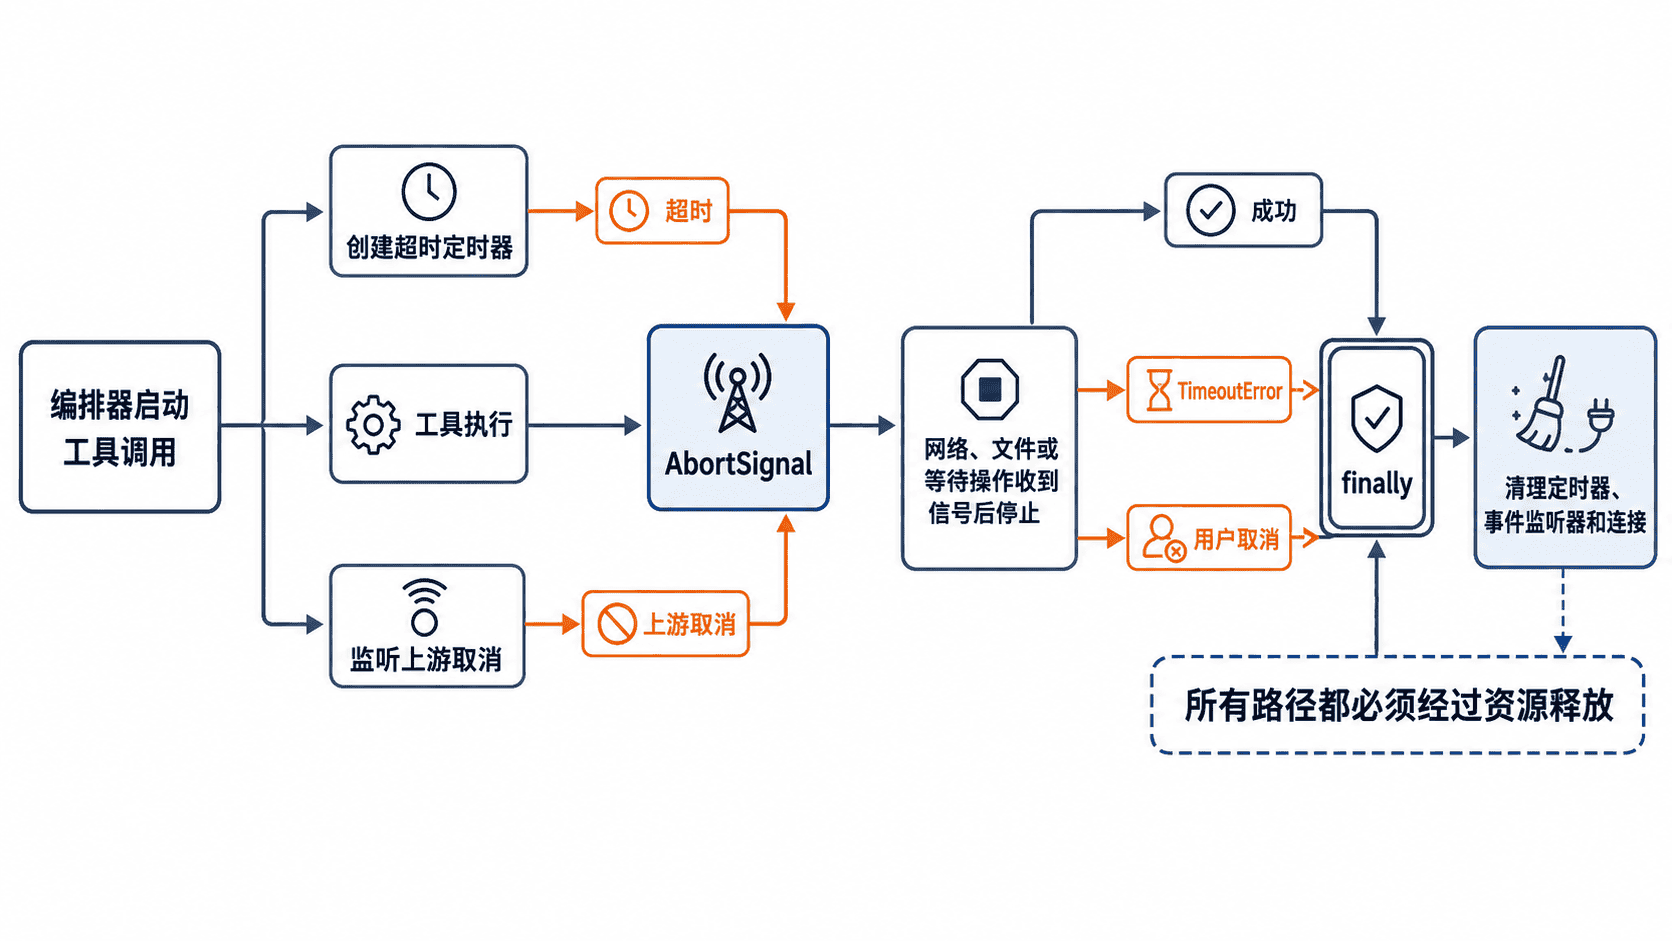
为工具执行配置超时、取消信号和资源释放机制,防止调用长期占用任务。
设置超时与取消
为每次工具调用同时接入超时信号和上游取消信号,并在 finally 中释放定时器、监听器和连接;这样无论超时、用户取消还是任务失败,都不会让调用长期占用资源。
执行模型
超时是系统主动终止,取消是上游任务主动终止,两者应汇合为同一个 AbortSignal 传给工具。工具必须在等待网络、文件或队列时响应信号,编排器则负责统一清理和错误分类。
主示例
下面示例兼容 Node.js 18+。第一次调用由 80 毫秒超时终止,第二次由上游取消信号终止。保存为 tool-timeout.js 后执行 node tool-timeout.js。
class TimeoutError extends Error {
  constructor(message) {
    super(message);
    this.name = "TimeoutError";
  }
}

function sleep(ms, signal) {
  return new Promise((resolve, reject) => {
    if (signal.aborted) return reject(signal.reason);

    const timer = setTimeout(() => {
      cleanup();
      resolve("tool completed");
    }, ms);

    const onAbort = () => {
      clearTimeout(timer);
      cleanup();
      reject(signal.reason);
    };

    const cleanup = () => signal.removeEventListener("abort", onAbort);
    signal.addEventListener("abort", onAbort, { once: true });
  });
}

async function executeWithTimeout(tool, { timeoutMs, parentSignal }) {
  const controller = new AbortController();
  const timeoutId = setTimeout(
    () => controller.abort(new TimeoutError(`tool exceeded ${timeoutMs} ms`)),
    timeoutMs
  );

  const onParentAbort = () =>
    controller.abort(parentSignal.reason ?? new Error("canceled"));

  if (parentSignal) {
    if (parentSignal.aborted) onParentAbort();
    else parentSignal.addEventListener("abort", onParentAbort, { once: true });
  }

  try {
    return await tool(controller.signal);
  } finally {
    // 无论成功、超时还是取消,都移除本次调用创建的资源。
    clearTimeout(timeoutId);
    parentSignal?.removeEventListener("abort", onParentAbort);
  }
}

async function main() {
  try {
    await executeWithTimeout((signal) => sleep(500, signal), { timeoutMs: 80 });
  } catch (error) {
    console.log(`timeout: ${error.name}: ${error.message}`);
  }

  const parent = new AbortController();
  setTimeout(() => parent.abort(new Error("user canceled")), 30);

  try {
    await executeWithTimeout((signal) => sleep(500, signal), {
      timeoutMs: 1000,
      parentSignal: parent.signal
    });
  } catch (error) {
    console.log(`cancel: ${error.name}: ${error.message}`);
  }
}

main().catch(console.error);
预期输出
timeout: TimeoutError: tool exceeded 80 ms
cancel: Error: user canceled
两行分别验证超时和上游取消路径。实际执行时间会有少量调度误差,但错误类型和消息应一致。
参数与错误分类
timeoutMs:单次工具调用的最长占用时间,应小于任务总超时,并预留重试和结果处理时间。parentSignal:由用户取消、任务终止或服务关闭触发;必须向下传到 HTTP、数据库或子进程 API。TimeoutError:可按策略重试,但要设置最大次数和退避。- 用户取消:通常不重试,也不应记录为系统故障。
风险与边界
只用 Promise.race 返回超时错误但不取消底层操作时,请求、子进程或文件读取仍会继续,可能耗尽连接池和工作线程。安全替代是把 AbortSignal 传到实际 I/O,并在取消后关闭流、套接字或子进程。
超时后立即重试有副作用的工具,可能产生重复写入。应先使用幂等键,再根据工具是否已提交决定重试;无法确认执行结果时进入人工核对或补偿流程。
排障清单
- 已返回超时但资源仍上涨:检查底层库是否真正支持取消,以及连接是否在
finally中释放。 - 取消无效:检查信号是否逐层传递到最终 I/O,而不是只停在编排器。
- 偶发重复执行:检查超时后的首次调用是否仍在后台完成,并为写操作增加幂等键。
- 大量误超时:分别记录排队、连接、服务处理和结果解析耗时,不要只看总时长。
速查原则:超时负责限定最长占用,取消负责响应上游意图,资源释放必须覆盖所有退出路径。
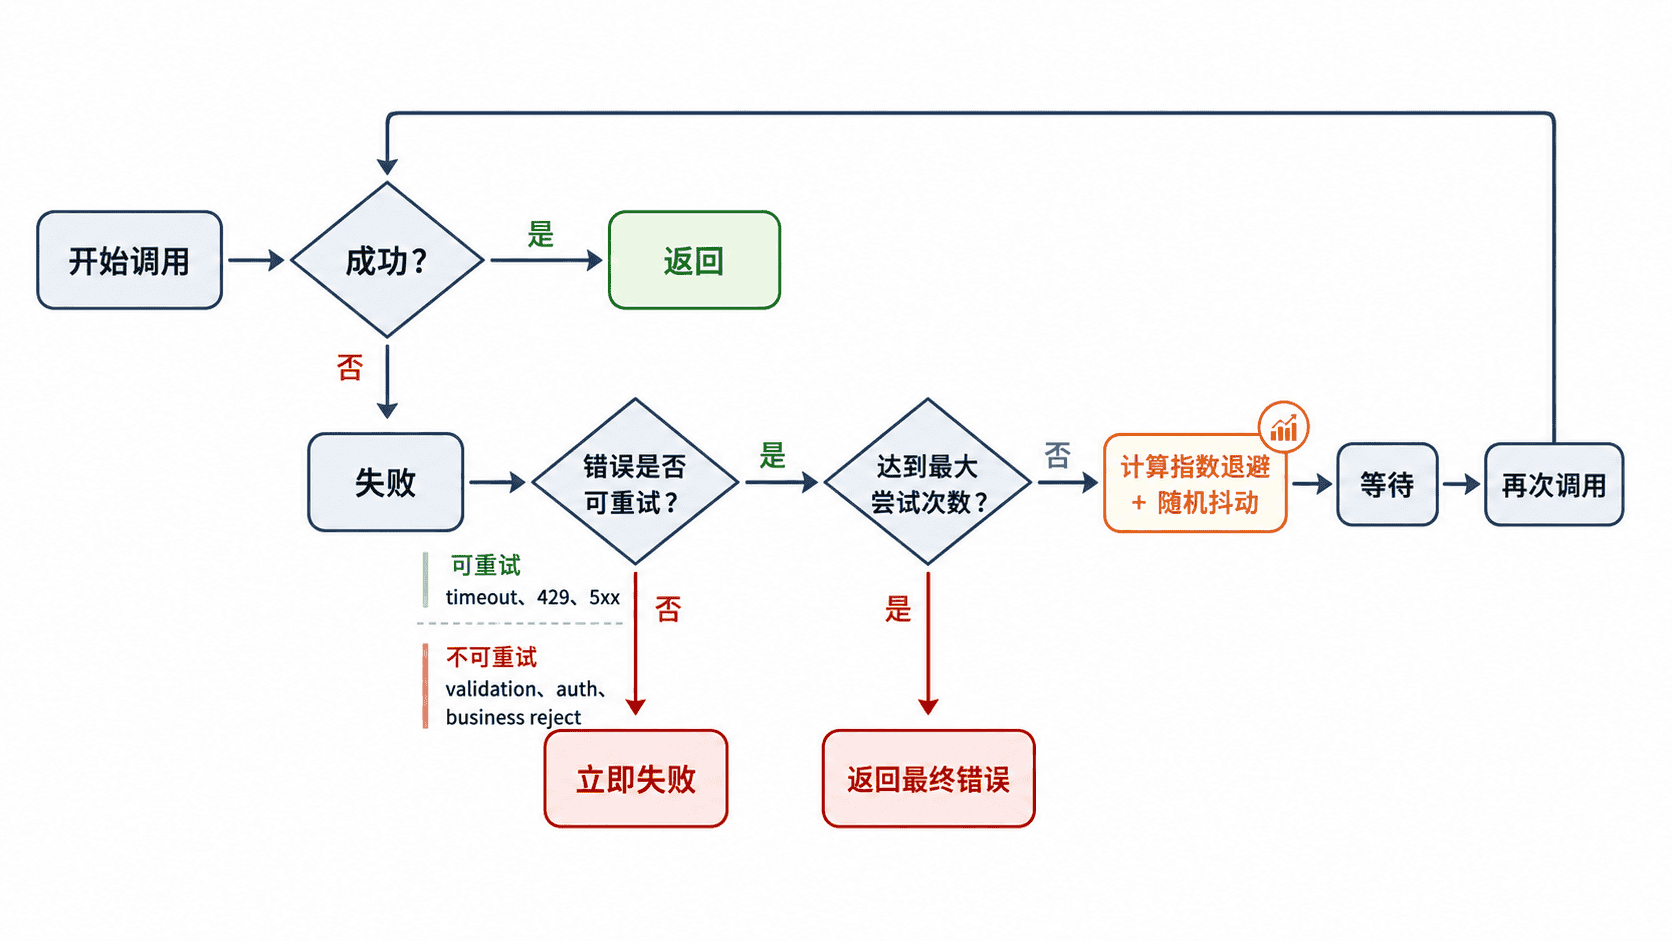
仅对适合重试的临时错误应用次数限制、指数退避和抖动策略。
配置重试与退避
用于工具调用遇到短暂网络抖动、限流或服务端临时故障时自动恢复。核心规则是:只重试可恢复错误,限制总尝试次数,并用指数退避加抖动分散并发重试。
适用范围
可重试错误通常包括连接超时、连接重置、HTTP 429、502、503、504,以及工具明确返回的临时不可用状态。参数校验失败、权限不足、余额不足、业务拒绝等确定性错误不应重试,否则只会放大流量和延迟。
推荐同时设置三个上限:maxAttempts 控制总尝试次数,baseDelay 控制初始等待,maxDelay 限制最长等待。单次调用还要有独立超时,整个任务再设置总截止时间,避免重试链无限拖长。
基本策略
常用退避上限可按下面的方式计算,其中 attempt 从 1 开始:
delay = min(maxDelay, baseDelay × 2^(attempt - 1))
再使用完整抖动,把实际等待随机取在 0 到 delay 之间。完整抖动比所有请求等待同一个固定时间更能避免“惊群式”同时重试。
可运行示例
下面模拟前两次调用分别返回 503 和超时,第三次成功。固定随机种子只为让示例输出可复现,生产环境不要固定种子。
import random
import time

class RetryableError(Exception):
    pass

outcomes = [
    RetryableError("HTTP 503"),
    RetryableError("timeout"),
    {"result": "ok"},
]

def call_tool():
    outcome = outcomes.pop(0)
    if isinstance(outcome, Exception):
        raise outcome
    return outcome

def call_with_retry(max_attempts=3, base_delay=0.5, max_delay=4.0):
    rng = random.Random(42)

    for attempt in range(1, max_attempts + 1):
        try:
            result = call_tool()
            print(f"attempt={attempt} result={result['result']}")
            return result
        except RetryableError as exc:
            if attempt == max_attempts:
                print(f"attempt={attempt} exhausted error={exc}")
                raise

            # 指数退避决定等待上限,完整抖动避免并发请求同时醒来。
            delay_cap = min(max_delay, base_delay * 2 ** (attempt - 1))
            sleep_seconds = rng.uniform(0, delay_cap)
            print(
                f"attempt={attempt} retryable={exc} "
                f"backoff={sleep_seconds:.2f}s"
            )
            time.sleep(sleep_seconds)

call_with_retry()
预期输出
attempt=1 retryable=HTTP 503 backoff=0.32s
attempt=2 retryable=timeout backoff=0.03s
attempt=3 result=ok
实际生产中的等待值会因随机抖动而不同;读取时重点看 attempt、错误分类和 backoff,确认重试次数未超限且非重试错误没有进入循环。
风险与边界
触发重试但调用本身不是幂等操作时,超时可能发生在“服务端已成功、客户端未收到响应”之后,继续重试会造成重复支付、重复写入或重复通知。安全替代方案是先为写操作配置幂等键,再启用重试。
退避只限制请求频率,不能替代熔断和并发隔离。下游持续故障时,大量任务仍可能占满线程、连接池或执行配额;应同时设置总截止时间、并发上限,并在连续失败达到阈值后快速失败。
不要机械重试所有 4xx。只有服务明确约定可重试的状态,例如带 Retry-After 的 429,才按响应提示等待;400、401、403 和多数 404 应先修正请求或权限。
排障清单
- 查看日志是否记录请求标识、工具名、尝试次数、错误分类、单次耗时和退避时长。
- 确认最大尝试次数包含首次调用,避免把“重试 3 次”误实现为总共调用 4 次。
- 检查 SDK 是否已经内置重试,防止 Agent 层与客户端层叠加后指数放大调用次数。
- 发现大量任务同时重试时,优先确认是否缺少抖动、是否忽略
Retry-After,以及并发上限是否生效。
速查:先分类错误,再限次退避;写操作没有幂等保护时,不要直接开启自动重试。
使用幂等键、请求标识和去重记录,避免重试导致重复支付、写入或通知。
保证调用幂等
用于可能被重试、重复投递或并发提交的写操作,确保同一个业务请求只产生一次副作用。支付、建单、发券、扣库存和发送通知都应在工具接口层明确幂等语义。
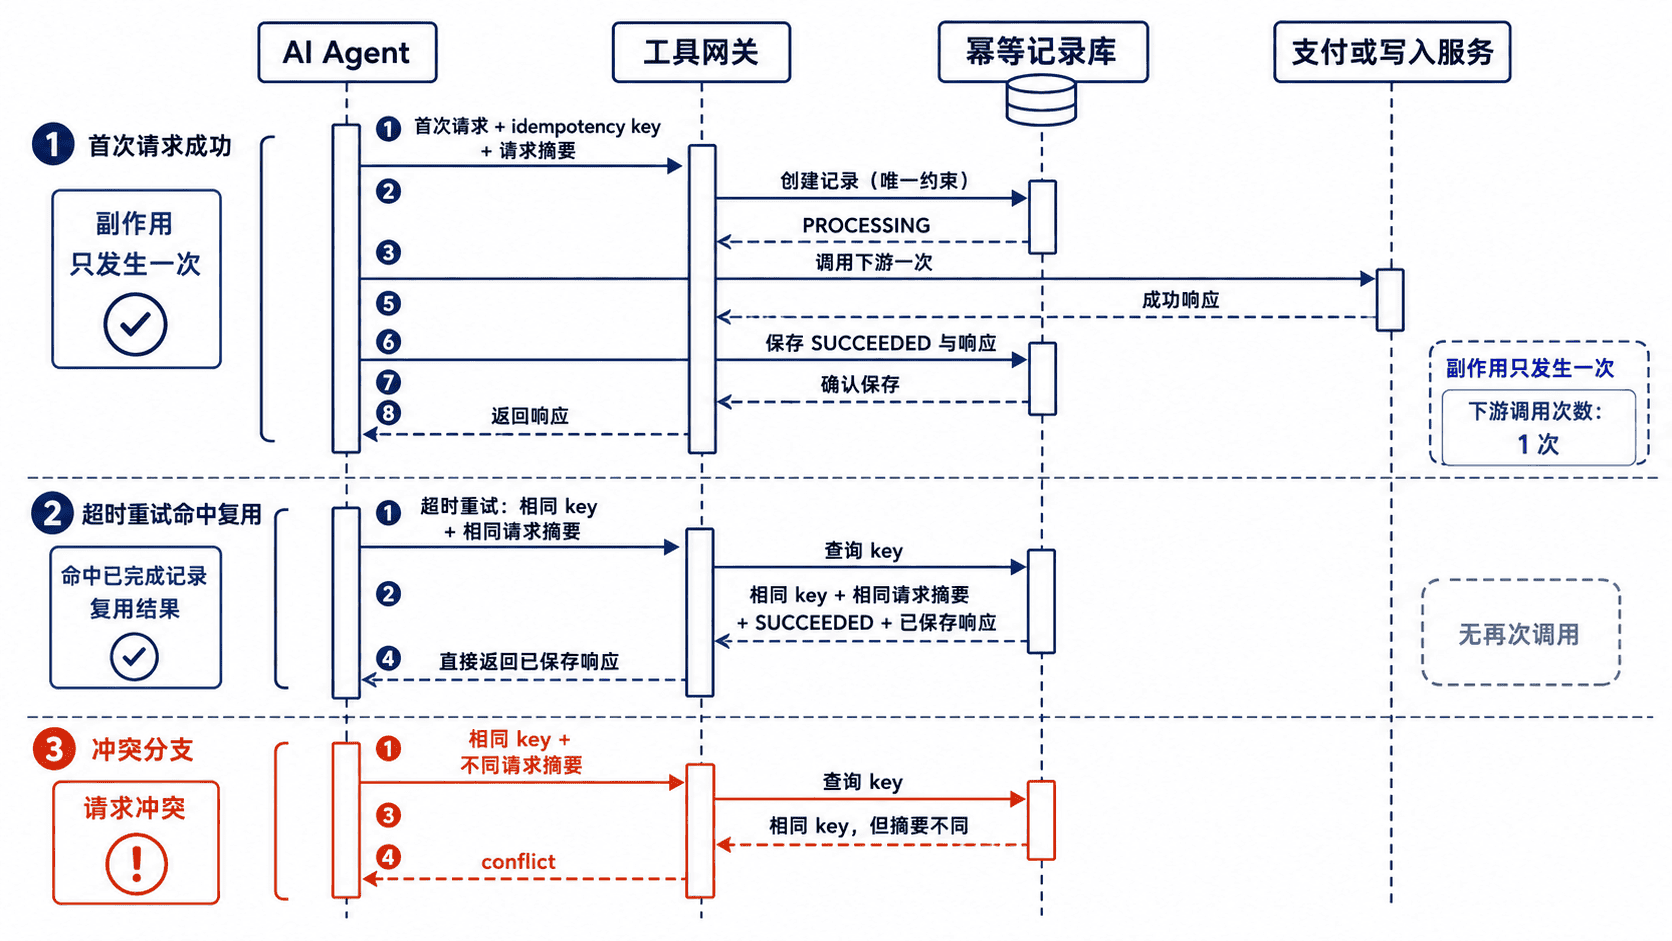
幂等协议
客户端为一次业务意图生成稳定的幂等键,例如 tenantId + operation + businessOrderNo。同一次重试必须复用原键,不同业务请求必须使用新键。
服务端收到请求后,应原子写入幂等记录并依赖唯一约束抢占执行权。记录至少保存幂等键、请求摘要、处理状态、最终响应和过期时间:
- 首次请求:创建
PROCESSING记录并执行副作用。 - 相同键、相同请求摘要:处理中则返回明确状态,成功后返回缓存结果。
- 相同键、不同请求摘要:拒绝请求,通常返回冲突错误。
- 执行失败:区分可安全重试和需要人工确认的未知状态。
可运行示例
下面使用 SQLite 的主键唯一约束模拟幂等记录。第一次调用创建支付,第二次使用相同键和相同参数时直接复用结果。
import hashlib
import json
import sqlite3

conn = sqlite3.connect(":memory:")
conn.execute(
    """
    CREATE TABLE idempotency_record (
        idempotency_key TEXT PRIMARY KEY,
        request_hash TEXT NOT NULL,
        status TEXT NOT NULL,
        response_json TEXT
    )
    """
)

def request_hash(payload):
    canonical = json.dumps(payload, sort_keys=True, separators=(",", ":"))
    return hashlib.sha256(canonical.encode("utf-8")).hexdigest()

def create_payment(idempotency_key, payload):
    digest = request_hash(payload)

    try:
        # 唯一约束保证并发请求中只有一个调用获得执行权。
        conn.execute(
            """
            INSERT INTO idempotency_record
                (idempotency_key, request_hash, status, response_json)
            VALUES (?, ?, 'PROCESSING', NULL)
            """,
            (idempotency_key, digest),
        )
        conn.commit()
    except sqlite3.IntegrityError:
        stored_hash, status, response_json = conn.execute(
            """
            SELECT request_hash, status, response_json
            FROM idempotency_record
            WHERE idempotency_key = ?
            """,
            (idempotency_key,),
        ).fetchone()

        if stored_hash != digest:
            raise ValueError("same key used with different request")
        if status == "SUCCEEDED":
            print(f"replay hit key={idempotency_key}")
            return json.loads(response_json)
        raise RuntimeError("request is still processing")

    # 只有首次请求会执行真实副作用。
    response = {
        "paymentId": "<ID>",
        "status": "SUCCEEDED",
        "amount": payload["amount"],
    }
    conn.execute(
        """
        UPDATE idempotency_record
        SET status = 'SUCCEEDED', response_json = ?
        WHERE idempotency_key = ?
        """,
        (json.dumps(response), idempotency_key),
    )
    conn.commit()
    print(f"created payment {response['paymentId']}")
    return response

payload = {"merchantOrderNo": "order-<ID>", "amount": 100}
key = "payment-order-<ID>"

print(create_payment(key, payload))
print(create_payment(key, payload))
预期输出
created payment <ID>
{'paymentId': '<ID>', 'status': 'SUCCEEDED', 'amount': 100}
replay hit key=payment-order-<ID>
{'paymentId': '<ID>', 'status': 'SUCCEEDED', 'amount': 100}
读取时确认第二次调用出现 replay hit,且没有再次输出 created payment。生产环境中的 <ID> 应替换为真实支付单号或业务请求标识。
风险与边界
只在副作用执行完成后才写幂等记录,会留下崩溃窗口:下游已经成功,但服务在保存结果前宕机,重试后可能再次执行。安全替代方案是先原子抢占幂等记录,再通过本地事务、事务消息或 Outbox 将状态变更与副作用可靠衔接。
幂等键复用范围过大会把不同业务请求误判为同一请求;范围过小又无法去重。应把租户、操作类型和稳定业务编号纳入键,并保存请求摘要。相同键对应不同摘要时必须拒绝,不能直接返回旧结果。
记录过期时间短于消息最大重投周期或客户端重试窗口时,旧请求可能在记录删除后再次执行。TTL 应覆盖最长重试、补偿和消息保留周期;高价值交易还应保留长期业务唯一约束。
PROCESSING 状态不能无限存在。执行节点崩溃后需要租约、超时接管或人工确认机制,但接管前必须先判断下游是否已经成功,不能简单删除记录后重跑。
排障清单
- 查询同一幂等键是否存在多条业务结果;若存在,优先检查数据库唯一约束是否缺失或未命中。
- 检查相同键是否携带不同请求参数,并确认请求摘要覆盖金额、收款方、业务订单号等关键字段。
- 发现请求长期停在
PROCESSING时,核对执行租约、超时接管和下游结果查询是否完整。 - 确认最终响应已经持久化;只保存“已处理”标记而不保存结果,会让重试方无法获得一致响应。
- 核对幂等记录 TTL 是否短于队列重投、客户端超时重试或人工补单窗口。
速查:唯一约束负责抢占,请求摘要防止错配,持久化结果负责安全复用;三者缺一都可能产生重复副作用。
将错误分类为参数、权限、网络、限流和业务错误,并选择修正、重试、降级或终止。
处理工具失败
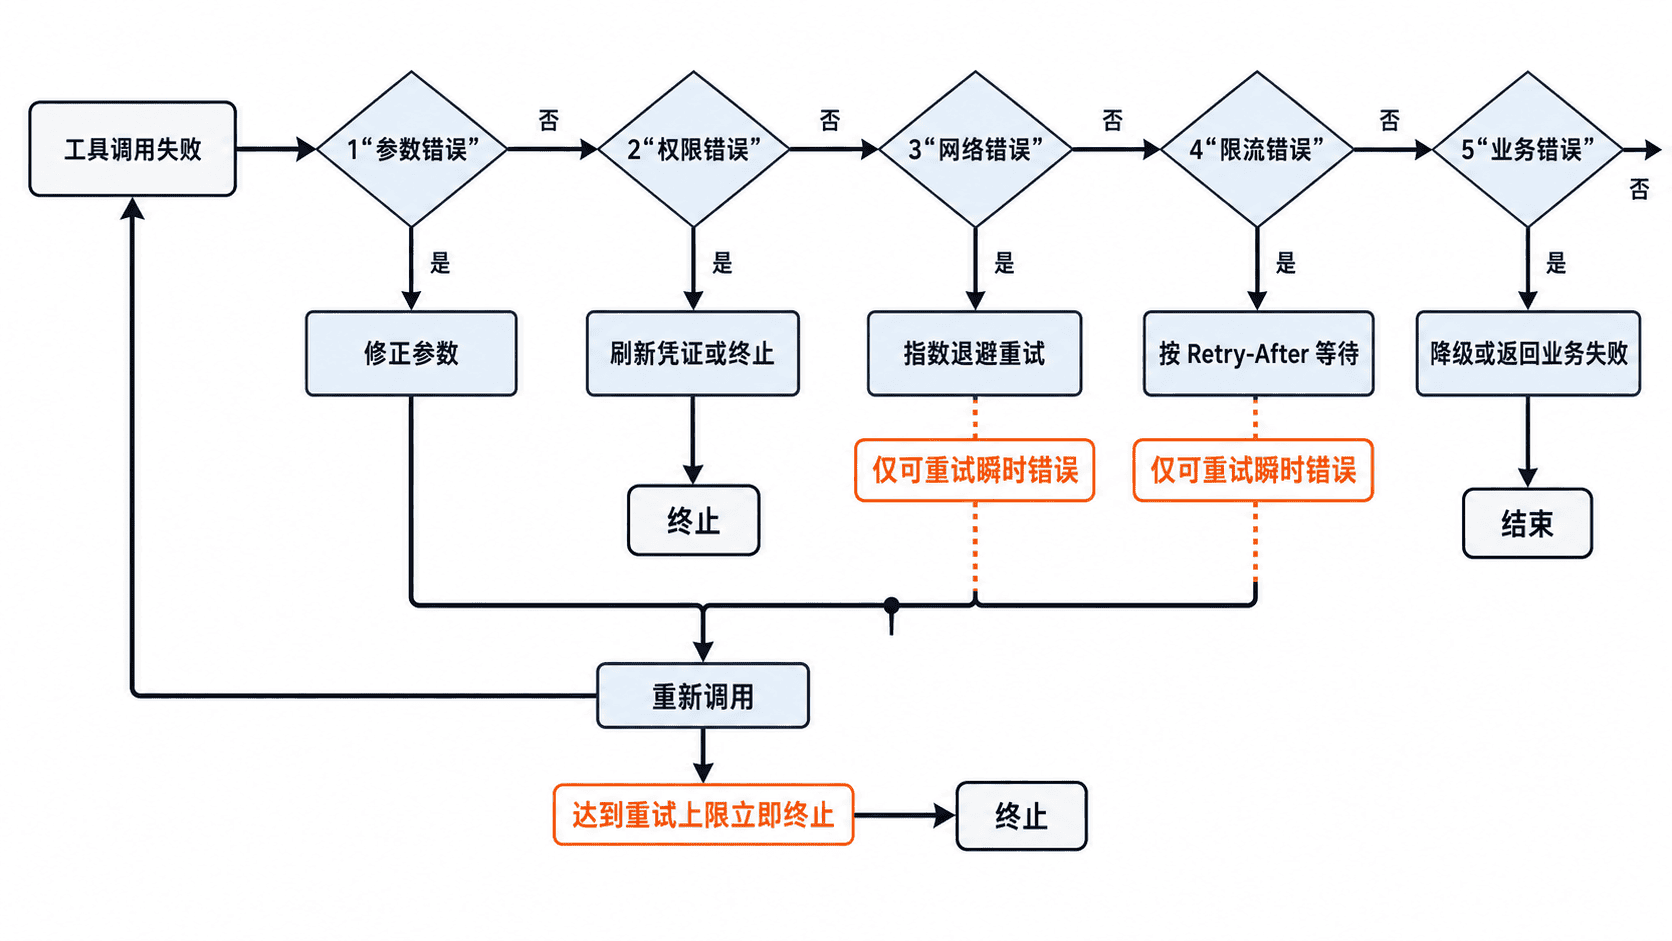
工具调用失败后,先判定错误类型,再决定修正参数、有限重试、降级或终止。核心目标是避免把不可重试错误反复执行,也避免一次瞬时网络故障直接中断任务。
错误分类
| 类型 | 常见信号 | 推荐动作 |
|---|---|---|
| 参数错误 | 400、字段缺失、类型不匹配 |
修正参数后最多重试一次 |
| 权限错误 | 401、403、凭证过期 |
刷新凭证;无法恢复则终止 |
| 网络错误 | 超时、连接重置、DNS 失败 | 指数退避重试,并设置总时限 |
| 限流错误 | 429、Retry-After |
按服务端等待时间重试 |
| 业务错误 | 库存不足、状态冲突、额度不足 | 改走业务分支或明确告知失败 |
可运行策略示例
下面的 Python 示例把错误映射为统一类别,并只对网络错误和限流错误重试。参数、权限和业务错误立即返回给上层决策器。
import time
from dataclasses import dataclass

@dataclass
class ToolError(Exception):
    kind: str
    message: str
    retry_after: float = 0.0

def call_tool(attempt: int) -> str:
    # 模拟前两次网络失败,第三次成功。
    if attempt < 3:
        raise ToolError("network", "connection reset")
    return "order-<ID>"

def run_with_policy(max_attempts: int = 3) -> str:
    for attempt in range(1, max_attempts + 1):
        try:
            result = call_tool(attempt)
            return f"SUCCESS: {result}"
        except ToolError as exc:
            print(f"attempt={attempt} kind={exc.kind} message={exc.message}")

            if exc.kind not in {"network", "rate_limit"}:
                return f"STOP: non-retryable {exc.kind}"

            if attempt == max_attempts:
                return "STOP: retry limit reached"

            delay = exc.retry_after or min(2 ** (attempt - 1), 4)
            time.sleep(delay)

    return "STOP: unexpected state"

print(run_with_policy())
预期输出
attempt=1 kind=network message=connection reset
attempt=2 kind=network message=connection reset
SUCCESS: order-<ID>
实际退避时间、订单 ID 和错误文本可能不同;读取时重点关注 kind、当前 attempt 和最终 SUCCESS 或 STOP。
风险与边界
当错误来源是参数、权限或确定性的业务规则时继续重试,会造成重复请求、额外费用或账号封禁。安全做法是把这三类标记为不可重试,并将结构化错误返回给规划器。
当工具具有写入副作用时,网络超时并不等于服务端未执行。重试前应携带幂等键或先查询执行结果,避免重复扣款、重复发消息或重复创建资源。
限流重试必须同时受最大次数和总耗时约束。服务端提供 Retry-After 时优先遵循;没有该字段时再使用带抖动的指数退避。
排障清单
- 记录工具名、参数摘要、错误类别、状态码、调用次数和请求 ID。
- 检查是否把
4xx统一误判为可重试。 - 确认写操作是否支持幂等键或结果查询。
- 验证降级结果是否明确标注为不完整,避免被后续步骤当成成功数据。
- 达到次数或时间上限后必须返回终止原因,不得静默继续循环。
设置最大调用次数、重复调用检测和停止条件,防止 Agent 陷入无限循环。
限制调用循环
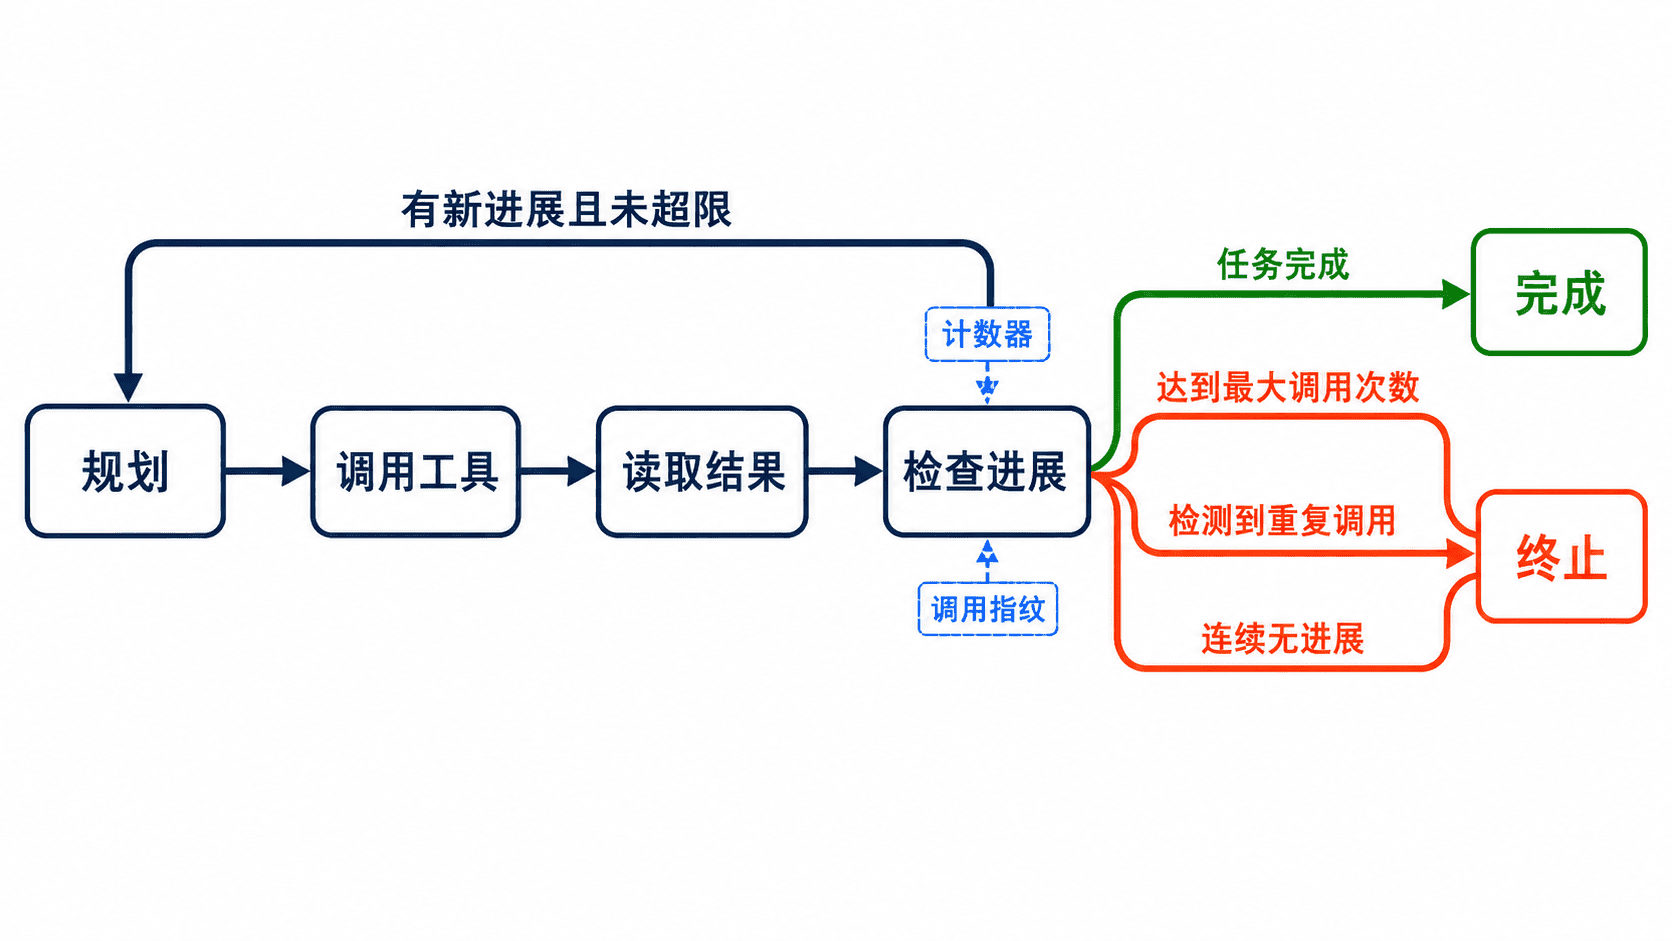
Agent 连续调用工具时,必须同时设置最大调用次数、重复调用检测和明确停止条件。任何一项缺失,都可能让模型在相同参数、相同错误或无进展状态中无限循环。
停止规则
至少配置以下三类保护:
- 最大调用次数:限制单次任务可触发的工具总数,例如 8 次。
- 重复调用阈值:同一工具与等价参数连续出现 2 次或 3 次时停止。
- 无进展检测:结果摘要、关键状态或待办集合连续不变时停止。
正常停止条件应包括任务已完成、用户要求终止、出现不可恢复错误、达到预算上限和需要人工确认。
可运行守卫示例
调用指纹由工具名和排序后的参数组成。示例在同一调用连续出现两次时终止,并且仍保留总调用次数上限。
import json
from collections import Counter
from typing import Any

def fingerprint(tool_name: str, arguments: dict[str, Any]) -> str:
    normalized = json.dumps(arguments, sort_keys=True, separators=(",", ":"))
    return f"{tool_name}:{normalized}"

def run_agent(planned_calls: list[tuple[str, dict[str, Any]]]) -> None:
    max_calls = 5
    duplicate_limit = 2
    seen: Counter[str] = Counter()

    for index, (tool_name, arguments) in enumerate(planned_calls, start=1):
        if index > max_calls:
            print("STOP: max tool calls reached")
            return

        call_id = fingerprint(tool_name, arguments)
        seen[call_id] += 1

        print(f"call={index} tool={tool_name} args={arguments}")

        if seen[call_id] >= duplicate_limit:
            print("STOP: repeated tool call detected")
            return

        # 生产环境应在这里执行工具,并更新可比较的进展状态。
        print("result=temporary failure")

    print("STOP: no more planned calls")

calls = [
    ("search_order", {"order_id": "<ID>"}),
    ("search_order", {"order_id": "<ID>"}),
    ("notify_user", {"message": "not found"}),
]

run_agent(calls)
预期输出
call=1 tool=search_order args={'order_id': '<ID>'}
result=temporary failure
call=2 tool=search_order args={'order_id': '<ID>'}
STOP: repeated tool call detected
读取时先看 call 是否接近上限,再看停止原因。真实系统还应记录任务 ID、累计耗时和成本;动态 ID 使用实际值替换 <ID>。
进展判定
不要只比较模型生成的自然语言,因为同一含义可能被改写。优先比较结构化状态,例如剩余待办数、已获取字段集合、资源版本号或规范化后的工具结果摘要。
当工具结果本身会变化时,重复调用不一定是死循环。例如轮询异步任务可以重复调用,但必须设置最晚截止时间、最小轮询间隔,并在状态进入 SUCCEEDED、FAILED 或 CANCELLED 时停止。
风险与边界
最大次数过大时,错误循环会放大费用、限流和副作用;过小时,正常的多步任务会被提前截断。安全做法是按任务类型配置上限,并额外设置总耗时和成本预算。
重复检测只比较原始 JSON 字符串时,参数顺序不同会绕过限制。应先排序键、移除无关动态字段,再生成指纹;但不要移除会改变业务含义的时间、租户或资源标识。
写操作再次执行前必须验证幂等性。无法确认幂等时,应停止并请求人工确认,而不是依靠循环上限承担风险。
排障清单
- 检查调用计数是否覆盖所有工具,而不是只统计成功调用。
- 确认重复指纹经过稳定序列化,且参数等价时结果一致。
- 为轮询任务配置截止时间和最小间隔。
- 连续无进展时记录前后状态差异,便于定位规划器为何未改变策略。
- 终止时返回明确原因和最后一次工具结果,避免上层再次从头执行。