
MySQL / 技术文章
MySQL 集群方案选型与落地指南
本文解决“MySQL 集群该选哪一种、怎样避免选型后才发现一致性或运维成本不合适”的问题,适合负责中小型到中大型 OLTP 系统的开发、架构和运维人员。读完后可按业务的 RPO、RTO、写入规模与团队能力,确定一套可落地的高可用方案和验收清单。
先确定集群要解决什么
“MySQL 集群”可能同时指高可用、读扩展、写扩展和容灾,但四个目标不能由同一套组件自动全部实现。选型前应先把需求写成可验证指标:
- RPO:故障后最多允许丢失多少已确认事务。
- RTO:从故障发生到恢复服务可接受多长时间。
- 读写模型:读多写少、单点写入,还是存在多个写入口。
- 故障范围:仅防进程和主机故障,还是要覆盖机房、地域和人为误操作。
- 运维能力:团队是否能维护仲裁、代理、自动切换、备份与演练体系。
高可用不等于备份。副本会同步误删和错误更新,真正的生产方案必须同时包含集群、备份、恢复演练和变更审计。
常见方案如何取舍
| 方案 | 核心组件 | 主要优势 | 主要限制 | 适合场景 |
|---|---|---|---|---|
| 主从复制 + 半同步 + Orchestrator/ProxySQL | MySQL 复制、故障检测、连接代理 | 架构成熟,读扩展灵活,改造成本低 | 自动切换链路较长,极端故障仍可能出现数据缺口 | 大多数互联网 OLTP、读多写少系统 |
| InnoDB Cluster | Group Replication、MySQL Router、MySQL Shell | 官方组件闭环,成员管理和故障转移较统一 | 对网络稳定性、事务大小和运维规范要求较高 | 希望使用官方高可用栈的新系统 |
| Percona XtraDB Cluster | Galera/PXC、负载入口 | 基于认证复制,节点间一致性较强 | 写延迟受最慢节点影响,多写容易冲突 | 对 RPO 要求高、同城低延迟部署 |
| MySQL NDB Cluster | SQL 节点、数据节点、管理节点 | 高并发、分布式内存与快速故障恢复 | 数据模型、运维方式与 InnoDB 差异大 | 电信、实时计费等专门场景 |
| 分库分表或分布式数据库 | 中间件或分布式存储 | 突破单机容量和写入上限 | SQL、事务、迁移和治理复杂度显著上升 | 单主写入已成为真实容量瓶颈 |
技术上支持多主写入,不代表业务应该同时向多个节点写。没有天然分区键和冲突规避规则时,单写入口通常更稳定,也更容易审计和回滚。
推荐的生产落地结构
对多数业务,优先采用“单主写入、多个只读副本、代理统一入口、自动故障转移、独立备份”的结构。应用只连接 ProxySQL 或 MySQL Router,不直接保存某个数据库节点地址;故障管理组件负责选主,代理负责刷新写节点和读节点。
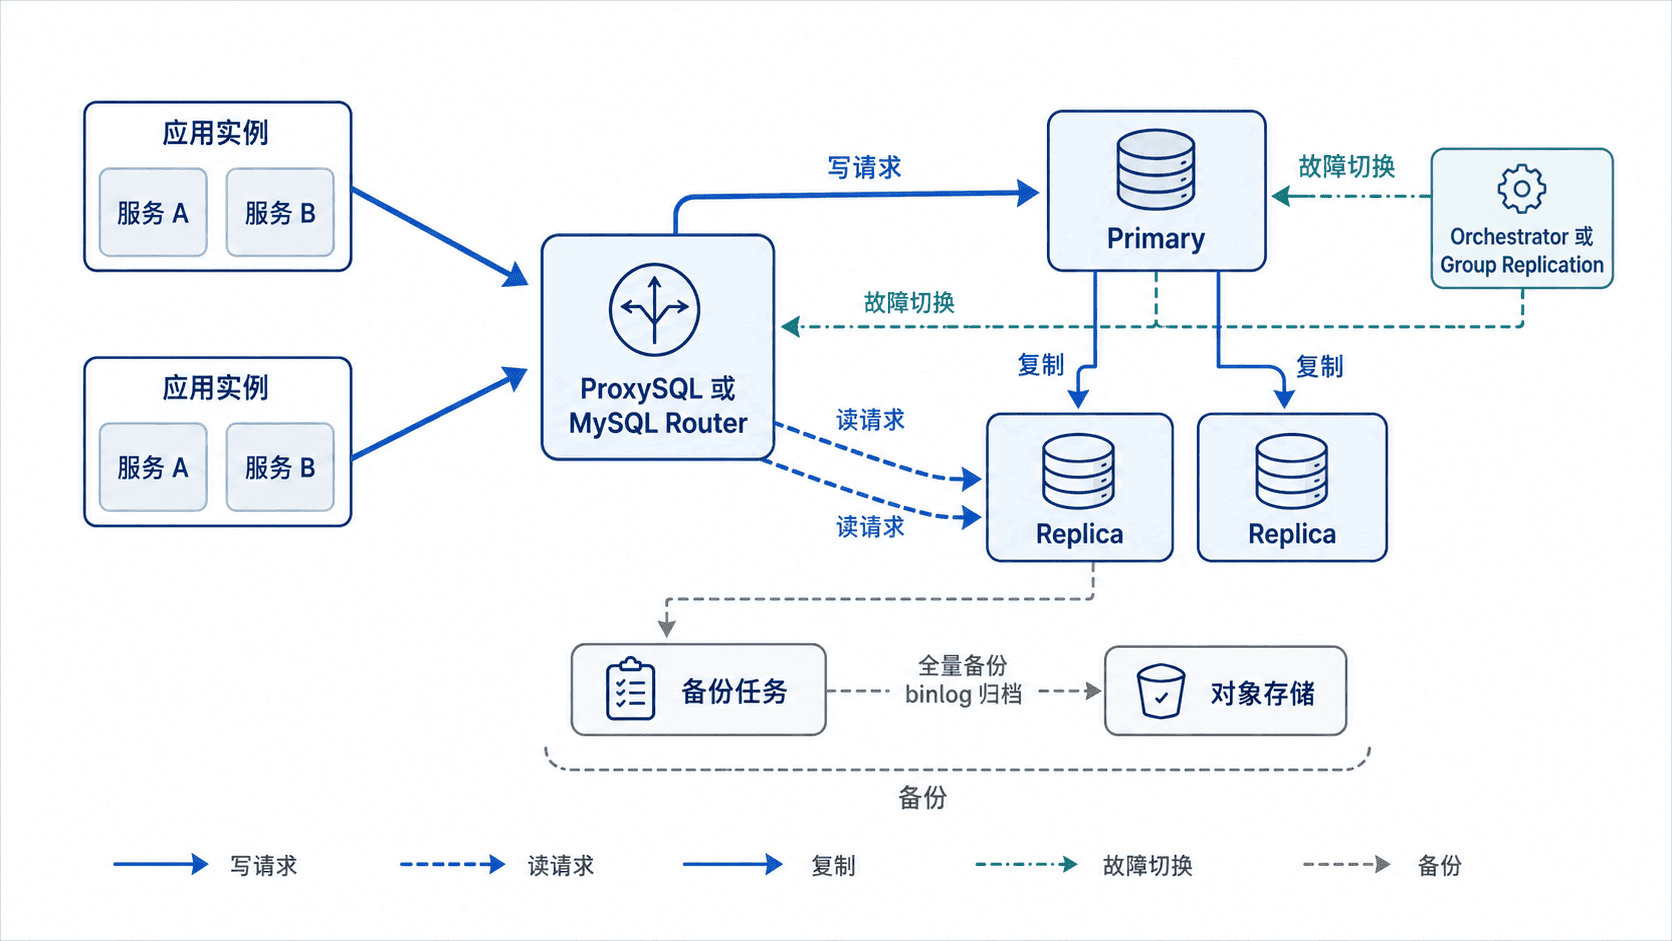
节点至少跨不同宿主机部署;需要抵御机房故障时,应将灾备副本放在独立故障域,并明确它是在线切换节点还是仅用于异地恢复。跨地域同步会放大写延迟,不应只为“看起来更安全”而强行组成同一个同步仲裁集群。
配置与切换必须守住的边界
基于传统复制的方案应启用 GTID、binlog 和崩溃恢复能力。下面是副本节点的最小配置片段,主节点需要使用不同的 server_id,并关闭只读限制。
[mysqld]
server_id=102
log_bin=mysql-bin
binlog_format=ROW
gtid_mode=ON
enforce_gtid_consistency=ON
relay_log_recovery=ON
read_only=ON
super_read_only=ON
这是片段示例,需要放入实际 MySQL 配置文件并重启实例。生效后可通过 SHOW VARIABLES 验证 GTID、binlog 和只读状态;不要在主节点误开 super_read_only,否则业务写入会被拒绝。
自动切换还必须配套 fencing:旧主失联后,要先阻止它继续接收写流量,再提升新主。只做“选出新主”而不隔离旧主,会产生双主写入和数据分叉。代理层、VIP、DNS 或服务发现的刷新时间也应计入 RTO,而不是只统计数据库选主时间。
用命令验收副本健康
在每个副本上执行以下命令,确认节点只读、复制线程正常且没有持续错误。将占位符替换为实际连接信息。
MYSQL_HOST="<REPLICA_HOST>"
MYSQL_PORT="<PORT>"
MYSQL_USER="<USER>"

mysql -h "$MYSQL_HOST" -P "$MYSQL_PORT" -u "$MYSQL_USER" -p -e "
SELECT @@hostname AS node,
       @@read_only AS read_only,
       @@super_read_only AS super_read_only;
SHOW REPLICA STATUS\G
"
预期输出
+----------------+-----------+-----------------+
| node           | read_only | super_read_only |
+----------------+-----------+-----------------+
| <REPLICA_HOST> |         1 |               1 |
+----------------+-----------+-----------------+
Replica_IO_Running: Yes
Replica_SQL_Running: Yes
Seconds_Behind_Source: <SECONDS>
Last_IO_Error:
Last_SQL_Error:<PORT>、<REPLICA_HOST>、<USER> 和 <SECONDS> 的实际值会不同。Seconds_Behind_Source 只能作为参考,还应观察 GTID 差距、复制队列、网络延迟和业务端到端提交时间。
最终选型建议
没有特殊约束时,可按以下顺序决策:已有系统优先“主从复制 + 半同步 + ProxySQL/Orchestrator”;新建且希望统一使用官方组件时选择 InnoDB Cluster;同城低延迟并强调已确认事务不丢失时评估 PXC;只有在单主容量经压测确认不足后,再进入分库分表或分布式数据库路线。
上线前至少完成一次主节点宕机、代理刷新、旧主隔离、延迟副本追平和备份恢复演练。真正可用的集群不是“节点都在线”,而是故障发生后能在目标 RPO、RTO 内恢复,并且结果可验证、过程可回放。