
大数据与流处理 / 技术文章
Flink Watermark 不推进怎么排查
窗口迟迟不触发、事件时间定时器不执行,往往不是窗口本身坏了,而是某条输入链路让 Watermark 停在旧时间。面向使用事件时间的 Flink 开发者,下面用指标追踪一条最短排查路径,最终判断卡点来自空闲分区、时间戳、生成策略还是阻塞。
先确认卡住的是 Watermark,不是窗口
先观察发生问题的窗口或定时器所在算子。先把 currentInputWatermark 与窗口或定时器需要越过的事件时间阈值相比。指标长时间停在阈值以下时,即使完全没有新数据,也应沿事件时间链路检查 Source。若已达到预期的触发时间却没有结果,再核对窗口边界、Trigger、定时器注册和迟到处理。
在有下游输出的算子上同时查看 currentOutputWatermark。输入已经推进、输出停滞时,核对当前算子的处理和转发;输入本身停滞时向上游追。对双输入算子分别查 currentInput1Watermark、currentInput2Watermark,并查看各输入是否空闲。活跃输入中较小的 Watermark 会限制合并进度。
从下游向上游找到第一处停点
以下使用 Flink 2.3 REST API。先在 shell 中设置 REST 根地址 FLINK_REST(末尾不带斜杠)、JOB_ID、VERTEX_ID 和从 0 开始的 SUBTASK,运行前两行取得实际指标 ID。对于算子输出 Watermark,从列表复制目标算子的完整 ID 到 OP_METRIC,再执行第三条命令。例如列表里可能出现 Parse.currentOutputWatermark。双输入的两个独立 Watermark 也按同样方式取带算子名前缀的 ID。
endpoint="$FLINK_REST/jobs/$JOB_ID/vertices/$VERTEX_ID/subtasks/$SUBTASK/metrics"
curl -fsS "$endpoint"
curl -fsS --get "$endpoint" \
  --data-urlencode "get=currentInputWatermark,numRecordsInPerSecond,numRecordsOutPerSecond,$OP_METRIC"
第二次查询返回 JSON 数组,元素形如 {"id":"currentInputWatermark","value":"1700000005000"}。值以字符串表示。Flink 初始 Watermark 可为 -9223372036854775808(Long.MIN_VALUE),应作为尚未得到有效 Watermark 的信号。Source 没有普通上游时不必强行找任务输入 Watermark。查不到某项时,先确认版本、任务是否运行、指标作用域和具体 ID。 Flink 2.3 指标 · Flink 2.3 REST API
从故障算子向 Source 逐个比较这些值,定位“上一个算子仍在推进、下一个算子开始固定”的第一处边界。若吞吐也接近零,优先查数据源或空闲分区;若吞吐很高而 Watermark 落后越来越多,优先查背压、积压和时间戳分布。
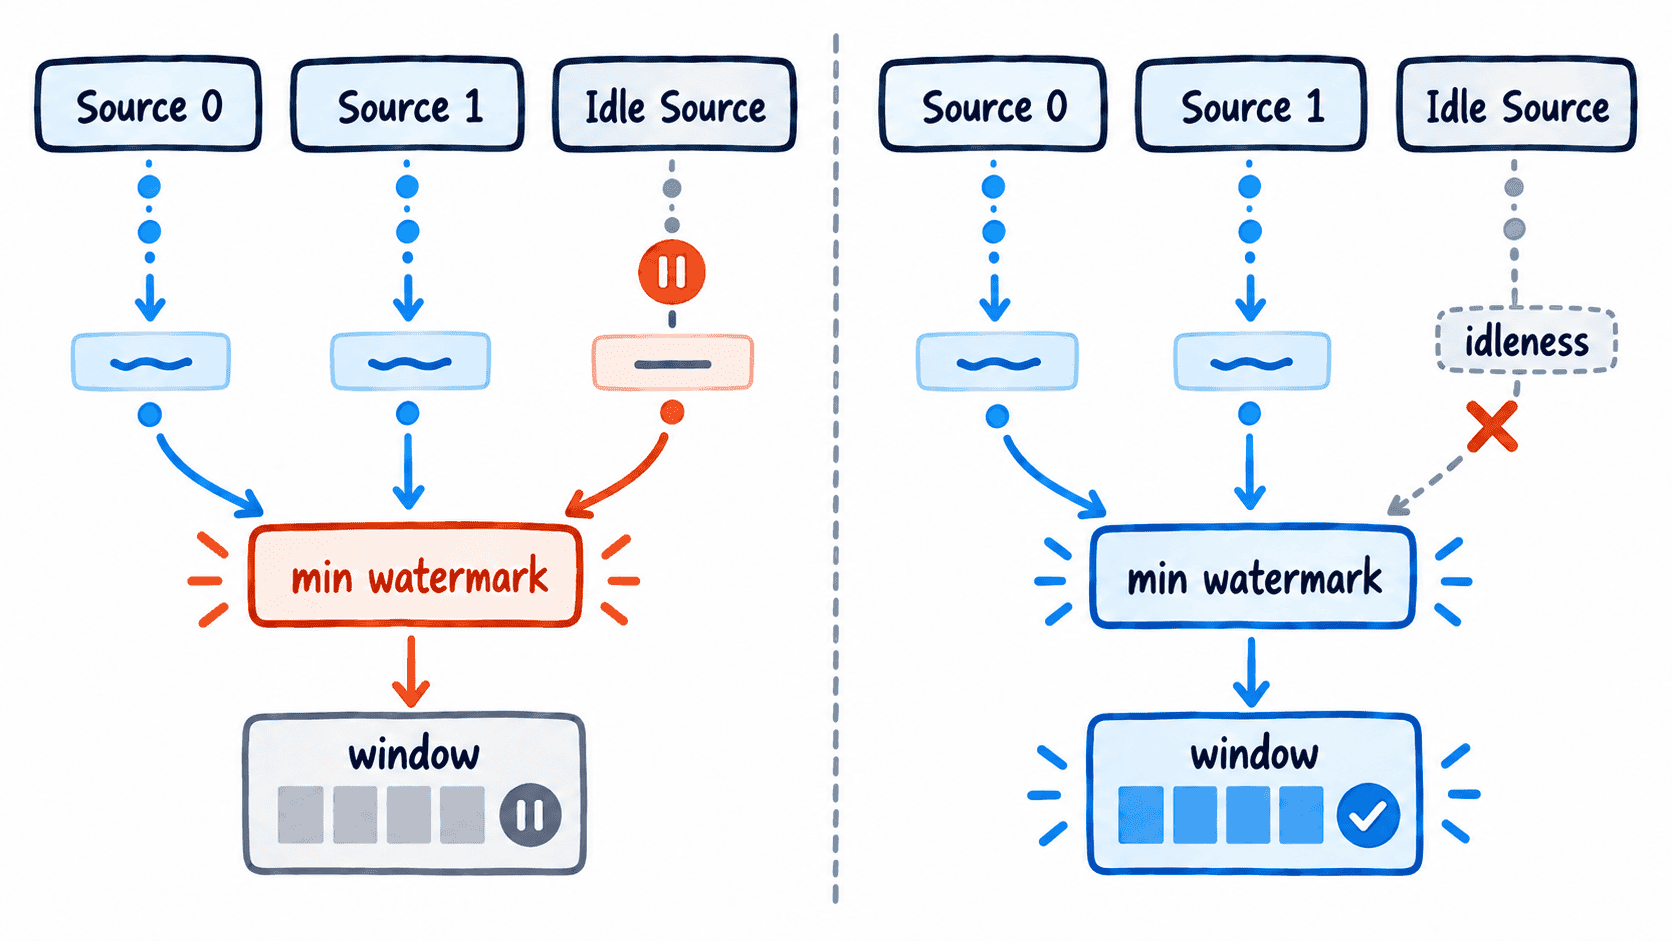
先查空闲分区与空闲 Source
这是最常见的卡点。并行输入的下游 Watermark 受最慢通道限制;某个 Kafka 分区长时间没有事件、Source 并行度高于有效分片数,或流量天然不均衡时,没有新记录的通道可能一直保留旧 Watermark。
DataStream 作业可以给 WatermarkStrategy 增加空闲检测。下面是片段示例,依赖已有的 Event 类型和 source,并假设 eventTimeMillis() 返回毫秒时间戳。
WatermarkStrategy<Event> strategy =
    WatermarkStrategy.<Event>forBoundedOutOfOrderness(Duration.ofSeconds(5))
        .withTimestampAssigner((event, recordTimestamp) -> event.eventTimeMillis())
        .withIdleness(Duration.ofMinutes(1));

DataStream<Event> events =
    env.fromSource(source, strategy, "event-source");
在支持相应分片水位线的 Source 中,空闲检测能让一段时间无事件的分片退出活跃输入的最小值计算。实际粒度和检测时刻取决于 Source 实现和 Watermark 周期回调。在 Source 之后再统一生成 Watermark 时,检测的是该处各 Subtask 看到的输入,无法单独识别已合并的分片。恢复的数据若落在下游已经越过的事件时间区间,下游 Watermark 不会回退,应按窗口的允许迟到或侧输出规则核对这些记录。超时应结合正常分片事件间隔和对迟到记录的容忍度设定。 Flink Watermark 策略
再查事件时间和生成策略
如果所有分区都有数据,下一步直接抽样事件时间。重点比较“最新业务事件时间”“当前 Watermark”“机器处理时间”三者,而不是只看记录数量。
常见问题包括:把秒级 Unix 时间戳当成毫秒;解析失败后把事件时间写成 0 或固定默认值;取错字段导致时间戳长期不变;自定义 WatermarkGenerator 只更新最大时间却没有在周期回调中发射;生成逻辑尝试发出比已发 Watermark 更小的值。Watermark 可以保持不变,已经向下游发出的进度不能回退。Flink 2.3 的有界乱序生成器在周期发射时按最大已见事件时间减去乱序容忍毫秒数,再减 1 ms。比如本分片最大时间为 20,000 ms、容忍 5,000 ms,下一次正常发射为 14,999 ms。错误的时间单位会让进度长期偏离预期,偶发的过大时间戳也可能提前推进进度。 有界乱序生成器实现
排查时可临时记录每个 Source subtask 的最大事件时间和当前 Watermark 差值。若最大事件时间持续增长但 Watermark 不变,检查生成与发射逻辑;若两者都不增长,问题在时间戳提取或上游数据本身。
排除背压、多输入和对齐造成的假停滞
Watermark 会沿数据流传播,因此严重背压或长队列会让它和前面的数据一起延迟到达下游。此时 Source 侧 Watermark 正常增长,而某个中间算子的输入 Watermark 落后,通常还能同时看到吞吐下降、busy 时间升高或反压迹象。应先消除阻塞算子,而不是直接缩小乱序容忍时间。
双输入算子要分别比较两路输入 Watermark,任何一路长期落后都会限制合并结果。在支持对齐的 FLIP-27 Source 上启用 watermark alignment 后,快 Source 或受支持的分片可能被暂停以限制与组内最慢 Watermark 的漂移。对齐应配在 Source,检查组名、最大漂移、更新间隔和连接器的分片暂停支持。首个公共 Watermark 发布后可结合 watermarkAlignmentDrift 与 watermark.pausedTimeMsPerSecond 等指标判断。 Flink 水位线对齐
修复后按同一条证据链验收
修复完成后,至少连续观察一个覆盖正常流量波动的时间段。Source 和故障算子的 currentOutputWatermark、currentInputWatermark 应在有事件时间进展的负载下按设计推进,低流量期允许保持不变。按分片比较最大事件时间与 Watermark,并把乱序容忍、发射间隔和传播排队分开估计;原先不触发的窗口或事件时间定时器应恢复触发。
还要专门验证两个边界:让一个分区短暂无数据,确认它进入 idle 后不会拖住其他分区;再恢复该分区流量,确认它能重新变为 active。最后检查迟到数据计数或侧输出是否异常上升,避免把“Watermark 能走”误当成“事件时间语义正确”。