
API 设计 / 技术文章
接口超时、重试与重复执行到底有什么关系
这篇文章解决一个很常见但容易误判的问题:接口超时之后,服务端到底有没有执行?客户端重试为什么可能把一次业务变成两次甚至多次执行?适合 Java 后端、网关与微服务开发者。读完后,你应能正确设计超时、重试和幂等之间的边界,避免重复下单、重复扣款和重复写数据。
超时只说明“没有按时拿到结果”,不代表服务端停止了
客户端调用接口时,通常会配置连接超时和读取超时。发生读取超时时,只能说明调用方在规定时间内没有收到完整响应,不能推出服务端没有收到请求,更不能推出服务端已经停止执行。
请求可能已经到达网关,也可能已经进入应用线程,甚至数据库事务已经提交,只是响应在返回途中超时。此时客户端看到的是失败,服务端看到的却可能是成功。
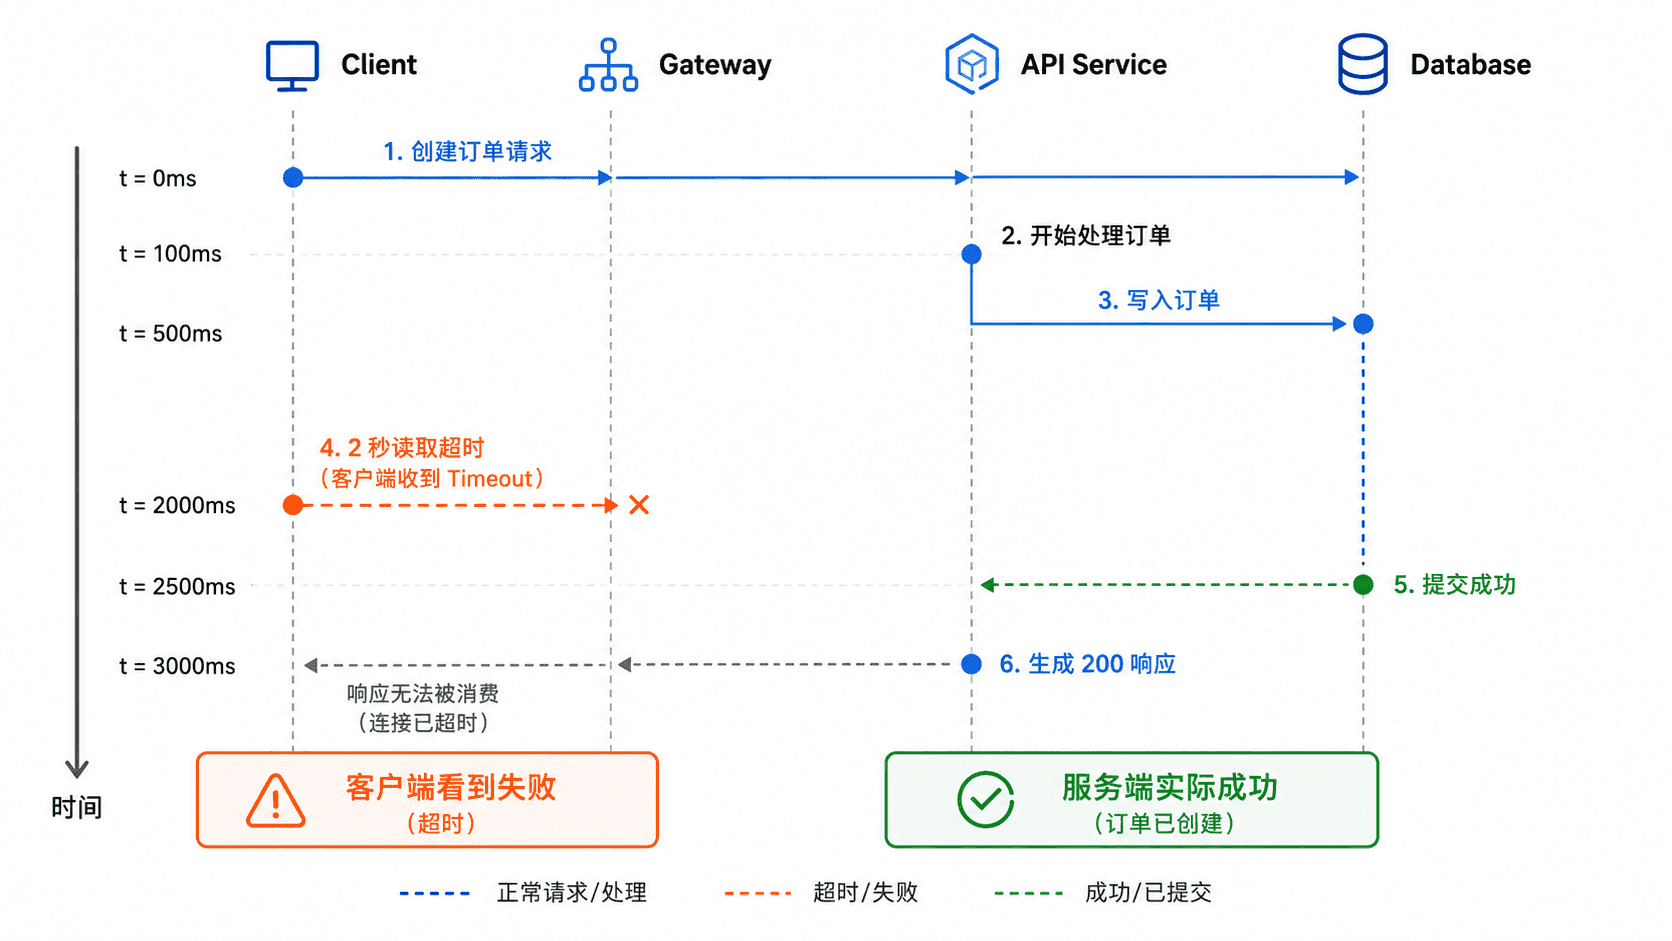
因此,超时本质上是一种调用方视角的不确定状态。如果这是查询接口,重试通常风险较低;如果这是创建订单、扣库存、支付确认等写接口,贸然重试就可能制造重复副作用。
重试为什么会把一次请求变成多次执行
重试的设计目标是提高成功率。网络抖动、瞬时 502、连接被重置、下游短暂不可用,都可能通过重试自动恢复。但重试机制无法天然判断上一次请求究竟“完全没到服务端”,还是“已经执行成功但响应丢了”。
最危险的时间窗口通常是:
- 第一次请求已经到达服务端。
- 服务端已经完成核心业务写入。
- 返回响应时发生超时、断网或网关连接中断。
- 客户端或网关认为第一次失败,于是重新发送同一个业务请求。
- 服务端再次执行同一逻辑。
如果接口没有幂等保护,重试次数越多,重复执行的上限就越高。
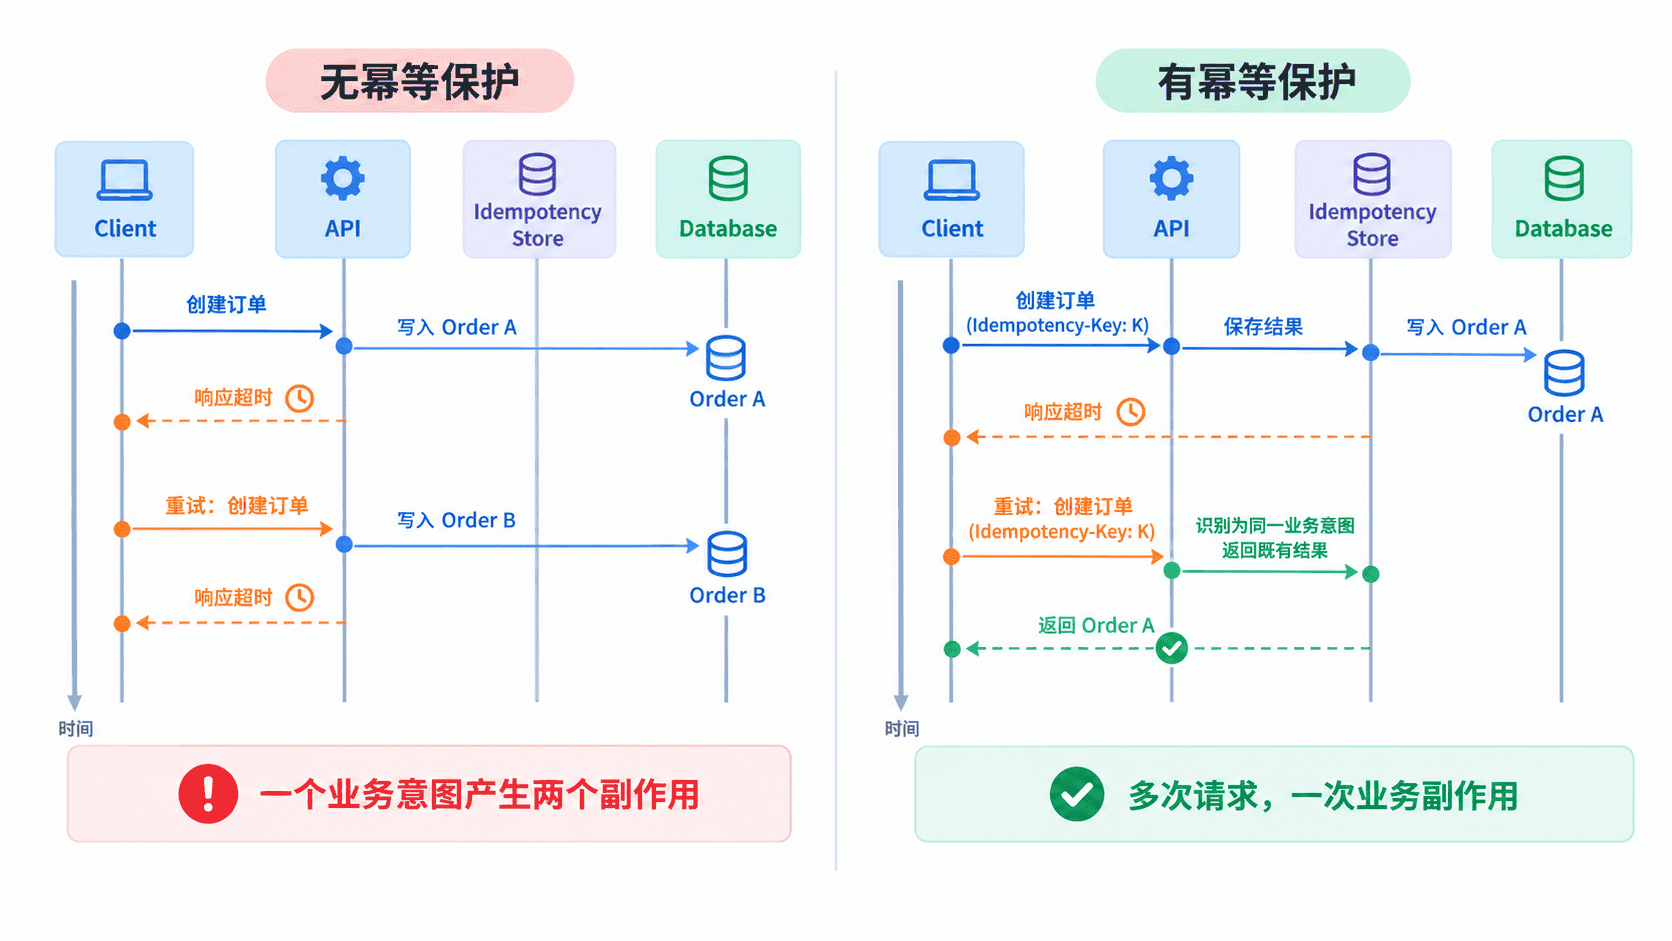
所以,“接口支持自动重试”与“接口可以安全重复执行”是两件完全不同的事。只有后者成立,前者才真正安全。
哪些错误适合重试,哪些错误不该重试
并不是所有失败都应该重试。判断的核心是:失败是否可能通过再次请求自动恢复,以及再次执行是否安全。
| 结果 | 一般是否重试 | 关键原因 |
|---|---|---|
| 连接建立失败 | 确知当前请求未发送时可有限重试 | 若经代理转发或存在先前尝试,仍需根据整条链路判断 |
| 读取超时 | 谨慎重试 | 服务端可能已经执行成功 |
| HTTP 502 / 503 / 504 | 仅对已确认可安全重试的操作,按契约有限重试 | 这些状态无法证明上游业务没有执行,网关超时尤其需要核对副作用 |
| HTTP 429 | 操作可安全重试且预算允许时退避 | 有 Retry-After 时遵守等待要求,无提示时按客户端退避策略处理 |
| HTTP 400 / 422 | 通常不重试 | 参数或业务输入不会因立即重试而自动变正确 |
| HTTP 401 / 403 | 修复认证后再请求 | 原样重试通常无意义 |
| 明确业务失败 | 通常不自动重试 | 例如余额不足、库存不足 |
即使某个错误“适合重试”,写请求仍然应该先具备幂等能力。否则技术层为了提高可用性而做的自动重试,会反过来破坏业务正确性。
重试策略本身也要有边界
可靠的重试通常不是“失败后立刻再发三次”,而是有限次数、指数退避,并加入随机抖动,避免大量客户端同时重试形成重试风暴。
下面用 Java 模拟一条已允许重试的只读请求。示例使用虚拟时钟,单次尝试固定消耗 80 ms,前两次得到可重试错误。随机等待从零到当前退避上限抽取。生产客户端应使用单调时钟、实际 I/O 超时和独立随机源。
import java.util.SplittableRandom;

public class RetryDemo {
    private static final int MAX_ATTEMPTS = 3;
    private static final long CALL_MILLIS = 80;

    static int simulate(long budgetMillis, int successAttempt) {
        var random = new SplittableRandom(17); // 固定种子使演示可复现
        long elapsed = 0;
        int attempts = 0;

        while (attempts < MAX_ATTEMPTS && budgetMillis - elapsed >= CALL_MILLIS) {
            attempts++;
            elapsed += CALL_MILLIS;
            if (attempts == successAttempt) {
                System.out.println("success after " + attempts + " attempts");
                return attempts;
            }
            // 模拟可重试失败。达到次数上限后不再等待。
            if (attempts == MAX_ATTEMPTS) break;
            long cap = 100L << (attempts - 1);
            long jitter = random.nextLong(cap + 1);
            if (budgetMillis - elapsed < jitter + CALL_MILLIS) break;
            elapsed += jitter;
        }

        System.out.println("stopped: attempts=" + attempts);
        return attempts;
    }

    public static void main(String[] args) {
        if (simulate(1000, 3) != 3 || simulate(100, 3) != 1 ||
                simulate(1000, 4) != MAX_ATTEMPTS) {
            throw new AssertionError("retry budget was not respected");
        }
    }
}
预期输出:
success after 3 attempts
stopped: attempts=1
stopped: attempts=3
实际工程中,尝试、退避等待与结果处理都要消耗同一个总预算。每次调用前重新计算剩余时间并设置相应超时。服务端若提供 Retry-After,可按秒数或 HTTP 日期解析等待要求。等待后已没有足够时间时,结束本轮重试。错误分类应依据协议和接口契约,参数错误、鉴权失败等不能仅因抛了异常就再次发送。参见 HTTP 重试与幂等语义和 AWS 超时、退避与抖动实践。
超时、重试和幂等应该作为一个整体设计
三者之间可以用一句话概括:
超时制造“不确定”,重试尝试“重新获得结果”,幂等保证“重复尝试不会重复产生业务副作用”。
因此,写接口设计时不要分别配置三个独立参数就结束,而应该把它们放在同一个调用契约里考虑。
客户端需要知道请求超时时能否重试;重试时必须复用同一个业务请求号或 Idempotency-Key,而不是每次生成新键;服务端收到重复请求后,应识别同一个业务意图,并返回首次执行结果或当前处理状态。
检查网关、SDK、HTTP 客户端和 Service Mesh 的重试设置。若三层都允许首次尝试加两次重试,且每次上层尝试都触发一整套下层重试,最深处最多收到 3 × 3 × 3 = 27 次请求。预算、提前成功或错误分类可能降低实际次数。明确由哪一层负责重试,并把外部写入的业务标识与剩余时间沿调用链传递。
生产环境应该遵守的设计原则
对于查询接口,可以把重点放在合理超时、有限重试和退避策略上。对于有副作用的写接口,则必须额外建立稳定业务标识、幂等记录或数据库唯一约束,确保重复请求仍然只产生一次业务结果。
超时值不要只按“平时平均响应时间”设置,而应结合调用链延迟预算和下游最坏可接受时间;重试不要无限进行,也不要多层组件重复叠加;出现超时时,不要默认认为上一次执行失败。
最终要形成的工程认知是:超时不是执行结果,重试不是失败回滚,幂等也不是简单防连点。只有把三者一起设计,系统才能在网络不可靠、服务抖动和重复请求同时出现时,既保证可用性,又守住业务正确性。